Votre chronologie d'affaire vit
dans les fils de discussion
Demandez à un assistant juridique d'un petit cabinet où passe le temps lors de l'établissement d'une chronologie, et la réponse n'est rarement le tableau. Une chronologie d'affaire (également appelée ligne du temps de l'affaire ou chronologie des événements) est une liste datée des événements clés d'un litige, chaque entrée étant liée au document ou au témoignage qui la prouve. Les colonnes sont simples. Ce qui n'est pas simple, c'est de lire des centaines de messages transférés, de décider laquelle des trois dates d'une chaîne de réponses est celle qui compte, puis de la saisir dans une ligne. La ligne du temps est le livrable. L'e-mail est le goulot d'étranglement.
Points clés à retenir
- Une chronologie d'affaire ressemble à un problème de mise en tableau, mais c'est en réalité un problème de lecture.
- 73 % du coût de production des preuves va à la révision des documents, où même les réviseurs rapides plafonnent à près de 100 documents par heure.
- Nommez les colonnes une seule fois et chaque message transféré devient une ligne, la ligne du temps n'étant alors qu'à un tri de distance.
Dresser une chronologie de l'affaire est simple. La lecture est le vrai travail.
Les avocats ont besoin d'une chronologie à presque chaque étape d'une affaire. Ils l'utilisent pour préparer un témoin à une déposition, pour repérer une lacune dans les preuves avant que la partie adverse ne le fasse, pour vérifier si une réclamation relève du délai de prescription, et pour expliquer une position de règlement à un client ou à un assureur. Chacun de ces usages repose sur la même chose : une ligne par événement, dans l'ordre, avec une citation renvoyant à la source. La structure s'apprend en une heure. La remplir prend des jours.
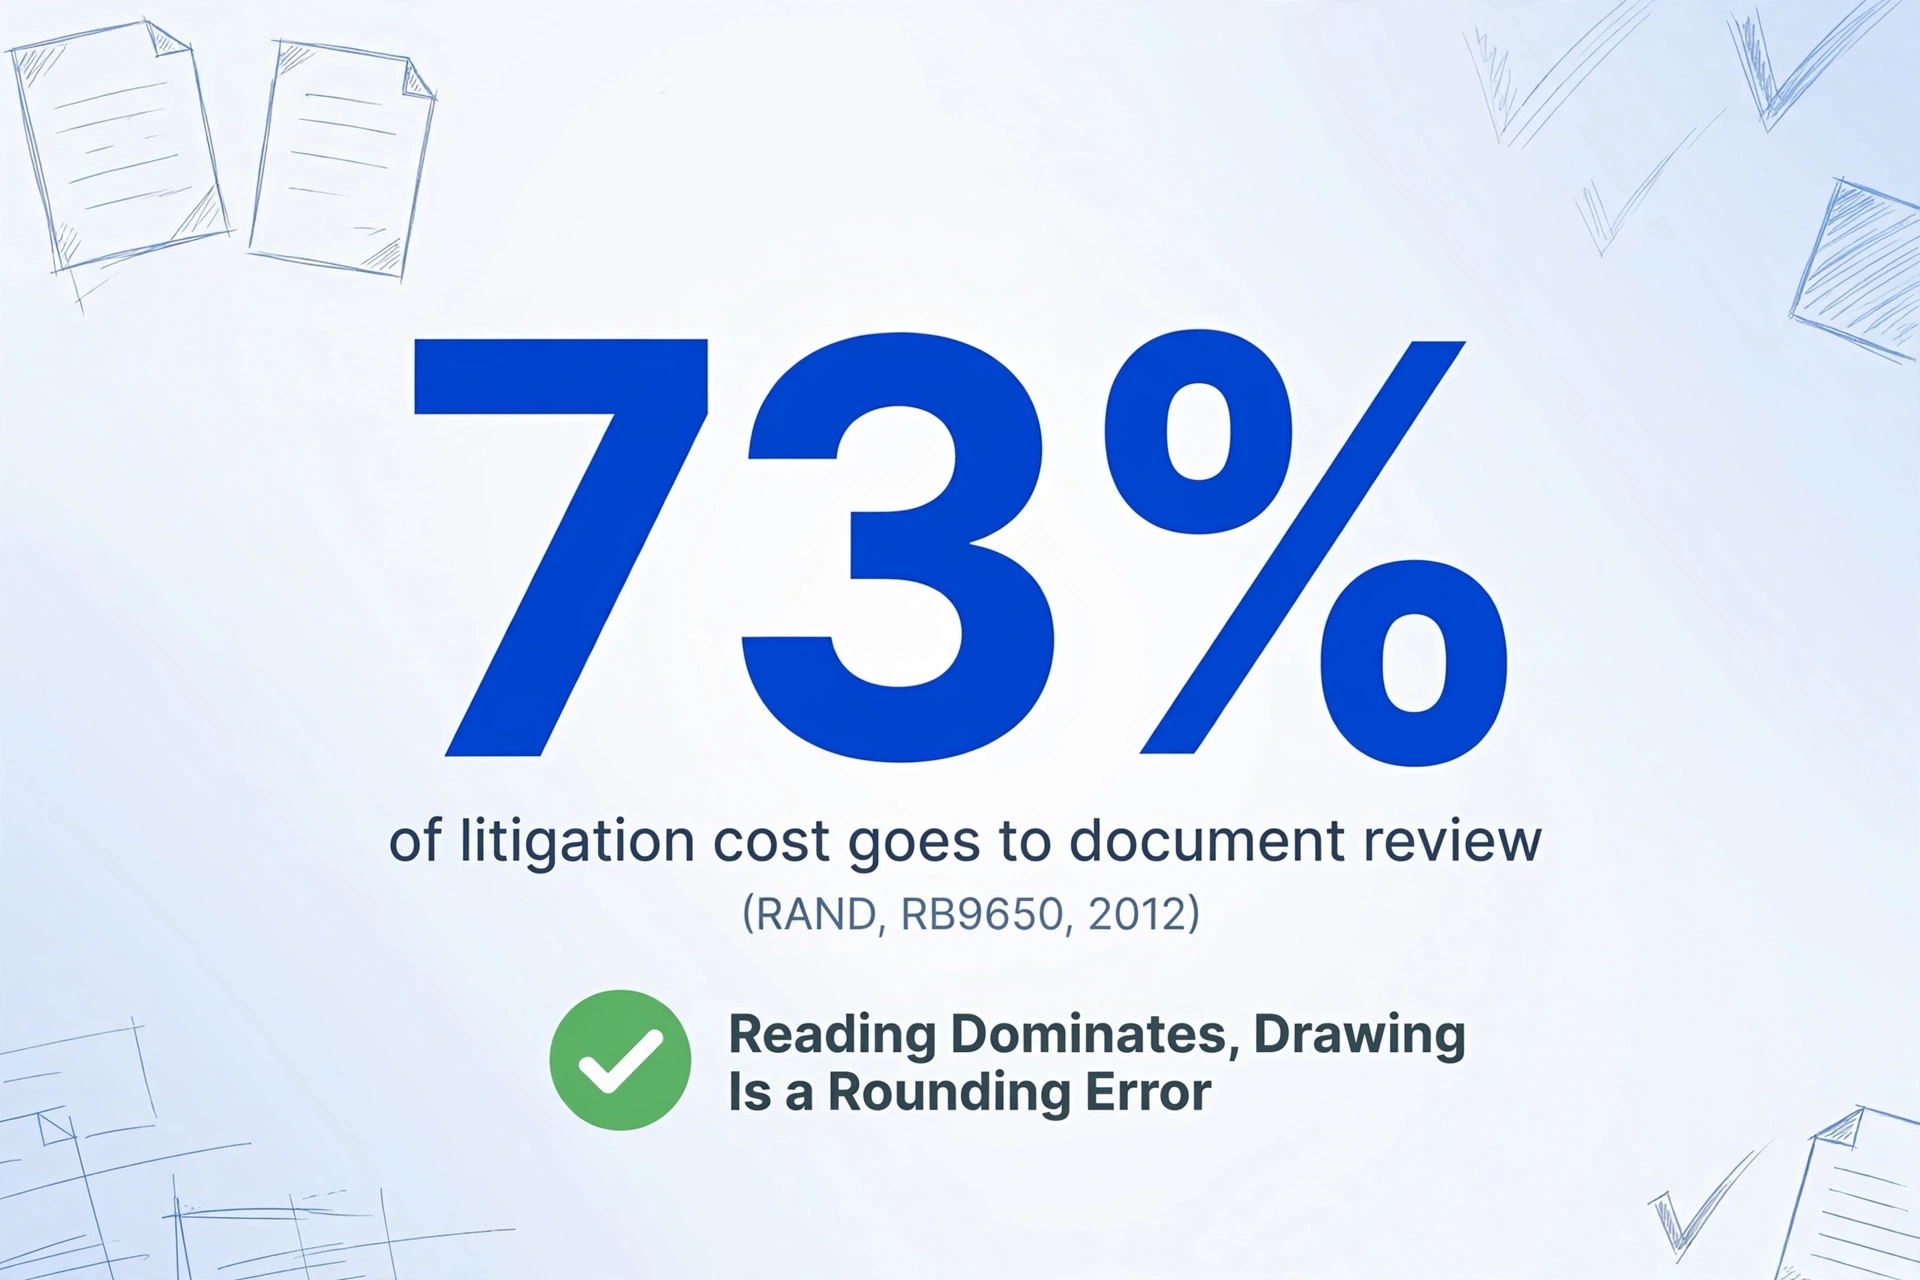
La raison est que l'examen des documents, plutôt que le montage du tableau, est ce qui prend le plus de temps. Une étude de la RAND Corporation sur les grands litiges a révélé que l'examen représentait 73 pour cent du coût total de production des preuves, et que même les examinateurs expérimentés plafonnent à près de 100 documents par heure (RAND, RB9650, 2012). Un petit cabinet ne traite pas ces volumes, mais le ratio tient : la lecture domine, et le dessin est une erreur d'arrondi.
La chronologie n'est pas difficile à dresser. Elle est difficile à mériter, un e-mail à la fois, avant de dessiner quoi que ce soit.
L'étape de lecture impose désormais une obligation professionnelle en plus de son coût. L'Avis officiel 512 de l'American Bar Association, publié en juillet 2024, applique les devoirs de compétence, de confidentialité des clients et de supervision aux outils d'IA générative. L'utilisation de l'IA pour lire la correspondance des clients est autorisée, mais l'avocat doit comprendre l'outil, protéger ce qui y est saisi et vérifier ce qui en sort (Avis officiel 512 de l'ABA). L'objectif n'est donc pas de retirer l'avocat de la boucle. Il est de supprimer la ressaisie, afin que la boucle soit consacrée au jugement plutôt qu'à la transcription.
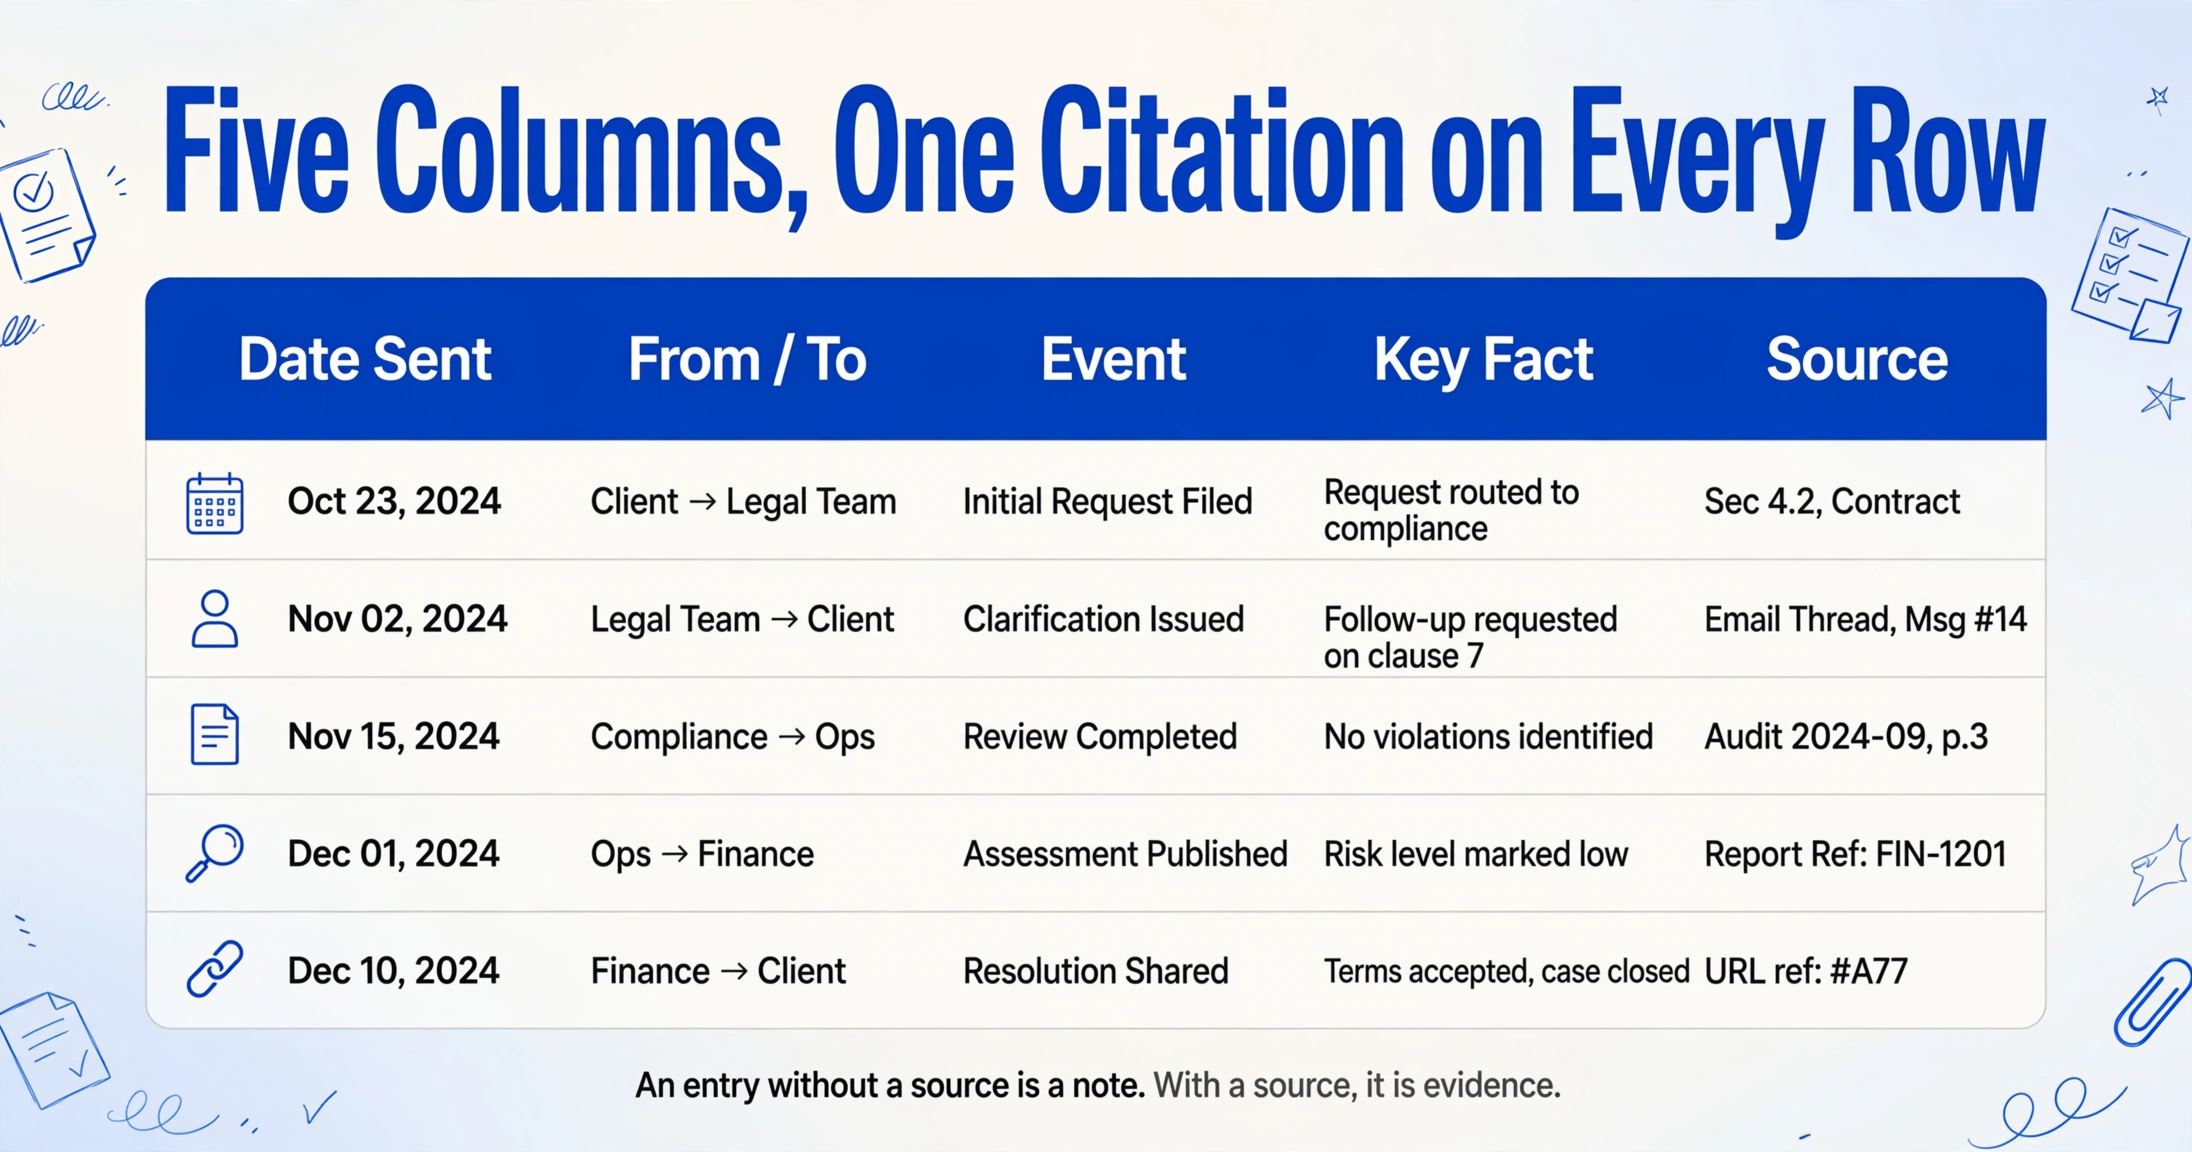
Une chronologie de l'affaire exploitable comporte cinq colonnes et une citation sur chaque ligne
Avant de comparer les outils, il est utile de définir à quoi doit ressembler le résultat, car le problème des e-mails est en réalité un problème de colonnes. Une chronologie de l'affaire construite à partir de correspondances est parfois appelée chronologie d'e-mails ou frise chronologique d'e-mails, et elle suit la même structure que toute autre : une date, un événement, les parties, le fait qu'elle établit et la source de chaque ligne. Une chronologie qu'un tribunal ou un assureur acceptera comporte ces cinq éléments, cités.
| Colonne | Ce qu'elle contient | Pourquoi c'est important |
|---|---|---|
| Date d'envoi | AAAA-MM-JJ, la date à laquelle le message a été envoyé, distincte de la date de transfert | Trier cette colonne est ce qui transforme un tas en frise chronologique |
| De / À | L'expéditeur et les destinataires, par nom et adresse | Établit qui savait quoi, et quand |
| Événement | Une description en une ligne de ce qui s'est passé ou a été convenu | La colonne vertébrale du récit |
| Fait clé | L'aveu, l'instruction, l'avertissement ou la contradiction que contient le message | Sépare les vingt lignes qui comptent des deux cents qui ne comptent pas |
| Source | Objet plus date, ou référence de la pièce jointe, pour le message exact | Une entrée sans source est une note. Avec une source, c'est une preuve |
Pour les documents électroniques, la colonne source n'est pas une décoration. Les Federal Rules of Civil Procedure traitent les informations stockées électroniquement comme une catégorie à part, et la Règle 26 définit la portée de ce qui est découvrable, y compris la proportionnalité par rapport aux besoins de l'affaire (Règle 26 des FRCP). La Règle 34 permet à la partie requérante de préciser la forme sous laquelle ces informations sont produites, c'est pourquoi une chronologie qui renvoie clairement à un message est plus défendable qu'une chronologie qui dit « e-mail, quelque part en mars ».
L'e-mail est la source la plus difficile d'un dossier à transformer en lignes propres
Un fil transféré peut contenir dix messages, trois dates candidates et aucun ordre fiable, c'est pourquoi l'étape d'ingestion est celle où le travail s'enlise, quel que soit le logiciel de chronologie utilisé. Les documents qui dominent le contenu des chronologies juridiques (rapports de police, dépositions, dossiers médicaux, plaidoiries) arrivent chacun comme un fichier avec une date. L'e-mail arrive comme une conversation, et une conversation ne tient pas dans une ligne sans être d'abord décomposée.
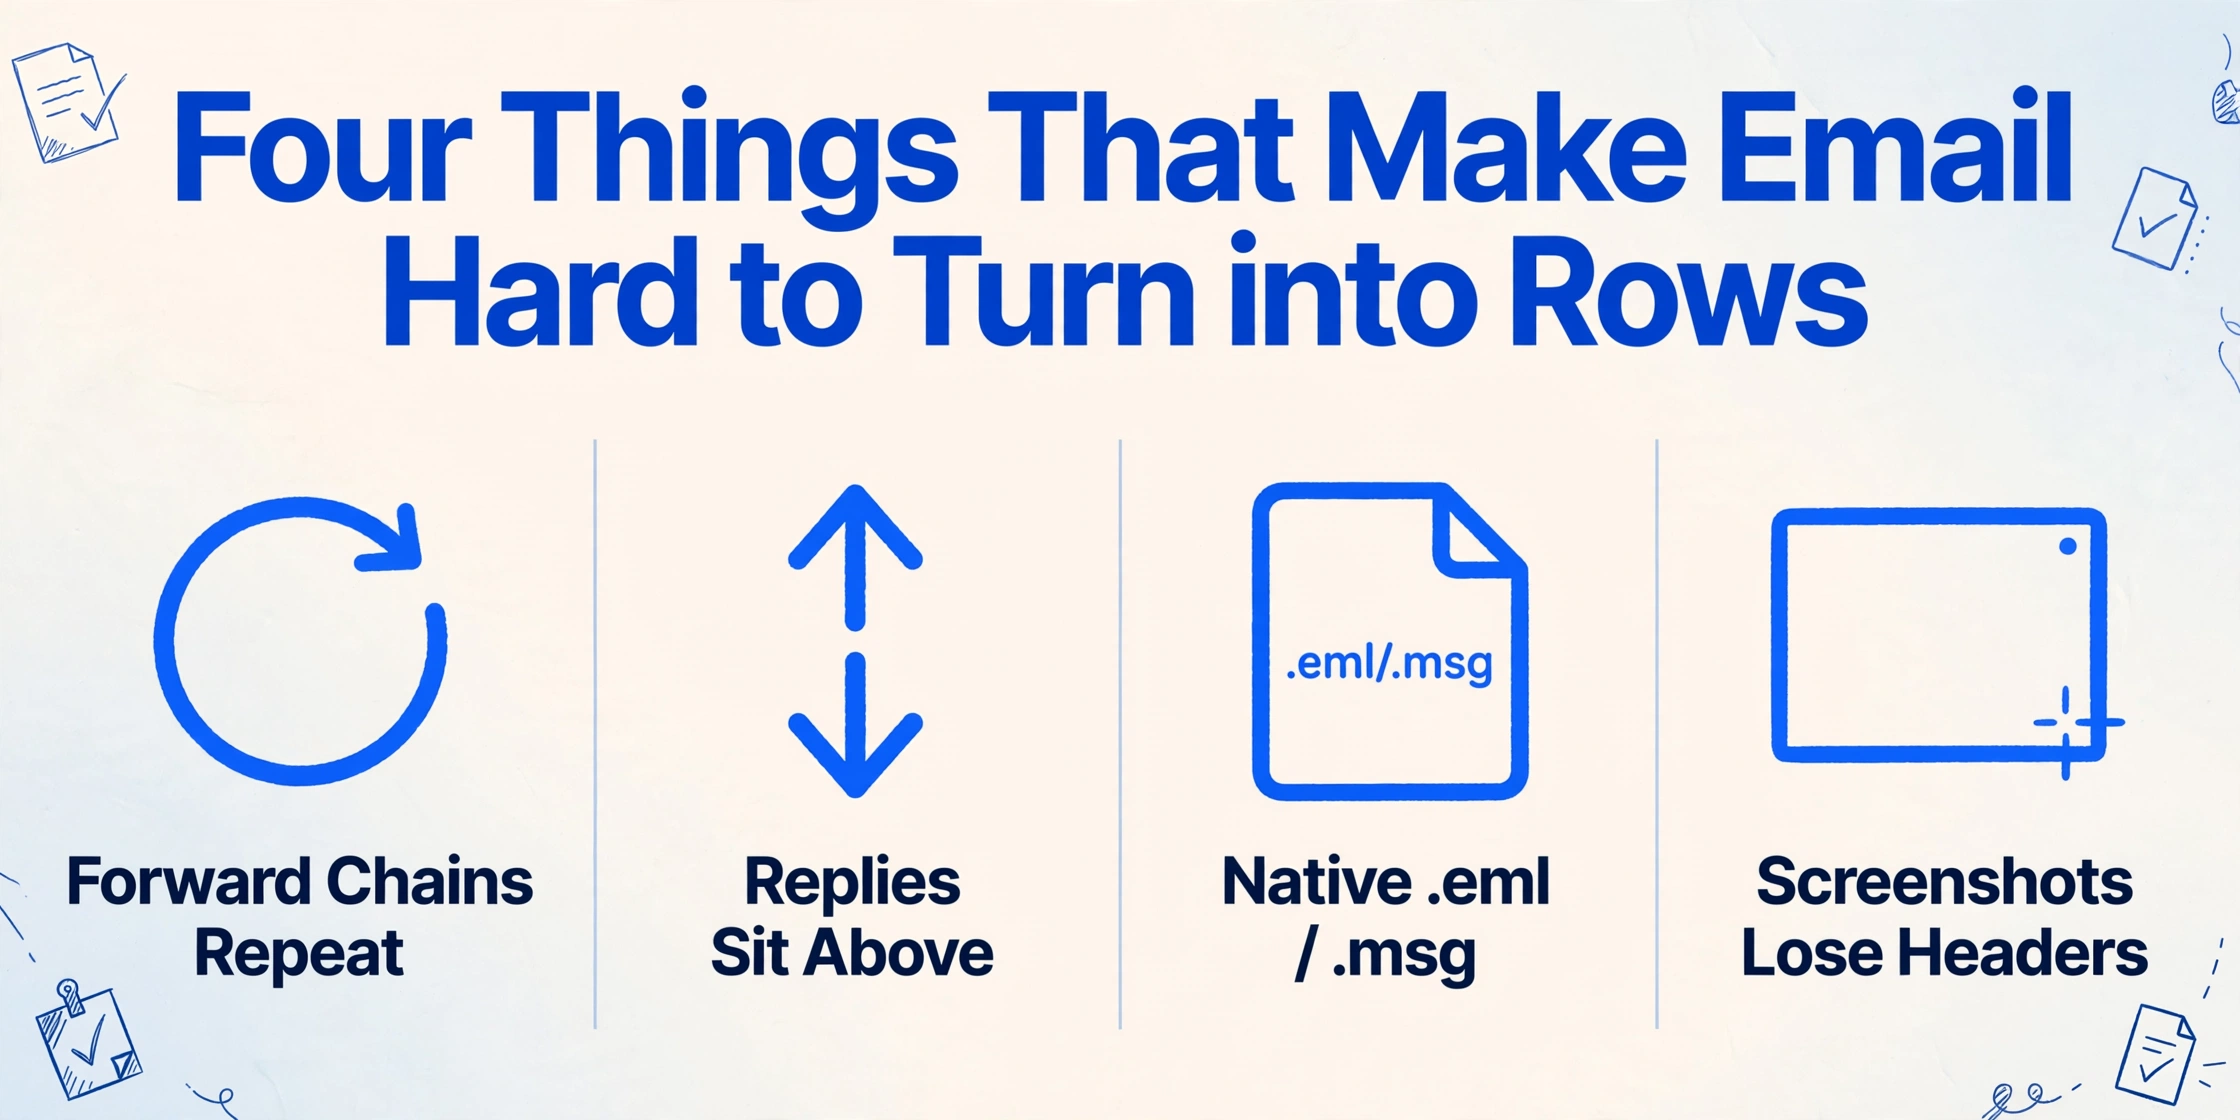
Quatre éléments rendent cette décomposition difficile. Une chaîne de transfert cite chaque message plus ancien sous le nouveau, donc le même événement apparaît plusieurs fois, et la copie citée affiche souvent une heure différente. Une réponse se trouve au-dessus du message auquel elle répond, donc lire de haut en bas ne signifie pas lire dans l'ordre. Les fichiers natifs .eml et .msg sont des exports de boîte mail plutôt que les PDF et images que la plupart des outils d'extraction acceptent. Et une capture d'écran d'un fil, la chose la plus rapide qu'un client puisse envoyer, perd complètement les en-têtes d'expéditeur et de destinataire.
Les personnes qui font ce travail décrivent le goulot d'étranglement dans les mêmes termes que le reste de cet article. Sur r/paralegal, un commentateur spécialisé en contentieux a résumé tout le travail comme « le vrai travail est extraire-normaliser-séquencer », ajoutant que la difficulté est de trouver le bon niveau de détail car « trop succinct et ils manquent la causalité, trop granulaire et c'est du bruit ». Dans le même fil, une assistante juridique a décrit l'envoi d'une chronologie à un avocat après avoir trié les signets à la main, et a nommé le gaspillage exact : « Je pense que cela me ferait gagner du temps si je pouvais simplement copier et coller les signets du PDF dans un e-mail à l'avocat au lieu de les retaper » (r/paralegal). Extraire, normaliser, séquencer. Chaque minute passée avant la séquence est une minute non consacrée à l'affaire.
C'est un problème plus étroit que celui déjà couvert par l'extraction de faits à partir de documents de découverte tels que les dépositions et les dossiers médicaux, où les fichiers sources sont séparés et chacun a sa propre date. L'e-mail est différent car l'entrée est un fil, et le problème d'ingestion est intrinsèque au format.
Transformer des fils de discussion en colonnes triables, puis les trier en chronologie
Vous transformez un dossier d'e-mails en chronologie datée en traitant chaque message comme une ligne et en définissant les colonnes avant toute lecture, de sorte que l'étape de lecture consiste à remplir plutôt qu'à copier-coller. ImageToTable.ai y parvient grâce à deux fonctionnalités déjà présentes dans le produit : Email Inbox, qui fait entrer les messages dans la file d'attente sans téléchargement ni réimportation, et Custom Column Extraction, qui transforme le contenu des messages en colonnes exactes dont une chronologie a besoin.
Email Inbox donne à chaque compte une adresse de boîte de réception dédiée. Vous transférez les messages liés à l'affaire à cette adresse, ou vous configurez une règle de transfert dans votre propre boîte aux lettres pour qu'ils y soient routés à leur arrivée, et ils atterrissent dans la file de traitement sans connexion ni page d'importation. Une liste blanche d'expéditeurs empêche les messages sans rapport d'entrer. Le paramètre le plus important ici est le mode de traitement. Par défaut, la boîte de réception lit les pièces jointes réelles et ignore le corps, ce qui est inadapté pour un litige qui réside dans le texte de la conversation. Vous pouvez passer en mode corps uniquement, ou pièces jointes et corps, afin qu'un message rédigé en texte brut et un message avec un PDF joint soient tous deux lus en une seule passe.
Custom Column Extraction transforme le contenu des messages en colonnes de la chronologie. Vous saisissez les noms souhaités, tels que date d'envoi, De, À, Objet, événement, fait clé et source, et ces noms deviennent les en-têtes de la sortie. L'IA localise chaque valeur en comprenant ce qu'elle signifie plutôt qu'en correspondant à une position fixe ou à un modèle, de sorte qu'une chaîne de transfert, un message simple et un message avec une réponse citée sont tous lus de la même manière. Comme l'e-mail est du HTML et que les tableaux HTML et les blocs de citation ne s'alignent pas de manière prévisible, la lecture par le sens est ce qui maintient les en-têtes stables entre des expéditeurs qui formatent leurs messages différemment.
Le traitement par lots place chaque message dans une seule feuille, et la chronologie est à un tri près. Importez ou transférez l'ensemble d'un coup et les messages fusionnent dans un seul fichier Excel, un message par ligne. Triez par date d'envoi en ordre croissant et la chronologie apparaît. Filtrez par De ou À pour isoler le côté d'une seule partie dans la conversation. Parcourez la colonne des faits clés pour repérer les contradictions, de la même manière que vous liriez le récit d'un témoin par rapport à un document.
Acheminez l'e-mail vers la file d'attente
Transférez les messages de l'affaire à l'adresse de boîte de réception dédiée de votre compte, ou définissez une règle de transfert pour qu'ils arrivent automatiquement. Activez la liste blanche des expéditeurs pour exclure les messages sans rapport, et choisissez les pièces jointes et le corps du message afin que les messages qui portent l'information dans leur texte soient également lus.
Nommez les colonnes de la chronologie une seule fois
Saisissez Date Sent, From, To, Subject, Event, Key Fact et Source, puis enregistrez-les comme modèle. Les noms de colonnes deviennent les en-têtes de la sortie. Liez le modèle et activez le traitement automatique pour que l'extraction démarre dès qu'un message arrive.
Triez la feuille fusionnée et vérifiez
Chaque message arrive sous forme de ligne dans une seule feuille de calcul. Triez par date d'envoi pour lire l'affaire dans l'ordre, filtrez par partie et parcourez le fait clé pour repérer les admissions et les contradictions. Pour toute ligne où une réponse citée a rendu la source ambiguë, survolez la cellule pour voir exactement quel texte a produit la valeur.
L'étape de vérification vaut la peine d'être effectuée, car une chaîne de transfert peut répéter plusieurs fois la même date. Le mode de révision d'ImageToTable.ai met en évidence le texte source derrière toute cellule extraite, de sorte que confirmer de quelle copie d'une date provient une ligne relève d'un coup d'œil plutôt que d'une relecture. Cela s'ajoute au travail que vous faites déjà avec les pièces jointes des e-mails, comme un analyseur d'e-mails qui lit les fichiers joints à un message, et la même approche par lots décrite pour produire par lots des documents de découverte juridique dans une seule feuille.
Les fichiers sont traités en toute sécurité et ne sont pas stockés.
Ce que cet outil ne fait pas
Cette approche lit le contenu des e-mails pour les organiser en colonnes triables, mais elle ne préserve pas les métadonnées natives de la boîte aux lettres, ne remplace pas une plateforme d'eDiscovery et ne produit pas à elle seule une pièce recevable au tribunal. Cinq limites méritent d'être énoncées avant de construire un flux de travail sur cette base.
Les fichiers natifs .eml et .msg doivent d'abord être convertis ou transférés. Une exportation brute de boîte aux lettres n'est pas un fichier que l'outil téléverse directement. Convertissez-la en PDF, ou transférez les messages via la boîte de réception des e-mails, et elle devient une entrée. Cela importe plus qu'il n'y paraît : cela détermine la manière dont vous collectez les documents auprès d'un client.
Les colonnes De, À et Date sont des valeurs extraites, et non les en-têtes originaux des e-mails. Elles proviennent de ce que le message affiche au lecteur. Cela suffit généralement pour une chronologie, mais ce n'est pas équivalent aux en-têtes bruts, au décalage horaire ou au chemin de livraison qu'une plateforme d'eDiscovery enregistre. Si vous avez besoin des en-têtes originaux pour l'authentification, travaillez à partir de la boîte aux lettres source.
La confidentialité reste votre décision. Selon l'Avis officiel 512 de l'ABA, confier la correspondance d'un client à un outil d'IA relève d'un jugement sur la compétence et la confidentialité des clients. Confirmez comment tout outil traite et conserve les fichiers avant d'y acheminer une affaire.
Ce n'est pas une plateforme d'eDiscovery. Il n'y a pas de journal des privilèges, pas de numérotation Bates, pas de regroupement des fils d'e-mails entre expéditeurs, ni de codage prédictif. Pour les affaires impliquant des dizaines de milliers de documents, des téraoctets de données ou un format de production défendable, les plateformes de révision gèrent ce travail, et le choix entre un outil d'extraction léger et une plateforme complète est exactement la comparaison présentée dans le logiciel de révision par rapport à l'extraction par IA pour un petit cabinet. Pour un panorama plus large des outils, le guide des logiciels d'extraction de documents pour les équipes juridiques couvre la place de chaque type.
Le résultat est une feuille de calcul que vous contrôlez. Vous obtenez un fichier Excel, CSV ou JSON, ou des lignes écrites dans Google Sheets. Ce n'est pas une surface de visibilité client ou de collaboration, et cela ne remplace pas le système de gestion des dossiers que Clio ou MyCase fournit. Cela remplace la partie du flux de travail où quelqu'un lit les e-mails et saisit les dates.
FAQ
Peut-il extraire les dates et les expéditeurs d'un fil de discussion transféré ?
Oui. Chaque message de l'ensemble devient une ligne, et les colonnes que vous définissez, telles que la date d'envoi, De, À, Objet et fait clé, sont remplies en lisant le contenu du message. Un bloc de citation qui répète un message plus ancien est une ambiguïté connue, c'est pourquoi le mode de révision vous permet de confirmer de quel texte provient une valeur.
Préserve-t-il les métadonnées d'origine de l'e-mail ?
Il extrait De, À et la date comme colonnes dans la sortie, tirées de ce que le message présente. Cela ne correspond pas aux en-têtes de courrier natifs ni aux données de fuseau horaire. Si vous avez besoin des en-têtes bruts pour l'authentification, collectez les messages depuis la boîte aux lettres source plutôt que depuis les transferts.
Peut-il lire directement les fichiers .eml ou .msg ?
Pas directement. Une exportation brute de boîte aux lettres doit être convertie en PDF ou transférée via la boîte de réception des e-mails d'abord. Les entrées prises en charge sont PDF, JPG, PNG, WebP et AVIF, donc un fichier de message natif nécessite une étape de conversion avant de pouvoir être traité.
Quelles colonnes une chronologie de l'affaire devrait-elle avoir ?
Un ensemble pratique comprend la date d'envoi, De, À, Objet, événement, fait clé et source. La colonne événement contient la description en une ligne, la colonne fait clé contient ce que le message prouve, et la colonne source renvoie au message exact afin que toute entrée puisse être vérifiée plus tard.
Est-ce un remplaçant pour l'eDiscovery ou une plateforme de chronologie ?
Non. Il lit les e-mails et les documents dans un tableur triable, et il ne fait pas d'examen des privilèges, de production Bates, ni de codage prédictif à grande échelle. C'est l'étape avant les outils de gestion de l'affaire et de révision : transformer la correspondance brute en lignes structurées afin qu'une personne puisse construire rapidement la chronologie.
Est-il sûr d'y mettre les e-mails des clients ?
C'est un jugement professionnel relevant des obligations de confidentialité et de compétence énoncées dans l'Avis officiel 512 de l'ABA, et la réponse dépend des obligations de votre cabinet et de la manière dont un outil traite les fichiers. Confirmez la politique de conservation et de traitement, et acheminez uniquement ce que l'affaire exige. L'extraction ne modifie pas votre obligation de vérifier le résultat avant son utilisation.
Le changement utile est le suivant : cessez de traiter l'e-mail comme quelque chose à lire et à ressaisir, et commencez à le traiter comme un tableau qui n'a pas encore ses en-têtes. Définissez les colonnes une fois, laissez les messages les remplir, et la chronologie juridique devient ce qu'elle a toujours dû être : une vue triée de ce qui s'est passé plutôt qu'une nouvelle transcription.