Meilleur parseur d'emails en 2026,
classé selon votre mix d'emails
Le Radicati Group a compté 361,6 milliards d'emails envoyés et reçus chaque jour en 2024, et son rapport sur le marché de l'email prévoit 392,5 milliards par jour en 2026 (The Radicati Group). Les données professionnelles transitent par ce canal : factures, confirmations de commande, avis d'expédition, prospects, relevés bancaires. La plupart n'arrivent jamais dans une feuille de calcul par elles-mêmes.
Recherchez « meilleur parseur d'emails » et la plupart des listes que vous trouverez ont été rédigées par l'outil qui arrive en tête. Cette page mène le même exercice avec une règle différente : chaque outil ci-dessous, y compris l'Email Inbox que ce site vend, est placé là où son comportement réel le situe, et le classement repose sur les deux propriétés de votre email qui décident de tout le reste. À quel point les formats de vos expéditeurs sont-ils stables, et vos données vivent-elles dans le corps du message ou dans une pièce jointe ?
Points clés à retenir
- Chaque classement de « meilleur parseur d'emails », y compris celui-ci, est une affirmation sur la boîte de réception de l'auteur plutôt qu'un fait sur la vôtre.
- Deux propriétés de votre propre courrier décident du gagnant : la stabilité des formats de vos expéditeurs, et si vos données vivent dans le corps du message ou dans une pièce jointe.
- Même le meilleur parseur se trompe parfois, donc l'étape que tous les récapitulatifs omettent est celle qui rend l'automatisation sûre : relier chaque valeur à sa source.
Un analyseur d'e-mails est un logiciel qui reçoit le courrier à une adresse dédiée vers laquelle vous transférez vos messages, lit le message et les fichiers joints, puis transforme les valeurs qui vous intéressent en lignes pour un tableur, un CRM ou une API. Une règle de boîte mail trie les messages dans des dossiers ; un analyseur lit leur contenu et en produit des données structurées.
Si l'extraction est difficile, c'est parce que l'e-mail n'a jamais été conçu pour porter une structure. La norme de l'Internet Engineering Task Force pour l'e-mail (RFC 5322) définit comment un message est assemblé : en-têtes, corps, pièces jointes. Elle ne dit rien sur ce que tout cela signifie. Chaque expéditeur est libre de présenter une facture comme il l'entend, et la plupart le font. Un analyseur doit donc reconstruire le sens à partir d'un bloc de texte sans schéma.
Il existe trois écoles. Les analyseurs à base de règles et de modèles (Mailparser, l'analyseur intégré à Zapier) vous obligent à décrire où se trouve chaque valeur, avec un modèle visuel ou des regex. Les analyseurs natifs IA (Airparser, le moteur GPT de Parsio, la boîte de réception e-mail d'ImageToTable.ai) vous permettent de nommer les champs souhaités et le modèle les trouve par le sens. Les plateformes hybrides (Parseur) exécutent les deux moteurs et vous laissent en assigner un par boîte mail. Ce seul choix de conception explique presque tout le reste concernant le coût, la maintenance et ce qui casse.
Un analyseur d'e-mails fonctionne à partir de ce que vous lui transférez à son adresse, et non à partir de toute votre boîte mail. Un outil basé sur le transfert ne voit jamais les messages que vous ne lui avez pas envoyés, c'est pourquoi les listes blanches d'expéditeurs et les règles de livraison comptent autant que le moteur d'extraction.
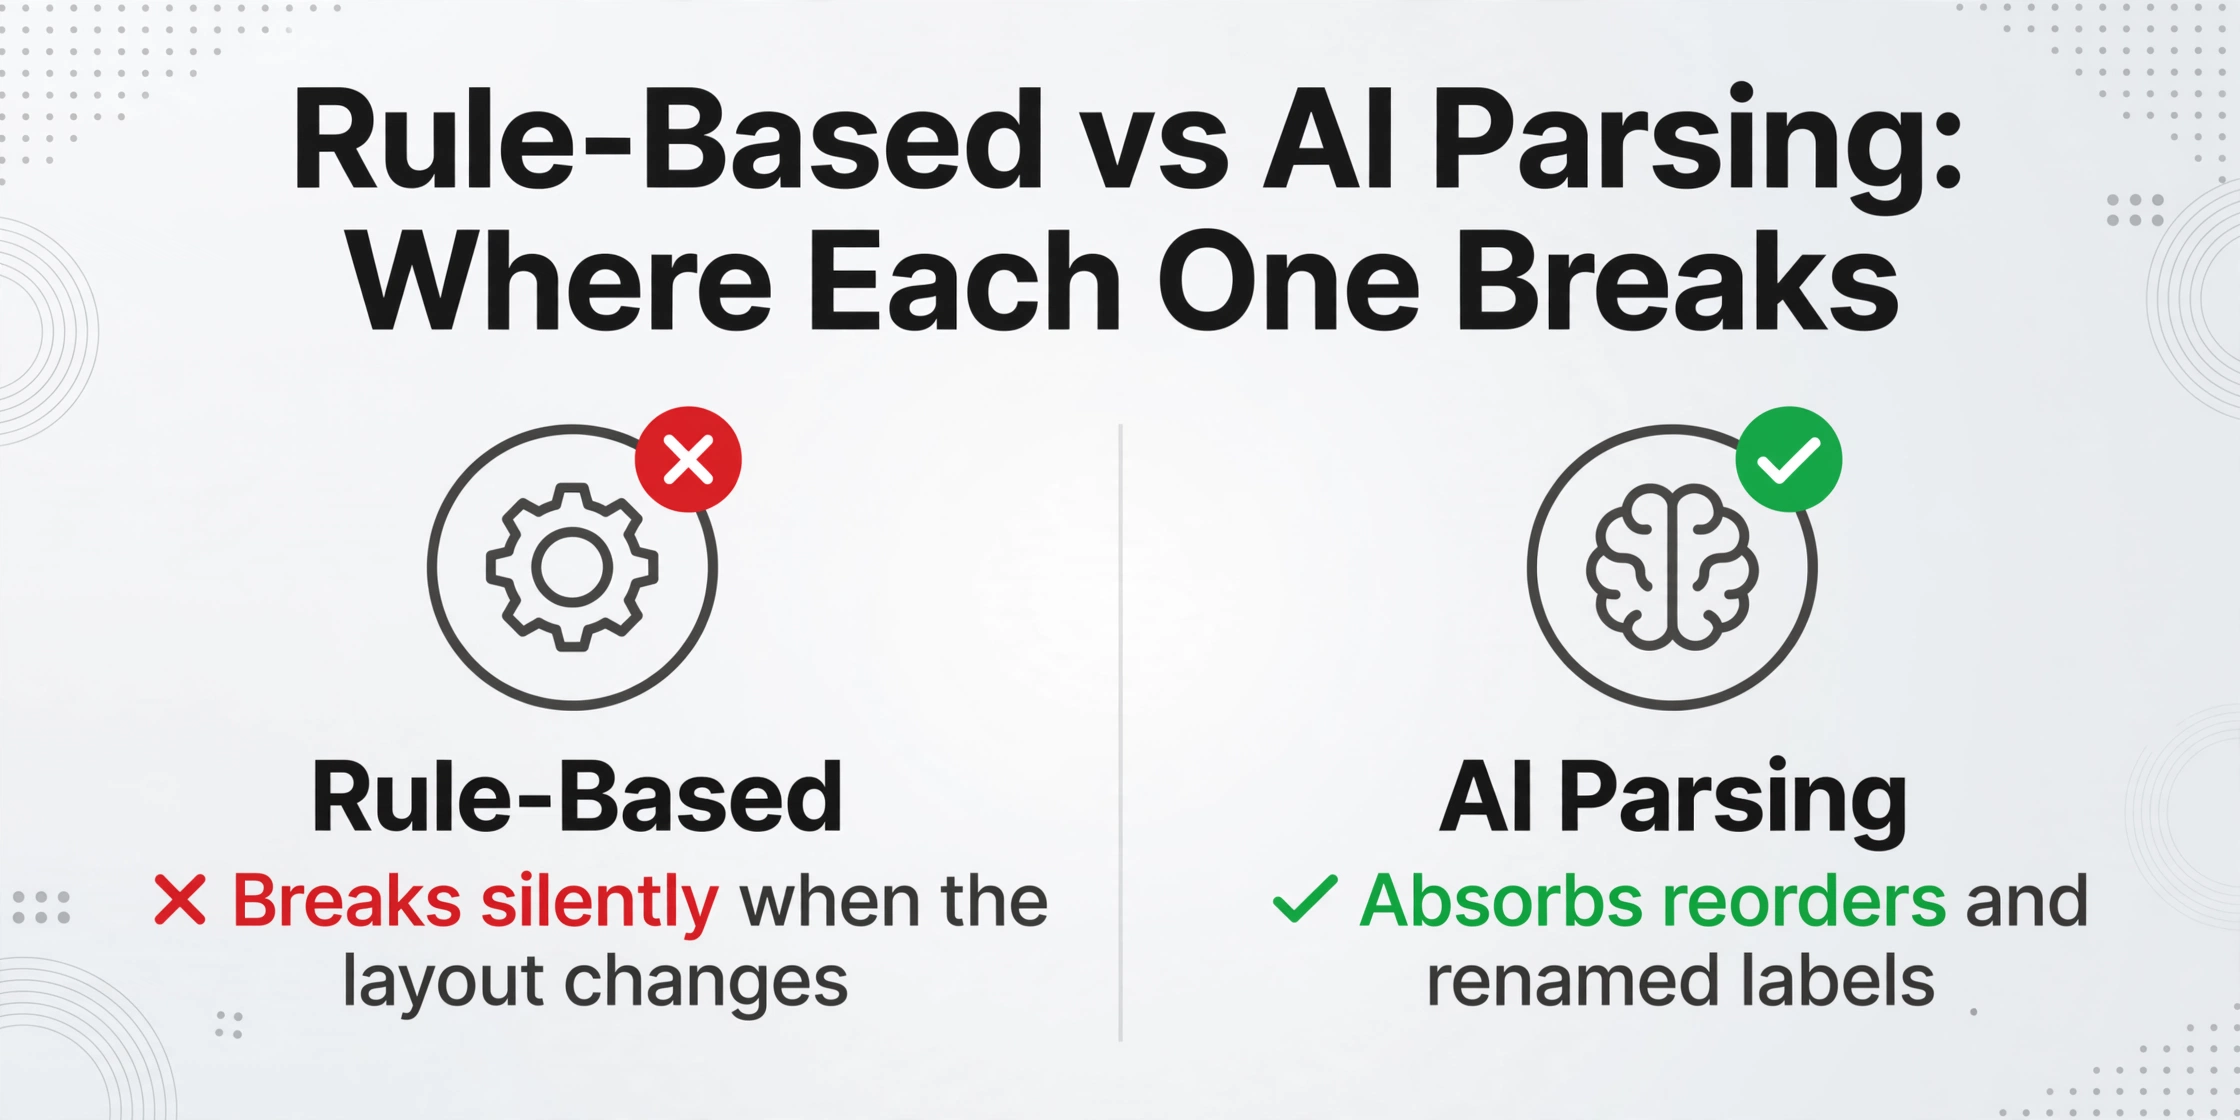
Un analyseur à base de règles suit des instructions que vous avez écrites, comme « prenez le nombre qui suit les mots Order ID ». Lorsque l'e-mail a toujours la même apparence, c'est rapide, peu coûteux par document et facile à auditer. Le coût apparaît à la mise en page suivante : chaque nouvel expéditeur ou refonte signifie réécrire et tester à nouveau la règle.
Cette charge de maintenance est exactement ce que décrivent les utilisateurs lorsqu'ils passent à l'IA. Un développeur travaillant avec des confirmations de commande et des avis d'expédition l'a dit clairement sur r/webdev : « L'approche habituelle semble être des règles regex ou des modèles fixes. Mais cela a tendance à casser dès que le format de l'e-mail change. » (r/webdev). Un autre utilisateur sur r/automation a signalé le même schéma après avoir changé : « Les analyseurs regex et à base de règles ont fonctionné jusqu'à ce que l'expéditeur fasse le plus petit changement. » (r/automation).
L'échec est pire qu'une lacune dans vos données, car il est souvent silencieux. Une règle ancrée sur une étiquette qui a bougé correspond toujours à quelque chose, mais à la mauvaise chose, et la mauvaise valeur se retrouve dans votre feuille de calcul. Un analyseur IA qui travaille sur le sens plutôt que sur la position absorbe généralement le réordonnancement, l'étiquette renommée, le pied de page supplémentaire.
Le miroir honnête s'applique à l'IA : l'extraction est probabiliste, donc une valeur revient parfois fausse avec une pleine confiance. Un chatbot générique avec des invites écrites à la main est un piètre substitut à un analyseur spécialisé, et l'utilisateur comptable qui a essayé la voie DIY a résumé l'écart : « écrire des invites sur GPT et corriger les erreurs qu'il fait est un autre cauchemar. » (r/Accounting).
Les règles ne sont pas obsolètes. Pour une alerte générée par machine qui est identique depuis des années, une règle est le choix le moins cher et le plus vérifiable. La règle de décision est simple : un petit ensemble fermé d'expéditeurs dont les formats n'ont pas bougé mérite ses règles ; au-delà, l'IA absorbe la longue traîne.
Corps ou pièce jointe : où vos données se trouvent réellement
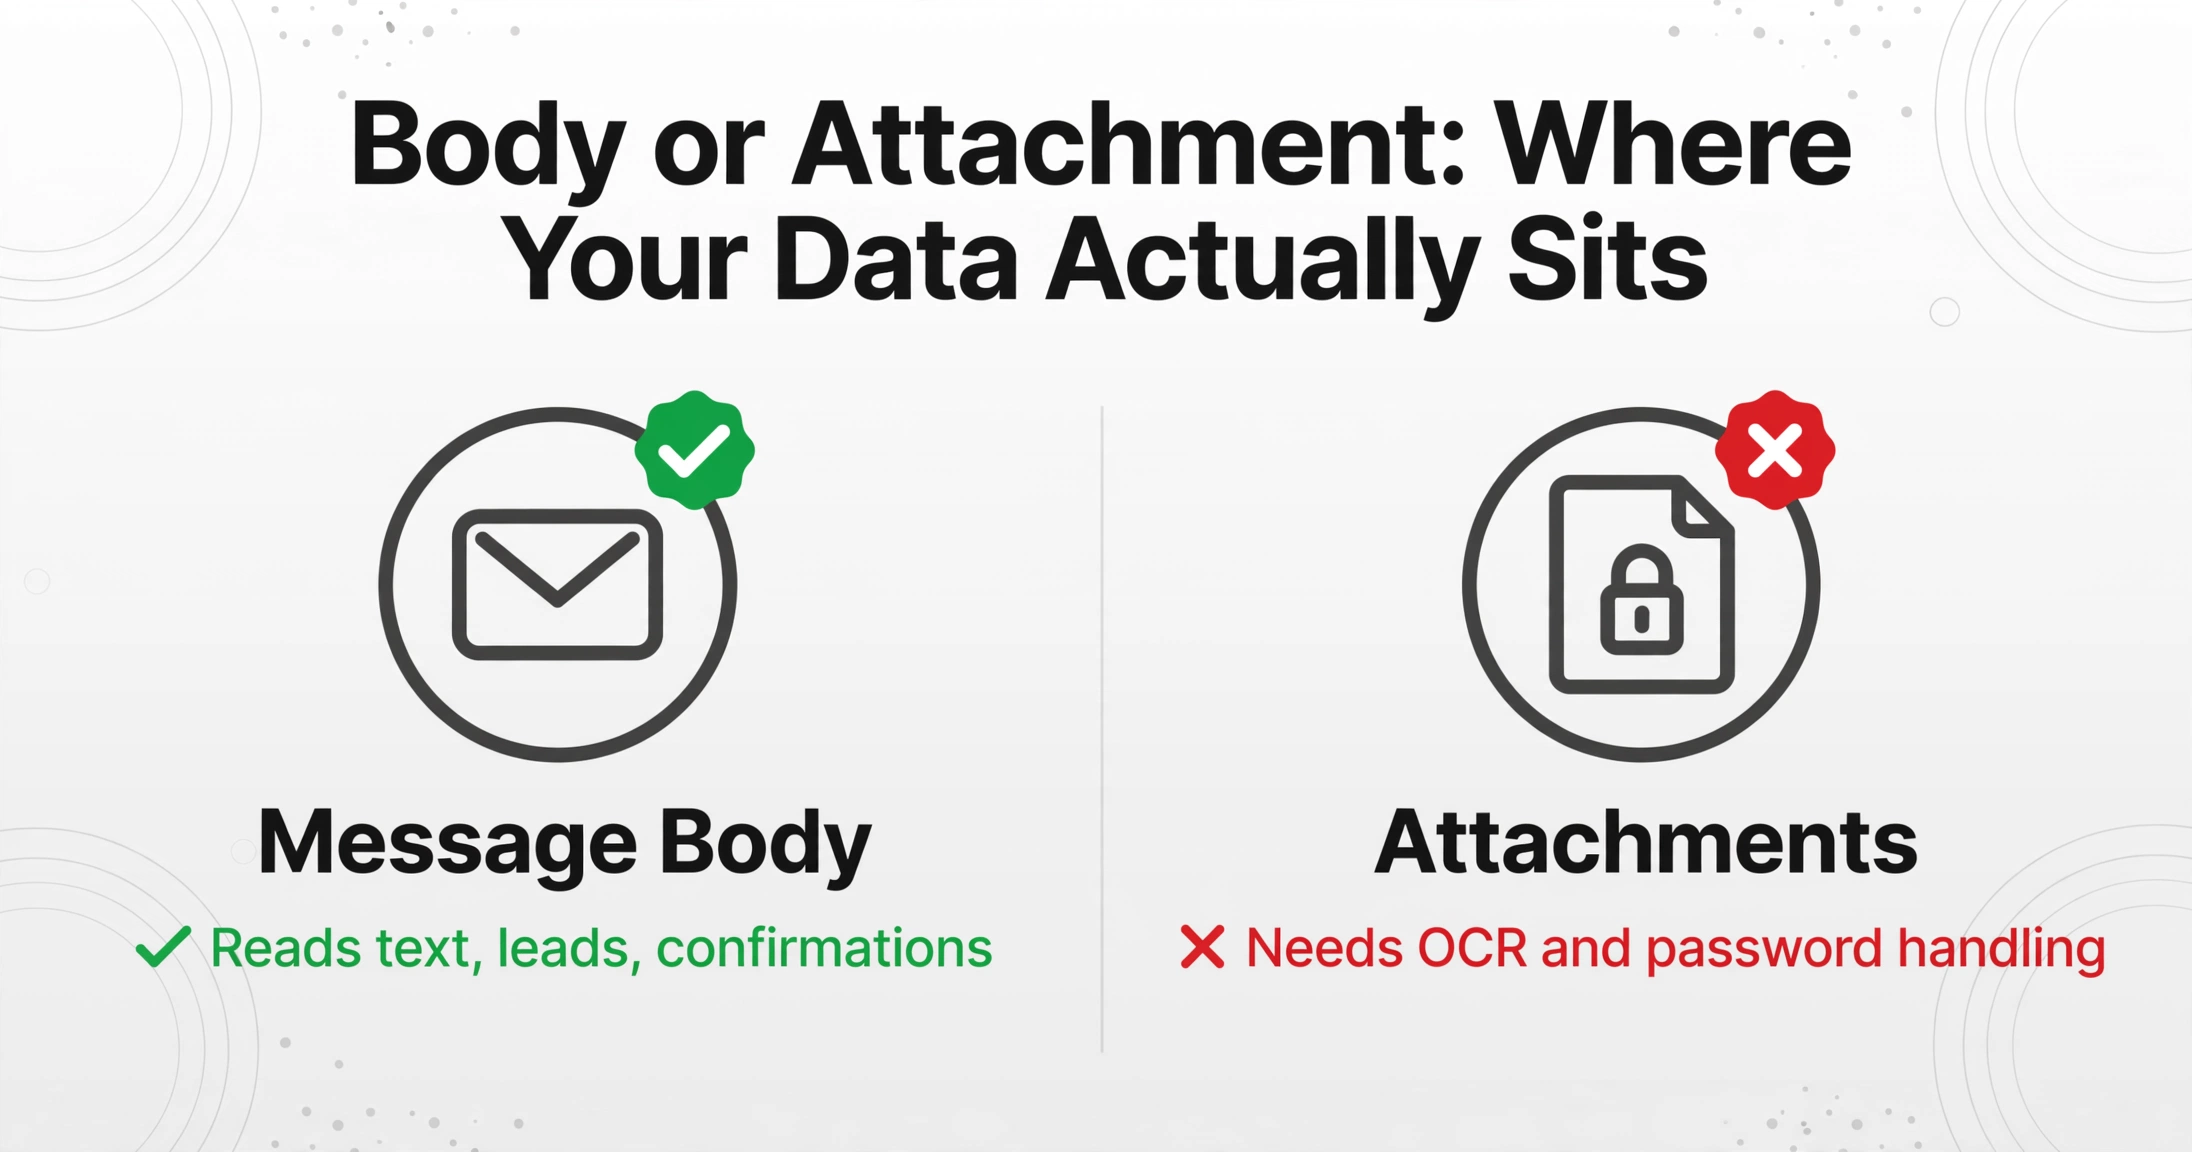
Que vos données se trouvent dans le corps du message ou dans une pièce jointe divise ce marché en deux, et c'est la question que la plupart des synthèses enterrent. Certaines équipes n'ont besoin que du texte qui arrive dans le message lui-même : prospects, confirmations de commande, notifications, détails de facture simples collés par un fournisseur. D'autres équipes ont besoin de la facture PDF jointe, du bon de commande scanné, du relevé bancaire protégé par mot de passe. Ce sont des tâches différentes, et de nombreux outils n'en font qu'une.
Commencez par l'option gratuite, car sa limite est instructive. Email Parser by Zapier extrait le texte que vous avez surligné dans un e-mail d'exemple à partir de messages envoyés à une adresse « @robot.zapier.com ». Les pièces jointes sont une autre histoire : la documentation du fournisseur note que plusieurs pièces jointes arrivent compressées avant que votre workflow ne les voie (Aide Zapier). Les fichiers sont transmis à votre Zap, pas lus.
Mailparser, l'analyseur à base de règles vétéran, montre la même limite depuis l'autre côté. Sa page de tarification est explicite sur les formats : il analyse les pièces jointes csv, xlsx, docx, pdf et txt, « mais ne prend pas en charge les images ou les documents scannés » (FAQ Mailparser). Si vos fournisseurs envoient des photos ou des scans par e-mail, un moteur de règles orienté texte les laissera passer.
Lire correctement les pièces jointes signifie exécuter l'OCR sur les pages scannées et gérer les cas particuliers. Airparser exécute l'OCR sur les formules payantes pour les images, les scans et le texte manuscrit. Parsio intègre un moteur d'OCR IA aux côtés de ses moteurs de modèle et GPT. La boîte de réception email d'ImageToTable.ai ajoute un traitement configurable : pièces jointes uniquement, corps uniquement, ou les deux ensemble, ce qui compte lorsqu'un fournisseur rédige la facture dans le message et qu'un autre la joint en PDF protégé par mot de passe. Les mots de passe enregistrés sont essayés automatiquement sur les fichiers chiffrés, et l'extraction lit les formats PDF, JPG, PNG, WebP et AVIF. Si vos données arrivent généralement collées dans le texte du message plutôt que dans un fichier, notre guide sur l'extraction des champs de facture directement depuis le corps d'un email couvre précisément ce cas.
L'outil qui ne peut pas lire votre type de pièce jointe n'échouera pas bruyamment. Il traitera silencieusement l'email, laissera le relevé joint non lu, et votre rapprochement mensuel restera en retard de deux documents sans que personne ne le remarque.
Six parseurs d'email comparés, prix de septembre 2026
Ces six outils couvrent le marché, et chacun est conçu pour un mélange d'emails différent. Les prix proviennent de la page tarifaire de chaque fournisseur et ont été vérifiés en septembre 2026 ; les formules changent souvent, alors vérifiez avant d'acheter. Le tableau donne la réponse rapide, les notes ci-dessous expliquent les compromis.
| Outil | Comment fonctionne l'extraction | Lit les pièces jointes | Prix d'entrée | Où les lignes arrivent |
|---|---|---|---|---|
| Mailparser | Règles d'analyse que vous écrivez par mise en page | PDF, DOCX, XLSX, CSV, TXT ; pas les images ni les scans | 29,95 $/mois pour 250 emails | Webhooks, Zapier, Google Sheets, CRM |
| Email Parser by Zapier | Mettez en surbrillance les champs dans un email d'exemple | Transmet les fichiers ; ne les lit pas | Gratuit, mais chaque exécution consomme des tâches Zapier | Toute application vers laquelle votre Zap écrit |
| Parseur | IA par défaut, modèles optionnels par clic | PDF y compris les scans, images, feuilles de calcul, Word | 20 pages/mois gratuites ; formules payantes selon le volume | Sheets, Excel, Zapier, Make, Power Automate, API |
| Airparser | L'IA extrait selon un schéma que vous définissez | Emails, PDF y compris les scans, images, DOCX, XLSX | Essai de 20 crédits/mois ; à partir de 39 $/mois pour 100 crédits | API, webhooks, Zapier, Make |
| Parsio | Moteurs de modèle, GPT, OCR IA et IA pré-entraînée | PDF, images, emails y compris les signatures | 30 crédits/mois gratuits ; à partir de 24 $/mois en facturation annuelle | Sheets, Excel, CSV, JSON, Zapier, Make, API |
| ImageToTable.ai | Vous saisissez les noms de colonnes, l'IA trouve les valeurs par sens | PDF y compris chiffré, JPG, PNG, WebP, AVIF | Démo gratuite ; Basic à partir de 9 $/mois | Excel, CSV, JSON, extension Google Sheets |
Mailparser est l'un des parseurs d'e-mails basés sur des règles les plus anciens du marché, et cette identité est à la fois sa force et son coût. Sur une mise en page stable provenant d'un groupe fixe d'expéditeurs, les règles produisent une sortie déterministe et auditable à un faible coût par e-mail ; chaque nouveau fournisseur ou refonte implique une nouvelle règle. Si votre travail dépasse le cadre des e-mails, notre panorama des meilleurs logiciels d'extraction de données le replace dans un contexte plus large.
Email Parser by Zapier remporte le cas « déjà dans Zapier » : en tant que nœud d'un flux plus vaste, un champ parsé alimentant une ligne Sheets ou une mise à jour CRM est réellement utile, et le prix d'entrée est nul sur le papier. Mais l'extraction ne porte que sur le corps du texte et repose sur des modèles, et la facture réelle apparaît sous forme de tâches Zapier à chaque exécution.
Parseur est l'hybride à battre : un moteur IA par défaut, des modèles visuels optionnels pour les expéditeurs fixes à fort volume, et l'OCR pour les pièces jointes scannées. Le coût est facturé par page, ce qui est équitable pour les documents et pénalisant si les pièces jointes sont longues. Là où sa philosophie de modèles s'arrête et où la nôtre commence, notre comparaison ImageToTable versus Parseur l'explique en détail.
Airparser est l'option IA axée sur le schéma : déclarez les champs souhaités en langage clair et il les extrait des e-mails, PDF et images, y compris les pages scannées et manuscrites sur les formules payantes. Le post-traitement s'exécute sous forme de code configurable, ce que les développeurs apprécient et que les utilisateurs métier ignorent. La tarification par crédit convient à des centaines de documents et nécessite une planification à volume élevé.
Parsio offre le plus grand choix de moteurs dans un seul compte : des modèles par clic pour les mises en page stables, un parseur GPT pour celles qui changent, et un moteur OCR IA pour les scans. Cette flexibilité a un compteur attaché, un à trois crédits par document selon le moteur. Les équipes qui veulent une boîte à outils unique pour l'e-mail et le téléversement direct de documents ont tendance à s'arrêter ici.
ImageToTable.ai est le produit que ce site vend, et nous l'avons placé là où il se situe honnêtement. Son pipeline d'extraction d'e-mails transforme les pièces jointes transférées et le corps du texte en lignes de feuille de calcul à partir des noms de colonnes que vous saisissez, sans règles ni modèles à maintenir, et la boîte de réception peut être restreinte aux expéditeurs approuvés. Les limites honnêtes : c'est un moteur IA par conception, donc ce n'est pas le bon choix si vous avez besoin de règles regex déterministes pour chaque expéditeur, et les utilisateurs à volume planifient autour de crédits par fichier plutôt que de nombres d'e-mails fixes.
La liste du « meilleur parseur d'e-mails » de chaque fournisseur place son propre produit en premier. Traitez tout classement, y compris celui-ci, comme une affirmation à tester sur votre propre boîte de réception plutôt qu'un fait concernant votre boîte de réception.
L'étape que tous les comparatifs oublient : vérifier ce que le parseur a trouvé
Personne ne parle de ce qui se passe après l'extraction, et ce silence est la plus grande lacune de fiabilité de cette catégorie. Un parseur basé sur des règles échoue silencieusement sur un expéditeur redessiné, renvoyant une valeur fausse mais plausible. Un parseur IA lit parfois mal un chiffre. Dans les deux cas, l'erreur atterrit dans votre feuille de calcul comme si elle était vraie, et aucune affirmation de précision d'un fournisseur de parseur n'y change quoi que ce soit.
Les praticiens qui construisent ces pipelines à la main le savent déjà. Dans un fil sur l'automatisation de la réception de documents clients, un commentateur a décrit la conception de révision qui rend l'automatisation sûre : « gardez une feuille de révision avec des colonnes comme identifiant de l'e-mail source, nom du fichier joint, numéro de facture, montant, date d'échéance, confiance, statut. Ainsi l'automatisation vous fait gagner la plupart du temps de copier-coller, mais un mauvais résultat de parseur ne peut pas silencieusement écraser votre vraie feuille. » (r/automation).
La version pratique de cette feuille de révision est une étape de vérification qui renvoie chaque valeur extraite à sa source. Sur ImageToTable.ai, nous avons conçu le Mode de révision exactement pour cela : survolez n'importe quelle cellule et le document original met en évidence la région d'où provient cette valeur, cliquez sur une région et elle saute à la cellule correspondante, et un champ modifié peut être rétabli à la lecture originale de l'IA en un clic. Activez le paramètre d'auto-annotation et les emplacements sources sont générés après chaque lot. De vrais utilisateurs sur r/QuickBooks décrivent vouloir « quelque chose qui lise le document contextuellement plutôt que positionnellement » après que les outils basés sur des modèles les aient laissés tomber lors de refontes de fournisseurs (r/QuickBooks) ; la couche de vérification est ce qui rend la lecture contextuelle suffisamment fiable pour agir.
Pour être clair sur nos chiffres : nous annonçons jusqu'à 99 % de précision sur les données de tableaux imprimés, notre propre affirmation pour un type d'entrée spécifique, pas une garantie pour chaque document scanné ou manuscrit. L'étape de révision existe précisément parce que des erreurs confiantes sont possibles, et elle compte le plus pour les champs à poids financier ou juridique : montants, dates, numéros de référence. Pour les notifications à faible risque, un coup d'œil à la file d'attente suffit. Décidez selon le risque du champ, pas selon la philosophie d'analyse.
Comment choisir un parseur d'e-mails en 2026
Le choix se résume à quatre questions, et il est préférable d'y répondre dans l'ordre. Passez dix minutes sur la première et le reste de la liste répond presque tout seul.
Comptez vos expéditeurs et leurs formats
Listez les types d'e-mails que vous traitez réellement. Trois mises en page stables générées par machine : les règles ou les modèles l'emportent en termes de coût et d'auditabilité. Des dizaines d'expéditeurs, des messages rédigés par des humains ou des mises en page qui évoluent : un moteur d'IA est la seule configuration qui ne se revalorise pas à chaque nouvel expéditeur.
Décidez : corps du message ou pièce jointe
Si vos données se trouvent toujours dans le texte du message, les outils qui ne traitent que le corps du message suffisent. Si elles se trouvent dans des PDF, des scans, des photos ou des relevés chiffrés, l'outil doit lire les fichiers, ce qui implique l'OCR et la gestion des mots de passe pour les cas difficiles. Confirmez avec un fichier réel, pas un PDF de démonstration.
Décidez où les lignes arrivent
Tout est exporté vers un tableur. La distinction apparaît en aval : l'accès aux webhooks et aux API est important si les données alimentent un CRM, un ERP ou un système interne ; un module complémentaire natif Google Sheets est important si les lignes restent dans un tableur dans lequel votre équipe travaille réellement.
Décidez qui vérifie, et ce que l'outil conserve
Mettez en place le flux de vérification avant d'acheter, pas après qu'une mauvaise valeur ait atteint la comptabilité. Et traitez l'e-mail pour ce qu'il est juridiquement : un fil de discussion contient des données personnelles telles que des noms et des numéros de compte, donc le transmettre à un parseur est un traitement de données au sens du GDPR, le parseur agissant en tant que sous-traitant (Règlement (UE) 2016/679). Demandez où le fournisseur stocke vos e-mails, qui peut y accéder et pendant combien de temps ils sont conservés.
Une note sur le flux de travail : vous n'êtes pas obligé d'engager tout un pipeline dans une seule philosophie. Pointez les règles vers les deux expéditeurs dont la mise en page n'a pas bougé depuis des années, laissez l'IA absorber tout le reste, et acheminez les deux sorties vers le même tableur. C'est cette combinaison, et non un moteur unique gagnant, qui est adoptée par la plupart des installations en production.
FAQ sur le parseur d'e-mails
Quel est le meilleur parseur d'e-mails gratuit ?
Email Parser by Zapier est gratuit, mais il ne lit que le texte des messages, et chaque exécution consomme des tâches Zapier, donc le coût réel augmente avec votre volume d'automatisation. Le niveau gratuit de Parseur inclut 20 pages par mois et lit les pièces jointes ; Airparser offre 20 crédits d'essai par mois, Parsio 30. ImageToTable.ai propose une démo gratuite qui traite vos propres fichiers dans le cadre d'un quota quotidien limité, avec des forfaits payants à partir de 9 $ par mois. Testez d'abord le niveau gratuit sur vos véritables pièces jointes.
Un parseur d'e-mails peut-il lire des pièces jointes comme des PDF et des fichiers scannés ?
Cela dépend entièrement de l'outil. Le parseur de Zapier transmet les pièces jointes à votre flux de travail sans les lire. Mailparser lit les fichiers PDF, DOCX, XLSX, CSV et TXT, mais indique qu'il ne prend pas en charge les images ou les documents scannés. Les outils natifs basés sur l'IA avec OCR, tels qu'Airparser, Parsio et ImageToTable.ai, lisent les pages scannées et les photos ; ImageToTable.ai tente en outre automatiquement les mots de passe enregistrés sur les PDF chiffrés. Vérifiez vos types de pièces jointes exacts avec un fichier réel avant de vous engager.
Les parseurs d'e-mails IA font-ils des erreurs ?
Oui. L'extraction par IA est probabiliste, donc une valeur peut être erronée avec la même confiance qu'une valeur correcte. L'étape de révision existe précisément pour cette raison, et un parseur basé sur des règles ne peut pas non plus l'ignorer, car les règles échouent silencieusement lorsqu'un expéditeur modifie sa mise en page. Vérifiez les champs ayant un poids financier ou juridique par rapport à leur emplacement source, quel que soit le moteur.
Vaut-il encore la peine de configurer des règles d'analyse en 2026 ?
Pour un format véritablement fixe et généré par machine, oui : les règles sont déterministes, peu coûteuses par document et faciles à auditer, c'est pourquoi les alertes système et les rapports internes fixes leur appartiennent toujours. Le calcul s'inverse dès que les expéditeurs se multiplient ou que les modèles dérivent, car chaque nouvelle mise en page coûte à nouveau la même configuration complète, et une refonte casse l'ancienne règle sans vous prévenir.
Est-il sûr de transférer mon e-mail professionnel à un parseur tiers ?
Traitez-le comme une relation de sous-traitance, pas comme une commodité. L'e-mail contient des données personnelles au sens du GDPR, alors confirmez où le fournisseur stocke les messages, combien de temps ils sont conservés et qui peut y accéder. Des contrôles pratiques aident aussi à la source : une liste blanche d'expéditeurs maintient tout ce qui est hors de vos expéditeurs approuvés hors de la file d'attente, et le chiffrement en transit ainsi que les options de suppression après traitement réduisent ce que le parseur détient jamais.
Dois-je choisir entre l'analyse par règles et l'analyse par IA ?
Non. Le modèle de production est d'utiliser des règles là où le format est fixe et l'IA partout ailleurs, et Parseur exécute les deux moteurs dans un seul compte. ImageToTable.ai est uniquement basé sur l'IA par conception, donc les besoins de règles déterministes pointent vers une plateforme hybride ; pour voir les deux philosophies sur les mêmes e-mails, notre comparaison ImageToTable versus Parseur y passe en revue.
La question, c'est votre boîte de réception, pas les classements
Chaque liste des « meilleurs parseurs d'e-mails », y compris celle-ci, est une affirmation sur les hypothèses de ses auteurs. Les deux questions qui déterminent réellement la réponse, la stabilité du format et le corps par rapport à la pièce jointe, prennent dix minutes à répondre pour vos propres e-mails, et les réponses survivent au marketing de n'importe quel fournisseur. Comptez vos expéditeurs, ouvrez un e-mail réel, demandez où se trouvent les données, et la liste restreinte se réduit d'elle-même.
Transférez un vrai document dans la démo gratuite de l'outil qui survit à votre test des deux questions, et vérifiez un champ à poids financier par rapport à son emplacement source. Ce seul passage vous en dit plus que n'importe quel classement, y compris le nôtre.