Bester E-Mail-Parser 2026,
eingestuft nach Ihrer E-Mail-Mischung
Die Radicati Group zählte 2024 täglich 361,6 Milliarden gesendete und empfangene E-Mails, und ihr E-Mail-Marktbericht prognostiziert 392,5 Milliarden pro Tag im Jahr 2026 (The Radicati Group). Geschäftsdaten reisen über diesen Kanal: Rechnungen, Auftragsbestätigungen, Versandmitteilungen, Leads, Kontoauszüge. Die meisten davon schaffen es nie von selbst in eine Tabelle.
Wenn Sie nach „bestem E-Mail-Parser" suchen, wurden die meisten Listen, die Sie finden, von dem Tool geschrieben, das ganz oben steht. Diese Seite führt dieselbe Übung mit einer anderen Regel durch: Jedes Tool unten, einschließlich des E-Mail-Posteingangs, den diese Website verkauft, wird dort platziert, wo sein tatsächliches Verhalten es hinstellt, und die Einstufung beruht auf den zwei Eigenschaften Ihrer E-Mail, die alles andere entscheiden. Wie stabil sind die Formate Ihrer Absender, und leben Ihre Daten im Nachrichtentext oder in einem Anhang?
Wichtige Erkenntnisse
- Jede „bester E-Mail-Parser"-Einstufung, einschließlich dieser, ist eine Aussage über das Postfach des Autors und keine Tatsache über Ihres.
- Zwei Eigenschaften Ihrer eigenen Post entscheiden über den Gewinner: wie stabil die Formate Ihrer Absender sind und ob Ihre Daten im Nachrichtentext oder in einem Anhang leben.
- Auch der beste Parser liegt manchmal falsch, daher ist der Schritt, den jede Übersicht überspringt, derjenige, der Automatisierung sicher macht: jeden Wert auf seine Quelle zurückzuführen.
Was ein E-Mail-Parser tatsächlich tut
Ein E-Mail-Parser ist eine Software, die Nachrichten an einer dedizierten Adresse empfängt, an die Sie weiterleiten, die Nachricht und alle angehängten Dateien liest und die für Sie wichtigen Werte in Zeilen für eine Tabellenkalkulation, ein CRM oder eine API umwandelt. Eine Postfachregel sortiert Nachrichten in Ordner; ein Parser liest deren Inhalt und erzeugt daraus strukturierte Daten.
Der Grund, warum die Extraktion schwierig ist, liegt darin, dass E-Mail nie dafür entwickelt wurde, Struktur zu tragen. Der Standard der Internet Engineering Task Force für E-Mail (RFC 5322) definiert, wie eine Nachricht zusammengesetzt ist: Kopfzeilen, ein Textkörper, Anhänge. Er sagt nichts darüber aus, was all das bedeutet. Jeder Absender ist frei, eine Rechnung so zu gestalten, wie er möchte, und die meisten tun das. Ein Parser muss also aus einem Textblock ohne Schema Bedeutung rekonstruieren.
Es gibt drei Ansätze. Regelbasierte und Vorlagen-Parser (Mailparser, der in Zapier integrierte Parser) erfordern, dass Sie beschreiben, wo sich jeder Wert befindet, mit einer visuellen Vorlage oder mit Regex. KI-native Parser (Airparser, Parsios GPT-Engine, ImageToTable.ai's E-Mail-Posteingang) lassen Sie die gewünschten Felder benennen, und das Modell findet sie anhand der Bedeutung. Hybrid-Plattformen (Parseur) führen beide Engines aus und lassen Sie pro Postfach eine zuweisen. Diese eine Designentscheidung erklärt fast alles andere über Kosten, Wartung und was kaputtgeht.
Ein E-Mail-Parser arbeitet mit dem, was Sie an seine Adresse weiterleiten, nicht mit Ihrem gesamten Postfach. Ein weiterleitungsbasiertes Tool sieht nie die Nachrichten, die Sie ihm nicht gesendet haben. Deshalb sind Absender-Whitelists und Zustellregeln genauso wichtig wie die Extraktions-Engine.
Regelbasiertes vs. KI-Parsing: Wo jeweils etwas bricht
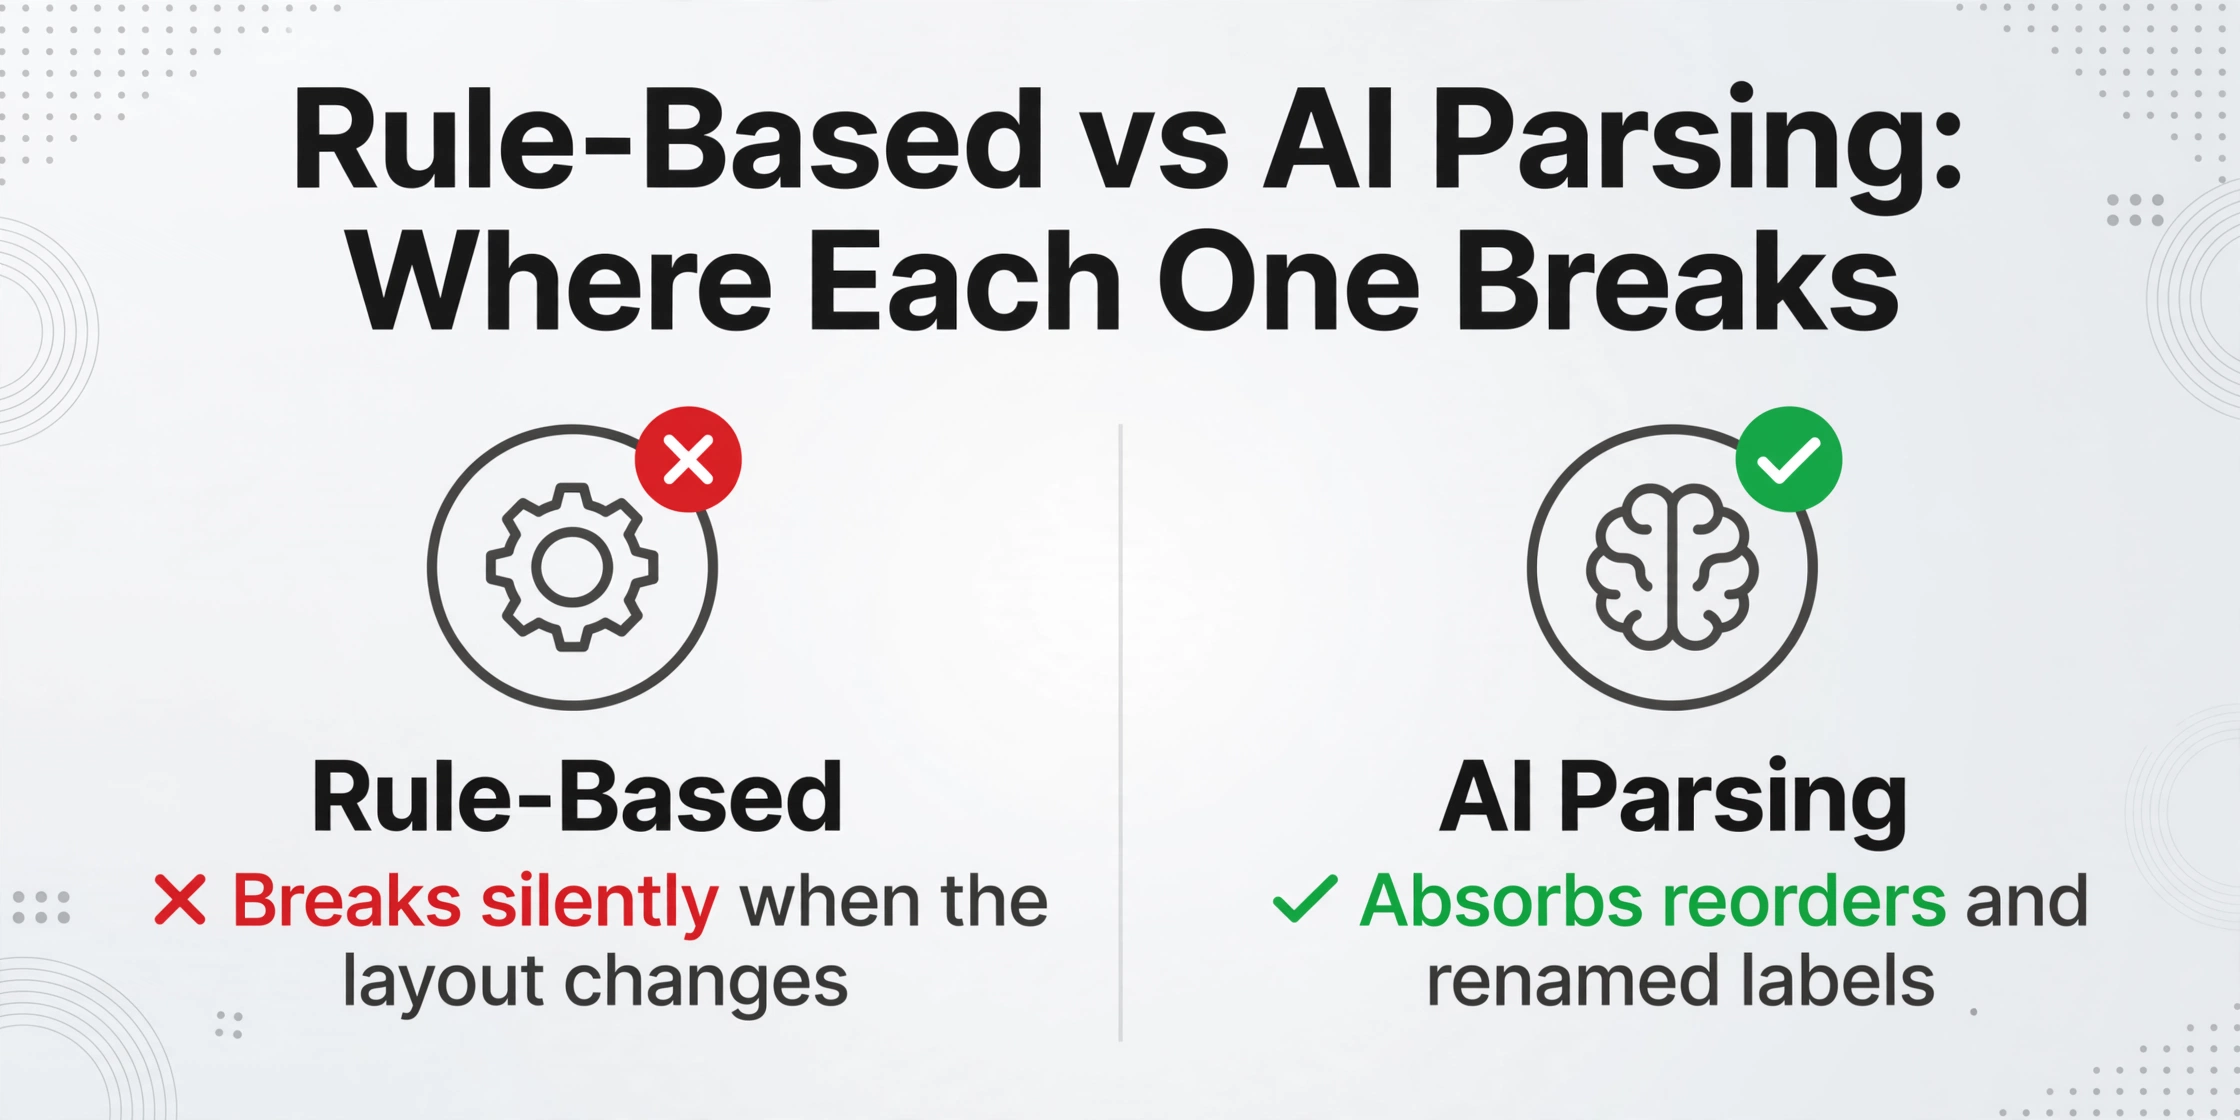
Ein regelbasierter Parser folgt Anweisungen, die Sie geschrieben haben, wie „nimm die Zahl, die auf die Wörter Order ID folgt." Wenn die E-Mail immer gleich aussieht, ist das schnell, günstig pro Dokument und leicht zu prüfen. Die Kosten zeigen sich beim nächsten Layout: Jeder neue Absender oder jedes Redesign bedeutet, die Regel erneut zu schreiben und zu testen.
Diese Wartungslast ist genau das, was Benutzer beschreiben, wenn sie zu KI wechseln. Ein Entwickler, der mit Auftragsbestätigungen und Versandmitteilungen arbeitet, drückte es auf r/webdev deutlich aus: „Der übliche Ansatz scheinen Regex-Regeln oder feste Vorlagen zu sein. Aber das bricht tendenziell, sobald sich das E-Mail-Format ändert." (r/webdev). Ein anderer Benutzer auf r/automation berichtete nach dem Wechsel dasselbe Muster: „Regex- und regelbasierte Parser funktionierten, bis der Absender die kleinste Änderung vornahm." (r/automation).
Der Fehler ist schlimmer als eine Lücke in Ihren Daten, denn er ist oft still. Eine Regel, die an einem Label verankert ist, das sich verschoben hat, matcht immer noch etwas – nur das Falsche, und der falsche Wert landet in Ihrer Tabelle. Ein KI-Parser, der auf Bedeutung statt Position arbeitet, absorbiert die Umstellung, das umbenannte Label und die zusätzliche Fußzeile normalerweise.
Das ehrliche Spiegelbild gilt für KI: Extraktion ist probabilistisch, daher kommt ein Wert gelegentlich mit voller Konfidenz falsch zurück. Ein generischer Chatbot mit handgeschriebenen Prompts ist ein schlechter Ersatz für einen zweckgebauten Parser, und der Buchhaltungsnutzer, der den DIY-Weg versuchte, fasste die Lücke zusammen: "Prompts auf GPT zu schreiben und die Fehler zu korrigieren, die es macht, ist ein weiterer Albtraum." (r/Accounting).
Regeln sind nicht veraltet. Für eine maschinell erzeugte Benachrichtigung, die seit Jahren identisch aussieht, ist eine Regel die günstigere und beweisbarere Wahl. Die Entscheidungsregel ist einfach: Eine kleine, geschlossene Gruppe von Absendern, deren Formate sich nicht bewegt haben, verdient ihre Regeln; darüber hinaus absorbiert KI den langen Schwanz.
Text oder Anhang: Wo Ihre Daten tatsächlich liegen
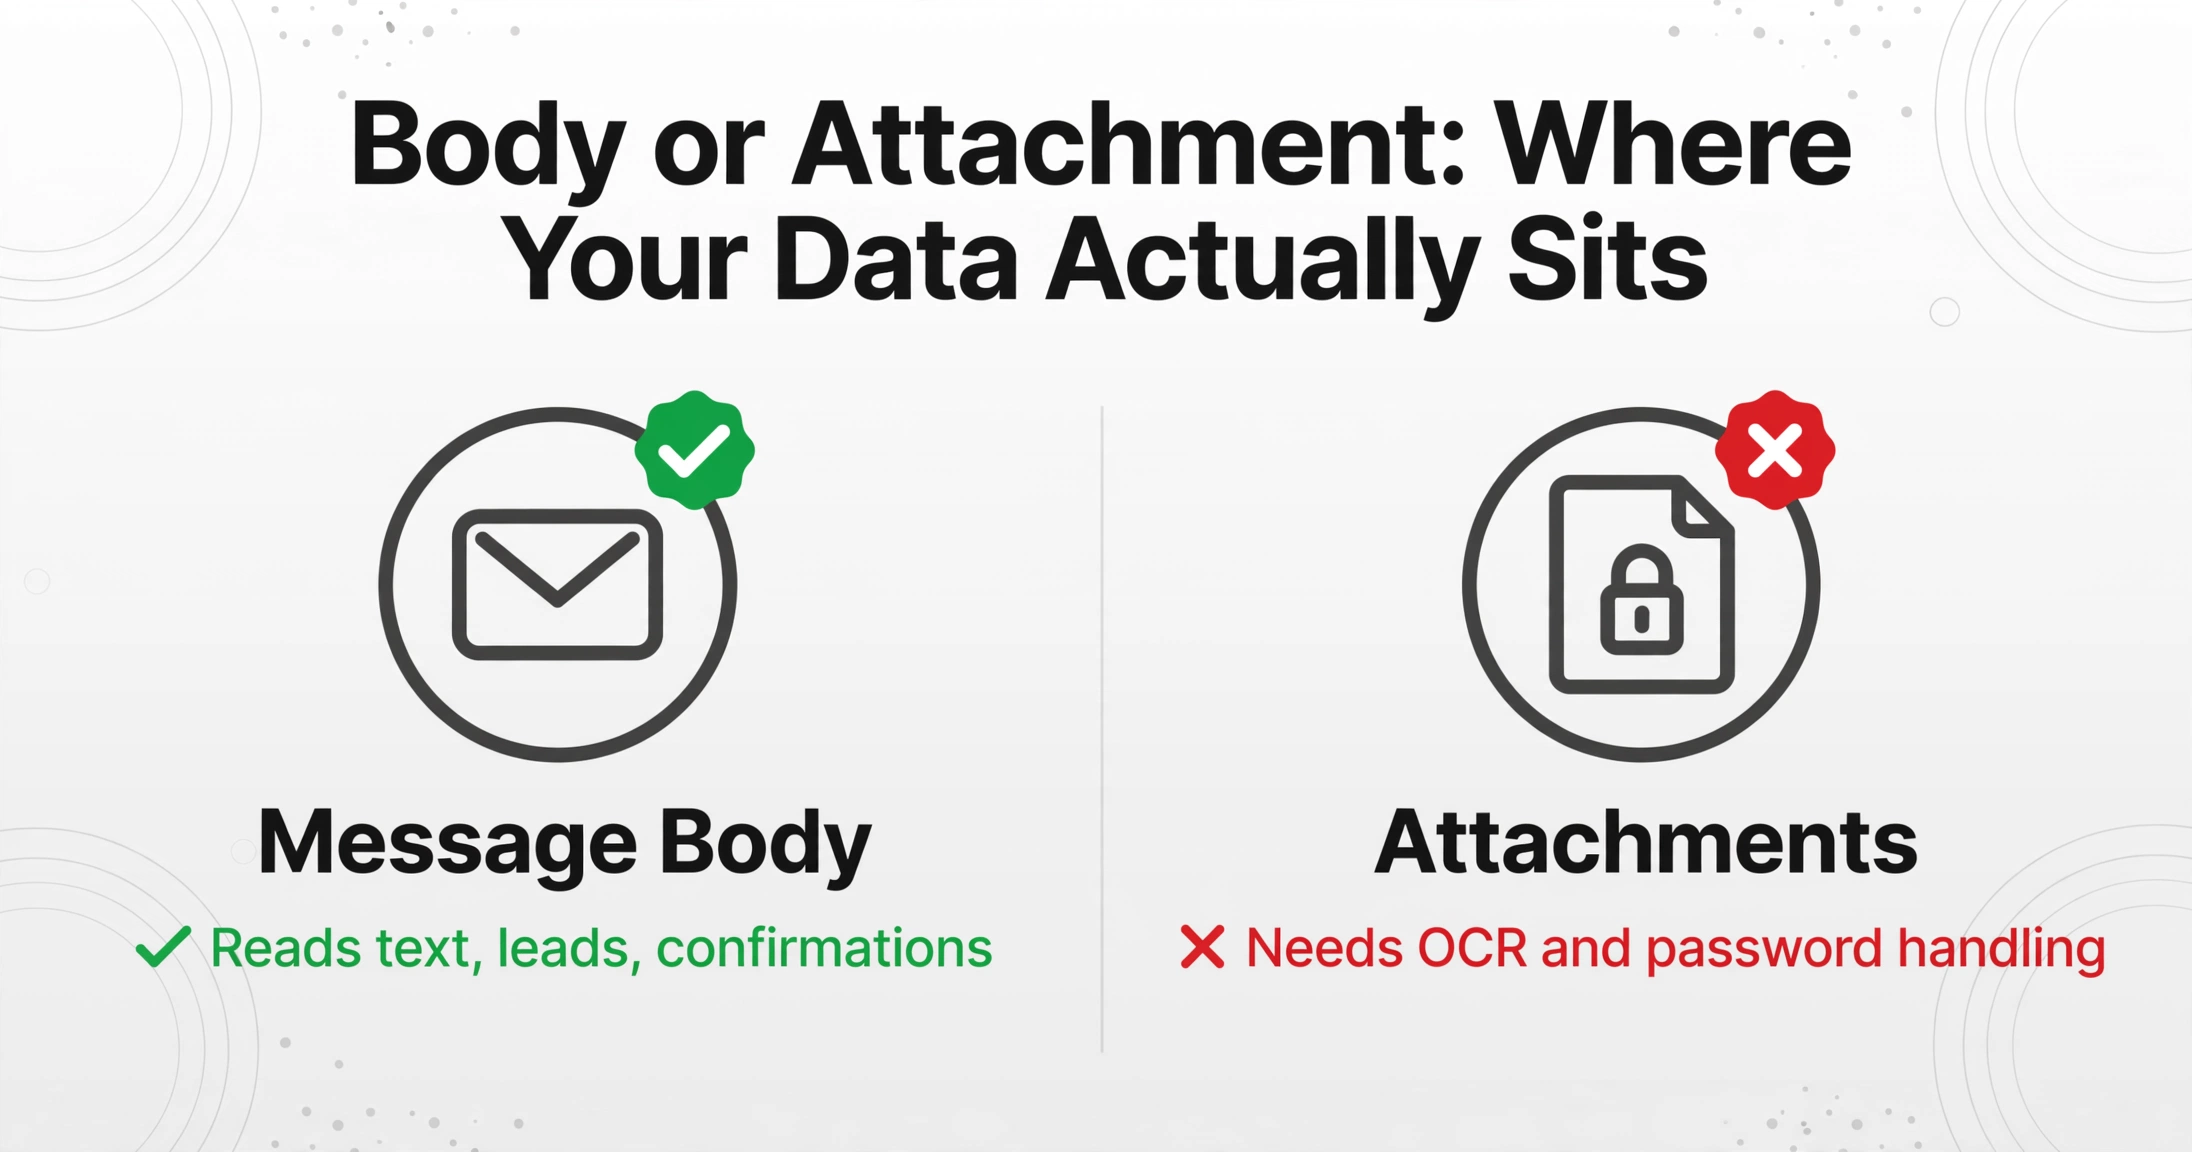
Ob Ihre Daten im Nachrichtentext oder in einem Anhang liegen, teilt diesen Markt in zwei Hälften – und es ist die Frage, die die meisten Übersichten vergraben. Einige Teams brauchen nur Text, der in der Nachricht selbst ankommt: Leads, Auftragsbestätigungen, Benachrichtigungen, schlichte Rechnungsdetails, die ein Lieferant einfügt. Andere Teams brauchen die angehängte PDF-Rechnung, den gescannten Bestellschein, den passwortgeschützten Kontoauszug. Das sind unterschiedliche Aufgaben, und viele Tools können nur eine davon.
Beginnen Sie mit der kostenlosen Option, denn ihre Grenze ist aufschlussreich. Email Parser von Zapier extrahiert Text, den Sie in einer Beispiel-E-Mail markiert haben, aus Nachrichten, die an eine "@robot.zapier.com"-Adresse gesendet werden. Anhänge sind eine andere Geschichte: Die eigene Dokumentation des Anbieters stellt fest, dass mehrere Anhänge gezippt ankommen, bevor Ihr Workflow sie sieht (Zapier-Hilfe). Die Dateien werden an Ihren Zap durchgereicht, nicht gelesen.
Mailparser, der erfahrene regelbasierte Parser, zeigt dieselbe Grenze von der anderen Seite. Seine Preisseite ist explizit zu den Formaten: Er parst csv-, xlsx-, docx-, pdf- und txt-Anhänge, "unterstützt aber keine Bilder oder gescannten Dokumente" (Mailparser-FAQ). Wenn Ihre Lieferanten Fotos oder Scans per E-Mail senden, wird eine textorientierte Regel-Engine diese auslassen.
Das ordnungsgemäße Lesen von Anhängen bedeutet OCR für gescannte Seiten sowie die Verarbeitung von Sonderfällen. Airparser führt OCR in kostenpflichtigen Tarifen für Bilder, Scans und handschriftlichen Text aus. Parsio bündelt eine KI-OCR-Engine zusammen mit seinen Vorlagen- und GPT-Engines. Der E-Mail-Posteingang von ImageToTable.ai bietet konfigurierbare Verarbeitung: nur Anhänge, nur Textkörper oder beides zusammen, was wichtig ist, wenn ein Lieferant die Rechnung in der Nachricht schreibt und ein anderer sie als passwortgeschütztes PDF anhängt. Gespeicherte Passwörter werden automatisch gegen verschlüsselte Dateien ausprobiert, und die Extraktion liest PDF, JPG, PNG, WebP und AVIF. Wenn Ihre Daten normalerweise im Nachrichtentext statt in einer Datei ankommen, behandelt unsere Anleitung zum Extrahieren von Rechnungsfeldern direkt aus einem E-Mail-Textkörper diesen Weg speziell.
Das Tool, das Ihren Anhangstyp nicht lesen kann, wird nicht laut scheitern. Es wird die E-Mail still verarbeiten, die angehängte Abrechnung ungelesen lassen, und Ihre monatliche Abstimmung bleibt zwei Dokumente zurück, ohne dass es jemand bemerkt.
Sechs E-Mail-Parser im Vergleich, Preise September 2026
Diese sechs Tools decken den Markt ab, und jedes ist für eine andere E-Mail-Mischung gebaut. Die Preise stammen von den jeweiligen Preisseiten der Anbieter und wurden im September 2026 geprüft; Tarife ändern sich oft, also verifizieren Sie vor dem Kauf. Die Tabelle ist die schnelle Antwort, die Notizen unten erklären die Kompromisse.
| Tool | Wie die Extraktion funktioniert | Liest Anhänge | Einstiegspreis | Wohin die Daten gehen |
|---|---|---|---|---|
| Mailparser | Parsing-Regeln, die Sie pro Layout schreiben | PDF, DOCX, XLSX, CSV, TXT; keine Bilder oder Scans | $29.95/Monat für 250 E-Mails | Webhooks, Zapier, Google Sheets, CRMs |
| Email Parser by Zapier | Felder in einer Beispiel-E-Mail markieren | Leitet Dateien durch; liest sie nicht | Kostenlos, aber jeder Lauf verbraucht Zapier-Aufgaben | Jede App, in die Ihr Zap schreibt |
| Parseur | KI standardmäßig, optionale Point-and-Click-Vorlagen | PDFs einschließlich Scans, Bilder, Tabellenkalkulationen, Word | Kostenlos 20 Seiten/Monat; kostenpflichtige Tarife nach Volumen | Sheets, Excel, Zapier, Make, Power Automate, API |
| Airparser | KI extrahiert aus einem Schema, das Sie definieren | E-Mails, PDFs einschließlich Scans, Bilder, DOCX, XLSX | Testversion 20 Credits/Monat; ab $39/Monat für 100 Credits | API, Webhooks, Zapier, Make |
| Parsio | Vorlagen-, GPT-, KI-OCR- und vortrainierte KI-Engines | PDFs, Bilder, E-Mails einschließlich Signaturen | Kostenlos 30 Credits/Monat; ab $24/Monat bei jährlicher Abrechnung | Sheets, Excel, CSV, JSON, Zapier, Make, API |
| ImageToTable.ai | Sie geben Spaltennamen ein, KI findet Werte nach Bedeutung | PDF einschließlich verschlüsselt, JPG, PNG, WebP, AVIF | Kostenlose Demo; Basic ab $9/Monat | Excel, CSV, JSON, Google Sheets-Add-on |
Mailparser ist einer der ältesten regelbasierten E-Mail-Parser auf dem Markt, und genau diese Identität ist sowohl seine Stärke als auch sein Preis. Bei einem stabilen Layout einer festen Gruppe von Absendern liefern Regeln deterministische, prüfbare Ergebnisse zu geringen Kosten pro E-Mail; jeder neue Lieferant oder jedes Redesign bedeutet eine weitere Regel. Wenn Ihre Arbeit über E-Mails hinausgeht, ordnet unsere Übersicht der besten Datenextraktionssoftware das Ganze in einen größeren Zusammenhang ein.
Email Parser by Zapier gewinnt den Fall „bereits in Zapier zu Hause“: Als ein Knoten innerhalb eines größeren Workflows ist ein geparstes Feld, das eine Sheets-Zeile oder ein CRM-Update speist, wirklich nützlich, und der Einstiegspreis ist auf dem Papier null. Aber die Extraktion ist nur auf den Textkörper beschränkt und vorlagenbasiert, und die eigentliche Rechnung erscheint bei jedem Lauf als Zapier-Tasks.
Parseur ist der Hybrid, den es zu schlagen gilt: eine standardmäßige KI-Engine, optionale visuelle Vorlagen für die festen Hochvolumen-Absender und OCR für gescannte Anhänge. Die Kosten werden pro Seite abgerechnet, was für Dokumente fair ist und bestrafend, wenn Anhänge lang werden. Wo seine Vorlagenphilosophie endet und unsere beginnt, geht unser ImageToTable-gegen-Parseur-Vergleich im Detail durch.
Airparser ist die schema-zuerst-KI-Option: Geben Sie die gewünschten Felder in einfacher Sprache an, und es extrahiert sie aus E-Mails, PDFs und Bildern, einschließlich gescannter und handschriftlicher Seiten in kostenpflichtigen Plänen. Die Nachbearbeitung läuft als konfigurierbarer Code, den Entwickler mögen und Geschäftsanwender ignorieren. Die Preisgestaltung pro Credit passt für Hunderte von Dokumenten und erfordert bei größeren Mengen Planung.
Parsio bietet die meisten Engine-Optionen in einem Konto: Point-and-Click-Vorlagen für stabile Layouts, einen GPT-Parser für wechselnde Layouts und eine KI-OCR-Engine für Scans. Diese Flexibilität hat einen Zähler: ein bis drei Credits pro Dokument, je nach Engine. Teams, die eine Toolbox für E-Mails und direkte Dokument-Uploads möchten, landen tendenziell hier.
ImageToTable.ai ist das Produkt, das diese Website verkauft, und wir haben es dort eingeordnet, wo es ehrlich hingehört. Seine E-Mail-Extraktions-Pipeline verwandelt weitergeleitete Anhänge und Textkörper in Tabellenzeilen aus den von Ihnen eingegebenen Spaltennamen, ohne Regeln oder Vorlagen, die gepflegt werden müssen, und der Posteingang kann auf genehmigte Absender beschränkt werden. Die ehrlichen Grenzen: Es ist von Natur aus eine KI-Engine, also nicht die richtige Wahl, wenn Sie deterministische Regex-Regeln für jeden Absender benötigen, und Vielnutzer planen mit Credits pro Datei statt mit festen E-Mail-Anzahlen.
Jede Liste „bester E-Mail-Parser“ eines Anbieters setzt das eigene Produkt an die erste Stelle. Behandeln Sie jedes Ranking, einschließlich dieses, als eine Behauptung, die Sie an Ihrem eigenen Posteingang testen sollten, und nicht als eine Tatsache über Ihren Posteingang.
Der Schritt, den jede Übersicht überspringt: Prüfen, was der Parser gefunden hat
Niemand spricht darüber, was nach der Extraktion passiert, und dieses Schweigen ist die größte Zuverlässigkeitslücke in dieser Kategorie. Ein regelbasierter Parser versagt stillschweigend bei einem neu gestalteten Absender und liefert einen falschen, aber plausiblen Wert. Ein KI-Parser liest gelegentlich eine Ziffer falsch. In beiden Fällen landet der Fehler in Ihrer Tabelle, als wäre er wahr, und keine Genauigkeitsangabe eines Parser-Anbieters ändert das.
Praktiker, die diese Pipelines von Hand aufbauen, wissen das bereits. In einem Thread über die Automatisierung der Kundendokument-Erfassung beschrieb ein Kommentator das Prüfdesign, das Automatisierung sicher macht: "Behalten Sie ein Prüfblatt mit Spalten wie Quell-E-Mail-ID, Anhangsdateiname, Rechnungsnummer, Betrag, Fälligkeitsdatum, Konfidenz, Status. So spart die Automatisierung den Großteil der Kopierarbeit, aber ein schlechtes Parser-Ergebnis kann Ihre echte Tabelle nicht stillschweigend überschreiben." (r/automation).
Die praktische Version dieses Prüfblatts ist ein Verifizierungsschritt, der jeden extrahierten Wert auf seine Quelle zurückführt. Auf ImageToTable.ai haben wir den Review-Modus genau dafür entwickelt: Fahren Sie mit der Maus über eine beliebige Zelle, und das Originaldokument hebt den Bereich hervor, aus dem der Wert stammt. Klicken Sie auf einen Bereich, und er springt zur passenden Zelle. Ein bearbeitetes Feld kann mit einem Klick auf die ursprüngliche KI-Lesung zurückgesetzt werden. Aktivieren Sie die Auto-Annotate-Einstellung, und die Quellpositionen werden nach jedem Batch generiert. Echte Nutzer auf r/QuickBooks beschreiben, dass sie "etwas wollen, das das Dokument kontextuell statt positionsbasiert liest", nachdem Vorlagen-Tools sie bei Lieferanten-Redesigns im Stich gelassen hatten (r/QuickBooks); die Verifizierungsebene macht kontextuelles Lesen vertrauenswürdig genug, um darauf zu handeln.
Um unsere Zahlen klar zu benennen: Wir geben bis zu 99 % Genauigkeit bei gedruckten Tabellendaten an – unsere eigene Angabe für einen bestimmten Eingabetyp, keine Garantie für jedes gescannte oder handschriftliche Dokument. Der Review-Schritt existiert genau deshalb, weil selbstbewusste Fehler möglich sind, und er ist am wichtigsten für Felder mit finanziellem oder rechtlichem Gewicht: Beträge, Daten, Referenznummern. Bei risikoarmen Benachrichtigungen reicht ein Blick auf die Warteschlange. Entscheiden Sie nach Feldrisiko, nicht nach Parsing-Philosophie.
So wählen Sie 2026 einen E-Mail-Parser aus
Die Wahl lässt sich auf vier Fragen reduzieren, die am besten der Reihe nach beantwortet werden. Nehmen Sie sich zehn Minuten für die erste Frage – der Rest der Liste beantwortet sich dann fast von selbst.
Zählen Sie Ihre Absender und deren Formate
Listen Sie die E-Mail-Typen auf, die Sie tatsächlich verarbeiten. Drei stabile, maschinell generierte Layouts: Regeln oder Vorlagen punkten bei Kosten und Prüfbarkeit. Dutzende Absender, von Menschen verfasste Nachrichten oder sich ändernde Layouts: Eine KI-Engine ist die einzige Lösung, die sich nicht mit jedem neuen Absender neu bepreist.
Entscheiden Sie: Nachrichtentext oder Anhang
Wenn Ihre Daten immer im Nachrichtentext stehen, reichen reine Text-Tools. Wenn sie in PDFs, Scans, Fotos oder verschlüsselten Kontoauszügen stecken, muss das Tool Dateien lesen können – das bedeutet OCR und Passwort-Handling für die schwierigen Fälle. Bestätigen Sie das mit einer echten Datei, nicht mit einer Demo-PDF.
Entscheiden Sie, wo die Zeilen landen
Alles lässt sich in eine Tabellenkalkulation exportieren. Der Unterschied zeigt sich erst später: Webhook- und API-Zugriff sind wichtig, wenn die Daten ein CRM, ERP oder internes System speisen; ein natives Google-Sheets-Add-on ist wichtig, wenn die Zeilen in einer Tabellenkalkulation bleiben, in der Ihr Team tatsächlich arbeitet.
Entscheiden Sie, wer prüft – und was das Tool behält
Legen Sie den Prüfworkflow fest, bevor Sie kaufen – nicht erst, wenn ein falscher Wert die Buchhaltung erreicht. Und behandeln Sie E-Mail so, wie es rechtlich ist: Ein Nachrichtenfaden enthält personenbezogene Daten wie Namen und Kontonummern. Die Weiterleitung an einen Parser ist daher eine Datenverarbeitung im Sinne der GDPR, wobei der Parser Ihr Auftragsverarbeiter ist (Verordnung (EU) 2016/679). Fragen Sie, wo der Anbieter Ihre E-Mails speichert, wer Zugriff darauf hat und wie lange sie aufbewahrt werden.
Ein Hinweis zum Workflow: Sie müssen nicht eine ganze Pipeline einer einzigen Philosophie verschreiben. Setzen Sie Regeln für die zwei Absender ein, deren Layout sich seit Jahren nicht verändert hat, lassen Sie KI alles andere übernehmen und führen Sie beide Ausgaben in derselben Tabellenkalkulation zusammen. Diese Kombination – nicht eine einzelne Sieger-Engine – ist es, worauf sich die meisten produktiven Installationen einpendeln.
E-Mail-Parser FAQ
Was ist der beste kostenlose E-Mail-Parser?
Email Parser von Zapier ist kostenlos nutzbar, liest aber nur den Nachrichtentext, und jeder Lauf verbraucht Zapier-Aufgaben, sodass die tatsächlichen Kosten mit Ihrem Automatisierungsvolumen skalieren. Parseurs kostenloser Tarif umfasst 20 Seiten pro Monat und liest Anhänge; Airparser bietet 20 Test-Credits pro Monat, Parsio 30. ImageToTable.ai hat eine kostenlose Demo, die Ihre eigenen Dateien innerhalb eines begrenzten Tageskontingents verarbeitet, mit kostenpflichtigen Plänen ab 9 $ pro Monat. Testen Sie zuerst den kostenlosen Tarif mit Ihren tatsächlichen Anhängen.
Kann ein E-Mail-Parser Anhänge wie PDFs und gescannte Dateien lesen?
Das hängt vollständig vom Tool ab. Der Parser von Zapier reicht Anhänge ohne sie zu lesen an Ihren Workflow weiter. Mailparser liest PDF-, DOCX-, XLSX-, CSV- und TXT-Dateien, gibt aber an, keine Bilder oder gescannten Dokumente zu unterstützen. KI-native Tools mit OCR, wie Airparser, Parsio und ImageToTable.ai, lesen gescannte Seiten und Fotos; ImageToTable.ai versucht zusätzlich automatisch gespeicherte Passwörter bei verschlüsselten PDFs. Prüfen Sie Ihre genauen Anhangstypen mit einer echten Datei, bevor Sie sich festlegen.
Machen KI-E-Mail-Parser Fehler?
Ja. KI-Extraktion ist probabilistisch, daher kann ein Wert mit derselben Konfidenz wie ein richtiger auch falsch zurückkommen. Der Review-Modus existiert genau aus diesem Grund, und ein regelbasierter Parser kann ihn ebenfalls nicht überspringen, weil Regeln stillschweigend fehlschlagen, wenn ein Absender sein Layout ändert. Verifizieren Sie Felder mit finanziellem oder rechtlichem Gewicht gegen ihre Quellposition, unabhängig von der Engine.
Lohnt es sich 2026 noch, Parsing-Regeln einzurichten?
Für ein wirklich festes, maschinell erzeugtes Format: ja. Regeln sind deterministisch, kostengünstig pro Dokument und leicht zu prüfen, weshalb Systemalarme und feste interne Berichte weiterhin zu ihnen gehören. Die Rechnung kippt, sobald Absender sich vermehren oder Vorlagen abweichen, denn jedes neue Layout kostet wieder denselben vollständigen Aufwand, und ein Redesign bricht die alte Regel, ohne Sie zu informieren.
Ist es sicher, meine Geschäfts-E-Mail an einen Drittanbieter-Parser weiterzuleiten?
Behandeln Sie es als Auftragsverarbeiter-Beziehung, nicht als Bequemlichkeit. E-Mails enthalten personenbezogene Daten gemäß GDPR. Bestätigen Sie daher, wo der Anbieter Nachrichten speichert, wie lange sie aufbewahrt werden und wer Zugriff hat. Praktische Kontrollen helfen auch an der Quelle: Eine Absender-Whitelist hält alles außerhalb Ihrer genehmigten Absender vollständig aus der Warteschlange, und Verschlüsselung während der Übertragung plus Löschung nach der Verarbeitung reduzieren, was der Parser jemals hält.
Muss ich mich zwischen regelbasiertem und KI-Parsing entscheiden?
Nein. Das Produktionsmuster ist: Regeln, wo das Format fest ist, und KI überall sonst. Parseur betreibt beide Engines in einem Konto. ImageToTable.ai ist von Natur aus reine KI, daher verweisen deterministische Regelanforderungen auf eine Hybrid-Plattform; um beide Philosophien an denselben E-Mails zu sehen, geht unser ImageToTable versus Parseur Vergleich darauf ein.
Die Frage ist Ihr Posteingang, nicht die Rankings
Jede Liste der „besten E-Mail-Parser“, einschließlich dieser, ist eine Aussage über die Annahmen ihrer Autoren. Die beiden Fragen, die die Antwort tatsächlich entscheiden – Formatstabilität und Textkörper versus Anhang –, lassen sich in zehn Minuten für Ihre eigene E-Mail beantworten, und die Antworten überdauern jedes Marketing des Anbieters. Zählen Sie Ihre Absender, öffnen Sie eine echte E-Mail, fragen Sie, wo die Daten liegen, und die Shortlist verengt sich von selbst.
Leiten Sie ein echtes Dokument in die kostenlose Demo des Tools weiter, das Ihren Zwei-Fragen-Test besteht, und prüfen Sie ein Feld mit finanziellem Gewicht anhand seines Quellorts. Dieser einzige Durchgang sagt Ihnen mehr als jedes Ranking, auch unseres.