Wenn die Rechnung der E-Mail-Text ist,
nicht der Anhang
Die meisten Rechnungsextraktionstools basieren auf einer einzigen Annahme: Die gewünschten Daten befinden sich in einer Datei, die der Nachricht als Anhang beigefügt ist. Diese Annahme gilt für einen großen Teil der Lieferantenrechnungen. Sie scheitert völlig bei denjenigen, bei denen die Rechnung die E-Mail selbst ist, als HTML oder Klartext im Textkörper verfasst, ohne dass sich irgendwo in der Nachricht eine PDF-Datei befindet. Wenn das passiert, liefert ein anhangorientiertes Tool keine falsche Zahl. Es liefert nichts – und es teilt Ihnen nicht mit, dass es nichts geliefert hat.
Wichtigste Erkenntnisse
- Der Rechnungsparser, dem Sie bereits vertrauen, hat bei den meisten Rechnungen recht, weil die meisten als Anhänge eintreffen.
- Bei einer Rechnung nur im Textkörper liefert er eine leere Zeile und meldet keinen Fehler – das ist die teurere Art des Scheiterns.
- Wenn Sie das E-Mail-Postfach so umstellen, dass es den Textkörper selbst liest, wird dieselbe E-Mail zu einer Tabellenzeile – ohne Schritt „Drucken zu PDF“.
Wenn die Rechnung nur im E-Mail-Text steht, liefern Attachment-First-Tools nichts zurück
Eine Rechnung, die nur im E-Mail-Text existiert, hat keine Datei, die ein Attachment-First-Parser öffnen könnte. Der Parser gibt daher eine leere Zeile zurück und meldet keinen Fehler. Die Extraktions-Pipeline scheint gelaufen zu sein. Die Ausgabe sieht aus wie eine Nachricht, aus der einfach nichts zu extrahieren war. Niemand erhält eine Warnung, und die Rechnung bleibt im Postfach liegen, bis ein Mensch bemerkt, dass die Zeile leer ist.
Das ist kein seltenes Format. Es ist der Standard für einen spezifischen und wachsenden Teil der B2B-Abrechnung. Abonnement- und Werbeplattformen senden ihre Rechnungen als formatierte Nachrichten statt als Dateien: Stripe-Belege, monatliche AWS-Abrechnungsübersichten, Google-Workspace-Abrechnungshinweise, Meta-Ads- und Google-Ads-Rechnungen, Uber-for-Business-Fahrtenabrechnungen. Auch kleinere Lieferanten und Freiberufler machen das so und tippen Rechnungsnummer und Gesamtbetrag direkt in die Nachricht, weil das schneller ist als das Erzeugen einer PDF.
Die Kosten, diese zu übersehen, sind nicht theoretisch. Ardent Partners bezifferte die durchschnittlichen Gesamtkosten für die Verarbeitung einer einzelnen Rechnung im Jahr 2025 auf 9,40 $, gegenüber 2,78 $ bei Best-in-Class-Teams, und stellte fest, dass nur 32,6 % der Rechnungen ohne manuellen Eingriff durchlaufen (Ardent Partners, AP Metrics That Matter in 2025). Jede Rechnung, die aus dem automatisierten Pfad fällt, wird von Hand bearbeitet – am manuellen Ende dieser Kostenspanne.
Ein Attachment-First-Parser scheitert bei einer Body-only-Rechnung nicht laut. Er hat Erfolg darin, kein Attachment zu finden – das ist die teurere Art des Scheiterns.
Body-only-Rechnungen kommen in drei Formen, und nur zwei davon enthalten extrahierbare Daten
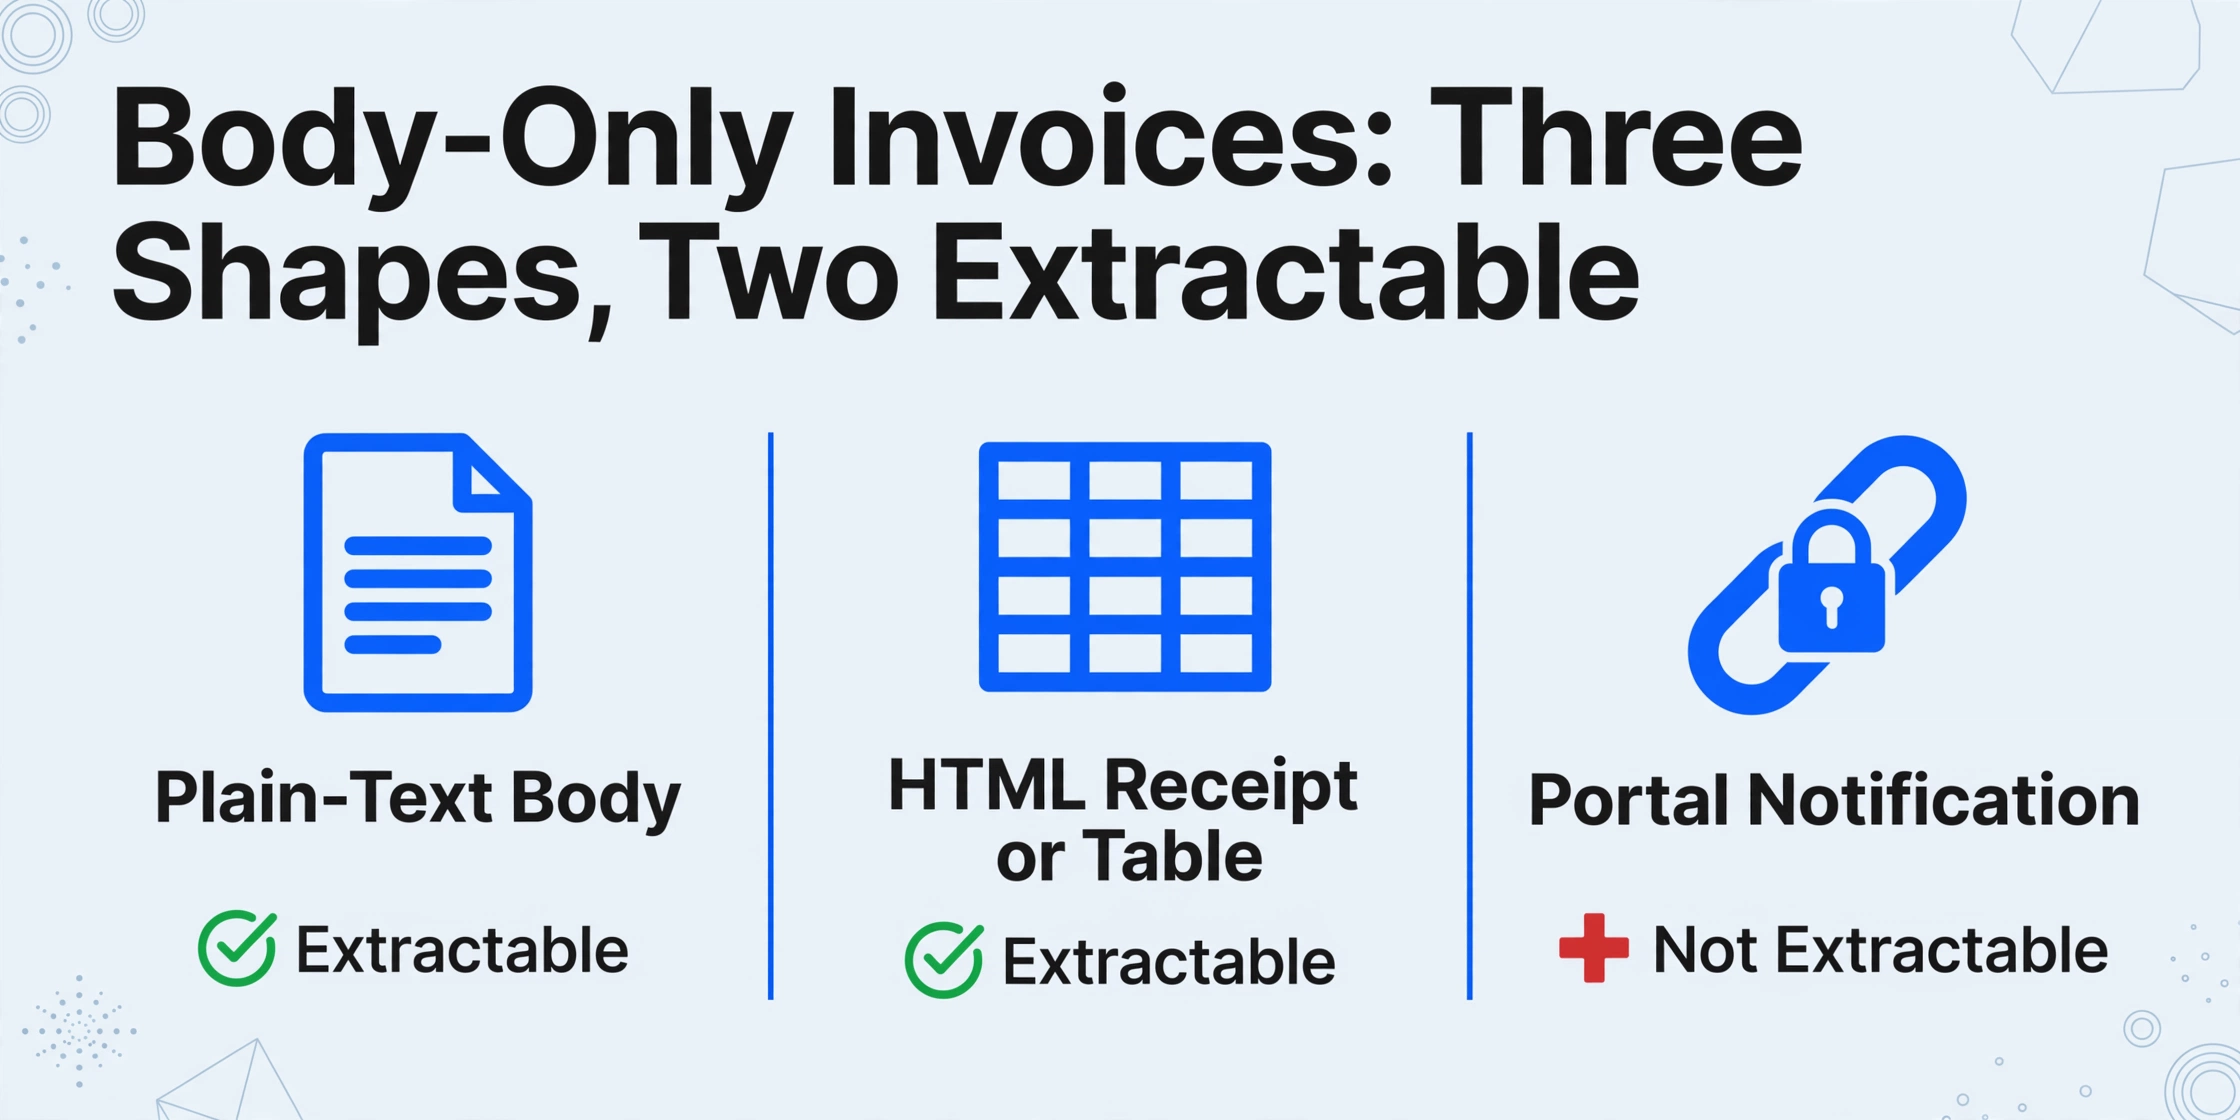
Body-only-Rechnungen erreichen das Postfach in drei Formen, und nur zwei davon enthalten Daten, die eine Maschine tatsächlich lesen kann. Zu wissen, um welche Form es sich handelt, sagt Ihnen, ob eine Extraktion überhaupt möglich ist – oder ob Sie einem Link hinterherjagen, der nie eine Tabellenzeile werden sollte.
| Form | Wie sie aussieht | Kann daraus eine Tabellenzeile werden? |
|---|---|---|
| Klartext-Body | Ein Freiberufler oder kleiner Anbieter tippt Rechnungsnummer, Betrag und Fälligkeitsdatum direkt in die Nachricht | Ja. Die Werte sind als Text vorhanden, auch wenn sie unstrukturiert sind |
| HTML-Beleg oder -Tabelle | Eine Abonnement- oder Werbeplattform rendert einen formatierten Beleg, oft eine echte Tabelle, im Text | Ja. Die Werte sind vorhanden, aber als Layout statt als Felder |
| Portalbenachrichtigung | „Ihre Rechnung ist fertig. Melden Sie sich an, um sie anzusehen und herunterzuladen.“ Die Nachricht kündigt die Rechnung an; die Rechnung selbst liegt hinter dem Login | Nein. Die E-Mail verweist auf die Rechnung, statt sie zu enthalten, und der Download-Link läuft ab |
Der Unterschied zwischen den ersten beiden Formen und der dritten ist der Unterschied zwischen einem strukturierten Dokument und einer Benachrichtigung darüber. Die Europäische Union zieht diese Grenze in ihrer eRechnungs-Definition präzise: Eine elektronische Rechnung ist eine, die „in einem strukturierten Datenformat ausgestellt, übermittelt und empfangen wird, das ihre automatische und elektronische Verarbeitung ermöglicht" (Europäische Kommission, Richtlinie 2014/55/EU). Eine formatierte HTML-E-Mail ist das nicht. Sie ist ein Bild einer Rechnung, gezeichnet in Markup.
Gemäß der europäischen Norm EN 16931 ist ein Rechnungsfeld ein definiertes semantisches Element mit eigenem Knoten in der UBL-Syntax: Die Rechnungsnummer ist cbc:ID, das Ausstellungsdatum ist cbc:IssueDate, der fällige Betrag ist cac:LegalMonetaryTotal/cbc:PayableAmount (Peppol BIS Billing 3.0). In einer HTML-Quittung befinden sich dieselben Werte in Tabellenzellen, die per Stylesheet positioniert werden, ohne Beschriftungen, auf die sich ein Programm verlassen kann. Diese Lücke ist der Grund, warum eine reine Textkörper-Rechnung ein schwierigeres Extraktionsproblem ist als eine angehängte PDF-Datei – nicht ein einfacheres.
Warum Parser hier scheitern: HTML ist kein Klartext, und Druck-zu-PDF verschlechtert die Daten
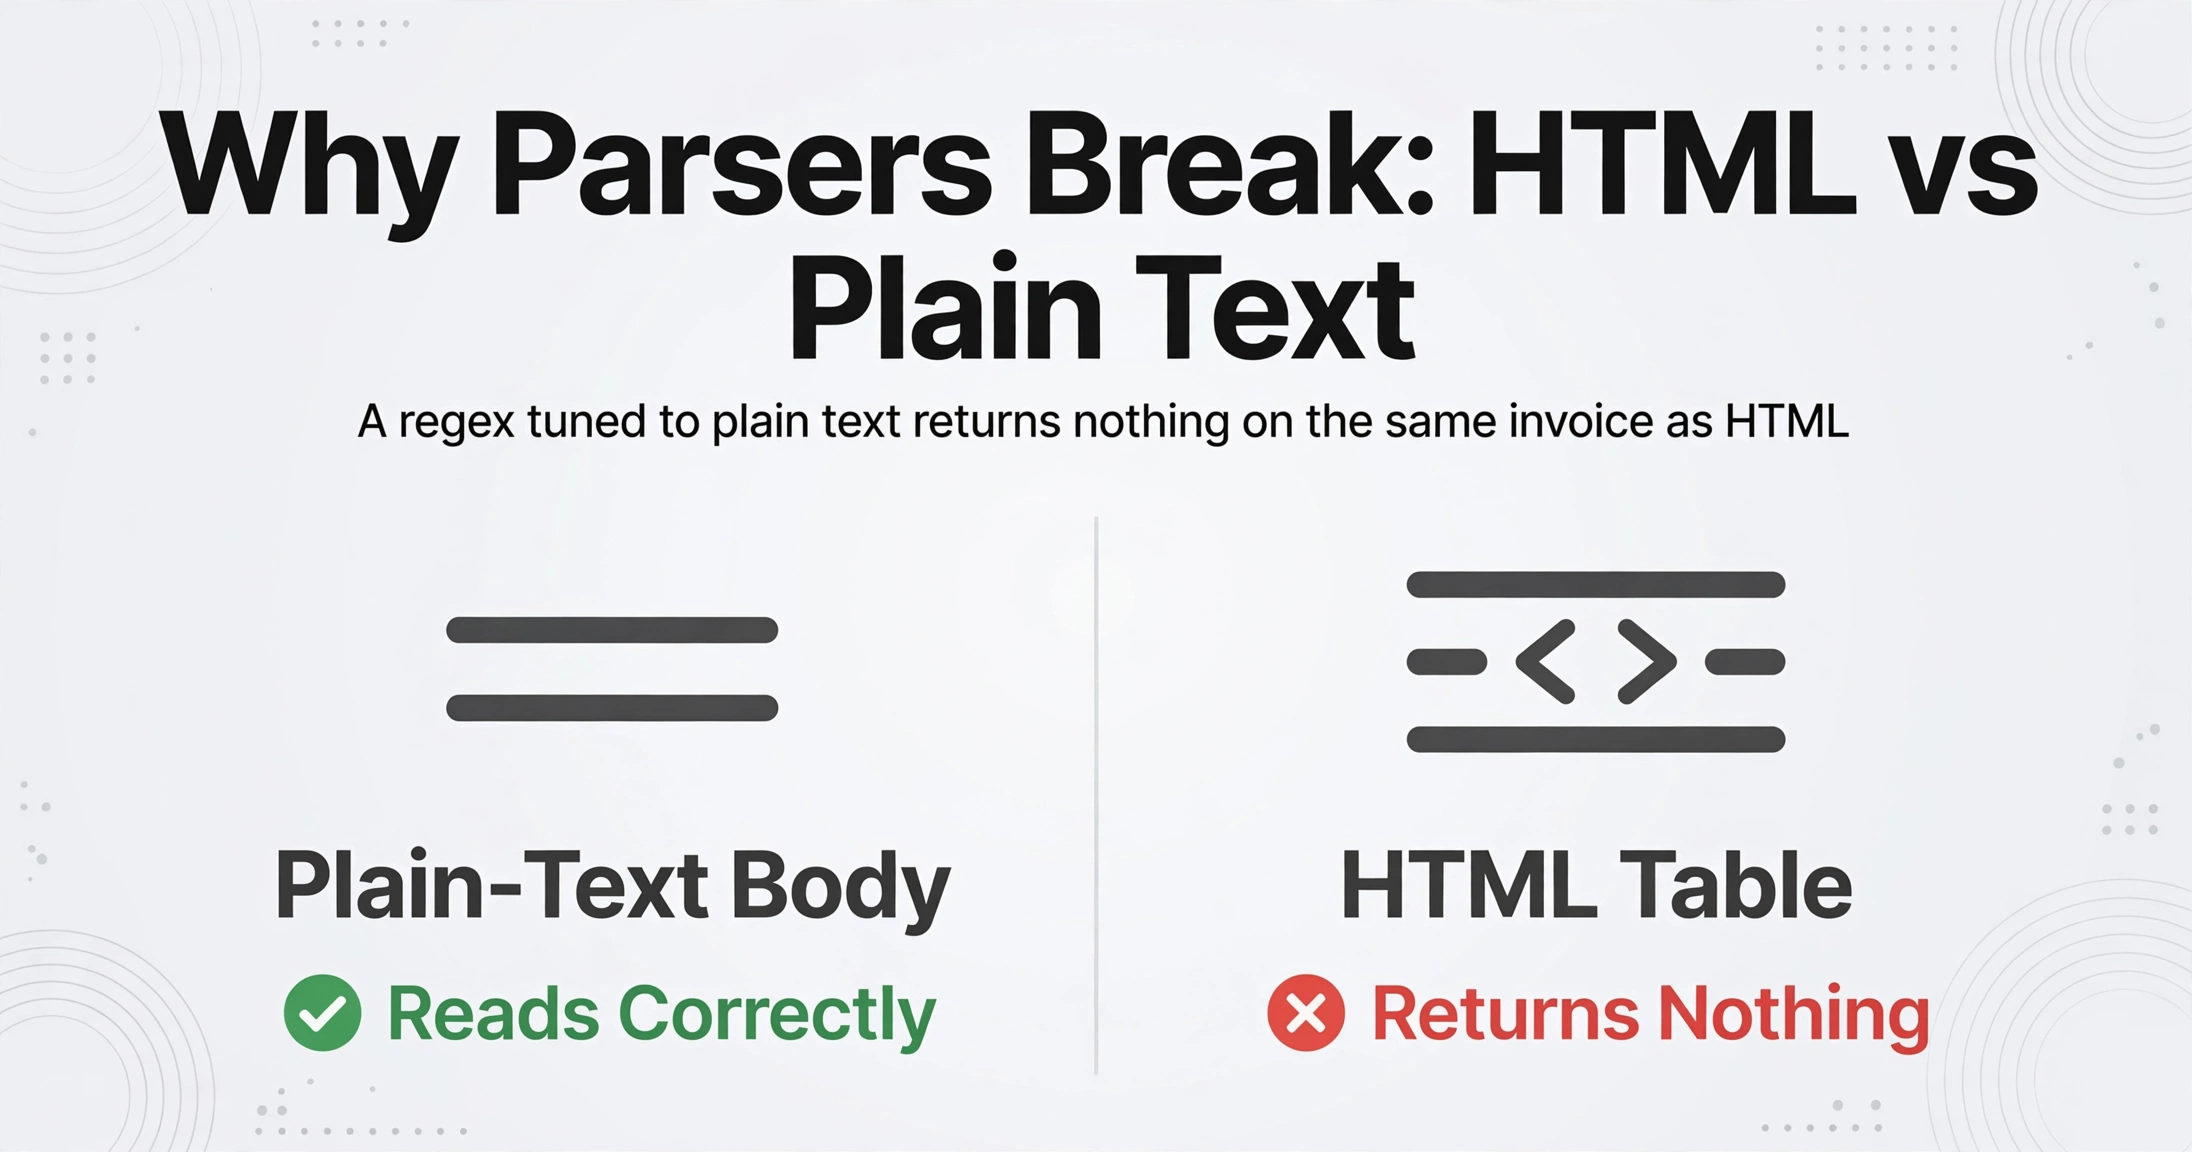
Parser scheitern bei reinen Textkörper-Rechnungen aus einem Grund, der nichts mit OCR-Qualität zu tun hat: Ein E-Mail-Textkörper ist HTML, nicht der Klartext, den die meisten Parser annehmen. Ein regulärer Ausdruck, der auf „Fälliger Betrag: $X" abgestimmt ist, liest einen Klartext-Textkörper korrekt und liefert bei derselben Rechnung, die als HTML-Tabelle gerendert wird, nichts zurück, weil Wert und Beschriftung durch Markup getrennt sind. Der Klartext-Fallback-Teil einer Multipart-Nachricht entfernt die Tabelle oft vollständig und hinterlässt dem Leser ein Layout, das nicht mehr zusammenpasst.
Der übliche Workaround besteht darin, die E-Mail als PDF zu drucken und diese zu verarbeiten. Das tun die meisten Buchhalter heute, und es ist aus drei getrennten Gründen fragil. Der erste ist die Paginierung: Eine lange Quittung oder eine detaillierte Tabelle wird über Seiten aufgeteilt, und die Summen landen auf einer anderen Seite als die Einzelposten. Der zweite ist Rauschen: Das gedruckte PDF enthält Absender, Betreffzeile, Signaturblock und rechtlichen Haftungsausschluss, sodass der Extraktor eine Rechnungssumme von einer Fußzeile unterscheiden muss, die zufällig das Wort „Summe" enthält. Der dritte Grund ist, dass der Schritt „Drucken zu PDF" selbst eine Verschlechterung der Dokumentqualität darstellt.
Ein Benchmark aus dem Jahr 2025 vom Fraunhofer IAIS und dem Lamarr Institute testete acht multimodale Modelle zur Rechnungsextraktion und stellte fest, dass dasselbe Top-Modell 96,50 % bei sauberen digitalen Rechnungen, 92,71 % bei gescannten Rechnungen und 87,46 % bei gescannten Quittungen erreichte (arXiv:2509.04469). Die Genauigkeit folgt der Dokumentqualität weit mehr als dem Modell. Eine HTML-Rechnung in ein PDF oder einen Screenshot zu rendern, verschiebt sie absichtlich auf dieser Skala nach unten.
Der Frust wird in klaren Worten von den Menschen deutlich, die die Arbeit erledigen. In r/Bookkeeping beschrieb ein Buchhalter den Alltag: "Einer meiner größten Ärgernisse ist, wenn eine Quittung oder Rechnung direkt in den Text einer E-Mail eingebettet ist, statt als sauberer PDF-Anhang. Ich muss die E-Mail manuell als PDF speichern und das stattdessen hochladen, und das ist selten sauber." Sie hatten auch versucht, den Quittungsbereich als Screenshot zu erfassen, und fanden das nicht besser: "Wenn es lang ist, ist es nicht wirklich praktikabel und dauert ehrlich gesagt länger als das Drucken zu PDF." Ein anderer Kommentator im selben Thread nannte die zugrunde liegende Ursache: "Die in den Text der E-Mail eingebettete Rechnung ist höchstwahrscheinlich nur HTML unter der Haube" (r/Bookkeeping).
Der Workaround existiert, weil das Tool eine Datei erwartet. Entfernen Sie diese Erwartung, und der Workaround verschwindet mit ihr.
Die Lösung besteht darin, den Postfachmodus umzuschalten, sodass die Extraktion den Text selbst liest
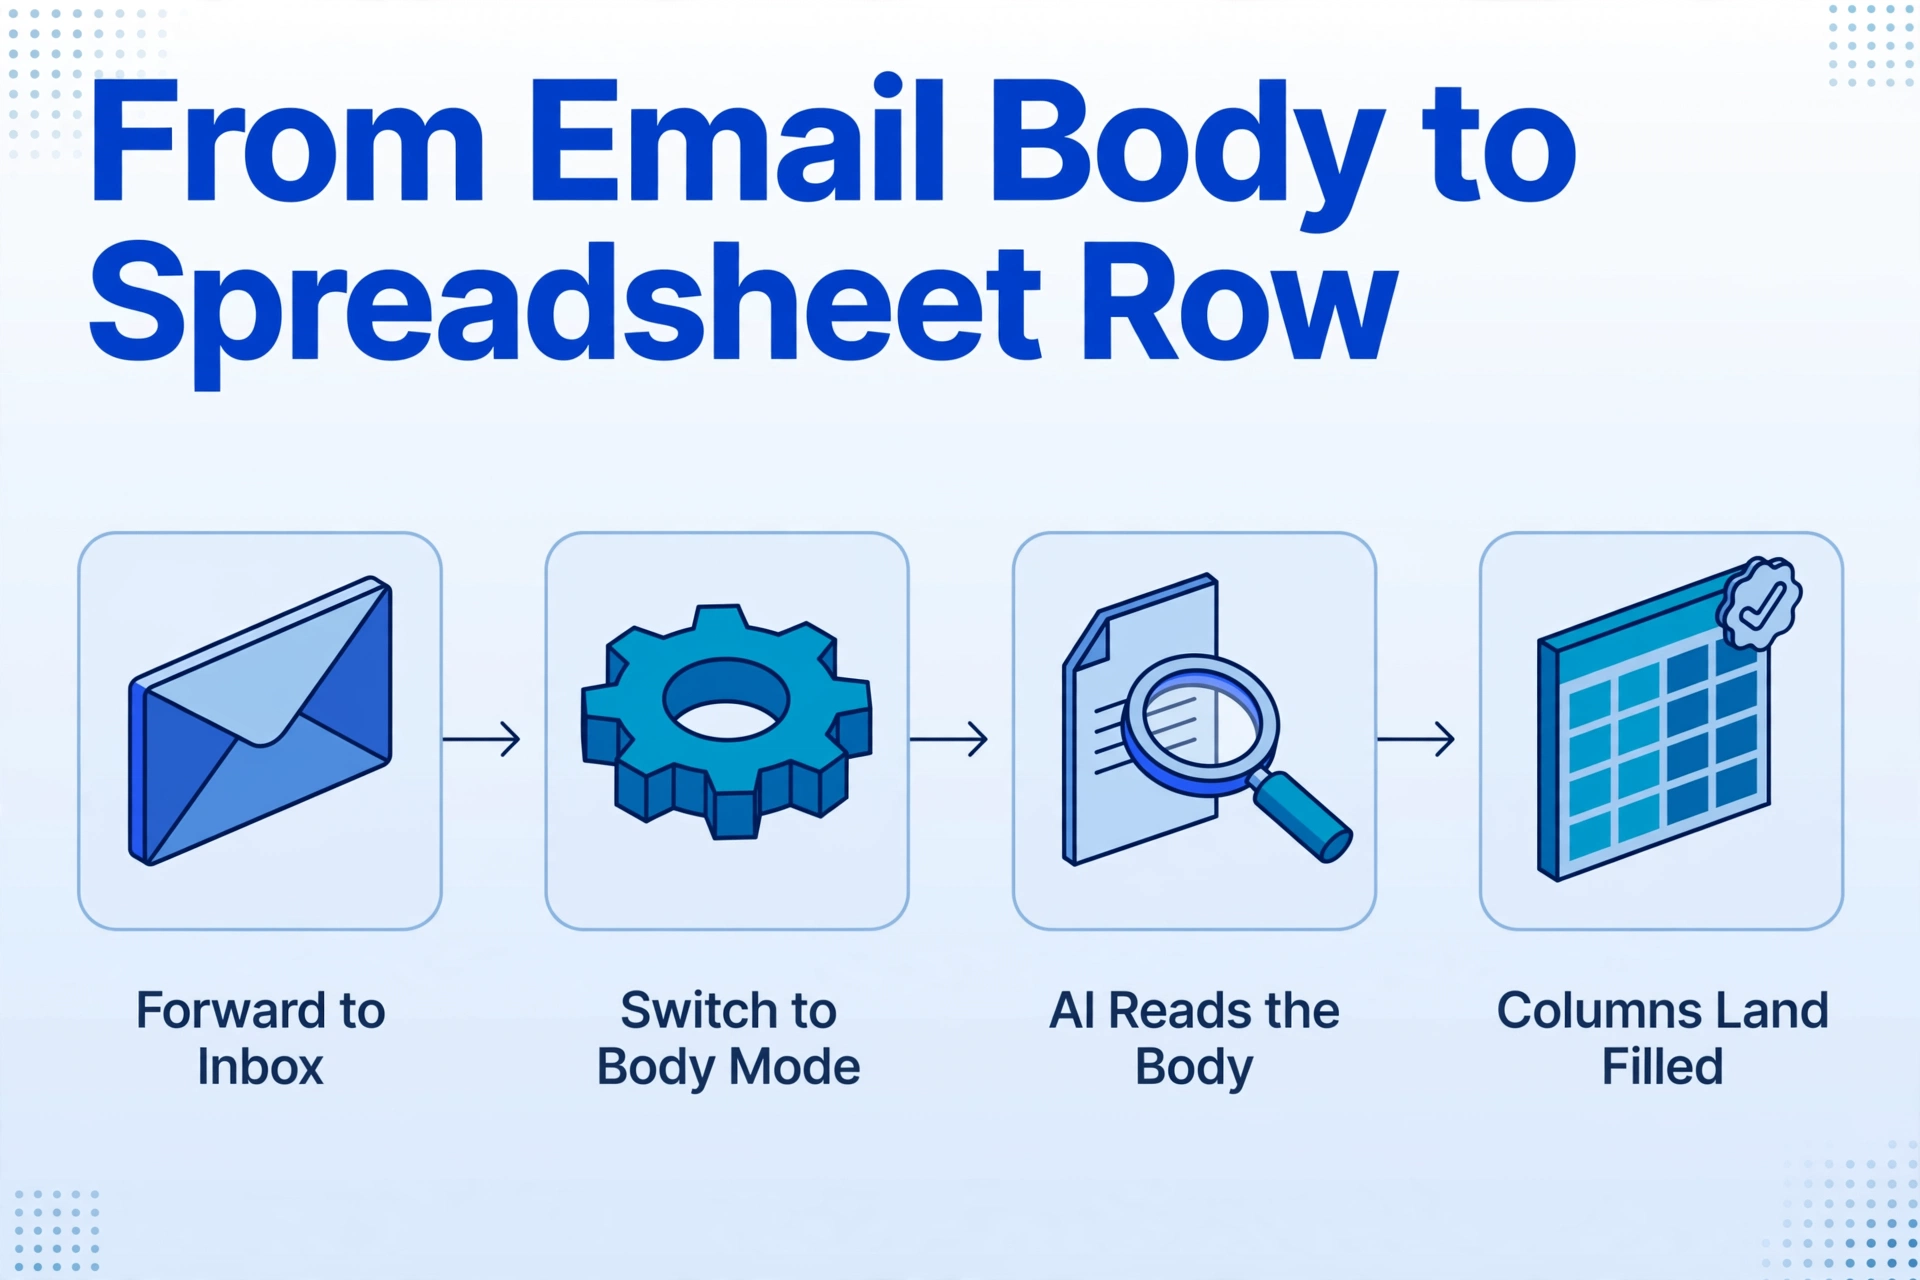
Die Lösung besteht darin, den Verarbeitungsmodus des Postfachs umzuschalten, sodass die Extraktion den Nachrichtentext direkt liest, anstatt auf einen Anhang zu warten, der nie eintreffen wird. Das E-Mail-Postfach von ImageToTable.ai gibt jedem Konto eine eigene Postfachadresse, an die Sie E-Mails weiterleiten, und das Standardverhalten ist genau das, das das Problem verursacht: Es liest echte Anhänge und ignoriert den Text. Die Einstellung, die zählt, ist die, die Sie als Nächstes ändern. Sie können die Verarbeitung auf body only umstellen, was Anhänge ignoriert, oder auf attachments and body, was beides im selben Durchlauf liest.
Dieser einzelne Schalter macht eine nur-Text-Rechnung zu einem erstklassigen Eingabewert statt zu einer Lücke. Die Nachricht benötigt keine Datei mehr, um verarbeitet zu werden, denn das, was gelesen wird, ist der Inhalt der Nachricht selbst.
Was mit dem Inhalt passiert, ist die Benutzerdefinierte Spaltenextraktion. Sie geben die gewünschten Spaltennamen ein, z. B. Rechnungsnummer, Lieferant, Rechnungsdatum, Fälligkeitsdatum und Gesamtbetrag, und die KI findet jeden Wert, indem sie versteht, was er bedeutet, nicht wo er steht. Die von Ihnen eingegebenen Namen werden zu den Kopfzeilen der Ausgabetabelle. Da die Spalten nach Bedeutung definiert sind, liest derselbe Spaltensatz einen Klartext, eine HTML-Quittung und einen PDF-Anhang, ohne dass für jeden eine separate Regel erforderlich ist. Ein Lieferant, der seine E-Mail-Vorlage ändert, oder ein neuer Lieferant, der ein Format sendet, das Sie noch nie gesehen haben, benötigt keine Neukonfiguration.
Leiten Sie die E-Mail an Ihre dedizierte Postfachadresse weiter
Jedes Konto erhält eine Adresse. Teilen Sie sie mit Lieferanten oder legen Sie eine Weiterleitungsregel in Ihrem eigenen Postfach an, damit Rechnungs-E-Mails automatisch dorthin geleitet werden. Aktivieren Sie die Absender-Whitelist, um unzugehörige E-Mails aus der Warteschlange fernzuhalten. Es wird nichts heruntergeladen oder erneut hochgeladen.
Ändern Sie, was das Postfach verarbeitet
Ändern Sie in den Postfacheinstellungen die Standardeinstellung „nur Anhänge“. Wählen Sie „body only“, wenn Ihre Rechnungen als Text oder HTML ohne Datei eintreffen, oder „attachments and body“, wenn Sie beide Arten erhalten und diese gemeinsam gelesen werden sollen. Dieser Schritt deckt die Rechnungen ab, die kein Anhang-Parser je sieht.
Benennen Sie die Spalten einmal und binden Sie sie an eine Vorlage
Geben Sie Ihre Spaltennamen ein, speichern Sie sie als Vorlage und aktivieren Sie Auto-Process, damit die Extraktion beginnt, sobald eine Nachricht eintrifft. Jede E-Mail wird zu einer Zeile. Exportieren Sie den Batch als Excel, CSV oder JSON oder senden Sie die Zeilen direkt an Google Sheets.
Wenn Sie bereits einen E-Mail-zu-Tabelle-Workflow für angehängte Rechnungen nutzen, ist dies der fehlende Zweig und kein Ersatz. Der E-Mail-Parser, der Anhänge liest und die Lieferanten-E-Mail-zu-AP-Pipeline setzen beide voraus, dass eine Datei vorhanden ist. Durch das Umschalten des Verarbeitungsmodus erfasst dasselbe Postfach auch die Nachrichten, die ohne Datei eintreffen.
Dateien werden sicher verarbeitet und nicht gespeichert.
Was dies nicht löst
Dieser Ansatz verarbeitet Rechnungen, die nur im Textkörper gesendet werden und ihre Daten als Text oder HTML enthalten, und er kann nicht bei E-Mails helfen, die gar keine Daten enthalten. Vier Grenzen sollten Sie nennen, bevor Sie einen Workflow darauf aufbauen.
Eine Portalbenachrichtigung enthält nichts zu lesen. Wenn ein Anbieter „Ihre Rechnung ist bereit“ mit einem Anmeldelink und ohne Zahlen sendet, hat der body-Modus-Schalter nichts zu extrahieren, da die Daten hinter einem authentifizierten Portal liegen. Das Lesen dieser Rechnung bedeutet, sich anzumelden und sie herunterzuladen, und der Link in der E-Mail läuft oft ab. Kein Postfach-Parser schließt diese Lücke, weil die E-Mail nie die Rechnung war.
Felder, die im Textkörper fehlen, können nicht erfunden werden. Eine Rechnung im Klartext, die „Rechnung 2026-041, $1.850, fällig am 15. Okt.“ sagt, enthält keine Positionen, sodass eine Line-Items-Spalte leer bleibt. Die Extraktion ist hier ehrlich: Sie füllt, was die Nachricht enthält, und lässt den Rest leer, was nützlicher ist als eine Schätzung, die Sie später korrigieren müssen. Wenn die Nachricht eine aufgeschlüsselte Tabelle enthält, wird diese gelesen; wenn nicht, spiegelt die Zeile einfach wider, was die E-Mail hatte.
Die Ausgabe sind strukturierte Daten, und sie bleiben strukturiert. Was Sie erhalten, ist eine Tabellenkalkulation, eine CSV- oder JSON-Zeile, und das Tool rendert die HTML-E-Mail nicht als Dokument neu. Wenn Sie für eine Audit-Datei eine saubere PDF der E-Mail benötigen, ist das eine separate Aufgabe.
Es ist keine QuickBooks- oder Dext-Integration. Die Ausgabe landet in Excel, CSV, JSON oder Google Sheets, und was als Nächstes passiert, ist Ihr Workflow. Teams, die Dext, Hubdoc oder Bill.com für die Erfassung und QuickBooks oder Xero für die Buchhaltung verwenden, behandeln dies typischerweise als strukturierten Feed, den diese Systeme konsumieren, und nicht als deren Ersatz. Für das größere Bild, wo die Extraktion im Verhältnis zu diesen Tools steht, behandeln der vollständige Leitfaden zur Rechnungsdatenextraktion und der Extraktionsleitfaden für Buchhalter den umgebenden Workflow.
Eine weitere Einschränkung betrifft weitergeleitete Ketten. Wenn eine Nachricht mehrere ältere Antworten zitiert, kann derselbe Gesamtbetrag mehr als einmal auftauchen, und die älteste Kopie steht oft im zitierten Text. Die Extraktion liest nach Bedeutung, aber eine solche Kette ist der eine Fall, in dem es sich lohnt, dreißig Sekunden zu investieren, um zu bestätigen, aus welchem Vorkommen ein Wert stammt. Review Mode existiert dafür: Wenn Sie eine Zelle überfahren, wird genau hervorgehoben, wo der Wert in der Quelle herkommt, sodass die Prüfung ein Blick statt eines erneuten Lesens ist.
FAQ
Kann eine Rechnung gelesen werden, die nur im E-Mail-Text steht und keinen Anhang hat?
Ja. Stellen Sie den Postfach-Verarbeitungsmodus auf body only oder auf attachments and body ein, wenn Sie beide Arten erhalten. Der Nachrichteninhalt wird direkt gelesen, sodass eine in die E-Mail getippte Rechnung oder eine als HTML-Beleg gerenderte Rechnung zu einer Tabellenzeile wird, ohne zuerst heruntergeladen, gedruckt oder gescreenshottet zu werden.
Was ist mit Rechnungen, die als HTML-Tabelle in der E-Mail ankommen?
Diese funktionieren im selben Durchlauf. Die KI liest den gerenderten Inhalt nach Bedeutung und nicht durch Parsen des rohen Markups nach einem festen Muster. So wird ein formatierter Beleg mit Betrag, Datum und Rechnungsnummer in Tabellenzellen genauso gelesen wie eine Rechnung im Klartext. Sie benötigen keine Regel pro Absender oder Layout.
Muss ich die E-Mail weiterhin als PDF drucken oder einen Screenshot machen?
Nein, und bei langen Rechnungen ist das der schwächere Weg. Drucken oder Screenshotten paginiert den Beleg, zieht Signatur- und Haftungsausschlusstext hinein und senkt die Dokumentqualität, die das Modell sieht. Das direkte Lesen des Texts vermeidet alle drei Probleme und entfernt einen manuellen Schritt, den der r/Bookkeeping-Thread als den Teil beschreibt, der „wirklich viel Zeit kostet“.
Was ist mit „Ihre Rechnung ist fertig“-E-Mails mit einem Portallink?
Diese können nicht aus der E-Mail extrahiert werden, da die E-Mail die Rechnung nicht enthält. Die Daten liegen hinter einem Anbieter-Login, und der Download-Link läuft häufig ab. Das ist eine echte Grenze, keine Konfigurationslücke: Die Lösung ist ein Portal-Download oder eine anbieterspezifische Integration, nicht ein besserer Parser.
Überträgt es Daten in QuickBooks oder Xero?
Es gibt strukturierte Daten als Excel, CSV oder JSON aus oder schreibt Zeilen in Google Sheets. Die Integration in ein Buchhaltungssystem erfolgt nachgelagert zu dieser Ausgabe, über Ihren eigenen Import oder Workflow. Es ist kein nativer QuickBooks- oder Xero-Konnektor und ersetzt nicht die Erfassungs- und Hauptbuch-Tools, die Sie bereits nutzen.
Konvertiert es die HTML-E-Mail in ein PDF?
Nein. Die Aufgabe hier ist die Extraktion: den Rechnungsinhalt der Nachricht in benannte Spalten umzuwandeln. Wenn Sie für Ihre Unterlagen ein PDF-Artefakt benötigen, erzeugen Sie das separat; dies erzeugt die strukturierte Zeile, für die ein PDF nur ein Zwischenschritt wäre.
Die nützliche Veränderung ist klein und spezifisch. Eine Rechnung nur im Nachrichtentext (body only) ist kein Ausnahmefall mehr, der eine manuelle Problemumgehung erzwingt, denn das, was der Workflow liest, ist keine Datei mehr. Wenn die Rechnung die E-Mail ist, ist die E-Mail das Dokument.