Der vollständige Leitfaden zur Rechnungsdatenextraktion
(2026)
Rechnungsdatenextraktion bedeutet, die in Rechnungen enthaltenen Informationen – Lieferantennamen, Beträge, Einzelposten, Daten, Steuer-IDs – in strukturierte Zeilen und Spalten umzuwandeln, die Sie sortieren, filtern, importieren und analysieren können. Das klingt einfach. Ist es aber nicht. Es gibt drei grundlegend verschiedene Ansätze, jeweils mit eigenen Einrichtungskosten, Genauigkeitsgrenzen und Skalierbarkeitslimits. Dieser vollständige Leitfaden zur Rechnungsdatenextraktion behandelt alle drei, erklärt, welche Felder Sie tatsächlich extrahieren müssen, und bietet einen Entscheidungsrahmen für die Wahl des richtigen Ansatzes – basierend auf Ihrem Rechnungsvolumen, der Formatkomplexität und dem Zielort der Daten.
Was ist Rechnungsdatenextraktion – und warum die meisten Teams sie immer noch von Hand durchführen
Rechnungsdatenextraktion ist der Prozess, bei dem Informationen aus Rechnungsdokumenten – PDFs, gescannten Bildern, Fotos – erfasst und in strukturierte Datenformate wie Excel, CSV oder JSON umgewandelt werden. Die extrahierten Informationen umfassen typischerweise den Rechnungskopf (Nummer, Daten, Lieferant, Summen) und die Einzelposten (Mengen, Beschreibungen, Einzelpreise, Positionssummen). Das Ergebnis ist eine Tabelle, in der jede Zeile eine Rechnung oder ein Einzelposten ist und jede Spalte ein Datenfeld.
Warum das wichtig ist: 68 % der Unternehmen geben Rechnungsdaten laut Branchendaten aus HighRadiuss AP-Automatisierungsstatistiken 2025 immer noch manuell in ihre ERP- oder Buchhaltungssysteme ein. Manuelle Eingabe kostet etwa 15 $ pro Rechnung an Arbeitsaufwand, dauert 3–5 Minuten pro Dokument und führt zu einer konstanten Fehlerquote von 2–5 %. Bei 500 Rechnungen im Monat sind das 7.500 $ an Arbeitskosten und 10–25 Fehler alle 30 Tage – Fehler, die sich in falschen Zahlungen, falsch codierten Sachkontenzuordnungen und Abstimmungsarbeiten niederschlagen, die mehr kosten als die ursprüngliche Eingabe.
Die Alternative – automatisierte Extraktion – ist seit Jahren möglich. Aber die Technologie hat sich so schnell verändert, dass das, was vor drei Jahren dem Stand der Technik entsprach (vorlagenbasierte OCR), heute der veraltete Ansatz ist, und das, was heute dem Stand der Technik entspricht (KI-gestützte semantische Extraktion), funktioniert mit Dokumenttypen und -formaten, die die vorherige Generation nicht verarbeiten konnte. Die drei Methoden zu verstehen – was sie sind, was sie kosten und wo sie scheitern – ist der Unterschied zwischen der Wahl eines funktionierenden Tools und sechs Monaten einer gescheiterten Implementierung. Für die tiefergehende Geschichte, warum manuelle Eingabe trotz verfügbarer Automatisierung fortbesteht, siehe warum AP-Teams Rechnungsdaten immer noch von Hand erfassen.
Die drei Methoden — Manuelle Eingabe, Vorlagen-OCR und KI-gestützte Extraktion
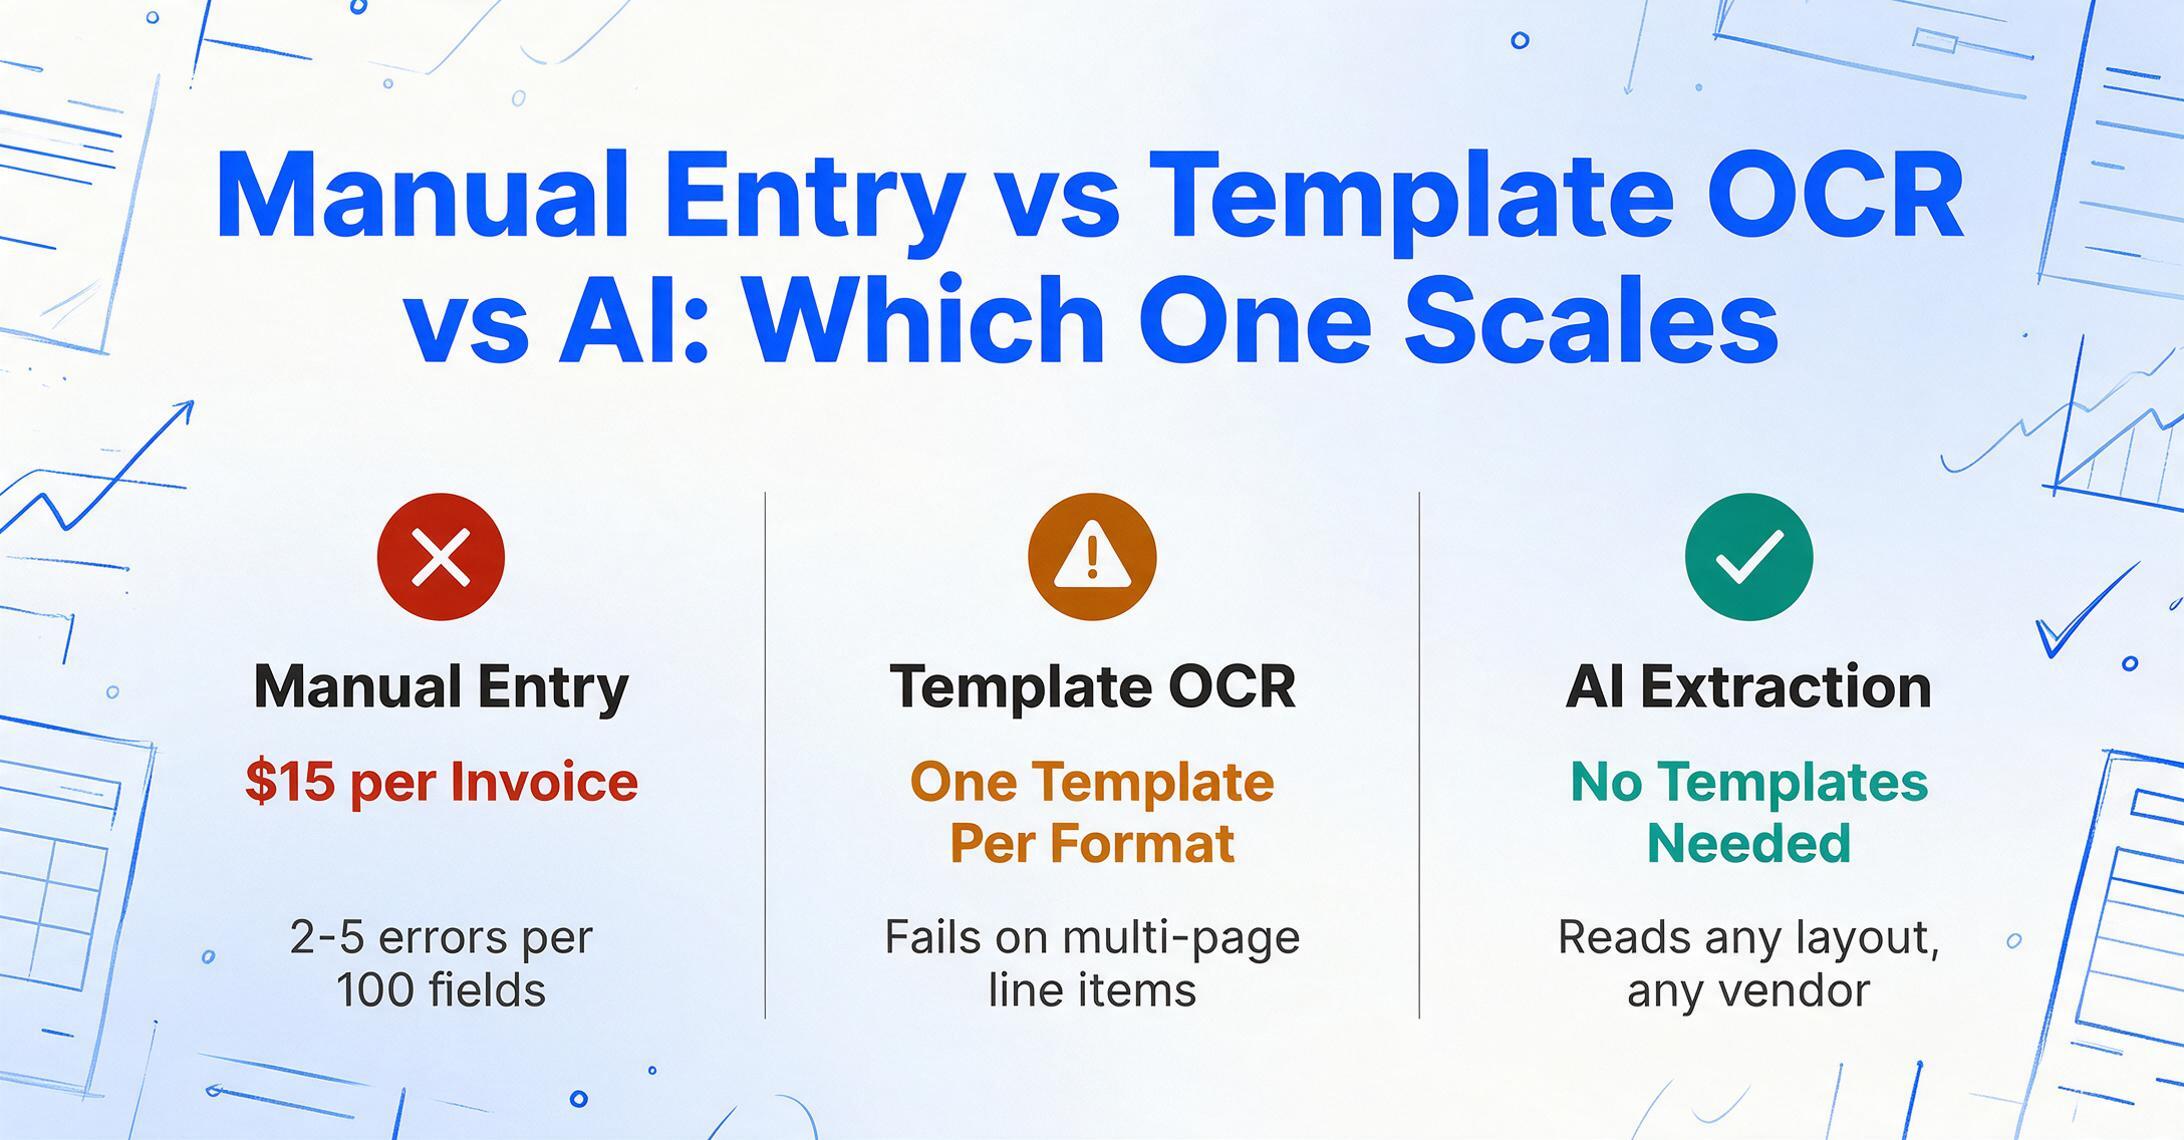
Jeder Ansatz zur Rechnungsextraktion fällt in eine von drei Kategorien. Sie sind nicht gleichwertig — jede hat eine andere Genauigkeitsgrenze, Einrichtungskosten und Skalierbarkeitsgrenze. Die richtige Wahl hängt von Ihrem Volumen und Ihrer Mischung an Rechnungsformaten ab, nicht davon, welche Methode am fortschrittlichsten klingt. Für einen praktischen Blick auf die Extraktion ohne Vorlage, probieren Sie den Rechnungsverarbeitungs-Workflow mit Spaltennamensextraktion aus.
Methode 1: Manuelle Eingabe
Was es ist: Eine Person öffnet jede Rechnungs-PDF, liest die Felder und tippt sie in eine Tabellenkalkulation oder ein ERP. Keine Technologie über einen PDF-Viewer und Excel hinaus.
Kosten: Ungefähr $15 pro Rechnung an vollständig belasteten Arbeitskosten, laut Quadients AP-Automatisierungs-Benchmarks 2025. Bei 100 Rechnungen pro Monat: $1.500/Monat. Bei 1.000 Rechnungen: $15.000/Monat — ungefähr ein Vollzeit-AP-Sachbearbeiter, der vollständig mit der Dateneingabe beschäftigt ist.
Genauigkeit: 95-98% pro Feld bei sorgfältigen Bedienern — das bedeutet 2-5 Fehler pro 100 Felder. Dies sind Übertragungsfehler: vertauschte Ziffern, falsch gelesene Handschrift, falsche Dezimalstellen. Bemerkenswert ist, dass ein Mensch, der eine Zahl vertauscht, einen falschen Wert erzeugt, der im System korrekt aussieht. Eine KI, die ein Feld übersieht, erzeugt eine Leerstelle — was sicherer ist, weil es sichtbar ist.
Wann es sinnvoll ist: Unter 50 Rechnungen pro Monat, oder wenn jede Rechnung von einem anderen Lieferanten mit einem einzigartigen Format stammt und die Kosten für die Einrichtung eines automatisierten Systems die Arbeitskosten übersteigen. Auch: wenn die Person, die die Eingabe durchführt, tiefes Kontextwissen über die Lieferantenbeziehung und Kodierungsregeln hat, das kein automatisiertes System ohne monatelanges Training reproduzieren kann.
Wann es scheitert: Über 200 Rechnungen pro Monat steigt die Fehlerquote schneller als der Durchsatz. Dieselbe Person, die bei 50 Rechnungen genau war, beginnt bei 200 Fehler zu machen, weil nach der ersten Stunde repetitiver Übertragung kognitive Ermüdung einsetzt. Für mehr über die spezifischen Fehler und ihre Kosten, siehe die sechs kostspieligsten Fehler bei der Rechnungsdateneingabe.
Methode 2: Vorlagenbasierte OCR
Was es ist: Eine OCR-Software liest den Text aus einem Rechnungsbild, und eine Vorlage gibt an, wo sich jedes Feld befindet („Rechnungsnummer bei Koordinaten x:420, y:180"). Sie erstellen eine Vorlage pro Lieferantenformat. Die OCR-Engine liest die Zeichen; die Vorlage ordnet sie den Feldern zu.
Kosten: OCR-Software reicht von kostenlos (Tesseract) bis $0,01–0,05 pro Seite (Cloud-APIs wie AWS Textract, Google Document AI) bis zu $30–300/Monat für Komplettpakete. Die versteckten Kosten liegen in der Vorlagenpflege — jedes neue Lieferantenformat erfordert eine neue Vorlage, und jede Änderung des Lieferantenlayouts bricht die bestehende Vorlage. Organisationen mit 100+ Lieferanten und vorlagenbasierter OCR geben typischerweise 5–10 Stunden pro Monat für die Vorlagenpflege aus.
Genauigkeit: 95–99 % bei gedrucktem Text an der exakten Position, die die Vorlage erwartet. Fällt unter 70 % bei handschriftlichen Inhalten, Stempeln, Anmerkungen oder jeder Layout-Abweichung, laut PDFExcels Analyse der OCR-Genauigkeit bei nicht standardisierten Rechnungen. Die Genauigkeit auf Seitenebene kann bei 99 % liegen, während die Genauigkeit auf Feldebene bei 70 % liegt, wenn sich die OCR-Fehler auf die finanziell bedeutsamen Felder konzentrieren.
Wann es sinnvoll ist: Wenn Sie hohe Rechnungsmengen von einer kleinen, stabilen Gruppe von Lieferanten mit konsistenten Formaten verarbeiten — zum Beispiel ein Hersteller, der wöchentlich Rechnungen von denselben 15 Rohstofflieferanten erhält. Erstellen Sie 15 Vorlagen einmal, pflegen Sie sie vierteljährlich und verarbeiten Sie Tausende von Rechnungen.
Wann es scheitert: Wenn Ihre Lieferantenanzahl groß ist oder sich ändert. Wenn Lieferanten ihre Buchhaltungssoftware wechseln und sich ihr Rechnungslayout verschiebt. Wenn Rechnungen handschriftliche Notizen, mehrsprachige Inhalte, Stempel oder unregelmäßige Tabellen enthalten. Vorlagen-OCR ist zuverlässig für bekannte Formate und fragil bei unbekannten — und in der AP sind unbekannte Formate die Norm, nicht die Ausnahme. Wie LlamaIndex' Analyse der realen Rechnungsvarianz dokumentiert, gibt es so etwas wie eine Standardrechnung nicht.
Methode 3: KI-gestützte semantische Extraktion
Was es ist: Ein Vision-Language-Modell liest die Rechnung wie ein Mensch – es erkennt das Layout, versteht, welche Beschriftungen zu welchen Werten gehören, und extrahiert Felder basierend auf semantischer Bedeutung statt auf festen Positionen. Sie legen fest, was Sie benötigen, über den Feldnamen („Rechnungsnummer", „Gesamtbetrag", „Lieferantenname"), nicht über Koordinaten. Die KI findet jedes Feld an beliebiger Stelle auf der Seite, weil sie versteht, was es ist, nicht wo es steht.
Kosten: Typischerweise 0,05–0,30 $ pro Seite für API-basierte Dienste oder 20–50 $/Monat für Komplettlösungen mit Weboberfläche und Stapelverarbeitung. Keine Vorlagenpflegekosten – dasselbe Setup funktioniert für jedes Lieferantenformat.
Genauigkeit: 97–99 % Feldgenauigkeit bei sauberen gedruckten Rechnungen, 88–95 % bei Rechnungen mit handschriftlichen Anmerkungen, 75–90 % bei vollständig handschriftlichen Dokumenten. Die Schwankung hängt mehr von der Dokumentqualität ab (Scanauflösung, Farbe vs. Schwarzweiß, Entzerrung) als vom Tool selbst. Eine detaillierte Aufschlüsselung der Genauigkeit nach Rechnungstyp und Hinweise zur Messung an eigenen Dokumenten finden Sie im praktischen Leitfaden zur Genauigkeit der KI-Extraktion.
Wann es sinnvoll ist: Wenn Sie mehr als 100 Rechnungen pro Monat von mehreren Lieferanten mit unterschiedlichen Formaten verarbeiten. Wenn Ihr Rechnungsmix handschriftliche Notizen, mehrsprachige Dokumente oder unregelmäßige Layouts enthält. Wenn Sie Einzelposten mit Mengen und Einzelpreisen extrahieren müssen – vorlagenbasierte OCR scheitert bei Tabellen über mehrere Seiten oder mit variabler Spaltenanzahl.
Wann es scheitert: Bei stark beschädigten Rechnungen – Kopien in vierter Generation, Faxbilder mit 72 DPI, schräg fotografierte Dokumente bei schlechtem Licht. Keine Extraktionsmethode bewältigt diese gut, aber KI degradiert eleganter als OCR, weil sie aus dem Kontext raten kann, wo OCR nur Rauschen liefert. Außerdem: wenn die Rechnung Felder enthält, die externes Wissen erfordern, das die KI nicht hat (z. B. welchem Kostenstelle ein bestimmter Einzelposten zugeordnet werden soll – das ist eine separate Sachkontenzuordnung, kein Extraktionsproblem).
Für einen direkten Vergleich spezifischer Tools innerhalb der Kategorie KI-Extraktion – einschließlich der Frage, welche ohne IT-Support funktionieren, Einzelposten verarbeiten und Stapelverarbeitung unterstützen – siehe unseren Vergleich der KI-Rechnungsextraktionstools für Finanzteams.
Die Felder, die Sie wirklich brauchen — Kopffelder, Einzelposten, berechnete und Compliance-Felder
Nicht jedes Rechnungsfeld muss extrahiert werden. Zu verstehen, welche Datenkategorien für Ihren Workflow relevant sind, verhindert Über- und Unterspezifikation — Über-spezifikation verlangsamt die Extraktion und erhöht die Fehleranfälligkeit, Unterspezifikation bedeutet, dass Sie später erneut extrahieren müssen.
Kopffelder — immer extrahieren. Diese identifizieren die Transaktion und erscheinen einmal pro Rechnung: Rechnungsnummer, Rechnungsdatum, Fälligkeitsdatum, Lieferantenname, Gesamtbetrag, Steuerbetrag, Währung und Bestellnummer. Das ist der minimale Extraktionsumfang. Jeder Rechnungsworkflow benötigt diese Felder für die Zahlungsabwicklung und den ERP-Import. Fehlende oder falsche Kopffelder verursachen die teuersten Fehler, da sie die Rechnung in den falschen Genehmigungspfad, den falschen Zahlungsbetrag oder den falschen Abrechnungszeitraum lenken.
Einzelposten — extrahieren, wenn Sie eine Kostenzuordnung benötigen. Jeder Einzelposten ist eine Zeile in der Rechnungstabelle: Beschreibung, Menge, Einzelpreis, Positionssumme und optional SKU, Steuersatz oder Kontonummer. Die Extraktion von Einzelposten ist wichtig, wenn Sie eine Rechnung auf mehrere Kostenstellen aufteilen müssen (Zeile 1 an Abteilung A, Zeile 2 an Abteilung B), Ausgaben nach Produktkategorie verfolgen oder prüfen möchten, ob die Einzelpreise dem Vertrag entsprechen. Die Extraktion von Einzelposten ist technisch anspruchsvoller als die von Kopffeldern, da Tabellen variable Spalten haben, über Seiten verteilt sind und uneinheitliche Formatierungen aufweisen — die Tabelle auf Seite 1 kann 5 Spalten haben, die auf Seite 2 sechs. Vorlagenbasierte OCR scheitert bei Einzelposten häufig. KI-Extraktion bewältigt sie, weil sie die Tabellenstruktur semantisch und nicht geometrisch liest.
Berechnete Felder — extrahieren, wenn das Dokument die benötigte Zahl nicht zeigt. Einige benötigte Werte sind nicht auf der Rechnung aufgedruckt. Eine Zwischensumme vor Steuern, wenn die Rechnung nur den Gesamtbetrag inklusive Steuern zeigt. Eine Positionssumme, wenn nur Menge und Einzelpreis angegeben sind. Die Differenz zwischen Rechnungsbetrag und vertraglich vereinbartem Satz. Die Spaltennamen-Berechnung — bei der Sie eine Berechnungslogik in den Feldnamen schreiben, z. B. „Zwischensumme (Gesamt − Steuerbetrag)“ oder „Positionssumme (Menge × Einzelpreis)“ — weist die KI an, den fehlenden Wert aus den lesbaren Feldern zu berechnen. Das verwandelt Extraktion (Auffinden vorhandener Daten) in Ableitung (Berechnung dessen, was Sie benötigen, aus vorhandenen Daten).
Compliance-Felder — extrahieren, wenn gesetzliche Vorschriften sie verlangen. Diese variieren je nach Land: USt-IdNr. für EU-Rechnungen, ABN für australische Rechnungen, GSTIN für indische Rechnungen, Steuer-ID des Lieferanten für die US-1099-Berichterstattung. Fehlende oder falsche Compliance-Felder blockieren die Zahlung nicht, verursachen aber nachgelagerte Steuerprobleme — eine 1099 mit falscher TIN führt zu einer IRS-Mitteilung, eine Umsatzsteuererklärung mit fehlender Lieferantenregistrierung löst eine Prüfungsanfrage aus. Diese Felder sollten Teil jedes Extraktions-Setups sein, wo sie zutreffen, und nicht erst in der Steuersaison nachträglich hinzugefügt werden.
Welche Methode passt zu Ihrer Situation – Ein Entscheidungsrahmen
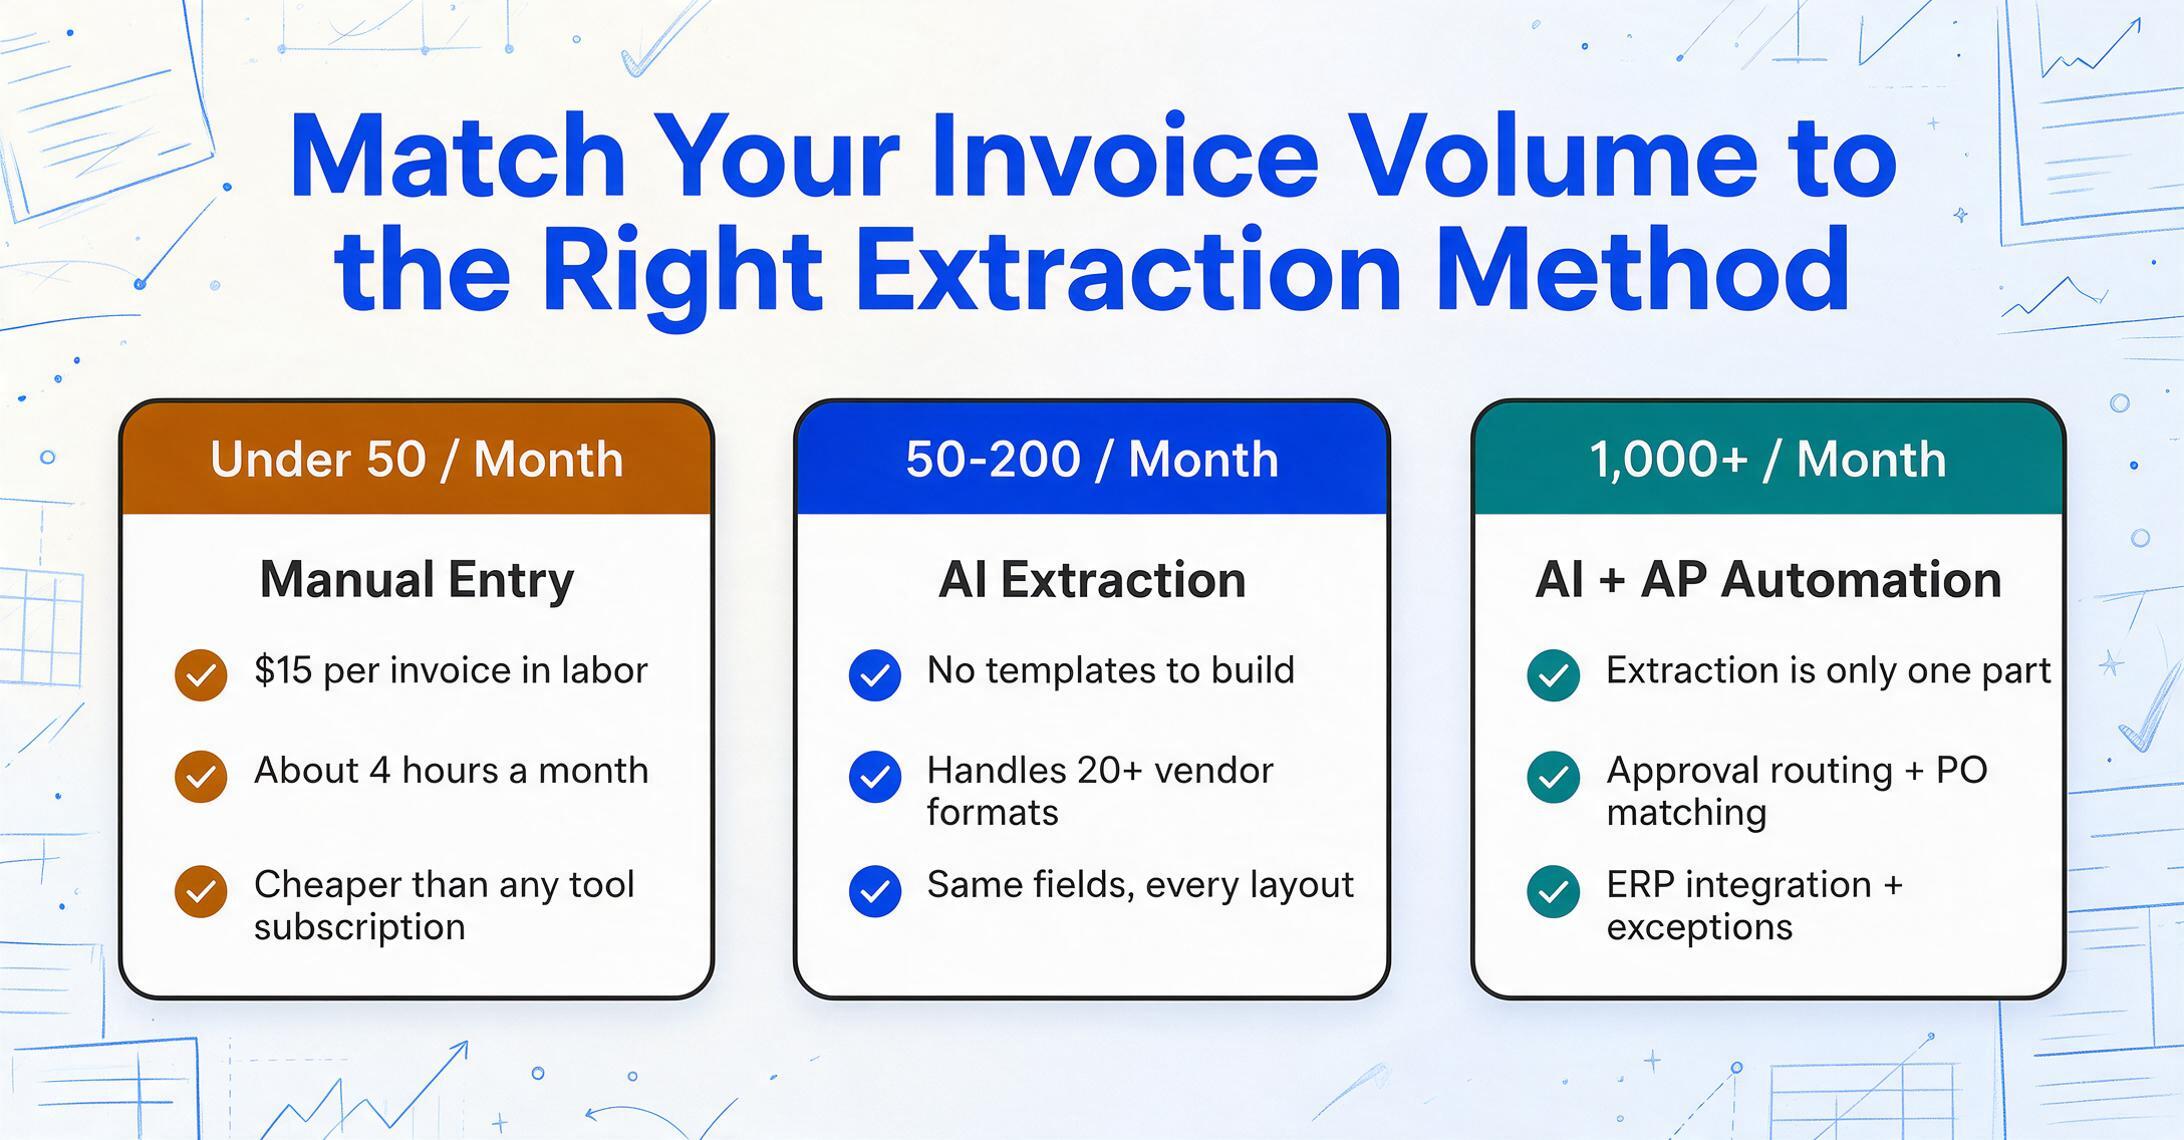
Die richtige Extraktionsmethode ist nicht die fortschrittlichste. Es ist diejenige, deren Kosten und Komplexität zu Ihrem Volumen und Ihrer Formatmischung passen. Hier ist die Entscheidungslogik, geordnet nach den Faktoren, die tatsächlich über Erfolg oder Misserfolg entscheiden:
| Ihre Situation | Beste Methode | Warum |
|---|---|---|
| < 50 Rechnungen/Monat, unterschiedliche Formate | Manuelle Eingabe | Die Einrichtungskosten jedes automatisierten Systems übersteigen bei diesem Volumen die Arbeitskosten. Eine einzelne Person, die 50 Rechnungen verarbeitet (~4 Stunden/Monat), ist günstiger als jedes Tool-Abonnement plus die Zeit, es zu erlernen. |
| 50–200/Monat, unterschiedliche Formate | KI-Extraktion | Die Einrichtungszeit für Template-OCR bei 20+ Lieferantenformaten kostet mehr als ein KI-Tool-Abonnement. KI bewältigt Formatvielfalt ohne Template-Pflege. |
| 200–1.000/Monat, < 20 stabile Lieferantenformate | Template-OCR oder KI | Wenn Ihre Lieferantenliste stabil ist und die Formate konsistent sind, liefert Template-OCR hohe Genauigkeit zu geringeren Kosten pro Seite. Wenn die Formate variieren, vermeidet KI den Template-Pflegeaufwand. |
| 200–1.000/Monat, 50+ Lieferantenformate | KI-Extraktion | Die Verwaltung von 50+ Templates ist ein Teilzeitjob. KI bewältigt Formatvielfalt ohne Einrichtung pro Lieferant. Siehe den Skalierungsrahmen für die volumenbasierte Entscheidungslogik. |
| 1.000+/Monat, beliebige Formatmischung | KI-Extraktion + AP-Automatisierung | Bei diesem Volumen ist die Extraktion nur ein Teil des Workflows. Sie benötigen außerdem automatisierte Genehmigungsrouten, Bestellnummernabgleich, ERP-Integration und Ausnahmebehandlung. Eigenständige KI-Extraktionstools übernehmen die Datenerfassung. Vollständige AP-Automatisierungsplattformen (Tipalti, Stampli, Rossum) übernehmen den gesamten Rechnungslebenszyklus. |
| Handschriftliche Rechnungen, beliebiges Volumen | KI (VLM-basiert) | Template-OCR fällt bei Handschrift unter 70%. VLMs lesen Handschrift, indem sie Buchstabenformen im semantischen Kontext verstehen. Hochauflösende Scans (400-600 DPI, Farbe) sind unerlässlich. |
| Mehrsprachige, grenzüberschreitende Rechnungen | KI (VLM-basiert) | Vision-Language-Modelle lesen semantisch über Sprachen hinweg. Template-OCR, das auf Englisch trainiert wurde, hat Probleme mit japanischen Beschriftungen, französischen Datumsformaten und europäischen Dezimalkonventionen. |
Der wichtigste Schwellenwert ist der Bereich von 50–200 Rechnungen. Unter 50 ist die manuelle Eingabe tatsächlich günstiger und einfacher als jede Automatisierung. Über 200 kostet die manuelle Eingabe allein durch direkte Arbeitskosten mehr als KI-Extraktion – noch bevor die Kosten für die Fehlerkorrektur berücksichtigt werden. Der mittlere Bereich ist der, in dem die Entscheidung von Ihrer spezifischen Formatmischung abhängt und davon, ob Sie eine Person haben, die einen Nachmittag damit verbringen kann, ein Extraktionstool einzurichten und zu erlernen.
Dateien werden sicher verarbeitet und nicht gespeichert.
Was nach der Extraktion passiert – Von der Tabelle zum ERP
Die Extraktion holt die Daten aus dem Dokument. Sie in Ihr Buchhaltungssystem zu bekommen, ist ein separater Schritt – und genau hier scheitern viele Extraktionsimplementierungen, weil das Team erkennt, dass die Daten strukturiert sind, aber die Verbindung zum ERP fehlt. Es gibt vier Integrationspfade, geordnet von der einfachsten bis zur am stärksten automatisierten Variante:
Pfad 1: Herunterladen und importieren. Das Extraktionstool gibt Excel oder CSV aus. Sie laden die Datei herunter, prüfen sie und importieren sie über die native Importfunktion in Ihr ERP. Das funktioniert mit jedem ERP – SAP, Oracle, NetSuite, QuickBooks, Xero, Sage, Microsoft Dynamics –, da der CSV-Import universell ist. Es erfordert keinerlei IT-Beteiligung. Der Preis dafür ist der manuelle Download-und-Import-Schritt, der pro Stapel 2–5 Minuten dauert, unabhängig davon, wie viele Rechnungen im Stapel sind. Dies ist der richtige Pfad für die meisten Teams, die unter 1.000 Rechnungen pro Monat verarbeiten.
Pfad 2: Direkte Tabellenintegration. Das Extraktionstool schreibt Daten direkt per API in Google Sheets oder Excel Online. Die Tabelle wird zum Vermittler zwischen Extraktion und ERP – das Tool fügt Zeilen zu einem Blatt hinzu, und eine separate Integration (Zapier, Make oder ein integrierter ERP-Konnektor) liest aus dem Blatt in das ERP. Das eliminiert den Download-Schritt und macht die Daten in einem Format zur Prüfung verfügbar, das das Finanzteam bereits nutzt. Speziell für Google-Sheets-Nutzer bieten einige Extraktionstools Seitenleisten-Add-ons an, mit denen Sie Rechnungen hochladen und extrahierte Daten erhalten, ohne die Tabelle zu verlassen.
Pfad 3: API-Integration. Das Extraktionstool sendet extrahierte Daten direkt per API an das ERP. Das erfordert, dass sowohl das Extraktionstool als auch das ERP kompatible APIs haben und dass jemand (normalerweise IT oder ein Integrationsberater) die Verbindung einrichtet. Einmal konfiguriert, läuft Extraktion → Validierung → ERP-Import mit minimalem menschlichem Eingriff. Die Rechnungen, die die Validierung bestehen, werden automatisch gebucht. Diejenigen, die durchfallen, werden zur Prüfung markiert. Dieser Pfad ist bei über 1.000 Rechnungen pro Monat geeignet oder wenn der manuelle Importschritt der Engpass im Workflow ist.
Pfad 4: Sammellinks für eingehende Dokumente. Ein Sammellink ist eine teilbare URL, über die Lieferanten, Kunden oder Teammitglieder Rechnungen direkt in Ihre Extraktionswarteschlange hochladen können – ohne Registrierung, ohne Anmeldung, ohne E-Mail-Hin und Her. Die Person öffnet den Link, gibt einen kurzen Verifizierungscode ein und lädt ihre Datei hoch. Sie landet in Ihrer Verarbeitungspipeline. Dadurch wird die Extraktion von „Ich sammle Dokumente, dann extrahiere ich" zu „Dokumente kommen vorgesammelt in der Extraktionswarteschlange an". Für Audit-Vorbereitungsszenarien, in denen Sie Rechnungen unter Zeitdruck aus mehreren Quellen sammeln müssen, siehe den Leitfaden zur Audit-Saison-Vorbereitung.
Der andere eingehende Kanal ist E-Mail. Ein Sammellink deckt die Dokumente ab, die Sie nachverfolgen müssen; die meisten Rechnungen kommen von selbst als Anhänge an. Eine dedizierte Posteingangsadresse leitet diesen Strom in dieselbe Warteschlange: Sie teilen eine Adresse mit Lieferanten oder Kunden, und jeder Anhang landet automatisch in Ihrer Verarbeitungswarteschlange. Mit aktivierter Auto-Verarbeitung und den gewünschten Feldern, die an den Posteingang gebunden sind, beginnt die Extraktion, sobald die Mail eintrifft; eine Absender-Whitelist hält fremde Mails fern, und gespeicherte Passwörter entsperren geschützte PDFs, ohne dass jemand das Passwort eingibt. Das Ergebnis entspricht dem Sammellink: Dokumente kommen vorgesammelt an, und niemand leitet Dateien manuell weiter oder lädt sie hoch.
Tiefer eintauchen – Schlüsselthemen für spezifische Anforderungen
Die Rechnungsdatenextraktion überschneidet sich mit mehreren spezialisierten Arbeitsabläufen. Die folgenden Artikel gehen jeweils tiefer auf jeden Bereich ein:
| Was ist Rechnungsdatenextraktion? So funktioniert sie und warum sie wichtig ist | Die Definition für Einsteiger – wenn Sie mit dem Konzept noch nicht vertraut sind, starten Sie hier, bevor Sie sich mit Methoden und Tools befassen. |
| Warum AP-Teams Rechnungsdaten immer noch manuell erfassen | Die strukturellen Gründe, warum die manuelle Eingabe trotz jahrzehntelanger Automatisierung fortbesteht – und warum ein „besseres ERP" nicht die Lösung war. |
| KI-Extraktionstools im Vergleich für Finanzteams | Direkter Vergleich nach technischem Ansatz – welche Tools ohne IT-Support funktionieren, Einzelposten verarbeiten und Stapelverarbeitung unterstützen. |
| Rechnungsverarbeitung skalieren ohne zusätzliches Personal | Entscheidungsrahmen dafür, wann Prozesse optimiert, wann automatisiert und wann eingestellt werden sollte – nach Volumen-Wendepunkt. |
| 6 Rechnungserfassungsfehler, die am teuersten werden | Die sichtbaren Fehler (Ziffernvertauschungen, Duplikate) und die unsichtbaren (Sachkontenzuordnung, Steuerklassifizierung) – mit Kostenaufschlüsselung pro Fehler. |
| Praktischer Genauigkeitsleitfaden für KI-Rechnungsextraktion | Warum „99 % Genauigkeit" eine Marketingzahl ist, was Feldgenauigkeit tatsächlich bedeutet und wie Sie an einem Nachmittag Ihren eigenen Genauigkeitstest durchführen. |
| Prüfungssaison: Rechnungsdaten vorbereiten, wenn die Zeit knapp ist | Notfall-Triage-System zur Digitalisierung von Rechnungsdaten, wenn die Prüfer nur noch Wochen entfernt sind – was priorisiert, was übersprungen werden sollte. |
Erweiterte Feldextraktion: Berechnete Spalten und feldübergreifende Validierung
Die nächste Stufe über das bloße Extrahieren dessen hinaus, was auf einer Rechnung gedruckt ist, ist das Extrahieren dessen, was Sie tatsächlich benötigen – und das ist nicht immer dasselbe. Eine Rechnung kann eine Zwischensumme von 1.247,83 $ ausweisen, ohne die Steuer aufzuschlüsseln, aber Sie benötigen den Nettobetrag für die Sachkontenzuordnung. Sie kann 15 Einzelposten mit Mengen und Einheitspreisen, aber ohne Positionssummen auflisten. Sie kann eine Gesamtsumme zeigen, die nicht mit der Summe der Einzelposten übereinstimmt – und Sie müssen wissen, welche Zahl falsch ist, bevor Sie die Zahlung verbuchen.
Das sind keine Randfälle. Das sind alltägliche Probleme der Rechnungsverarbeitung, die die Extraktion von einem einstufigen Auslesen in einen mehrstufigen Prüf- und Berechnungsworkflow verwandeln. Die Werkzeuge, die das gut beherrschen, heben sich von denen ab, die nur Text lesen.
Berechnete Spalten – berechnete Ergebnisse, nicht nur extrahierte Werte
Eine berechnete Spalte ist ein Feld, das Sie definieren und das nicht nur einen Wert auf dem Dokument lokalisiert. Es nimmt einen oder mehrere extrahierte Werte, führt eine Berechnung damit durch und gibt das Ergebnis als eigene Spalte in der Tabelle aus. Das einfachste und häufigste Beispiel: Positionssumme = Menge × Einzelpreis. Viele Rechnungen drucken die Positionssumme neben Menge und Einzelpreis – aber wenn sie das nicht tun (oder wenn die gedruckte Positionssumme falsch ist), schließt eine berechnete Spalte die Lücke, indem sie das Extrahierte multipliziert.
Diese Fähigkeit geht weit über einfache Arithmetik hinaus. Derselbe Mechanismus bewältigt:
- Fehlende Zwischensumme: Die Rechnung zeigt nur den Gesamtbetrag inklusive Steuern. Eine berechnete Spalte leitet
Zwischensumme = Gesamtbetrag − Steuerbetragab und liefert Ihnen den Nettobetrag für die Sachkontenzuordnung – ohne separaten Taschenrechnerschritt. - Validierung auf Positionsebene: Extrahieren Sie Menge und Einzelpreis separat und berechnen Sie dann
Erwartete Positionssumme = Menge × Einzelpreis. Vergleichen Sie mit der gedruckten Positionssumme. Eine Abweichungsspalte markiert Unstimmigkeiten, bevor sie das ERP erreichen. - Abstimmung auf Rechnungsebene: Summieren Sie alle berechneten Positionssummen und vergleichen Sie mit der gedruckten Zwischensumme. Ist die Differenz ungleich null, stimmt etwas nicht – entweder wurden die Einzelpositionen falsch gelesen oder die Zwischensumme im Kopf wurde falsch gedruckt. In beiden Fällen erkennen Sie es vor der Zahlung.
- Bedingte Logik:
Rabattkennzeichen = WENN(Positionssumme > 500 $, "Prüfen", "OK")– wenden Sie Geschäftsregeln während der Extraktion an, sodass die Ausgabe bereits segmentiert, was Aufmerksamkeit erfordert und was automatisch verbucht werden kann. - Ratensuche: Betten Sie einen festen Steuersatz (z. B. 8,875 % für NYC) in die Berechnungsregel ein. Die KI wendet ihn auf jede Position an, ohne dass der Satz irgendwo auf dem Dokument erscheint.
Der architektonische Wandel hier ist erheblich: Die Extraktion ist nicht mehr nur das Lesen dessen, was vorhanden ist, sondern wird zu einer kombinierten Lese- und Ableitungsoperation. Statt Rohdaten zu extrahieren und dann Excel zu öffnen, um zu berechnen, zu pivotieren und zu validieren, erhalten Sie berechnete Ergebnisse in derselben Tabelle, die aus der Extraktion stammt – ein Schritt statt drei. Eine detaillierte Anleitung zum vollständigen Mechanismus der berechneten Spalten finden Sie unter wie die Extraktion von Einzelpositionen mit berechneten Summen funktioniert.
Feldübergreifende Validierung – Fehler erkennen ohne manuelle Prüfung
Die feldübergreifende Validierung ist die mathematische Überprüfung, ob extrahierte Werte intern konsistent sind. Sie beantwortet die Frage: „Wenn ich die Einzelposten addiere, erhalte ich dann die Zwischensumme? Wenn ich den Steuersatz anwende, erhalte ich dann den Steuerbetrag? Wenn ich die Steuer zur Zwischensumme addiere, erhalte ich dann die Gesamtsumme?"
Diese Prüfungen sind deterministisch – sie bestehen entweder oder nicht. Keine Beurteilung erforderlich. Und sie fangen die gefährlichste Klasse von Extraktionsfehlern ab: Werte, die isoliert richtig aussehen, aber nicht zusammenpassen. Eine vertauschte Ziffer in einer Positionssumme (war $1.247, extrahiert als $1.274) könnte einen Drei-Wege-Abgleich bestehen. Aber Σ(Menge × Einzelpreis) ≠ Zwischensumme fängt es sofort ab.
Die drei Validierungsstufen, die in der Praxis relevant sind:
| Validierungsstufe | Prüfung | Was sie erkennt |
|---|---|---|
| Positionsebene | Menge × Einzelpreis = Positionssumme | Fehlgelesene Ziffern, vertauschte Menge/Preis, fehlende Positionssummen, die abgeleitet werden sollten |
| Rechnungsebene | Summe der Positionssummen + Steuer = Gesamtsumme | Fehlende Einzelposten, doppelte Extraktion, falsche Steuerklassifizierung, Rundungsabweichungen |
| Dokumentübergreifend | Bestellsumme − bereits fakturiert = Restbetrag | Erkennung doppelter Rechnungen, Überfakturierung, Fehler bei der Teil-Lieferungsverfolgung |
Nicht jedes Extraktionstool unterstützt berechnete Spalten und feldübergreifende Validierung nativ. Vorlagenbasierte Tools haben hier besonders Probleme – sie können extrahieren, was an einer Koordinate liegt, aber keine Arithmetik auf die Ergebnisse anwenden. Der Validierungsschritt fällt auf einen Menschen mit Taschenrechner oder einen separaten Excel-Abgleichprozess zurück. Wenn Sie mehr als 100 Rechnungen pro Monat verarbeiten, liegt der eigentliche Zeitaufwand in diesem manuellen Validierungsschritt, nicht in der anfänglichen Dateneingabe. Für eine tiefergehende Untersuchung der Extraktionsgenauigkeit und wie Sie sie auf Ihren Dokumenten messen können, deckt der praktische Genauigkeitsleitfaden die Methodik der Feldvalidierung ab.
Rechnungsvarianten nach Branche – Was jede Art unterscheidet
Eine Standard-Handelsrechnung – Lieferantenname, Datum, Einzelposten, Gesamtsumme – ist die Grundlage. Aber wenn Ihr Unternehmen Rechnungen verarbeitet, die von der kommerziellen Norm abweichen, hängt die Extraktionsgenauigkeit davon ab, ob das Tool versteht, womit es es zu tun hat. Drei Branchenvarianten zeigen, wie weit sich „Rechnung" vom Standardformat entfernen kann – und warum generische Extraktion daran oft scheitert.
Bauwesen – AIA G702/G703 Abschlagsrechnungen
Das AIA G702 Application and Certificate for Payment ist im traditionellen Sinne keine Rechnung. Es ist ein Abschlagsdokument, das die kumulative Arbeit über ein Bauprojekt hinweg verfolgt. Das Formular hat eine eigene Struktur, für die Standard-Extraktionstools nicht ausgelegt sind:
- Zeile 1: Ursprüngliche Vertragssumme – der gesamte Vertragswert bei Unterzeichnung. Dies ist eine feste Zahl, die durch jeden Abrechnungszyklus getragen wird, keine Gebühr pro Zeitraum.
- Zeile 2: Nettoänderungen durch Änderungsaufträge – kumulierte genehmigte Änderungen. Jeder unterzeichnete Änderungsauftrag verändert diese Zahl, was bedeutet, dass die G702 für Monat 4 andere Basiszahlen enthält als Monat 1.
- Zeile 3: Vertragssumme bis heute – Zeile 1 + Zeile 2. Das bewegliche Ziel, das definiert, was „100 % abgeschlossen" zu diesem Zeitpunkt im Projekt bedeutet.
- Zeile 4: Gesamtwert abgeschlossen und eingelagert bis heute – der Wert aller geleisteten Arbeiten plus der vor Ort eingelagerten Materialien. Dies ist die Schlüsselzahl, die durch das G703-Fortschreibungsblatt belegt werden muss.
- Zeile 5: Einbehalt – in der Regel 5–10 %, die bis zur Projektabnahme einbehalten werden, berechnet getrennt nach abgeschlossener Arbeit und eingelagerten Materialien.
- Zeile 6: Gesamtverdienst abzüglich Einbehalt – was der Auftragnehmer nach dem Einbehalt des Auftraggebers tatsächlich verdient hat.
- Zeile 7: Abzüglich früherer Zahlungsbescheinigungen – die Summe aller zuvor genehmigten Zahlungen. Für den ersten Zahlungsantrag ist dies null. Für spätere ist es die laufende Summe aus früheren Zyklen.
- Zeile 8: Aktuell fällige Zahlung – Zeile 6 minus Zeile 7. Der Betrag, der in diesem Abrechnungszeitraum angefordert wird.
- Zeile 9: Restbetrag bis zur Fertigstellung, einschließlich Einbehalt – was nach dieser Zahlung im Vertrag verbleibt.
Das G703-Fortschreibungsblatt liefert die detaillierte Einzelposten-Unterstützung für Zeile 4 der G702. Es unterteilt das Projekt in einzelne Leistungspositionen – jeweils mit ihrem geplanten Wert, der abgeschlossenen Arbeit aus dem vorherigen Antrag, der in diesem Zeitraum abgeschlossenen Arbeit, eingelagerten Materialien, dem Gesamtwert abgeschlossen und eingelagert bis heute, dem Prozentsatz der Fertigstellung und dem Restbetrag bis zur Fertigstellung. Die G703-Gesamtsumme muss exakt der G702-Zeile 4 entsprechen. Laut Rabbets Construction Payments Report 2024 erleben inzwischen 82 % der Auftragnehmer Zahlungsverzögerungen von über 30 Tagen, gegenüber 49 % vor nur zwei Jahren. Rechenfehler zwischen G702- und G703-Formularen gehören zu den häufigsten Ablehnungsgründen. Für eine gezielte Betrachtung der Bau-Rechnungsverarbeitung im Speziellen siehe was Bau-Rechnungsextraktion tatsächlich beinhaltet.
Medizin — CMS-1500 (HCFA-1500) Abrechnungsformulare
Das CMS-1500-Formular (in Abrechnungsabteilungen noch immer häufig HCFA-1500 genannt) ist das Standard-Abrechnungsformular, das von Ärzten und ambulanten Leistungserbringern zur Abrechnung mit Medicare, Medicaid und privaten Krankenversicherungen in den USA verwendet wird. Es enthält 33 nummerierte Felder – einige mit mehreren Unterfeldern – die Patientendaten, Versicherungsinformationen, Diagnosecodes (ICD-10), Prozedurencodes (CPT/HCPCS), Leistungsdaten, Gebühren und Leistungserbringer-Identifikatoren abdecken.
Was die CMS-1500-Extraktion besonders herausfordernd macht:
- Feld 24 ist eine mehrzeilige Tabelle innerhalb eines einzelnen Formularfelds. Jede Zeile enthält Leistungsdaten, Ort der Leistung, Prozedurencode, Diagnoseverweis, Gebühren, Einheiten und Leistungserbringer-ID. Ein einzelnes CMS-1500 kann bis zu 6 Leistungszeilen haben. Die Extraktion muss jede Zeile als eigenen Datensatz erkennen, während sie demselben Patienten und Anspruch zugeordnet bleibt.
- Diagnoseverweise bilden ein Querverweissystem. Feld 21 listet bis zu 12 ICD-10-Codes auf. Feld 24E enthält Zahlen (1, 2, 3 usw.), die auf bestimmte Diagnosen in Feld 21 verweisen. Die Extraktion muss diese Verweise auflösen – nicht nur die Zahlen erfassen – um einen vollständigen Abrechnungsdatensatz zu erstellen.
- NPI-Nummern erscheinen in mehreren Feldern. Die NPI des erbringenden Leistungserbringers (Feld 24J), die NPI des abrechnenden Leistungserbringers (Feld 33a) und die NPI des überweisenden Leistungserbringers (Feld 17b) sind unterschiedliche Entitäten. Eine Verwechslung führt zur Zuordnung des Anspruchs zum falschen Leistungserbringerdatensatz.
- Feldgenauigkeit ist entscheidend. Feld 32 (Standort der Leistungseinrichtung) ist erforderlich, wenn dieser vom abrechnenden Leistungserbringer abweicht. Feld 11 (Versicherungsnummer des Versicherten) muss exakt mit den Aufzeichnungen des Zahlers übereinstimmen. Ein falsch ausgefülltes Feld kann eine Anspruchsablehnung auslösen, deren Korrektur Wochen dauert.
Ein einzelnes CMS-1500 enthält über 30 verschiedene Datenelemente. Die manuelle Eingabe dauert 5-7 Minuten pro Formular, und die Fehlerrate bei der feldspezifischen Kodierung – insbesondere bei der Zuordnung von Diagnoseverweisen und der Platzierung von Modifikatoren – ist so hoch, dass die meisten Abrechnungsabteilungen Ansprüche vor dem Einreichen durch einen Prüflauf schicken. KI-Extraktion, die die Querverweisstruktur des Formulars versteht, kann dies auf Sekunden reduzieren und eine feldspezifische Genauigkeit erreichen, die mit einem geschulten Abrechner vergleichbar ist. Es ist jedoch zu beachten, dass zahlerspezifische Anforderungen (welche Felder für welche Versicherung obligatorisch sind) weiterhin menschliche Aufsicht erfordern.
Gastronomie & Lebensmittelservice — Rechnungen mit hohem Volumen und variablem Format
Rechnungen von Lebensmittellieferanten sehen anders aus als Handelsrechnungen. Eine Rechnung von Sysco oder US Foods erstreckt sich über mehrere Seiten mit 30–50 Positionen, jede mit einem Packungs-/Größenangabe („6/5 lb Sack“), Menge in Kartons, einer je nach Produkt variablen Maßeinheit (Karton für Trockenwaren, Pfund für Obst und Gemüse, Stück für Spezialartikel) und einem Stückpreis, der pro Karton, pro Pfund oder pro Stück angegeben sein kann. Handschriftliche Vermerke — Preisänderungen, Gutschriften, vom Fahrer notierte Ersatzvermerke — erscheinen auf derselben Seite wie die gedruckte Tabelle.
Was bei Gastronomierechnungen schiefgeht:
- Inkonsistente Maßeinheiten sind die Regel. Dieselbe Rechnung kann Obst und Gemüse pro Karton, Fleisch pro Pfund, Meeresfrüchte pro Stück und Reinigungsmittel pro Karton ausweisen – wobei die Spalte für die Maßeinheit manchmal vorhanden ist und manchmal aus der Packungs-/Größenbeschreibung hervorgeht. Eine Extraktion, die die Maßeinheit nicht als eigenes Feld behandelt, erzeugt Positionssummen, die nicht überprüfbar sind.
- Packungs-/Größenangabe ist ein zusammengesetztes Feld. „6/5 lb“ bedeutet sechs 5-Pfund-Einheiten pro Karton. Eine Position mit Menge 2 und Packungsangabe „6/5 lb“ bedeutet insgesamt 60 Pfund – nicht 2 Artikel. Ein Fehler hier führt zu einer Verzerrung der Lebensmittelkosten um ein Vielfaches, nicht nur um Prozente.
- Handschriftliche Anpassungen sind Standard. Ein vom Fahrer notierter „2 $ Rabatt auf Obst“ oder eine eingekreiste Ersatzlieferung mit handschriftlichem Preis ändert die effektive Positionssumme. Der gedruckte Wert ist falsch, der handschriftliche ist der richtige. Die Extraktion muss beide erfassen – oder zumindest die Abweichung kennzeichnen.
- Mehrseitige Positionstabellen. Eine 4-seitige Sysco-Rechnung kann den Kopf auf Seite 1 und Positionen über alle vier Seiten verteilt haben. Vorlagenbasierte Tools, die eine einseitige Tabelle erwarten, scheitern ab Seite 2. KI-Extraktion verarbeitet seitenübergreifende Tabellen, muss aber erkennen, dass Folgeseiten zur selben Rechnung gehören.
Eine Restaurantgruppe mit 10 Standorten arbeitet möglicherweise mit 50–100 Lebensmittel- und Getränkelieferanten, jeder mit einem anderen Rechnungsformat. Die Extraktion auf Kopfebene (Lieferantenname, Datum, Gesamtsumme) reicht für die Kreditorenbuchhaltung. Aber Lebensmittelkostenanalyse, Rezeptkalkulation, artikelgenaue Preisverfolgung und Soll-Ist-Abweichungen erfordern eine vollständige Positionsextraktion mit Normierung der Maßeinheiten. Die Extraktionsengine muss neue Lieferantenformate bereits beim ersten Beleg ohne Einrichtung verarbeiten – das bedeutet vorlagenfreie KI-Extraktion, nicht die Erstellung von Vorlagen pro Lieferant.
Stapelverarbeitung in großem Maßstab – Von einer Rechnung zu einer Tabelle
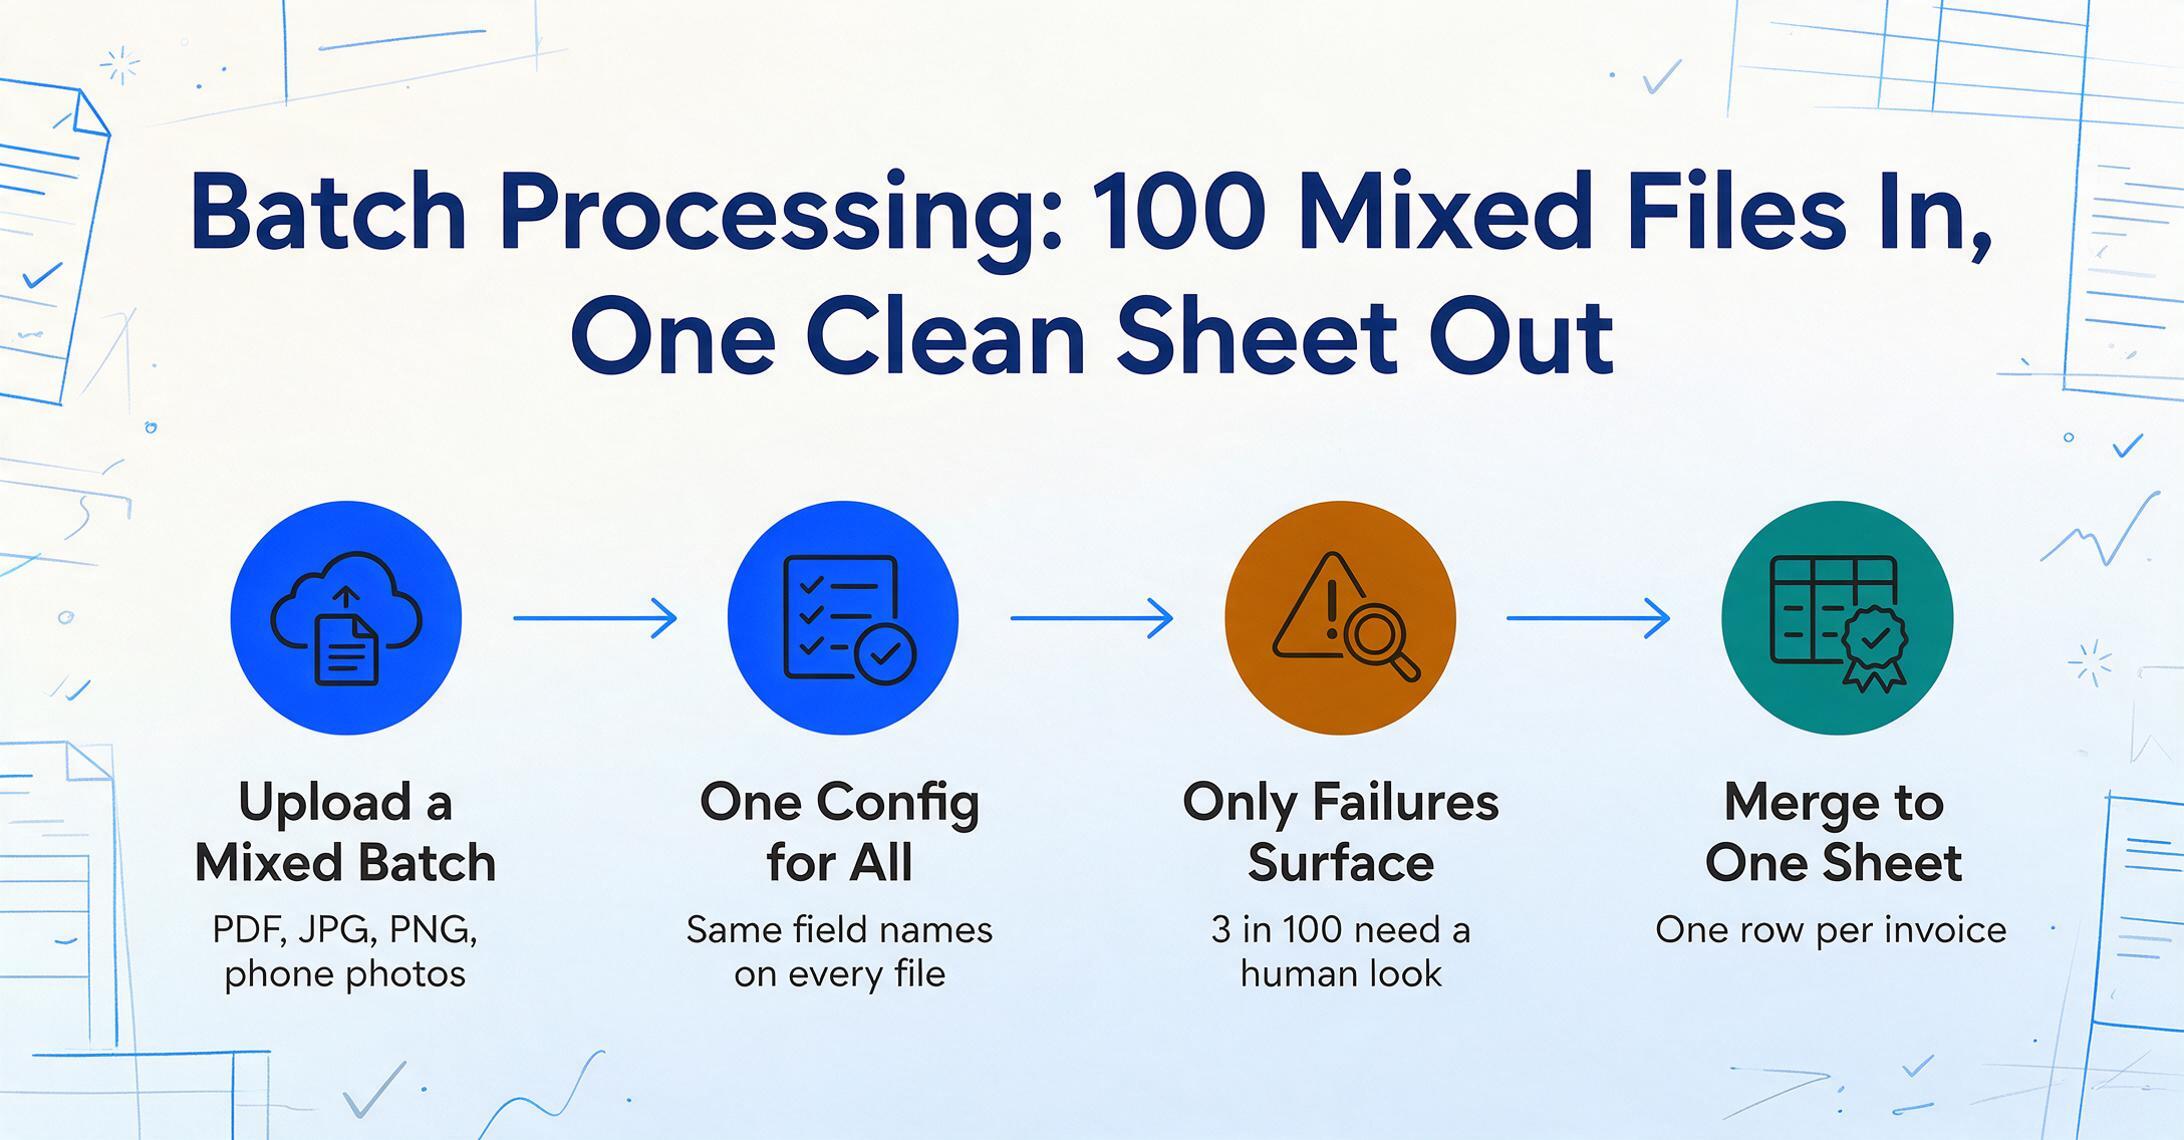
Eine Rechnung nach der anderen zu verarbeiten, zeigt Ihnen, wie das Tool funktioniert. Hundert Rechnungen auf einmal zu verarbeiten, zeigt Ihnen, ob das Tool wirklich funktioniert – denn das Volumen legt Designfehler offen, die Einzeldokument-Demos verbergen. Stapelverarbeitung ist der Unterschied zwischen Extraktion, die in einen Workflow passt, und Extraktion, die den Aufbau eines Workflows um sie herum erfordert.
Wie Stapelverarbeitung tatsächlich funktioniert
Stapelverarbeitung ist nicht einfach „dasselbe N-mal tun“. Es ist eine spezifische Pipeline: N Rechnungsdateien hochladen (die eine Mischung aus PDFs, JPGs, PNGs und Handyfotos sein können) → das Tool verarbeitet alle mit derselben Extraktionskonfiguration → die Ergebnisse werden in einer einzigen Ausgabedatei zusammengeführt, eine Zeile pro Rechnung (oder eine Zeile pro Einzelposten, je nach Ausgabemodus).
Was das schwieriger macht als die Einzeldokumentverarbeitung:
- Formatheterogenität. Ein Stapel von 50 Rechnungen kann 30 verschiedene Lieferantenformate enthalten. Vorlagenbasierte Extraktion scheitert hier, weil Sie 30 Vorlagen konfigurieren müssten, bevor Sie „Verarbeiten“ drücken. KI-Extraktion bewältigt das, weil dieselben Felddefinitionen über alle Formate hinweg funktionieren.
- Gemischte Dateitypen. Einige Rechnungen kommen als saubere PDFs. Andere als Fotos von Papier. Manche als mehrseitige Dokumente mit Bestellungen und Lieferscheinen. Der Stapelprozessor muss all das ohne manuelle Dateitypsortierung im Vorfeld bewältigen.
- Behandlung von Teilfehlern. In einem Stapel von 100 Rechnungen könnten 3 bei der Extraktion fehlschlagen (unlesbarer Scan, beschädigte Datei, Format, das die KI nicht parsen kann). Die Stapelausgabe sollte Ergebnisse für die 97 erfolgreichen sowie klare Fehlerindikatoren für die 3 fehlgeschlagenen enthalten – nicht eine einzige „Stapel fehlgeschlagen“-Meldung, die einen Neustart erfordert.
- Zeilen-zu-Quelle-Nachverfolgbarkeit. In einer zusammengeführten Tabelle mit 500 Zeilen aus 50 Rechnungen muss jede Zeile auf ihre Quelldatei verweisen. Ohne dies bedeutet das Finden des Originaldokuments für einen verdächtigen Wert, Zeilen manuell Dateien zuzuordnen – was den Zweck der Stapelverarbeitung zunichte macht.
Die Stapelpipeline interagiert auch mit berechneten Spalten und Validierung: Statt die Validierung eine Rechnung nach der anderen auszuführen, wendet ein Stapellauf dieselben Berechnungsregeln und feldübergreifenden Prüfungen auf den gesamten Stapel an. Eine einzelne Validierungsregel („Einzelpostensumme = Menge × Einzelpreis“) fängt Fehler über alle 50 Rechnungen gleichzeitig ab – was sich grundlegend vom Öffnen von 50 einzelnen Ergebnissen und dem Prüfen jeder einzelnen unterscheidet.
Was passiert, nachdem der Batch abgeschlossen ist
Das Batch-Ergebnis — eine einzelne Excel-Datei oder strukturiertes JSON — ist der Ausgangspunkt, nicht der Endpunkt. Es gibt drei Phasen nach dem Batch, die aus der rohen Extraktion gebuchte AP-Daten machen:
1. Ausnahmeprüfung. Zeilen markieren, bei denen die Validierung fehlgeschlagen ist (nicht übereinstimmende Positionssummen, fehlende Pflichtfelder, doppelte Rechnungsnummern). Diese gehen zur Klärung an einen Menschen. Der Rest — typischerweise 85-95 % des Batches — läuft ohne manuellen Eingriff durch. Das Ziel ist nicht null Ausnahmen; es geht darum, Ausnahmen leicht auffindbar zu machen, damit die Prüfung Minuten statt Stunden dauert.
2. Datentransformation. Die extrahierten Daten entsprechen selten exakt dem ERP-Importformat. Daten müssen möglicherweise neu formatiert werden (MM/DD/YYYY → YYYY-MM-DD). Lieferantennamen müssen möglicherweise normalisiert werden („Sysco Corp" → „SYSCO-01" im Lieferantenstamm). Währungsbeträge müssen möglicherweise umgerechnet werden. Wenn das Extraktionstool eine saubere, vorhersehbare Struktur exportiert (jede Spalte hat einen konsistenten Datentyp, keine verbundenen Zellen, keine Formatierungsartefakte), ist diese Transformation eine 5-minütige Tabellenkalkulationsoperation. Wenn die Ausgabe unübersichtlich ist, wird die Transformation zu einem separaten Datenbereinigungsprojekt.
3. ERP-Import. Die transformierte Datei wird über CSV-Import, API oder Tabellenkalkulationsintegration in das ERP eingespeist (wie im Abschnitt zu Integrationspfaden oben beschrieben). Die Batch-Größe bestimmt, welche Methode sinnvoll ist: CSV-Import für unter 200 Rechnungen pro Monat, API für 200-1.000, vollständige AP-Automatisierungsplattform-Integration über 1.000.
Eine Schritt-für-Schritt-Anleitung zum vollständigen Batch-Workflow — vom Upload bis zum zusammengeführten Excel — finden Sie unter So extrahieren Sie Rechnungsdaten per Batch in eine Excel-Datei. Das Skalierungsframework, das das Volumen mit dem richtigen Verarbeitungsansatz abgleicht, finden Sie unter Skalierung der Rechnungsverarbeitung ohne zusätzliches Personal.