Le guide complet de l'extraction de données de factures
(2026)
L'extraction de données de factures consiste à transformer les informations contenues dans les factures — noms de fournisseurs, montants, lignes de facture, dates, identifiants fiscaux — en lignes et colonnes structurées que vous pouvez trier, filtrer, importer et analyser. Cela semble simple. Ça ne l'est pas. Il existe trois méthodes fondamentalement différentes pour y parvenir, chacune avec son propre coût de mise en place, son plafond de précision et sa limite d'évolutivité. Ce guide complet de l'extraction de données de factures couvre les trois méthodes, explique quels champs vous devez réellement extraire, et vous propose un cadre de décision pour choisir la bonne approche en fonction de votre volume de factures, de la complexité des formats et de la destination finale des données.
Qu'est-ce que l'extraction de données de factures — et pourquoi la plupart des équipes le font encore à la main
L'extraction de données de factures est le processus qui consiste à capturer les informations des documents de facturation — PDF, images scannées, photos — et à les convertir en formats de données structurés comme Excel, CSV ou JSON. Les informations extraites comprennent généralement l'en-tête de la facture (numéro, dates, fournisseur, totaux) et les lignes de facture (quantités, descriptions, prix unitaires, totaux de ligne). Le résultat est un tableau où chaque ligne correspond à une facture ou à une ligne de facture, et chaque colonne à un champ de données.
Pourquoi c'est important : 68 % des entreprises saisissent encore manuellement les données de factures dans leur ERP ou leurs systèmes comptables, selon les données sectorielles de HighRadius's 2025 AP automation statistics. La saisie manuelle coûte environ 15 $ par facture en main-d'œuvre, prend 3 à 5 minutes par document et génère un taux d'erreur constant de 2 à 5 %. À 500 factures par mois, cela représente 7 500 $ en main-d'œuvre et 10 à 25 erreurs tous les 30 jours — des erreurs qui se répercutent sur des paiements incorrects, des écritures de codification comptable erronées et un travail de rapprochement qui coûte plus cher que la saisie initiale.
L'alternative — l'extraction automatisée — est possible depuis des années. Mais la technologie a tellement évolué que ce qui était à la pointe il y a trois ans (OCR par modèle) est désormais l'approche héritée, et ce qui est à la pointe aujourd'hui (extraction sémantique par IA) fonctionne sur des types de documents et des formats que la génération précédente ne pouvait pas traiter. Comprendre les trois méthodes — ce qu'elles sont, ce qu'elles coûtent et où elles échouent — fait la différence entre choisir un outil qui fonctionne et passer six mois sur une implémentation ratée. Pour en savoir plus sur les raisons pour lesquelles la saisie manuelle persiste malgré l'automatisation disponible, voir pourquoi les équipes AP saisissent encore les données de factures à la main.
Les trois méthodes — Saisie manuelle, OCR par modèle et extraction par IA
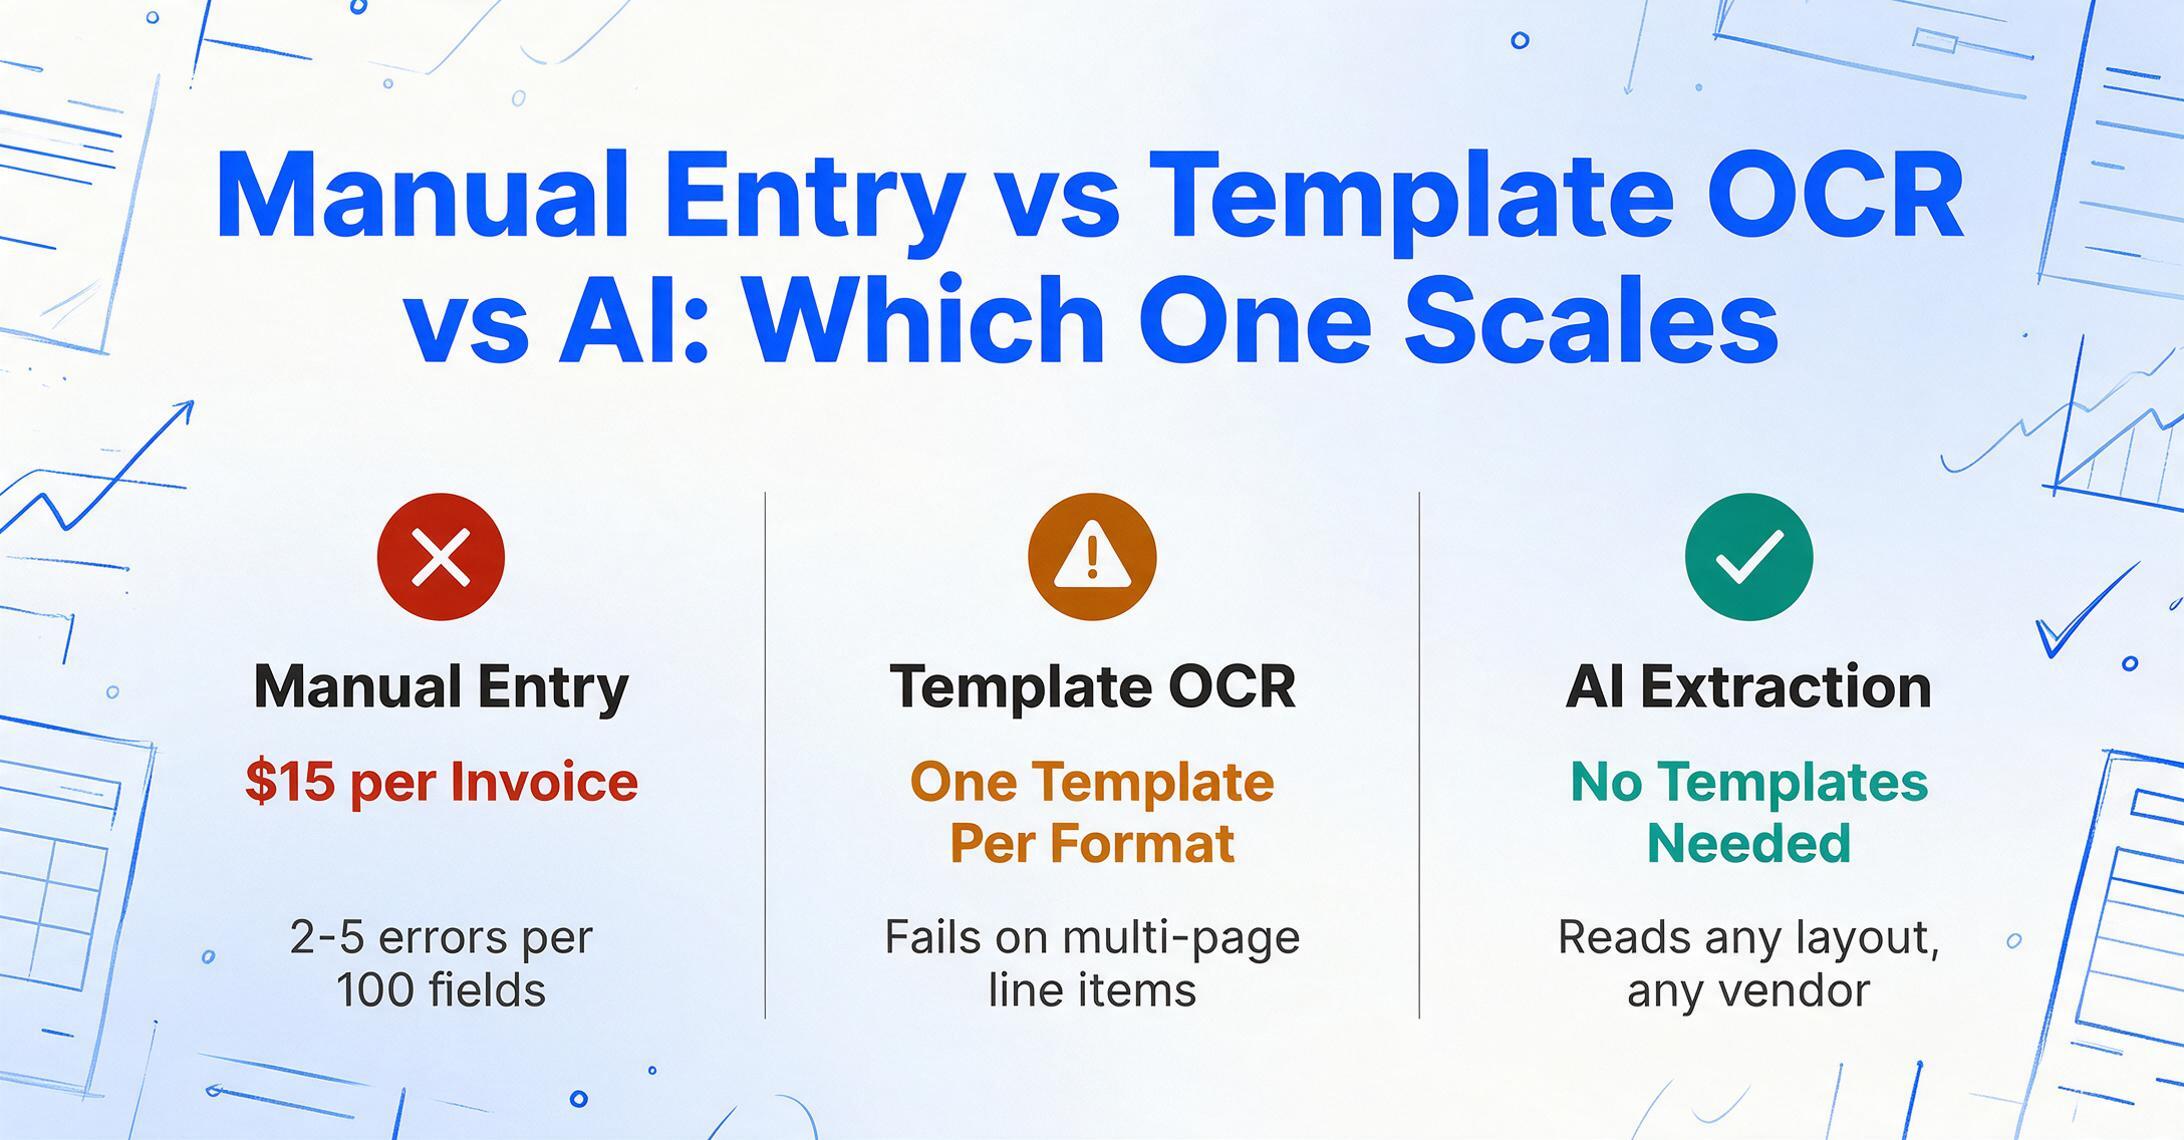
Chaque approche d'extraction de factures se range dans l'une de trois catégories. Elles ne se valent pas — chacune a un plafond de précision, un coût de mise en place et une limite de passage à l'échelle différents. Le bon choix dépend de votre volume et de la diversité de vos formats de factures, pas de la méthode qui semble la plus avancée. Pour un aperçu pratique de l'extraction sans modèle en action, essayez le flux de traitement de factures avec extraction de noms de colonnes.
Méthode 1 : Saisie manuelle
Ce que c'est : Une personne ouvre chaque PDF de facture, lit les champs et les saisit dans un tableur ou un ERP. Aucune technologie au-delà d'un lecteur PDF et d'Excel.
Coût : Environ 15 $ par facture en coût de main-d'œuvre complet, selon les références 2025 de Quadient sur l'automatisation de la comptabilité fournisseurs. À 100 factures par mois : 1 500 $/mois. À 1 000 factures : 15 000 $/mois — soit environ un employé de comptabilité fournisseurs à temps plein entièrement dédié à la saisie de données.
Précision : 95-98 % par champ pour des opérateurs attentifs — soit 2 à 5 erreurs pour 100 champs. Ce sont des erreurs de transcription : chiffres inversés, écriture manuscrite mal lue, erreur de position de la virgule décimale. À noter : un humain qui transpose un nombre crée une valeur erronée qui semble correcte dans le système. Une IA qui manque un champ crée un vide — ce qui est plus sûr car visible.
Quand c'est pertinent : En dessous de 50 factures par mois, ou lorsque chaque facture provient d'un fournisseur différent avec un format unique et que le coût de mise en place d'un système automatisé dépasse le coût de la main-d'œuvre. Aussi : lorsque la personne qui saisit les données a une connaissance approfondie de la relation fournisseur et des règles de codification qu'aucun système automatisé ne peut reproduire sans des mois de formation.
Quand ça ne fonctionne plus : Au-delà de 200 factures par mois, le taux d'erreur augmente plus vite que le débit. La même personne précise à 50 factures commence à faire des erreurs à 200 parce que la fatigue cognitive s'installe après la première heure de transcription répétitive. Pour en savoir plus sur les erreurs spécifiques et leur coût, consultez les six erreurs de saisie de factures les plus coûteuses.
Méthode 2 : OCR par modèle
Ce que c'est : Le logiciel de reconnaissance optique de caractères lit le texte d'une image de facture, et un modèle indique où se trouve chaque champ (« le numéro de facture est aux coordonnées x:420, y:180 »). Vous créez un modèle par format de fournisseur. Le moteur OCR lit les caractères ; le modèle les associe aux champs.
Coût : Les logiciels OCR vont du gratuit (Tesseract) à 0,01-0,05 $ par page (API cloud comme AWS Textract, Google Document AI) et de 30 à 300 $/mois pour les outils packagés. Le coût caché est la maintenance des modèles — chaque nouveau format de fournisseur exige un nouveau modèle, et chaque changement de mise en page chez un fournisseur casse le modèle existant. Les organisations avec 100+ fournisseurs et un OCR par modèle consacrent généralement 5 à 10 heures par mois à la maintenance des modèles.
Précision : 95-99 % sur du texte imprimé à la position exacte attendue par le modèle. Elle tombe sous 70 % sur le contenu manuscrit, les tampons, les annotations ou toute variation de mise en page, selon l'analyse de PDFExcel sur la précision de l'OCR pour les factures non standard. La précision au niveau de la page peut être de 99 % tandis que la précision au niveau des champs est de 70 % si les erreurs d'OCR se concentrent sur les champs financièrement significatifs.
Quand c'est pertinent : Lorsque vous traitez de gros volumes de factures provenant d'un petit ensemble stable de fournisseurs aux formats cohérents — par exemple, un fabricant qui reçoit des factures hebdomadaires des mêmes 15 fournisseurs de matières premières. Créez 15 modèles une fois, maintenez-les trimestriellement, traitez des milliers de factures.
Quand ça casse : Lorsque votre nombre de fournisseurs est important ou change. Lorsque les fournisseurs changent de logiciel comptable et que la mise en page de leurs factures évolue. Lorsque les factures incluent des notes manuscrites, du contenu multilingue, des tampons ou des tableaux irréguliers. L'OCR par modèle est fiable pour les formats connus et fragile pour les formats inconnus — et en comptabilité fournisseurs, les formats inconnus sont la norme, pas l'exception. Comme le documente l'analyse de LlamaIndex sur la variabilité réelle des factures, il n'existe pas de facture standard.
Méthode 3 : Extraction sémantique par IA
Ce que c'est : Un modèle vision-langage lit la facture comme un humain — il voit la mise en page, comprend quelles étiquettes correspondent à quelles valeurs, et extrait les champs en fonction du sens sémantique plutôt que de positions fixes. Vous spécifiez ce que vous voulez par nom de champ (« Numéro de facture », « Montant total », « Nom du fournisseur »), pas par coordonnées. L'IA localise chaque champ n'importe où sur la page en comprenant ce que c'est, pas où il se trouve.
Coût : Généralement 0,05 à 0,30 $ par page pour les services basés sur API, ou 20 à 50 $/mois pour les outils packagés incluant une interface web et un traitement par lots. Aucun coût de maintenance de modèle — la même configuration fonctionne pour tout format de fournisseur.
Précision : 97 à 99 % de précision au niveau des champs sur les factures imprimées propres, 88 à 95 % sur les factures avec annotations manuscrites, 75 à 90 % sur les documents entièrement manuscrits. La variation dépend davantage de la qualité du document (résolution de numérisation, couleur vs N&B, redressement) que de l'outil lui-même. Pour une analyse détaillée de la précision par type de facture et comment la mesurer sur vos propres documents, consultez le guide pratique sur la précision de l'extraction par IA.
Quand c'est pertinent : Lorsque vous traitez plus de 100 factures par mois provenant de plusieurs fournisseurs avec des formats variés. Lorsque vos factures incluent des annotations manuscrites, des documents multilingues ou des mises en page irrégulières. Lorsque vous devez extraire des lignes de facture avec quantités et prix unitaires — l'OCR par modèle peine avec les tableaux qui s'étendent sur plusieurs pages ou ont des nombres de colonnes variables.
Quand ça échoue : Lorsque les factures sont fortement dégradées — photocopies de quatrième génération, images fax à 72 DPI, photos prises en angle avec un mauvais éclairage. Aucune méthode d'extraction ne gère bien ces cas, mais l'IA se dégrade plus gracieusement que l'OCR car elle peut deviner à partir du contexte là où l'OCR ne renvoie que du bruit. Aussi : lorsque la facture contient des champs nécessitant des connaissances externes que l'IA ne possède pas (par exemple, à quel centre de coûts une ligne de facture spécifique doit être codée — c'est une décision de codification comptable distincte, pas un problème d'extraction).
Pour une comparaison côte à côte des outils spécifiques dans la catégorie de l'extraction par IA — notamment lesquels fonctionnent sans support informatique, gèrent les lignes de facture et prennent en charge le traitement par lots — consultez notre comparaison des outils d'extraction de factures par IA pour les équipes financières.
Les champs dont vous avez réellement besoin — En-tête, lignes de facture, champs calculés et conformité
Tous les champs d'une facture ne doivent pas nécessairement être extraits. Comprendre quelles catégories de données comptent pour votre flux de travail permet d'éviter la sur-spécification (qui ralentit l'extraction et augmente la marge d'erreur) et la sous-spécification (qui impose une ré-extraction ultérieure).
Champs d'en-tête — à extraire systématiquement. Ils identifient la transaction et apparaissent une seule fois par facture : N° de facture, Date de facture, Date d'échéance, Nom du fournisseur, Montant total, Montant de la taxe, Devise et N° de commande. C'est l'ensemble d'extraction minimal viable. Chaque flux de travail de facturation en a besoin pour le traitement des paiements et l'importation ERP. Des champs d'en-tête manquants ou erronés provoquent les erreurs les plus coûteuses, car ils orientent la facture vers le mauvais circuit d'approbation, le mauvais montant de paiement ou la mauvaise période comptable.
Lignes de facture — à extraire lorsque vous avez besoin d'une répartition des coûts. Chaque ligne de facture correspond à une ligne du tableau : Description, Quantité, Prix unitaire, Total de la ligne, et éventuellement SKU, Taux de taxe ou Code comptable. L'extraction des lignes de facture est nécessaire lorsque vous devez répartir une facture entre plusieurs centres de coûts (la ligne 1 va au département A, la ligne 2 au département B), suivre les dépenses par catégorie de produit ou vérifier que les prix unitaires correspondent au contrat. L'extraction des lignes de facture est techniquement plus difficile que celle des champs d'en-tête, car les tableaux ont des colonnes variables, s'étendent sur plusieurs pages et utilisent une mise en forme incohérente — le tableau de la page 1 peut avoir 5 colonnes et celui de la page 2 en avoir 6. L'OCR par modèle échoue fréquemment sur les lignes de facture. L'extraction par IA les gère parce qu'elle lit la structure du tableau de manière sémantique, et non géométrique.
Champs calculés — à extraire lorsque le document n'affiche pas le nombre dont vous avez besoin. Certaines valeurs dont vous avez besoin ne figurent pas sur la facture. Un sous-total hors taxes lorsque la facture n'affiche que le total TTC. Un total de ligne lorsque seuls la quantité et le prix unitaire sont indiqués. La différence entre le montant facturé et le tarif contractuel. Le calcul par nom de colonne — où vous intégrez une logique de calcul dans le nom du champ, comme « Sous-total (Total − Montant de la taxe) » ou « Total de la ligne (Quantité × Prix unitaire) » — indique à l'IA de calculer la valeur manquante à partir des champs qu'elle peut lire. Cela transforme l'extraction (trouver ce qui existe) en dérivation (calculer ce dont vous avez besoin à partir de ce qui existe).
Champs de conformité — à extraire lorsque la réglementation l'exige. Ils varient selon le pays : N° de TVA pour les factures de l'UE, ABN pour les factures australiennes, GSTIN pour les factures indiennes, Identifiant fiscal du fournisseur pour les déclarations 1099 aux États-Unis. Des champs de conformité manquants ou erronés ne bloquent pas le paiement, mais entraînent des problèmes de déclaration fiscale en aval — un 1099 déclaré avec un mauvais TIN génère un avis de l'IRS, une déclaration de TVA sans numéro d'enregistrement du fournisseur déclenche une demande de vérification. Ces champs doivent faire partie de chaque configuration d'extraction lorsqu'ils s'appliquent, et non être ajoutés après coup pendant la saison fiscale.
Quelle méthode correspond à votre situation — Un cadre de décision
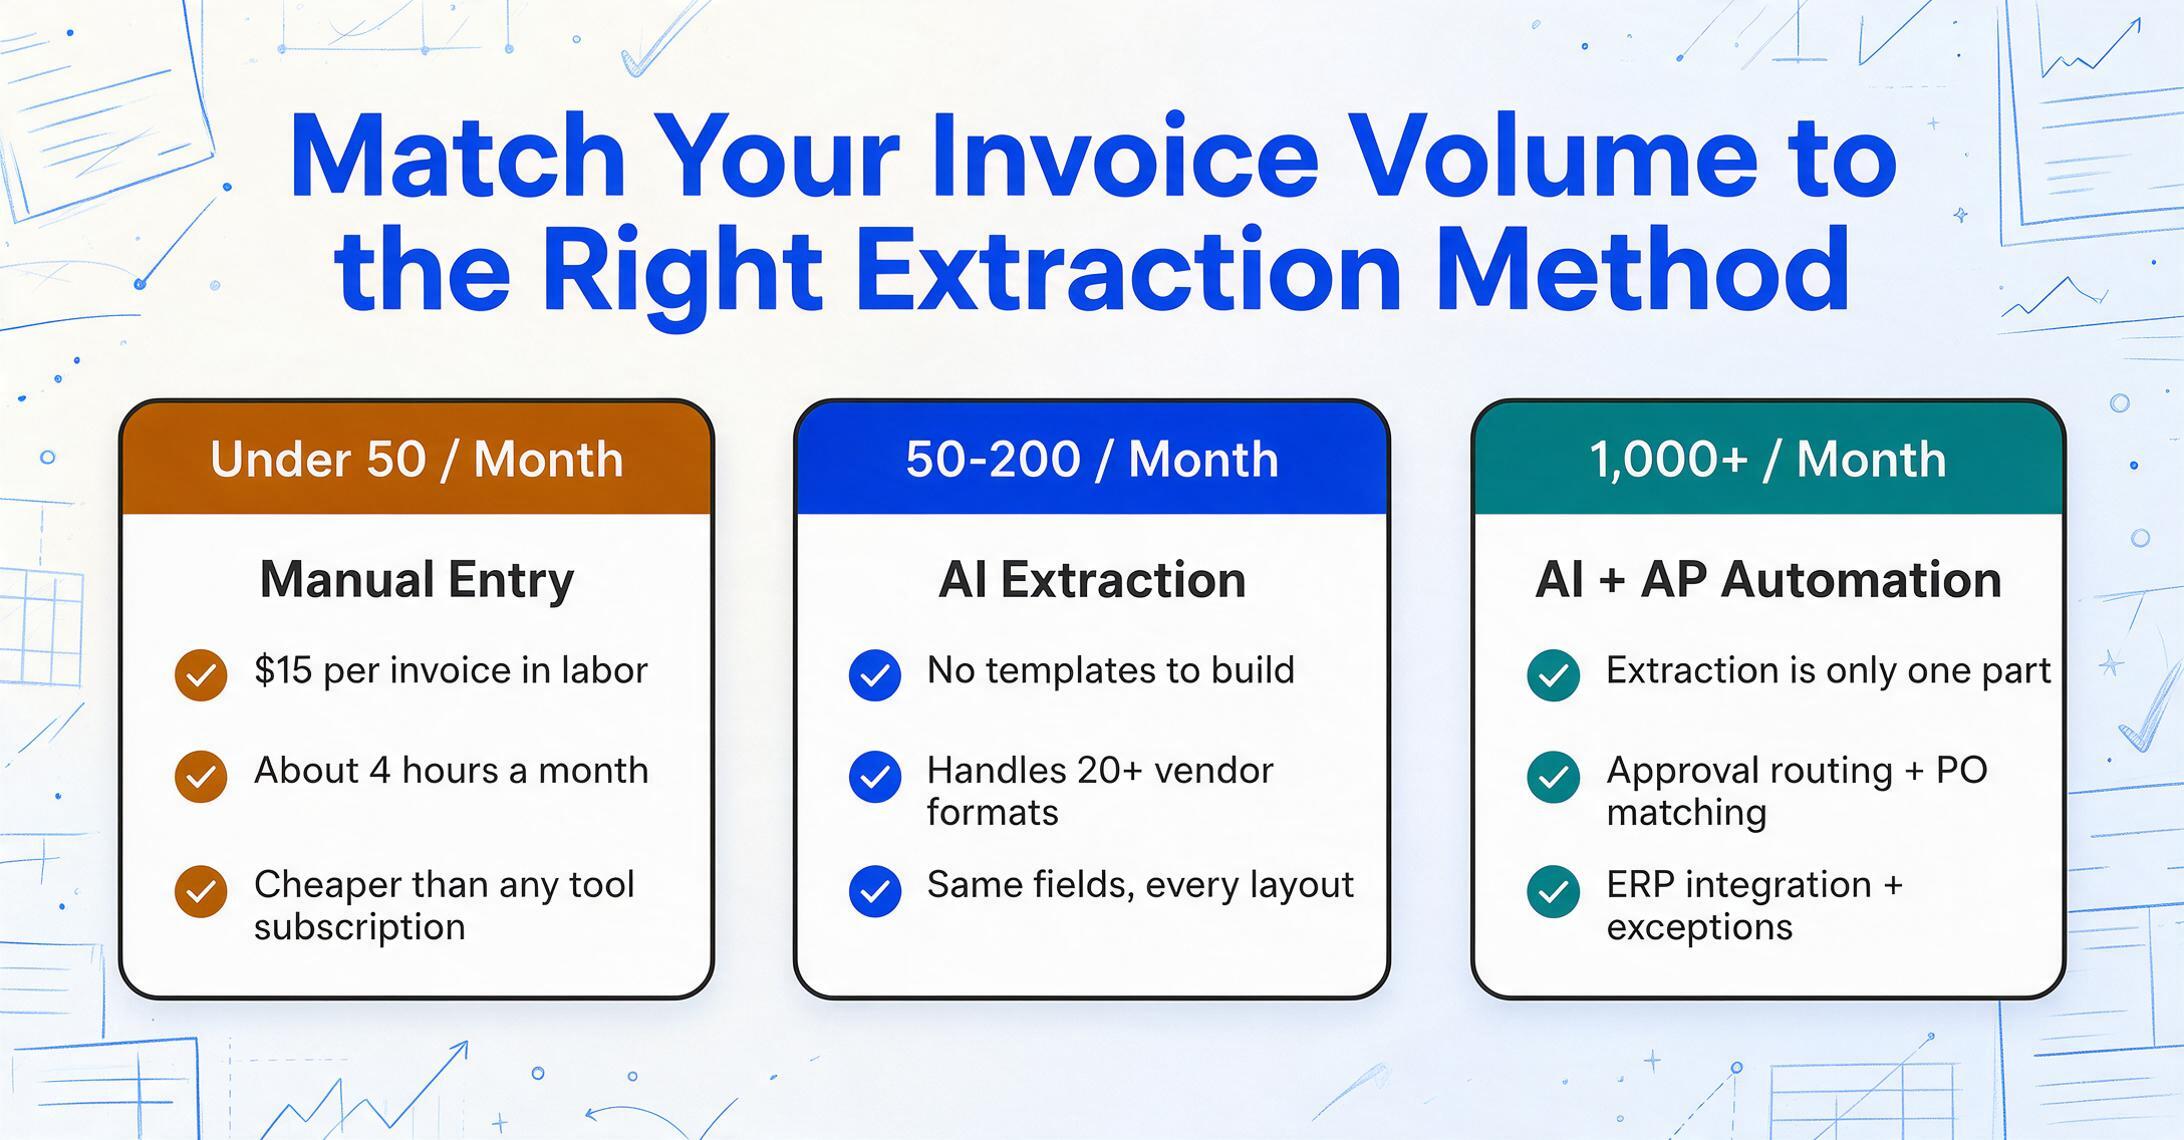
La bonne méthode d'extraction n'est pas la plus avancée. C'est celle dont le coût et la complexité correspondent à votre volume et à votre mix de formats. Voici la logique de décision, organisée selon les facteurs qui déterminent réellement le succès ou l'échec :
| Votre situation | Meilleure méthode | Pourquoi |
|---|---|---|
| < 50 factures/mois, formats variés | Saisie manuelle | Le coût de mise en place de tout système automatisé dépasse le coût de la main-d'œuvre à ce volume. Une seule personne traitant 50 factures (~4 heures/mois) coûte moins cher que n'importe quel abonnement à un outil, plus le temps d'apprentissage. |
| 50–200/mois, formats variés | Extraction par IA | Le temps de configuration d'un OCR par modèle sur plus de 20 formats de fournisseurs coûte plus cher qu'un abonnement à un outil d'IA. L'IA gère la variabilité des formats sans maintenance de modèles. |
| 200–1 000/mois, < 20 formats de fournisseurs stables | OCR par modèle ou IA | Si votre liste de fournisseurs est stable et que les formats sont cohérents, l'OCR par modèle offre une grande précision à un coût par page inférieur. Si les formats varient, l'IA évite la surcharge de maintenance des modèles. |
| 200–1 000/mois, 50+ formats de fournisseurs | Extraction par IA | Gérer plus de 50 modèles est un travail à temps partiel. L'IA gère la diversité des formats sans configuration par fournisseur. Voir le cadre de passage à l'échelle pour la logique de décision basée sur le volume. |
| 1 000+/mois, tout mix de formats | Extraction par IA + automatisation de la comptabilité fournisseurs | À ce volume, l'extraction n'est qu'une partie du flux de travail. Vous avez aussi besoin d'un routage d'approbation automatisé, d'un rapprochement des bons de commande, d'une intégration ERP et d'une gestion des exceptions. Les outils d'extraction par IA autonomes gèrent la capture des données. Les plateformes complètes d'automatisation de la comptabilité fournisseurs (Tipalti, Stampli, Rossum) gèrent l'ensemble du cycle de vie des factures. |
| Factures manuscrites, tout volume | IA (basée sur VLM) | L'OCR par modèle tombe sous 70 % sur l'écriture manuscrite. Les VLM lisent l'écriture manuscrite en comprenant les formes des lettres dans leur contexte sémantique. Des scans haute résolution (400-600 DPI, couleur) sont essentiels. |
| Factures multilingues et transfrontalières | IA (basée sur VLM) | Les modèles vision-langage lisent sémantiquement à travers les langues. L'OCR par modèle entraîné sur l'anglais a du mal avec les libellés japonais, les formats de date français et les conventions décimales européennes. |
Le seuil le plus important se situe entre 50 et 200 factures. En dessous de 50, la saisie manuelle est réellement moins chère et plus simple que toute automatisation. Au-delà de 200, la saisie manuelle coûte plus cher que l'extraction par IA en main-d'œuvre directe uniquement — avant même de compter le coût de correction des erreurs. La zone intermédiaire (50-200) est celle où la décision dépend de votre combinaison de formats spécifique et de la disponibilité d'une personne capable de consacrer un après-midi à configurer et à apprendre à utiliser un outil d'extraction.
Les fichiers sont traités en toute sécurité et ne sont pas stockés.
Ce qui se passe après l'extraction — du tableur à l'ERP
L'extraction permet de sortir les données du document. Les intégrer dans votre système comptable est une étape distincte — et c'est là que de nombreuses implémentations d'extraction échouent, car l'équipe se rend compte que les données sont structurées mais que la connexion à l'ERP n'existe pas. Il existe quatre voies d'intégration, classées de la plus simple à la plus automatisée :
Voie 1 : Téléchargement et importation. L'outil d'extraction génère un fichier Excel ou CSV. Vous téléchargez le fichier, le vérifiez, puis l'importez dans votre ERP à l'aide de la fonction d'importation native de l'ERP. Cela fonctionne avec tous les ERP — SAP, Oracle, NetSuite, QuickBooks, Xero, Sage, Microsoft Dynamics — car l'importation CSV est universelle. Aucune implication informatique n'est requise. Le coût réside dans l'étape manuelle de téléchargement et d'importation, qui prend 2 à 5 minutes par lot, quel que soit le nombre de factures dans le lot. C'est la bonne voie pour la plupart des équipes traitant moins de 1 000 factures par mois.
Voie 2 : Intégration directe au tableur. L'outil d'extraction écrit les données directement dans Google Sheets ou Excel Online via API. Le tableur devient l'intermédiaire entre l'extraction et l'ERP — l'outil ajoute des lignes à une feuille, et une intégration distincte (Zapier, Make ou un connecteur ERP intégré) lit la feuille pour alimenter l'ERP. Cela élimine l'étape de téléchargement et rend les données disponibles pour examen dans un format que l'équipe financière utilise déjà. Pour les utilisateurs de Google Sheets spécifiquement, certains outils d'extraction proposent des extensions latérales qui permettent de téléverser des factures et d'obtenir les données extraites sans quitter le tableur.
Voie 3 : Intégration API. L'outil d'extraction envoie les données extraites directement à l'ERP via API. Cela nécessite que l'outil d'extraction et l'ERP disposent d'API compatibles et que quelqu'un (généralement l'informatique ou un consultant en intégration) configure la connexion. Une fois configurée, la séquence extraction → validation → importation ERP s'exécute avec une intervention humaine minimale. Les factures qui réussissent la validation sont automatiquement comptabilisées. Celles qui échouent sont signalées pour examen. Cette voie est appropriée au-delà de 1 000 factures par mois ou lorsque l'étape d'importation manuelle constitue le goulot d'étranglement du flux de travail.
Voie 4 : Liens de collecte pour les documents entrants. Un lien de collecte est une URL partageable qui permet aux fournisseurs, clients ou membres de l'équipe de téléverser des factures directement dans votre file d'extraction — sans inscription, sans connexion, sans échange d'e-mails. La personne ouvre le lien, saisit un court code de vérification et téléverse son fichier. Il atterrit dans votre pipeline de traitement. Cela transforme l'extraction de « je rassemble les documents, puis j'extrais » en « les documents arrivent pré-rassemblés dans la file d'extraction ». Pour les scénarios de préparation d'audit où vous devez collecter des factures auprès de multiples sources sous pression de temps, consultez le guide de préparation à la saison d'audit.
L'autre canal entrant est l'e-mail. Un lien de collecte couvre les documents que vous devez relancer ; la plupart des factures arrivent d'elles-mêmes, en pièces jointes. Une adresse de boîte de réception dédiée transforme ce flux en la même file : vous partagez une adresse avec les fournisseurs ou clients, et chaque pièce jointe atterrit automatiquement dans votre file de traitement. Avec le traitement automatique activé et les champs souhaités liés à la boîte de réception, l'extraction démarre dès l'arrivée du courrier, une liste blanche d'expéditeurs exclut les courriers non pertinents, et les mots de passe enregistrés permettent de déverrouiller les PDF protégés sans que personne ne saisisse le mot de passe. Le résultat correspond au lien de collecte : les documents arrivent pré-rassemblés, et personne ne transfère ni ne téléverse de fichiers manuellement.
Aller plus loin — Sujets clés pour des besoins spécifiques
L'extraction de données de factures recoupe plusieurs flux de travail spécialisés. Les articles ci-dessous approfondissent chaque domaine :
| Qu'est-ce que l'extraction de données de factures ? Comment ça fonctionne et pourquoi c'est important | La définition de base — si vous découvrez le concept, commencez ici avant d'aborder les méthodes et les outils. |
| Pourquoi les équipes AP saisissent encore les factures à la main | Les raisons structurelles pour lesquelles la saisie manuelle persiste malgré des décennies d'automatisation — et pourquoi « un meilleur ERP » n'était pas la réponse. |
| Outils d'extraction par IA comparés pour les équipes financières | Comparaison côte à côte par approche technique — quels outils fonctionnent sans support informatique, gèrent les lignes de facture et prennent en charge le traitement par lots. |
| Passer à l'échelle du traitement des factures sans embaucher | Cadre de décision pour savoir quand optimiser le processus, quand automatiser et quand embaucher — selon le point d'inflexion du volume. |
| Les 6 erreurs de saisie de factures les plus coûteuses | Les erreurs visibles (inversions, doublons) et les invisibles (codification comptable, classification fiscale) — avec le coût par erreur détaillé. |
| Guide pratique de précision pour l'extraction de factures par IA | Pourquoi « 99 % de précision » est un chiffre marketing, ce que signifie réellement la précision au niveau des champs, et comment mener votre propre test de précision en un après-midi. |
| Saison d'audit : préparer les données de factures quand le temps manque | Système de triage d'urgence pour numériser les données de factures lorsque les auditeurs arrivent dans quelques semaines — quoi prioriser, quoi laisser de côté. |
Extraction avancée de champs : colonnes calculées et validation inter-champs
Le niveau suivant au-delà de l'extraction de ce qui est imprimé sur une facture, c'est l'extraction de ce dont vous avez réellement besoin — ce qui n'est pas toujours la même chose. Une facture peut afficher un sous-total de 1 247,83 $ sans détailler la taxe, mais vous avez besoin du montant hors taxe pour la codification comptable. Elle peut lister 15 lignes de facture avec quantités et prix unitaires, mais sans totaux par ligne. Elle peut afficher un total général qui ne correspond pas à la somme des lignes de facture — et vous devez savoir quel chiffre est erroné avant de valider le paiement.
Ce ne sont pas des cas limites. Ce sont des problèmes quotidiens de traitement de factures qui transforment l'extraction d'une simple lecture en un flux de travail de vérification et de calcul en plusieurs étapes. Les outils qui gèrent bien cela se distinguent de ceux qui se contentent de lire le texte.
Colonnes calculées — des résultats calculés, pas seulement des valeurs extraites
Une colonne calculée est un champ que vous définissez et qui ne se contente pas de localiser une valeur sur le document. Elle prend une ou plusieurs valeurs extraites, effectue un calcul sur celles-ci, puis génère le résultat comme colonne propre dans le tableur. L'exemple le plus simple et le plus courant : Total de ligne = Quantité × Prix unitaire. De nombreuses factures impriment le total de ligne avec la quantité et le prix unitaire — mais quand ce n'est pas le cas (ou quand le total imprimé est erroné), une colonne calculée comble l'écart en multipliant ce qui a été extrait.
Cette capacité va bien au-delà de l'arithmétique de base. Le même mécanisme gère :
- Sous-total manquant : La facture n'affiche que le total TTC. Une colonne calculée dérive
Sous-total = Total − Montant de la taxe, vous donnant le montant hors taxes pour la codification comptable sans étape de calcul séparée. - Validation au niveau des lignes : Extrayez la quantité et le prix unitaire séparément, puis calculez
Total de ligne attendu = Quantité × Prix unitaire. Comparez avec le total de ligne imprimé. Une colonne d'écart signale les divergences avant qu'elles n'atteignent l'ERP. - Rapprochement au niveau de la facture : Additionnez tous les totaux de ligne calculés et comparez avec le sous-total imprimé. Si la différence est non nulle, quelque chose cloche — soit les lignes de facture ont été mal lues, soit le sous-total d'en-tête a été mal imprimé. Dans les deux cas, vous le détectez avant le paiement.
- Logique conditionnelle :
Indicateur de remise = SI(Total de ligne > 500 $, « À examiner », « OK »)— appliquez des règles métier pendant l'extraction pour que la sortie segmente déjà ce qui nécessite une attention de ce qui peut être validé automatiquement. - Recherche de taux : Intégrez un taux de taxe fixe (par exemple 8,875 % pour New York) dans la règle de calcul. L'IA l'applique à chaque ligne sans que le taux n'apparaisse nulle part sur le document.
Le changement architectural est ici significatif : l'extraction cesse d'être purement une lecture de ce qui existe et devient une opération combinée de lecture et de dérivation. Au lieu d'extraire des données brutes puis d'ouvrir Excel pour calculer, pivoter et valider, vous obtenez des résultats calculés dans le même tableau issu de l'extraction — une seule étape au lieu de trois. Pour une présentation détaillée du mécanisme complet des colonnes calculées, voir comment fonctionne l'extraction des lignes de facture avec totaux calculés.
Validation inter-champs — détecter les erreurs sans relecture manuelle
La validation inter-champs est la vérification mathématique que les valeurs extraites sont cohérentes entre elles. Elle répond à la question : « Si j'additionne les lignes de facture, est-ce que j'obtiens le sous-total ? Si j'applique le taux de taxe, est-ce que j'obtiens le montant de la taxe ? Si j'ajoute la taxe au sous-total, est-ce que j'obtiens le total général ? »
Ces vérifications sont déterministes — elles réussissent ou échouent. Aucun jugement requis. Et elles détectent la classe d'erreurs d'extraction la plus dangereuse : les valeurs qui semblent correctes isolément mais ne fonctionnent pas ensemble. Un chiffre transposé dans un total de ligne (était $1 247, extrait comme $1 274) pourrait passer une correspondance à trois voies. Mais Σ(Quantité × Prix unitaire) ≠ Sous-total le détecte instantanément.
Les trois niveaux de validation qui comptent en pratique :
| Niveau de validation | Vérification | Ce que cela détecte |
|---|---|---|
| Niveau ligne | Quantité × Prix unitaire = Total de ligne | Chiffres mal lus, Quantité/Prix inversés, totaux de ligne manquants qui devraient être dérivés |
| Niveau facture | Somme des totaux de ligne + taxe = Total général | Lignes de facture manquantes, extraction en double, mauvaise classification de la taxe, dérive d'arrondi |
| Inter-documents | Total de la commande − déjà facturé = solde restant | Détection de factures en double, surfacturation, erreurs de suivi des expéditions partielles |
Tous les outils d'extraction ne prennent pas en charge les colonnes calculées et la validation inter-champs de manière native. Les outils basés sur des modèles peinent particulièrement ici — ils peuvent extraire ce qui se trouve à une coordonnée, mais ils ne peuvent pas effectuer d'arithmétique sur les résultats. L'étape de validation retombe alors sur une personne avec une calculatrice ou un processus de rapprochement Excel séparé. Si vous traitez plus de 100 factures par mois, cette étape de validation manuelle est là où se trouve la véritable perte de temps, pas dans la saisie initiale des données. Pour une exploration plus approfondie de la précision de l'extraction et de la façon de la mesurer sur vos documents, le guide pratique sur la précision couvre la méthodologie de validation au niveau des champs.
Variantes de factures par secteur — ce qui distingue chaque type
Une facture commerciale standard — nom du fournisseur, date, lignes de facture, total — sert de référence. Mais si votre entreprise traite des factures qui sortent de la norme commerciale, la précision de l'extraction dépend de la capacité de l'outil à comprendre ce qu'il examine. Trois variantes sectorielles illustrent à quel point le terme « facture » peut s'éloigner du format standard — et pourquoi l'extraction générique échoue souvent sur ces documents.
Construction — Facturation progressive AIA G702/G703
Le formulaire AIA G702 (demande et certificat de paiement) n'est pas une facture au sens traditionnel. Il s'agit d'un document de facturation progressive qui suit le travail cumulé sur un projet de construction. Le formulaire possède une structure distincte pour laquelle les outils d'extraction de factures standard n'ont pas été conçus :
- Ligne 1 : Montant initial du contrat — la valeur totale du contrat à la signature. Il s'agit d'un montant fixe reporté à chaque cycle de facturation, et non d'une charge périodique.
- Ligne 2 : Variation nette due aux avenants — les modifications approuvées cumulées. Chaque avenant signé modifie ce montant, ce qui signifie que le G702 du mois 4 comporte des montants de base différents de ceux du mois 1.
- Ligne 3 : Montant du contrat à ce jour — Ligne 1 + Ligne 2. La cible évolutive qui définit ce que signifie « 100 % achevé » à ce stade du projet.
- Ligne 4 : Total des travaux achevés et des matériaux stockés à ce jour — la valeur de tous les travaux réalisés plus les matériaux stockés sur site. C'est le chiffre clé qui doit être étayé par la feuille de continuation G703.
- Ligne 5 : Retenue de garantie — généralement 5 à 10 % retenus jusqu'à l'achèvement du projet, calculés séparément sur les travaux achevés par rapport aux matériaux stockés.
- Ligne 6 : Total gagné moins la retenue de garantie — ce que l'entrepreneur a réellement gagné après la retenue du maître d'ouvrage.
- Ligne 7 : Moins les certificats de paiement antérieurs — le total de tous les paiements approuvés précédemment. Pour la première demande de paiement, ce montant est nul. Pour les suivantes, il s'agit du total cumulé des cycles précédents.
- Ligne 8 : Paiement actuel dû — Ligne 6 moins Ligne 7. Le montant demandé pour la période de facturation en cours.
- Ligne 9 : Solde à terminer, retenue de garantie comprise — ce qui reste sur le contrat après ce paiement.
La feuille de continuation G703 fournit le détail ligne par ligne qui étaye la Ligne 4 du G702. Elle décompose le projet en éléments de périmètre individuels — chacun avec sa valeur planifiée, les travaux achevés lors de la demande précédente, les travaux achevés au cours de la période, les matériaux stockés, le total des travaux achevés et des matériaux stockés à ce jour, le pourcentage d'achèvement et le solde à terminer. Le total général du G703 doit correspondre exactement à la Ligne 4 du G702. Selon le rapport 2024 de Rabbet sur les paiements dans la construction, 82 % des entrepreneurs subissent désormais des retards de paiement de plus de 30 jours, contre 49 % il y a seulement deux ans. Les erreurs de calcul entre les formulaires G702 et G703 comptent parmi les causes de rejet les plus courantes. Pour une présentation détaillée du traitement des factures de construction, consultez ce que implique réellement l'extraction de factures de construction.
Médical — Formulaires de demande CMS-1500 (HCFA-1500)
Le formulaire CMS-1500 (encore largement appelé HCFA-1500 dans les services de facturation) est le formulaire standard utilisé par les médecins et les prestataires de soins ambulatoires pour facturer Medicare, Medicaid et les assureurs privés aux États-Unis. Il contient 33 champs numérotés — certains avec plusieurs sous-champs — couvrant les données démographiques du patient, les informations d'assurance, les codes de diagnostic (CIM-10), les codes de procédure (CPT/HCPCS), les dates de service, les frais et les identifiants du prestataire.
Ce qui rend l'extraction du CMS-1500 particulièrement difficile :
- La case 24 est un tableau multi-lignes dans un seul champ du formulaire. Chaque ligne contient les dates de service, le lieu de service, le code de procédure, le pointeur de diagnostic, les frais, les unités et l'identifiant du prestataire. Un seul CMS-1500 peut comporter 6 lignes de service. L'extraction doit reconnaître chaque ligne comme un enregistrement distinct tout en les liant au même patient et à la même demande.
- Les pointeurs de diagnostic créent un système de renvois. La case 21 liste jusqu'à 12 codes CIM-10. La case 24E contient des chiffres (1, 2, 3, etc.) qui renvoient à des diagnostics spécifiques dans la case 21. L'extraction doit résoudre ces pointeurs — pas seulement capturer les chiffres — pour produire un enregistrement de demande complet.
- Les numéros NPI apparaissent dans plusieurs cases. Le NPI du prestataire traitant (case 24J), le NPI du prestataire facturant (case 33a) et le NPI du prestataire référent (case 17b) sont des entités différentes. Les mélanger achemine la demande vers le mauvais dossier de prestataire.
- La précision au niveau de la case est cruciale. Le champ 32 (lieu de l'établissement de service) est obligatoire lorsqu'il est différent du prestataire facturant. Le champ 11 (numéro de police de l'assuré) doit correspondre exactement aux dossiers du payeur. Une erreur dans une seule case peut déclencher un rejet de demande qui prend des semaines à corriger.
Un seul CMS-1500 contient plus de 30 éléments de données distincts. La saisie manuelle prend 5 à 7 minutes par formulaire et le taux d'erreur sur le codage au niveau des cases — en particulier le mappage des pointeurs de diagnostic et le placement des modificateurs — est suffisamment élevé pour que la plupart des services de facturation passent les demandes dans un logiciel de vérification avant soumission. L'extraction par IA qui comprend la structure de renvois du formulaire peut réduire ce temps à quelques secondes avec une précision au niveau des cases comparable à celle d'un facturateur formé, bien qu'il faille noter que les exigences spécifiques aux payeurs (quelles cases sont obligatoires pour quel assureur) nécessitent toujours une supervision humaine.
Factures de restauration — Volume élevé, formats variables
Les factures des fournisseurs de restauration ne ressemblent pas aux factures commerciales classiques. Une facture Sysco ou US Foods s'étend sur plusieurs pages avec 30 à 50 lignes, chacune comportant un spécificateur de conditionnement/taille (« sac de 6/5 lb »), une quantité en caisses, une unité de mesure qui varie selon le produit (caisse pour les produits secs, livre pour les fruits et légumes, pièce pour les articles spéciaux), et un prix unitaire qui peut être par caisse, par livre ou par pièce. Des annotations manuscrites — ajustements de prix, notes de crédit, notes de substitution griffonnées par le livreur — apparaissent sur la même page que le tableau imprimé.
Ce qui coince sur les factures de restauration :
- L'incohérence de l'unité de mesure (UoM) est la norme. Une même facture peut avoir des fruits et légumes facturés à la caisse, de la viande à la livre, des fruits de mer à la pièce et des produits d'entretien à la caisse — avec la colonne UoM parfois présente, parfois implicite dans la description du conditionnement. Une extraction qui ne traite pas l'UoM comme un champ distinct produit des totaux de ligne impossibles à vérifier.
- Le conditionnement/taille est un champ composé. « 6/5 lb » signifie six unités de 5 livres par caisse. Une ligne avec une quantité de 2 et un conditionnement « 6/5 lb » représente 60 livres au total — pas 2 articles. Se tromper là-dessus gonfle ou réduit les calculs de coût des aliments par multiples, pas par pourcentages.
- Les ajustements manuscrits sont courants. Un « 2 $ de moins sur les fruits et légumes » griffonné par le livreur ou une substitution entourée avec un prix manuscrit modifie le total effectif de la ligne. Le chiffre imprimé est erroné, le chiffre manuscrit est le bon. L'extraction doit capturer les deux — ou au minimum signaler l'écart.
- Tableaux de lignes sur plusieurs pages. Une facture Sysco de 4 pages peut avoir l'en-tête sur la page 1 et les lignes réparties sur les quatre pages. Les outils basés sur des modèles qui s'attendent à un tableau sur une seule page échouent à la page 2. L'extraction par IA gère les tableaux sur plusieurs pages mais doit reconnaître les pages de suite comme faisant partie de la même facture.
Un groupe de 10 restaurants peut travailler avec 50 à 100 fournisseurs de produits alimentaires et de boissons, chacun avec un format de facture différent. L'extraction au niveau de l'en-tête (nom du fournisseur, date, total) suffit pour la comptabilisation. Mais l'analyse des coûts des aliments, le calcul du coût des recettes, le suivi des prix par article et l'écart entre le théorique et le réel nécessitent une extraction complète des lignes avec normalisation de l'UoM. Le moteur d'extraction doit gérer les nouveaux formats de fournisseurs dès le premier document, sans configuration — ce qui signifie une extraction par IA sans modèle, et non la création de modèles par fournisseur.
Traitement par lots à grande échelle — d'une facture à un tableur complet
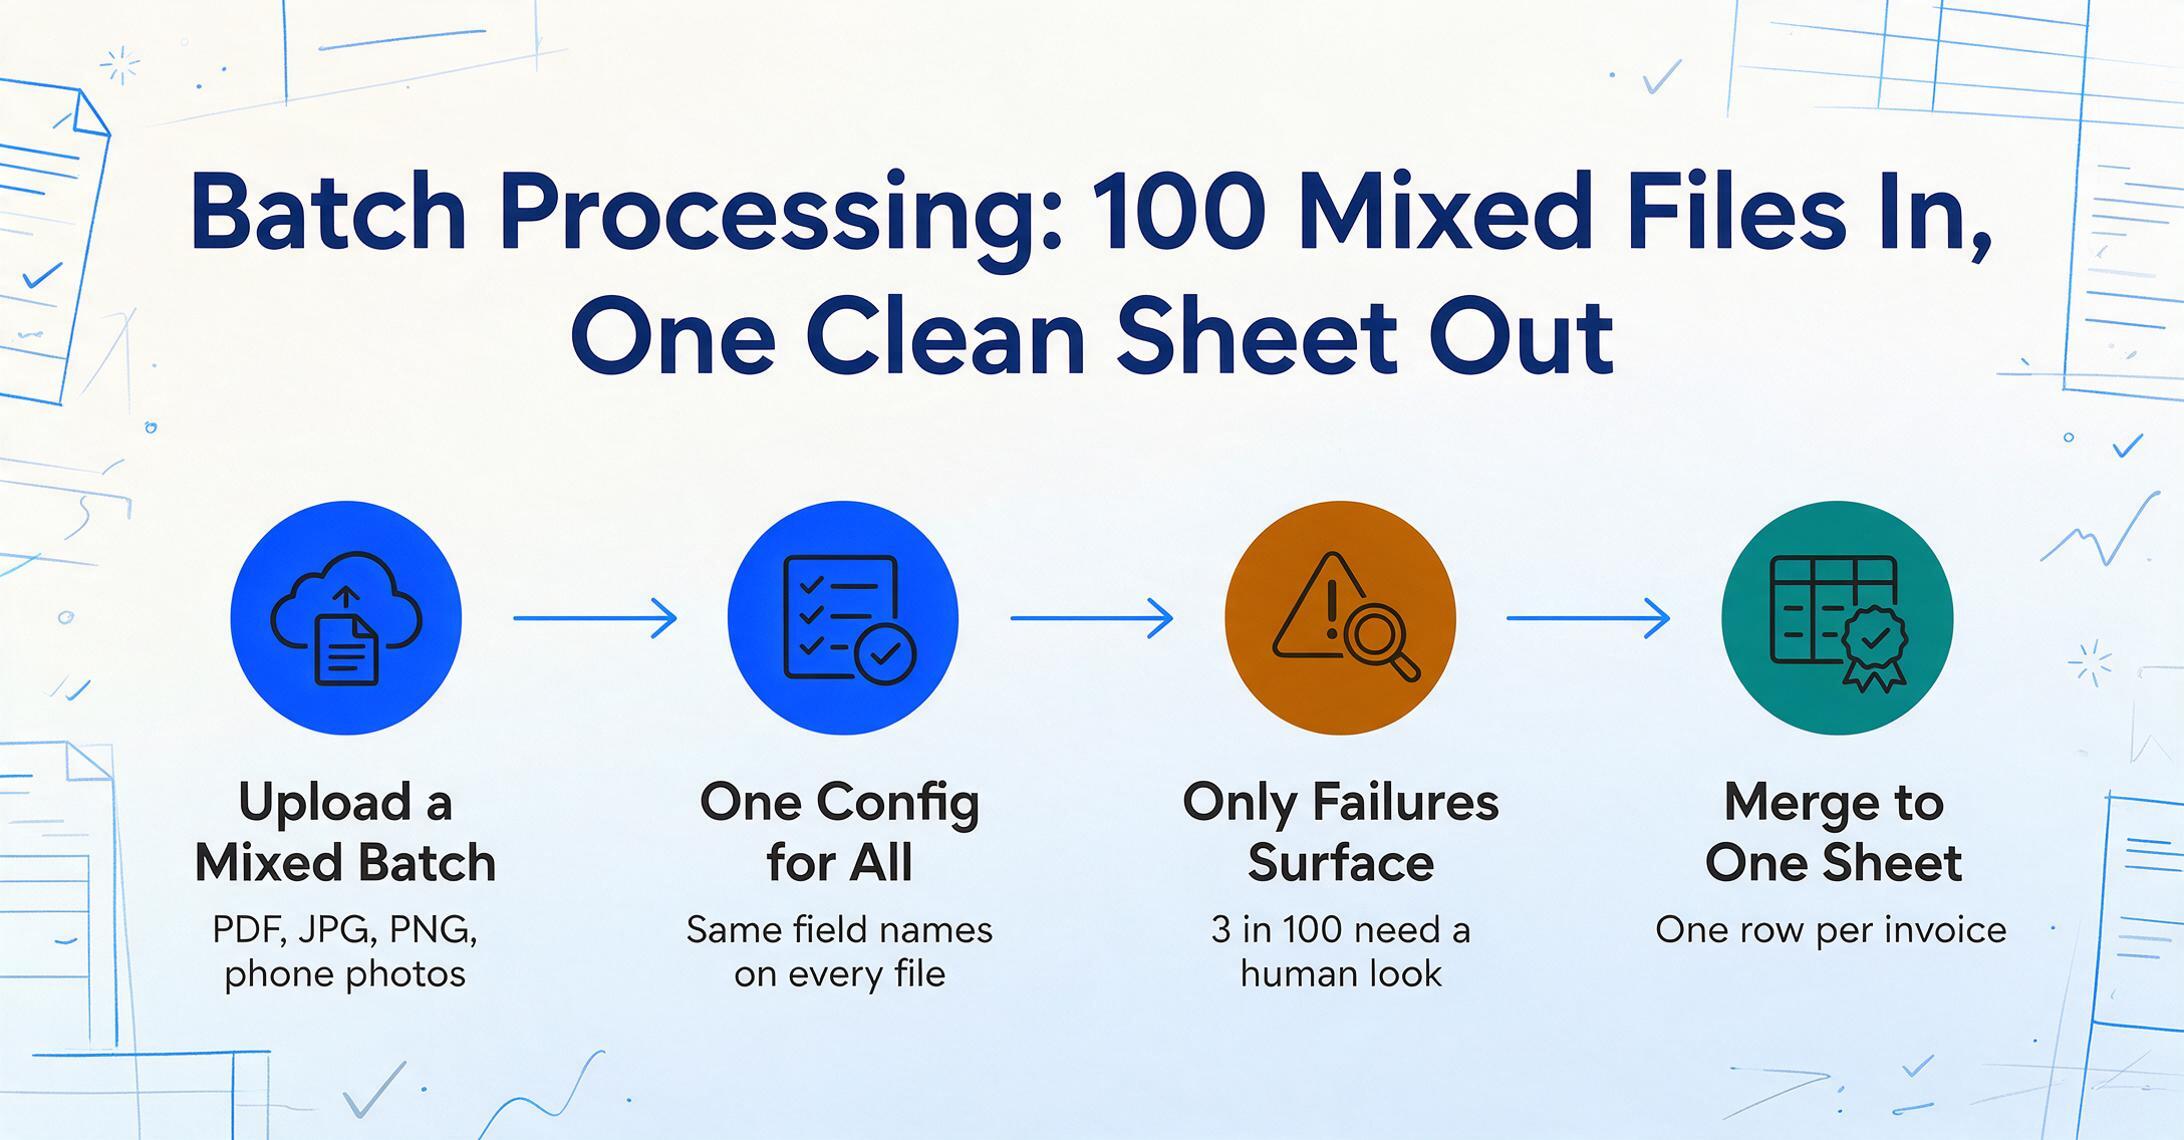
Traiter une facture à la fois vous apprend comment l'outil fonctionne. En traiter cent d'un coup vous apprend si l'outil fonctionne vraiment — car le volume révèle des défauts de conception que les démos sur document unique masquent. Le traitement par lots fait la différence entre une extraction qui s'intègre à un flux de travail et une extraction qui exige de construire un flux de travail autour d'elle.
Comment fonctionne réellement le traitement par lots
Le traitement par lots n'est pas simplement « faire la même chose N fois ». C'est un pipeline spécifique : téléversez N fichiers de factures (qui peuvent être un mélange de PDF, JPG, PNG et photos de téléphone) → l'outil les traite tous avec la même configuration d'extraction → les résultats fusionnent dans un seul fichier de sortie, une ligne par facture (ou une ligne par ligne de facture, selon le mode de sortie).
Ce qui rend cela plus difficile que le traitement de documents uniques :
- Hétérogénéité des formats. Un lot de 50 factures peut inclure 30 formats de fournisseurs différents. L'extraction par modèle échoue ici car il faudrait configurer 30 modèles avant d'appuyer sur « traiter ». L'extraction par IA gère cela car les mêmes définitions de champs fonctionnent sur tous les formats.
- Types de fichiers mixtes. Certaines factures arrivent en PDF propres. D'autres en photos de papier. Certaines en documents multipages avec bons de commande et bons de livraison mélangés. Le processeur de lots doit gérer tout cela sans tri manuel préalable des types de fichiers.
- Gestion des échecs partiels. Dans un lot de 100 factures, 3 peuvent échouer à l'extraction (scan illisible, fichier corrompu, format que l'IA ne peut pas analyser). La sortie du lot doit inclure les résultats des 97 réussies plus des indicateurs d'erreur clairs pour les 3 échouées — pas un simple message « échec du lot » qui oblige à tout recommencer.
- Traçabilité ligne-source. Dans un tableur fusionné de 500 lignes provenant de 50 factures, chaque ligne doit référencer son fichier source. Sans cela, retrouver le document original pour une valeur suspecte signifie faire correspondre manuellement les lignes aux fichiers — ce qui annule l'intérêt du traitement par lots.
Le pipeline de lots interagit également avec les colonnes calculées et la validation : au lieu d'exécuter la validation sur une facture à la fois, une exécution par lots applique les mêmes règles de calcul et les mêmes vérifications inter-champs sur l'ensemble du lot. Une seule règle de validation (« Total ligne = Qté × Prix unitaire ») détecte les erreurs sur les 50 factures simultanément — ce qui est fondamentalement différent d'ouvrir 50 résultats individuels et de vérifier chacun d'eux.
Ce qui se passe après la fin du lot
Le résultat du lot — un fichier Excel unique ou un JSON structuré — est le point de départ, pas l'arrivée. Trois étapes post-lot transforment l'extraction brute en données AP comptabilisées :
1. Revue des exceptions. Signalez les lignes où la validation a échoué (totaux de lignes incohérents, champs obligatoires manquants, numéros de facture en double). Celles-ci sont confiées à un humain pour résolution. Le reste — généralement 85 à 95 % du lot — passe sans intervention manuelle. L'objectif n'est pas zéro exception ; c'est de rendre les exceptions faciles à repérer pour que la revue prenne des minutes au lieu d'heures.
2. Transformation des données. Les données extraites correspondent rarement exactement au format d'import ERP. Les dates peuvent nécessiter un reformatage (MM/DD/YYYY → YYYY-MM-DD). Les noms de fournisseurs peuvent nécessiter une normalisation (« Sysco Corp » → « SYSCO-01 » dans le référentiel fournisseurs). Les montants en devises peuvent nécessiter une conversion. Si l'outil d'extraction exporte une structure propre et prévisible (chaque colonne a un type de données cohérent, pas de cellules fusionnées, pas d'artefacts de formatage), cette transformation est une opération de feuille de calcul de 5 minutes. Si la sortie est désordonnée, la transformation devient un projet distinct de nettoyage de données.
3. Import ERP. Le fichier transformé entre dans l'ERP via un import CSV, une API ou une intégration de feuille de calcul (comme expliqué dans la section sur les chemins d'intégration ci-dessus). La taille du lot détermine la méthode la plus adaptée : import CSV pour moins de 200 factures par mois, API pour 200 à 1 000, intégration complète de plateforme d'automatisation AP au-delà de 1 000.
Pour une procédure pas à pas du flux de travail de lot de bout en bout — de l'upload à l'Excel fusionné — voir comment extraire par lot les données de factures vers un fichier Excel. Pour le cadre de mise à l'échelle qui adapte le volume à la bonne approche de traitement, voir la mise à l'échelle du traitement des factures sans ajouter de personnel.