O Guia Completo para Extração de Dados de Faturas
(2026)
A extração de dados de faturas significa transformar as informações contidas nas faturas — nomes de fornecedores, valores, itens de linha, datas, IDs fiscais — em linhas e colunas estruturadas que você pode classificar, filtrar, importar e analisar. Parece simples. Não é. Existem três maneiras fundamentalmente diferentes de fazer isso, cada uma com seu próprio custo de configuração, teto de precisão e limite de escalabilidade. Este guia completo para extração de dados de faturas aborda as três, explica quais campos você realmente precisa extrair e oferece uma estrutura de decisão para escolher a abordagem certa com base no volume de faturas, na complexidade do formato e para onde os dados precisam ir depois.
O que é a Extração de dados de faturas — e por que a maioria das equipes ainda faz isso manualmente
A extração de dados de faturas é o processo de capturar informações de documentos de fatura — PDFs, imagens escaneadas, fotos — e convertê-las em formatos de dados estruturados como Excel, CSV ou JSON. As informações extraídas normalmente incluem o cabeçalho da fatura (número, datas, fornecedor, totais) e os itens de linha (quantidades, descrições, preços unitários, totais por linha). A saída é uma tabela em que cada linha é uma fatura ou um item de linha, e cada coluna é um campo de dados.
Por que isso importa: 68% das empresas ainda inserem dados de faturas manualmente em seus sistemas ERP ou contábeis, de acordo com dados do setor da estatísticas de automação de contas a pagar 2025 da HighRadius. A entrada manual custa cerca de $15 por fatura em mão de obra, leva de 3 a 5 minutos por documento e introduz uma taxa de erro consistente de 2 a 5%. Com 500 faturas por mês, isso representa $7.500 em mão de obra e 10 a 25 erros a cada 30 dias — erros que se acumulam em pagamentos incorretos, lançamentos contábeis com codificação errada e trabalho de conciliação que custa mais do que a entrada original.
A alternativa — extração automatizada — é possível há anos. Mas a tecnologia mudou tão rápido que o que era estado da arte há três anos (OCR baseado em modelos) agora é a abordagem legada, e o que é estado da arte hoje (extração semântica com IA) funciona em tipos de documentos e formatos que a geração anterior não conseguia lidar. Entender os três métodos — o que são, quanto custam e onde falham — é a diferença entre escolher uma ferramenta que funciona e gastar seis meses em uma implementação fracassada. Para a história mais profunda de por que a entrada manual persiste apesar de a automação estar disponível, veja por que as equipes de contas a pagar ainda inserem dados de faturas manualmente.
Os Três Métodos — Entrada Manual, OCR Baseado em Modelos e Extração Semântica com IA
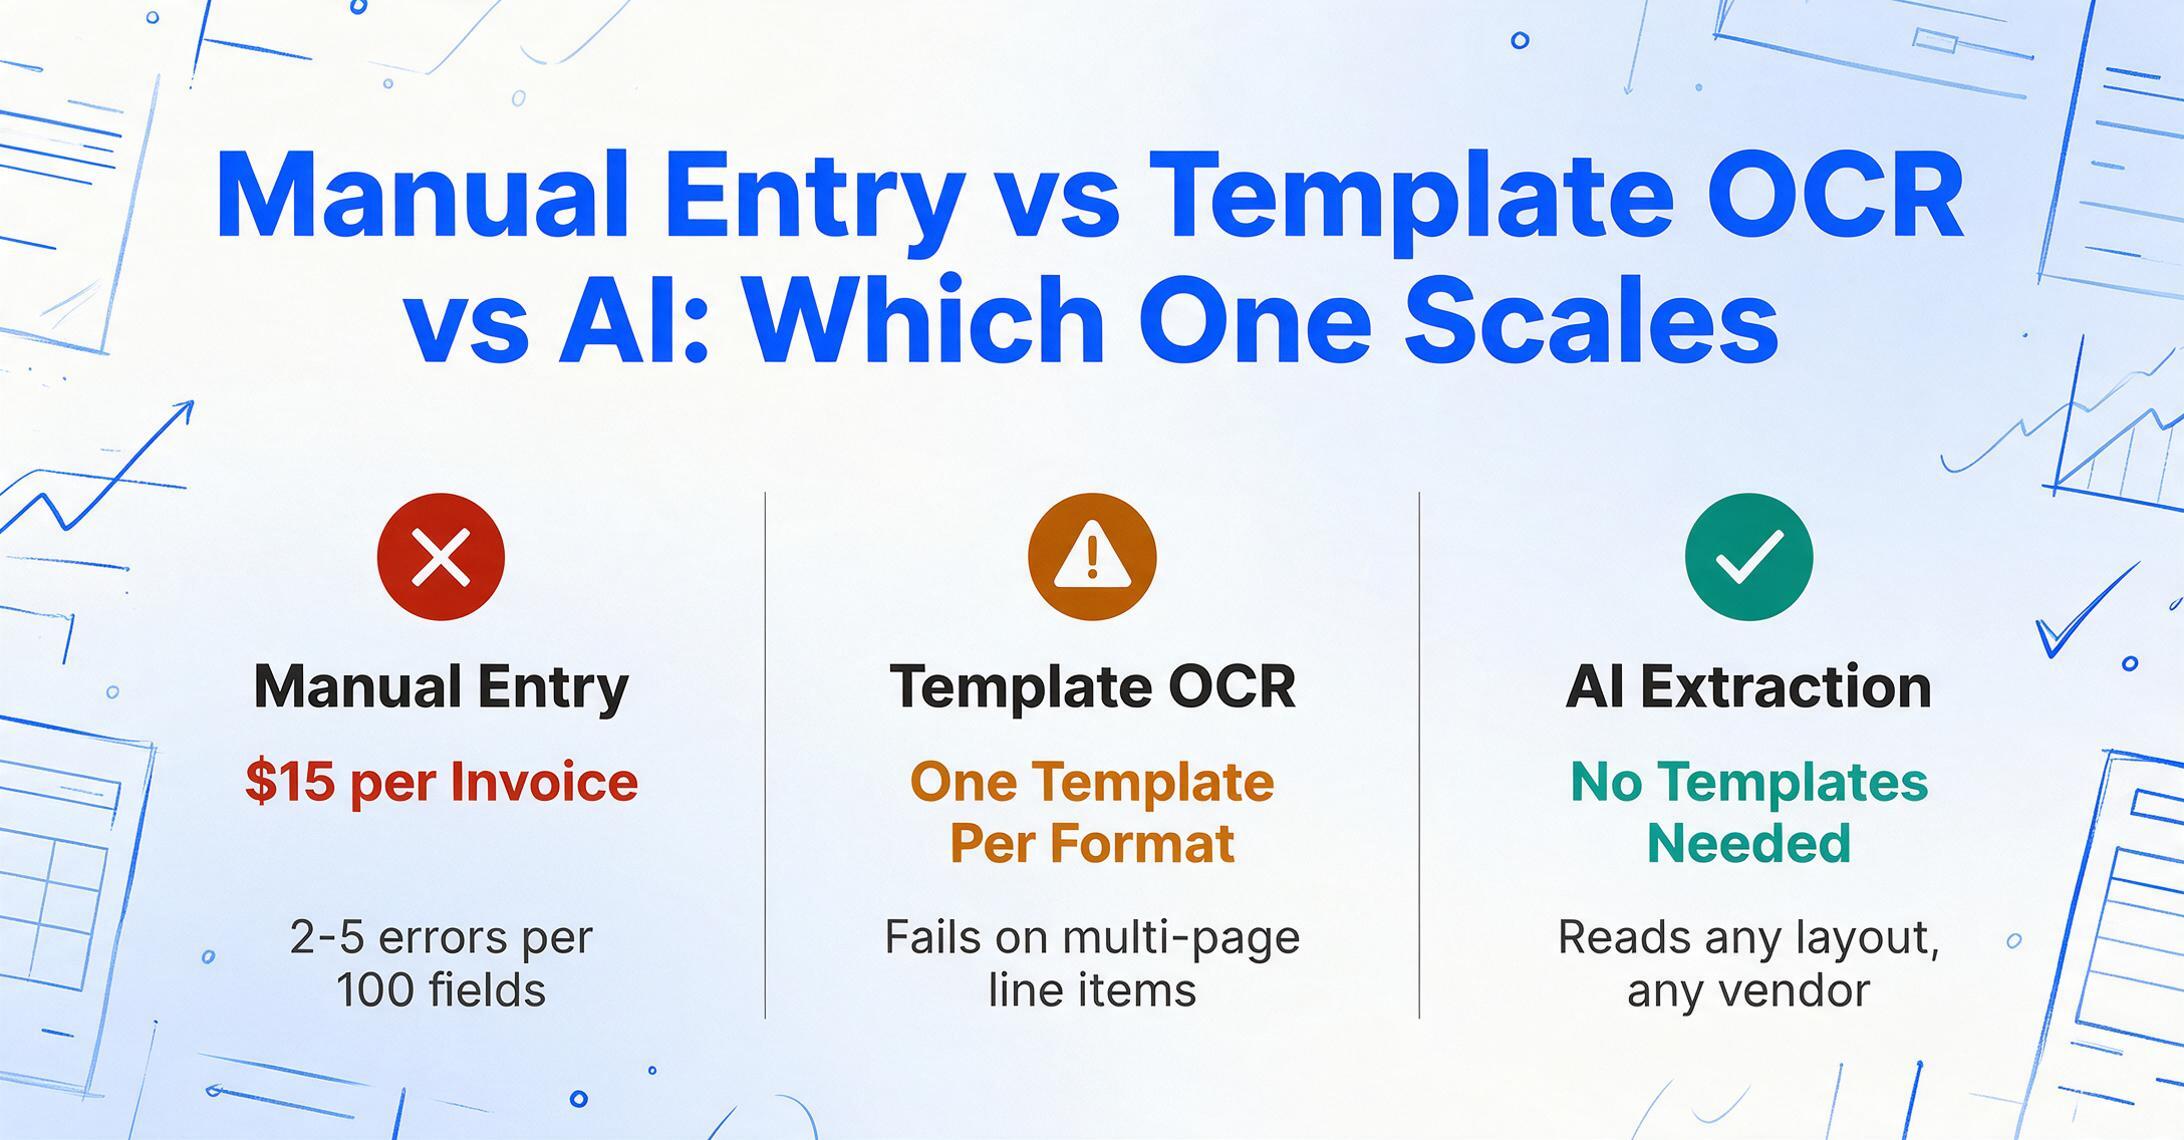
Toda abordagem de extração de faturas se enquadra em uma de três categorias. Elas não são iguais — cada uma tem um teto de precisão, custo de configuração e limite de escalabilidade diferentes. A escolha certa depende do seu volume e da sua mistura de formatos de fatura, não de qual método parece mais avançado. Para uma visão prática da extração sem modelo em ação, experimente o fluxo de trabalho de processamento de faturas com extração de nomes de colunas.
Método 1: Entrada Manual
O que é: Uma pessoa abre cada PDF de fatura, lê os campos e os digita em uma planilha ou ERP. Nenhuma tecnologia além de um visualizador de PDF e Excel.
Custo: Aproximadamente $15 por fatura em custo de mão de obra totalmente carregado, de acordo com os benchmarks de automação de contas a pagar da Quadient de 2025. Com 100 faturas por mês: $1.500/mês. Com 1.000 faturas: $15.000/mês — aproximadamente um funcionário de contas a pagar em tempo integral dedicado inteiramente à entrada de dados.
Precisão: 95-98% por campo para operadores cuidadosos — ou seja, 2-5 erros por 100 campos. São erros de transcrição: dígitos invertidos, leitura incorreta de caligrafia, posicionamento de ponto decimal. Notavelmente, um humano que inverte um número cria um valor errado que parece certo no sistema. Uma IA que não identifica um campo cria um espaço em branco — o que é mais seguro porque é visível.
Quando faz sentido: Abaixo de 50 faturas por mês, ou quando cada fatura é de um fornecedor diferente com um formato único e o custo de configurar qualquer sistema automatizado excede o custo da mão de obra. Também: quando a pessoa que faz a entrada tem contexto profundo sobre o relacionamento com o fornecedor e as regras de codificação que nenhum sistema automatizado pode replicar sem meses de treinamento.
Quando falha: Acima de 200 faturas por mês, a taxa de erro aumenta mais rápido do que a produtividade. A mesma pessoa que era precisa com 50 faturas começa a cometer erros com 200 porque a fadiga cognitiva se instala após a primeira hora de transcrição repetitiva. Para saber mais sobre os erros específicos e seus custos, veja os seis erros de entrada de dados de faturas que custam mais caro.
Método 2: OCR baseado em modelos
O que é: O software de reconhecimento óptico de caracteres lê o texto de uma imagem de fatura, e um modelo informa onde cada campo está localizado ("o número da fatura está nas coordenadas x:420, y:180"). Você cria um modelo por formato de fornecedor. O mecanismo de OCR lê os caracteres; o modelo os mapeia para os campos.
Custo: O software de OCR varia de gratuito (Tesseract) a $0,01-0,05 por página (APIs em nuvem como AWS Textract, Google Document AI) a $30-300/mês para ferramentas empacotadas. O custo oculto é a manutenção dos modelos — cada novo formato de fornecedor exige um novo modelo, e qualquer alteração no layout do fornecedor quebra o modelo existente. Organizações com mais de 100 fornecedores e OCR baseado em modelos normalmente gastam de 5 a 10 horas por mês mantendo modelos.
Precisão: 95-99% em texto impresso na posição exata que o modelo espera. Cai abaixo de 70% em conteúdo manuscrito, carimbos, anotações ou qualquer variação de layout, de acordo com a análise da PDFExcel sobre a precisão do OCR em faturas não padronizadas. A precisão em nível de página pode ser de 99%, enquanto a precisão em nível de campo é de 70% se os erros de OCR se concentrarem nos campos financeiramente significativos.
Quando faz sentido: Quando você processa grandes volumes de faturas de um conjunto pequeno e estável de fornecedores com formatos consistentes — por exemplo, um fabricante que recebe faturas semanais dos mesmos 15 fornecedores de matéria-prima. Crie 15 modelos uma vez, faça a manutenção trimestralmente e processe milhares de faturas.
Quando falha: Quando o número de fornecedores é grande ou está mudando. Quando os fornecedores trocam de software de contabilidade e o layout da fatura muda. Quando as faturas incluem anotações manuscritas, conteúdo em vários idiomas, carimbos ou tabelas irregulares. O OCR baseado em modelos é confiável para formatos conhecidos e frágil para formatos desconhecidos — e em contas a pagar, formatos desconhecidos são a norma, não a exceção. Como a análise da LlamaIndex sobre a variabilidade de faturas no mundo real documenta, não existe uma fatura padrão.
Método 3: Extração semântica com IA
O que é: Um modelo de visão-linguagem lê a fatura como um humano — ele enxerga o layout, entende quais rótulos correspondem a quais valores e extrai campos com base no significado semântico, não em posições fixas. Você especifica o que deseja pelo nome do campo ("Número da Fatura", "Valor Total", "Nome do Fornecedor"), não por coordenadas. A IA localiza cada campo em qualquer lugar da página com base na compreensão do que ele é, não de onde está.
Custo: Normalmente US$ 0,05–0,30 por página em serviços baseados em API, ou US$ 20–50/mês para ferramentas completas que incluem interface web e processamento em lote. Sem custo de manutenção de modelos — a mesma configuração funciona para qualquer formato de fornecedor.
Precisão: 97–99% de precisão em nível de campo em faturas impressas limpas, 88–95% em faturas com anotações manuscritas, 75–90% em documentos totalmente manuscritos. A variação depende mais da qualidade do documento (resolução do scan, cor vs. P&B, correção de inclinação) do que da ferramenta em si. Para um detalhamento da precisão por tipo de fatura e como medi-la em seus próprios documentos, consulte o guia prático de precisão da extração com IA.
Quando faz sentido: Quando você processa mais de 100 faturas por mês de vários fornecedores com formatos variados. Quando sua mistura de faturas inclui anotações manuscritas, documentos em vários idiomas ou layouts irregulares. Quando você precisa extrair itens de linha com quantidades e preços unitários — o OCR baseado em modelos tem dificuldade com tabelas que abrangem várias páginas ou têm contagens variáveis de colunas.
Quando falha: Quando as faturas estão severamente degradadas — fotocópias de quarta geração, imagens de fax a 72 DPI, fotos tiradas em ângulo com pouca iluminação. Nenhum método de extração lida bem com isso, mas a IA degrada de forma mais graciosa que o OCR porque pode inferir pelo contexto onde o OCR simplesmente retorna ruído. Também: quando a fatura contém campos que exigem conhecimento externo que a IA não possui (por exemplo, para qual centro de custo um item de linha específico deve ser codificado — isso é uma decisão separada de codificação contábil, não um problema de extração).
Para uma comparação lado a lado de ferramentas específicas na categoria de extração com IA — incluindo quais funcionam sem suporte de TI, lidam com itens de linha e suportam processamento em lote — consulte nossa comparação de ferramentas de extração de dados de faturas com IA para equipes financeiras.
Os Campos Que Você Realmente Precisa — Cabeçalho, Itens de Linha, Calculados e Conformidade
Nem todo campo de uma fatura precisa ser extraído. Entender quais categorias de dados importan para seu fluxo de trabalho evita especificar demais (o que retarda a extração e aumenta a superfície de erro) e especificar de menos (o que significa re-extraer depois).
Campos de cabeçalho — extrair sempre. Estes identificam a transação e aparecem uma vez por fatura: Número de Fatura, Data da Fatura, Data de Vencimento, Nome do Fornecedor, Monto Total, Monto de Imposto, Moeda e Nº do Pedido de Compra. Estes são o conjunto mínimo viável de extração. Todo fluxo de trabalho de faturas os necesita para o processamento de pagamentos e importação em ERP. Campos de cabeçalho ausentes ou incorretos causam os erros mais caros porque rotean a fatura ao caminho de aprobación errado, ao montante de pagamento errado ou ao período contable errado.
Itens de linha — extrair quando você precisa de alocação de custos. Cada item de linha é uma fila na tabela da fatura: Descrição, Quantidade, Preço Unitário, Total da Linha e, opcionalmente, SKU, Taxa de Imposto ou Código de Conta. Extraer itens de linha importa quando você precisa dividir uma fatura entre centros de custo (linha 1 vai ao departamento A, linha 2 ao departamento B), rastrear gastos por categoria de produto ou verificar que os preços unitários coincidam com o contrato. A extração de itens de linha é tecnicamente mais difícil que a de cabeçalho porque as tabelas têm colunas variáveis, se dividem entre páginas e usan formatos inconsistentes — a tabela na página 1 pode ter 5 colunas e a da página 2, 6. O OCR baseado em modelos falha frequentemente com itens de linha. A extração semântica com IA os maneja porque lê a estrutura da tabela semanticamente, não geometricamente.
Campos calculados — extrair quando o documento não mostra o número que você necesita. Alguns valores que você necesita não estão impressos na fatura. Um subtotal antes de impostos quando a fatura só mostra o total com impostos. Um total de linha quando só se mostran quantidade e preço unitário. A diferença entre o montante facturado e a tarifa contratada. A computação por nome de columna — onde você escreve uma lógica de cálculo no nome do campo, como "Subtotal (Total − Monto de Imposto)" ou "Total da Linha (Quantidade × Preço Unitário)" — indica à IA que calcule o valor ausente a partir dos campos que pode ler. Isso transforma a extração (encontrar o que existe) em derivação (calcular o que você necesita a partir do que existe).
Campos de conformidade — extrair quando as regulaciones os exigem. Estes variam por país: Nº de IVA para faturas da UE, ABN para faturas australianas, GSTIN para faturas indias, ID fiscal do fornecedor para reportes 1099 dos EUA. Campos de conformidade ausentes ou incorretos não bloquean o pagamento, mas causan problemas posteriores de declaración de impostos — um 1099 apresentado com TIN incorreto genera um aviso do IRS, uma declaración de IVA com registro de fornecedor ausente provoca uma consulta de auditoría. Estes campos devem fazer parte de toda configuración de extracción onde se apliquen, não ser adicionados como pensamento posterior durante a temporada de impostos.
Qual Método se Adequa à Sua Situação — Um Guia de Decisão
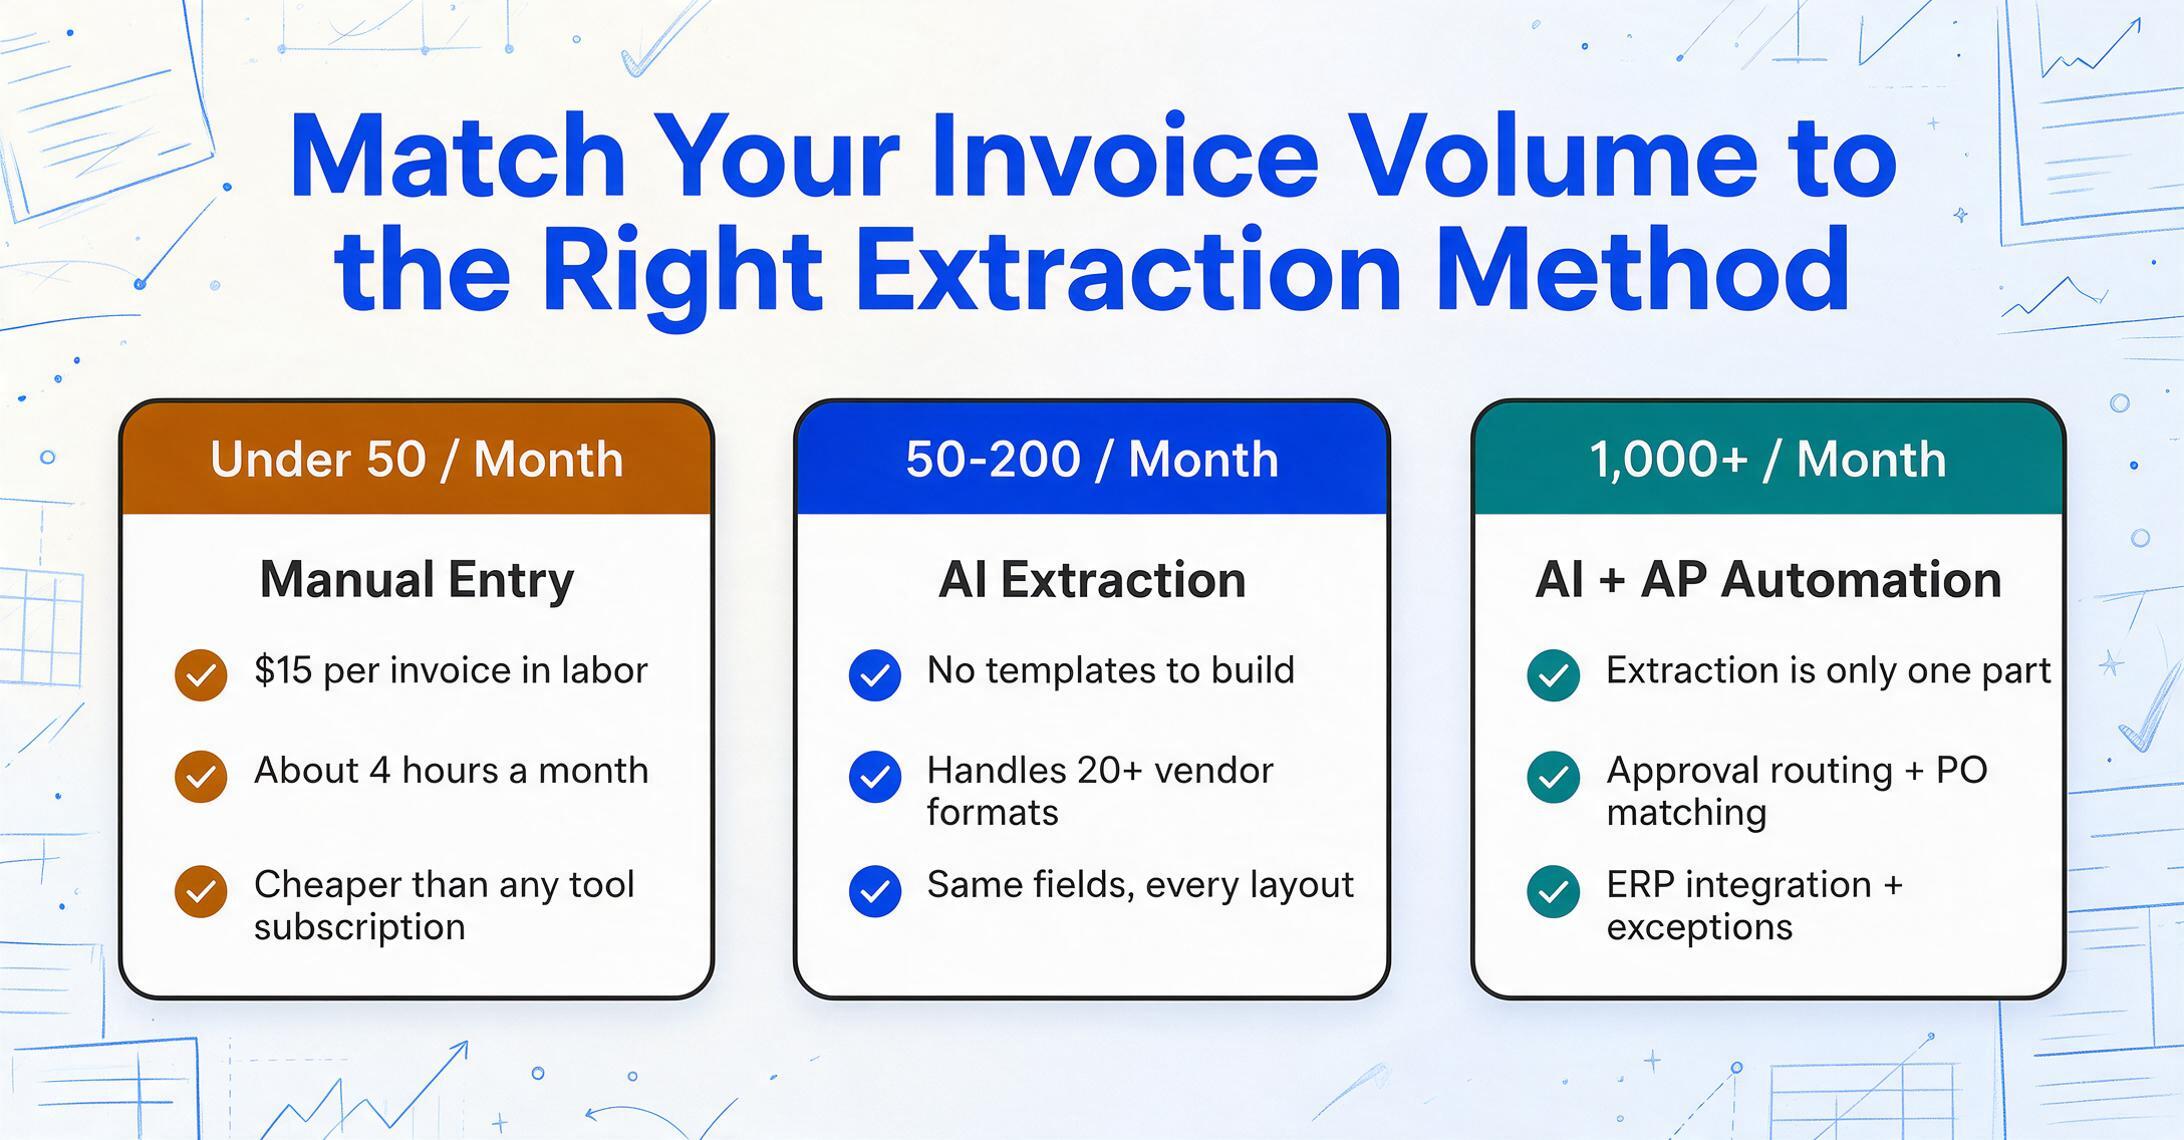
O método de extração certo não é o mais avançado. É aquele cujo custo e complexidade correspondem ao seu volume e à mistura de formatos. Aqui está a lógica de decisão, organizada pelos fatores que realmente determinam sucesso ou fracasso:
| Sua Situação | Melhor Método | Porquê |
|---|---|---|
| < 50 faturas/mês, formatos variados | Entrada manual | O custo de configuração de qualquer sistema automatizado excede o custo de mão de obra neste volume. Uma única pessoa processando 50 faturas (~4 horas/mês) é mais barato do que qualquer assinatura de ferramenta mais o tempo para aprendê-la. |
| 50–200/mês, formatos variados | Extração com IA | O tempo de configuração de OCR baseado em modelos em mais de 20 formatos de fornecedores custa mais do que uma assinatura de ferramenta de IA. A IA lida com a variabilidade de formatos sem manutenção de modelos. |
| 200–1.000/mês, < 20 formatos estáveis de fornecedores | OCR baseado em modelos ou IA | Se sua lista de fornecedores é estável e os formatos são consistentes, o OCR baseado em modelos oferece alta precisão a um custo menor por página. Se os formatos variam, a IA evita a sobrecarga de manutenção de modelos. |
| 200–1.000/mês, 50+ formatos de fornecedores | Extração com IA | Gerenciar mais de 50 modelos é um trabalho de meio período. A IA lida com a diversidade de formatos sem configuração por fornecedor. Veja o framework de escalabilidade para a lógica de decisão baseada em volume. |
| 1.000+/mês, qualquer mistura de formatos | Extração com IA + automação de contas a pagar | Neste volume, a extração é apenas uma parte do fluxo de trabalho. Você também precisa de roteamento de aprovação automatizado, correspondência de pedidos de compra, integração com ERP e tratamento de exceções. Ferramentas independentes de extração com IA lidam com a captura de dados. Plataformas completas de automação de contas a pagar (Tipalti, Stampli, Rossum) lidam com todo o ciclo de vida da fatura. |
| Faturas manuscritas, qualquer volume | IA (baseada em VLM) | O OCR baseado em modelos cai abaixo de 70% em manuscritos. VLMs leem manuscritos compreendendo formas de letras em contexto semântico. Digitalizações de alta resolução (400-600 DPI, coloridas) são essenciais. |
| Faturas multilíngues e transfronteiriças | IA (baseada em VLM) | Modelos de visão-linguagem leem semanticamente entre idiomas. O OCR baseado em modelos treinado em inglês tem dificuldades com rótulos em japonês, formatos de data franceses e convenções decimais europeias. |
Os arquivos são processados com segurança e não são armazenados.
O Que Acontece Após a Extração — Da Planilha ao ERP
A extração retira os dados do documento. Colocá-los no seu sistema contábil é uma etapa separada — e é onde muitas implementações de extração travam, porque a equipe percebe que os dados estão estruturados, mas a conexão com o ERP não está. Existem quatro caminhos de integração, ordenados do mais simples ao mais automatizado:
Caminho 1: Baixar e importar. A ferramenta de extração gera Excel ou CSV. Você baixa o arquivo, verifica e importa para o ERP usando a função nativa de importação do ERP. Isso funciona com todos os ERPs — SAP, Oracle, NetSuite, QuickBooks, Xero, Sage, Microsoft Dynamics — porque a importação de CSV é universal. Não exige envolvimento de TI. O custo é a etapa manual de baixar e importar, que leva de 2 a 5 minutos por lote, independentemente de quantas faturas há no lote. Este é o caminho certo para a maioria das equipes que processam menos de 1.000 faturas por mês.
Caminho 2: Integração direta com planilha. A ferramenta de extração grava dados diretamente no Google Sheets ou Excel Online via API. A planilha se torna o intermediário entre a extração e o ERP — a ferramenta adiciona linhas a uma planilha, e uma integração separada (Zapier, Make ou um conector nativo de ERP) lê da planilha para o ERP. Isso elimina a etapa de download e disponibiliza os dados para revisão em um formato que a equipe financeira já usa. Especificamente para usuários do Google Sheets, algumas ferramentas de extração oferecem complementos de barra lateral que permitem enviar faturas e obter dados extraídos sem sair da planilha.
Caminho 3: Integração via API. A ferramenta de extração envia os dados extraídos diretamente para o ERP via API. Isso exige que tanto a ferramenta de extração quanto o ERP tenham APIs compatíveis e que alguém (geralmente TI ou um consultor de integração) configure a conexão. Uma vez configurado, extração → validação → importação no ERP funciona com intervenção humana mínima. As faturas que passam na validação são lançadas automaticamente. As que falham são sinalizadas para revisão. Este caminho é adequado acima de 1.000 faturas por mês ou quando a etapa de importação manual é o gargalo no fluxo de trabalho.
Caminho 4: Links de coleta para documentos recebidos. Um link de coleta é uma URL compartilhável que permite que fornecedores, clientes ou membros da equipe enviem faturas diretamente para a sua fila de extração — sem registro, sem login, sem troca de e-mails. A pessoa abre o link, insere um código de verificação curto e envia o arquivo. Ele chega direto no seu pipeline de processamento. Isso transforma a extração de "eu reúno documentos e depois extraio" para "os documentos chegam pré-reunidos na fila de extração". Para cenários de preparação de auditoria em que você precisa coletar faturas de várias fontes sob pressão de tempo, consulte o guia de preparação para a temporada de auditoria.
O outro canal de entrada é o e-mail. Um link de coleta cobre os documentos que você precisa buscar; a maioria das faturas chega sozinha, como anexos. Um endereço de caixa de entrada dedicado transforma esse fluxo na mesma fila: você compartilha um endereço com fornecedores ou clientes, e cada anexo chega automaticamente na sua fila de processamento. Com o processamento automático ativado e os campos que você deseja vinculados à caixa de entrada, a extração começa no momento em que o e-mail chega, uma lista de remetentes autorizados mantém e-mails não relacionados fora, e senhas salvas permitem que PDFs protegidos sejam desbloqueados sem que ninguém digite a senha. O resultado é o mesmo do link de coleta: os documentos chegam pré-reunidos, e ninguém encaminha ou envia arquivos manualmente.
Aprofundando — Tópicos-chave para Necessidades Específicas
A extração de dados de faturas se conecta a vários fluxos de trabalho especializados. Os artigos abaixo aprofundam cada área:
| O que é Extração de dados de faturas? Como funciona e por que importa | A definição inicial — se você é novo no conceito, comece aqui antes de mergulhar nos métodos e ferramentas. |
| Por que equipes de AP ainda digitam dados de faturas manualmente | As razões estruturais pelas quais a Entrada manual persiste apesar de décadas de automação — e por que "um ERP melhor" não era a resposta. |
| Ferramentas de extração com IA comparadas para equipes financeiras | Comparação lado a lado por abordagem técnica — quais ferramentas funcionam sem suporte de TI, lidam com Itens de linha e suportam Processamento em lote. |
| Escalando o processamento de faturas sem aumentar o quadro | Estrutura de decisão para saber quando otimizar o processo, quando automatizar e quando contratar — por ponto de inflexão de volume. |
| 6 erros de lançamento de faturas que custam mais caro | Os erros visíveis (transposições, duplicatas) e os invisíveis (Codificação contábil, classificação fiscal) — com detalhamento de custo por erro. |
| Guia prático de precisão para extração de faturas com IA | Por que "99% de precisão" é um número de marketing, o que a precisão em nível de campo realmente significa e como fazer seu próprio teste de precisão em uma tarde. |
| Temporada de auditoria: preparando dados de faturas com pouco tempo | Sistema de triagem de emergência para digitalizar dados de faturas quando os auditores estão a semanas de distância — o que priorizar, o que pular. |
Extração Avançada de Campos: Colunas Calculadas e Validação Entre Campos
O próximo nível além de extrair o que está impresso em uma fatura é extrair o que você realmente precisa — o que nem sempre é a mesma coisa. Uma fatura pode mostrar um subtotal de R$ 1.247,83 sem discriminar os impostos, mas você precisa do valor antes dos impostos para a codificação contábil. Ela pode listar 15 itens de linha com quantidades e preços unitários, mas sem totais por linha. Pode mostrar um total geral que não corresponde à soma dos itens de linha — e você precisa saber qual número está errado antes de lançar o pagamento.
Esses não são casos isolados. São problemas cotidianos de processamento de faturas que transformam a extração de uma leitura de uma etapa em um fluxo de trabalho de verificação e cálculo em várias etapas. As ferramentas que lidam bem com isso se diferenciam das que apenas leem texto.
Colunas Calculadas — Resultados Calculados, Não Apenas Valores Extraídos
Uma coluna calculada é um campo que você define e que não apenas localiza um valor no documento. Ela pega um ou mais valores extraídos, realiza um cálculo com eles e gera o resultado como uma coluna própria na planilha. O exemplo mais simples e comum: Total da Linha = Quantidade × Preço Unitário. Muitas faturas imprimem o total da linha junto com a quantidade e o preço unitário — mas quando não imprimem (ou quando o total impresso está errado), uma coluna calculada preenche essa lacuna multiplicando o que foi extraído.
Essa capacidade vai muito além da aritmética básica. O mesmo mecanismo lida com:
- Subtotal ausente: A fatura mostra apenas o total com impostos incluídos. Uma coluna calculada deriva
Subtotal = Total − Valor do Imposto, fornecendo o valor antes dos impostos para a codificação contábil sem uma etapa separada de calculadora. - Validação em nível de linha: Extraia Quantidade e Preço Unitário separadamente e depois calcule
Total Esperado da Linha = Quantidade × Preço Unitário. Compare com o total impresso na linha. Uma coluna de divergência sinaliza discrepâncias antes que cheguem ao ERP. - Conciliação em nível de fatura: Some todos os totais de linha calculados e compare com o subtotal impresso. Se a diferença for diferente de zero, algo está errado — ou os itens de linha foram lidos incorretamente, ou o subtotal do cabeçalho foi impresso errado. De qualquer forma, você detecta antes do pagamento.
- Lógica condicional:
Indicador de Desconto = SE(Total da Linha > R$ 500, "Revisar", "OK")— aplique regras de negócio durante a extração para que a saída já segmente o que precisa de atenção do que pode ser lançado automaticamente. - Consulta de taxa: Incorpore uma taxa fixa de imposto (por exemplo, 8,875% para NYC) na regra de cálculo. A IA a aplica a cada linha sem que a taxa apareça em qualquer lugar do documento.
A mudança arquitetural aqui é significativa: a extração deixa de ser puramente sobre ler o que está lá e se torna uma operação combinada de leitura e derivação. Em vez de extrair dados brutos e depois abrir o Excel para calcular, pivotar e validar, você obtém resultados calculados na mesma tabela que saiu da extração — uma etapa em vez de três. Para um passo a passo detalhado do mecanismo completo de colunas calculadas, veja como funciona a extração de itens de linha com totais calculados.
Validação entre campos — detectando erros sem revisão manual
A validação entre campos é a verificação matemática de que os valores extraídos são internamente consistentes. Ela responde à pergunta: "Se eu somar os itens de linha, obtenho o subtotal? Se eu aplicar a alíquota de imposto, obtenho o valor do imposto? Se eu somar o imposto ao subtotal, obtenho o total geral?"
Essas verificações são determinísticas — ou passam ou não passam. Não é necessário julgamento. E elas detectam a classe mais perigosa de erros de extração: valores que parecem corretos isoladamente, mas não funcionam juntos. Um dígito transposto em um total de linha (era $1.247, extraído como $1.274) pode passar em uma conciliação de três vias. Mas Σ(Quantidade × Preço unitário) ≠ Subtotal detecta isso instantaneamente.
Os três níveis de validação que importam na prática:
| Nível de validação | Verificação | O que detecta |
|---|---|---|
| Nível de linha | Quantidade × Preço unitário = Total da linha | Dígitos lidos incorretamente, Qtd/Preço trocados, totais de linha ausentes que deveriam ser derivados |
| Nível de fatura | Soma dos totais de linha + imposto = Total geral | Itens de linha ausentes, extração duplicada, classificação incorreta de imposto, desvios de arredondamento |
| Entre documentos | Total do pedido de compra − valor já faturado = saldo restante | Detecção de faturas duplicadas, cobrança excessiva, erros de rastreamento de remessas parciais |
Nem toda ferramenta de extração suporta colunas calculadas e validação entre campos nativamente. Ferramentas baseadas em modelos, em particular, têm dificuldade aqui — elas podem extrair o que estiver em uma coordenada, mas não conseguem realizar operações aritméticas sobre os resultados. A etapa de validação acaba recaindo sobre um humano com calculadora ou um processo separado de conciliação em Excel. Se você processa mais de 100 faturas por mês, essa etapa de validação manual é onde está o maior consumo de tempo, não na entrada de dados inicial. Para uma exploração mais aprofundada da precisão da extração e de como medi-la em seus documentos, o guia prático de precisão aborda a metodologia de validação em nível de campo.
Variações de Faturas por Setor — O Que Torna Cada Tipo Diferente
Uma fatura comercial padrão — nome do fornecedor, data, itens de linha, total — é a referência básica. Mas se sua empresa lida com faturas fora do padrão comercial, a precisão da extração depende de a ferramenta entender o que está analisando. Três variações de setor ilustram o quanto "fatura" pode se afastar do formato padrão — e por que a extração genérica costuma falhar nelas.
Construção — AIA G702/G703 Faturamento Progressivo
A AIA G702 Application and Certificate for Payment não é uma fatura no sentido tradicional. É um documento de faturamento progressivo que acompanha o trabalho acumulado em um projeto de construção. O formulário tem uma estrutura distinta para a qual as ferramentas padrão de extração de faturas não foram projetadas:
- Linha 1: Valor Original do Contrato — o valor total do contrato na assinatura. É um número fixo mantido em todos os ciclos de faturamento, não uma cobrança por período.
- Linha 2: Variação Líquida por Ordens de Alteração — alterações aprovadas acumuladas. Cada ordem de alteração assinada modifica esse número, o que significa que a G702 do mês 4 traz números-base diferentes da do mês 1.
- Linha 3: Valor do Contrato até a Data — Linha 1 + Linha 2. A meta móvel que define o que "100% concluído" significa neste ponto do projeto.
- Linha 4: Total Concluído e Armazenado até a Data — o valor de todo o trabalho realizado mais os materiais armazenados no local. Este é o valor-chave que deve ser respaldado pela folha de continuação G703.
- Linha 5: Retenção — normalmente 5-10% retidos até a conclusão do projeto, calculados separadamente sobre o trabalho concluído versus materiais armazenados.
- Linha 6: Total Ganho Menos Retenção — o que o contratante realmente ganhou após a retenção do proprietário.
- Linha 7: Menos Certificados de Pagamento Anteriores — o total de todos os pagamentos aprovados anteriormente. Para a primeira solicitação de pagamento, é zero. Para as seguintes, é o total acumulado dos ciclos anteriores.
- Linha 8: Pagamento Atual Devido — Linha 6 menos Linha 7. O valor solicitado neste período de faturamento.
- Linha 9: Saldo para Concluir, Incluindo Retenção — o que resta no contrato após este pagamento.
A Folha de Continuação G703 fornece o detalhamento dos itens de linha para a Linha 4 da G702. Ela divide o projeto em itens de escopo individuais — cada um com seu valor programado, trabalho concluído na aplicação anterior, trabalho concluído neste período, materiais armazenados, total concluído e armazenado até a data, percentual concluído e saldo para concluir. O total geral da G703 deve ser exatamente igual à Linha 4 da G702. De acordo com o Relatório de Pagamentos na Construção 2024 da Rabbet, 82% dos contratantes agora enfrentam atrasos de pagamento superiores a 30 dias, ante 49% apenas dois anos antes. Erros de cálculo entre os formulários G702 e G703 estão entre as causas mais comuns de rejeição. Para um passo a passo focado no processamento de faturas de construção especificamente, veja o que a extração de faturas de construção realmente envolve.
Médico — Formulários de Reivindicação CMS-1500 (HCFA-1500)
O formulário CMS-1500 (ainda amplamente chamado de HCFA-1500 nos departamentos de faturamento) é o formulário padrão de reivindicação usado por médicos e prestadores ambulatoriais para faturar Medicare, Medicaid e seguradoras comerciais nos Estados Unidos. Ele contém 33 campos numerados — alguns com múltiplos subcampos — abrangendo dados demográficos do paciente, informações do seguro, códigos de diagnóstico (CID-10), códigos de procedimento (CPT/HCPCS), datas de serviço, valores e identificadores do prestador.
O que torna a extração do CMS-1500 especialmente desafiadora:
- O Box 24 é uma tabela de várias linhas dentro de um único campo do formulário. Cada linha contém datas de serviço, local de serviço, código do procedimento, ponteiro de diagnóstico, valores, unidades e ID do prestador. Um único CMS-1500 pode ter 6 linhas de serviço. A extração deve reconhecer cada linha como um registro separado, mantendo-as vinculadas ao mesmo paciente e reivindicação.
- Os ponteiros de diagnóstico criam um sistema de referência cruzada. O Box 21 lista até 12 códigos CID-10. O Box 24E contém números (1, 2, 3, etc.) que apontam para diagnósticos específicos no Box 21. A extração precisa resolver esses ponteiros — não apenas capturar os números — para produzir um registro completo da reivindicação.
- Os números NPI aparecem em vários boxes. O NPI do prestador executor (Box 24J), o NPI do prestador faturante (Box 33a) e o NPI do prestador de referência (Box 17b) são entidades diferentes. Misturá-los direciona a reivindicação para o registro errado do prestador.
- A precisão em nível de box é essencial. O campo 32 (local da instalação de serviço) é obrigatório quando diferente do prestador faturante. O campo 11 (número da apólice do segurado) deve corresponder exatamente aos registros da pagadora. Um erro em um box pode desencadear uma rejeição da reivindicação que leva semanas para corrigir.
Um único CMS-1500 contém mais de 30 elementos de dados distintos. A entrada manual leva de 5 a 7 minutos por formulário, e a taxa de erro na codificação em nível de box — particularmente no mapeamento de ponteiros de diagnóstico e colocação de modificadores — é alta o suficiente para que a maioria dos departamentos de faturamento execute as reivindicações por um verificador antes do envio. A extração por IA que entende a estrutura de referência cruzada do formulário pode reduzir isso para segundos, com precisão em nível de campo comparável a um faturante treinado, embora seja importante notar que os requisitos específicos de cada pagadora (quais boxes são obrigatórios para cada seguradora) ainda exigem supervisão humana.
Faturas de Restaurante & Serviço de Alimentação — Alto Volume, Formato Variável
As faturas de fornecedores de restaurantes não se parecem com faturas comerciais comuns. Uma fatura da Sysco ou US Foods se estende por várias páginas com 30 a 50 itens, cada um com especificação de embalagem/tamanho ("saco de 6/5 lb"), quantidade em caixas, unidade de medida que varia conforme o produto (caixa para secos, libra para hortifrúti, unidade para itens especiais) e um preço unitário que pode ser por caixa, por libra ou por unidade. Anotações manuscritas — ajustes de preço, notas de crédito, anotações de substituição rabiscadas pelo entregador — aparecem na mesma página da tabela impressa.
O que quebra nas faturas de restaurante:
- Inconsistência na unidade de medida (UoM) é a regra. A mesma fatura pode ter hortifrúti precificado por caixa, carne por libra, frutos do mar por unidade e materiais de limpeza por caixa — com a coluna UoM às vezes presente e às vezes implícita na descrição da embalagem/tamanho. A extração que não trata UoM como um campo distinto produz totais de linha que não podem ser verificados.
- Embalagem/tamanho é um campo composto. "6/5 lb" significa seis unidades de 5 libras por caixa. Uma linha com quantidade 2 e embalagem "6/5 lb" significa 60 libras no total — não 2 itens. Errar isso infla ou deflaciona os cálculos de custo de alimentos por múltiplos, não por porcentagens.
- Ajustes manuscritos são padrão. Um "$2 de desconto no hortifrúti" rabiscado pelo entregador ou uma substituição circulada com um preço manuscrito altera o total efetivo da linha. O número impresso está errado, e o número manuscrito é o real. A extração deve capturar ambos — ou, no mínimo, sinalizar a discrepância.
- Tabelas de itens em várias páginas. Uma fatura da Sysco de 4 páginas pode ter o cabeçalho na página 1 e os itens distribuídos por todas as quatro páginas. Ferramentas baseadas em modelo que esperam uma tabela de página única quebram na página 2. A extração por IA lida com tabelas que abrangem páginas, mas precisa reconhecer páginas de continuação como parte da mesma fatura.
Um grupo de restaurantes com 10 unidades pode trabalhar com 50 a 100 fornecedores de alimentos e bebidas, cada um com um formato de fatura diferente. A extração de cabeçalho (nome do fornecedor, data, total) é suficiente para lançamento no contas a pagar. Mas a análise de custo de alimentos, custeio de receitas, rastreamento de preço por item e variação entre o teórico e o real exigem extração completa de itens com normalização de UoM. O mecanismo de extração precisa lidar com novos formatos de fornecedor no primeiro documento sem configuração — o que significa extração por IA sem modelo, não criação de modelo por fornecedor.
Processamento em lote em escala — de uma fatura a uma planilha
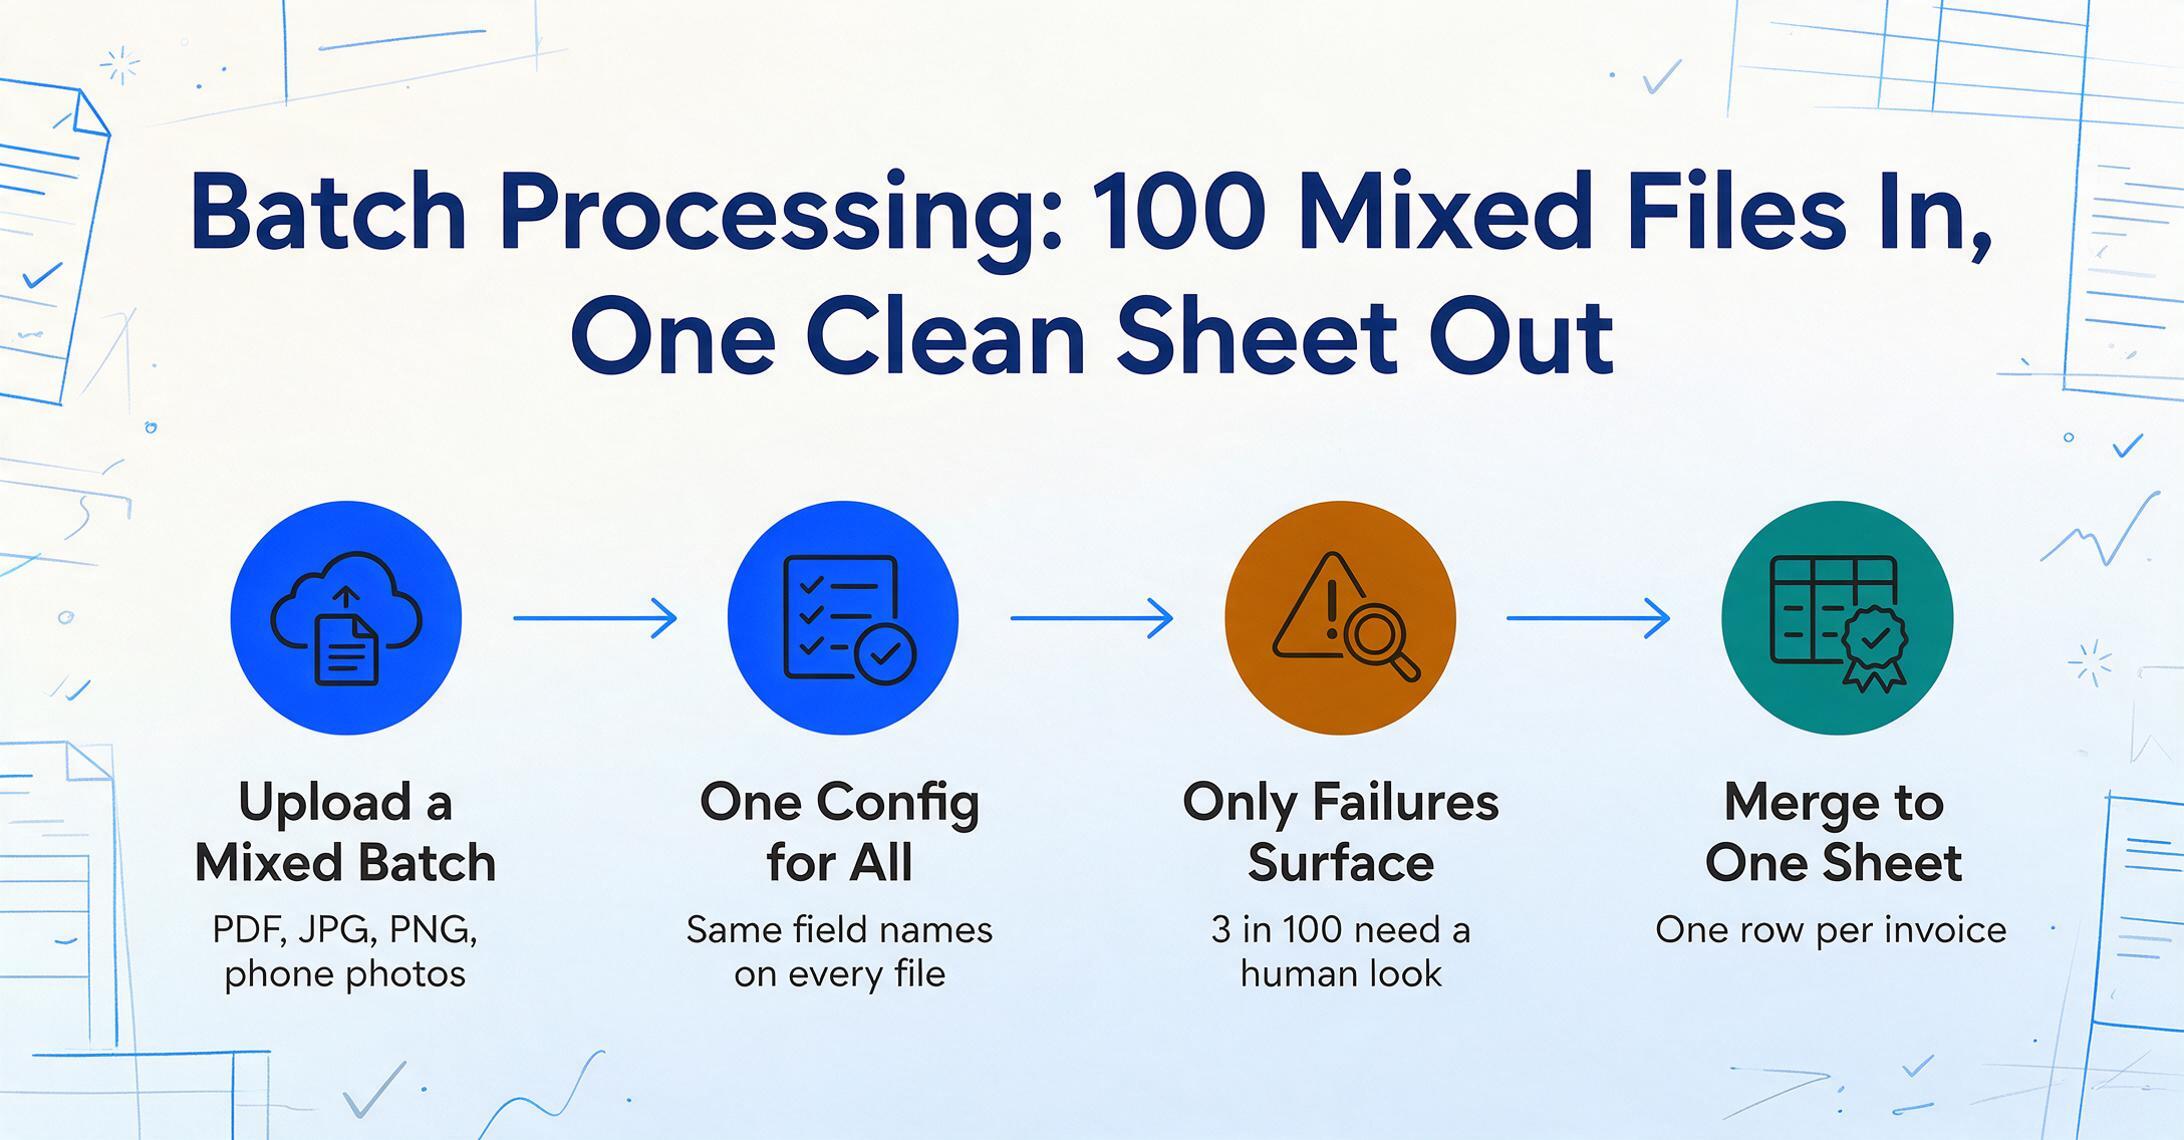
Processar uma fatura por vez ensina como funciona a ferramenta. Processar cem faturas de uma vez ensina se a ferramenta realmente funciona — porque o volume expõe falhas de design que as demos de documentos únicos escondem. O processamento em lote é a diferença entre uma extração que se adapta ao seu fluxo de trabalho e uma extração que exige que você construya um fluxo de trabalho ao redor dela.
Como Funciona Realmente o Processamento em Lote
O processamento em lote não é apenas "fazer a mesma coisa N vezes". É um pipeline específico: enviar N arquivos de fatura (que podem ser uma mistura de PDFs, JPGs, PNGs e fotos de celular) → a ferramenta processa todos com a mesma configuração de extração → os resultados são mesclados em um único arquivo de saída, uma linha por fatura (ou uma linha por item de linha, dependendo do modo de saída).
O que torna isso mais difícil que o processamento de documentos únicos:
- Heterogeneidade de formatos. Um lote de 50 faturas pode incluir 30 formatos de fornecedores diferentes. A extração baseada em modelos falha aqui porque você precisaria configurar 30 modelos antes de pressionar "processar". A extração com IA resolve isso porque as mesmas definições de campos funcionam em todos os formatos.
- Tipos de arquivo mistos. Algumas faturas chegan como PDFs limpos. Outras, como fotos de papel. Algumas, como documentos de várias páginas com ordens de compra e notas de entrega misturadas. O processador de lote precisa lidar com tudo isso sem uma classificação manual prévia dos tipos de arquivo.
- Manejo de falhas parciais. Em um lote de 100 faturas, 3 podem falhar na extração (digitalização ilegible, arquivo corrompido, formato que a IA não consegue analizar). A saída do lote deve incluir resultados para as 97 que tiveram sucesso, além de indicadores de erro claros para as 3 que falharam — não uma única mensagem de "lote falido" que exija recomeçar do zero.
- Rastreabilidade linha-a-origen. Em uma planilha mesclada com 500 linhas de 50 faturas, cada linha precisa referenciar seu arquivo de origem. Sem isso, encontrar o documento original para um valor suspeito significa combinar manualmente linhas com arquivos — o que anula o propósito do processamento em lote.
O pipeline de lote também interage com campos calculados e validação: em vez de executar a validação em uma fatura por vez, uma execução em lote aplica as mesmas regras de cálculo e verificações entre campos em todo o lote. Uma única regra de validação ("Total da linha = Quantidade × Preço unitário") detecta erros em todas as 50 faturas simultaneamente — o que é fundamentalmente diferente de abrir 50 resultados individuais e verificar cada um.
O que acontece depois que o lote termina
O resultado do lote — um único arquivo Excel ou JSON estruturado — é o ponto de partida, não o ponto final. Há três etapas pós-lote que transformam a extração bruta em dados de AP lançados:
1. Revisão de exceções. Sinalize linhas em que a validação falhou (totais de itens divergentes, campos obrigatórios ausentes, números de fatura duplicados). Essas vão para um humano para resolução. O restante — normalmente 85-95% do lote — flui sem intervenção manual. O objetivo não é zero exceções; é tornar as exceções fáceis de encontrar para que a etapa de revisão leve minutos em vez de horas.
2. Transformação de dados. Os dados extraídos raramente correspondem exatamente ao formato de importação do ERP. As datas podem precisar de reformatação (MM/DD/AAAA → AAAA-MM-DD). Os nomes de fornecedores podem precisar de normalização ("Sysco Corp" → "SYSCO-01" no cadastro de fornecedores). Os valores em moeda podem precisar de conversão. Se a ferramenta de extração exportar uma estrutura limpa e previsível (cada coluna tem um tipo de dados consistente, sem células mescladas, sem artefatos de formatação), essa transformação é uma operação de planilha de 5 minutos. Se a saída for bagunçada, a transformação vira um projeto separado de limpeza de dados.
3. Importação no ERP. O arquivo transformado entra no ERP via importação CSV, API ou integração de planilha (conforme abordado na seção de caminhos de integração acima). O tamanho do lote determina qual método faz sentido: importação CSV para menos de 200 faturas por mês, API para 200-1.000, integração completa de plataforma de automação de contas a pagar acima de 1.000.
Para um passo a passo do fluxo de trabalho de lote de ponta a ponta — do upload ao Excel mesclado — veja como extrair dados de faturas em lote para um único arquivo Excel. Para a estrutura de escalabilidade que combina volume com a abordagem de processamento correta, veja como escalar o processamento de faturas sem adicionar pessoal.
Perguntas Frequentes
Quanto tempo leva para configurar um fluxo de extração com IA?
Do zero ao primeiro resultado estruturado: 15 minutos. Faça upload de uma nota fiscal de teste, digite os nomes dos campos desejados (ex.: "Número da Nota", "Data", "Total") e baixe o Excel. O tempo de configuração é aprender a interface da ferramenta, não definir regras de extração — a extração por IA não exige modelos, mapeamento de campos ou treinamento de formato. O que leva mais tempo é integrar a saída ao seu fluxo existente: decidir quais campos extrair para cada tipo de nota, definir o processo de revisão pós-extração e conectar a saída à importação do seu ERP. Planeje uma tarde para a configuração inicial da extração e uma semana de operação paralela com seu processo atual antes de entrar em produção.
Posso extrair dados de fotos de notas fiscais em papel tiradas com o celular?
Sim, com ressalvas. A extração por IA funciona com fotos de celular — o modelo de visão lê o documento independentemente de como foi capturado. Mas a qualidade da foto afeta diretamente a precisão. Uma foto bem iluminada, plana, sem inclinação e com resolução adequada produz resultados comparáveis a um escaneamento. Uma foto escura, inclinada, com sombras e baixa resolução produz resultados piores. Para qualidade consistente de extração com fotos de celular: use boa iluminação, mantenha o celular paralelo ao documento (evite distorção de perspectiva), garanta que todos os quatro cantos da nota estejam visíveis e evite flash, que cria reflexos em papel brilhante. Se você processa grandes volumes de fotos de celular, considere pedir aos fornecedores que enviem PDFs por e-mail — isso elimina completamente a variável de qualidade da foto.
Preciso de suporte de TI para implementar a extração de notas fiscais?
Para o fluxo de baixar e importar (Caminho 1 acima): não. Você precisa saber fazer upload de arquivos em um site e baixar um arquivo Excel — as mesmas habilidades necessárias para usar Gmail e Google Planilhas. Para integração via API (Caminho 3): sim, você precisará de alguém que saiba configurar conexões de API entre a ferramenta de extração e seu ERP. Para o fluxo baseado em planilha (Caminho 2): geralmente não — a maioria das ferramentas com integração de planilha gerencia a conexão via OAuth (login com conta Google/Microsoft), o que não exige programação. Por que isso importa: um número significativo de avaliações de ferramentas de extração falha não porque a ferramenta não funciona, mas porque a dependência de TI para implementação cria um atraso de vários meses. Começar pelo caminho de baixar e importar — que exige zero de TI — permite que você comprove o valor e a precisão antes de envolver a TI para uma integração mais profunda.
Qual a diferença entre extração por IA e automação completa de AP?
A extração por IA responde a uma pergunta: "Quais dados estão nesta fatura?" Ela lê o documento e gera campos estruturados. A automação completa de AP abrange todo o ciclo de vida da fatura: extração + conciliação com PO + roteamento de aprovações + codificação contábil + agendamento de pagamentos + integração com ERP + trilha de auditoria. Ferramentas como Tipalti, Stampli e Medius são plataformas de automação de AP — elas incluem extração, mas seu valor está no gerenciamento de fluxos de trabalho. Ferramentas de extração por IA focam na captura de dados — geram dados estruturados e deixam as decisões de fluxo (aprovações, conciliação, pagamento) para seus processos existentes e ERP. Para equipes com menos de 1.000 faturas por mês, uma ferramenta de extração independente combinada com o ERP atual costuma ser suficiente. Acima desse volume ou com hierarquias de aprovação complexas, a automação completa de AP pode ser o melhor investimento.
A extração consegue lidar com faturas em PDFs de várias páginas misturadas com outros documentos?
Depende da ferramenta. Algumas processam um documento por upload — esperam que cada PDF seja uma fatura única. Se você enviar um PDF de 50 páginas com 12 faturas, 8 POs, 15 recibos de entrega e 5 capas aleatórias, a ferramenta pode processar apenas a página 1 e ignorar o resto, ou tentar extrair campos de todas as páginas e gerar lixo. Ferramentas que suportam processamento em lote e divisão de documentos com várias páginas detectam limites entre documentos (ex.: uma nova fatura começa quando um novo cabeçalho aparece) e extraem cada documento separadamente. Se suas faturas chegam frequentemente em PDFs agrupados, verifique se a ferramenta de extração suporta divisão de páginas antes de contratar — essa é uma falha comum que não aparece em demonstrações com arquivos limpos de fatura única.
Os dados extraídos são seguros? O que acontece com as faturas após o processamento?
As práticas de segurança variam, mas há padrões comuns. Ferramentas confiáveis processam faturas em memória durante a extração e as excluem de seus servidores depois — o documento é usado para a extração e descartado. Os arquivos são transmitidos via HTTPS (criptografados em trânsito) e nunca armazenados permanentemente, a menos que você escolha uma ferramenta que ofereça arquivamento de documentos como recurso. Para dados sensíveis de faturas — dados bancários de fornecedores, preços, termos contratuais — verifique a política de retenção de dados da ferramenta antes de enviar documentos reais. As perguntas-chave: (1) Os arquivos são excluídos após o processamento? (2) Se armazenados, por quanto tempo e onde? (3) Os dados são usados para treinar o modelo de IA? (4) Existe um acordo de processamento de dados que atenda aos requisitos de privacidade da sua jurisdição? A maioria das ferramentas voltadas para empresas aborda esses pontos em sua página de segurança ou termos de serviço.
A extração por IA consegue lidar com faturas com itens de linha manuscritos ou anotações nas margens?
Sim, com uma ressalva: depende do que "manuscrito" significa na prática. Os modelos de visão por IA leem escrita à mão com 85-95% de precisão em nível de campo para escrita clara e legível em resolução razoável (300+ DPI). Isso cobre a maioria das anotações de motoristas de entrega, ajustes manuais de preço e anotações nas margens de faturas de fornecedores. Onde a precisão cai: letra cursiva que até um humano pausaria para ler, fotocópias de múltiplas gerações onde a escrita perdeu contraste, e escrita sobreposta a texto impresso ou carimbos. A abordagem prática: configure a extração para capturar tanto o campo impresso quanto tentar a versão manuscrita como uma coluna separada. Então o revisor vê a discrepância e decide qual valor está correto — o que ainda é mais rápido do que inserir ambos manualmente. Para fluxos de trabalho com muitas faturas manuscritas, como faturamento de empreiteiros comerciais, veja extração de faturas manuscritas para empreiteiros.
Como a extração lida com faturas em múltiplas moedas?
Os modelos de visão por IA leem símbolos e códigos de moeda (€, £, ¥, $, USD, EUR) como parte do campo. O desafio não é reconhecer a moeda — é que a moeda determina a convenção decimal, o que muda o valor numérico. Faturas europeias usam vírgula como separador decimal (1.234,56 €) enquanto faturas dos EUA usam ponto ($1.234,56). Uma extração que lê "1.234" como mil duzentos e trinta e quatro em uma fatura europeia produz números 100x maiores na melhor das hipóteses, ou gera um erro na pior. Ferramentas que lidam corretamente com extração em múltiplas moedas separam a detecção de moeda da análise numérica — primeiro identificando o contexto da moeda, depois aplicando a convenção decimal/de milhares correta antes de gerar o valor numérico. Isso é requisito básico para qualquer equipe que processe faturas de fornecedores transfronteiriças. Para mais sobre os desafios de formato, veja extração de dados de faturas internacionais entre moedas e formatos.
O que acontece se a IA cometer um erro em um campo — isso afeta os outros campos?
Não. A extração por IA processa cada campo de forma independente — ela localiza o Número da Fatura, Nome do Fornecedor, Data, Itens de Linha e Total entendendo o que cada campo significa semanticamente, não lendo sequencialmente a página. Uma leitura incorreta no Nome do Fornecedor não se propaga para um Total errado porque os campos não são encadeados. Essa é uma diferença fundamental em relação à extração baseada em modelos, onde um único deslocamento de coordenada (porque o modelo está levemente desalinhado) pode fazer todos os campos subsequentes puxarem valores errados. Dito isso, há uma exceção: colunas calculadas que dependem de valores extraídos. Uma Quantidade lida incorretamente faz o Total do Item também ficar errado — então o mesmo princípio de independência se aplica: verifique os campos de origem e confie nos derivados.
Preciso criar um modelo para o formato de fatura de cada fornecedor?
Não com a extração por IA. Ferramentas baseadas em modelos exigem um modelo separado para cada formato de fornecedor (e retrabalho quando o fornecedor muda o formato), por isso só são práticas com uma lista pequena e estável de fornecedores. A extração por IA funciona de forma diferente: você define os campos que deseja (ex.: "Nº da fatura", "Data", "Total") uma única vez, e a IA localiza cada campo em qualquer fatura de qualquer fornecedor entendendo o significado do campo — não olhando para uma coordenada fixa. Uma configuração de campos funciona em 100 formatos diferentes de fornecedores. O fator limitante não é o tempo de criação de modelo; é se sua ferramenta de extração usa correspondência por coordenadas (que exige modelos) ou correspondência semântica (que não exige). Essa distinção — sem modelo vs. baseado em modelo — é o maior determinante para saber se uma implementação de extração terá sucesso ou estagnará em escala.
A extração consegue calcular Quantidade × Preço unitário se a fatura mostrar apenas um deles?
Sim, se dois dos três valores (Quantidade, Preço unitário, Total do item) estiverem presentes. A IA extrai o que está impresso, e uma coluna calculada deriva o valor ausente: se apenas Quantidade e Total do item forem exibidos, Preço unitário = Total do item ÷ Quantidade. Se apenas Preço unitário e Total do item forem exibidos, Quantidade = Total do item ÷ Preço unitário. O cenário mais comum — Quantidade e Preço unitário impressos, mas sem Total do item — é resolvido diretamente com Total do item = Quantidade × Preço unitário. Isso não é uma etapa de cálculo separada após a extração; acontece durante a extração e o resultado aparece como uma coluna própria na planilha de saída. O caso limite é quando apenas um dos três valores é exibido (ex.: apenas um total do item sem detalhamento de quantidade ou preço unitário) — então não há nada a calcular e a extração retorna o que estiver disponível.
Teste a extração nas suas próprias faturas. Sem configuração, sem modelos.
Testar Extração de Faturas