請求書データ抽出の完全ガイド
(2026)
請求書データ抽出とは、請求書に含まれる情報(ベンダー名、金額、明細行、日付、税務IDなど)を、並べ替え、フィルタリング、インポート、分析できる構造化された行と列に変換することです。単純に聞こえますが、実際はそうではありません。これには根本的に異なる3つの方法があり、それぞれに初期設定コスト、精度の上限、スケーラビリティの限界があります。この請求書データ抽出の完全ガイドでは、その3つの方法すべてを解説し、実際に抽出すべきフィールドを説明し、請求書の量、フォーマットの複雑さ、データの送信先に基づいて適切なアプローチを選択するための判断フレームワークを提供します。
請求書データ抽出とは — そして、なぜ多くのチームが今も手作業で行っているのか
請求書データ抽出とは、請求書ドキュメント(PDF、スキャン画像、写真)から情報を取得し、Excel、CSV、JSONなどの構造化データ形式に変換するプロセスです。抽出される情報には通常、請求書ヘッダー(番号、日付、ベンダー、合計)と明細行(数量、説明、単価、行合計)が含まれます。出力はテーブル形式で、各行が1つの請求書または1つの明細行、各列が1つのデータフィールドに対応します。
これが重要な理由:業界データによると、HighRadiusの2025年AP自動化統計によれば、68%の企業が今も請求書データをERPや会計システムに手入力しています。手入力は1件あたり約$15の労力コストがかかり、1ドキュメントあたり3〜5分を要し、一貫して2〜5%のエラー率が発生します。月500件の請求書の場合、労力コストは$7,500、30日ごとに10〜25件のエラーが発生します — これらのエラーは誤った支払い、誤ったGLコード付与、そして元の入力よりもコストがかかる照合作業へと連鎖します。
代替手段である自動抽出は、何年も前から可能でした。しかし、テクノロジーの進化があまりに速く、3年前の最先端(テンプレートベースOCR)は現在ではレガシーな手法となり、今日の最先端(AIによる意味抽出)は、従来の世代では扱えなかったドキュメントタイプやフォーマットに対応しています。3つの方法 — それぞれの内容、コスト、限界 — を理解することは、機能するツールを選ぶか、6ヶ月間の失敗する導入に費やすかの違いを生みます。自動化が利用可能であるにもかかわらず手入力が続く背景については、APチームが今も請求書データを手で入力する理由をご覧ください。
3つの方法 — 手入力、テンプレートベースOCR、AIによる意味抽出
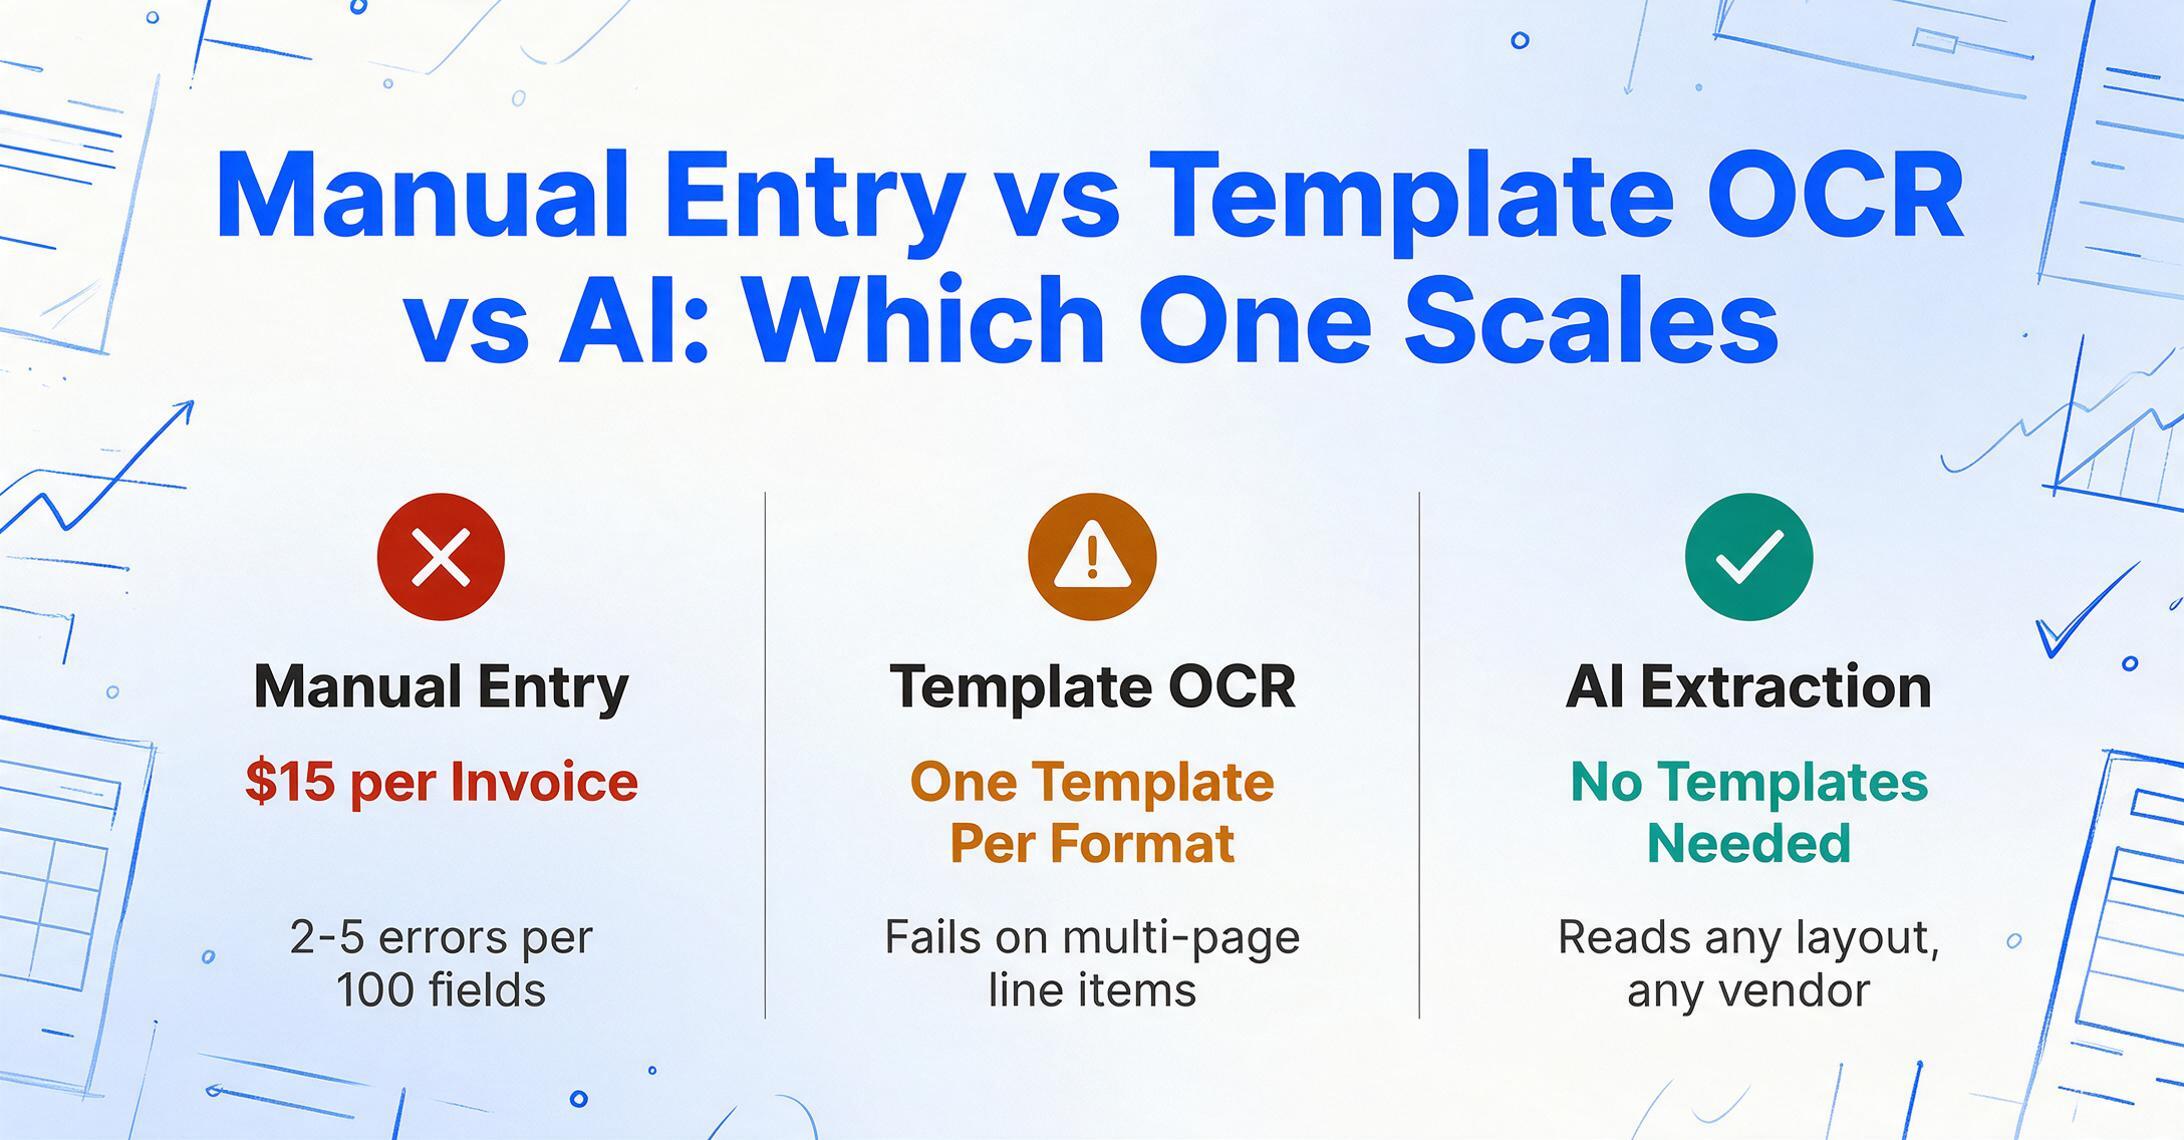
請求書データ抽出のアプローチは、すべて3つのカテゴリに分類されます。これらは同等ではありません。それぞれ精度の上限、導入コスト、拡張性の限界が異なります。適切な選択は、請求書の件数とフォーマットの組み合わせによって決まり、どの方法が最も先進的かに基づくものではありません。テンプレート不要の抽出を実際に試すには、列名抽出を使用した請求書処理ワークフローをご覧ください。
方法1: 手入力
概要: 担当者が各請求書PDFを開き、フィールドを読み取って、スプレッドシートやERPに入力します。必要なテクノロジーはPDFビューアとExcelのみです。
コスト: 完全負荷の人件費で請求書1件あたり約15ドル(Quadientの2025年AP自動化ベンチマークによる)。月100件の場合:月1,500ドル。月1,000件の場合:月15,000ドル — データ入力専任のAP担当者1名分にほぼ相当します。
精度: 注意深い担当者の場合、フィールドあたり95〜98% — つまり100フィールドあたり2〜5件のエラーです。これらは転記ミスです:数字の桁違い、手書きの読み間違い、小数点の位置ミス。特に、人間が数字を転記する際に生じる誤りは、システム上は正しく見える間違った値になります。AIがフィールドを見逃すと空白が生じますが、これは目に見えるため安全です。
適しているケース: 月50件未満の場合、またはすべての請求書が異なるベンダーからの独自フォーマットであり、自動化システムの導入コストが人件費を上回る場合。また、入力担当者がベンダー関係やコーディングルールについて深い文脈知識を持っており、自動化システムが数か月のトレーニングなしでは再現できない場合も該当します。
破綻するケース: 月200件を超えると、エラー率は処理量よりも速く悪化します。50件では正確だった担当者も、200件になるとミスをし始めます。反復的な転記作業の最初の1時間を過ぎると、認知的疲労が生じるためです。具体的なミスとそのコストについては、最もコストがかかる請求書データ入力の6つのミスをご覧ください。
方法2:テンプレートベースOCR
概要:光学文字認識(OCR)ソフトウェアが請求書画像からテキストを読み取り、テンプレートが各フィールドの位置を指定します(「請求書番号は座標x:420、y:180にあります」)。ベンダー形式ごとに1つのテンプレートを作成します。OCRエンジンが文字を読み取り、テンプレートがそれらをフィールドにマッピングします。
コスト:OCRソフトウェアは、無料(Tesseract)から1ページあたり$0.01〜0.05(AWS Textract、Google Document AIなどのクラウドAPI)、パッケージツールで月額$30〜300まで幅があります。隠れたコストはテンプレートのメンテナンスです。新しいベンダー形式ごとに新しいテンプレートが必要になり、ベンダーのレイアウト変更があれば既存のテンプレートが壊れます。100社以上のベンダーを持つ組織でテンプレートベースOCRを利用する場合、通常、月に5〜10時間をテンプレートのメンテナンスに費やします。
精度:テンプレートが想定する正確な位置にある印刷テキストでは95〜99%。手書きコンテンツ、スタンプ、注釈、またはレイアウトのバリエーションがある場合は70%未満に低下します(PDFExcelによる非標準請求書のOCR精度分析による)。ページレベルの精度が99%でも、OCRエラーが財務上重要なフィールドに集中すると、フィールドレベルの精度は70%になることがあります。
適しているケース:形式が一貫した少数で安定したベンダーセットから大量の請求書を処理する場合です。たとえば、同じ15社の原材料サプライヤーから毎週請求書を受け取るメーカーなどです。15のテンプレートを一度作成し、四半期ごとにメンテナンスし、数千件の請求書を処理します。
機能しなくなるケース:ベンダー数が多い、または変化している場合です。ベンダーが会計ソフトを切り替えて請求書レイアウトが変わった場合。請求書に手書きのメモ、多言語コンテンツ、スタンプ、または不規則なテーブルが含まれる場合。テンプレートOCRは既知の形式には信頼性がありますが、未知の形式には脆弱です。そしてAPでは、未知の形式が標準であり、例外ではありません。LlamaIndexによる実世界の請求書のばらつきの分析が示すように、標準的な請求書というものは存在しません。
方法3:AIによる意味抽出
概要:視覚言語モデルが人間のように請求書を読み取ります。レイアウトを認識し、どのラベルがどの値に対応するかを理解し、固定位置ではなく意味的な意味に基づいてフィールドを抽出します。座標ではなくフィールド名(「請求書番号」「合計金額」「ベンダー名」)で抽出したい項目を指定します。AIは、項目がどこにあるかではなく何であるかを理解することで、ページ上のどこにあっても各フィールドを特定します。
コスト:APIベースのサービスでは通常1ページあたり$0.05〜0.30、Webインターフェースとバッチ処理を含むパッケージツールでは月額$20〜50です。テンプレートのメンテナンスコストは不要です。同じ設定がどのベンダーのフォーマットでも機能します。
精度:鮮明な印刷請求書ではフィールド精度97〜99%、手書き注釈付きの請求書では88〜95%、完全手書き文書では75〜90%です。ばらつきはツール自体よりも文書品質(スキャン解像度、カラーか白黒か、傾き補正)に依存します。請求書タイプ別の精度の詳細と、ご自身の文書での測定方法については、AI抽出精度の実践ガイドをご覧ください。
適しているケース:複数のベンダーから多様なフォーマットの請求書を月100枚以上処理する場合。手書きのメモ、多言語文書、不規則なレイアウトが混在する場合。数量と単価を含む明細行の抽出が必要な場合——テンプレートOCRは複数ページにまたがる表や列数が可変の表を苦手とします。
限界:請求書が著しく劣化している場合——4世代目のコピー、72 DPIのFAX画像、悪い照明で斜めから撮影した写真など。どの抽出方法でもうまく処理できませんが、AIはOCRがノイズを返すだけの状況でも文脈から推測できるため、より優雅に劣化します。また、AIが持っていない外部知識を必要とするフィールドが請求書に含まれる場合(例:特定の明細行をどのコストセンターにコード化すべきか——これはGLコード付与の判断であり、抽出の問題ではありません)。
AI抽出カテゴリ内の特定ツールの比較 — ITサポートなしで使えるもの、明細行を処理できるもの、バッチ処理に対応しているものなどについては、財務チーム向けAI請求書抽出ツールの比較をご覧ください。
実際に必要なフィールド — ヘッダー、明細行、計算、コンプライアンス
すべての請求書フィールドを抽出する必要はありません。ワークフローにとって重要なデータのカテゴリを理解することで、過剰指定(抽出が遅くなりエラーが増える)や過少指定(後で再抽出が必要になる)を防げます。
ヘッダーフィールド — 常に抽出。 これらは取引を識別し、請求書ごとに1回表示されます:請求書番号、請求日、支払期日、仕入先名、合計金額、税額、通貨、PO番号。これらが最小限の抽出セットです。すべての請求書ワークフローで、支払い処理とERPインポートに必要です。ヘッダーフィールドの欠落や誤りは最もコストのかかるエラーを引き起こします。請求書が誤った承認経路、誤った支払い金額、または誤った会計期間にルーティングされるからです。
明細行 — コスト配分が必要な場合に抽出。 各明細行は請求書テーブルの1行です:説明、数量、単価、行合計、および任意でSKU、税率、勘定科目コード。明細行の抽出は、コストセンター間で請求書を分割する必要がある場合(行1は部門A、行2は部門B)、製品カテゴリ別の支出を追跡する場合、または単価が契約と一致するかを検証する場合に重要です。明細行の抽出はヘッダー抽出よりも技術的に困難です。テーブルの列が可変で、ページをまたいで分割され、不整合なフォーマットを使用するためです — 1ページ目のテーブルは5列でも、2ページ目は6列の場合があります。テンプレートベースOCRは明細行で頻繁に失敗します。AI抽出はテーブル構造を幾何学的ではなく意味的に読み取るため、明細行を処理できます。
計算フィールド — 文書に必要な数値が表示されていない場合に抽出。 必要な値の中には請求書に印刷されていないものがあります。税込合計のみが表示されている請求書の税抜小計。数量と単価のみが表示されている場合の明細行合計。請求金額と契約レートの差。列名計算 — 「小計(合計 − 税額)」や「行合計(数量 × 単価)」のようにフィールド名に計算ロジックを記述する方法 — は、AIに読み取れるフィールドから欠落値を計算するよう指示します。これにより、抽出(存在するものを見つける)が導出(存在するものから必要なものを計算する)に変わります。
コンプライアンスフィールド — 規制で要求される場合に抽出。 これらは国によって異なります:EU請求書のVAT番号、オーストラリア請求書のABN、インド請求書のGSTIN、米国1099申告用のサプライヤー税務ID。コンプライアンスフィールドの欠落や誤りは支払いを妨げませんが、下流の税務申告に問題を引き起こします — 誤ったTINで提出された1099はIRS通知を生成し、サプライヤー登録が欠落したVAT申告は監査照会を引き起こします。これらのフィールドは、該当するすべての抽出設定に最初から含めるべきであり、税務シーズン中の後付けとして追加するものではありません。
あなたの状況に合う方法は?— 判断のフレームワーク
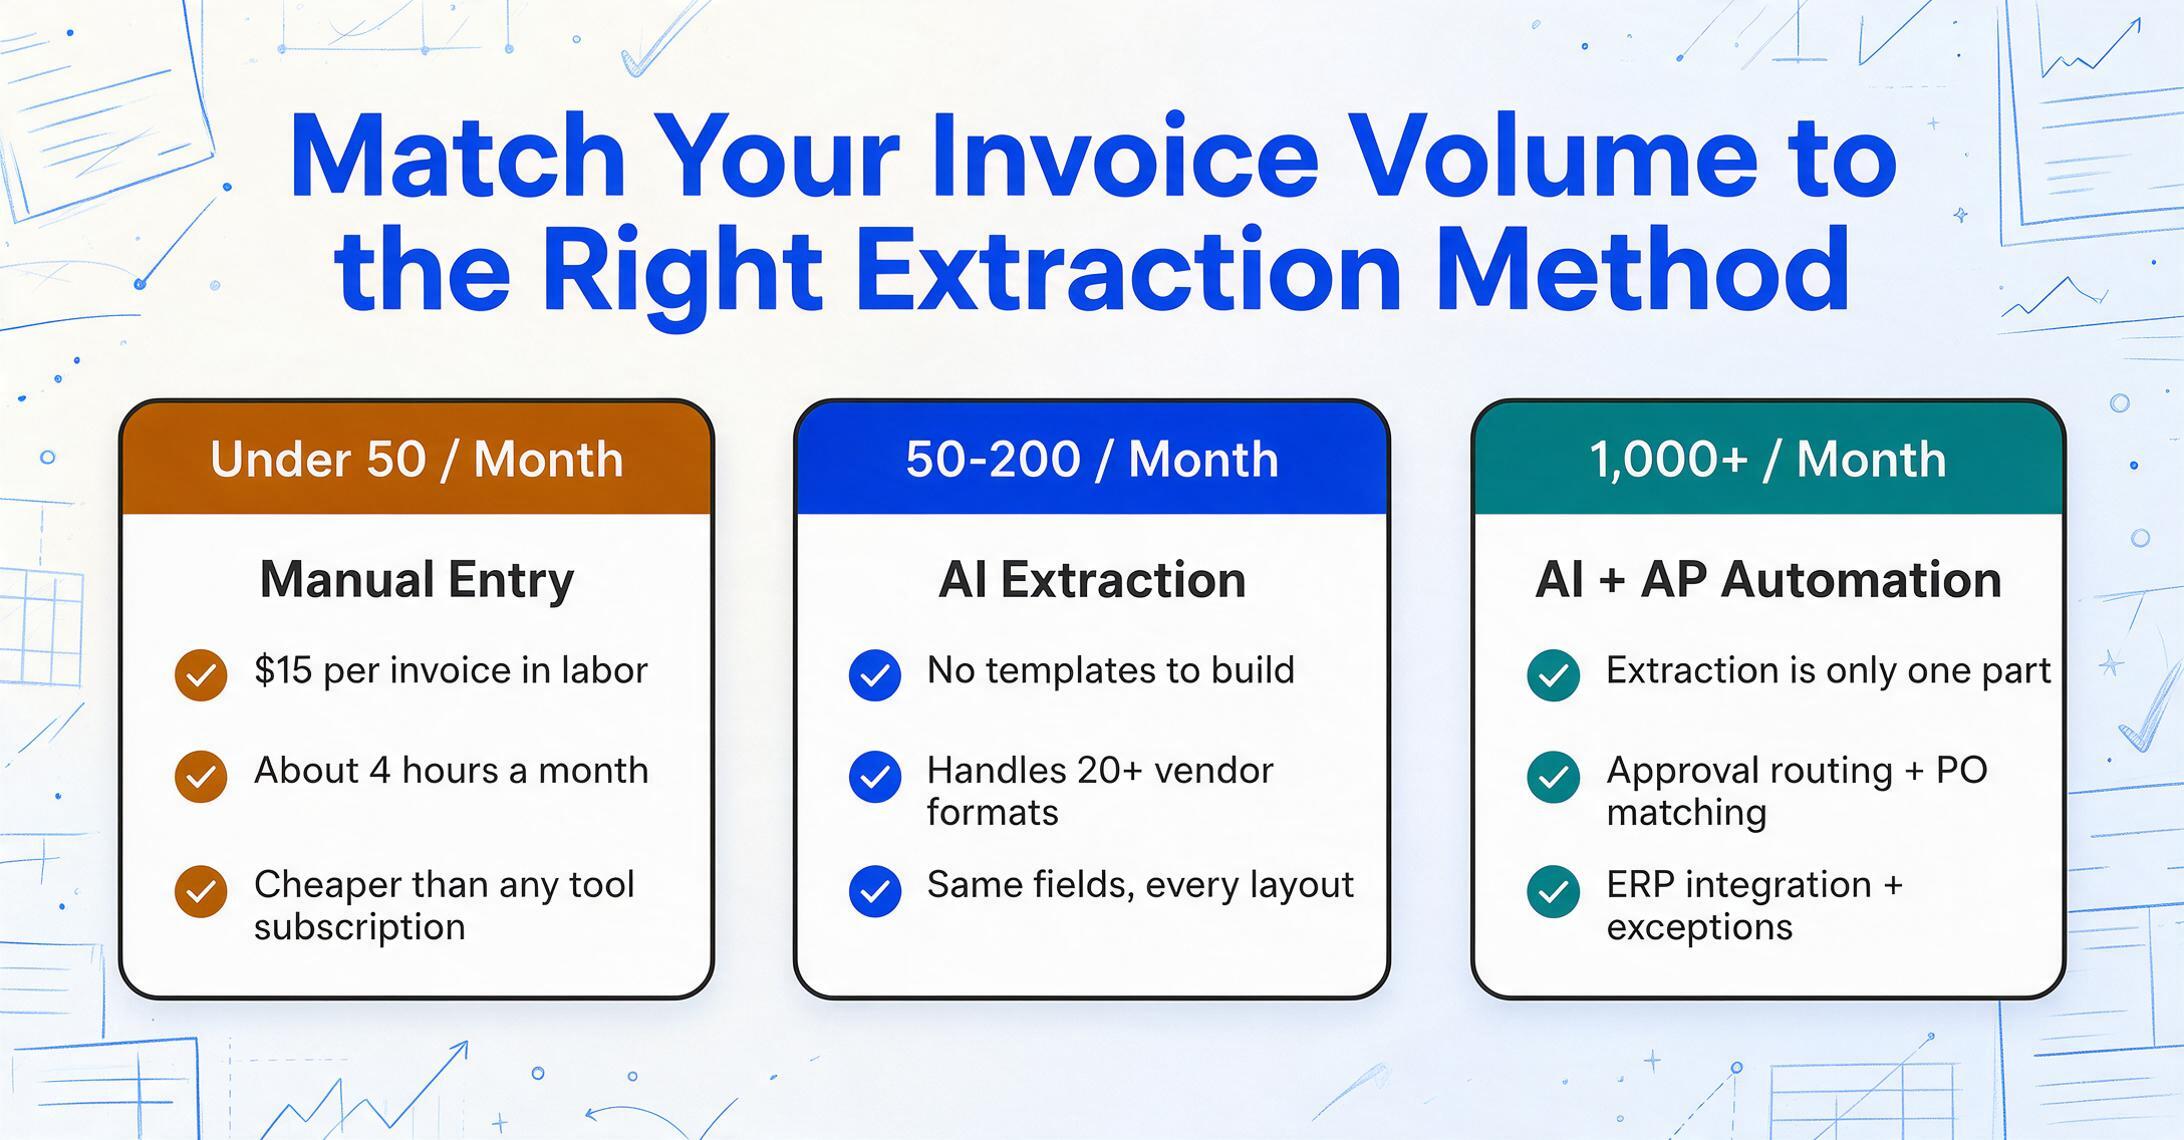
最適な抽出方法とは、最も高度な方法ではありません。コストと複雑さが、あなたの処理量とフォーマットの組み合わせに合っている方法こそが最適です。ここでは、成功と失敗を実際に左右する要素に基づいた判断ロジックをご紹介します。
| あなたの状況 | 最適な方法 | 理由 |
|---|---|---|
| 月50件未満、フォーマット多様 | 手入力 | この処理量では、自動化システムの導入コストが人件費を上回ります。1人で月50件(約4時間)を処理する方が、ツールのサブスクリプション費用と学習時間を合わせたコストより安価です。 |
| 月50〜200件、フォーマット多様 | AI抽出 | 20以上のベンダーフォーマットにテンプレートOCRを設定する時間は、AIツールのサブスクリプション費用を上回ります。AIはテンプレート管理なしでフォーマットのばらつきに対応できます。 |
| 月200〜1,000件、安定したベンダーフォーマット20未満 | テンプレートOCRまたはAI | ベンダーリストが安定しフォーマットが一貫している場合、テンプレートOCRはページ単価を抑えつつ高い精度を実現します。フォーマットにばらつきがある場合は、AIがテンプレート管理の負担を回避します。 |
| 月200〜1,000件、ベンダーフォーマット50以上 | AI抽出 | 50以上のテンプレート管理は、それ自体がパートタイムの仕事です。AIはベンダーごとの設定なしでフォーマットの多様性に対応します。処理量に基づく判断ロジックの詳細はスケーリングフレームワークをご覧ください。 |
| 月1,000件以上、フォーマット構成問わず | AI抽出+AP自動化 | この処理量では、抽出はワークフローの一部にすぎません。承認ルーティングの自動化、PO照合、ERP連携、例外処理も必要です。スタンドアロンのAI抽出ツールはデータ取得を担い、フル機能のAP自動化プラットフォーム(Tipalti、Stampli、Rossum)は請求書ライフサイクル全体を管理します。 |
| 手書き請求書、処理量問わず | AI(VLMベース) | テンプレートOCRは手書き文字では70%を下回ります。VLMは意味的文脈の中で文字形状を理解することで手書き文字を読み取ります。高解像度スキャン(400〜600 DPI、カラー)が不可欠です。 |
| 多言語・越境請求書 | AI(VLMベース) | 視覚言語モデルは言語をまたいで意味的に読み取ります。英語で学習されたテンプレートOCRは、日本語のラベル、フランス語の日付形式、ヨーロッパの小数点表記に苦戦します。 |
最も重要な閾値は50〜200枚の請求書の範囲です。50枚未満であれば、手入力はどの自動化よりも実際に安価で簡単です。200枚を超えると、エラー修正コストを数える前から、直接の人件費だけで手入力はAI抽出よりもコストがかかります。中間帯(50〜200枚)では、判断はあなたの特定のフォーマット構成と、抽出ツールの設定と学習に午後を費やせる担当者がいるかどうかに依存します。
ファイルは安全に処理され、保存されません。
抽出後はどうなるか — スプレッドシートからERPへ
抽出によってデータが文書から取り出されます。それを会計システムに取り込むのは別のステップです — そして、データが構造化されているもののERPへの接続が確立されていないことにチームが気づき、多くの抽出実装がここで停滞します。統合パスは4つあり、最もシンプルなものから最も自動化されたものの順に並んでいます:
パス1:ダウンロードしてインポート。 抽出ツールがExcelまたはCSVを出力します。ファイルをダウンロードして検証し、ERPのネイティブインポート機能を使用してERPにインポートします。これはすべてのERP(SAP、Oracle、NetSuite、QuickBooks、Xero、Sage、Microsoft Dynamics)で機能します。CSVインポートは普遍的だからです。ITの関与は一切不要です。コストは手動のダウンロード・インポートステップで、バッチ内の請求書の枚数に関係なく、バッチごとに2〜5分かかります。これは月1,000枚未満を処理するほとんどのチームにとって正しいパスです。
パス2:スプレッドシート直接統合。 抽出ツールがAPIを介してGoogle SheetsまたはExcel Onlineに直接データを書き込みます。スプレッドシートが抽出とERPの間の仲介役になります — ツールがシートに行を追加し、別の統合(Zapier、Make、または組み込みのERPコネクタ)がシートからERPに読み取ります。これによりダウンロードステップが不要になり、財務チームがすでに使用している形式でデータを確認できるようになります。特にGoogle Sheetsユーザー向けに、一部の抽出ツールはサイドバーアドオンを提供しており、スプレッドシートから離れることなく請求書をアップロードして抽出データを取得できます。
パス3:API統合。 抽出ツールがAPIを介して抽出データをERPに直接送信します。これには、抽出ツールとERPの両方に互換性のあるAPIがあり、誰か(通常はITまたは統合コンサルタント)が接続を設定する必要があります。一度設定すれば、抽出 → 検証 → ERPインポートは最小限の人的介入で実行されます。検証に合格した請求書は自動的に転記されます。不合格のものはレビュー用にフラグが立てられます。このパスは月1,000枚を超える場合、または手動インポートステップがワークフローのボトルネックになっている場合に適しています。
パス4:受信ドキュメント用のコレクションリンク。コレクションリンクとは、サプライヤー、クライアント、チームメンバーが登録やログイン、メールのやり取りなしで、請求書を直接抽出キューにアップロードできる共有可能なURLです。相手はリンクを開き、短い確認コードを入力してファイルをアップロードします。ファイルは処理パイプラインに届きます。これにより、抽出が「ドキュメントを集めてから抽出する」から「ドキュメントが抽出キューに集められた状態で届く」へと変わります。時間に追われる中で複数のソースから請求書を収集する必要がある監査準備のシナリオについては、監査シーズン準備ガイドをご覧ください。
もう1つの受信チャネルはメールです。コレクションリンクは追跡が必要なドキュメントをカバーしますが、ほとんどの請求書は添付ファイルとして自動的に届きます。専用の受信トレイアドレスを使えば、そのストリームを同じキューに変換できます。サプライヤーやクライアントと1つのアドレスを共有すると、各添付ファイルが自動的に処理キューに届きます。自動処理をオンにして、受信トレイにバインドしたいフィールドを設定すると、メールが届いた瞬間に抽出が開始され、送信者ホワイトリストが無関係なメールを除外し、保存されたパスワードにより保護されたPDFを誰もパスワードを入力せずにロック解除できます。結果はコレクションリンクと同じです。ドキュメントは事前に集められた状態で届き、誰も手動でファイルを転送したりアップロードしたりする必要はありません。
さらに詳しく — 特定のニーズに応える主要トピック
請求書データ抽出は、複数の専門ワークフローと交差します。以下の記事では、各分野についてさらに詳しく説明します。
| 請求書データ抽出とは?仕組みと重要性 | 入門レベルの定義 — この概念に初めて触れる方は、手法やツールの詳細に入る前に、まずここから始めてください。 |
| APチームが今も請求書データを手入力する理由 | 数十年にわたる自動化にもかかわらず手入力が残り続ける構造的な理由 — そして「より良いERP」が答えではなかった理由。 |
| 財務チーム向けAI抽出ツール比較 | 技術的アプローチによる横並び比較 — ITサポートなしで使えるツール、明細行の処理、バッチ処理対応の有無を確認できます。 |
| 人員を増やさずに請求書処理をスケールする方法 | プロセス最適化・自動化・採用の判断基準を、処理量の転換点ごとに整理した意思決定フレームワーク。 |
| コストが最も大きい請求書入力ミス6選 | 目に見えるミス(転記ミス、重複)と見えないミス(GLコード付与、税区分)— エラーごとのコスト内訳付き。 |
| AI請求書抽出の実践的な精度ガイド | 「99%の精度」がマーケティング上の数値である理由、フィールドレベルの精度の実際の意味、半日で実施できる独自の精度テストの方法。 |
| 監査シーズン:時間がないときの請求書データ準備 | 監査まで数週間しかない場合の緊急トリアージ体制 — 優先すべき項目と省略すべき項目を解説。 |
高度なフィールド抽出:計算列とフィールド間検証
請求書に印刷されている内容を抽出する次のレベルは、実際に必要なものを抽出することです。これは必ずしも同じものではありません。請求書に税抜きの内訳なしで小計$1,247.83が表示されている場合、GLコード付与には税抜き金額が必要です。数量と単価はあるが行合計がない15の明細行がリストされているかもしれません。明細行の合計と一致しない総計が表示され、支払いを転記する前にどちらの数値が間違っているかを知る必要があるかもしれません。
これらはエッジケースではありません。これらは日常的な請求書処理の問題であり、抽出を1ステップの読み取りから、検証と計算を伴う複数ステップのワークフローに変えます。これをうまく処理するツールは、単にテキストを読み取るだけのツールとは一線を画します。
計算列 — 抽出値だけでなく計算結果
計算列とは、文書上の値を単に特定するだけでなく、抽出した1つ以上の値に対して計算を実行し、その結果をスプレッドシートの独自の列として出力する、ユーザーが定義するフィールドです。最もシンプルで一般的な例は、行合計 = 数量 × 単価です。多くの請求書には数量と単価とともに行合計が印刷されていますが、印刷されていない場合(または印刷された行合計が間違っている場合)、計算列が抽出した値を掛け合わせてギャップを埋めます。
この機能は基本的な算術をはるかに超えて拡張されます。同じメカニズムで以下を処理できます:
- 小計の欠落:請求書に税込総額のみが表示されている場合。計算列は
小計 = 総額 − 税額を導出し、別途計算機を使わずにGLコード付与のための税抜き金額を提供します。 - 明細行レベルの検証:数量と単価を別々に抽出し、
期待行合計 = 数量 × 単価を計算します。印刷された行合計と比較します。不一致列は、ERPに到達する前に差異をフラグ付けします。 - 請求書レベルの照合:すべての計算行合計を合計し、印刷された小計と比較します。差がゼロでない場合、何かが間違っています — 明細行が誤って読み取られたか、ヘッダーの小計が誤って印刷されたかのいずれかです。どちらにしても、支払い前に検出できます。
- 条件付きロジック:
Discount Flag = IF(Line Total > $500, "Review", "OK")— 抽出中にビジネスルールを適用して、出力が自動転記できるものと注意が必要なものをすでに分類します。 - レート参照:計算ルールに固定税率(例:NYCの8.875%)を組み込みます。AIは文書のどこにも税率が表示されなくても、すべての行にそれを適用します。
ここでのアーキテクチャ上の変化は重要です。抽出は、そこにあるものを純粋に読み取ることから、読み取りと導出を組み合わせた操作になります。生データを抽出してからExcelを開いて計算、ピボット、検証する代わりに、抽出から得られた同じテーブルで計算結果が得られます — 3ステップではなく1ステップです。計算列メカニズムの完全な詳細な説明については、計算された合計による明細行抽出の仕組みをご覧ください。
フィールド間検証 — 手作業レビューなしでエラーを検出
フィールド間検証とは、抽出された値が内部的に整合しているかを数学的に確認するプロセスです。「明細行を合計すると小計になるか?税率を適用すると税額になるか?小計に税を加えると総額になるか?」という問いに答えます。
これらのチェックは決定的です — 合格か不合格かのどちらかであり、判断は不要です。そして、最も危険なタイプの抽出エラーを検出します。それは、単独では正しく見えるが、組み合わせると整合しない値です。明細合計の桁の入れ替え($1,247 が $1,274 として抽出された場合)は、三者照合を通過するかもしれません。しかし、Σ(数量 × 単価) ≠ 小計 は即座に検出します。
実務上重要な3つの検証レベル:
| 検証レベル | チェック内容 | 検出できるエラー |
|---|---|---|
| 明細行レベル | 数量 × 単価 = 明細合計 | 数字の誤読、数量と単価の入れ替え、導出されるべき明細合計の欠落 |
| 請求書レベル | 明細合計の合計 + 税 = 総額 | 明細行の欠落、重複抽出、税の誤分類、丸め誤差 |
| 文書間レベル | PO合計 − 既請求額 = 残高 | 重複請求書の検出、過大請求、部分納品の追跡エラー |
すべての抽出ツールが計算列とフィールド間検証をネイティブにサポートしているわけではありません。特にテンプレートベースのツールはここで苦戦します — 座標にあるものを抽出することはできても、結果に対して算術演算を行うことはできません。検証ステップは、電卓を使う人間か、別のExcel照合プロセスに委ねられることになります。月に100件以上の請求書を処理している場合、実際の時間の浪費は初期データ入力ではなく、この手動検証ステップにあります。お客様のドキュメントにおける抽出精度とその測定方法についてさらに詳しく知りたい場合は、実践的な精度ガイドでフィールドレベルの検証方法論を解説しています。
業界別の請求書バリエーション — それぞれのタイプの違いとは
標準的な商用請求書 — ベンダー名、日付、明細行、合計 — が基準となります。しかし、ビジネスで商用標準から外れた請求書を扱う場合、抽出精度はツールが何を見ているかを理解しているかどうかにかかっています。3つの業界バリエーションは、「請求書」が標準形式からどれほどかけ離れ得るかを示しており、汎用的な抽出がなぜこれらで失敗することが多いのかを説明しています。
建設業 — AIA G702/G703 進捗請求
AIA G702支払申請書兼証明書は、従来の意味での請求書ではありません。建設プロジェクト全体の累計作業を追跡する進捗請求書です。このフォームは標準的な請求書抽出ツールが想定していない独自の構造を持っています:
- 明細1: 当初契約額 — 契約締結時の総契約価格。これは全請求サイクルにわたって引き継がれる固定の数字であり、期間ごとの請求額ではありません。
- 明細2: 変更指示書による純変更額 — 承認済み変更の累計。署名された変更指示書ごとにこの数字が変わるため、4ヶ月目のG702は1ヶ月目とは異なる基準数字になります。
- 明細3: 現在までの契約額 — 明細1 + 明細2。プロジェクトのこの時点で「100%完了」が何を意味するかを定義する変動する目標値です。
- 明細4: 現在までの完了・保管総額 — 完了した全作業と現場に保管された材料の価値。G703継続シートで裏付けが必要な主要な数字です。
- 明細5: 保留金 — 通常、プロジェクト完了まで5〜10%が差し引かれ、完了した作業と保管された材料で別々に計算されます。
- 明細6: 保留金控除後の総獲得額 — 発注者の差し控え後に請負業者が実際に獲得した金額。
- 明細7: 以前の支払証明書を差し引いた額 — 承認済みの過去の支払いの合計。最初の支払申請ではゼロです。以降の申請では、前サイクルからの累計額になります。
- 明細8: 今回の支払予定額 — 明細6から明細7を差し引いた額。この請求期間に請求される金額です。
- 明細9: 保留金を含む完了までの残高 — 今回の支払い後に契約に残っている金額。
G703継続シートは、G702の明細4の詳細な明細行の裏付けを提供します。プロジェクトを個々のスコープ項目に分解し、各項目には計画価値、前回申請からの完了作業、今回の期間の完了作業、保管された材料、現在までの完了・保管累計、完了率、完了までの残高が含まれます。G703の総計はG702の明細4と正確に一致する必要があります。Rabbetの2024年建設支払いレポートによると、請負業者の82%が30日を超える支払い遅延を経験しており、わずか2年前の49%から増加しています。G702とG703フォーム間の計算エラーは、拒否の最も一般的な原因の一つです。建設請求書処理に特化した詳細な解説については、建設請求書データ抽出で実際に行われることをご覧ください。
医療 — CMS-1500(HCFA-1500)請求書フォーム
CMS-1500フォーム(現在も多くの請求部門でHCFA-1500と呼ばれています)は、米国の医師や外来医療提供者がメディケア、メディケイド、民間保険会社に請求する際に使用する標準的な請求書フォームです。患者の基本情報、保険情報、診断コード(ICD-10)、処置コード(CPT/HCPCS)、診療日、請求額、提供者識別子など、33の番号フィールド(一部に複数のサブフィールドあり)で構成されています。
CMS-1500のデータ抽出を特に困難にしている点:
- ボックス24は単一フォームフィールド内の複数行テーブルです。各行には診療日、診療場所、処置コード、診断ポインタ、請求額、単位数、提供者IDが含まれます。1枚のCMS-1500に最大6行のサービス明細が記載可能で、各行を個別のレコードとして認識しつつ、同一患者・同一請求に紐付ける抽出が必要です。
- 診断ポインタが相互参照システムを形成します。ボックス21には最大12のICD-10コードがリストされ、ボックス24Eにはボックス21の特定診断を指し示す番号(1、2、3など)が入ります。抽出では、単に番号を取得するだけでなく、これらのポインタを解決して完全な請求レコードを生成する必要があります。
- NPI番号が複数のボックスに出現します。診療提供者NPI(ボックス24J)、請求提供者NPI(ボックス33a)、紹介提供者NPI(ボックス17b)はそれぞれ異なる事業者です。これらを混同すると、請求が誤った提供者レコードにルーティングされます。
- ボックスレベルの正確性が重要です。フィールド32(サービス施設所在地)は請求提供者と異なる場合に必須です。フィールド11(被保険者の保険証番号)は保険者の記録と完全に一致する必要があります。1つのボックスの記入ミスが請求却下を引き起こし、修正に数週間かかることもあります。
1枚のCMS-1500には30以上の異なるデータ要素が含まれます。手動入力は1枚あたり5〜7分かかり、ボックスレベルのコーディング(特に診断ポインタのマッピングと修飾子の配置)のエラー率は高く、ほとんどの請求部門では提出前に請求書スクラバーにかけています。フォームの相互参照構造を理解するAI抽出により、これを数秒に短縮し、訓練された請求担当者と同等のフィールドレベルの精度を達成できます。ただし、保険者固有の要件(どのボックスがどの保険者で必須か)については、依然として人間による確認が必要です。
飲食店・フードサービス — 高頻度・多様形式の請求書
飲食店向け仕入先の請求書は、一般の商用請求書とは異なります。SyscoやUS Foodsの請求書は複数ページにわたり、30~50行の明細があり、各行にはパック/サイズ指定(「6/5 lb袋」)、ケース単位の数量、商品ごとに異なる単位(乾物はケース、青果はポンド、特注品は個数)、そしてケース単価・ポンド単価・個数単価が混在する単価が記載されています。印刷された表と同じページに、値引き調整、クレジット通知、配送ドライバーによる代替品のメモなど、手書きの注釈が書き込まれています。
飲食店請求書で問題となる点:
- 単位(UoM)の不統一が常態。 同一請求書内で、青果はケース単価、肉はポンド単価、魚介類は個数単価、清掃用品はケース単価となることがあり、単位の列が明示される場合もあれば、パック/サイズの説明から暗黙的に判断する場合もあります。単位を独立したフィールドとして扱わない抽出では、行合計の検証ができません。
- パック/サイズは複合フィールド。 「6/5 lb」は1ケースあたり5ポンド単位が6個入りを意味します。数量2、パック「6/5 lb」の行は、合計60ポンド(2個ではない)です。これを誤ると、食品原価計算が数倍単位で狂います。
- 手書き調整は標準的。 ドライバーが走り書きした「青果 $2引き」や、手書きの価格が記された代替品の丸囲みは、実効的な行合計を変えます。印刷された数字は誤りで、手書きの数字が正しいものです。抽出では両方を取得するか、少なくとも不一致をフラグ付けする必要があります。
- 複数ページにわたる明細表。 4ページのSysco請求書では、ヘッダーが1ページ目、明細が全4ページにわたることがあります。1ページの表を想定したテンプレートベースのツールは2ページ目で破綻します。AI抽出はページをまたぐ表を処理できますが、継続ページを同一請求書の一部として認識する必要があります。
10店舗の飲食店グループは、50~100の食品・飲料ベンダーと取引し、それぞれ異なる請求書形式を使用します。ヘッダーレベルの抽出(ベンダー名、日付、合計)は買掛金転記には十分です。しかし、食品原価分析、レシピ原価計算、品目別価格追跡、理論値対実績値の差異分析には、単位の正規化を伴う完全な明細抽出が必要です。抽出エンジンは、設定なしで初回のドキュメントから新しいベンダー形式を処理できる必要があります。つまり、ベンダーごとのテンプレート作成ではなく、テンプレート不要のAI抽出が求められます。
バッチ処理のスケール — 1枚の請求書から1つのスプレッドシートへ
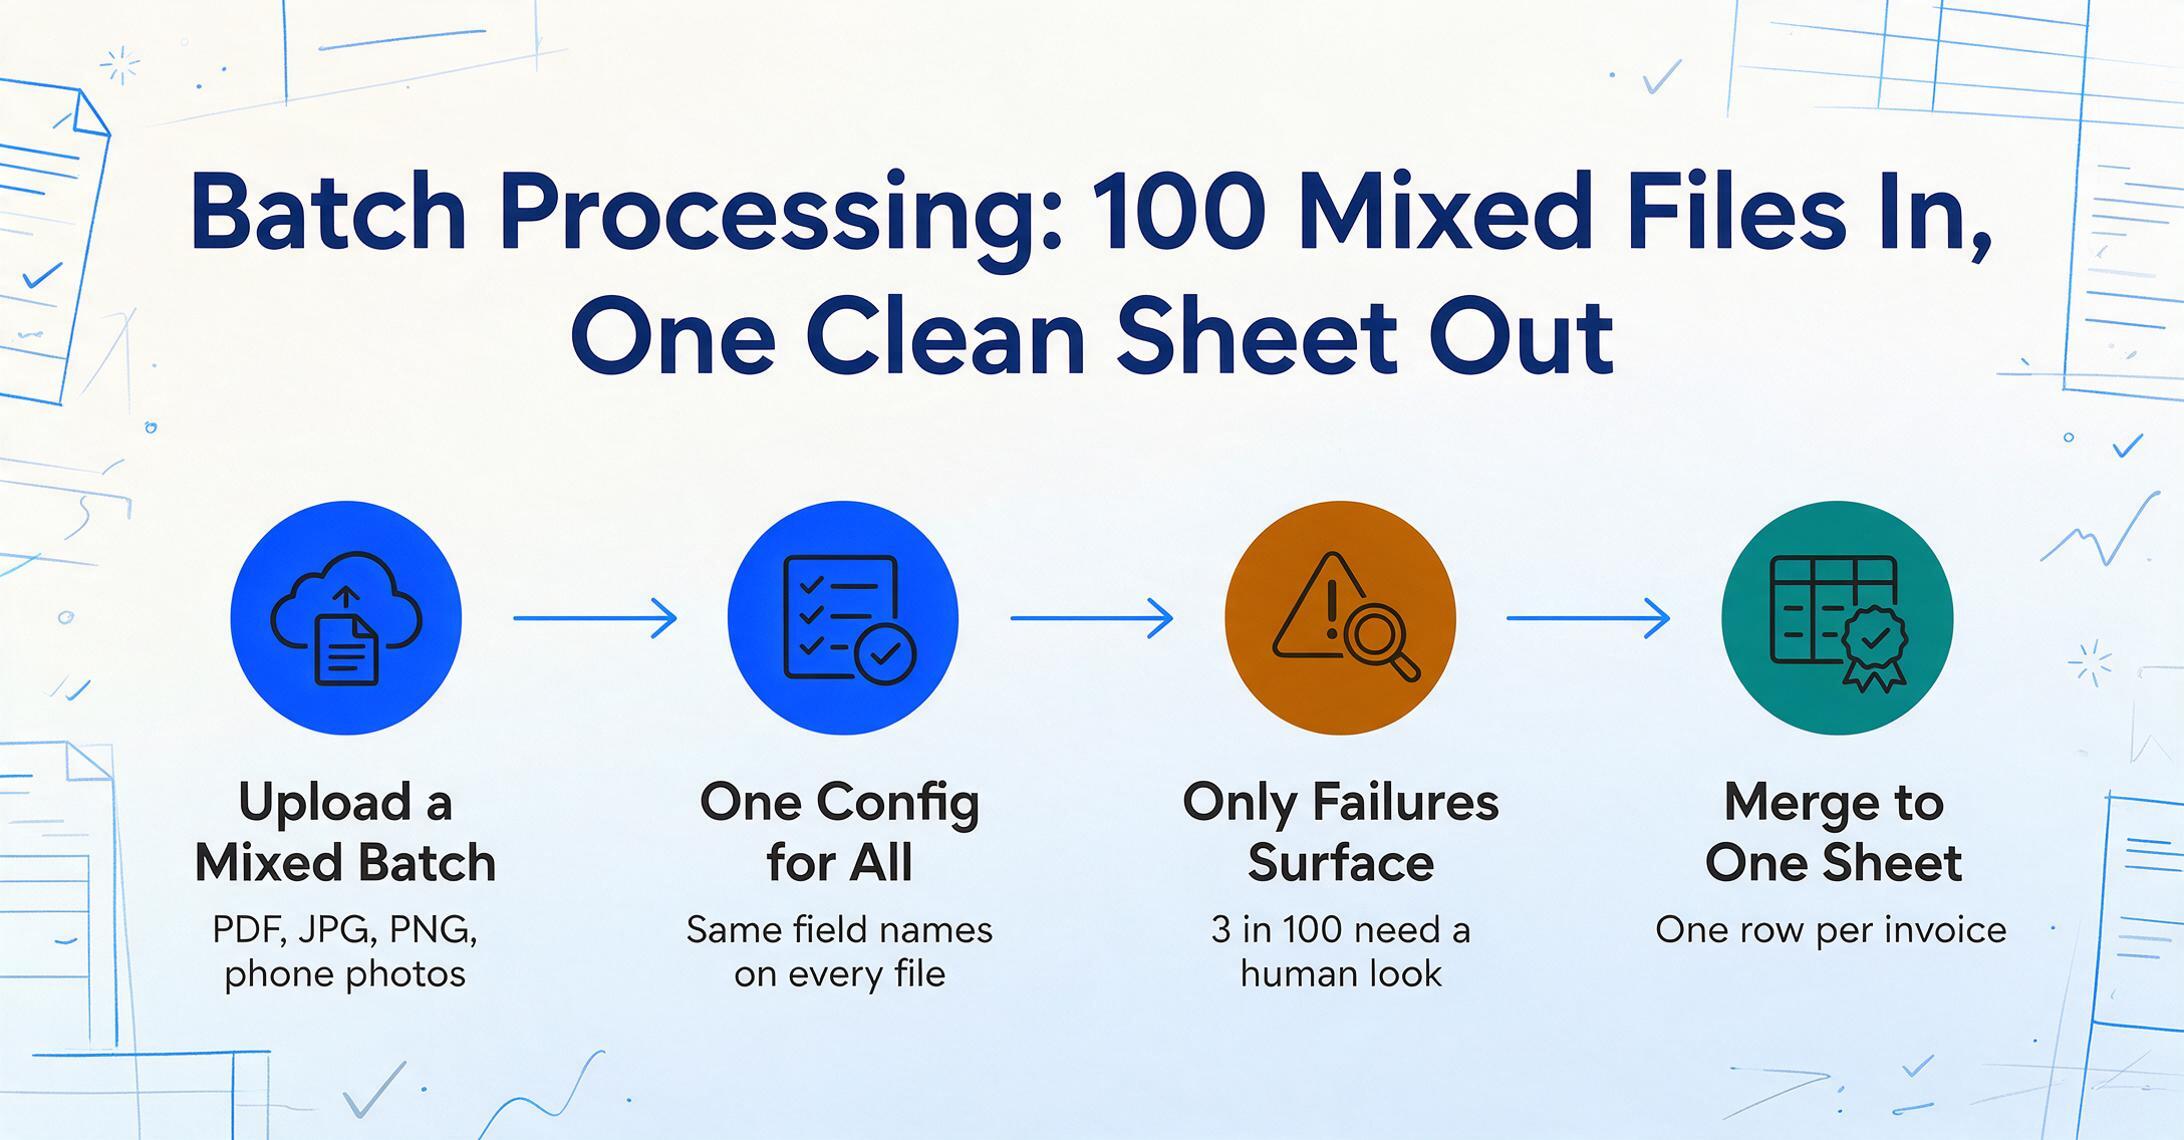
1枚の請求書を処理すると、ツールの使い方がわかります。100枚の請求書を一度に処理すると、ツールが本当に機能するかがわかります — なぜなら、ボリュームは単一ドキュメントのデモでは隠れてしまう設計上の欠陥を露呈するからです。バッチ処理は、ワークフローに適合する抽出と、その周りにワークフローを構築する必要がある抽出との違いです。
バッチ処理の実際の仕組み
バッチ処理は単に「同じことをN回行う」だけではありません。それは特定のパイプラインです:N件の請求書ファイル(PDF、JPG、PNG、スマホ写真の混在可)をアップロード → ツールが同じ抽出設定で全ファイルを処理 → 結果が1つの出力ファイルに統合され、請求書ごとに1行(または出力モードに応じて明細行ごとに1行)になります。
単一ドキュメント処理よりも難しい点:
- フォーマットの多様性。50件のバッチには30種類のベンダーフォーマットが含まれる場合があります。テンプレートベースOCRはここで破綻します — 「処理」を押す前に30個のテンプレートを設定する必要があるからです。AIによる意味抽出は、同じフィールド定義が全フォーマットで機能するため対応できます。
- 混在ファイルタイプ。クリーンなPDFで届く請求書もあれば、紙の写真として届くものもあります。POや納品書が混在した複数ページのドキュメントもあります。バッチプロセッサは、事前の手動ファイルタイプ分類なしでこれらすべてを処理する必要があります。
- 部分的な失敗の処理。100件のバッチのうち3件が抽出に失敗する可能性があります(読み取れないスキャン、破損ファイル、AIが解析できないフォーマット)。バッチ出力には、成功した97件の結果に加えて、失敗した3件の明確なエラー表示を含める必要があります — やり直しが必要な単一の「バッチ失敗」メッセージではなく。
- 行からソースへのトレーサビリティ。50件の請求書から500行の統合スプレッドシートでは、すべての行がソースファイルを参照する必要があります。これがないと、疑わしい値の元のドキュメントを見つけるには、行とファイルを手動で照合する必要があり、バッチ処理の目的が無意味になります。
バッチパイプラインは計算列と検証とも連動します:1枚ずつ検証を実行する代わりに、バッチ実行では同じ計算ルールとフィールド間検証をバッチ全体に適用します。単一の検証ルール(「明細合計 = 数量 × 単価」)が50件すべての請求書のエラーを同時に検出します — これは50件の個別結果を開いて1件ずつ確認するのとは根本的に異なります。
バッチ完了後に起こること
バッチ結果(単一のExcelファイルまたは構造化されたJSON)は終点ではなく出発点です。生の抽出結果を転記済みのAPデータに変える、バッチ後のステージは3つあります。
1. 例外レビュー。検証に失敗した行(明細合計の不一致、必須フィールドの欠落、請求書番号の重複)にフラグを立てます。これらは人間による解決に回されます。残り(通常はバッチの85〜95%)は手動介入なしで通過します。目標は例外ゼロではなく、例外を簡単に見つけられるようにして、レビュー工程を数時間ではなく数分にすることです。
2. データ変換。抽出されたデータがERPのインポート形式と完全に一致することはまれです。日付の再フォーマット(MM/DD/YYYY → YYYY-MM-DD)が必要な場合があります。ベンダー名の正規化(「Sysco Corp」→ ベンダーマスターでは「SYSCO-01」)が必要な場合もあります。通貨金額の換算が必要な場合もあります。抽出ツールがクリーンで予測可能な構造(すべての列が一貫したデータ型を持ち、セル結合や書式のアーティファクトがない)をエクスポートすれば、この変換は5分のスプレッドシート操作です。出力が乱雑な場合、変換は別のデータクレンジングプロジェクトになります。
3. ERPインポート。変換されたファイルは、CSVインポート、API、またはスプレッドシート統合(前述の統合パスのセクションで説明)を介してERPに入力されます。バッチサイズによって適切な方法が決まります。月200件未満の請求書にはCSVインポート、200〜1,000件にはAPI、1,000件を超える場合は完全なAP自動化プラットフォーム統合です。
アップロードからマージされたExcelまでのエンドツーエンドのバッチワークフローのステップバイステップのチュートリアルについては、請求書データを1つのExcelファイルにバッチ抽出する方法を参照してください。ボリュームに適した処理アプローチをマッチングするスケーリングフレームワークについては、人員を増やさずに請求書処理をスケーリングする方法を参照してください。