Cuando la factura es el cuerpo del correo,
no el archivo adjunto
La mayoría de las herramientas de extracción de facturas se basan en un único supuesto: los datos que necesita están dentro de un archivo adjunto al mensaje. Ese supuesto se cumple en una gran parte de las facturas de proveedores. Pero falla por completo en aquellas donde la factura es el propio correo, redactada como HTML o texto plano en el cuerpo, sin ningún PDF en el mensaje. Cuando eso ocurre, una herramienta centrada en archivos adjuntos no devuelve un número incorrecto. No devuelve nada, y no le informa de que no ha devuelto nada.
Conclusiones clave
- El analizador de facturas en el que ya confía tiene razón en la mayoría de los casos, porque la mayoría de las facturas llegan como archivos adjuntos.
- Con una factura solo en el cuerpo, devuelve una fila vacía y no informa de ningún error, que es el tipo de fallo más costoso.
- Configurar la bandeja de entrada para leer el propio cuerpo convierte ese mismo correo en una fila de hoja de cálculo, sin necesidad de imprimir en PDF.
Cuando la factura solo existe en el cuerpo del correo, las herramientas que priorizan los archivos adjuntos no devuelven nada
Una factura que solo vive en el cuerpo del correo no tiene ningún archivo que un analizador que prioriza los adjuntos pueda abrir, por lo que devuelve una fila vacía sin informar de ningún error. El proceso de extracción parece haberse ejecutado. La salida parece un mensaje que simplemente no tenía nada que extraer. Nadie recibe una alerta y la factura permanece en la bandeja de entrada hasta que una persona nota que la fila está en blanco.
No se trata de un formato poco común. Es el estándar para un segmento específico y creciente de la facturación B2B. Las plataformas de suscripción y publicidad envían sus facturas como mensajes con formato en lugar de archivos: recibos de Stripe, resúmenes de facturación mensual de AWS, avisos de facturación de Google Workspace, facturas de Meta Ads y Google Ads, extractos de viajes de Uber for Business. Los proveedores más pequeños y los autónomos también lo hacen, escribiendo el número de factura y el total directamente en el mensaje porque es más rápido que generar un PDF.
El costo de pasarlas por alto no es teórico. Ardent Partners situó el costo total promedio de procesar una sola factura en $9.40 en 2025, frente a los $2.78 de los mejores equipos, y descubrió que solo el 32.6% de las facturas avanzan sin que una persona intervenga (Ardent Partners, AP Metrics That Matter in 2025). Cada factura que sale del proceso automatizado se gestiona manualmente, en el extremo manual de ese rango de costos.
Un analizador que prioriza los archivos adjuntos no falla de forma evidente con una factura del cuerpo del correo. Tiene éxito al no encontrar ningún archivo adjunto, que es el tipo de fallo más costoso.
Las facturas del cuerpo del correo se presentan de tres formas, y solo dos contienen datos extraíbles
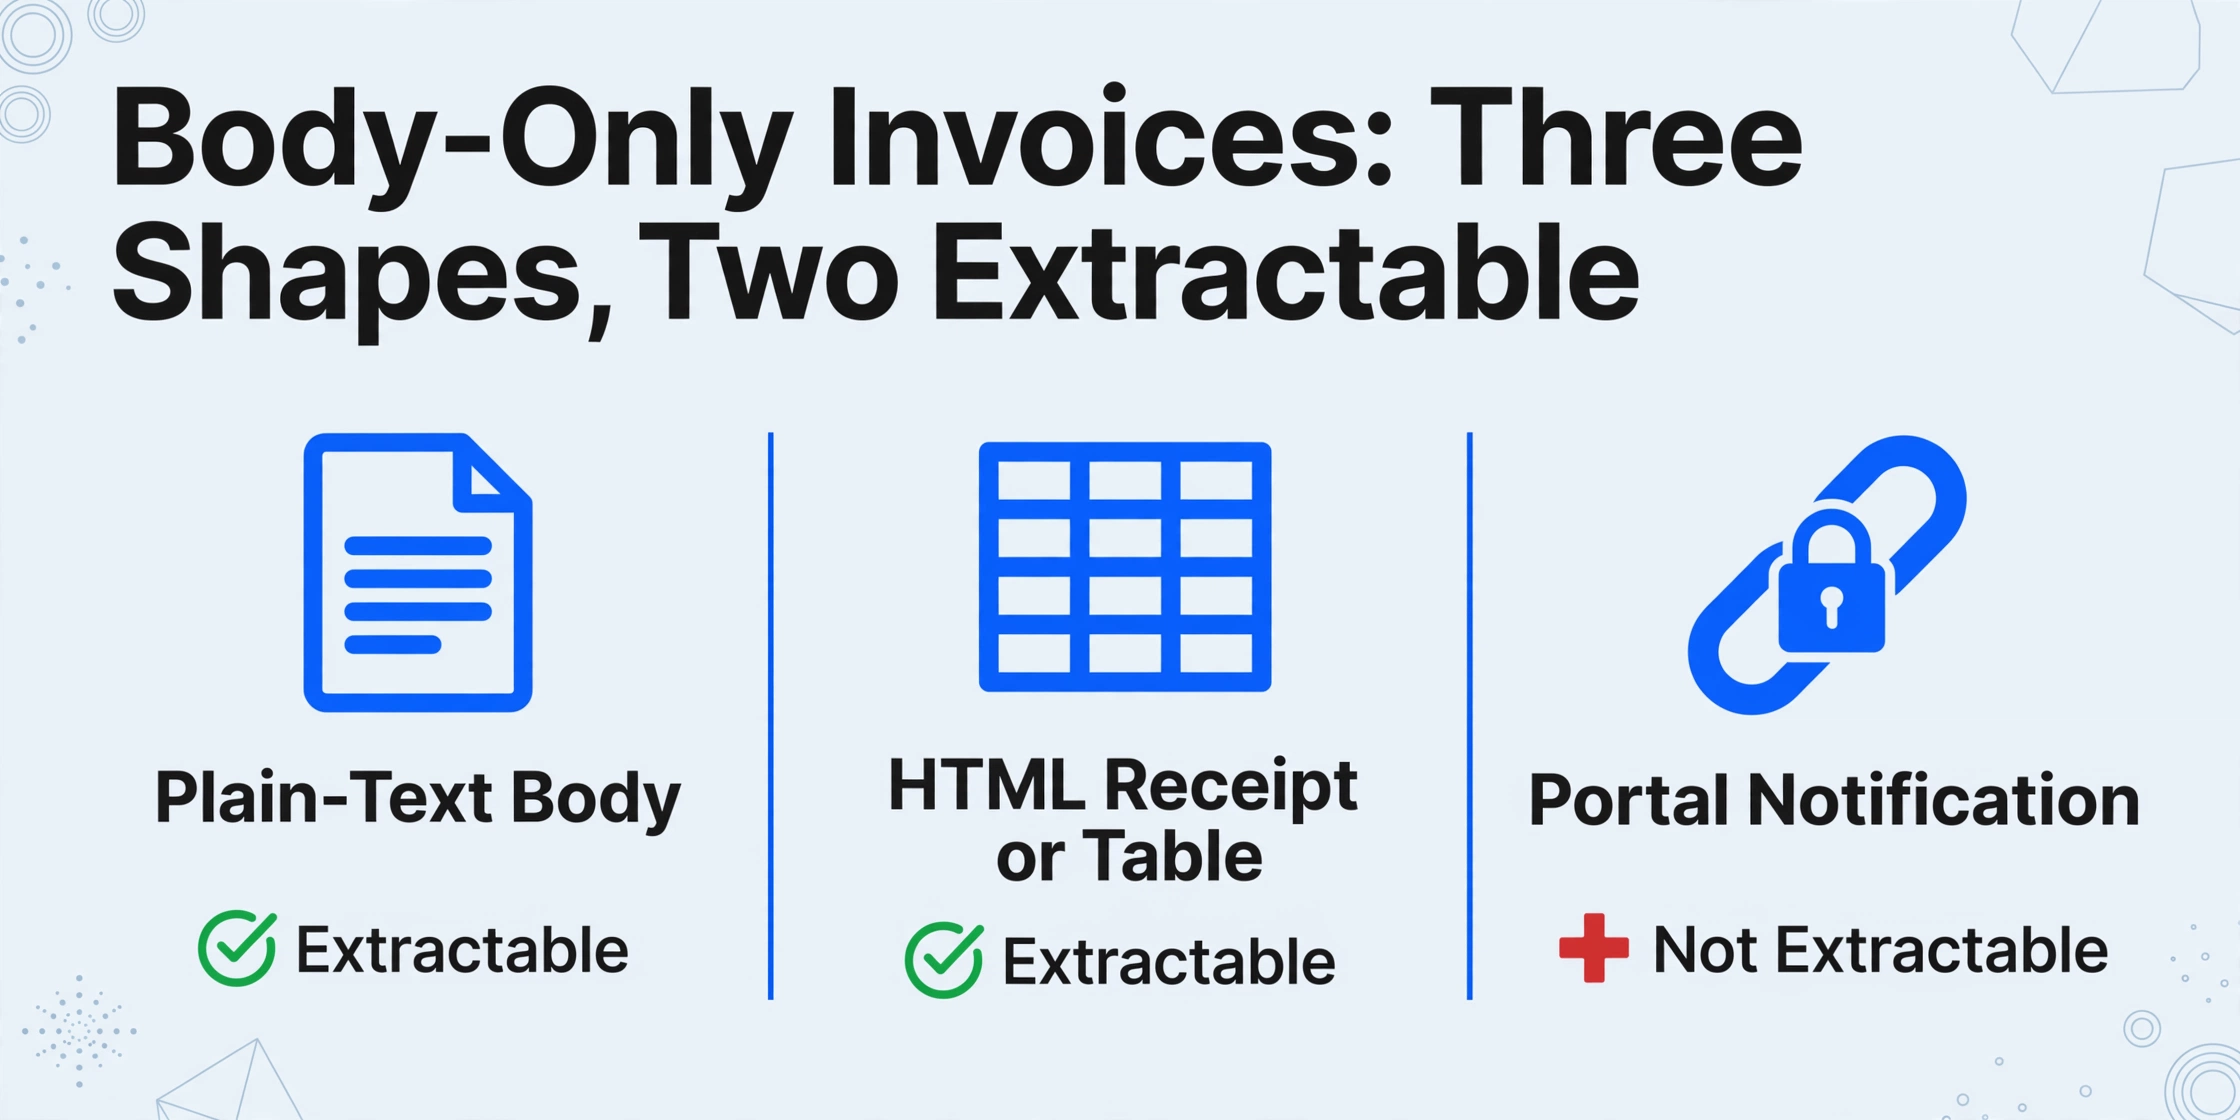
Las facturas del cuerpo del correo llegan a la bandeja de entrada de tres formas, y solo dos de ellas contienen datos que una máquina puede leer realmente. Saber qué forma está viendo le indica si la extracción es posible o si está persiguiendo un enlace que nunca iba a convertirse en una fila de hoja de cálculo.
| Forma | Aspecto | ¿Puede convertirse en una fila de hoja de cálculo? |
|---|---|---|
| Cuerpo de texto plano | Un autónomo o un proveedor pequeño escribe el número de factura, el importe y la fecha de vencimiento directamente en el mensaje | Sí. Los valores están presentes como texto, aunque no estén estructurados |
| Recibo HTML o tabla | Una plataforma de suscripción o publicidad muestra un recibo con formato, a menudo una tabla real, en el cuerpo del correo | Sí. Los valores están presentes, pero como diseño, no como campos |
| Notificación de portal | "Su factura está lista. Inicie sesión para verla y descargarla." El mensaje anuncia la factura; la factura en sí está detrás del inicio de sesión | No. El correo apunta a la factura en lugar de incluirla, y el enlace de descarga caduca |
La distinción entre las dos primeras formas y la tercera es la diferencia entre un documento estructurado y una notificación sobre uno. La Unión Europea traza esa línea con precisión en su definición de facturación electrónica: una factura electrónica es aquella "expedida, transmitida y recibida en un formato de datos estructurado que permita su tratamiento automático y electrónico" (Comisión Europea, Directiva 2014/55/UE). Un correo electrónico con formato HTML no es eso. Es una imagen de una factura dibujada en marcado.
Según la norma europea EN 16931, un campo de factura es un elemento semántico definido con su propio nodo en la sintaxis UBL: el número de factura es cbc:ID, la fecha de emisión es cbc:IssueDate, el importe a pagar es cac:LegalMonetaryTotal/cbc:PayableAmount (Peppol BIS Billing 3.0). En un recibo HTML, esos mismos valores se encuentran en celdas de tabla posicionadas por una hoja de estilo, sin etiquetas en las que un programa pueda confiar. Esa brecha es la razón por la que una factura body only es un problema de extracción más difícil que un PDF adjunto, no más fácil.
Por qué los analizadores fallan aquí: HTML no es texto sin formato, y la impresión a PDF degrada los datos
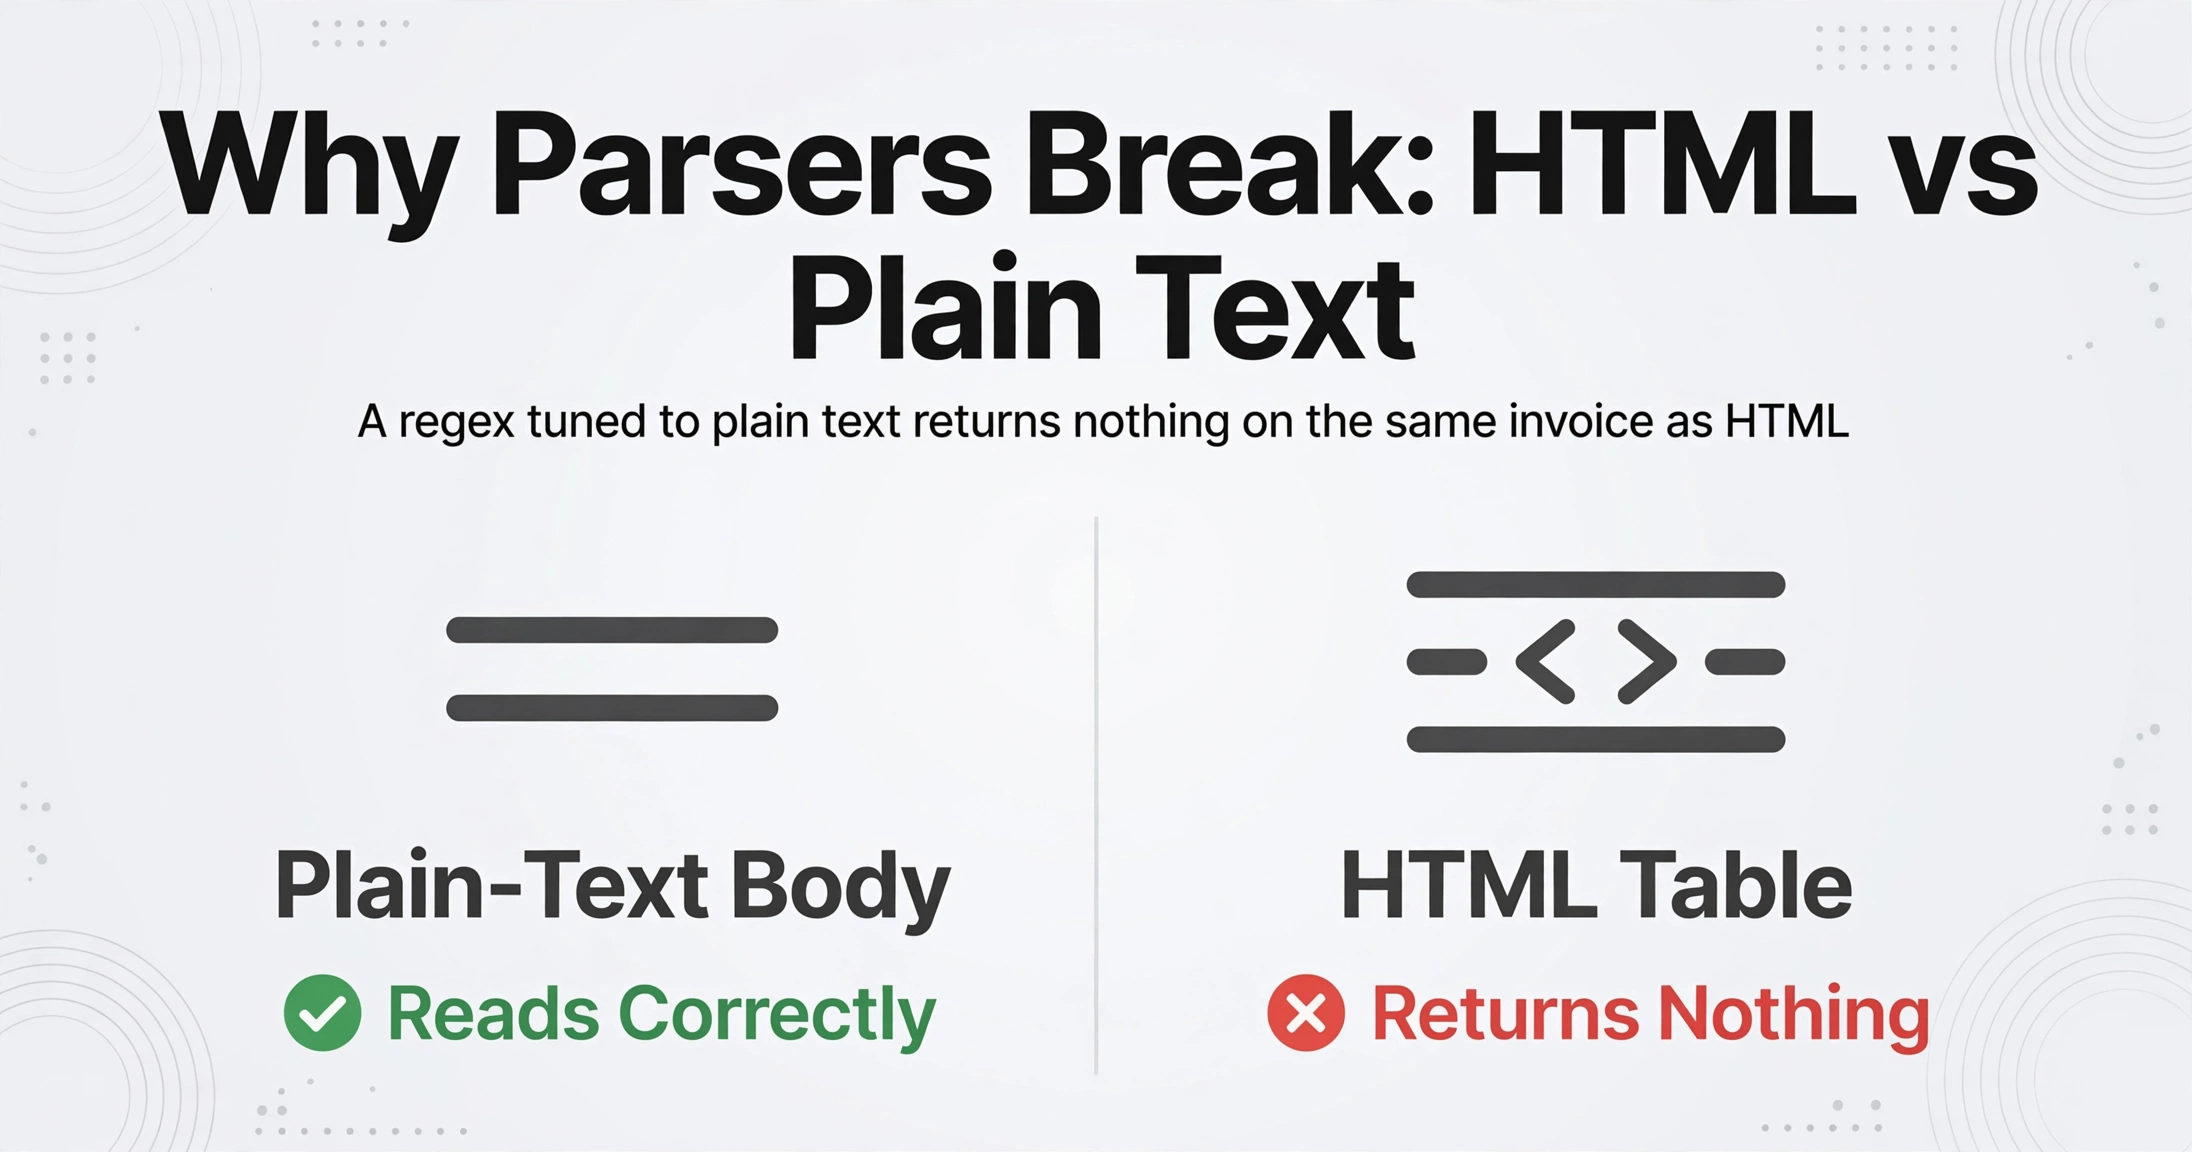
Los analizadores fallan con las facturas body only por una razón que no tiene nada que ver con la calidad del OCR: el cuerpo de un correo electrónico es HTML, no el texto sin formato que la mayoría de los analizadores suponen. Una expresión regular ajustada a "Importe adeudado: $X" lee correctamente un cuerpo de texto sin formato y no devuelve nada en la misma factura representada como tabla HTML, porque el valor y su etiqueta están separados por marcado. La parte de texto sin formato de un mensaje multiparte a menudo elimina la tabla por completo, dejando al lector con un diseño que ya no se alinea.
La solución habitual es imprimir el correo electrónico a PDF y procesarlo. Es lo que hacen hoy la mayoría de los contables, y es frágil por tres razones distintas. La primera es la paginación: un recibo largo o una tabla detallada se divide entre páginas, y los totales caen en una página diferente a la de las partidas. La segunda es el ruido: el PDF impreso incluye el remitente, la línea de asunto, el bloque de firma y el aviso legal, por lo que el extractor debe distinguir un total de factura de un pie de página que casualmente contiene la palabra "total". La tercera es que el paso de imprimir a PDF es en sí mismo una degradación de la calidad del documento.
Un estudio comparativo de 2025 de Fraunhofer IAIS y el Instituto Lamarr probó ocho modelos multimodales en la extracción de facturas y encontró que el mismo modelo líder obtenía un 96.50% en facturas digitales limpias, un 92.71% en facturas escaneadas y un 87.46% en recibos escaneados (arXiv:2509.04469). La precisión sigue la calidad del documento mucho más de lo que sigue al modelo. Renderizar una factura HTML a PDF o a una captura de pantalla la mueve hacia abajo en esa escala a propósito.
La frustración se manifiesta en un lenguaje claro por parte de quienes hacen el trabajo. En r/Bookkeeping, un tenedor de libros describió la rutina: «Una de las pesadillas de mi existencia es cuando un recibo o una factura se incrusta directamente en el cuerpo de un correo electrónico en lugar de venir como un archivo PDF ordenado. Tengo que guardar manualmente el correo como PDF y subirlo en su lugar, y rara vez sale limpio». También habían probado a capturar la parte del recibo con una captura de pantalla y no les fue mejor: «si es largo, no es muy práctico y, sinceramente, tarda más que imprimir a PDF de todos modos». Otro comentarista en el mismo hilo señaló la causa subyacente: «La factura incrustada en el cuerpo de un correo electrónico es, muy probablemente, solo HTML por debajo» (r/Bookkeeping).
La solución provisional existe porque la herramienta espera un archivo. Elimine esa expectativa y la solución provisional desaparecerá con ella.
La solución es cambiar el modo de la bandeja de entrada para que la extracción lea el cuerpo en sí
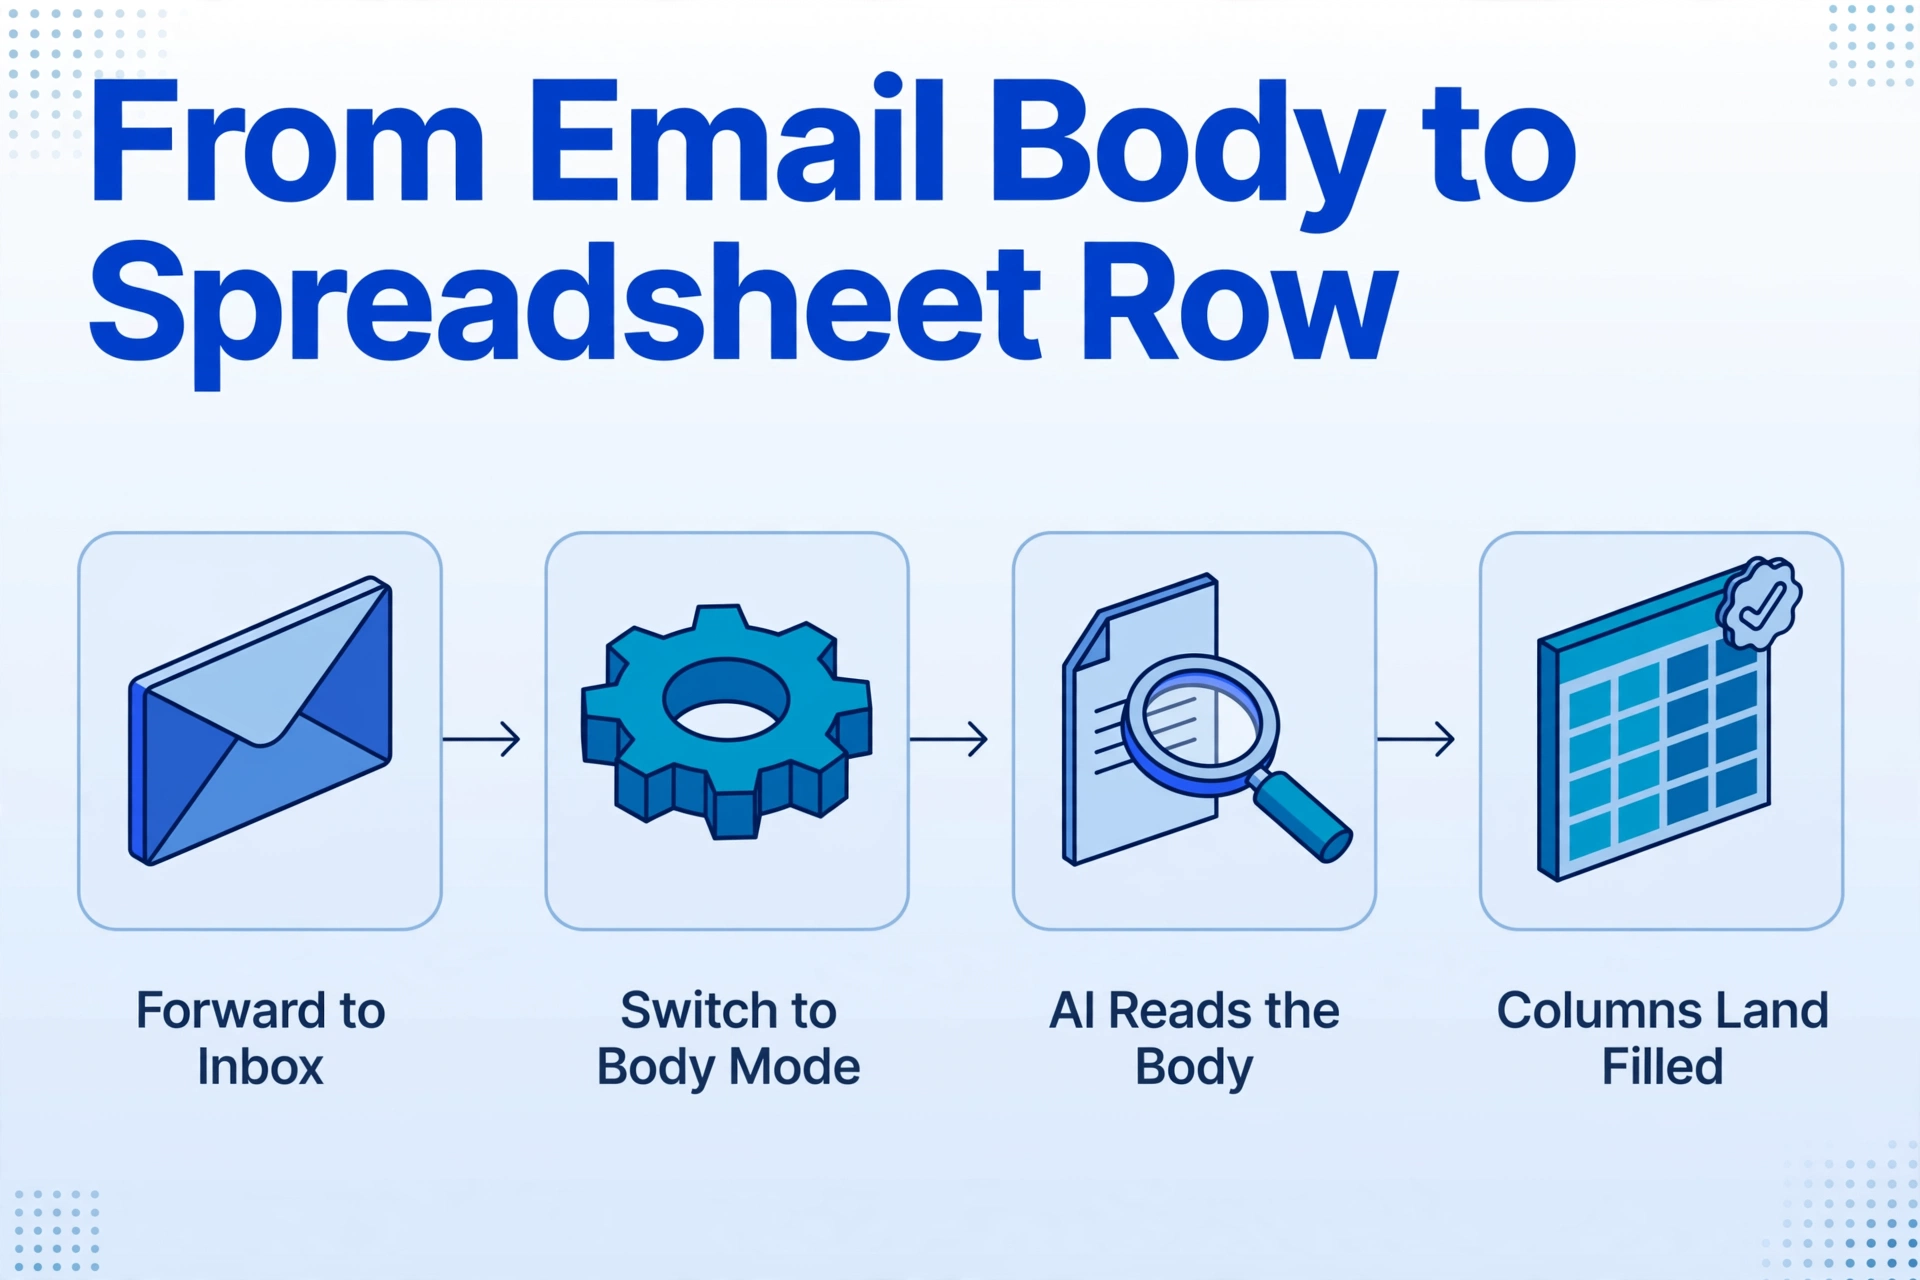
La solución es cambiar el modo de procesamiento de la bandeja de entrada para que la extracción lea directamente el cuerpo del mensaje, en lugar de esperar un archivo adjunto que nunca llegará. La bandeja de entrada de ImageToTable.ai ofrece a cada cuenta una dirección de bandeja de entrada dedicada a la que puede reenviar el correo, y su comportamiento predeterminado es el que causa el problema: lee los archivos adjuntos reales e ignora el cuerpo. La configuración que importa es la que cambia a continuación. Puede cambiar el procesamiento a body only, que ignora los archivos adjuntos, o a attachments and body, que lee ambos en la misma pasada.
Ese único interruptor es lo que convierte una factura solo con el cuerpo en una entrada de primera clase en lugar de una brecha. El mensaje ya no necesita un archivo para que valga la pena procesarlo, porque lo que se lee es el contenido del mensaje en sí.
Lo que ocurre con el contenido es la Extracción de Columnas Personalizadas. Usted escribe los nombres de las columnas que desea, como Número de factura, Proveedor, Fecha de la factura, Fecha de vencimiento y Monto total, y la IA localiza cada valor comprendiendo lo que significa, no dónde se encuentra. Los nombres que escribe se convierten en los encabezados de la hoja de cálculo de salida. Dado que las columnas se definen por significado, el mismo conjunto de columnas lee un cuerpo de texto plano, un recibo HTML y un archivo adjunto PDF sin una regla separada para cada uno. Un proveedor que cambia su plantilla de correo electrónico, o un proveedor nuevo que envía un formato que nunca ha visto, no necesita reconfiguración.
Reenvíe el correo a la dirección de su bandeja de entrada dedicada
Cada cuenta recibe una dirección. Compártala con los proveedores o configure una regla de reenvío en su propio buzón para que los correos de facturas se enruten automáticamente. Active la lista blanca de remitentes para mantener el correo no relacionado fuera de la cola. Nada se descarga ni se vuelve a subir.
Cambie lo que procesa la bandeja de entrada
En la configuración de la bandeja de entrada, salga del valor predeterminado de solo archivos adjuntos. Elija body only si sus facturas llegan como texto o HTML sin archivo, o attachments and body si recibe ambos tipos y desea que se lean juntos. Este es el paso que cubre las facturas que ningún analizador de archivos adjuntos ve.
Asigne nombre a las columnas una vez y vincúlelas a una plantilla
Escriba los nombres de sus columnas, guárdelos como plantilla y active el Auto-Procesamiento para que la extracción comience en cuanto llegue un mensaje. Cada correo se convierte en una fila. Exporte el lote como Excel, CSV o JSON, o envíe las filas directamente a Google Sheets.
Si ya utiliza un flujo de correo a hoja de cálculo para facturas con archivos adjuntos, esto es la rama faltante, no un reemplazo. Tanto el analizador de correos que lee archivos adjuntos como la canalización de correo de proveedor a AP asumen que hay un archivo presente. Cambiar el modo de procesamiento es cómo la misma bandeja de entrada también captura los mensajes que llegan sin uno.
Los archivos se procesan de forma segura y no se almacenan.
Lo que esto no resuelve
Este enfoque gestiona facturas solo con el cuerpo del mensaje que llevan sus datos en texto o HTML, y no puede ayudar con los correos que no contienen ningún dato. Vale la pena señalar cuatro límites antes de construir un flujo de trabajo sobre esta base.
Una notificación de portal no tiene nada que leer. Cuando un proveedor envía "su factura está lista" con un enlace de inicio de sesión y sin cifras, el modo de cuerpo no tiene nada que extraer, porque los datos están detrás de un portal autenticado. Leer esa factura implica iniciar sesión y descargarla, y el enlace del correo a menudo caduca. Ningún analizador de bandeja de entrada cierra esta brecha, porque el correo nunca fue la factura.
Los campos ausentes del cuerpo no pueden inventarse. Una factura en texto plano que dice "Factura 2026-041, $1,850, vence el 15 de octubre" no tiene partidas, por lo que una columna de Partidas vuelve vacía. La extracción es honesta al respecto: completa lo que contiene el mensaje y deja el resto en blanco, lo cual es más útil que una suposición que deba corregir después. Cuando el mensaje contiene una tabla detallada, la tabla se lee; cuando no la contiene, la fila simplemente refleja lo que tenía el correo.
El resultado son datos estructurados, y así permanecen. Lo que obtiene es una hoja de cálculo, un CSV o una fila JSON, y la herramienta no vuelve a representar el correo HTML como documento. Si necesita específicamente un PDF ordenado del correo para un archivo de auditoría, esa es una tarea aparte.
No es una integración con QuickBooks ni Dext. El resultado llega a Excel, CSV, JSON o Google Sheets, y lo que suceda después es su flujo de trabajo. Los equipos que usan Dext, Hubdoc o Bill.com para la captura y QuickBooks o Xero para el libro mayor suelen tratar esto como el flujo estructurado que esos sistemas consumen, más que como un reemplazo de ellos. Para una visión más amplia de dónde se sitúa la extracción en relación con esas herramientas, la guía completa de extracción de datos de facturas y la guía de extracción orientada a contadores cubren el flujo de trabajo circundante.
Una advertencia más se aplica a las cadenas reenviadas. Cuando un mensaje cita varias respuestas anteriores, el mismo total puede aparecer más de una vez, y la copia más antigua suele estar en el texto citado. La extracción lee por significado, pero una cadena así es el único caso en el que confirmar de qué aparición proviene un valor vale treinta segundos. Review Mode existe para eso: al pasar el cursor sobre una celda se resalta exactamente dónde en la fuente se originó el valor, de modo que la verificación es una mirada rápida en lugar de una relectura.
Preguntas frecuentes
¿Puede leer una factura que solo está en el cuerpo del correo, sin ningún adjunto?
Sí. Configure el modo de procesamiento de la bandeja de entrada en body only, o en attachments and body si recibe ambos tipos. El contenido del mensaje se lee directamente, por lo que una factura escrita en el correo o presentada como recibo HTML se convierte en una fila de hoja de cálculo sin necesidad de descargarla, imprimirla ni capturarla primero.
¿Qué pasa con las facturas que llegan como tabla HTML en el correo?
Esas funcionan en la misma pasada. La IA lee el contenido presentado por su significado, no analizando el marcado en bruto en busca de un patrón fijo, por lo que un recibo con formato con el importe, la fecha y el número de factura dispuestos en celdas de tabla se lee igual que una factura de texto plano. No necesita una regla por remitente ni por diseño.
¿Todavía necesito imprimir el correo a PDF o tomar una captura de pantalla?
No, y para facturas largas es la opción más débil. Imprimir o capturar pagina el recibo, incluye la firma y el texto de descargo de responsabilidad, y reduce la calidad del documento que ve el modelo. Leer el cuerpo directamente evita los tres problemas y elimina un paso manual que el hilo de r/Bookkeeping describe como la parte que "realmente se acumula".
¿Qué pasa con los correos de "su factura está lista" con un enlace al portal?
Esos no se pueden extraer del correo, porque el correo no contiene la factura. Los datos están detrás de un inicio de sesión del proveedor y el enlace de descarga caduca con frecuencia. Este es un límite real, no una falta de configuración: la solución es una descarga del portal o una integración específica del proveedor, no un mejor analizador.
¿Envía datos a QuickBooks o Xero?
Genera datos estructurados como Excel, CSV o JSON, o escribe filas en Google Sheets. La integración con un sistema de contabilidad ocurre después de esa salida, mediante su propia importación o flujo de trabajo. No es un conector nativo de QuickBooks ni de Xero, y no reemplaza las herramientas de captura y contabilidad que usted ya utiliza.
¿Convertirá el correo HTML en un PDF?
No. La tarea aquí es la extracción: convertir el contenido de la factura en el mensaje en columnas con nombre. Si necesita específicamente un artefacto PDF para sus registros, genérelo por separado; esto produce la fila estructurada para la cual un PDF sería solo un paso intermedio.
El cambio útil es pequeño y específico. Una factura de solo cuerpo deja de ser una excepción que obliga a una solución manual, porque lo que el flujo de trabajo lee ya no es un archivo. Cuando la factura es el correo, el correo es el documento.