송장이 이메일 본문에 있을 때,
첨부 파일이 아닌 경우
대부분의 송장 추출 도구는 하나의 가정에 기반합니다. 원하는 데이터가 메시지에 첨부된 파일 안에 있다는 것입니다. 이 가정은 많은 공급업체 송장에 대해서는 성립합니다. 그러나 송장이 이메일 자체인 경우, 즉 HTML이나 일반 텍스트로 본문에 작성되어 있고 메시지 어디에도 PDF가 없는 경우에는 완전히 실패합니다. 이런 경우 첨부 파일 우선 도구는 잘못된 숫자를 반환하지 않습니다. 아무것도 반환하지 않으며, 아무것도 반환하지 않았다는 사실조차 알려주지 않습니다.
주요 요점
- 이미 신뢰하고 있는 송장 파서가 대부분의 송장에 대해 정확한 이유는 대부분이 첨부 파일로 도착하기 때문입니다.
- body only 송장에서는 빈 행을 반환하고 오류를 보고하지 않으며, 이것이 더 비용이 많이 드는 실패 유형입니다.
- 이메일 받은편지함이 본문 자체를 읽도록 전환하면 인쇄-PDF 단계 없이 동일한 이메일이 스프레드시트 행으로 변환됩니다.
인보이스가 이메일 본문에만 존재할 때, 첨부파일 우선 도구는 아무것도 반환하지 않습니다
이메일 본문에만 존재하는 인보이스는 첨부파일 우선 파서가 열 수 있는 파일이 없으므로, 파서는 빈 행을 반환하고 오류를 보고하지 않습니다. 추출 파이프라인은 실행된 것처럼 보입니다. 출력은 단순히 추출할 내용이 없는 메시지처럼 보입니다. 아무도 알림을 받지 못하며, 인보이스는 사람이 빈 행을 발견할 때까지 받은편지함에 남아 있습니다.
이것은 드문 형식이 아닙니다. 이는 특정하고 점점 늘어나는 B2B 청구 영역의 기본값입니다. 구독 및 광고 플랫폼은 파일이 아닌 형식화된 메시지로 인보이스를 보냅니다: Stripe 영수증, AWS 월별 청구 요약, Google Workspace 청구 알림, Meta Ads 및 Google Ads 인보이스, Uber for Business 여행 명세서. 소규모 공급업체와 프리랜서도 PDF를 생성하는 것보다 빠르기 때문에 인보이스 번호와 총액을 메시지에 직접 입력합니다.
이러한 인보이스를 놓치는 비용은 이론에 그치지 않습니다. Ardent Partners는 2025년 단일 인보이스 처리의 평균 총비용을 $9.40으로, 최고 수준 팀은 $2.78로 집계했으며, 인보이스의 32.6%만이 사람의 개입 없이 처리된다는 것을 발견했습니다 (Ardent Partners, AP Metrics That Matter in 2025). 자동화 경로에서 벗어난 모든 인보이스는 수동으로 처리되며, 이 비용 범위의 수동 끝에 해당합니다.
첨부파일 우선 파서는 본문 전용 인보이스에서 크게 실패하지 않습니다. 첨부파일을 찾지 못하는 데는 성공하며, 이것이 더 비용이 많이 드는 실패 유형입니다.
본문 전용 인보이스는 세 가지 형태로 도착하며, 그중 두 가지만 추출 가능한 데이터를 담고 있습니다
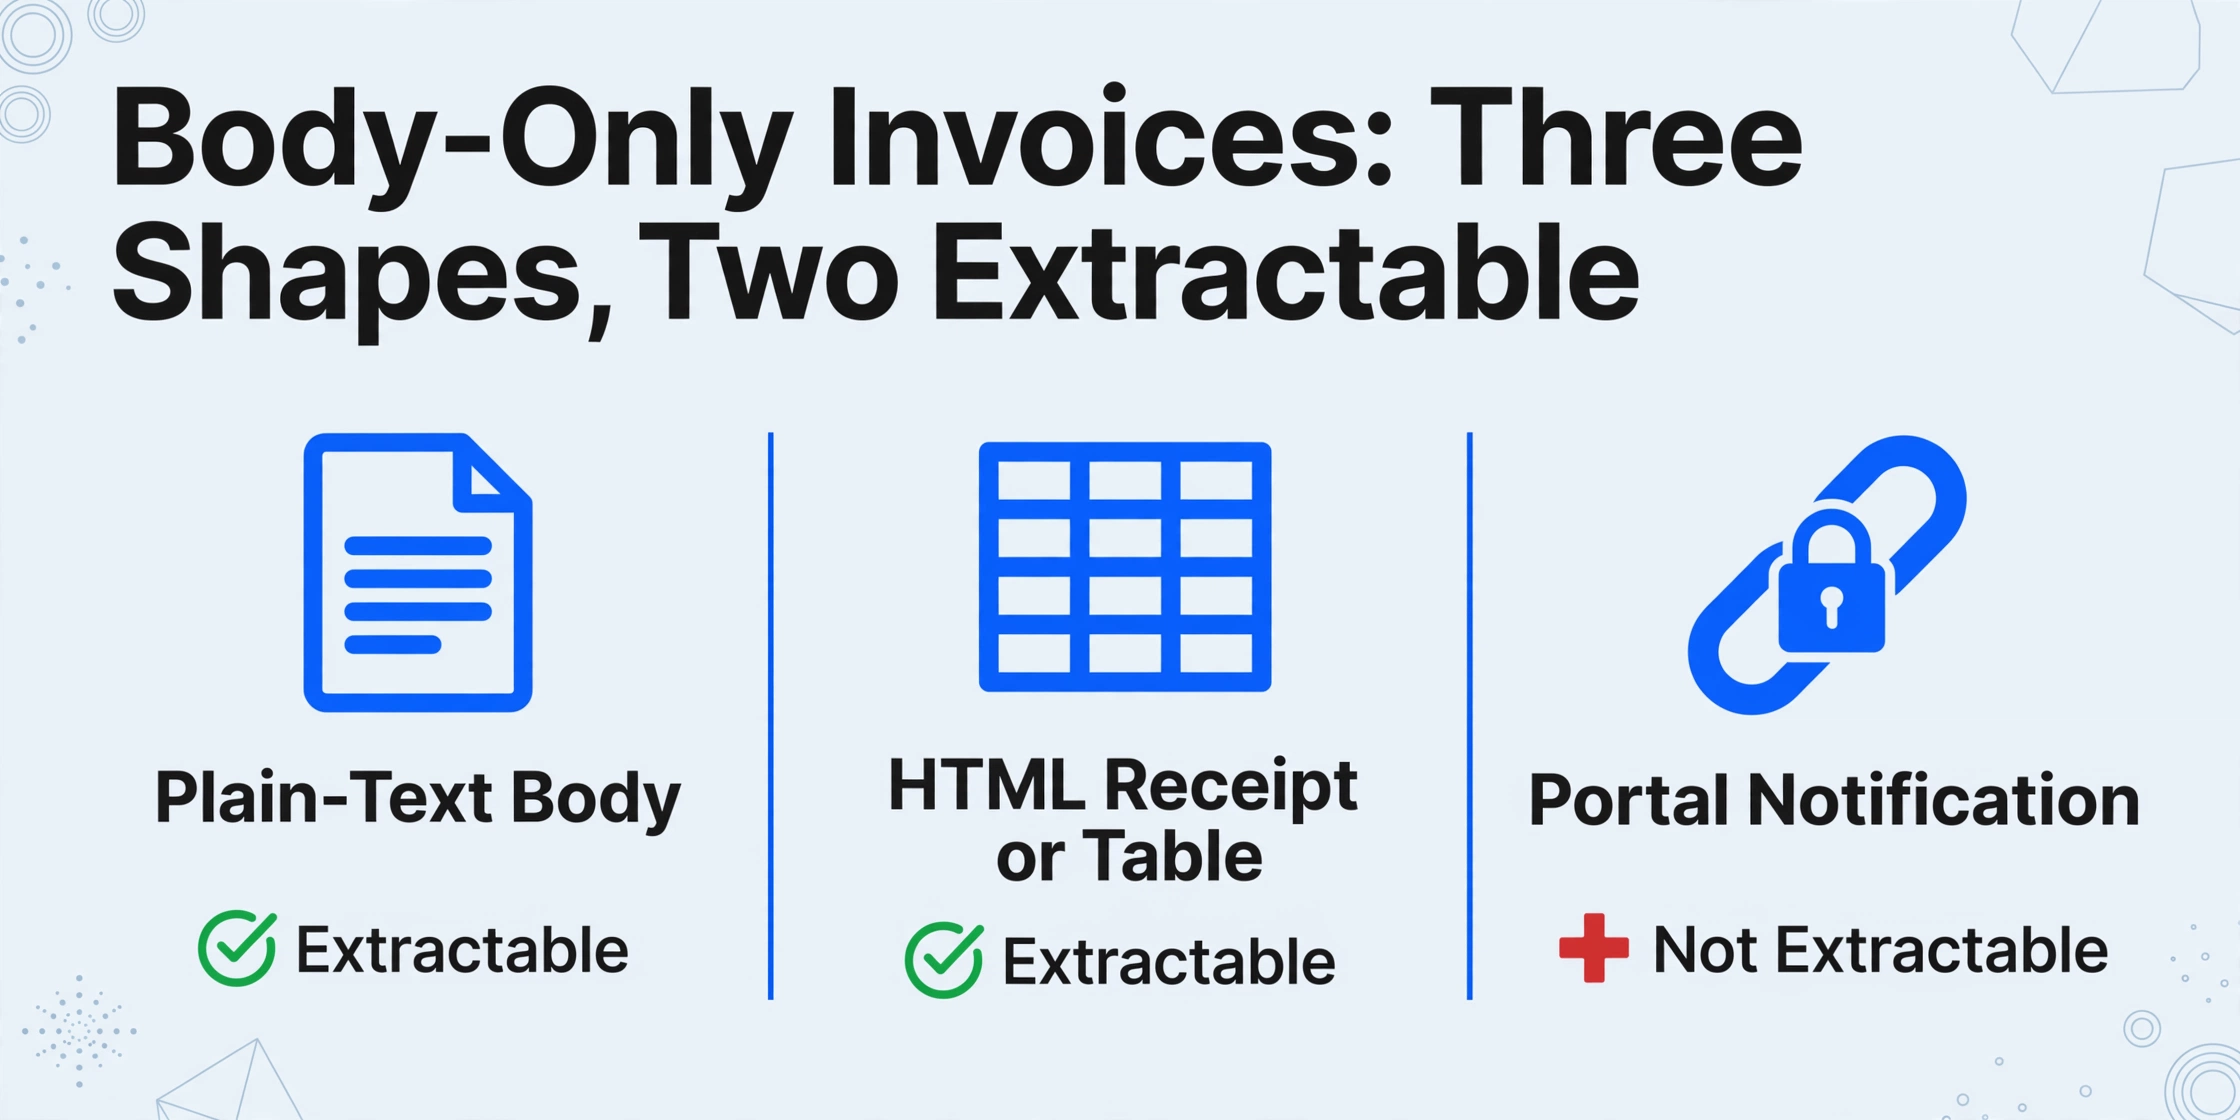
본문 전용 인보이스는 세 가지 형태로 받은편지함에 도착하며, 그중 두 가지만 기계가 실제로 읽을 수 있는 데이터를 포함합니다. 어떤 형태인지 알면 추출이 가능한지, 아니면 스프레드시트 행이 될 수 없었던 링크를 쫓고 있는 것인지 알 수 있습니다.
| 형태 | 표시 방식 | 스프레드시트 행이 될 수 있나요? |
|---|---|---|
| 일반 텍스트 본문 | 프리랜서나 소규모 공급업체가 인보이스 번호, 금액, 마감일을 메시지에 직접 입력합니다 | 예. 값이 텍스트로 존재하며, 구조화되지 않았더라도 추출 가능합니다 |
| HTML 영수증 또는 테이블 | 구독 또는 광고 플랫폼이 본문에 형식화된 영수증(종종 실제 테이블)을 렌더링합니다 | 예. 값은 존재하지만 필드가 아닌 레이아웃으로 존재합니다 |
| 포털 알림 | "인보이스가 준비되었습니다. 로그인하여 확인하고 다운로드하세요." 메시지는 청구서를 알리지만, 청구서 자체는 로그인 뒤에 있습니다 | 아니요. 이메일은 인보이스를 담고 있는 대신 가리키기만 하며, 다운로드 링크는 만료됩니다 |
첫 번째 두 형태와 세 번째 형태의 차이는 구조화된 문서와 그에 대한 알림의 차이입니다. 유럽연합은 eInvoicing 정의에서 그 경계를 정확히 긋습니다: 전자 인보이스는 "자동 및 전자 처리가 가능한 구조화된 데이터 형식으로 발행, 전송, 수신되는" 것입니다 (유럽 위원회, 지침 2014/55/EU). 형식화된 HTML 이메일은 그렇지 않습니다. 그것은 마크업으로 그려진 인보이스의 그림일 뿐입니다.
유럽 표준 EN 16931에 따라 인보이스 필드는 UBL 구문에서 고유한 노드를 가진 정의된 의미 요소입니다: 인보이스 번호는 cbc:ID, 발행일은 cbc:IssueDate, 지불 금액은 cac:LegalMonetaryTotal/cbc:PayableAmount입니다 (Peppol BIS Billing 3.0). HTML 영수증에서 이러한 값들은 스타일시트로 배치된 테이블 셀에 있으며, 프로그램이 신뢰할 수 있는 레이블이 없습니다. 이 격차가 본문만 있는 인보이스가 첨부된 PDF보다 더 어려운 추출 문제인 이유이며, 더 쉬운 문제가 아닌 이유입니다.
파서가 여기서 실패하는 이유: HTML은 일반 텍스트가 아니며, 인쇄-투-PDF는 데이터를 저하시킵니다
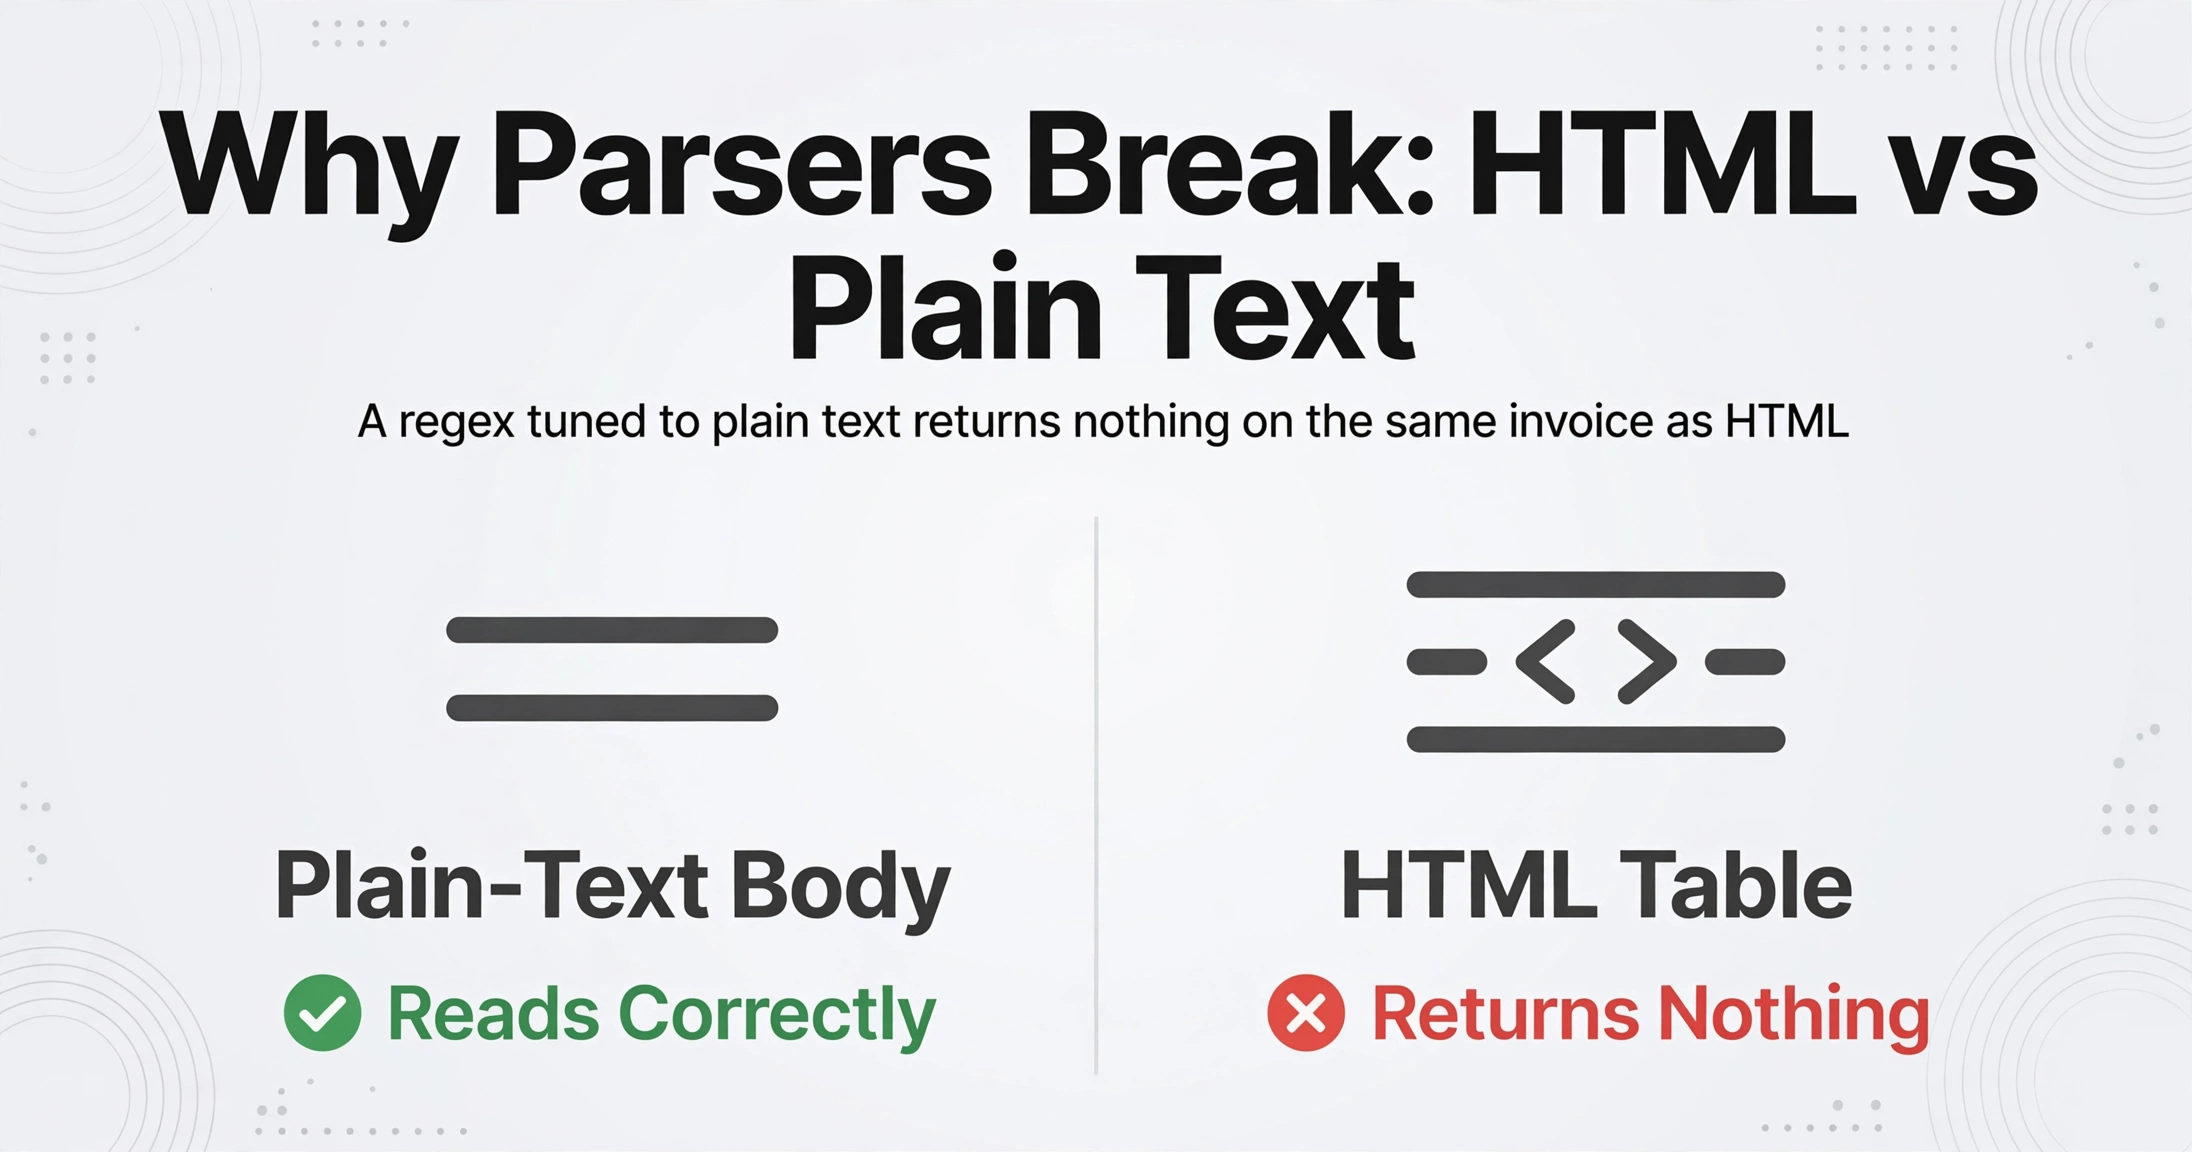
파서가 본문만 있는 인보이스에서 실패하는 이유는 OCR 품질과는 무관합니다: 이메일 본문은 대부분의 파서가 가정하는 일반 텍스트가 아닌 HTML입니다. "Amount due: $X"에 맞춰진 정규 표현식은 일반 텍스트 본문을 올바르게 읽지만, 동일한 인보이스가 HTML 테이블로 렌더링되면 값과 레이블이 마크업으로 분리되어 아무것도 반환하지 않습니다. 멀티파트 메시지의 일반 텍스트 대체 부분은 종종 테이블을 완전히 제거하여 더 이상 정렬되지 않는 레이아웃을 남깁니다.
일반적인 해결 방법은 이메일을 PDF로 인쇄하여 처리하는 것입니다. 오늘날 대부분의 회계 담당자가 하는 방식이며, 세 가지 별개의 이유로 취약합니다. 첫 번째는 페이지 나눔입니다: 긴 영수증이나 항목별 테이블이 페이지를 넘어 분할되고, 합계가 품목과 다른 페이지에 배치됩니다. 두 번째는 노이즈입니다: 인쇄된 PDF에는 발신자, 제목 줄, 서명 블록, 법적 고지 사항이 포함되어 있어 추출기가 "total"이라는 단어가 포함된 바닥글에서 인보이스 합계를 구분해야 합니다. 세 번째는 인쇄-투-PDF 단계 자체가 문서 품질 저하라는 점입니다.
2025년 Fraunhofer IAIS와 Lamarr Institute의 벤치마크는 8개의 멀티모달 모델을 인보이스 추출에 대해 테스트했으며, 동일한 최고 모델이 깨끗한 디지털 인보이스에서 96.50%, 스캔된 인보이스에서 92.71%, 스캔된 영수증에서 87.46%를 기록했습니다 (arXiv:2509.04469). 정확도는 모델 자체보다 문서 품질에 훨씬 더 좌우됩니다. HTML 인보이스를 PDF나 스크린샷으로 렌더링하는 것은 의도적으로 그 척도에서 아래로 이동시키는 것입니다.
좌절감은 실제 업무를 하는 사람들의 솔직한 언어로 드러납니다. r/Bookkeeping에서 한 회계 담당자는 일상적인 상황을 이렇게 설명했습니다. "영수증이나 인보이스가 깔끔한 PDF 첨부 파일이 아니라 이메일 본문에 직접 포함되어 있을 때가 가장 골칫거리입니다. 이메일을 PDF로 저장해서 업로드해야 하는데, 거의 깔끔하지 않거든요." 영수증 부분을 스크린샷으로 찍어보기도 했지만 결과는 마찬가지였습니다. "길면 실용적이지 않고, 솔직히 PDF로 인쇄하는 것보다 더 오래 걸립니다." 같은 스레드의 다른 댓글 작성자는 근본 원인을 지적했습니다. "이메일 본문에 포함된 인보이스는 사실상 HTML일 가능성이 높습니다" (r/Bookkeeping).
이런 임시방편이 존재하는 이유는 도구가 파일을 기대하기 때문입니다. 그 기대를 없애면 임시방편도 함께 사라집니다.
해결책은 받은편지함 모드를 전환하여 추출이 본문 자체를 읽도록 하는 것입니다
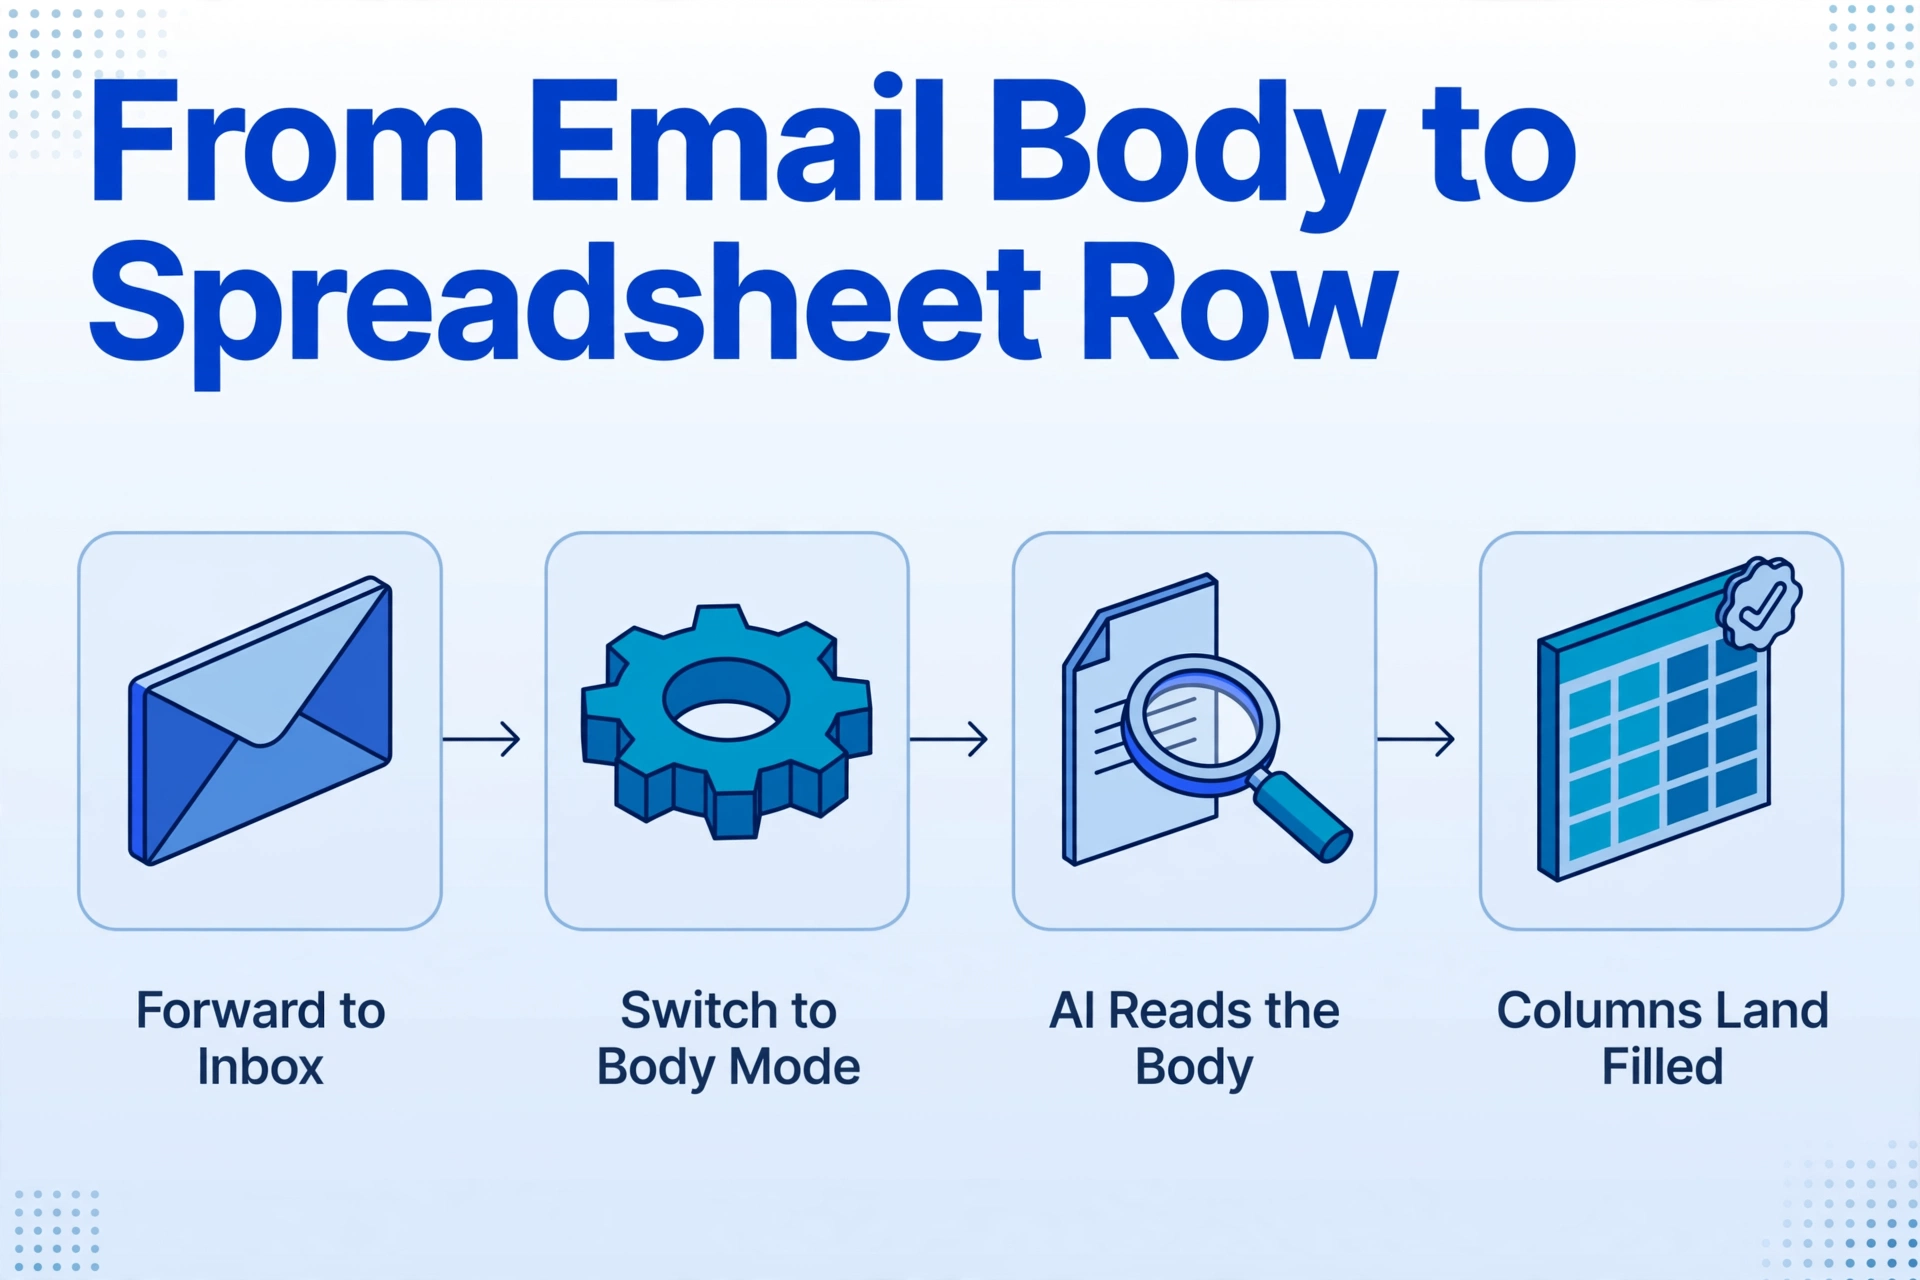
해결책은 받은편지함의 처리 모드를 전환하여 추출이 첨부 파일을 기다리는 대신 메시지 본문을 직접 읽도록 하는 것입니다. ImageToTable.ai의 이메일 받은편지함은 모든 계정에 메일을 전달할 수 있는 전용 받은편지함 주소를 제공하며, 기본 동작이 바로 문제를 일으키는 원인입니다. 실제 첨부 파일을 읽고 본문은 무시합니다. 중요한 설정은 다음에 변경하는 바로 그 항목입니다. 처리를 body only(첨부 파일 무시) 또는 attachments and body(동일한 패스에서 둘 다 읽기)로 전환할 수 있습니다.
이 하나의 토글 덕분에 본문만 있는 인보이스가 공백이 아닌 정식 입력이 됩니다. 메시지에 더 이상 처리할 파일이 필요하지 않습니다. 읽히는 대상이 바로 메시지 콘텐츠 자체이기 때문입니다.
콘텐츠에 적용되는 것은 맞춤 열 추출입니다. Invoice Number, Vendor, Invoice Date, Due Date, Total Amount와 같은 열 이름을 입력하면 AI가 위치가 아닌 의미를 이해하여 각 값을 찾습니다. 입력한 이름이 출력 스프레드시트의 헤더가 됩니다. 열이 의미로 정의되므로 동일한 열 세트가 일반 텍스트 본문, HTML 영수증, PDF 첨부 파일을 각각 별도의 규칙 없이 읽을 수 있습니다. 이메일 템플릿을 변경하는 공급업체나 한 번도 본 적 없는 형식을 보내는 새 공급업체도 재구성할 필요가 없습니다.
전용 받은편지함 주소로 메일을 전달하세요
모든 계정에는 주소가 하나씩 부여됩니다. 공급업체와 공유하거나, 자체 메일함에 전달 규칙을 설정하여 송장 메일이 자동으로 라우팅되게 하세요. 발신자 화이트리스트를 켜면 관련 없는 메일이 대기열에 들어오지 않습니다. 어떤 것도 다운로드되거나 재업로드되지 않습니다.
받은편지함이 처리하는 대상을 변경하세요
받은편지함 설정에서 첨부 파일만 처리하는 기본값을 변경하세요. 송장이 파일 없이 텍스트나 HTML로 도착한다면 body only를 선택하고, 두 종류를 모두 받아 함께 읽어야 한다면 attachments and body를 선택하세요. 이 단계가 첨부 파일 파서가 절대 볼 수 없는 송장을 처리합니다.
열 이름을 한 번 지정하고 템플릿에 바인딩하세요
열 이름을 입력하고 템플릿으로 저장한 다음 Auto-Process를 켜면 메시지가 도착하는 즉시 추출이 시작됩니다. 각 이메일은 하나의 행이 됩니다. 배치를 Excel, CSV 또는 JSON으로 내보내거나 행을 Google Sheets로 바로 보낼 수 있습니다.
이미 첨부 송장에 대해 이메일-스프레드시트 워크플로를 운영 중이라면, 이 기능은 대체가 아니라 누락된 분기입니다. 첨부 파일을 읽는 이메일 파서와 공급업체 이메일-AP 파이프라인은 모두 파일이 있다고 가정합니다. 처리 모드를 전환하는 것이 동일한 받은편지함이 파일 없이 도착하는 메시지도 잡아내는 방법입니다.
파일은 안전하게 처리되며 저장되지 않습니다.
이 도구가 해결하지 못하는 것
이 방식은 본문에 데이터가 텍스트나 HTML로 포함된 body-only 인보이스를 처리하며, 데이터가 전혀 없는 이메일에는 도움이 되지 않습니다. 이 방식을 기반으로 워크플로우를 구축하기 전에 네 가지 한계를 명확히 짚고 넘어가겠습니다.
포털 알림에는 읽을 내용이 없습니다. 공급업체가 로그인 링크와 숫자 없이 "인보이스가 준비되었습니다"라는 이메일을 보낸 경우, 데이터가 인증된 포털 뒤에 있으므로 body 모드 전환으로 추출할 내용이 없습니다. 해당 인보이스를 읽으려면 로그인하여 다운로드해야 하며, 이메일의 링크는 종종 만료됩니다. 이메일 자체가 인보이스가 아니었기 때문에 어떤 받은편지함 파서도 이 공백을 메울 수 없습니다.
본문에 없는 필드는 만들어낼 수 없습니다. "Invoice 2026-041, $1,850, due Oct 15"라고만 적힌 일반 텍스트 인보이스에는 라인 항목이 없으므로 Line Items 열은 비어서 반환됩니다. 추출은 이 점을 정직하게 처리합니다. 메시지에 포함된 내용만 채우고 나머지는 비워 두는 것이, 나중에 잡아내야 하는 추측보다 더 유용합니다. 메시지에 항목별 표가 포함된 경우 해당 표를 읽고, 그렇지 않은 경우 행은 단순히 이메일에 있던 내용을 반영합니다.
출력물은 구조화된 데이터이며, 구조화된 상태로 유지됩니다. 여러분이 받는 것은 스프레드시트, CSV 또는 JSON 행이며, 이 도구는 HTML 이메일을 문서로 다시 렌더링하지 않습니다. 감사 파일용으로 이메일의 깔끔한 PDF가 특별히 필요하다면 그것은 별도의 작업입니다.
QuickBooks 또는 Dext 통합이 아닙니다. 출력물은 Excel, CSV, JSON 또는 Google Sheets에 저장되며, 그 다음에 무엇을 할지는 여러분의 워크플로우에 달려 있습니다. Dext, Hubdoc 또는 Bill.com을 캡처용으로 사용하고 QuickBooks 또는 Xero를 원장용으로 사용하는 팀은 일반적으로 이 도구를 해당 시스템이 소비하는 구조화된 피드로 취급하며, 이를 대체하는 도구로는 취급하지 않습니다. 추출이 이러한 도구들과 어떤 관계에 있는지 더 넓은 관점에서 보려면 인보이스 데이터 추출 전체 가이드와 회계사 대상 추출 가이드에서 관련 워크플로우를 다룹니다.
전달된 체인에 적용되는 주의 사항이 하나 더 있습니다. 메시지에 여러 개의 이전 답변이 인용되어 있으면 동일한 합계가 두 번 이상 나타날 수 있으며, 가장 오래된 사본이 인용된 텍스트에 있는 경우가 많습니다. 추출은 의미를 기준으로 읽지만, 이러한 체인은 값이 어느 항목에서 왔는지 확인하는 데 30초를 투자할 가치가 있는 유일한 경우입니다. Review Mode가 바로 이를 위해 존재합니다. 셀에 마우스를 올리면 값이 소스의 정확히 어느 위치에서 왔는지 강조 표시되므로, 다시 읽는 대신 한눈에 확인할 수 있습니다.
FAQ
이메일 본문에만 있고 첨부 파일이 전혀 없는 인보이스도 읽을 수 있나요?
네. 받은편지함 처리 모드를 body only로 설정하거나, 두 가지 유형을 모두 받는 경우 attachments and body로 설정하면 됩니다. 메시지 내용을 직접 읽으므로 이메일에 입력된 인보이스나 HTML 영수증으로 렌더링된 내용도 다운로드, 인쇄, 스크린샷 없이 스프레드시트 행이 됩니다.
이메일에 HTML 테이블로 도착하는 인보이스는 어떻게 하나요?
동일한 방식으로 처리됩니다. AI는 고정된 패턴의 원시 마크업을 파싱하는 대신 의미 단위로 렌더링된 콘텐츠를 읽으므로, 금액, 날짜, 인보이스 번호가 테이블 셀에 배치된 서식 있는 영수증도 일반 텍스트 인보이스와 동일하게 읽습니다. 발신자나 레이아웃별 규칙이 필요하지 않습니다.
이메일을 PDF로 인쇄하거나 스크린샷을 찍어야 하나요?
아니요. 긴 인보이스의 경우 오히려 더 나쁜 방법입니다. 인쇄나 스크린샷은 영수증을 페이지로 나누고 서명과 면책 문구를 포함시켜 모델이 보는 문서 품질을 떨어뜨립니다. 본문을 직접 읽으면 이 세 가지 문제를 모두 피할 수 있고, r/Bookkeeping 스레드에서 "정말 시간이 많이 걸리는" 부분으로 설명하는 수동 단계도 제거됩니다.
포털 링크가 있는 "인보이스가 준비되었습니다" 이메일은 어떻게 하나요?
해당 이메일에서는 추출할 수 없습니다. 이메일에 인보이스가 포함되어 있지 않기 때문입니다. 데이터는 공급업체 로그인 뒤에 있으며 다운로드 링크는 자주 만료됩니다. 이는 구성 문제가 아닌 실제 한계입니다. 해결 방법은 더 나은 파서가 아니라 포털 다운로드 또는 공급업체별 통합입니다.
QuickBooks나 Xero로 데이터를 보내나요?
구조화된 데이터를 Excel, CSV, JSON으로 출력하거나 Google Sheets에 행으로 기록합니다. 회계 시스템과의 통합은 해당 출력 이후에 여러분의 자체 가져오기 또는 워크플로를 통해 이루어집니다. 네이티브 QuickBooks 또는 Xero 커넥터가 아니며, 이미 사용 중인 캡처 및 원장 도구를 대체하지 않습니다.
HTML 이메일을 PDF로 변환하나요?
아니요. 여기서의 작업은 추출입니다. 메시지에 있는 인보이스 내용을 명명된 열로 변환하는 것입니다. 기록용으로 PDF 파일이 특별히 필요하다면 별도로 생성하세요. 이 기능은 PDF가 단지 중간 단계일 뿐인 구조화된 행을 생성합니다.
유용한 변화는 작고 구체적입니다. 본문만 있는 인보이스는 더 이상 수동 해결 방법을 강요하는 예외 사항이 아닙니다. 워크플로가 읽는 대상이 더 이상 파일이 아니기 때문입니다. 인보이스가 이메일일 때, 이메일이 곧 문서입니다.