Quando a Fatura É o Corpo do E-mail,
Não o Anexo
A maioria das ferramentas de extração de faturas parte de uma única premissa: os dados que você quer estão dentro de um arquivo anexado à mensagem. Essa premissa vale para grande parte das faturas de fornecedores. Ela falha completamente para aquelas em que a fatura é o próprio e-mail, escrita como HTML ou texto simples no corpo da mensagem, sem nenhum PDF em lugar algum. Quando isso acontece, uma ferramenta focada em anexos não retorna um número errado. Ela não retorna nada, e não informa que não retornou nada.
Principais Conclusões
- O parser de faturas em que você já confia está certo sobre a maioria das faturas, porque a maioria delas chega como anexo.
- Em uma fatura apenas no corpo da mensagem, ele retorna uma linha vazia e não reporta erro, o que é o tipo de falha mais caro.
- Configurar a caixa de entrada para ler o próprio corpo transforma esse mesmo e-mail em uma linha de planilha, sem a etapa de imprimir em PDF.
Quando a Fatura Existe Apenas no Corpo do E-mail, Ferramentas que Priorizam Anexos Não Retornam Nada
Uma fatura que existe apenas no corpo do e-mail não tem arquivo para um parser que prioriza anexos abrir, então o parser retorna uma linha vazia e não reporta erro. O pipeline de extração parece ter sido executado. A saída parece uma mensagem que simplesmente não tinha nada para extrair. Ninguém recebe um alerta, e a fatura fica na caixa de entrada até que um humano perceba que a linha está em branco.
Este não é um formato raro. É o padrão para um segmento específico e crescente de cobrança B2B. Plataformas de assinatura e publicidade enviam suas faturas como mensagens formatadas em vez de arquivos: recibos do Stripe, resumos de cobrança mensal da AWS, avisos de cobrança do Google Workspace, faturas do Meta Ads e Google Ads, extratos de viagens do Uber for Business. Fornecedores menores e freelancers também fazem isso, digitando um número de fatura e um total diretamente na mensagem porque é mais rápido do que gerar um PDF.
O custo de perder essas faturas não é teórico. A Ardent Partners estimou o custo médio total de processar uma única fatura em US$ 9,40 em 2025, contra US$ 2,78 para equipes de melhor desempenho, e descobriu que apenas 32,6% das faturas passam sem que uma pessoa as toque (Ardent Partners, AP Metrics That Matter in 2025). Cada fatura que sai do caminho automatizado é tratada manualmente, no extremo manual dessa faixa de custo.
Um parser que prioriza anexos não falha de forma ruidosa em uma fatura apenas no corpo. Ele tem sucesso em não encontrar anexo, que é o tipo de falha mais cara.
Faturas Apenas no Corpo Chegam em Três Formatos, e Apenas Dois Contêm Dados Extraíveis
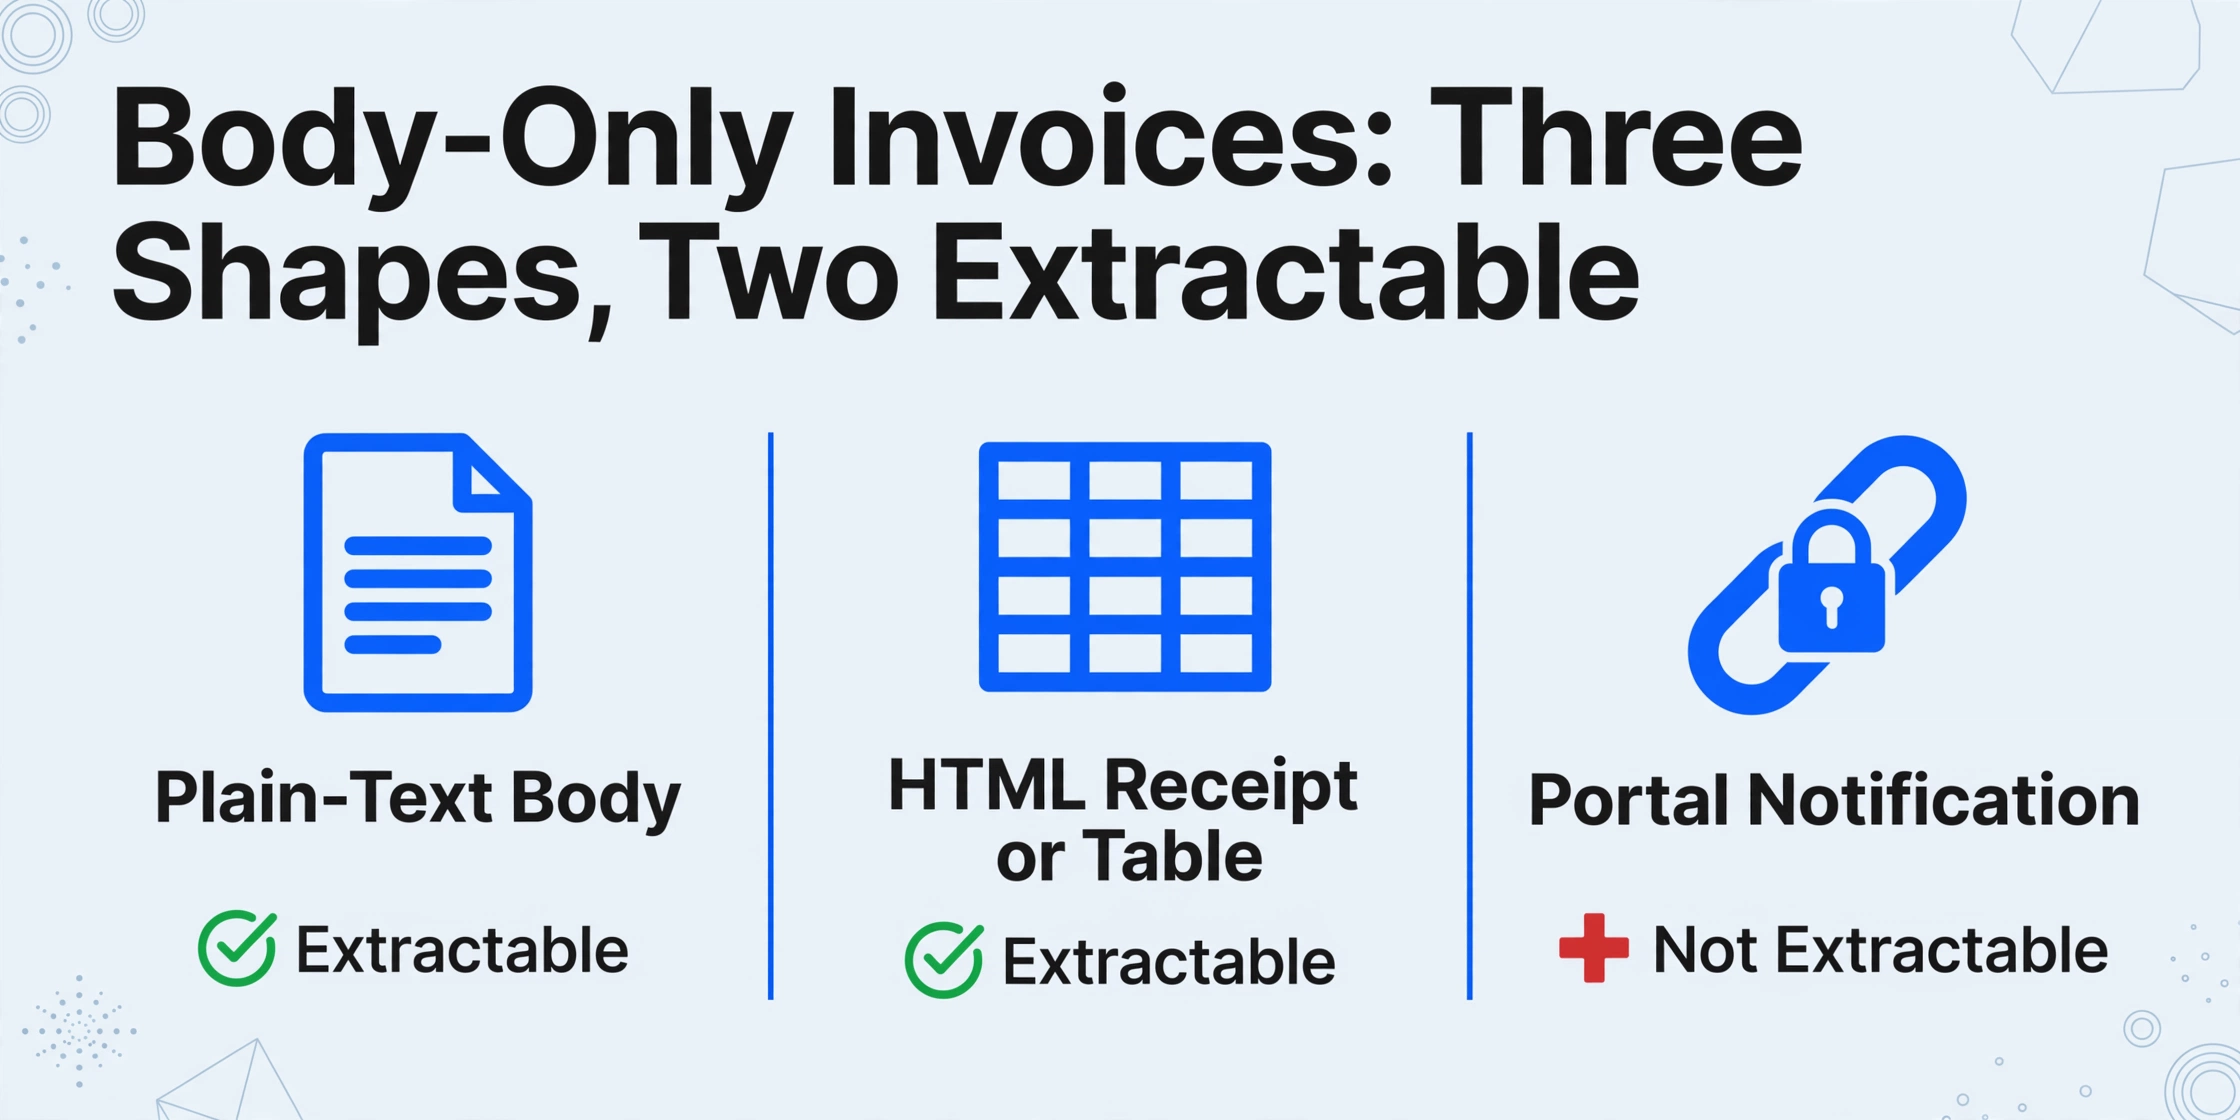
Faturas apenas no corpo chegam à caixa de entrada em três formatos, e apenas dois deles contêm dados que uma máquina pode realmente ler. Saber qual formato você está vendo indica se a extração é possível ou se você está perseguindo um link que nunca seria uma linha de planilha.
| Formato | Como parece | Pode se tornar uma linha de planilha? |
|---|---|---|
| Corpo em texto simples | Um freelancer ou pequeno fornecedor digita o número da fatura, o valor e a data de vencimento diretamente na mensagem | Sim. Os valores estão presentes como texto, mesmo que não estruturados |
| Recibo HTML ou tabela | Uma plataforma de assinatura ou anúncios renderiza um recibo formatado, geralmente uma tabela real, no corpo | Sim. Os valores estão presentes, mas como layout, não como campos |
| Notificação de portal | "Sua fatura está pronta. Faça login para visualizar e baixar." A mensagem anuncia a conta; a conta em si está atrás do login | Não. O e-mail aponta para a fatura em vez de carregá-la, e o link de download expira |
A distinção entre as duas primeiras formas e a terceira é a diferença entre um documento estruturado e uma notificação sobre um. A União Europea traça essa linha precisamente em sua definição de eInvoicing: uma fatura eletrónica é aquela "emitida, transmitida e recebida em um formato de dados estruturado que permite seu processamento automático e eletrónico" (Comisión Europea, Directiva 2014/55/UE). Um e-mail HTML formatado não é isso. É uma imagem de fatura desenhada em markup.
Sob o padrão europeo EN 16931, um campo de fatura é um elemento semántico definido com seu próprio nodo na sintaxis UBL: o número de fatura é cbc:ID, a data de emissão é cbc:IssueDate, o montante a pagar é cac:LegalMonetaryTotal/cbc:PayableAmount (Peppol BIS Billing 3.0). Em um recibo HTML, esses mesmos valores estão em células de tabela posicionadas por uma hoja de estilos, sem rótulos nos que um programa possa confiar. Essa lacuna é o motivo pelo qual uma fatura body only é um problema de extração mais difícil que um PDF adjunto, não mais fácil.
Por que os Parsers Falham Aquí: HTML Não é Texto Plano, e Imprimir a PDF Degrada os Dados
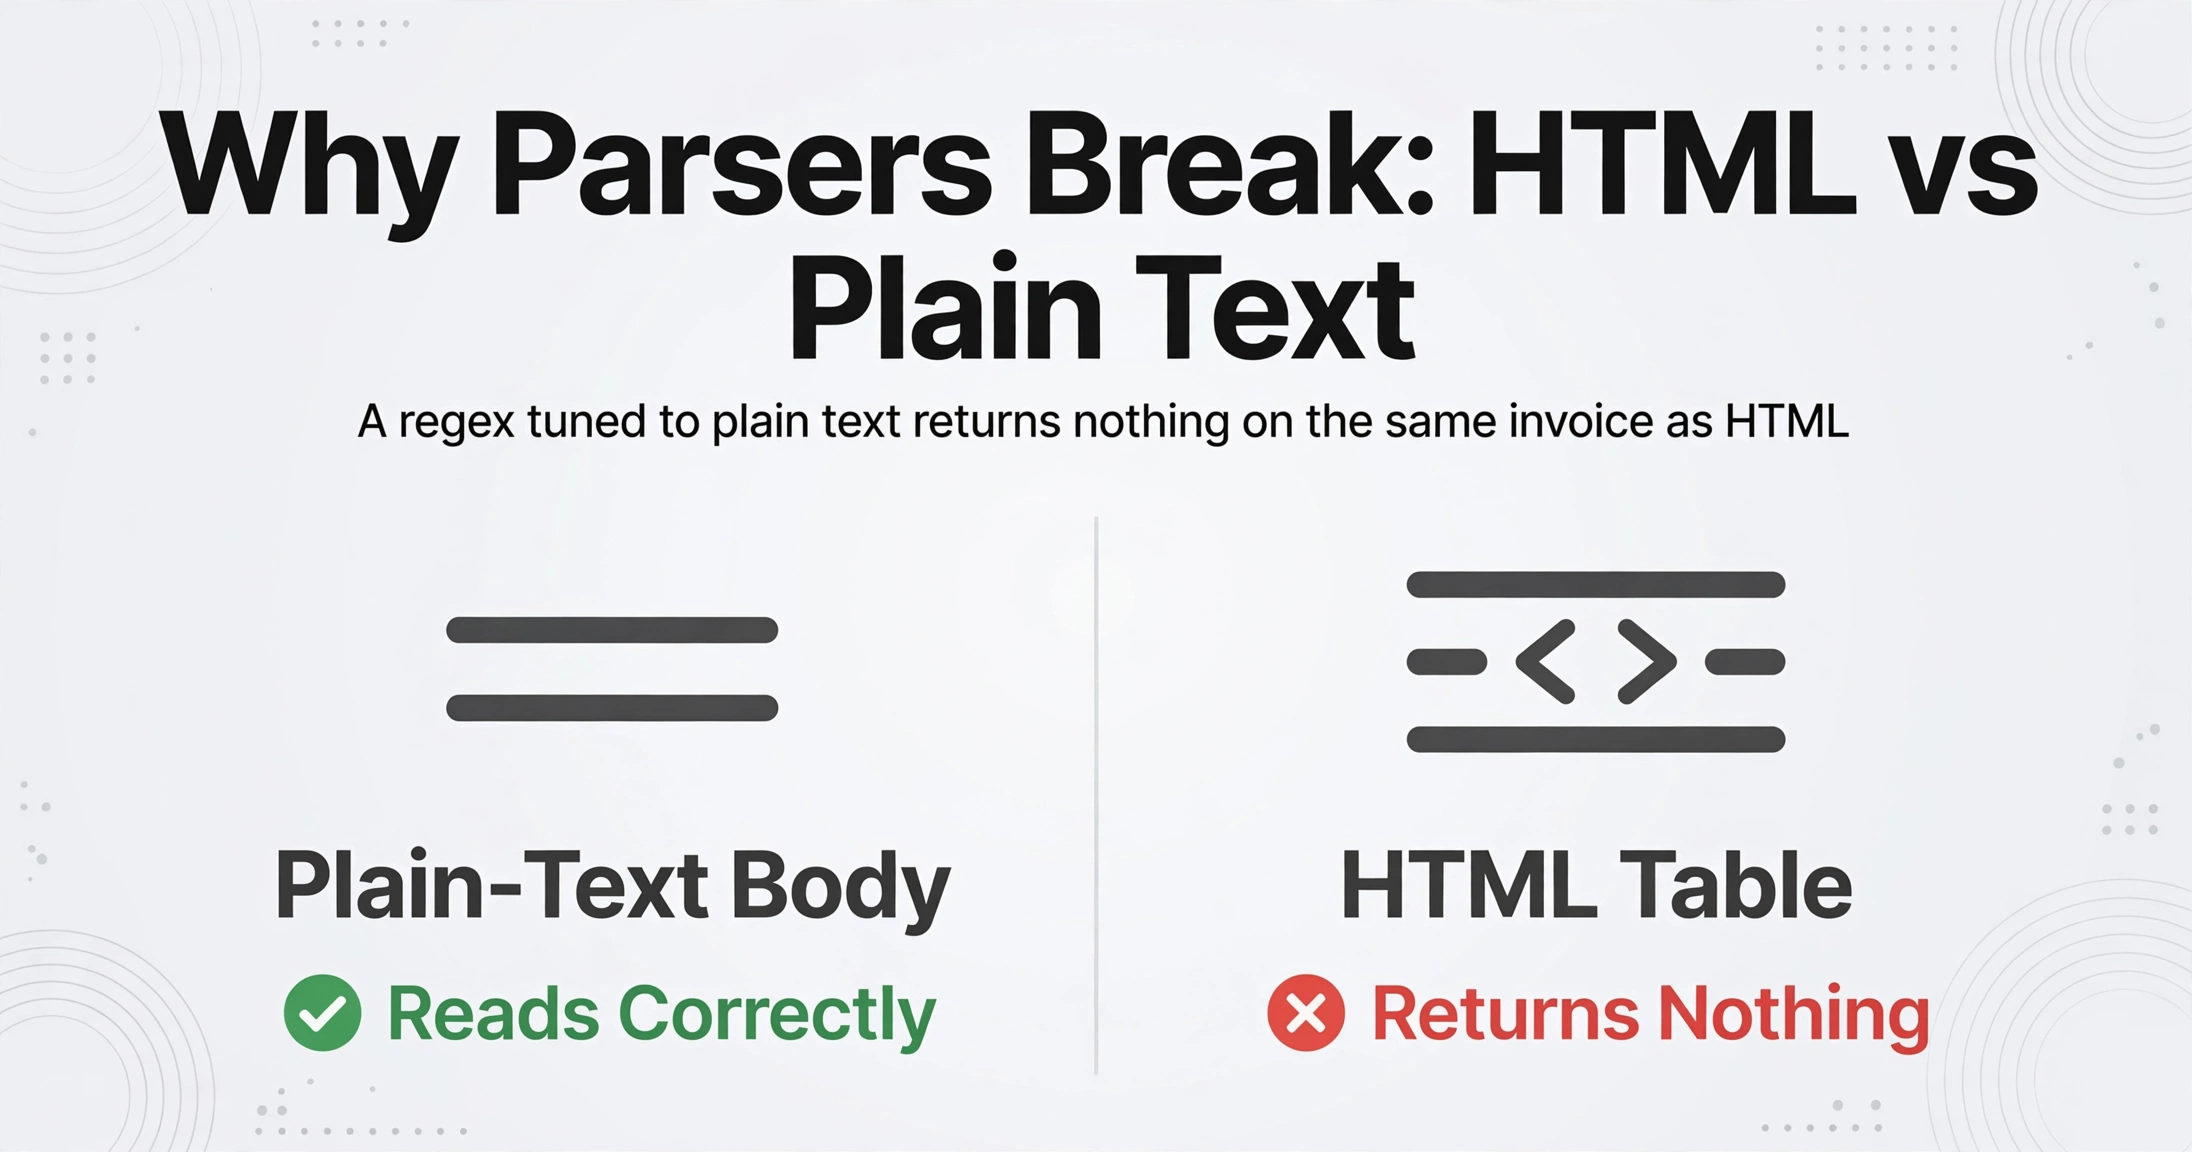
Os parsers falham com faturas body only por uma razão que não tem nada a ver com a qualidade do OCR: o corpo de um e-mail é HTML, não o texto plano que a maioria dos parsers assume. Uma expressão regular ajustada a "Amount due: $X" lê um corpo de texto plano corretamente e não devolve nada na mesma fatura renderizada como uma tabela HTML, porque o valor e seu rótulo estão separados por markup. A parte de texto plano de uma mensagem multiparte muitas vezes elimina a tabela por completo, deixando ao lector um layout que já não se alinha.
A solução habitual é imprimir o e-mail a PDF e processar isso. É o que a maioria dos contadores faz hoje, e é frágil por três razões separadas. A primeira é a paginação: um recibo longo ou uma tabela detalhada se divide entre páginas, e os totais caem em uma página diferente dos itens de linha. A segunda é o ruido: o PDF impresso leva o remitente, a linha de assunto, o bloque de firma e o aviso legal, então o extractor tem que distinguir um total de fatura de um pie de página que por acaso contém a palavra "total". A terceira é que o próprio passo de imprimir a PDF é uma degradação da qualidade do documento.
Um benchmark de 2025 do Fraunhofer IAIS e do Instituto Lamarr testou oito modelos multimodales na extração de faturas e encontrou o mesmo modelo principal com 96.50% em faturas digitais limpias, 92.71% em faturas escaneadas e 87.46% em recibos escaneados (arXiv:2509.04469). A precisão segue a qualidade do documento muito mais do que segue o modelo. Renderizar uma fatura HTML a PDF ou a uma captura de pantalla a move para abaixo nessa escala de propósito.
A frustração aparece em linguagem clara nas palavras de quem faz o trabalho. No r/Bookkeeping, um contador descreveu a rotina: "Um dos tormentos da minha existência é quando um recibo ou fatura é incorporado diretamente no corpo do e-mail em vez de vir como um anexo PDF organizado. Tenho que salvar manualmente o e-mail em PDF e enviar isso no lugar, e raramente fica limpo." Ele também tentou capturar a tela da parte do recibo e achou que não era melhor: "se for longo, não é prático e, sinceramente, leva mais tempo do que imprimir em PDF de qualquer forma." Outro comentarista no mesmo tópico apontou a causa subjacente: "A fatura incorporada no corpo do e-mail provavelmente é só HTML por baixo dos panos" (r/Bookkeeping).
A solução alternativa existe porque a ferramenta espera um arquivo. Remova essa expectativa e a solução alternativa desaparece junto.
A Correção é Mudar o Modo da Caixa de Entrada para que a Extração Leia o Próprio Corpo
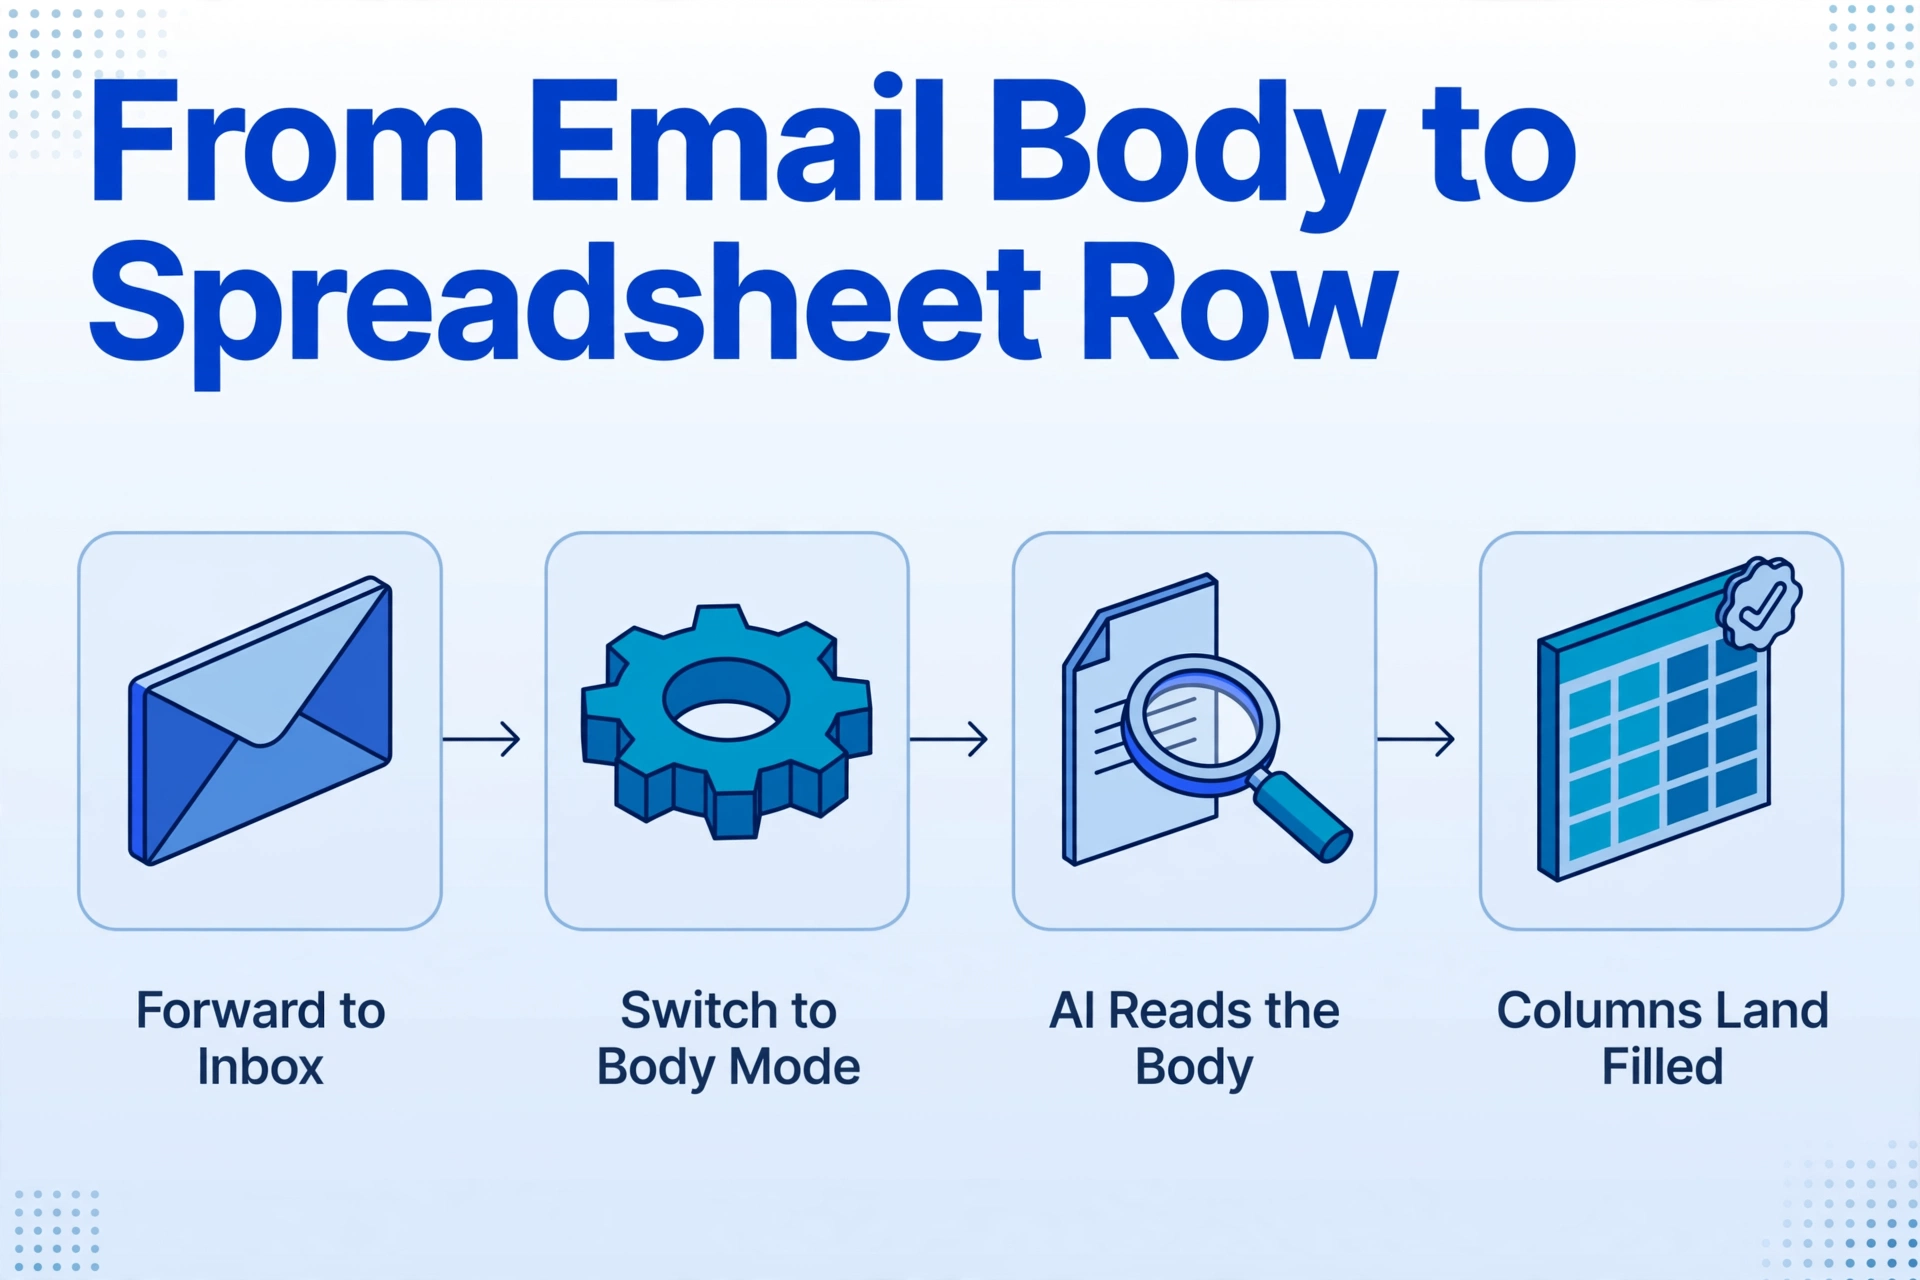
A correção é mudar o modo de processamento da caixa de entrada para que a extração leia diretamente o corpo da mensagem, em vez de esperar por um anexo que nunca vai chegar. O Email Inbox do ImageToTable.ai dá a cada conta um endereço de caixa de entrada dedicado para onde você encaminha os e-mails, e o comportamento padrão dele é o que causa o problema: ele lê anexos reais e ignora o corpo. A configuração que importa é a que você altera em seguida. Você pode mudar o processamento para body only, que ignora anexos, ou para attachments and body, que lê ambos na mesma passada.
Esse único interruptor é o que transforma uma fatura somente no corpo em uma entrada de primeira classe, em vez de uma lacuna. A mensagem não precisa mais de um arquivo para valer o processamento, porque o que está sendo lido é o próprio conteúdo da mensagem.
O que acontece com o conteúdo é a Extração de Colunas Personalizadas. Você digita os nomes das colunas que deseja, como Número da Fatura, Fornecedor, Data da Fatura, Data de Vencimento e Valor Total, e a IA localiza cada valor entendendo o que ele significa, não onde está. Os nomes que você digita se tornam os cabeçalhos da planilha de saída. Como as colunas são definidas pelo significado, o mesmo conjunto de colunas lê um corpo em texto puro, um recibo em HTML e um anexo em PDF sem uma regra separada para cada um. Um fornecedor que muda o modelo de e-mail, ou um novo fornecedor que envia um formato que você nunca viu, não exige reconfiguração.
Reenvie o e-mail ao endereço da sua caixa de entrada dedicada
Cada conta recebe um endereço. Comparta-o com os fornecedores ou configure uma regra de reenvio na sua própria caixa de correo para que os e-mails de fatura sejam roteados lá automaticamente. Ative a lista de remitentes autorizados para manter e-mails não relacionados fora da fila. Nada é baixado ou reenviado.
Altere o que a caixa de entrada processa
Nas configurações da caixa de entrada, saia do padrão de somente anexos. Escolha body only se suas faturas chegam como texto ou HTML sem arquivo, ou attachments and body se você recebe ambos os tipos e deseja que sejam lidos juntos. Este é o passo que cobre as faturas que nenhum parser de anexos jamais vê.
Nomee as colunas uma vez e vincule-as a um modelo
Digite os nomes das suas colunas, salve-os como um modelo e ative o Auto-Process para que a extração comece no momento em que uma mensagem chega. Cada e-mail se torna uma linha. Exporte o lote como Excel, CSV ou JSON, ou envie as linhas diretamente ao Google Sheets.
Se você já usa um fluxo de trabalho de e-mail para planilha para faturas anexadas, esta é a ramificação que faltava, não um substituto. O parser de e-mail que lê anexos e o pipeline de e-mail de fornecedor para AP ambos assumem que um arquivo está presente. Alternar o modo de processamento é como a mesma caixa de entrada também captura as mensagens que chegam sem um.
Os arquivos são processados de forma segura e não são armazenados.
O Que Isso Não Resolve
Esta abordagem lida com faturas somente com corpo que carregam seus dados em texto ou HTML, e não pode ajudar com e-mails que não carregam nenhum dado. Quatro limites valem ser declarados antes de você construir um fluxo de trabalho sobre ela.
Uma notificação de portal não tem nada para ler. Quando um fornecedor envia "sua fatura está pronta" com um link de login e sem valores, a alternância de modo de corpo não tem nada para extrair, porque os dados estão atrás de um portal autenticado. Ler essa fatura significa fazer login e baixá-la, e o link no e-mail geralmente expira. Nenhum parser de caixa de entrada fecha essa lacuna, porque o e-mail nunca foi a fatura.
Campos ausentes no corpo não podem ser inventados. Uma fatura em texto simples que diz "Fatura 2026-041, $1.850, vencimento em 15 de outubro" não tem itens de linha, então uma coluna de Itens de Linha volta vazia. A extração é honesta sobre isso: ela preenche o que a mensagem contém e deixa o resto em branco, o que é mais útil do que um palpite que você precisa corrigir depois. Onde a mensagem contém uma tabela detalhada, a tabela é lida; onde não contém, a linha simplesmente reflete o que o e-mail tinha.
A saída são dados estruturados, e eles permanecem estruturados. O que você obtém é uma planilha, um CSV ou uma linha JSON, e a ferramenta não re-renderiza o e-mail HTML como um documento. Se você precisar especificamente de um PDF organizado do e-mail para um arquivo de auditoria, isso é um trabalho separado.
Não é uma integração com QuickBooks ou Dext. A saída chega em Excel, CSV, JSON ou Google Sheets, e o que acontece em seguida é seu fluxo de trabalho. Equipes que usam Dext, Hubdoc ou Bill.com para captura e QuickBooks ou Xero para o razão geralmente tratam isso como o feed estruturado que esses sistemas consomem, em vez de um substituto para eles. Para uma visão mais ampla de onde a extração se posiciona em relação a essas ferramentas, o guia completo para extração de dados de faturas e o guia de extração focado em contadores cobrem o fluxo de trabalho ao redor.
Mais uma ressalva se aplica a cadeias encaminhadas. Quando uma mensagem cita várias respostas mais antigas, o mesmo total pode aparecer mais de uma vez, e a cópia mais antiga geralmente está no texto citado. A extração lê pelo significado, mas uma cadeia como esta é o único caso em que confirmar de qual ocorrência um valor veio vale trinta segundos. Review Mode existe para isso: passar o mouse sobre uma célula destaca exatamente de onde no original o valor veio, então a verificação é uma olhada rápida em vez de uma releitura.
FAQ
Consegue ler uma fatura que está apenas no corpo do e-mail, sem nenhum anexo?
Sim. Defina o modo de processamento da caixa de entrada como body only, ou como attachments and body se você receber os dois tipos. O conteúdo da mensagem é lido diretamente, então uma fatura digitada no e-mail ou renderizada como um recibo em HTML vira uma linha na planilha sem precisar ser baixada, impressa ou capturada em tela antes.
E quanto a faturas que chegam como uma tabela HTML no e-mail?
Essas funcionam na mesma etapa. A IA lê o conteúdo renderizado pelo significado, em vez de analisar a marcação bruta em busca de um padrão fixo, então um recibo formatado com valor, data e número da fatura organizados em células de tabela é lido da mesma forma que uma fatura em texto simples. Você não precisa de uma regra por remetente ou por layout.
Ainda preciso imprimir o e-mail em PDF ou tirar um print da tela?
Não, e para faturas longas esse é o caminho mais fraco. Imprimir ou capturar a tela paginiza o recibo, inclui a assinatura e o texto de aviso, e reduz a qualidade do documento que o modelo vê. Ler o corpo diretamente evita esses três problemas e elimina uma etapa manual que o tópico do r/Bookkeeping descreve como a parte que "realmente soma".
E quanto a e-mails de "sua fatura está pronta" com um link para o portal?
Esses não podem ser extraídos do e-mail, porque o e-mail não contém a fatura. Os dados estão atrás de um login do fornecedor, e o link de download frequentemente expira. Este é um limite real, não uma falha de configuração: a solução é um download pelo portal ou uma integração específica do fornecedor, não um parser melhor.
Ele envia dados para o QuickBooks ou Xero?
Ele gera dados estruturados em Excel, CSV ou JSON, ou escreve linhas no Google Sheets. A integração com um sistema contábil acontece depois dessa saída, por meio da sua própria importação ou fluxo de trabalho. Não é um conector nativo do QuickBooks ou Xero, e não substitui as ferramentas de captura e lançamento que você já utiliza.
Ele converterá o e-mail HTML em PDF?
Não. A tarefa aqui é a extração: transformar o conteúdo da fatura na mensagem em colunas nomeadas. Se você precisar especificamente de um artefato em PDF para seus registros, gere isso separadamente; isto produz a linha estruturada para a qual um PDF seria apenas uma etapa intermediária.
A mudança útil é pequena e específica. Uma fatura body only deixa de ser uma exceção que força um trabalho manual, porque aquilo que o fluxo de trabalho lê não é mais um arquivo. Quando a fatura é o e-mail, o e-mail é o documento.