請求書がメール本文にある場合、
添付ファイルではない場合
ほとんどの請求書抽出ツールは、1つの前提に基づいて構築されています。それは、必要なデータがメッセージに添付されたファイルの中にあるという前提です。この前提は、多くの仕入先請求書に当てはまります。しかし、請求書がメール自体であり、本文にHTMLまたはプレーンテキストとして書かれていて、メッセージ内にPDFが一切ない場合には、この前提は完全に崩れます。そのような場合、添付ファイル優先のツールは誤った数値を返すのではありません。何も返さず、しかも何も返さなかったことを知らせないのです。
重要なポイント
- お客様がすでに信頼している請求書パーサーは、ほとんどの請求書が添付ファイルとして届くため、その大半について正しい結果を返します。
- body onlyの請求書では空の行を返し、エラーを報告しません。これはよりコストのかかる種類の失敗です。
- Email Inboxを本文自体を読み取るように切り替えると、印刷してPDF化する手順なしで、同じメールがスプレッドシートの行に変わります。
請求書がメール本文のみに存在する場合、添付ファイル優先ツールは何も返しません
メール本文のみに存在する請求書には、添付ファイル優先パーサーが開くファイルがないため、パーサーは空の行を返し、エラーを報告しません。抽出パイプラインは実行されたように見えます。出力は、抽出するものが単になかったメッセージのように見えます。誰もアラートを受け取らず、請求書は人間が行が空白であることに気づくまで受信ボックスに残ります。
これは珍しい形式ではありません。 これは、B2B請求の特定かつ成長中のセグメントにおけるデフォルトです。サブスクリプションおよび広告プラットフォームは、ファイルではなくフォーマットされたメッセージとして請求書を送信します。Stripeの領収書、AWSの月次請求サマリー、Google Workspaceの請求通知、Meta AdsおよびGoogle Adsの請求書、Uber for Businessの出張明細書などです。小規模なサプライヤーやフリーランサーも同様に行い、PDFを生成するよりも速いため、請求書番号と合計をメッセージに直接入力します。
これらを見逃すコストは理論上のものではありません。Ardent Partnersは、2025年に請求書1件の処理にかかる平均総コストを9.40ドルとし、ベストインクラスのチームでは2.78ドルであるとし、請求書のわずか32.6%しか人が触れずに処理されていないことを明らかにしました(Ardent Partners、AP Metrics That Matter in 2025)。自動化されたパスから外れた請求書はすべて、そのコスト範囲の手作業側で手作業によって処理されます。
添付ファイル優先パーサーは、body onlyの請求書に対して大きな失敗をしません。添付ファイルが見つからないことに成功するのです。これは、より高くつく種類の失敗です。
Body Onlyの請求書は3つの形状で届き、そのうち2つだけが抽出可能なデータを持ちます
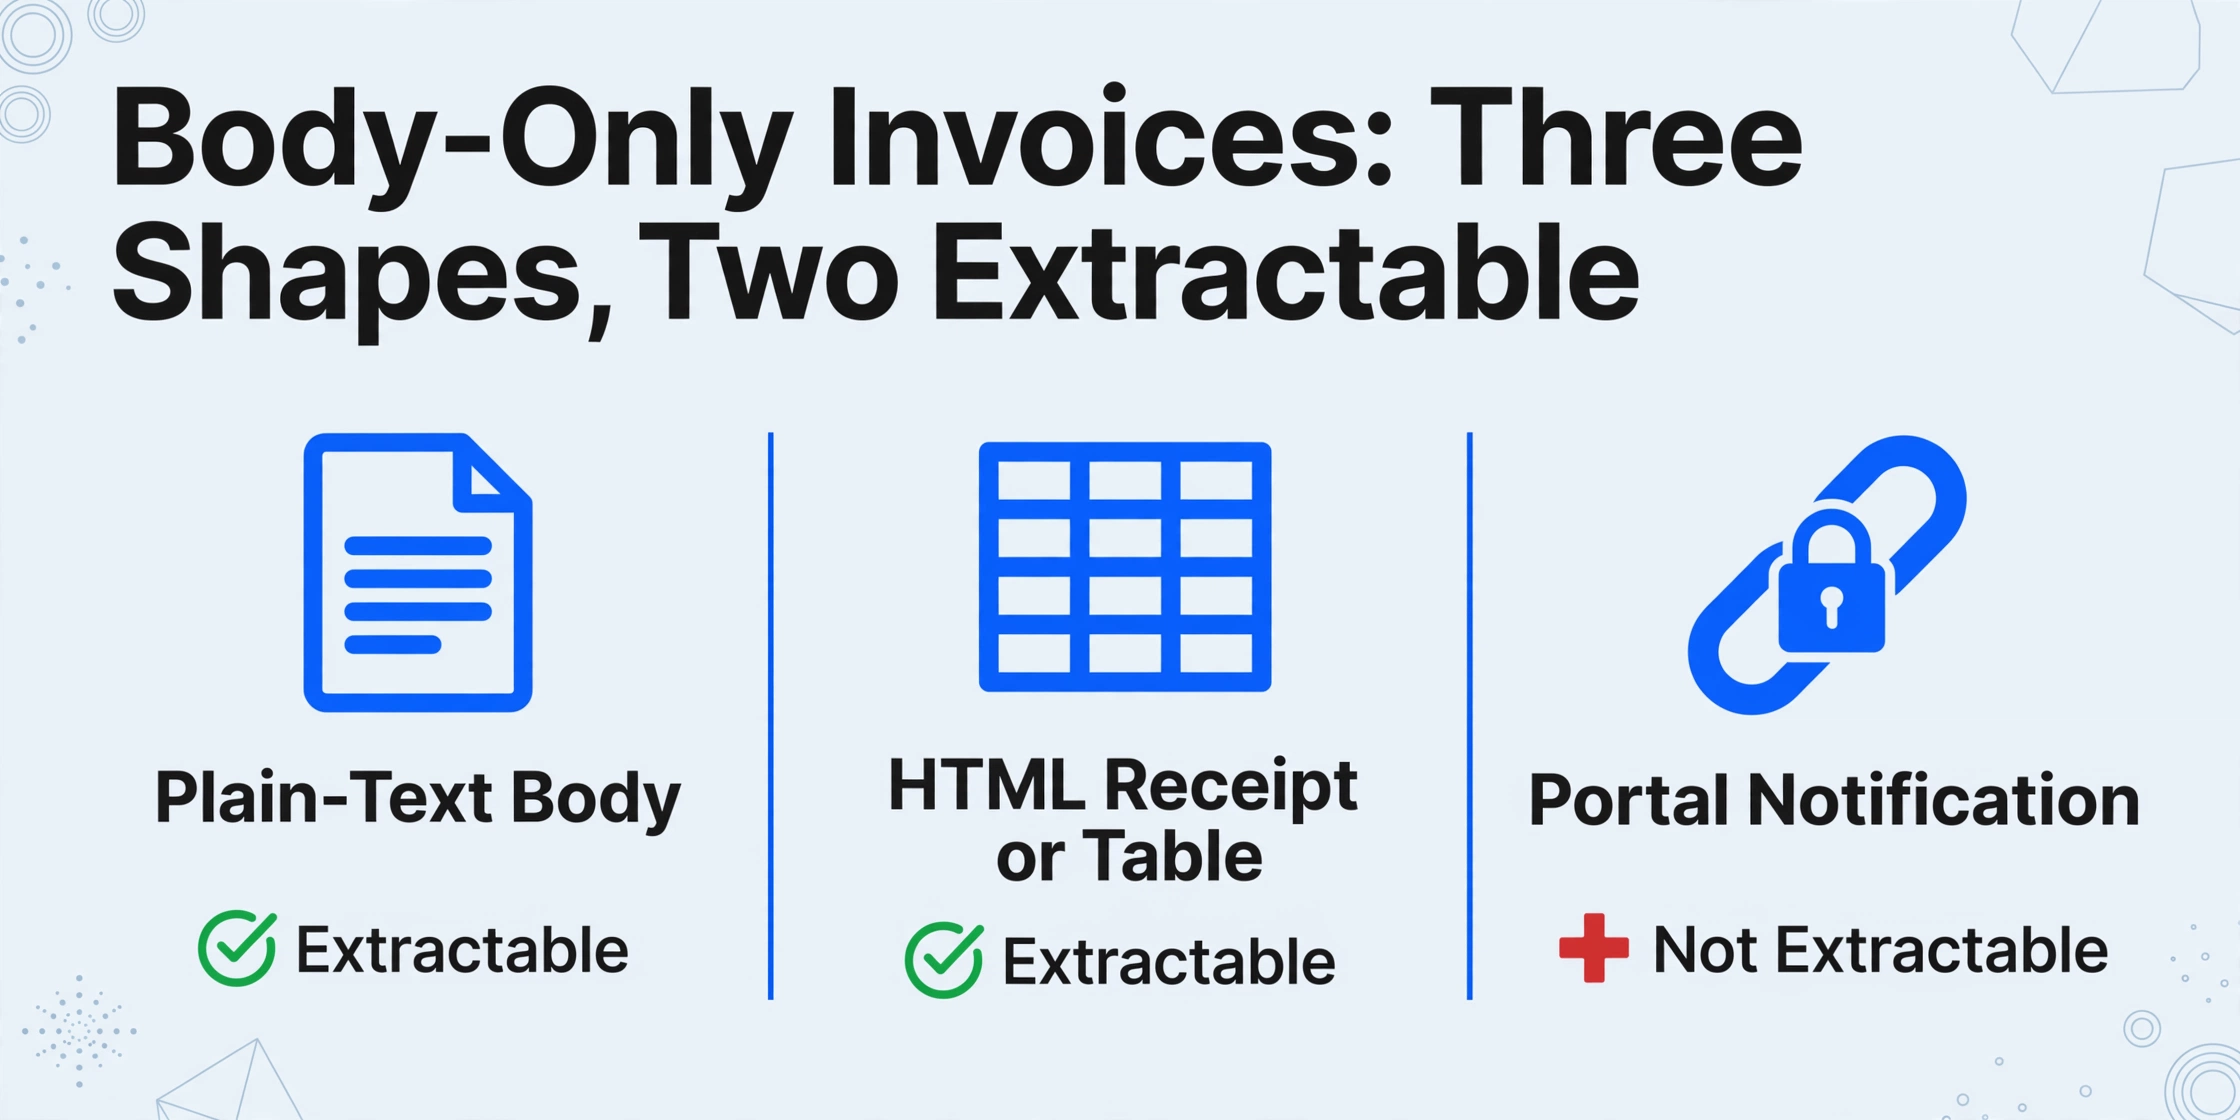
Body onlyの請求書は3つの形状で受信ボックスに届き、そのうち2つだけが機械が実際に読み取れるデータを含んでいます。どの形状を見ているかを知ることで、抽出がそもそも可能かどうか、またはスプレッドシートの行になることは決してなかったリンクを追いかけているかどうかがわかります。
| 形状 | 見た目 | スプレッドシートの行にできますか? |
|---|---|---|
| プレーンテキスト本文 | フリーランサーまたは小規模ベンダーが請求書番号、金額、期日をメッセージに直接入力します | はい。値はテキストとして存在します。構造化されていなくてもです |
| HTML領収書またはテーブル | サブスクリプションまたは広告プラットフォームがフォーマットされた領収書(多くの場合、実際のテーブル)を本文に表示します | はい。値は存在しますが、フィールドとしてではなくレイアウトとしてです |
| ポータル通知 | 「請求書の準備ができました。ログインして表示およびダウンロードしてください。」メッセージは請求書を告知します。請求書自体はログインの背後にあります | いいえ。メールは請求書を運ぶのではなく指し示すものであり、ダウンロードリンクは期限切れになります |
最初の2つの形状と3つ目の形状の違いは、構造化されたドキュメントと、それに関する通知の違いです。欧州連合は、電子インボイスに関する定義でこの線引きを明確にしています。電子インボイスとは、「自動的かつ電子的な処理を可能にする構造化データ形式で発行、送信、受信される」ものです(欧州委員会、指令2014/55/EU)。フォーマットされたHTMLメールはこれに該当しません。それは、マークアップで描かれたインボイスの画像にすぎません。
欧州規格EN 16931では、インボイスフィールドはUBL構文内に独自のノードを持つ定義済みの意味要素です。インボイス番号はcbc:ID、発行日はcbc:IssueDate、支払額はcac:LegalMonetaryTotal/cbc:PayableAmountです(Peppol BIS Billing 3.0)。HTMLの領収書では、これらの同じ値はスタイルシートで配置された表のセルにあり、プログラムが頼れるラベルはありません。このギャップこそが、body onlyのインボイスが添付PDFよりも抽出が難しく、簡単ではない理由です。
ここでパーサーが失敗する理由:HTMLはプレーンテキストではなく、印刷用PDF化でデータが劣化する
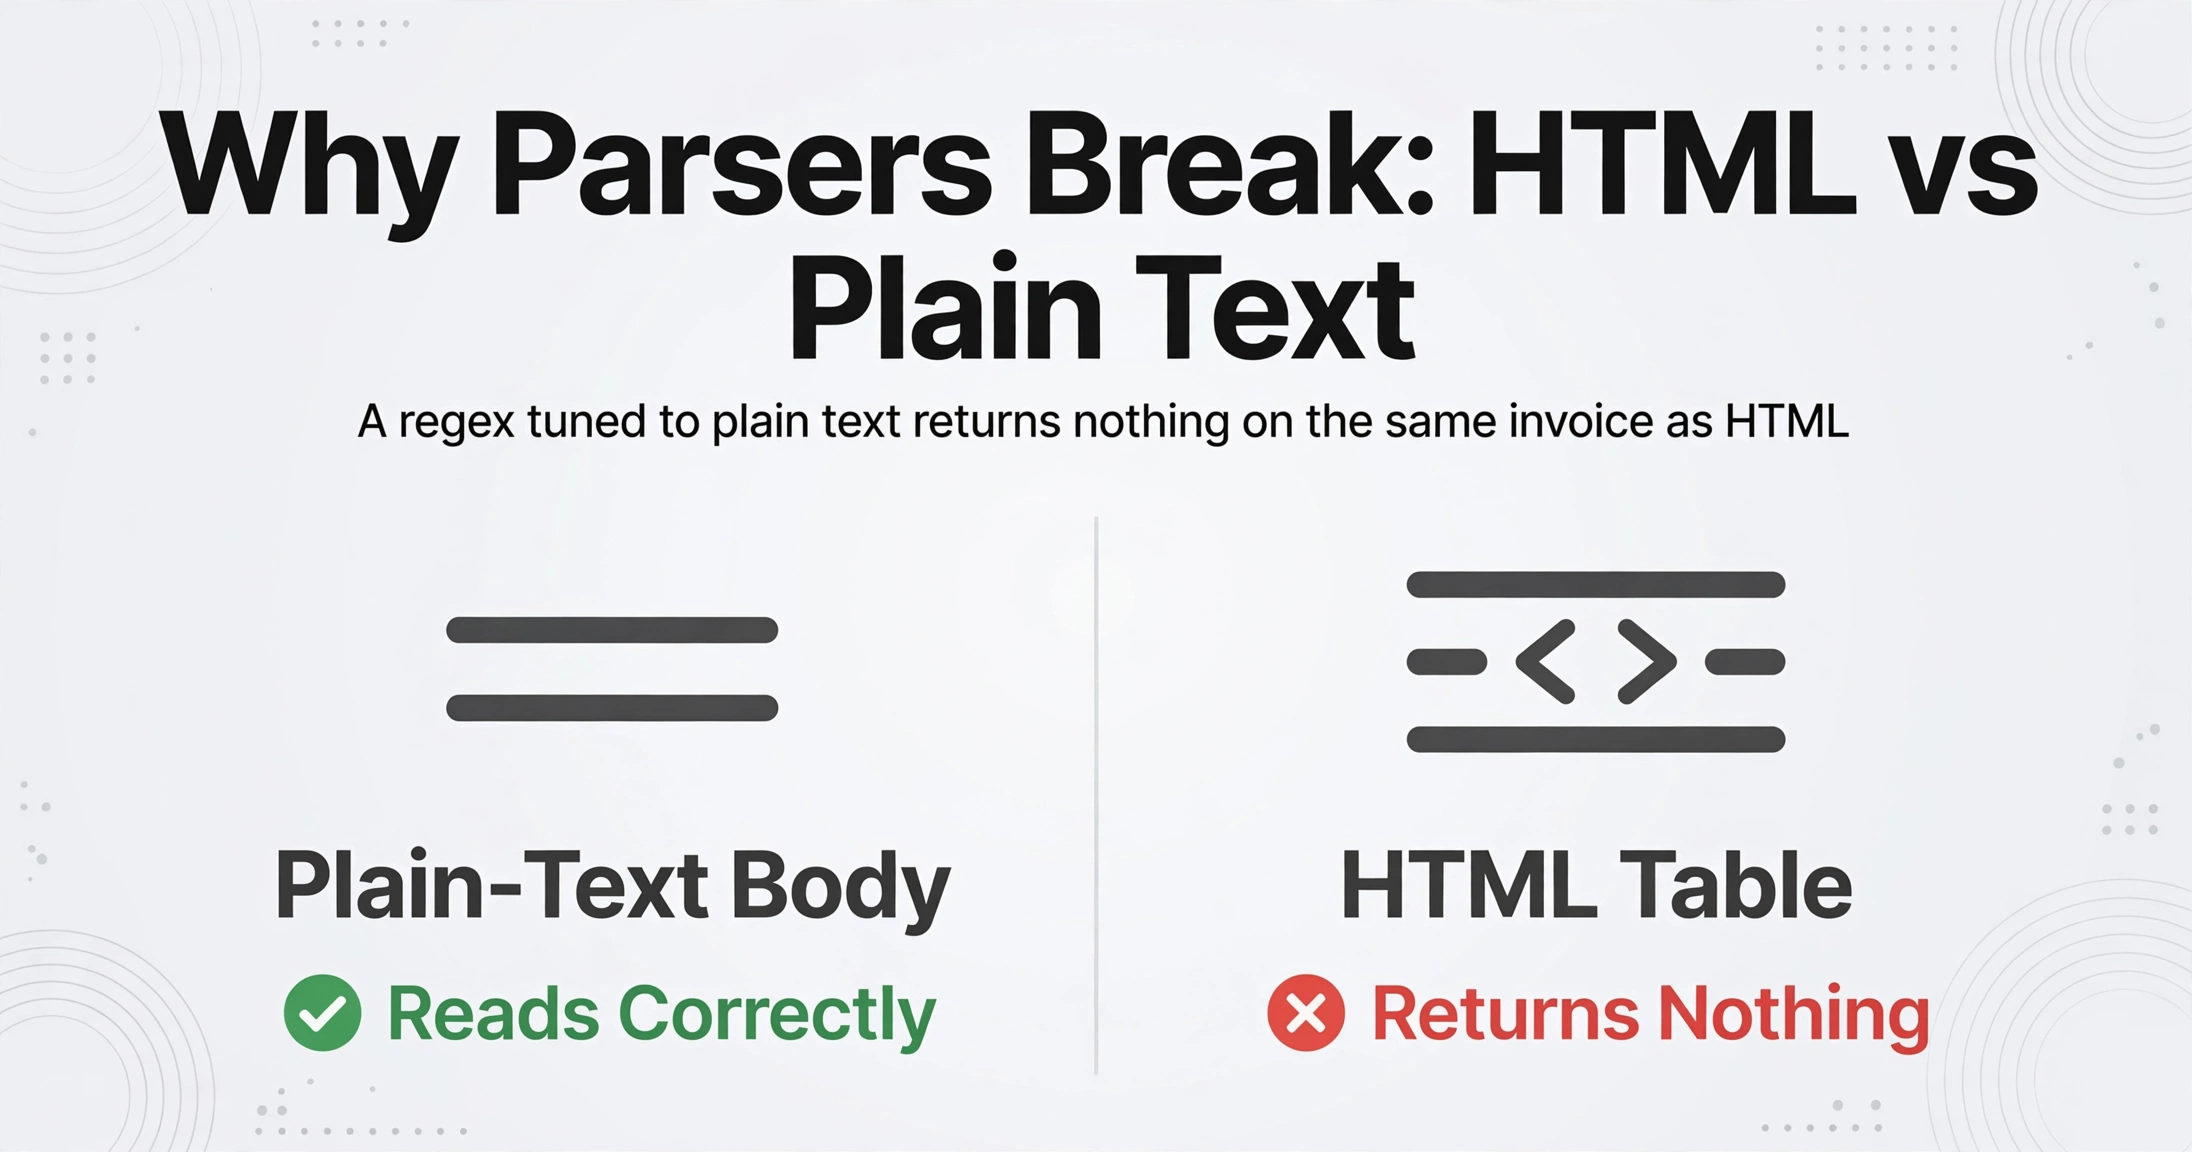
パーサーがbody onlyのインボイスで失敗する理由は、OCR品質とは無関係です。メール本文はHTMLであり、ほとんどのパーサーが想定するプレーンテキストではないからです。「Amount due: $X」に調整された正規表現は、プレーンテキスト本文を正しく読み取りますが、同じインボイスがHTMLテーブルとしてレンダリングされると、値とラベルがマークアップで分離されているため、何も返しません。マルチパートメッセージのプレーンテキストフォールバック部分では、テーブル全体が削除されることが多く、レイアウトが揃わなくなります。
一般的な回避策は、メールをPDFに印刷して処理することです。これは現在、ほとんどの簿記担当者が行っている方法ですが、3つの別々の理由で脆弱です。1つ目はページ分割です。長い領収書や明細テーブルがページをまたいで分割され、合計が明細項目とは別のページに表示されます。2つ目はノイズです。印刷されたPDFには、送信者、件名、署名ブロック、法的免責事項が含まれるため、抽出ツールは「total」という単語を含むフッターからインボイス合計を判別する必要があります。3つ目は、PDFへの印刷ステップ自体がドキュメント品質の低下であることです。
2025年のFraunhofer IAISとLamarr Instituteによるベンチマークでは、8つのマルチモーダルモデルをインボイス抽出でテストし、同じトップモデルがクリーンなデジタルインボイスで96.50%、スキャンされたインボイスで92.71%、スキャンされた領収書で87.46%のスコアを獲得しました(arXiv:2509.04469)。精度はモデルよりもドキュメント品質に大きく左右されます。HTMLインボイスをPDFやスクリーンショットにレンダリングすると、意図的にそのスケールを下げることになります。
このフラストレーションは、実際に作業をしている人々の言葉に如実に表れています。r/Bookkeepingでは、ある簿記担当者が日常をこう語っています。「領収書や請求書がメールの本文に直接埋め込まれていると、きれいなPDF添付ファイルとして届く場合と違って、本当に厄介です。メールを手動でPDFに保存してアップロードし直さなければならず、しかもそれがきれいに仕上がることはほとんどありません。」彼らは領収書部分のスクリーンショットも試しましたが、改善にはなりませんでした。「長い場合は現実的ではなく、正直言ってPDFに印刷するよりも時間がかかります。」同じスレッドの別のコメント投稿者は、根本的な原因を指摘しています。「メール本文に埋め込まれた請求書は、おそらくその正体はHTMLに過ぎません」(r/Bookkeeping)。
この回避策が存在するのは、ツールがファイルを前提としているからです。その前提を取り除けば、回避策も一緒に消え去ります。
解決策は、受信ボックスのモードを切り替えて、抽出が本文自体を読み取るようにすることです
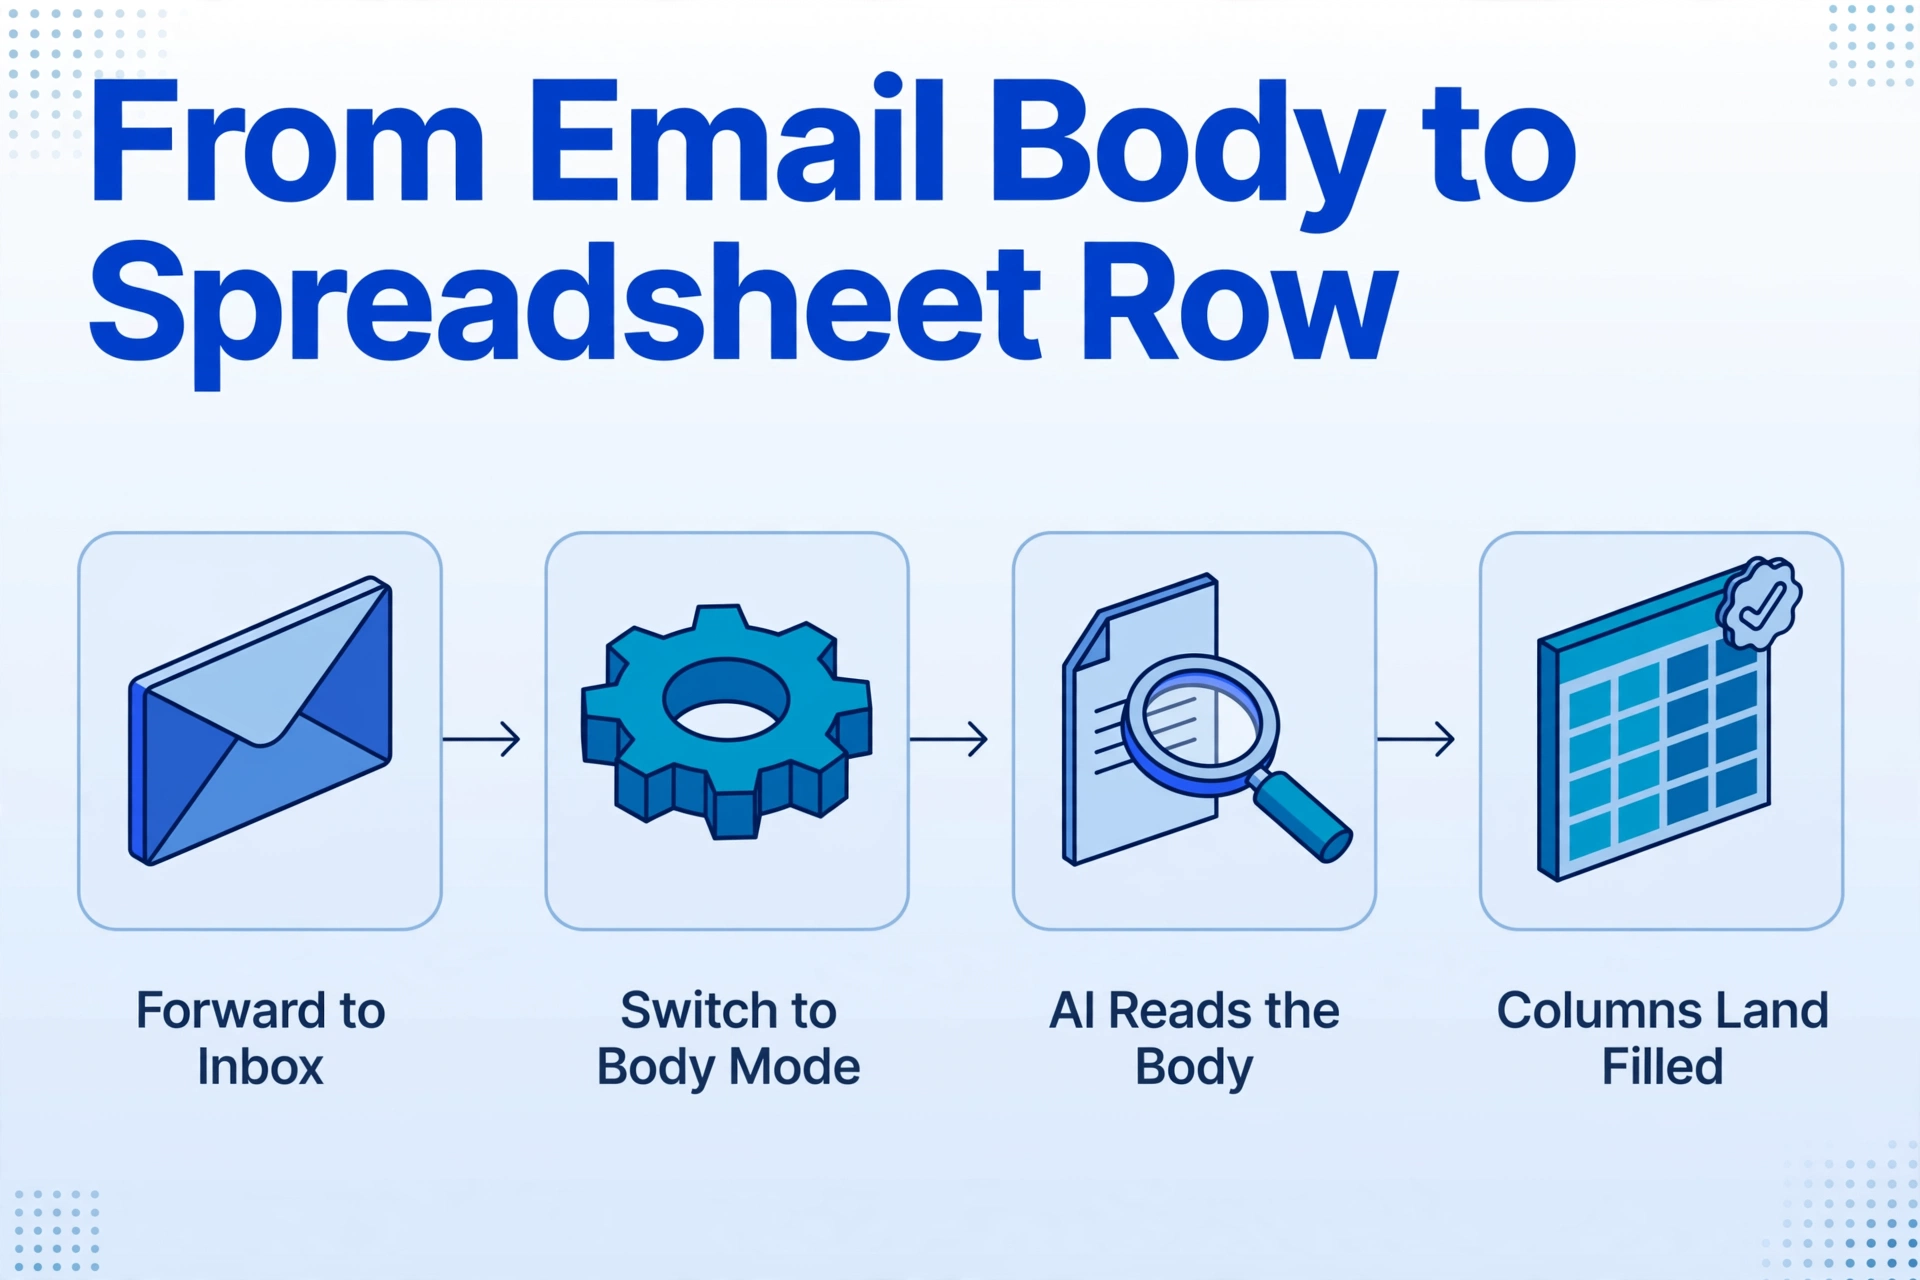
解決策は、受信ボックスの処理モードを切り替えて、抽出がメッセージ本文を直接読み取るようにすることです。添付ファイルが届くのを待つ必要はありません。ImageToTable.aiのEmail Inboxは、すべてのアカウントに、メールを転送する専用の受信ボックスアドレスを提供します。そして、そのデフォルトの動作こそが問題の原因です。実際の添付ファイルを読み取り、本文を無視します。重要なのは、次に変更するこの設定です。処理をbody onlyに切り替えると添付ファイルが無視され、attachments and bodyに切り替えると同じパスで両方を読み取ります。
この単一のトグルこそが、本文のみの請求書をギャップではなく第一級の入力にするものです。メッセージは、処理する価値のあるファイルを必要としなくなります。なぜなら、読み取られるものはメッセージのコンテンツそのものだからです。
コンテンツに対して行われるのはカスタム列抽出です。Invoice Number、Vendor、Invoice Date、Due Date、Total Amountなど、必要な列名を入力すると、AIは値がどこにあるかではなく、何を意味するかを理解して各値を特定します。入力した名前が出力スプレッドシートのヘッダーになります。列が意味によって定義されているため、同じ列セットがプレーンテキストの本文、HTMLの領収書、PDFの添付ファイルを、それぞれに個別のルールを設定することなく読み取ります。メールテンプレートを変更したベンダーや、見たことのない形式で送信してくる新しいベンダーでも、再設定は不要です。
専用の受信ボックスアドレスにメールを転送する
すべてのアカウントに1つのアドレスが付与されます。サプライヤーと共有するか、ご自身のメールボックスに転送ルールを設定して、請求書メールが自動的にそこへ届くようにします。送信者ホワイトリストを有効にすると、無関係なメールがキューに入るのを防げます。ダウンロードや再アップロードは一切行われません。
受信ボックスが処理する内容を変更する
受信ボックス設定で、添付ファイルのみというデフォルトから変更します。請求書がファイルなしのテキストやHTMLで届く場合はbody onlyを選択し、両方の形式を受け取って一緒に読み取りたい場合はattachments and bodyを選択します。このステップで、添付ファイルパーサーが決して認識しない請求書にも対応できます。
列名を一度設定してテンプレートに紐付ける
列名を入力してテンプレートとして保存し、Auto-Processを有効にすると、メッセージが届いた瞬間に抽出が開始されます。各メールが1行になります。バッチをExcel、CSV、JSONでエクスポートするか、行をGoogle Sheetsに直接送信できます。
添付ファイル付き請求書のメールからスプレッドシートへのワークフローをすでに運用している場合、これは置き換えではなく、欠けていた分岐です。添付ファイルを読み取るメールパーサーとサプライヤーメールからAPへのパイプラインはどちらもファイルの存在を前提としています。処理モードを切り替えることで、同じ受信ボックスがファイルなしで届くメッセージも捕捉できるようになります。
ファイルは安全に処理され、保存されることはありません。
これが解決しないこと
このアプローチは、テキストまたはHTMLでデータを運ぶbody onlyの請求書を処理し、データを一切含まないメールには対応できません。この上にワークフローを構築する前に、4つの境界を明確にしておく価値があります。
ポータル通知には読み取るものがありません。ベンダーがログインリンクと数字なしで「請求書が準備できました」と送信する場合、データは認証されたポータルの背後にあるため、body-modeスイッチには抽出するものがありません。その請求書を読むにはログインしてダウンロードする必要があり、メール内のリンクはしばしば期限切れになります。メール自体が請求書ではなかったため、どのインボックスパーサーもこのギャップを埋めることはできません。
本文に存在しないフィールドは作り出せません。「請求書2026-041、$1,850、10月15日支払い期限」と書かれたプレーンテキストの請求書には明細項目がないため、Line Items列は空で返されます。抽出はこれについて正直です。メッセージに含まれるものを埋め、残りは空白のままにします。これは後で見つけなければならない推測よりも有用です。メッセージに明細化されたテーブルが含まれる場合はそれが読み取られ、含まれない場合は行は単にメールにあったものを反映します。
出力は構造化データであり、構造化されたままです。得られるものはスプレッドシート、CSV、またはJSON行であり、ツールはHTMLメールをドキュメントとして再レンダリングしません。監査ファイル用にメールの整ったPDFが具体的に必要な場合は、それは別の作業です。
QuickBooksやDextの統合ではありません。出力はExcel、CSV、JSON、またはGoogle Sheetsに出力され、次に何が起こるかはお客様のワークフロー次第です。キャプチャにDext、Hubdoc、Bill.comを使用し、元帳にQuickBooksやXeroを使用するチームは、通常これをそれらのシステムが消費する構造化フィードとして扱い、それらの代替とは見なしません。抽出がそれらのツールに対してどこに位置するかの全体像については、請求書データ抽出の完全ガイドと会計士向け抽出ガイドが周囲のワークフローをカバーしています。
転送チェーンにはもう1つの注意点が当てはまります。メッセージが複数の古い返信を引用している場合、同じ合計が複数回表示されることがあり、最も古いコピーはしばしば引用テキストにあります。抽出は意味によって読み取りますが、このようなチェーンは、値がどの出現箇所から来たかを確認するのに30秒かける価値がある唯一のケースです。Review Modeはそのために存在します。セルにホバーすると、値がソースのどこから来たかが正確に強調表示されるため、チェックは再読むのではなく一目で済みます。
FAQ
メール本文のみに記載された請求書で、添付ファイルがまったくない場合でも読み取れますか?
はい。受信ボックスの処理モードを「body only」または、両方の形式を受け取る場合は「attachments and body」に設定してください。メッセージの内容が直接読み取られるため、メールに記載された請求書やHTMLレシートとして表示されたものも、ダウンロードや印刷、スクリーンショットをせずにスプレッドシートの行になります。
メール内にHTMLテーブルとして届く請求書はどうなりますか?
それらも同じ工程で処理されます。AIは固定パターンのための生のマークアップを解析するのではなく、レンダリングされた内容を意味で読み取るため、金額、日付、請求書番号がテーブルのセルに配置された整形済みレシートも、プレーンテキストの請求書と同じように読み取られます。送信者ごとやレイアウトごとのルールは不要です。
メールをPDFに印刷したりスクリーンショットを撮ったりする必要はまだありますか?
いいえ、長い請求書の場合、それはむしろ低品質な方法です。印刷やスクリーンショットはレシートをページ分割し、署名や免責事項のテキストを取り込み、モデルが見るドキュメント品質を低下させます。本文を直接読み取ることで、これら3つの問題すべてが回避され、r/Bookkeepingのスレッドが「本当に積み重なる」と述べている手作業のステップも不要になります。
ポータルリンク付きの「請求書の準備ができました」というメールはどうなりますか?
これらはメールから抽出できません。なぜなら、メールに請求書が含まれていないからです。データはベンダーログインの背後にあり、ダウンロードリンクもしばしば失効します。これは設定の欠陥ではなく実際の制限です。解決策はポータルからのダウンロードやベンダー固有の統合であり、より良いパーサーではありません。
QuickBooksやXeroにデータをプッシュしますか?
構造化データをExcel、CSV、JSONとして出力するか、Google Sheetsに行を書き込みます。会計システムへの統合はその出力の後段で、お客様自身のインポートやワークフローを通じて行われます。ネイティブのQuickBooksやXeroコネクタではなく、すでに運用中のキャプチャや元帳ツールを置き換えるものでもありません。
HTMLメールをPDFに変換しますか?
いいえ。ここでの作業は抽出です。メッセージ内の請求書コンテンツを名前付きの列に変換します。記録用にPDFファイルが具体的に必要な場合は、別途生成してください。ここで生成されるのは構造化された行であり、PDFはその中間ステップにすぎません。
有益な変化は小さく、具体的です。body onlyの請求書は、手動の回避策を強制する例外ではなくなります。ワークフローが読み取るものがファイルではなくなるからです。請求書がメールである場合、メールがドキュメントです。