ImageToTable vs. Parseur:
Mit Vorlage oder ohne Vorlage? Ein ehrlicher Vergleich 2026
Die Wahl zwischen ImageToTable und Parseur läuft auf eine Frage hinaus: Kommen Ihre Dokumente in vorhersehbaren, gleichbleibenden Formaten – oder haben Sie es mit Layoutvielfalt zu tun, die sich je nach Anbieter, Monat und Quelle ändert? Die Antwort beeinflusst nicht nur, welches Tool schneller eingerichtet ist. Sie entscheidet, ob Ihre Extraktionspipeline mit der Zeit einfacher wird oder zu einem Wartungslaufband verkommt. Beide Tools extrahieren Daten zuverlässig aus Dokumenten. Doch sie gehen das Problem aus gegensätzlichen Architekturphilosophien an, und die Philosophie, die für ein Team mit drei stabilen Lieferanten funktioniert, wird ein Team frustrieren, das Rechnungen von vierzig Anbietern jongliert, die ihre Layouts nach eigenem Zeitplan aktualisieren.
Die wichtigsten Erkenntnisse
- Jeder Vergleich von Extraktionstools liest sich gleich, bis Ihnen auffällt, was fehlt – niemand berechnet, was nach drei Monaten passiert, wenn die Lieferantenformate zu driften beginnen.
- Vorlagenpflege ist keine einmalige Einrichtungskosten – sie ist eine unvorhersehbare wiederkehrende Steuer, die mit jedem Anbieter wächst, der sein Dokumentdesign aktualisiert.
- Überspringen Sie die Vergleichstabelle und stellen Sie eine Frage: Wie oft haben Ihre Lieferanten letztes Jahr ihre Layouts geändert? Mehr als zweimal bedeutet, dass ohne Vorlage das gesamte Wartungslaufband eingespart wird, nicht nur die Ersteinrichtung.
Kurzvergleich
Bevor wir auf die einzelnen Dimensionen eingehen, hier ein Überblick, wie sich die beiden Tools bei den Faktoren unterscheiden, die bei der Entscheidung für eine Dokumentenextraktion am wichtigsten sind.
| Dimension | Parseur | ImageToTable.ai |
|---|---|---|
| Extraktionsmodell | Drei Engines: vorlagenbasiert (Zone/Schlüsselwort), KI-Extraktion, CSV-Auto-Parsing — beste Genauigkeit mit Vorlagen | Vision LLM — liest die Dokumentensemantik direkt; keine Vorlagen, kein Training, keine Layout-Abhängigkeit |
| Einrichtungszeit | 15–30 Minuten pro Vorlage; mehrere Vorlagen für mehrere Anbieter nötig | Unter 1 Minute — Spaltennamen eingeben, hochladen, Ergebnisse erscheinen |
| Umgang mit Formatänderungen | Vorlagen brechen; manuelle Aktualisierung nötig; die KI-Engine fängt einen Teil der Variationen ab | Automatisch — die semantische Extraktion passt sich an jede Layoutänderung an |
| E-Mail-Eingang | Nativ — dediziertes Postfach, automatische Weiterleitung, automatische Extraktion | Nativ — ein Postfach pro Konto, Auto-Process bindet an eine Vorlage |
| Batch-Verarbeitung + Zusammenführung | Ergebnisse pro Dokument; keine integrierte Batch-Merge-Oberfläche | Nativ Batch-First: Dokumente in gemischten Formaten in eine ausgerichtete Tabelle zusammenführen |
| Berechnete / abgeleitete Spalten | Nicht unterstützt — nur Rohwerte; Nachbearbeitung über Python in Scale-Plänen | Nativ — Summen berechnen, Kategorien klassifizieren, Werte während der Extraktion ableiten |
| Zapier / Make-Integration | Nativ — tiefe Integration mit beiden Plattformen | Direkter Excel/CSV/JSON-Download; kein nativer Zapier-Connector |
| Einstiegspreis (100 Dokumente/Monat) | 39–49 $/Monat für 100 Seiten | 9 $/Monat für 150 Credits — ca. 5× günstiger im Einstiegsbereich |
Die Tabelle macht die Kompromisse sichtbar. Doch die eigentliche Entscheidung hängt davon ab, welche dieser Dimensionen in Ihrem Workflow am wichtigsten ist. Gehen wir sie einzeln durch.
Einrichtung & Onboarding: Vorlagen vs. Spaltennamen
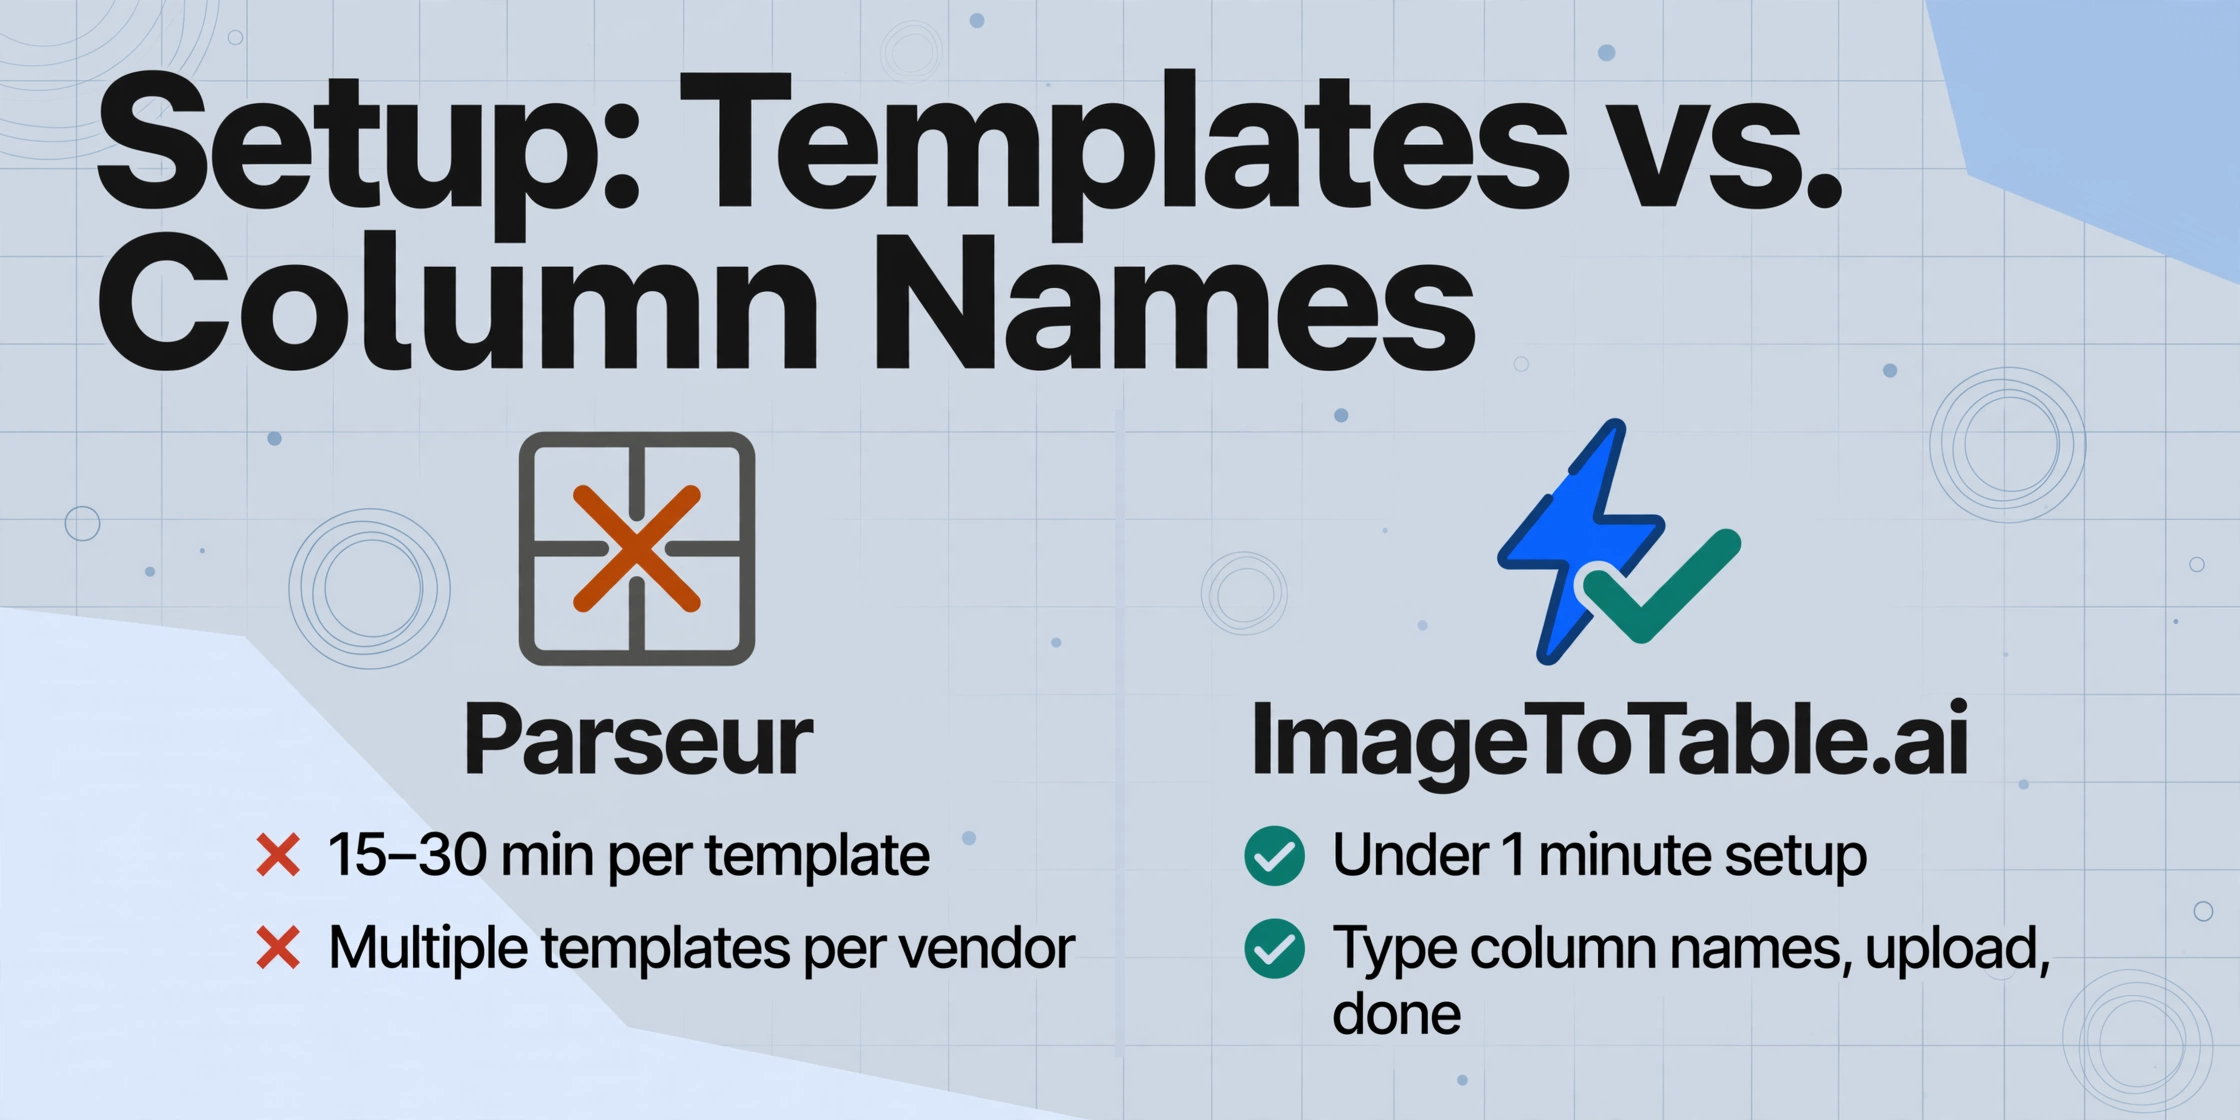
Parseur organisiert die Extraktion rund um „Mailboxes“ – jede Mailbox ist ein eigener Dokumenteingangskanal mit eigener Parsing-Konfiguration. Beim ersten Verarbeiten eines Dokumenttyps erkennt Parseur Felder beim ersten Upload automatisch – ein wirklich hilfreicher Ausgangspunkt. Um jedoch zuverlässige Ergebnisse zu erzielen, werden Sie zum Erstellen einer Vorlage geführt: Sie markieren Zonen auf einem Beispieldokument, definieren Feld-Extraktionsregeln (zonales OCR für feste Positionen, dynamisches OCR für Felder, die sich relativ zu einem Label bewegen) und trainieren das System auf dieses Layout. Die erste Vorlage benötigt in der Regel 15–30 Minuten zum Konfigurieren, Testen und Verfeinern.
Wenn Sie Dokumente von fünf Anbietern mit einheitlichen Formaten erhalten, sind das 75–150 Minuten Vorlageneinrichtung – ein einmaliger Aufwand, der sich auszahlt, wenn sich die Formate nie ändern. Wenn Sie jedoch Dokumente von dreißig Anbietern verarbeiten oder Ihre Dokumentquellen monatlich variieren, wird die Ersteinrichtung zu einer erheblichen Zeitinvestition, bevor Sie überhaupt einen Nutzen sehen.
ImageToTable kehrt diese Gleichung um. Sie richten keinen Eingangskanal ein – keine Mailboxes, keine Vorlagen, keine Felddefinitionen. Sie geben die Spaltennamen ein, die extrahiert werden sollen („Rechnungsnummer“, „Anbietername“, „Datum“, „Gesamt – exkl. Steuer“, „Positionen“) und laden Ihre Dokumente hoch. Das Vision LLM findet diese Werte, indem es versteht, was jedes Feld semantisch bedeutet. Es sucht nicht nach Text an einer bestimmten Pixelkoordinate oder neben einem bestimmten Label. Es sucht nach dem Konzept von „Rechnungsnummer“ – wo auch immer es steht, wie auch immer es bezeichnet ist, in jedem Dokumentlayout, das Sie ihm vorlegen. Für wiederkehrende Nutzer bedeutet Extraktion ohne Vorlage, dass Spaltenlisten als Presets gespeichert werden können, sodass dieselbe Extraktion bei jedem zukünftigen Batch ohne erneute Eingabe der Feldnamen läuft.
Der Unterschied zeigt sich vor allem im ersten Monat. Parseur verlangt Konfigurationszeit im Voraus, bevor Sie Ergebnisse sehen. ImageToTable liefert seine erste Extraktion in unter 10 Sekunden – Sie bewerten das Tool anhand Ihrer eigenen Dokumente, nicht anhand eines Einrichtungs-Tutorials.
Umgang mit Formatänderungen: Die versteckten Kosten der Vorlagenpflege
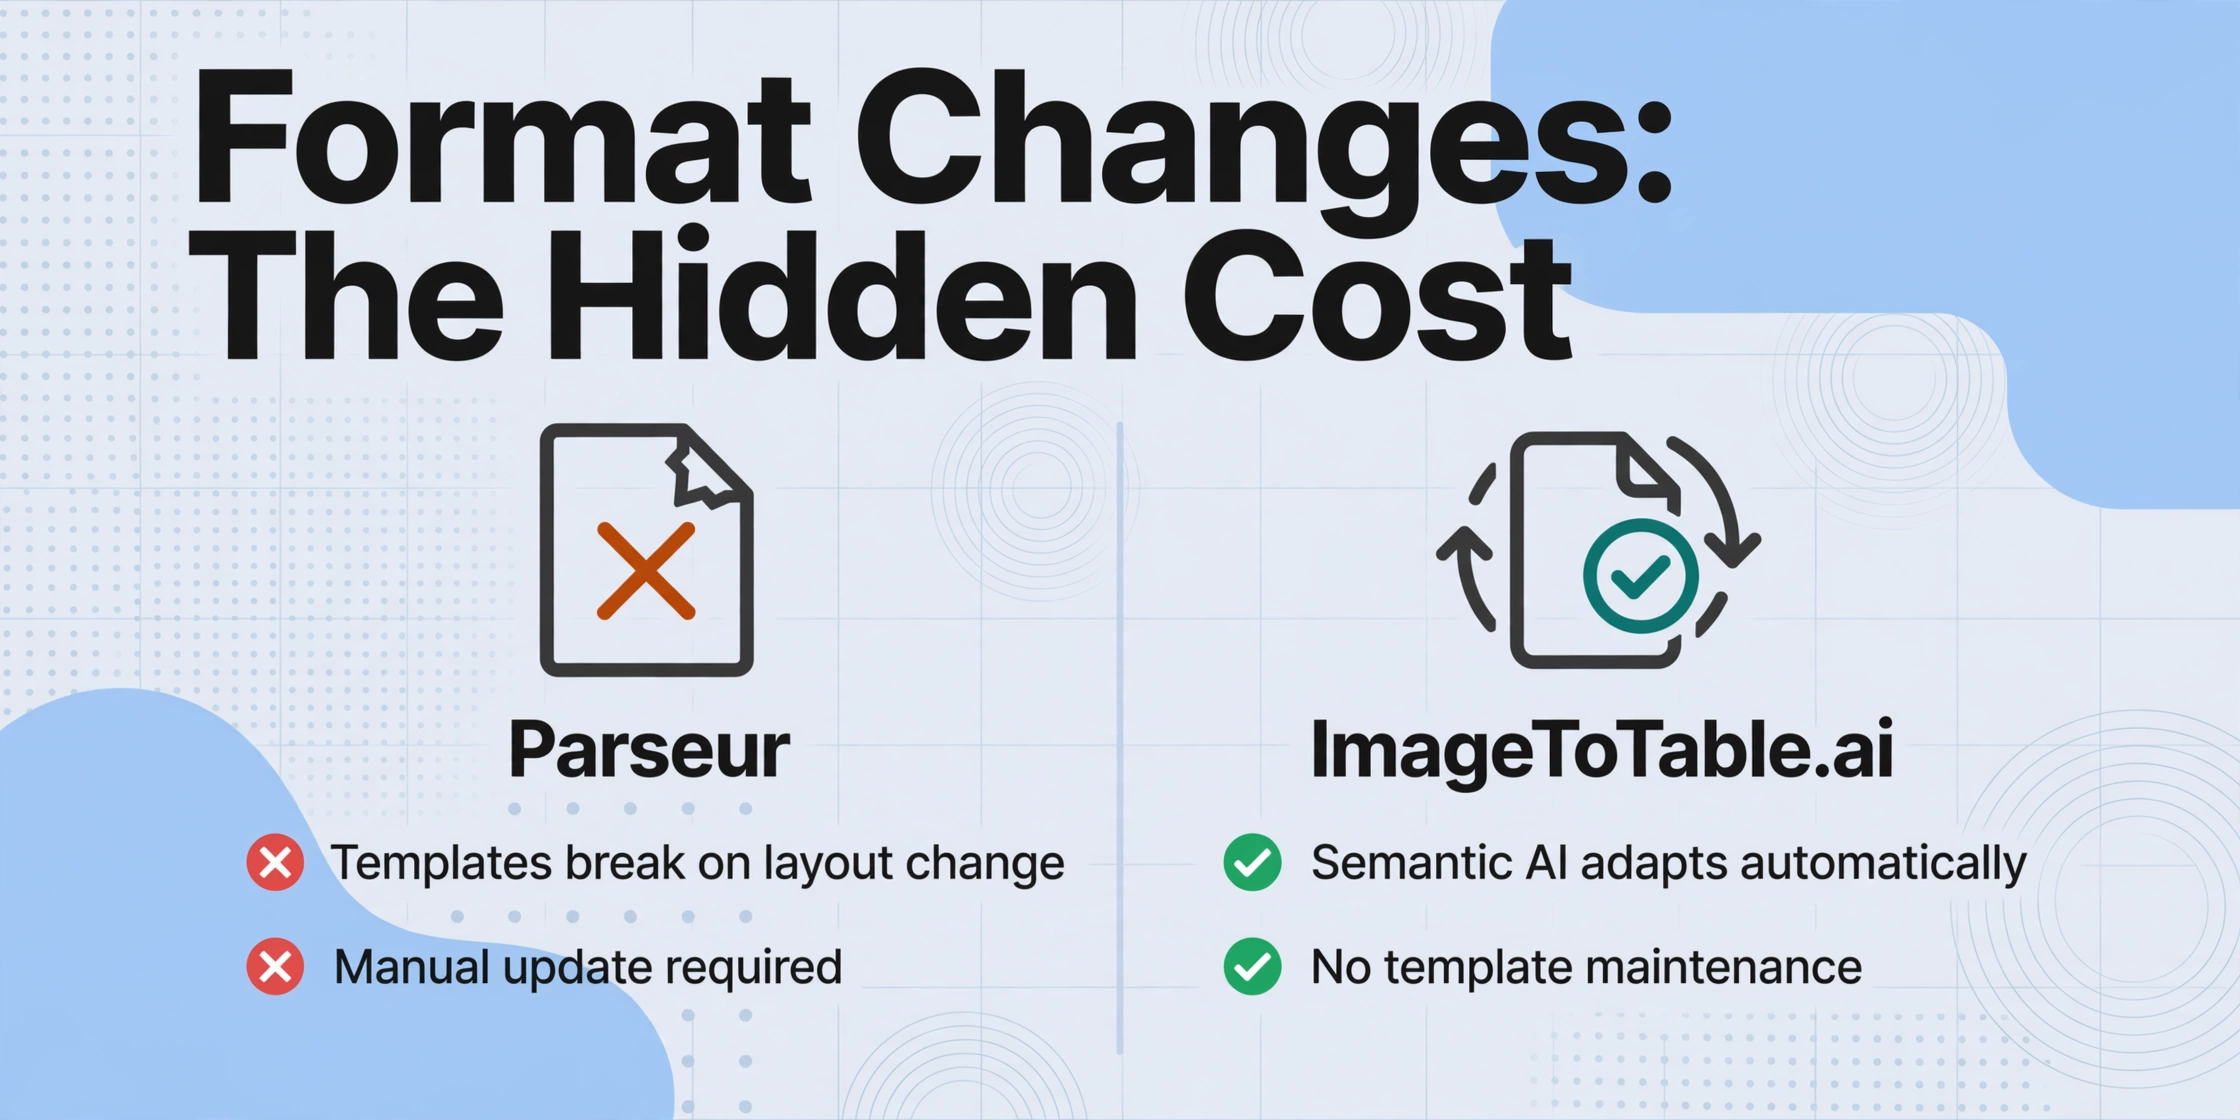
Dies ist die Dimension, die die beiden Tools am deutlichsten trennt, und zugleich diejenige, die die meisten Vergleichsartikel übergehen. Vorlagenbasierte Extraktion funktioniert perfekt – bis sie es nicht mehr tut. Und in der realen Dokumentenverarbeitung sind Formatänderungen keine Ausnahmen, sondern die Regel.
Lieferanten ändern ihre Rechnungslayouts, wenn sie die Buchhaltungssoftware wechseln, mit einem anderen Unternehmen fusionieren, ihr Branding überarbeiten oder neue Vorschriften einhalten. Ein Anbieter ändert seine Rechnungsvorlage – das Feld „Total“ wandert von unten rechts nach unten links. Ein Lieferant fügt seinem Bestellformat eine neue Kopfzeile hinzu. Ein E-Mail-Benachrichtigungssystem formatiert seine HTML-Vorlage neu und verschiebt die Bestelldetails in eine andere Tabellenstruktur. Jede Änderung bleibt für Sie unsichtbar, bis der nächste Dokumentenstapel mit Extraktionsfehlern eintrifft.
Die Template-Engine von Parseur – die bei bekannten Layouts die konsistentesten Ergebnisse liefert – bricht ein, wenn diese Änderungen auftreten. Die Feldpositionen, die Sie im Beispieldokument markiert haben, stimmen nicht mehr mit den tatsächlichen Daten überein. Das Anker-Schlüsselwort, das Sie für dynamisches OCR verwendet haben, wurde verschoben oder umbenannt. Die KI-Engine von Parseur ist flexibler als ihre Template-Engine – sie kann einige Layoutabweichungen verkraften, ohne zu brechen –, aber die KI-Engine arbeitet weiterhin innerhalb einer Dokumenttyp-Konfiguration, nicht über beliebige Layouts hinweg. G2-Rezensenten bestätigen dies: „Kleine Änderungen an E-Mail-Formaten können das Parsing stören.“ Jede Störung bedeutet einen manuellen Eingriff – Vorlageneditor öffnen, das verschobene Feld neu markieren, erneut testen, erneut bereitstellen.
Das Vision LLM von ImageToTable kümmert sich nicht darum, wo ein Feld auf der Seite steht. Es liest das Dokument als Ganzes und findet jedes angeforderte Feld anhand seiner Bedeutung. Ein Anbieter verschiebt „Total“ von unten rechts nach unten links – die KI findet „Total“ trotzdem. Ein Lieferant benennt „Invoice #“ in „Inv No“ um – die KI ordnet es Ihrer Spalte „Invoice Number“ zu, weil sie die semantische Beziehung versteht. Ein neuer Anbieter sendet ein Dokument in einem Format, das Sie noch nie gesehen haben – es wird beim ersten Upload korrekt verarbeitet, ohne dass eine Vorlage erstellt werden muss. Das ist die praktische Bedeutung von Dokumentenextraktion ohne Training: Das Tool passt sich automatisch an Formatabweichungen an, ohne Ihr Zutun.
Die wahren Kosten der Vorlagenpflege sind nicht die Ersteinrichtung – es ist der laufende, unvorhersehbare Aufwand, Vorlagen jedes Mal zu reparieren, wenn sich irgendwo in Ihrer Lieferkette ein Format ändert. Für Teams mit stabilen, bekannten Absendern sind diese Kosten gering. Für alle anderen verwandelt es das, was Automatisierung sein sollte, in eine reaktive Wartungsaufgabe.
E-Mail & Automatisierung: Parseurs unfairer Vorteil
Das ist die Dimension, in der Parseur gewinnt — und das sagen wir direkt. Parseur wurde von Grund auf um E-Mail als primären Kanal für den Dokumenteingang herum entwickelt. Sie erhalten eine dedizierte E-Mail-Adresse für jedes Postfach. Leiten Sie eingehende Rechnungen, Bestellungen, Versandbenachrichtigungen oder beliebige Anhänge an diese Adresse weiter, und Parseur verarbeitet sie automatisch, ohne dass jemand einen Browser öffnet, eine Datei hochlädt oder einen Button klickt. Die Extraktionspipeline läuft unbeaufsichtigt — Dokumente landen in Ihrem Postfach, Daten landen in Ihrer Tabelle, und niemand muss den Prozess anfassen.
Für Teams, deren Dokumenten-Workflow grundsätzlich E-Mail-getrieben ist — Kreditorenbuchhaltungen, in denen Lieferanten Rechnungen an [email protected] senden, Logistikteams, in denen Frachtführer PDFs als Liefernachweis mailen, E-Commerce-Abteilungen, in denen Auftragsbestätigungen per E-Mail eintreffen — eliminiert Parseurs E-Mail-First-Architektur mehr Schritte aus dem Workflow, als jeder Ansatz ohne Vorlage allein durch bessere Extraktion aufholen kann. Der Unterschied liegt nicht darin, wie die Daten extrahiert werden, sondern darin, wie das Dokument zur Extraktions-Engine gelangt.
Parseur integriert sich außerdem nativ mit Zapier, Make, Power Automate und n8n. Das heißt, extrahierte Daten fließen automatisch in Hunderte nachgelagerte Ziele — Google Sheets, Airtable, QuickBooks, Slack, Salesforce — ohne manuellen Export. Für Teams, die in Automatisierungsplattformen investiert haben, ist diese Integrationstiefe ein echter Produktivitätsmultiplikator.
ImageToTable deckt inzwischen ebenfalls den unbeaufsichtigten E-Mail-Eingang ab. Jedes Konto erhält eine dedizierte Postfachadresse — teilen Sie sie mit Lieferanten oder leiten Sie Ihre eigenen Rechnungen und Belege dorthin weiter, und Anhänge landen automatisch in Ihrer Verarbeitungswarteschlange, ohne Login oder Upload-Seite. Aktivieren Sie Auto-Process und binden Sie es an eine Extraktionsvorlage, startet die Verarbeitung, sobald Post eintrifft — weiterleiten und laufen lassen, genau wie bei Parseurs Pipeline.
Die verbleibende Lücke ist die Granularität, nicht die Automatisierung. Parseur gibt jedem Dokumenttyp oder Kanal ein eigenes Postfach und eine eigene Adresse, jeweils separat konfiguriert. ImageToTable gibt jedem Konto eine einzige Postfachadresse, sodass gemischte Post aus verschiedenen Quellen über eine gebundene Vorlage läuft statt über mehrere unabhängig konfigurierte Postfächer. Email Inbox lässt sich so einstellen, dass Anhänge, der E-Mail-Text selbst oder beides gelesen wird — ein Lieferant, der die Zahlen direkt in die Nachricht tippt, funktioniert also ebenfalls, nicht nur weitergeleitete Dateien. Eine Absender-Whitelist hält fremde Post aus der Warteschlange, und bei verschlüsselten Anhängen wie passwortgeschützten Kontoauszügen werden gespeicherte Passwörter automatisch versucht, bevor etwas Ihren Prüfbildschirm erreicht.
Dokumente erreichen die Extraktions-Engine außerdem über den direkten Datei-Upload in der Web-Oberfläche oder die Seitenleiste des Google Sheets-Add-ons — zwei weitere Wege, die E-Mail gar nicht berühren.
Allerdings füllt der Sammellink eine angrenzende Lücke, die Parseurs E-Mail-Architektur nicht abdeckt: Dokumente von Personen sammeln, die sie Ihnen nicht per E-Mail schicken. Außendienstmitarbeiter, die Baustellenfotos vom Handy hochladen, Kunden, die Rechnungen über ein Portal einreichen, Mitarbeiter, die Belegfotos von einer Reise weiterleiten — der Sammellink akzeptiert Uploads von jedem mit dem Link, ohne Registrierung. Das ist keine E-Mail-Automatisierung, löst aber ein anderes Eingangsproblem, das E-Mail-Weiterleitung nicht adressiert.
Preise & Nutzen: Zwei verschiedene Kostenmodelle
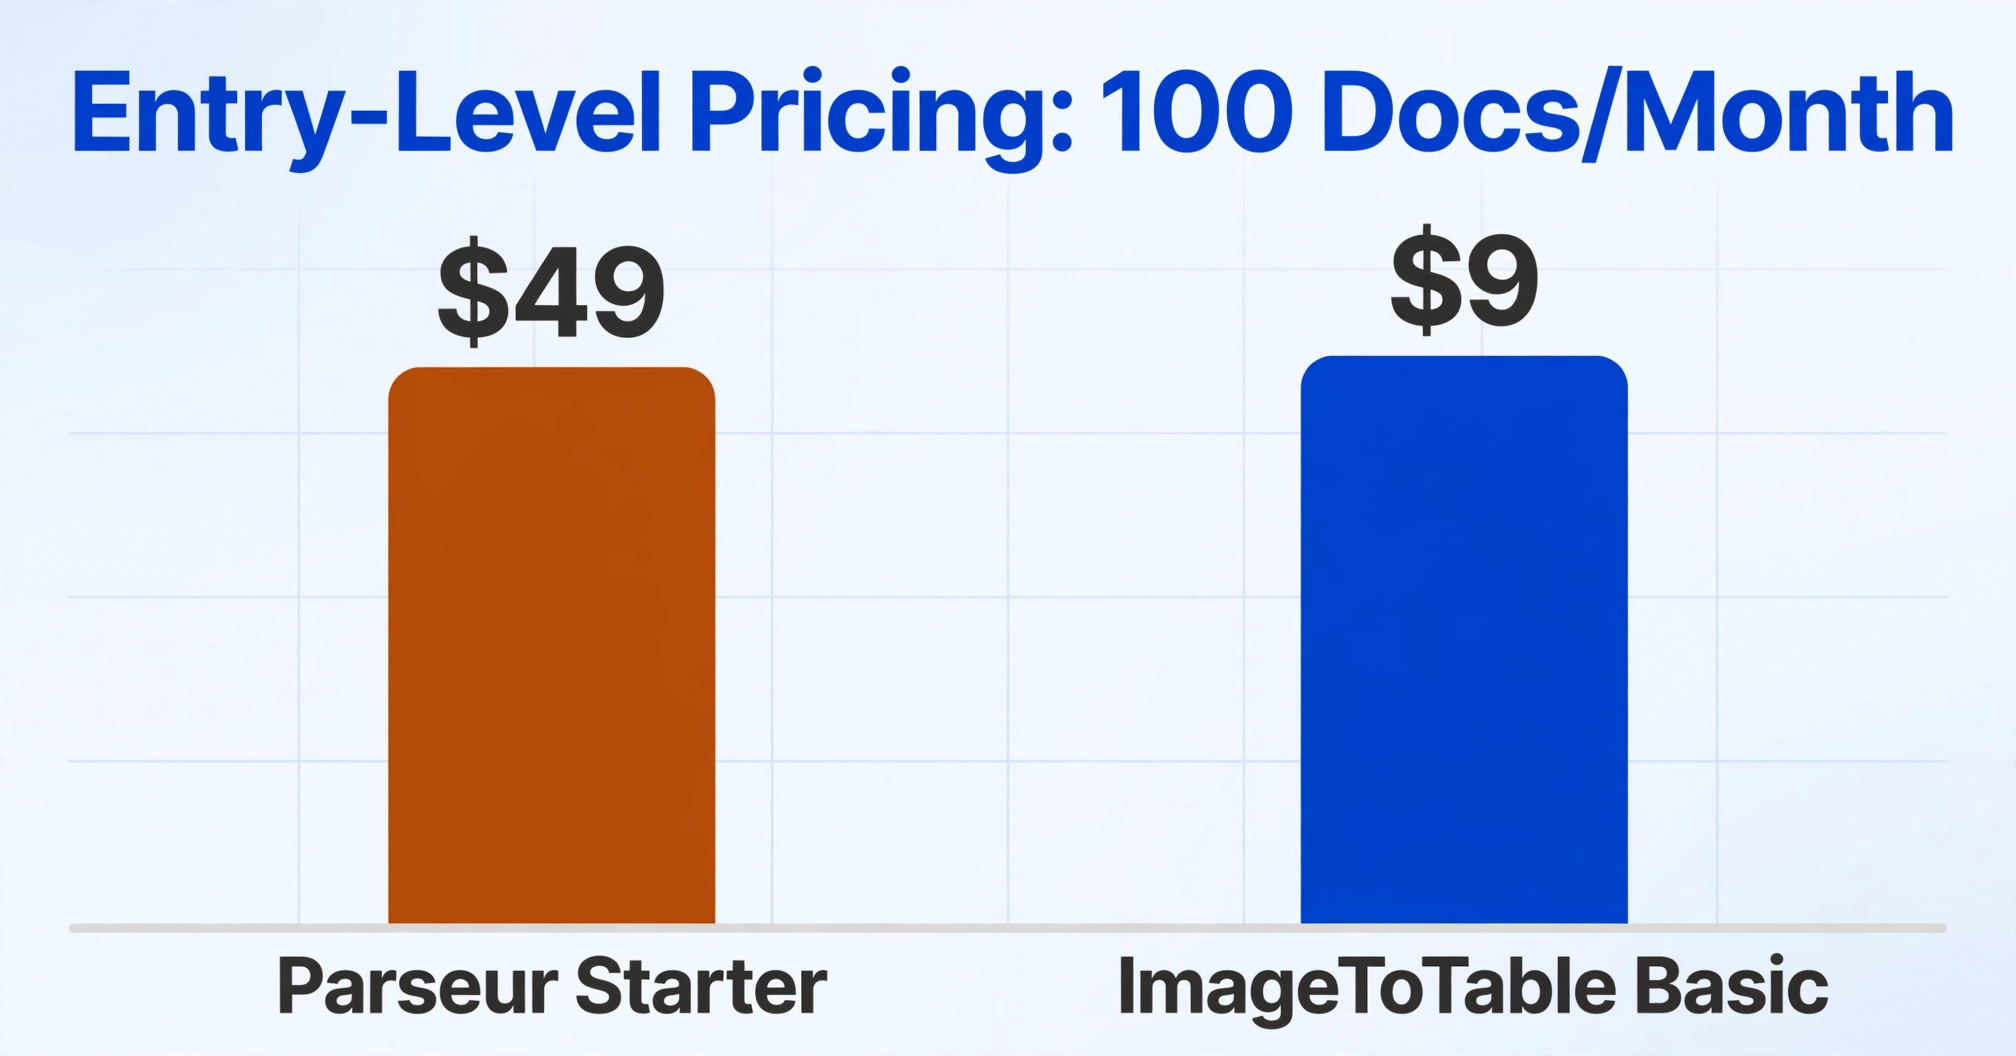
Die veröffentlichten Preise von Parseur beginnen bei 39 $/Monat (jährliche Abrechnung) bzw. 49 $/Monat (monatlich) für den Starter-Plan bei 100 Seiten. Eine Seite entspricht einem Credit — eine 3-seitige PDF-Rechnung verbraucht 3 Credits. Die kostenlose Stufe bietet 20 Seiten/Monat mit Wasserzeichen auf exportierten Daten. Der Pro-Plan (99 $/Monat) deckt 1.000 Seiten ab, der Scale-Plan (399 $/Monat) 10.000 Seiten. Alle Pläne enthalten dieselben Kernfunktionen — die Preisgestaltung richtet sich ausschließlich nach dem Volumen.
ImageToTable verwendet ein Abonnementmodell mit Credit-Limits: Basic bei 9 $/Monat für 150 Credits, Pro bei 29 $/Monat für 500 Credits, Max bei 59 $/Monat für 1.500 Credits. Ein Credit entspricht einem Bild oder einer PDF-Seite. Es gibt in keinem Plan ein Wasserzeichen. Ein tägliches kostenloses Kontingent ermöglicht Tests mit echten Dokumenten vor der Zahlung. Einmalige Credit-Pakete sind ohne Abonnement erhältlich.
Auf Einstiegsebene kostet der Basic-Plan von ImageToTable (9 $/Monat für 150 Seiten) rund 80 % weniger als der Starter-Plan von Parseur (39–49 $/Monat für 100 Seiten) und bietet 50 % mehr Volumen. Bei 1.000 Seiten/Monat kostet der Max-Plan von ImageToTable 59 $/Monat im Vergleich zu Parseurs Pro bei 99 $/Monat — eine Ersparnis von 40 % bei gleichem Volumen. Einen detaillierten Vergleich, wie sich verschiedene Preismodelle auf Ihre monatliche Rechnung auswirken, finden Sie unter Preisübersicht für Dokumentenextraktion 2026.
Es gibt ein Szenario, in dem die Preisgestaltung von Parseur günstiger ist: sehr hohes Volumen mit einer festen, vorhersehbaren Absenderbasis. Wenn Sie jeden Monat genau 10.000 Seiten von bekannten Lieferanten verarbeiten, bei denen Vorlagen zuverlässig funktionieren, sinken die Kosten pro Seite bei Parseur auf etwa 4 Cent pro Seite im Scale-Plan (399 $/Monat für 10.000 Seiten). Die Preisgestaltung von ImageToTable ist in dieser Volumenstufe nicht so aggressiv — die beste Option wäre der Growth-Plan für 149 $ für bis zu 3.000 Credits, die im Team geteilt werden, oder der Enterprise-Plan für 899 $ für bis zu 10.000 geteilte Credits. Bei echtem Enterprise-Umfang (100.000+ Seiten) kann das Mengenrabattmodell von Parseur zu niedrigeren Kosten pro Seite führen.
Doch in dem Volumenbereich, in dem die meisten Teams arbeiten — 100 bis 3.000 Dokumente pro Monat — liefert das Pauschalabonnement von ImageToTable durchweg mehr Volumen für weniger Geld, mit dem zusätzlichen Vorteil einer vorhersehbaren monatlichen Abrechnung, die nicht mit der Dokumentkomplexität schwankt.
Dokumenttypen & Genauigkeit
Beide Tools decken die gängigen Dokumenttypen ab: Rechnungen, Belege, Bestellungen, Lieferscheine, Verträge und Formulare. Doch sie erreichen Genauigkeit über unterschiedliche Mechanismen, und der Unterschied ist entscheidend, je nachdem, wie Ihre Dokumente aussehen.
Die Template-Engine von Parseur ist am stärksten bei sauberen digitalen PDFs und strukturierten E-Mail-Inhalten, bei denen die Feldpositionen über Dokumente desselben Absenders hinweg konsistent sind. Sobald eine Vorlage für ein bekanntes Layout erstellt und getestet wurde, ist die Extraktion deterministisch — dieselben Felder an denselben Positionen, jedes Mal. Die Template-Engine bewältigt auch die Tabellenextraktion (Positionen innerhalb von Rechnungen) über einen visuellen Tabelleneditor, doch die Konfiguration erfordert die Festlegung von Zeilengrenzen, Spaltentrennern sowie Kopf- und Fußzeilenrändern. Für Dokumente mit festem Format von einer stabilen Absendergruppe liefert dieser Ansatz zuverlässige, wiederholbare Ergebnisse.
Die Vision AI Engine von Parseur erweitert die Abdeckung auf gescannte Dokumente und Bilder — sie kann Kontrollkästchen, Stempel und Handschrift besser verarbeiten als die Template-Engine allein. Doch sie ist eine sekundäre Option, nicht der primäre Extraktionsweg. Die Template-Engine bleibt Parseurs genaueste Methode, und ihre Stärken sind an Formatkonsistenz gebunden.
Das Vision LLM von ImageToTable behandelt jedes Dokument als einzigartiges visuelles Layout. Druck, Scan, Handyfoto, Screenshot oder handschriftliches Formular — die KI liest die Dokumentensemantik direkt, ohne die Engine zu wechseln. Bei gedruckten Tabellendaten erreicht die Genauigkeit bis zu 99 % bei sauberen Dokumenten. Das Modell ist besonders stark bei Dokumenten, die gedruckte und handschriftliche Inhalte mischen — etwa Prüfformulare, bei denen vorgedruckte Beschriftungen handschriftlich ausgefüllt werden —, weil es die Beziehung zwischen Beschriftung und Wert versteht, statt sich auf positionsbasierte Extraktion zu verlassen.
Eine Fähigkeit, für die es bei Parseur kein Äquivalent gibt, sind Berechnete Spalten. Über die Extraktion dessen hinaus, was auf der Seite steht, können Sie Spalten definieren, in denen die KI während der Extraktion berechnet — „Positionssumme (Menge × Stückpreis)", „Gesamt ohne Steuer", „Kategorie (Optionen: Mahlzeiten/Transport/Büro)" als abgeleitete Klassifizierung. Parseur extrahiert Rohwerte; Berechnungen und Klassifizierungen führen Sie extern durch. ImageToTable bettet sie in den Extraktionsschritt ein, sodass Ihre Ausgabe ohne Nachbearbeitung einsatzbereit ist.
Wann ImageToTable mehr Sinn ergibt
Wenn Ihre Dokumente von mehreren Anbietern mit unterschiedlichen Layouts eintreffen – und sich diese Layouts ändern – erspart Ihnen der Ansatz ohne Vorlage von ImageToTable das Wartungsrad, das vorlagenbasierte Tools erzeugen. Das semantische Extraktionsmodell bedeutet, dass Sie Ihre Ausgabe einmal definieren (die gewünschten Spaltennamen) und die KI jede Variation im Eingabelayout automatisch bewältigt.
Wenn Sie Dokumente im Batch verarbeiten – 50 Rechnungen auf einmal hochladen und sie in einer ausgerichteten Tabelle zusammengeführt benötigen – liefert das Batch-First-Design von ImageToTable dies in einem einzigen Schritt. Parseur behandelt jedes Dokument als einzelnen Eintrag in einem Postfach; das Zusammenführen mehrerer Extraktionen in eine einheitliche Tabelle erfordert externe Arbeit.
Wenn Sie Werte berechnen oder Kategorien während der Extraktion ableiten müssen – nicht nur rohe Feldwerte – kann Parseur nicht mit den berechneten Spalten und abgeleiteten Spalten von ImageToTable mithalten. Sie müssten die Rohdaten von Parseur exportieren und in einer Tabellenkalkulation oder einem separaten Skript verarbeiten. ImageToTable liefert fertige Daten bei der Extraktion.
Wenn Ihr Budget knapp ist und Sie unter 3.000 Dokumente pro Monat verarbeiten, bietet die Preisgestaltung von ImageToTable 5× mehr Volumen pro Dollar im Einstiegsbereich und 40 % Ersparnis in der mittleren Stufe.
Wann Parseur mehr Sinn ergibt
Wenn Ihr Eingang mehrere Dokumenttypen oder Quellen umfasst, die jeweils ihre eigene Parsing-Einrichtung benötigen – eine Adresse für Rechnungen, eine andere für Versandbenachrichtigungen, eine dritte für Auftragsbestätigungen – bewältigt das Postfach-Modell von Parseur dies nativ, mit einer separaten Adresse und Konfiguration für jede. Der Email Inbox von ImageToTable läuft ebenfalls hands-off, sobald Auto-Process an eine Vorlage gebunden ist – leiten Sie die Mail weiter und lehnen Sie sich zurück, genau wie bei Parseur – aber es ist eine Postfachadresse pro Konto statt eines Postfachs pro Dokumenttyp, sodass gemischte Mail über eine einzige gebundene Vorlage statt über mehrere unabhängig konfigurierte läuft. Für Kreditorenbuchhaltung (AP)-Teams, deren Anbieter über separate Adressen wirklich unterschiedliche Rechnungslayouts senden, oder Logistik- und E-Commerce-Betriebe, die mehrere verschiedene Benachrichtigungstypen jonglieren, ist die Trennung pro Kanal bei Parseur die skalierbarere Einrichtung.
Wenn Ihr Workflow von Zapier, Make oder Power Automate abhängt, um extrahierte Daten in nachgelagerte Systeme zu leiten, ist die native Integrationstiefe von Parseur ausgereifter. ImageToTable konzentriert sich auf den direkten Dateiexport; es hat nicht das Automatisierungs-Connector-Ökosystem von Parseur.
Wenn Ihre Dokumente von einem festen, kleinen Satz bekannter Absender mit stabilen Formaten und ohne Layoutänderungen kommen, liefert die Template-Engine von Parseur eine deterministische, zuverlässige Extraktion. Die Einrichtungskosten der Vorlage sind eine einmalige Investition, die sich über Monate konsistenter Verarbeitung amortisiert. In diesem Szenario ist die Vorlagenwartung keine Last – sie ist eine einmalige Konfiguration.
Wenn Sie sehr hohe Volumina (10.000+ Seiten pro Monat) vorhersehbarer Dokumente verarbeiten, kann die Preisgestaltung pro Seite von Parseur bei Skalierung (bis zu 3–4 Cent pro Seite) Flat-Abonnement-Modelle unterbieten. Bei diesem Volumen schaltet Parseur auch Multi-User-Konten frei (bis zu 100 Benutzer im Scale-Plan) und Python-Nachbearbeitung für benutzerdefinierte Geschäftslogik.
Das ehrliche Urteil: Parseur gewinnt für E-Mail-gesteuerte Workflows mit hohem Volumen und stabilen Formaten. ImageToTable gewinnt für Teams, die Layoutvielfalt, Batch-Verarbeitung, begrenzte Budgets und den Bedarf an berechneten Ausgaben ohne Nachbearbeitung jonglieren. Die Tools lösen dasselbe Problem mit unterschiedlichen Architekturen, und keine Architektur ist universell besser.
Das Fazit: Es hängt von Ihrem Dokumenten-Ökosystem ab
Nach dem Vergleich beider Tools in Bezug auf Einrichtungszeit, Formatrobustheit, E-Mail-Automatisierung, Preisgestaltung, Dokumentenabdeckung und berechnete Ausgabefunktionen ist das Entscheidungsframework klarer als es die meisten Vergleichsartikel vermuten lassen.
Parseur ist für eingehende E-Mail-Dokumentenpipelines konzipiert — wiederkehrende, vorhersehbare Anhänge, die per E-Mail eintreffen und ohne menschliches Eingreifen extrahiert werden müssen. Seine Template-Engine belohnt Teams mit stabilen Absendern durch deterministische Genauigkeit. Seine Grenzen zeigen sich, wenn sich Formate ändern, wenn Dokumente aus vielen Quellen stammen oder wenn Sie berechnete Ausgaben über reine Feldwerte hinaus benötigen.
ImageToTable ist für die Batch-Dokumentenverarbeitung mit Layoutvariabilität konzipiert — Teams, die Dokumente in Gruppen hochladen, zusammengeführte Ausgaben benötigen und ständig wechselnden Dokumentformaten gegenüberstehen. Seine semantische KI eliminiert die Vorlagenpflege vollständig, und sein eigener E-Mail-Posteingang deckt nun auch die unbeaufsichtigte Erfassung ab — allerdings gehen Parseurs Kanal-Postfachmodell und die native Integrationstiefe mit Zapier/Make für automatisierungsintensive Pipelines noch weiter.
Wenn Ihr Dokumenten-Ökosystem E-Mail-gesteuert mit stabilen Absendern ist, ist Parseur die pragmatische Wahl. Wenn Ihr Ökosystem vielfältige Formate aus mehreren Quellen umfasst, die in Batches verarbeitet werden, liefert ImageToTable mehr Wert mit weniger laufendem Aufwand. Wenn Sie irgendwo dazwischen liegen — und die meisten Teams tun das —, ist die Dimension, die den Ausschlag geben sollte, die Häufigkeit von Formatänderungen. Wenn Ihre Lieferanten ihre Layouts mehr als einmal pro Quartal aktualisieren, spart Ihnen der vorlagenfreie Ansatz über ein Jahr mehr Zeit, als jeder E-Mail-Automatisierungsgewinn ausgleichen kann.
Möchten Sie die komprimierte Version? Sehen Sie sich die Feature-Vergleichstabelle im Direktvergleich an oder durchsuchen Sie alle ImageToTable-Vergleiche.
FAQ
Benötigt Parseur Vorlagen oder funktioniert die KI-Engine ohne?
Parseur bietet sowohl eine Template-Engine als auch eine KI-Engine. Die Template-Engine – die die konsistentesten Ergebnisse liefert – erfordert den Aufbau einer visuellen Vorlage für jedes Dokumentlayout, indem Feldpositionen in einem Beispieldokument markiert werden. Die KI-Engine ist flexibler und kann Layoutvarianten ohne Vorlage verarbeiten, erfordert aber dennoch eine Konfiguration des Dokumenttyps. In der Praxis verlassen sich die meisten Parseur-Nutzer bei wiederkehrenden Dokumenten von bekannten Absendern auf Vorlagen, da die Template-Engine für feste Layouts eine höhere Präzision liefert. ImageToTable verwendet ausschließlich semantische KI – keine Vorlagen, keine Engine-Auswahl, keine Konfiguration des Dokumenttyps erforderlich.
Kann ImageToTable Dokumente, die per E-Mail eingehen, automatisch extrahieren?
Ja. Jedes Konto erhält eine dedizierte Posteingangsadresse – teilen Sie sie mit Lieferanten oder leiten Sie Ihre eigenen Rechnungen und Belege dorthin weiter, und Anhänge landen automatisch in Ihrer Verarbeitungswarteschlange, ohne Anmeldung oder Upload-Seite. Aktivieren Sie Auto-Process und binden Sie es an eine Extraktionsvorlage, und die Verarbeitung startet, sobald die Mail eintrifft – derselbe Workflow zum Weiterleiten und Vergessen, den Parseur bietet. Eine Absender-Whitelist hält unerwünschte Mails fern, und gespeicherte Passwörter werden automatisch bei verschlüsselten Anhängen wie passwortgeschützten Kontoauszügen versucht. Der Unterschied liegt in der Granularität: Parseur gibt jedem Dokumenttyp oder Kanal ein eigenes Postfach und eine eigene Adresse mit unabhängiger Konfiguration, während ImageToTable jedem Konto eine Posteingangsadresse gibt, sodass gemischte Mails über eine einzige gebundene Vorlage laufen. Email Inbox kann so eingestellt werden, dass Anhänge, der E-Mail-Text oder beides gelesen wird.
Welches Tool ist für 100 Dokumente pro Monat günstiger?
ImageToTable ist bei diesem Volumen deutlich günstiger. Der Basic-Plan kostet 9 $/Monat für 150 Credits – genug für 100 einseitige Dokumente mit 50 übrigen Credits. Der Starter-Plan von Parseur kostet 39 $/Monat (jährlich) oder 49 $/Monat (monatlich) für 100 Seiten. ImageToTable ist auf Einstiegsebene etwa 5× günstiger. Einen vollständigen Preisvergleich über verschiedene Volumenstufen finden Sie unter Preisübersicht zur Dokumentenextraktion 2026.
Unterstützt Parseur die Batch-Verarbeitung wie ImageToTable?
Parseur verarbeitet Dokumente als einzelne Elemente innerhalb eines Postfachs. Sie können mehrere Dokumente an ein Postfach senden, und jedes wird unabhängig geparst. Es gibt jedoch keine integrierte Benutzeroberfläche zum „Zusammenführen von 50 Dokumenten in eine ausgerichtete Tabelle“. Die Ergebnisse sind pro Dokument verfügbar, und deren Zusammenführung in eine einzige Tabelle erfordert eine Integrationsausgabe (Google Sheets-Synchronisierung, Zapier) oder einen manuellen Export. ImageToTable wurde Batch-First konzipiert: Laden Sie mehrere Dateien hoch, definieren Sie die Spaltennamen einmal, und laden Sie eine zusammengeführte Excel-Datei mit konsistenten Überschriften für alle Dokumente herunter.
Kann Parseur Felder während der Extraktion berechnen, wie die Berechneten Spalten von ImageToTable?
Nicht als native Extraktionsfunktion. Parseur extrahiert Rohwerte aus Dokumenten. Berechnungen, Klassifizierungen oder Transformationen müssen extern durchgeführt werden – in einer Tabellenkalkulation, über Python-Nachbearbeitung (verfügbar in Scale-Tarifen ab 399 $/Monat) oder durch Zapier/Make-Transformationen. Die Berechneten Spalten und Abgeleiteten Spalten von ImageToTable führen Berechnungen und Klassifizierungen während des Extraktionsschritts durch, sodass die Ausgabe ohne zusätzliche Verarbeitung sofort nutzbar ist.
Kann ich von Parseur zu ImageToTable wechseln?
Ja, und die Migration erfordert keinen Import von Vorlagen – denn ImageToTable verwendet keine Vorlagen. Exportieren Sie Ihre historischen Parseur-Daten als CSV oder Excel. Laden Sie dieselben Quelldokumente in ImageToTable hoch, geben Sie die Spaltennamen ein, die Ihren Parseur-Felddefinitionen entsprechen, und die KI extrahiert sie ohne jegliche Vorlagenkonfiguration. Die in Parseur verwendeten Spaltennamen (Rechnungsnummer, Lieferant, Datum, Gesamtbetrag) werden zu Ihren Spaltennamen in ImageToTable. Führen Sie Ihre historischen Parseur-Exporte mit neuen ImageToTable-Extraktionen in einer Tabellenkalkulation zusammen – konsistente Überschriftennamen machen die Zusammenführung unkompliziert.
Welches Tool ist besser für die DSGVO-Konformität geeignet?
Parseur hat eine stärkere DSGVO-Konformität. Das Unternehmen hat seinen Sitz in Singapur mit EU-Gründern, und die DSGVO-Konformität ist von Anfang an mit EU-gehosteter Infrastruktur in die Architektur integriert. SOC 2 Type II und HIPAA sind in Bearbeitung. ImageToTable verschlüsselt Daten während der Übertragung (TLS) und im Ruhezustand mit konfigurierbarer automatischer Löschung — ausreichend für die meisten KMU-Anwendungsfälle, aber ohne formale DSGVO-Zertifizierungsdokumentation. Wenn dokumentierte DSGVO-Konformität mit EU-Datenresidenz eine harte Anforderung ist, ist Parseur die sicherere Wahl.