ImageToTableとParseurの比較:
テンプレート型か、テンプレート不要か?2026年、正直に比較する
ImageToTableとParseurのどちらを選ぶかは、次の1つの問いに尽きます。それは、あなたの文書が予測可能で一貫した形式で届くのか、それとも、ベンダーや月、送信元によって変わるレイアウトの多様性に対応する必要があるのか、ということです。この答えは、どちらのツールがセットアップしやすいかという点だけでなく、抽出パイプラインが時間とともに楽になるのか、それともメンテナンスの負担が増えるだけになるのかも左右します。どちらのツールも文書からデータを確実に抽出できます。しかし、そのアプローチはまったく逆の設計思想に基づいています。安定した3社のサプライヤーを抱えるチームに合う思想は、独自のタイミングでレイアウトを更新する40社のベンダーからの請求書を扱うチームには、フラストレーションの種になるでしょう。
重要ポイント
- どんな抽出ツールの比較も同じように読めてしまうが、決定的に欠けている点がある——サプライヤーの形式が変わり始める3ヶ月後に何が起きるかを計算している人は誰もいないということだ。
- テンプレートのメンテナンスは、一度払えば済むセットアップ費用ではない——文書デザインを更新するベンダーが増えるたびに膨らむ、予測不能で継続的なコストなのだ。
- 比較表は飛ばして、1つの質問をしよう。あなたのサプライヤーは去年、レイアウトを何回変更しただろうか?2回を超えるなら、テンプレート不要方式が初期セットアップだけでなく、メンテナンスの負担全体を省いてくれる。
クイック比較
各項目の詳細に入る前に、文書抽出の判断で最も重要となる要素について、2つのツールの違いをまとめたスナップショットをご紹介します。
| 項目 | Parseur | ImageToTable.ai |
|---|---|---|
| 抽出モデル | 3つのエンジン:テンプレートベース(ゾーン/キーワード)、AI抽出、CSV自動パース — テンプレートによる精度が最高 | Vision LLM — 文書の意味を直接解釈。テンプレート不要、学習不要、レイアウト非依存 |
| セットアップ時間 | テンプレート1つにつき15〜30分。複数のベンダーには複数のテンプレートが必要 | 1分未満 — 列名を入力し、アップロードすれば結果が表示されます |
| フォーマット変更への対応 | テンプレートが壊れるため手動更新が必要。AIエンジンが多少のバリエーションは吸収 | 自動 — 意味抽出により、あらゆるレイアウト変更に適応 |
| メール取り込み | ネイティブ対応 — 専用受信トレイ、自動転送、自動抽出 | ネイティブ対応 — アカウントごとに1つの受信トレイ。Auto-Processがテンプレートにバインド |
| バッチ処理とマージ | ドキュメントごとの結果。組み込みのバッチマージUIはなし | ネイティブのバッチファースト処理:異なる形式のドキュメントを1つの整列されたスプレッドシートにマージ |
| 計算列 / 推論列 | 非対応 — 生の値のみ。ScaleプランではPythonによる後処理が必要 | ネイティブ対応 — 抽出中に合計の計算、カテゴリの分類、値の導出が可能 |
| Zapier / Make 連携 | ネイティブ対応 — 両プラットフォームとの深い連携 | Excel/CSV/JSONの直接ダウンロード。ネイティブのZapierコネクタはなし |
| 初期価格(月100ドキュメント) | 100ページで月額39〜49ドル | 150クレジットで月額9ドル — エントリーレベルで約5倍お得 |
この表を見れば、トレードオフの関係が一目でわかります。しかし、実際の判断は、あなたのワークフローにおいて、これらの要素のどれが最も重要かによって決まります。それぞれについて見ていきましょう。
セットアップと導入:テンプレート vs. 列名
Parseurは「メールボックス」を中心に抽出を構成します。各メールボックスは、独自の解析設定を持つ専用の書類取り込みチャネルです。初めて書類タイプを処理する際、Parseurは最初のアップロードでフィールドを自動検出します。これは確かに便利な出発点です。しかし、信頼性の高い結果を得るには、テンプレートの作成が推奨されます。サンプル書類上の領域をハイライトし、フィールド抽出ルール(固定位置用のゾーンOCR、ラベルに対して相対的に移動するフィールド用の動的OCR)を定義し、そのレイアウトでシステムをトレーニングします。最初のテンプレートの設定、テスト、調整には通常15〜30分かかります。
フォーマットが一貫している5つのベンダーから書類を受け取る場合、テンプレート設定に75〜150分かかります。これは一度きりのコストであり、フォーマットが変わらなければ投資に見合うものです。しかし、30のベンダーから書類を処理する場合や、書類の送信元が月によって異なる場合、初期設定は成果が見えるまでの大きな時間投資になります。
ImageToTableはこの方程式を逆転させます。取り込みチャネルの設定は一切不要です。メールボックスも、テンプレートも、フィールド定義もありません。抽出したい列名(「請求書番号」「ベンダー名」「日付」「合計(税抜)」「明細項目」)を入力し、書類をアップロードするだけです。Vision LLMは各フィールドの意味を理解することで、それらの値を特定します。特定のピクセル座標や特定のラベルの隣にあるテキストを探すのではありません。「請求書番号」という概念を探します。それがどこにあっても、どのようにラベル付けされていても、どのような書類レイアウトでも対応します。リピーターの方は、テンプレート不要の抽出により、列リストをプリセットとして保存できるため、フィールド名を再入力することなく、同じ抽出を将来のすべてのバッチで実行できます。
この違いが最も顕著なのは、最初の1ヶ月です。Parseurは結果が出る前に、初期設定の時間を要求します。ImageToTableは最初の抽出を10秒以内で返します。セットアップのチュートリアルではなく、実際の書類でツールを評価できます。
フォーマット変更への対応:テンプレート保守に隠れたコスト
この点こそ、この2つのツールを最も明確に分ける要素であり、同時に、ほとんどの比較記事が軽視している点でもあります。テンプレートベースの抽出は、うまく機能している間は完璧です。しかし、現実の文書処理において、フォーマット変更は例外ではなく、むしろ標準です。
サプライヤーは、会計ソフトを切り替えたり、他社と合併したり、ブランディングを刷新したり、新しい規制に対応したりする際に、請求書のレイアウトを変更します。取引先が請求書テンプレートを変更すれば、「合計」フィールドが右下から左下に移動します。サプライヤーが発注書フォーマットに新しいヘッダー行を追加することもあります。メール通知システムがHTMLテンプレートを再構成し、注文確認の詳細を別のテーブル構造に移すこともあります。こうした変更は、次のバッチの文書に抽出エラーが発生するまで、あなたには見えません。
Parseurのテンプレートエンジンは、既知のレイアウトに対して最も一貫した結果をもたらしますが、こうした変更が発生すると破綻します。サンプル文書上でハイライトしたフィールドの位置が、実際のデータと一致しなくなります。動的OCRに使用したアンカーキーワードが移動したり、名前が変更されたりします。ParseurのAIエンジンはテンプレートエンジンよりも柔軟で、ある程度のレイアウト変動を吸収できますが、それでも文書タイプの設定内で機能するものであり、任意のレイアウトに対応するものではありません。G2のレビュアーもこれを認めています:「メールフォーマットの小さな変更でも解析が中断されることがある」。中断のたびに手動介入が必要です。テンプレートエディターを開き、移動したフィールドを再ハイライトし、再テストし、再デプロイするのです。
ImageToTableのVision LLMは、フィールドがページ上のどこにあるかを気にしません。文書全体を読み取り、各要求フィールドを意味によって特定します。取引先が「合計」を右下から左下に移動しても、AIは「合計」を見つけます。サプライヤーが「請求書番号」を「請求No」に変更しても、AIは意味的関係を理解して「請求書番号」列にマッピングします。新しい取引先が、これまで見たことのないフォーマットの文書を送ってきても、テンプレートを作成することなく、最初のアップロードで正しく処理されます。これこそがトレーニング不要の文書抽出の実践的な意味です。ツールがフォーマットの変動に自動的に適応し、あなたの関与を必要としないのです。
テンプレート保守の真のコストは初期設定ではなく、サプライチェーンのどこかでフォーマットが変更されるたびに発生する、継続的で予測不可能な修正作業です。 取引先が安定して既知の場合は、このコストは低く抑えられます。しかし、それ以外の場合は、自動化のはずが、事後対応の保守タスクに変わってしまいます。
メールと自動化:Parseurの圧倒的優位性
ここがParseurが勝っている分野であり、私たちは率直に言う必要があります。Parseurは、メールを主要なドキュメント取り込みチャネルとして、ゼロから構築されました。各メールボックスには専用のメールアドレスが付与されます。請求書、発注書、出荷通知、または添付ファイルをそのアドレスに転送するだけで、Parseurが自動的に解析します。ブラウザを開いたり、ファイルをアップロードしたり、ボタンをクリックしたりする必要は一切ありません。抽出パイプラインは無人で実行されます。ドキュメントは受信トレイに届き、データはスプレッドシートに反映され、誰もプロセスに触れる必要はありません。
ドキュメントワークフローが根本的にメール駆動型であるチーム、つまり、ベンダーが[email protected]に請求書を送るAP(買掛金)部門、運送会社が配達証明PDFをメールで送る物流チーム、注文確認がメールで届くEコマース業務などにとって、Parseurのメールファーストのアーキテクチャは、テンプレート不要のアプローチが抽出精度の向上だけで実現できる以上のステップをワークフローから排除します。違いはデータの抽出方法ではなく、ドキュメントが抽出エンジンに到達する方法にあります。
Parseurはまた、Zapier、Make、Power Automate、n8nとネイティブに統合されています。つまり、解析されたデータは、手動エクスポートなしで、Google スプレッドシート、Airtable、QuickBooks、Slack、Salesforceなど、数百の下流の宛先に自動的に流れ込むことができます。自動化プラットフォームに投資してきたチームにとって、この統合の深さは真の生産性向上をもたらします。
ImageToTableも現在、無人メール取り込みに対応しています。すべてのアカウントに専用の受信トレイアドレスが付与されます。ベンダーと共有するか、自分の請求書や領収書を転送するだけで、添付ファイルは自動的に処理キューに追加されます。ログインやアップロードページは不要です。自動処理を有効にして抽出テンプレートにバインドすると、メールが届いた瞬間に処理が開始されます。メールを転送してその場を離れるだけで、Parseurのパイプラインと同じように機能します。
残る差は、自動化ではなく、きめ細かさです。Parseurは、ドキュメントタイプやチャネルごとに独自のメールボックスとアドレスを提供し、それぞれ個別に設定できます。ImageToTableは、すべてのアカウントに単一の受信トレイアドレスを提供するため、異なるソースからの混在メールは、複数の独立して設定されたメールボックスではなく、1つのバインドされたテンプレートを通じてルーティングされます。メール受信トレイは、添付ファイル、メール本文自体、またはその両方を読み取るように設定できます。つまり、メッセージ本文に直接数字を入力するサプライヤーにも対応できます。送信者ホワイトリストは、無関係なメールをキューから除外し、パスワードで保護された銀行取引明細書などの暗号化された添付ファイルについては、保存されたパスワードがレビュー画面に到達する前に自動的に試行されます。
ドキュメントは、Webインターフェースでの直接ファイルアップロードまたはGoogle Sheetsアドオンサイドバーからも抽出エンジンに到達できます。これらはメールに一切触れない2つのルートです。
とはいえ、コレクションリンクは、Parseurのメールアーキテクチャがカバーしない隣接するギャップを埋めます。それは、あなたにメールを送っていない人々からドキュメントを収集することです。現場スタッフが携帯電話から現場写真をアップロードしたり、クライアントがポータルを通じて請求書を提出したり、従業員が出張中の領収書写真を転送したりする場合、コレクションリンクは、登録不要でリンクを持つ誰からでもアップロードを受け付けます。これはメール自動化ではありませんが、メール転送では対応できない、異なる取り込み問題を解決します。
料金と価値:2つの異なるコストモデル
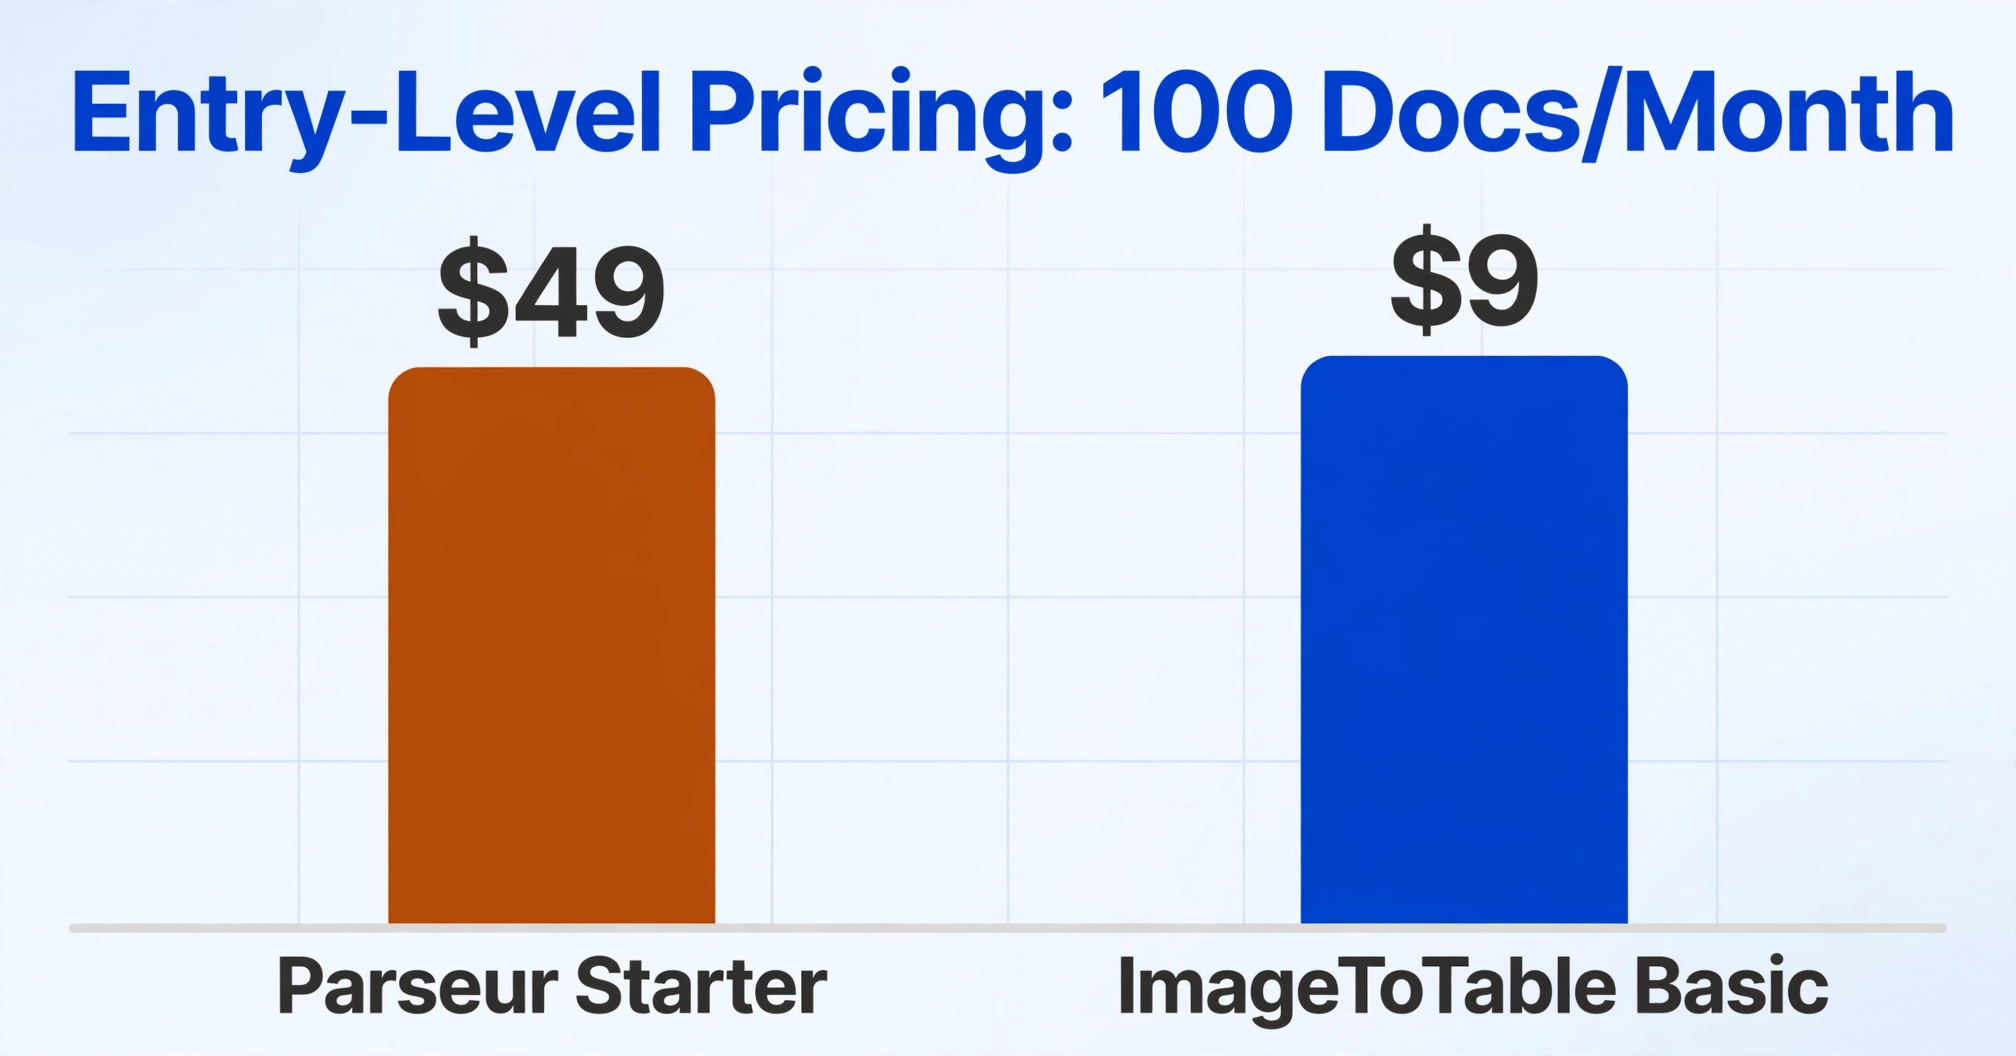
Parseurの公開料金は、Starterプラン(100ページ)で月額39ドル(年払い)または月額49ドル(月払い)から始まります。1ページが1クレジットで、3ページのPDF請求書は3クレジットを消費します。無料プランでは月20ページまで利用でき、エクスポートデータに透かしが入ります。Proプラン(月額99ドル)は1,000ページ、Scaleプラン(月額399ドル)は10,000ページまで対応します。全プランに同じコア機能が含まれており、料金は純粋にボリュームに基づいています。
ImageToTableはクレジット制のサブスクリプションモデルを採用しています:Basicは月額9ドルで150クレジット、Proは月額29ドルで500クレジット、Maxは月額59ドルで1,500クレジットです。1クレジットは画像1枚またはPDF1ページに相当します。どのプランにも透かしはありません。毎日の無料枠で、支払い前に実際のドキュメントをテストできます。サブスクリプションなしで使える一回限りのクレジットパックもあります。
エントリーレベルでは、ImageToTableのBasicプラン(月額9ドルで150ページ)は、ParseurのStarterプラン(月額39〜49ドルで100ページ)より約80%安く、ボリュームは50%多くなります。月1,000ページの場合、ImageToTableのMaxプランは月額59ドルで、ParseurのProプラン(月額99ドル)と比較して、同等ボリュームで40%の節約になります。異なる料金モデルが月額請求にどう影響するかの詳細な比較は、2026年のドキュメント抽出料金の内訳をご覧ください。
Parseurの料金が有利になるシナリオが1つあります:固定された予測可能な送信元からの非常に高いボリュームです。既知のサプライヤーから毎月ちょうど10,000ページを処理し、テンプレートが確実に機能する場合、Parseurの1ページあたりのコストはScaleプラン(月額399ドルで10,000ページ)で約4セントまで下がります。ImageToTableの料金はそのボリューム帯ではそれほど積極的ではありません—最良の選択肢は、チームで共有する最大3,000クレジットのGrowthプラン(149ドル)、または最大10,000共有クレジットのEnterpriseプラン(899ドル)です。真のエンタープライズ規模(100,000ページ以上)では、Parseurのボリューム割引モデルが1ページあたりのコストを低く抑えられる可能性があります。
しかし、ほとんどのチームが運用するボリューム帯—月100〜3,000ドキュメント—では、ImageToTableの定額サブスクリプションが一貫して少ないコストでより多くのボリュームを提供し、さらにドキュメントの複雑さに左右されない予測可能な月額請求という利点もあります。
文書の種類と精度
どちらのツールも、請求書、領収書、発注書、納品書、契約書、フォームといった一般的な文書タイプに対応しています。しかし、精度の達成方法は異なり、その違いは文書の見た目によって重要になります。
Parseurのテンプレートエンジンは、同一送信元からの文書でフィールド位置が一貫している、クリーンなデジタルPDFや構造化されたメールコンテンツに最適です。既知のレイアウト用にテンプレートを構築・テストすれば、抽出は決定的です。つまり、毎回同じ位置から同じフィールドが抽出されます。テンプレートエンジンは、ビジュアルテーブルエディターによるテーブル抽出(請求書内の明細項目)も処理しますが、設定には行の境界、列区切り、ヘッダー/フッターのマージンの定義が必要です。安定した送信元からの固定フォーマット文書には、このアプローチで信頼性が高く再現性のある結果が得られます。
ParseurのVision AIエンジンは、スキャン文書や画像にも対応範囲を広げます。チェックボックス、スタンプ、手書き文字も、テンプレートエンジン単独よりも適切に処理できます。ただし、これは主要な抽出経路ではなく、二次的なオプションです。テンプレートエンジンがParseurの最も正確な方法であり、その強みはフォーマットの一貫性に依存します。
ImageToTableのビジョンLLMは、すべての文書を独自のビジュアルレイアウトとして扱います。印刷、スキャン、スマホ写真、スクリーンショット、手書きフォームのいずれでも、AIはエンジンを切り替えることなく文書のセマンティクスを直接読み取ります。印刷されたテーブルデータの場合、クリーンな文書では最大99%の精度に達します。このモデルは、印刷と手書きが混在する文書(例えば、あらかじめ印刷されたラベルに手書きで記入する検査フォーム)に特に強く、位置ベースの抽出ではなく、ラベルと値の関係を理解します。
ImageToTableにあってParseurにない機能の一つが計算列です。ページ上の情報を抽出するだけでなく、抽出時にAIが計算する列を定義できます。「明細合計(数量×単価)」「税抜き合計」「カテゴリ(選択肢:食事/交通/オフィス)」のような推論による分類も可能です。Parseurは生の値を抽出するため、計算や分類は外部で行う必要があります。ImageToTableはこれらを抽出ステップに組み込むため、後処理なしで出力をすぐに利用できます。
ImageToTableが適しているケース
複数のベンダーから異なるレイアウトのドキュメントが届き、しかもそのレイアウトが変わる場合、ImageToTableのテンプレート不要のアプローチは、テンプレートベースのツールが生み出すメンテナンスの負担から解放してくれます。セマンティック抽出モデルにより、出力を一度定義するだけで(必要な列名)、AIが入力レイアウトのあらゆるバリエーションを自動で処理します。
ドキュメントをまとめてバッチ処理する場合(50枚の請求書を一度にアップロードし、1つの整列されたスプレッドシートに結合する必要がある場合)、ImageToTableのバッチファースト処理はこれを1ステップで実現します。Parseurは各ドキュメントをメールボックス内の個別アイテムとして扱うため、複数の抽出結果を1つの統合テーブルにマージするには外部での作業が必要です。
抽出中に値の計算やカテゴリの推論が必要な場合(生のフィールド値だけでなく)、ParseurはImageToTableの計算列と推論列に対応できません。Parseurの生データをエクスポートし、スプレッドシートや別のスクリプトで処理する必要があります。ImageToTableは抽出時に完成したデータを提供します。
予算が限られていて、月間3,000ドキュメント未満を処理する場合、ImageToTableの価格設定はエントリーレベルで1ドルあたり5倍のボリュームを提供し、ミッドティアでは40%のコスト削減を実現します。
Parseurが適しているケース
複数のドキュメントタイプやソースからの取り込みがあり、それぞれに個別の解析設定が必要な場合(請求書用のアドレス、配送通知用の別アドレス、注文確認用の3つ目のアドレスなど)、Parseurのメールボックス単位のモデルは、それぞれに個別のアドレスと設定を持ち、ネイティブに対応します。ImageToTableのメール受信トレイも、Auto-Processがテンプレートにバインドされていれば手間なく動作します(メールを転送して放置するだけで、Parseurと同じです)。ただし、アカウントごとに1つの受信トレイアドレスであり、ドキュメントタイプごとのメールボックスではないため、混在するメールは複数の独立した設定ではなく、1つのバインドされたテンプレートを経由します。ベンダーが別々のアドレスを通じて本当に異なる請求書レイアウトを送ってくるAP(買掛金)チームや、複数の異なる通知タイプを扱う物流・Eコマース業務にとって、Parseurのチャネルごとの分離はよりスケーラブルな構成です。
抽出データを下流システムにルーティングするためにZapier、Make、Power Automateに依存するワークフローの場合、Parseurのネイティブ統合の成熟度はより高いです。ImageToTableは直接ファイルエクスポートに焦点を当てており、Parseurのようなオートメーションコネクタのエコシステムはありません。
ドキュメントが固定された少数の既知の送信者から届き、形式が安定していてレイアウトの変更がない場合、Parseurのテンプレートエンジンは決定的で信頼性の高い抽出を実現します。テンプレート設定のコストは一度きりの投資であり、数ヶ月の一貫した処理で回収できます。このシナリオでは、テンプレートのメンテナンスは負担ではなく、一度きりの設定です。
予測可能なドキュメントを非常に高いボリューム(月間10,000ページ以上)で処理する場合、Parseurのスケール時のページ単価(1ページあたり3〜4セントまで)は、定額サブスクリプションモデルを下回ることができます。そのボリュームでは、Parseurはマルチユーザーアカウント(Scaleプランで最大100ユーザー)と、カスタムビジネスロジックのためのPython後処理も利用可能にします。
正直な結論:Parseurは、形式が安定したメール駆動の高ボリュームワークフローに優れています。ImageToTableは、レイアウトの多様性、バッチ処理、限られた予算、そして後処理なしの計算出力を必要とするチームに優れています。 両ツールは異なるアーキテクチャで同じ問題を解決しており、どちらのアーキテクチャが普遍的により優れているわけでもありません。
結論:ドキュメント環境次第
セットアップ時間、フォーマット耐性、メール自動化、価格、ドキュメント対応範囲、計算出力機能を両ツールで比較した結果、その判断基準はほとんどの比較記事が示すよりも明確です。
Parseurは受信メールのドキュメントパイプライン向けに作られています。メールで届く定期的で予測可能な添付ファイルを、人手を介さずに抽出する必要があるケースです。そのテンプレートエンジンは、送信元が安定しているチームに決定的な精度をもたらします。ただし、フォーマットが変わったり、複数の送信元からドキュメントが届いたり、生のフィールド値以外の計算出力が必要な場合には限界があります。
ImageToTableはレイアウトのばらつきがあるバッチドキュメント処理向けに作られています。ドキュメントをまとめてアップロードし、マージ出力が必要で、ドキュメントフォーマットが絶えず変化するチーム向けです。そのセマンティックAIがテンプレート管理を完全に不要にし、独自のEmail Inboxも無人での取り込みをカバーするようになりました。ただし、自動化重視のパイプラインでは、Parseurのチャネル単位のメールボックスモデルとネイティブなZapier/Make統合の深さが依然として優れています。
ドキュメント環境が送信元が安定したメール駆動型であれば、Parseurが現実的な選択肢です。環境が複数の送信元からの多様なフォーマットをバッチ処理するものであれば、ImageToTableは継続的な労力を抑えつつより多くの価値を提供します。その中間にいる場合——そしてほとんどのチームがそうですが——判断を左右すべき要素はフォーマット変更の頻度です。ベンダーがレイアウトを四半期に1回以上更新するなら、テンプレート不要のアプローチは、1年間でメール自動化の利点を上回る時間を節約してくれます。
簡潔版が必要ですか?機能比較表をご覧いただくか、すべてのImageToTable比較をご確認ください。
FAQ
Parseurにはテンプレートが必要ですか?AIエンジンはテンプレートなしで動作しますか?
ParseurにはテンプレートエンジンとAIエンジンの両方が用意されています。テンプレートエンジンは最も安定した結果を生み出しますが、サンプルドキュメント上でフィールドの位置を指定して、ドキュメントのレイアウトごとにビジュアルテンプレートを作成する必要があります。AIエンジンは柔軟性が高く、テンプレートなしでもレイアウトの変化に対応できますが、ドキュメントタイプの設定は必要です。実際には、既知の送信元からの定型ドキュメントについては、テンプレートエンジンの方が固定レイアウトに対して高い精度を発揮するため、多くのParseurユーザーがテンプレートに依存しています。ImageToTableはセマンティックAIのみを使用します。テンプレートもエンジン選択もドキュメントタイプの設定も一切不要です。
ImageToTableはメールで受信したドキュメントを自動的に抽出できますか?
はい。すべてのアカウントに専用の受信メールアドレスが付与されます。ベンダーにこのアドレスを共有するか、自分の請求書や領収書を転送するだけで、添付ファイルが自動的に処理キューに登録されます。ログインやアップロードページは不要です。Auto-Processを有効にして抽出テンプレートにバインドすれば、メールが届くとすぐに処理が開始されます。これはParseurが提供する「転送して放置」のワークフローと同じです。送信者ホワイトリストで無関係なメールを除外でき、パスワード保護された銀行明細書などの暗号化添付ファイルには、保存済みパスワードが自動的に試されます。違いは粒度です。Parseurはドキュメントタイプやチャネルごとに独立した設定を持つメールボックスとアドレスを提供しますが、ImageToTableはアカウントごとに1つの受信アドレスを提供するため、混在したメールは単一のバインド済みテンプレートを通って処理されます。メール受信ボックスは、添付ファイルのみ、メール本文のみ、またはその両方を読み取るように設定できます。
月100ドキュメントの場合、どちらのツールがよりお手頃ですか?
このボリュームではImageToTableの方がはるかに手頃です。Basicプランは月額9ドルで150クレジットを含み、100ページの単一ページドキュメントをカバーし、50クレジット余ります。ParseurのStarterプランは月額39ドル(年払い)または月額49ドル(月払い)で100ページです。エントリーレベルではImageToTableは約5分の1のコストです。異なるボリューム層の完全な価格比較については、2026年のドキュメント抽出価格の内訳をご覧ください。
ParseurはImageToTableのようなバッチ処理に対応していますか?
Parseurは、メールボックス内の個々のアイテムとしてドキュメントを処理します。複数のドキュメントをメールボックスに送信でき、それぞれが独立して解析されます。ただし、「50件のドキュメントを1つの整列されたスプレッドシートにマージする」ような組み込みのUIはありません。結果はドキュメントごとに利用可能で、それらを1つのテーブルにマージするには、統合出力(Google スプレッドシート同期、Zapier)または手動エクスポートが必要です。ImageToTableはバッチファースト処理を念頭に設計されています。複数のファイルをアップロードし、列名を一度定義すれば、すべてのドキュメントで一貫したヘッダーを持つ1つのマージ済みExcelファイルをダウンロードできます。
ParseurはImageToTableの計算列のように、抽出中にフィールドを計算できますか?
ネイティブな抽出機能としてはできません。Parseurはドキュメントから生の値を抽出します。計算、分類、変換は外部で処理する必要があります。スプレッドシート、Python後処理(Scaleプランで月額399ドル以上)、またはZapier/Make変換を通じて行います。ImageToTableの計算列と推論列は、抽出ステップ中に計算と分類を実行するため、追加処理なしで出力をすぐに使用できます。
ParseurからImageToTableに乗り換えられますか?
はい、可能です。ImageToTableはテンプレートを使用しないため、移行にテンプレートのインポートは不要です。過去のParseurデータをCSVまたはExcelとしてエクスポートします。同じソースドキュメントをImageToTableにアップロードし、Parseurのフィールド定義に対応する列名を入力すれば、AIがテンプレート設定なしで抽出します。Parseurで使用していた列名(請求書番号、取引先、日付、合計)が、そのままImageToTableの列名になります。過去のParseurエクスポートと新しいImageToTable抽出結果をスプレッドシートでマージします。ヘッダー名が一貫しているため、マージは簡単です。
GDPR準拠に優れているのはどちらのツールですか?
Parseurの方がGDPR準拠体制は強固です。同社はシンガポール拠点でEU出身の創業者が率いており、EUホストのインフラを備え、GDPR準拠は設計当初からアーキテクチャに組み込まれています。SOC 2 Type IIおよびHIPAA準拠は現在進行中です。ImageToTableは転送中(TLS)および保存時のデータを暗号化し、自動削除も設定可能で、ほとんどのSMBユースケースには十分ですが、正式なGDPR認証の文書化はありません。EUデータ所在地を含む文書化されたGDPR準拠が必須条件であれば、Parseurがより安全な選択肢です。