ImageToTable vs Parseur :
Basé sur un modèle ou sans modèle ? Une comparaison honnête pour 2026
Choisir entre ImageToTable et Parseur revient à une seule question : vos documents arrivent-ils dans des formats prévisibles et cohérents — ou devez-vous gérer une variété de mises en page qui change selon le fournisseur, le mois et la source ? La réponse n'affecte pas seulement la rapidité de configuration de l'outil. Elle détermine si votre pipeline d'extraction devient plus facile avec le temps ou se transforme en un tapis roulant de maintenance. Les deux outils extraient les données des documents de manière fiable. Mais ils abordent le problème selon des philosophies architecturales opposées, et la philosophie qui fonctionne pour une équipe avec trois fournisseurs stables frustrera une équipe qui jongle avec des factures de quarante fournisseurs qui mettent à jour leurs mises en page selon leurs propres calendriers.
Points clés à retenir
- Toute comparaison d'outils d'extraction se lit de la même manière jusqu'à ce que vous remarquiez ce qui manque — personne ne calcule ce qui se passe trois mois plus tard, lorsque les formats des fournisseurs commencent à dériver.
- La maintenance des modèles n'est pas un coût de configuration que vous payez une seule fois — c'est une taxe récurrente imprévisible qui augmente avec chaque fournisseur qui met à jour la conception de ses documents.
- Ignorez le tableau comparatif et posez une seule question : combien de fois vos fournisseurs ont-ils modifié leurs mises en page l'année dernière ? Plus de deux fois signifie que l'approche sans modèle vous épargne tout le tapis roulant de maintenance, pas seulement la configuration initiale.
Comparaison rapide
Avant d'entrer dans le détail de chaque dimension, voici un aperçu des différences entre les deux outils sur les critères qui comptent le plus dans une décision d'extraction de documents.
| Dimension | Parseur | ImageToTable.ai |
|---|---|---|
| Modèle d'extraction | Trois moteurs : basé sur modèles (zone/mot-clé), extraction IA, analyse CSV automatique — meilleure précision avec les modèles | Vision LLM — lit directement la sémantique du document ; sans modèle, sans formation, sans dépendance à la mise en page |
| Temps de configuration | 15 à 30 minutes par modèle ; plusieurs modèles nécessaires pour plusieurs fournisseurs | Moins d'une minute — saisissez les noms de colonnes, importez, les résultats apparaissent |
| Gestion des changements de format | Les modèles se cassent ; mise à jour manuelle requise ; le moteur IA absorbe certaines variations | Automatique — l'extraction sémantique s'adapte à tout changement de mise en page |
| Réception par e-mail | Native — boîte de réception dédiée, transfert automatique, extraction automatique | Native — une boîte de réception par compte, Auto-annotate lié à un modèle |
| Traitement par lots + fusion | Résultats par document ; aucune interface de fusion par lots intégrée | Traitement par lots prioritaire natif : fusionnez des documents de formats variés en une seule feuille de calcul alignée |
| Colonnes calculées / déduites | Non pris en charge — valeurs brutes uniquement ; post-traitement via Python sur les plans Scale | Natif — calculez des totaux, classez des catégories, dérivez des valeurs pendant l'extraction |
| Intégration Zapier / Make | Native — intégration approfondie avec les deux plateformes | Téléchargement direct Excel/CSV/JSON ; aucun connecteur Zapier natif |
| Prix de départ (100 docs/mois) | 39–49 $/mois pour 100 pages | 9 $/mois pour 150 crédits — environ 5× moins cher au niveau d'entrée |
Le tableau rend les compromis visibles. Mais la vraie décision dépend de la dimension la plus importante dans votre flux de travail. Passons en revue chacune d'elles.
Configuration et prise en main : modèles vs noms de colonnes
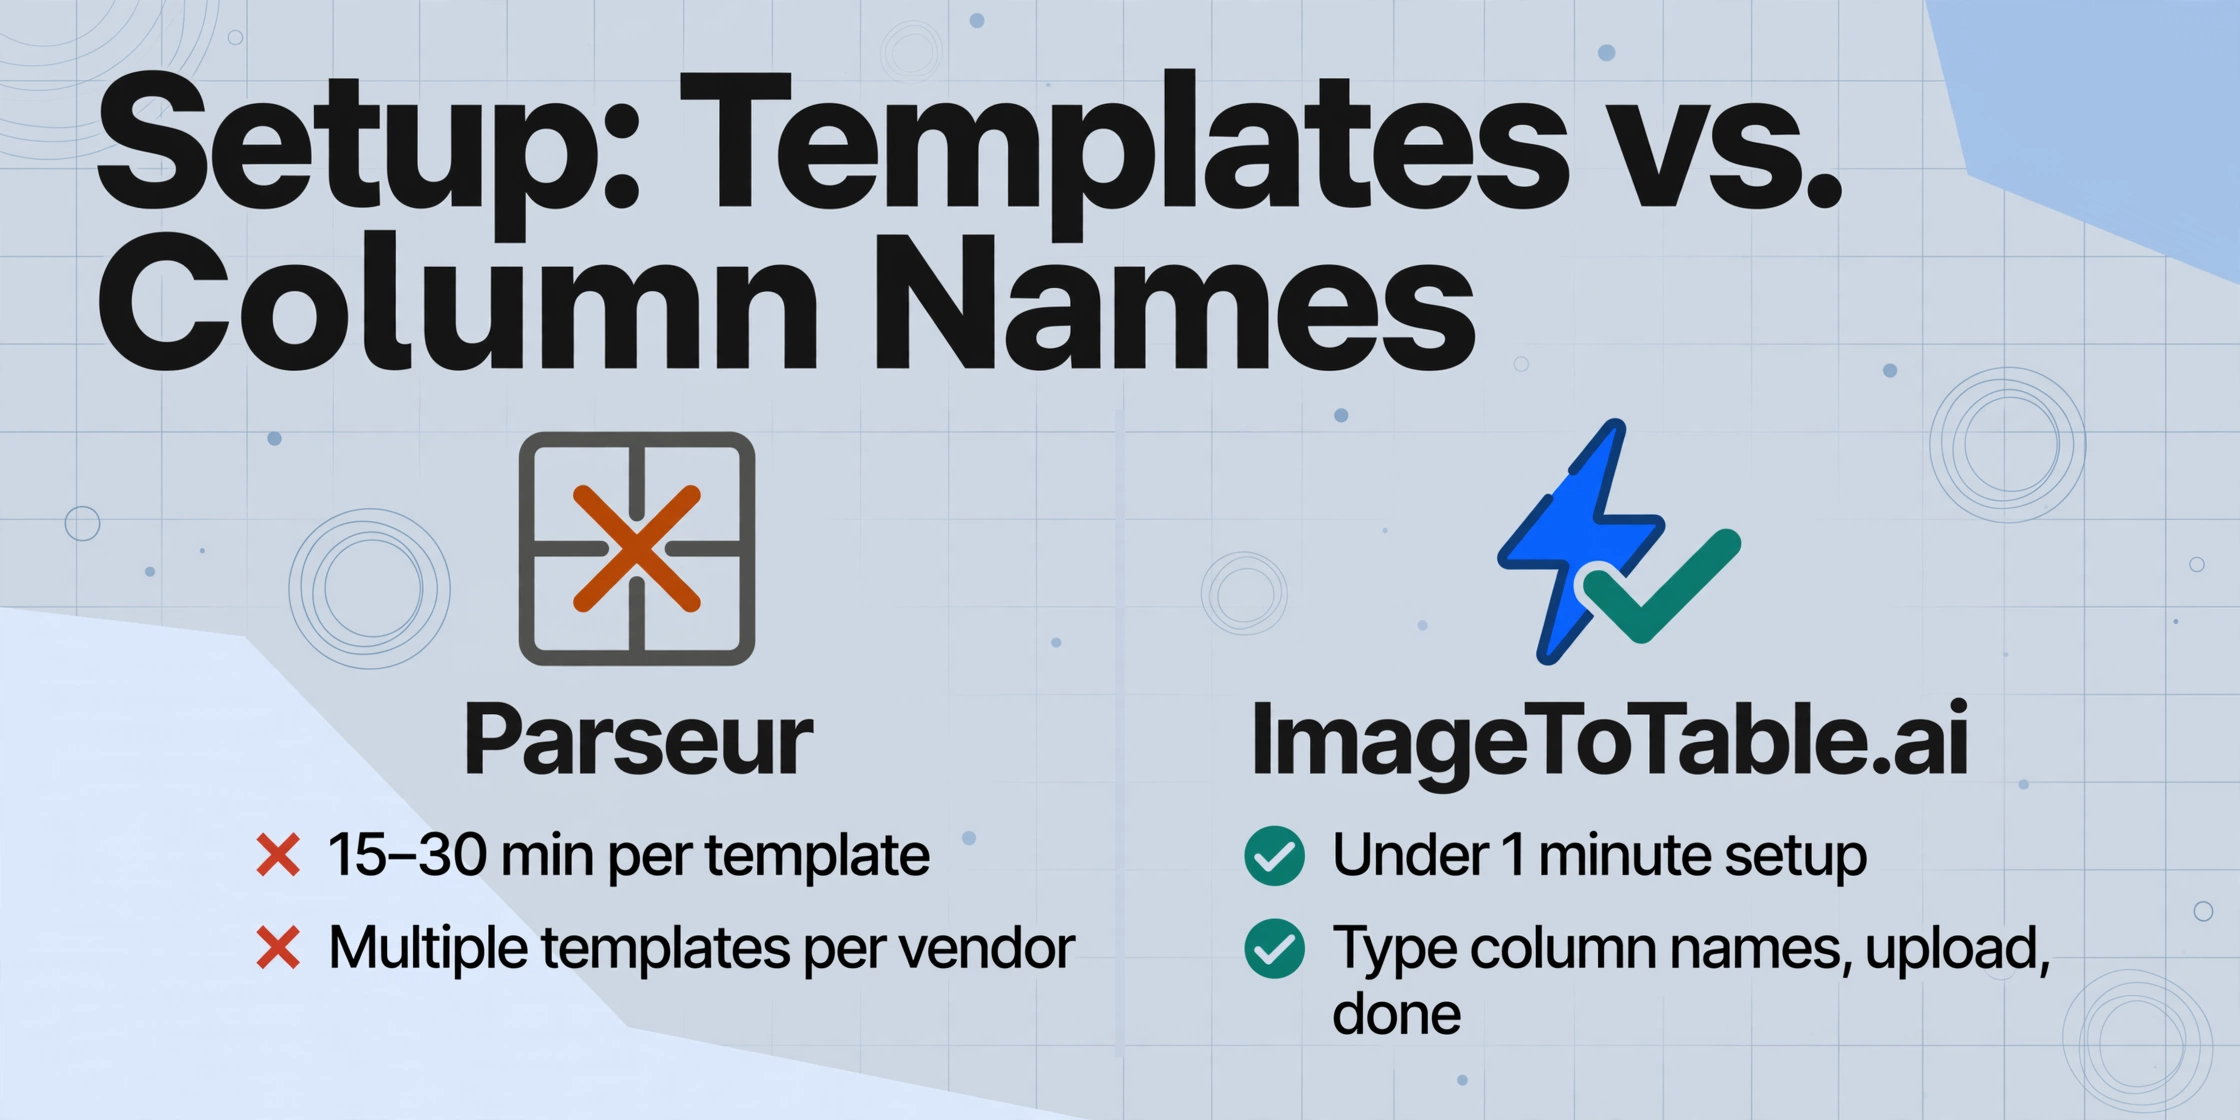
Parseur organise l'extraction autour de « mailboxes » — chaque mailbox est un canal d'entrée de documents dédié avec sa propre configuration d'analyse. La première fois que vous traitez un type de document, Parseur détecte automatiquement les champs lors du premier téléversement — un point de départ vraiment utile. Mais pour obtenir des résultats fiables, vous êtes guidé vers la création d'un modèle : vous surlignez des zones sur un document d'exemple, définissez des règles d'extraction de champs (OCR zonal pour les positions fixes, OCR dynamique pour les champs qui se déplacent par rapport à une étiquette), et entraînez le système sur cette mise en page. Le premier modèle prend généralement 15 à 30 minutes à configurer, tester et affiner.
Si vous recevez des documents de cinq fournisseurs avec des formats cohérents, cela représente 75 à 150 minutes de configuration de modèles — un coût unique qui porte ses fruits si les formats ne changent jamais. Mais si vous traitez des documents de trente fournisseurs, ou si vos sources de documents varient chaque mois, la configuration initiale devient un investissement de temps important avant de voir un quelconque retour.
ImageToTable inverse cette équation. Vous ne configurez aucun canal d'entrée — pas de mailboxes, pas de modèles, pas de définitions de champs. Vous saisissez les noms de colonnes que vous souhaitez extraire (« Numéro de facture », « Nom du fournisseur », « Date », « Total — hors taxes », « Lignes d'articles ») et téléversez vos documents. Le Vision LLM localise ces valeurs en comprenant ce que chaque champ signifie sémantiquement. Il ne cherche pas du texte à une coordonnée de pixel spécifique ou à côté d'une étiquette précise. Il cherche le concept de « Numéro de facture » — où qu'il se trouve, quelle que soit son étiquette, dans toute mise en page de document que vous lui soumettez. Pour les utilisateurs réguliers, l'extraction sans modèle permet d'enregistrer les listes de colonnes comme préréglages, afin que la même extraction s'exécute sur chaque futur lot sans ressaisir les noms de champs.
La différence compte surtout au premier mois. Parseur exige du temps de configuration initial avant de voir des résultats. ImageToTable renvoie sa première extraction en moins de 10 secondes — vous évaluez l'outil sur vos propres documents, pas sur un tutoriel de configuration.
Gérer les changements de format : le coût caché de la maintenance des modèles
C'est la dimension qui sépare le plus nettement les deux outils, et c'est aussi celle que la plupart des articles comparatifs passent sous silence. L'extraction basée sur des modèles fonctionne parfaitement — jusqu'à ce qu'elle ne fonctionne plus. Et dans le traitement de documents réel, les changements de format ne sont pas des exceptions ; ils sont la norme.
Les fournisseurs mettent à jour leurs factures lorsqu'ils changent de logiciel de comptabilité, fusionnent avec une autre entreprise, redessinent leur image de marque ou se conforment à de nouvelles réglementations. Un vendeur modifie son modèle de facture — le champ « Total » passe du coin inférieur droit au coin inférieur gauche. Un fournisseur ajoute une nouvelle ligne d'en-tête à son bon de commande. Un système de notification par e-mail reformate son modèle HTML, déplaçant les détails de confirmation de commande dans une structure de tableau différente. Chaque changement vous est invisible jusqu'à ce que le prochain lot de documents arrive avec des erreurs d'extraction.
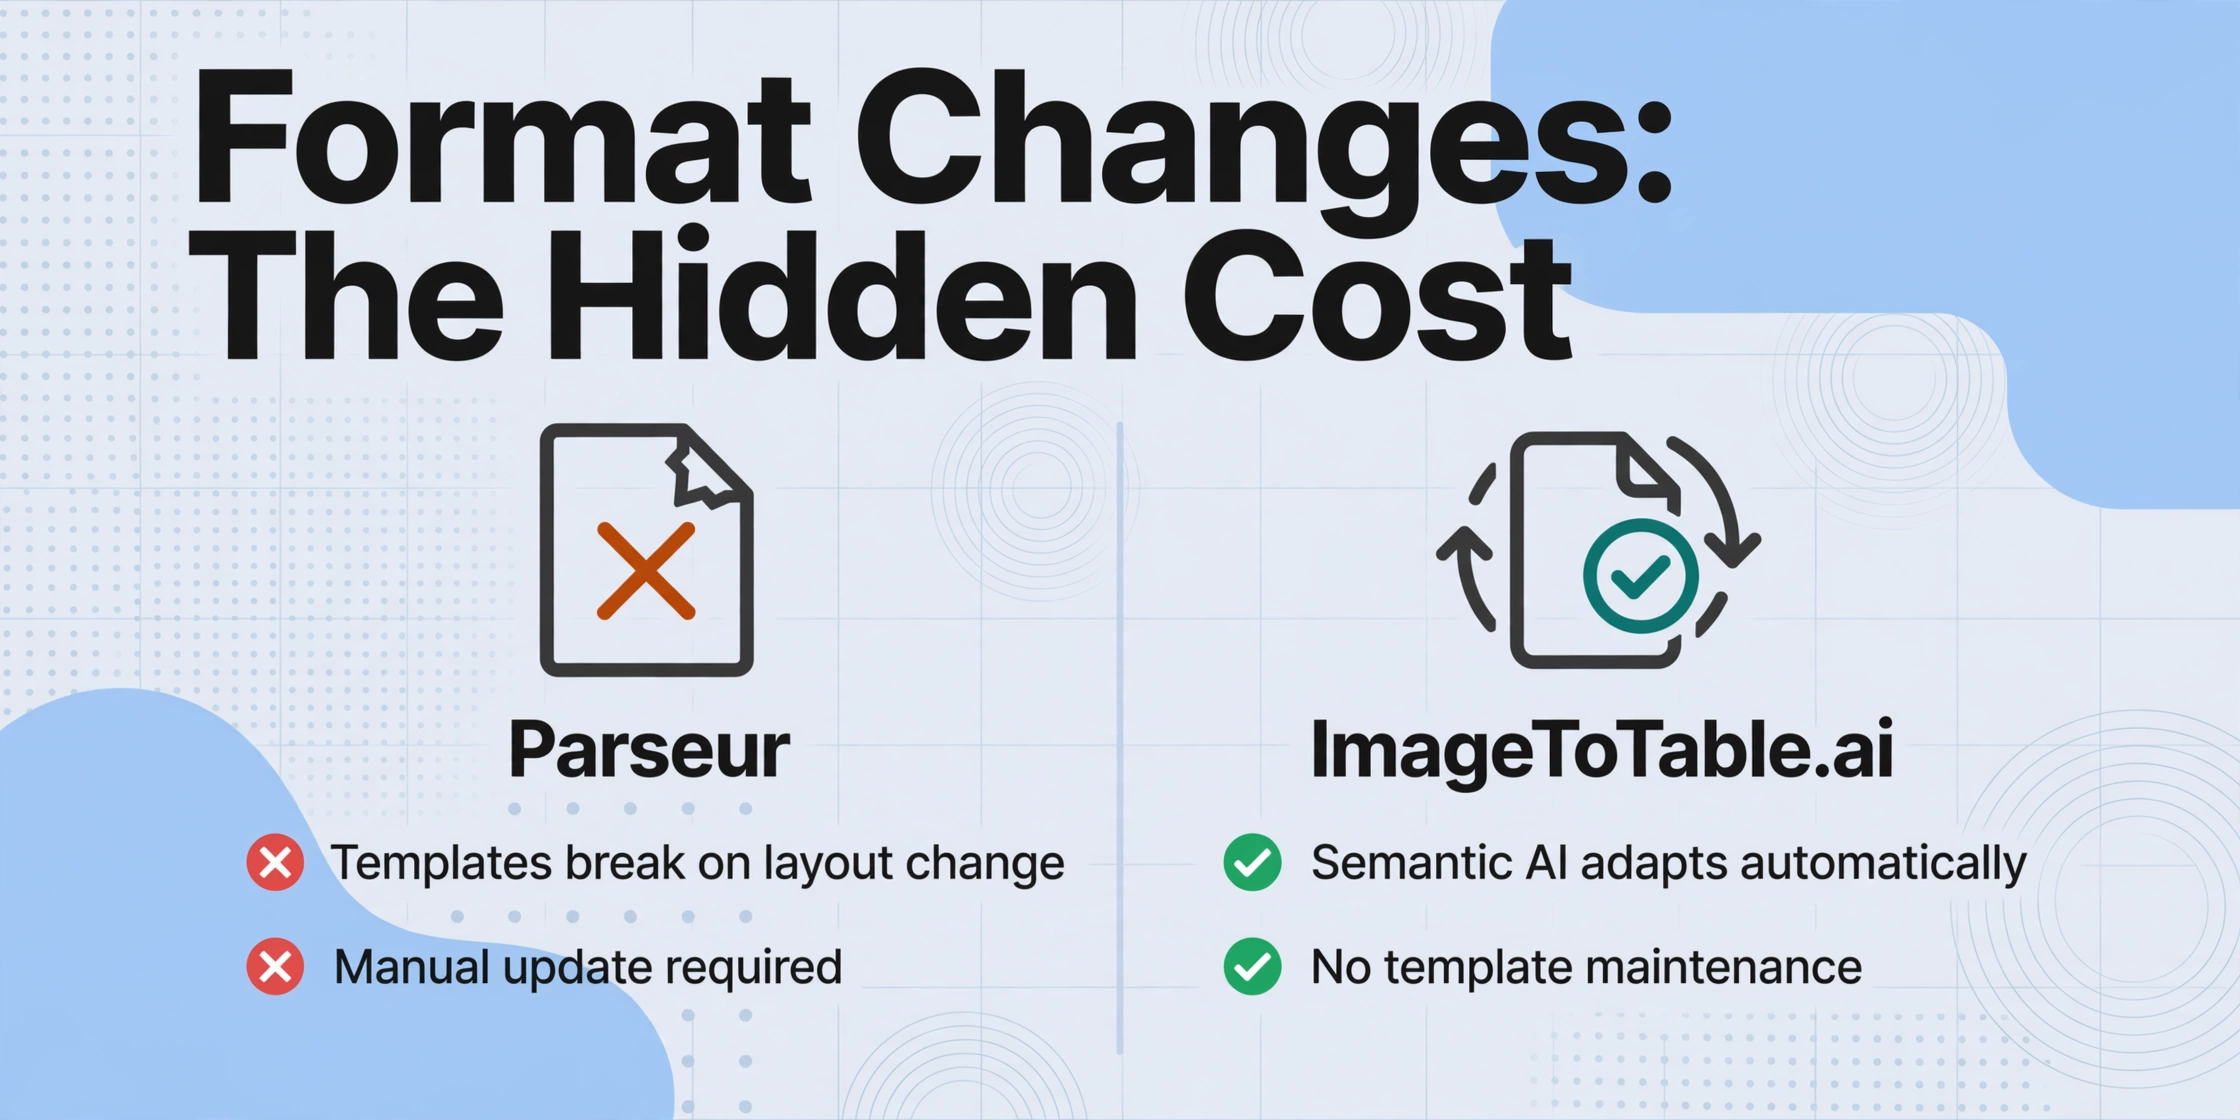
Le moteur de modèles de Parseur — qui donne les résultats les plus cohérents sur les mises en page connues — casse lorsque ces changements surviennent. Les positions des champs que vous avez surlignées sur le document d'exemple ne correspondent plus aux données réelles. Le mot-clé d'ancrage que vous avez utilisé pour l'OCR dynamique a été déplacé ou renommé. Le moteur IA de Parseur est plus flexible que son moteur de modèles — il peut absorber certaines variations de mise en page sans casser — mais le moteur IA fonctionne toujours dans une configuration de type de document, pas sur des mises en page arbitraires. Les avis G2 le confirment : « Des changements mineurs dans les formats d'e-mail peuvent perturber l'analyse. » Chaque perturbation signifie une intervention manuelle — ouvrir l'éditeur de modèles, re-surligner le champ déplacé, re-tester, re-déployer.
Le Vision LLM d'ImageToTable ne se soucie pas de l'emplacement d'un champ sur la page. Il lit le document dans son ensemble et localise chaque champ demandé par sa signification. Un vendeur déplace le « Total » du coin inférieur droit au coin inférieur gauche — l'IA trouve toujours « Total ». Un fournisseur renomme « Facture n° » en « N° Inv » — l'IA le mappe à votre colonne « Numéro de facture » car elle comprend la relation sémantique. Un nouveau fournisseur envoie un document dans un format que vous n'avez jamais vu — il est traité correctement dès le premier envoi, sans modèle à créer. C'est le sens pratique de l'extraction de documents sans formation : l'outil s'adapte automatiquement aux variations de format, sans votre intervention.
Le coût réel de la maintenance des modèles n'est pas la configuration initiale — c'est l'effort continu et imprévisible de corriger les modèles à chaque changement de format dans votre chaîne d'approvisionnement. Pour les équipes ayant des expéditeurs stables et connus, ce coût est faible. Pour tous les autres, il transforme ce qui était censé être de l'automatisation en une tâche de maintenance réactive.
E-mail et automatisation : l'avantage décisif de Parseur
C'est le domaine où Parseur excelle — et nous devons être directs à ce sujet. Parseur a été conçu dès le départ autour de l'e-mail comme canal principal de réception des documents. Vous obtenez une adresse e-mail dédiée pour chaque boîte aux lettres. Transférez les factures entrantes, les bons de commande, les notifications d'expédition ou toute pièce jointe à cette adresse, et Parseur les analyse automatiquement, sans que personne n'ait à ouvrir un navigateur, téléverser un fichier ou cliquer sur un bouton. Le pipeline d'extraction fonctionne sans surveillance — les documents arrivent dans votre boîte de réception, les données arrivent dans votre feuille de calcul, et personne n'a besoin d'intervenir dans le processus.
Pour les équipes dont le flux de travail documentaire repose fondamentalement sur l'e-mail — les services de comptabilité fournisseurs (AP) où les fournisseurs envoient des factures à [email protected], les équipes logistiques où les transporteurs envoient des preuves de livraison en PDF, les opérations e-commerce où les confirmations de commande arrivent par e-mail — l'architecture axée sur l'e-mail de Parseur élimine plus d'étapes du flux de travail que toute approche sans modèle ne peut égaler par une meilleure extraction seule. La différence ne réside pas dans la manière dont les données sont extraites, mais dans la manière dont le document atteint le moteur d'extraction.
Parseur s'intègre également nativement avec Zapier, Make, Power Automate et n8n. Cela signifie que les données analysées peuvent circuler automatiquement vers des centaines de destinations en aval — Google Sheets, Airtable, QuickBooks, Slack, Salesforce — sans exportation manuelle. Pour les équipes qui ont investi dans des plateformes d'automatisation, cette profondeur d'intégration est un véritable multiplicateur de productivité.
ImageToTable couvre désormais aussi la réception d'e-mails sans surveillance. Chaque compte dispose d'une adresse de boîte de réception dédiée — partagez-la avec vos fournisseurs, ou transférez vos propres factures et reçus à cette adresse, et les pièces jointes arrivent automatiquement dans votre file de traitement, sans page de connexion ni de téléversement. Activez Auto-Process et liez-le à un modèle d'extraction, et le traitement démarre dès l'arrivée du courrier — transférez l'e-mail et éloignez-vous, de la même manière que fonctionne le pipeline de Parseur.
L'écart restant concerne la granularité, pas l'automatisation. Parseur donne à chaque type de document ou canal sa propre boîte aux lettres et sa propre adresse, chacune configurée séparément. ImageToTable donne à chaque compte une seule adresse de boîte de réception, de sorte que les courriers mixtes provenant de différentes sources passent par un modèle lié unique plutôt que par plusieurs boîtes aux lettres configurées indépendamment. La boîte de réception e-mail peut être configurée pour lire les pièces jointes, le corps de l'e-mail lui-même, ou les deux — ainsi, un fournisseur qui saisit les chiffres directement dans le texte du message fonctionne aussi, pas seulement les fichiers transférés. Une liste blanche d'expéditeurs empêche les courriers non liés d'entrer dans la file, et pour les pièces jointes chiffrées comme les relevés bancaires protégés par mot de passe, les mots de passe enregistrés sont essayés automatiquement avant que quoi que ce soit n'atteigne votre écran de révision.
Les documents atteignent également le moteur d'extraction par téléversement direct de fichiers dans l'interface web ou via la barre latérale du module complémentaire Google Sheets — deux autres voies qui ne touchent pas du tout à l'e-mail.
Ceci dit, le lien de collecte comble une lacune adjacente que l'architecture e-mail de Parseur ne couvre pas : collecter des documents auprès de personnes qui ne vous les envoient pas par e-mail. Le personnel de terrain téléversant des photos de chantier depuis son téléphone, des clients soumettant des factures via un portail, des employés transférant des photos de reçus d'un voyage — le lien de collecte accepte les téléversements de toute personne disposant du lien, sans inscription requise. Ce n'est pas de l'automatisation par e-mail, mais cela résout un problème de réception différent que le transfert d'e-mails ne traite pas.
Tarifs et valeur : deux modèles de coûts différents
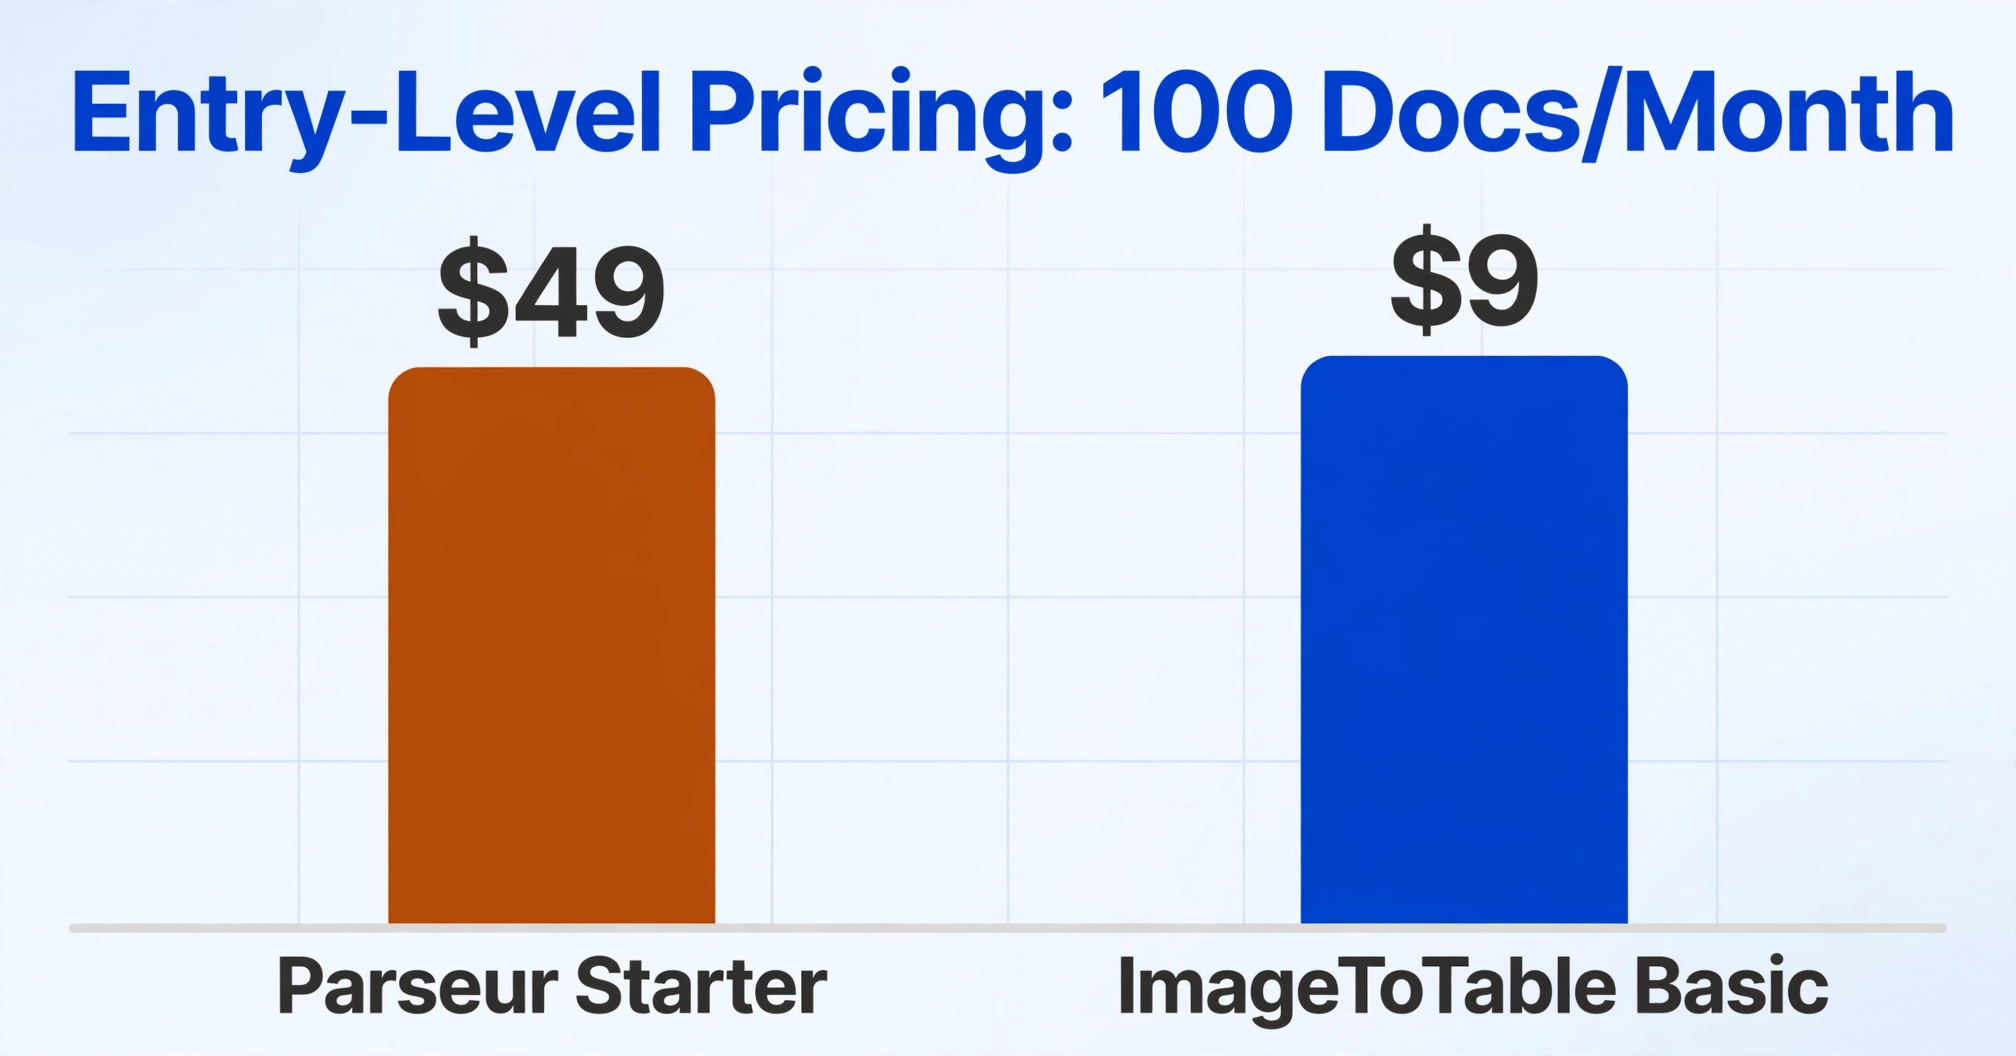
Les tarifs publiés de Parseur commencent à 39 $/mois (facturation annuelle) ou 49 $/mois (mensuelle) pour le plan Starter à 100 pages. Une page équivaut à un crédit — une facture PDF de 3 pages consomme 3 crédits. Le niveau gratuit offre 20 pages/mois avec des filigranes sur les données exportées. Le plan Pro (99 $/mois) couvre 1 000 pages, et le plan Scale (399 $/mois) couvre 10 000 pages. Tous les plans incluent les mêmes fonctionnalités de base — la tarification est purement basée sur le volume.
ImageToTable utilise un modèle d'abonnement avec des limites de crédits : Basic à 9 $/mois pour 150 crédits, Pro à 29 $/mois pour 500 crédits, Max à 59 $/mois pour 1 500 crédits. Un crédit équivaut à une image ou à une page PDF. Aucun filigrane sur aucun plan. Un quota gratuit quotidien vous permet de tester avec de vrais documents avant de payer. Des packs de crédits ponctuels sont disponibles sans abonnement.
Au niveau d'entrée, le plan Basic d'ImageToTable (9 $/mois pour 150 pages) coûte environ 80 % de moins que le plan Starter de Parseur (39–49 $/mois pour 100 pages) et offre 50 % de volume en plus. À 1 000 pages/mois, le plan Max d'ImageToTable coûte 59 $/mois contre 99 $/mois pour le plan Pro de Parseur — une économie de 40 % à volume équivalent. Pour une comparaison détaillée de l'impact des différents modèles de tarification sur votre facture mensuelle, consultez la ventilation des tarifs d'extraction de documents 2026.
Il existe un scénario où la tarification de Parseur est plus avantageuse : les très gros volumes avec une base d'expéditeurs fixe et prévisible. Si vous traitez exactement 10 000 pages chaque mois provenant de fournisseurs connus où les modèles fonctionnent de manière fiable, le coût par page de Parseur tombe à environ 4 centimes par page sur le plan Scale (399 $/mois pour 10 000 pages). La tarification d'ImageToTable n'est pas aussi agressive à ce niveau de volume — la meilleure option serait le plan Growth à 149 $ pour jusqu'à 3 000 crédits partagés entre une équipe, ou le plan Enterprise à 899 $ pour jusqu'à 10 000 crédits partagés. À l'échelle véritablement entreprise (100 000+ pages), le modèle de remise sur volume de Parseur peut produire un coût par page inférieur.
Mais pour la plage de volumes où opèrent la plupart des équipes — 100 à 3 000 documents par mois — l'abonnement forfaitaire d'ImageToTable offre systématiquement plus de volume pour moins d'argent, avec l'avantage supplémentaire d'une facturation mensuelle prévisible qui ne fluctue pas selon la complexité des documents.
Types de documents & Précision
Les deux outils couvrent les types de documents courants : factures, reçus, bons de commande, bons de livraison, contrats et formulaires. Mais ils atteignent la précision par des mécanismes différents, et la différence importe selon l'apparence de vos documents.
Le moteur de modèles de Parseur excelle sur les PDF numériques propres et les contenus d'e-mails structurés où les positions des champs sont cohérentes entre les documents d'un même expéditeur. Une fois qu'un modèle est créé et testé pour une mise en page connue, l'extraction est déterministe — les mêmes champs aux mêmes positions à chaque fois. Le moteur de modèles gère également l'extraction de tableaux (lignes d'articles dans les factures) via un éditeur visuel de tableaux, mais sa configuration nécessite de définir les limites des lignes, les séparateurs de colonnes et les marges d'en-tête/pied de page. Pour les documents au format fixe provenant d'un ensemble stable d'expéditeurs, cette approche fournit des résultats fiables et reproductibles.
Le moteur Vision AI de Parseur étend la couverture aux documents numérisés et aux images — il gère mieux les cases à cocher, les tampons et l'écriture manuscrite que le moteur de modèles seul. Mais c'est une option secondaire, pas la voie d'extraction principale. Le moteur de modèles reste la méthode la plus précise de Parseur, et ses atouts sont liés à la cohérence du format.
Le LLM visuel d'ImageToTable traite chaque document comme une mise en page visuelle unique. Impression, scan, photo de téléphone, capture d'écran ou formulaire manuscrit — l'IA lit la sémantique du document directement sans changer de moteur. Pour les données tabulaires imprimées, la précision atteint jusqu'à 99 % sur les documents propres. Le modèle est particulièrement performant sur les documents mélangeant contenu imprimé et manuscrit — comme les formulaires d'inspection où les étiquettes pré-imprimées sont remplies à la main — car il comprend la relation entre l'étiquette et la valeur plutôt que de se fier à une extraction basée sur la position.
Une capacité où ImageToTable n'a pas d'équivalent chez Parseur est les Colonnes calculées. Au-delà de l'extraction de ce qui figure sur la page, vous pouvez définir des colonnes où l'IA calcule pendant l'extraction — « Total ligne (Qté × Prix unitaire) », « Total HT », « Catégorie (options : Repas/Transport/Bureau) » comme classification inférée. Parseur extrait les valeurs brutes ; vous effectuez les calculs et classifications en externe. ImageToTable les intègre dans l'étape d'extraction, de sorte que votre résultat soit prêt à l'emploi sans post-traitement.
Quand ImageToTable est plus pertinent
Si vos documents proviennent de plusieurs fournisseurs avec des mises en page différentes — et que ces mises en page changent — l'approche sans modèle d'ImageToTable vous évite la maintenance constante qu'exigent les outils basés sur des modèles. Le modèle d'extraction sémantique vous permet de définir votre sortie une seule fois (les noms de colonnes souhaités) et l'IA gère automatiquement toute variation de mise en page en entrée.
Si vous traitez des lots de documents ensemble — en téléversant 50 factures à la fois et en ayant besoin qu'elles soient fusionnées en une seule feuille de calcul alignée — la conception de traitement par lots prioritaire d'ImageToTable réalise cela en une seule étape. Parseur traite chaque document comme un élément individuel dans une boîte mail ; la fusion de plusieurs extractions en un tableau unifié nécessite un travail externe.
Si vous avez besoin de valeurs calculées ou de catégories déduites pendant l'extraction — pas seulement des valeurs de champs brutes — Parseur ne peut pas égaler les colonnes calculées et les colonnes déduites d'ImageToTable. Vous devriez exporter les données brutes de Parseur et les traiter dans une feuille de calcul ou un script séparé. ImageToTable fournit des données finalisées dès l'extraction.
Si votre budget est serré et que vous traitez moins de 3 000 documents par mois, la tarification d'ImageToTable offre 5× plus de volume par dollar au niveau d'entrée et 40 % d'économies au niveau intermédiaire.
Quand Parseur est plus pertinent
Si votre flux englobe plusieurs types de documents ou sources qui nécessitent chacun leur propre configuration d'extraction — une adresse pour les factures, une autre pour les notifications d'expédition, une troisième pour les confirmations de commande — le modèle par boîte mail de Parseur gère cela nativement, avec une adresse et une configuration distinctes pour chacune. La boîte mail d'ImageToTable fonctionne également sans intervention une fois l'auto-traitement lié à un modèle — transférez le courrier et laissez faire, comme avec Parseur — mais il s'agit d'une seule adresse de boîte mail par compte plutôt que d'une boîte mail par type de document, donc les courriers mixtes passent par un seul modèle lié au lieu de plusieurs configurations indépendantes. Pour les équipes de comptabilité fournisseurs (AP) dont les fournisseurs envoient des mises en page de factures vraiment différentes via des adresses séparées, ou pour les opérations logistiques et e-commerce qui gèrent plusieurs types de notifications distincts, la séparation par canal de Parseur est la configuration la plus évolutive.
Si votre flux de travail dépend de Zapier, Make ou Power Automate pour acheminer les données extraites vers les systèmes en aval, la profondeur d'intégration native de Parseur est plus mature. ImageToTable se concentre sur l'export direct de fichiers ; il ne dispose pas de l'écosystème de connecteurs d'automatisation de Parseur.
Si vos documents proviennent d'un ensemble fixe et restreint d'expéditeurs connus avec des formats stables et sans changement de mise en page, le moteur de modèles de Parseur offre une extraction déterministe et fiable. Le coût de configuration du modèle est un investissement ponctuel qui est rentabilisé sur des mois de traitement constant. Dans ce scénario, la maintenance du modèle n'est pas une charge — c'est une configuration unique.
Si vous traitez de très gros volumes (10 000+ pages par mois) de documents prévisibles, la tarification par page de Parseur à grande échelle (dès 3–4 centimes par page) peut être inférieure aux abonnements à tarif fixe. À ce volume, Parseur débloque également des comptes multi-utilisateurs (jusqu'à 100 utilisateurs sur le plan Scale) et un post-traitement Python pour une logique métier personnalisée.
Le verdict honnête : Parseur l'emporte pour les flux à volume élevé pilotés par e-mail avec des formats stables. ImageToTable l'emporte pour les équipes confrontées à une variété de mises en page, au traitement par lots, à des budgets limités et au besoin de sorties calculées sans post-traitement. Les outils résolvent le même problème avec des architectures différentes, et aucune architecture n'est universellement supérieure.
Le verdict : tout dépend de votre écosystème documentaire
Après avoir comparé les deux outils sur le temps de configuration, la résilience aux formats, l'automatisation des e-mails, la tarification, la couverture documentaire et les capacités de sortie calculée, le cadre de décision est plus clair que ce que suggèrent la plupart des articles de comparaison.
Parseur est conçu pour les pipelines de documents entrants par e-mail — des pièces jointes récurrentes et prévisibles qui arrivent par e-mail et doivent être extraites sans intervention humaine. Son moteur de modèles récompense les équipes ayant des expéditeurs stables par une précision déterministe. Ses limites apparaissent lorsque les formats changent, lorsque les documents proviennent de nombreuses sources, ou lorsque vous avez besoin de sorties calculées au-delà des valeurs de champs brutes.
ImageToTable est conçu pour le traitement de documents par lots avec variabilité de mise en page — des équipes qui téléversent des documents en groupes, ont besoin de sorties fusionnées et font face à des formats de documents en constante évolution. Son IA sémantique élimine entièrement la maintenance des modèles, et sa propre boîte de réception e-mail couvre désormais aussi la réception non supervisée — bien que le modèle de boîte aux lettres par canal de Parseur et la profondeur d'intégration native Zapier/Make aillent encore plus loin pour les pipelines fortement automatisés.
Si votre écosystème documentaire est piloté par e-mail avec des expéditeurs stables, Parseur est le choix pragmatique. Si votre écosystème est composé de formats variés provenant de multiples sources, traités par lots, ImageToTable offre plus de valeur avec moins d'effort continu. Si vous êtes quelque part entre les deux — et c'est le cas de la plupart des équipes — la dimension qui devrait faire pencher la balance est la fréquence des changements de format. Si vos fournisseurs mettent à jour leurs mises en page plus d'une fois par trimestre, l'approche sans modèle vous fera gagner plus de temps sur une année que ne peut le compenser tout gain d'automatisation des e-mails.
Vous voulez la version condensée ? Consultez le tableau comparatif des fonctionnalités côte à côte, ou parcourez toutes les comparaisons ImageToTable.
FAQ
Est-ce que Parseur nécessite des modèles, ou son moteur IA fonctionne-t-il sans eux ?
Parseur propose à la fois un moteur de modèles et un moteur IA. Le moteur de modèles — qui produit les résultats les plus cohérents — nécessite de créer un modèle visuel pour chaque mise en page de document en surlignant les positions des champs sur un document exemple. Le moteur IA est plus flexible et peut gérer les variations de mise en page sans modèle, mais il nécessite tout de même une configuration du type de document. En pratique, la plupart des utilisateurs de Parseur finissent par s'appuyer sur des modèles pour les documents récurrents provenant d'expéditeurs connus, car le moteur de modèles offre une meilleure précision pour les mises en page fixes. ImageToTable utilise exclusivement l'IA sémantique — aucun modèle, aucune sélection de moteur, aucune configuration de type de document requise.
ImageToTable peut-il extraire automatiquement les documents reçus par e-mail ?
Oui. Chaque compte dispose d'une adresse de boîte de réception dédiée — partagez-la avec vos fournisseurs ou transférez-y vos propres factures et reçus, et les pièces jointes arrivent automatiquement dans votre file de traitement, sans connexion ni page de téléversement. Activez le traitement automatique et liez-le à un modèle d'extraction, et le traitement démarre dès l'arrivée du courrier — le même flux « transférer et laisser faire » que propose Parseur. Une liste blanche d'expéditeurs empêche les courriers non pertinents d'entrer, et les mots de passe enregistrés sont essayés automatiquement sur les pièces jointes chiffrées comme les relevés bancaires protégés par mot de passe. La différence réside dans la granularité : Parseur donne à chaque type de document ou canal sa propre boîte de réception et sa propre adresse avec une configuration indépendante, tandis qu'ImageToTable donne à chaque compte une seule adresse de boîte de réception, de sorte que les courriers mixtes passent par un seul modèle lié. La boîte de réception e-mail peut être configurée pour lire les pièces jointes, le corps de l'e-mail, ou les deux.
Quel outil est le plus abordable pour 100 documents par mois ?
ImageToTable est nettement plus abordable à ce volume. Le plan Basic coûte 9 $/mois pour 150 crédits — assez pour couvrir 100 documents d'une page avec 50 crédits de réserve. Le plan Starter de Parseur coûte 39 $/mois (annuel) ou 49 $/mois (mensuel) pour 100 pages. ImageToTable est environ 5× moins cher au niveau d'entrée. Pour une comparaison complète des prix selon les différents paliers de volume, consultez la répartition des prix d'extraction de documents 2026.
Parseur prend-il en charge le traitement par lots comme ImageToTable ?
Parseur traite les documents comme des éléments individuels dans une boîte mail. Vous pouvez envoyer plusieurs documents vers une boîte mail et chacun est analysé indépendamment. Mais il n'existe pas d'interface intégrée « fusionner 50 documents en une seule feuille de calcul alignée ». Les résultats sont disponibles par document, et leur fusion dans un tableau unique nécessite une sortie d'intégration (synchronisation Google Sheets, Zapier) ou une exportation manuelle. ImageToTable a été conçu pour un traitement par lots prioritaire : téléversez plusieurs fichiers, définissez les noms de colonnes une seule fois, et téléchargez un fichier Excel fusionné avec des en-têtes cohérents sur tous les documents.
Parseur peut-il calculer des champs pendant l'extraction comme les colonnes calculées d'ImageToTable ?
Pas en tant que fonctionnalité d'extraction native. Parseur extrait des valeurs brutes des documents. Les calculs, classifications ou transformations doivent être gérés en externe — dans une feuille de calcul, via un post-traitement Python (disponible sur les plans Scale à 399 $/mois et plus), ou via des transformations Zapier/Make. Les colonnes calculées et les colonnes déduites d'ImageToTable effectuent des calculs et des classifications pendant l'étape d'extraction, de sorte que la sortie est prête à l'emploi sans traitement supplémentaire.
Puis-je passer de Parseur à ImageToTable ?
Oui, et la migration ne nécessite pas d'importer des modèles — car ImageToTable n'utilise pas de modèles. Exportez vos données historiques de Parseur au format CSV ou Excel. Téléversez les mêmes documents sources vers ImageToTable, saisissez les noms de colonnes qui correspondent à vos définitions de champs Parseur, et l'IA les extrait sans aucune configuration de modèle. Les noms de colonnes que vous utilisiez dans Parseur (Invoice Number, Vendor, Date, Total) deviennent vos noms de colonnes dans ImageToTable. Fusionnez vos exportations historiques de Parseur avec les nouvelles extractions d'ImageToTable dans une feuille de calcul — des noms d'en-têtes cohérents rendent la fusion simple.
Quel outil est le meilleur pour la conformité RGPD ?
Parseur a une meilleure posture de conformité RGPD. L'entreprise est basée à Singapour avec des fondateurs européens, et la conformité RGPD est intégrée à l'architecture dès le départ avec une infrastructure hébergée dans l'UE. La conformité SOC 2 Type II et HIPAA est en cours. ImageToTable chiffre les données en transit (TLS) et au repos avec une suppression automatique configurable — suffisant pour la plupart des cas d'usage des PME, mais sans documentation de certification RGPD formelle. Si une conformité RGPD documentée avec résidence des données dans l'UE est une exigence stricte, Parseur est le choix le plus sûr.