ImageToTable vs Parseur:
Com Modelo ou Sem Modelo? Uma Comparação Honesta para 2026
Escolher entre ImageToTable e Parseur se resume a uma pergunta: seus documentos chegam em formatos previsíveis e consistentes — ou você lida com uma variedade de layouts que muda por fornecedor, por mês e por fonte? A resposta não afeta apenas qual ferramenta é mais rápida de configurar. Ela determina se seu pipeline de extração fica mais fácil com o tempo ou se transforma em uma esteira de manutenção. Ambas as ferramentas extraem dados de documentos com confiabilidade. Mas elas abordam o problema a partir de filosofias arquitetônicas opostas, e a filosofia que funciona para uma equipe com três fornecedores estáveis vai frustrar uma equipe que lida com faturas de quarenta fornecedores que atualizam seus layouts em seus próprios cronogramas.
Principais Conclusões
- Toda comparação de ferramentas de extração parece a mesma até você notar o que está faltando — ninguém calcula o que acontece três meses depois, quando os formatos dos fornecedores começam a mudar.
- A manutenção de modelos não é um custo de configuração que você paga uma vez — é um imposto recorrente e imprevisível que cresce a cada fornecedor que atualiza o design de seus documentos.
- Pule a tabela de comparação e faça uma pergunta: quantas vezes seus fornecedores mudaram seus layouts no ano passado? Mais de duas vezes significa que a abordagem sem modelo economiza toda a esteira de manutenção, não apenas a configuração inicial.
Comparação Rápida
Antes de analisarmos cada dimensão, aqui está um resumo de como as duas ferramentas se diferenciam nos fatores que mais importam em uma decisão de extração de documentos.
| Dimensão | Parseur | ImageToTable.ai |
|---|---|---|
| Modelo de extração | Três motores: baseado em modelo (zona/palavra-chave), extração por IA, análise automática de CSV — melhor precisão com modelos | Vision LLM — lê a semântica do documento diretamente; sem modelos, sem treinamento, sem dependência de layout |
| Tempo de configuração | 15–30 minutos por modelo; vários modelos necessários para vários fornecedores | Menos de 1 minuto — digite os nomes das colunas, envie, os resultados aparecem |
| Tratamento de mudanças de formato | Os modelos quebram; exigem atualização manual; o motor de IA absorve algumas variações | Automático — a extração semântica se adapta a qualquer mudança de layout |
| Recebimento por e-mail | Nativo — caixa de entrada dedicada, encaminhamento automático, extração automática | Nativo — uma caixa de entrada por conta, o Auto-Process vincula a um modelo |
| Processamento em lote + mesclagem | Resultados por documento; sem interface de mesclagem em lote integrada | Processamento em lote prioritário nativo: mescla documentos de formatos variados em uma única planilha alinhada |
| Colunas calculadas / inferidas | Não suportado — apenas valores brutos; pós-processamento via Python nos planos Scale | Nativo — calcule totais, classifique categorias, derive valores durante a extração |
| Integração Zapier / Make | Nativa — integração profunda com ambas as plataformas | Download direto em Excel/CSV/JSON; sem conector nativo do Zapier |
| Preço inicial (100 docs/mês) | US$ 39–49/mês para 100 páginas | US$ 9/mês para 150 créditos — ~5× mais barato no nível inicial |
A tabela torna as compensações visíveis. Mas a decisão real depende de quais dessas dimensões importam mais no seu fluxo de trabalho. Vamos analisar cada uma.
Configuração e Integração: Modelos vs. Nomes de Colunas
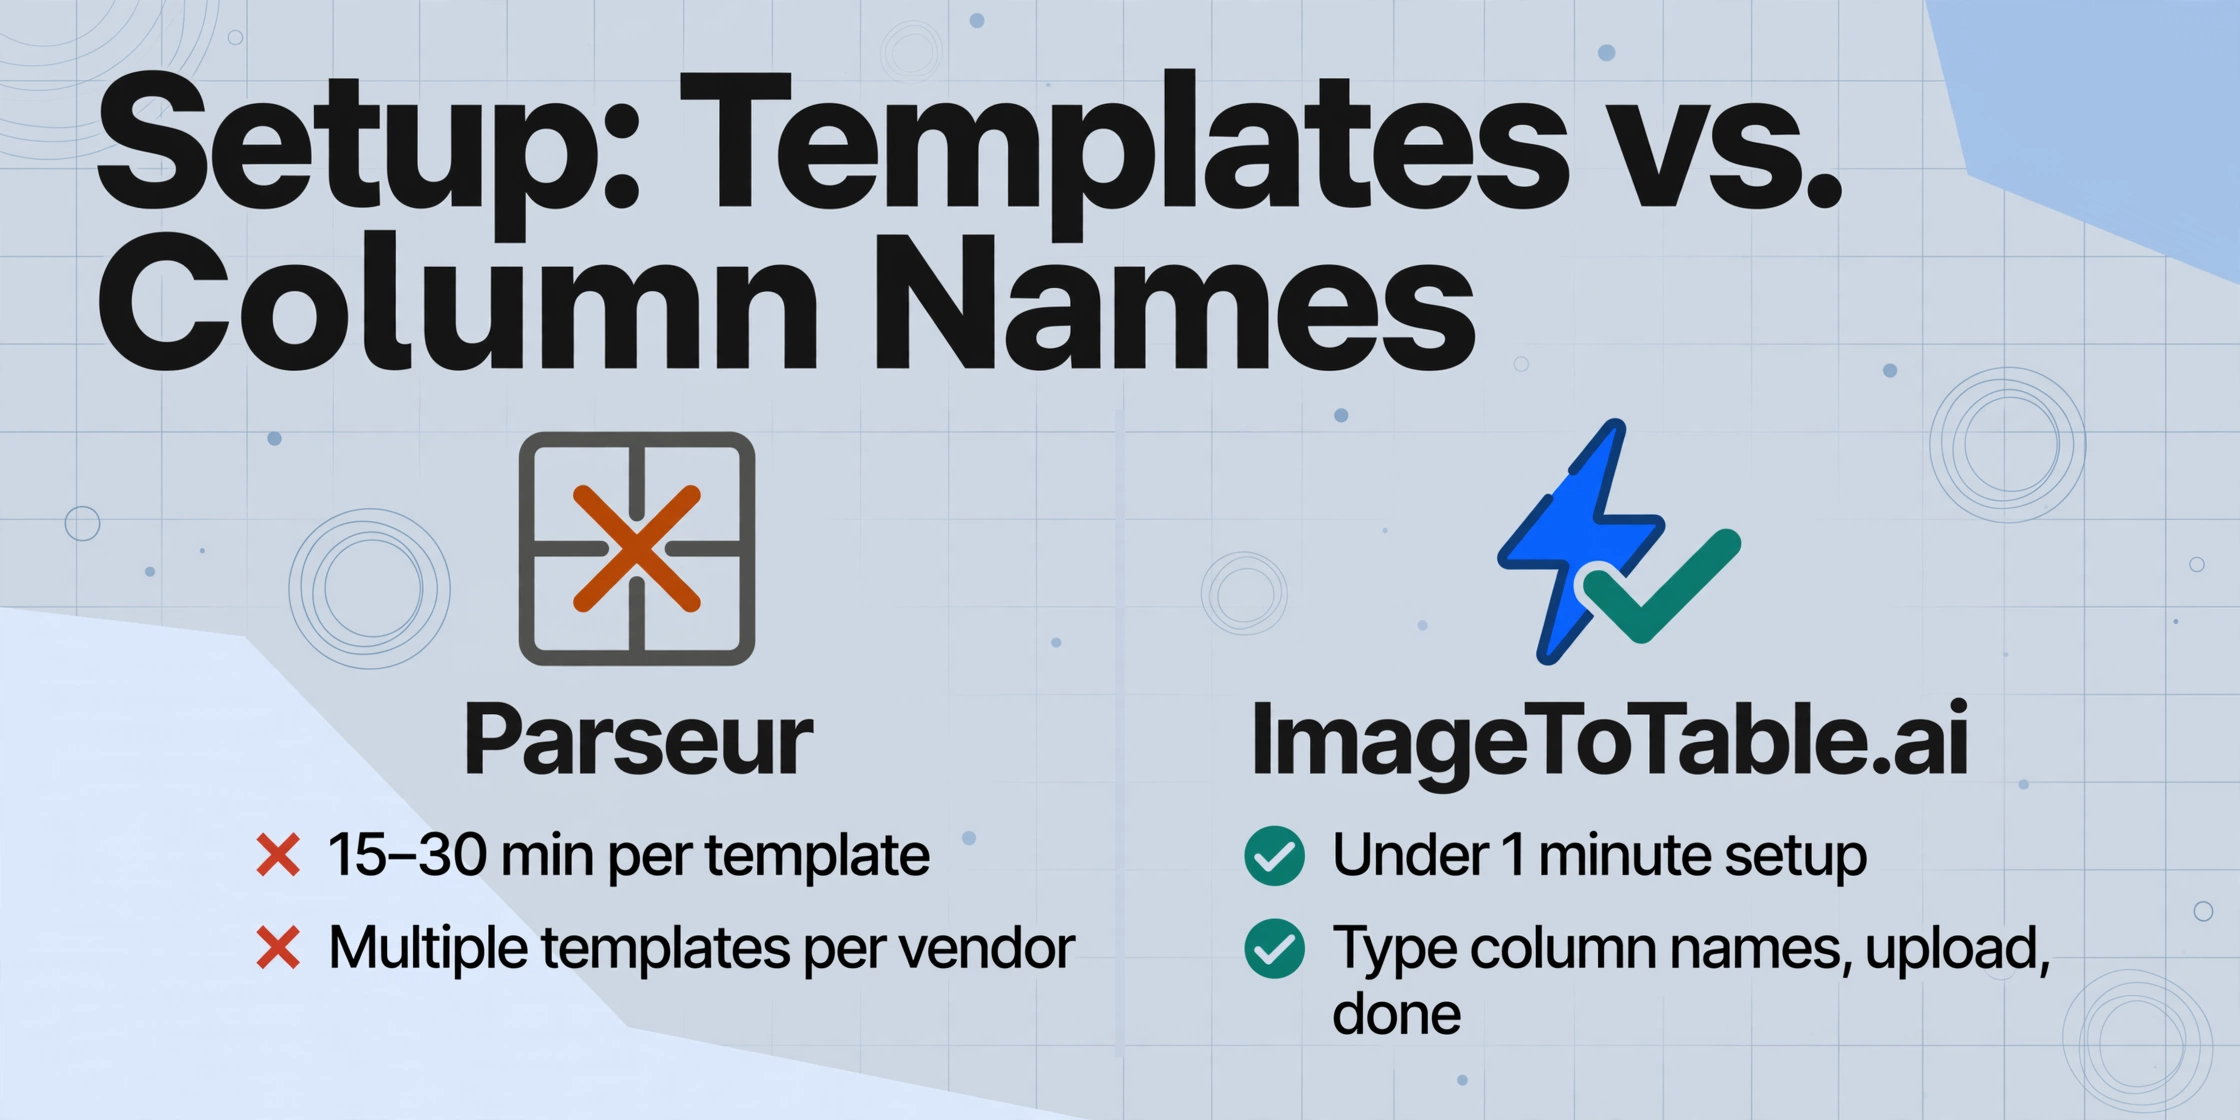
O Parseur organiza a extração em torno de "mailboxes" — cada mailbox é um canal dedicado de recebimento de documentos com sua própria configuração de análise. Na primeira vez que você processa um tipo de documento, o Parseur detecta automaticamente os campos no primeiro upload — um ponto de partida genuinamente útil. Mas para obter resultados confiáveis, você é orientado a criar um modelo: você destaca zonas em um documento de exemplo, define regras de extração de campos (OCR zonal para posições fixas, OCR dinâmico para campos que se movem em relação a um rótulo) e treina o sistema nesse layout. O primeiro modelo normalmente leva de 15 a 30 minutos para configurar, testar e refinar.
Se você recebe documentos de cinco fornecedores com formatos consistentes, isso representa de 75 a 150 minutos de configuração de modelos — um custo único que se paga se os formatos nunca mudarem. Mas se você processa documentos de trinta fornecedores, ou se suas fontes de documentos variam mensalmente, a configuração inicial se torna um investimento de tempo significativo antes de você ver qualquer retorno.
O ImageToTable inverte essa equação. Você não configura nenhum canal de recebimento — sem mailboxes, sem modelos, sem definições de campos. Você digita os nomes das colunas que deseja extrair ("Número da Fatura", "Nome do Fornecedor", "Data", "Total — sem impostos", "Itens de Linha") e envia seus documentos. O Vision LLM localiza esses valores entendendo o que cada campo significa semanticamente. Ele não procura texto em uma coordenada de pixel específica ou ao lado de um rótulo específico. Ele procura o conceito de "Número da Fatura" — onde quer que esteja, como quer que seja rotulado, em qualquer layout de documento que você enviar. Para usuários recorrentes, extração sem modelo significa que as listas de colunas podem ser salvas como predefinições, para que a mesma extração seja executada em todos os lotes futuros sem reinserir os nomes dos campos.
A diferença importa mais no primeiro mês. O Parseur exige tempo de configuração inicial antes que você veja resultados. O ImageToTable retorna sua primeira extração em menos de 10 segundos — você avalia a ferramenta com seus próprios documentos, não com um tutorial de configuração.
Como Lidar com Mudanças de Formato: O Custo Oculto da Manutenção de Modelos
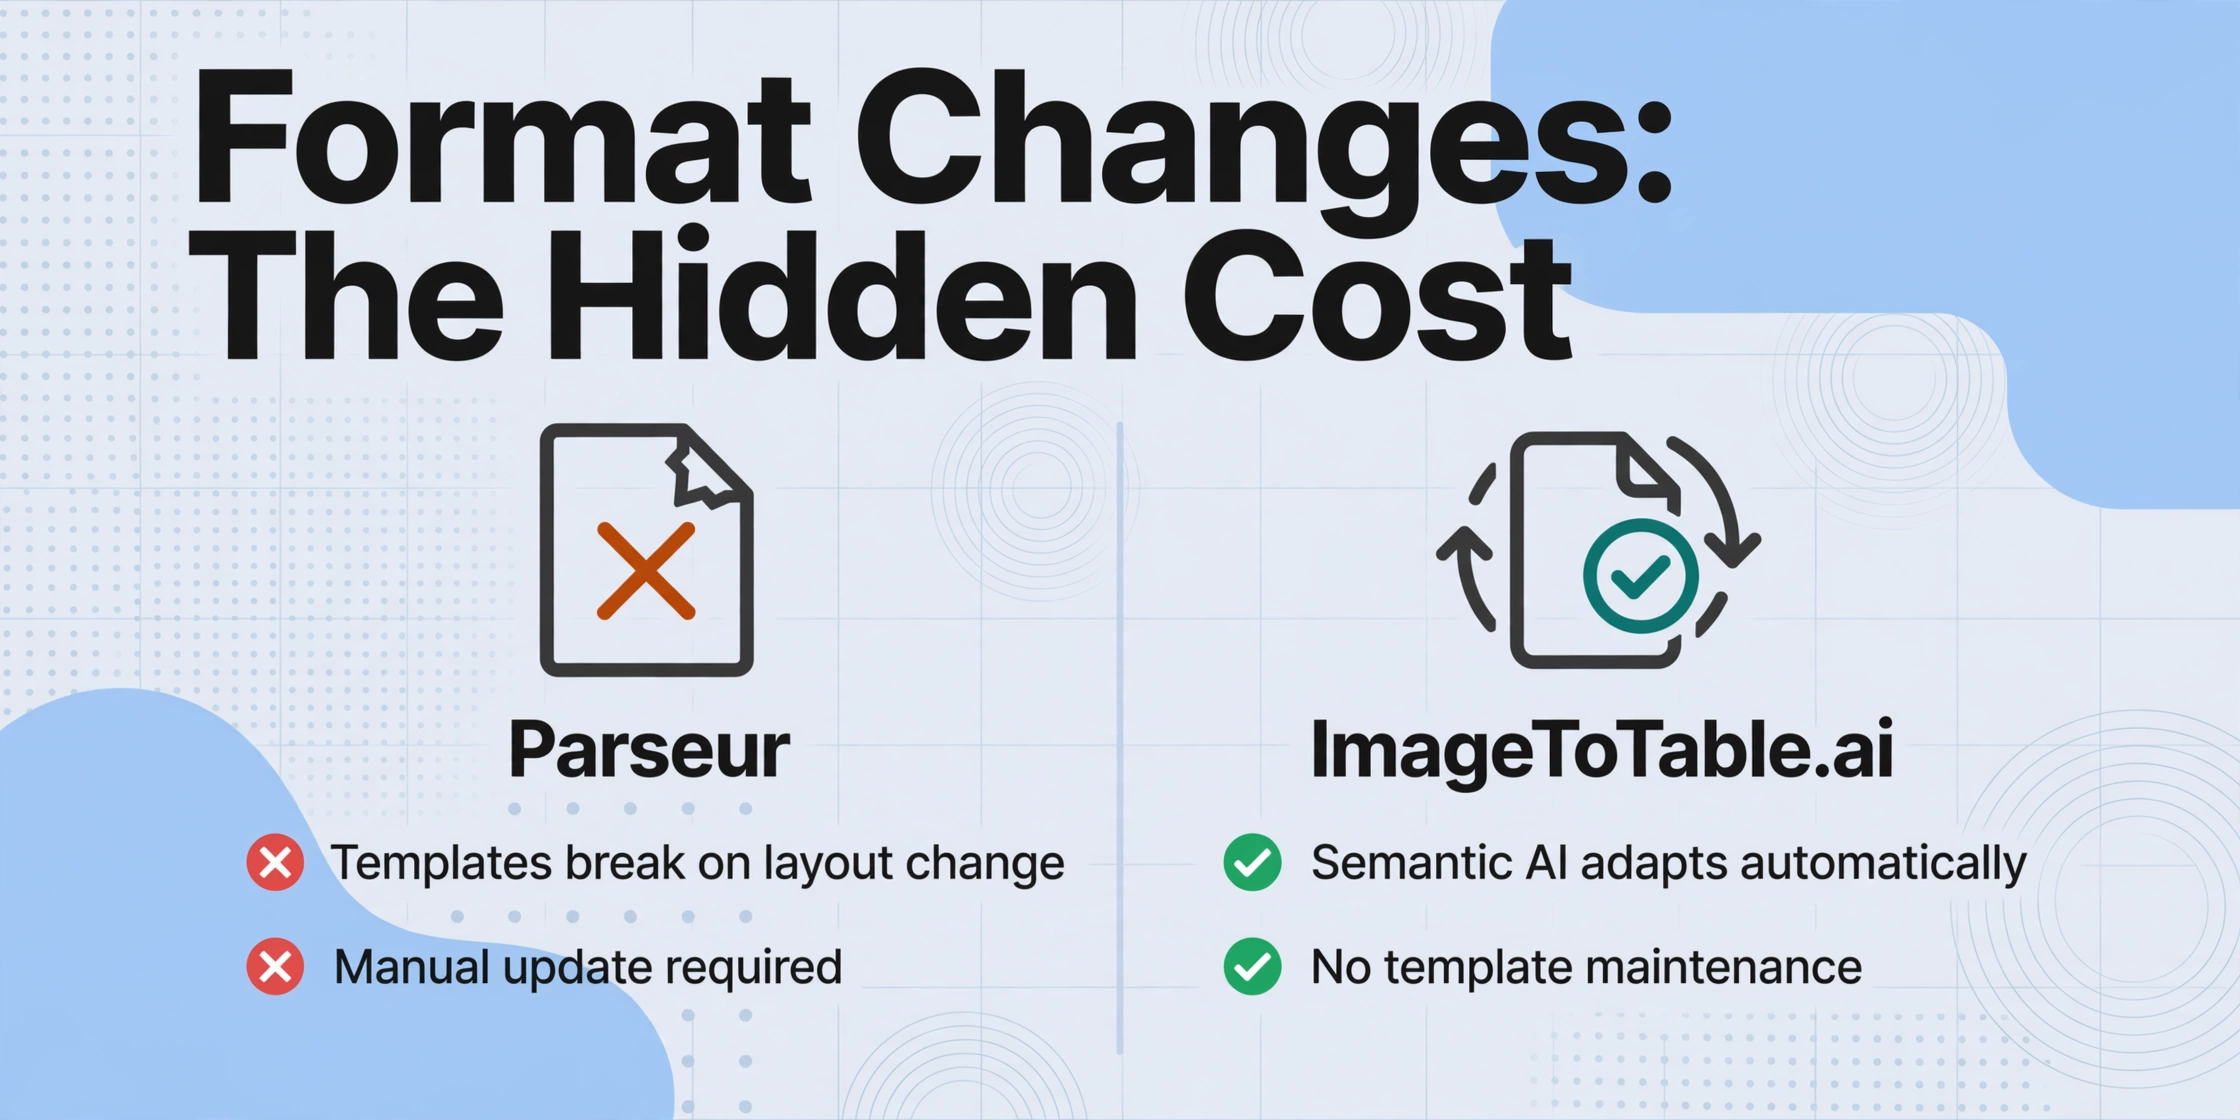
Esta é a dimensão que separa as duas ferramentas de forma mais acentuada, e também é a que a maioria dos artigos de comparação ignora. A extração baseada em modelos funciona perfeitamente — até deixar de funcionar. E no processamento real de documentos, mudanças de formato não são exceções; são a norma.
Fornecedores atualizam seus layouts de fatura quando trocam de software de contabilidade, se fundem com outra empresa, redesenham sua marca ou se adequam a novas regulamentações. Um fornecedor altera seu modelo de fatura — o campo "Total" muda do canto inferior direito para o canto inferior esquerdo. Um fornecedor adiciona uma nova linha de cabeçalho ao seu formato de pedido de compra. Um sistema de notificação por e-mail reformata seu modelo de HTML, deslocando os detalhes de confirmação do pedido para uma estrutura de tabela diferente. Cada mudança é invisível para você até o próximo lote de documentos chegar com erros de extração.
O motor de modelos do Parseur — que oferece os resultados mais consistentes em layouts conhecidos — quebra quando essas mudanças acontecem. As posições dos campos que você destacou no documento de exemplo não se alinham mais com os dados reais. A palavra-chave âncora que você usou para OCR dinâmico foi movida ou renomeada. O motor de IA do Parseur é mais flexível que seu motor de modelos — ele pode absorver alguma variação de layout sem quebrar — mas o motor de IA ainda funciona dentro de uma configuração de tipo de documento, não entre layouts arbitrários. Revisores do G2 confirmam isso: "Mudanças menores nos formatos de e-mail podem interromper a extração." Cada interrupção significa uma intervenção manual — abrir o editor de modelos, re-destacar o campo deslocado, re-testar, re-implantar.
O Vision LLM do ImageToTable não se importa onde um campo está na página. Ele lê o documento como um todo e localiza cada campo solicitado pelo significado. Um fornecedor move o "Total" do canto inferior direito para o canto inferior esquerdo — a IA ainda encontra "Total". Um fornecedor renomeia "Invoice #" para "Inv No" — a IA mapeia isso para sua coluna "Número da Fatura" porque entende a relação semântica. Um novo fornecedor envia um documento em um formato que você nunca viu antes — ele processa corretamente no primeiro upload, sem precisar criar um modelo. Este é o significado prático de extração de documentos sem modelo: a ferramenta se adapta à variação de formato automaticamente, sem o seu envolvimento.
O custo real da manutenção de modelos não é a configuração inicial — é o esforço contínuo e imprevisível de corrigir modelos toda vez que um formato muda em algum lugar da sua cadeia de suprimentos. Para equipes com remetentes estáveis e conhecidos, esse custo é baixo. Para todos os outros, transforma o que deveria ser automação em uma tarefa reativa de manutenção.
Email e Automação: A Vantagem Injusta do Parseur
Esta é a dimensão em que o Parseur vence — e precisamos ser diretos sobre isso. O Parseur foi construído do zero em torno do email como o principal canal de entrada de documentos. Você recebe um endereço de email dedicado para cada caixa de entrada. Encaminhe faturas recebidas, ordens de compra, notificações de envio ou qualquer anexo para esse endereço, e o Parseur os processa automaticamente, sem que ninguém precise abrir um navegador, enviar um arquivo ou clicar em um botão. O pipeline de extração é executado sem supervisão — os documentos chegam à sua caixa de entrada, os dados chegam à sua planilha, e ninguém precisa tocar no processo.
Para equipes cujo fluxo de trabalho de documentos é fundamentalmente baseado em email — departamentos de contas a pagar (AP) onde fornecedores enviam faturas para [email protected], equipes de logística onde transportadoras enviam PDFs de comprovante de entrega por email, operações de ecommerce onde confirmações de pedido chegam por email — a arquitetura email-first do Parseur elimina mais etapas do fluxo de trabalho do que qualquer abordagem sem modelo pode alcançar apenas com melhor extração. A diferença não está em como os dados são extraídos; está em como o documento chega ao motor de extração.
O Parseur também integra nativamente com Zapier, Make, Power Automate e n8n. Isso significa que os dados processados podem fluir automaticamente para centenas de destinos downstream — Google Sheets, Airtable, QuickBooks, Slack, Salesforce — sem exportação manual. Para equipes que investiram em plataformas de automação, essa profundidade de integração é um multiplicador genuíno de produtividade.
O ImageToTable agora também cobre a entrada de email sem supervisão. Cada conta recebe um endereço de caixa de entrada dedicado — compartilhe-o com fornecedores, ou encaminhe suas próprias faturas e recibos para ele, e os anexos chegam à sua fila de processamento automaticamente, sem necessidade de login ou página de upload. Ative o Auto-Process e vincule-o a um modelo de extração, e o processamento começa no momento em que o email chega — encaminhe o email e vá embora, da mesma forma que o pipeline do Parseur funciona.
A lacuna restante é a granularidade, não a automação. O Parseur dá a cada tipo de documento ou canal sua própria caixa de entrada e seu próprio endereço, cada um configurado separadamente. O ImageToTable dá a cada conta um único endereço de caixa de entrada, então emails mistos de fontes diferentes passam por um único modelo vinculado em vez de várias caixas de entrada configuradas independentemente. A Caixa de Entrada de Email pode ser configurada para ler anexos, o corpo do email em si, ou ambos — então um fornecedor que digita os números diretamente no texto da mensagem também funciona, não apenas arquivos encaminhados. Uma lista de remetentes permitidos mantém emails não relacionados fora da fila, e para anexos criptografados, como extratos bancários protegidos por senha, as senhas salvas são tentadas automaticamente antes que qualquer coisa chegue à sua tela de revisão.
Os documentos também chegam ao motor de extração por upload direto de arquivo na interface web ou na barra lateral do add-on do Google Sheets — mais duas rotas que não tocam em email.
Dito isso, o Link de Coleta preenche uma lacuna adjacente que a arquitetura de email do Parseur não cobre: coletar documentos de pessoas que não estão enviando-os por email. Funcionários de campo enviando fotos do local pelo celular, clientes enviando faturas por um portal, funcionários encaminhando fotos de recibos de uma viagem — o Link de Coleta aceita uploads de qualquer pessoa com o link, sem necessidade de registro. Não é automação de email, mas resolve um problema diferente de entrada que o encaminhamento de email não aborda.
Preços e Valor: Dois Modelos de Custo Diferentes
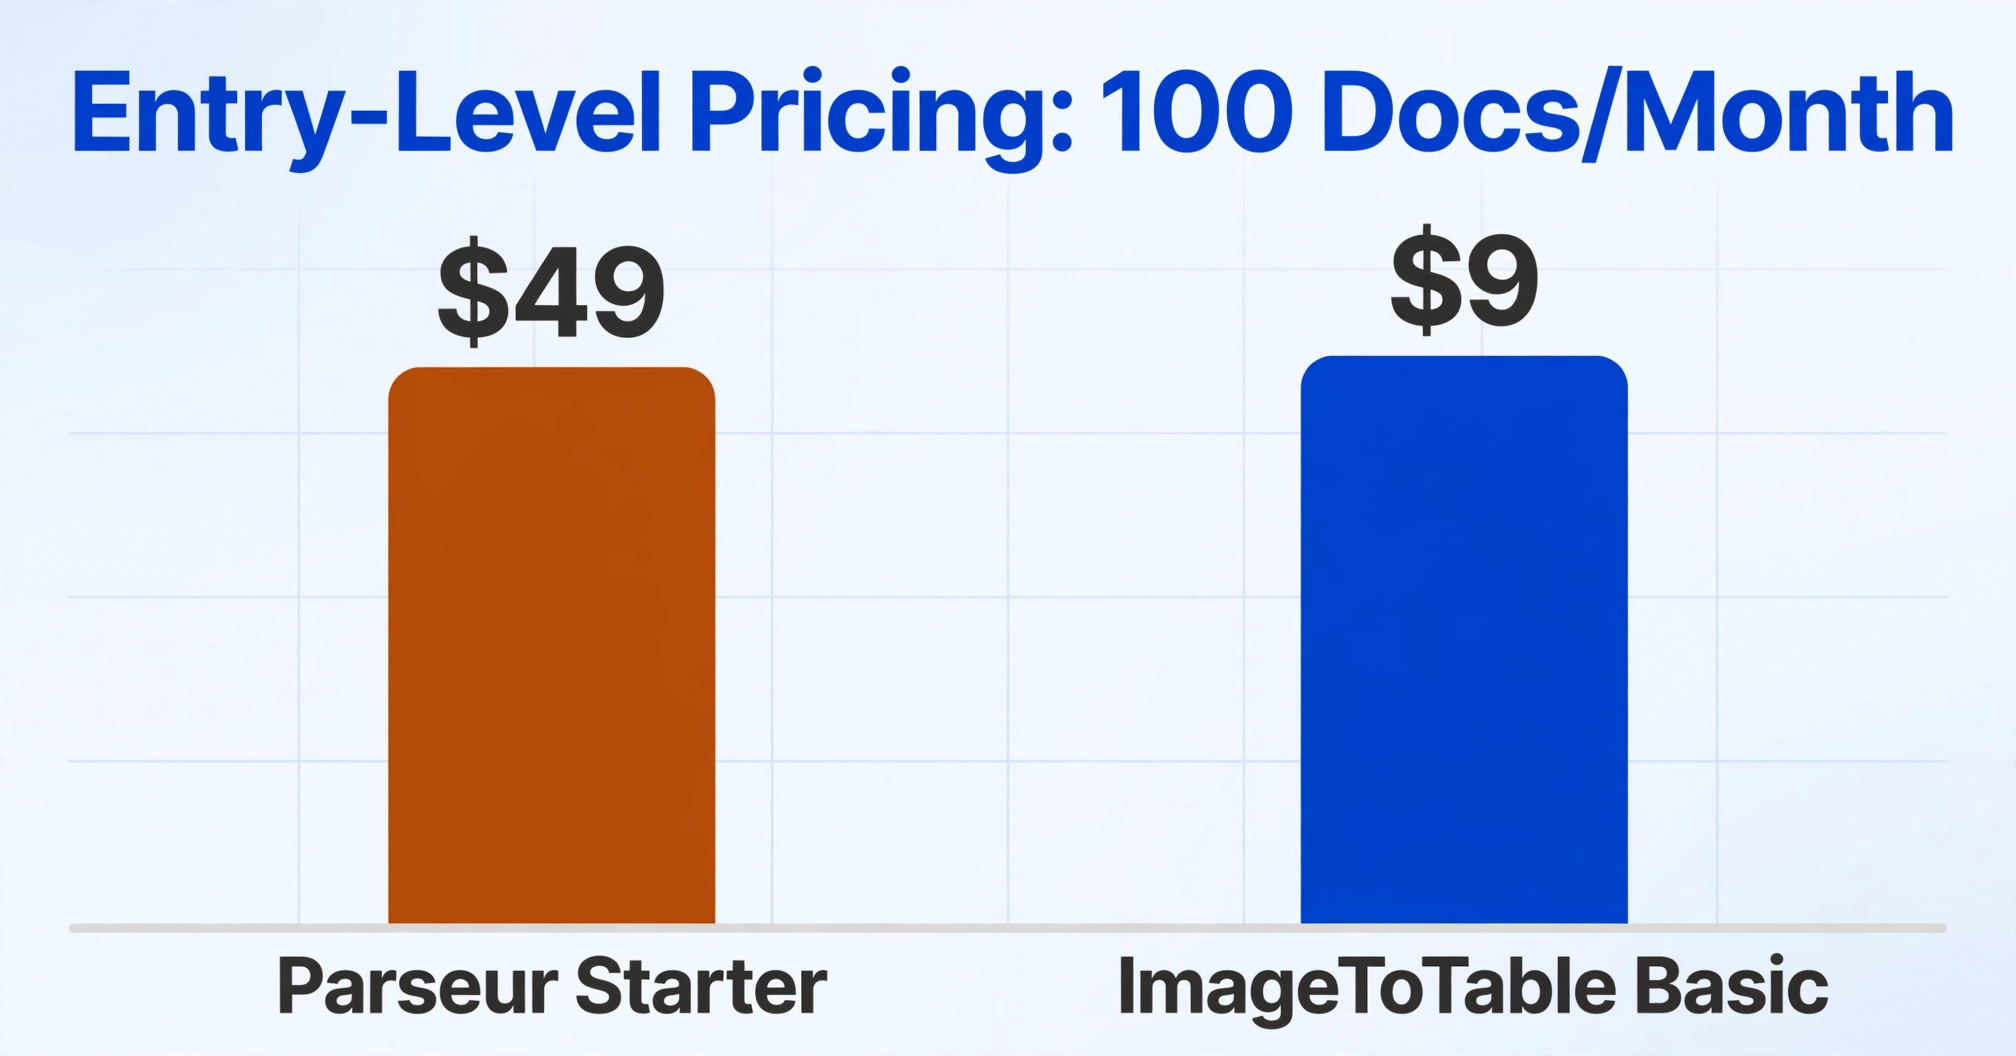
Os preços publicados da Parseur começam em US$ 39/mês (faturamento anual) ou US$ 49/mês (mensal) para o plano Starter com 100 páginas. Uma página equivale a um crédito — um PDF de 3 páginas consome 3 créditos. O plano gratuito oferece 20 páginas/mês com marcas d'água nos dados exportados. O plano Pro (US$ 99/mês) cobre 1.000 páginas, e o plano Scale (US$ 399/mês) cobre 10.000 páginas. Todos os planos incluem os mesmos recursos principais — o preço é puramente baseado em volume.
O ImageToTable usa um modelo de assinatura com limites de crédito: Basic a US$ 9/mês para 150 créditos, Pro a US$ 29/mês para 500 créditos, Max a US$ 59/mês para 1.500 créditos. Um crédito equivale a uma imagem ou uma página de PDF. Não há marca d'água em nenhum plano. Uma cota gratuita diária permite testar com documentos reais antes de pagar. Pacotes de crédito avulsos estão disponíveis sem assinatura.
No nível inicial, o plano Basic do ImageToTable (US$ 9/mês para 150 páginas) custa cerca de 80% menos que o plano Starter da Parseur (US$ 39–49/mês para 100 páginas) e oferece 50% mais volume. Em 1.000 páginas/mês, o plano Max do ImageToTable custa US$ 59/mês, comparado ao Pro da Parseur a US$ 99/mês — uma economia de 40% em volume equivalente. Para uma comparação detalhada de como diferentes modelos de preços afetam sua conta mensal, veja detalhamento de preços de extração de documentos 2026.
Há um cenário em que o preço da Parseur é mais favorável: volume muito alto com uma base fixa e previsível de remetentes. Se você processa exatamente 10.000 páginas todos os meses de fornecedores conhecidos onde os modelos funcionam de forma confiável, o custo por página da Parseur cai para cerca de 4 centavos por página no plano Scale (US$ 399/mês para 10.000 páginas). O preço do ImageToTable não é tão agressivo nesse nível de volume — a melhor opção seria o plano Growth a US$ 149 para até 3.000 créditos compartilhados em uma equipe, ou o plano Enterprise a US$ 899 para até 10.000 créditos compartilhados. Em escala empresarial real (100.000+ páginas), o modelo de desconto por volume da Parseur pode gerar um custo por página menor.
Mas para a faixa de volume onde a maioria das equipes opera — 100 a 3.000 documentos por mês — a assinatura fixa do ImageToTable entrega consistentemente mais volume por menos dinheiro, com a vantagem adicional de cobrança mensal previsível que não flutua com a complexidade dos documentos.
Tipos de Documentos & Precisão
Ambas as ferramentas cobrem os tipos de documentos comuns: faturas, recibos, ordens de compra, notas de entrega, contratos e formulários. Mas elas alcançam precisão por mecanismos diferentes, e a diferença importa dependendo de como seus documentos se parecem.
O mecanismo de template do Parseur é melhor em PDFs digitais limpos e conteúdo de e-mail estruturado, onde as posições dos campos são consistentes entre documentos do mesmo remetente. Uma vez que um template é criado e testado para um layout conhecido, a extração é determinística — os mesmos campos nas mesmas posições todas as vezes. O mecanismo de template também lida com extração de tabelas (itens de linha em faturas) através de um editor visual de tabelas, mas configurá-lo requer definir limites de linhas, separadores de colunas e margens de cabeçalho/rodapé. Para documentos de formato fixo de um conjunto estável de remetentes, essa abordagem oferece resultados confiáveis e repetíveis.
O mecanismo Vision AI do Parseur estende a cobertura para documentos digitalizados e imagens — ele pode lidar com caixas de seleção, carimbos e escrita à mão melhor do que o mecanismo de template sozinho. Mas é uma opção secundária, não o caminho principal de extração. O mecanismo de template continua sendo o método mais preciso do Parseur, e seus pontos fortes estão ligados à consistência de formato.
O LLM de visão do ImageToTable trata cada documento como um layout visual único. Impresso, digitalizado, foto de celular, captura de tela ou formulário manuscrito — a IA lê a semântica do documento diretamente, sem alternar mecanismos. Para dados de tabela impressos, a precisão chega a até 99% em documentos limpos. O modelo é particularmente forte em documentos que misturam conteúdo impresso e manuscrito — como formulários de inspeção onde rótulos pré-impressos são preenchidos à mão — porque entende a relação entre o rótulo e o valor, em vez de depender da extração baseada em posição.
Uma capacidade onde o ImageToTable não tem equivalente no Parseur são as Colunas Calculadas. Além de extrair o que está na página, você pode definir colunas onde a IA calcula durante a extração — "Total da Linha (Qtd × Preço Unitário)", "Total sem Impostos", "Categoria (opções: Refeições/Transporte/Escritório)" como uma classificação inferida. O Parseur extrai valores brutos; você realiza cálculos e classificações externamente. O ImageToTable os incorpora na etapa de extração, para que sua saída esteja pronta para uso sem pós-processamento.
Quando o ImageToTable faz mais sentido
Se os seus documentos chegam de vários fornecedores com layouts diferentes — e esses layouts mudam — a abordagem sem modelo do ImageToTable poupa você da manutenção contínua que as ferramentas baseadas em modelo criam. O modelo de extração semântica significa que você define a saída uma vez (os nomes das colunas que deseja) e a IA lida automaticamente com qualquer variação no layout de entrada.
Se você processa lotes de documentos juntos — enviando 50 faturas de uma vez e precisando mesclá-las em uma planilha alinhada — o processamento em lote prioritário do ImageToTable entrega isso em uma única etapa. O Parseur trata cada documento como um item individual em uma caixa de entrada; mesclar várias extrações em uma tabela unificada exige trabalho externo.
Se você precisa de valores calculados ou categorias inferidas durante a extração — não apenas valores brutos de campo — o Parseur não consegue igualar as colunas calculadas e colunas inferidas do ImageToTable. Você precisaria exportar os dados brutos do Parseur e processá-los em uma planilha ou script separado. O ImageToTable entrega dados prontos na extração.
Se o seu orçamento é limitado e você processa menos de 3.000 documentos por mês, os preços do ImageToTable oferecem 5× mais volume por dólar no nível inicial e 40% de economia no nível intermediário.
Quando o Parseur faz mais sentido
Se a sua captação abrange vários tipos de documentos ou fontes que precisam de configurações de análise próprias — um endereço para faturas, outro para notificações de envio, um terceiro para confirmações de pedido — o modelo por caixa de entrada do Parseur lida com isso nativamente, com um endereço e configuração separados para cada um. A caixa de entrada de e-mail do ImageToTable também opera sem intervenção quando o Auto-annotate está vinculado a um modelo — encaminhe o e-mail e vá embora, igual ao Parseur — mas é um endereço de caixa de entrada por conta, em vez de uma caixa por tipo de documento, então e-mails mistos passam por um único modelo vinculado, em vez de vários configurados de forma independente. Para equipes de contas a pagar (AP) cujos fornecedores enviam layouts de fatura realmente diferentes por endereços separados, ou operações logísticas e de e-commerce que lidam com vários tipos distintos de notificação, a separação por canal do Parseur é a configuração mais escalável.
Se o seu fluxo de trabalho depende de Zapier, Make ou Power Automate para rotear dados extraídos para sistemas downstream, a profundidade de integração nativa do Parseur é mais madura. O ImageToTable foca na exportação direta de arquivos; ele não tem o ecossistema de conectores de automação do Parseur.
Se os seus documentos vêm de um conjunto fixo e pequeno de remetentes conhecidos, com formatos estáveis e sem mudanças de layout, o motor de modelos do Parseur entrega extração determinística e confiável. O custo de configuração do modelo é um investimento único que se paga ao longo de meses de processamento consistente. Nesse cenário, a manutenção do modelo não é um fardo — é uma configuração única.
Se você processa volumes muito altos (10.000+ páginas por mês) de documentos previsíveis, o preço por página do Parseur em escala (a partir de US$ 0,03–0,04 por página) pode superar assinaturas fixas. Nesse volume, o Parseur também desbloqueia contas multiusuário (até 100 usuários no plano Scale) e pós-processamento em Python para lógica de negócios personalizada.
O veredito honesto: o Parseur vence para fluxos de trabalho acionados por e-mail, de alto volume e com formatos estáveis. O ImageToTable vence para equipes que lidam com variedade de layouts, processamento em lote, orçamentos limitados e a necessidade de saídas calculadas sem pós-processamento. As ferramentas resolvem o mesmo problema com arquiteturas diferentes, e nenhuma arquitetura é universalmente melhor.
O Veredito: Depende do Seu Ecossistema de Documentos
Após comparar ambas as ferramentas em tempo de configuração, resiliência de formato, automação de e-mail, preços, cobertura de documentos e capacidades de saída calculada, o quadro de decisão é mais claro do que a maioria dos artigos de comparação sugere.
O Parseur é feito para pipelines de documentos recebidos por e-mail — anexos recorrentes e previsíveis que chegam por e-mail e precisam ser extraídos sem intervenção humana. Seu motor de modelos recompensa equipes com remetentes estáveis por meio de precisão determinística. Suas limitações aparecem quando os formatos mudam, quando os documentos vêm de muitas fontes ou quando você precisa de saídas calculadas além dos valores brutos dos campos.
O ImageToTable é feito para processamento de documentos em lote com variabilidade de layout — equipes que enviam documentos em grupos, precisam de saídas mescladas e enfrentam formatos de documentos em constante mudança. Sua IA semântica elimina totalmente a manutenção de modelos, e sua própria Caixa de Entrada de E-mail agora também cobre a captura não supervisionada — embora o modelo de caixa de correio por canal do Parseur e a profundidade nativa de integração com Zapier/Make ainda vão mais longe para pipelines com muita automação.
Se o seu ecossistema de documentos é orientado por e-mail com remetentes estáveis, o Parseur é a escolha pragmática. Se o seu ecossistema é de formatos variados de múltiplas fontes, processados em lotes, o ImageToTable entrega mais valor com menos esforço contínuo. Se você está em algum lugar no meio — e a maioria das equipes está — a dimensão que deve inclinar a balança é a frequência de mudança de formato. Se seus fornecedores atualizam os layouts mais de uma vez por trimestre, a abordagem sem modelo economizará mais tempo ao longo de um ano do que qualquer ganho de automação de e-mail pode compensar.
Quer a versão resumida? Veja a tabela de comparação de recursos lado a lado ou navegue por todas as comparações do ImageToTable.
FAQ
O Parseur exige modelos, ou o motor de IA funciona sem eles?
O Parseur oferece tanto um motor de modelos quanto um motor de IA. O motor de modelos — que produz os resultados mais consistentes — exige a criação de um modelo visual para cada layout de documento, destacando as posições dos campos em um documento de exemplo. O motor de IA é mais flexível e pode lidar com variações de layout sem um modelo, mas ainda exige configuração do tipo de documento. Na prática, a maioria dos usuários do Parseur acaba dependendo de modelos para documentos recorrentes de remetentes conhecidos, porque o motor de modelos oferece maior precisão para layouts fixos. O ImageToTable usa IA semântica exclusivamente — sem modelos, sem seleção de motor, sem configuração de tipo de documento.
O ImageToTable consegue extrair automaticamente documentos recebidos por e-mail?
Sim. Toda conta recebe um endereço de caixa de entrada dedicado — compartilhe-o com fornecedores ou encaminhe suas próprias faturas e recibos para ele, e os anexos entram automaticamente na sua fila de processamento, sem necessidade de login ou página de upload. Ative o Auto-Process e vincule-o a um modelo de extração, e o processamento começa assim que o e-mail chega — o mesmo fluxo de encaminhar e esquecer que o Parseur oferece. Uma lista de remetentes permitidos mantém e-mails não relacionados fora, e senhas salvas são testadas automaticamente contra anexos criptografados, como extratos bancários protegidos por senha. A diferença está na granularidade: o Parseur dá a cada tipo de documento ou canal seu próprio e-mail e endereço com configuração independente, enquanto o ImageToTable dá a cada conta um endereço de caixa de entrada, então e-mails mistos passam por um único modelo vinculado. A Caixa de Entrada de E-mail pode ser configurada para ler anexos, o corpo do e-mail ou ambos.
Qual ferramenta é mais acessível para 100 documentos por mês?
O ImageToTable é significativamente mais acessível nesse volume. O plano Basic custa US$ 9/mês por 150 créditos — suficiente para cobrir 100 documentos de uma página com 50 créditos de sobra. O plano Starter do Parseur custa US$ 39/mês (anual) ou US$ 49/mês (mensal) para 100 páginas. O ImageToTable é cerca de 5× mais barato no nível inicial. Para uma comparação completa de preços em diferentes faixas de volume, veja detalhamento de preços de extração de documentos 2026.
O Parseur suporta processamento em lote como o ImageToTable?
O Parseur processa documentos como itens individuais dentro de uma caixa de entrada. Você pode enviar vários documentos para uma caixa de entrada e cada um é analisado de forma independente. Mas não há uma interface integrada de "mesclar 50 documentos em uma planilha alinhada". Os resultados ficam disponíveis por documento, e mesclá-los em uma única tabela exige saída de integração (sincronização com Google Sheets, Zapier) ou exportação manual. O ImageToTable foi projetado com processamento em lote prioritário: envie vários arquivos, defina os nomes das colunas uma vez e baixe um único arquivo Excel mesclado com cabeçalhos consistentes em todos os documentos.
O Parseur consegue calcular campos durante a extração como as colunas calculadas do ImageToTable?
Não como um recurso nativo de extração. O Parseur extrai valores brutos dos documentos. Cálculos, classificações ou transformações precisam ser tratados externamente — em uma planilha, via pós-processamento em Python (disponível nos planos Scale a partir de US$ 399/mês) ou por transformações no Zapier/Make. As colunas calculadas e colunas inferidas do ImageToTable realizam cálculos e classificações durante a etapa de extração, então a saída fica pronta para uso sem processamento adicional.
Posso migrar do Parseur para o ImageToTable?
Sim, e a migração não exige importação de modelos — porque o ImageToTable não usa modelos. Exporte seus dados históricos do Parseur como CSV ou Excel. Envie os mesmos documentos de origem para o ImageToTable, digite os nomes das colunas que correspondem às suas definições de campos do Parseur, e a IA os extrai sem qualquer configuração de modelo. Os nomes de colunas que você usou no Parseur (Número da Fatura, Fornecedor, Data, Total) se tornam seus nomes de colunas no ImageToTable. Mescle suas exportações históricas do Parseur com novas extrações do ImageToTable em uma planilha — nomes de cabeçalho consistentes facilitam a mesclagem.
Qual ferramenta é melhor para conformidade com a GDPR?
A Parseur tem uma postura mais forte de conformidade com a GDPR. A empresa tem sede em Singapura com fundadores europeus, e a conformidade com a GDPR foi incorporada à arquitetura desde o início, com infraestrutura hospedada na UE. A conformidade com SOC 2 Type II e HIPAA está em andamento. A ImageToTable criptografa os dados em trânsito (TLS) e em repouso, com exclusão automática configurável — suficiente para a maioria dos casos de uso de PMEs, mas sem documentação formal de certificação GDPR. Se a conformidade documentada com a GDPR e a residência de dados na UE forem um requisito rígido, a Parseur é a escolha mais segura.