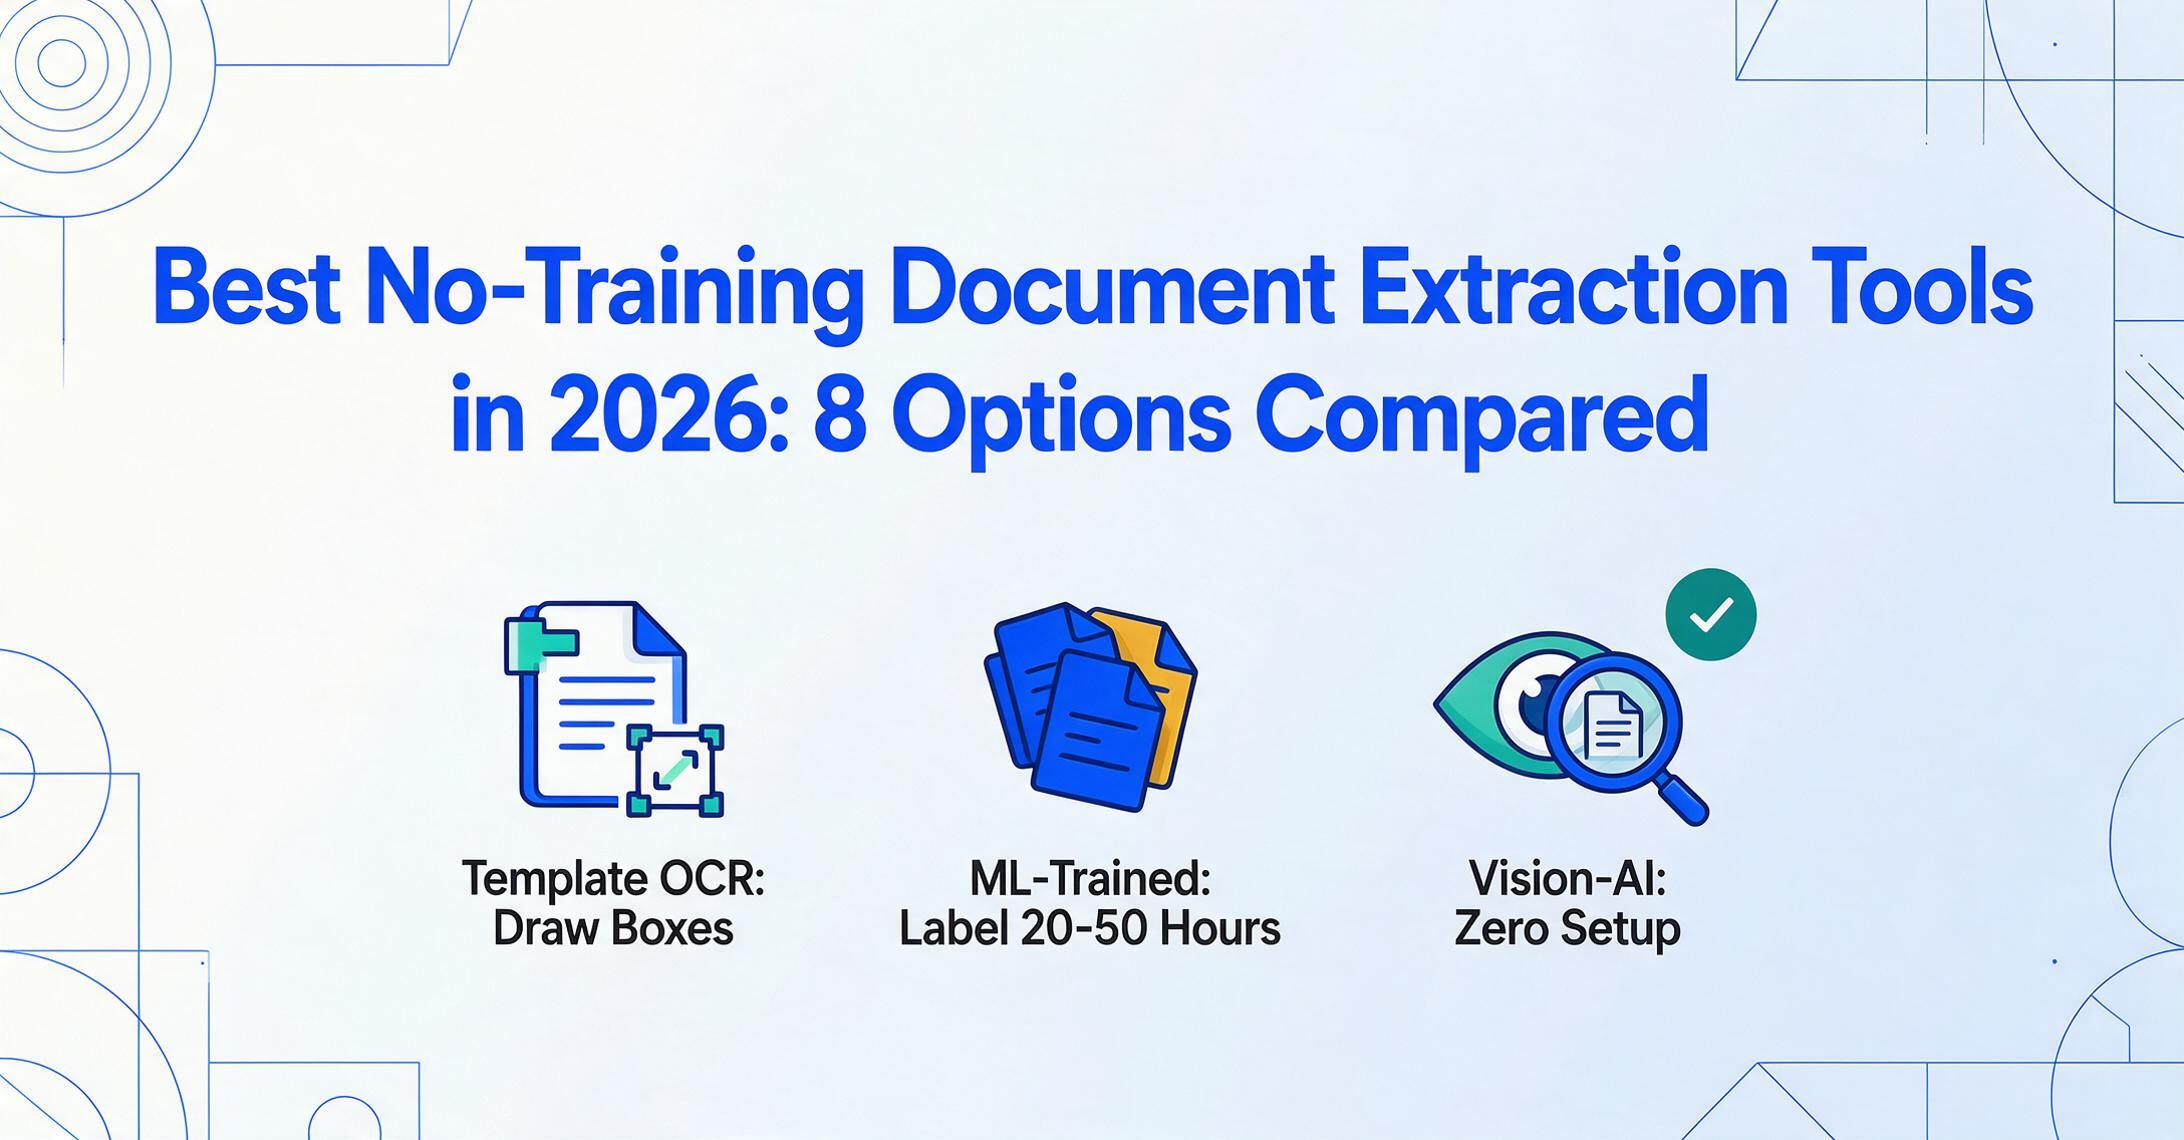
Melhores Ferramentas de Extração de Documentos
sem Treinamento em 2026: 8 Opções Comparadas
Testamos oito ferramentas de extração de documentos que afirmam ter capacidade de configuração zero — sem rotulagem de amostras, sem treinamento de modelo, sem configuração de modelo. Cada ferramenta recebeu os mesmos 30 documentos (faturas, recibos, pedidos de compra e extratos bancários em vários layouts) e foi solicitada a extrair o mesmo conjunto de campos no primeiro contato. Medimos a precisão que você obtém no primeiro dia — não depois de uma semana de configuração. Este artigo aborda o que "sem treinamento" realmente significa no nível arquitetural, quais ferramentas entregam isso honestamente e onde você ainda vai se pegar desenhando caixas ou rotulando amostras, apesar das promessas de marketing. Se você é novo no conceito de fundamentos da extração de documentos com IA, comece pelo guia principal — este artigo pressupõe que você conhece o básico.
Principais Conclusões
- Apenas 3 das 8 ferramentas "sem treinamento" retornaram dados estruturados no primeiro contato — as outras 5 pediram que desenhássemos caixas ou rotulássemos amostras antes de extrair qualquer coisa.
- A manutenção de modelos custa mais que a assinatura — um fornecedor muda o layout da fatura e você perde de 15 a 60 minutos consertando um modelo quebrado, toda vez.
- A questão não é qual ferramenta tem a melhor precisão — é se a ferramenta extrai dados de um layout que nunca viu sem você desenhar uma única caixa.
Divulgação: Este post inclui links de afiliados. O ImageToTable.ai é a ferramenta que criamos e vendemos. Todas as outras ferramentas desta lista são concorrentes genuínos. Testamos cada uma nos seus próprios termos e destacamos pontos fortes e limitações com honestidade. Você não vai encontrar "o ImageToTable.ai é o melhor em tudo" aqui — porque não é.
O que "Sem Treinamento" Realmente Significa
A expressão "sem treinamento" aparece na maioria das páginas de produtos de extração de documentos em 2026. Mas significa coisas muito diferentes dependendo da tecnologia por trás. Entender essas diferenças é como você evita comprar uma ferramenta que promete configuração zero mas pede que você desenhe caixas após o primeiro upload.
Existem três arquiteturas de extração distintas no mercado hoje:
| Arquitetura | Como Funciona | Configuração Necessária | Exemplos |
|---|---|---|---|
| OCR zonal / baseado em modelos | Você desenha caixas (zonas) em um documento de amostra nas coordenadas exatas de pixel onde cada campo aparece. A ferramenta extrai o que estiver dentro dessas coordenadas em documentos futuros com o mesmo layout. | Um modelo por layout de documento. A criação do modelo leva de 15 a 60 minutos por layout. Novo formato de fornecedor → novo modelo. | Docparser, Parseur (motor de modelos), ABBYY legado |
| Extração com ML treinado (few-shot) | Você envia de 20 a 200 documentos de amostra rotulados por tipo. O modelo aprende a reconhecer campos nos seus formatos específicos de documento. A precisão melhora com mais amostras e correções humanas. | 20 a 50 horas de rotulagem por tipo de documento. Ciclos iterativos de treinamento. Correções contínuas para melhorar a precisão. | Docsumo, Nanonets, Rossum |
| Extração semântica com Vision-AI (zero-shot) | Um modelo de visão-linguagem pré-treinado lê o documento como um humano faria — ele entende que "INV-2026-001" perto do topo da página provavelmente é um número de fatura, independentemente de onde esteja. Você define os campos que deseja por nome; o modelo os encontra por significado, não por coordenadas. | Zero. Envie um documento, digite os nomes dos campos, obtenha resultados. Funciona no primeiro contato com qualquer layout que o modelo tenha visto no pré-treinamento (o que cobre essencialmente todos os tipos comuns de documentos comerciais). | ImageToTable.ai, Airparser, Parseur (motor de IA) |
Esta é a distinção principal: ferramentas baseadas em modelos (OCR zonal) exigem configuração por layout. Ferramentas com ML treinado exigem rotulagem de amostras por tipo. Apenas ferramentas de Vision-AI zero-shot entregam o que "sem treinamento" realmente implica: envie um documento que você nunca viu antes e receba dados estruturados imediatamente. Essa mesma divisão tripla — IA sem modelo, baseada em modelos e IDP treinado/empresarial — é o eixo organizador da nossa comparação mais ampla de software de extração de dados para documentos não estruturados, caso você queira o campo mais amplo em vez de apenas o nível de configuração zero.
Várias ferramentas desta lista operam em mais de um modo. O Parseur, por exemplo, tem tanto um mecanismo de IA zero-shot quanto um mecanismo baseado em modelos. Se você obtém "sem treinamento" ou "requer modelos" depende do modo que você usa — e algumas ferramentas usam o modo baseado em modelos por padrão porque é mais barato para elas operarem. A IA consegue extrair dados sem treinamento? esse artigo responde em profundidade. A resposta curta: sim, mas apenas se a arquitetura for construída para isso.
Tabela de Comparação Rápida
| Ferramenta | Arquitetura | Zero-Setup de Verdade? | Preço Inicial | Melhor Para |
|---|---|---|---|---|
| ImageToTable.ai | Vision-AI zero-shot | ✅ Sim | $9/mês (150 docs) | Extração de colunas personalizadas, processamento em lote para Excel |
| Airparser | LLM zero-shot | ✅ Sim | Grátis (20 docs/mês), pago a partir de ~$20/mês | Análise rápida de e-mails + documentos, extração baseada em GPT |
| Parseur | IA zero-shot + modelo | ⚠️ Modo IA sim; modo modelo não | $39/mês (500 docs) | Ingestão de e-mails, entrada de documentos mistos |
| Docparser | OCR zonal + complemento de IA | ⚠️ Modo IA parcial; modo modelo não | $39/mês (teste de 14 dias) | PDFs com layout fixo, extração de códigos de barras |
| Docsumo | ML treinado (few-shot) | ⚠️ Tipos pré-treinados sim; tipos personalizados não | Enterprise (preço personalizado) | Alto volume, tipos de documentos conhecidos |
| Tesseract | OCR grátis (sem estrutura) | ⚠️ Sem treinamento, mas sem saída estruturada | Grátis (código aberto) | Extração de texto bruto, projetos de desenvolvedores |
| Tabula | Extrator de tabelas de PDF | ⚠️ Apenas tabelas, sem extração de campos | Grátis (código aberto) | Extrair tabelas de PDFs digitais limpos |
ImageToTable.ai
Arquitetura: Vision-AI zero-shot (sem modelo, sem treinamento)
O ImageToTable.ai é construído sobre um modelo de visão-linguagem que lê documentos por compreensão semântica em vez de correspondência de coordenadas. Você digita os nomes das colunas que deseja — "Invoice Number", "Date", "Total", "Vendor Name" ou qualquer campo personalizado — e a IA localiza esses valores em qualquer lugar da página, independentemente do layout. É isso que o produto chama de Extração de Colunas Personalizadas: você define a saída, e a IA cuida da entrada.
A promessa zero-shot se confirma na prática. Durante os testes, enviamos faturas de 15 fornecedores diferentes em formatos variados — paisagem, retrato, várias páginas, fotos digitalizadas — e a ferramenta retornou os campos solicitados em todas as primeiras tentativas. O único ponto de falha foi uma foto de qualidade extremamente baixa de um recibo térmico (resolução inferior a 300px), que o modelo de visão não conseguiu ler com clareza. O mesmo documento falhou em todas as ferramentas que testamos.
O que diferencia o ImageToTable.ai é sua abordagem de processamento prioritário em lote. Envie 30 faturas, especifique os nomes das colunas uma vez, e a ferramenta processa todas as 30 simultaneamente em um único arquivo Excel com um clique. Ela também oferece suporte a colunas calculadas — você pode definir uma coluna como "Line Total (Qty × Unit Price)" e a IA a calcula durante a extração, sem necessidade de pós-processamento. Para usuários que querem os resultados diretamente no Google Sheets, o complemento do Google Sheets adiciona os dados extraídos à planilha ativa sem sair da planilha.
Os arquivos são processados com segurança e não são armazenados.
Ideal para: Usuários que precisam definir suas próprias colunas de extração, processar vários documentos em lote e querem resultados entregues como uma tabela pronta para uso no Excel ou Google Sheets. O plano gratuito (sem necessidade de cadastro) permite testar com seus próprios documentos antes de se comprometer.
Não ideal para: Fluxos de trabalho de análise puramente de e-mails (o ImageToTable.ai é focado em upload, não em caixa de entrada de e-mail). Usuários que precisam de saída em formato Word devem usar o modo Para Word, que preserva o layout original — mas para extração de dados estruturados, o modo Para Tabela é o mais adequado.
Preço: A partir de $9/mês para 150 documentos. Plano gratuito disponível (sem necessidade de cartão de crédito).
Airparser
Arquitetura: LLM zero-shot (baseado em GPT, sem modelo)
O Airparser adota uma abordagem diferente para extração zero-shot: em vez de um modelo de visão dedicado, ele usa um LLM baseado em GPT para entender o conteúdo do documento. Você descreve os campos que deseja em linguagem simples — nome do campo, tipo, breve descrição — e a IA os extrai dos seus documentos. Sem modelos, sem conjuntos de dados de treinamento, sem rotulagem.
Essa abordagem funciona bem em documentos com muito texto e conteúdo de e-mail, onde a compreensão de linguagem do GPT se destaca. No nosso conjunto de testes, o Airparser processou faturas por e-mail e PDFs de pedidos de compra com precisão. Onde ele teve dificuldades foi em documentos com muitas tabelas e imagens digitalizadas com layouts complexos — o mecanismo baseado em GPT às vezes identificava incorretamente itens de linha ou inventava valores que não estavam presentes no documento.
O ponto forte do Airparser é seu fallback multi-mecanismo: ele tenta primeiro o LLM de texto, recorre ao LLM de visão para layouts complexos e usa OCR com IA para documentos digitalizados. Isso o torna mais resiliente do que uma ferramenta de mecanismo único. Mas o risco de alucinação — uma limitação conhecida da extração baseada em GPT — significa que você precisa de uma etapa de revisão humana para dados financeiros críticos.
Ideal para: Fluxos de trabalho de análise de e-mails, documentos com muito texto, usuários que querem a configuração mais rápida possível (descreva os campos, comece a extrair).
Não ideal para: Extração complexa de tabelas, recibos digitalizados com vários itens de linha ou fluxos de trabalho em que um valor alucinado possa causar erros financeiros reais sem uma camada de validação.
Preços: O plano gratuito inclui 20 documentos/mês. Os planos pagos começam em aproximadamente $20/mês.
Parseur
Arquitetura: Mecanismo de IA zero-shot + mecanismo de modelo (modo duplo)
O Parseur é uma das ferramentas mais nuançadas desta lista porque opera dois mecanismos fundamentalmente diferentes. Seu mecanismo de IA realmente funciona sem treinamento: você cria uma caixa de correio, envia documentos e a IA tenta identificar e extrair campos automaticamente. Seu mecanismo de modelo, por outro lado, exige a criação de um modelo por layout — desenhar caixas, definir âncoras, configurar regras — assim como as ferramentas de OCR zonal.
A mensagem de marketing é "nenhum treinamento de modelo necessário", o que é preciso para o mecanismo de IA. Mas a documentação do Parseur adverte que "o mecanismo de IA às vezes pode ter dificuldades com a precisão" e recomenda modelos para "extração confiável". Na prática, a maioria dos usuários sérios do Parseur acaba criando modelos para os tipos de documento que processam regularmente. Um artigo de ajuda do Parseur afirma explicitamente: "Os modelos oferecem uma maneira mais confiável e precisa de extrair dados, especialmente se você tiver documentos com layouts consistentes. Você precisará criar um modelo para cada layout."
Isso importa porque a criação de modelos no Parseur leva de 15 a 30 minutos por layout — melhor do que algumas alternativas, mas ainda é um investimento inicial significativo se você processa faturas de 50 fornecedores diferentes. A ferramenta detecta automaticamente qual modelo usar, mas você ainda precisa criar cada um.
O ponto ideal do Parseur é a ingestão de e-mails. Ele se conecta nativamente a caixas de entrada de e-mail, processa anexos e o conteúdo do corpo do e-mail juntos e encaminha os dados extraídos para o Google Sheets, Zapier ou webhooks personalizados. Se o seu fluxo de trabalho começa com faturas chegando em uma caixa de entrada de e-mail, o Parseur lida com esse pipeline melhor do que as ferramentas que priorizam o upload.
Ideal para: Fluxos de trabalho de documentos centrados em e-mail, canais de entrada mistos (e-mail + upload + API), usuários que querem a opção de criar modelos para formatos repetitivos de alto volume.
Não ideal para: Usuários que querem zero-shot puro sem qualquer configuração de modelo. O motor de IA funciona, mas a arquitetura do produto empurra você para modelos no uso em "produção".
Preços: A partir de $39/mês para 500 documentos. Plano gratuito disponível.
Docparser
Arquitetura: OCR zonal + complemento de IA opcional (DocparserAI)
O Docparser é a ferramenta mais consolidada desta lista e, sem dúvida, aquela cuja alegação de "sem treinamento" exige mais explicações. O motor de extração principal da ferramenta é o OCR zonal — você desenha caixas em um documento de amostra para definir onde cada campo fica na página, configura regras de análise usando palavras-chave âncora e torce para que o layout permaneça consistente. A própria documentação do Docparser chama isso de "treinar seu software" no sentido de OCR zonal: definir zonas uma vez, salvá-las como modelos e aplicá-las a documentos semelhantes.
Nos últimos meses, o Docparser introduziu o "DocparserAI", um complemento com IA que tenta a extração zero-shot. Em nossos testes, o modo de IA funcionou em faturas simples com layouts padrão, mas teve dificuldades em pedidos de compra e extratos bancários — tipos de documento em que os modelos de OCR zonal do Docparser são mais confiáveis. O complemento parece uma resposta ao mercado, e não uma reestruturação do produto.
O custo real do Docparser não é a assinatura de $39/mês — são as horas gastas mantendo modelos. Cada novo formato de fornecedor exige um novo conjunto de zonas. Cada mudança de layout de um fornecedor existente quebra seu modelo. Discussões no Reddit em r/automation e r/smallbusiness frequentemente descrevem a manutenção de modelos do Docparser como "a parte que ninguém avisa". Um usuário descreveu sua rotina semanal como "verificar qual fornecedor mudou o layout da fatura esta semana e corrigir o modelo".
Melhor para: Documentos previsíveis e com layout fixo de um pequeno número de fornecedores. Usuários que precisam de extração de código de barras/QR code. Equipes que têm tempo dedicado à manutenção de modelos.
Não ideal para: Tipos de documento mistos, layouts variáveis ou qualquer fluxo de trabalho em que você não pode gastar 15–30 minutos por formato de fornecedor mantendo modelos.
Preços: A partir de $39/mês. Teste gratuito de 14 dias (sem cartão de crédito).
Docsumo
Arquitetura: Extração com ML treinado (few-shot) com modelos pré-treinados
O Docsumo é uma plataforma de processamento inteligente de documentos que se posiciona firmemente na categoria de ML treinado. Ele oferece mais de 30 modelos pré-treinados para tipos comuns de documentos, como faturas, pedidos de compra e extratos bancários — e, para esses tipos de documentos, funciona de verdade sem treinamento. Você envia um documento e o modelo pré-treinado extrai os campos relevantes.
O problema está no que acontece quando seus documentos ficam fora desses mais de 30 tipos pré-treinados. O próprio post do blog do Docsumo sobre "The Best Template-Free Data Extraction Software" é honesto quanto a isso: "This is not a zero-setup solution. If you need to extract from a truly exotic document type, you'll invest 10–20 hours labeling samples." O post observa ainda que "few-shot platforms demand 20–50 hours of upfront label work, but exceptions drop to 5–10% of documents."
Para faturas padrão de fornecedores conhecidos na América do Norte, os modelos pré-treinados do Docsumo têm bom desempenho. Para formulários de construção específicos, documentos médicos regionais ou romaneios de fornecedores específicos, você precisará rotular amostras e treinar um modelo personalizado. O ponto forte da plataforma é o volume: se você processa 100.000 faturas por ano de mais de 50 fornecedores, o investimento inicial em rotulagem compensa em estabilidade operacional. Mas se você precisa extrair dados de 30 tipos diferentes de documentos hoje à tarde, o Docsumo não é a ferramenta certa.
Ideal para: Equipes de médio porte e empresas processando grandes volumes de tipos de documentos conhecidos. Equipes com mais de 50 fornecedores que podem investir em rotulagem inicial para estabilidade de longo prazo.
Não ideal para: Extração pontual de tipos diversos de documentos. Equipes pequenas ou freelancers que não podem justificar de 20 a 50 horas de rotulagem antes de ver resultados.
Preços: Preços para empresas (orçamento personalizado). Nenhum plano autoatendido disponível.
Opções Gratuitas e de Código Aberto
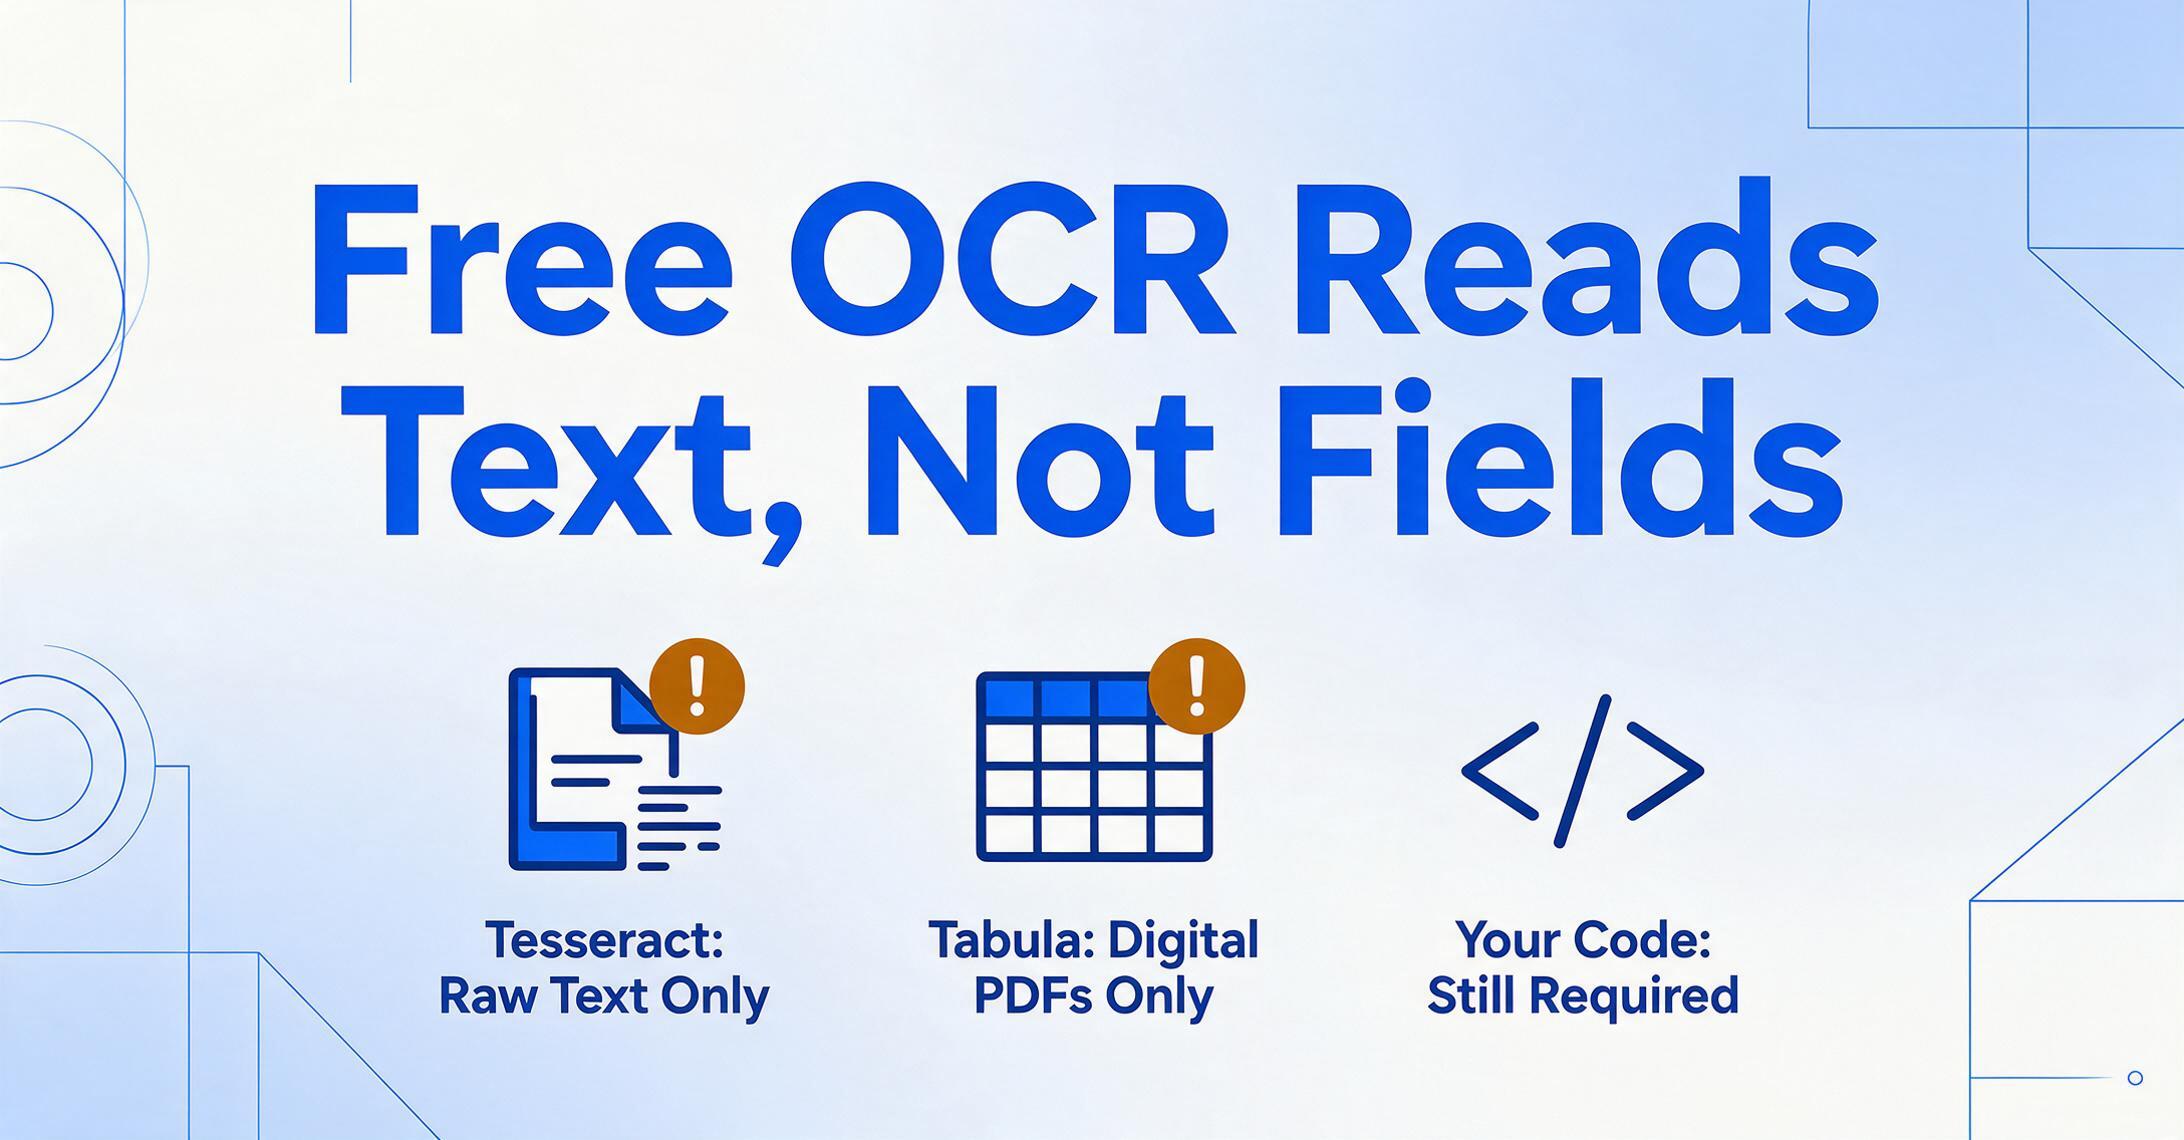
Nenhuma lista de ferramentas sem treinamento está completa sem reconhecer as opções gratuitas — mas elas vêm com ressalvas importantes sobre o que "sem treinamento" significa no contexto de código aberto.
Tesseract OCR
O Tesseract é o mecanismo de OCR de código aberto mais amplamente utilizado. Ele não exige treinamento no sentido de ML — você o instala e ele lê texto imediatamente. A limitação é que o Tesseract gera texto bruto sem nenhum entendimento da estrutura do documento. Ele não consegue dizer qual texto é o número da fatura, a data ou a descrição do item. Você precisa criar lógica de pós-processamento (expressões regulares, mapeamento de coordenadas, código personalizado) para transformar a saída do Tesseract em dados estruturados. Ir do texto bruto do OCR até uma planilha utilizável normalmente exige várias horas de trabalho de desenvolvimento por tipo de documento.
Ideal para: Desenvolvedores que querem criar um pipeline de extração personalizado e têm o tempo de engenharia para mantê-lo.
Não ideal para: Qualquer pessoa que queira dados estruturados prontos para uso sem escrever código.
Tabula
O Tabula é uma ferramenta gratuita e de código aberto que extrai tabelas de PDFs digitais. Você arrasta uma caixa ao redor da tabela em uma página do PDF, e o Tabula gera os dados como CSV. Ele funciona bem em PDFs digitais limpos, com bordas de tabela claramente definidas. Ele não funciona em PDFs digitalizados ou documentos baseados em imagem, e não consegue extrair campos de chave-valor (como número da fatura ou nome do fornecedor) — apenas dados tabulares.
Ideal para: Extração ocasional de tabelas de PDFs digitais quando você precisa de uma exportação rápida em CSV.
Não ideal para: Documentos digitalizados, extração de campos de fatura ou qualquer tipo de processamento em lote automatizado.
OCR.space
O OCR.space oferece uma API de OCR gratuita sem necessidade de cadastro. Ele converte imagens em texto, mas, assim como o Tesseract, gera texto não estruturado em vez de dados em nível de campo. O plano gratuito tem limites de uso (1 solicitação a cada 10 segundos, até 25.000 solicitações por mês), e a precisão é sólida em texto impresso. Para extração estruturada de campos, você precisaria criar uma análise adicional sobre a saída do OCR.
Ideal para: Extração rápida de texto de imagens, API de OCR para desenvolvedores que criam pipelines personalizados.
Não ideal para: Extração de dados estruturados, processamento em lote ou usuários não técnicos que querem uma planilha sem configuração.
Qual ferramenta se adapta ao seu fluxo de trabalho?
Toda ferramenta desta lista consegue extrair dados de documentos. A questão é quanto tempo de configuração você está disposto a investir antes de ver resultados — e se essa configuração é um investimento único ou uma obrigação de manutenção contínua.
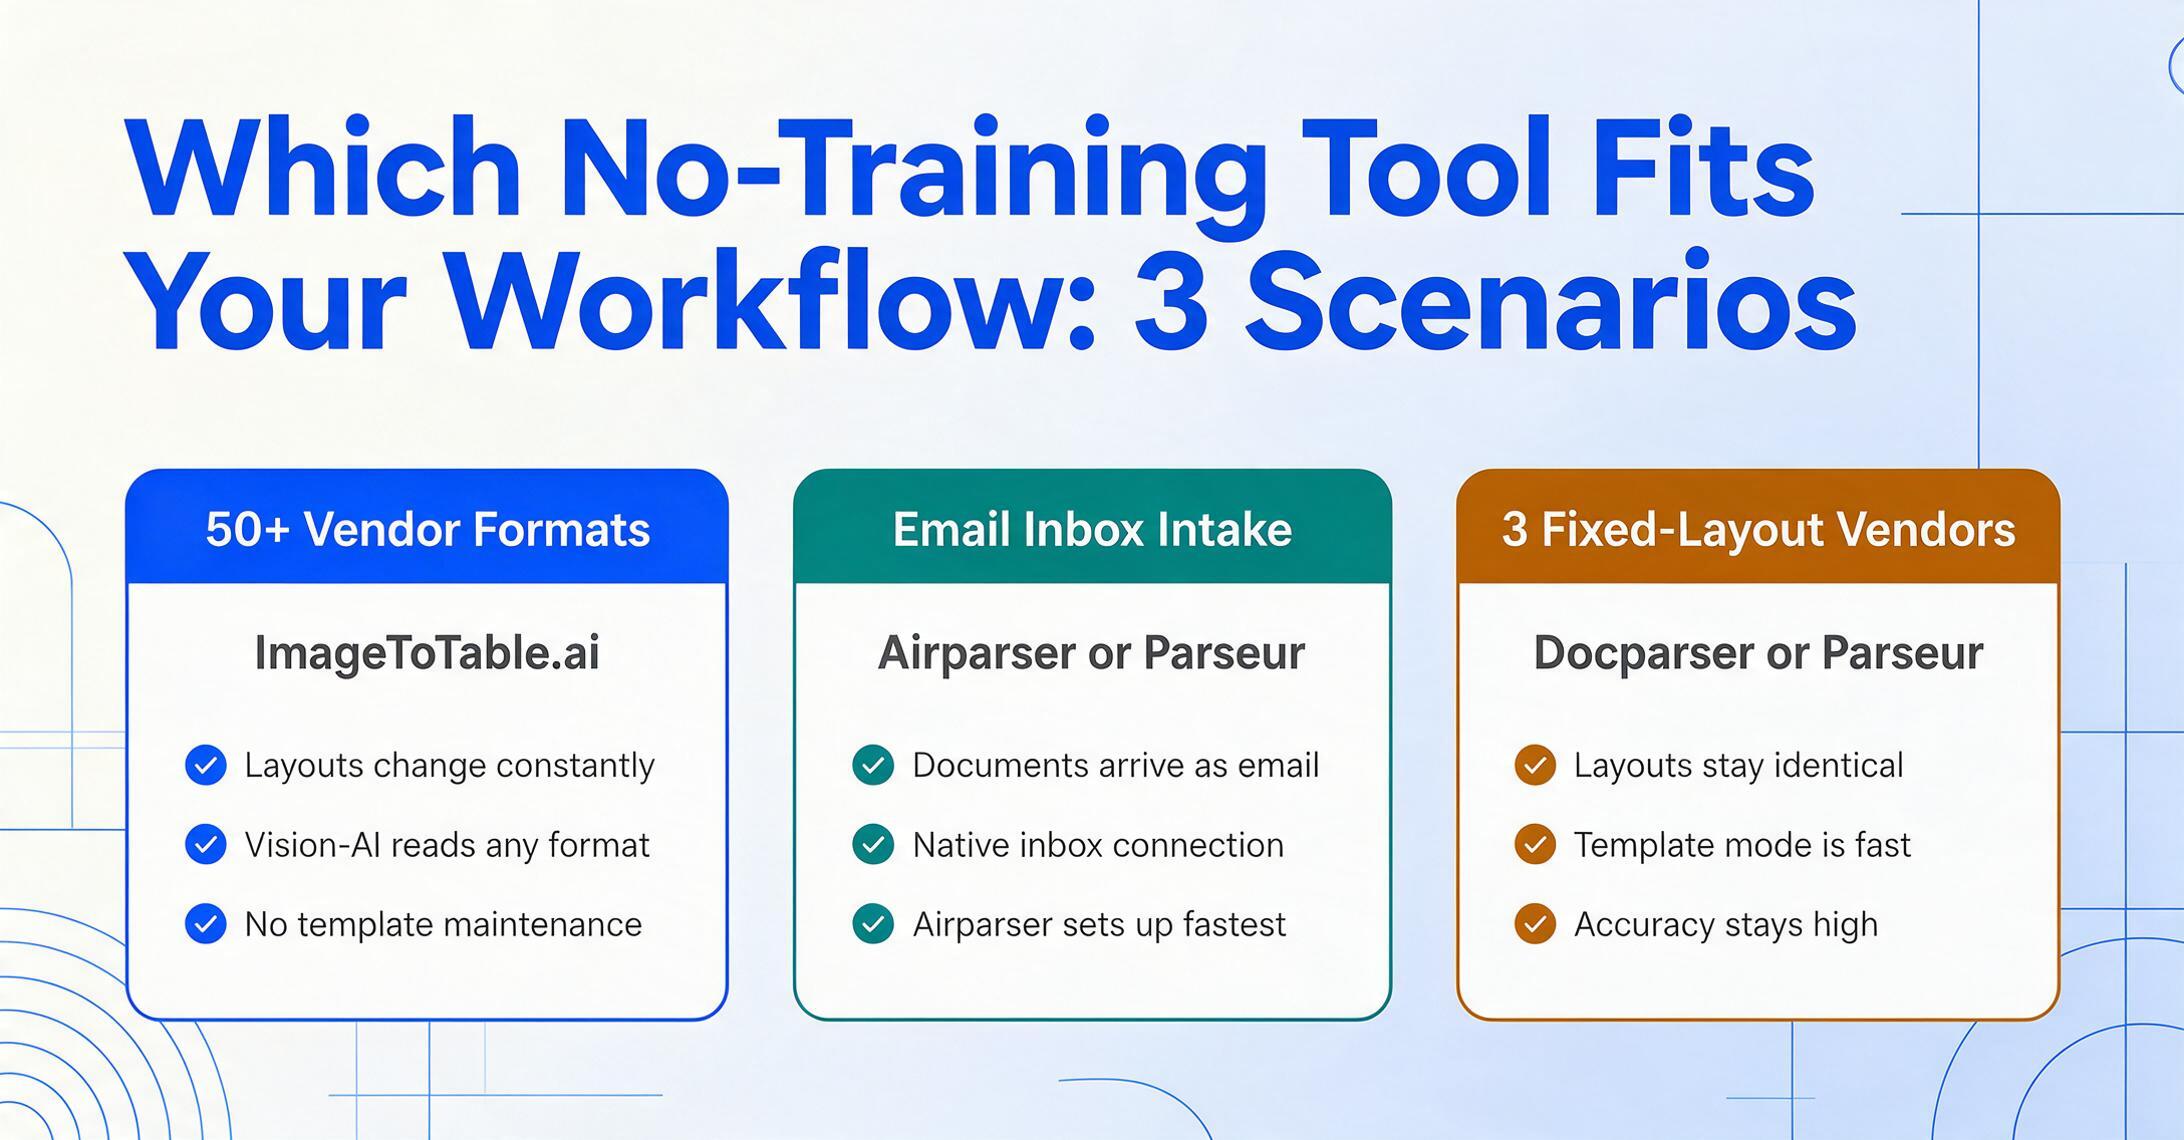
| Seu cenário | Ferramenta recomendada | Por quê |
|---|---|---|
| Você processa faturas de mais de 50 fornecedores — os layouts mudam constantemente | ImageToTable.ai | A Vision-AI zero-shot lida com qualquer layout. Sem manutenção de modelos. |
| Seus documentos chegam por e-mail (faturas, pedidos de compra, avisos de envio) | Airparser ou Parseur | Ingestão nativa de e-mail. Airparser para configuração mais rápida; Parseur para opção com modelo. |
| Você precisa de dados estruturados no Google Sheets sem sair da planilha | ImageToTable.ai (complemento para Sheets) | Complemento nativo do Google Sheets para extração diretamente na planilha. |
| Você tem 3 fornecedores regulares com layouts idênticos todas as vezes | Docparser ou Parseur (modo modelo) | A extração baseada em modelos é rápida e precisa quando os layouts nunca mudam. |
| Você processa 10.000 faturas/mês de fornecedores conhecidos | Docsumo | Modelos pré-treinados + treinamento de modelo personalizado para seus fornecedores. O volume justifica o investimento. |
| Você é um desenvolvedor criando um pipeline de extração personalizado | Tesseract + código personalizado, ou API do OCR.space | Gratuito, flexível, configurável. Exige esforço de engenharia para produzir saída estruturada. |
| Você precisa de uma tabela pontual de um PDF | Tabula | Gratuito, sem conta, extração de tabela por arrastar e soltar. |
Se você ainda estiver em dúvida, comece com uma ferramenta que ofereça um teste genuinamente gratuito ou de baixo compromisso — e faça o mesmo teste que fizemos. Pegue um documento com um layout bagunçado, um com o qual sua ferramenta atual tem dificuldade. Faça o upload sem nenhuma configuração prévia. Se a ferramenta retornar dados estruturados precisos na primeira tentativa, a alegação de "sem treinamento" se sustenta. Se ela pedir para você criar um modelo ou rotular amostras antes de conseguir extrair, a alegação não se sustenta — independentemente do que a página de marketing diga.
Também temos um guia separado sobre extração sem modelos que se aprofunda mais na própria tecnologia, e uma comparação de ferramentas de documentos para freelancers se você trabalha sozinho.
Perguntas frequentes
O que significa "extração zero-shot"?
Extração zero-shot significa que a IA consegue extrair dados de um tipo de documento que nunca viu antes, sem nenhuma amostra de treinamento ou configuração de modelo. O modelo se baseia no conhecimento pré-treinado sobre como os documentos se parecem e o que os nomes dos campos significam. Isso é diferente da extração few-shot (que usa de 5 a 200 amostras rotuladas) e da extração baseada em modelos (que usa zonas definidas por coordenadas).
A IA realmente consegue extrair dados sem nenhum treinamento?
Sim — mas apenas ferramentas construídas sobre arquiteturas de Vision-AI ou LLM que foram pré-treinadas em milhões de documentos. Esses modelos já entendem como uma fatura, um recibo ou um pedido de compra se parecem. Você não precisa ensiná-los. Ferramentas que dependem de OCR zonal ou aprendizado de máquina clássico exigem modelos ou amostras rotuladas porque foram projetadas antes de os modelos de visão pré-treinados existirem. Veja nosso artigo dedicado: A IA consegue extrair dados sem treinamento?
Qual é a diferença entre "sem treinamento" e "sem modelo"?
"Sem treinamento" significa que a IA não precisa de documentos de amostra para aprender seu formato específico. "Sem modelo" significa que ela não precisa de definições de zonas baseadas em coordenadas. Para um mergulho mais profundo sobre o que a extração sem modelo significa especificamente, veja nosso artigo sobre se a IA consegue extrair dados sem modelos. Algumas ferramentas oferecem um, mas não o outro. O mecanismo de IA do Parseur, por exemplo, não exige amostras de treinamento, mas ainda oferece modelos para "maior precisão". As ferramentas mais genuinamente sem configuração oferecem ambos: nenhuma amostra de treinamento e nenhuma configuração de modelo.
O Docparser realmente funciona sem treinamento?
O mecanismo principal do Docparser é o OCR zonal, que exige desenhar zonas de extração em cada layout de documento — isso é configuração de modelo, não zero-shot. O Docparser adicionou recentemente o "DocparserAI" para extração com IA, mas é um complemento ao produto principal. Para o modo OCR zonal, a afirmação de "sem treinamento" é enganosa: criar zonas e regras é exatamente o tipo de configuração que a maioria dos usuários quer evitar. O modo de IA mais recente oferece extração zero-shot em documentos simples, com precisão mais limitada do que ferramentas dedicadas de Vision-AI.
A precisão é menor sem treinamento?
Em tipos de documentos padrão (faturas, recibos, pedidos de compra, extratos bancários), a precisão zero-shot costuma ser de 90–98% para campos impressos claramente visíveis — comparável a ferramentas baseadas em modelos após a criação do modelo. Em formatos de documentos altamente especializados ou incomuns, a precisão zero-shot pode ser menor do que a de um modelo treinado sob medida para aquele formato exato. Esse é o trade-off: você troca a precisão máxima em um formato específico pela usabilidade imediata em todos os formatos. Para a maioria das equipes de pequeno e médio porte, a vantagem da amplitude supera a diferença marginal de precisão.
Existem ferramentas gratuitas de extração de documentos sem treinamento?
Ferramentas gratuitas como Tesseract e OCR.space extraem texto sem treinamento, mas não produzem dados estruturados (extração em nível de campo). Você obtém texto bruto e precisa escrever código para transformá-lo em campos. O Tabula extrai tabelas de PDFs digitais gratuitamente, mas só lida com tabelas, não com campos de chave-valor. Para extração estruturada genuinamente gratuita e sem treinamento, algumas ferramentas SaaS oferecem planos gratuitos — o Airparser oferece 20 documentos/mês grátis, e o ImageToTable.ai oferece uma demonstração sem cadastro.
Qual é mais rápido de configurar: Parseur ou Airparser?
O Airparser é mais rápido para documentos pontuais — você descreve os campos em inglês simples e obtém os resultados. O mecanismo de IA do Parseur é igualmente rápido, mas sua documentação do produto direciona os usuários para modelos no uso em produção. Para uma extração única de alguns documentos, ambos levam menos de 10 minutos. Para processamento contínuo de diversos tipos de documentos, a abordagem de LLM do Airparser exige menos manutenção. Para processar layouts conhecidos em alto volume, os modelos do Parseur (depois de criados) são mais confiáveis.
Quanto tempo os modelos realmente custam?
Com base em nossos testes e relatos de usuários do Reddit e avaliações no G2, cada modelo normalmente leva de 15 a 60 minutos para ser criado e testado. Para uma empresa que processa faturas de 50 fornecedores com layouts diferentes, isso representa de 12 a 50 horas de trabalho inicial com modelos. Toda vez que um fornecedor altera o layout, adicione mais 15 a 60 minutos para corrigir o modelo quebrado. Esse custo recorrente é uma das desvantagens menos divulgadas das ferramentas baseadas em modelos — a página de marketing mostra a extração bem-sucedida, não a hora gasta todo mês corrigindo modelos.
Ferramentas zero-shot alucinam dados?
Ferramentas baseadas em GPT (como o Airparser) têm um risco conhecido de alucinação — a IA pode às vezes gerar um valor que parece plausível, mas não existe no documento. Modelos Vision-AI (como o ImageToTable.ai) alucinam com muito menos frequência porque baseiam sua saída no conteúdo visual da página. Se você processa dados financeiros que precisam ser à prova de auditoria, procure uma ferramenta que forneça citações de origem ou pontuações de confiança para cada campo extraído. E sempre inclua uma etapa de revisão humana em fluxos de trabalho onde um valor errado possa causar danos financeiros reais.
Conclusão
"Sem treinamento" é uma das características mais valiosas que uma ferramenta de extração de documentos pode oferecer — mas apenas quando é genuína. A diferença entre uma ferramenta que realmente exige zero configuração e uma que pede para você criar modelos após o primeiro upload não é um detalhe menor de fluxo de trabalho. Ela determina se você vai passar sua primeira hora extraindo dados ou desenhando caixas.
As ferramentas que oferecem extração zero-shot genuína — ImageToTable.ai, Airparser e o mecanismo de IA do Parseur — são construídas sobre arquiteturas fundamentalmente diferentes das alternativas baseadas em modelos ou treinadas por ML. Elas funcionam desde o primeiro dia, em qualquer layout, em qualquer tipo de documento que tenham sido pré-treinadas para entender. A contrapartida é que, em um único formato altamente específico que você processa 10.000 vezes por mês, um modelo treinado sob medida ou um modelo cuidadosamente construído pode alcançar uma precisão ligeiramente maior.
Para a maioria das equipes que processam uma mistura de tipos de documentos de várias fontes, a extração zero-shot não é um compromisso — é a única abordagem prática. Uma hora economizada na configuração por tipo de documento é uma hora que se multiplica em cada fornecedor, cada mudança de formato, cada novo tipo de documento que você encontra. Ao longo de um ano, a diferença entre uma ferramenta que exige treinamento e uma que não exige é medida em dias, não em horas.