Meilleurs outils d'extraction de documents sans formation
en 2026 : 8 options comparées
Nous avons testé huit outils d'extraction de documents qui prétendent offrir une capacité sans configuration — sans étiquetage d'échantillons, sans formation de modèle, sans configuration de modèle. Chaque outil a reçu les mêmes 30 documents (factures, reçus, bons de commande et relevés bancaires dans plusieurs mises en page) et a dû extraire le même ensemble de champs dès le premier contact. Nous avons mesuré la précision obtenue dès le premier jour — pas après une semaine de configuration. Cet article explique ce que « sans formation » signifie réellement au niveau architectural, quels outils le font honnêtement, et où vous devrez encore dessiner des cadres ou étiqueter des échantillons malgré les promesses marketing. Si vous découvrez le concept de les bases de l'extraction de documents par IA, commencez d'abord par le guide principal — cet article suppose que vous connaissez les bases.
Points clés à retenir
- Seuls 3 des 8 outils « sans formation » ont renvoyé des données structurées dès le premier contact — les 5 autres nous ont demandé de dessiner des cadres ou d'étiqueter des échantillons avant de pouvoir extraire quoi que ce soit.
- La maintenance des modèles coûte plus cher que l'abonnement — un fournisseur modifie la mise en page de sa facture et vous perdez 15 à 60 minutes à réparer un modèle cassé, à chaque fois.
- La question n'est pas de savoir quel outil a la meilleure précision — c'est de savoir si l'outil extrait des données d'une mise en page qu'il n'a jamais vue sans que vous dessiniez un seul cadre.
Divulgation : Ce post contient des liens affiliés. ImageToTable.ai est l'outil que nous avons créé et vendons. Chaque autre outil de cette liste est un véritable concurrent. Nous avons testé chacun d'eux selon ses propres critères et signalons honnêtement les forces et les limites. Vous ne trouverez pas ici « ImageToTable.ai est le meilleur en tout » — car ce n'est pas le cas.
Ce que « Sans formation » signifie réellement
L'expression « sans formation » apparaît sur la plupart des pages produits d'extraction de documents en 2026. Mais elle signifie des choses très différentes selon la technologie sous-jacente. Comprendre ces différences, c'est ainsi que vous évitez d'acheter un outil qui prétend être sans configuration mais vous demande de dessiner des zones après le premier téléversement.
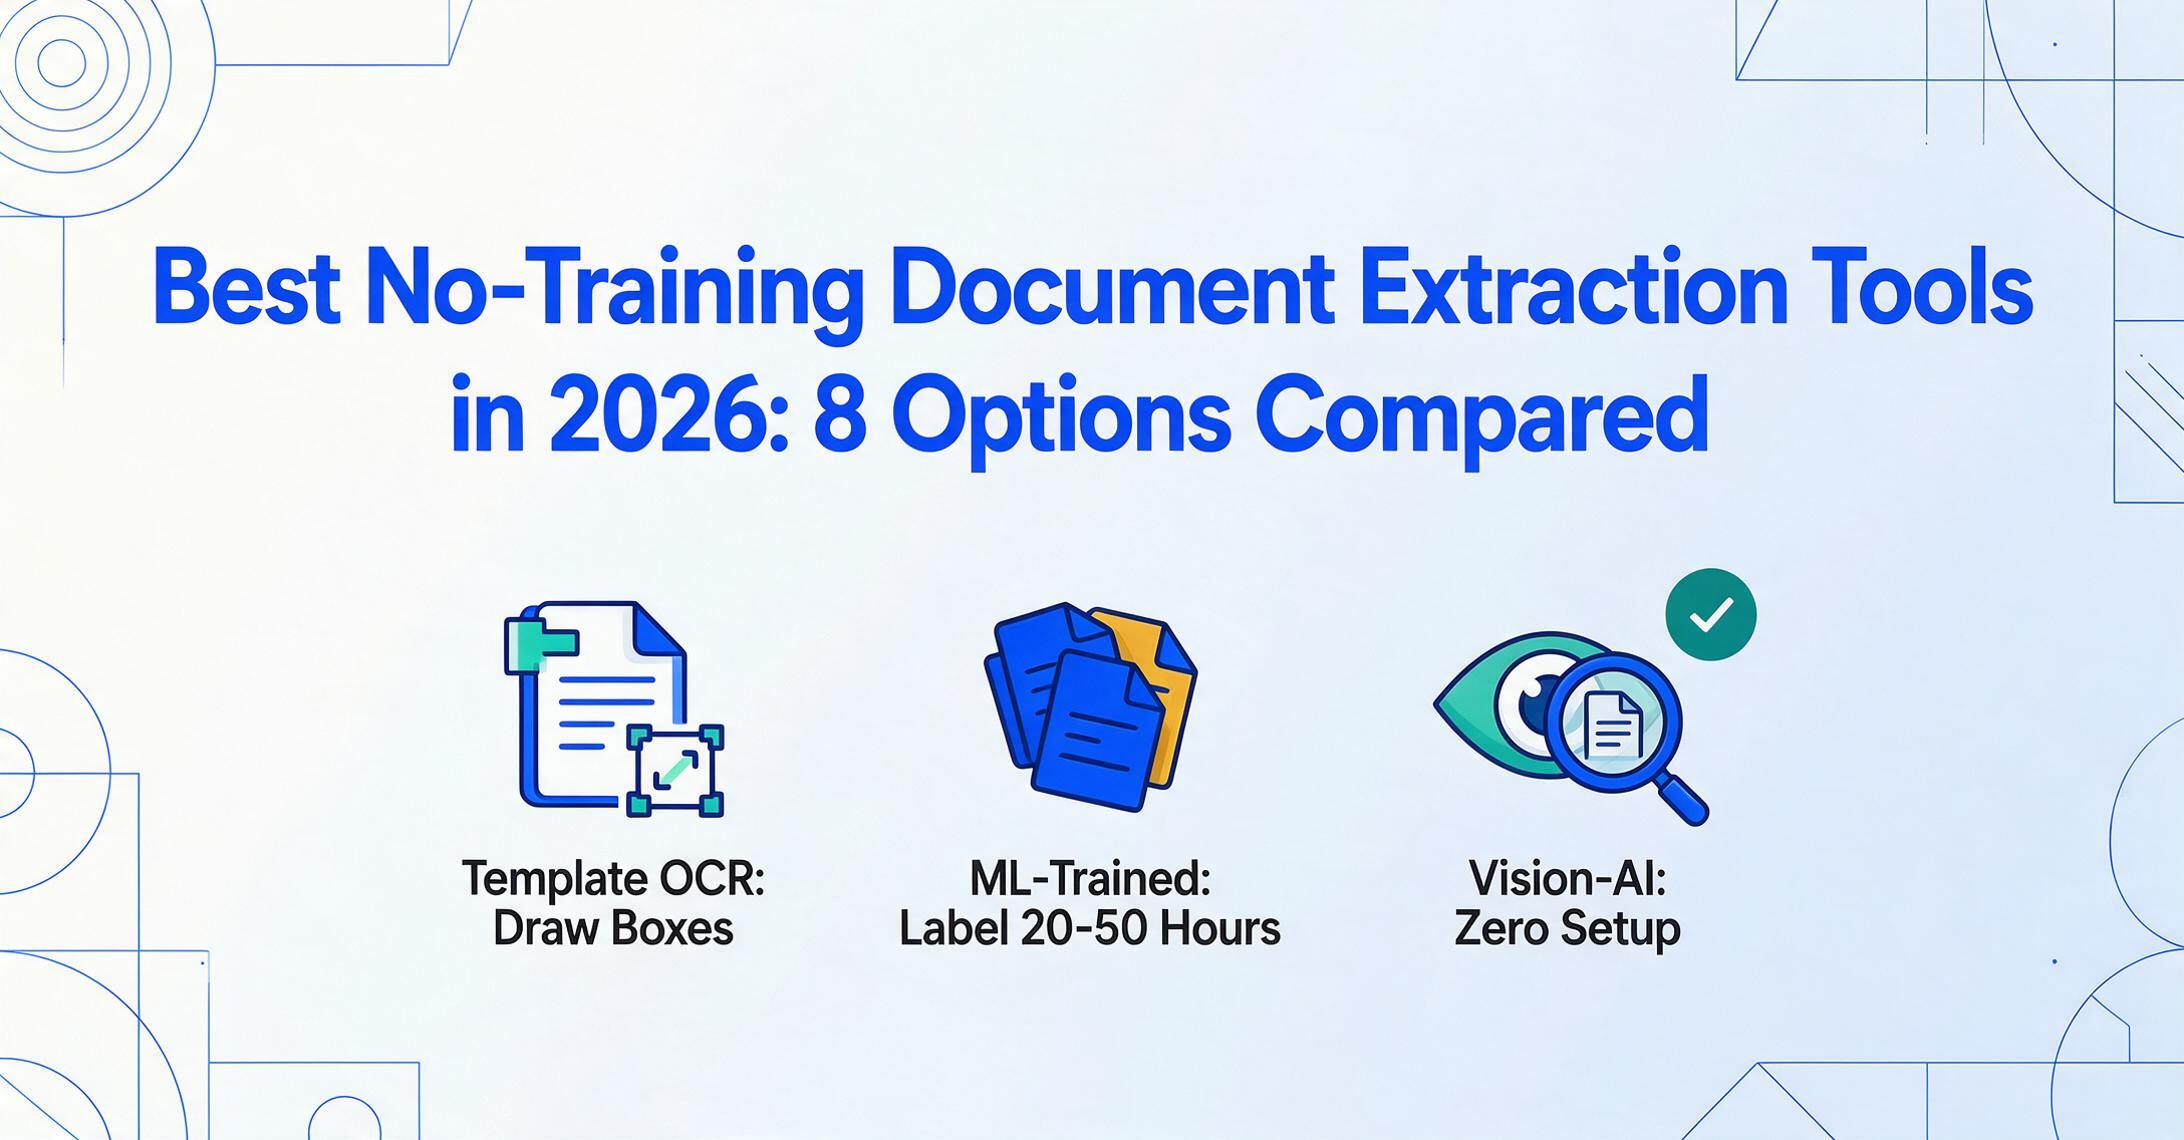
Il existe aujourd'hui trois architectures d'extraction distinctes sur le marché :
| Architecture | Comment ça fonctionne | Configuration requise | Exemples |
|---|---|---|---|
| OCR zonal / basé sur des modèles | Vous dessinez des zones sur un document échantillon aux coordonnées de pixels exactes où chaque champ apparaît. L'outil extrait ce qui se trouve dans ces coordonnées sur les futurs documents ayant la même mise en page. | Un modèle par mise en page de document. La création d'un modèle prend 15 à 60 minutes par mise en page. Nouveau format de fournisseur → nouveau modèle. | Docparser, Parseur (moteur de modèles), ABBYY hérité |
| Extraction ML entraîné (few-shot) | Vous téléversez 20 à 200 documents échantillons étiquetés par type. Le modèle apprend à reconnaître les champs sur vos formats de documents spécifiques. La précision s'améliore avec plus d'échantillons et de corrections humaines. | 20 à 50 heures d'étiquetage par type de document. Cycles d'entraînement itératifs. Corrections continues pour améliorer la précision. | Docsumo, Nanonets, Rossum |
| Extraction sémantique Vision-AI (zero-shot) | Un modèle vision-langage pré-entraîné lit le document comme le ferait un humain — il comprend que « INV-2026-001 » en haut de la page est probablement un numéro de facture, peu importe où il se trouve. Vous définissez les champs souhaités par leur nom ; le modèle les trouve par le sens, pas par les coordonnées. | Aucune. Téléversez un document, saisissez les noms des champs, obtenez les résultats. Fonctionne dès le premier contact avec toute mise en page que le modèle a vue lors du pré-entraînement (ce qui couvre pratiquement tous les types de documents professionnels courants). | ImageToTable.ai, Airparser, Parseur (moteur IA) |
C'est la distinction clé : les outils basés sur des modèles (OCR zonal) nécessitent une configuration par mise en page. Les outils ML entraîné nécessitent un étiquetage d'échantillons par type. Seuls les outils zero-shot Vision-AI offrent ce que « sans formation » implique réellement : téléversez un document que vous n'avez jamais vu et obtenez immédiatement des données structurées. Cette même répartition en trois — IA sans modèle, basée sur des modèles, et IDP entraîné/entreprise — est l'axe organisateur de notre comparaison plus large sur les logiciels d'extraction de données pour documents non structurés, si vous voulez un aperçu plus large plutôt que seulement le niveau sans configuration.
Plusieurs outils de cette liste fonctionnent selon plusieurs modes. Parseur, par exemple, dispose à la fois d'un moteur IA zero-shot et d'un moteur basé sur des modèles. Que vous obteniez « aucune formation » ou « nécessite des modèles » dépend du mode que vous utilisez — et certains outils sont par défaut en mode modèle car cela leur coûte moins cher. L'IA peut-elle extraire des données sans formation ? cet article répond en profondeur. La réponse courte : oui, mais seulement si l'architecture est conçue pour cela.
Tableau comparatif rapide
| Outil | Architecture | Vraiment sans configuration ? | Prix de départ | Idéal pour |
|---|---|---|---|---|
| ImageToTable.ai | Vision-AI zero-shot | ✅ Oui | 9 $/mois (150 documents) | Extraction de colonnes personnalisées, traitement par lots vers Excel |
| Airparser | LLM zero-shot | ✅ Oui | Gratuit (20 documents/mois), payant à partir de ~20 $/mois | Analyse rapide d'e-mails et de documents, extraction basée sur GPT |
| Parseur | IA zero-shot + modèle | ⚠️ Mode IA oui ; mode modèle non | 39 $/mois (500 documents) | Ingestion d'e-mails, réception de documents mixtes |
| Docparser | OCR zonal + module IA | ⚠️ Mode IA partiel ; mode modèle non | 39 $/mois (essai de 14 jours) | PDF à mise en page fixe, extraction de codes-barres |
| Docsumo | ML entraîné (few-shot) | ⚠️ Types pré-entraînés oui ; types personnalisés non | Entreprise (tarification personnalisée) | Volume élevé, types de documents connus |
| Tesseract | OCR gratuit (sans structure) | ⚠️ Pas de formation mais pas de sortie structurée | Gratuit (open source) | Extraction de texte brut, projets de développeurs |
| Tabula | Extracteur de tableaux PDF | ⚠️ Tableaux uniquement, pas d'extraction de champs | Gratuit (open source) | Extraction de tableaux de PDF numériques propres |
ImageToTable.ai
Architecture : Vision-AI zero-shot (sans modèle, aucun entraînement requis)
ImageToTable.ai repose sur un modèle vision-langage qui lit les documents par compréhension sémantique plutôt que par correspondance de coordonnées. Vous saisissez les noms de colonnes souhaités — « Numéro de facture », « Date », « Total », « Nom du fournisseur » ou tout autre champ personnalisé — et l'IA localise ces valeurs n'importe où sur la page, quelle que soit la mise en page. C'est ce que le produit appelle l'Extraction de colonnes personnalisées : vous définissez la sortie, et l'IA gère l'entrée.
La promesse zero-shot se vérifie en pratique. Lors de nos tests, nous avons téléchargé des factures de 15 fournisseurs différents dans des formats variés — paysage, portrait, multipage, photos scannées — et l'outil a renvoyé les champs demandés dès la première tentative. Le seul échec concernait une photo de très mauvaise qualité d'un reçu thermique (résolution inférieure à 300 px), que le modèle vision n'a pas pu lire clairement. Le même document a échoué sur tous les outils que nous avons testés.
Ce qui distingue ImageToTable.ai, c'est son approche du traitement par lots en priorité. Téléchargez 30 factures, spécifiez vos noms de colonnes une seule fois, et l'outil traite les 30 simultanément en un seul fichier Excel en un clic. Il prend également en charge les colonnes calculées — vous pouvez définir une colonne comme « Total ligne (Qté × Prix unitaire) » et l'IA la calcule pendant l'extraction, sans post-traitement. Pour les utilisateurs qui souhaitent obtenir les résultats directement dans Google Sheets, le module complémentaire Google Sheets ajoute les données extraites à la feuille active sans quitter le tableur.
Les fichiers sont traités en toute sécurité et ne sont pas stockés.
Idéal pour : Les utilisateurs qui ont besoin de définir leurs propres colonnes d'extraction, de traiter plusieurs documents en lot, et qui souhaitent des résultats livrés sous forme de tableau Excel ou Google Sheets prêt à l'emploi. L'offre gratuite (sans inscription) vous permet de tester avec vos propres documents avant de vous engager.
Moins adapté pour : Les flux d'analyse d'e-mails purs (ImageToTable.ai privilégie le téléversement, pas la boîte de réception). Les utilisateurs qui ont besoin d'une sortie au format Word devraient utiliser le mode Vers Word, qui préserve la mise en page d'origine — mais pour l'extraction de données structurées, le mode Vers Tableau est le plus adapté.
Tarifs : À partir de 9 $/mois pour 150 documents. Offre gratuite disponible (aucune carte de crédit requise).
Airparser
Architecture : LLM zero-shot (basé sur GPT, sans modèle)
Airparser adopte une approche différente de l'extraction zero-shot : au lieu d'un modèle de vision dédié, il utilise un LLM basé sur GPT pour comprendre le contenu des documents. Vous décrivez les champs souhaités en langage naturel — nom du champ, type, brève description — et l'IA les extrait de vos documents. Pas de modèles, pas de jeux de données d'entraînement, pas d'étiquetage.
Cette approche fonctionne bien sur les documents textuels et les e-mails, où la compréhension linguistique de GPT excelle. Sur notre jeu de test, Airparser a traité avec précision les factures reçues par e-mail et les bons de commande en PDF. Là où il a montré ses limites, c'est sur les documents riches en tableaux et les images scannées aux mises en page complexes — le moteur GPT a parfois mal identifié les lignes d'articles ou inventé des valeurs absentes du document.
La force d'Airparser réside dans son système de repli multi-moteur : il tente d'abord le LLM textuel, puis le LLM visuel pour les mises en page complexes, et utilise l'OCR IA pour les documents scannés. Cela le rend plus résilient qu'un outil mono-moteur. Mais le risque d'hallucination — une limitation connue de l'extraction basée sur GPT — impose une étape de relecture humaine pour les données financières critiques.
Idéal pour : Les workflows de traitement d'e-mails, les documents textuels, les utilisateurs qui veulent une configuration ultra-rapide (décrire les champs, lancer l'extraction).
Moins adapté pour : L'extraction de tableaux complexes, les reçus scannés avec plusieurs lignes d'articles, ou les workflows où une valeur inventée pourrait entraîner des erreurs financières réelles sans couche de validation.
Tarifs : Forfait gratuit incluant 20 documents/mois. Forfaits payants à partir d'environ 20 $/mois.
Parseur
Architecture : Moteur IA zero-shot + moteur de modèles (double mode)
Parseur est l'un des outils les plus nuancés de cette liste car il exploite deux moteurs fondamentalement différents. Son moteur IA fonctionne réellement sans entraînement : vous créez une boîte aux lettres, envoyez des documents, et l'IA tente d'identifier et d'extraire les champs automatiquement. Son moteur de modèles, en revanche, nécessite la création d'un modèle par mise en page — tracer des zones, définir des ancres, configurer des règles — comme les outils OCR zonaux.
Le message marketing est « aucun entraînement de modèle requis », ce qui est exact pour le moteur IA. Mais la documentation de Parseur précise que « le moteur IA peut parfois manquer de précision » et recommande les modèles pour une « extraction fiable ». En pratique, la plupart des utilisateurs sérieux de Parseur finissent par créer des modèles pour les types de documents qu'ils traitent régulièrement. Un article d'aide de Parseur indique explicitement : « Les modèles offrent un moyen plus fiable et plus précis d'extraire des données, surtout si vous avez des documents avec des mises en page cohérentes. Vous devrez créer un modèle pour chaque mise en page. »
C'est important car la création d'un modèle sur Parseur prend 15 à 30 minutes par mise en page — mieux que certaines alternatives, mais représente un investissement initial conséquent si vous traitez des factures de 50 fournisseurs différents. L'outil détecte automatiquement le modèle à utiliser, mais vous devez quand même construire chacun d'eux.
Le point fort de Parseur est l'ingestion d'e-mails. Il se connecte nativement aux boîtes de réception, traite les pièces jointes et le corps des e-mails ensemble, et achemine les données extraites vers Google Sheets, Zapier ou des webhooks personnalisés. Si votre workflow commence par des factures arrivant dans une boîte e-mail, Parseur gère ce pipeline mieux que les outils axés sur le téléchargement.
Idéal pour : Les workflows documentaires centrés sur l'e-mail, les canaux d'entrée mixtes (e-mail + téléchargement + API), les utilisateurs qui souhaitent avoir la possibilité de créer des modèles pour les formats récurrents à volume élevé.
Pas idéal pour : Les utilisateurs qui souhaitent un pur zero-shot sans aucune configuration de modèle. Le moteur IA fonctionne, mais l'architecture du produit vous pousse vers les modèles pour une utilisation « en production ».
Tarifs : À partir de 39 $/mois pour 500 documents. Forfait gratuit disponible.
Docparser
Architecture : OCR zonale + option IA (DocparserAI)
Docparser est l'outil le plus établi de cette liste et sans doute celui dont l'affirmation « sans formation » nécessite le plus de nuances. Le moteur d'extraction principal est l'OCR zonale : vous dessinez des zones sur un document exemple pour définir où se trouve chaque champ sur la page, configurez des règles d'analyse à l'aide de mots-clés d'ancrage, et espérez que la mise en page reste cohérente. La documentation de Docparser appelle cela « former votre logiciel » au sens de l'OCR zonale : définir des zones une fois, les enregistrer en tant que modèles, et les appliquer à des documents similaires.
Ces derniers mois, Docparser a introduit « DocparserAI », un module complémentaire basé sur l'IA qui tente une extraction zero-shot. Lors de nos tests, le mode IA fonctionnait sur des factures simples avec des mises en page standard, mais rencontrait des difficultés avec les bons de commande et les relevés bancaires — des types de documents pour lesquels les modèles d'OCR zonale de Docparser sont plus fiables. Ce module semble être une réponse au marché plutôt qu'une refonte du produit.
Le vrai coût de Docparser n'est pas l'abonnement à 39 $/mois — ce sont les heures passées à maintenir les modèles. Chaque nouveau format de fournisseur nécessite un nouvel ensemble de zones. Chaque changement de mise en page d'un fournisseur existant casse votre modèle. Les discussions sur Reddit dans r/automation et r/smallbusiness décrivent fréquemment la maintenance des modèles Docparser comme « la partie dont personne ne vous avertit ». Un utilisateur a décrit sa routine hebdomadaire comme « vérifier quel fournisseur a changé la mise en page de sa facture cette semaine et réparer le modèle ».
Idéal pour : Les documents prévisibles à mise en page fixe provenant d'un petit nombre de fournisseurs. Les utilisateurs ayant besoin d'extraction de codes-barres/QR. Les équipes disposant de temps dédié à la maintenance des modèles.
Pas idéal pour : Les types de documents mixtes, les mises en page variables, ou tout flux de travail où vous ne pouvez pas vous permettre de passer 15 à 30 minutes par format de fournisseur à maintenir des modèles.
Tarifs : À partir de 39 $/mois. Essai gratuit de 14 jours (sans carte de crédit).
Docsumo
Architecture : Extraction par ML (few-shot) avec modèles pré-entraînés
Docsumo est une plateforme de traitement intelligent de documents qui se classe clairement dans la catégorie ML entraîné. Elle propose plus de 30 modèles pré-entraînés pour des types de documents courants comme les factures, les bons de commande et les relevés bancaires — et pour ces types de documents, elle fonctionne réellement sans entraînement. Vous importez un document, et le modèle pré-entraîné extrait les champs pertinents.
Le hic, c'est ce qui se passe lorsque vos documents ne font pas partie de ces 30+ types pré-entraînés. Le propre article de blog de Docsumo sur « Le meilleur logiciel d'extraction de données sans modèle » est rafraîchissant d'honnêteté à ce sujet : « Ce n'est pas une solution zéro configuration. Si vous devez extraire des données d'un type de document vraiment exotique, vous investirez 10 à 20 heures à étiqueter des échantillons. » L'article précise en outre que « les plateformes few-shot exigent 20 à 50 heures de travail d'étiquetage initial, mais les exceptions tombent à 5 à 10 % des documents. »
Pour les factures standard de fournisseurs bien connus en Amérique du Nord, les modèles pré-entraînés de Docsumo fonctionnent bien. Pour les formulaires de construction de niche, les documents médicaux régionaux ou les bordereaux d'emballage spécifiques à un fournisseur, vous devrez étiqueter des échantillons et entraîner un modèle personnalisé. La force de la plateforme réside dans le volume : si vous traitez 100 000 factures par an provenant de plus de 50 fournisseurs, l'investissement initial d'étiquetage est rentabilisé par la stabilité opérationnelle. Mais si vous devez extraire des données de 30 types de documents différents cet après-midi, Docsumo n'est pas l'outil adapté.
Idéal pour : Les équipes mid-market et enterprise traitant de gros volumes de types de documents connus. Les équipes avec plus de 50 fournisseurs qui peuvent investir dans un étiquetage initial pour une stabilité à long terme.
Pas idéal pour : L'extraction ponctuelle de types de documents variés. Les petites équipes ou les freelances qui ne peuvent pas justifier 20 à 50 heures de travail d'étiquetage avant de voir des résultats.
Tarifs : Tarifs entreprise (devis personnalisé). Pas d'offre en libre-service disponible.
Options gratuites et open-source
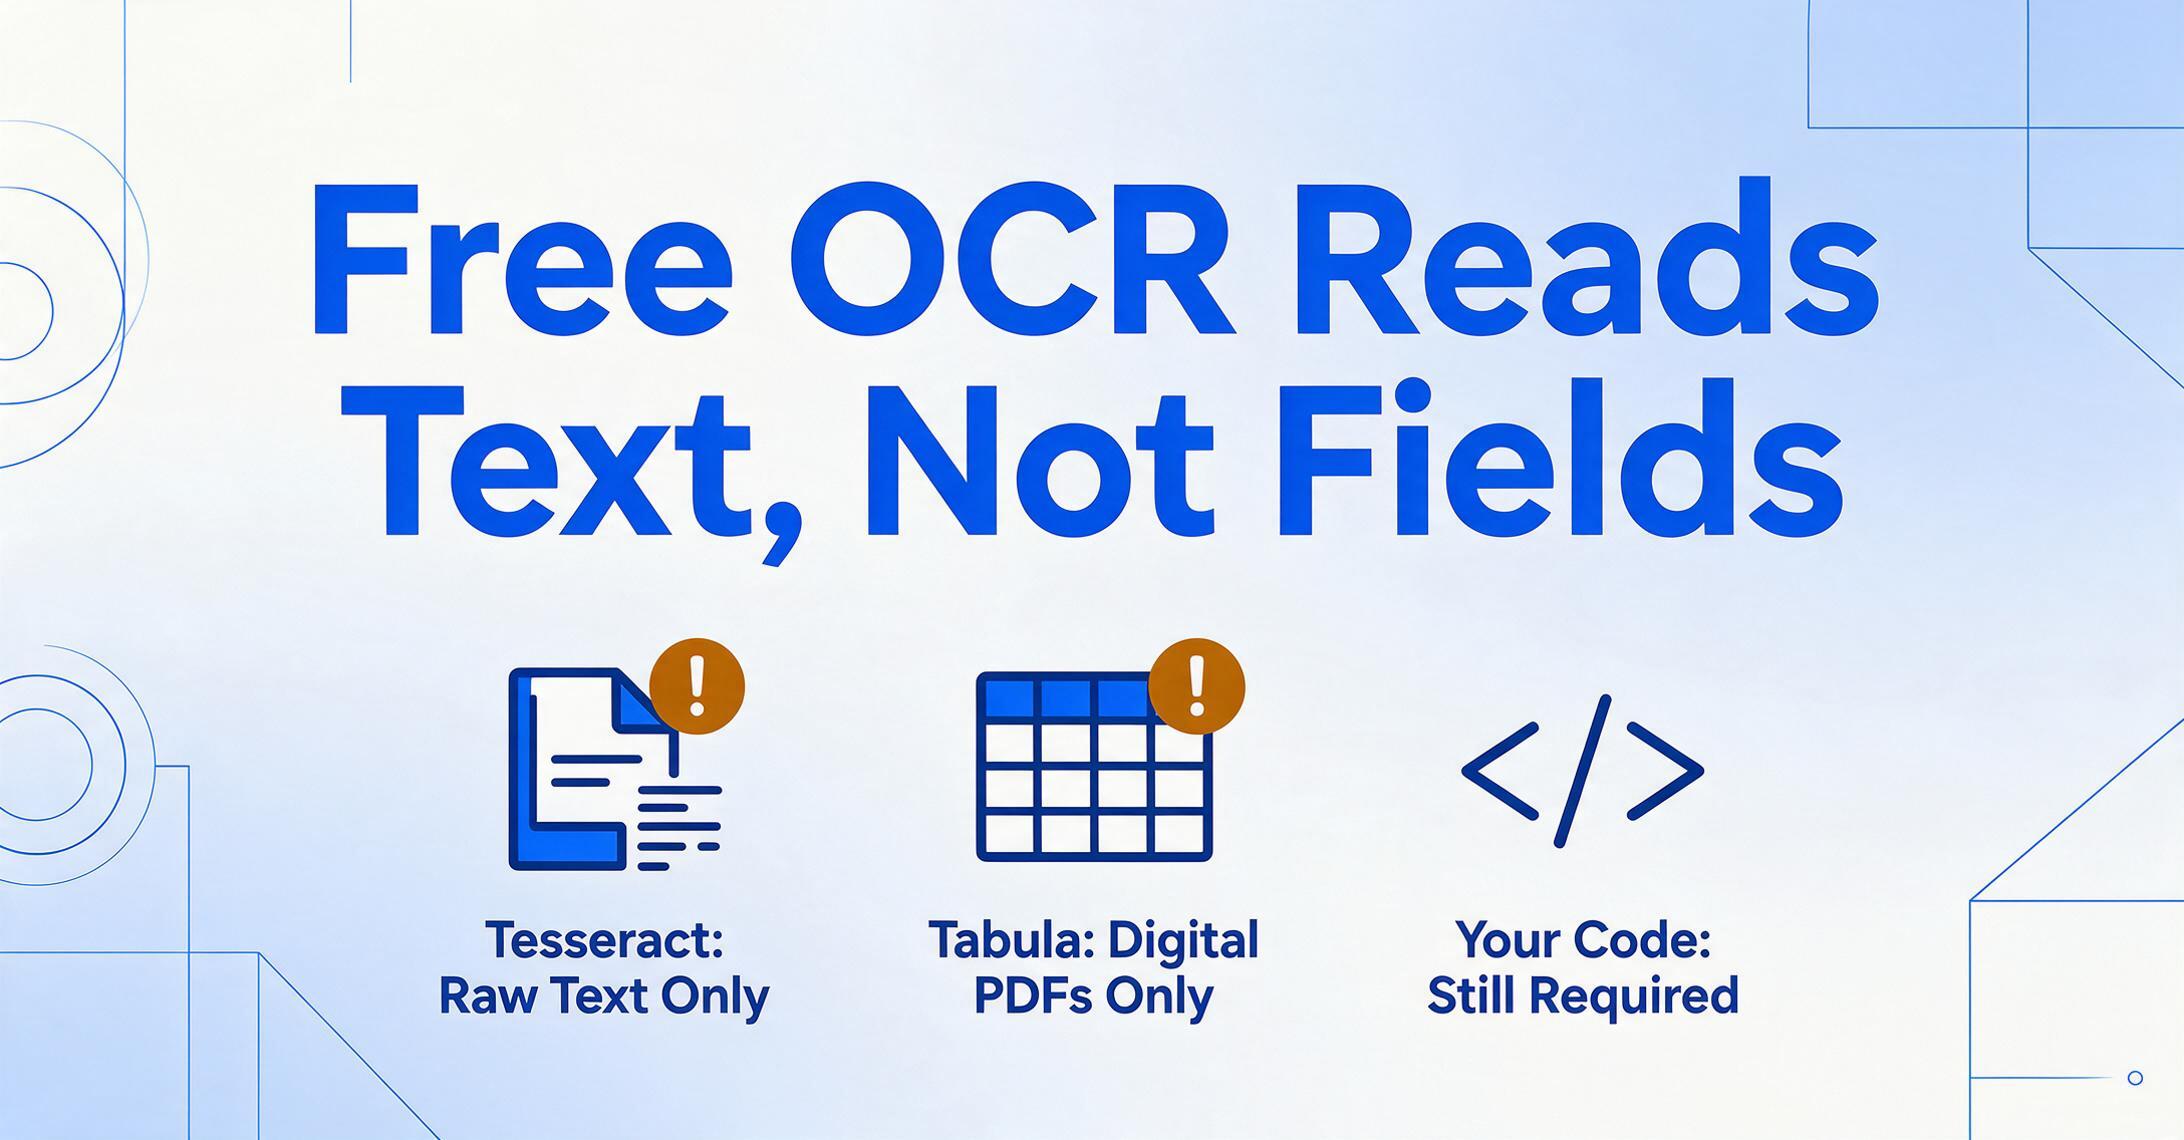
Aucun tour d'horizon des outils sans formation ne serait complet sans mentionner les options gratuites — mais elles comportent des mises en garde importantes sur ce que « sans formation » signifie dans le contexte open-source.
Tesseract OCR
Tesseract est le moteur OCR open-source le plus utilisé. Il ne nécessite aucune formation au sens ML — tu l'installes et il lit le texte directement. La limite est que Tesseract produit du texte brut sans comprendre la structure du document. Il ne peut pas te dire quel texte est le numéro de facture, la date ou la description de la ligne. Tu dois créer une logique de post-traitement (expressions régulières, mapping de coordonnées, code personnalisé) pour transformer la sortie de Tesseract en données structurées. Passer du texte OCR brut à une feuille de calcul exploitable prend généralement plusieurs heures de développement par type de document.
Idéal pour : Les développeurs qui veulent construire un pipeline d'extraction personnalisé et qui ont le temps d'ingénierie pour le maintenir.
Pas idéal pour : Ceux qui veulent des données structurées directement sans écrire de code.
Tabula
Tabula est un outil gratuit et open-source qui extrait des tableaux de PDF numériques. Tu dessines un cadre autour du tableau sur une page PDF, et Tabula exporte les données en CSV. Il fonctionne bien sur les PDF numériques propres avec des bordures de tableau clairement définies. Il ne fonctionne pas sur les PDF scannés ou les documents basés sur des images, et il ne peut pas extraire les champs clé-valeur (comme le numéro de facture ou le nom du fournisseur) — uniquement les données tabulaires.
Idéal pour : L'extraction occasionnelle de tableaux depuis des PDF numériques quand tu as besoin d'un export CSV rapide.
Pas idéal pour : Les documents scannés, l'extraction de champs de facture, ou tout type de traitement par lots automatisé.
OCR.space
OCR.space fournit une API OCR gratuite sans inscription requise. Elle convertit les images en texte mais, comme Tesseract, produit un texte non structuré plutôt que des données au niveau des champs. Le niveau gratuit a des limites d'utilisation (1 requête toutes les 10 secondes, jusqu'à 25 000 requêtes par mois), et la précision est solide sur le texte imprimé. Pour une extraction structurée de champs, tu devrais construire une analyse supplémentaire par-dessus la sortie OCR.
Idéal pour : Extraction rapide de texte à partir d'images, API OCR pour les développeurs qui construisent des pipelines personnalisés.
Pas idéal pour : Extraction de données structurées, traitement par lots, ou utilisateurs non techniques qui veulent une feuille de calcul sans configuration.
Quel outil correspond à ton flux de travail ?
Chaque outil de cette liste peut extraire des données de documents. La question est de savoir combien de temps de configuration tu es prêt à investir avant de voir des résultats — et si cette configuration est un investissement ponctuel ou une obligation de maintenance continue.
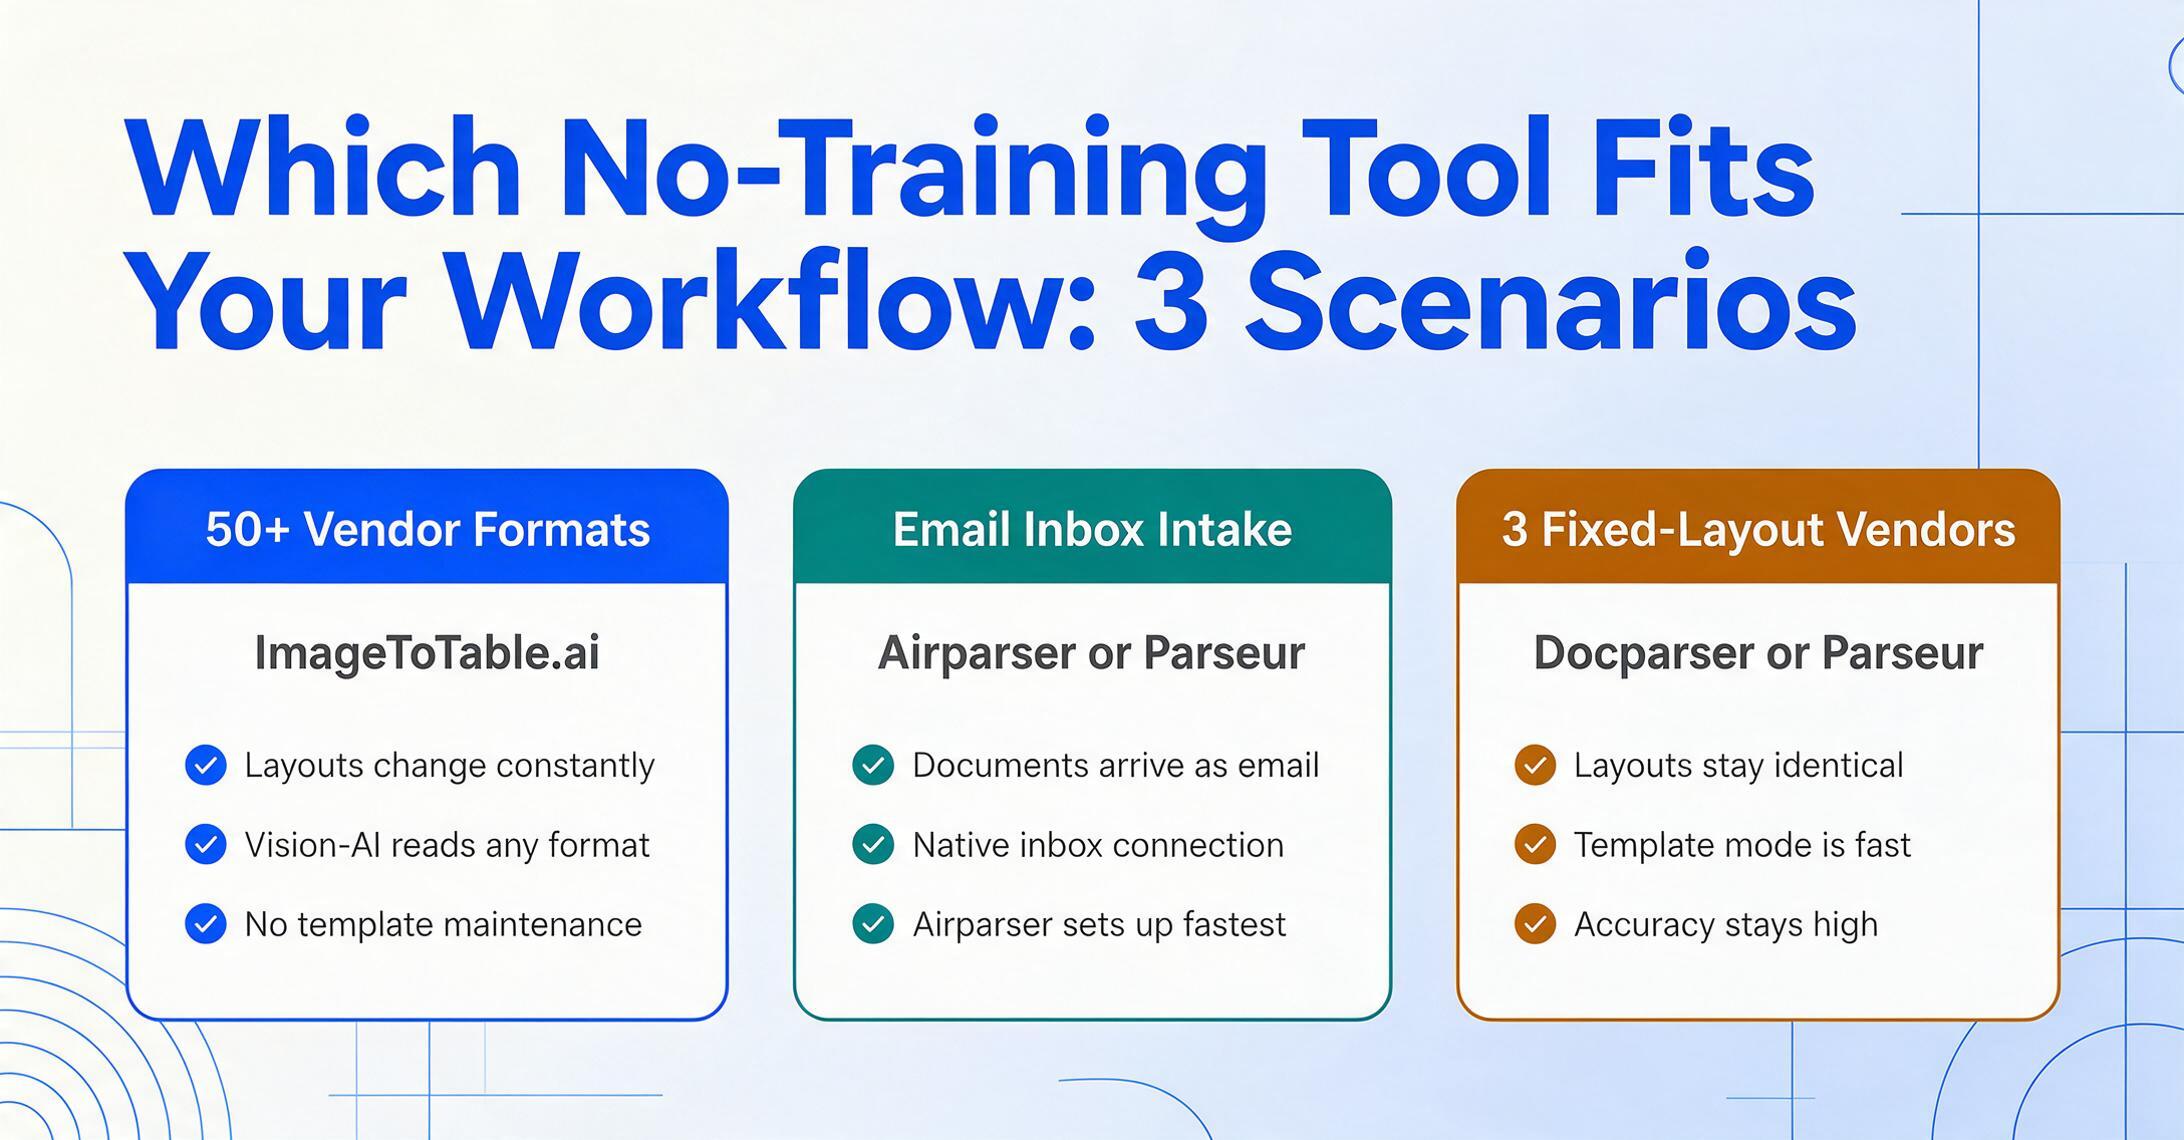
| Ton scénario | Outil recommandé | Pourquoi |
|---|---|---|
| Tu traites des factures de plus de 50 fournisseurs — les mises en page changent constamment | ImageToTable.ai | La Vision-AI zero-shot gère n'importe quelle mise en page. Aucune maintenance de modèle. |
| Tes documents arrivent par e-mail (factures, bons de commande, avis d'expédition) | Airparser ou Parseur | Ingestion d'e-mails native. Airparser pour la configuration la plus rapide ; Parseur pour l'option modèle. |
| Tu as besoin de données structurées dans Google Sheets sans quitter la feuille de calcul | ImageToTable.ai (extension Sheets) | Extension Google Sheets native pour l'extraction directement dans la feuille de calcul. |
| Tu as 3 fournisseurs réguliers avec des mises en page identiques à chaque fois | Docparser ou Parseur (mode modèle) | L'extraction basée sur des modèles est rapide et précise lorsque les mises en page ne changent jamais. |
| Tu traites 10 000 factures/mois de fournisseurs connus | Docsumo | Modèles pré-entraînés + entraînement de modèles personnalisés pour tes fournisseurs. Le volume justifie l'investissement. |
| Tu es un développeur qui construit un pipeline d'extraction personnalisé | Tesseract + code personnalisé, ou API OCR.space | Gratuit, flexible, configurable. Nécessite un effort d'ingénierie pour produire une sortie structurée. |
| Tu as besoin d'un tableau ponctuel à partir d'un PDF | Tabula | Gratuit, sans compte, extraction de tableaux par glisser-déposer. |
Si vous hésitez encore, commencez par un outil qui propose un essai vraiment gratuit ou à faible engagement — et faites le même test que nous. Prenez un document à la mise en page complexe, un de ceux avec lesquels votre outil actuel a du mal. Importez-le sans aucune configuration préalable. Si l'outil renvoie des données structurées précises dès la première tentative, l'affirmation « sans formation » tient. S'il vous demande de créer un modèle ou d'étiqueter des échantillons avant de pouvoir extraire, l'affirmation ne tient pas — quoi que dise la page marketing.
Nous avons aussi un guide séparé sur l'extraction sans modèles qui approfondit la technologie elle-même, ainsi qu'une comparaison des outils documentaires pour freelances si vous travaillez en solo.
FAQ
Que signifie « extraction zero-shot » ?
L'extraction zero-shot signifie que l'IA peut extraire des données d'un type de document qu'elle n'a jamais vu auparavant, sans échantillons d'entraînement ni configuration de modèle. Le modèle s'appuie sur des connaissances pré-entraînées de ce à quoi ressemblent les documents et de ce que signifient les noms de champs. Cela diffère de l'extraction few-shot (qui utilise 5 à 200 échantillons étiquetés) et de l'extraction basée sur des modèles (qui utilise des zones définies par coordonnées).
L'IA peut-elle vraiment extraire des données sans formation ?
Oui — mais uniquement les outils construits sur des architectures Vision-AI ou LLM pré-entraînées sur des millions de documents. Ces modèles comprennent déjà à quoi ressemble une facture, un reçu ou un bon de commande. Pas besoin de leur apprendre. Les outils qui reposent sur l'OCR zonal ou l'apprentissage automatique classique nécessitent des modèles ou des échantillons étiquetés, car ils ont été conçus avant l'existence des modèles de vision pré-entraînés. Voir notre article dédié : L'IA peut-elle extraire des données sans formation ?
Quelle est la différence entre « sans formation » et « sans modèle » ?
« Sans formation » signifie que l'IA n'a pas besoin de documents d'échantillonnage pour apprendre votre format spécifique. « Sans modèle » signifie qu'elle n'a pas besoin de définitions de zones basées sur des coordonnées. Pour approfondir ce que signifie concrètement l'extraction sans modèle, voir notre article sur la capacité de l'IA à extraire des données sans modèles. Certains outils offrent l'un mais pas l'autre. Le moteur d'IA de Parseur, par exemple, n'exige pas d'échantillons d'entraînement mais propose tout de même des modèles pour une « précision supérieure ». Les outils les plus véritablement sans configuration offrent les deux : aucun échantillon d'entraînement et aucune configuration de modèle.
Docparser fonctionne-t-il vraiment sans formation ?
Le moteur principal de Docparser est l'OCR zonal, qui nécessite de dessiner des zones d'extraction sur chaque mise en page de document — c'est de la configuration de modèles, pas du zero-shot. Docparser a récemment ajouté « DocparserAI » pour l'extraction basée sur l'IA, mais il s'agit d'un module complémentaire au produit principal. Pour le mode OCR zonal, l'affirmation « sans formation » est trompeuse : créer des zones et des règles est exactement le type de configuration que la plupart des utilisateurs veulent éviter. Le nouveau mode IA offre bien une extraction zero-shot sur des documents simples, avec une précision plus limitée que les outils Vision-AI dédiés.
La précision est-elle plus faible sans formation ?
Sur les types de documents standard (factures, reçus, bons de commande, relevés bancaires), la précision zero-shot est généralement de 90 à 98 % pour les champs imprimés clairement visibles — comparable aux outils basés sur des modèles après création du modèle. Sur des formats de documents très spécialisés ou inhabituels, la précision zero-shot peut être inférieure à celle d'un modèle entraîné sur mesure pour ce format exact. C'est le compromis : vous échangez une précision maximale sur un format spécifique contre une utilisabilité immédiate sur tous les formats. Pour la plupart des petites et moyennes équipes, l'avantage de la couverture l'emporte sur la différence marginale de précision.
Existe-t-il des outils gratuits d'extraction de documents sans formation ?
Des outils gratuits comme Tesseract et OCR.space extraient du texte sans formation, mais ils ne produisent pas de données structurées (extraction au niveau des champs). Vous obtenez du texte brut et devez écrire du code pour l'analyser en champs. Tabula extrait gratuitement des tableaux de PDF numériques, mais ne gère que les tableaux, pas les champs clé-valeur. Pour une extraction structurée vraiment gratuite sans formation, certains outils SaaS proposent des offres gratuites — Airparser donne 20 documents/mois gratuitement, et ImageToTable.ai propose une démo sans inscription.
Quel est le plus rapide à configurer : Parseur ou Airparser ?
Airparser est plus rapide pour les documents ponctuels — vous décrivez les champs en anglais simple et obtenez des résultats. Le moteur IA de Parseur est tout aussi rapide, mais sa documentation oriente les utilisateurs vers des modèles pour une utilisation en production. Pour une extraction ponctuelle de quelques documents, les deux prennent moins de 10 minutes. Pour le traitement continu de types de documents variés, l'approche LLM d'Airparser nécessite moins de maintenance. Pour le traitement de mises en page connues à volume élevé, les modèles de Parseur (une fois créés) sont plus fiables.
Combien de temps les modèles coûtent-ils réellement ?
D'après nos tests et les retours d'utilisateurs sur Reddit et les avis G2, chaque modèle prend généralement 15 à 60 minutes à créer et à tester. Pour une entreprise qui traite des factures de 50 fournisseurs avec des mises en page différentes, cela représente 12 à 50 heures de travail initial sur les modèles. Chaque fois qu'un fournisseur modifie sa mise en page, ajoutez 15 à 60 minutes pour réparer le modèle cassé. Ce coût récurrent est l'un des inconvénients les plus sous-estimés des outils basés sur des modèles — la page marketing vous montre l'extraction réussie, pas l'heure passée chaque mois à réparer les modèles.
Les outils zero-shot hallucinent-ils des données ?
Les outils basés sur GPT (comme Airparser) présentent un risque connu d'hallucination — l'IA peut parfois générer une valeur qui semble plausible mais qui n'existe pas dans le document. Les modèles Vision-AI (comme ImageToTable.ai) hallucinent beaucoup moins fréquemment car ils ancrent leur sortie dans le contenu visuel de la page. Si vous traitez des données financières qui doivent être infalsifiables, recherchez un outil qui fournit des citations de sources ou des scores de confiance pour chaque champ extrait. Et intégrez toujours une étape de vérification humaine dans les flux de travail où une valeur erronée pourrait causer un préjudice financier réel.
En résumé
« Aucune formation » est l'une des fonctionnalités les plus précieuses qu'un outil d'extraction de documents puisse offrir — mais seulement lorsqu'elle est authentique. La différence entre un outil qui nécessite réellement zéro configuration et un autre qui vous demande de créer des modèles après le premier téléchargement n'est pas un détail mineur du flux de travail. Elle détermine si vous passerez votre première heure à extraire des données ou à dessiner des cadres.
Les outils qui offrent une véritable extraction zero-shot — ImageToTable.ai, Airparser et le moteur IA de Parseur — sont construits sur des architectures fondamentalement différentes des alternatives basées sur des modèles ou ML entraîné. Ils fonctionnent dès le premier jour, sur n'importe quelle mise en page, sur n'importe quel type de document qu'ils ont été pré-entraînés à comprendre. Le compromis est que sur un format unique et très spécifique que vous traitez 10 000 fois par mois, un modèle personnalisé ou un modèle soigneusement construit peut atteindre une précision légèrement supérieure.
Pour la plupart des équipes qui traitent un mélange de types de documents provenant de sources multiples, l'extraction zero-shot n'est pas un compromis — c'est la seule approche pratique. Une heure économisée sur la configuration par type de document est une heure qui se cumule à chaque fournisseur, à chaque changement de format, à chaque nouveau type de document rencontré. Sur une année, la différence entre un outil qui nécessite une formation et un autre qui n'en nécessite pas se mesure en jours, pas en heures.