2026年、トレーニング不要の文書抽出
ツールベスト8:徹底比較
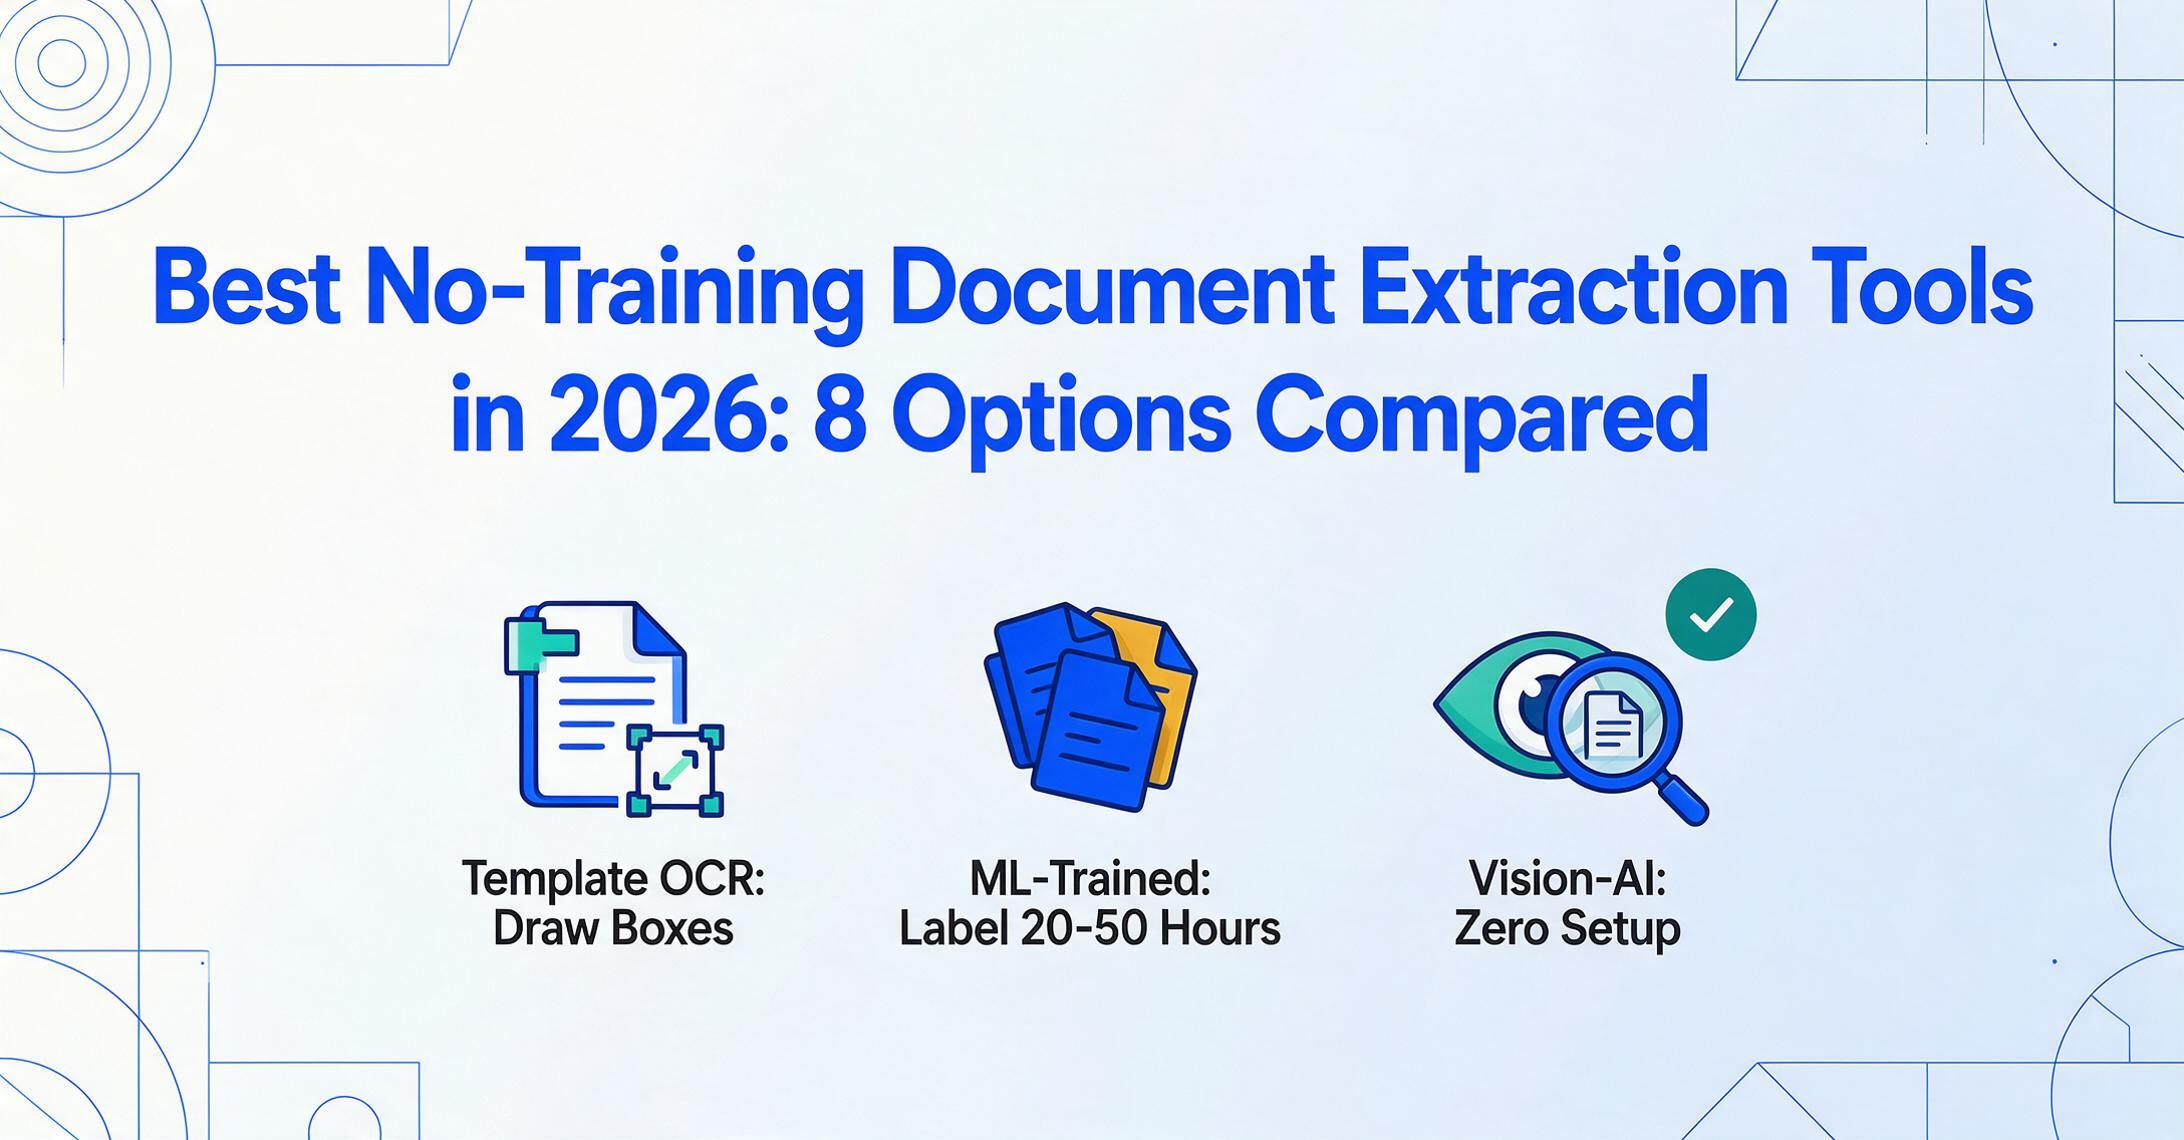
セットアップ不要(サンプルのラベリングなし、モデルのトレーニングなし、テンプレート設定なし)を謳う8つの文書抽出ツールをテストしました。各ツールに同じ30種類のドキュメント(請求書、レシート、発注書、銀行明細書を複数のレイアウトで用意)を与え、初回接触時に同じフィールドセットを抽出するよう依頼しました。測定したのは、セットアップから1週間後ではなく、初日から得られる精度です。この記事では、「トレーニング不要」がアーキテクチャレベルで実際に何を意味するのか、どのツールがそれを正直に実現しているのか、そしてマーケティング上の主張にもかかわらず、ボックスを描いたりサンプルにラベルを付けたりする必要が依然として生じる箇所について説明します。AI文書抽出の基本という概念自体が初めての方は、まずハブガイドから始めてください。この記事は基本を理解していることを前提としています。
重要なポイント
- 「トレーニング不要」を謳う8ツールのうち、初回接触で構造化データを返したのはわずか3つ。残りの5つは、何かを抽出する前にボックスを描くかサンプルにラベルを付けるよう要求した。
- テンプレートのメンテナンスコストはサブスクリプション料金を上回る。あるベンダーが請求書レイアウトを変更すると、壊れたテンプレートの修正に毎回15〜60分を費やすことになる。
- 重要なのは、どのツールの精度が最も高いかではなく、ボックスを1つも描かずに、見たことのないレイアウトからデータを抽出できるかどうかである。
開示: この投稿にはアフィリエイトリンクが含まれています。ImageToTable.ai は当社が開発・販売しているツールです。このリストに挙げられている他のツールはすべて実際の競合製品です。各ツールをそれぞれの条件でテストし、長所と限界を正直に指摘しています。ここに「ImageToTable.ai がすべてにおいて最高」という記述はありません。実際、そうではないからです。
「トレーニング不要」の実際の意味
2026年現在、ほとんどのドキュメント抽出製品ページに「トレーニング不要」という表現が見られます。しかし、その意味は基盤となるテクノロジーによって大きく異なります。この違いを理解することが、初期設定不要を謳いながら最初のアップロード後にボックス描画を要求するツールを避けるための鍵です。
現在の市場には、3つの異なる抽出アーキテクチャが存在します。
| アーキテクチャ | 仕組み | 必要な設定 | 例 |
|---|---|---|---|
| ゾーナルOCR / テンプレートベース | サンプル文書上の各フィールドが表示される正確なピクセル座標にボックス(ゾーン)を描画します。ツールは、同じレイアウトの将来の文書で、その座標内にあるものを抽出します。 | 文書レイアウトごとに1つのテンプレートが必要。テンプレート作成にはレイアウトごとに15〜60分かかります。新しいベンダー形式 → 新しいテンプレート。 | Docparser、Parseur(テンプレートエンジン)、レガシーABBYY |
| ML学習済み抽出(Few-shot) | タイプごとに20〜200件のラベル付けされたサンプル文書をアップロードします。モデルは、特定の文書形式のフィールドを認識することを学習します。サンプルと人間による修正が増えるほど精度が向上します。 | 文書タイプごとに20〜50時間のラベリングが必要。反復的なトレーニングサイクル。精度向上のための継続的な修正。 | Docsumo、Nanonets、Rossum |
| Vision-AI セマンティック抽出(ゼロショット) | 事前トレーニング済みのビジョン言語モデルが、人間と同じように文書を読み取ります。ページ上部近くの「INV-2026-001」がおそらく請求書番号であることを、位置に関係なく理解します。フィールドを名前で定義すると、モデルは座標ではなく意味によってフィールドを見つけます。 | ゼロ。文書をアップロードし、フィールド名を入力して、結果を取得します。事前トレーニングでモデルが見たことのあるレイアウト(基本的にすべての一般的なビジネス文書タイプをカバー)に対して、最初の接触で機能します。 | ImageToTable.ai、Airparser、Parseur(AIエンジン) |
これが重要な違いです。テンプレートベースのツール(ゾーナルOCR)はレイアウトごとの設定が必要です。ML学習済みのツールはタイプごとのサンプルラベリングが必要です。「トレーニング不要」が実際に意味することを実現するのは、Vision-AIゼロショットツールだけです。つまり、見たことのない文書をアップロードして、すぐに構造化データを取得できることです。この3つの分類(テンプレート不要AI、テンプレートベース、トレーニング済み/エンタープライズIDP)は、ゼロセットアップ層だけでなくより広い分野を知りたい場合は、当社のより広範な非構造化文書向けデータ抽出ソフトウェア比較の整理軸でもあります。
このリストのツールのいくつかは、複数のモードで動作します。例えばParseurには、ゼロショットAIエンジンとテンプレートエンジンの両方があります。「トレーニング不要」か「テンプレート必須」かは、どのモードを使うかによって異なります。また、一部のツールは実行コストが安いため、デフォルトでテンプレートモードになっています。AIはトレーニングなしでデータを抽出できますか? その記事で詳しく説明しています。簡単に言うと、はい、ただしアーキテクチャがそのために構築されている場合に限ります。
クイック比較表
| ツール | アーキテクチャ | 真のゼロセットアップ? | 開始価格 | 最適な用途 |
|---|---|---|---|---|
| ImageToTable.ai | Vision-AI ゼロショット | ✅ はい | $9/月(150ドキュメント) | カスタム列抽出、Excelへのバッチ処理 |
| Airparser | LLM ゼロショット | ✅ はい | 無料(20ドキュメント/月)、有料は約$20/月から | メールとドキュメントの迅速な解析、GPTベースの抽出 |
| Parseur | ゼロショットAI + テンプレート | ⚠️ AIモードははい、テンプレートモードはいいえ | $39/月(500ドキュメント) | メール取り込み、混合ドキュメントの受付 |
| Docparser | ゾーナルOCR + AIアドオン | ⚠️ AIモードは部分的、テンプレートモードはいいえ | $39/月(14日間トライアル) | 固定レイアウトのPDF、バーコード抽出 |
| Docsumo | ML学習済み(Few-shot) | ⚠️ 事前学習済みタイプははい、カスタムタイプはいいえ | エンタープライズ(カスタム価格) | 大量処理、既知のドキュメントタイプ |
| Tesseract | 無料OCR(構造なし) | ⚠️ トレーニング不要だが構造化出力なし | 無料(オープンソース) | 生テキスト抽出、開発者向けプロジェクト |
| Tabula | PDFテーブル抽出 | ⚠️ テーブルのみ、フィールド抽出なし | 無料(オープンソース) | クリーンなデジタルPDFからのテーブル抽出 |
ImageToTable.ai
アーキテクチャ: Vision-AI ゼロショット(テンプレート不要、学習不要)
ImageToTable.ai は、座標マッチングではなく意味理解によってドキュメントを読み取るビジョン言語モデルを基盤としています。「請求書番号」「日付」「合計」「ベンダー名」など、必要なカラム名を入力するだけで、AI がレイアウトに関係なくページ上の該当値を特定します。これが製品のいうカスタム列抽出です。出力を定義すれば、AI が入力を処理します。
ゼロショットの主張は実際に検証済みです。テストでは、15 社のベンダーからさまざまな形式(横向き、縦向き、複数ページ、スキャン写真)の請求書をアップロードし、毎回初回で要求したフィールドを取得できました。唯一の失敗点は、解像度 300px 未満の極めて低品質な感熱レシートの写真で、ビジョンモデルが明確に読み取れませんでした。同じドキュメントは、テストしたすべてのツールで失敗しました。
ImageToTable.ai が差別化しているのは、バッチファーストのアプローチです。請求書を 30 枚アップロードし、カラム名を一度指定すれば、ツールは 30 枚すべてを同時に処理し、ワンクリックで単一の Excel ファイルに出力します。また、計算列もサポートしており、「明細合計(数量 × 単価)」のような列を定義すると、AI が抽出時に計算するため、後処理は不要です。結果を Google Sheets で直接利用したいユーザー向けに、Google Sheets アドオンはスプレッドシートを離れることなく、抽出したデータをアクティブなシートに追加します。
ファイルは安全に処理され、保存されません。
最適なユーザー: 独自の抽出カラムを定義し、複数のドキュメントをバッチ処理し、すぐに使える Excel または Google Sheets テーブルとして結果を受け取りたいユーザー。無料プラン(サインアップ不要)で、実際のドキュメントを使って試すことができます。
不向きなユーザー: 純粋なメール解析ワークフロー(ImageToTable.ai はアップロードファーストであり、メール受信ボックスファーストではありません)。Word 形式の出力が必要なユーザーは、元のレイアウトを保持する Wordに変換 モードを使用してください。ただし、構造化データ抽出には、テーブルに変換 モードが適しています。
料金: 月額 $9 から、150 ドキュメントまで。無料プランあり(クレジットカード不要)。
Airparser
アーキテクチャ: LLMゼロショット(GPTベース、テンプレート不要)
Airparserはゼロショット抽出に独自のアプローチを採用しています。専用のビジョンモデルではなく、GPTベースのLLMを使用して文書の内容を理解します。抽出したいフィールドを、フィールド名、タイプ、簡単な説明という形でプレーンテキストで指定するだけで、AIが文書からデータを抽出します。テンプレート、トレーニングデータセット、ラベリングは一切不要です。
このアプローチは、GPTの言語理解能力が活きるテキスト主体の文書やメールコンテンツで効果を発揮します。テストセットでは、メールで送られた請求書や発注書のPDFを正確に処理しました。一方、表が多い文書や複雑なレイアウトのスキャン画像では苦戦し、GPTベースのエンジンが明細項目を誤認識したり、文書に存在しない値を幻覚(ハルシネーション)することがありました。
Airparserの強みはマルチエンジンのフォールバック機能です。まずテキストLLMを試し、複雑なレイアウトにはビジョンLLMにフォールバックし、スキャン文書にはAI OCRを使用します。これにより、単一エンジンのツールよりも高い耐障害性を実現しています。ただし、GPTベースの抽出に内在するハルシネーションのリスクを考慮すると、重要な財務データには人間によるレビュープロセスが必要です。
最適な用途: メール解析ワークフロー、テキスト主体の文書、可能な限り迅速なセットアップ(フィールドを記述してすぐに抽出開始)を求めるユーザー。
不向きな用途: 複雑な表の抽出、複数の明細項目を含むスキャンされたレシート、検証レイヤーなしにハルシネーション値が実際の財務エラーを引き起こす可能性があるワークフロー。
料金: 無料プランは月20文書まで。有料プランは月額約20ドルから。
Parseur
アーキテクチャ: ゼロショットAIエンジン + テンプレートエンジン(デュアルモード)
Parseurは、根本的に異なる2つのエンジンを搭載している点で、このリストの中でも特にニュアンスのあるツールの一つです。AIエンジンは実際にトレーニングなしで動作します。メールボックスを作成し、文書を送信すると、AIが自動的にフィールドを識別して抽出を試みます。一方、テンプレートエンジンは、ゾーンOCRツールと同様に、レイアウトごとにテンプレートを作成(ボックスの描画、アンカーの設定、ルールの構成)する必要があります。
マーケティングメッセージは「モデルトレーニング不要」ですが、これはAIエンジンに関しては正確です。しかし、Parseurのドキュメントでは、「AIエンジンは精度に苦戦することがある」とアドバイスしており、「信頼性の高い抽出」にはテンプレートを推奨しています。実際には、本格的に使用するParseurユーザーのほとんどは、定期的に処理する文書タイプのテンプレートを作成することになります。Parseurのヘルプ記事には、「テンプレートは、特に一貫したレイアウトの文書の場合、より信頼性が高く正確なデータ抽出方法を提供します。レイアウトごとにテンプレートを作成する必要があります」と明記されています。
これは重要な点です。なぜなら、Parseurでのテンプレート作成にはレイアウトあたり15~30分かかるからです。これは一部の代替ツールよりは優れていますが、50の異なるベンダーからの請求書を処理する場合、依然としてかなりの初期投資になります。使用するテンプレートを自動検出する機能はありますが、各テンプレートを個別に構築する必要があります。
Parseurの得意分野はメール取り込みです。メール受信箱にネイティブ接続し、添付ファイルとメール本文の内容を一緒に処理し、抽出したデータをGoogleスプレッドシート、Zapier、カスタムWebhookにルーティングします。ワークフローが請求書のメール受信から始まる場合、Parseurはアップロード優先のツールよりもそのパイプラインを効率的に処理します。
最適な用途: メール中心の文書ワークフロー、複数の取り込みチャネル(メール + アップロード + API)、大量の反復可能なフォーマット用にテンプレートを構築するオプションを求めるユーザー。
こんな方には不向き: テンプレート設定なしで純粋なゼロショット抽出を求めるユーザー。AIエンジンは動作しますが、製品アーキテクチャ上、「本番」利用ではテンプレートの使用が前提となります。
料金: 月額39ドル(500ドキュメント分)から。無料プランあり。
Docparser
アーキテクチャ: ゾーンOCR + オプションのAIアドオン(DocparserAI)
Docparserはこのリストで最も実績のあるツールであり、「トレーニング不要」という主張が最も注意深く検討を要するツールでもあります。このツールのコア抽出エンジンはゾーンOCRです。サンプルドキュメント上に各フィールドの位置を枠で指定し、アンカーキーワードを使った解析ルールを設定し、レイアウトが一貫していることを前提とします。Docparser自身のドキュメントでは、これをゾーンOCRの意味で「ソフトウェアのトレーニング」と呼んでいます。つまり、ゾーンを一度定義してテンプレートとして保存し、類似のドキュメントに適用する方法です。
最近、Docparserは「DocparserAI」というAI搭載のアドオンを導入し、ゼロショット抽出を試みています。私たちのテストでは、AIモードは標準的なレイアウトのシンプルな請求書では機能しましたが、発注書や銀行取引明細書では苦戦しました。これらのドキュメントタイプでは、DocparserのゾーンOCRテンプレートの方が信頼性が高いです。このアドオンは、製品の再設計というよりも、市場への対応策という印象です。
Docparserの本当のコストは月額39ドルのサブスクリプションではなく、テンプレートのメンテナンスに費やす時間です。新しいベンダーのフォーマットごとに新しいゾーンセットが必要になります。既存のベンダーのレイアウト変更があれば、テンプレートは使えなくなります。Redditのr/automationやr/smallbusinessでは、Docparserのテンプレートメンテナンスについて「誰も警告してくれない部分」と頻繁に説明されています。あるユーザーは、毎週のルーティンを「今週はどのベンダーが請求書のレイアウトを変更したか確認し、テンプレートを修正すること」と表現していました。
こんな方に最適: 少数のベンダーからの、予測可能で固定レイアウトのドキュメント。バーコード/QRコード抽出が必要なユーザー。テンプレートメンテナンスに専任の時間を割けるチーム。
こんな方には不向き: 混在するドキュメントタイプ、可変レイアウト、またはベンダーフォーマットごとに15~30分のテンプレートメンテナンスに時間を割けないワークフロー。
料金: 月額39ドルから。14日間の無料トライアル(クレジットカード不要)。
Docsumo
アーキテクチャ: ML学習型抽出(Few-shot)+事前学習モデル
Docsumoは、ML学習型に分類されるインテリジェント文書処理プラットフォームです。請求書、発注書、銀行取引明細書など、一般的な文書タイプ向けに30以上の事前学習モデルを提供しており、これらの文書タイプについてはトレーニング不要で実際に機能します。文書をアップロードするだけで、事前学習モデルが該当フィールドを抽出します。
問題は、文書がこれら30以上の事前学習タイプに該当しない場合です。Docsumo自身のブログ記事「最高のテンプレート不要データ抽出ソフトウェア」では、この点について率直に述べています。「これはゼロセットアップのソリューションではありません。本当に特殊な文書タイプから抽出する必要がある場合、サンプルのラベル付けに10~20時間かかります。」さらに、「Few-shotプラットフォームでは初期のラベル作業に20~50時間かかりますが、例外は文書の5~10%に減少します。」とも記されています。
北米の有名サプライヤーからの標準的な請求書であれば、Docsumoの事前学習モデルは良好に機能します。しかし、ニッチな建設業のフォーム、地域特有の医療文書、サプライヤー固有の納品書などでは、サンプルにラベルを付けてカスタムモデルをトレーニングする必要があります。このプラットフォームの強みはボリュームにあります。50以上のサプライヤーから年間10万件の請求書を処理する場合、初期のラベル付け投資は運用の安定性という形で回収できます。しかし、今日中に30種類もの異なる文書タイプからデータを抽出する必要がある場合、Docsumoは適切なツールではありません。
最適な用途: 既知の文書タイプを大量に処理するミッドマーケットおよびエンタープライズチーム。50以上のサプライヤーと取引があり、長期的な安定性のために初期のラベル付けに投資できるチーム。
不向きな用途: 多様な文書タイプのアドホックな抽出。結果が出る前に20~50時間のラベル付け作業を正当化できない小規模チームやフリーランサー。
料金: エンタープライズ価格(個別見積もり)。セルフサービスプランはなし。
無料・オープンソースの選択肢
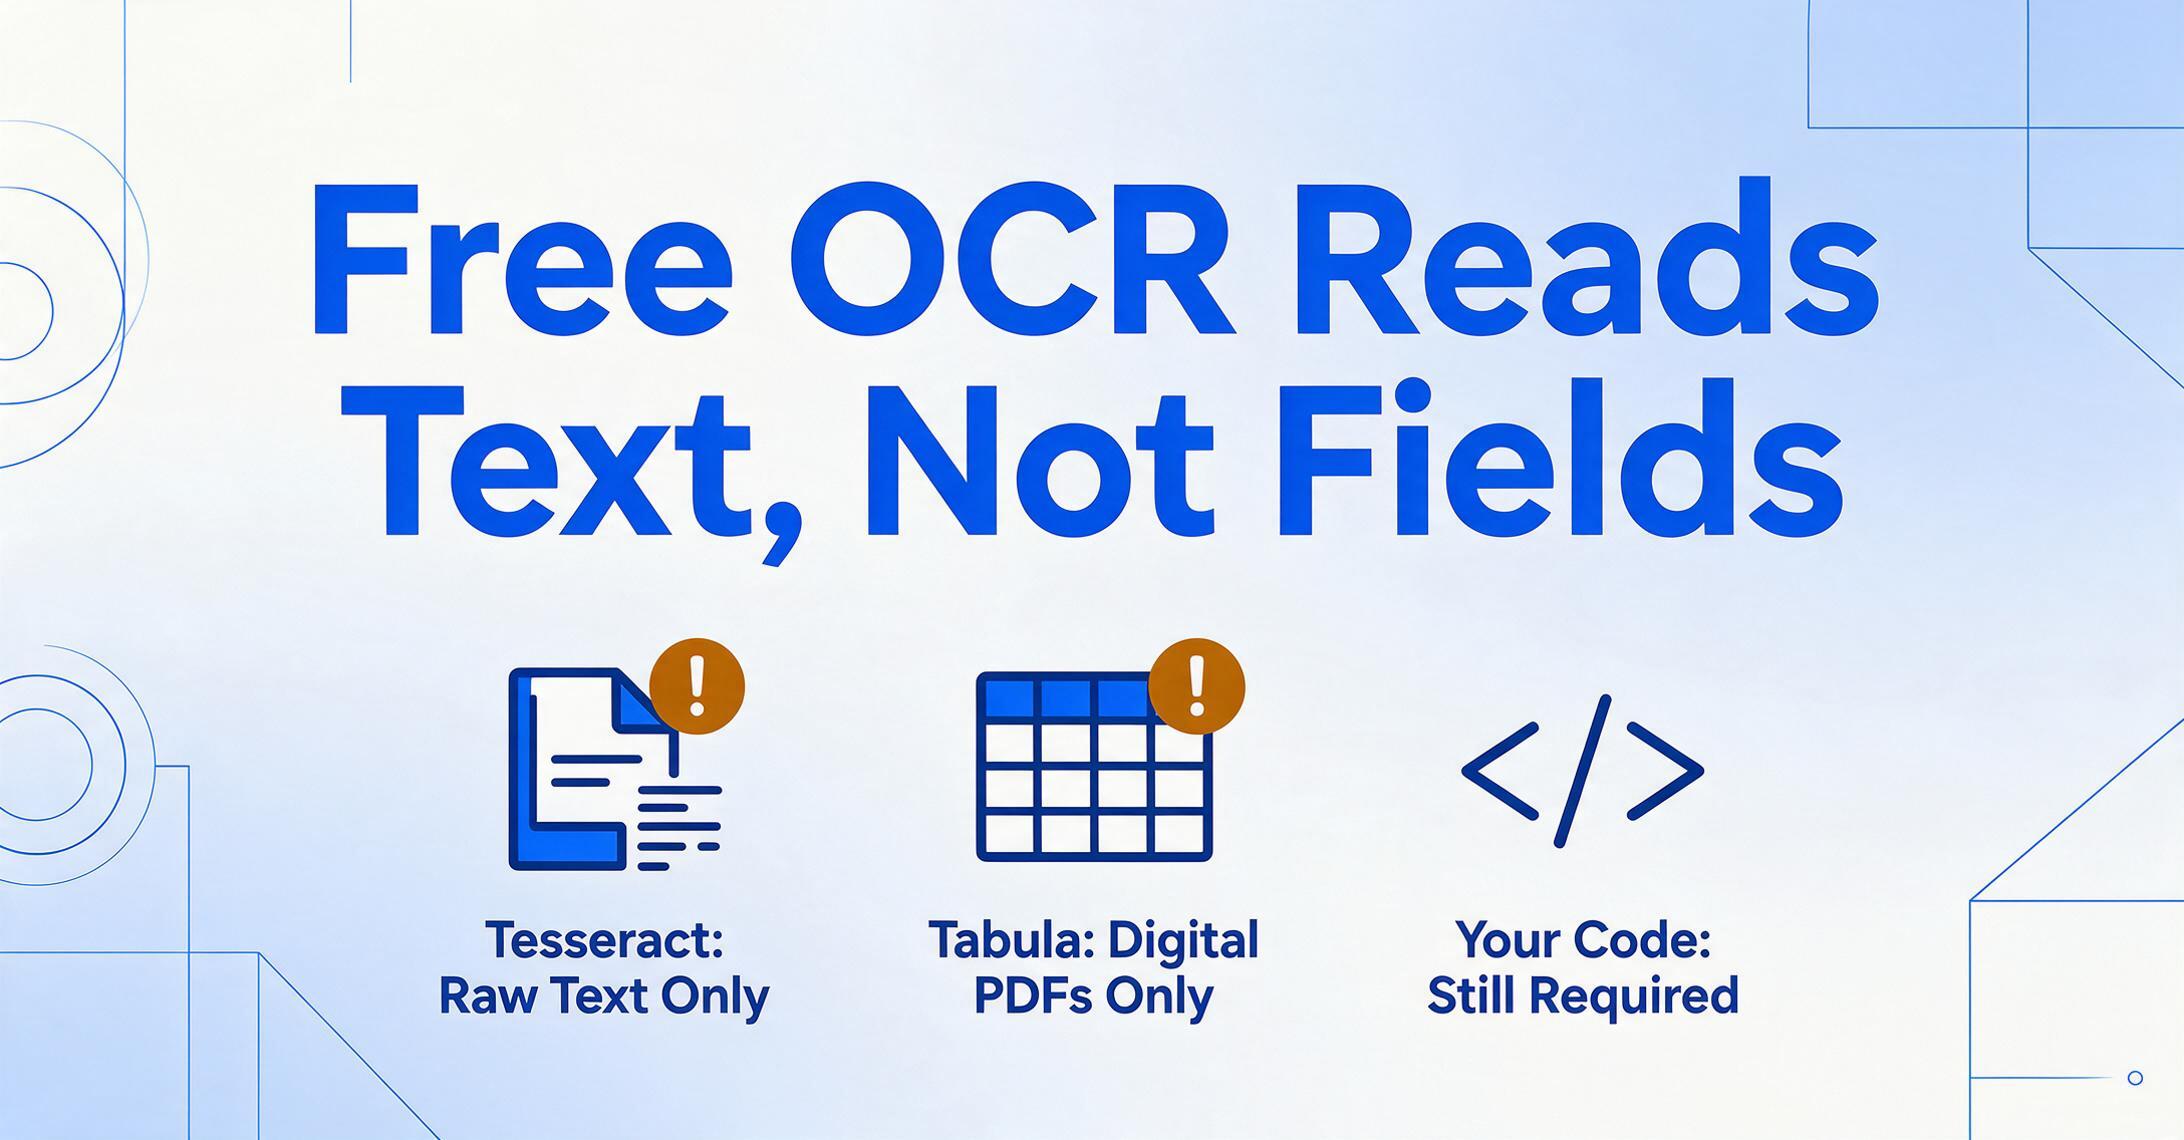
トレーニング不要のツールを紹介する際、無料の選択肢に触れないわけにはいきません。ただし、オープンソースの文脈における「トレーニング不要」の意味には、重要な注意点があります。
Tesseract OCR
Tesseractは、最も広く使用されているオープンソースのOCRエンジンです。MLの意味でのトレーニングは不要で、インストールすればすぐにテキストを読み取ります。制限事項は、Tesseractが構造を理解せずに生のテキストを出力することです。どのテキストが請求書番号で、どれが日付で、どれが明細項目の説明かを判別できません。Tesseractの出力を構造化データに変換するには、後処理ロジック(正規表現、座標マッピング、カスタムコード)を構築する必要があります。生のOCRテキストから実用的なスプレッドシートを得るには、通常、ドキュメントタイプごとに数時間の開発作業が必要です。
最適なケース: カスタム抽出パイプラインを構築し、それを維持するエンジニアリング時間を持つ開発者。
不向きなケース: コードを書かずに、すぐに構造化データを取得したい方。
Tabula
Tabulaは、デジタルPDFからテーブルを抽出する無料のオープンソースツールです。PDFページ上のテーブルの周りにボックスをドラッグすると、TabulaがデータをCSVとして出力します。明確に定義されたテーブル境界線を持つ、クリーンなデジタルPDFではうまく機能します。スキャンされたPDFや画像ベースのドキュメントでは機能せず、キーと値のフィールド(請求書番号やベンダー名など)を抽出できません。表形式のデータのみを抽出できます。
最適なケース: デジタルPDFからテーブルを時々抽出し、迅速なCSVエクスポートが必要な場合。
不向きなケース: スキャンされたドキュメント、請求書のフィールド抽出、またはあらゆる種類の自動バッチ処理。
OCR.space
OCR.spaceは、登録不要で利用できる無料のOCR APIを提供しています。画像をテキストに変換しますが、Tesseractと同様に、フィールドレベルのデータではなく非構造化テキストを出力します。無料プランには利用制限があり(10秒間に1リクエスト、月間最大25,000リクエスト)、印刷されたテキストに対する精度は良好です。構造化されたフィールド抽出を行うには、OCR出力の上に追加の解析処理を構築する必要があります。
最適な用途: 画像からの迅速なテキスト抽出、カスタムパイプラインを構築する開発者向けのOCR API。
不向きな用途: 構造化データ抽出、バッチ処理、設定なしでスプレッドシートを利用したい非技術系ユーザー。
どのツールがワークフローに適しているか?
このリストのすべてのツールは、ドキュメントからデータを抽出できます。問題は、結果が出るまでにどれだけのセットアップ時間を投資するか、そしてそのセットアップが一度きりの投資なのか、継続的なメンテナンスの義務なのかということです。
| シナリオ | 推奨ツール | 理由 |
|---|---|---|
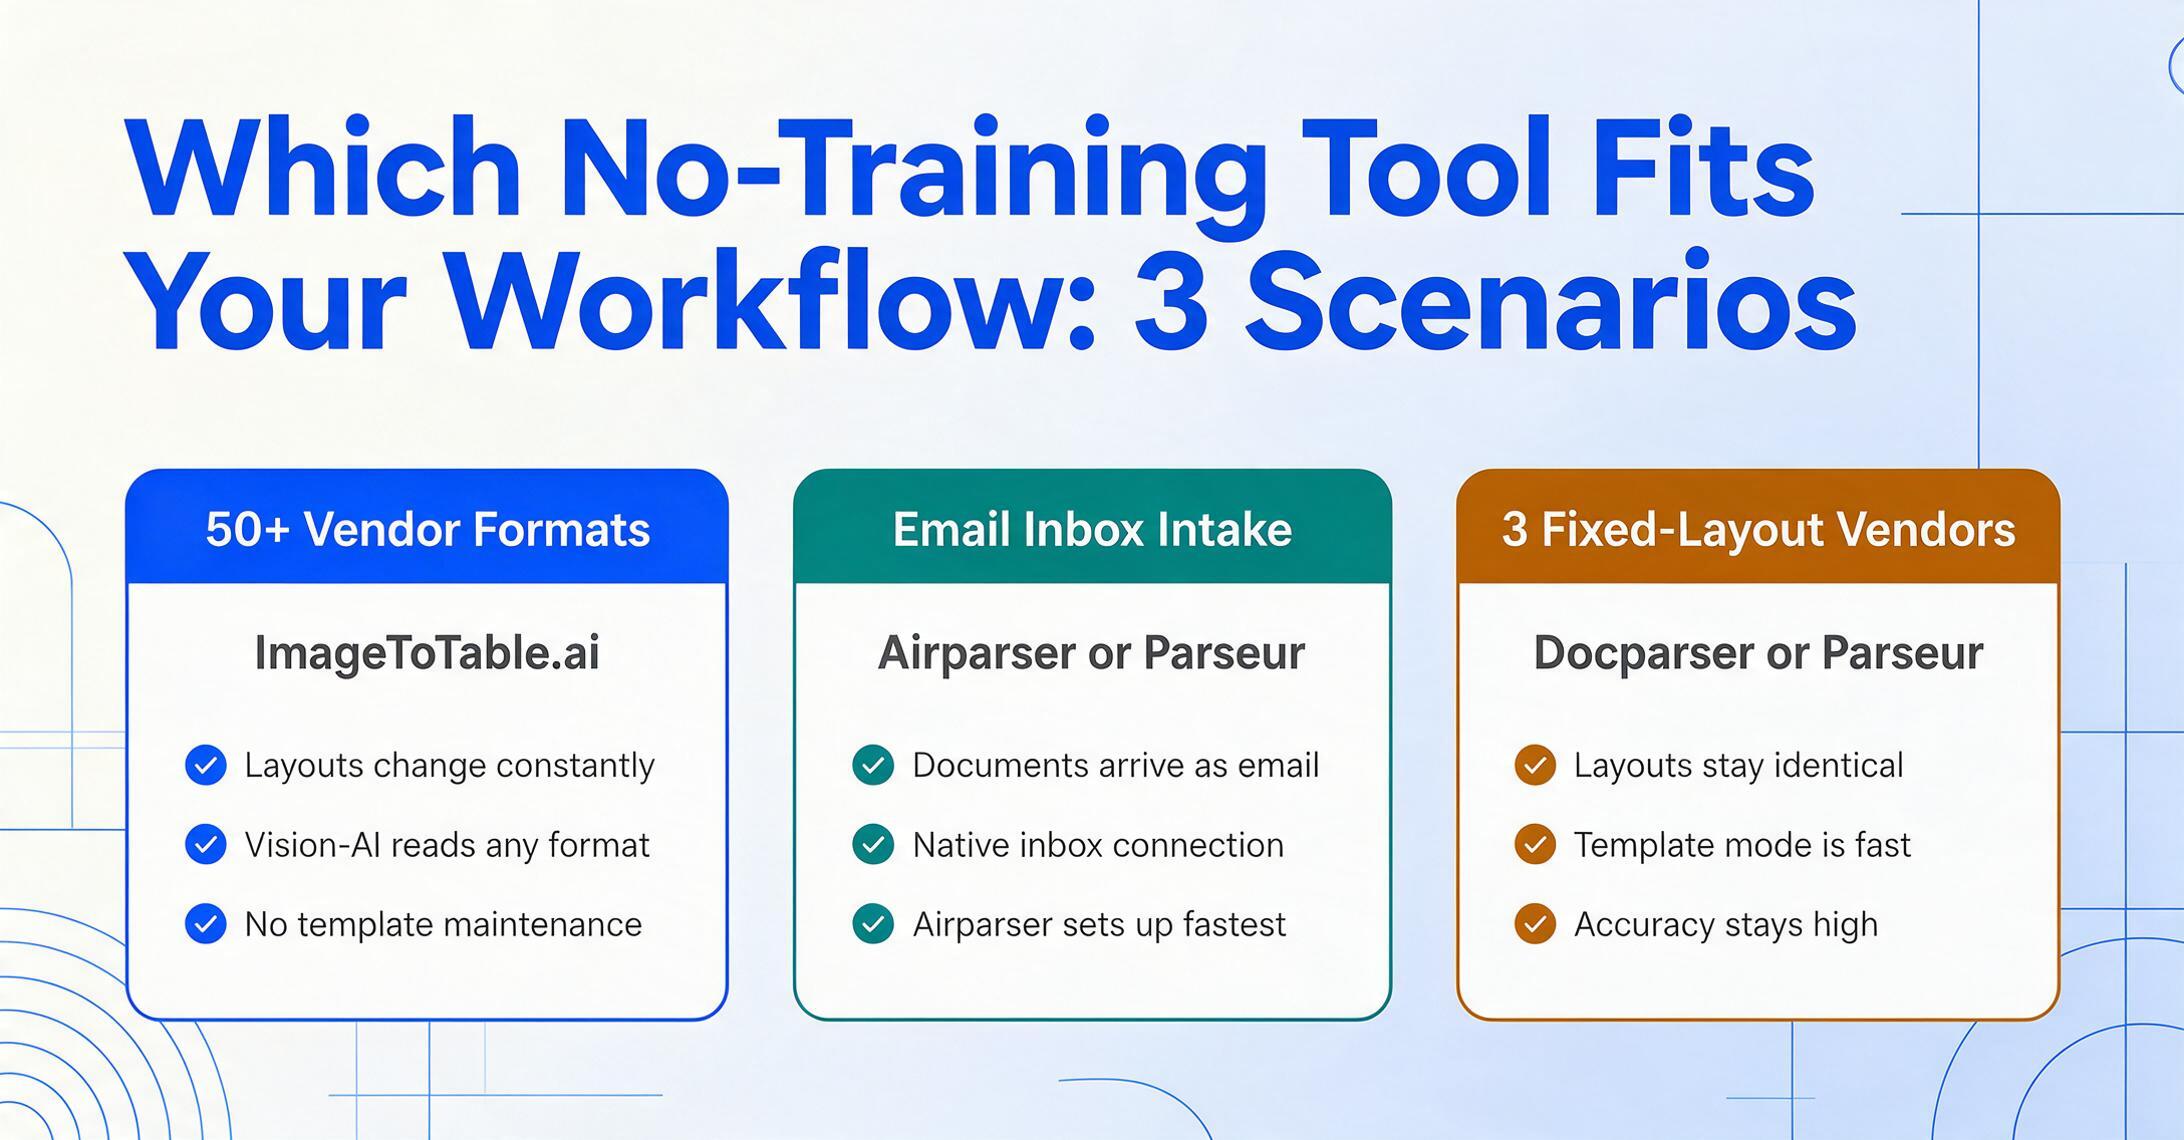
| 50社以上のベンダーからの請求書を処理する — レイアウトが頻繁に変わる | ImageToTable.ai | ゼロショットのVision-AIがあらゆるレイアウトに対応。テンプレートのメンテナンス不要。 |
| ドキュメントがメールで届く(請求書、発注書、出荷通知) | Airparser または Parseur | ネイティブのメール取り込みに対応。最短セットアップならAirparser、テンプレートオプションならParseur。 |
| スプレッドシートから離れずにGoogle Sheetsで構造化データを取得したい | ImageToTable.ai(Sheetsアドオン) | スプレッドシートに直接抽出できるネイティブのGoogle Sheetsアドオン。 |
| 毎回同じレイアウトの取引先が3社ある | Docparser または Parseur(テンプレートモード) | レイアウトが変わらない場合、テンプレートベースの抽出は高速かつ正確。 |
| 既知のサプライヤーから月10,000件の請求書を処理する | Docsumo | 事前学習済みモデル+サプライヤー向けのカスタムモデルトレーニング。ボリュームがあれば投資に見合う。 |
| カスタム抽出パイプラインを構築する開発者である | Tesseract +カスタムコード、または OCR.space API | 無料で柔軟性が高く、設定可能。構造化出力を生成するにはエンジニアリングの労力が必要。 |
| PDFから一度だけテーブルを抽出したい | Tabula | 無料、アカウント不要、ドラッグ&ドロップでテーブル抽出。 |
それでも迷う場合は、本当に無料または低コミットメントのトライアルを提供するツールから始めて、私たちが行ったのと同じテストを実行してください。現在のツールが苦手とする、レイアウトが乱雑なドキュメントを用意し、事前設定なしでアップロードしてください。最初の試行で正確な構造化データが返ってきたら、「トレーニング不要」という主張は正しいと言えます。抽出前にテンプレートの作成やサンプルのラベリングを求められた場合、マーケティングページに何と書いてあっても、その主張は正しくありません。
また、テクノロジー自体をより深く掘り下げたテンプレートなしの抽出に関する別のガイドと、個人で作業している場合のフリーランサー向けドキュメントツールの比較も用意しています。
FAQ
「ゼロショット抽出」とはどういう意味ですか?
ゼロショット抽出とは、AIがトレーニングサンプルやテンプレート設定なしで、これまで見たことのないドキュメントタイプからデータを抽出できることを意味します。モデルは、ドキュメントがどのようなものか、フィールド名が何を意味するかについての事前学習済みの知識に依存します。これは、Few-shot抽出(5〜200個のラベル付きサンプルを使用)やテンプレートベース抽出(座標定義ゾーンを使用)とは異なります。
AIは本当にトレーニングなしでデータを抽出できますか?
はい — ただし、数百万のドキュメントで事前学習されたVision-AIまたはLLMアーキテクチャに基づいて構築されたツールに限ります。これらのモデルは、請求書、レシート、発注書がどのようなものかをすでに理解しています。教える必要はありません。ゾーナルOCRや従来の機械学習に依存するツールは、事前学習済みのビジョンモデルが存在する前に設計されたため、テンプレートやラベル付きサンプルが必要です。専用記事をご覧ください:AIはトレーニングなしでデータを抽出できますか?
「トレーニングなし」と「テンプレートなし」の違いは何ですか?
「トレーニングなし」とは、AIが特定のフォーマットを学習するためにサンプルドキュメントを必要としないことを意味します。「テンプレートなし」とは、座標ベースのゾーン定義を必要としないことを意味します。テンプレート不要の抽出が具体的に何を意味するかについての詳細は、AIがテンプレートなしでデータを抽出できるかに関する記事をご覧ください。一部のツールはどちらか一方のみを提供します。たとえば、ParseurのAIエンジンはトレーニングサンプルを必要としませんが、「高精度」のためにテンプレートを提供しています。最も真にゼロセットアップのツールは、トレーニングサンプルなしとテンプレート設定なしの両方を提供します。
Docparserは本当にトレーニングなしで動作しますか?
DocparserのコアエンジンはゾーナルOCRであり、各ドキュメントレイアウトに抽出ゾーンを描画する必要があります。これはテンプレート設定であり、ゼロショットではありません。Docparserは最近、AI駆動の抽出のための「DocparserAI」を追加しましたが、これはコア製品へのアドオンです。ゾーナルOCRモードでは、「トレーニング不要」という主張は誤解を招きます。ゾーンとルールの作成は、まさに多くのユーザーが避けたいと思っている設定です。新しいAIモードは、シンプルなドキュメントに対してゼロショット抽出を提供しますが、専用のVision-AIツールよりも精度は限られています。
トレーニングなしでは精度は低くなりますか?
標準的なドキュメントタイプ(請求書、レシート、発注書、銀行明細書)では、ゼロショットの精度は通常90〜98%で、明確に表示された印刷フィールドに対しては、テンプレート作成後のテンプレートベースのツールと同等です。高度に専門化された、または珍しいドキュメント形式では、ゼロショットの精度は、その正確な形式でカスタムトレーニングされたモデルよりも低くなる可能性があります。これがトレードオフです。特定の形式での最大精度と、すべての形式での即時使用性を交換します。ほとんどの中小規模のチームにとって、幅広さの利点は、わずかな精度の差を上回ります。
トレーニング不要の無料のドキュメント抽出ツールはありますか?
TesseractやOCR.spaceなどの無料ツールは、トレーニングなしでテキストを抽出しますが、構造化データ(フィールドレベルの抽出)は生成しません。生のテキストが得られるため、フィールドに解析するコードを自分で書く必要があります。TabulaはデジタルPDFからテーブルを無料で抽出しますが、テーブルのみを処理し、キーと値のフィールドは処理しません。トレーニング不要の真に無料の構造化抽出には、一部のSaaSツールが無料枠を提供しています。Airparserは月20ドキュメントを無料で提供し、ImageToTable.aiはサインアップ不要のデモを提供しています。
ParseurとAirparserのどちらがセットアップが速いですか?
Airparserは、1回限りのドキュメントに対して高速です。フィールドを平易な英語で記述するだけで結果が得られます。ParseurのAIエンジンも同様に高速ですが、その製品ドキュメントは、本番運用ではテンプレートの使用をユーザーに促しています。数枚のドキュメントの1回限りの抽出では、両方とも10分未満で完了します。多様なドキュメントタイプの継続的な処理では、AirparserのLLMアプローチはメンテナンスが少なくて済みます。既知のレイアウトを高ボリュームで処理する場合、Parseurのテンプレート(一度構築すれば)はより信頼性が高くなります。
テンプレートの維持には実際どれくらいの時間がかかるのか?
当社のテストとRedditやG2のレビューでのユーザー報告によると、各テンプレートの作成とテストには通常15〜60分かかります。異なるレイアウトを持つ50社のベンダーから請求書を処理する企業の場合、初期のテンプレート作業に12〜50時間かかります。ベンダーがレイアウトを変更するたびに、壊れたテンプレートの修正にさらに15〜60分かかります。この継続的なコストは、テンプレートベースのツールの最も過小評価されている欠点の1つです。マーケティングページには成功した抽出結果が表示されますが、毎月テンプレート修正に費やす時間は表示されません。
ゼロショットツールはデータを幻覚することがあるのか?
GPTベースのツール(Airparserなど)には既知の幻覚リスクがあります。AIが文書に存在しないがもっともらしく見える値を生成することがあります。Vision-AIモデル(ImageToTable.aiなど)は、出力をページの視覚的コンテンツに基づかせるため、幻覚の頻度がはるかに低くなります。監査に耐えうる財務データを処理する場合は、抽出された各フィールドにソース引用や信頼スコアを提供するツールを探してください。また、誤った値が実際の財務上の損害を引き起こす可能性があるワークフローには、常に人間によるレビューステップを組み込んでください。
結論
「トレーニング不要」は、ドキュメント抽出ツールが提供できる最も価値のある機能の1つですが、それが本物の場合に限ります。本当にセットアップ不要のツールと、最初のアップロード後にテンプレート作成を求めるツールの違いは、単なるワークフローの細部ではありません。最初の1時間をデータ抽出に費やすか、ボックス描画に費やすかを決定します。
真のゼロショット抽出を提供するツール(ImageToTable.ai、Airparser、ParseurのAIエンジン)は、テンプレートベースやML学習済みの代替ツールとは根本的に異なるアーキテクチャに基づいています。これらは、事前トレーニングされたあらゆるレイアウト、あらゆるドキュメントタイプで初日から機能します。トレードオフとして、毎月10,000回処理する単一の非常に特殊なフォーマットでは、カスタムトレーニングされたモデルや慎重に構築されたテンプレートの方がわずかに高い精度を達成できる可能性があります。
複数のソースからさまざまなドキュメントタイプを処理するほとんどのチームにとって、ゼロショット抽出は妥協ではなく、唯一の実用的なアプローチです。ドキュメントタイプごとにセットアップで1時間節約できれば、その時間はすべてのベンダー、すべてのフォーマット変更、遭遇するすべての新しいドキュメントタイプにわたって積み重なります。1年の間に、トレーニングが必要なツールと不要なツールの違いは、時間単位ではなく日単位で測定されます。