Las mejores herramientas de extracción de documentos sin entrenamiento
en 2026: 8 opciones comparadas
Probamos ocho herramientas de extracción de documentos que afirman tener capacidad de configuración cero: sin etiquetado de muestras, sin entrenamiento de modelos, sin configuración de plantillas. A cada herramienta se le dieron los mismos 30 documentos (facturas, recibos, órdenes de compra y extractos bancarios en múltiples diseños) y se le pidió extraer el mismo conjunto de campos al primer contacto. Medimos la precisión que se obtiene el primer día, no después de una semana de configuración. Este artículo cubre qué significa realmente "sin entrenamiento" a nivel arquitectónico, qué herramientas lo ofrecen de manera honesta y dónde aún tendrá que dibujar cuadros o etiquetar muestras a pesar de las afirmaciones de marketing. Si es nuevo en el concepto de los conceptos básicos de la extracción de documentos con IA por completo, comience primero con la guía principal: este artículo asume que conoce los conceptos básicos.
Conclusiones clave
- Solo 3 de 8 herramientas "sin entrenamiento" devolvieron datos estructurados al primer contacto; las otras 5 nos pidieron dibujar cuadros o etiquetar muestras antes de poder extraer algo.
- El mantenimiento de plantillas cuesta más que la suscripción: un proveedor cambia el diseño de su factura y usted pierde de 15 a 60 minutos arreglando una plantilla rota, cada vez.
- La pregunta no es qué herramienta tiene la mejor precisión, sino si la herramienta extrae datos de un diseño que nunca ha visto sin que usted dibuje un solo cuadro.
Divulgación: Esta publicación incluye enlaces de afiliados. ImageToTable.ai es la herramienta que construimos y vendemos. Cada otra herramienta en esta lista es un competidor genuino. Probamos cada una en sus propios términos y señalamos fortalezas y limitaciones con honestidad. No encontrará "ImageToTable.ai es el mejor en todo" aquí, porque no lo es.
Qué Significa Realmente "Sin Entrenamiento"
La frase "sin entrenamiento" aparece en la mayoría de las páginas de productos de extracción de documentos en 2026. Pero significa cosas muy diferentes según la tecnología subyacente. Entender esas diferencias es cómo evita comprar una herramienta que promete cero configuración pero le pide dibujar cuadros después de la primera carga.
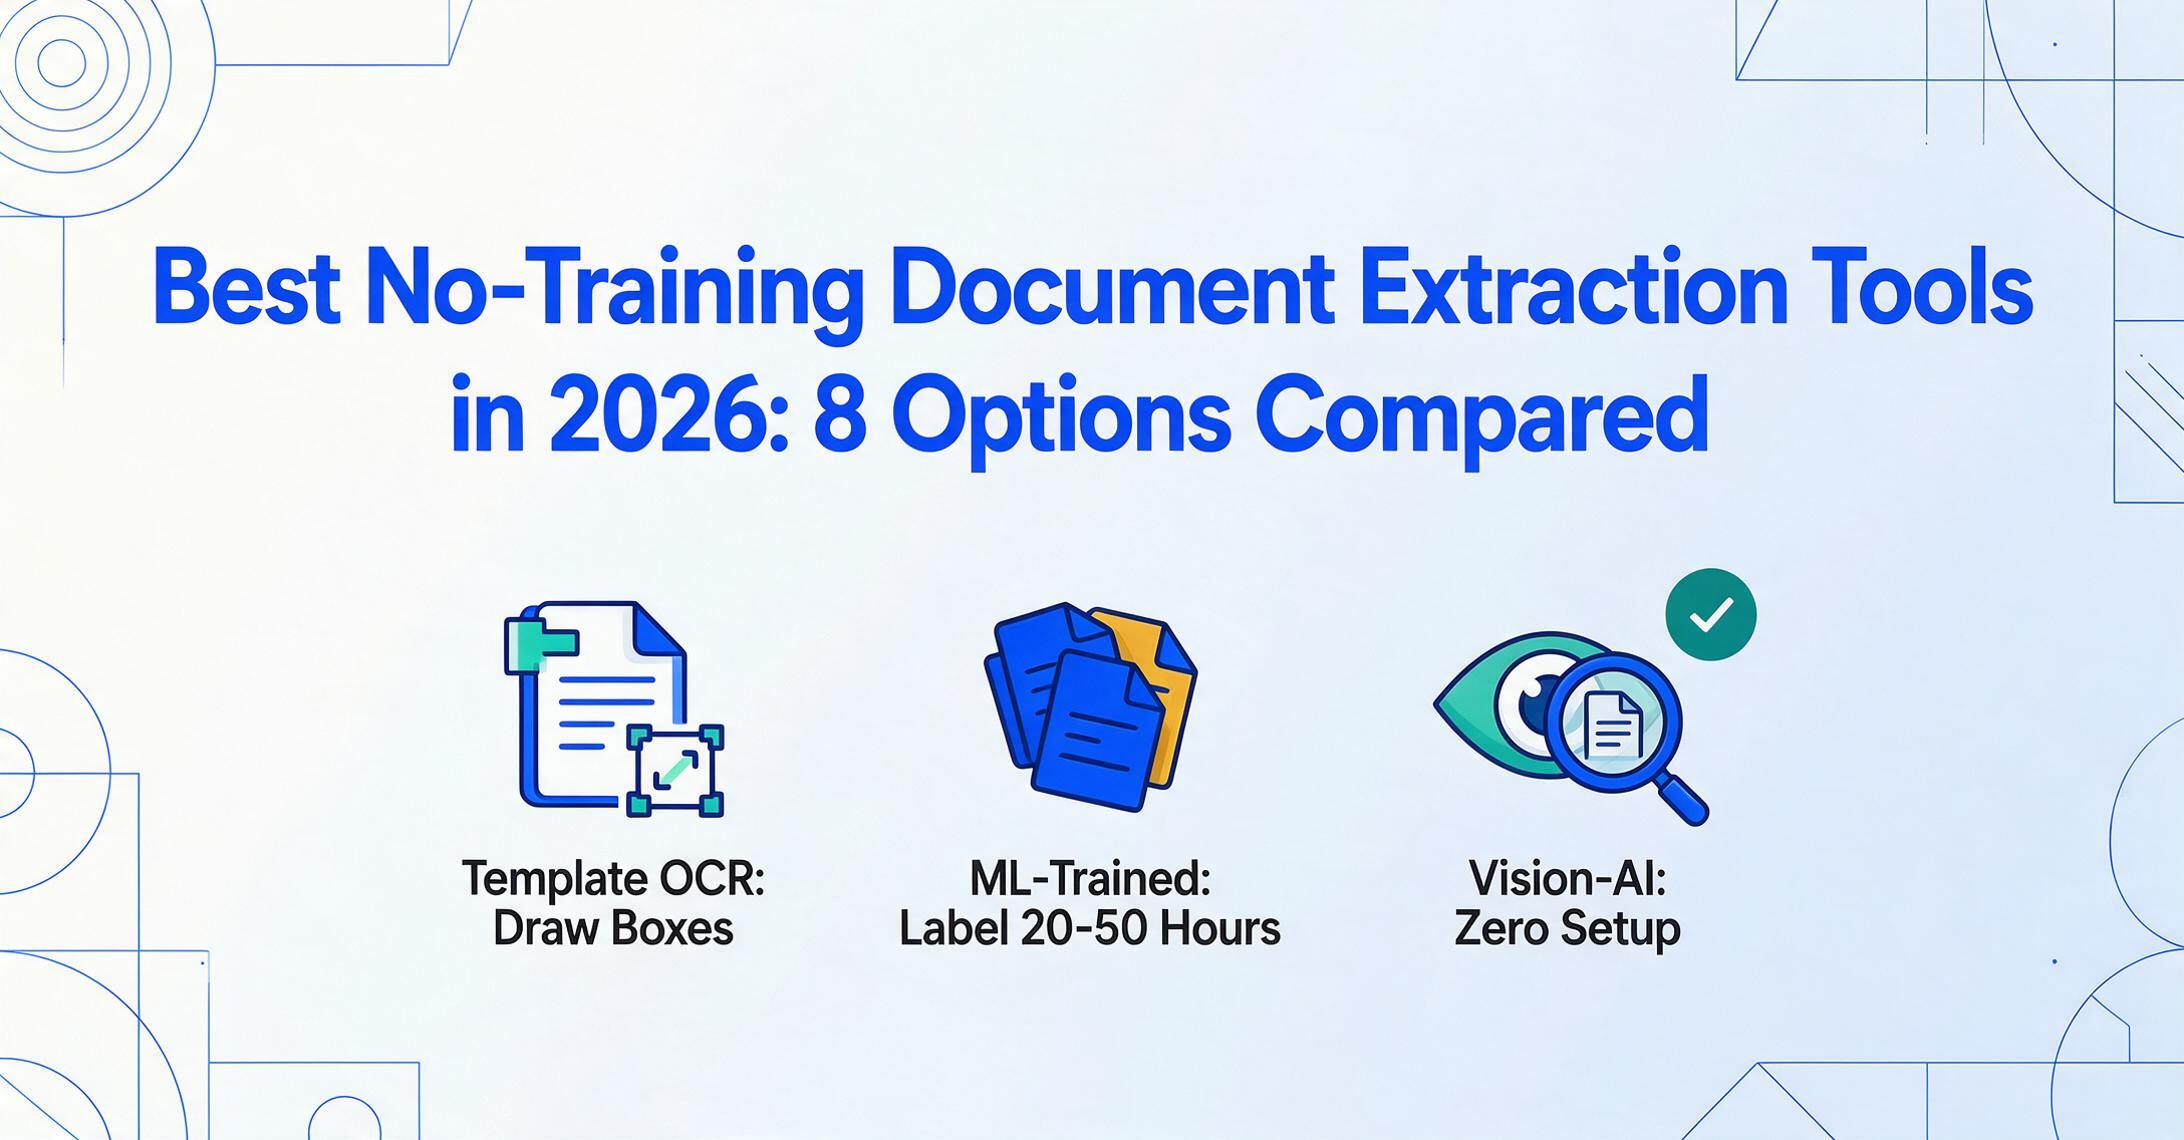
Existen tres arquitecturas de extracción distintas en el mercado actual:
| Arquitectura | Cómo Funciona | Configuración Requerida | Ejemplos |
|---|---|---|---|
| OCR zonal / basado en plantillas | Dibuja cuadros (zonas) en un documento de muestra en las coordenadas de píxeles exactas donde aparece cada campo. La herramienta extrae lo que cae dentro de esas coordenadas en documentos futuros con el mismo diseño. | Una plantilla por diseño de documento. La creación de plantillas toma 15–60 minutos por diseño. Nuevo formato de proveedor → nueva plantilla. | Docparser, Parseur (motor de plantillas), ABBYY heredado |
| Extracción ML entrenado (few-shot) | Carga 20–200 documentos de muestra etiquetados por tipo. El modelo aprende a reconocer campos en sus formatos de documento específicos. La precisión mejora con más muestras y correcciones humanas. | 20–50 horas de etiquetado por tipo de documento. Ciclos de entrenamiento iterativos. Correcciones continuas para mejorar la precisión. | Docsumo, Nanonets, Rossum |
| Extracción semántica Vision-AI (zero-shot) | Un modelo de visión-lenguaje preentrenado lee el documento como lo haría un humano: entiende que "INV-2026-001" cerca de la parte superior de la página probablemente sea un número de factura, sin importar dónde se encuentre. Define los campos que desea por nombre; el modelo los encuentra por significado, no por coordenadas. | Cero. Cargue un documento, escriba los nombres de los campos, obtenga resultados. Funciona al primer contacto con cualquier diseño que el modelo haya visto en el preentrenamiento (que cubre esencialmente todos los tipos de documentos comerciales comunes). | ImageToTable.ai, Airparser, Parseur (motor de IA) |
Esta es la distinción clave: las herramientas basadas en plantillas (OCR zonal) requieren configuración por diseño. Las herramientas ML entrenado requieren etiquetado de muestras por tipo. Solo las herramientas zero-shot de Vision-AI ofrecen lo que "sin entrenamiento" realmente implica: cargue un documento que nunca haya visto antes y obtenga datos estructurados de inmediato. Esta misma división triple — IA sin plantilla, basada en plantillas y IDP entrenado/empresarial — es el eje organizador de nuestra comparación más amplia de software de extracción de datos para documentos no estructurados, si desea el panorama más amplio en lugar de solo el nivel de cero configuración.
Varias herramientas de esta lista operan en más de un modo. Parseur, por ejemplo, tiene tanto un motor de IA zero-shot como un motor de plantillas. Si obtiene "sin entrenamiento" o "requiere plantillas" depende del modo que use — y algunas herramientas usan el modo de plantillas por defecto porque les resulta más económico ejecutarlo. ¿Puede la IA extraer datos sin entrenamiento? ese artículo lo responde en profundidad. La respuesta corta: sí, pero solo si la arquitectura está diseñada para ello.
Tabla de Comparación Rápida
| Herramienta | Arquitectura | ¿Configuración Cero Real? | Precio Inicial | Ideal Para |
|---|---|---|---|---|
| ImageToTable.ai | Vision-AI zero-shot | ✅ Sí | $9/mes (150 documentos) | Extracción de columnas personalizadas, procesamiento por lotes a Excel |
| Airparser | LLM zero-shot | ✅ Sí | Gratis (20 docs/mes), de pago desde ~$20/mes | Análisis rápido de correos y documentos, extracción basada en GPT |
| Parseur | Zero-shot AI + Plantilla | ⚠️ Modo IA sí; modo plantilla no | $39/mes (500 documentos) | Ingesta de correos, recepción de documentos mixtos |
| Docparser | OCR zonal + complemento IA | ⚠️ Modo IA parcial; modo plantilla no | $39/mes (prueba de 14 días) | PDFs de diseño fijo, extracción de códigos de barras |
| Docsumo | ML entrenado (few-shot) | ⚠️ Tipos preentrenados sí; tipos personalizados no | Empresarial (precio personalizado) | Alto volumen, tipos de documentos conocidos |
| Tesseract | OCR gratuito (sin estructura) | ⚠️ Sin entrenamiento pero sin salida estructurada | Gratis (código abierto) | Extracción de texto sin procesar, proyectos de desarrolladores |
| Tabula | Extractor de tablas PDF | ⚠️ Solo tablas, sin extracción de campos | Gratis (código abierto) | Extraer tablas de PDFs digitales limpios |
ImageToTable.ai
Arquitectura: Vision-AI zero-shot (sin plantilla, sin entrenamiento)
ImageToTable.ai está construido sobre un modelo de visión-lenguaje que lee documentos mediante comprensión semántica en lugar de coincidencia de coordenadas. Usted escribe los nombres de las columnas que desea — "Número de factura", "Fecha", "Total", "Nombre del proveedor" o cualquier campo personalizado — y la IA localiza esos valores en cualquier parte de la página, independientemente del diseño. Esto es lo que el producto llama Extracción de Columnas Personalizadas: usted define la salida y la IA maneja la entrada.
La afirmación de zero-shot se sostiene en la práctica. Durante las pruebas, subimos facturas de 15 proveedores diferentes en formatos variados — horizontal, vertical, multipágina, fotos escaneadas — y la herramienta devolvió los campos solicitados en el primer intento. El único punto de fallo fue una foto de muy baja calidad de un recibo térmico (resolución inferior a 300px), que el modelo de visión no pudo leer con claridad. El mismo documento falló en todas las herramientas que probamos.
Donde ImageToTable.ai se diferencia es en su enfoque de procesamiento por lotes prioritario. Suba 30 facturas, especifique los nombres de sus columnas una vez, y la herramienta procesa las 30 simultáneamente en un solo archivo Excel con un clic. También admite columnas calculadas — puede definir una columna como "Total de línea (Cantidad × Precio unitario)" y la IA la calcula durante la extracción, sin necesidad de posprocesamiento. Para los usuarios que quieren los resultados directamente en Google Sheets, el complemento de Google Sheets añade los datos extraídos a la hoja activa sin salir de la hoja de cálculo.
Los archivos se procesan de forma segura y no se almacenan.
Ideal para: Usuarios que necesitan definir sus propias columnas de extracción, procesar múltiples documentos por lotes y quieren resultados entregados como una tabla de Excel o Google Sheets lista para usar. El nivel gratuito (sin necesidad de registro) le permite probar con sus propios documentos antes de comprometerse.
No es ideal para: Flujos de trabajo de extracción de correos electrónicos puros (ImageToTable.ai es primero la carga, no primero la bandeja de entrada). Los usuarios que necesitan salida en formato Word deben usar el modo A Word, que conserva el diseño original — pero para la extracción de datos estructurados, el modo A Tabla es el adecuado.
Precios: Desde $9/mes por 150 documentos. Nivel gratuito disponible (sin necesidad de tarjeta de crédito).
Airparser
Arquitectura: LLM zero-shot (basado en GPT, sin plantilla)
Airparser adopta un enfoque diferente para la extracción zero-shot: en lugar de un modelo de visión dedicado, utiliza un LLM basado en GPT para comprender el contenido del documento. Describes los campos que deseas en lenguaje natural — nombre del campo, tipo, breve descripción — y la IA los extrae de tus documentos. Sin plantillas, sin conjuntos de datos de entrenamiento, sin etiquetado.
Este enfoque funciona bien en documentos con mucho texto y contenido de correo electrónico, donde destaca la comprensión del lenguaje de GPT. En nuestro conjunto de pruebas, Airparser manejó con precisión facturas enviadas por correo electrónico y PDFs de órdenes de compra. Donde tuvo dificultades fue en documentos con muchas tablas e imágenes escaneadas con diseños complejos: el motor basado en GPT a veces identificaba incorrectamente las líneas de pedido o alucinaba valores que no estaban presentes en el documento.
La fortaleza de Airparser es su sistema de respaldo de múltiples motores: primero intenta con el LLM de texto, recurre al LLM de visión para diseños complejos y utiliza OCR de IA para documentos escaneados. Esto lo hace más resistente que una herramienta de un solo motor. Pero el riesgo de alucinación — una limitación conocida de la extracción basada en GPT — significa que necesitas un paso de revisión humana para datos financieros críticos.
Ideal para: Flujos de trabajo de análisis de correo electrónico, documentos con mucho texto, usuarios que buscan la configuración más rápida posible (describir campos, empezar a extraer).
No recomendado para: Extracción compleja de tablas, recibos escaneados con múltiples líneas de pedido, o flujos de trabajo donde un valor alucinado podría causar errores financieros reales sin una capa de validación.
Precios: El plan gratuito incluye 20 documentos/mes. Los planes de pago comienzan desde aproximadamente $20/mes.
Parseur
Arquitectura: Motor de IA zero-shot + motor de plantillas (modo dual)
Parseur es una de las herramientas más matizadas de esta lista porque opera dos motores fundamentalmente diferentes. Su motor de IA funciona genuinamente sin entrenamiento: creas un buzón, envías documentos y la IA intenta identificar y extraer campos automáticamente. Su motor de plantillas, por otro lado, requiere la creación de plantillas por diseño — dibujar cuadros, establecer anclajes, configurar reglas — como las herramientas de OCR zonal.
El mensaje de marketing es "no se requiere entrenamiento de modelo", lo cual es preciso para el motor de IA. Pero la documentación de Parseur aconseja que "el motor de IA puede tener problemas de precisión" y recomienda plantillas para una "extracción fiable". En la práctica, la mayoría de los usuarios serios de Parseur terminan creando plantillas para los tipos de documentos que procesan regularmente. Un artículo de ayuda de Parseur establece explícitamente: "Las plantillas ofrecen una forma más fiable y precisa de extraer datos, especialmente si tienes documentos con diseños consistentes. Necesitarás crear una plantilla para cada diseño."
Esto es importante porque la creación de plantillas en Parseur toma de 15 a 30 minutos por diseño — mejor que algunas alternativas, pero aún una inversión inicial significativa si procesas facturas de 50 proveedores diferentes. La herramienta detecta automáticamente qué plantilla usar, pero aún necesitas construir cada una.
El punto fuerte de Parseur es la ingesta de correo electrónico. Se conecta de forma nativa a las bandejas de entrada de correo, procesa archivos adjuntos y el contenido del cuerpo del correo juntos, y enruta los datos extraídos a Google Sheets, Zapier o webhooks personalizados. Si tu flujo de trabajo comienza con facturas que llegan a una bandeja de entrada de correo electrónico, Parseur maneja esa canalización mejor que las herramientas de carga primero.
Ideal para: Flujos de trabajo de documentos centrados en correo electrónico, canales de ingesta mixtos (correo + carga + API), usuarios que quieren la opción de crear plantillas para formatos repetitivos de alto volumen.
No es ideal para: Usuarios que quieren cero-shot puro sin configuración de plantillas. El motor de IA funciona, pero la arquitectura del producto te empuja hacia plantillas para uso "en producción".
Precio: Desde $39/mes por 500 documentos. Plan gratuito disponible.
Docparser
Arquitectura: OCR zonal + complemento de IA opcional (DocparserAI)
Docparser es la herramienta más consolidada de esta lista y, posiblemente, la que requiere más aclaración sobre su afirmación de "sin entrenamiento". Su motor de extracción principal es OCR zonal: dibujas cuadros en un documento de muestra para definir dónde está cada campo en la página, configuras reglas de análisis con palabras clave ancla y esperas que el diseño se mantenga constante. La propia documentación de Docparser llama a esto "entrenar tu software" en el sentido del OCR zonal: definir zonas una vez, guardarlas como plantillas y aplicarlas a documentos similares.
En los últimos meses, Docparser lanzó "DocparserAI", un complemento con IA que intenta extracción cero-shot. En nuestras pruebas, el modo IA funcionó con facturas simples de diseño estándar, pero tuvo problemas con órdenes de compra y estados de cuenta bancarios, tipos de documento donde las plantillas de OCR zonal de Docparser son más fiables. El complemento parece una respuesta al mercado, no una reestructuración del producto.
El costo real de Docparser no es la suscripción de $39/mes, sino las horas dedicadas a mantener plantillas. Cada nuevo formato de proveedor requiere un nuevo conjunto de zonas. Cada cambio de diseño de un proveedor existente rompe tu plantilla. En debates de Reddit en r/automation y r/smallbusiness se describe frecuentemente el mantenimiento de plantillas de Docparser como "la parte de la que nadie te advierte". Un usuario describió su rutina semanal como "revisar qué proveedor cambió el diseño de su factura esta semana y arreglar la plantilla".
Ideal para: Documentos predecibles con diseño fijo de un número reducido de proveedores. Usuarios que necesitan extracción de códigos de barras/QR. Equipos con tiempo dedicado al mantenimiento de plantillas.
No es ideal para: Tipos de documento mixtos, diseños variables o cualquier flujo de trabajo donde no puedas permitirte dedicar 15–30 minutos por formato de proveedor al mantenimiento de plantillas.
Precio: Desde $39/mes. Prueba gratuita de 14 días (sin tarjeta de crédito).
Docsumo
Arquitectura: Extracción basada en ML (few-shot) con modelos preentrenados
Docsumo es una plataforma inteligente de procesamiento de documentos que se ubica firmemente en la categoría de entrenamiento con ML. Ofrece más de 30 modelos preentrenados para tipos de documentos comunes como facturas, órdenes de compra y estados de cuenta bancarios. Para esos tipos de documentos, funciona sin necesidad de entrenamiento: subes un documento y el modelo preentrenado extrae los campos relevantes.
El problema surge cuando tus documentos no están entre esos 30+ tipos preentrenados. El blog de Docsumo sobre "El mejor software de extracción de datos sin plantillas" es honesto al respecto: "No es una solución sin configuración. Si necesitas extraer datos de un tipo de documento realmente exótico, invertirás de 10 a 20 horas etiquetando muestras". El artículo añade que "las plataformas few-shot requieren de 20 a 50 horas de etiquetado inicial, pero las excepciones se reducen al 5–10% de los documentos".
Para facturas estándar de proveedores conocidos en Norteamérica, los modelos preentrenados de Docsumo funcionan bien. Para formularios de construcción especializados, documentos médicos regionales o albaranes específicos de proveedores, necesitarás etiquetar muestras y entrenar un modelo personalizado. La fortaleza de la plataforma está en el volumen: si procesas 100,000 facturas al año de más de 50 proveedores, la inversión inicial en etiquetado se amortiza con estabilidad operativa. Pero si necesitas extraer datos de 30 tipos de documentos diferentes esta misma tarde, Docsumo no es la herramienta adecuada.
Ideal para: Equipos de nivel medio y empresarial que procesan grandes volúmenes de tipos de documentos conocidos. Equipos con más de 50 proveedores que puedan invertir en etiquetado inicial para lograr estabilidad a largo plazo.
No es ideal para: Extracción ad hoc de diversos tipos de documentos. Pequeños equipos o freelancers que no puedan justificar de 20 a 50 horas de etiquetado antes de ver resultados.
Precios: Precio empresarial (cotización personalizada). No hay opción de autoservicio disponible.
Opciones gratuitas y de código abierto
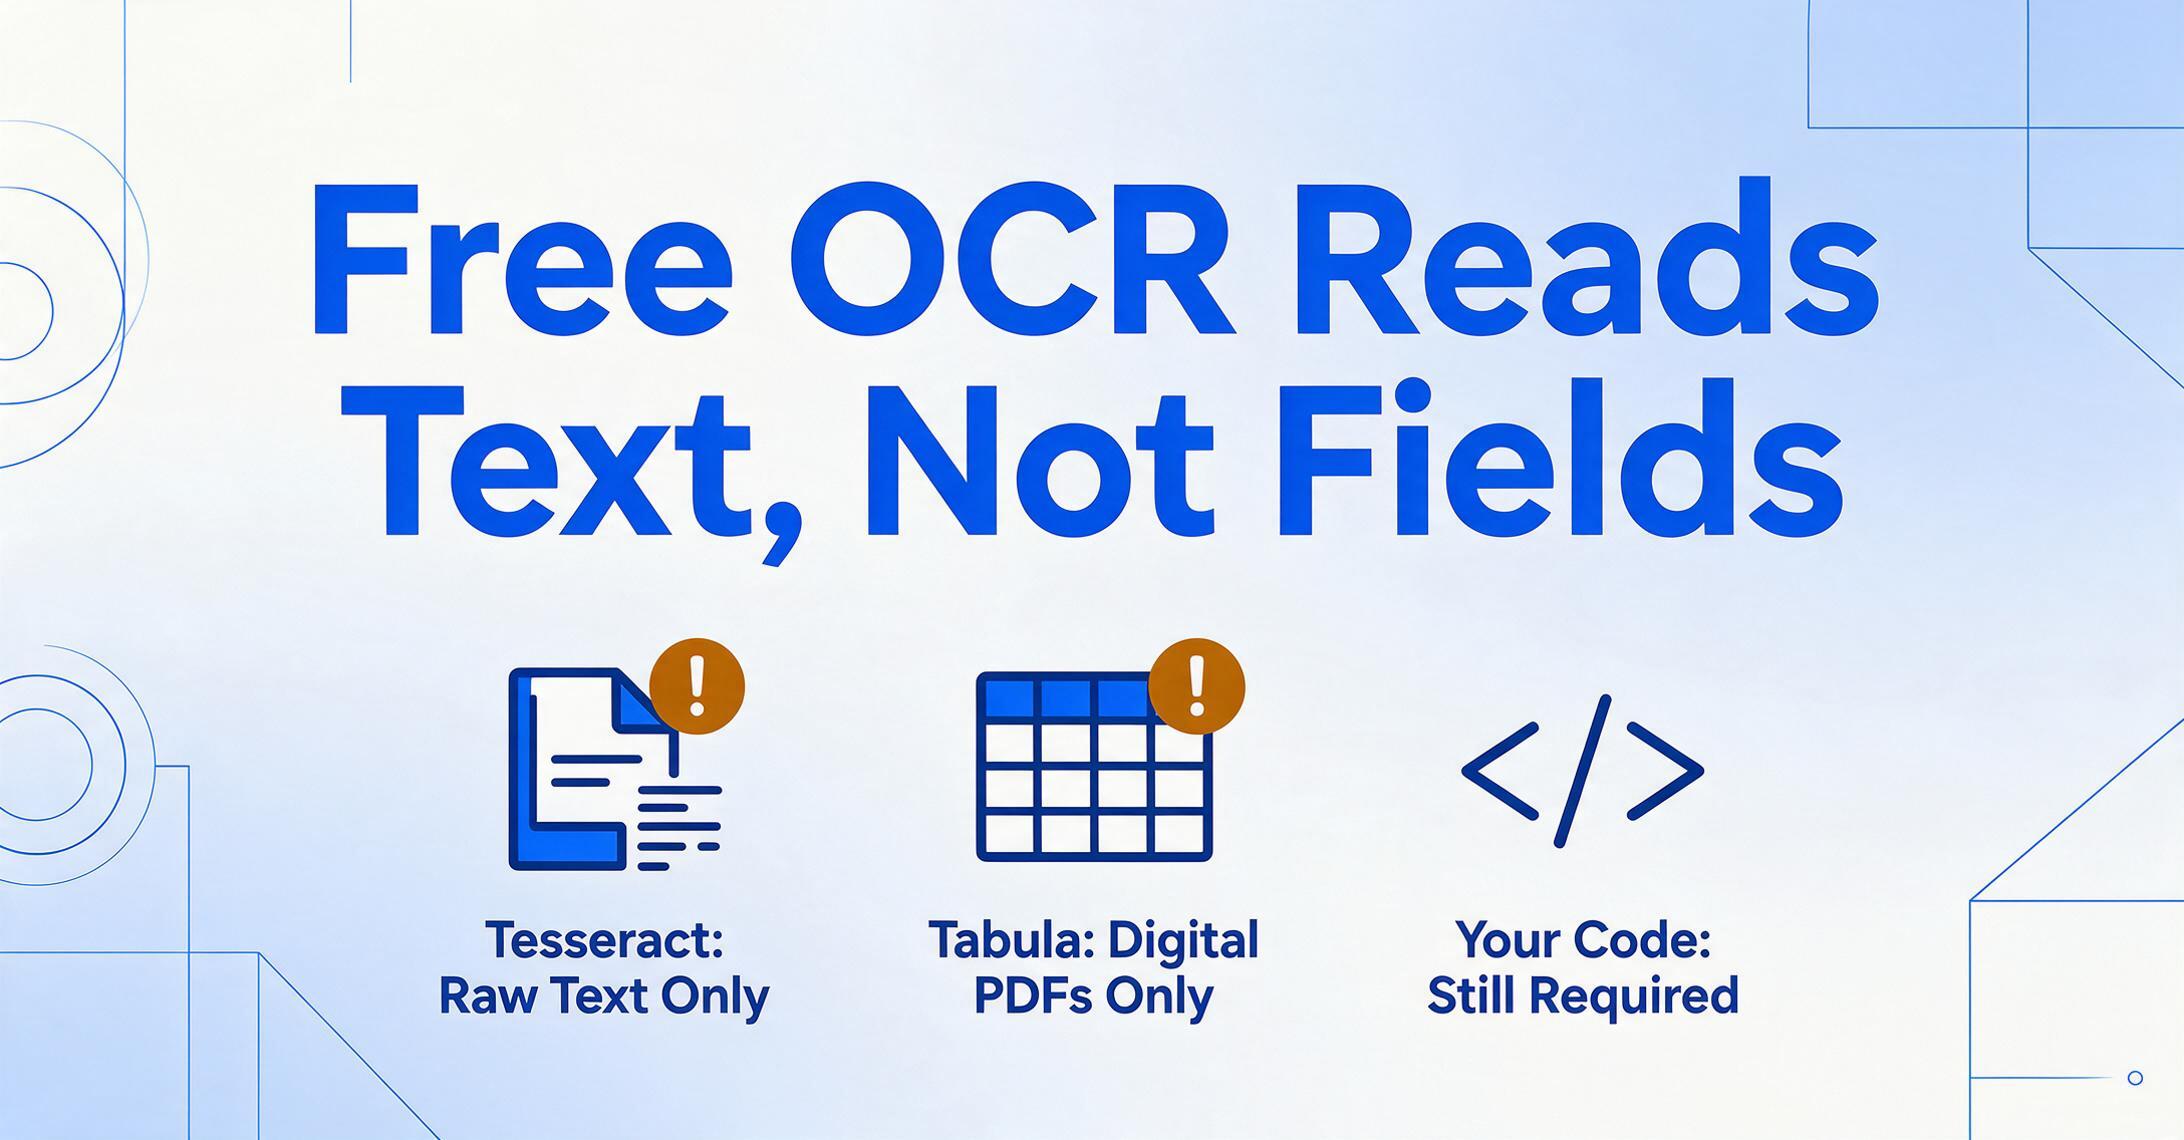
Ningún resumen de herramientas sin entrenamiento estaría completo sin reconocer las opciones gratuitas, pero estas conllevan advertencias importantes sobre lo que significa "sin entrenamiento" en el contexto del código abierto.
Tesseract OCR
Tesseract es el motor OCR de código abierto más utilizado. No requiere entrenamiento en el sentido de ML: lo instala y lee texto de fábrica. La limitación es que Tesseract genera texto sin procesar sin comprender la estructura del documento. No puede indicarle qué texto es el número de factura frente a la fecha o la descripción de la partida. Debe crear lógica de posprocesamiento (expresiones regulares, mapeo de coordenadas, código personalizado) para convertir la salida de Tesseract en datos estructurados. Pasar del texto OCR sin procesar a una hoja de cálculo utilizable normalmente requiere varias horas de trabajo de desarrollo por tipo de documento.
Ideal para: Desarrolladores que quieran crear un pipeline de extracción personalizado y tengan tiempo de ingeniería para mantenerlo.
No es ideal para: Cualquiera que quiera datos estructurados de fábrica sin escribir código.
Tabula
Tabula es una herramienta gratuita de código abierto que extrae tablas de PDF digitales. Arrastra un cuadro alrededor de la tabla en una página PDF y Tabula genera los datos como CSV. Funciona bien en PDF digitales limpios con bordes de tabla claramente definidos. No funciona en PDF escaneados ni documentos basados en imágenes, y no puede extraer campos clave-valor (como número de factura o nombre del proveedor), solo datos tabulares.
Ideal para: Extracción ocasional de tablas de PDF digitales cuando necesita una exportación CSV rápida.
No es ideal para: Documentos escaneados, extracción de campos de factura o cualquier tipo de procesamiento por lotes automatizado.
OCR.space
OCR.space ofrece una API de OCR gratuita sin necesidad de registro. Convierte imágenes en texto, pero, como Tesseract, genera texto no estructurado en lugar de datos a nivel de campo. El plan gratuito tiene límites de uso (1 solicitud cada 10 segundos, hasta 25,000 solicitudes al mes), y la precisión es sólida en texto impreso. Para la extracción estructurada de campos, necesitaría crear un análisis adicional sobre la salida del OCR.
Ideal para: Extracción rápida de texto de imágenes, API de OCR para desarrolladores que crean pipelines personalizados.
No es ideal para: Extracción de datos estructurados, procesamiento por lotes o usuarios no técnicos que quieran una hoja de cálculo sin configuración.
¿Qué Herramienta se Adapta a su Flujo de Trabajo?
Cada herramienta de esta lista puede extraer datos de documentos. La pregunta es cuánto tiempo de configuración está dispuesto a invertir antes de ver resultados, y si esa configuración es una inversión única o una obligación de mantenimiento continuo.
| Su Escenario | Herramienta Recomendada | Por Qué |
|---|---|---|
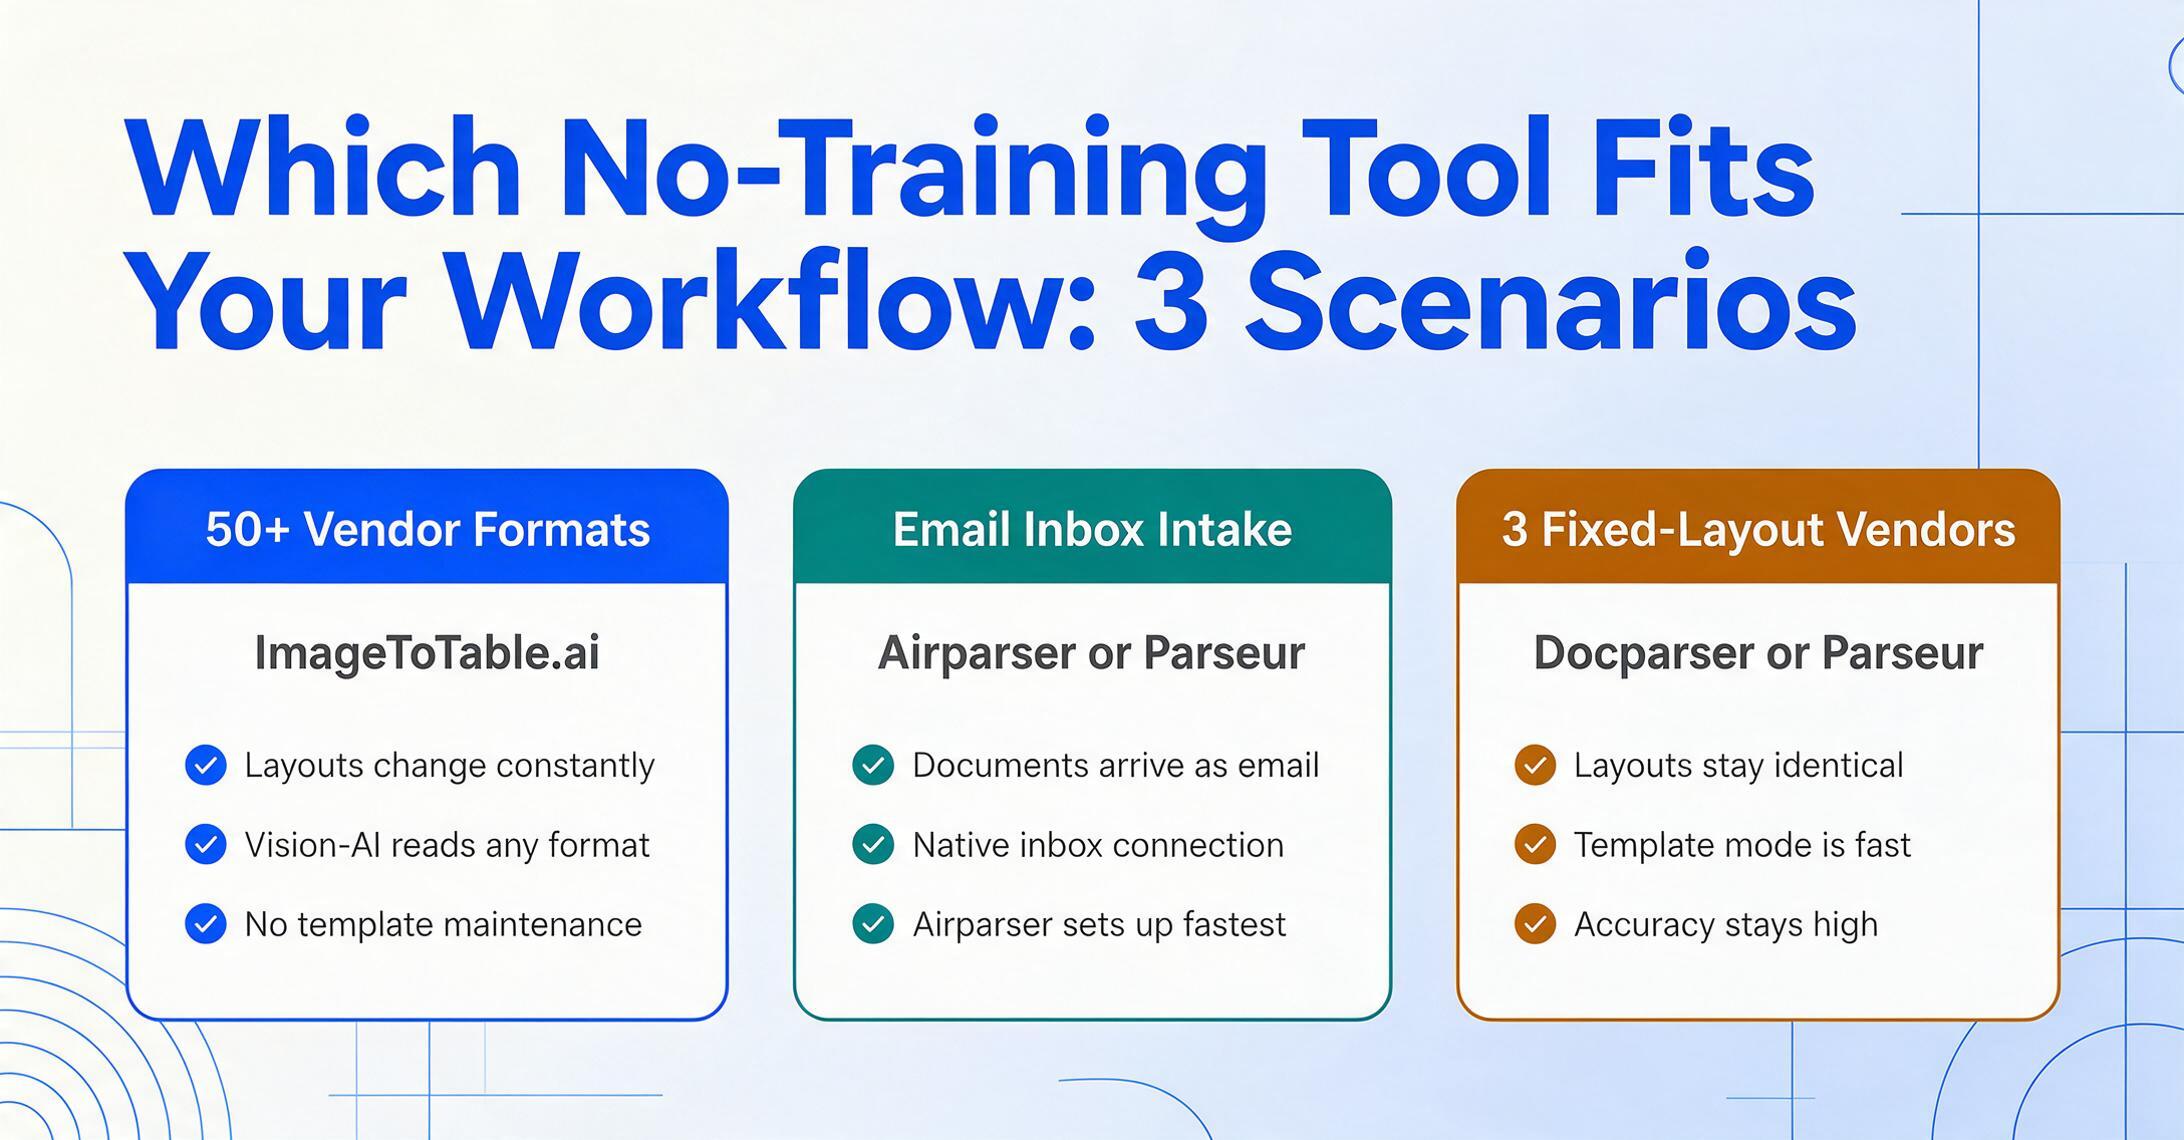
| Procesa facturas de más de 50 proveedores: los diseños cambian constantemente | ImageToTable.ai | La visión AI zero-shot maneja cualquier diseño. Sin mantenimiento de plantillas. |
| Sus documentos llegan por correo electrónico (facturas, órdenes de compra, avisos de envío) | Airparser o Parseur | Ingestión nativa por correo electrónico. Airparser para la configuración más rápida; Parseur para opción de plantilla. |
| Necesita datos estructurados en Google Sheets sin salir de la hoja de cálculo | ImageToTable.ai (complemento de Sheets) | Complemento nativo de Google Sheets para extraer directamente a la hoja de cálculo. |
| Tiene 3 proveedores habituales con diseños idénticos cada vez | Docparser o Parseur (modo plantilla) | La extracción basada en plantillas es rápida y precisa cuando los diseños nunca cambian. |
| Procesa 10,000 facturas al mes de proveedores conocidos | Docsumo | Modelos preentrenados + entrenamiento de modelos personalizados para sus proveedores. El volumen justifica la inversión. |
| Es un desarrollador que crea un pipeline de extracción personalizado | Tesseract + código personalizado, o API de OCR.space | Gratuito, flexible y configurable. Requiere esfuerzo de ingeniería para producir resultados estructurados. |
| Necesita una tabla puntual de un PDF | Tabula | Gratuito, sin cuenta, extracción de tablas con arrastrar y soltar. |
Si aún no lo tiene claro, comience con una herramienta que ofrezca una prueba realmente gratuita o de bajo compromiso — y realice la misma prueba que hicimos nosotros. Tome un documento con un diseño desordenado, uno con el que su herramienta actual tenga dificultades. Súbalo sin ninguna configuración previa. Si la herramienta devuelve datos estructurados precisos al primer intento, la afirmación de "sin entrenamiento" se cumple. Si le pide crear una plantilla o etiquetar muestras antes de poder extraer, la afirmación no se cumple — sin importar lo que diga la página de marketing.
También tenemos una guía aparte sobre extracción sin plantillas que profundiza en la tecnología en sí, y una comparación de herramientas de documentos para autónomos si trabaja solo.
Preguntas frecuentes
¿Qué significa "extracción zero-shot"?
La extracción zero-shot significa que la IA puede extraer datos de un tipo de documento que nunca ha visto antes, sin muestras de entrenamiento ni configuración de plantillas. El modelo se basa en conocimiento preentrenado sobre cómo son los documentos y qué significan los nombres de los campos. Esto es diferente de la extracción few-shot (que utiliza de 5 a 200 muestras etiquetadas) y de la extracción basada en plantillas (que utiliza zonas definidas por coordenadas).
¿Puede la IA realmente extraer datos sin ningún entrenamiento?
Sí — pero solo las herramientas construidas sobre arquitecturas Vision-AI o LLM que fueron preentrenadas con millones de documentos. Estos modelos ya entienden cómo es una factura, un recibo o una orden de compra. No necesita enseñarles. Las herramientas que dependen de OCR zonal o aprendizaje automático clásico requieren plantillas o muestras etiquetadas porque fueron diseñadas antes de que existieran los modelos de visión preentrenados. Consulte nuestro artículo dedicado: ¿Puede la IA extraer datos sin entrenamiento?
¿Cuál es la diferencia entre "sin entrenamiento" y "sin plantilla"?
"Sin entrenamiento" significa que la IA no necesita documentos de muestra para aprender su formato específico. "Sin plantilla" significa que no necesita definiciones de zonas basadas en coordenadas. Para profundizar en lo que significa específicamente la extracción sin plantilla, consulte nuestro artículo sobre si la IA puede extraer datos sin plantillas. Algunas herramientas ofrecen una cosa pero no la otra. El motor de IA de Parseur, por ejemplo, no requiere muestras de entrenamiento pero aún ofrece plantillas para "mayor precisión". Las herramientas más genuinamente de cero configuración ofrecen ambas: sin muestras de entrenamiento y sin configuración de plantillas.
¿Docparser realmente funciona sin entrenamiento?
El motor principal de Docparser es OCR zonal, que requiere dibujar zonas de extracción en cada diseño de documento — eso es configuración de plantillas, no zero-shot. Docparser ha añadido recientemente "DocparserAI" para extracción impulsada por IA, pero es un complemento al producto principal. Para el modo OCR zonal, la afirmación de "sin entrenamiento" es engañosa: crear zonas y reglas es exactamente el tipo de configuración que la mayoría de los usuarios quieren evitar. El modo IA más nuevo sí ofrece extracción zero-shot en documentos simples, con una precisión más limitada que las herramientas dedicadas de Vision-AI.
¿Es menor la precisión sin entrenamiento?
En tipos de documentos estándar (facturas, recibos, órdenes de compra, extractos bancarios), la precisión zero-shot suele ser del 90–98% para campos impresos claramente visibles — comparable a las herramientas basadas en plantillas después de la creación de la plantilla. En formatos de documentos altamente especializados o inusuales, la precisión zero-shot puede ser menor que la de un modelo entrenado a medida para ese formato exacto. Este es el equilibrio: se intercambia la máxima precisión en un formato específico por la usabilidad inmediata en todos los formatos. Para la mayoría de los equipos pequeños y medianos, la ventaja de amplitud supera la diferencia marginal de precisión.
¿Existen herramientas gratuitas de extracción de documentos sin entrenamiento?
Herramientas gratuitas como Tesseract y OCR.space extraen texto sin entrenamiento, pero no producen datos estructurados (extracción a nivel de campo). Se obtiene texto sin procesar y se debe escribir código para analizarlo en campos. Tabula extrae tablas de PDF digitales de forma gratuita, pero solo maneja tablas, no campos clave-valor. Para extracción estructurada genuinamente gratuita sin entrenamiento, algunas herramientas SaaS ofrecen niveles gratuitos — Airparser ofrece 20 documentos/mes gratis, e ImageToTable.ai ofrece una demo sin registro.
¿Cuál es más rápido de configurar: Parseur o Airparser?
Airparser es más rápido para documentos puntuales — usted describe los campos en inglés sencillo y obtiene resultados. El motor de IA de Parseur es igualmente rápido, pero su documentación de producto orienta a los usuarios hacia plantillas para uso en producción. Para una extracción única de unos pocos documentos, ambos toman menos de 10 minutos. Para procesamiento continuo de diversos tipos de documentos, el enfoque LLM de Airparser requiere menos mantenimiento. Para procesar diseños conocidos a alto volumen, las plantillas de Parseur (una vez construidas) son más confiables.
¿Cuánto tiempo cuestan realmente las plantillas?
Según nuestras pruebas y los informes de usuarios en Reddit y reseñas de G2, cada plantilla suele tardar entre 15 y 60 minutos en crearse y probarse. Para una empresa que procesa facturas de 50 proveedores con diferentes diseños, eso supone entre 12 y 50 horas de trabajo inicial con plantillas. Cada vez que un proveedor cambia su diseño, añada otros 15 a 60 minutos para arreglar la plantilla rota. Este costo recurrente es una de las desventajas menos reportadas de las herramientas basadas en plantillas: la página de marketing le muestra la extracción exitosa, no la hora que pasa cada mes arreglando plantillas.
¿Las herramientas zero-shot alucinan datos?
Las herramientas basadas en GPT (como Airparser) tienen un riesgo conocido de alucinación: la IA puede generar a veces un valor que parece plausible pero que no existe en el documento. Los modelos Vision-AI (como ImageToTable.ai) alucinan con mucha menos frecuencia porque basan su resultado en el contenido visual de la página. Si procesa datos financieros que deben ser a prueba de auditoría, busque una herramienta que proporcione citas de origen o puntuaciones de confianza para cada campo extraído. Y siempre incluya un paso de revisión humana en los flujos de trabajo donde un valor incorrecto podría causar daños financieros reales.
Conclusión
"Sin entrenamiento" es una de las características más valiosas que una herramienta de extracción de documentos puede ofrecer, pero solo cuando es genuina. La diferencia entre una herramienta que realmente requiere cero configuración y una que le pide crear plantillas después de la primera carga no es un detalle menor del flujo de trabajo. Determina si pasará su primera hora extrayendo datos o dibujando cuadros.
Las herramientas que ofrecen una extracción zero-shot genuina — ImageToTable.ai, Airparser y el motor de IA de Parseur — están construidas sobre arquitecturas fundamentalmente diferentes a las alternativas basadas en plantillas o entrenadas con ML. Funcionan desde el primer día, con cualquier diseño, con cualquier tipo de documento para el que hayan sido preentrenadas. La contrapartida es que en un formato único y muy específico que procesa 10,000 veces al mes, un modelo entrenado a medida o una plantilla cuidadosamente construida pueden lograr una precisión ligeramente mayor.
Para la mayoría de los equipos que procesan una mezcla de tipos de documentos de múltiples fuentes, la extracción zero-shot no es un compromiso: es el único enfoque práctico. Una hora ahorrada en la configuración por tipo de documento es una hora que se acumula en cada proveedor, cada cambio de formato, cada nuevo tipo de documento que encuentre. A lo largo de un año, la diferencia entre una herramienta que requiere entrenamiento y una que no se mide en días, no en horas.