Beste Dokumentenextraktions-Tools ohne Training
im Jahr 2026: 8 Optionen im Vergleich
Wir haben acht Dokumentenextraktions-Tools getestet, die eine Einrichtung ohne Vorkenntnisse versprechen – keine Musterbeschriftung, kein Modelltraining, keine Vorlagenkonfiguration. Jedes Tool erhielt dieselben 30 Dokumente (Rechnungen, Belege, Bestellungen und Kontoauszüge in verschiedenen Layouts) und sollte beim ersten Kontakt dieselben Felder extrahieren. Wir haben die Genauigkeit gemessen, die Sie am ersten Tag erhalten – nicht nach einer Woche Einrichtungszeit. Dieser Artikel behandelt, was „ohne Training“ auf architektonischer Ebene tatsächlich bedeutet, welche Tools dies ehrlich umsetzen und wo Sie trotz der Marketingversprechen weiterhin Boxen zeichnen oder Muster beschriften müssen. Wenn Sie mit dem Konzept der Grundlagen der KI-Dokumentenextraktion noch nicht vertraut sind, beginnen Sie zuerst mit dem Hub-Leitfaden – dieser Artikel setzt Grundkenntnisse voraus.
Wichtigste Erkenntnisse
- Nur 3 von 8 „No-Training“-Tools lieferten beim ersten Kontakt strukturierte Daten – die anderen 5 forderten uns auf, Boxen zu zeichnen oder Muster zu beschriften, bevor sie etwas extrahieren konnten.
- Die Vorlagenwartung kostet mehr als das Abonnement – ein Anbieter ändert sein Rechnungslayout und Sie verlieren jedes Mal 15 bis 60 Minuten mit der Reparatur einer defekten Vorlage.
- Die Frage ist nicht, welches Tool die beste Genauigkeit hat – sondern ob das Tool Daten aus einem Layout extrahiert, das es noch nie gesehen hat, ohne dass Sie eine einzige Box zeichnen müssen.
Offenlegung: Dieser Beitrag enthält Affiliate-Links. ImageToTable.ai ist das Tool, das wir entwickelt haben und verkaufen. Jedes andere Tool auf dieser Liste ist ein echter Konkurrent. Wir haben jedes einzelne nach seinen eigenen Maßstäben getestet und weisen Stärken und Schwächen ehrlich auf. Sie werden hier kein „ImageToTable.ai ist bei allem am besten" finden – denn das ist es nicht.
Was „Kein Training" tatsächlich bedeutet
Der Begriff „kein Training" erscheint 2026 auf den meisten Produktseiten zur Dokumentenextraktion. Doch er bedeutet je nach zugrunde liegender Technologie sehr Unterschiedliches. Diese Unterschiede zu verstehen, ist der Schlüssel, um nicht ein Tool zu kaufen, das zwar null Einrichtung verspricht, aber nach dem ersten Upload das Zeichnen von Boxen verlangt.
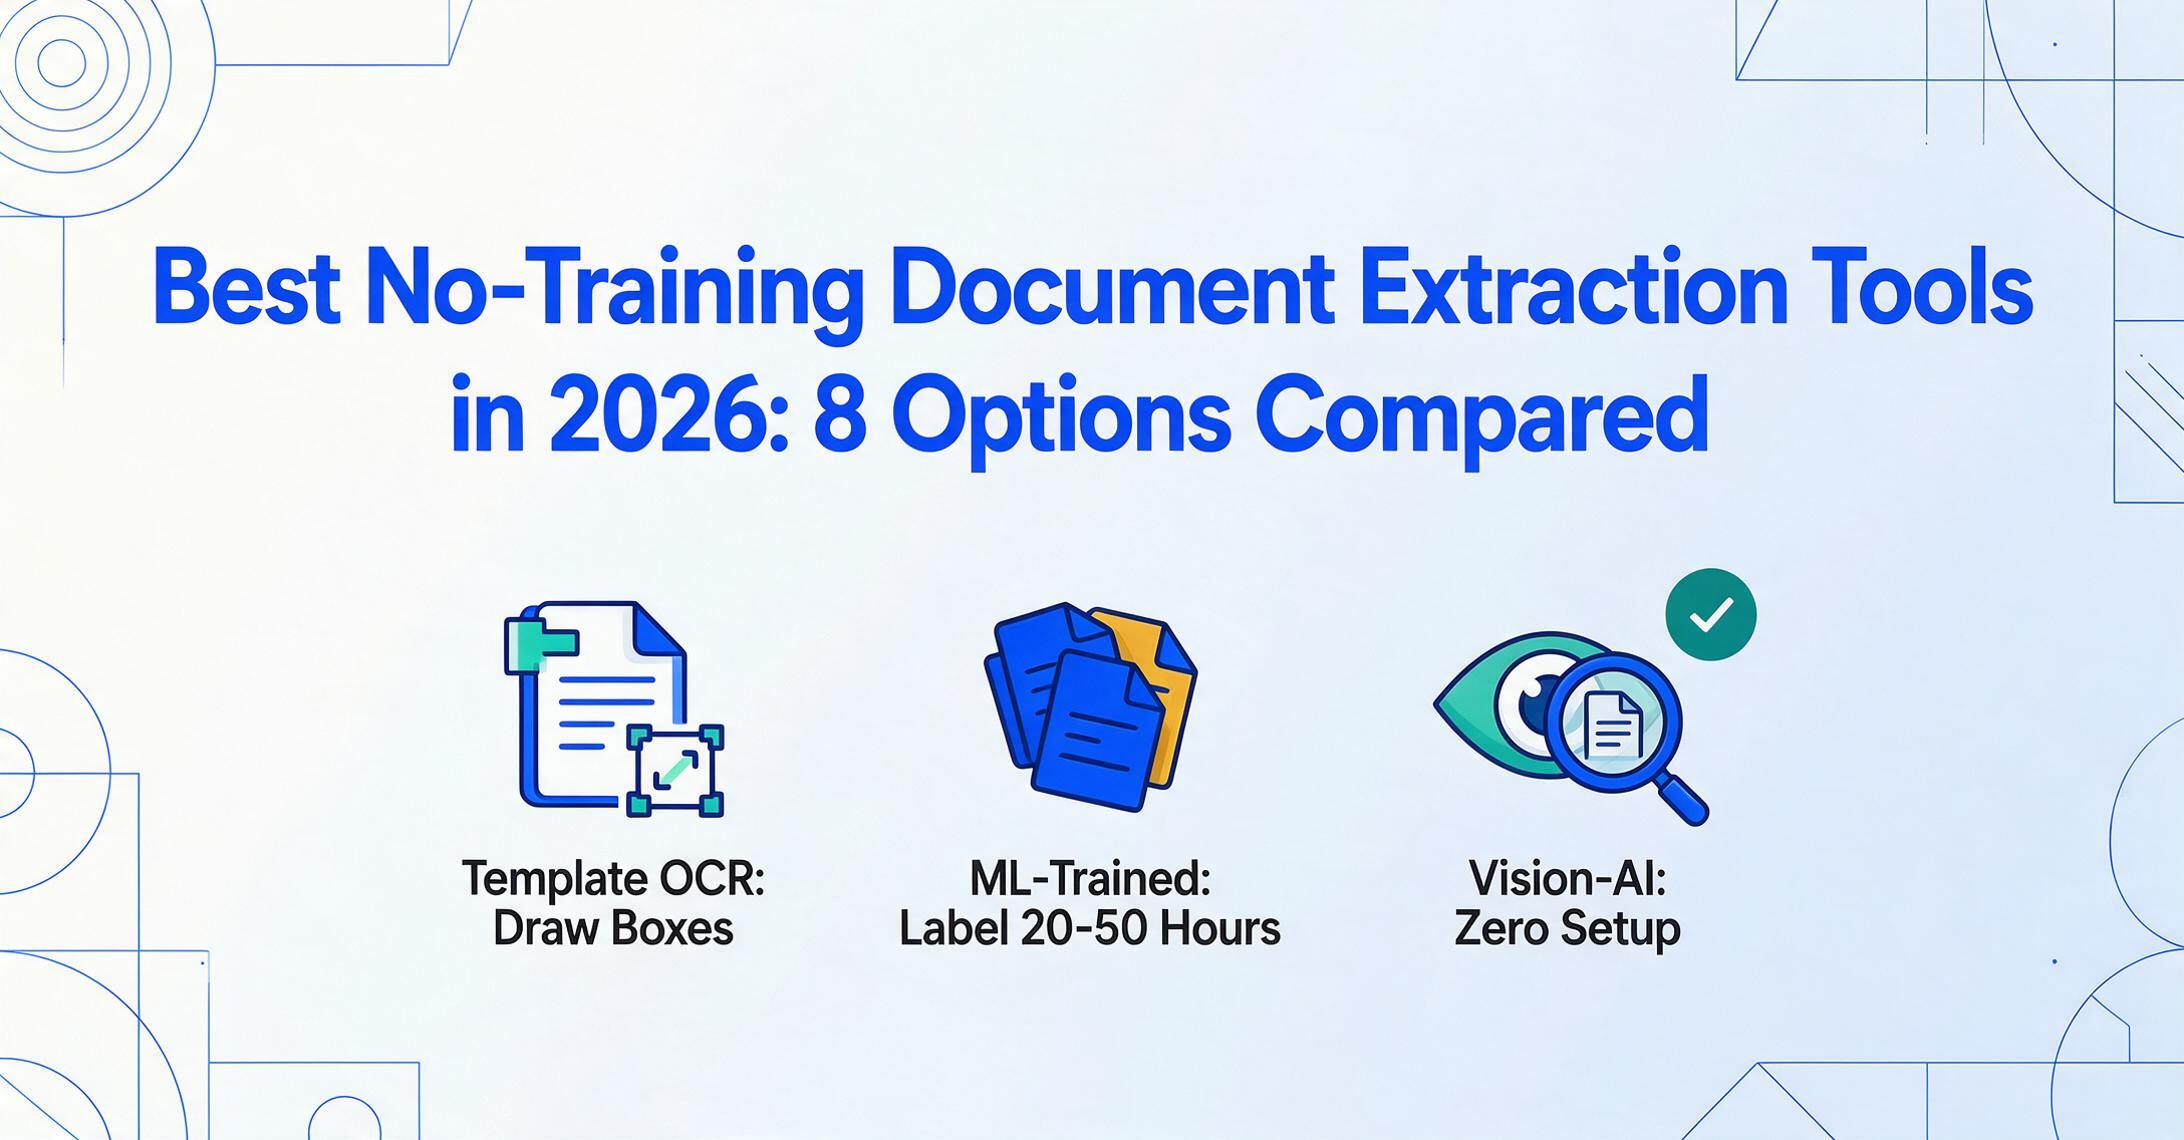
Es gibt heute drei verschiedene Extraktionsarchitekturen auf dem Markt:
| Architektur | Funktionsweise | Erforderliche Einrichtung | Beispiele |
|---|---|---|---|
| Zonen-OCR / templatebasiert | Sie zeichnen Boxen (Zonen) auf einem Musterdokument an den exakten Pixelkoordinaten, an denen jedes Feld erscheint. Das Tool extrahiert alles, was bei künftigen Dokumenten mit demselben Layout innerhalb dieser Koordinaten liegt. | Eine Vorlage pro Dokumentlayout. Die Vorlagenerstellung dauert 15–60 Minuten pro Layout. Neues Lieferantenformat → neue Vorlage. | Docparser, Parseur (Vorlagen-Engine), Legacy-ABBYY |
| ML-geschulte Extraktion (Few-shot) | Sie laden 20–200 beschriftete Musterdokumente pro Typ hoch. Das Modell lernt, Felder auf Ihren spezifischen Dokumentformaten zu erkennen. Die Genauigkeit verbessert sich mit mehr Mustern und manuellen Korrekturen. | 20–50 Stunden Beschriftung pro Dokumenttyp. Iterative Trainingszyklen. Laufende Korrekturen zur Verbesserung der Genauigkeit. | Docsumo, Nanonets, Rossum |
| Vision-AI semantische Extraktion (Zero-Shot) | Ein vortrainiertes Vision-Language-Modell liest das Dokument so, wie es ein Mensch tun würde – es versteht, dass „INV-2026-001" oben auf der Seite wahrscheinlich eine Rechnungsnummer ist, unabhängig davon, wo es steht. Sie definieren die gewünschten Felder per Name; das Modell findet sie nach Bedeutung, nicht nach Koordinaten. | Null. Dokument hochladen, Feldnamen eingeben, Ergebnisse erhalten. Funktioniert beim ersten Kontakt mit jedem Layout, das das Modell im Vortraining gesehen hat (was praktisch alle gängigen Geschäftsdokumenttypen abdeckt). | ImageToTable.ai, Airparser, Parseur (KI-Engine) |
Das ist der entscheidende Unterschied: templatebasierte Tools (Zonen-OCR) erfordern eine Konfiguration pro Layout. ML-geschulte Tools erfordern eine Musterbeschriftung pro Typ. Nur Vision-AI-Zero-Shot-Tools liefern, was „kein Training" tatsächlich bedeutet: Laden Sie ein Dokument hoch, das Sie noch nie gesehen haben, und erhalten Sie sofort strukturierte Daten zurück. Diese gleiche Dreiteilung – ohne Vorlage, templatebasiert und geschult/Enterprise-IDP – ist die organisierende Achse unseres umfassenderen Vergleichs zu Datenextraktionssoftware für unstrukturierte Dokumente, falls Sie das breitere Feld statt nur der Null-Einrichtungs-Stufe sehen möchten.
Mehrere Tools auf dieser Liste arbeiten in mehr als einem Modus. Parseur verfügt beispielsweise sowohl über eine Zero-Shot-KI-Engine als auch über eine Vorlagen-Engine. Ob Sie „kein Training" oder „Vorlagen erforderlich" erhalten, hängt davon ab, welchen Modus Sie verwenden – und einige Tools verwenden standardmäßig den Vorlagenmodus, da dieser für sie kostengünstiger ist. Kann KI Daten ohne Training extrahieren? Dieser Artikel beantwortet das ausführlich. Die kurze Antwort: Ja, aber nur, wenn die Architektur dafür ausgelegt ist.
Schnellvergleichstabelle
| Tool | Architektur | Wirklich ohne Einrichtung? | Startpreis | Am besten geeignet für |
|---|---|---|---|---|
| ImageToTable.ai | Vision-AI Zero-Shot | ✅ Ja | $9/Monat (150 Dokumente) | Benutzerdefinierte Spaltenextraktion, Stapelverarbeitung nach Excel |
| Airparser | LLM Zero-Shot | ✅ Ja | Kostenlos (20 Dokumente/Monat), kostenpflichtig ab ca. $20/Monat | Schnelle E-Mail- und Dokumentenanalyse, GPT-basierte Extraktion |
| Parseur | Zero-Shot-KI + Vorlage | ⚠️ KI-Modus ja; Vorlagenmodus nein | $39/Monat (500 Dokumente) | E-Mail-Erfassung, gemischter Dokumenteneingang |
| Docparser | Zonen-OCR + KI-Add-on | ⚠️ KI-Modus teilweise; Vorlagenmodus nein | $39/Monat (14-Tage-Testversion) | PDFs mit festem Layout, Barcode-Extraktion |
| Docsumo | ML-geschult (Few-shot) | ⚠️ Vordefinierte Typen ja; benutzerdefinierte Typen nein | Enterprise (individuelle Preise) | Hohe Mengen, bekannte Dokumenttypen |
| Tesseract | Kostenlose OCR (ohne Struktur) | ⚠️ Kein Training, aber keine strukturierte Ausgabe | Kostenlos (Open Source) | Rohe Textextraktion, Entwicklerprojekte |
| Tabula | PDF-Tabellenextraktor | ⚠️ Nur Tabellen, keine Feldextraktion | Kostenlos (Open Source) | Extrahieren von Tabellen aus sauberen digitalen PDFs |
ImageToTable.ai
Architektur: Vision-AI Zero-Shot (ohne Vorlage, kein Training)
ImageToTable.ai basiert auf einem Vision-Sprachmodell, das Dokumente durch semantisches Verständnis statt durch Koordinatenabgleich liest. Sie geben die gewünschten Spaltennamen ein – „Rechnungsnummer", „Datum", „Gesamtsumme", „Lieferantenname" oder ein beliebiges benutzerdefiniertes Feld – und die KI findet diese Werte überall auf der Seite, unabhängig vom Layout. Das nennt das Produkt Benutzerdefinierte Spaltenextraktion: Sie definieren die Ausgabe, und die KI übernimmt die Eingabe.
Der Zero-Shot-Anspruch hält in der Praxis. Bei unseren Tests haben wir Rechnungen von 15 verschiedenen Lieferanten in unterschiedlichen Formaten hochgeladen – Querformat, Hochformat, mehrseitig, gescannte Fotos – und das Tool lieferte die angeforderten Felder bei jedem ersten Versuch. Der einzige Fehlerpunkt war ein extrem qualitativ minderwertiges Foto eines Thermo-Belegs (unter 300px Auflösung), das das Vision-Modell nicht klar lesen konnte. Dasselbe Dokument scheiterte bei jedem von uns getesteten Tool.
Was ImageToTable.ai auszeichnet, ist der Batch-First-Ansatz. Laden Sie 30 Rechnungen hoch, geben Sie Ihre Spaltennamen einmal an, und das Tool verarbeitet alle 30 gleichzeitig mit einem Klick in eine einzige Excel-Datei. Es unterstützt auch berechnete Spalten – Sie können eine Spalte wie „Zeilensumme (Menge × Einzelpreis)" definieren, und die KI berechnet sie während der Extraktion, ohne Nachbearbeitung. Für Nutzer, die Ergebnisse direkt in Google Sheets möchten, fügt das Google-Sheets-Add-on extrahierte Daten dem aktiven Blatt hinzu, ohne die Tabellenkalkulation zu verlassen.
Dateien werden sicher verarbeitet und nicht gespeichert.
Am besten geeignet für: Nutzer, die eigene Extraktionsspalten definieren möchten, mehrere Dokumente in Stapeln verarbeiten wollen und Ergebnisse als gebrauchsfertige Excel- oder Google-Sheets-Tabelle benötigen. Der kostenlose Tarif (ohne Anmeldung) ermöglicht es Ihnen, vor der Entscheidung mit eigenen Dokumenten zu testen.
Nicht ideal für: Reine E-Mail-Parsing-Workflows (ImageToTable.ai ist Upload-first, nicht E-Mail-Postfach-first). Nutzer, die Word-Format-Ausgabe benötigen, sollten stattdessen den Modus Nach Word verwenden, der das ursprüngliche Layout beibehält – für strukturierte Datenextraktion ist jedoch der Modus Nach Tabelle die richtige Wahl.
Preise: Ab $9/Monat für 150 Dokumente. Kostenloser Tarif verfügbar (keine Kreditkarte erforderlich).
Airparser
Architektur: LLM Zero-Shot (GPT-basiert, ohne Vorlage)
Airparser verfolgt einen anderen Ansatz bei der Zero-Shot-Extraktion: Statt eines speziellen Bilderkennungsmodells wird ein GPT-basiertes LLM verwendet, um den Dokumentinhalt zu verstehen. Sie beschreiben die gewünschten Felder einfach in Klartext – Feldname, Typ, kurze Beschreibung – und die KI extrahiert sie aus Ihren Dokumenten. Keine Vorlagen, keine Trainingsdatensätze, keine Kennzeichnung.
Dieser Ansatz funktioniert gut bei textlastigen Dokumenten und E-Mail-Inhalten, wo das Sprachverständnis von GPT glänzt. In unserem Testdatensatz verarbeitete Airparser per E-Mail gesendete Rechnungen und Bestell-PDFs präzise. Schwierigkeiten gab es bei tabellenlastigen Dokumenten und gescannten Bildern mit komplexen Layouts – die GPT-basierte Engine identifizierte manchmal Positionen falsch oder halluzinierte Werte, die nicht im Dokument vorhanden waren.
Die Stärke von Airparser liegt im Multi-Engine-Fallback: Es versucht es zuerst mit dem Text-LLM, fällt bei komplexen Layouts auf das visuelle LLM zurück und nutzt KI-OCR für gescannte Dokumente. Das macht es widerstandsfähiger als ein Einzel-Engine-Tool. Das Halluzinationsrisiko – eine bekannte Einschränkung der GPT-basierten Extraktion – erfordert jedoch einen manuellen Prüfschritt für kritische Finanzdaten.
Am besten geeignet für: E-Mail-Parsing-Workflows, textlastige Dokumente, Nutzer, die die schnellstmögliche Einrichtung wünschen (Felder beschreiben, Extraktion starten).
Weniger geeignet für: Komplexe Tabellenextraktion, gescannte Quittungen mit mehreren Positionen oder Workflows, bei denen ein halluzinierter Wert ohne Validierungsebene zu echten finanziellen Fehlern führen könnte.
Preise: Der kostenlose Plan umfasst 20 Dokumente/Monat. Kostenpflichtige Pläne beginnen bei ca. 20 $/Monat.
Parseur
Architektur: Zero-Shot-KI-Engine + Vorlagen-Engine (Dualmodus)
Parseur ist eines der differenzierteren Tools auf dieser Liste, da es mit zwei grundlegend unterschiedlichen Engines arbeitet. Die KI-Engine funktioniert tatsächlich ohne Training: Sie erstellen ein Postfach, senden Dokumente, und die KI versucht, Felder automatisch zu identifizieren und zu extrahieren. Die Vorlagen-Engine hingegen erfordert die Erstellung von Vorlagen pro Layout – das Zeichnen von Rahmen, das Setzen von Ankern, das Konfigurieren von Regeln – genau wie bei zonalen OCR-Tools.
Die Marketingbotschaft lautet „kein Modelltraining erforderlich“, was für die KI-Engine zutrifft. Aber die Parseur-Dokumentation rät, dass „die KI-Engine manchmal Probleme mit der Genauigkeit haben kann“ und empfiehlt Vorlagen für „zuverlässige Extraktion“. In der Praxis erstellen die meisten ernsthaften Parseur-Nutzer letztendlich Vorlagen für die Dokumenttypen, die sie regelmäßig verarbeiten. Ein Parseur-Hilfeartikel stellt klar: „Vorlagen bieten eine zuverlässigere und genauere Möglichkeit, Daten zu extrahieren, insbesondere wenn Sie Dokumente mit konsistenten Layouts haben. Sie müssen für jedes Layout eine Vorlage erstellen.“
Das ist wichtig, weil die Vorlagenerstellung in Parseur 15–30 Minuten pro Layout dauert – besser als bei manchen Alternativen, aber dennoch ein erheblicher anfänglicher Aufwand, wenn Sie Rechnungen von 50 verschiedenen Lieferanten verarbeiten. Das Tool erkennt automatisch, welche Vorlage verwendet werden soll, aber Sie müssen dennoch jede einzelne erstellen.
Die Stärke von Parseur liegt in der E-Mail-Erfassung. Es verbindet sich nativ mit E-Mail-Postfächern, verarbeitet Anhänge und E-Mail-Textkörper gemeinsam und leitet extrahierte Daten an Google Sheets, Zapier oder benutzerdefinierte Webhooks weiter. Wenn Ihr Workflow mit Rechnungen beginnt, die in einem E-Mail-Postfach landen, bewältigt Parseur diese Pipeline besser als Upload-zuerst-Tools.
Am besten geeignet für: E-Mail-zentrierte Dokumenten-Workflows, gemischte Eingangskanäle (E-Mail + Upload + API), Nutzer, die die Option zum Erstellen von Vorlagen für häufig wiederkehrende Formate wünschen.
Nicht ideal für: Nutzer, die reines Zero-Shot ohne Vorlagenkonfiguration wünschen. Die KI-Engine funktioniert, aber die Produktarchitektur drängt Sie für den „Produktiv"-Einsatz zu Vorlagen.
Preise: Ab 39 $/Monat für 500 Dokumente. Kostenloser Tarif verfügbar.
Docparser
Architektur: Zonen-OCR + optionales KI-Add-on (DocparserAI)
Docparser ist das etablierteste Tool in dieser Liste und wohl dasjenige, dessen „Kein Training"-Behauptung am meisten Erklärung erfordert. Die Kern-Extraktions-Engine ist Zonen-OCR – Sie zeichnen Kästchen auf ein Musterdokument, um zu definieren, wo jedes Feld auf der Seite sitzt, richten Parsing-Regeln mit Anker-Keywords ein und hoffen, dass das Layout konsistent bleibt. Docparsers eigene Dokumentation nennt dies „Trainieren Ihrer Software" im Zonen-OCR-Sinne: einmal Zonen definieren, als Vorlagen speichern und auf ähnliche Dokumente anwenden.
In den letzten Monaten führte Docparser „DocparserAI" ein, ein KI-gestütztes Add-on für Zero-Shot-Extraktion. In unseren Tests funktionierte der KI-Modus bei einfachen Rechnungen mit Standardlayouts, hatte aber Schwierigkeiten mit Bestellungen und Kontoauszügen – Dokumenttypen, bei denen Docparsers Zonen-OCR-Vorlagen zuverlässiger sind. Das Add-on wirkt eher wie eine Reaktion auf den Markt als eine Neuausrichtung des Produkts.
Die wahren Kosten von Docparser sind nicht das Abo von 39 $/Monat – es sind die Stunden, die Sie mit der Wartung von Vorlagen verbringen. Jedes neue Lieferantenformat erfordert einen neuen Satz Zonen. Jede Layoutänderung eines bestehenden Lieferanten zerbricht Ihre Vorlage. Diskussionen auf Reddit in r/automation und r/smallbusiness beschreiben die Vorlagenwartung von Docparser häufig als „den Teil, vor dem niemand warnt". Ein Nutzer beschrieb seine wöchentliche Routine als „prüfen, welcher Lieferant diese Woche sein Rechnungslayout geändert hat, und die Vorlage reparieren".
Am besten geeignet für: Vorhersagbare Dokumente mit festem Layout von wenigen Lieferanten. Nutzer, die Barcode-/QR-Code-Extraktion benötigen. Teams mit Zeit für Vorlagenwartung.
Nicht ideal für: Gemischte Dokumenttypen, variable Layouts oder Workflows, bei denen Sie sich keine 15–30 Minuten pro Lieferantenformat für die Vorlagenwartung leisten können.
Preise: Ab 39 $/Monat. 14-tägige kostenlose Testversion (keine Kreditkarte).
Docsumo
Architektur: ML-gestützte Extraktion (Few-Shot) mit vortrainierten Modellen
Docsumo ist eine intelligente Dokumentenverarbeitungsplattform, die klar in die Kategorie der ML-gestützten Systeme fällt. Sie bietet über 30 vortrainierte Modelle für gängige Dokumenttypen wie Rechnungen, Bestellungen und Kontoauszüge – und für diese Dokumenttypen funktioniert sie tatsächlich ohne Training. Sie laden ein Dokument hoch, und das vortrainierte Modell extrahiert die relevanten Felder.
Der Haken kommt, wenn Ihre Dokumente nicht in diese 30+ vortrainierten Typen fallen. Docsumos eigener Blogbeitrag über „Die beste vorlagenfreie Datenextraktionssoftware“ ist erfrischend ehrlich: „Dies ist keine Null-Einrichtungs-Lösung. Wenn Sie aus einem wirklich exotischen Dokumenttyp extrahieren müssen, investieren Sie 10–20 Stunden für die Beschriftung von Beispielen.“ Der Beitrag stellt weiter fest, dass „Few-Shot-Plattformen 20–50 Stunden anfängliche Beschriftungsarbeit erfordern, aber Ausnahmen auf 5–10 % der Dokumente sinken.“
Für Standardrechnungen von bekannten Lieferanten in Nordamerika liefern Docsumos vortrainierte Modelle gute Ergebnisse. Bei Nischen-Bauformularen, regionalen medizinischen Dokumenten oder lieferantenspezifischen Packzetteln müssen Sie Beispiele beschriften und ein benutzerdefiniertes Modell trainieren. Die Stärke der Plattform liegt im Volumen: Wenn Sie 100.000 Rechnungen pro Jahr von über 50 Lieferanten verarbeiten, zahlt sich die anfängliche Beschriftungsinvestition durch operative Stabilität aus. Aber wenn Sie heute Nachmittag Daten aus 30 verschiedenen Dokumenttypen extrahieren müssen, ist Docsumo nicht das richtige Werkzeug.
Am besten geeignet für: Mittelständische und große Teams, die hohe Volumen bekannter Dokumenttypen verarbeiten. Teams mit über 50 Lieferanten, die in anfängliche Beschriftungsarbeit für langfristige Stabilität investieren können.
Nicht ideal für: Ad-hoc-Extraktion verschiedener Dokumenttypen. Kleine Teams oder Freiberufler, die keine 20–50 Stunden Beschriftungsarbeit rechtfertigen können, bevor sie Ergebnisse sehen.
Preise: Unternehmenspreise (individuelles Angebot). Keine Self-Service-Stufe verfügbar.
Kostenlose & Open-Source-Optionen
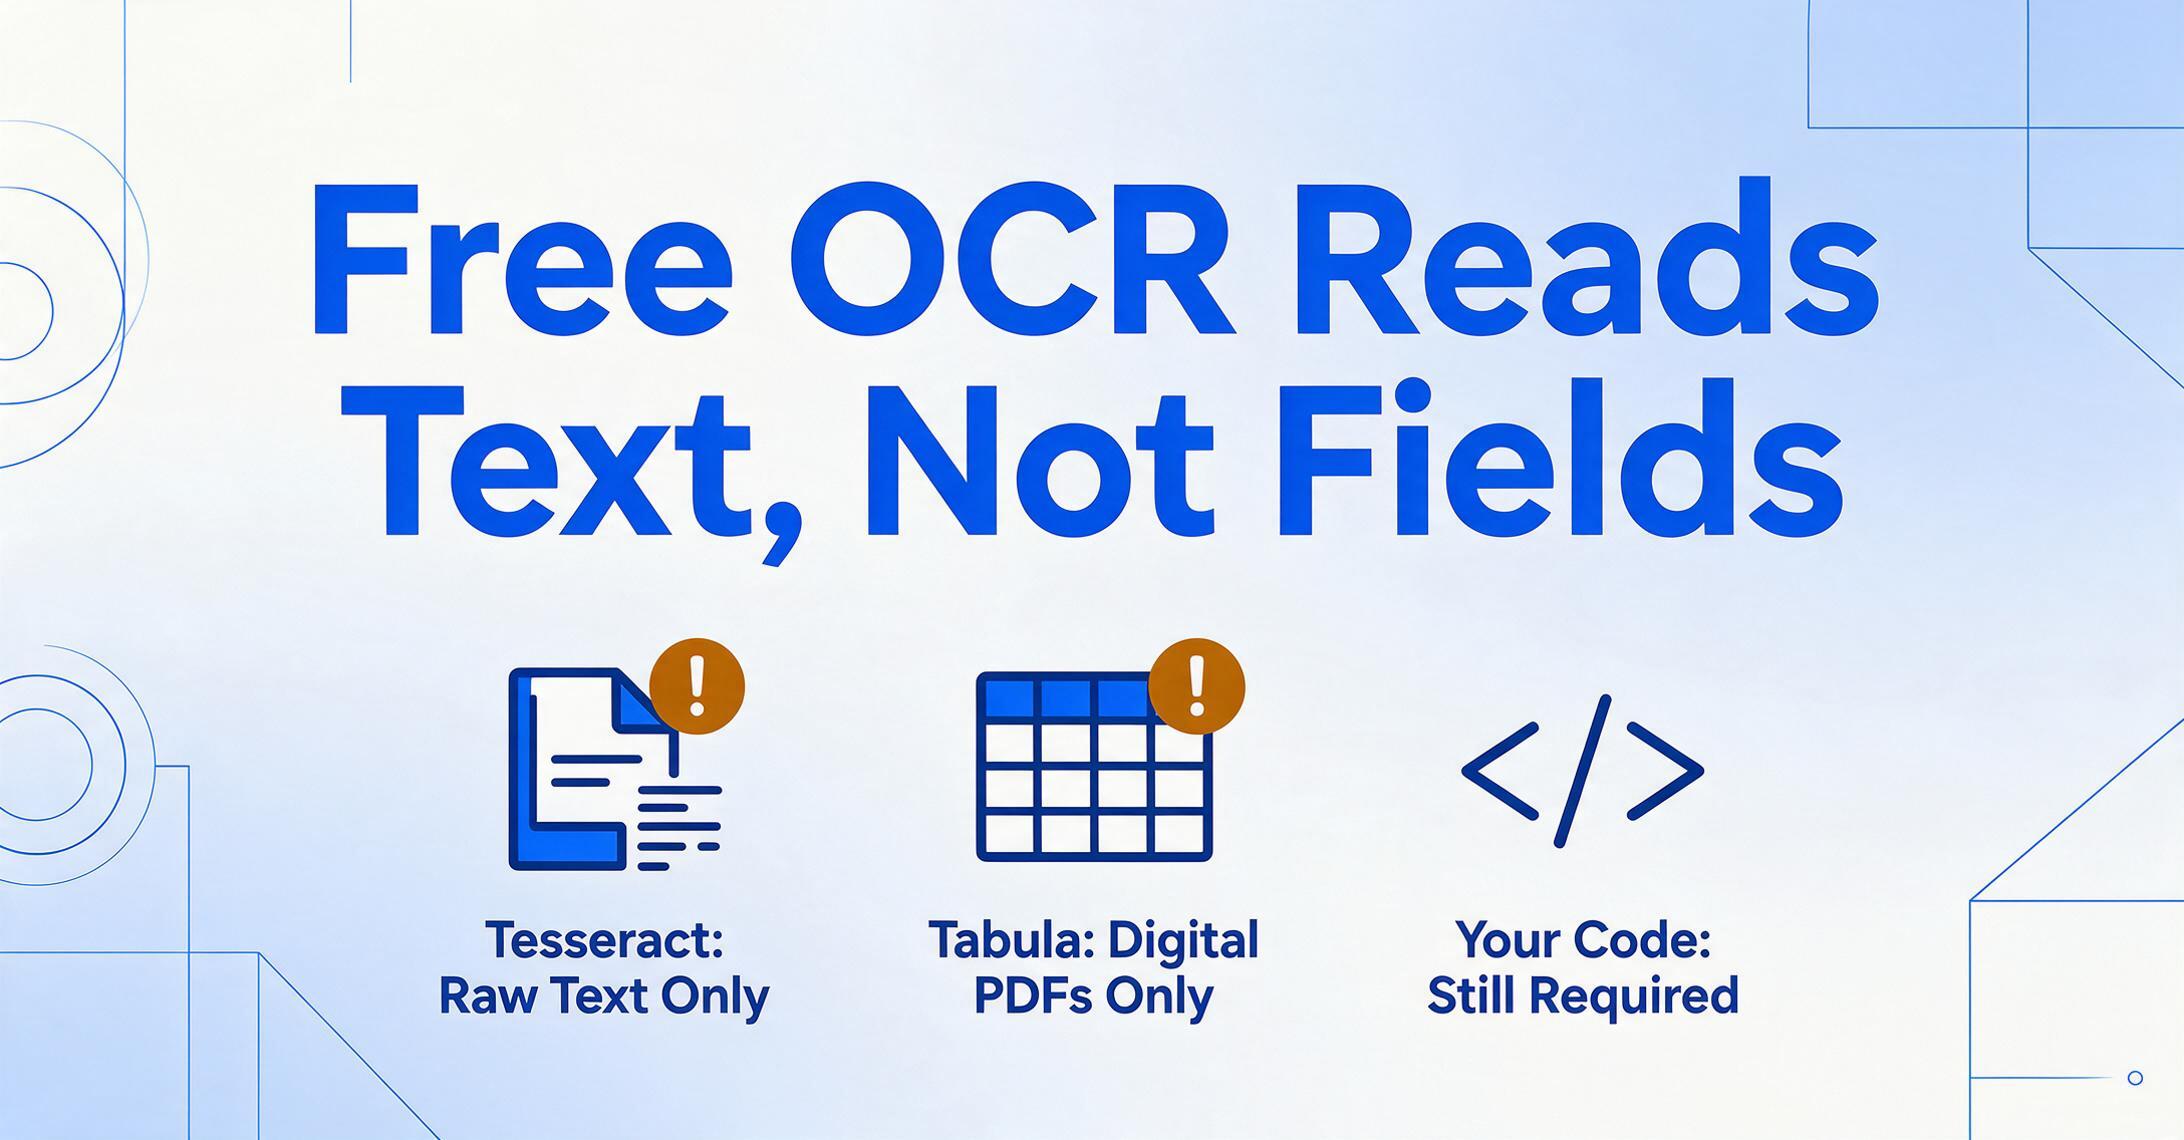
Keine Übersicht über Tools ohne Training wäre vollständig, ohne die kostenlosen Optionen zu erwähnen – aber diese bringen wichtige Einschränkungen mit sich, was „kein Training" im Open-Source-Kontext bedeutet.
Tesseract OCR
Tesseract ist die am weitesten verbreitete Open-Source-OCR-Engine. Es erfordert kein Training im ML-Sinn – Sie installieren es und es liest Text sofort. Die Einschränkung besteht darin, dass Tesseract Rohtext ohne Verständnis der Dokumentstruktur ausgibt. Es kann Ihnen nicht sagen, welcher Text die Rechnungsnummer, das Datum oder die Positionsbeschreibung ist. Sie müssen Nachbearbeitungslogik (reguläre Ausdrücke, Koordinatenzuordnung, benutzerdefinierten Code) erstellen, um Tesseracts Ausgabe in strukturierte Daten umzuwandeln. Der Weg von Rohtext zu einer nutzbaren Tabelle erfordert in der Regel mehrere Stunden Entwicklungsarbeit pro Dokumenttyp.
Am besten geeignet für: Entwickler, die eine benutzerdefinierte Extraktionspipeline aufbauen möchten und die technische Zeit haben, sie zu warten.
Nicht ideal für: Alle, die strukturierte Daten ohne Code schreiben möchten.
Tabula
Tabula ist ein kostenloses Open-Source-Tool, das Tabellen aus digitalen PDFs extrahiert. Sie ziehen ein Feld um die Tabelle auf einer PDF-Seite, und Tabula gibt die Daten als CSV aus. Es funktioniert gut bei sauberen, digitalen PDFs mit klar definierten Tabellenrändern. Es funktioniert nicht bei gescannten PDFs oder bildbasierten Dokumenten und kann keine Schlüssel-Wert-Felder (wie Rechnungsnummer oder Lieferantenname) extrahieren – nur tabellarische Daten.
Am besten geeignet für: Gelegentliche Tabellenextraktion aus digitalen PDFs, wenn Sie einen schnellen CSV-Export benötigen.
Nicht ideal für: Gescannte Dokumente, Rechnungsfeldextraktion oder jede Art von automatisierter Stapelverarbeitung.
OCR.space
OCR.space bietet eine kostenlose OCR-API ohne Registrierung. Es wandelt Bilder in Text um, gibt aber – wie Tesseract – unstrukturierten Text statt feldspezifischer Daten aus. Die kostenlose Stufe hat Nutzungslimits (1 Anfrage pro 10 Sekunden, bis zu 25.000 Anfragen pro Monat), und die Genauigkeit bei gedrucktem Text ist solide. Für die strukturierte Feldextraktion müssten Sie zusätzliche Parsing-Logik auf der Grundlage der OCR-Ausgabe aufbauen.
Am besten geeignet für: Schnelle Textextraktion aus Bildern, OCR-API für Entwickler, die benutzerdefinierte Pipelines erstellen.
Nicht ideal für: Strukturierte Datenextraktion, Stapelverarbeitung oder nicht-technische Benutzer, die ohne Konfiguration eine Tabelle erhalten möchten.
Welches Tool passt zu Ihrem Workflow?
Jedes Tool auf dieser Liste kann Daten aus Dokumenten extrahieren. Die Frage ist, wie viel Einrichtungszeit Sie investieren möchten, bevor Sie Ergebnisse sehen – und ob diese Einrichtung eine einmalige Investition oder eine laufende Wartungsverpflichtung ist.
| Ihr Szenario | Empfohlenes Tool | Warum |
|---|---|---|
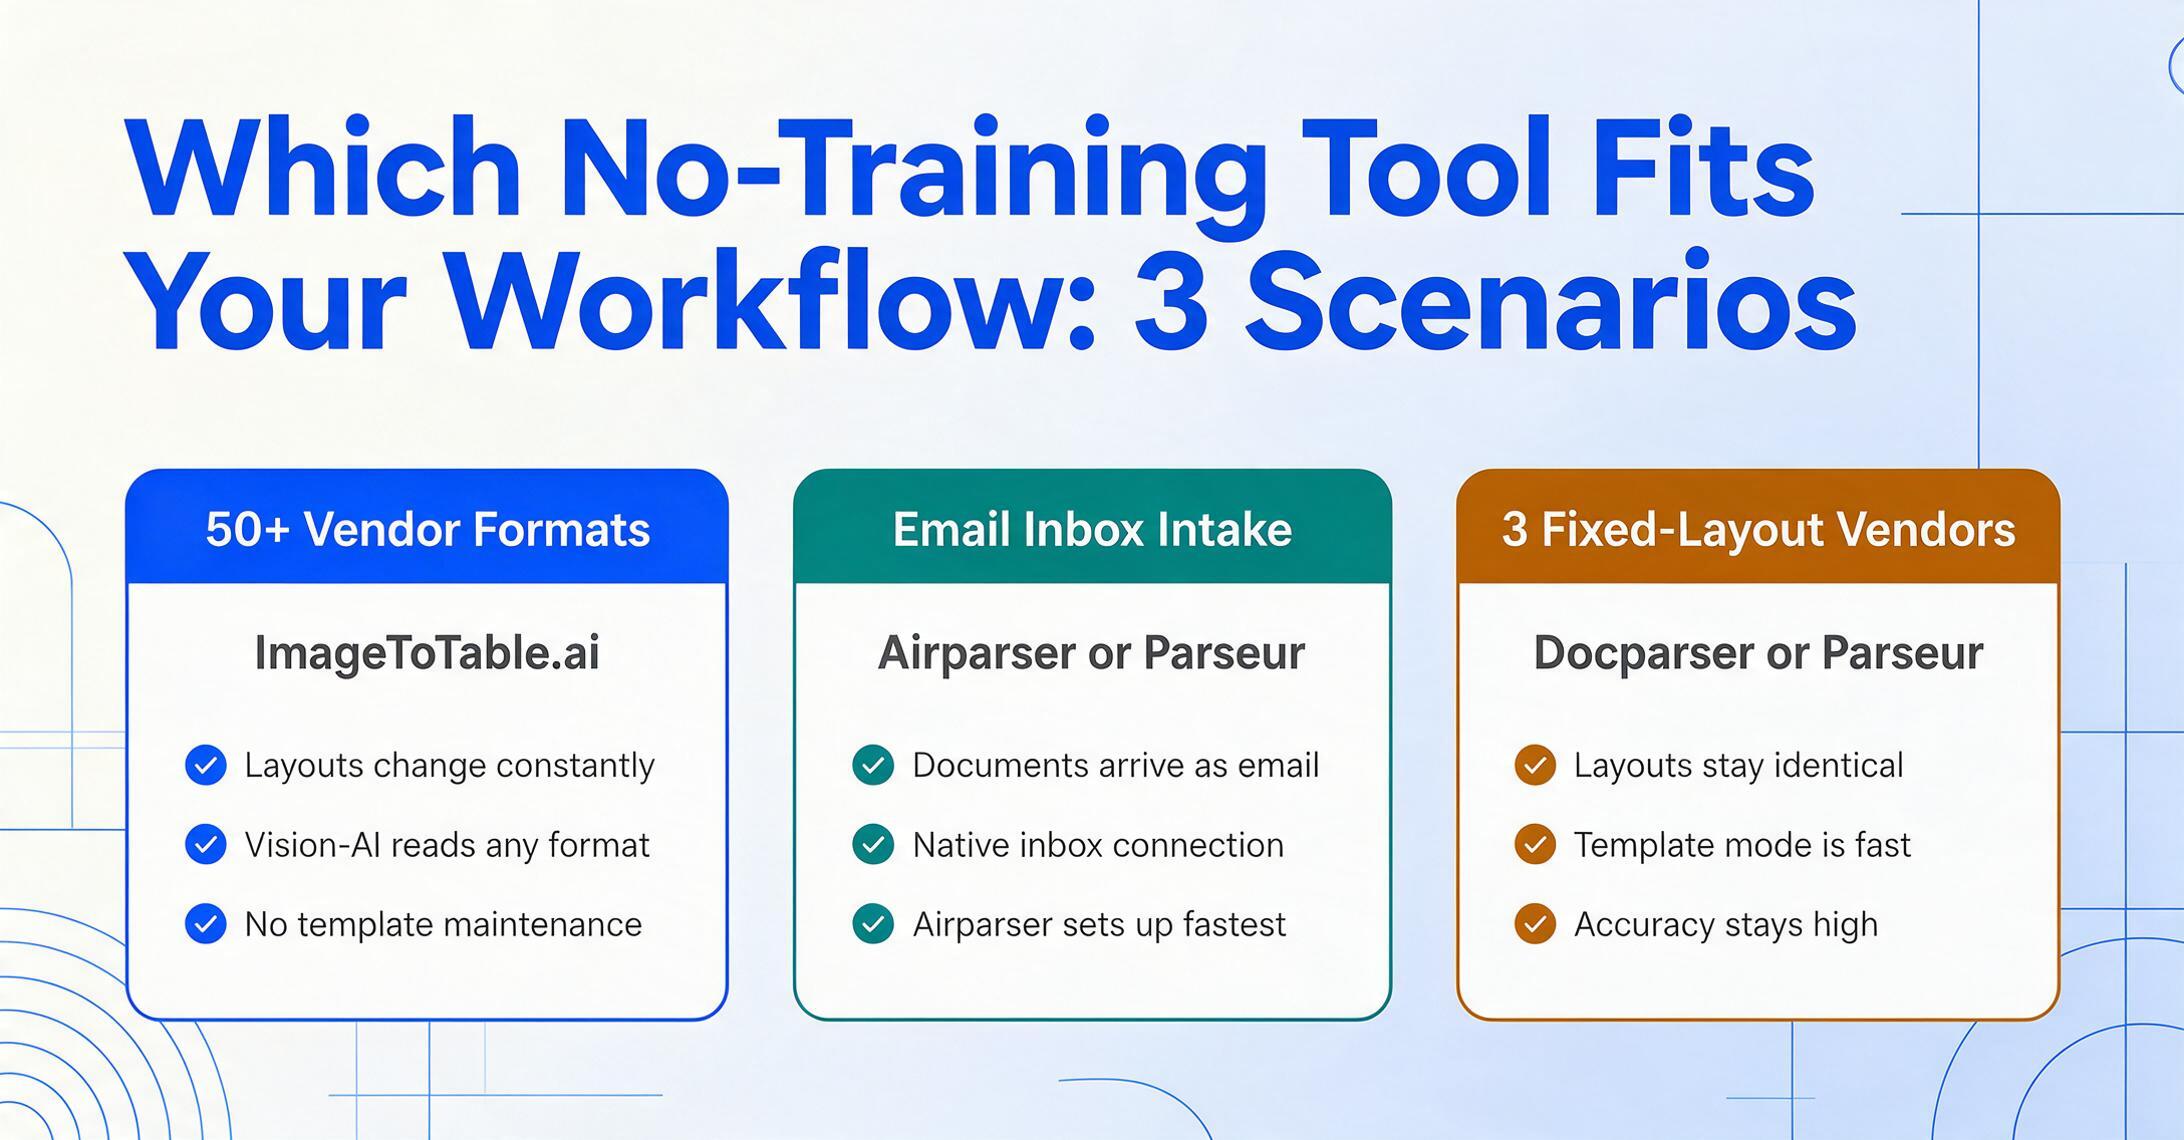
| Sie verarbeiten Rechnungen von 50+ Lieferanten – Layouts ändern sich ständig | ImageToTable.ai | Zero-Shot-Vision-AI verarbeitet jedes Layout. Keine Vorlagenwartung erforderlich. |
| Ihre Dokumente kommen per E-Mail an (Rechnungen, Bestellungen, Versandmitteilungen) | Airparser oder Parseur | Native E-Mail-Erfassung. Airparser für den schnellsten Start; Parseur für die Vorlagenoption. |
| Sie benötigen strukturierte Daten in Google Sheets, ohne die Tabellenkalkulation zu verlassen | ImageToTable.ai (Sheets-Add-on) | Natives Google-Sheets-Add-on für die Extraktion direkt in die Tabellenkalkulation. |
| Sie haben 3 regelmäßige Lieferanten mit jedes Mal identischen Layouts | Docparser oder Parseur (Vorlagenmodus) | Templatebasierte Extraktion ist schnell und genau, wenn sich Layouts nie ändern. |
| Sie verarbeiten 10.000 Rechnungen pro Monat von bekannten Lieferanten | Docsumo | Vortrainierte Modelle + benutzerdefiniertes Modelltraining für Ihre Lieferanten. Das Volumen rechtfertigt die Investition. |
| Sie sind Entwickler und erstellen eine benutzerdefinierte Extraktionspipeline | Tesseract + benutzerdefinierter Code oder OCR.space-API | Kostenlos, flexibel, konfigurierbar. Erfordert technischen Aufwand für strukturierte Ausgaben. |
| Sie benötigen eine einmalige Tabelle aus einer PDF-Datei | Tabula | Kostenlos, kein Konto erforderlich, Drag-and-Drop-Tabellenextraktion. |
Wenn Sie noch unsicher sind, beginnen Sie mit einem Tool, das eine wirklich kostenlose oder unverbindliche Testphase anbietet – und führen Sie denselben Test durch wie wir. Nehmen Sie ein Dokument mit unübersichtlichem Layout, eines, mit dem Ihr aktuelles Tool Schwierigkeiten hat. Laden Sie es ohne vorherige Konfiguration hoch. Wenn das Tool beim ersten Versuch genaue strukturierte Daten liefert, ist die „Kein-Training“-Behauptung haltbar. Wenn es Sie auffordert, eine Vorlage zu erstellen oder Muster zu beschriften, bevor es extrahieren kann, ist die Behauptung nicht haltbar – unabhängig davon, was die Marketingseite sagt.
Wir haben außerdem einen separaten Leitfaden zu Extraktion ohne Vorlagen, der tiefer in die Technologie selbst eintaucht, sowie einen Vergleich von Dokumenttools für Freiberufler, falls Sie solo arbeiten.
FAQ
Was bedeutet „Zero-Shot-Extraktion“?
Zero-Shot-Extraktion bedeutet, dass die KI Daten aus einem Dokumenttyp extrahieren kann, den sie noch nie gesehen hat – ohne Trainingsmuster oder Vorlagenkonfiguration. Das Modell stützt sich auf vortrainiertes Wissen darüber, wie Dokumente aussehen und was Feldnamen bedeuten. Dies unterscheidet sich von Few-shot-Extraktion (die 5–200 beschriftete Muster verwendet) und templatebasierter Extraktion (die koordinatendefinierte Zonen verwendet).
Kann KI wirklich Daten ohne jegliches Training extrahieren?
Ja – aber nur Tools, die auf Vision-AI- oder LLM-Architekturen basieren, die mit Millionen von Dokumenten vortrainiert wurden. Diese Modelle verstehen bereits, wie eine Rechnung, ein Beleg oder eine Bestellung aussieht. Sie müssen sie nicht trainieren. Tools, die auf Zonen-OCR oder klassischem maschinellem Lernen basieren, benötigen Vorlagen oder beschriftete Muster, weil sie entwickelt wurden, bevor vortrainierte Vision-Modelle existierten. Siehe unseren ausführlichen Artikel: Kann KI Daten ohne Training extrahieren?
Was ist der Unterschied zwischen „kein Training“ und „keine Vorlage“?
„Kein Training“ bedeutet, dass die KI keine Beispieldokumente benötigt, um Ihr spezifisches Format zu lernen. „Keine Vorlage“ bedeutet, dass sie keine koordinatenbasierten Zonendefinitionen benötigt. Für eine tiefere Betrachtung dessen, was Vorlagenfreiheit konkret bedeutet, siehe unseren Artikel über ob KI Daten ohne Vorlagen extrahieren kann. Einige Tools bieten das eine, aber nicht das andere. Parseurs KI-Engine beispielsweise benötigt keine Trainingsmuster, bietet aber dennoch Vorlagen für „höhere Genauigkeit“ an. Die wirklich am stärksten auf null Setup ausgelegten Tools bieten beides: keine Trainingsmuster und keine Vorlagenkonfiguration.
Funktioniert Docparser wirklich ohne Training?
Die Kern-Engine von Docparser ist Zonen-OCR, die das Zeichnen von Extraktionszonen auf jedem Dokumentlayout erfordert – das ist Template-Konfiguration, kein Zero-Shot. Docparser hat kürzlich "DocparserAI" für KI-gestützte Extraktion hinzugefügt, aber es ist ein Add-on zum Kernprodukt. Für den Zonen-OCR-Modus ist die Behauptung "kein Training" irreführend: Das Erstellen von Zonen und Regeln ist genau die Art von Einrichtung, die die meisten Benutzer vermeiden möchten. Der neuere KI-Modus bietet zwar Zero-Shot-Extraktion bei einfachen Dokumenten, jedoch mit geringerer Genauigkeit als spezielle Vision-AI-Tools.
Ist die Genauigkeit ohne Training geringer?
Bei Standarddokumenttypen (Rechnungen, Belege, Bestellungen, Kontoauszüge) liegt die Zero-Shot-Genauigkeit typischerweise bei 90–98 % für klar sichtbare gedruckte Felder – vergleichbar mit templatebasierten Tools nach der Vorlagenerstellung. Bei hochspezialisierten oder ungewöhnlichen Dokumentformaten kann die Zero-Shot-Genauigkeit geringer sein als bei einem individuell trainierten Modell für genau dieses Format. Das ist der Kompromiss: Sie tauschen maximale Genauigkeit bei einem bestimmten Format gegen sofortige Nutzbarkeit bei allen Formaten. Für die meisten kleinen und mittleren Teams überwiegt der Breitenvorteil den marginalen Genauigkeitsunterschied.
Gibt es kostenlose Dokumentextraktions-Tools ohne Training?
Kostenlose Tools wie Tesseract und OCR.space extrahieren Text ohne Training, erzeugen jedoch keine strukturierten Daten (Feldebene-Extraktion). Sie erhalten Rohtext und müssen Code schreiben, um ihn in Felder zu parsen. Tabula extrahiert Tabellen aus digitalen PDFs kostenlos, verarbeitet aber nur Tabellen, keine Schlüssel-Wert-Felder. Für wirklich kostenlose strukturierte Extraktion ohne Training bieten einige SaaS-Tools kostenlose Stufen an – Airparser bietet 20 Dokumente/Monat kostenlos, und ImageToTable.ai bietet eine Demo ohne Anmeldung.
Welches ist schneller eingerichtet: Parseur oder Airparser?
Airparser ist schneller für einmalige Dokumente – Sie beschreiben Felder in einfachem Englisch und erhalten Ergebnisse. Parseurs KI-Engine ist ähnlich schnell, aber die Produktdokumentation lenkt Benutzer für den Produktionseinsatz zu Vorlagen. Für eine einmalige Extraktion weniger Dokumente dauern beide unter 10 Minuten. Für die laufende Verarbeitung verschiedener Dokumenttypen erfordert Airparsers LLM-Ansatz weniger Wartung. Für die Verarbeitung bekannter Layouts in hohem Volumen sind Parseurs Vorlagen (einmal erstellt) zuverlässiger.
Wie viel Zeit kosten Vorlagen tatsächlich?
Basierend auf unseren Tests und Nutzerberichten von Reddit und G2-Bewertungen dauert die Erstellung und Prüfung einer Vorlage in der Regel 15–60 Minuten. Für ein Unternehmen, das Rechnungen von 50 Lieferanten mit unterschiedlichen Layouts verarbeitet, bedeutet das 12–50 Stunden anfänglicher Vorlagenarbeit. Jedes Mal, wenn ein Lieferant sein Layout ändert, kommen weitere 15–60 Minuten hinzu, um die defekte Vorlage zu reparieren. Diese wiederkehrenden Kosten sind einer der am meisten unterschätzten Nachteile templatebasierter Tools – die Marketingseite zeigt Ihnen die erfolgreiche Extraktion, nicht die Stunde, die Sie jeden Monat mit der Reparatur von Vorlagen verbringen.
Halluzinieren Zero-Shot-Tools Daten?
GPT-basierte Tools (wie Airparser) haben ein bekanntes Halluzinationsrisiko – die KI kann manchmal einen Wert generieren, der plausibel aussieht, aber nicht im Dokument existiert. Vision-AI-Modelle (wie ImageToTable.ai) halluzinieren weitaus seltener, da sie ihre Ausgabe auf den visuellen Inhalt der Seite stützen. Wenn Sie Finanzdaten verarbeiten, die prüfungssicher sein müssen, suchen Sie nach einem Tool, das Quellenangaben oder Konfidenzwerte für jedes extrahierte Feld bereitstellt. Und bauen Sie immer einen menschlichen Prüfschritt in Workflows ein, bei denen ein falscher Wert echten finanziellen Schaden verursachen könnte.
Fazit
„Kein Training“ ist eines der wertvollsten Features, das ein Dokumentenextraktionstool bieten kann – aber nur, wenn es echt ist. Der Unterschied zwischen einem Tool, das wirklich keine Einrichtung erfordert, und einem, das Sie nach dem ersten Upload zur Vorlagenerstellung auffordert, ist kein nebensächliches Workflow-Detail. Er bestimmt, ob Sie Ihre erste Stunde mit der Datenextraktion oder dem Zeichnen von Boxen verbringen.
Die Tools, die echte Zero-Shot-Extraktion bieten – ImageToTable.ai, Airparser und Parseurs KI-Engine – basieren auf grundlegend anderen Architekturen als templatebasierte oder ML-geschulte Alternativen. Sie funktionieren ab dem ersten Tag, mit jedem Layout, bei jedem Dokumenttyp, den sie verstehen gelernt haben. Der Kompromiss ist, dass ein individuell trainiertes Modell oder eine sorgfältig erstellte Vorlage bei einem einzigen, hochspezifischen Format, das Sie 10.000-mal im Monat verarbeiten, möglicherweise eine etwas höhere Genauigkeit erzielt.
Für die meisten Teams, die eine Mischung aus verschiedenen Dokumenttypen aus mehreren Quellen verarbeiten, ist Zero-Shot-Extraktion kein Kompromiss – sie ist der einzig praktikable Ansatz. Eine Stunde, die Sie bei der Einrichtung pro Dokumenttyp sparen, ist eine Stunde, die sich über jeden Lieferanten, jede Formatänderung und jeden neuen Dokumenttyp summiert. Im Laufe eines Jahres wird der Unterschied zwischen einem Tool, das Training erfordert, und einem, das keins benötigt, in Tagen gemessen, nicht in Stunden.