ImageToTable vs Nanonets vs Parseur para Equipes Não Técnicas:
Uma Comparação Honesta de 2026
A maioria das comparações de extração de documentos parece listas de recursos escritas por fornecedores. Elas respondem perguntas que ninguém na sua equipe está realmente fazendo. A gerente de operações que processa 200 faturas por mês não se importa com qual ferramenta teve a pontuação mais alta no IDP Leaderboard. Ela quer saber se alguém da equipe consegue descobrir isso hoje à tarde sem chamar o TI, quanto vai custar de verdade a cada mês e se os dados extraídos chegam ao Google Sheets sem um desvio pelo Zapier. Esta comparação responde a essas perguntas — e explicitamente não responde às que importam mais para equipes de compras da Fortune 500 do que para a equipe que você realmente gerencia.
Principais Conclusões
- As três ferramentas vendem 'extração de documentos' — mas seus modelos de preços divergem tanto que 400 páginas por mês custam $19 em uma e $120 em outra.
- A pergunta sobre o Google Sheets que importa não é 'os dados podem eventualmente chegar a uma planilha' — é se a extração acontece dentro da planilha que sua equipe já tem aberta, e apenas o ImageToTable.ai responde com um add-on nativo de barra lateral.
- Esqueça as tabelas de comparação de recursos — a pergunta certa escolhe sua ferramenta por você: sua equipe vive em planilhas, processa documentos de e-mails encaminhados ou precisa de certificações de conformidade empresarial?
Por que esta comparação existe (e o que não vamos abordar)
ImageToTable, Nanonets e Parseur resolvem o mesmo problema central: transformar documentos não estruturados em dados estruturados, prontos para planilha, sem redigitação manual. Mas eles abordam isso de três ângulos fundamentalmente diferentes — e a diferença importa mais do que qualquer lista de recursos revela.
Esta comparação foi escrita na perspectiva de um líder de equipe não técnico: alguém que gerencia operações, finanças ou um pequeno negócio e precisa que a extração de documentos funcione dentro de um fluxo de trabalho baseado em planilhas. A equipe provavelmente vive no Google Sheets. Ninguém na equipe tem tempo para rotular dados de treinamento ou esperar por um ciclo de implementação. O orçamento é real, mas não é zero — a questão não é "o que é mais barato", mas "qual é o gasto certo para o nosso uso real".
O que não vamos abordar: Esta não é uma análise de latência de API, pontuações de benchmark de modelos ou arquiteturas de implantação empresarial. Se você é um líder de engenharia avaliando APIs de extração para um pipeline de produção que processa um milhão de páginas por mês, os critérios que importam para você são diferentes dos que importam aqui. Também não vamos fingir que esta é uma "análise imparcial de terceiros". Nós criamos o ImageToTable. Mas usamos as outras duas ferramentas, conversamos com seus usuários e consultamos seus preços em páginas públicas. Onde um concorrente faz algo melhor, vamos dizer.
Se você ainda está entendendo o que a extração de documentos com AI realmente faz — e como ela difere das ferramentas de OCR que você pode ter usado antes — comece por o que a extração de dados de documentos realmente significa e como a extração com AI difere do OCR tradicional. Este artigo pressupõe que você já sabe que precisa de uma ferramenta de extração e está decidindo qual usar.
Pergunta 1: Alguém da Minha Equipe Pode Usar Hoje Sem Treinamento?
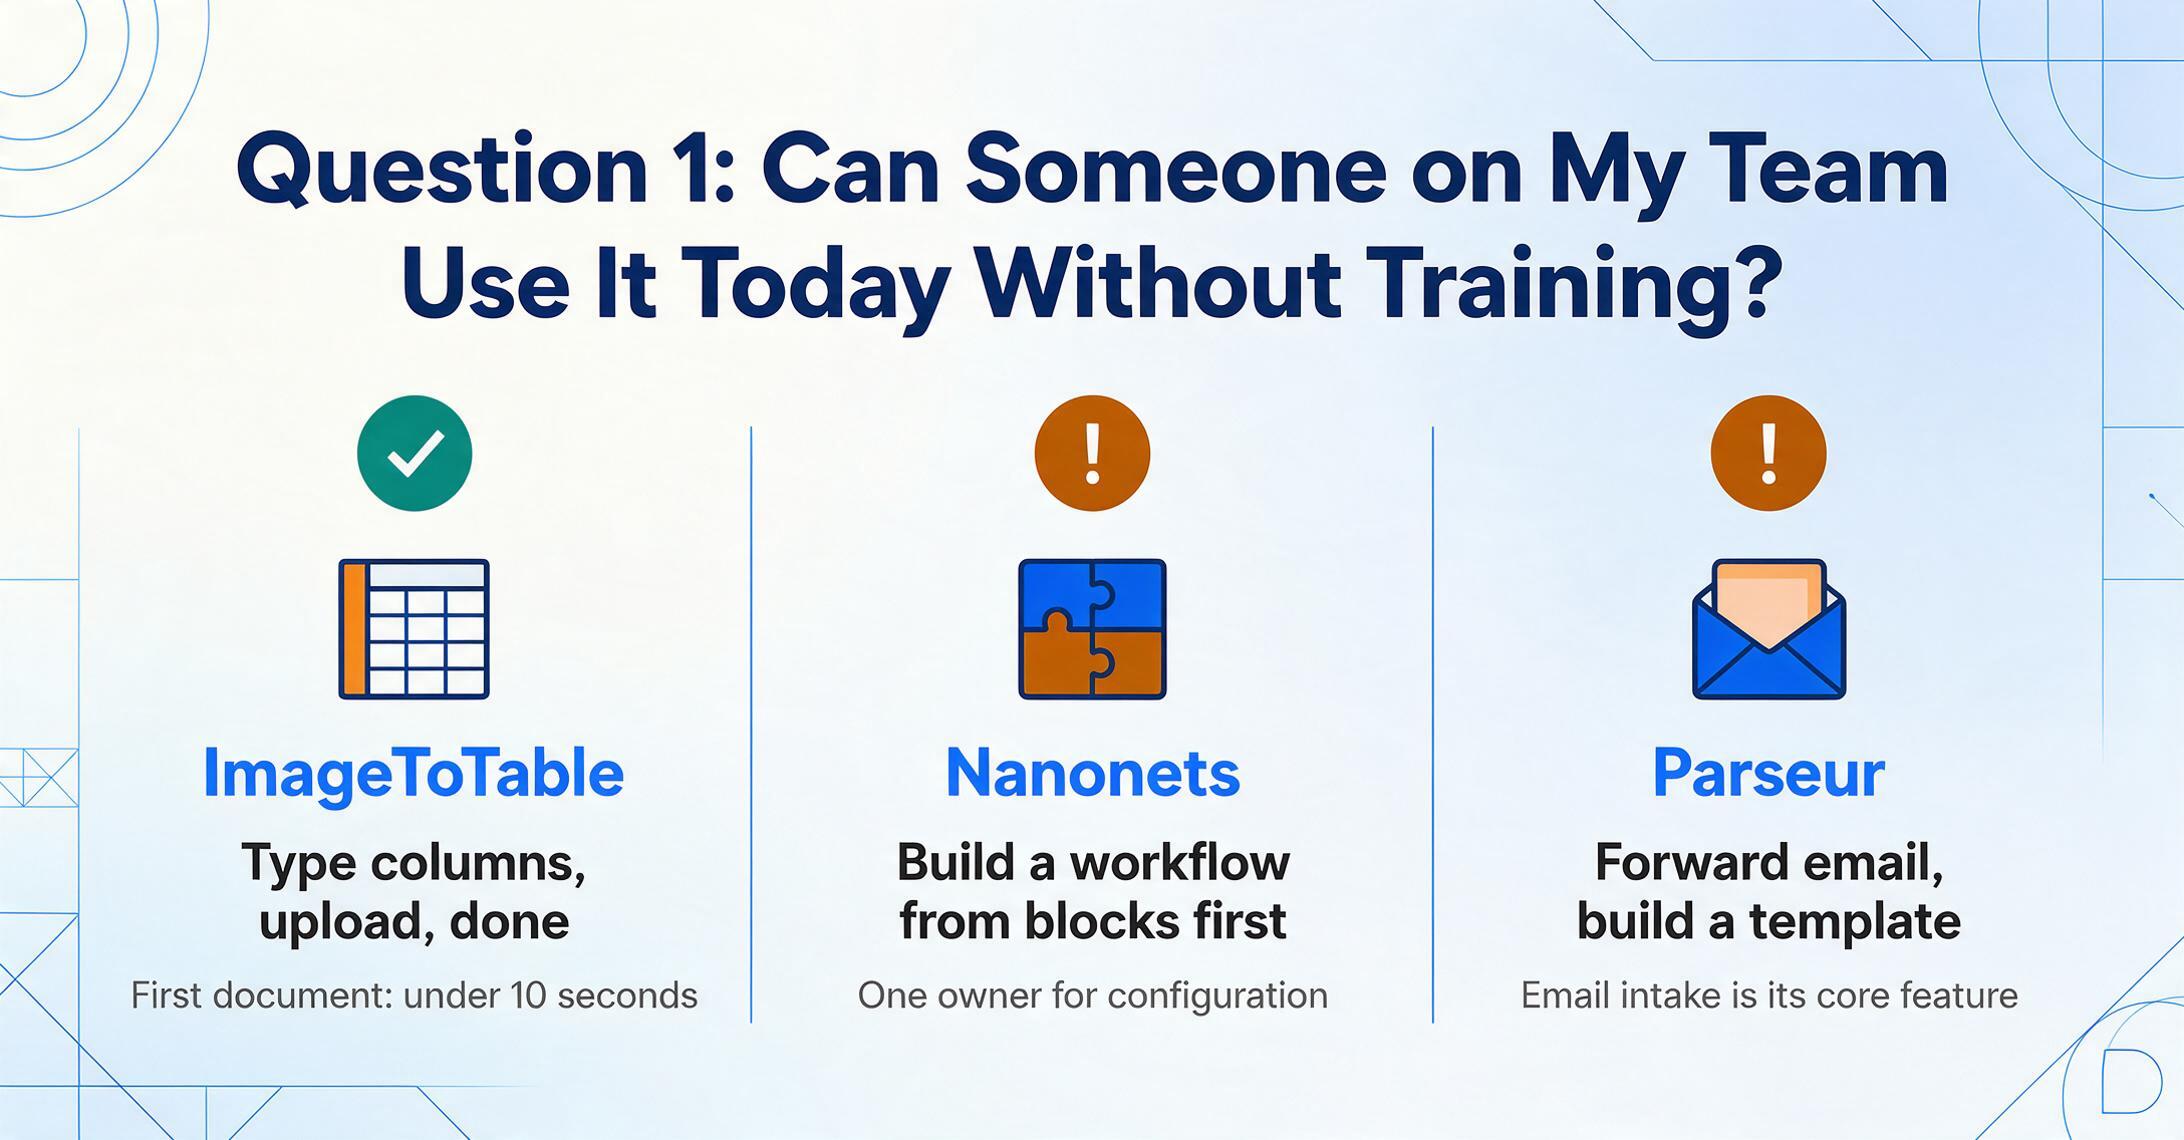
Esta é a pergunta que elimina a maioria das avaliações de ferramentas. Um produto pode ser poderoso no papel, mas se leva uma semana para integrar — ou exige conceitos que sua equipe não domina — a adoção morre no primeiro mês. As três ferramentas adotam abordagens bem diferentes para a primeira experiência de uso.
ImageToTable: Digite os Nomes das Colunas, Faça Upload, Pronto
Não há fase de configuração. Você digita os nomes dos campos que deseja — "Invoice Number", "Vendor", "Date", "Total" — faz upload de um documento e a AI extrai esses valores. Os nomes de coluna que você insere se tornam os cabeçalhos da sua tabela de saída. Não há modelo para construir, nem dados de treinamento para rotular, nem "parse engine" para selecionar. Você pode pular completamente os nomes de coluna e deixar a AI detectar automaticamente o que está no documento, refinando a partir daí.
Essa abordagem — o que chamamos de Custom Column Extraction — funciona porque a AI entende o que "Invoice Number" significa semanticamente, não onde ele fica na página. Você não desenha caixas ao redor dos campos nem ensina ao sistema como são suas faturas. Um fornecedor mudou o layout da fatura? A AI se adapta. Alguém enviou uma foto de celular em vez de um PDF? Mesmo processo. Para uma análise mais profunda de por que isso importa, veja como a extração de colunas personalizadas se compara à conversão de tabela de documento inteiro.
O primeiro documento normalmente é processado em menos de 10 segundos. Um novo membro da equipe pode ir do cadastro à extração concluída sem documentação.
Nanonets: Crie um Fluxo de Trabalho com Blocos
O Nanonets usa um construtor visual de fluxo de trabalho feito de "blocos" — cada bloco executa uma etapa: entrada de documento, classificação, extração de dados, validação, exportação. Para um fluxo de trabalho padrão de faturas, você normalmente encadeia de 4 a 6 blocos. O bloco de extração é alimentado por AI e não exige a criação de modelo — ele detecta campos automaticamente nos documentos, de forma muito parecida com o ImageToTable.
Mas colocar um fluxo de trabalho em produção exige mais etapas do que um simples fluxo de enviar e extrair. Você precisa entender o conceito de bloco, configurar cada estágio e testar o pipeline de ponta a ponta. A interface foi projetada para pessoas familiarizadas com conceitos de automação de fluxo de trabalho — é intuitiva para esse público, mas a curva é mais íngreme do que "digitar campos, enviar, baixar". A documentação oficial do Nanonets estima o tempo de configuração em minutos para fluxos de trabalho simples, mas usuários no r/dataengineering do Reddit relatam que ajustar pipelines complexos com vários tipos de documento pode levar dias de iteração.
Parseur: Escolha Seu Motor, Configure uma Caixa de Correio
O Parseur organiza a extração em torno de "caixas de correio" — cada caixa de correio lida com um tipo de documento com seu próprio esquema de campos e regras de processamento. No primeiro envio, o Parseur identifica automaticamente os campos que acha que você quer extrair. Você pode então refinar a lista de campos e escrever instruções em linguagem simples para cada campo. O Parseur escolhe o motor de análise correto automaticamente — Vision AI para layouts com muitas imagens, Text AI para conteúdo de texto simples, modelos para formulários fixos.
A detecção automática de campos no primeiro envio é realmente útil e reduz o trabalho inicial de adivinhação. Mas a estrutura de caixa de correio + motor + pós-processamento introduz conceitos que usuários não técnicos precisam aprender. O motor de modelo, embora opcional, exige a criação de um modelo visual para cada layout de documento — útil quando você precisa de saída idêntica todas as vezes, mas trabalho adicional se seus documentos vierem de muitos fornecedores diferentes com formatos diferentes. Segundo a própria documentação do Parseur, a maioria dos fluxos de trabalho entra em produção em menos de 10 minutos para casos de uso simples.
| ImageToTable | Nanonets | Parseur | |
|---|---|---|---|
| Tempo até a primeira extração | Menos de 1 minuto | 5–15 minutos (fluxo de trabalho simples) | 2–10 minutos (primeira caixa de correio) |
| Modelo de configuração | Digite os nomes das colunas → faça upload | Construtor visual de fluxo de trabalho (blocos) | Caixa de correio + instruções de campo |
| Modelo obrigatório? | Não | Não (a AI detecta campos automaticamente) | Opcional — a AI funciona sem modelos |
| Precisa de dados de treinamento? | Nenhum | Nenhum para extração padrão | Nenhum |
| Mudanças de layout são tratadas? | Automaticamente — extração semântica | Automaticamente — a AI se adapta | Os mecanismos de AI se adaptam; os modelos precisam de atualização |
Se o seu requisito principal é tornar um membro não técnico da equipe produtivo em menos de 5 minutos, o ImageToTable tem o caminho mais curto. O conceito de caixa de correio do Parseur é o próximo mais acessível — a detecção automática de campos no primeiro upload elimina a fricção de "como eu nomeio os campos?". O Nanonets oferece o maior controle de fluxo de trabalho, mas com um custo de complexidade que faz mais sentido se você já tem alguém confortável com ferramentas de automação na equipe.
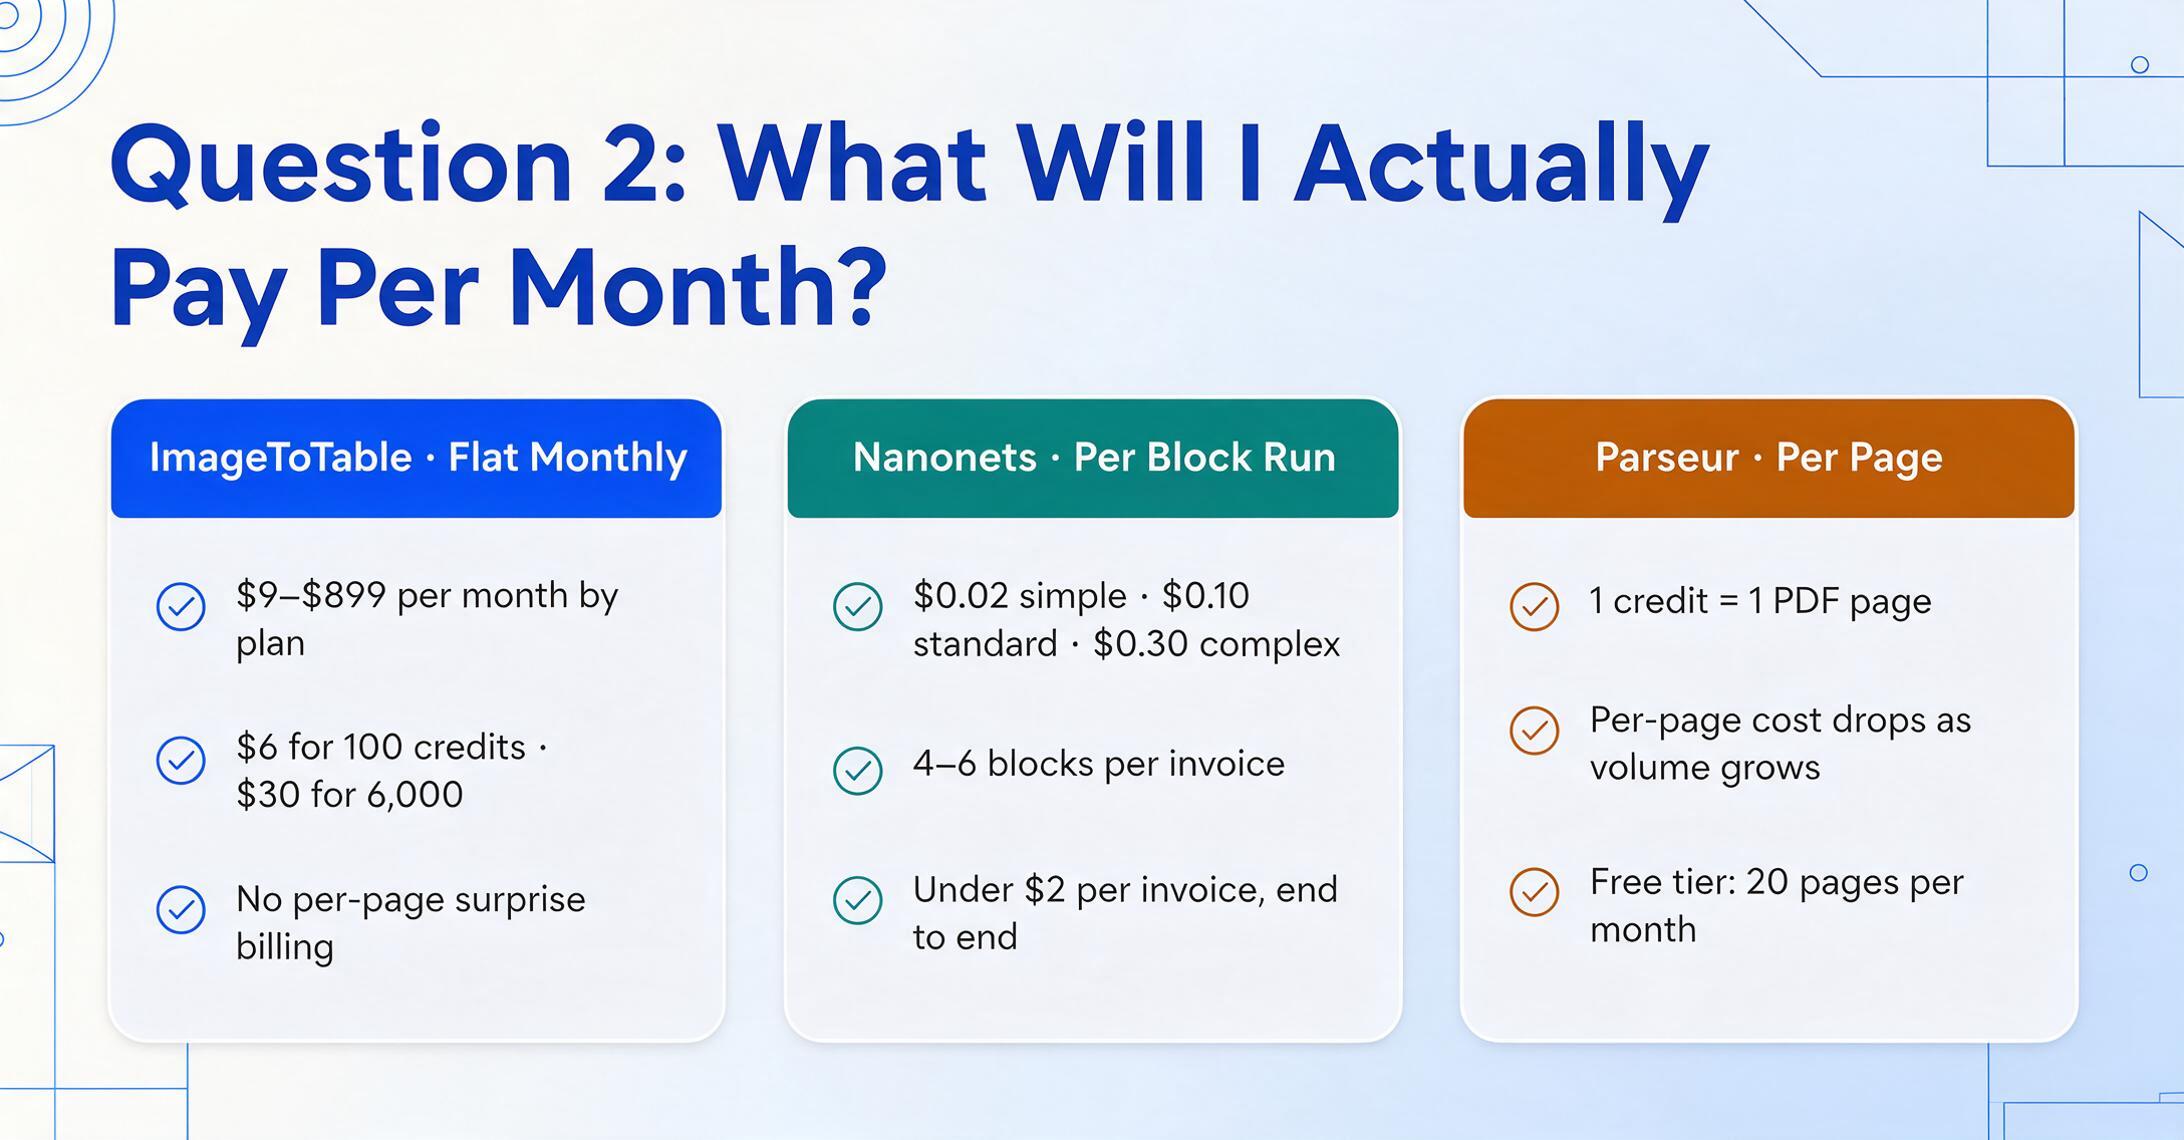
Pergunta 2: Quanto vou pagar por mês, na prática?
Os modelos de preços na extração de documentos são surpreendentemente diferentes — e as diferenças importam mais do que os preços anunciados. Uma ferramenta cobra por página, outra cobra por operação de AI, outra cobra uma assinatura mensal fixa. O mesmo volume de documentos pode gerar faturas totalmente diferentes dependendo do modelo em que você está.
Os três modelos de preços, explicados
ImageToTable: assinatura mensal com limites de créditos. Você paga uma taxa mensal fixa ($9–$899 dependendo do plano) e recebe um número definido de créditos — cada crédito processa uma imagem ou uma página de PDF. Créditos não usados não acumulam, mas não há cobrança surpresa por página. Você também pode comprar pacotes de créditos avulsos ($6 por 100 créditos, até $300 por 6.000 créditos) sem assinatura. Uma cota diária gratuita permite testar com documentos reais antes de pagar qualquer coisa.
Nanonets: preço por consumo de bloco. O Nanonets cobra por "execução de bloco" — cada etapa de um fluxo de trabalho consome créditos a taxas diferentes: $0,02 para operações simples (formatação, roteamento), $0,10 para AI padrão (classificação, validação), $0,30 para AI complexa (extração de dados). Um fluxo de trabalho típico de fatura usa 4–6 blocos. O Nanonets estima isso em menos de $2 por fatura de ponta a ponta. O plano Starter inclui $200 em créditos gratuitos. Planos de equipe com descontos por volume e créditos compartilhados exigem contato com o setor de vendas.
Parseur: preço por volume de páginas. O Parseur cobra por página processada, com o custo por página diminuindo conforme o volume aumenta. 1 crédito = 1 página de PDF. E-mails e planilhas contam como 1 página, independentemente do tamanho. O nível gratuito inclui 20 páginas/mês. Os planos pagos começam em um nível básico e escalam até 1 milhão de páginas/mês no autoatendimento, com o Enterprise lidando com até 10 milhões de páginas. O Parseur não publica os preços exatos por página em cada faixa de volume — o controle deslizante de preços permite estimar, mas o preço final aparece após o cadastro. A calculadora de ROI na página de preços do Parseur permite modelar custos com base no volume de documentos e no número de funcionários.
Quanto Custa Cada Modelo em Três Volumes Realistas
| Volume Mensal | ImageToTable | Nanonets (est.) | Parseur (est.) |
|---|---|---|---|
| 50 páginas/mês | $0 (cota diária gratuita) ou $9/mês (Basic) | $0 (os créditos do Starter cobrem isso) | Plano pago mais baixo (acima de 20 gratuitas) |
| 400 páginas/mês | $19/mês (Pro, 400 créditos) — ~$0,05/página | ~$60–$120/mês (a ~$0,15–$0,30/página para fluxos com muita extração) | Plano pago — estimado em $40–$80/mês |
| 3.000 páginas/mês | $149/mês (Growth, 3.000 créditos compartilhados) — ~$0,05/página | ~$150–$300/mês (com descontos por volume, fale com vendas) | Nível Scale — estimado em $150–$300/mês |
Preços do ImageToTable da página pública de preços em imagetotable.ai/upgrade_service. Estimativas do Nanonets com base no preço público por bloco em nanonets.com/pricing, assumindo um fluxo típico de fatura de 4–6 blocos. Estimativas do Parseur com base nas faixas do controle deslizante de volume em parseur.com/pricing — os preços exatos por página exigem cadastro. Todos os preços em USD. As estimativas do Nanonets e do Parseur são para extração — custos adicionais podem se aplicar a recursos complementares.
O modelo por bloco introduz uma imprevisibilidade real que os modelos de assinatura evitam. Em um mês, sua equipe processa 400 faturas padrão de uma página — acessível. No mês seguinte, um fornecedor envia 50 extratos de várias páginas com contratos anexados que cada um aciona mais blocos do que o esperado. Sua conta muda e você não sabe em quanto até ela chegar. Para equipes com tipos e volumes de documentos previsíveis, isso é administrável. Para equipes que processam uma mistura de documentos curtos e longos de fontes variáveis, o modelo de assinatura é mais fácil de orçar.
Uma dimensão de preço em que Nanonets e Parseur têm vantagem: descontos por alto volume. Se você processa 10.000+ páginas por mês de forma consistente, o preço por faixas de volume deles pode superar modelos de assinatura fixa no custo por página. Para as faixas de volume em que a maioria das equipes não técnicas opera (50–3.000 páginas/mês), no entanto, a assinatura fixa do ImageToTable geralmente sai mais barata.
Pergunta 3: Funciona dentro do Google Sheets?
Para equipes cujo fluxo de trabalho inteiro vive no Google Sheets, a questão da integração não é "os dados podem eventualmente chegar a uma planilha?" — é "posso extrair dados sem sair da planilha em que já estou trabalhando?" A diferença entre um add-on nativo e um pipeline Zapier/webhook determina se a extração se torna parte do fluxo de trabalho ou uma etapa separada que alguém precisa lembrar de fazer.
ImageToTable: Add-on de barra lateral nativo do Google Sheets
O ImageToTable oferece um add-on do Google Workspace Marketplace que incorpora o mecanismo de extração completo como uma barra lateral do Sheets. Você define colunas, faz upload de documentos, e os dados extraídos chegam diretamente na sua planilha ativa — sem exportar arquivo, sem baixar e reenviar, sem trocar de aba. Modelos de coluna podem ser salvos e reutilizados entre lotes, então seu modelo "Invoice Extraction" funciona da mesma forma todo mês.
O add-on roda em modo de conta: conecte sua API Key uma vez, e seu histórico de extração e modelos do Sheets sincronizam com sua conta web. O uso conta contra a cota do seu plano. Isso é importante porque significa que toda a sua equipe pode usar o add-on a partir da mesma planilha compartilhada — os dados extraídos aparecem onde todos já trabalham.
Nanonets: Zapier, API ou exportação
O Nanonets não oferece um add-on nativo do Google Sheets. Os dados chegam ao Google Sheets por um de três caminhos: um conector Zapier/Make/Power Automate (que adiciona uma etapa de middleware e possível latência), a API REST (exige trabalho de engenharia para montar um pipeline), ou exportação manual para CSV/Excel (o que anula o propósito da automação).
Para equipes com uma stack de automação existente, a rota do Zapier funciona bem — uma vez configurada, os dados extraídos fluem para o Sheets automaticamente. Mas a configuração inicial exige entender tanto o construtor de fluxo de trabalho do Nanonets quanto o modelo de gatilho/ação do Zapier. Não é o mesmo que uma barra lateral que funciona pronta para uso.
Parseur: Webhook, Zapier ou Sincronização Direta
O Parseur oferece "sincronização ao vivo com o Google Sheets" como integração nativa — uma vez conectado, os dados extraídos são sincronizados automaticamente com uma planilha especificada. Isso está mais próximo de uma experiência nativa do que a abordagem de middleware do Nanonets, mas ainda é uma etapa de configuração separada, e não um fluxo de trabalho dentro do Sheets. O Parseur também oferece suporte ao Google Sheets por meio dos conectores Zapier, Make, Power Automate e n8n.
A sincronização direta significa que você configura a conexão uma vez e os dados fluem automaticamente a cada novo documento processado. Mas você ainda gerencia a extração pela interface web do Parseur — não há barra lateral que você possa usar sem sair do Sheets.
Se o Google Sheets é onde sua equipe vive: a barra lateral nativa do ImageToTable é a integração mais próxima. A sincronização direta do Parseur é uma forte segunda opção para pipelines automatizados de "configurar e esquecer". O Nanonets exige mais etapas intermediárias, mas oferece a maior flexibilidade se seu fluxo de trabalho abrange vários destinos além do Sheets.
Pergunta 4: Quais Tipos de Documento Cada Um Lida Bem?
As três ferramentas afirmam lidar com "qualquer documento". Na prática, cada uma tem pontos fortes e casos extremos em que se sai melhor — e onde pode ter dificuldades. Entender isso não é sobre declarar um vencedor; é sobre combinar a ferramenta com o que sua equipe realmente processa.
| Capacidade de Documentos | ImageToTable | Nanonets | Parseur |
|---|---|---|---|
| Formatos de entrada | PDF, JPG, PNG, WebP, AVIF, capturas de tela | PDF, imagens, Word, Excel — amplo suporte a formatos | PDF, imagens, e-mails, planilhas, mais de 25 formatos |
| Recebimento por e-mail | Disponível — endereço de caixa de entrada dedicado, processa automaticamente com um modelo vinculado | Disponível (integração de e-mail) | Recurso principal — encaminhe e-mails para um endereço de caixa postal exclusivo |
| Suporte a escrita à mão | Sim — compreensão semântica por VLM | Não é um destaque | Vision AI captura escrita à mão, caixas de seleção e carimbos |
| Extração de tabelas / itens de linha | Sim — baseada em colunas + coluna calculada para cálculos | Sim — com estrutura de tabela preservada na saída | Sim — cada linha vira um registro próprio, lida com contagens variáveis de linhas |
| Documentos em vários idiomas | Principais idiomas suportados | Mais de 100 idiomas | Mais de 200 idiomas (OCR); mecanismos de AI suportam os principais idiomas |
| Preservação de layout (Para Word) | Modo Para Word — restauração completa do layout em Word editável | Layout preservado na saída em markdown | Não é um recurso principal — a saída são dados estruturados |
| Detecção de caixa de seleção / carimbo / assinatura | Sim — estado da caixa de seleção, carimbos, assinaturas | Detecção de código de barras e assinatura nos planos Growth+ | Vision AI captura caixas de seleção e carimbos |
| Certificações de conformidade e segurança | Criptografia HTTPS, armazenamento criptografado, exclusão automática | SOC 2 Type II, HIPAA, GDPR, ISO 27001 | Nativo em GDPR (hospedado na EU), SOC 2 Type II em andamento |
A diferença na entrada por email costumava ser uma lacuna clara entre essas ferramentas — não é mais. O Parseur foi construído em torno do email como fonte primária de documentos — você encaminha faturas e recibos para um endereço de caixa postal dedicado e eles são processados automaticamente. Para equipes cujos documentos chegam principalmente por email (faturas de fornecedores enviadas para ap@, recibos de despesas encaminhados pela equipe), isso é um verdadeiro ganho de produtividade. O Nanonets oferece integração de email semelhante. O ImageToTable agora também tem isso por meio do Email Inbox: cada conta recebe um endereço de caixa de entrada dedicado, ativar o Auto-Process com um modelo vinculado inicia a extração no momento em que o email chega, e uma lista de remetentes permitidos opcional mantém emails não relacionados fora da fila. O Email Inbox pode ser configurado para ler anexos, o próprio corpo do email, ou ambos, então cobre os dois casos — um PDF de fatura encaminhado ou um fornecedor que apenas digita os números no texto da mensagem.
No quesito conformidade, o Nanonets está em outra liga. As certificações SOC 2 Type II, HIPAA, GDPR e ISO 27001 importam se você atua na área de saúde, finanças ou qualquer setor com requisitos regulamentados de tratamento de dados. O Parseur oferece infraestrutura nativa de GDPR (hospedada na EU) com SOC 2 em andamento. O ImageToTable criptografa dados em trânsito e em repouso com exclusão automática configurável — suficiente para a maioria dos casos de uso de SMB, mas não para organizações que precisam cumprir requisitos de conformidade durante a avaliação de fornecedores.
Pergunta 5: Ele Cresce Junto com a Nossa Equipe?
A ferramenta que funciona para duas pessoas processando 100 faturas por mês pode quebrar quando a equipe cresce para oito pessoas processando 2.000. A questão do crescimento não é apenas sobre volume — é sobre acesso da equipe, recursos compartilhados e se o teto da ferramenta fica acima ou abaixo da trajetória da sua equipe.
Processamento em Lote: Quantos Documentos de Uma Vez?
O ImageToTable oferece suporte a uploads em lote, nos quais você solta vários arquivos de uma vez, define suas colunas uma única vez e obtém uma única tabela de saída mesclada. A simultaneidade de uploads escala conforme o nível do plano — de 1 upload simultâneo no Free até 3 nos planos Team. O verdadeiro valor do lote é a mesclagem: 50 faturas de 15 fornecedores diferentes, todas extraídas em uma única planilha com cabeçalhos de coluna consistentes, sem configuração por arquivo. O recurso Link de Coleta adiciona uma dimensão de crescimento que nenhum concorrente oferece: você pode gerar um link compartilhável onde clientes ou equipes de campo enviam documentos diretamente para a sua fila de processamento.
O Nanonets lida com o processamento em lote por meio de seu mecanismo de workflow — os documentos passam pelos blocos configurados em sequência, com filas por conta que isolam seu processamento dos outros clientes. Os planos Team incluem créditos compartilhados e até 3 usuários no Starter. Os planos Growth e Enterprise adicionam análises, relatórios e descontos por volume de até 40%. Para equipes que precisam acompanhar métricas de throughput e precisão de extração ao longo dos meses, a camada de análises do Nanonets é a mais forte dos três.
O Parseur processa documentos por meio de caixas de correio com campos ilimitados por extração. Os planos Scale (10.000+ créditos/mês) desbloqueiam contas multiusuário (até 100 usuários), pós-processamento avançado (código Python para lógica de negócios personalizada) e retenção ilimitada de documentos. O ponto forte exclusivo do Parseur em escala é seu pipeline de entrada por e-mail: quando o volume de documentos cresce para milhares por mês, a capacidade de ingestão automática via encaminhamento de e-mail se torna mais valiosa, não menos.
A dimensão de crescimento em que o ImageToTable tem uma vantagem que nenhum concorrente replica: o Link de Coleta permite que você aumente a entrada de documentos sem aumentar sua equipe. Em vez de contratar alguém para cobrar faturas dos fornecedores ou lembrar os funcionários de enviar recibos de despesas, você envia um link. Os documentos chegam até você. É um tipo diferente de escalabilidade — não processar mais documentos mais rápido, mas colocar documentos no pipeline com menos atrito.
Quando Escolher Cada Ferramenta: Um Guia Prático de Decisão
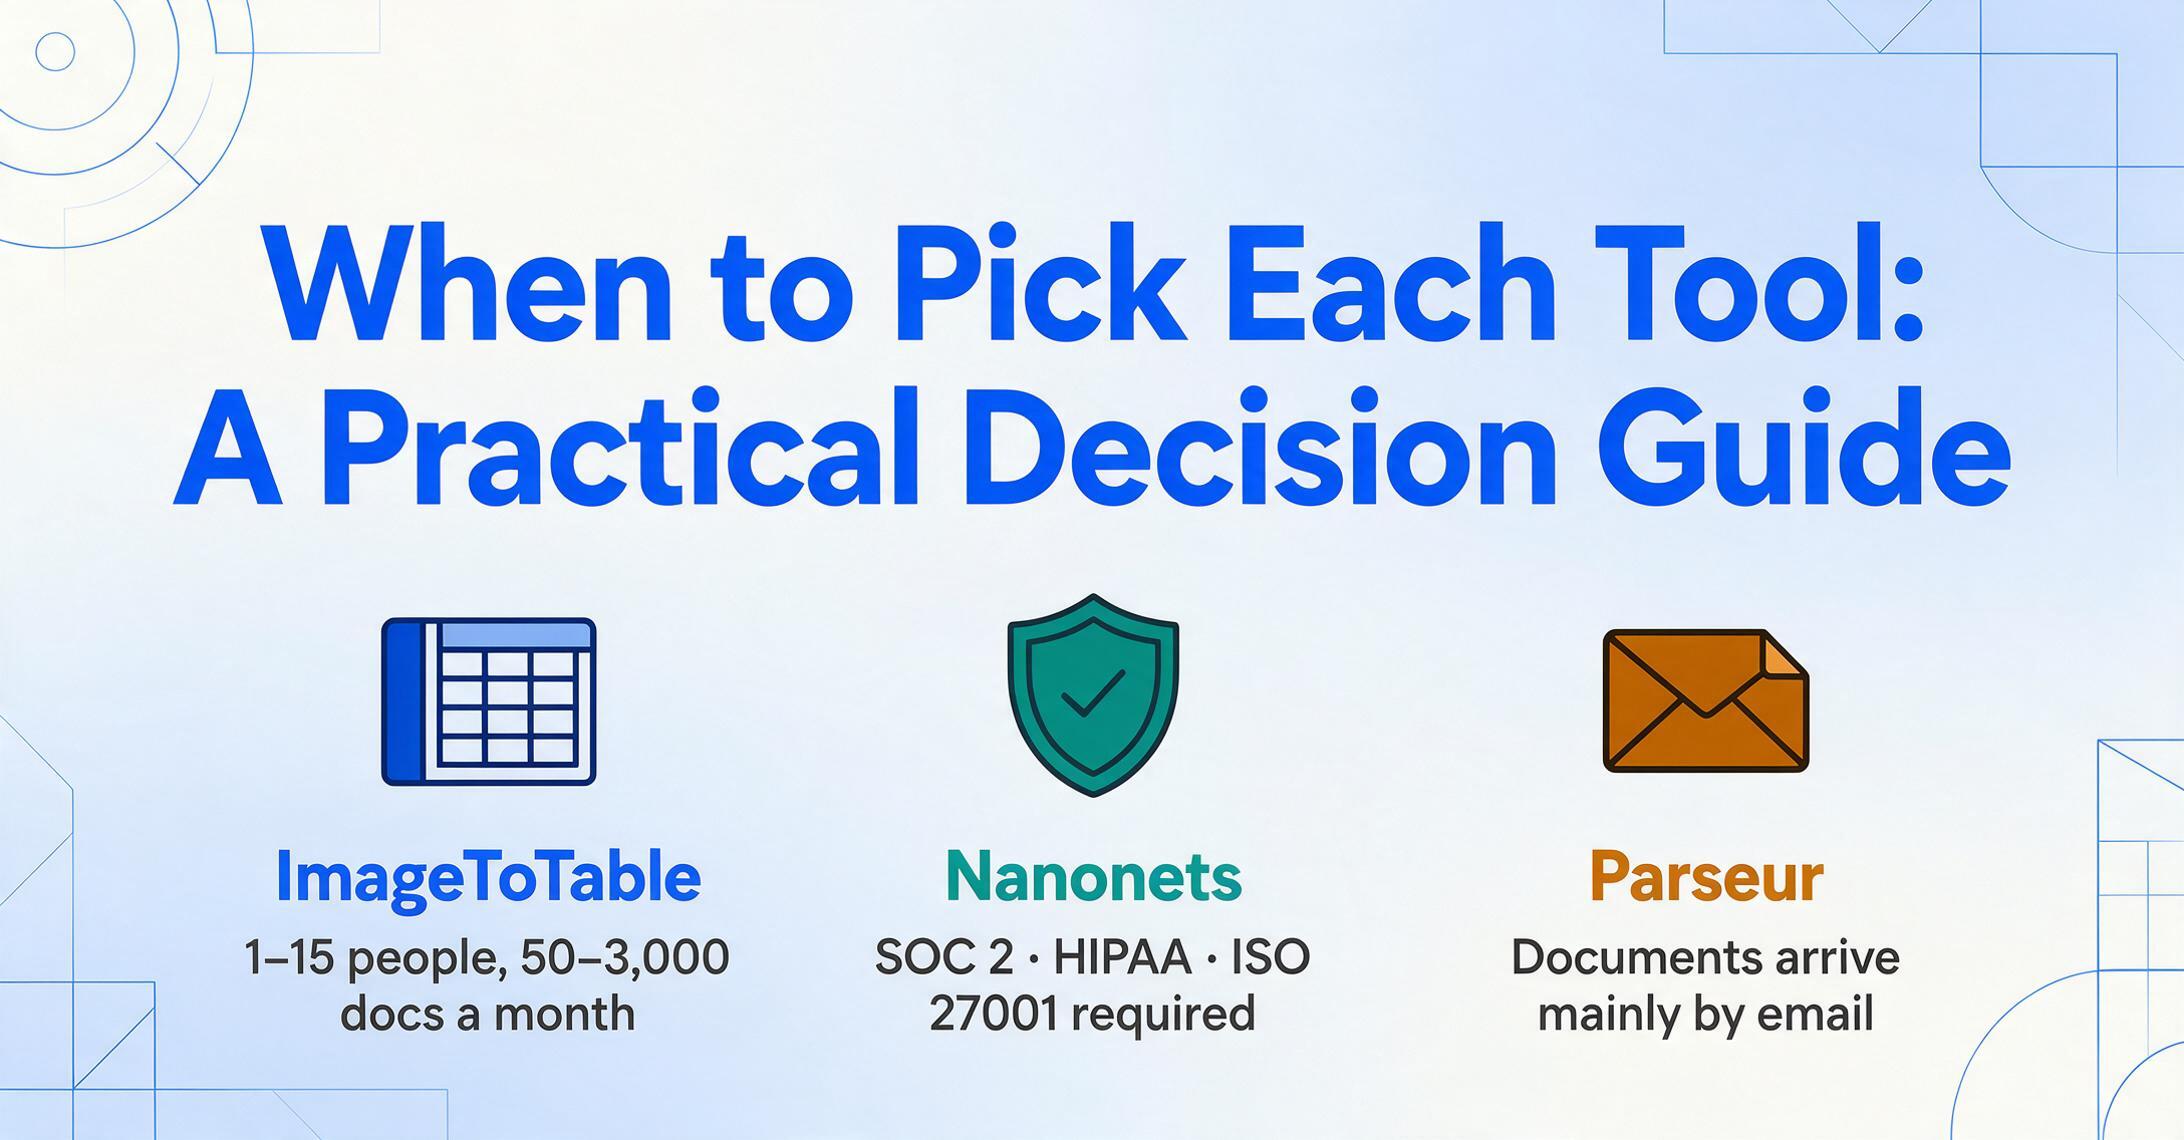
Nenhuma ferramenta vence em todas as dimensões. A escolha certa depende do que sua equipe mais valoriza e de quais tradeoffs você está disposto a aceitar. Veja como a decisão se desenrola nos cenários mais comuns que encontramos.
Escolha o ImageToTable se sua equipe vive no Google Sheets e precisa que a extração funcione hoje — sem configuração, sem treinamento, sem envolvimento de TI.
Ideal para: equipes pequenas e médias (1–15 pessoas) que processam 50–3.000 documentos/mês. Você quer uma barra lateral no Sheets, não outra aba para gerenciar. Você valoriza preços mensais previsíveis em vez de otimização por documento. Seus documentos chegam de várias fontes e você precisa do Link de Coleta para reuni-los sem precisar cobrar. Você ocasionalmente precisa de saída em Word que preserve o layout. Você não precisa de certificações de conformidade no nível do Nanonets, como SOC 2 ou HIPAA — a captação automatizada por e-mail já é coberta pelo Email Inbox.
Escolha o Nanonets se conformidade, integrações corporativas e automação de fluxos de trabalho forem requisitos inegociáveis.
Ideal para: equipes de médio porte a corporativas que precisam de conformidade SOC 2 / HIPAA / ISO 27001. Você está conectando ao SAP, Oracle ou Salesforce — não apenas ao Google Sheets. Você quer análises sobre produtividade e precisão da extração. Você está confortável com uma interface de construtor de fluxos de trabalho e tem pelo menos uma pessoa que pode cuidar da configuração. Seu volume justifica preços por faixas de volume. Você precisa de detecção de código de barras ou blocos personalizados em Python no seu pipeline de extração.
Escolha o Parseur se seus documentos chegam principalmente por e-mail e você precisa de um pipeline automatizado, configurado uma vez e esquecido, com preços para alto volume.
Ideal para: equipes de operações que recebem centenas ou milhares de documentos padronizados por e-mail todos os meses (faturas de fornecedores para ap@, notificações de envio, confirmações de pedido). Você quer a flexibilidade da extração por AI mais a confiabilidade da extração baseada em modelo para documentos de formato fixo. Você precisa de conformidade com o GDPR com infraestrutura hospedada na EU. Você está confortável em gerenciar a extração pelo painel web do Parseur e conectar a saída ao Sheets via sincronização ou Zapier. Seu volume é alto o suficiente (1.000+ páginas/mês) para que o preço por página funcione a seu favor.
O Que Usaríamos: Uma Recomendação Parcial, mas Honesta
Nós criamos o ImageToTable, então você sabe de que lado estamos. Mas aqui está quando realmente recomendaríamos as outras ferramentas — porque escolher a errada por lealdade não ajuda ninguém.
Se alguém da sua equipe tem experiência com ferramentas de automação de fluxo de trabalho e seus documentos chegam principalmente por email, o pipeline de encaminhamento de email do Parseur combinado com o motor híbrido de modelo/AI é genuinamente difícil de superar. A combinação de "encaminhar para a caixa de entrada → extração automática → sincronizar com o Sheets" elimina mais etapas do fluxo de trabalho do que qualquer abordagem concorrente para esse padrão específico de entrada.
Se você atua na área de saúde, jurídica ou financeira em uma escala em que certificações de conformidade são o mínimo esperado, a pilha SOC 2 + HIPAA + ISO 27001 do Nanonets o coloca em uma categoria própria. Você também pode precisar das integrações empresariais deles (SAP, Salesforce, Oracle) que ferramentas de autoatendimento não oferecem. Nessa escala, o preço por bloco com descontos por volume pode ser mais econômico do que modelos de assinatura fixa.
Mas para a equipe que a maioria das pessoas que fazem essa pergunta realmente tem — de 3 a 15 pessoas, de 100 a 3.000 documentos por mês, Google Sheets como hub, sem engenheiro de automação dedicado, sem checklist de certificação de conformidade do jurídico — o ImageToTable faz a coisa específica que elas precisam (extração baseada em nome de coluna para uma planilha) com o menor atrito entre abrir a ferramenta e ter dados utilizáveis. Se você ainda está em dúvida, as dicas práticas para aproveitar ao máximo a extração de documentos com AI se aplicam independentemente da ferramenta que você escolher.
Perguntas Frequentes
Essas ferramentas oferecem testes gratuitos?
Sim, todas as três. O ImageToTable tem uma cota gratuita diária sem necessidade de cadastro — você pode processar documentos reais imediatamente. O Nanonets dá a cada nova conta $200 em créditos gratuitos, o suficiente para milhares de documentos. O plano gratuito do Parseur inclui 20 páginas por mês com acesso completo aos recursos. Nenhum exige cartão de crédito para começar.
Qual ferramenta tem a melhor precisão?
A precisão depende mais do tipo e da qualidade dos seus documentos do que da ferramenta. O Nanonets ocupa o 1º lugar no IDP Leaderboard independente em precisão de extração de documentos de referência. O mecanismo de modelo do Parseur produz resultados idênticos todas as vezes em layouts fixos, e o Vision AI lida com layouts variáveis. O ImageToTable relata até 99% de precisão em dados de tabelas impressas usando extração semântica baseada em VLM. Para qualquer ferramenta, documentos manuscritos, digitalizações de baixa qualidade e layouts muito densos reduzem a precisão. A melhor forma de comparar é testar cada uma com seus próprios documentos — as três oferecem pontos de partida gratuitos.
Essas ferramentas são compatíveis com o GDPR?
O Parseur é o mais forte em GDPR — a infraestrutura é hospedada na EU e nativa em GDPR por design. O Nanonets oferece conformidade com o GDPR com opções de residência de dados (US, EU, APAC) nos planos Enterprise. O ImageToTable criptografa dados em trânsito e em repouso com exclusão automática configurável; é adequado para a maioria dos casos de uso de SMB, mas não possui certificação formal de GDPR. Se a conformidade com o GDPR com certificações documentadas for um requisito obrigatório, o Parseur ou o Nanonets Enterprise são as escolhas mais seguras.
Posso usar essas ferramentas sem escrever código?
Sim, as três são projetadas para operação sem código. ImageToTable: digite os nomes das colunas em um campo de texto, faça upload dos arquivos, baixe os resultados. Nanonets: construtor visual de fluxos de trabalho com blocos de arrastar e soltar — a programação é opcional (blocos personalizados em Python estão disponíveis para usuários avançados). Parseur: instruções de campo em linguagem simples através de uma interface web, com pós-processamento opcional em Python nos planos Scale+. Nenhuma exige programação para começar, embora as três ofereçam APIs para equipes que desejam acesso programático.
Posso misturar tipos diferentes de documentos em um lote?
ImageToTable: Sim — você pode fazer upload de uma mistura de faturas, recibos e extratos em um lote e extrair as mesmas colunas nomeadas de cada um. A AI localiza "Date" ou "Total" independentemente do tipo de documento. Nanonets: os fluxos de trabalho normalmente são configurados por tipo de documento — você usaria blocos de classificação para encaminhar documentos diferentes para caminhos de extração diferentes. Parseur: cada caixa de correio é projetada para um esquema de documento, mas o Vision AI e o Text AI podem lidar com variação de layout dentro desse tipo. Misturar tipos de documentos fundamentalmente diferentes (faturas + contratos) em uma caixa de correio não é o caso de uso pretendido.
Existem custos ocultos com os quais devo me preocupar?
O modelo por bloco do Nanonets tem o maior potencial de cobranças inesperadas — um documento complexo que aciona mais blocos do que o esperado custa mais do que um simples. O modelo por página do Parseur é mais previsível, mas PDFs de várias páginas multiplicam o custo (um extrato de 10 páginas custa 10x uma fatura de 1 página). O modelo de assinatura do ImageToTable é o mais previsível — você paga a taxa mensal fixa independentemente da complexidade do documento ou do número de páginas, embora exceder seu limite de Credits exija fazer upgrade ou comprar Credits adicionais.