ImageToTable vs Nanonets vs Parseur para equipos no técnicos:
Una comparación honesta de 2026
La mayoría de las comparativas de extracción de documentos parecen listas de funciones escritas por los proveedores. Responden preguntas que nadie en tu equipo se está haciendo. A la gerente de operaciones que procesa 200 facturas al mes no le importa qué herramienta obtuvo la puntuación más alta en el IDP Leaderboard. Ella quiere saber si alguien de su equipo puede configurarla esta misma tarde sin llamar a TI, cuánto costará realmente cada mes, y si los datos extraídos llegan a Google Sheets sin un desvío por Zapier. Esta comparativa responde esas preguntas — y explícitamente no responde las que les importan más a los equipos de compras de Fortune 500 que al equipo que realmente diriges.
Conclusiones clave
- Las tres herramientas venden 'extracción de documentos' — pero sus modelos de precios divergen tanto que 400 páginas al mes cuestan $19 en una y $120 en otra.
- La pregunta sobre Google Sheets que importa no es '¿pueden los datos llegar eventualmente a una hoja de cálculo?' — es si la extracción ocurre dentro de la hoja que tu equipo ya tiene abierta, y solo ImageToTable.ai responde con un complemento nativo de panel lateral.
- Olvídate de las tablas comparativas de funciones — la pregunta correcta elige tu herramienta por ti: ¿tu equipo vive en hojas de cálculo, procesa documentos desde correos reenviados, o necesita certificaciones de cumplimiento empresarial?
Por Qué Existe Esta Comparación (Y Lo Que No Cubriremos)
ImageToTable, Nanonets y Parseur resuelven el mismo problema central: convertir documentos no estructurados en datos estructurados listos para hojas de cálculo, sin volver a teclear manualmente. Pero lo abordan desde tres ángulos fundamentalmente diferentes — y la diferencia importa más de lo que revela cualquier lista de funciones.
Esta comparación está escrita desde la perspectiva de un líder de equipo no técnico: alguien que dirige operaciones, finanzas o una pequeña empresa y necesita extracción de documentos que funcione dentro de un flujo de trabajo centrado en hojas de cálculo. El equipo probablemente vive en Google Sheets. Nadie en el personal tiene tiempo para etiquetar datos de entrenamiento o esperar un ciclo de implementación. El presupuesto es real pero no es cero — la pregunta no es "qué es lo más barato" sino "cuál es el gasto adecuado para nuestro uso real."
Lo que no cubriremos: Esta no es una revisión de latencia de API, puntuaciones de benchmarks de modelos o arquitecturas de implementación empresarial. Si eres un líder de ingeniería evaluando APIs de extracción para un pipeline de producción que procesa un millón de páginas al mes, los criterios que te importan son diferentes de los que importan aquí. Tampoco vamos a fingir que esta es una "revisión imparcial de terceros." Construimos ImageToTable. Pero hemos usado las otras dos herramientas, hablado con sus usuarios y consultado sus precios en páginas públicas. Cuando un competidor hace algo mejor, lo diremos.
Si todavía estás entendiendo qué hace realmente la extracción de documentos con AI — y en qué se diferencia de las herramientas de OCR que quizás hayas probado antes — comienza con qué significa realmente la extracción de datos de documentos y cómo difiere la extracción con AI del OCR tradicional. Este artículo asume que ya sabes que necesitas una herramienta de extracción y estás decidiendo cuál.
Pregunta 1: ¿Alguien de mi equipo puede usarlo hoy sin capacitación?
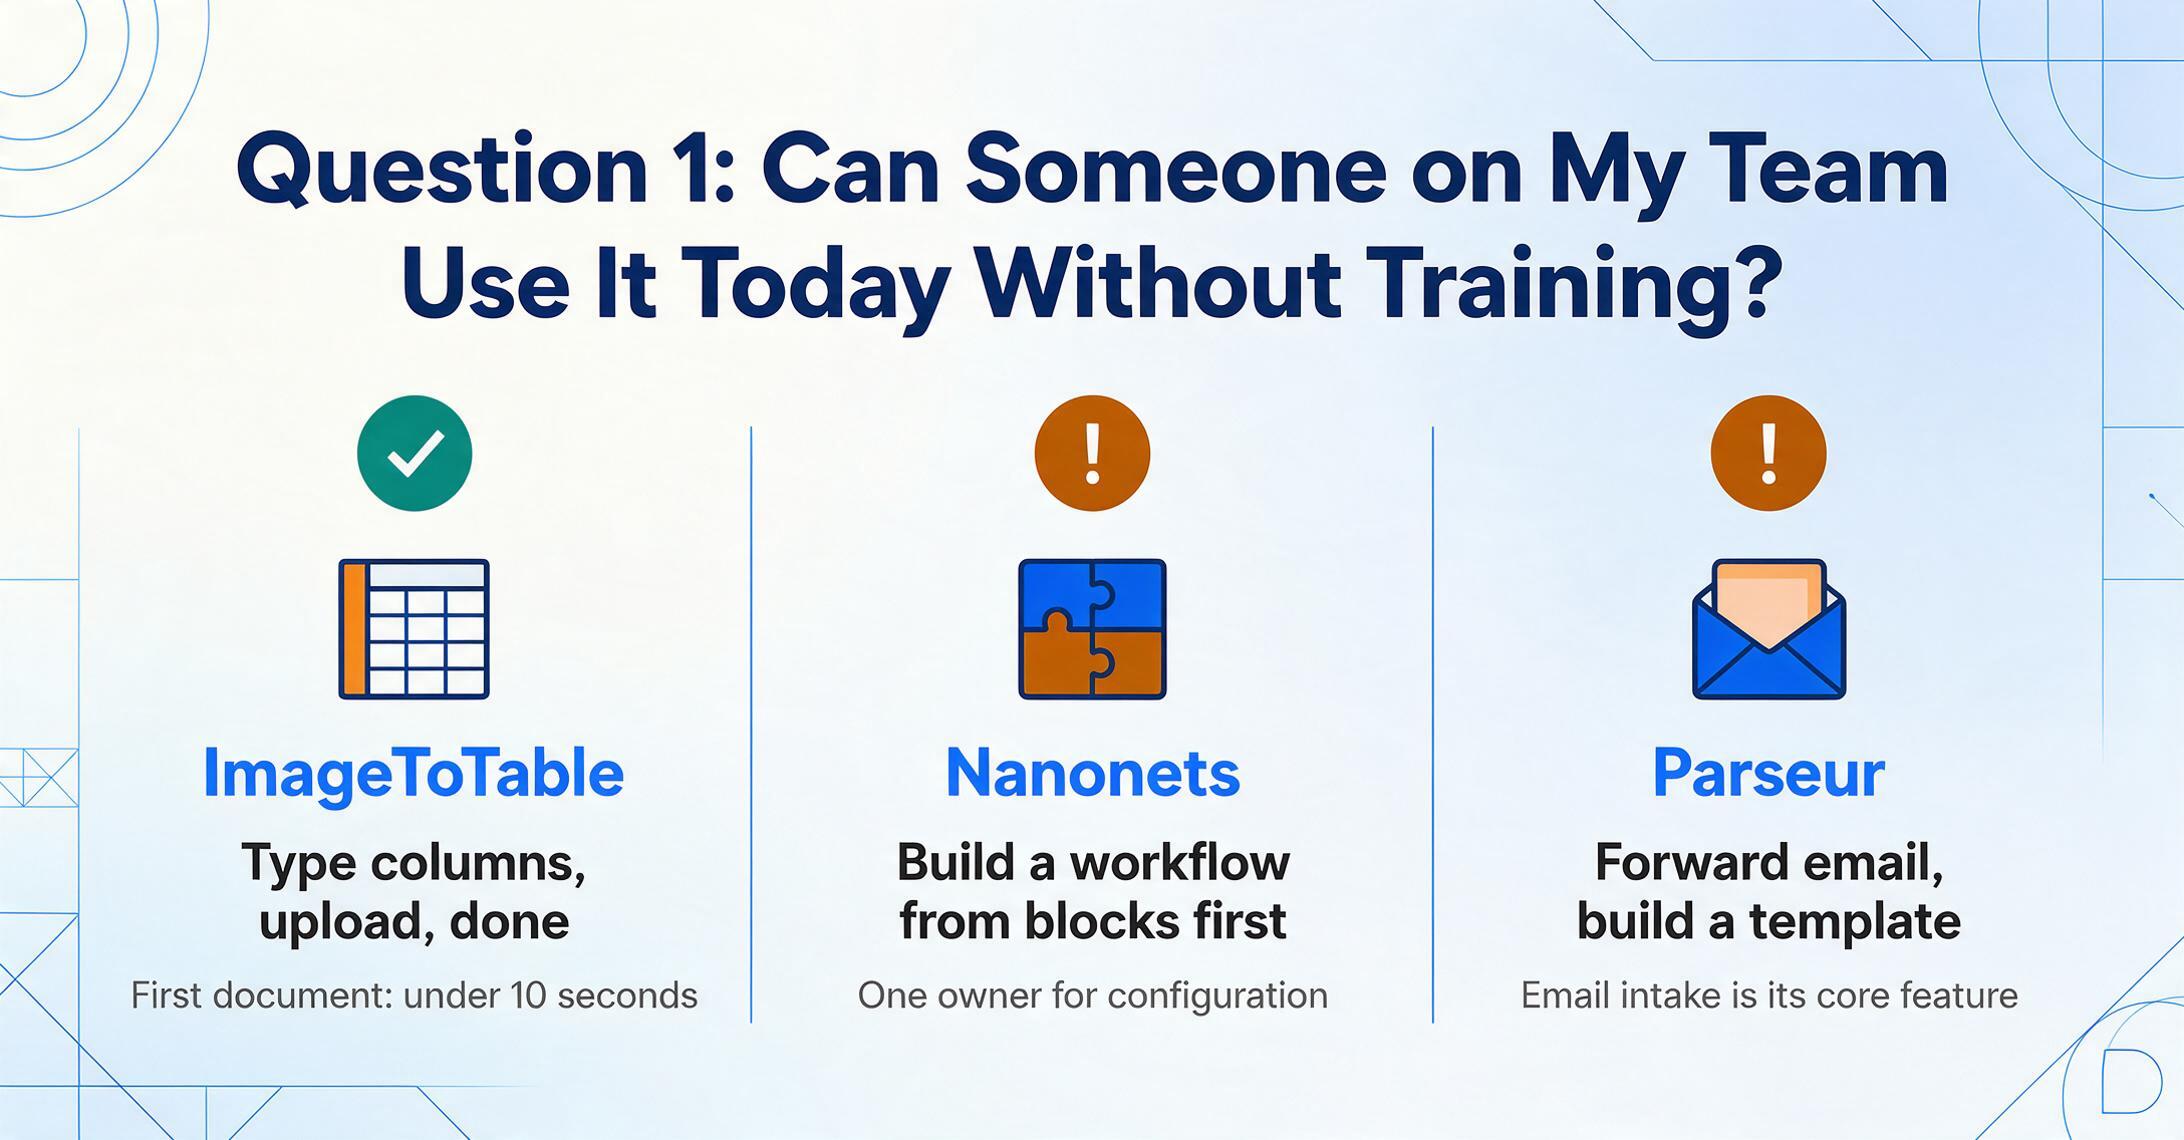
Esta es la pregunta que mata la mayoría de las evaluaciones de herramientas. Un producto puede ser potente sobre el papel, pero si lleva una semana incorporarlo — o requiere conceptos que tu equipo no maneja — la adopción muere en el primer mes. Las tres herramientas adoptan enfoques claramente distintos para la primera experiencia.
ImageToTable: escribe los nombres de tus columnas, sube, listo
No hay fase de configuración. Escribes los nombres de los campos que quieres — "Número de factura", "Proveedor", "Fecha", "Total" — subes un documento, y la AI extrae esos valores. Los nombres de columna que introduces se convierten en los encabezados de tu tabla de salida. No hay plantilla que crear, ni datos de entrenamiento que etiquetar, ni "motor de análisis" que seleccionar. Puedes omitir los nombres de columna por completo y dejar que la AI detecte automáticamente lo que hay en el documento, y luego refinar a partir de ahí.
Este enfoque — lo que llamamos Extracción de Columnas Personalizadas — funciona porque la AI entiende qué significa "Número de factura" semánticamente, no dónde se encuentra en la página. No dibujas recuadros alrededor de los campos ni enseñas al sistema cómo son tus facturas. ¿Un proveedor cambia el diseño de su factura? La AI se adapta. ¿Alguien envía una foto desde el móvil en lugar de un PDF? Mismo proceso. Para un análisis más profundo de por qué esto importa, consulta cómo se compara la extracción de columnas personalizadas con la conversión de documentos completos a tablas.
El primer documento suele procesarse en menos de 10 segundos. Un nuevo miembro del equipo puede pasar del registro a la extracción finalizada sin documentación.
Nanonets: Crea un flujo de trabajo con bloques
Nanonets usa un creador de flujos de trabajo visual hecho de "bloques": cada bloque realiza un paso: ingesta de documentos, clasificación, extracción de datos, validación, exportación. Para un flujo de trabajo de facturas estándar, normalmente encadenarás de 4 a 6 bloques. El bloque de extracción funciona con AI y no requiere crear plantillas: detecta campos automáticamente en los documentos, igual que ImageToTable.
Pero llevar un flujo de trabajo a producción requiere más pasos que un simple flujo de subir y extraer. Necesitas entender el concepto de bloque, configurar cada etapa y probar el pipeline de principio a fin. La interfaz está diseñada para personas familiarizadas con conceptos de automatización de flujos de trabajo: es intuitiva para ese público, pero la curva es más pronunciada que "escribe campos, sube, descarga". La documentación oficial de Nanonets estima que la configuración toma minutos para flujos simples, pero usuarios en Reddit r/dataengineering reportan que ajustar pipelines complejos con múltiples tipos de documentos puede tomar días de iteración.
Parseur: Elige tu motor y configura un buzón
Parseur organiza la extracción alrededor de "buzones": cada buzón maneja un tipo de documento con su propio esquema de campos y reglas de procesamiento. En la primera subida, Parseur identifica automáticamente los campos que cree que quieres extraer. Luego puedes refinar la lista de campos y escribir instrucciones en inglés sencillo por campo. Parseur elige el motor de análisis correcto automáticamente: Vision AI para diseños con muchas imágenes, Text AI para contenido de texto plano, plantillas para formularios fijos.
La detección automática de campos en la primera subida es realmente útil y reduce las conjeturas iniciales. Pero la estructura de buzón + motor + post-procesamiento introduce conceptos que los usuarios no técnicos necesitan aprender. El motor de plantillas, aunque opcional, requiere crear una plantilla visual por diseño de documento: útil cuando necesitas resultados idénticos cada vez, pero trabajo adicional si tus documentos vienen de muchos proveedores con formatos diferentes. Según la documentación de Parseur, la mayoría de los flujos de trabajo se ponen en marcha en menos de 10 minutos para casos de uso simples.
| ImageToTable | Nanonets | Parseur | |
|---|---|---|---|
| Tiempo hasta la primera extracción | Menos de 1 minuto | 5–15 minutos (flujo de trabajo simple) | 2–10 minutos (primer buzón) |
| Modelo de configuración | Escribe nombres de columnas → sube | Constructor visual de flujos (bloques) | Buzón + instrucciones de campos |
| ¿Se requiere plantilla? | No | No (la AI detecta campos automáticamente) | Opcional — la AI funciona sin plantillas |
| ¿Se necesitan datos de entrenamiento? | Ninguno | Ninguno para extracción estándar | Ninguno |
| ¿Maneja cambios de diseño? | Automáticamente — extracción semántica | Automáticamente — la AI se adapta | Los motores de AI se adaptan; las plantillas necesitan actualización |
Si tu requisito principal es que un miembro del equipo sin conocimientos técnicos sea productivo en menos de 5 minutos, ImageToTable tiene el camino más corto. El concepto de buzón de Parseur es el siguiente más accesible: la detección automática de campos en la primera subida elimina la fricción de "¿cómo nombro los campos?". Nanonets te da el mayor control del flujo de trabajo, pero a un costo de complejidad que tiene más sentido si ya tienes a alguien cómodo con herramientas de automatización en el equipo.
Pregunta 2: ¿Cuánto Pagaré Realmente al Mes?
Los modelos de precios en la extracción de documentos son sorprendentemente diferentes, y las diferencias importan más que los precios de etiqueta. Una herramienta cobra por página, otra por operación de AI, otra cobra una suscripción mensual fija. El mismo volumen de documentos puede generar facturas muy distintas según el modelo en el que estés.
Los Tres Modelos de Precios, Explicados
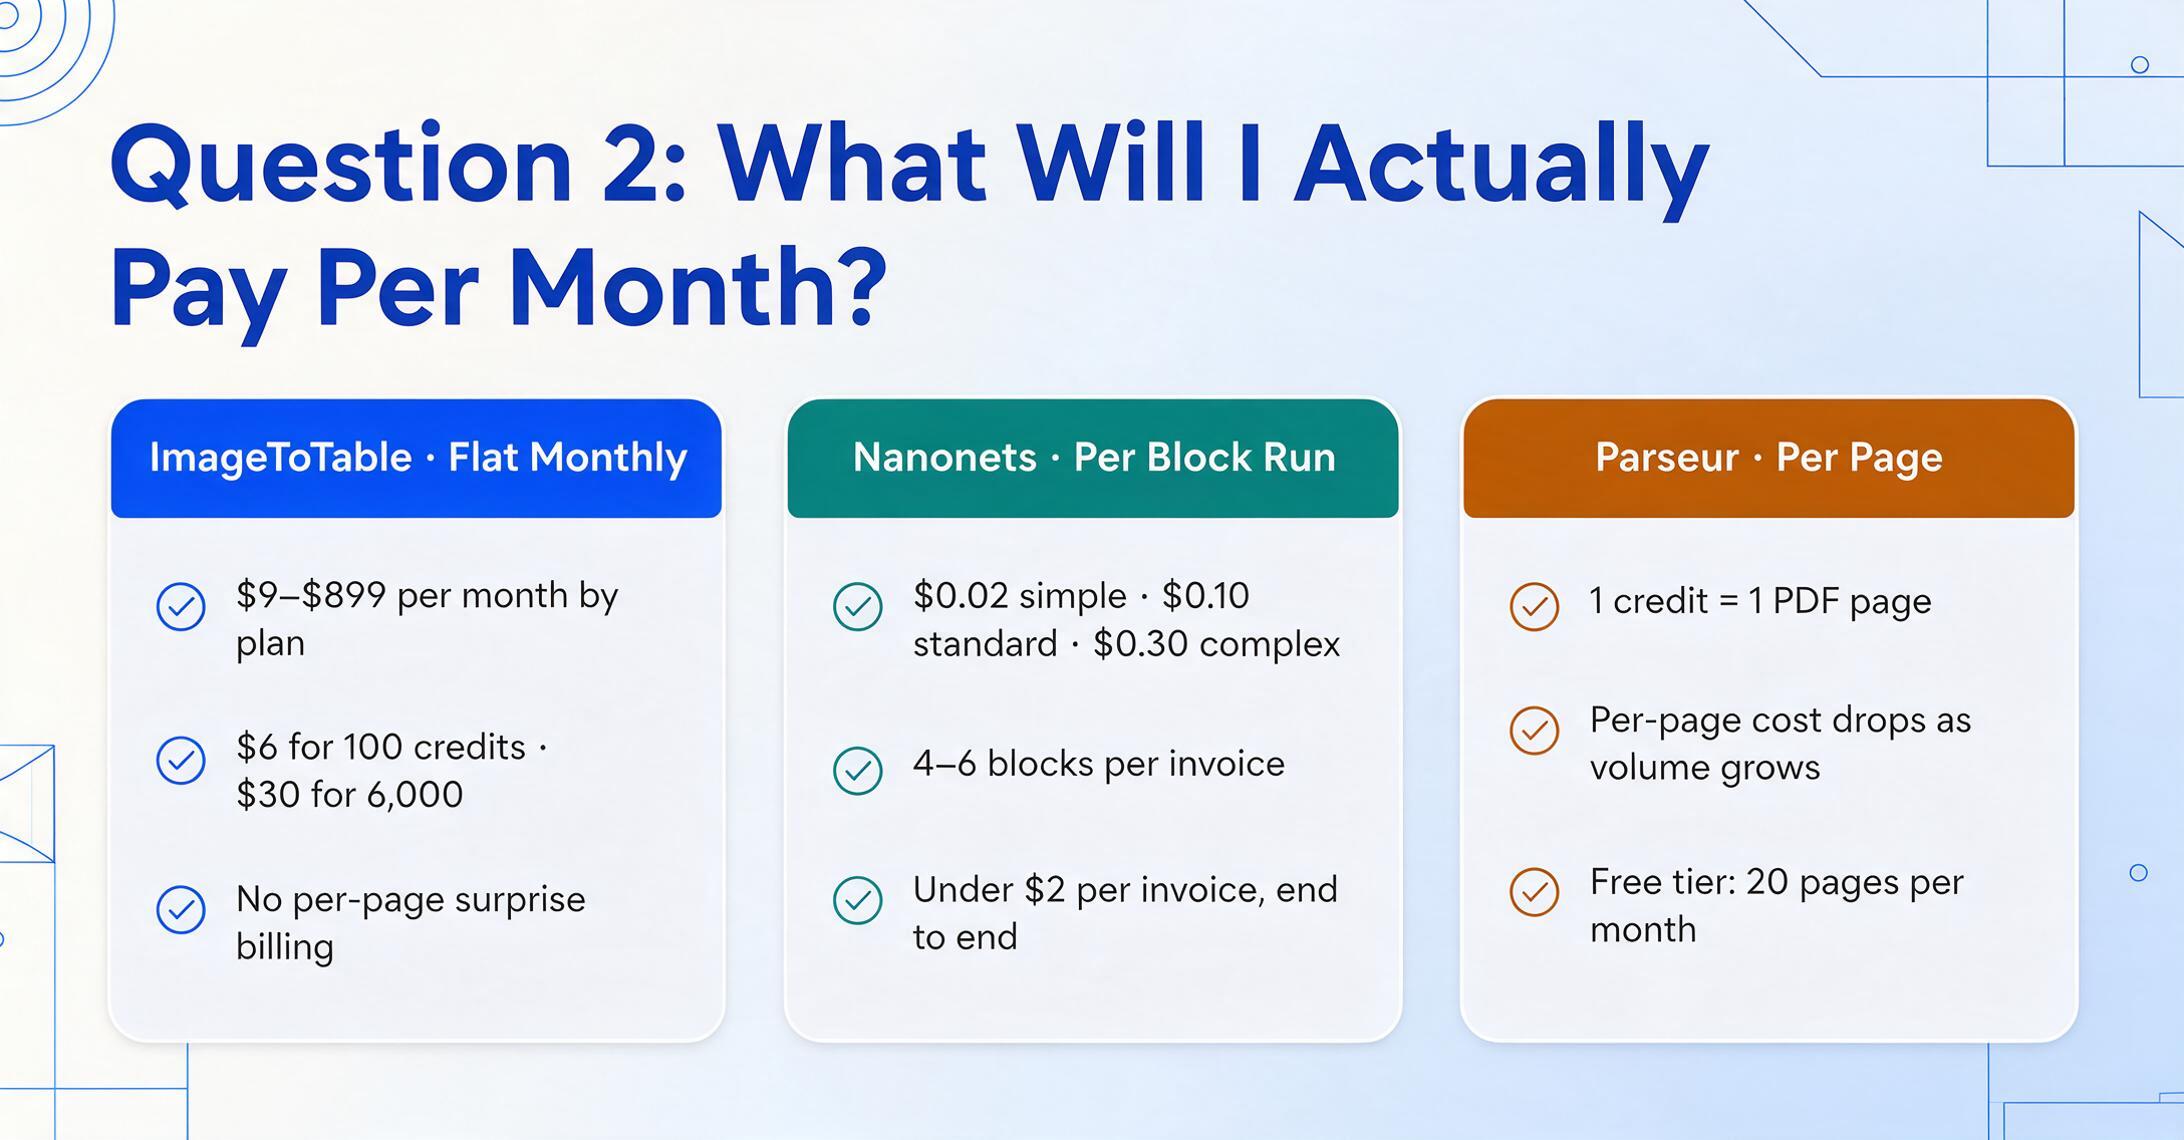
ImageToTable: Suscripción mensual con límites de créditos. Pagas una tarifa mensual fija ($9–$899 según el plan) y obtienes un número determinado de créditos; cada crédito procesa una imagen o una página de PDF. Los créditos no usados no se acumulan, pero no hay facturas sorpresa por página. También puedes comprar paquetes de créditos únicos ($6 por 100 créditos, hasta $300 por 6,000 créditos) sin suscripción. Una cuota diaria gratuita te permite probar con documentos reales antes de pagar nada.
Nanonets: Precio por consumo de bloques. Nanonets cobra por "block run": cada paso en un flujo de trabajo consume créditos a diferentes tarifas: $0.02 por operaciones simples (formato, enrutamiento), $0.10 por AI estándar (clasificación, validación), $0.30 por AI complejo (extracción de datos). Un flujo de trabajo típico de facturas usa 4–6 bloques. Nanonets estima esto en menos de $2 por factura de principio a fin. El plan Starter incluye $200 en créditos gratuitos. Los planes Team con descuentos por volumen y créditos compartidos requieren contactar con ventas.
Parseur: Precio por volumen de páginas. Parseur cobra por página procesada, y el costo por página disminuye a medida que aumenta el volumen. 1 crédito = 1 página de PDF. Los correos electrónicos y hojas de cálculo cuentan como 1 página independientemente de su longitud. El nivel gratuito incluye 20 páginas/mes. Los planes de pago comienzan desde un nivel base y escalan hasta 1 millón de páginas/mes en autoservicio, con Enterprise manejando hasta 10 millones de páginas. Parseur no publica precios exactos por página en cada nivel de volumen; el control deslizante de precios te permite estimar, pero el precio final aparece después del registro. La calculadora de ROI en la página de precios de Parseur te permite modelar costos según tu volumen de documentos y número de empleados.
Cuánto Cuesta Cada Modelo en Tres Volúmenes Realistas
| Volumen Mensual | ImageToTable | Nanonets (est.) | Parseur (est.) |
|---|---|---|---|
| 50 páginas/mes | $0 (cuota diaria gratuita) o $9/mes (Basic) | $0 (los créditos Starter cubren esto) | Plan de pago de gama baja (por encima de 20 gratuitas) |
| 400 páginas/mes | $19/mes (Pro, 400 créditos) — ~$0.05/página | ~$60–$120/mes (a ~$0.15–$0.30/página para flujos de trabajo con mucha extracción) | Plan de pago — estimado $40–$80/mes |
| 3,000 páginas/mes | $149/mes (Growth, 3,000 créditos compartidos) — ~$0.05/página | ~$150–$300/mes (con descuentos por volumen, contactar ventas) | Plan Scale — estimado $150–$300/mes |
Precios de ImageToTable de la página pública de precios en imagetotable.ai/upgrade_service. Estimaciones de Nanonets basadas en precios públicos por bloque en nanonets.com/pricing, asumiendo un flujo de trabajo típico de facturas de 4–6 bloques. Estimaciones de Parseur basadas en los rangos del controlador de volumen en parseur.com/pricing — los precios exactos por página requieren registro. Todos los precios en USD. Las estimaciones de Nanonets y Parseur son para extracción — pueden aplicarse costos adicionales por funciones complementarias.
El modelo por bloque introduce una imprevisibilidad real que los modelos de suscripción evitan. Un mes tu equipo procesa 400 facturas estándar de una página — asequible. El siguiente mes, un proveedor envía 50 estados de cuenta de varias páginas con contratos adjuntos que activan más bloques de lo esperado. Tu factura cambia y no sabes cuánto hasta que llega. Para equipos con tipos de documentos y volúmenes predecibles, esto es manejable. Para equipos que procesan una mezcla de documentos cortos y largos de fuentes cambiantes, el modelo de suscripción es más fácil de presupuestar.
Una dimensión de precios donde Nanonets y Parseur tienen ventaja: descuentos por alto volumen. Si procesas 10,000+ páginas al mes de forma constante, sus precios escalonados por volumen pueden superar a los modelos de suscripción plana en costo por página. Para los rangos de volumen en los que operan la mayoría de los equipos no técnicos (50–3,000 páginas/mes), sin embargo, la suscripción plana de ImageToTable suele salir más barata.
Pregunta 3: ¿Funciona dentro de Google Sheets?
Para equipos cuyo flujo de trabajo completo vive en Google Sheets, la pregunta sobre la integración no es "¿pueden los datos llegar eventualmente a una hoja de cálculo?" — es "¿puedo extraer datos sin salir de la hoja de cálculo en la que ya estoy trabajando?" La diferencia entre un complemento nativo y un pipeline de Zapier/webhook determina si la extracción se convierte en parte del flujo de trabajo o en un paso separado que alguien tiene que recordar hacer.
ImageToTable: Complemento nativo de barra lateral para Google Sheets
ImageToTable ofrece un complemento de Google Workspace Marketplace que integra el motor de extracción completo como barra lateral de Sheets. Defines columnas, subes documentos y los datos extraídos llegan directamente a tu hoja activa — sin exportar archivos, sin descargar y volver a subir, sin cambiar de pestaña. Las plantillas de columnas se pueden guardar y reutilizar entre lotes, así tu plantilla de "Extracción de Facturas" funciona igual todos los meses.
El complemento funciona en modo cuenta: conecta tu API Key una vez, y tu historial de extracción y plantillas de Sheets se sincronizan con tu cuenta web. El uso cuenta contra tu cuota del plan. Esto es importante porque significa que todo tu equipo puede usar el complemento desde la misma hoja de cálculo compartida — los datos extraídos aparecen donde todos ya trabajan.
Nanonets: Zapier, API o exportación
Nanonets no ofrece un complemento nativo de Google Sheets. Los datos llegan a Google Sheets a través de una de tres vías: un conector de Zapier/Make/Power Automate (que añade un paso de middleware y posible latencia), la API REST (requiere trabajo de ingeniería para configurar un pipeline), o exportación manual a CSV/Excel (que anula el propósito de la automatización).
Para equipos con una pila de automatización existente, la ruta de Zapier funciona bien — una vez configurada, los datos extraídos fluyen a Sheets automáticamente. Pero la configuración inicial requiere entender tanto el constructor de flujos de trabajo de Nanonets como el modelo de disparador/acción de Zapier. No es lo mismo que una barra lateral que funciona directamente.
Parseur: Webhook, Zapier o sincronización directa
Parseur ofrece "sincronización en vivo con Google Sheets" como integración nativa: una vez conectado, los datos extraídos se sincronizan automáticamente a una hoja específica. Esto se acerca más a una experiencia nativa que el enfoque de middleware de Nanonets, pero sigue siendo un paso de configuración separado, no un flujo de trabajo dentro de Sheets. Parseur también admite Google Sheets a través de conectores de Zapier, Make, Power Automate y n8n.
La sincronización directa significa que configuras la conexión una vez y los datos fluyen automáticamente con cada nuevo documento procesado. Pero sigues gestionando la extracción desde la interfaz web de Parseur: no hay un panel lateral que puedas usar sin salir de Sheets.
Si Google Sheets es donde trabaja tu equipo: el panel lateral nativo de ImageToTable es la integración más cercana. La sincronización directa de Parseur es una sólida segunda opción para pipelines automatizados de "configurar y olvidar". Nanonets requiere más pasos intermedios, pero ofrece la mayor flexibilidad si tu flujo de trabajo abarca múltiples destinos más allá de Sheets.
Pregunta 4: ¿Qué tipos de documentos maneja bien cada uno?
Las tres herramientas afirman manejar "cualquier documento". En la práctica, cada una tiene puntos fuertes y casos límite donde rinde mejor — y donde podría tener dificultades. Entender esto no se trata de declarar un ganador; se trata de hacer coincidir la herramienta con lo que tu equipo realmente procesa.
| Capacidad del documento | ImageToTable | Nanonets | Parseur |
|---|---|---|---|
| Formatos de entrada | PDF, JPG, PNG, WebP, AVIF, capturas de pantalla | PDF, imágenes, Word, Excel: amplia compatibilidad de formatos | PDF, imágenes, correos electrónicos, hojas de cálculo, más de 25 formatos |
| Recepción por correo electrónico | Disponible: dirección de bandeja de entrada dedicada, procesamiento automático con una plantilla vinculada | Disponible (integración de correo electrónico) | Función principal: reenvía correos a una dirección de buzón única |
| Compatibilidad con escritura a mano | Sí: comprensión semántica VLM | No se destaca especialmente | Vision AI captura escritura a mano, casillas de verificación y sellos |
| Extracción de tablas / partidas | Sí: basada en columnas + columna calculada para cálculos | Sí: con estructura de tabla conservada en la salida | Sí: cada fila se convierte en un registro propio, maneja recuentos de filas variables |
| Documentos multilingües | Idiomas principales compatibles | Más de 100 idiomas | Más de 200 idiomas (OCR); los motores de IA admiten los idiomas principales |
| Conservación del diseño (A Word) | Modo A Word: restauración completa del diseño a Word editable | Diseño conservado en la salida de Markdown | No es una función principal: la salida son datos estructurados |
| Detección de casillas / sellos / firmas | Sí: estado de casillas, sellos, firmas | Detección de códigos de barras y firmas en planes Growth+ | Vision AI captura casillas de verificación y sellos |
| Cumplimiento y certificaciones de seguridad | Cifrado HTTPS, almacenamiento cifrado, auto-eliminación | SOC 2 Type II, HIPAA, GDPR, ISO 27001 | Nativo GDPR (alojado en la UE), SOC 2 Type II en curso |
La diferencia en la recepción de correos electrónicos solía ser una brecha clara entre estas herramientas — ya no lo es. Parseur se construyó en torno al correo electrónico como fuente principal de documentos: reenvías facturas y recibos a una dirección de buzón dedicada y se procesan automáticamente. Para equipos cuyos documentos llegan principalmente por correo (facturas de proveedores enviadas a ap@, recibos de gastos reenviados por el personal), esto es un verdadero impulso de productividad. Nanonets ofrece una integración de correo similar. ImageToTable ahora también tiene esto a través de Email Inbox: cada cuenta recibe una dirección de buzón dedicada, activar Auto-Process con una plantilla vinculada inicia la extracción en cuanto llega el correo, y una lista blanca de remitentes opcional mantiene el correo no relacionado fuera de la cola. Email Inbox se puede configurar para leer archivos adjuntos, el cuerpo del correo o ambos, por lo que cubre ambos casos: un PDF de factura reenviado o un proveedor que simplemente escribe los números en el texto del mensaje.
En el frente de cumplimiento, Nanonets está en otra liga. Las certificaciones SOC 2 Type II, HIPAA, GDPR e ISO 27001 importan si estás en salud, finanzas o cualquier industria con requisitos de manejo de datos regulados. Parseur ofrece infraestructura nativa de GDPR (alojada en la EU) con SOC 2 en progreso. ImageToTable cifra los datos en tránsito y en reposo con auto-eliminación configurable — suficiente para la mayoría de los casos de uso de SMB, pero no para organizaciones que necesitan marcar casillas de cumplimiento durante la revisión de proveedores.
Pregunta 5: ¿Puede crecer con nosotros?
La herramienta que funciona para dos personas procesando 100 facturas al mes podría fallar cuando el equipo crece a ocho personas procesando 2,000. La pregunta del crecimiento no es solo sobre volumen — es sobre acceso del equipo, recursos compartidos, y si el techo de la herramienta está por encima o por debajo de la trayectoria de tu equipo.
Procesamiento por lotes: ¿Cuántos documentos a la vez?
ImageToTable admite cargas por lotes donde sueltas varios archivos a la vez, defines tus columnas una vez, y obtienes una única tabla de salida combinada. La concurrencia de carga escala con el nivel del plan — desde 1 carga simultánea en Free hasta 3 en planes Team. El valor real del lote es la fusión: 50 facturas de 15 proveedores diferentes, todas extraídas en una sola hoja de cálculo con encabezados de columna consistentes, sin configuración por archivo. La función Enlace de Recopilación añade una dimensión de crecimiento que ningún competidor ofrece: puedes generar un enlace compartible donde clientes o personal de campo suben documentos directamente a tu cola de procesamiento.
Nanonets maneja el procesamiento por lotes a través de su motor de flujo de trabajo — los documentos fluyen por los bloques configurados en secuencia, con colas por cuenta que aíslan tu procesamiento de otros clientes. Los planes Team incluyen créditos compartidos y hasta 3 usuarios en Starter. Growth y Enterprise añaden análisis, informes y descuentos por volumen de hasta 40%. Para equipos que necesitan rastrear métricas de rendimiento y precisión de extracción a lo largo de meses, la capa de análisis de Nanonets es la más sólida de las tres.
Parseur procesa documentos a través de buzones con campos ilimitados por extracción. Los planes Scale (10,000+ créditos/mes) desbloquean cuentas multiusuario (hasta 100 usuarios), post-procesamiento avanzado (código Python para lógica de negocio personalizada) y retención de documentos ilimitada. La fortaleza única de Parseur a escala es su pipeline de ingesta por correo electrónico: cuando tu volumen de documentos crece a miles por mes, la capacidad de auto-ingestar mediante reenvío de correo se vuelve más valiosa, no menos.
La dimensión de crecimiento donde ImageToTable tiene una ventaja que ningún competidor replica: Enlace de Recopilación te permite aumentar tu ingesta de documentos sin aumentar tu equipo. En lugar de contratar a alguien para perseguir proveedores por facturas o recordar a los empleados que envíen recibos de gastos, envías un enlace. Los documentos vienen a ti. Es un tipo diferente de escalabilidad — no procesar más documentos más rápido, sino llevar documentos al pipeline con menos fricción.
Cuándo elegir cada herramienta: una guía práctica para decidir
Ninguna herramienta gana en todas las dimensiones. La elección correcta depende de lo que tu equipo valore más y de las concesiones que estés dispuesto a aceptar. Así se desglosa la decisión para los escenarios más comunes que vemos.
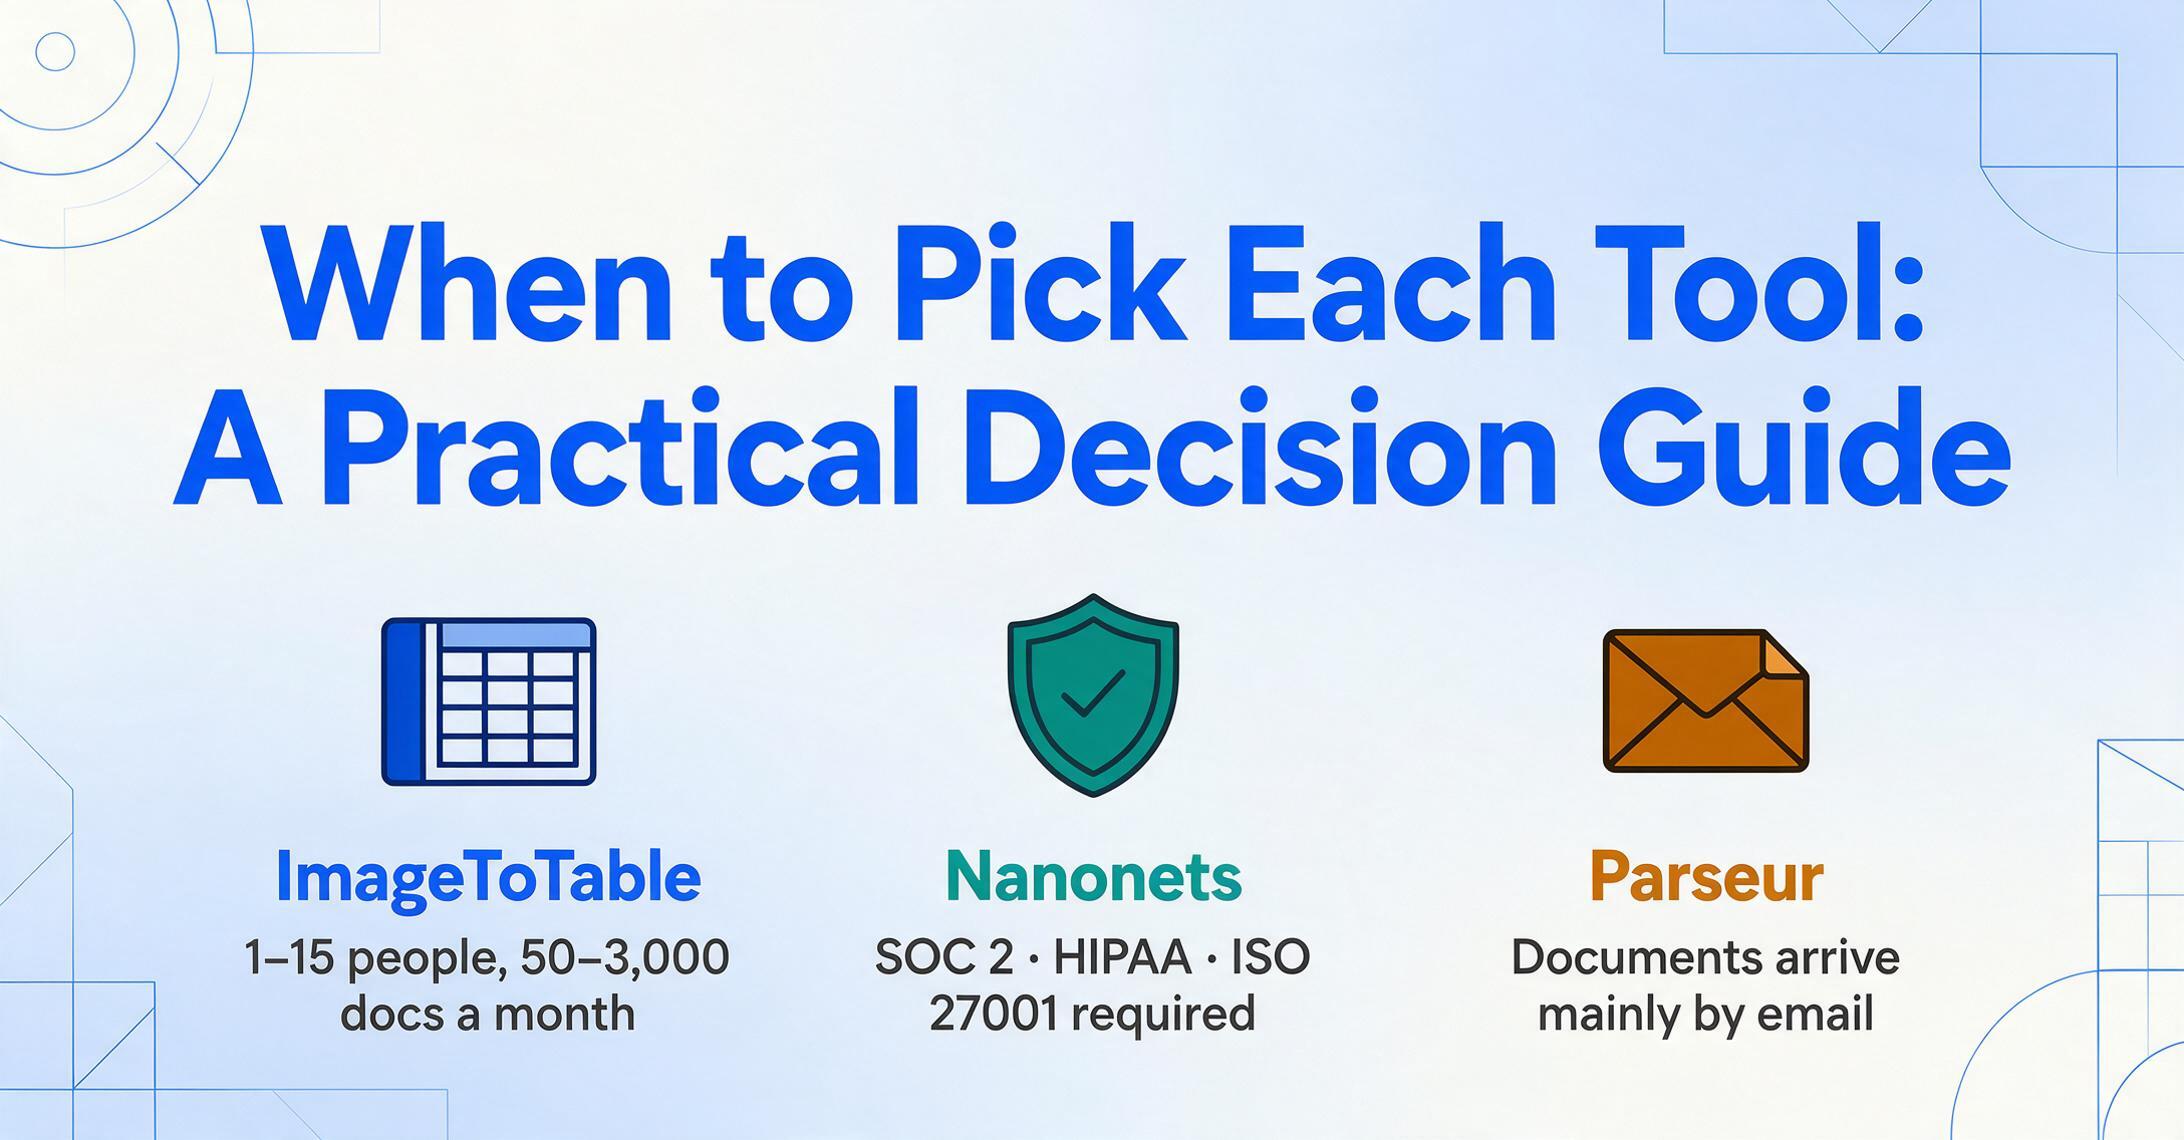
Elige ImageToTable si tu equipo trabaja en Google Sheets y necesita extracción que funcione hoy mismo: sin configuración, sin entrenamiento y sin involucrar a TI.
Ideal para: equipos pequeños y medianos (1–15 personas) que procesan 50–3,000 documentos/mes. Quieres un panel lateral en Sheets, no otra pestaña que gestionar. Valoras un precio mensual predecible por encima de la optimización por documento. Tus documentos llegan de múltiples fuentes y necesitas Enlace de Recopilación para reunirlos sin perseguirlos. Ocasionalmente necesitas salida a Word que conserve el diseño. No necesitas certificaciones de cumplimiento de nivel Nanonets como SOC 2 o HIPAA — la recepción automática de correos ya está cubierta por Email Inbox.
Elige Nanonets si el cumplimiento, las integraciones empresariales y la automatización de flujos de trabajo son requisitos innegociables.
Ideal para: equipos medianos y empresas que necesitan cumplimiento SOC 2 / HIPAA / ISO 27001. Te conectas a SAP, Oracle o Salesforce, no solo a Google Sheets. Quieres analíticas sobre rendimiento y precisión de extracción. Te sientes cómodo con una interfaz de creador de flujos y tienes al menos una persona que pueda encargarse de la configuración. Tu volumen justifica precios escalonados por volumen. Necesitas detección de códigos de barras o bloques personalizados de Python en tu pipeline de extracción.
Elige Parseur si tus documentos llegan principalmente por correo electrónico y necesitas un pipeline sin intervención, de configurar y olvidar, con precios para alto volumen.
Ideal para: equipos de operaciones que reciben cientos o miles de documentos estandarizados por correo cada mes (facturas de proveedores a ap@, notificaciones de envío, confirmaciones de pedido). Quieres la flexibilidad de la extracción con AI más la fiabilidad de la extracción basada en plantillas para documentos de formato fijo. Necesitas cumplimiento GDPR con infraestructura alojada en la EU. Te sientes cómodo gestionando la extracción desde el panel web de Parseur y conectando la salida a Sheets mediante sincronización o Zapier. Tu volumen es lo bastante alto (1,000+ páginas/mes) como para que el precio por página juegue a tu favor.
Qué usaríamos: una recomendación parcial pero honesta
Nosotros creamos ImageToTable, así que ya sabes hacia dónde nos inclinamos. Pero te diremos cuándo realmente recomendaríamos las otras herramientas, porque elegir la equivocada por lealtad no ayuda a nadie.
Si alguien de tu equipo tiene experiencia con herramientas de automatización de flujos de trabajo y tus documentos llegan principalmente por correo electrónico, el pipeline de reenvío por correo de Parseur más su motor híbrido de plantilla/AI es genuinamente difícil de superar. La combinación de "reenviar al buzón → extracción automática → sincronizar con Sheets" elimina más pasos del flujo de trabajo que cualquier otro enfoque para ese patrón de captura específico.
Si trabajas en salud, legal o finanzas a una escala donde las certificaciones de cumplimiento son requisitos básicos, el stack de SOC 2 + HIPAA + ISO 27001 de Nanonets lo coloca en una categoría propia. También podrías necesitar sus integraciones empresariales (SAP, Salesforce, Oracle) que las herramientas de autoservicio no ofrecen. A esa escala, el precio por bloque con descuentos por volumen puede ser más económico que los modelos de suscripción plana.
Pero para el equipo que la mayoría de quienes hacen esta pregunta realmente tienen — 3 a 15 personas, 100 a 3,000 documentos al mes, Google Sheets como centro, sin ingeniero de automatización dedicado, sin lista de certificaciones de cumplimiento del departamento legal — ImageToTable hace exactamente lo que necesitan (extracción basada en nombres de columnas hacia una hoja de cálculo) con la menor fricción entre abrir la herramienta y tener datos utilizables. Si aún tienes dudas, los consejos prácticos para aprovechar al máximo la extracción de documentos con AI aplican sin importar qué herramienta elijas.
Preguntas frecuentes
¿Estas herramientas ofrecen pruebas gratuitas?
Sí, las tres. ImageToTable tiene una cuota gratuita diaria sin necesidad de registro — puedes procesar documentos reales de inmediato. Nanonets da a cada cuenta nueva $200 en créditos gratuitos, suficientes para miles de documentos. El plan gratuito de Parseur incluye 20 páginas al mes con acceso completo a todas las funciones. Ninguna requiere tarjeta de crédito para empezar.
¿Qué herramienta tiene la mejor precisión?
La precisión depende más del tipo y la calidad de tu documento que de la herramienta. Nanonets ocupa el #1 en el IDP Leaderboard independiente en precisión de extracción de documentos de referencia. El motor de plantillas de Parseur produce resultados idénticos en cada ejecución con diseños fijos, y Vision AI maneja diseños variables. ImageToTable reporta hasta un 99% de precisión en datos tabulares impresos mediante extracción semántica basada en VLM. Para cualquier herramienta, los documentos manuscritos, los escaneos de baja calidad y los diseños muy densos reducirán la precisión. La mejor forma de comparar es probar cada una con tus propios documentos: las tres ofrecen puntos de partida gratuitos.
¿Estas herramientas cumplen con el GDPR?
Parseur es la más sólida en GDPR: su infraestructura está alojada en la EU y es GDPR-nativa por diseño. Nanonets ofrece cumplimiento de GDPR con opciones de residencia de datos (US, EU, APAC) en planes Enterprise. ImageToTable cifra los datos en tránsito y en reposo con auto-eliminación configurable; es adecuada para la mayoría de los casos de uso SMB, pero no cuenta con certificación formal de GDPR. Si el cumplimiento de GDPR con certificaciones documentadas es un requisito estricto, Parseur o Nanonets Enterprise son las opciones más seguras.
¿Puedo usar estas herramientas sin escribir código?
Sí, las tres están diseñadas para operación sin código. ImageToTable: escribe los nombres de las columnas en un campo de texto, sube archivos y descarga los resultados. Nanonets: constructor visual de flujos de trabajo con bloques de arrastrar y soltar: la programación es opcional (bloques personalizados de Python disponibles para usuarios avanzados). Parseur: instrucciones de campos en inglés sencillo a través de una interfaz web, con post-procesamiento opcional en Python en planes Scale+. Ninguna requiere programación para empezar, aunque las tres ofrecen APIs para equipos que quieran acceso programático.
¿Puedo mezclar diferentes tipos de documentos en un solo lote?
ImageToTable: Sí: puedes subir una mezcla de facturas, recibos y estados de cuenta en un solo lote y extraer las mismas columnas nombradas de cada uno. La AI localiza "Date" o "Total" independientemente del tipo de documento. Nanonets: los flujos de trabajo se configuran típicamente por tipo de documento: usarías bloques de clasificación para enrutar diferentes documentos a diferentes rutas de extracción. Parseur: cada buzón está diseñado para un esquema de documento, pero Vision AI y Text AI pueden manejar variaciones de diseño dentro de ese tipo. Mezclar tipos de documentos fundamentalmente diferentes (facturas + contratos) en un mismo buzón no es el caso de uso previsto.
¿Hay costos ocultos que deba tener en cuenta?
El modelo por bloques de Nanonets es el que más posibilidades tiene de generar cargos inesperados: un documento complejo que activa más bloques de lo previsto cuesta más que uno simple. El modelo por página de Parseur es más predecible, pero los PDF de varias páginas multiplican el costo (un extracto de 10 páginas cuesta 10 veces más que una factura de 1 página). El modelo de suscripción de ImageToTable es el más predecible: pagas la tarifa mensual fija sin importar la complejidad del documento ni la cantidad de páginas, aunque superar tu límite de créditos requiere actualizar el plan o comprar créditos adicionales.