ImageToTable vs Docparser:
¿Campos Flexibles o Plantillas Fijas? Una Comparación Honesta para 2026
Elegir entre ImageToTable y Docparser se reduce a una sola pregunta arquitectónica: ¿quieres una herramienta que coincida con zonas predefinidas en diseños fijos — o una que lea documentos entendiendo lo que significan los campos? La respuesta determina no solo qué tan rápido empiezas, sino cuánto tiempo dedicas a mantener el flujo seis meses después. Ambas herramientas extraen datos estructurados de documentos. Pero abordan la extracción desde arquitecturas fundamentalmente diferentes, y la arquitectura que funciona para un equipo con tres plantillas de facturas estables frustrará a un equipo que maneja documentos de cuarenta proveedores que actualizan sus diseños según sus propios calendarios.
Conclusiones Clave
- La mayoría de los artículos de comparación analizan el tiempo de configuración — el costo real es el mantenimiento silencioso que comienza cuando el primer proveedor cambia el diseño de su factura tres meses después.
- Docparser gana honestamente en dos dimensiones: su motor de regex y reglas de análisis condicional son más profundos que las columnas calculadas de ImageToTable, y su ecosistema de integraciones de nivel Zapier no tiene equivalente en el lado de ImageToTable.
- Elige según cómo se ven tus documentos — los PDFs estables de varias páginas de remitentes conocidos favorecen a Docparser, mientras que la variedad de diseños, fotos de teléfono, escritura a mano y lotes de fuentes mixtas favorecen a ImageToTable.
Comparación rápida
Antes de analizar cada dimensión, aquí tienes un resumen de cómo se comparan las dos herramientas en los factores que más importan al decidir sobre extracción de documentos.
| Dimensión | Docparser | ImageToTable.ai |
|---|---|---|
| Modelo de extracción | OCR zonal con reglas de análisis personalizadas: dibuja zonas en una plantilla, define anclas y filtros regex por campo | Vision LLM: lee la semántica del documento directamente; sin plantillas, sin zonas, sin configuración por diseño |
| Tiempo de configuración | 30–60 min por plantilla y diseño; analizadores de múltiples diseños disponibles como complemento de $29.95/mes o en el plan Business | Menos de 1 minuto: escribe los nombres de las columnas, sube y aparecen los resultados |
| Gestión de cambios de formato | Las plantillas se rompen cuando cambian los diseños; requieren ajuste manual de zonas y nuevas pruebas | Automática: la extracción semántica se adapta a cualquier cambio de diseño al instante |
| Profundidad de las reglas de análisis | Potente: regex, lógica condicional, cálculos, palabras clave de anclaje, escaneo de códigos de barras/QR, filtros de varios pasos | columna calculada y columna inferida para cálculos y clasificaciones más simples |
| Integraciones | Zapier, Make, Power Automate, Workato, API REST, activadores por correo electrónico, conectores de almacenamiento en la nube, QuickBooks, Salesforce de forma nativa | Exportación a Excel/CSV/JSON/Word; complemento de Google Sheets; Enlace de Recopilación; Bandeja de entrada de correo con Auto-Process; API REST pública con webhooks: sin conector de Zapier en la tienda de aplicaciones |
| Documentos de varias páginas | 1 crédito = 1 documento de hasta 5 páginas; límite de 30 páginas por documento (máx. 50); límite de tamaño de archivo de 20 MB | 1 crédito = 1 página o imagen; sin límite de páginas por documento; procesa PDF grandes página por página |
| Flexibilidad de documentos | Ideal en PDF digitales limpios y consistentes; pierde calidad con escaneos de baja resolución, fotos de teléfono, escritura a mano y sellos | Lee cualquier entrada visual: fotos de teléfono, escaneos, capturas de pantalla, escritura a mano, sellos, texto impreso/manuscrito mixto |
| Precio inicial | $39/mes (mensual) / $32.50/mes (anual): 100 créditos (100 documentos, hasta 5 páginas cada uno) | $9/mes: 150 créditos (150 páginas o imágenes); plan gratuito disponible sin registro |
La tabla hace visibles las ventajas y desventajas. Pero la decisión real depende de cuál de estas dimensiones importa más en tu ecosistema de documentos. Veamos cada una.
Configuración: Zonas, anclas y reglas frente a nombres de columna
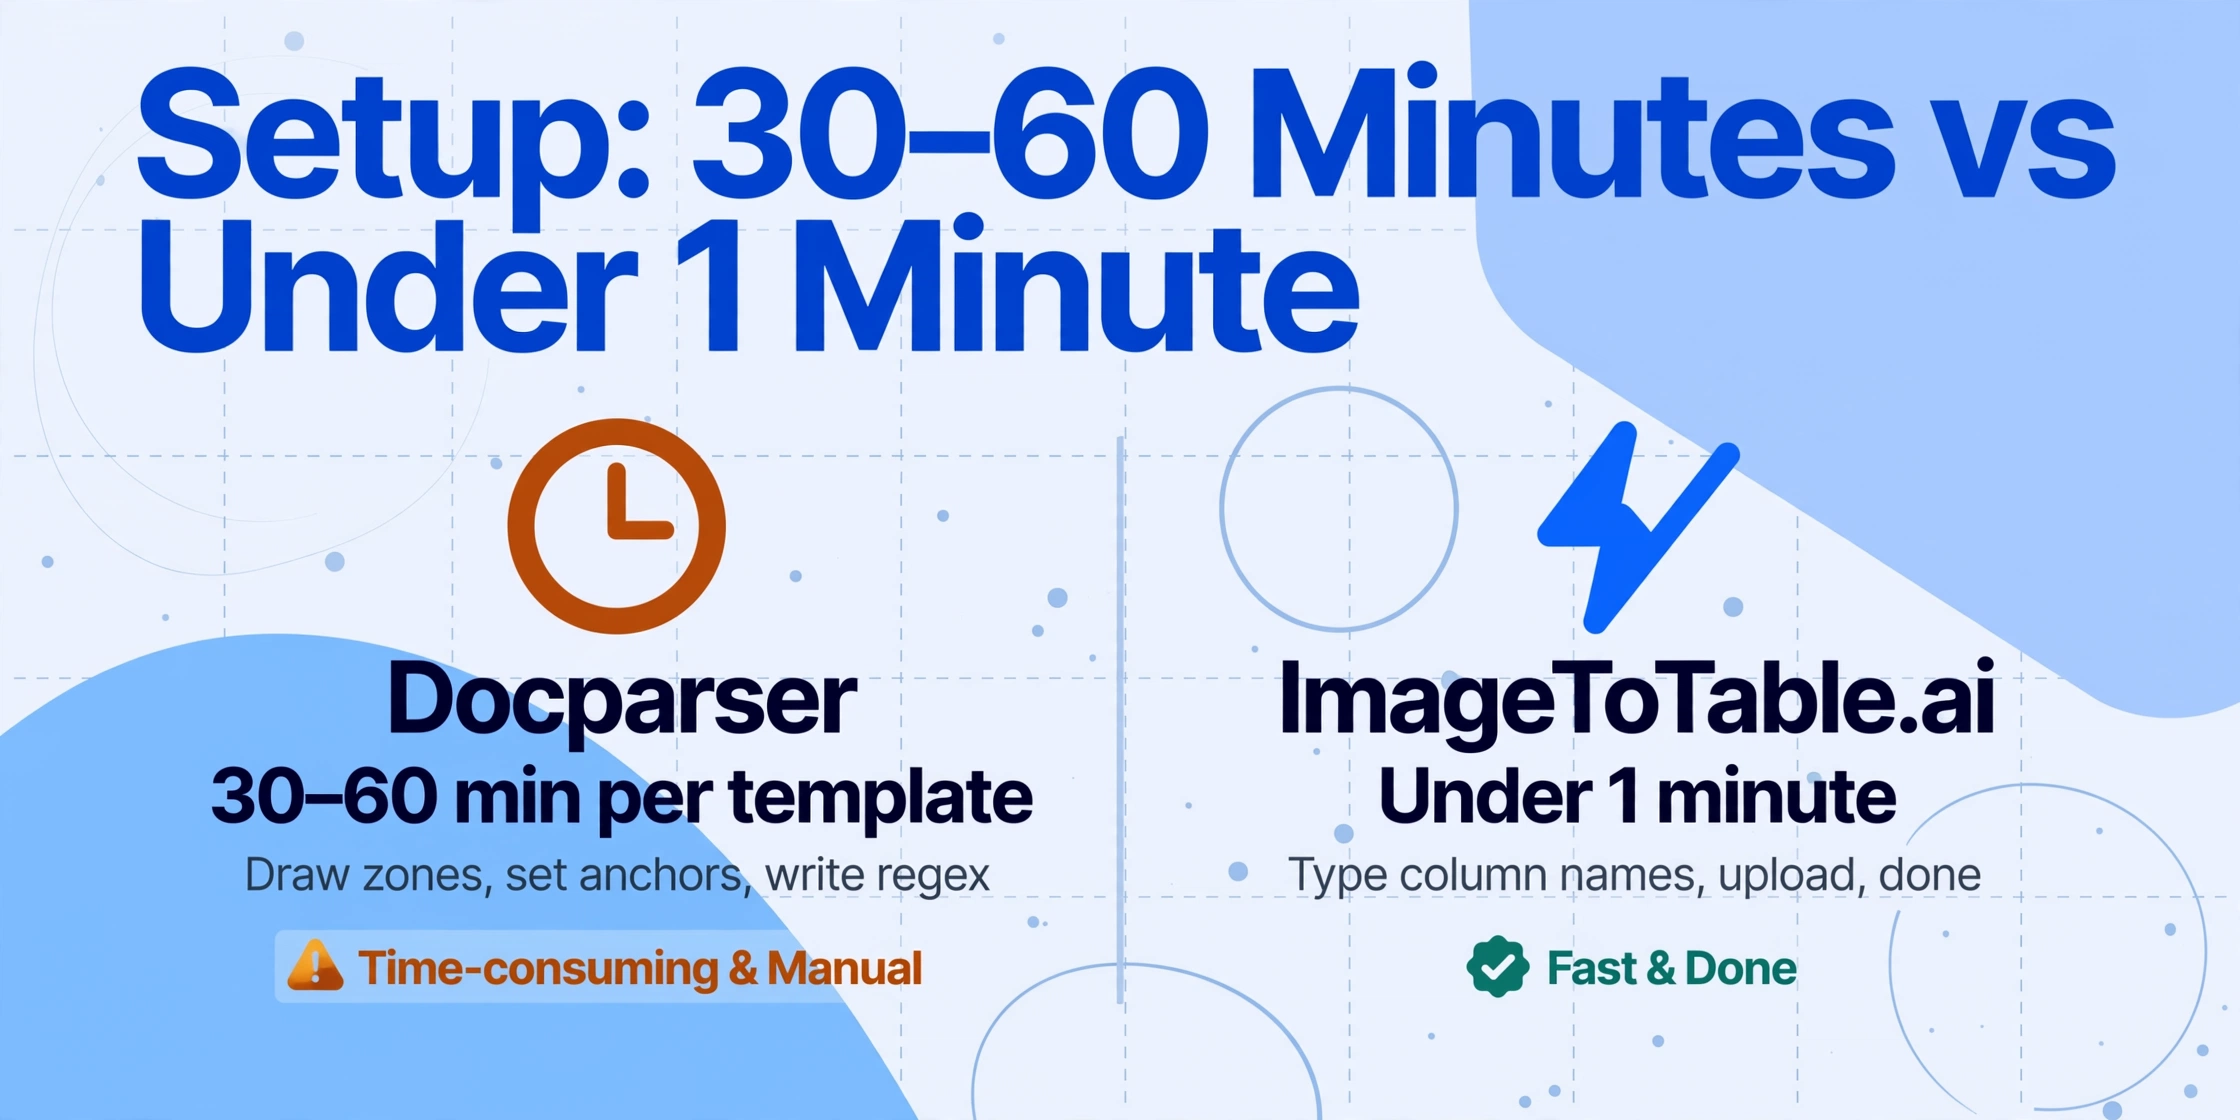
La diferencia más evidente entre las dos herramientas se nota en la primera hora. El proceso de configuración de Docparser es una secuencia de pasos deliberados: subes un documento de muestra, defines zonas de extracción dibujando rectángulos alrededor de cada campo en la página, configuras palabras clave de anclaje para ayudar al analizador a localizar campos que puedan cambiar de posición, estableces filtros de regex para normalizar los valores extraídos y pruebas la plantilla con una segunda muestra antes de poder confiar en ella con documentos reales. Para una factura de un solo proveedor con un formato fijo, este proceso suele llevar de 30 a 60 minutos.
Si procesas documentos de cinco proveedores con formatos consistentes, eso supone de 2,5 a 5 horas de creación de plantillas iniciales. Si necesitas analizadores de varios formatos (un analizador que maneje múltiples variantes de formato), esa capacidad cuesta $29.95 adicionales al mes en los planes Starter y Professional, o puedes actualizar al plan Business ($159/mes) donde está incluida. Docparser también ofrece un servicio de pago de Asistente de Análisis a $149 por formato, donde su equipo crea la plantilla por ti, un reconocimiento honesto de que crear plantillas es un trabajo real.
ImageToTable invierte toda la ecuación de configuración. No dibujas zonas, no defines anclas, no escribes regex ni configuras ninguna plantilla por formato. Escribes los nombres de columna que quieres — "Número de factura", "Nombre del proveedor", "Fecha", "Total" — y subes tus documentos. El modelo de visión de lenguaje localiza cada valor comprendiendo lo que el campo significa, no dónde está en la página. La primera extracción se completa en 5–10 segundos. No hay una "fase de configuración" antes de obtener resultados: evalúas la herramienta con tus documentos reales desde la primera carga. Para usuarios recurrentes, las listas de columnas se pueden guardar como ajustes preestablecidos, de modo que la misma definición de extracción se ejecuta en cada lote futuro sin volver a introducir los nombres de los campos.
La diferencia en el costo de configuración no se trata de que una herramienta sea más fácil de aprender. Se trata de si la herramienta requiere configuración por formato antes de poder extraer datos de un nuevo tipo de documento. Docparser lo requiere. ImageToTable no.
Cambios de Formato: Cuando la Plantilla se Rompe
Esta es la dimensión que separa más honestamente a las dos herramientas — y también es la que la mayoría de los artículos comparativos subestiman. La extracción basada en plantillas funciona perfectamente en la plantilla para la que fue creada. El problema es que los documentos del mundo real no se mantienen en sus plantillas.
Los proveedores actualizan los diseños de facturas cuando cambian de software de contabilidad, se fusionan con otra empresa o rediseñan su marca. Un proveedor mueve el campo "Total a Pagar" de la esquina inferior derecha a la esquina inferior izquierda — el rectángulo de zona que dibujaste ahora apunta a espacio vacío o, peor, a un valor diferente. Otro proveedor renombra "Factura #" a "Referencia" — la palabra clave ancla en la que confiabas ya no existe. Cada cambio es invisible para ti hasta que llega el siguiente lote de documentos con errores de extracción que alguien tiene que identificar, diagnosticar y corregir.
La tecnología OCR Zonal de Docparser es determinista y precisa en diseños conocidos — esa es su fortaleza. Pero cuando un diseño cambia, cada zona definida en esa plantilla se vuelve poco confiable. La solución requiere abrir el editor de plantillas, volver a resaltar los campos desplazados, ajustar cualquier filtro de regex afectado y volver a probar. Si estás en un plan sin analizadores de múltiples diseños, una variante de formato de un proveedor conocido podría requerir una plantilla completamente nueva. La propia documentación de Docparser reconoce que el OCR Zonal "no puede manejar" campos de datos compuestos, campos de datos repetidos, datos tabulares y "campos de datos con posiciones variables (p. ej., totales de factura)" — precisamente los escenarios que ocurren cuando los diseños se desvían.
El LLM de visión de ImageToTable lee documentos de manera holística. No le importa dónde se encuentra un campo en la página, cómo está etiquetado o si las coordenadas de píxeles cambiaron desde el último lote. "Total a Pagar" en la esquina inferior derecha y "Total a Pagar" en la esquina inferior izquierda son el mismo concepto semántico — la IA lo encuentra independientemente. Un proveedor renombra un campo — la IA resuelve la relación semántica entre lo que pediste y lo que dice el documento. Un nuevo proveedor envía un documento en un formato que la herramienta nunca ha visto — se procesa correctamente en la primera carga porque no hay zonas que configurar. Este es el significado práctico de extracción de documentos sin entrenamiento.
Docparser gana en precisión determinista para diseños estables. ImageToTable gana en resiliencia — nunca se rompe cuando un formato cambia porque nunca se configuró para un formato específico en primer lugar. La brecha entre ellos se amplía con el tiempo a medida que los diseños se desvían y aparecen nuevos formatos de proveedores.
Granularidad de análisis: cuándo gana el motor de reglas de Docparser
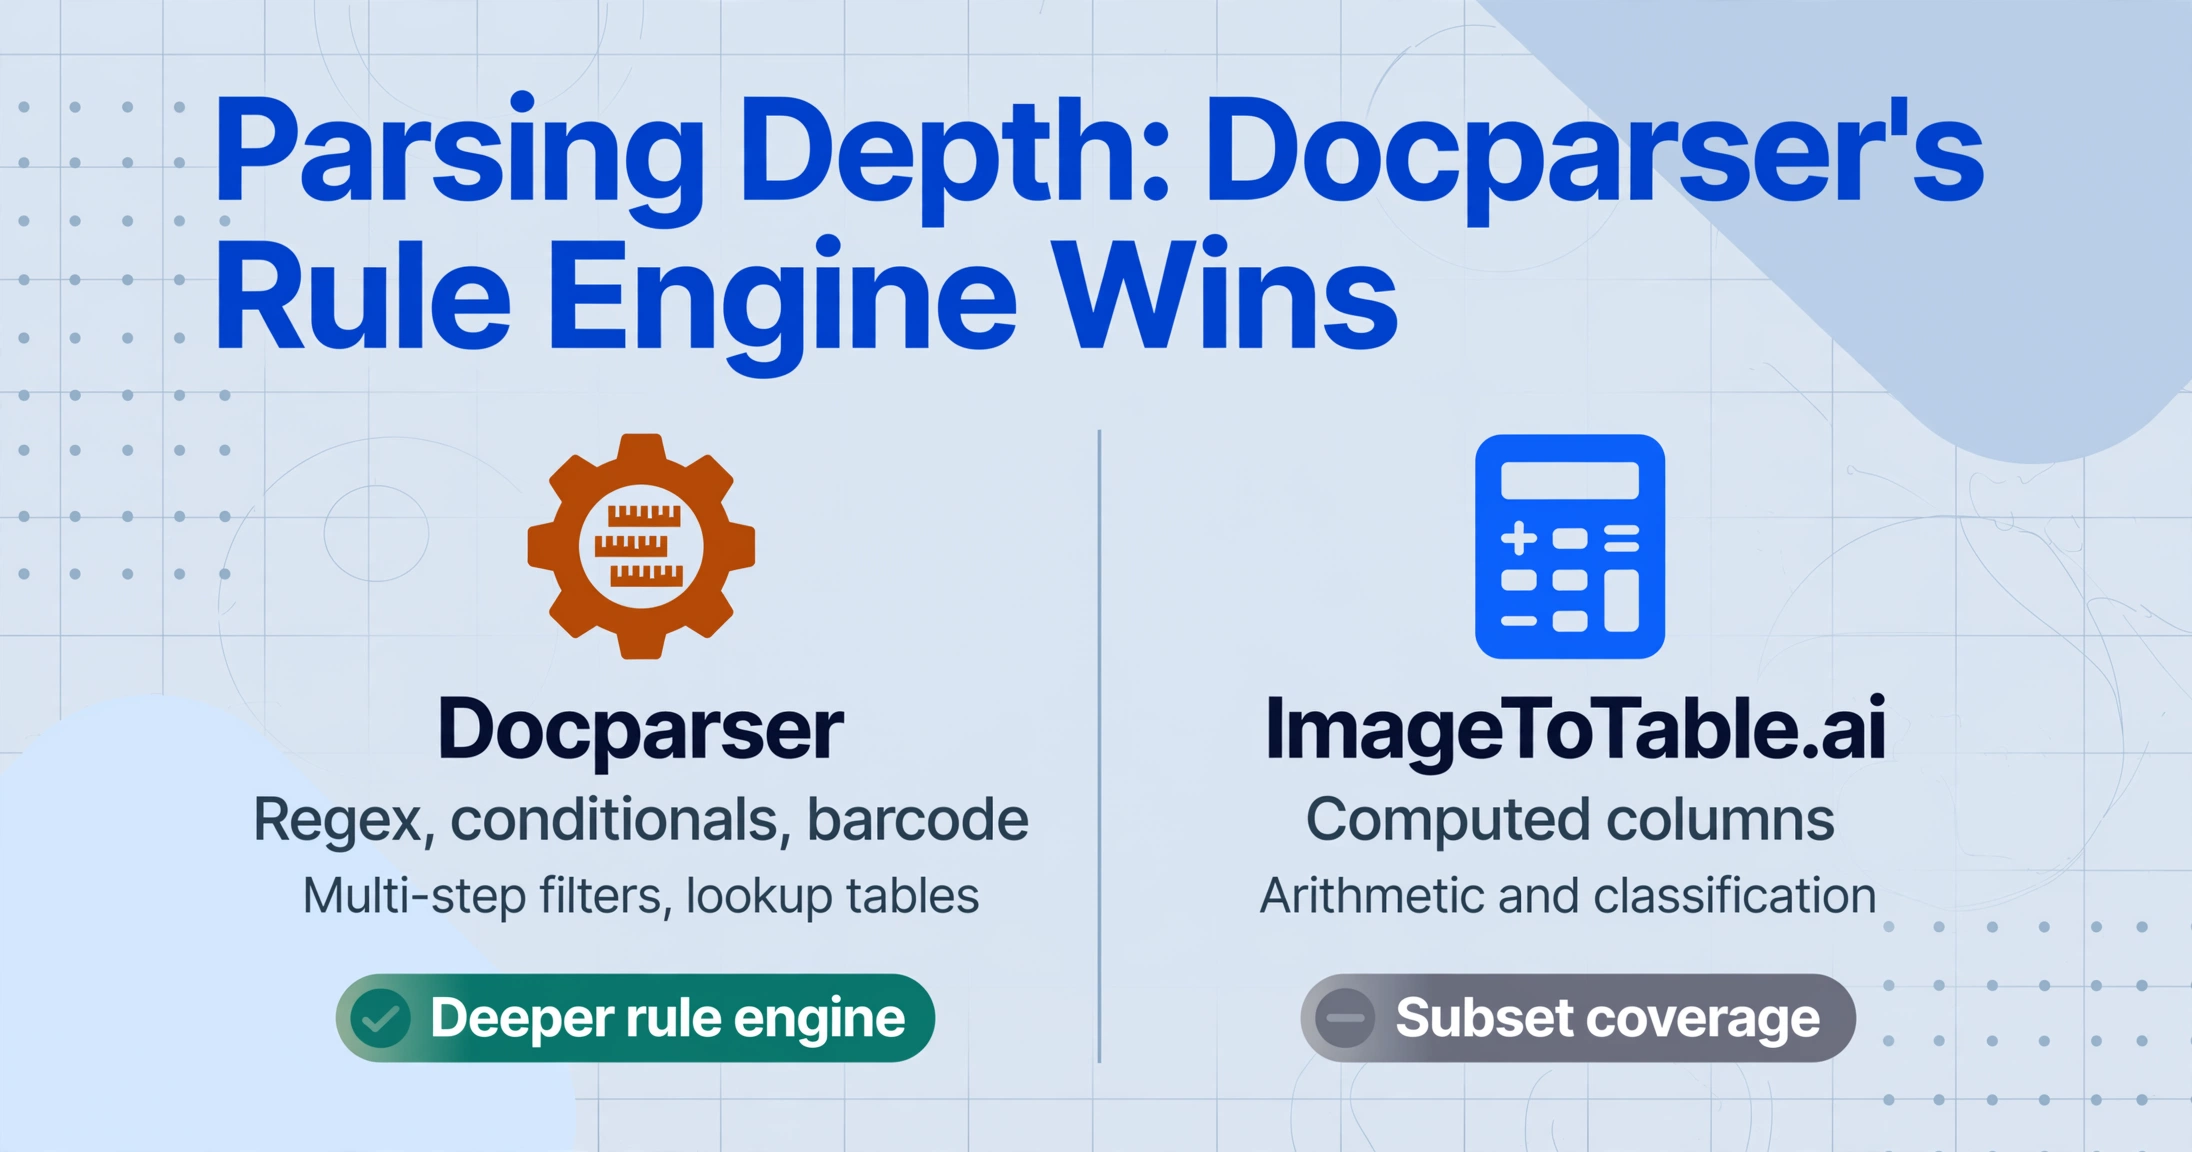
Esta es la dimensión en la que Docparser es genuinamente superior, y una comparación honesta debe decirlo directamente. El sistema de reglas de análisis de Docparser es la parte más madura de la plataforma, y va significativamente más allá de las columnas calculadas de ImageToTable en varios aspectos importantes.
Docparser te permite definir patrones regex a nivel de campo para normalizar los valores extraídos — por ejemplo, eliminar caracteres no numéricos de los números de teléfono, reformatear fechas de MM/DD/AAAA a AAAA-MM-DD, o extraer solo los dígitos de un campo "ID de proveedor" que incluye texto de prefijo. Puedes definir reglas de extracción condicionales: "Si el tipo de documento es Nota de crédito, extrae el campo 'Monto de crédito' en lugar de 'Total de factura'." Puedes combinar palabras clave de anclaje con extracción basada en desplazamiento — "busca el texto 'Total:' en la página y extrae todo lo que esté dentro de 50 píxeles a su derecha." Puedes configurar reglas de análisis que hagan referencia a otros campos extraídos, aplicar tablas de búsqueda para traducir códigos específicos del proveedor en valores estandarizados, y encadenar múltiples filtros en secuencia. El escaneo de códigos de barras y QR también está integrado en la plataforma, una capacidad que ImageToTable no ofrece en absoluto.
Las columnas calculadas y las columnas inferidas de ImageToTable cubren un subconjunto significativo de estos casos de uso. Puedes definir una columna como "Total de línea (Cantidad × Precio unitario)" y la IA la calcula durante la extracción. Puedes definir columnas inferidas con listas de opciones — "Categoría (opciones: Comidas/Transporte/Oficina/Otros)" — y la IA clasifica cada documento automáticamente. Pero ImageToTable no admite transformaciones de campo a nivel de regex, rutas de extracción condicionales ni reglas encadenadas de varios pasos. Si tu flujo de trabajo de extracción requiere transformaciones deterministas campo por campo que vayan más allá de la aritmética y la clasificación, el motor de reglas de Docparser es la herramienta adecuada.
Sin embargo, esta fortaleza tiene una advertencia: la profundidad de las reglas de Docparser solo está disponible después de haber creado una plantilla funcional sobre un diseño estable. Si el diseño cambia, las reglas se rompen junto con las zonas — no puedes usar regex potente ni lógica condicional en campos que se están extrayendo de la ubicación incorrecta.
Integraciones: el ecosistema de automatización de Docparser
Esta es la segunda dimensión en la que Docparser claramente gana. La plataforma ha invertido años en desarrollar un ecosistema de integraciones maduro que ImageToTable.ai no iguala actualmente en amplitud.
Docparser se conecta de forma nativa a Zapier (más de 6,000 aplicaciones), Make, Microsoft Power Automate y Workato. Ofrece una API REST para integraciones personalizadas, activadores por correo electrónico que analizan automáticamente los archivos adjuntos entrantes cuando se reenvían a una bandeja de entrada dedicada de Docparser, y conectores directos de almacenamiento en la nube para Google Drive, Dropbox, Box y OneDrive que permiten importar documentos sin carga manual. Los datos analizados pueden enviarse directamente a QuickBooks, Salesforce, Google Sheets, MySQL y cientos de otras aplicaciones a través de estos conectores. Para un equipo de cuentas por pagar que quiere que los datos de facturas extraídos fluyan automáticamente a su ERP, activen una notificación de Slack y envíen un resumen a Google Sheets — todo sin que nadie toque un navegador — la profundidad de integración de Docparser es una ventaja competitiva genuina.
La superficie de integración de ImageToTable.ai es más limitada pero no está ausente en el frente del correo electrónico. Los datos pueden exportarse directamente a Excel, CSV, JSON o Word desde la interfaz web. El complemento de Google Sheets permite extraer datos directamente a la hoja de cálculo activa sin salir de Sheets. Email Inbox cubre el mismo activador de reenvío y análisis que la bandeja de entrada dedicada de Docparser — cada cuenta tiene su propia dirección, y vincular Auto-Process a una plantilla inicia la extracción en el momento en que llega el correo, con una lista blanca de remitentes y reintento automático de contraseña para archivos adjuntos cifrados. El Enlace de Recopilación proporciona un punto final de carga compartible que los remitentes externos pueden usar sin registro. Lo que ImageToTable.ai no iguala es el alcance posterior de Docparser una vez que los datos se extraen — sin sondeo de almacenamiento en la nube, sin conectores nativos de Zapier/Make/Salesforce/QuickBooks, y un par de API v1/webhook en lugar del catálogo de automatización más amplio de Docparser.
Si su flujo de trabajo depende del enrutamiento posterior conectado a Zapier hacia sistemas ERP/CRM, sondeo de almacenamiento en la nube o un catálogo maduro de conectores sin código, Docparser es la opción más fuerte en integraciones. Si el requisito es la recepción de correo electrónico sin supervisión, ambas herramientas lo cubren — Email Inbox maneja el lado del activador aunque no se expanda a la misma amplitud de destinos después.
Precios: Diferentes Modelos de Costo para Diferentes Patrones de Uso
Las estructuras de precios de las dos herramientas reflejan sus filosofías arquitectónicas — y cuál es más barata depende completamente de cómo la uses.
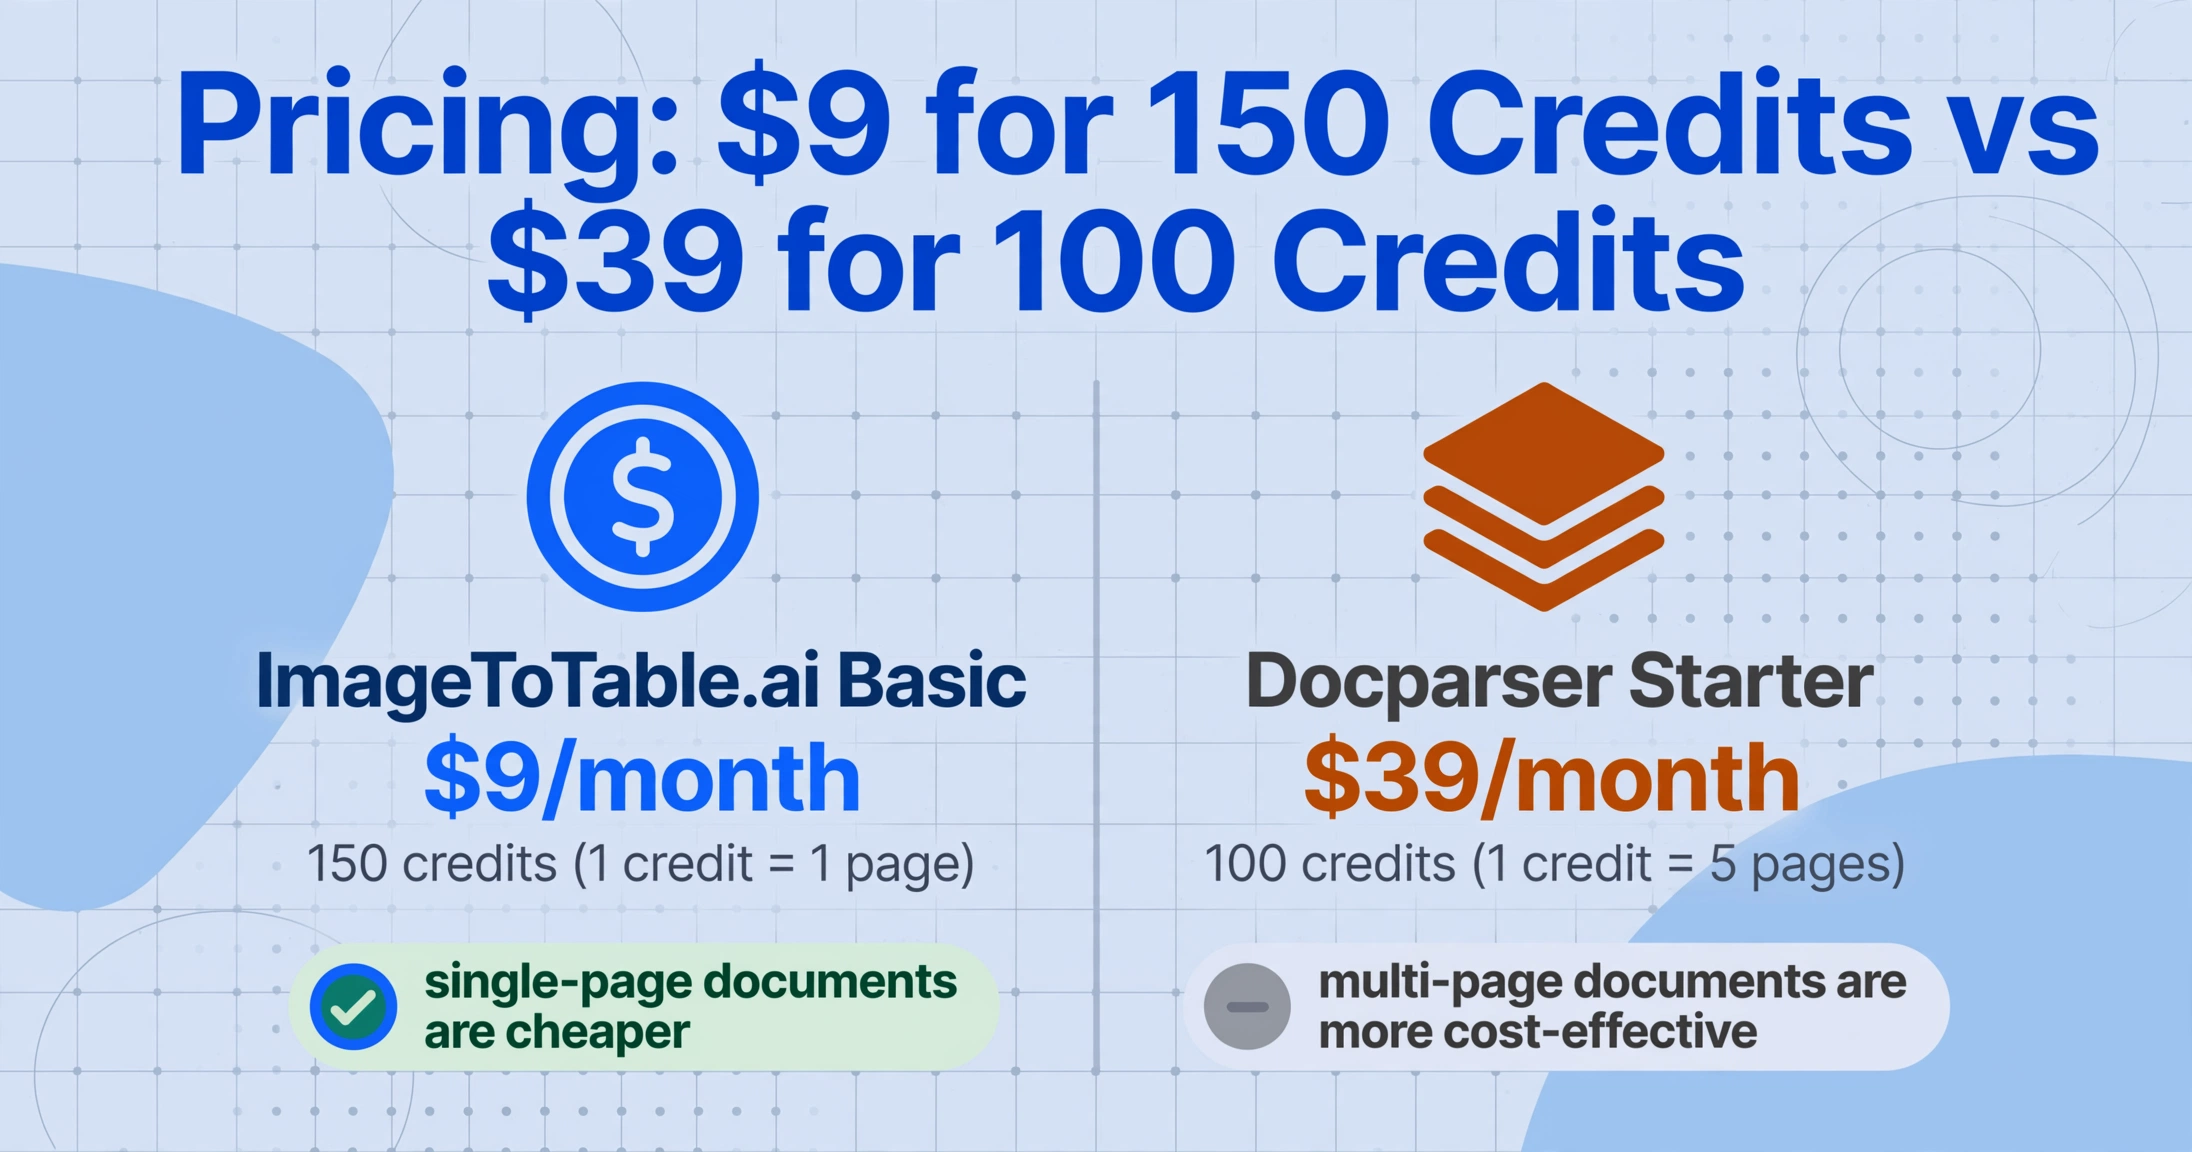
Docparser utiliza un modelo de crédito por documento. Un crédito equivale a un documento de hasta cinco páginas. El plan Starter cuesta $39/mes (mensual) o $32.50/mes (anual) por 100 créditos — efectivamente de 100 a 500 páginas al mes dependiendo de la longitud del documento. El plan Professional ($74/mes mensual, $61.50/mes anual) otorga 250 créditos. El plan Business ($159/mes mensual, $133/mes anual) otorga 1,000 créditos con analizadores de múltiples diseños incluidos. Funciones adicionales como analizadores de múltiples diseños ($29.95/mes), control de versiones del analizador ($9.95/mes) y retención extendida de documentos ($19.95/mes) se cobran por separado en los planes de nivel inferior.
ImageToTable utiliza un modelo de suscripción por crédito donde un crédito equivale a una imagen o una página PDF. El plan Basic cuesta $9/mes por 150 créditos. Pro cuesta $29/mes por 500 créditos. Max cuesta $59/mes por 1,500 créditos. Una cuota gratuita diaria te permite probar con documentos reales antes de suscribirte, y hay paquetes de créditos únicos disponibles sin compromiso de suscripción.
En el nivel inicial para documentos de una sola página, el plan Basic de ImageToTable ofrece 150 créditos por $9 — aproximadamente 4× más volumen por dólar que el Starter de Docparser a $39 por 100 créditos. Pero el modelo por documento de Docparser se vuelve significativamente más barato para documentos de varias páginas. Una factura de 5 páginas consume 5 créditos de ImageToTable pero solo 1 crédito de Docparser. Si la mayoría de tus documentos son PDFs de 3 a 5 páginas de un conjunto estable de remitentes conocidos, el costo efectivo por documento de Docparser puede ser sustancialmente menor que el precio basado en páginas de ImageToTable.
Para un análisis detallado de cómo los diferentes modelos de precios afectan tu factura mensual según los niveles de volumen, consulta desglose de precios de extracción de documentos 2026.
Flexibilidad de Documentos: Qué Puede Leer Realmente Cada Herramienta
Ambas herramientas cubren los tipos de documentos comerciales estándar: facturas, órdenes de compra, recibos, contratos, extractos bancarios. Pero los tipos de documentos que pueden manejar de manera confiable divergen significativamente una vez que se va más allá de los PDF digitales limpios.
El OCR Zonal de Docparser está diseñado para documentos con diseños predecibles. Funciona mejor en PDF digitales y escaneos de alta calidad donde cada campo aparece en una posición consistente. Su propia documentación señala que para obtener mejores resultados, "los documentos entrantes se escanean en alta calidad y tienen un diseño consistente." La plataforma ha añadido opciones de preprocesamiento OCR — enderezado, eliminación de artefactos, rotación de página — para mejorar el manejo de escaneos imperfectos, y DocparserAI ahora admite reconocimiento de escritura a mano mediante la plantilla SmartAI Parser. Pero la limitación fundamental permanece: la extracción basada en zonas se degrada en imágenes de baja resolución, escaneos inclinados, fotos de teléfono y documentos donde sellos o timbres superponen campos de datos. Cuando el rectángulo de zona no puede encerrar de manera confiable el texto objetivo, la calidad de extracción disminuye.
ImageToTable fue construido desde cero precisamente para esta brecha. El LLM de visión lee documentos como lo haría un humano: comprendiendo el diseño visual completo y localizando los campos solicitados por significado semántico, no por posición de píxeles. Tablas impresas, formularios escritos a mano, fotos de teléfono de un recibo de restaurante, una captura de pantalla de una factura enviada por correo, un contrato escaneado con un sello de empresa superpuesto al bloque de firma — la IA procesa todos ellos en el mismo flujo de extracción sin cambiar de motor ni ajustar configuraciones. Para datos de tablas impresas, la precisión alcanza hasta el 99% en documentos limpios. La escritura a mano se reconoce con niveles de precisión utilizables — suficientes para la extracción de datos incluso si los caracteres individuales no se transcriben perfectamente — porque la IA comprende el contexto del campo: "este número escrito a mano está junto a 'Total' y debajo de 'Cargos por artículos', por lo que es el monto total independientemente de cómo se curven los dígitos."
La capa DocparserAI de Docparser ha traído reconocimiento de escritura a mano y detección de casillas de verificación a la plataforma. Pero estas funciones se ejecutan sobre una arquitectura basada en zonas que aún espera campos en posiciones predecibles. Si un campo escrito a mano aparece en una ubicación diferente en cada documento (porque el formulario se llena a mano y la mano del escritor se desplaza), ninguna cantidad de mejora de IA puede compensar que la zona espere datos en una coordenada fija. ImageToTable no tiene tal restricción — la IA encuentra el campo por lo que es, no por dónde debería estar.
Cuándo ImageToTable Tiene Más Sentido
ImageToTable es la mejor opción cuando tu ecosistema de documentos se define por la variedad más que por la repetición. Si recibes documentos de múltiples proveedores que usan diseños diferentes — y esos diseños cambian — el enfoque sin plantilla elimina el mantenimiento constante que exigen las herramientas basadas en plantillas. Defines tu salida una sola vez (los nombres de columna que quieres) y la IA maneja automáticamente cualquier variación en el diseño de entrada. Cada nuevo formato de proveedor, cada rediseño de suministrador, cada formulario personalizado de cliente se procesa correctamente en la primera carga con cero tiempo de configuración. Esa es la diferencia práctica entre un analizador de documentos semántico y uno basado en plantillas.
Si tus documentos llegan como fotos de teléfono, copias escaneadas o escritura a mano en lugar de PDFs digitales impecables, el LLM de visión de ImageToTable los lee sin la degradación de calidad que sufren las herramientas basadas en zonas. Un contratista fotografiando una nota de entrega en el sitio de trabajo, un empleado enviando un informe de gastos manuscrito, un inspector de campo capturando una lectura de medidor con su teléfono — estos no son casos excepcionales para ImageToTable. Son el caso de uso principal para el que fue diseñada la herramienta.
Si procesas lotes de documentos de formato mixto juntos — subiendo facturas de veinte proveedores diferentes en un solo lote y necesitando que los resultados se fusionen en una única hoja de cálculo alineada — la arquitectura de Procesamiento por lotes prioritario de ImageToTable lo logra en un solo paso. Docparser procesa cada documento individualmente dentro de un buzón; fusionar los resultados de extracción de múltiples proveedores en una tabla unificada requiere automatización de Zapier o ensamblaje manual.
Si tu presupuesto es ajustado y tus documentos son en su mayoría de una sola página (recibos, facturas, órdenes de compra), el plan Basic de ImageToTable a $9/mes incluye 150 páginas — significativamente más valor por dólar que el nivel de entrada de Docparser.
Cuándo Docparser Tiene Más Sentido
Docparser es la mejor opción cuando sus requisitos de extracción van más allá de la ubicación de campos hacia transformación determinista de datos. Si necesita normalización de regex, rutas de extracción condicionales, filtros de múltiples pasos, escaneo de códigos de barras o reglas de cálculo que se encadenan entre varios campos, el motor de reglas de análisis de Docparser es más potente que las columnas calculadas de ImageToTable. ImageToTable maneja bien la aritmética y la clasificación, pero no alcanza la profundidad de reglas de Docparser para transformaciones complejas campo por campo.
Si su flujo de trabajo depende de integraciones automatizadas — documentos que llegan por correo electrónico → se analizan automáticamente → los datos se envían a QuickBooks vía Zapier → se envía una notificación a Slack — el ecosistema de integraciones de Docparser es sustancialmente más maduro. La Bandeja de Entrada de Correo de ImageToTable cubre el mismo disparador de reenvío y análisis (con Auto-Process volviéndolo completamente automático), pero el catálogo de conectores más amplio de Docparser — acciones nativas de Zapier, Make, Power Automate y Salesforce que se encadenan directamente a QuickBooks o Slack — va más allá de lo que la API v1 y el webhook de ImageToTable pueden alcanzar sin código de integración personalizado. Para equipos que han invertido en plataformas de automatización y necesitan que la herramienta de extracción se conecte a esos flujos de trabajo en lugar de proporcionar su propia interfaz, la profundidad de conectores de Docparser es una ventaja genuina.
Si cada documento que procesa es un PDF de varias páginas de un remitente estable y conocido — digamos, procesa 200 facturas mensuales de 5 proveedores cuyos formatos no han cambiado en años — el modelo de créditos de Docparser (1 crédito por documento de hasta 5 páginas) lo hace más económico que el precio por página de ImageToTable, y el costo de configuración de la plantilla es una inversión única que se amortiza con el procesamiento constante.
Si necesita escaneo de códigos de barras o QR integrado en el pipeline de extracción, Docparser lo incluye de forma nativa. ImageToTable no puede leer códigos de barras o QR durante la extracción — esa capacidad no está actualmente en el producto.
El veredicto honesto: Docparser gana cuando sus requisitos de procesamiento son profundos en reglas y estables en formato. ImageToTable gana cuando su ecosistema de documentos es variado en formato, diverso en fuentes o cambiante en diseño. Ninguna arquitectura es universalmente mejor — la herramienta adecuada depende del tipo de variabilidad con la que realmente trabaje.
El Veredicto: Basado en Escenarios, No en un Binario Forzado
Después de comparar ambas herramientas en tiempo de configuración, resiliencia de formato, granularidad de análisis, integraciones, precios y flexibilidad de documentos, el marco de decisión es más claro de lo que la mayoría de los artículos de comparación sugieren.
Docparser está diseñado para extracción determinista de diseños estables. Su motor Zonal OCR y su sistema de reglas recompensan a los equipos con formatos de documentos consistentes mediante una extracción precisa y repetible a nivel de campo. El costo es la configuración y el mantenimiento por diseño. La recompensa es el control: normalización de regex, lógica condicional, escaneo de códigos de barras y un pipeline de automatización maduro que se conecta a las herramientas que ya usas. Si tus documentos provienen de un conjunto fijo de remitentes conocidos cuyos diseños no cambian, la profundidad y el alcance de integración de Docparser lo convierten en la opción pragmática.
ImageToTable está diseñado para extracción semántica de fuentes variadas. Su LLM de visión elimina por completo la configuración por diseño, manejando cualquier formato, cualquier calidad de entrada y cualquier combinación de tipos de documentos en un solo lote. El costo es un control menos granular sobre las transformaciones a nivel de campo. La recompensa es la resiliencia: cambios de formato, nuevos proveedores, fotos de teléfono, escritura a mano y lotes mixtos funcionan sin mantenimiento de plantillas. Si tus documentos llegan de múltiples fuentes con diferentes diseños, o si la calidad de entrada varía (escaneos, fotos, escritura a mano), ImageToTable elimina más trabajo continuo del que el conjunto de reglas más profundo de Docparser puede compensar.
Si estás construyendo un pipeline de automatización de AP impulsado por correo electrónico con facturas de formato fijo que fluyen hacia QuickBooks a través de Zapier, Docparser es la mejor opción: su capa de automatización y la profundidad de sus reglas coinciden con ese flujo de trabajo. Si estás recopilando documentos de personal de campo, procesando órdenes de compra de formato mixto o extrayendo datos por lotes de fotos de teléfono y formularios escaneados, el enfoque sin plantilla de ImageToTable te ahorra el costo de mantenimiento que las herramientas basadas en plantillas imponen a los flujos de trabajo de entrada variada. Ninguna herramienta es una respuesta universal. Pero si sabes cómo se ve realmente tu ecosistema de documentos — cuántos formatos, con qué frecuencia cambian, con qué calidad llegan — la elección correcta se vuelve clara.
Para una visión más amplia de cómo ambas herramientas se comparan con el resto del panorama de extracción, consulta ImageToTable vs Parseur.
¿Quieres la versión condensada? Consulta la tabla comparativa de características lado a lado, o explora todas las comparaciones de ImageToTable.
Preguntas frecuentes
¿Docparser requiere plantillas, o DocparserAI funciona sin ellas?
La ruta principal de extracción de Docparser se basa en plantillas: creas un parser dibujando rectángulos Zonal OCR en un documento de muestra. DocparserAI añade funciones asistidas por IA (plantilla SmartAI Parser que crea reglas automáticamente, reconocimiento de escritura a mano, resumen de contenido), pero estas funcionan dentro de la misma arquitectura por tipo de documento. El SmartAI Parser reduce el tiempo de configuración manual al generar reglas automáticamente a partir de un documento de muestra, pero aún espera diseños consistentes dentro de un tipo de documento. ImageToTable usa IA semántica exclusivamente: sin plantillas, sin dibujo de zonas, sin configuración por diseño en ninguna ruta de extracción.
¿Puede ImageToTable integrarse con Zapier o webhooks como Docparser?
Sí, a través de la API pública v1. La API REST de ImageToTable te permite subir documentos, iniciar el procesamiento y registrar un webhook que se activa automáticamente cuando un lote o documento termina, sin necesidad de sondeo. Zapier y Make pueden conectarse a través de esta API, pero ImageToTable no tiene un conector preinstalado en la tienda de aplicaciones ni integraciones nativas con Salesforce/ERP como Docparser. ImageToTable también ofrece exportación directa a Excel, CSV, JSON y Word, además de un complemento de Google Sheets que escribe los datos extraídos directamente en la hoja de cálculo activa. Si necesitas la aplicación de Zapier con un clic de Docparser o sus conectores nativos de QuickBooks/Salesforce, el ecosistema de integraciones de Docparser es más maduro para ese caso específico.
¿Qué herramienta es más económica para documentos de varias páginas?
Depende de la longitud del documento. Docparser cuenta un crédito de parseo por documento de hasta cinco páginas, por lo que una factura de 5 páginas consume 1 crédito. ImageToTable cuenta un crédito por página: esa misma factura de 5 páginas consume 5 créditos. Si tus documentos tienen consistentemente de 3 a 5 páginas, el modelo de créditos de Docparser puede ser significativamente más barato por documento. Para documentos de una sola página (recibos, la mayoría de facturas), el precio de ImageToTable es más bajo por crédito. Tu costo total depende de si procesas principalmente documentos de una o varias páginas. Consulta el desglose de precios de extracción de documentos 2026 para una comparación volumen por volumen.
¿Docparser admite procesamiento por lotes como ImageToTable?
Docparser procesa documentos dentro de un buzón: puedes subir varios documentos a la vez o configurar importaciones automáticas desde almacenamiento en la nube o correo electrónico. Pero cada documento se analiza individualmente, y combinar resultados de varios documentos (especialmente entre diferentes analizadores) en una sola hoja de cálculo alineada requiere trabajo externo mediante Zapier/API o exportación manual. ImageToTable fue diseñado con procesamiento por lotes prioritario: sube archivos desde cualquier fuente, define los nombres de las columnas una vez y descarga un archivo Excel combinado con encabezados consistentes en todos los documentos. Para equipos que procesan lotes de formatos mixtos con regularidad, esta es una diferencia significativa en el flujo de trabajo.
¿Docparser puede manejar escritura a mano tan bien como ImageToTable?
DocparserAI ha introducido el reconocimiento de escritura a mano mediante la plantilla SmartAI Parser. Puede extraer texto manuscrito de documentos. Sin embargo, la arquitectura subyacente basada en zonas significa que la escritura a mano debe aparecer en una ubicación predecible en la página para una extracción precisa. El LLM de visión de ImageToTable encuentra campos manuscritos en cualquier parte de la página al comprender el contexto; no requiere que la escritura a mano esté en una zona predefinida. Para documentos donde la escritura a mano aparece en posiciones variables (formularios de inspección de sitios, hojas de trabajo de campo, notas de entrega completadas por diferentes personas), el enfoque de ImageToTable es más confiable.
¿Puedo cambiar de Docparser a ImageToTable?
Sí. La migración no requiere importar plantillas — ImageToTable no usa plantillas. Exporta tus datos históricos de Docparser como CSV o Excel. Sube los mismos documentos fuente a ImageToTable, escribe los nombres de las columnas que correspondan a tus definiciones de campos de Docparser, y la IA los extrae sin configuración de plantilla. Los nombres de columnas que usaste en Docparser (Número de Factura, Nombre del Proveedor, Fecha, Total) se convierten en tus nombres de columnas en ImageToTable. Combina tus datos históricos con nuevas extracciones en una hoja de cálculo — los nombres de encabezados consistentes hacen que la transición sea sencilla.