ImageToTable vs Docparser:
Flexible Felder oder feste Vorlagen? Ein ehrlicher Vergleich 2026
Die Wahl zwischen ImageToTable und Docparser läuft auf eine einzige architektonische Frage hinaus: Wollen Sie ein Tool, das vordefinierte Zonen auf festen Layouts abgleicht – oder eines, das Dokumente liest, indem es versteht, was die Felder bedeuten? Die Antwort bestimmt nicht nur, wie schnell Sie starten, sondern auch, wie viel Zeit Sie sechs Monate später für die Wartung der Pipeline aufwenden. Beide Tools extrahieren strukturierte Daten aus Dokumenten. Aber sie gehen die Extraktion mit grundlegend unterschiedlichen Architekturen an – und die Architektur, die für ein Team mit drei stabilen Rechnungsvorlagen funktioniert, wird ein Team frustrieren, das Dokumente von vierzig Anbietern verarbeitet, die ihre Layouts nach eigenem Zeitplan aktualisieren.
Wichtigste Erkenntnisse
- Die meisten Vergleichsartikel vergleichen die Einrichtungszeit – die eigentlichen Kosten entstehen durch die stille Wartungsroutine, die beginnt, sobald der erste Anbieter sein Rechnungslayout nach drei Monaten ändert.
- Docparser gewinnt ehrlich in zwei Bereichen: Seine Regex-Engine und bedingten Parsing-Regeln gehen tiefer als die berechneten Spalten von ImageToTable, und sein Zapier-taugliches Integrationsökosystem hat auf ImageToTable-Seite kein Äquivalent.
- Wählen Sie danach, wie Ihre Dokumente tatsächlich aussehen – stabile mehrseitige PDFs von bekannten Absendern sprechen für Docparser, während Layout-Vielfalt, Handyfotos, Handschrift und gemischte Quell-Batches alle für ImageToTable sprechen.
Schnellvergleich
Bevor wir jede Dimension im Detail durchgehen, hier ein Überblick, wie die beiden Tools bei den Faktoren abschneiden, die bei einer Dokumentextraktions-Entscheidung am wichtigsten sind.
| Dimension | Docparser | ImageToTable.ai |
|---|---|---|
| Extraktionsmodell | Zonen-OCR mit benutzerdefinierten Parsing-Regeln – Zonen auf einer Vorlage zeichnen, Anker und Regex-Filter pro Feld definieren | Vision-LLM – liest Dokument-Semantik direkt; keine Vorlagen, keine Zonen, keine Layout-Konfiguration |
| Einrichtungszeit | 30–60 Min. pro Vorlage und Layout; Multi-Layout-Parser als Add-on für $29.95/Monat oder im Business-Plan | Unter 1 Minute – Spaltennamen eingeben, hochladen, Ergebnisse erscheinen |
| Umgang mit Formatänderungen | Vorlagen brechen bei Layoutänderungen; erfordern manuelle Zonenanpassung und erneutes Testen | Automatisch – semantische Extraktion passt sich jeder Layoutänderung sofort an |
| Tiefe der Parsing-Regeln | Leistungsstark – Regex, Bedingungslogik, Berechnungen, Anker-Keywords, Barcode/QR-Scan, mehrstufige Filter | Berechnete Spalten und abgeleitete Spalten für einfachere Berechnungen und Klassifizierungen |
| Integrationen | Native Zapier, Make, Power Automate, Workato, REST-API, E-Mail-Trigger, Cloud-Speicher-Konnektoren, QuickBooks, Salesforce | Excel/CSV/JSON/Word-Export; Google-Sheets-Add-on; Sammellink; E-Mail-Postfach mit Auto-Process; öffentliche REST-API mit Webhooks – kein App-Store-Zapier-Konnektor |
| Mehrseitige Dokumente | 1 Credit = 1 Dokument bis 5 Seiten; 30-Seiten-Dokumentlimit (max. 50); 20-MB-Dateigrößenlimit | 1 Credit = 1 Seite oder Bild; kein Seitenlimit auf Dokumentebene; verarbeitet große PDFs Seite für Seite |
| Dokumentflexibilität | Am besten bei sauberen, konsistenten digitalen PDFs; verschlechtert sich bei niedrig aufgelösten Scans, Handyfotos, Handschrift, Stempeln | Liest jede visuelle Eingabe – Handyfotos, Scans, Screenshots, Handschrift, Stempel, gemischt gedruckt/handschriftlich |
| Startpreis | $39/Monat (monatlich) / $32,50/Monat (jährlich) – 100 Credits (100 Dokumente, je bis 5 Seiten) | $9/Monat – 150 Credits (150 Seiten oder Bilder); kostenloser Tarif ohne Anmeldung verfügbar |
Die Tabelle macht die Kompromisse sichtbar. Aber die eigentliche Entscheidung hängt davon ab, welche dieser Dimensionen in Ihrer Dokumentumgebung am wichtigsten ist. Gehen wir jede einzelne durch.
Einrichtung: Zonen, Anker und Regeln vs. Spaltennamen
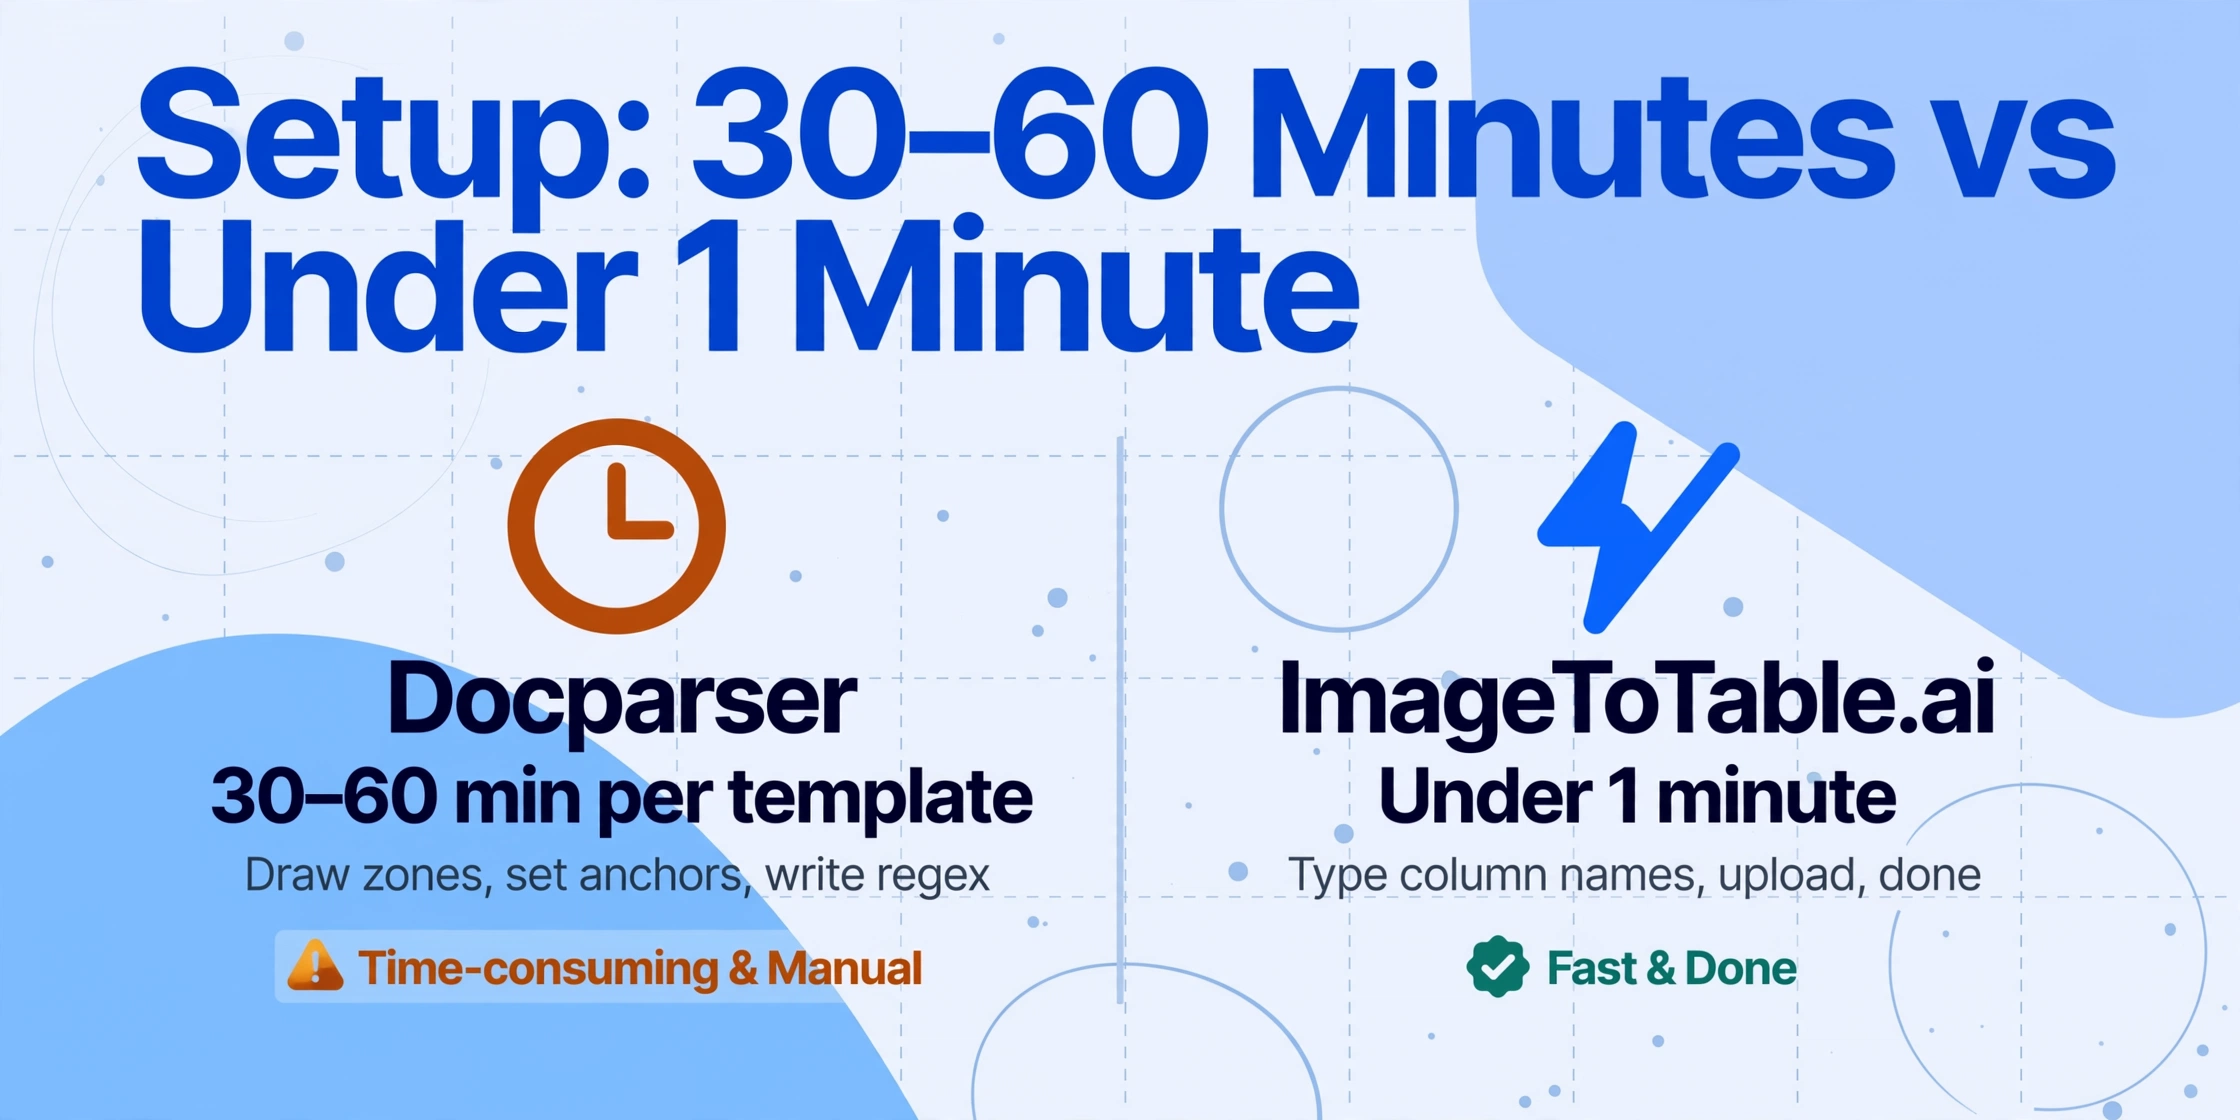
Der offensichtlichste Unterschied zwischen den beiden Tools zeigt sich in der ersten Stunde. Docparsers Einrichtungsprozess ist eine Abfolge bewusster Schritte: Sie laden ein Beispieldokument hoch, definieren Extraktionszonen, indem Sie Rechtecke um jedes Feld auf der Seite zeichnen, konfigurieren Anker-Keywords, damit der Parser Felder findet, die sich verschieben könnten, setzen Regex-Filter zur Normalisierung extrahierter Werte und testen die Vorlage an einem zweiten Beispiel, bevor Sie ihr bei Live-Dokumenten vertrauen können. Für eine Rechnung mit einheitlichem Layout von einem Anbieter dauert dieser Prozess typischerweise 30 bis 60 Minuten.
Wenn Sie Dokumente von fünf Anbietern mit konsistenten Formaten verarbeiten, sind das 2,5 bis 5 Stunden Vorlagen-Erstellung im Vorfeld. Wenn Sie Multi-Layout-Parser benötigen (ein Parser, der mehrere Formatvarianten verarbeitet), kostet diese Funktion zusätzlich $29.95 pro Monat bei den Starter- und Professional-Plänen, oder Sie upgraden auf den Business-Plan ($159/Monat), wo sie enthalten ist. Docparser bietet auch einen kostenpflichtigen Parsing-Assistenten-Service für $149 pro Layout an, bei dem deren Team die Vorlage für Sie erstellt – eine ehrliche Anerkennung, dass Vorlagenerstellung echte Arbeit ist.
ImageToTable dreht die gesamte Einrichtungsgleichung um. Sie zeichnen keine Zonen, definieren keine Anker, schreiben kein Regex und konfigurieren keine Layout-Vorlage. Sie geben die gewünschten Spaltennamen ein – „Rechnungsnummer", „Lieferantenname", „Datum", „Gesamtbetrag" – und laden Ihre Dokumente hoch. Das Vision-LLM lokalisiert jeden Wert, indem es versteht, was das Feld bedeutet, nicht wo es auf der Seite sitzt. Die erste Extraktion ist in 5–10 Sekunden abgeschlossen. Es gibt keine „Einrichtungsphase" vor den Ergebnissen – Sie bewerten das Tool ab dem allerersten Upload an Ihren echten Dokumenten. Für wiederkehrende Nutzer können Spaltenlisten als Presets gespeichert werden, sodass dieselbe Extraktionsdefinition bei jedem zukünftigen Batch läuft, ohne Feldnamen erneut eingeben zu müssen.
Der Unterschied bei den Einrichtungskosten liegt nicht darin, dass ein Tool einfacher zu erlernen ist. Es geht darum, ob das Tool eine Layout-Konfiguration erfordert, bevor es Daten aus einem neuen Dokumenttyp extrahieren kann. Docparser erfordert das. ImageToTable nicht.
Formatänderungen: Wenn die Vorlage versagt
Diese Dimension trennt die beiden Tools am ehrlichsten – und sie wird in den meisten Vergleichsartikeln unterschätzt. Die vorlagenbasierte Extraktion funktioniert perfekt mit der Vorlage, für die sie erstellt wurde. Das Problem: Dokumente aus der Praxis bleiben nicht in ihren Vorlagen.
Lieferanten aktualisieren Rechnungslayouts, wenn sie ihre Buchhaltungssoftware wechseln, mit einem anderen Unternehmen fusionieren oder ihr Branding überarbeiten. Ein Anbieter verschiebt das Feld „Gesamtbetrag" von der unteren rechten in die untere linke Ecke – das von Ihnen gezeichnete Zonenrechteck zeigt nun auf leeren Raum oder, schlimmer noch, auf einen anderen Wert. Ein anderer Lieferant benennt „Rechnungsnr." in „Referenz" um – das Anker-Keyword, auf das Sie sich verließen, existiert nicht mehr. Jede Änderung bleibt unsichtbar, bis die nächste Dokumentencharge mit Extraktionsfehlern eintrifft, die jemand identifizieren, diagnostizieren und beheben muss.
Docparsers Zonal-OCR-Technologie ist bei bekannten Layouts deterministisch und präzise – das ist ihre Stärke. Doch wenn sich ein Layout ändert, wird jede in dieser Vorlage definierte Zone unzuverlässig. Die Behebung erfordert das Öffnen des Vorlageneditors, das erneute Markieren der verschobenen Felder, das Anpassen betroffener Regex-Filter und erneutes Testen. Wenn Sie einen Plan ohne Multi-Layout-Parser haben, kann eine Formatvariante eines bekannten Anbieters eine völlig neue Vorlage erfordern. Docparsers eigene Dokumentation räumt ein, dass Zonal-OCR „zusammengesetzte Datenfelder, sich wiederholende Datenfelder, Tabellendaten und Datenfelder mit variablen Positionen (z. B. Rechnungssummen)" nicht verarbeiten kann – genau die Szenarien, die bei Layout-Abweichungen auftreten.
ImageToTables Vision-LLM liest Dokumente ganzheitlich. Es ist ihm egal, wo ein Feld auf der Seite steht, wie es beschriftet ist oder ob sich die Pixelkoordinaten seit der letzten Charge verschoben haben. „Gesamtbetrag" unten rechts und „Gesamtbetrag" unten links sind dasselbe semantische Konzept – die KI findet es trotzdem. Ein Anbieter benennt ein Feld um – die KI löst die semantische Beziehung zwischen dem, was Sie angefragt haben, und dem, was das Dokument aussagt. Ein neuer Anbieter sendet ein Dokument in einem Format, das das Tool noch nie gesehen hat – es wird beim ersten Upload korrekt verarbeitet, da es keine zu konfigurierenden Zonen gibt. Das ist die praktische Bedeutung von Dokumentextraktion ohne Training.
Docparser punktet mit deterministischer Präzision bei stabilen Layouts. ImageToTable punktet mit Resilienz – es bricht nie, wenn sich ein Format ändert, weil es nie auf ein bestimmtes Format konfiguriert wurde. Der Abstand zwischen beiden wächst mit der Zeit, da Layouts abweichen und neue Anbieterformate auftauchen.
Parsing-Granularität: Wann Docparsers Regel-Engine gewinnt
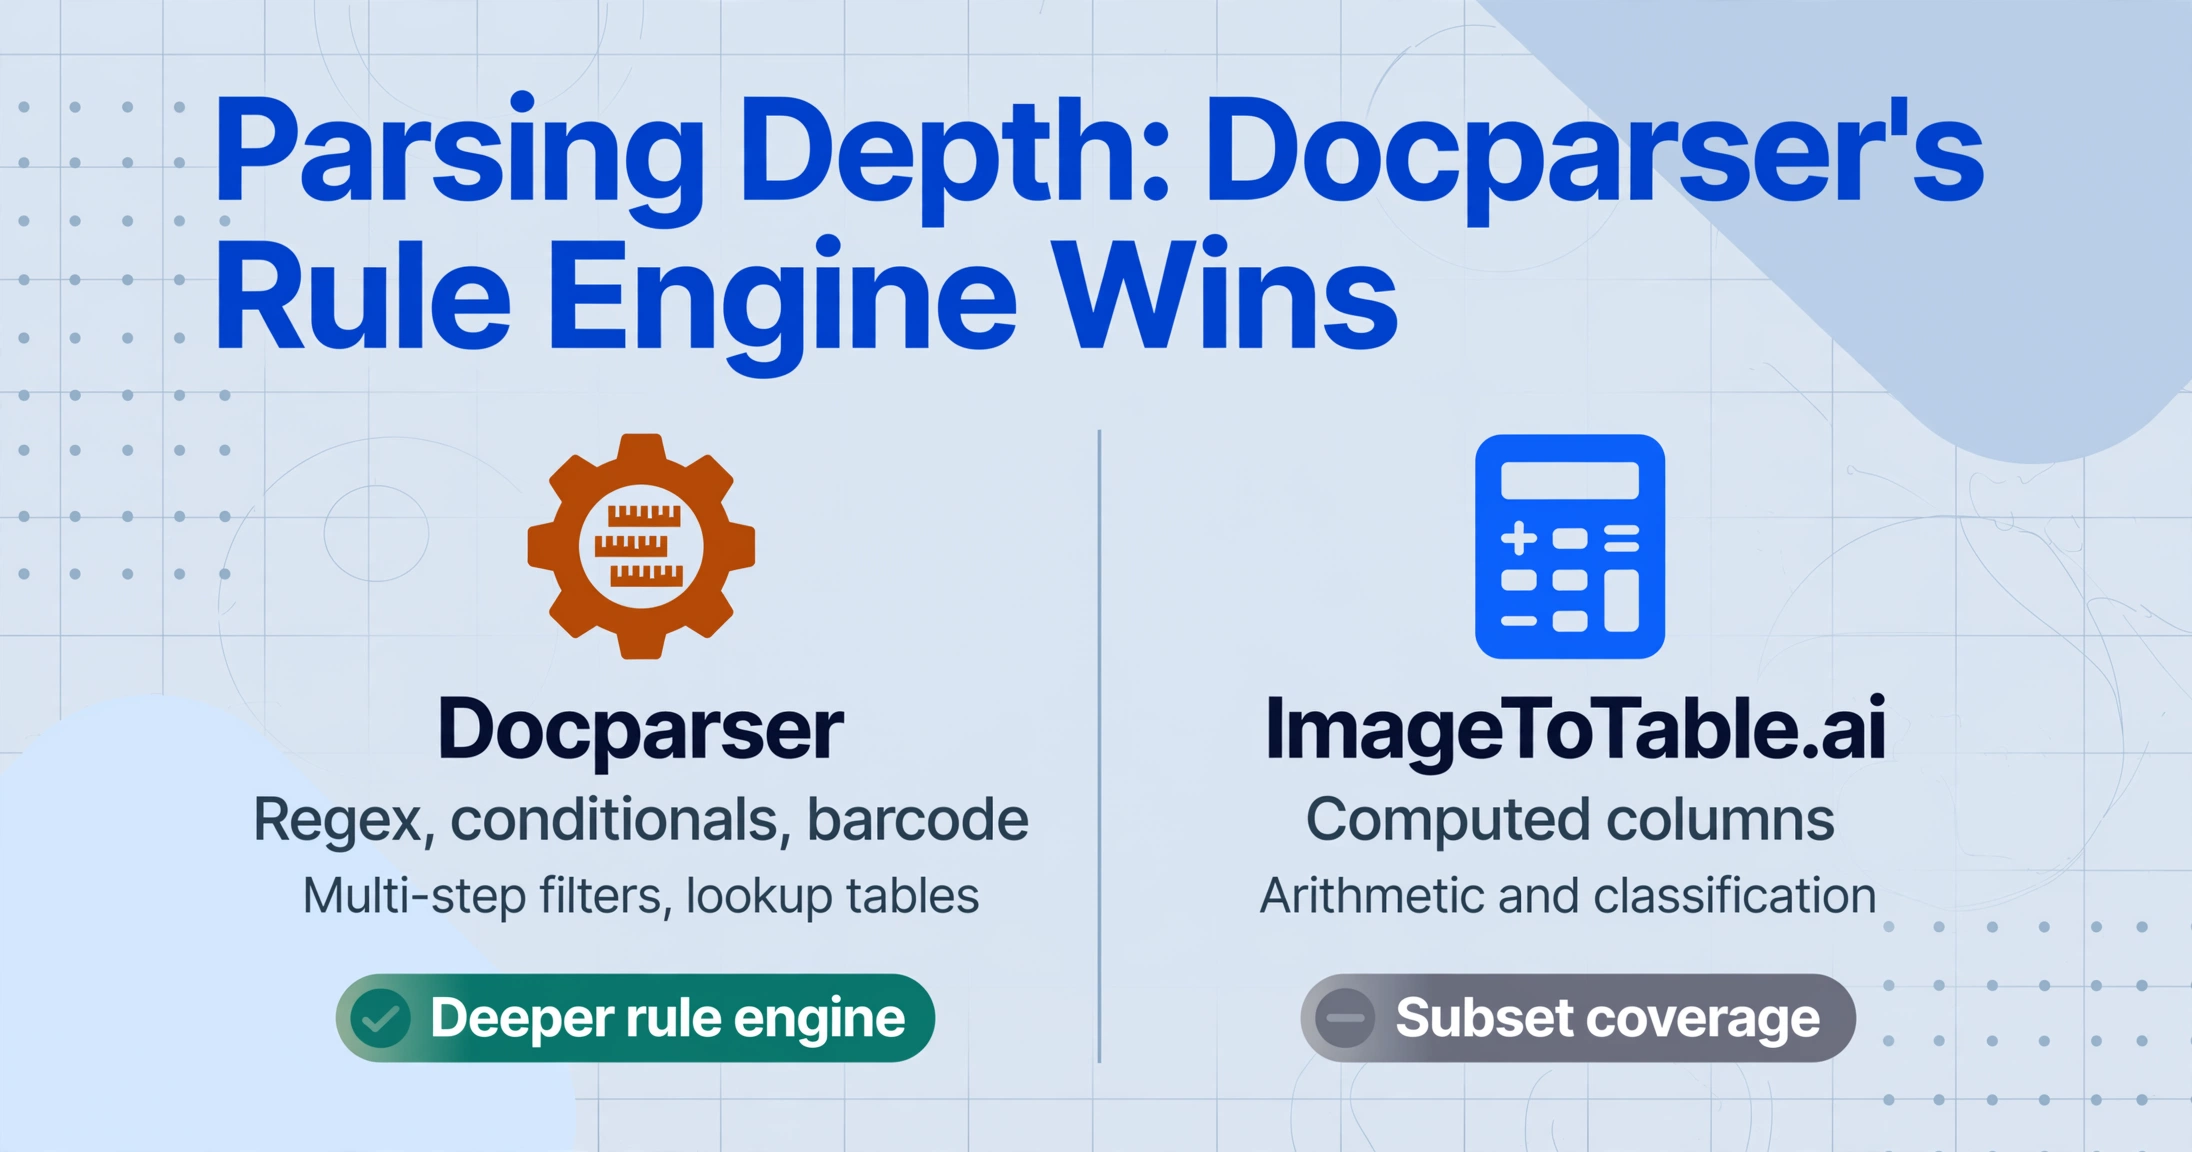
Dies ist die Dimension, in der Docparser wirklich überlegen ist, und ein ehrlicher Vergleich muss dies direkt feststellen. Docparsers Parsing-Regelsystem ist der ausgereifteste Teil der Plattform und geht in mehreren wichtigen Punkten deutlich tiefer als die berechneten Spalten von ImageToTable.
Docparser ermöglicht die Definition von Feld-RegEx-Mustern zur Normalisierung extrahierter Werte – zum Beispiel das Entfernen nicht-numerischer Zeichen aus Telefonnummern, das Umformatieren von Daten von MM/TT/JJJJ zu JJJJ-MM-TT oder das Extrahieren nur der Ziffern aus einem „Lieferanten-ID“-Feld, das Präfixtext enthält. Sie können bedingte Extraktionsregeln definieren: „Wenn der Dokumenttyp Gutschrift ist, extrahiere das Feld ‚Gutschriftsbetrag‘ statt ‚Rechnungssumme‘.“ Sie können Anker-Keywords mit offsetbasierter Extraktion kombinieren – „finde den Text ‚Gesamt:‘ auf der Seite und extrahiere alles innerhalb von 50 Pixeln rechts davon.“ Sie können Parsing-Regeln konfigurieren, die auf andere extrahierte Felder verweisen, Nachschlagetabellen anwenden, um lieferantenspezifische Codes in standardisierte Werte zu übersetzen, und mehrere Filter in Sequenz verketten. Barcode- und QR-Code-Scanning ist ebenfalls in die Plattform integriert – eine Fähigkeit, die ImageToTable überhaupt nicht bietet.
Die berechneten Spalten und abgeleiteten Spalten von ImageToTable decken eine sinnvolle Teilmenge dieser Anwendungsfälle ab. Sie können eine Spalte wie „Positionssumme (Menge × Einzelpreis)“ definieren und die KI berechnet sie während der Extraktion. Sie können abgeleitete Spalten mit Optionslisten definieren – „Kategorie (Optionen: Mahlzeiten/Transport/Büro/Sonstiges)“ – und die KI klassifiziert jedes Dokument automatisch. Aber ImageToTable unterstützt keine RegEx-Transformationen auf Feldebene, keine bedingten Extraktionspfade und keine mehrstufigen verketteten Regeln. Wenn Ihr Extraktionsworkflow deterministische feldweise Transformationen erfordert, die über Arithmetik und Klassifizierung hinausgehen, ist Docparsers Regel-Engine das richtige Werkzeug.
Diese Stärke hat jedoch eine Einschränkung: Die Regeltiefe von Docparser ist nur verfügbar, nachdem Sie eine funktionierende Vorlage auf einem stabilen Layout erstellt haben. Wenn sich das Layout ändert, brechen die Regeln zusammen mit den Zonen – Sie können leistungsstarke Regex- und Bedingungslogik nicht auf Feldern anwenden, die aus der falschen Position extrahiert werden.
Integrationen: Docparsers Automatisierungs-Ökosystem
Dies ist die zweite Dimension, in der Docparser klar die Nase vorn hat. Die Plattform hat Jahre in den Aufbau eines ausgereiften Integrations-Ökosystems investiert, das ImageToTable derzeit in der Breite nicht erreicht.
Docparser verbindet sich nativ mit Zapier (6.000+ Apps), Make, Microsoft Power Automate und Workato. Es bietet eine REST-API für individuelle Integrationen, E-Mail-Trigger, die eingehende Anhänge automatisch parsen, wenn sie an ein dediziertes Docparser-Postfach weitergeleitet werden, sowie direkte Cloud-Speicher-Connectors für Google Drive, Dropbox, Box und OneDrive, mit denen Sie Dokumente ohne manuellen Upload importieren können. Geparste Daten können über diese Connectors direkt an QuickBooks, Salesforce, Google Sheets, MySQL und Hunderte anderer Anwendungen gesendet werden. Für ein AP-Team, das extrahierte Rechnungsdaten automatisch in sein ERP fließen lassen, eine Slack-Benachrichtigung auslösen und eine Zusammenfassung an Google Sheets pushen möchte – ganz ohne dass jemand einen Browser anfasst – ist die Integrationstiefe von Docparser ein echter Wettbewerbsvorteil.
Die Integrationsfläche von ImageToTable ist schmaler, aber beim E-Mail-Bereich nicht abwesend. Daten können direkt aus der Weboberfläche nach Excel, CSV, JSON oder Word exportiert werden. Das Google-Sheets-Add-on ermöglicht es, Daten direkt in die aktive Tabelle zu extrahieren, ohne Sheets zu verlassen. Der E-Mail-Posteingang deckt denselben Weiterleiten-und-Parsen-Trigger ab wie das dedizierte Postfach von Docparser – jedes Konto erhält eine eigene Adresse, und die Bindung von Auto-Process an eine Vorlage startet die Extraktion, sobald die Mail eintrifft, mit einer Absender-Whitelist und automatischem Passwort-Retry für verschlüsselte Anhänge. Der Sammellink bietet einen teilbaren Upload-Endpunkt, den externe Absender ohne Registrierung nutzen können. Was ImageToTable nicht erreicht, ist die nachgelagerte Reichweite von Docparser nach der Datenextraktion – kein Cloud-Speicher-Polling, keine nativen Zapier/Make/Salesforce/QuickBooks-Connectors und ein v1-API/Webhook-Paar statt des breiteren Automatisierungskatalogs von Docparser.
Wenn Ihr Workflow von Zapier-verbundenem Downstream-Routing in ERP/CRM-Systeme, Cloud-Speicher-Polling oder einem ausgereiften No-Code-Connector-Katalog abhängt, ist Docparser bei Integrationen die stärkere Wahl. Wenn unbeaufsichtigter E-Mail-Eingang selbst die Anforderung ist, decken beide Tools das ab – der E-Mail-Posteingang übernimmt die Trigger-Seite, auch wenn er danach nicht auf dieselbe Breite an Zielen ausstrahlt.
Preise: Verschiedene Kostenmodelle für unterschiedliche Nutzungsmuster
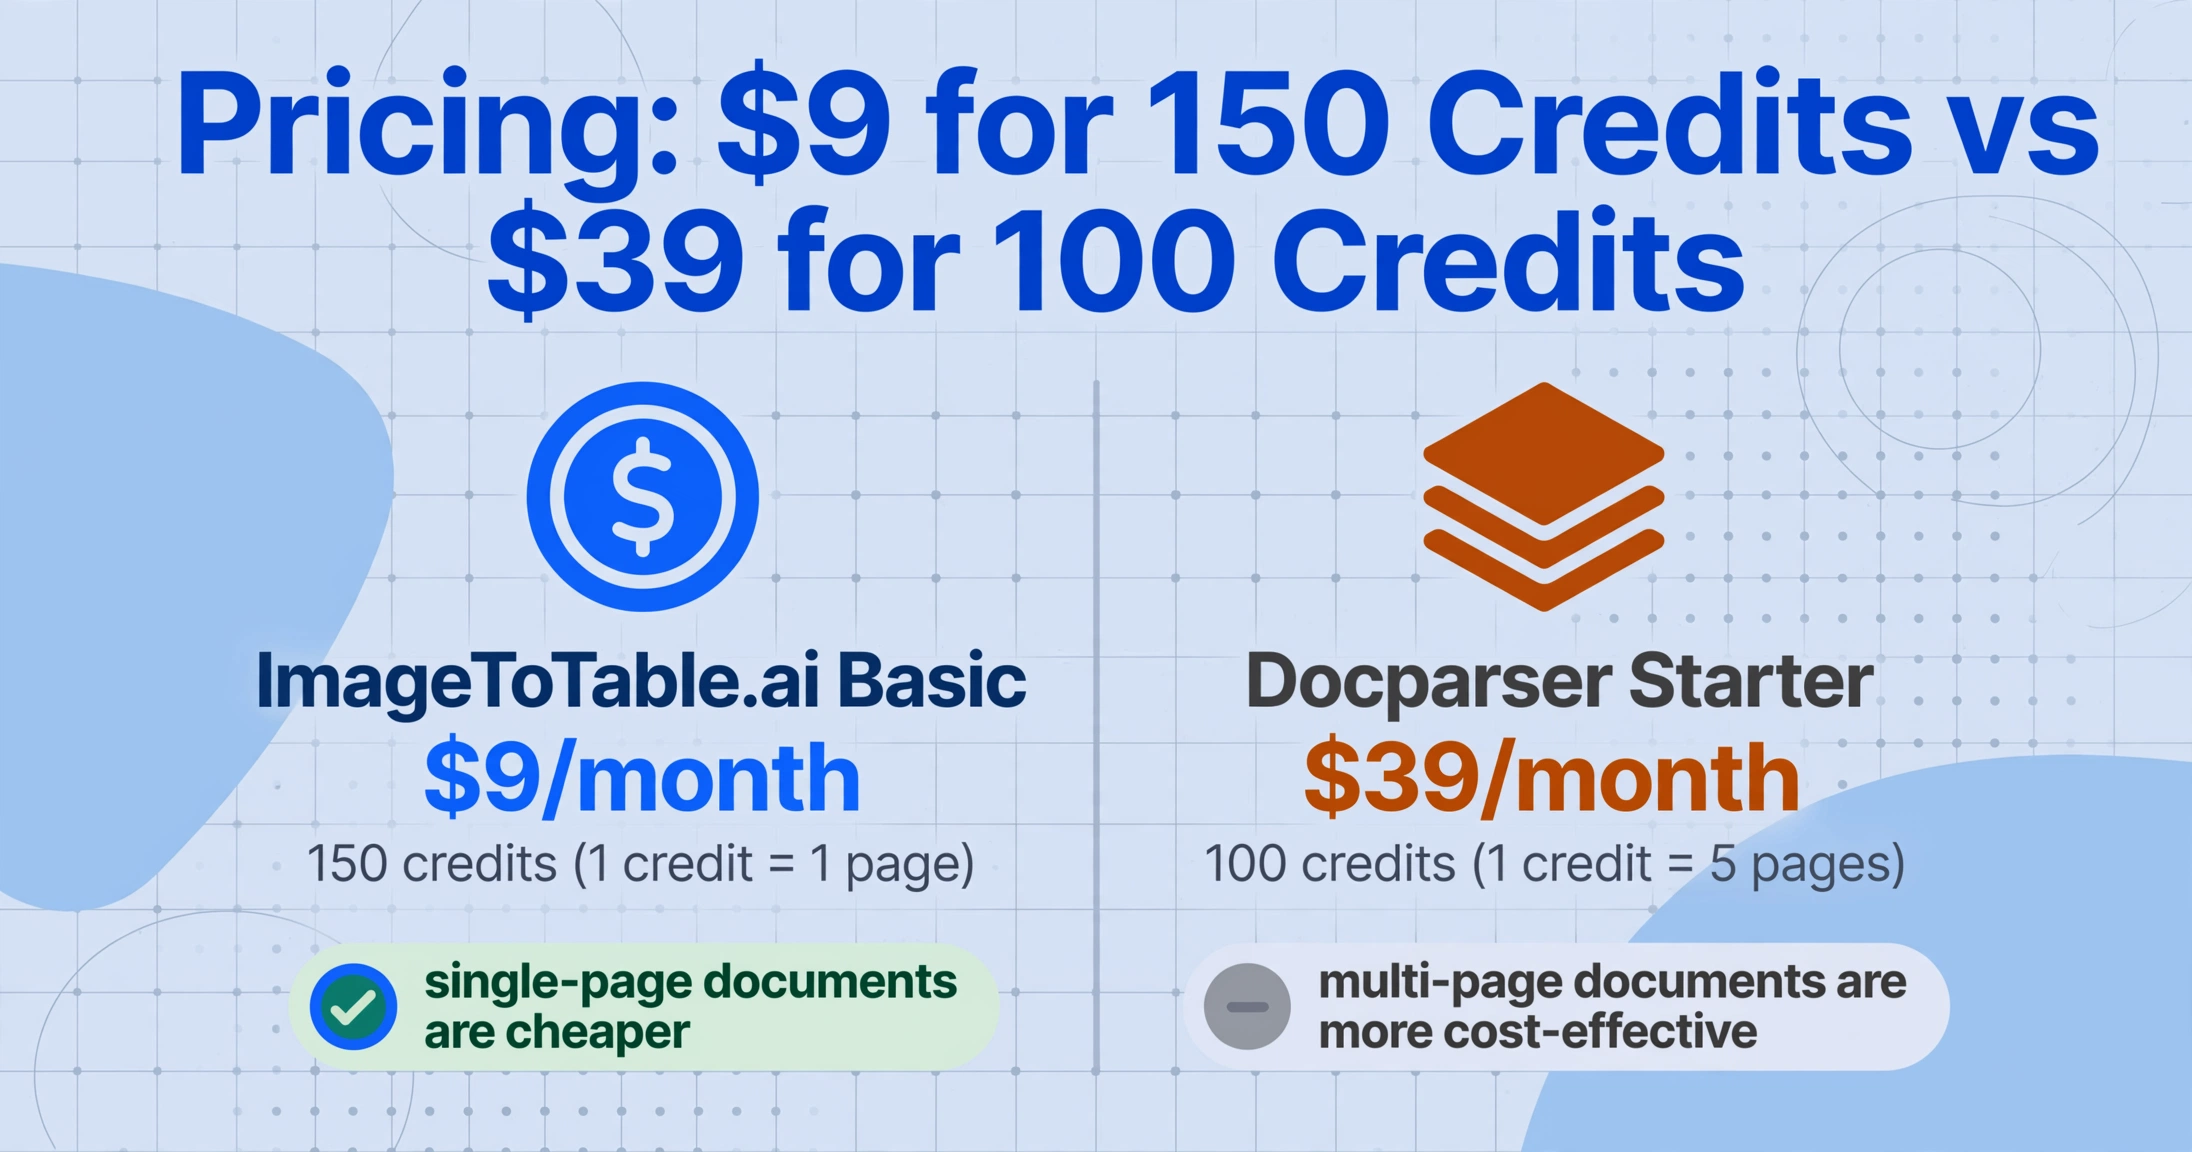
Die Preisstrukturen der beiden Tools spiegeln ihre architektonischen Philosophien wider – und welches günstiger ist, hängt ganz davon ab, wie du es nutzt.
Docparser verwendet ein Kostenmodell pro Dokument. Ein Credit entspricht einem Dokument mit bis zu fünf Seiten. Der Starter-Plan kostet 39 $/Monat (monatlich) oder 32,50 $/Monat (jährlich) für 100 Credits – also effektiv 100 bis 500 Seiten pro Monat, je nach Dokumentlänge. Der Professional-Plan (74 $/Monat monatlich, 61,50 $/Monat jährlich) bietet 250 Credits. Der Business-Plan (159 $/Monat monatlich, 133 $/Monat jährlich) bietet 1.000 Credits inklusive Multi-Layout-Parser. Zusätzliche Funktionen wie Multi-Layout-Parser (29,95 $/Monat), Parser-Versionskontrolle (9,95 $/Monat) und erweiterte Dokumentenspeicherung (19,95 $/Monat) werden bei niedrigeren Tarifen separat berechnet.
ImageToTable verwendet ein Abonnementmodell pro Credit, bei dem ein Credit einem Bild oder einer PDF-Seite entspricht. Der Basic-Plan kostet 9 $/Monat für 150 Credits. Pro kostet 29 $/Monat für 500 Credits. Max kostet 59 $/Monat für 1.500 Credits. Ein tägliches kostenloses Kontingent ermöglicht es dir, mit echten Dokumenten zu testen, bevor du ein Abonnement abschließt, und einmalige Credit-Pakete sind ohne Abonnementverpflichtung erhältlich.
Bei einseitigen Dokumenten im Einstiegsbereich bietet der Basic-Plan von ImageToTable 150 Credits für 9 $ – etwa 4× mehr Volumen pro Dollar als Docparser Starter mit 39 $ für 100 Credits. Aber das Kostenmodell pro Dokument von Docparser wird bei mehrseitigen Dokumenten deutlich günstiger. Eine einzelne 5-seitige Rechnung verbraucht 5 ImageToTable-Credits, aber nur 1 Docparser-Credit. Wenn der Großteil deiner Dokumente 3–5-seitige PDFs von einem stabilen Satz bekannter Absender sind, können die effektiven Kosten pro Dokument bei Docparser erheblich niedriger sein als die seitenbasierte Preisgestaltung von ImageToTable.
Eine detaillierte Übersicht darüber, wie sich verschiedene Preismodelle auf deine monatliche Rechnung über verschiedene Volumenstufen auswirken, findest du unter Aufschlüsselung der Dokumentextraktionspreise 2026.
Dokumentflexibilität: Was jedes Tool tatsächlich lesen kann
Beide Tools decken die gängigen Geschäftsdokumenttypen ab — Rechnungen, Bestellungen, Belege, Verträge, Kontoauszüge. Doch die Dokumenttypen, die sie zuverlässig verarbeiten können, unterscheiden sich erheblich, sobald man über saubere digitale PDFs hinausgeht.
Docparsers Zonal OCR ist für Dokumente mit vorhersehbaren Layouts konzipiert. Es funktioniert am besten bei digitalen PDFs und hochwertigen Scans, bei denen jedes Feld an einer konsistenten Position erscheint. Die eigene Dokumentation weist darauf hin, dass für beste Ergebnisse „eingehende Dokumente in hoher Qualität gescannt werden und ein konsistentes Layout aufweisen". Die Plattform hat OCR-Vorverarbeitungsoptionen hinzugefügt — Entzerrung, Artefaktentfernung, Seitenrotation — um die Verarbeitung unvollkommener Scans zu verbessern, und DocparserAI unterstützt nun Handschrifterkennung über die SmartAI-Parser-Vorlage. Die grundlegende Einschränkung bleibt jedoch bestehen: Die zonenbasierte Extraktion verschlechtert sich bei Bildern mit niedriger Auflösung, schrägen Scans, Handyfotos und Dokumenten, bei denen Stempel oder Siegel Datenfelder überlagern. Wenn das Zonenrechteck den Zieltext nicht zuverlässig umschließen kann, sinkt die Extraktionsqualität.
ImageToTable wurde von Grund auf genau für diese Lücke entwickelt. Das Vision-LLM liest Dokumente so, wie es ein Mensch tut — indem es das gesamte visuelle Layout versteht und angeforderte Felder anhand ihrer semantischen Bedeutung lokalisiert, nicht anhand der Pixelposition. Gedruckte Tabellen, handschriftliche Formulare, Handyfotos einer Restaurantrechnung, ein Screenshot einer per E-Mail erhaltenen Rechnung, ein gescannter Vertrag mit einem Firmenstempel, der den Unterschriftsblock überlappt — die KI verarbeitet all dies in derselben Extraktionspipeline, ohne die Engine zu wechseln oder Einstellungen anzupassen. Bei gedruckten Tabellendaten erreicht die Genauigkeit bis zu 99 % bei sauberen Dokumenten. Handschrift wird mit brauchbarer Genauigkeit erkannt — ausreichend für die Datenextraktion, auch wenn einzelne Zeichen nicht perfekt transkribiert werden — weil die KI den Feldkontext versteht: „Diese handschriftliche Zahl steht neben ‚Gesamtbetrag' und unter ‚Positionen', also ist es der Gesamtbetrag, unabhängig davon, wie die Ziffern geschwungen sind."
Docparsers DocparserAI-Schicht hat Handschrifterkennung und Kontrollkästchenerkennung auf die Plattform gebracht. Diese Funktionen laufen jedoch auf einer zonenbasierten Architektur, die weiterhin Felder an vorhersehbaren Positionen erwartet. Wenn ein handschriftliches Feld auf jedem Dokument an einer anderen Stelle erscheint (weil das Formular von Hand ausgefüllt wird und die Handschrift des Schreibers variiert), kann keine noch so große KI-Verbesserung ausgleichen, dass die Zone Daten an einer festen Koordinate erwartet. ImageToTable hat diese Einschränkung nicht — die KI findet das Feld danach, was es ist, nicht danach, wo es sein sollte.
Wann ImageToTable mehr Sinn ergibt
ImageToTable ist die bessere Wahl, wenn Ihr Dokumenten-Ökosystem von Vielfalt statt Wiederholung geprägt ist. Wenn Sie Dokumente von mehreren Anbietern mit unterschiedlichen Layouts erhalten – und sich diese Layouts ändern –, eliminiert der Ansatz ohne Vorlage den Wartungsaufwand, den vorlagenbasierte Tools erfordern. Sie definieren Ihre Ausgabe einmal (die gewünschten Spaltennamen) und die KI verarbeitet automatisch jede Variation im Eingabelayout. Jedes neue Anbieterformat, jedes Lieferanten-Redesign, jedes kundenspezifische Formular wird beim ersten Upload ohne Einrichtungszeit korrekt verarbeitet. Das ist der praktische Unterschied zwischen einem semantischen Dokument-Parser und einem vorlagenbasierten.
Wenn Ihre Dokumente als Handyfotos, Scans oder Handschrift statt als makellose digitale PDFs ankommen, liest ImageToTables Vision-LLM sie ohne die Qualitätsverluste, die zonierungsbasierte Tools erleben. Ein Bauunternehmer, der einen Lieferschein auf der Baustelle fotografiert, ein Mitarbeiter, der einen handschriftlichen Spesenbericht einreicht, ein Außendienstinspektor, der mit seinem Handy einen Zählerstand erfasst – das sind für ImageToTable keine Randfälle. Das ist der primäre Anwendungsfall, für den das Tool entwickelt wurde.
Wenn Sie Batches mit gemischten Dokumentformaten zusammen verarbeiten – Rechnungen von zwanzig verschiedenen Anbietern in einem Batch hochladen und die Ergebnisse in einer einzigen ausgerichteten Tabelle zusammengeführt benötigen –, liefert ImageToTables Batch-First-Verarbeitung das in einem Schritt. Docparser verarbeitet jedes Dokument einzeln innerhalb eines Postfachs; das Zusammenführen von Extraktionsergebnissen mehrerer Anbieter in eine einheitliche Tabelle erfordert Zapier-Automatisierung oder manuelle Zusammenstellung.
Wenn Ihr Budget knapp ist und Ihre Dokumente meist einseitig sind (Belege, Rechnungen, Bestellungen), liefert ImageToTables Basic Plan für 9 $/Monat 150 Seiten – deutlich mehr Wert pro Dollar als Docparsers Einstiegstarif.
Wann Docparser die bessere Wahl ist
Docparser ist die bessere Wahl, wenn Ihre Extraktionsanforderungen über die Feldposition hinausgehen und eine deterministische Datentransformation erfordern. Wenn Sie Regex-Normalisierung, bedingte Extraktionspfade, mehrstufige Filter, Barcode-Scanning oder Berechnungsregeln benötigen, die über mehrere Felder hinweg verknüpft sind, ist die Parsing-Regelengine von Docparser leistungsfähiger als die berechneten Spalten von ImageToTable. ImageToTable bewältigt Arithmetik und Klassifizierung gut, erreicht aber nicht die Regeltiefe von Docparser bei komplexen feldweisen Transformationen.
Wenn Ihr Workflow von automatisierten Integrationen abhängt — Dokumente, die per E-Mail-Weiterleitung eintreffen → automatisch geparst → Daten über Zapier an QuickBooks übertragen → Slack-Benachrichtigung gesendet — ist das Integrationsökosystem von Docparser deutlich ausgereifter. Die E-Mail-Inbox von ImageToTable deckt denselben Weiterleitungs-und-Parse-Trigger ab (mit Auto-Process wird dies vollständig automatisiert), aber der breitere Konnektorkatalog von Docparser — native Zapier-, Make-, Power-Automate- und Salesforce-Aktionen, die direkt in QuickBooks oder Slack übergehen — geht weiter als das, was die v1-API und der Webhook von ImageToTable allein ohne benutzerdefinierten Klebecode erreichen können. Für Teams, die in Automatisierungsplattformen investiert haben und das Extraktionstool in diese Workflows einbinden möchten, anstatt eine eigene Oberfläche bereitzustellen, ist die Konnektortiefe von Docparser ein echter Vorteil.
Wenn jedes von Ihnen verarbeitete Dokument eine mehrseitige PDF-Datei von einem stabilen, bekannten Absender ist — sagen wir, Sie verarbeiten 200 monatliche Rechnungen von 5 Lieferanten, deren Formate sich seit Jahren nicht geändert haben — ist das Credits-Modell von Docparser (1 Credit pro Dokument bis zu 5 Seiten) wirtschaftlicher als die Seitenpreise von ImageToTable, und die Einrichtungskosten für die Vorlage sind eine einmalige Investition, die sich bei konsistenter Verarbeitung auszahlt.
Wenn Sie Barcode- oder QR-Code-Scanning direkt in die Extraktions-Pipeline integriert benötigen, enthält Docparser dies nativ. ImageToTable kann während der Extraktion keine Barcodes oder QR-Codes lesen — diese Funktion ist derzeit nicht im Produkt enthalten.
Das ehrliche Fazit: Docparser gewinnt, wenn Ihre Verarbeitungsanforderungen regelbasiert und formatstabil sind. ImageToTable gewinnt, wenn Ihr Dokumentenökosystem formatvielfältig, quellenreich oder layoutveränderlich ist. Keine der beiden Architekturen ist universell besser — das richtige Tool hängt davon ab, mit welcher Art von Variabilität Sie tatsächlich umgehen.
Das Urteil: Szenariobasiert, nicht erzwungen binär
Nach dem Vergleich beider Tools hinsichtlich Einrichtungszeit, Formatresilienz, Parsing-Granularität, Integrationen, Preisen und Dokumentflexibilität ist der Entscheidungsrahmen klarer, als die meisten Vergleichsartikel vermuten lassen.
Docparser ist für deterministische Extraktion aus stabilen Layouts gebaut. Seine Zonal-OCR-Engine und das Regelsystem belohnen Teams mit konsistenten Dokumentformaten durch präzise, wiederholbare Feldebene-Extraktion. Der Preis ist die Einrichtung und Wartung pro Layout. Der Nutzen ist Kontrolle: Regex-Normalisierung, Bedingungslogik, Barcode-Scanning und eine ausgereifte Automatisierungspipeline, die sich mit den Tools verbindet, die Sie bereits nutzen. Wenn Ihre Dokumente von einer festen Gruppe bekannter Absender stammen, deren Layouts sich nicht ändern, sind Docparsers Tiefe und Integrationsumfang die pragmatische Wahl.
ImageToTable ist für semantische Extraktion aus unterschiedlichen Quellen gebaut. Sein Vision-LLM eliminiert die Konfiguration pro Layout vollständig und verarbeitet jedes Format, jede Eingabequalität und jede Kombination von Dokumenttypen in einem einzigen Batch. Der Preis ist weniger granulare Kontrolle über Transformationen auf Feldebene. Der Nutzen ist Resilienz: Formatänderungen, neue Anbieter, Handyfotos, Handschrift und gemischte Batches funktionieren ohne Vorlagenwartung. Wenn Ihre Dokumente aus mehreren Quellen mit unterschiedlichen Layouts stammen oder die Eingabequalität variiert (Scans, Fotos, Handschrift), eliminiert ImageToTable mehr laufende Arbeit, als Docparsers tiefere Regelstruktur kompensieren kann.
Wenn Sie eine E-Mail-gesteuerte AP-Automatisierungspipeline mit festformatigen Rechnungen aufbauen, die über Zapier in QuickBooks fließen, ist Docparser die bessere Wahl – seine Automatisierungsebene und Regeltiefe passen zu diesem Workflow. Wenn Sie Dokumente von Außendienstmitarbeitern sammeln, gemischte Bestellformate verarbeiten oder Daten aus Handyfotos und gescannten Formularen im Batch extrahieren, erspart Ihnen der Ansatz ohne Vorlage von ImageToTable die Wartungskosten, die vorlagenbasierte Tools bei Workflows mit variierenden Eingaben verursachen. Kein Tool ist eine universelle Antwort. Aber wenn Sie wissen, wie Ihr Dokumentenökosystem tatsächlich aussieht – wie viele Formate, wie oft sie sich ändern, in welcher Qualität sie ankommen – wird die richtige Wahl klar.
Für einen breiteren Blick darauf, wie beide Tools im Vergleich zur übrigen Extraktionslandschaft abschneiden, siehe ImageToTable vs. Parseur.
Möchten Sie die Kurzfassung? Siehe die Nebeneinander-Funktionsvergleichstabelle oder stöbern Sie in allen ImageToTable-Vergleichen.
FAQ
Benötigt Docparser Vorlagen oder funktioniert DocparserAI auch ohne?
Der primäre Extraktionspfad von Docparser ist vorlagenbasiert – Sie erstellen einen Parser, indem Sie Zonen-OCR-Rechtecke auf einem Beispieldokument zeichnen. DocparserAI fügt KI-gestützte Funktionen hinzu (SmartAI-Parser-Vorlage, die Regeln automatisch erstellt, Handschrifterkennung, Inhaltszusammenfassung), aber diese laufen innerhalb derselben Architektur pro Dokumenttyp. Der SmartAI-Parser reduziert den manuellen Einrichtungsaufwand, indem er automatisch Regeln aus einem Beispieldokument generiert, erwartet aber dennoch konsistente Layouts innerhalb eines Dokumenttyps. ImageToTable.ai verwendet ausschließlich semantische KI – keine Vorlagen, kein Zeichnen von Zonen, keine Konfiguration pro Layout in irgendeinem Extraktionspfad.
Kann ImageToTable.ai wie Docparser in Zapier oder Webhooks integriert werden?
Ja, über die öffentliche v1-API. Die REST-API von ImageToTable.ai ermöglicht das Hochladen von Dokumenten, das Auslösen der Verarbeitung und das Registrieren eines Webhooks, der automatisch ausgelöst wird, wenn ein Batch oder Dokument abgeschlossen ist – kein Polling erforderlich. Zapier und Make können sich über diese API verbinden, aber ImageToTable.ai hat keinen vorgefertigten App-Store-Konnektor oder native Salesforce/ERP-Integrationen wie Docparser. ImageToTable.ai bietet außerdem direkten Export nach Excel, CSV, JSON und Word sowie ein Google-Sheets-Add-on, das extrahierte Daten direkt in die aktive Tabelle schreibt. Wenn Sie die Zapier-App mit einem Klick von Docparser oder dessen native QuickBooks/Salesforce-Konnektoren benötigen, ist das Integrationsökosystem von Docparser für diesen speziellen Fall ausgereifter.
Welches Tool ist bei mehrseitigen Dokumenten günstiger?
Das hängt von der Dokumentlänge ab. Docparser zählt ein Parsing-Credit pro Dokument bis zu fünf Seiten – eine 5-seitige Rechnung verbraucht also 1 Credit. ImageToTable.ai zählt ein Credit pro Seite – dieselbe 5-seitige Rechnung verbraucht 5 Credits. Wenn Ihre Dokumente durchgängig 3–5 Seiten lang sind, kann das Credit-Modell von Docparser pro Dokument deutlich günstiger sein. Bei einseitigen Dokumenten (Belege, die meisten Rechnungen) ist der Preis pro Credit bei ImageToTable.ai niedriger. Ihre Gesamtkosten hängen davon ab, ob Sie hauptsächlich einseitige oder mehrseitige Dokumente verarbeiten. Siehe Aufschlüsselung der Dokumentextraktionspreise 2026 für einen Volumenvergleich.
Unterstützt Docparser die Stapelverarbeitung wie ImageToTable?
Docparser verarbeitet Dokumente innerhalb eines Postfachs – Sie können mehrere Dokumente gleichzeitig hochladen oder automatisierte Importe aus Cloud-Speicher oder E-Mail konfigurieren. Aber jedes Dokument wird einzeln geparst, und das Zusammenführen von Ergebnissen aus mehreren Dokumenten (insbesondere über verschiedene Parser hinweg) in eine einzige ausgerichtete Tabelle erfordert externe Arbeit über Zapier/API oder manuellen Export. ImageToTable wurde für die Batch-First-Verarbeitung entwickelt: Laden Sie Dateien aus beliebigen Quellen hoch, definieren Sie Spaltennamen einmal, und laden Sie eine zusammengeführte Excel-Datei mit konsistenten Kopfzeilen über alle Dokumente herunter. Für Teams, die regelmäßig gemischte Format-Batches verarbeiten, ist dies ein bedeutender Workflow-Unterschied.
Kann Docparser Handschrift genauso gut verarbeiten wie ImageToTable?
DocparserAI hat die Handschrifterkennung über die SmartAI-Parser-Vorlage eingeführt. Es kann handschriftlichen Text aus Dokumenten extrahieren. Die zugrunde liegende zonenbasierte Architektur bedeutet jedoch, dass die Handschrift an einer vorhersehbaren Stelle auf der Seite erscheinen muss, um eine genaue Extraktion zu ermöglichen. Das Vision-LLM von ImageToTable findet handschriftliche Felder überall auf der Seite, indem es den Kontext versteht – es erfordert nicht, dass die Handschrift in einer vordefinierten Zone liegt. Für Dokumente, bei denen Handschrift an variablen Positionen erscheint (Inspektionsformulare vor Ort, Feldarbeitsblätter, Lieferscheine, die von verschiedenen Personen ausgefüllt werden), ist der Ansatz von ImageToTable zuverlässiger.
Kann ich von Docparser zu ImageToTable wechseln?
Ja. Die Migration erfordert keinen Import von Vorlagen – ImageToTable verwendet keine Vorlagen. Exportieren Sie Ihre historischen Docparser-Daten als CSV oder Excel. Laden Sie dieselben Quelldokumente in ImageToTable hoch, geben Sie die Spaltennamen ein, die Ihren Docparser-Felddefinitionen entsprechen, und die KI extrahiert sie ohne jegliche Vorlagenkonfiguration. Die Spaltennamen, die Sie in Docparser verwendet haben (Rechnungsnummer, Lieferantenname, Datum, Gesamtbetrag), werden zu Ihren Spaltennamen in ImageToTable. Führen Sie Ihre historischen Daten mit neuen Extraktionen in einer Tabelle zusammen – konsistente Kopfzeilennamen machen den Übergang unkompliziert.