ImageToTable vs Docparser :
Champs flexibles ou modèles fixes ? Une comparaison honnête pour 2026
Choisir entre ImageToTable et Docparser revient à une seule question d'architecture : voulez-vous un outil qui fait correspondre des zones prédéfinies sur des mises en page fixes — ou un outil qui lit les documents en comprenant ce que les champs signifient ? La réponse détermine non seulement la rapidité de votre démarrage, mais aussi le temps que vous passerez à maintenir le pipeline six mois plus tard. Les deux outils extraient des données structurées à partir de documents. Mais leurs architectures d'extraction sont fondamentalement différentes, et l'architecture qui convient à une équipe disposant de trois modèles de factures stables frustrera une équipe qui jongle avec des documents provenant de quarante fournisseurs mettant à jour leurs mises en page selon leur propre calendrier.
Points clés
- La plupart des articles comparatifs comparent le temps de configuration — le vrai coût est le tapis roulant de maintenance silencieux qui démarre quand le premier fournisseur modifie sa mise en page de facture trois mois plus tard.
- Docparser l'emporte honnêtement sur deux plans : son moteur d'expressions régulières et ses règles d'analyse conditionnelles vont plus loin que les colonnes calculées d'ImageToTable, et son écosystème d'intégrations de niveau Zapier n'a pas d'équivalent du côté d'ImageToTable.
- Choisissez selon l'apparence réelle de vos documents — des PDF multipages stables provenant d'expéditeurs connus favorisent Docparser, tandis que la variété des mises en page, les photos prises au téléphone, l'écriture manuscrite et les lots de sources mixtes favorisent ImageToTable.
Comparaison rapide
Avant de détailler chaque dimension, voici un aperçu de la façon dont les deux outils se comparent sur les facteurs les plus déterminants dans le choix d'une solution d'extraction de documents.
| Dimension | Docparser | ImageToTable.ai |
|---|---|---|
| Modèle d'extraction | OCR zonal avec règles d'analyse personnalisées — dessinez des zones sur un modèle, définissez des ancres et des filtres regex par champ | LLM de vision — lit directement la sémantique du document ; sans modèle, sans zone, sans configuration par mise en page |
| Temps de configuration | 30–60 min par modèle et par mise en page ; analyseurs multi-mises en page disponibles en option à $29.95/mois ou avec le plan Business | Moins d'une minute — saisissez les noms de colonnes, importez, les résultats apparaissent |
| Gestion des changements de format | Les modèles se cassent quand la mise en page change ; nécessitent un ajustement manuel des zones et de nouveaux tests | Automatique — l'extraction sémantique s'adapte instantanément à tout changement de mise en page |
| Profondeur des règles d'analyse | Puissante — regex, logique conditionnelle, calculs, mots-clés d'ancrage, lecture de codes-barres/QR, filtres multi-étapes | Colonnes calculées et colonnes inférées pour des calculs et classifications plus simples |
| Intégrations | Zapier, Make, Power Automate, Workato, API REST, déclencheurs e-mail, connecteurs de stockage cloud, QuickBooks, Salesforce natifs | Export Excel/CSV/JSON/Word ; module Google Sheets ; Lien de collecte ; Email Inbox avec Auto-Process ; API REST publique avec webhooks — pas de connecteur Zapier en app-store |
| Documents multipages | 1 crédit = 1 document jusqu'à 5 pages ; limite de 30 pages par document (50 max) ; taille de fichier limitée à 20 MB | 1 crédit = 1 page ou image ; aucune limite de pages par document ; traite les gros PDF page par page |
| Flexibilité des documents | Idéal sur les PDF numériques propres et cohérents ; se dégrade sur les scans à faible DPI, les photos de téléphone, l'écriture manuscrite, les tampons | Lit toute entrée visuelle — photos de téléphone, scans, captures d'écran, écriture manuscrite, tampons, mélange imprimé/manuscrit |
| Prix de départ | $39/mois (mensuel) / $32.50/mois (annuel) — 100 crédits (100 docs, jusqu'à 5 pages chacun) | $9/mois — 150 crédits (150 pages ou images) ; offre gratuite disponible sans inscription |
Le tableau met en évidence les compromis. Mais la décision réelle dépend de la dimension qui compte le plus dans votre écosystème documentaire. Examinons chacune d'elles.
Configuration : zones, ancres et règles vs noms de colonnes
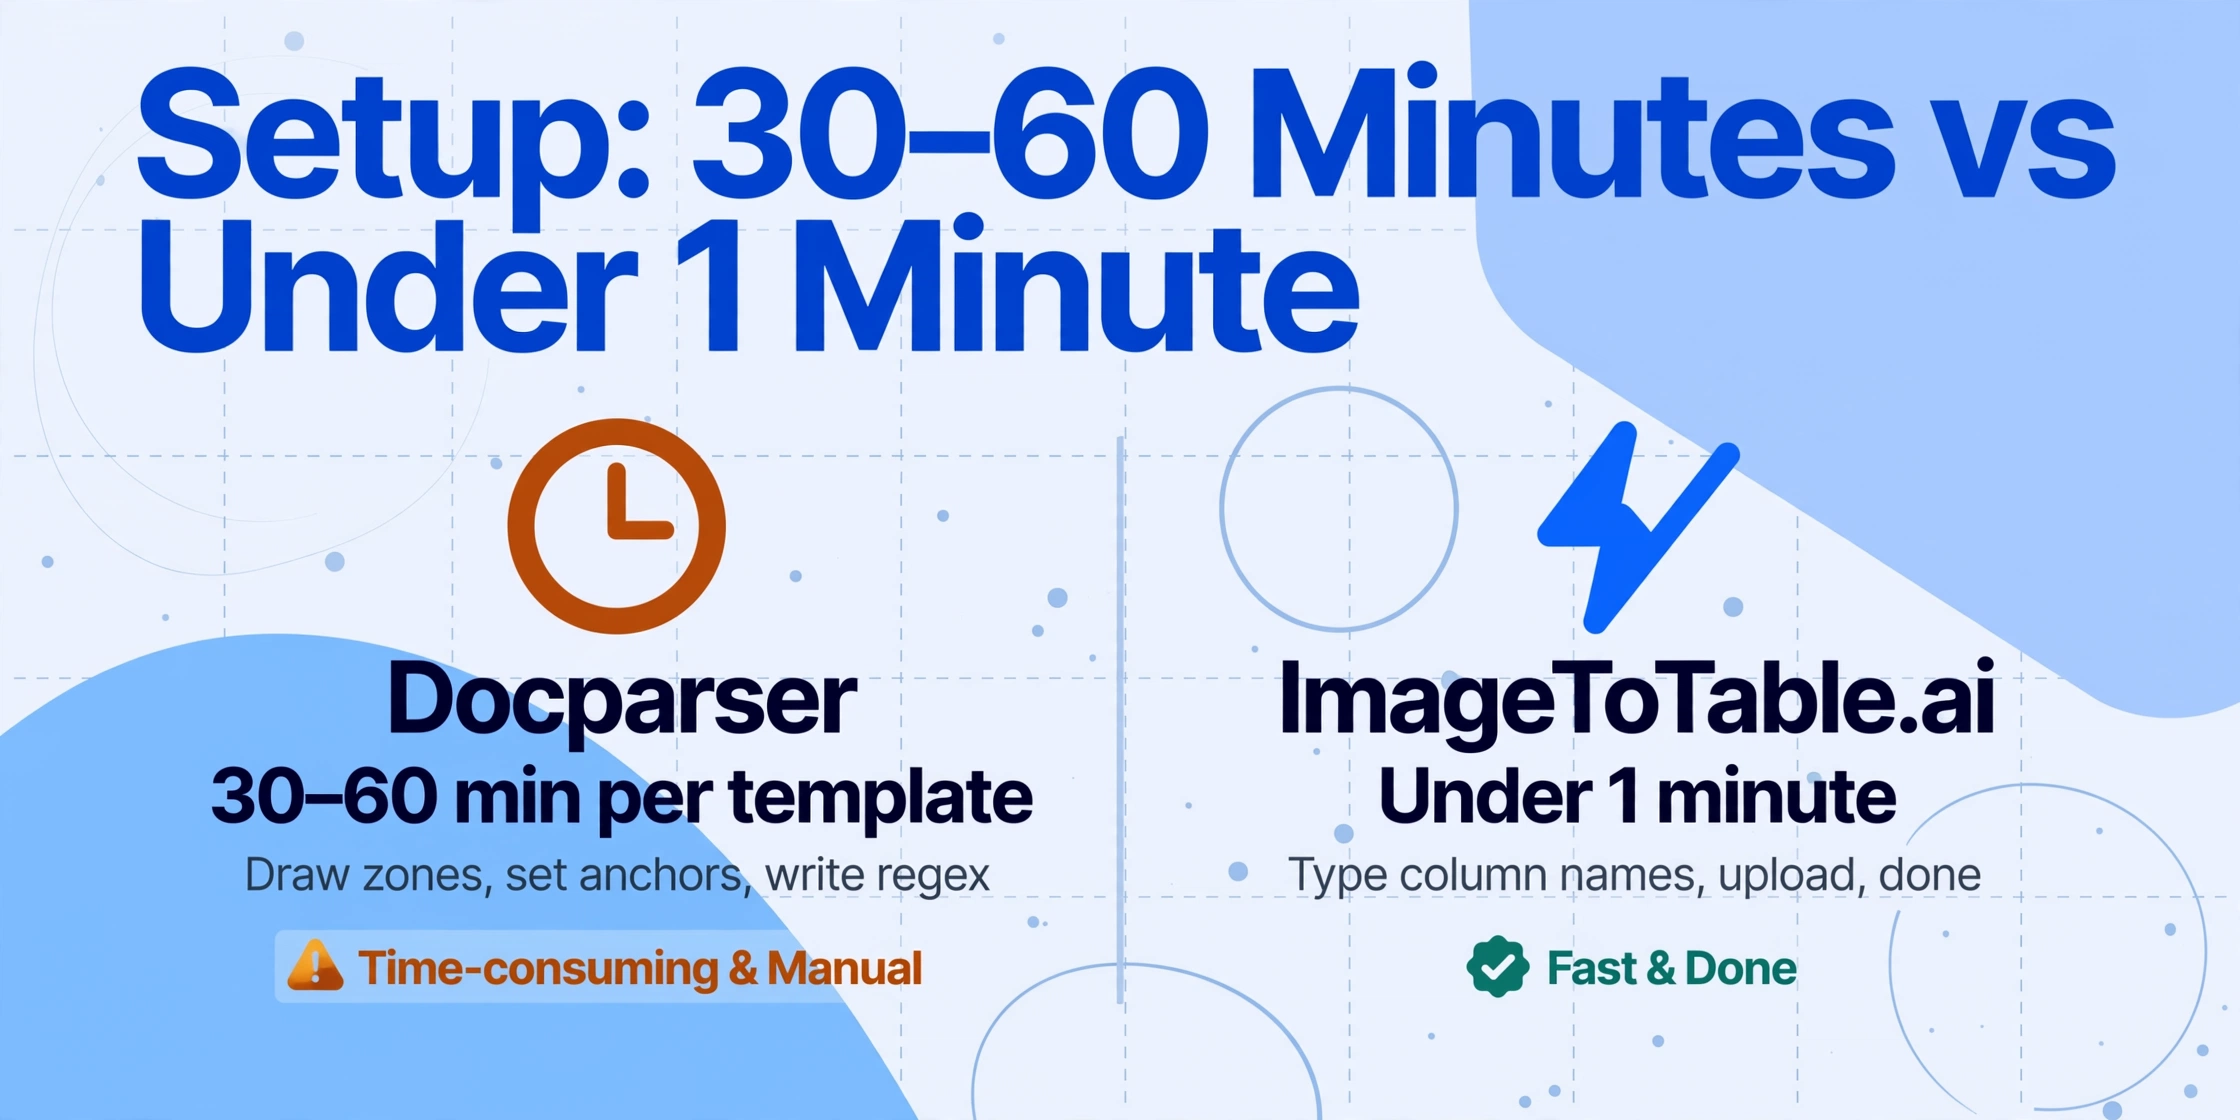
La différence la plus évidente entre les deux outils apparaît dès la première heure. Le processus de configuration de Docparser est une séquence d'étapes délibérées : vous téléchargez un document exemple, définissez des zones d'extraction en dessinant des rectangles autour de chaque champ sur la page, configurez des mots-clés d'ancrage pour aider le parseur à localiser les champs susceptibles de se déplacer, définissez des filtres regex pour normaliser les valeurs extraites, et testez le modèle sur un second exemple avant de pouvoir lui faire confiance sur des documents réels. Pour une facture à mise en page unique d'un seul fournisseur, ce processus prend généralement 30 à 60 minutes.
Si vous traitez des documents de cinq fournisseurs aux formats cohérents, cela représente 2,5 à 5 heures de création de modèles en amont. Si vous avez besoin de parseurs multi-mises en page (un parseur qui gère plusieurs variantes de format), cette capacité coûte 29,95 $ supplémentaires par mois sur les plans Starter et Professional, ou vous pouvez passer au plan Business (159 $/mois) où elle est incluse. Docparser propose également un service payant Parsing Assistant à 149 $ par mise en page où leur équipe crée le modèle pour vous — une reconnaissance honnête que la création de modèles représente un vrai travail.
ImageToTable renverse toute l'équation de configuration. Vous ne dessinez pas de zones, ne définissez pas d'ancres, n'écrivez pas de regex et ne configurez aucun modèle par mise en page. Vous saisissez les noms de colonnes souhaités — « Invoice Number », « Vendor Name », « Date », « Total » — et téléchargez vos documents. Le LLM de vision localise chaque valeur en comprenant ce que le champ signifie, et non où il se trouve sur la page. La première extraction se termine en 5 à 10 secondes. Il n'y a pas de « phase de configuration » avant d'obtenir des résultats — vous évaluez l'outil sur vos documents réels dès le premier téléchargement. Pour les utilisateurs réguliers, les listes de colonnes peuvent être enregistrées comme préréglages, de sorte que la même définition d'extraction s'applique à chaque lot futur sans ressaisir les noms de champs.
La différence de coût de configuration ne tient pas au fait qu'un outil soit plus facile à apprendre. Elle tient au fait que l'outil exige ou non une configuration par mise en page avant de pouvoir extraire des données d'un nouveau type de document. Docparser l'exige. ImageToTable non.
Changements de format : quand le modèle casse
C'est la dimension qui sépare le plus honnêtement les deux outils — et c'est aussi celle que la plupart des articles comparatifs sous-estiment. L'extraction basée sur un modèle fonctionne parfaitement sur le modèle pour lequel elle a été conçue. Le problème, c'est que les documents du monde réel ne restent pas dans leur modèle.
Les fournisseurs modifient la mise en page de leurs factures lorsqu'ils changent de logiciel comptable, fusionnent avec une autre entreprise ou refondent leur image de marque. Un fournisseur déplace le champ « Total dû » du coin inférieur droit vers le coin inférieur gauche — le rectangle de zone que vous avez dessiné pointe désormais vers un espace vide ou, pire, vers une valeur différente. Un autre fournisseur renomme « N° de facture » en « Référence » — le mot-clé d'ancrage sur lequel vous comptiez n'existe plus. Chaque changement vous est invisible jusqu'à ce que le lot suivant de documents arrive avec des erreurs d'extraction que quelqu'un doit identifier, diagnostiquer et corriger.
La technologie Zonal OCR de Docparser est déterministe et précise sur les mises en page connues — c'est sa force. Mais lorsqu'une mise en page change, chaque zone définie dans ce modèle devient peu fiable. La correction nécessite d'ouvrir l'éditeur de modèle, de re-surligner les champs déplacés, d'ajuster les filtres regex concernés et de retester. Si vous êtes sur une offre sans parseurs multi-mises en page, une variante de format d'un fournisseur connu peut nécessiter un tout nouveau modèle. La documentation de Docparser reconnaît elle-même que le Zonal OCR « ne peut pas gérer » les champs de données composés, les champs de données répétitifs, les données tabulaires et les « champs de données à positions variables (par ex. les totaux de facture) » — précisément les scénarios qui se produisent lorsque les mises en page dérivent.
Le LLM de vision d'ImageToTable.ai lit les documents de manière holistique. Il ne se soucie pas de l'endroit où se trouve un champ sur la page, de son libellé, ni du fait que les coordonnées en pixels aient changé depuis le dernier lot. « Total dû » en bas à droite et « Total dû » en bas à gauche sont le même concept sémantique — l'IA le trouve dans les deux cas. Un fournisseur renomme un champ — l'IA résout la relation sémantique entre ce que vous avez demandé et ce que dit le document. Un nouveau fournisseur envoie un document dans un format que l'outil n'a jamais vu — il le traite correctement dès le premier import car il n'y a aucune zone à configurer. C'est le sens pratique de l'extraction de documents sans entraînement.
Docparser l'emporte sur la précision déterministe pour les mises en page stables. ImageToTable l'emporte sur la résilience — il ne casse jamais lorsqu'un format change car il n'a jamais été configuré pour un format spécifique au départ. L'écart entre les deux se creuse avec le temps, à mesure que les mises en page dérivent et que de nouveaux formats de fournisseurs apparaissent.
Granularité d'analyse : quand le moteur de règles de Docparser l'emporte
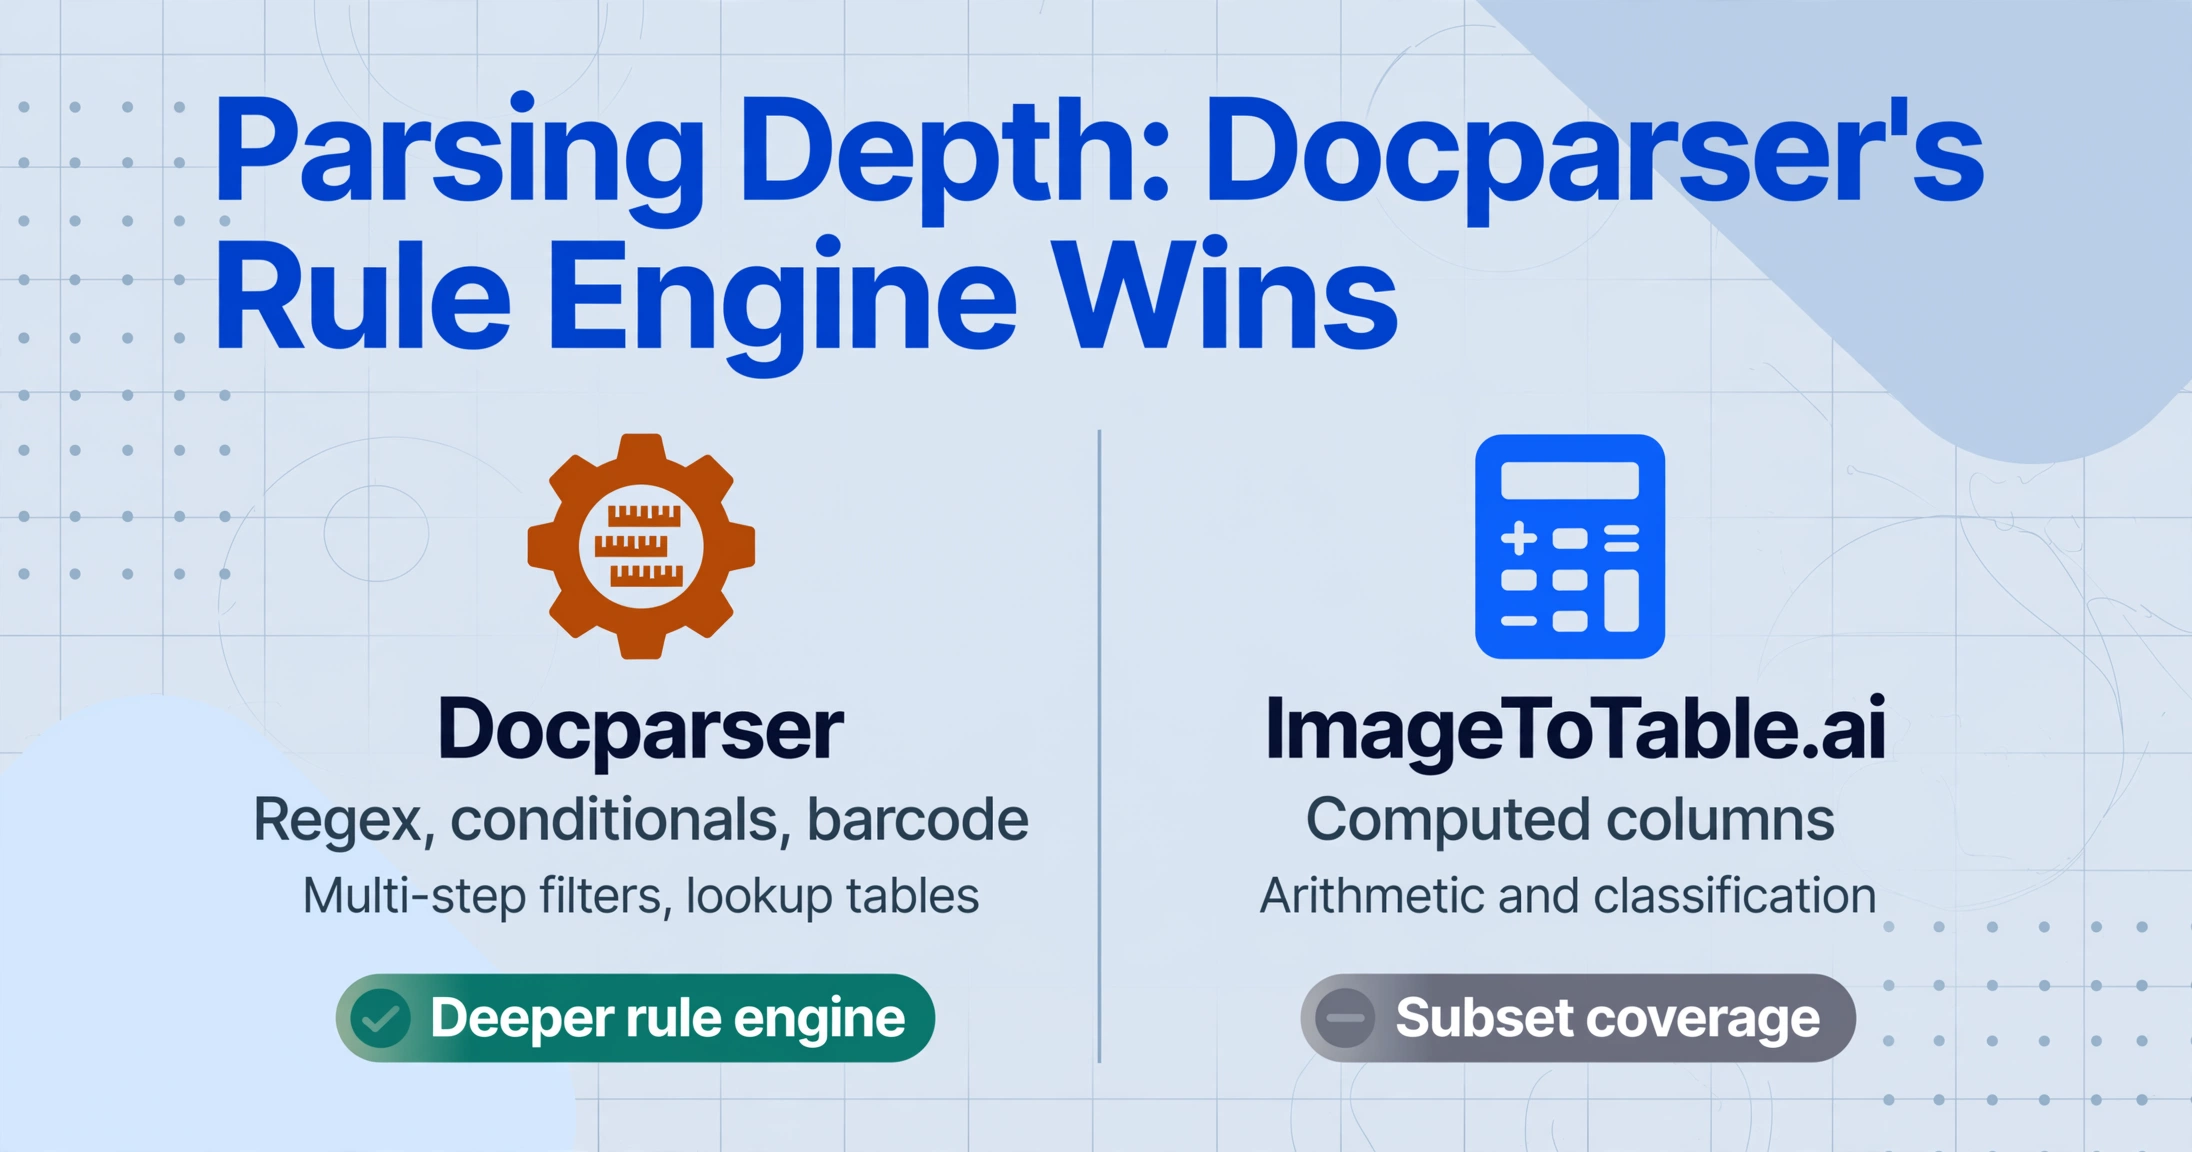
C'est la dimension où Docparser est véritablement supérieur, et une comparaison honnête doit le dire clairement. Le système de règles d'analyse de Docparser est la partie la plus mature de la plateforme, et il va bien plus loin que les colonnes calculées d'ImageToTable à plusieurs égards importants.
Docparser vous permet de définir des motifs regex au niveau des champs pour normaliser les valeurs extraites — par exemple, supprimer les caractères non numériques des numéros de téléphone, reformater les dates de MM/DD/YYYY en YYYY-MM-DD, ou extraire uniquement les chiffres d'un champ « Vendor ID » qui contient du texte préfixe. Vous pouvez définir des règles d'extraction conditionnelles : « Si le type de document est Credit Note, extraire le champ "Credit Amount" au lieu de "Invoice Total". » Vous pouvez combiner des mots-clés d'ancrage avec une extraction basée sur un décalage — « trouver le texte "Total:" sur la page et extraire tout ce qui se trouve dans les 50 pixels à sa droite. » Vous pouvez configurer des règles d'analyse qui référencent d'autres champs extraits, appliquer des tables de correspondance pour traduire des codes propres à un fournisseur en valeurs standardisées, et enchaîner plusieurs filtres en séquence. La lecture de codes-barres et de QR codes est également intégrée à la plateforme, une capacité qu'ImageToTable n'offre pas du tout.
Les colonnes calculées et les colonnes inférées d'ImageToTable couvrent un sous-ensemble significatif de ces cas d'usage. Vous pouvez définir une colonne comme « Line Total (Qty × Unit Price) » et l'IA la calcule pendant l'extraction. Vous pouvez définir des colonnes inférées avec des listes d'options — « Category (options: Meals/Transport/Office/Other) » — et l'IA classe automatiquement chaque document. Mais ImageToTable ne prend pas en charge la transformation de champs au niveau regex, les chemins d'extraction conditionnels, ni les règles enchaînées à plusieurs étapes. Si votre flux d'extraction nécessite des transformations déterministes champ par champ qui vont au-delà de l'arithmétique et de la classification, le moteur de règles de Docparser est l'outil adapté.
Cependant, cette force a une réserve : la profondeur des règles de Docparser n'est disponible qu'après avoir construit un modèle fonctionnel sur une mise en page stable. Si la mise en page change, les règles se cassent en même temps que les zones — vous ne pouvez pas utiliser de regex puissantes et de logique conditionnelle sur des champs extraits au mauvais endroit.
Intégrations : l'écosystème d'automatisation de Docparser
C'est la deuxième dimension où Docparser gagne clairement. La plateforme a investi des années dans la construction d'un écosystème d'intégration mature qu'ImageToTable.ai n'égale pas actuellement en étendue.
Docparser se connecte nativement à Zapier (plus de 6 000 applications), Make, Microsoft Power Automate et Workato. Il propose une API REST pour les intégrations personnalisées, des déclencheurs par e-mail qui analysent automatiquement les pièces jointes entrantes lorsqu'elles sont transférées vers une boîte de réception Docparser dédiée, et des connecteurs de stockage cloud directs pour Google Drive, Dropbox, Box et OneDrive qui vous permettent d'importer des documents sans téléversement manuel. Les données analysées peuvent être envoyées directement à QuickBooks, Salesforce, Google Sheets, MySQL et des centaines d'autres applications via ces connecteurs. Pour une équipe AP qui souhaite que les données de factures extraites alimentent automatiquement son ERP, déclenchent une notification Slack et envoient un résumé vers Google Sheets — sans que personne n'ouvre un navigateur — la profondeur d'intégration de Docparser est un véritable avantage concurrentiel.
La surface d'intégration d'ImageToTable.ai est plus étroite, mais pas absente côté e-mail. Les données peuvent être exportées directement vers Excel, CSV, JSON ou Word depuis l'interface web. L'add-on Google Sheets vous permet d'extraire des données directement dans la feuille de calcul active sans quitter Sheets. Email Inbox couvre le même déclencheur de transfert et d'analyse que la boîte de réception dédiée de Docparser — chaque compte dispose de sa propre adresse, et l'association d'Auto-Process à un modèle lance l'extraction dès l'arrivée du courrier, avec une liste blanche d'expéditeurs et une nouvelle tentative automatique de mot de passe pour les pièces jointes chiffrées. Le Lien de collecte fournit un point de dépôt partageable que des expéditeurs externes peuvent utiliser sans inscription. Ce qu'ImageToTable.ai n'égale pas, c'est la portée en aval de Docparser une fois les données extraites — pas d'interrogation du stockage cloud, pas de connecteurs natifs Zapier/Make/Salesforce/QuickBooks, et une paire API/webhook v1 au lieu du catalogue d'automatisation plus large de Docparser.
Si votre flux de travail dépend d'un routage en aval connecté à Zapier vers des systèmes ERP/CRM, de l'interrogation du stockage cloud ou d'un catalogue mature de connecteurs no-code, Docparser est le meilleur choix pour les intégrations. Si la réception d'e-mails sans intervention est l'exigence, les deux outils y répondent — Email Inbox gère le déclencheur même s'il ne se déploie pas ensuite vers la même étendue de destinations.
Tarifs : différents modèles de coûts pour différents modes d'utilisation
Les structures tarifaires des deux outils reflètent leurs philosophies d'architecture — et lequel est le moins cher dépend entièrement de votre façon de l'utiliser.
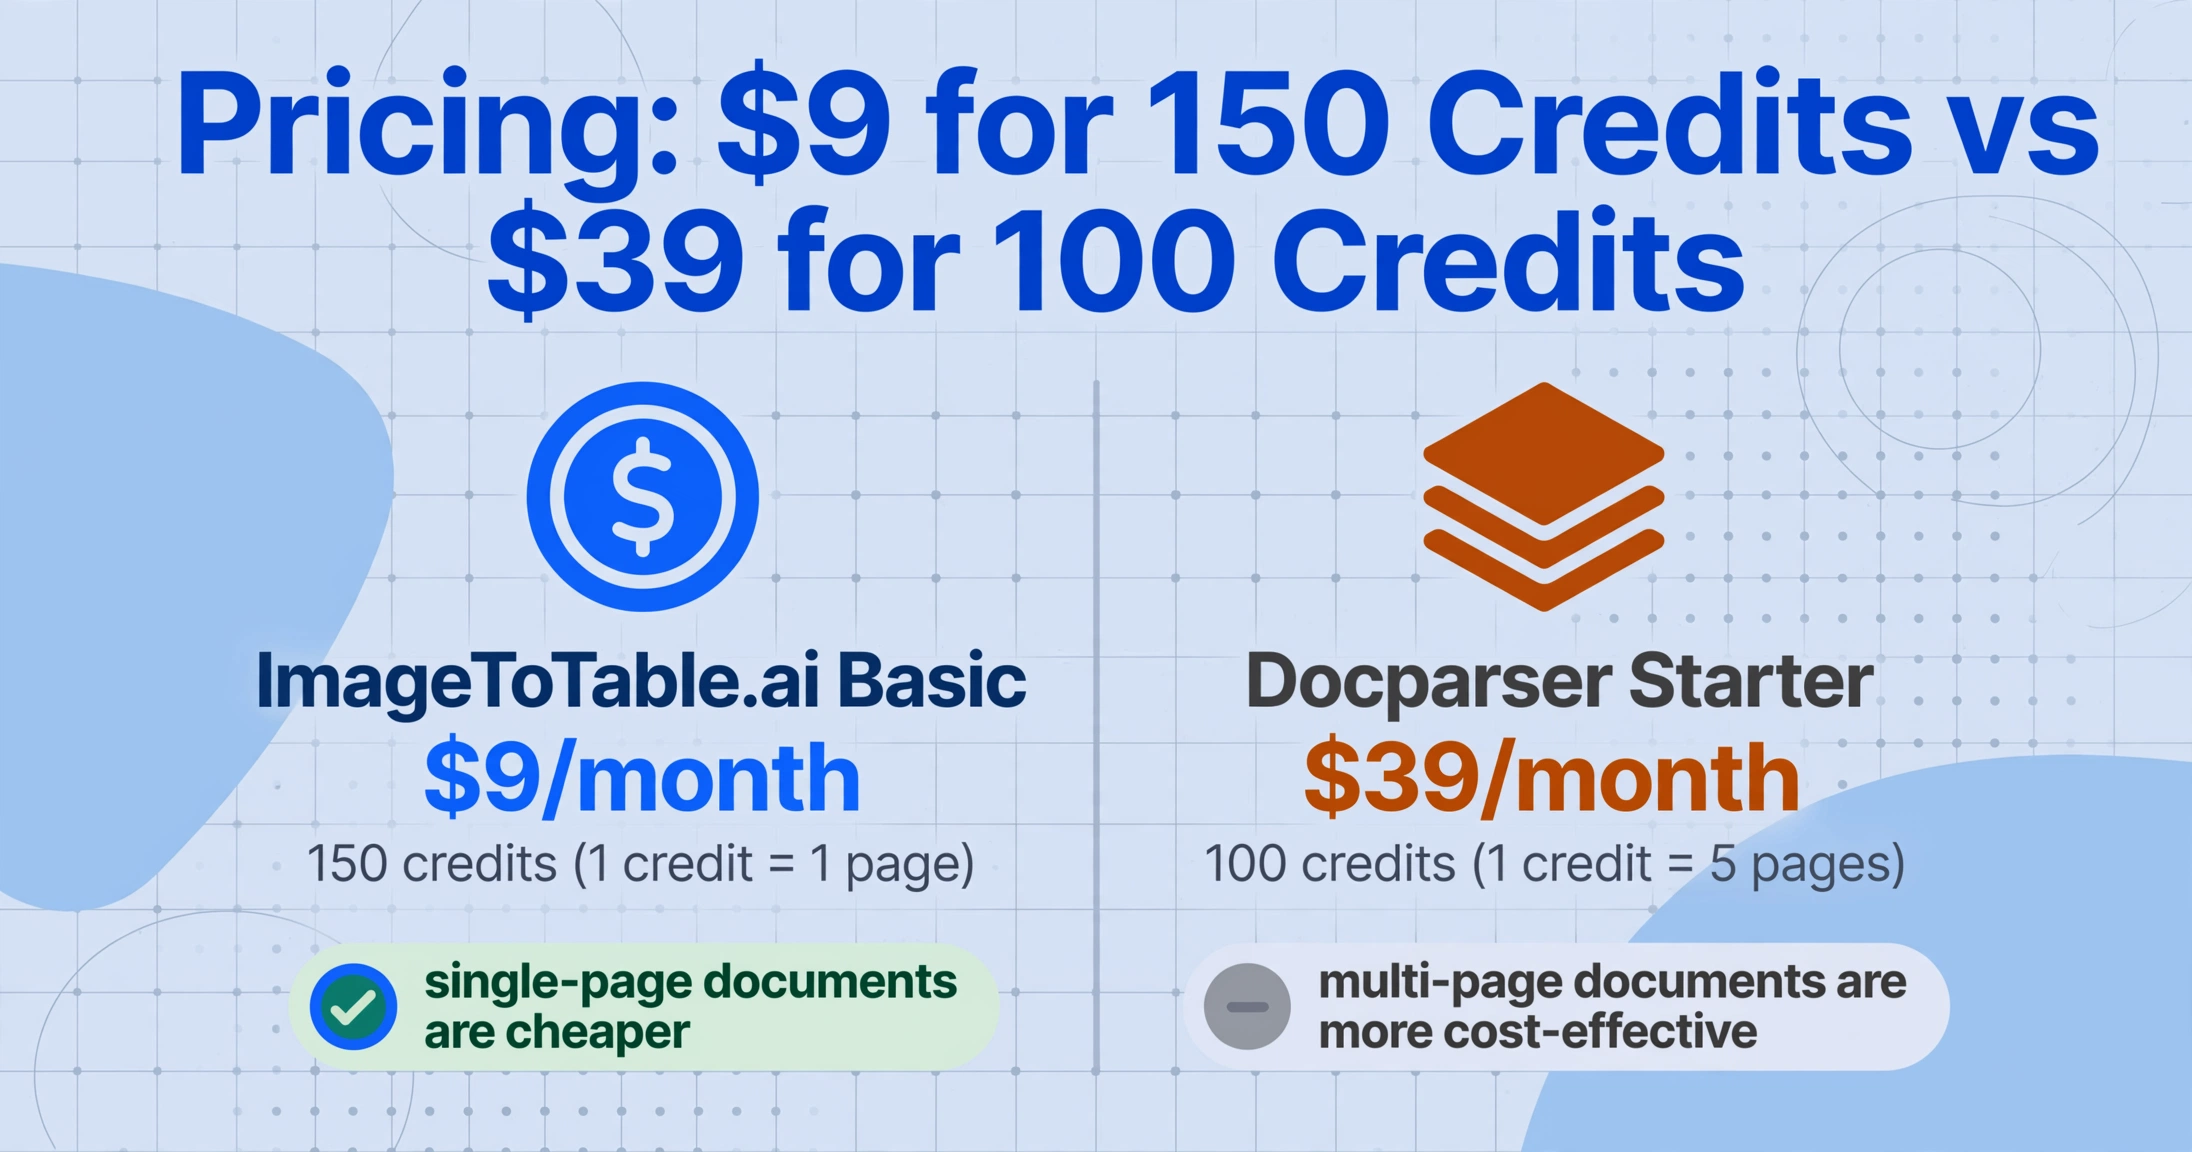
Docparser utilise un modèle de crédits par document. Un crédit équivaut à un document allant jusqu'à cinq pages. Le plan Starter coûte $39/mois (mensuel) ou $32.50/mois (annuel) pour 100 credits — soit effectivement 100 à 500 pages par mois selon la longueur des documents. Le plan Professional ($74/mois en mensuel, $61.50/mois en annuel) donne 250 credits. Le plan Business ($159/mois en mensuel, $133/mois en annuel) donne 1 000 credits avec les parseurs multi-layout inclus. Des fonctionnalités supplémentaires comme les parseurs multi-layout ($29.95/mois), le contrôle de version des parseurs ($9.95/mois) et la conservation étendue des documents ($19.95/mois) sont facturées séparément sur les plans inférieurs.
ImageToTable utilise un modèle d'abonnement par crédit où un crédit équivaut à une image ou une page PDF. Le plan Basic coûte $9/mois pour 150 credits. Pro est à $29/mois pour 500 credits. Max est à $59/mois pour 1 500 credits. Un quota gratuit quotidien vous permet de tester avec de vrais documents avant de vous abonner, et des packs de crédits uniques sont disponibles sans engagement d'abonnement.
Au niveau d'entrée pour les documents d'une seule page, le plan Basic d'ImageToTable offre 150 credits pour $9 — environ 4× plus de volume par dollar que le Starter de Docparser à $39 pour 100 credits. Mais le modèle par document de Docparser devient nettement moins cher pour les documents multipages. Une seule facture de 5 pages consomme 5 credits ImageToTable mais seulement 1 credit Docparser. Si la majorité de vos documents sont des PDF de 3 à 5 pages provenant d'un ensemble stable d'expéditeurs connus, le coût effectif par document de Docparser peut être sensiblement inférieur à la tarification par page d'ImageToTable.
Pour un examen détaillé de l'impact des différents modèles tarifaires sur votre facture mensuelle selon les paliers de volume, consultez document extraction pricing breakdown 2026.
Flexibilité des documents : ce que chaque outil peut réellement lire
Les deux outils couvrent les types de documents professionnels standards — factures, bons de commande, reçus, contrats, relevés bancaires. Mais les types de documents qu'ils traitent de manière fiable divergent nettement dès que l'on sort des PDF numériques propres.
L'OCR zonal de Docparser est conçu pour les documents à mise en page prévisible. Il donne les meilleurs résultats sur les PDF numériques et les scans de haute qualité où chaque champ apparaît à une position constante. Sa propre documentation indique que pour de meilleurs résultats, « les documents entrants sont scannés en haute qualité et ont une mise en page cohérente ». La plateforme a ajouté des options de prétraitement OCR — redressement, suppression d'artefacts, rotation de page — pour améliorer le traitement des scans imparfaits, et DocparserAI prend désormais en charge la reconnaissance de l'écriture manuscrite via le modèle SmartAI Parser. Mais la limitation fondamentale demeure : l'extraction par zones se dégrade sur les images à faible DPI, les scans inclinés, les photos prises au téléphone et les documents où des tampons ou des sceaux recouvrent les champs de données. Lorsque le rectangle de zone ne peut pas englober de manière fiable le texte cible, la qualité d'extraction chute.
ImageToTable.ai a été conçu dès le départ pour combler exactement cette lacune. Le LLM de vision lit les documents comme un humain — en comprenant l'ensemble de la mise en page visuelle et en localisant les champs demandés par leur sens sémantique, et non par leur position en pixels. Tableaux imprimés, formulaires manuscrits, photos au téléphone d'un reçu de restaurant, capture d'écran d'une facture envoyée par e-mail, contrat scanné avec un tampon d'entreprise chevauchant le bloc de signature — l'IA traite tout cela dans le même pipeline d'extraction, sans changer de moteur ni ajuster les paramètres. Pour les données de tableaux imprimés, la précision atteint jusqu'à 99 % sur des documents propres. L'écriture manuscrite est reconnue à des niveaux de précision exploitables — suffisants pour l'extraction de données même si les caractères individuels ne sont pas parfaitement transcrits — car l'IA comprend le contexte du champ : « ce nombre manuscrit se trouve à côté de "Total" et sous "Item charges", il s'agit donc du montant total, quelle que soit la courbure des chiffres. »
La couche DocparserAI de Docparser a apporté la reconnaissance de l'écriture manuscrite et la détection de cases à cocher à la plateforme. Mais ces fonctionnalités reposent sur une architecture par zones qui attend encore les champs à des positions prévisibles. Si un champ manuscrit apparaît à un emplacement différent sur chaque document (parce que le formulaire est rempli à la main et que la main de l'auteur se décale), aucune amélioration par IA ne peut compenser le fait que la zone attend des données à une coordonnée fixe. ImageToTable.ai n'a pas cette contrainte — l'IA trouve le champ par ce qu'il est, et non par l'endroit où il devrait se trouver.
Quand ImageToTable est plus pertinent
ImageToTable est le meilleur choix lorsque votre écosystème documentaire se caractérise par la variété plutôt que la répétition. Si vous recevez des documents de plusieurs fournisseurs utilisant des mises en page différentes — et que ces mises en page changent — l'approche sans modèle élimine la maintenance fastidieuse qu'exigent les outils basés sur des modèles. Vous définissez votre sortie une seule fois (les noms de colonnes souhaités) et l'IA gère automatiquement toute variation de mise en page en entrée. Chaque nouveau format de fournisseur, chaque refonte de mise en page, chaque formulaire personnalisé de client est traité correctement dès le premier import, sans aucun temps de configuration. C'est la différence pratique entre un analyseur de documents sémantique et un outil piloté par modèle.
Si vos documents arrivent sous forme de photos prises au téléphone, de copies scannées ou de documents manuscrits plutôt que de PDF numériques impeccables, le LLM de vision d'ImageToTable les lit sans la dégradation de qualité que subissent les outils basés sur des zones. Un entrepreneur photographiant un bon de livraison sur un chantier, un employé soumettant une note de frais manuscrite, un inspecteur relevant un compteur avec son téléphone — ce ne sont pas des cas limites pour ImageToTable. C'est le cas d'usage principal pour lequel l'outil a été conçu.
Si vous traitez des lots de documents de formats mixtes ensemble — en important les factures de vingt fournisseurs différents en un seul lot et en ayant besoin que les résultats soient fusionnés dans un seul tableau aligné — l'architecture d'ImageToTable axée sur le traitement par lots le fait en une seule étape. Docparser traite chaque document individuellement dans une boîte mail ; fusionner les résultats d'extraction de plusieurs fournisseurs dans un tableau unifié nécessite une automatisation Zapier ou un assemblage manuel.
Si votre budget est serré et que vos documents sont majoritairement d'une seule page (reçus, factures, bons de commande), le Basic Plan d'ImageToTable à $9/mois offre 150 pages — un rapport valeur/prix nettement supérieur au niveau d'entrée de Docparser.
Quand Docparser est plus pertinent
Docparser est le meilleur choix lorsque vos besoins d'extraction dépassent la simple localisation de champs pour aller vers une transformation déterministe des données. Si vous avez besoin de normalisation par regex, de chemins d'extraction conditionnels, de filtres multi-étapes, de lecture de codes-barres ou de règles de calcul enchaînées sur plusieurs champs, le moteur de règles d'analyse de Docparser est plus puissant que les colonnes calculées d'ImageToTable. ImageToTable gère bien l'arithmétique et la classification, mais n'égale pas la profondeur des règles de Docparser pour les transformations complexes champ par champ.
Si votre flux de travail repose sur des intégrations automatisées — documents reçus par transfert d'e-mail → analysés automatiquement → données envoyées à QuickBooks via Zapier → notification Slack envoyée — l'écosystème d'intégrations de Docparser est nettement plus mature. L'Email Inbox d'ImageToTable couvre le même déclencheur transfert-et-analyse (avec Auto-Process qui le rend entièrement automatique), mais le catalogue de connecteurs plus large de Docparser — actions natives Zapier, Make, Power Automate et Salesforce s'enchaînant directement vers QuickBooks ou Slack — va plus loin que ce que l'API v1 et le webhook d'ImageToTable seuls peuvent atteindre sans code d'intégration personnalisé. Pour les équipes qui ont investi dans des plateformes d'automatisation et ont besoin que l'outil d'extraction s'intègre à ces flux plutôt que de fournir sa propre interface, la profondeur des connecteurs de Docparser est un véritable atout.
Si chaque document que vous traitez est un PDF multipage provenant d'un expéditeur stable et connu — par exemple, vous traitez 200 factures mensuelles de 5 fournisseurs dont les formats n'ont pas changé depuis des années — le modèle de crédits de Docparser (1 crédit par document jusqu'à 5 pages) le rend plus économique que la tarification par page d'ImageToTable, et le coût de configuration du modèle est un investissement unique qui s'amortit sur un traitement régulier.
Si vous avez besoin de lecture de codes-barres ou de QR codes intégrée au pipeline d'extraction, Docparser l'inclut nativement. ImageToTable ne peut pas lire les codes-barres ni les QR codes pendant l'extraction — cette capacité n'est pas actuellement disponible dans le produit.
Le verdict honnête : Docparser gagne lorsque vos besoins de traitement sont riches en règles et stables en format. ImageToTable gagne lorsque votre écosystème documentaire est varié en formats, diversifié en sources ou changeant en mise en page. Aucune architecture n'est universellement meilleure — le bon outil dépend du type de variabilité que vous rencontrez réellement.
Le verdict : basé sur les scénarios, pas un choix binaire forcé
Après avoir comparé les deux outils sur le temps de configuration, la résilience aux formats, la granularité d'extraction, les intégrations, le prix et la flexibilité des documents, le cadre de décision est plus clair que ne le suggèrent la plupart des articles comparatifs.
Docparser est conçu pour l'extraction déterministe à partir de mises en page stables. Son moteur Zonal OCR et son système de règles récompensent les équipes dont les formats de documents sont constants, grâce à une extraction au niveau des champs précise et reproductible. Le coût, c'est la configuration et la maintenance par mise en page. Le bénéfice, c'est le contrôle : normalisation par regex, logique conditionnelle, lecture de codes-barres et un pipeline d'automatisation mature qui se connecte aux outils que vous utilisez déjà. Si vos documents proviennent d'un ensemble fixe d'expéditeurs connus dont les mises en page ne changent pas, la profondeur et l'étendue des intégrations de Docparser en font le choix pragmatique.
ImageToTable est conçu pour l'extraction sémantique à partir de sources variées. Son LLM de vision supprime entièrement la configuration par mise en page, gérant tout format, toute qualité d'entrée et toute combinaison de types de documents en un seul lot. Le coût, c'est un contrôle moins granulaire sur les transformations au niveau des champs. Le bénéfice, c'est la résilience : changements de format, nouveaux fournisseurs, photos prises au téléphone, écriture manuscrite et lots mixtes fonctionnent tous sans maintenance de modèle. Si vos documents arrivent de sources multiples avec des mises en page différentes, ou si la qualité d'entrée varie (scans, photos, écriture manuscrite), ImageToTable élimine plus de travail récurrent que ce que le jeu de règles plus poussé de Docparser peut compenser.
Si vous construisez un pipeline d'automatisation AP piloté par e-mail avec des factures au format fixe alimentant QuickBooks via Zapier, Docparser est plus adapté — sa couche d'automatisation et la profondeur de ses règles correspondent à ce flux de travail. Si vous collectez des documents auprès d'équipes terrain, traitez des bons de commande aux formats mixtes, ou extrayez en lot des données à partir de photos prises au téléphone et de formulaires scannés, l'approche sans modèle d'ImageToTable vous épargne le coût de maintenance que les outils basés sur des modèles imposent aux flux de travail à entrées variées. Aucun des deux outils n'est une réponse universelle. Mais si vous savez à quoi ressemble réellement votre écosystème documentaire — combien de formats, à quelle fréquence ils changent, dans quelle qualité ils arrivent — le bon choix devient évident.
Pour un aperçu plus large de la façon dont les deux outils se comparent au reste du paysage de l'extraction, voir ImageToTable vs Parseur.
Vous voulez la version condensée ? Consultez le tableau comparatif des fonctionnalités côte à côte, ou parcourez toutes les comparaisons ImageToTable.
FAQ
Docparser nécessite-t-il des modèles, ou DocparserAI fonctionne-t-il sans ?
La principale méthode d'extraction de Docparser repose sur des modèles — vous créez un parseur en dessinant des rectangles OCR zonaux sur un document exemple. DocparserAI ajoute des fonctionnalités assistées par IA (modèle SmartAI Parser qui crée automatiquement des règles, reconnaissance de l'écriture manuscrite, résumé de contenu), mais celles-ci fonctionnent dans la même architecture par type de document. Le SmartAI Parser réduit le temps de configuration manuelle en générant automatiquement des règles à partir d'un document exemple, mais il attend toujours des mises en page cohérentes au sein d'un type de document. ImageToTable utilise exclusivement l'IA sémantique — aucun modèle, aucun dessin de zone, aucune configuration par mise en page dans aucune méthode d'extraction.
ImageToTable peut-il s'intégrer à Zapier ou à des webhooks comme Docparser ?
Oui, via l'API publique v1. L'API REST d'ImageToTable vous permet de téléverser des documents, de déclencher le traitement et d'enregistrer un webhook qui se déclenche automatiquement lorsqu'un lot ou un document se termine — aucun sondage requis. Zapier et Make peuvent se connecter via cette API, mais ImageToTable n'a pas de connecteur préconstruit dans un app-store ni d'intégrations natives Salesforce/ERP comme Docparser. ImageToTable propose aussi l'export direct vers Excel, CSV, JSON et Word, ainsi qu'un module complémentaire Google Sheets qui écrit les données extraites directement dans la feuille de calcul active. Si vous avez besoin de l'application Zapier en un clic de Docparser ou de ses connecteurs natifs QuickBooks/Salesforce, l'écosystème d'intégration de Docparser est plus mature pour ce cas précis.
Quel outil est plus abordable pour les documents multipages ?
Cela dépend de la longueur du document. Docparser compte un crédit d'analyse par document jusqu'à cinq pages — une facture de 5 pages consomme donc 1 crédit. ImageToTable compte un crédit par page — cette même facture de 5 pages consomme 5 crédits. Si vos documents font systématiquement 3 à 5 pages, le modèle de crédits de Docparser peut être nettement moins cher par document. Pour les documents d'une seule page (reçus, la plupart des factures), la tarification d'ImageToTable est plus basse par crédit. Votre coût total dépend de la proportion de documents d'une page ou multipages que vous traitez. Voir détail des tarifs d'extraction de documents 2026 pour une comparaison volume par volume.
Docparser prend-il en charge le traitement par lots comme ImageToTable ?
Docparser traite les documents dans une boîte mail — vous pouvez importer plusieurs documents à la fois ou configurer des imports automatisés depuis un stockage cloud ou un e-mail. Mais chaque document est analysé individuellement, et fusionner les résultats de plusieurs documents (surtout entre différents analyseurs) dans un seul tableur aligné nécessite un travail externe via Zapier/API ou un export manuel. ImageToTable a été conçu Traitement par lots en priorité : importez des fichiers depuis n'importe quelle source, définissez les noms de colonnes une fois, et téléchargez un seul fichier Excel fusionné avec des en-têtes cohérents pour tous les documents. Pour les équipes qui traitent régulièrement des lots de formats mixtes, c'est une différence de flux de travail notable.
Docparser peut-il gérer l'écriture manuscrite aussi bien qu'ImageToTable ?
DocparserAI a introduit la reconnaissance de l'écriture manuscrite via le modèle SmartAI Parser. Il peut extraire du texte manuscrit à partir de documents. Cependant, l'architecture sous-jacente basée sur des zones signifie que l'écriture manuscrite doit apparaître à un emplacement prévisible sur la page pour une extraction précise. Le LLM de vision d'ImageToTable trouve les champs manuscrits n'importe où sur la page en comprenant le contexte — il n'exige pas que l'écriture manuscrite soit dans une zone prédéfinie. Pour les documents où l'écriture manuscrite apparaît à des positions variables (formulaires d'inspection de site, feuilles de terrain, bons de livraison remplis par différentes mains), l'approche d'ImageToTable est plus fiable.
Puis-je passer de Docparser à ImageToTable ?
Oui. La migration ne nécessite pas d'importer des modèles — ImageToTable n'utilise pas de modèles. Exportez vos données historiques Docparser au format CSV ou Excel. Importez les mêmes documents sources dans ImageToTable, saisissez les noms de colonnes qui correspondent à vos définitions de champs Docparser, et l'IA les extrait sans aucune configuration de modèle. Les noms de colonnes que vous utilisiez dans Docparser (Invoice Number, Vendor Name, Date, Total) deviennent vos noms de colonnes dans ImageToTable. Fusionnez vos données historiques avec les nouvelles extractions dans un tableur — des noms d'en-têtes cohérents rendent la transition simple.