ImageToTable vs Docparser:
柔軟なフィールドか固定テンプレートか?誠実な2026年比較レビュー
ImageToTableとDocparserのどちらを選ぶかは、単一のアーキテクチャ上の問いに帰着します。固定レイアウト上の事前定義されたゾーンにマッチするツールが欲しいのか、それともフィールドの意味を理解してドキュメントを読み取るツールが欲しいのか。その答えは、開始時のスピードだけでなく、6か月後のパイプライン維持にかかる時間も左右します。両ツールともドキュメントから構造化データを抽出します。しかし、その抽出アプローチは根本的に異なるアーキテクチャに基づいており、安定した3つの請求書テンプレートを持つチームに適したアーキテクチャは、独自のスケジュールでレイアウトを更新する40社のベンダーからドキュメントを扱うチームを悩ませることになります。
重要なポイント
- ほとんどの比較記事はセットアップ時間に焦点を当てますが、実際のコストは、3か月後に最初のベンダーが請求書レイアウトを変更したときから始まる、静かなメンテナンスの負担です。
- Docparserは正直に2つの点で優れています。正規表現エンジンと条件付き解析ルールはImageToTableの計算列よりも深く、Zapierレベルの統合エコシステムはImageToTable側に相当するものがないからです。
- ドキュメントの実際の見た目に基づいて選択してください。既知の送信者からの安定したマルチページPDFはDocparserに有利ですが、レイアウトの多様性、スマホ写真、手書き、複数ソースからのバッチはすべてImageToTableに有利です。
クイック比較
各項目を詳しく見る前に、ドキュメント抽出の判断に最も影響する要素について、2つのツールを比較した概要を紹介します。
| 項目 | Docparser | ImageToTable.ai |
|---|---|---|
| 抽出モデル | ゾーンOCRとカスタム解析ルール — テンプレート上にゾーンを描画し、フィールドごとにアンカーキーワードと正規表現フィルターを定義 | ビジョンLLM — ドキュメントの意味を直接読み取り、テンプレート不要、ゾーン不要、レイアウトごとの設定も不要 |
| セットアップ時間 | レイアウトごとにテンプレート1つあたり30〜60分。マルチレイアウトパーサーは月額$29.95のアドオンまたはBusinessプランで利用可能 | 1分未満 — 列名を入力し、アップロードするだけで結果が表示されます |
| フォーマット変更への対応 | レイアウトが変わるとテンプレートが機能しなくなり、手動でのゾーン調整と再テストが必要 | 自動対応 — 意味的抽出により、あらゆるレイアウト変更に即座に適応します |
| 解析ルールの深さ | 強力 — 正規表現、条件ロジック、計算、アンカーキーワード、バーコード/QRコードスキャン、多段階フィルター | 計算列と推論列で、よりシンプルな計算と分類を実現 |
| 連携機能 | ネイティブのZapier、Make、Power Automate、Workato、REST API、メールトリガー、クラウドストレージコネクタ、QuickBooks、Salesforce | Excel/CSV/JSON/Word書き出し、Google スプレッドシートのアドオン、コレクションリンク、自動処理対応のメール受信ボックス、Webhook対応の公開REST API — アプリストアのZapierコネクタはなし |
| 複数ページのドキュメント | 1クレジット = 最大5ページのドキュメント1件。ドキュメントの上限は30ページ(最大50ページ)、ファイルサイズ上限は20 MB | 1クレジット = 1ページまたは画像1枚。ドキュメントレベルのページ上限なし。大きなPDFもページ単位で処理 |
| ドキュメントの柔軟性 | 鮮明で一貫性のあるデジタルPDFに最適。低DPIのスキャン、スマホ写真、手書き、スタンプがあると精度が低下 | スマホ写真、スキャン、スクリーンショット、手書き、スタンプ、印刷と手書きの混在など、あらゆる視覚入力を読み取り可能 |
| 初期費用 | 月額$39(月払い)/ 月額$32.50(年払い)— 100クレジット(各最大5ページのドキュメント100件) | 月額$9 — 150クレジット(150ページまたは画像150枚)。サインアップ不要の無料プランあり |
この表でトレードオフが明確になります。しかし、実際の判断は、ユーザーのドキュメント環境において、これらの要素のどれが最も重要かによって決まります。それぞれ見ていきましょう。
セットアップ:ゾーン、アンカー、ルール vs. 列名
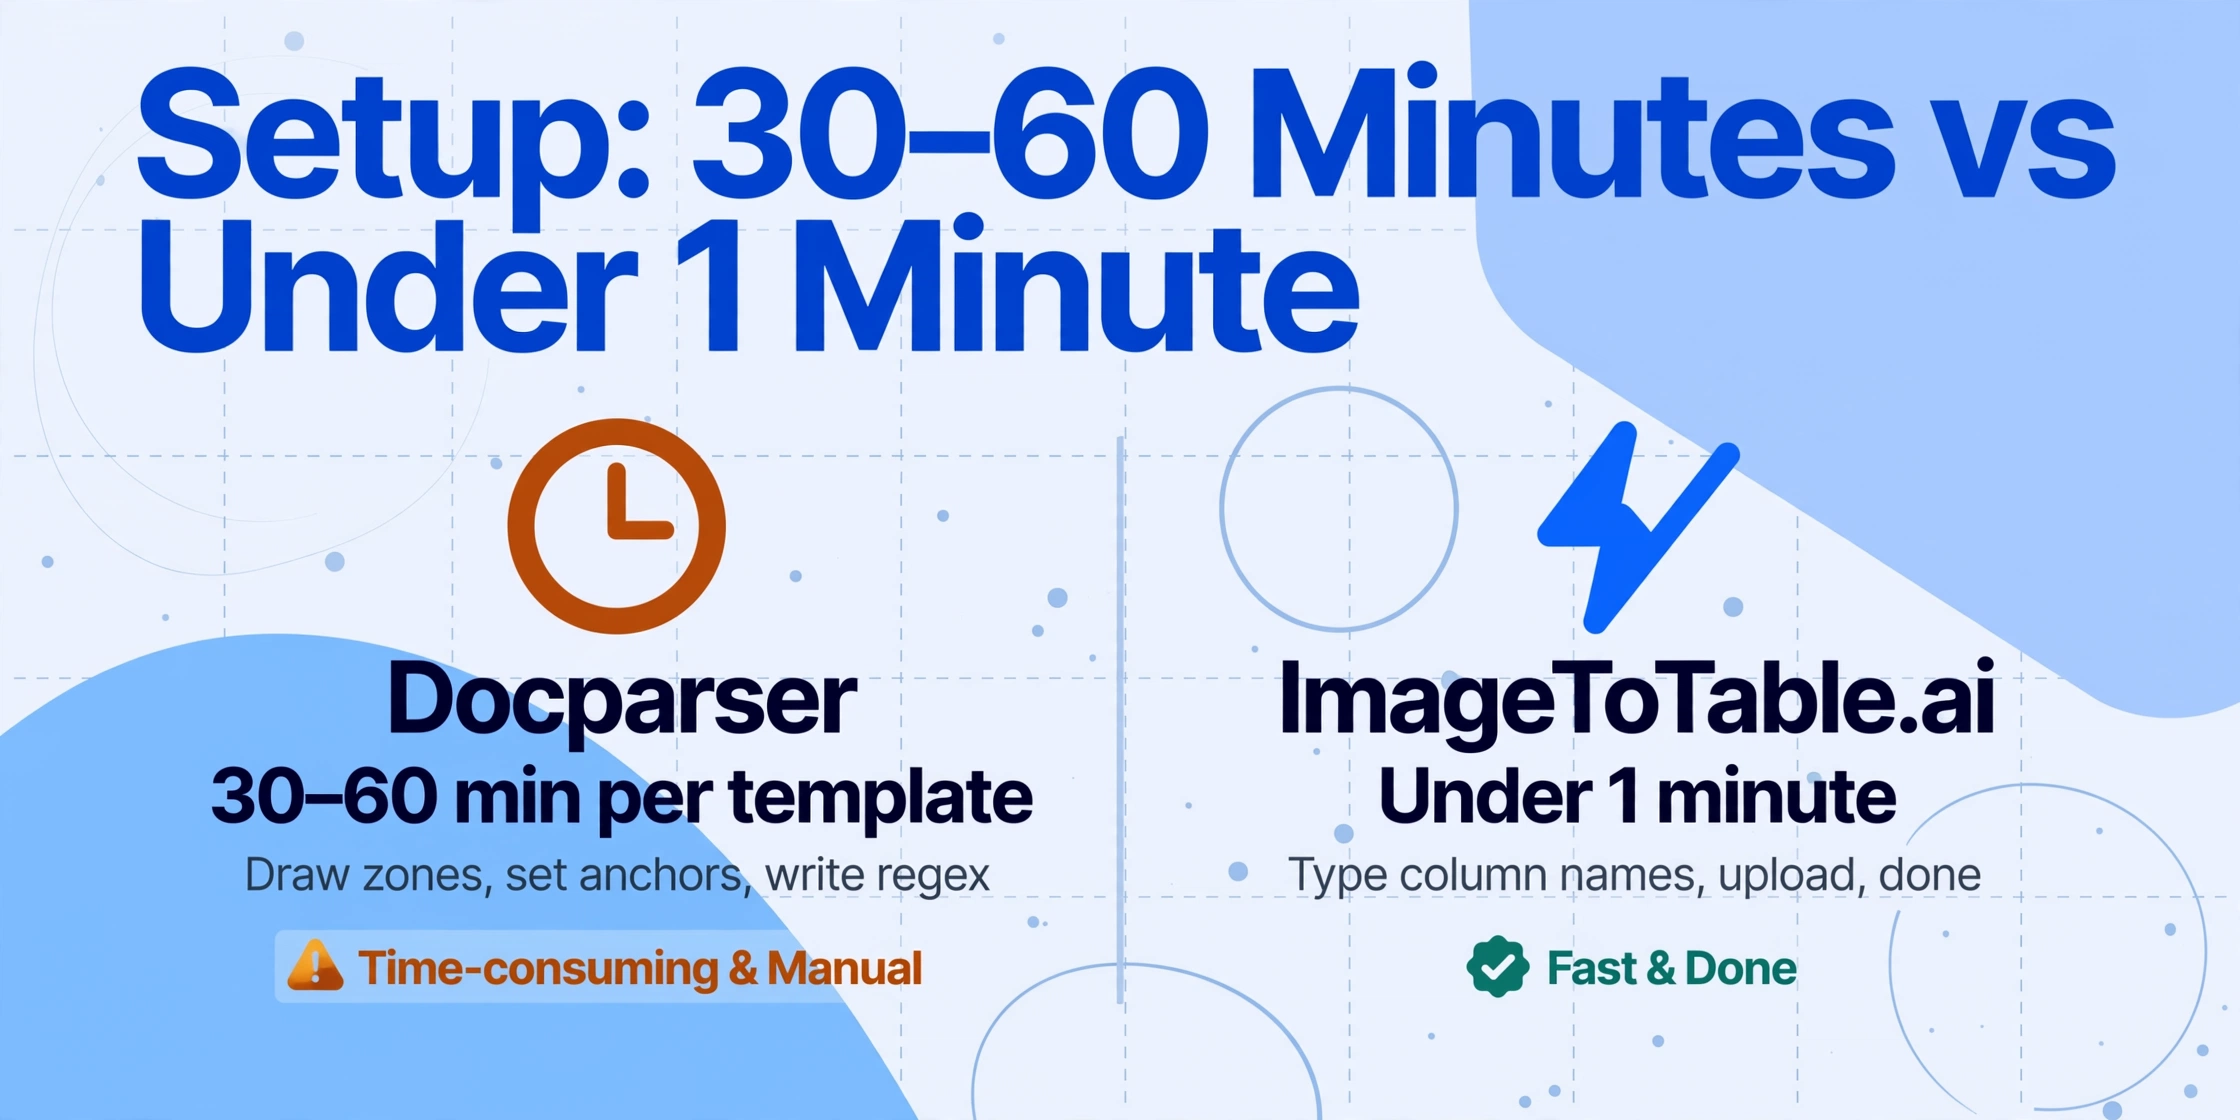
2つのツールの最も明確な違いは、最初の1時間で表面化します。Docparserのセットアッププロセスは、意図的な一連のステップです。サンプルドキュメントをアップロードし、ページ上の各フィールドの周囲に長方形を描いて抽出ゾーンを定義し、パーサーが移動する可能性のあるフィールドを特定できるようにアンカーキーワードを設定し、抽出値を正規化するための正規表現フィルターを設定し、ライブドキュメントで信頼できるようになる前に、2番目のサンプルに対してテンプレートをテストします。1つのベンダーからの単一レイアウトの請求書の場合、このプロセスは通常30〜60分かかります。
一貫した形式の5つのベンダーからのドキュメントを処理する場合、事前のテンプレート作成に2.5〜5時間かかります。マルチレイアウトパーサー(複数の形式バリアントを処理する1つのパーサー)が必要な場合、その機能はStarterプランとProfessionalプランで月額追加$29.95かかります。または、Businessプラン(月額$159)にアップグレードすると含まれます。Docparserはまた、有料のParsing Assistantサービスをレイアウトあたり$149で提供しており、彼らのチームがユーザーに代わってテンプレートを作成します。これは、テンプレート作成が実際の作業であることを正直に認めているものです。
ImageToTableはセットアップの方程式全体を逆転させます。ゾーンを描画したり、アンカーを定義したり、正規表現を書いたり、レイアウトごとのテンプレートを設定したりする必要はありません。「請求書番号」「ベンダー名」「日付」「合計」など、必要な列名を入力して、ドキュメントをアップロードするだけです。ビジョンLLMは、フィールドがページ上のどこにあるかではなく、フィールドが意味することを理解して各値を特定します。最初の抽出は5〜10秒で完了します。結果を得る前に「セットアップフェーズ」はありません。最初のアップロードから実際のドキュメントでツールを評価できます。リピーターユーザーの場合、列リストはプリセットとして保存できるため、同じ抽出定義がフィールド名を再入力することなく、将来のすべてのバッチで実行されます。
セットアップコストの違いは、一方のツールが学習しやすいかどうかではありません。新しいドキュメントタイプからデータを抽出する前に、ツールがレイアウトごとの設定を必要とするかどうかです。Docparserはそれを必要とします。ImageToTableは必要としません。
フォーマット変更:テンプレートが崩れるとき
これは、2つのツールを最も正直に分ける側面であり、比較記事の多くが過小評価している点でもあります。テンプレートベースの抽出は、そのテンプレート用に構築された文書に対しては完璧に機能します。問題は、実際の文書がテンプレートの枠に収まり続けるとは限らないことです。
サプライヤーが会計ソフトを切り替えたり、他社と合併したり、ブランディングを刷新したりすると、請求書のレイアウトが変わります。ベンダーが「Total Due」フィールドを右下から左下に移動した場合、描画したゾーン矩形は空白部分を指すか、さらに悪い場合は別の値を指すことになります。別のサプライヤーが「Invoice #」を「Reference」に改名した場合、依存していたアンカーキーワードは存在しなくなります。こうした変更は、抽出エラーを含む次の文書バッチが届き、誰かがその特定・診断・修正を行うまで、ユーザーには見えません。
DocparserのゾーンOCR技術は、既知のレイアウトに対して決定的かつ正確です。それが強みです。しかし、レイアウトが変わると、そのテンプレートで定義されたすべてのゾーンが信頼できなくなります。修正には、テンプレートエディターを開き、移動したフィールドを再ハイライトし、影響を受ける正規表現フィルターを調整し、再テストする必要があります。マルチレイアウトパーサーを含まないプランの場合、既知のベンダーからのフォーマットのバリエーションでも、まったく新しいテンプレートが必要になる可能性があります。Docparser自身のドキュメントも、ゾーンOCRは複合データフィールド、繰り返しデータフィールド、テーブルデータ、「可変位置のデータフィールド(例:請求書合計)」を「処理できない」ことを認めており、これらはまさにレイアウトのずれが発生したときに起こるシナリオです。
ImageToTableのビジョンLLMは、文書を全体として読み取ります。フィールドがページのどこにあるか、どのようにラベル付けされているか、前回のバッチ以降にピクセル座標がずれたかどうかは気にしません。右下の「Total Due」と左下の「Total Due」は同じ意味概念であり、AIはどちらも見つけ出します。ベンダーがフィールド名を変更しても、AIはユーザーが求めたものと文書に記載されているものの間の意味的関係を解決します。新しいベンダーが、ツールがこれまで見たことのないフォーマットの文書を送ってきても、設定するゾーンがないため、最初のアップロードで正しく処理されます。これがトレーニング不要の文書抽出の実際的な意味です。
Docparserは、安定したレイアウトに対する決定的な精度で優れています。ImageToTableは、回復力で優れています。特定のフォーマットに設定されていないため、フォーマットが変更されても壊れることはありません。 レイアウトのずれが生じ、新しいベンダーフォーマットが登場するにつれて、両者の差は時間とともに広がります。
解析の粒度:Docparserのルールエンジンが勝るケース
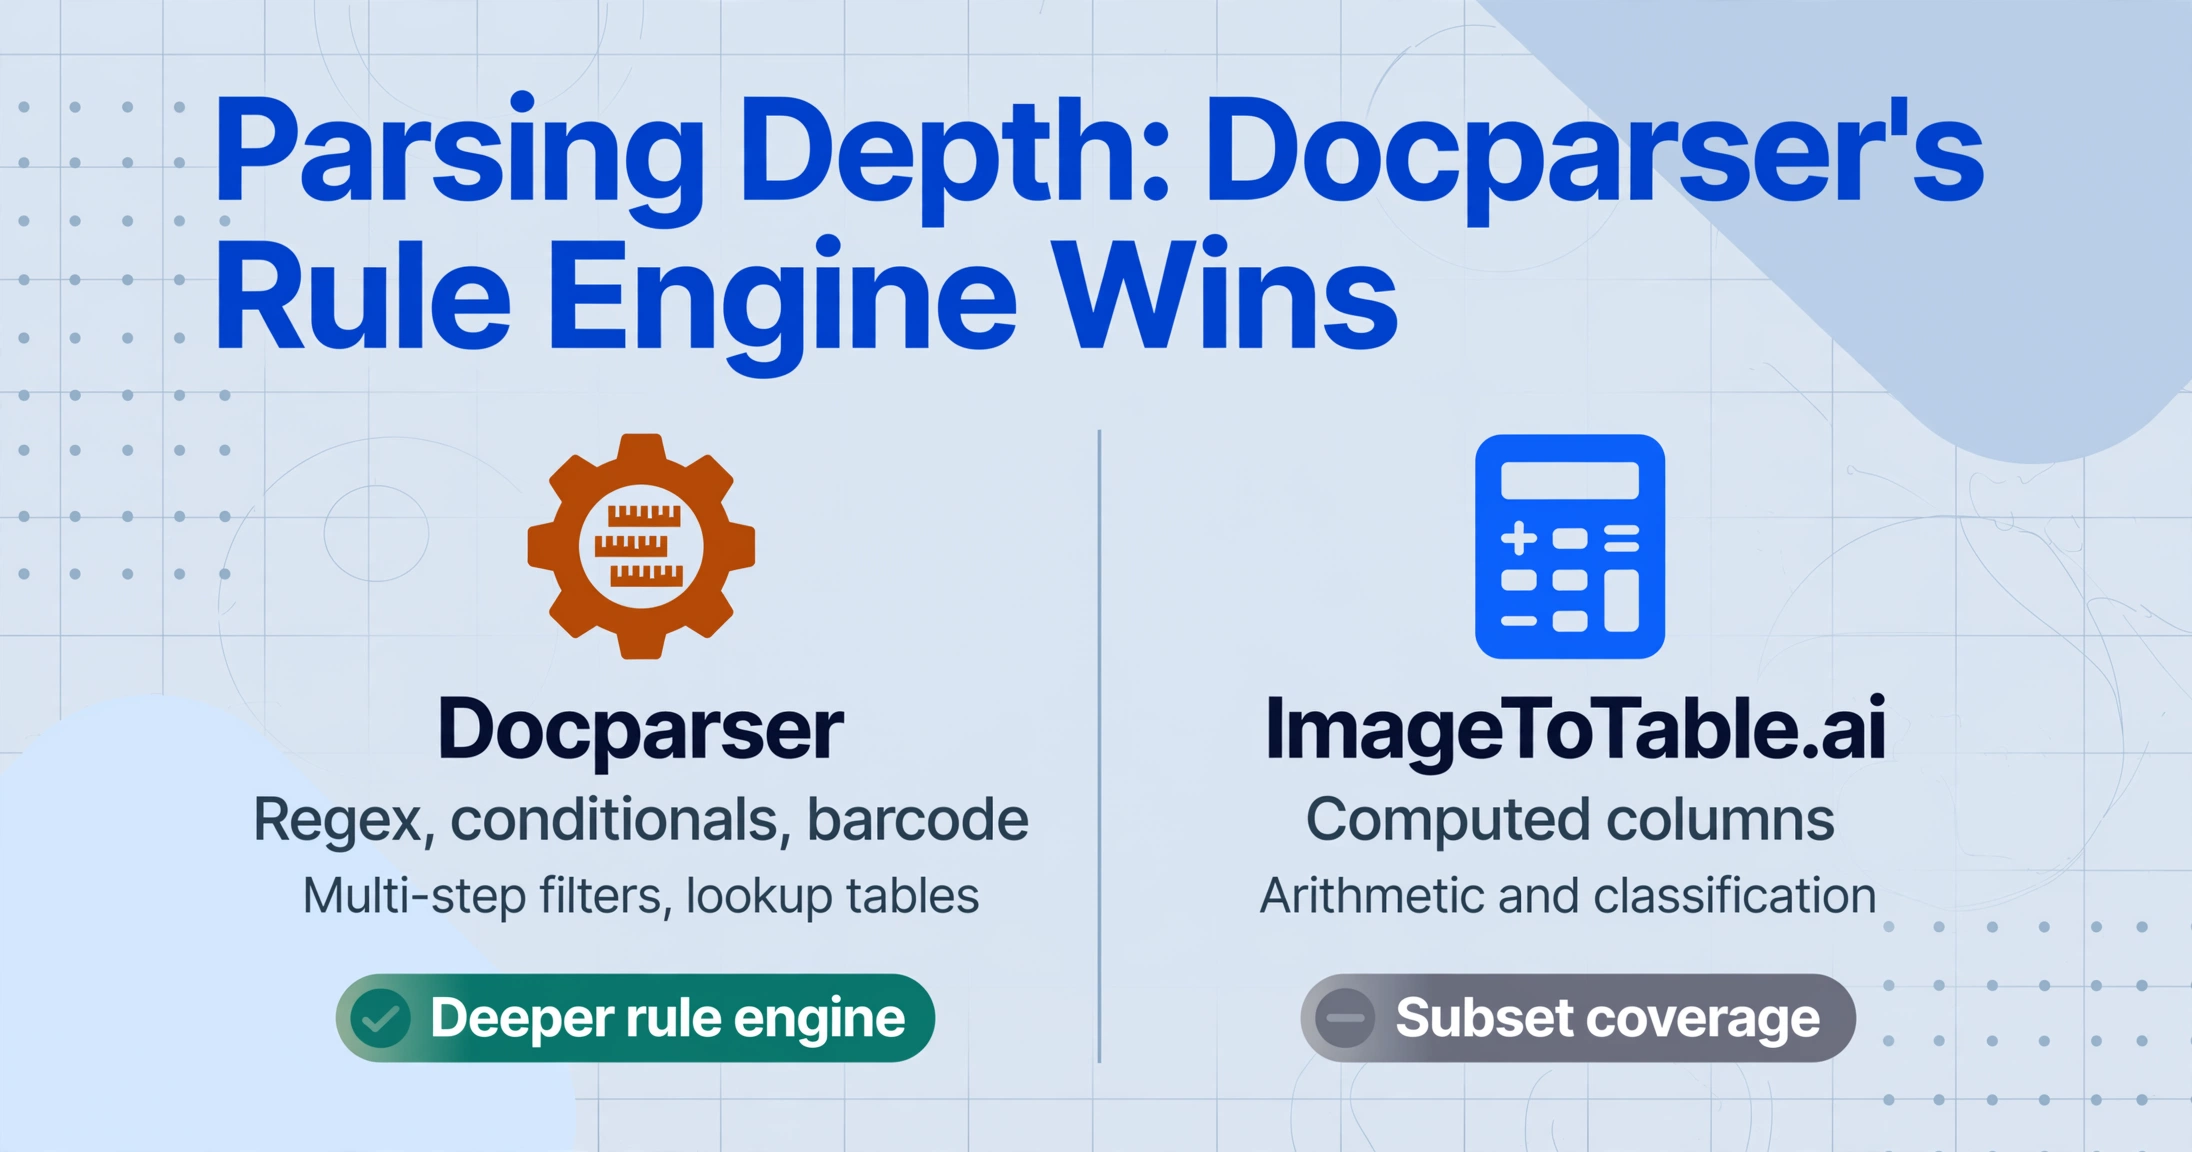
この点において、Docparserは確かに優れており、公正な比較を行うならば、これを明確に述べる必要があります。Docparserの解析ルールシステムはプラットフォームの中で最も成熟した部分であり、いくつかの重要な点でImageToTableの計算列よりもはるかに深い機能を提供します。
Docparserでは、フィールドレベルの正規表現パターンを定義して抽出値を正規化できます。例えば、電話番号から非数値文字を除去したり、日付をMM/DD/YYYYからYYYY-MM-DDに再フォーマットしたり、プレフィックス文字を含む「Vendor ID」フィールドから数字のみを抽出したりできます。条件付き抽出ルールも定義できます。「ドキュメントタイプがCredit Noteの場合、'Invoice Total'ではなく'Credit Amount'フィールドを抽出する」といった具合です。アンカーキーワードとオフセットベースの抽出を組み合わせることもできます。「ページ上の'Total:'というテキストを探し、その右側50ピクセル以内のすべてを抽出する」というように。他の抽出フィールドを参照する解析ルールの設定、ベンダー固有のコードを標準化された値に変換するルックアップテーブルの適用、複数のフィルターを順番にチェーンすることも可能です。バーコードとQRコードのスキャンもプラットフォームに組み込まれており、これはImageToTableがまったく提供していない機能です。
ImageToTableの計算列と推論列は、これらのユースケースの有意義なサブセットをカバーしています。「Line Total (Qty × Unit Price)」のような列を定義すれば、AIが抽出時に計算します。オプションリスト付きの推論列も定義できます。「Category (options: Meals/Transport/Office/Other)」といったもので、AIが各ドキュメントを自動的に分類します。しかし、ImageToTableは正規表現レベルのフィールド変換、条件付き抽出パス、多段階のチェーンルールをサポートしていません。抽出ワークフローに、算術演算や分類を超えた決定的なフィールド単位の変換が必要な場合、Docparserのルールエンジンが適切なツールです。
ただし、この強みには注意点があります。Docparserのルールの深さは、安定したレイアウトで動作するテンプレートを構築した後にのみ利用可能です。レイアウトが変更されると、ルールはゾーンとともに壊れます。誤った位置から抽出されているフィールドに対して、強力な正規表現や条件ロジックを使用することはできません。
連携機能:Docparserの自動化エコシステム
これはDocparserが明確に優位に立つ2つ目の側面です。同プラットフォームは、成熟した連携エコシステムの構築に長年投資しており、ImageToTableは現時点でその広がりに匹敵していません。
Docparserは、Zapier(6,000以上のアプリ)、Make、Microsoft Power Automate、Workatoにネイティブ接続します。カスタム連携のためのREST API、専用のDocparser受信トレイに転送された添付ファイルを自動的に解析するメールトリガー、そして手動アップロードなしでドキュメントをインポートできるGoogle ドライブ、Dropbox、Box、OneDrive向けの直接クラウドストレージコネクタを提供しています。解析されたデータは、これらのコネクタを通じてQuickBooks、Salesforce、Google スプレッドシート、MySQL、その他数百のアプリケーションに直接送信できます。抽出した請求書データを自動的にERPに流し込み、Slack通知をトリガーし、サマリーをGoogle スプレッドシートにプッシュしたいAPチームにとって、誰もブラウザに触れることなく実現できるDocparserの連携の深さは、真の競争優位性です。
ImageToTableの連携範囲は狭いものの、メール機能に関しては皆無ではありません。データはWebインターフェースからExcel、CSV、JSON、Wordに直接エクスポートできます。Google スプレッドシートのアドオンを使用すると、スプレッドシートから離れることなく、アクティブなスプレッドシートに直接データを抽出できます。Email Inboxは、Docparserの専用受信トレイと同じ転送・解析トリガーをカバーしています。各アカウントには専用のアドレスが付与され、Auto-Processをテンプレートにバインドすると、メールが届いた瞬間に抽出が開始されます。送信者ホワイトリストと、暗号化された添付ファイルに対する自動パスワード再試行機能も備えています。コレクションリンクは、外部の送信者が登録なしで使用できる共有アップロードエンドポイントを提供します。ImageToTableがDocparserに及ばないのは、データ抽出後の下流への到達範囲です。クラウドストレージのポーリング、ネイティブのZapier/Make/Salesforce/QuickBooksコネクタはなく、Docparserのより広範な自動化カタログの代わりにv1 API/Webhookの組み合わせを提供しています。
ワークフローがZapier接続によるERP/CRMシステムへの下流ルーティング、クラウドストレージのポーリング、または成熟したノーコードコネクタカタログに依存している場合、連携機能に関してはDocparserがより有力な選択肢です。無人でのメール受信自体が要件であれば、両ツールとも対応しています。Email Inboxはトリガー側を処理しますが、その後の宛先への展開範囲はDocparserほど広くありません。
料金:利用パターンに応じた異なるコストモデル
2つのツールの料金体系は、それぞれの設計思想を反映しています。どちらが安いかは、利用方法によってまったく異なります。
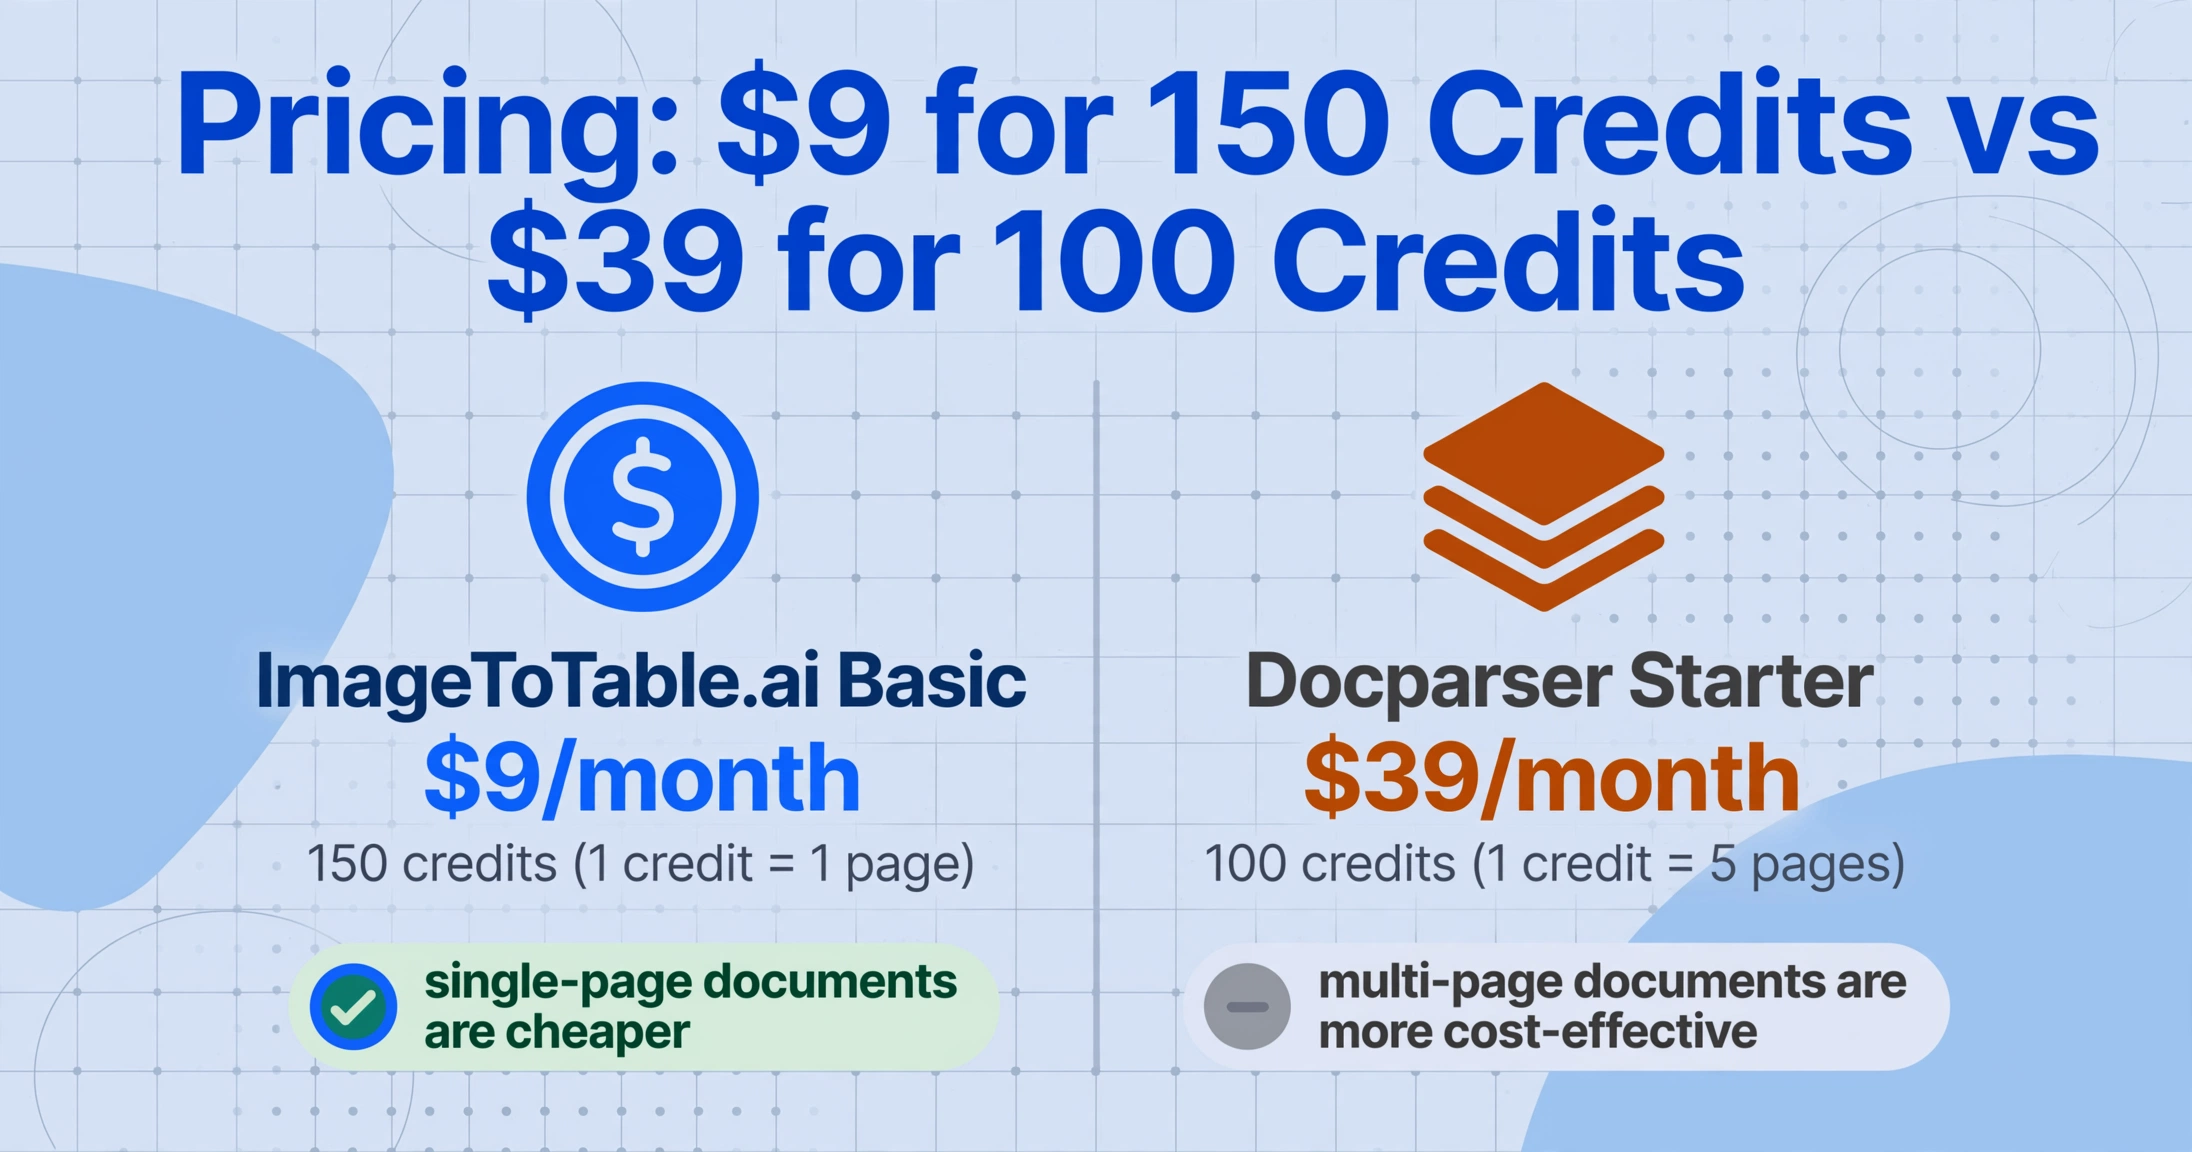
Docparserはドキュメント単位のクレジットモデルを採用しています。1クレジットは最大5ページのドキュメント1件分に相当します。Starterプランは月額39ドル(月払い)、または月額32.50ドル(年払い)で100クレジットを利用でき、ドキュメントの長さにもよりますが、実質的に月100〜500ページ分に相当します。Professionalプラン(月払い74ドル、年払い61.50ドル)では250クレジットを利用できます。Businessプラン(月払い159ドル、年払い133ドル)では、マルチレイアウトパーサーを含む1,000クレジットを利用できます。マルチレイアウトパーサー(月額29.95ドル)、パーサーのバージョン管理(月額9.95ドル)、ドキュメントの長期保存(月額19.95ドル)などの追加機能は、下位プランでは別途料金が発生します。
ImageToTableはクレジット単位のサブスクリプションモデルを採用しており、1クレジットは画像1枚またはPDF1ページ分に相当します。Basicプランは月額9ドルで150クレジットを利用できます。Proは月額29ドルで500クレジット、Maxは月額59ドルで1,500クレジットです。毎日の無料枠で、サブスクリプション前に実際のドキュメントをテストできます。また、サブスクリプション契約なしで利用できる単発のクレジットパックも用意されています。
単一ページのドキュメントのエントリーレベルでは、ImageToTableのBasicプランは9ドルで150クレジットを提供しており、39ドルで100クレジットのDocparserのStarterと比較して、1ドルあたりのボリュームは約4倍です。ただし、複数ページのドキュメントでは、Docparserのドキュメント単位モデルの方が大幅に安くなります。5ページの請求書1枚は、ImageToTableでは5クレジットを消費しますが、Docparserでは1クレジットのみです。ドキュメントの大部分が、既知の送信元からの3〜5ページのPDFである場合、Docparserのドキュメントあたりの実効コストは、ImageToTableのページ単位の料金よりも大幅に低くなる可能性があります。
さまざまな料金モデルがボリューム層ごとの月額請求額にどのように影響するかの詳細な解説については、2026年のドキュメント抽出料金の内訳をご覧ください。
文書の柔軟性:各ツールが実際に読み取れるもの
両ツールとも、標準的なビジネス文書タイプをカバーしています。しかし、クリーンなデジタルPDFを超えた文書を確実に処理できるかどうかは、両者で大きく異なります。
DocparserのゾーンOCRは、レイアウトが予測可能な文書向けに設計されています。デジタルPDFや高品質スキャンで、各フィールドが一貫した位置に表示される場合に最適なパフォーマンスを発揮します。同社のドキュメントには、最良の結果を得るには「受信文書は高品質でスキャンされ、一貫したレイアウトであること」と記載されています。プラットフォームにはOCR前処理オプションが追加され、不完全なスキャンの処理が改善され、DocparserAIはSmartAI Parserテンプレートによる手書き文字認識にも対応しています。しかし、根本的な制限は変わりません。ゾーンベースの抽出は、低DPI画像、傾いたスキャン、スマートフォン写真、スタンプやシールがデータフィールドに重なる文書では精度が低下します。ゾーン矩形が対象テキストを確実に囲めない場合、抽出品質は低下します。
ImageToTableは、まさにこのギャップを埋めるためにゼロから構築されました。ビジョンLLMは人間と同じように文書を読み取ります。つまり、視覚的なレイアウト全体を理解し、要求されたフィールドをピクセル位置ではなく意味的な意味で特定します。印刷された表、手書きのフォーム、レストランの領収書のスマートフォン写真、メールで送られた請求書のスクリーンショット、署名欄に会社スタンプが重なったスキャン契約書など、AIはエンジンを切り替えたり設定を調整したりすることなく、すべてを同じ抽出パイプラインで処理します。印刷された表データの場合、クリーンな文書では最大99%の精度に達します。手書き文字は実用的な精度レベルで認識され、個々の文字が完全に書き起こされなくてもデータ抽出には十分です。これはAIがフィールドの文脈を理解しているためです。「この手書きの数字は『合計』の隣にあり、『項目料金』の下にあるため、数字の曲がり方に関係なく合計金額である」と判断します。
DocparserのDocparserAIレイヤーは、手書き文字認識とチェックボックス検出をプラットフォームに追加しました。しかし、これらの機能は、フィールドが予測可能な位置にあることを前提としたゾーンベースのアーキテクチャ上で動作します。手書きフィールドが文書ごとに異なる位置に表示される場合、ゾーンが固定座標でデータを期待しているため、AIの強化では補えません。ImageToTableにはそのような制約はありません。AIはフィールドが「どこにあるか」ではなく「何であるか」でフィールドを見つけます。
ImageToTableが適しているケース
ImageToTableは、ドキュメント環境が反復ではなく多様性によって特徴づけられる場合に、より良い選択肢となります。異なるレイアウトを使用する複数のベンダーからドキュメントを受け取り、そのレイアウトが変更される場合、テンプレート不要のアプローチにより、テンプレートベースのツールに必要なメンテナンスの負担がなくなります。出力を一度定義するだけで(必要な列名)、AIが入力レイアウトのあらゆるバリエーションを自動的に処理します。新しいベンダー形式、サプライヤーの再設計、クライアントのカスタムフォームも、セットアップ時間ゼロで最初のアップロード時に正しく処理されます。これがセマンティックドキュメントパーサーとテンプレート駆動型パーサーの実際的な違いです。
ドキュメントがデジタルPDFではなく、スマートフォンでの撮影、スキャンコピー、手書きで届く場合、ImageToTableのビジョンLLMは、ゾーンベースのツールで発生する品質低下なしにそれらを読み取ります。現場の写真を撮る請負業者、手書きの経費報告書を提出する従業員、スマートフォンでメーターの測定値を記録する現場検査員 — これらはImageToTableにとってエッジケースではありません。これらは、このツールが設計された主なユースケースです。
混合形式のドキュメントをまとめてバッチ処理する場合 — 20社のベンダーからの請求書を1つのバッチでアップロードし、結果を単一の整列されたスプレッドシートにマージする必要がある場合 — ImageToTableのバッチファースト処理アーキテクチャは、これを1ステップで実現します。Docparserはメールボックス内で各ドキュメントを個別に処理するため、複数ベンダーの抽出結果を統合テーブルにマージするには、Zapierの自動化または手動での組み立てが必要です。
予算が限られており、ドキュメントのほとんどが単一ページ(領収書、請求書、発注書)の場合、ImageToTableのBasicプランは月額$9で150ページを提供し、Docparserのエントリーティアよりも1ドルあたりの価値が大幅に高くなります。
Docparserが適しているケース
Docparserは、抽出要件がフィールド位置の特定を超えて決定的なデータ変換に及ぶ場合に、より適した選択肢です。正規表現による正規化、条件付き抽出パス、多段階フィルター、バーコードスキャン、複数フィールドにまたがる計算ルールが必要な場合、Docparserの解析ルールエンジンはImageToTableの計算列よりも強力です。ImageToTableは算術演算と分類を得意としますが、複雑なフィールド単位の変換におけるDocparserのルールの深さには及びません。
ワークフローが自動化された統合に依存している場合(メール転送でドキュメントが届く→自動解析→Zapier経由でQuickBooksにデータをプッシュ→Slack通知が送信される)、Docparserの統合エコシステムははるかに成熟しています。ImageToTableのEmail Inboxも同じ転送・解析トリガーをカバーしていますが(Auto-Processにより完全に手間のかからない運用が可能)、Docparserのより広範なコネクタカタログ(ネイティブのZapier、Make、Power Automate、そしてQuickBooksやSlackに直接連携するSalesforceアクション)は、ImageToTableのv1 APIとWebhookだけではカスタムのグルーコードなしに到達できない範囲を超えています。自動化プラットフォームに投資しており、抽出ツールが独自のインターフェースを提供するのではなく、それらのワークフローに接続されることを必要とするチームにとって、Docparserのコネクタの深さは真の利点です。
処理するすべてのドキュメントが、安定した既知の送信元からのマルチページPDFである場合(たとえば、フォーマットが何年も変わっていない5社のサプライヤーから毎月200件の請求書を処理する場合)、Docparserのクレジットモデル(5ページまでのドキュメント1件につき1クレジット)は、ImageToTableのページ単位の価格設定よりも経済的であり、テンプレート設定コストは一度きりの投資で、一貫した処理を通じて回収できます。
抽出パイプラインにバーコードまたはQRコードスキャンが組み込まれている必要がある場合、Docparserはこれをネイティブに備えています。ImageToTableは抽出中にバーコードやQRコードを読み取ることができません。その機能は現在製品に含まれていません。
率直な結論:Docparserは、処理要件がルールに深く依存し、フォーマットが安定している場合に優れています。ImageToTableは、ドキュメント環境のフォーマットが多様で、ソースが多岐にわたり、レイアウトが変化する場合に優れています。どちらのアーキテクチャも普遍的に優れているわけではありません。適切なツールは、実際に扱う変動の種類によって決まります。
結論:場面に応じた選択であり、単純な二択ではない
セットアップ時間、フォーマット耐性、解析の粒度、連携機能、価格、ドキュメントの柔軟性の両方を比較した結果、その判断基準は、多くの比較記事が示すよりも明確です。
Docparserは、安定したレイアウトからの決定的な抽出に適しています。そのゾーンOCRエンジンとルールシステムは、一貫したドキュメント形式を持つチームに、正確で再現性のあるフィールドレベルの抽出を提供します。コストはレイアウトごとのセットアップとメンテナンスです。利点は制御性です。正規表現の正規化、条件ロジック、バーコードスキャン、そして既存のツールに接続する成熟した自動化パイプラインを備えています。ドキュメントがレイアウトの変わらない既知の送信元の固定セットから来る場合、Docparserの深さと連携範囲は実用的な選択肢となります。
ImageToTableは、多様なソースからの意味的抽出に適しています。そのビジョンLLMはレイアウトごとの設定を完全に不要にし、あらゆる形式、あらゆる入力品質、あらゆるドキュメントタイプの組み合わせを単一のバッチで処理します。コストはフィールドレベルの変換における細かい制御が少ないことです。利点は耐性です。フォーマットの変更、新しいベンダー、スマホ写真、手書き、混合バッチがすべてテンプレートメンテナンスなしで機能します。ドキュメントが異なるレイアウトの複数のソースから届く場合、または入力品質がばらつく場合(スキャン、写真、手書き)、ImageToTableはDocparserのより深いルールセットが補える以上の継続的な作業を削減します。
固定フォーマットの請求書がZapier経由でQuickBooksに流れるメール駆動のAP自動化パイプラインを構築している場合、Docparserの方が適しています。その自動化レイヤーとルールの深さがそのワークフローに合致します。現場スタッフからドキュメントを収集し、混合フォーマットの注文書を処理し、スマホ写真やスキャン済みフォームからデータをバッチ抽出する場合、ImageToTableのテンプレート不要のアプローチは、テンプレートベースのツールが多様な入力ワークフローに課すメンテナンスコストを回避します。どちらのツールも万能ではありません。しかし、ドキュメントエコシステムが実際にどのようなものか(フォーマットの数、変更頻度、入力品質)を把握していれば、正しい選択は明確になります。
両ツールを他の抽出ツールと比較したより広い視点については、ImageToTable vs Parseurをご覧ください。
簡潔なバージョンが必要ですか?機能比較表をご覧いただくか、すべてのImageToTable比較を参照してください。
FAQ
Docparserはテンプレートを必要としますか、それともDocparserAIはテンプレートなしで動作しますか?
Docparserの主要な抽出パスはテンプレートベースです。サンプルドキュメント上にゾーンOCRの矩形を描画してパーサーを作成します。DocparserAIはAI支援機能(ルールを自動生成するSmartAI Parserテンプレート、手書き文字認識、コンテンツ要約)を追加しますが、これらは同じドキュメントタイプ別アーキテクチャ内で動作します。SmartAI Parserはサンプルドキュメントからルールを自動生成することで手動設定時間を削減しますが、それでもドキュメントタイプ内での一貫したレイアウトを前提としています。ImageToTableはセマンティックAIのみを使用します。テンプレートなし、ゾーン描画なし、レイアウト別設定なしで、すべての抽出パスで動作します。
ImageToTableはDocparserのようにZapierやWebhookと連携できますか?
はい、公開v1 APIを通じて可能です。ImageToTableのREST APIでは、ドキュメントのアップロード、処理のトリガー、バッチまたはドキュメント完了時に自動的に発火するWebhookの登録が可能です。ポーリングは不要です。ZapierとMakeはこのAPIを通じて接続できますが、ImageToTableにはDocparserのような事前構築されたアプリストアコネクタやネイティブなSalesforce/ERP統合はありません。ImageToTableはExcel、CSV、JSON、Wordへの直接エクスポートに加え、抽出データをアクティブなスプレッドシートに直接書き込むGoogle スプレッドシートアドオンも提供しています。DocparserのワンクリックZapierアプリやネイティブなQuickBooks/Salesforceコネクタが必要な場合、その特定のケースではDocparserの統合エコシステムの方が成熟しています。
マルチページドキュメントではどちらのツールがより手頃ですか?
ドキュメントの長さによります。Docparserは5ページまでのドキュメント1件につき1クレジットを消費します。つまり、5ページの請求書は1クレジットを消費します。ImageToTableは1ページにつき1クレジットを消費します。同じ5ページの請求書は5クレジットを消費します。ドキュメントが一貫して3〜5ページの場合、Docparserのクレジットモデルはドキュメント1件あたりのコストが大幅に低くなる可能性があります。単一ページのドキュメント(レシート、ほとんどの請求書)の場合、ImageToTableの価格はクレジットあたりのコストが低くなります。総コストは、主に単一ページまたはマルチページのどちらのドキュメントを処理するかによって異なります。ボリューム別の比較については、ドキュメント抽出価格内訳2026を参照してください。
DocparserはImageToTableのようにバッチ処理に対応していますか?
Docparserはメールボックス内の文書を処理します。複数の文書を一度にアップロードしたり、クラウドストレージやメールからの自動インポートを設定したりできます。ただし、各文書は個別に解析され、複数の文書(特に異なるパーサーを使用した場合)の結果を1つの整列されたスプレッドシートに統合するには、Zapier/API経由の外部作業または手動エクスポートが必要です。ImageToTableはバッチファーストで設計されています。任意のソースからファイルをアップロードし、列名を一度定義するだけで、全文書で一貫したヘッダーを持つ1つの結合Excelファイルをダウンロードできます。混合形式のバッチを定期的に処理するチームにとって、これは重要なワークフローの違いです。
DocparserはImageToTableと同様に手書き文字を処理できますか?
DocparserAIはSmartAI Parserテンプレートを通じて手書き文字認識機能を導入しています。文書から手書き文字を抽出できます。ただし、基盤となるゾーン型アーキテクチャのため、正確な抽出には手書き文字がページ上の予測可能な位置に表示される必要があります。ImageToTableのビジョンLLMは、コンテキストを理解することでページ上のどこにある手書きフィールドでも見つけ出します。手書き文字が事前定義されたゾーンにある必要はありません。手書き文字が可変位置に現れる文書(現場検査フォーム、現場ワークシート、異なる担当者が記入した納品書など)では、ImageToTableのアプローチの方が信頼性が高くなります。
DocparserからImageToTableに切り替えられますか?
はい。移行にテンプレートのインポートは不要です。ImageToTableはテンプレートを使用しないためです。Docparserの過去のデータをCSVまたはExcelとしてエクスポートします。同じソース文書をImageToTableにアップロードし、Docparserのフィールド定義に対応する列名を入力すると、AIがテンプレート設定なしで抽出します。Docparserで使用していた列名(請求書番号、仕入先名、日付、合計)がそのままImageToTableの列名になります。過去のデータと新しい抽出結果をスプレッドシートで統合します。一貫したヘッダー名により、移行は簡単です。