ImageToTable vs Docparser:
Campos Flexíveis ou Modelos Fixos? Uma Comparação Honesta para 2026
Escolher entre ImageToTable e Docparser se resume a uma única questão arquitetural: você quer uma ferramenta que corresponda a zonas predefinidas em layouts fixos — ou uma que leia documentos entendendo o que os campos significam? A resposta determina não apenas a rapidez com que você começa, mas quanto tempo você gasta mantendo o pipeline seis meses depois. Ambas as ferramentas extraem dados estruturados de documentos. Mas elas abordam a extração a partir de arquiteturas fundamentalmente diferentes, e a arquitetura que funciona para uma equipe com três modelos de fatura estáveis vai frustrar uma equipe que lida com documentos de quarenta fornecedores que atualizam seus layouts conforme seus próprios cronogramas.
Principais Conclusões
- A maioria dos artigos de comparação compara o tempo de configuração — o custo real é a esteira de manutenção silenciosa que começa quando o primeiro fornecedor muda o layout da fatura três meses depois.
- O Docparser honestamente vence em duas dimensões: seu mecanismo de regex e regras de análise condicional vão mais fundo que as colunas calculadas do ImageToTable, e seu ecossistema de integrações de nível Zapier não tem equivalente no lado do ImageToTable.
- Escolha pelo que seus documentos realmente parecem — PDFs estáveis de várias páginas de remetentes conhecidos favorecem o Docparser, enquanto variedade de layouts, fotos de celular, manuscritos e lotes de fontes mistas favorecem o ImageToTable.
Comparação Rápida
Antes de analisarmos cada dimensão, aqui está um panorama de como as duas ferramentas se comparam nos fatores que mais importam em uma decisão de extração de documentos.
| Dimensão | Docparser | ImageToTable.ai |
|---|---|---|
| Modelo de extração | OCR zonal com regras de análise personalizadas — desenhe zonas em um modelo, defina âncoras e filtros regex por campo | LLM de visão — lê a semântica do documento diretamente; sem modelos, sem zonas, sem configuração por layout |
| Tempo de configuração | 30–60 min por modelo por layout; analisadores multi-layout disponíveis como complemento de $29.95/mês ou no plano Business | Menos de 1 minuto — digite os nomes das colunas, faça o upload, os resultados aparecem |
| Tratamento de mudanças de formato | Os modelos quebram quando os layouts mudam; exigem ajuste manual das zonas e novos testes | Automático — a extração semântica se adapta a qualquer mudança de layout instantaneamente |
| Profundidade das regras de análise | Poderoso — regex, lógica condicional, cálculos, palavras-chave de âncora, leitura de código de barras/QR, filtros de várias etapas | Colunas calculadas e colunas inferidas para cálculos e classificações mais simples |
| Integrações | Zapier, Make, Power Automate, Workato nativos, API REST, gatilhos por e-mail, conectores de armazenamento em nuvem, QuickBooks, Salesforce | Exportação para Excel/CSV/JSON/Word; complemento do Google Sheets; Link de Coleta; Caixa de Entrada de E-mail com Processamento Automático; API REST pública com webhooks — sem conector Zapier na loja de aplicativos |
| Documentos de várias páginas | 1 crédito = 1 documento de até 5 páginas; limite de 30 páginas por documento (máx. 50); limite de 20 MB por arquivo | 1 crédito = 1 página ou imagem; sem limite de páginas por documento; processa PDFs grandes página por página |
| Flexibilidade de documentos | Melhor em PDFs digitais limpos e consistentes; piora em digitalizações de baixa resolução, fotos de celular, manuscritos, carimbos | Lê qualquer entrada visual — fotos de celular, digitalizações, capturas de tela, manuscritos, carimbos, mistos de impresso e manuscrito |
| Preço inicial | $39/mês (mensal) / $32.50/mês (anual) — 100 créditos (100 documentos, até 5 páginas cada) | $9/mês — 150 créditos (150 páginas ou imagens); plano gratuito disponível sem cadastro |
A tabela deixa os trade-offs visíveis. Mas a decisão real depende de qual dessas dimensões importa mais no seu ecossistema de documentos. Vamos analisar cada uma.
Configuração: Zonas, Âncoras e Regras vs. Nomes de Colunas
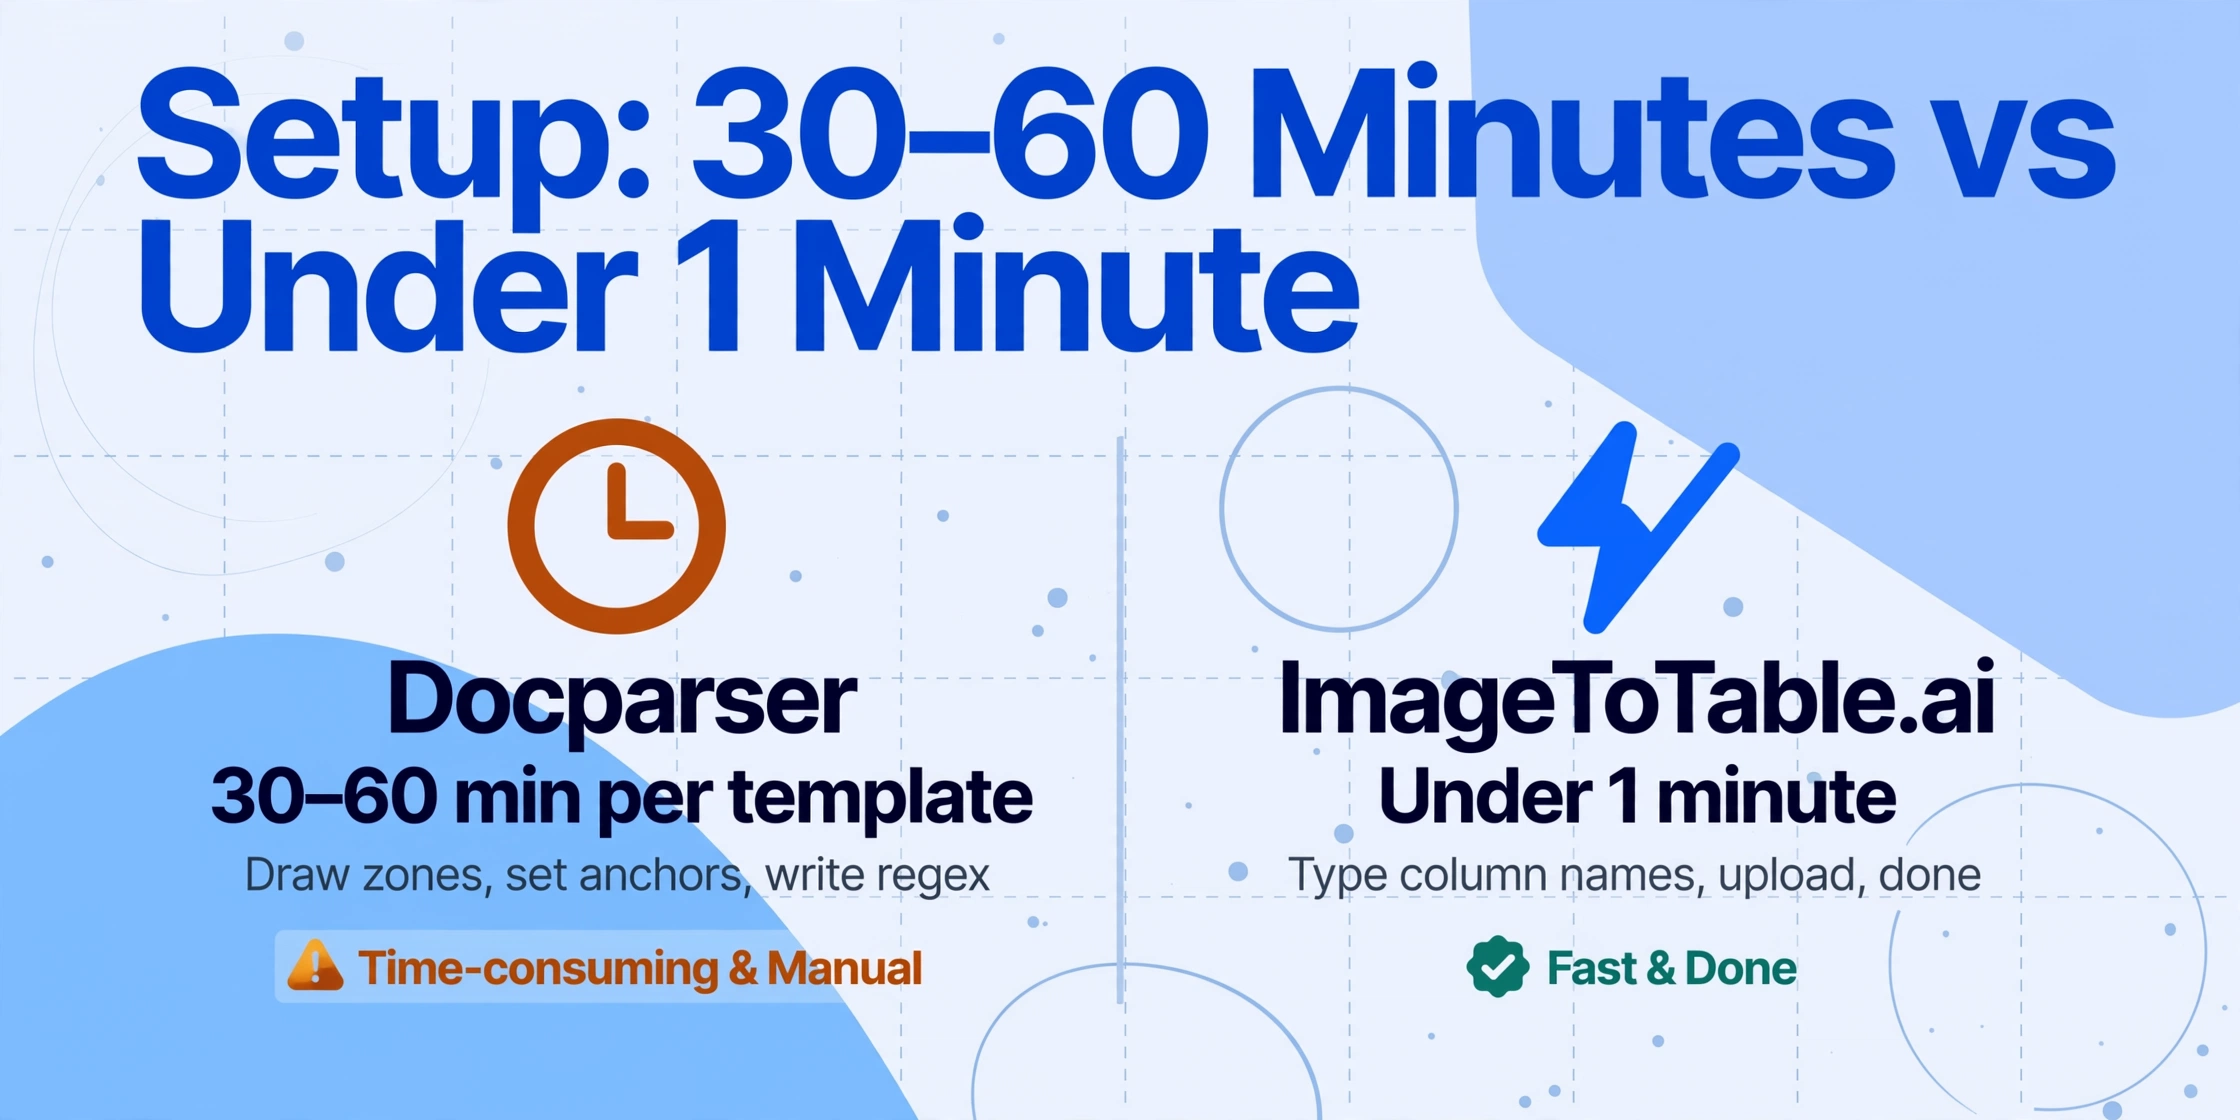
A diferença mais óbvia entre as duas ferramentas aparece na primeira hora. O processo de configuração do Docparser é uma sequência de etapas deliberadas: você envia um documento de amostra, define zonas de extração desenhando retângulos ao redor de cada campo na página, configura palavras-chave de âncora para ajudar o parser a localizar campos que podem se deslocar, define filtros regex para normalizar os valores extraídos e testa o modelo com uma segunda amostra antes de confiar nele em documentos reais. Para uma fatura de layout único de um fornecedor, esse processo normalmente leva de 30 a 60 minutos.
Se você processa documentos de cinco fornecedores com formatos consistentes, isso representa de 2,5 a 5 horas de criação de modelos antecipada. Se você precisa de parsers multi-layout (um parser que lida com várias variantes de formato), esse recurso custa $29.95 adicionais por mês nos planos Starter e Professional, ou você pode fazer upgrade para o plano Business ($159/mês), onde ele está incluído. O Docparser também oferece um serviço pago de Parsing Assistant por $149 por layout, no qual a equipe deles cria o modelo para você — um reconhecimento honesto de que a criação de modelos dá trabalho de verdade.
O ImageToTable inverte toda a equação de configuração. Você não desenha zonas, define âncoras, escreve regex nem configura nenhum modelo por layout. Você digita os nomes das colunas que deseja — "Invoice Number", "Vendor Name", "Date", "Total" — e envia seus documentos. O LLM de visão localiza cada valor entendendo o que o campo significa, não onde ele fica na página. A primeira extração é concluída em 5–10 segundos. Não existe "fase de configuração" antes de você obter resultados — você avalia a ferramenta nos seus documentos reais desde o primeiro envio. Para usuários recorrentes, as listas de colunas podem ser salvas como presets, então a mesma definição de extração é executada em todos os lotes futuros sem reinserir os nomes dos campos.
A diferença de custo de configuração não se trata de uma ferramenta ser mais fácil de aprender. Trata-se de a ferramenta exigir configuração por layout antes de conseguir extrair dados de um novo tipo de documento. O Docparser exige. O ImageToTable não.
Mudanças de Formato: Quando o Modelo Quebra
Esta é a dimensão que separa com mais honestidade as duas ferramentas — e também é a que a maioria dos artigos comparativos subestima. A extração baseada em modelo funciona perfeitamente no modelo para o qual foi criada. O problema é que documentos do mundo real não permanecem em seus modelos.
Fornecedores atualizam layouts de faturas quando trocam de software contábil, se fundem com outra empresa ou redesenham sua marca. Um fornecedor move o campo "Total Due" do canto inferior direito para o canto inferior esquerdo — o retângulo de zona que você desenhou agora aponta para espaço vazio ou, pior, para um valor diferente. Outro fornecedor renomeia "Invoice #" para "Reference" — a palavra-chave âncora em que você confiava não existe mais. Cada mudança é invisível para você até que o próximo lote de documentos chegue com erros de extração que alguém precisa identificar, diagnosticar e corrigir.
A tecnologia Zonal OCR do Docparser é determinística e precisa em layouts conhecidos — essa é sua força. Mas quando um layout muda, cada zona definida naquele modelo se torna não confiável. A correção exige abrir o editor de modelo, realçar novamente os campos deslocados, ajustar quaisquer filtros regex afetados e testar de novo. Se você está em um plano sem parsers de múltiplos layouts, uma variante de formato de um fornecedor conhecido pode exigir um modelo totalmente novo. A própria documentação do Docparser reconhece que o Zonal OCR "não consegue lidar" com campos de dados compostos, campos de dados repetidos, dados de tabela e "campos de dados com posições variáveis (por exemplo, totais de faturas)" — precisamente os cenários que ocorrem quando os layouts mudam.
O LLM de visão do ImageToTable lê documentos de forma holística. Ele não se importa onde um campo fica na página, como é rotulado ou se as coordenadas de pixel mudaram desde o último lote. "Total Due" no canto inferior direito e "Total Due" no canto inferior esquerdo são o mesmo conceito semântico — a IA o encontra independentemente. Um fornecedor renomeia um campo — a IA resolve a relação semântica entre o que você pediu e o que o documento diz. Um novo fornecedor envia um documento em um formato que a ferramenta nunca viu — ela o processa corretamente no primeiro upload porque não há zonas a configurar. Este é o significado prático de extração de documentos sem treinamento.
O Docparser vence em precisão determinística para layouts estáveis. O ImageToTable vence em resiliência — ele nunca quebra quando um formato muda porque nunca foi configurado para um formato específico em primeiro lugar. A diferença entre eles aumenta com o tempo, à medida que os layouts mudam e novos formatos de fornecedores aparecem.
Granularidade de Análise: Quando o Mecanismo de Regras do Docparser Vence
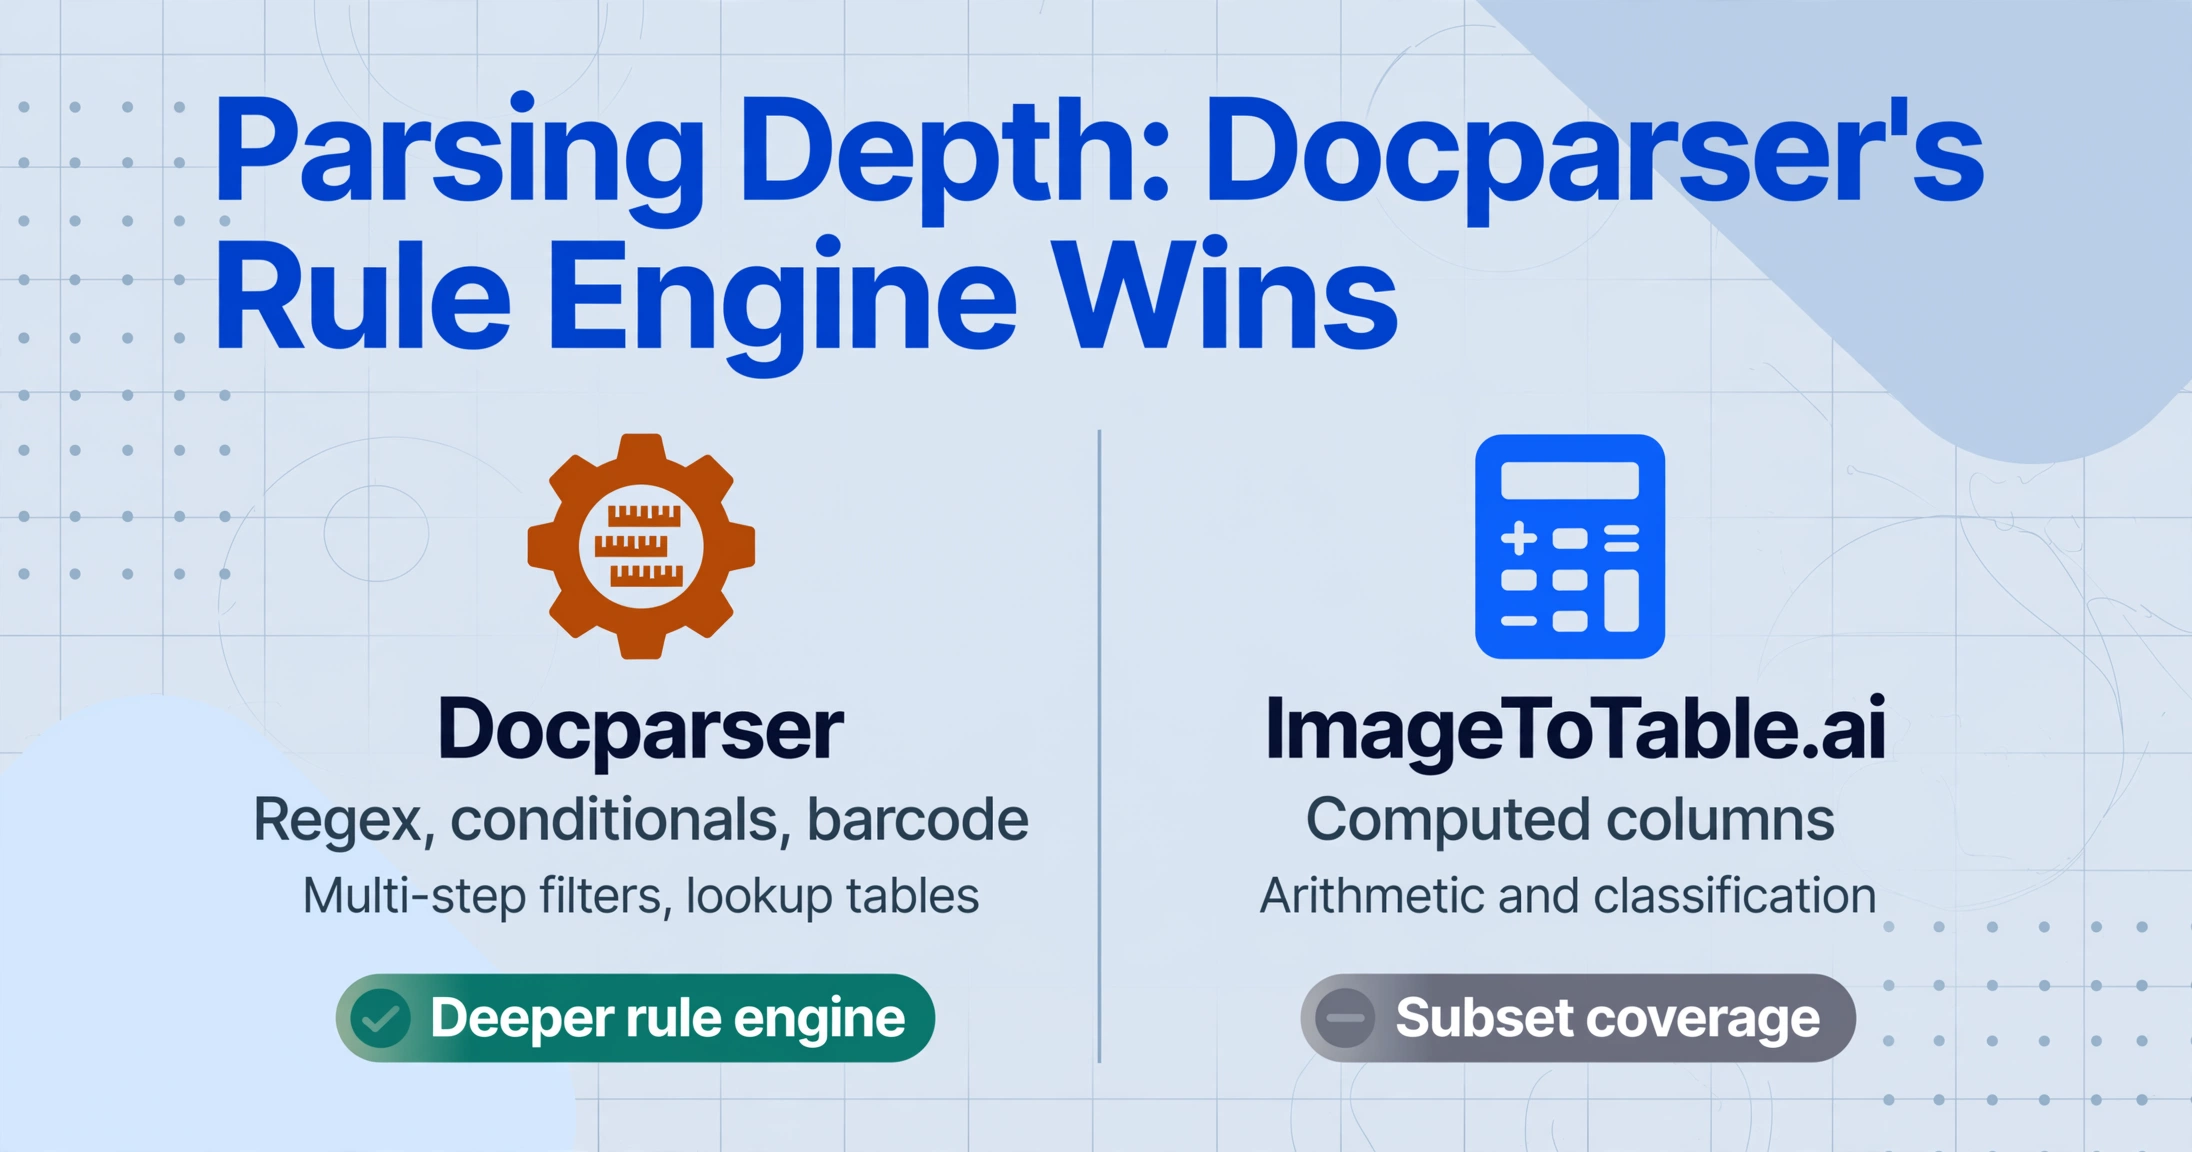
Esta é a dimensão em que o Docparser é genuinamente superior, e uma comparação honesta deve afirmar isso diretamente. O sistema de regras de análise do Docparser é a parte mais madura da plataforma e vai significativamente mais fundo do que as colunas calculadas do ImageToTable em vários aspectos importantes.
O Docparser permite definir padrões regex em nível de campo para normalizar valores extraídos — por exemplo, remover caracteres não numéricos de números de telefone, reformatar datas de MM/DD/YYYY para YYYY-MM-DD ou extrair apenas os dígitos de um campo "Vendor ID" que inclui texto de prefixo. Você pode definir regras de extração condicional: "Se o tipo de documento for Credit Note, extraia o campo 'Credit Amount' em vez de 'Invoice Total'." Você pode combinar palavras-chave âncora com extração baseada em deslocamento — "encontre o texto 'Total:' na página e extraia tudo dentro de 50 pixels à sua direita." Você pode configurar regras de análise que fazem referência a outros campos extraídos, aplicar tabelas de consulta para traduzir códigos específicos de fornecedores em valores padronizados e encadear vários filtros em sequência. A leitura de código de barras e QR code também é integrada à plataforma, uma capacidade que o ImageToTable não oferece de forma alguma.
As colunas calculadas e colunas inferidas do ImageToTable cobrem um subconjunto relevante desses casos de uso. Você pode definir uma coluna como "Line Total (Qty × Unit Price)" e a IA a calcula durante a extração. Você pode definir colunas inferidas com listas de opções — "Category (options: Meals/Transport/Office/Other)" — e a IA classifica cada documento automaticamente. Mas o ImageToTable não oferece suporte a transformação de campos em nível de regex, caminhos de extração condicional ou regras encadeadas em várias etapas. Se o seu fluxo de extração exige transformações determinísticas campo a campo que vão além de aritmética e classificação, o mecanismo de regras do Docparser é a ferramenta certa.
No entanto, esse ponto forte vem com uma ressalva: a profundidade de regras do Docparser só está disponível depois que você construiu um modelo funcional em um layout estável. Se o layout mudar, as regras quebram junto com as zonas — você não pode usar regex poderosas e lógica condicional em campos que estão sendo extraídos do local errado.
Integrações: o ecossistema de automação do Docparser
Esta é a segunda dimensão em que o Docparser claramente vence. A plataforma investiu anos construindo um ecossistema de integrações maduro que o ImageToTable atualmente não iguala em amplitude.
O Docparser se conecta nativamente ao Zapier (mais de 6.000 apps), Make, Microsoft Power Automate e Workato. Oferece uma API REST para integrações personalizadas, gatilhos de e-mail que analisam automaticamente anexos recebidos quando encaminhados para uma caixa de entrada dedicada do Docparser, e conectores diretos de armazenamento em nuvem para Google Drive, Dropbox, Box e OneDrive que permitem importar documentos sem upload manual. Os dados extraídos podem ser enviados diretamente ao QuickBooks, Salesforce, Google Sheets, MySQL e centenas de outros aplicativos através desses conectores. Para uma equipe de contas a pagar que quer que os dados de faturas extraídos fluam automaticamente para o ERP, disparem uma notificação no Slack e enviem um resumo ao Google Sheets — tudo sem que ninguém toque em um navegador — a profundidade de integração do Docparser é uma vantagem competitiva genuína.
A superfície de integração do ImageToTable é mais estreita, mas não ausente no quesito e-mail. Os dados podem ser exportados diretamente para Excel, CSV, JSON ou Word pela interface web. O complemento do Google Sheets permite extrair dados diretamente na planilha ativa sem sair do Sheets. O Email Inbox cobre o mesmo gatilho de encaminhar e analisar da caixa de entrada dedicada do Docparser — cada conta recebe seu próprio endereço, e vincular o Auto-Process a um modelo inicia a extração no momento em que o e-mail chega, com uma lista de remetentes permitidos e nova tentativa automática de senha para anexos criptografados. O Link de Coleta fornece um endpoint de upload compartilhável que remetentes externos podem usar sem cadastro. O que o ImageToTable não iguala é o alcance downstream do Docparser depois que os dados são extraídos — sem polling de armazenamento em nuvem, sem conectores nativos de Zapier/Make/Salesforce/QuickBooks, e um par de API/webhook v1 em vez do catálogo de automação mais amplo do Docparser.
Se o seu fluxo de trabalho depende de roteamento downstream conectado ao Zapier para sistemas ERP/CRM, polling de armazenamento em nuvem ou um catálogo maduro de conectores no-code, o Docparser é a escolha mais forte em integrações. Se a entrada de e-mail não assistida em si é o requisito, ambas as ferramentas cobrem isso — o Email Inbox cuida do lado do gatilho, mesmo que depois não se ramifique para a mesma amplitude de destinos.
Preços: Modelos de Custo Diferentes para Padrões de Uso Diferentes
As estruturas de preços das duas ferramentas refletem suas filosofias de arquitetura — e qual delas é mais barata depende inteiramente de como você a usa.
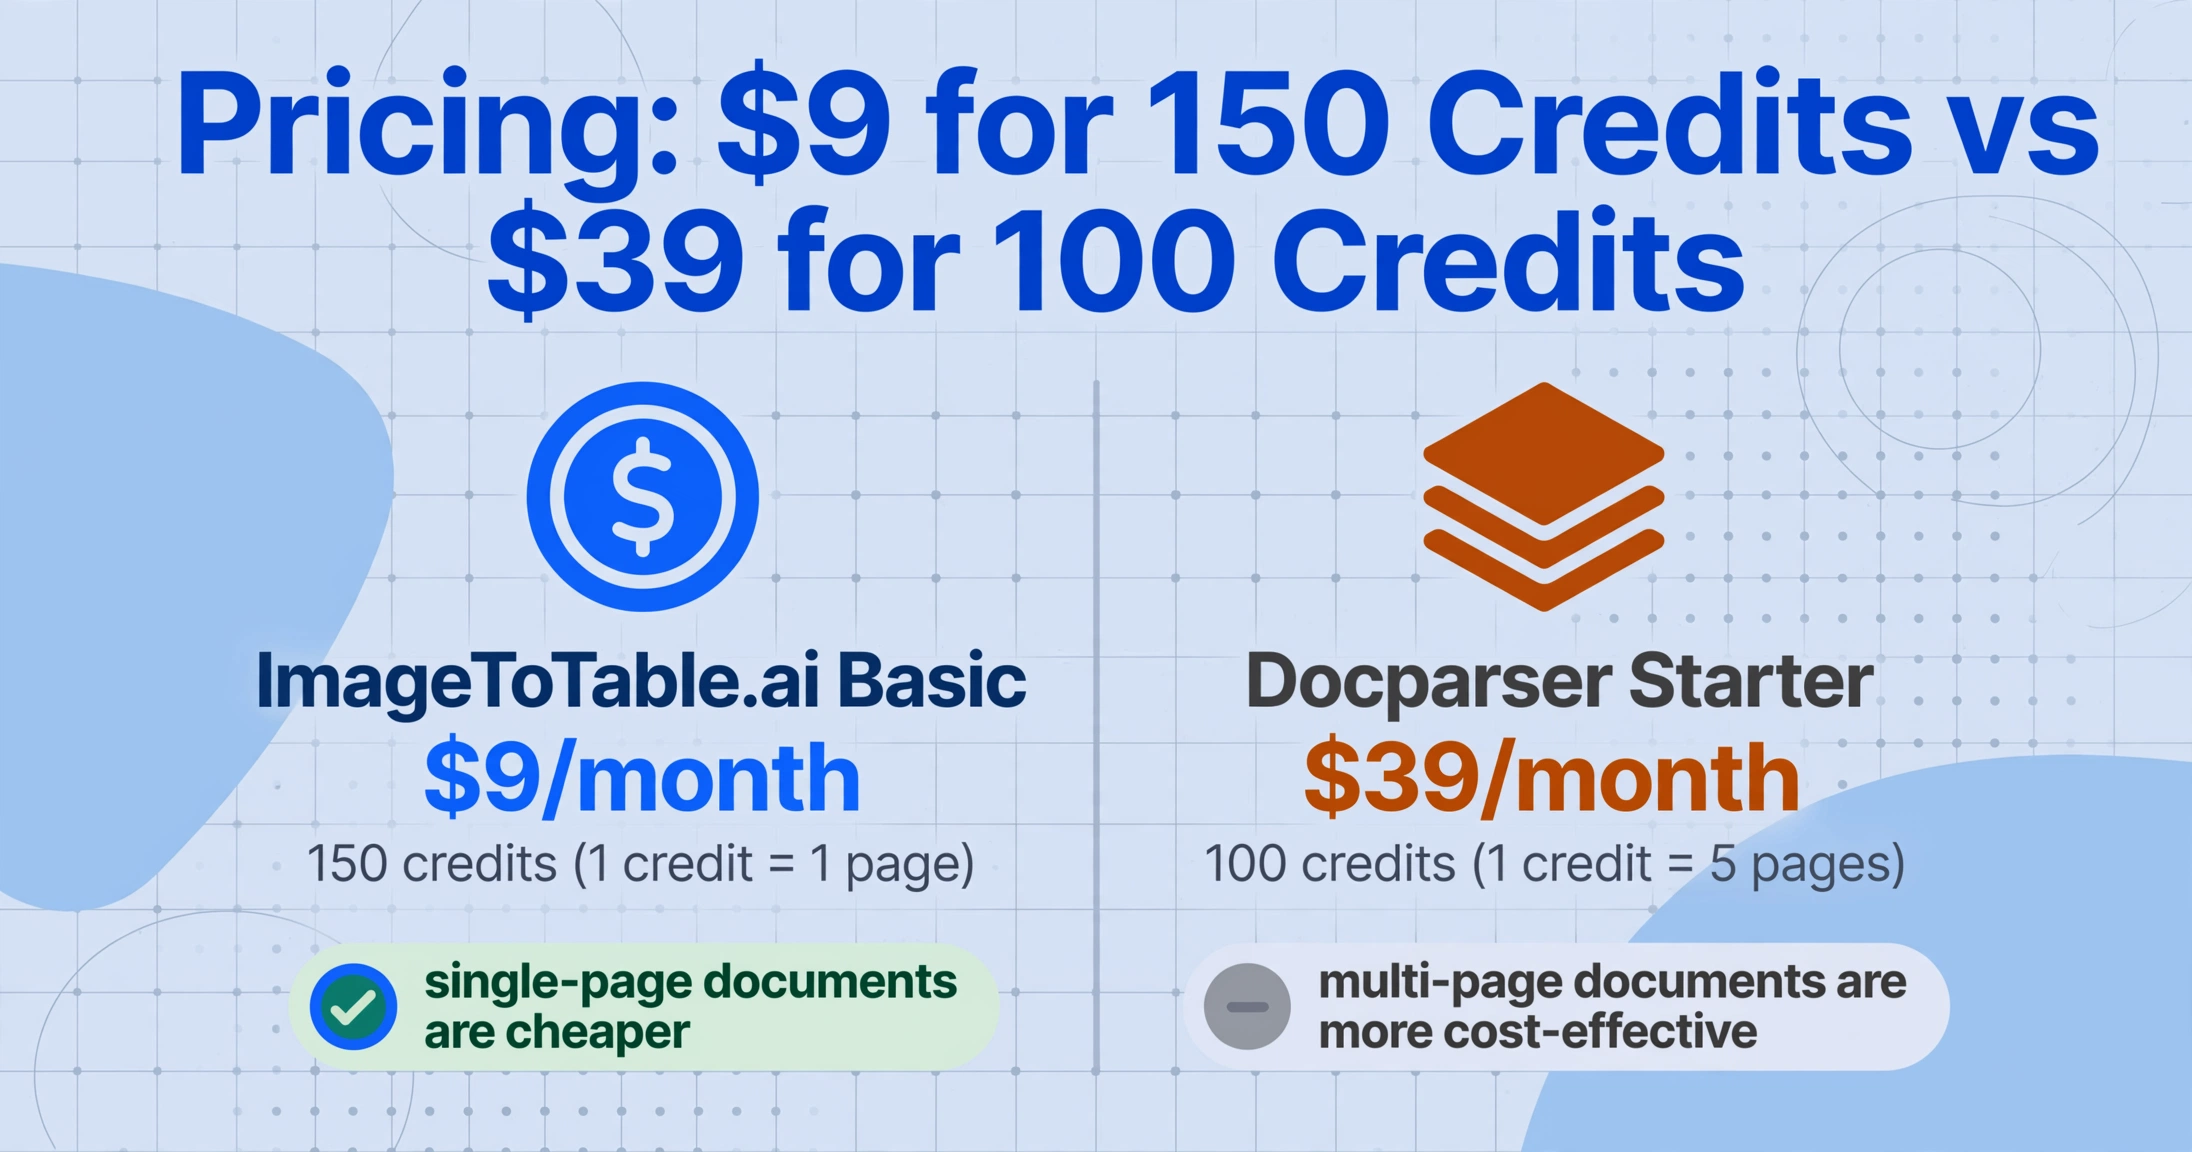
O Docparser usa um modelo de crédito por documento. Um crédito equivale a um documento com até cinco páginas. O plano Starter custa $39/mês (mensal) ou $32.50/mês (anual) por 100 créditos — efetivamente 100 a 500 páginas por mês, dependendo do tamanho do documento. O plano Professional ($74/mês mensal, $61.50/mês anual) oferece 250 créditos. O plano Business ($159/mês mensal, $133/mês anual) oferece 1.000 créditos com parsers multi-layout incluídos. Recursos adicionais como parsers multi-layout ($29.95/mês), controle de versão de parser ($9.95/mês) e retenção estendida de documentos ($19.95/mês) são cobrados separadamente nos planos de nível inferior.
O ImageToTable usa um modelo de assinatura por crédito em que um crédito equivale a uma imagem ou uma página de PDF. O plano Basic custa $9/mês por 150 créditos. O Pro é $29/mês por 500 créditos. O Max é $59/mês por 1.500 créditos. Uma cota gratuita diária permite testar com documentos reais antes de assinar, e pacotes de créditos avulsos estão disponíveis sem compromisso de assinatura.
No nível de entrada para documentos de uma página, o plano Basic do ImageToTable oferece 150 créditos por $9 — cerca de 4× mais volume por dólar do que o Starter do Docparser a $39 por 100 créditos. Mas o modelo por documento do Docparser se torna significativamente mais barato para documentos de várias páginas. Uma única fatura de 5 páginas consome 5 créditos do ImageToTable, mas apenas 1 crédito do Docparser. Se a maior parte dos seus documentos são PDFs de 3 a 5 páginas de um conjunto estável de remetentes conhecidos, o custo efetivo por documento do Docparser pode ser substancialmente menor do que o preço baseado em páginas do ImageToTable.
Para um passo a passo detalhado de como diferentes modelos de preços afetam sua conta mensal em diferentes faixas de volume, veja detalhamento de preços de extração de documentos 2026.
Flexibilidade de Documentos: O Que Cada Ferramenta Realmente Consegue Ler
Ambas as ferramentas cobrem os tipos padrão de documentos empresariais — faturas, pedidos de compra, recibos, contratos, extratos bancários. Mas os tipos de documentos que conseguem processar de forma confiável divergem significativamente quando você vai além de PDFs digitais limpos.
O OCR Zonal do Docparser foi criado para documentos com layouts previsíveis. Ele tem melhor desempenho em PDFs digitais e digitalizações de alta qualidade, onde cada campo aparece em uma posição consistente. Sua própria documentação observa que, para melhores resultados, "os documentos recebidos são digitalizados em alta qualidade e têm um layout consistente". A plataforma adicionou opções de pré-processamento de OCR — correção de inclinação, remoção de artefatos, rotação de página — para melhorar o processamento de digitalizações imperfeitas, e o DocparserAI agora oferece reconhecimento de escrita manual através do modelo SmartAI Parser. Mas a limitação fundamental permanece: a extração baseada em zonas se degrada em imagens de baixa DPI, digitalizações inclinadas, fotos de celular e documentos onde carimbos ou selos cobrem campos de dados. Quando o retângulo da zona não consegue delimitar de forma confiável o texto desejado, a qualidade da extração cai.
O ImageToTable foi construído do zero exatamente para essa lacuna. O LLM de visão lê documentos como um humano faz — compreendendo todo o layout visual e localizando os campos solicitados pelo significado semântico, não pela posição em pixels. Tabelas impressas, formulários manuscritos, fotos de celular de um recibo de restaurante, uma captura de tela de uma fatura enviada por e-mail, um contrato digitalizado com um carimbo da empresa sobre o bloco de assinatura — a IA processa todos eles no mesmo pipeline de extração, sem trocar de mecanismo ou ajustar configurações. Para dados de tabelas impressas, a precisão chega a até 99% em documentos limpos. A escrita manual é reconhecida em níveis de precisão utilizáveis — suficiente para extração de dados mesmo que caracteres individuais não sejam transcritos perfeitamente — porque a IA entende o contexto do campo: "este número manuscrito fica ao lado de 'Total' e abaixo de 'Item charges', então é o valor total independentemente de como os dígitos se curvam."
A camada DocparserAI do Docparser trouxe reconhecimento de escrita manual e detecção de caixas de seleção para a plataforma. Mas esses recursos funcionam sobre uma arquitetura baseada em zonas que ainda espera campos em posições previsíveis. Se um campo manuscrito aparece em um local diferente em cada documento (porque o formulário é preenchido à mão e a caligrafia do escritor varia), nenhum aprimoramento de IA consegue compensar a zona que espera dados em uma coordenada fixa. O ImageToTable não tem essa restrição — a IA encontra o campo pelo que ele é, não por onde deveria estar.
Quando o ImageToTable Faz Mais Sentido
O ImageToTable é a melhor escolha quando seu ecossistema de documentos é definido por variedade em vez de repetição. Se você recebe documentos de vários fornecedores que usam layouts diferentes — e esses layouts mudam —, a abordagem sem modelo elimina a rotina de manutenção que as ferramentas baseadas em modelo exigem. Você define sua saída uma vez (os nomes das colunas que deseja) e a IA lida automaticamente com qualquer variação no layout de entrada. Cada novo formato de fornecedor, cada reformulação de fornecedor, cada formulário personalizado de cliente é processado corretamente no primeiro upload, sem tempo de configuração. Essa é a diferença prática entre um parser semântico de documentos e um orientado por modelo.
Se seus documentos chegam como fotos de celular, cópias digitalizadas ou manuscritos em vez de PDFs digitais impecáveis, o LLM de visão do ImageToTable os lê sem a degradação de qualidade que as ferramentas baseadas em zonas apresentam. Um empreiteiro fotografando uma nota de entrega no canteiro de obras, um funcionário enviando um relatório de despesas manuscrito, um inspetor de campo capturando a leitura de um medidor com o celular — esses não são casos extremos para o ImageToTable. São o caso de uso principal para o qual a ferramenta foi projetada.
Se você processa lotes de documentos de formatos mistos juntos — enviando faturas de vinte fornecedores diferentes em um único lote e precisando que os resultados sejam mesclados em uma única planilha alinhada —, a arquitetura de Processamento Prioritário em Lote do ImageToTable entrega isso em uma etapa. O Docparser processa cada documento individualmente dentro de uma caixa de correio; mesclar resultados de extração de vários fornecedores em uma tabela unificada exige automação via Zapier ou montagem manual.
Se seu orçamento é apertado e seus documentos são em sua maioria de página única (recibos, faturas, ordens de compra), o plano Basic do ImageToTable a $9/mês entrega 150 páginas — significativamente mais valor por dólar do que o nível de entrada do Docparser.
Quando o Docparser Faz Mais Sentido
O Docparser é a melhor escolha quando seus requisitos de extração vão além da localização de campos e entram em transformação determinística de dados. Se você precisa de normalização com regex, caminhos de extração condicionais, filtros de várias etapas, leitura de código de barras ou regras de cálculo que encadeiam vários campos, o motor de regras de análise do Docparser é mais poderoso que as colunas calculadas do ImageToTable. O ImageToTable lida bem com aritmética e classificação, mas não iguala a profundidade de regras do Docparser para transformações complexas campo a campo.
Se seu fluxo de trabalho depende de integrações automatizadas — documentos chegando por encaminhamento de e-mail → analisados automaticamente → dados enviados ao QuickBooks via Zapier → notificação no Slack — o ecossistema de integrações do Docparser é substancialmente mais maduro. A Caixa de Entrada de E-mail do ImageToTable cobre o mesmo gatilho de encaminhar e analisar (com o Auto-Process tornando tudo totalmente automático), mas o catálogo mais amplo de conectores do Docparser — ações nativas de Zapier, Make, Power Automate e Salesforce encadeando direto no QuickBooks ou Slack — vai além do que a API v1 e o webhook do ImageToTable sozinhos conseguem alcançar sem código de integração personalizado. Para equipes que investiram em plataformas de automação e precisam que a ferramenta de extração se conecte a esses fluxos em vez de oferecer sua própria interface, a profundidade de conectores do Docparser é uma vantagem real.
Se todo documento que você processa é um PDF de várias páginas de um remetente estável e conhecido — digamos, você processa 200 faturas mensais de 5 fornecedores cujos formatos não mudam há anos — o modelo de créditos do Docparser (1 crédito por documento até 5 páginas) o torna mais econômico que o preço por página do ImageToTable, e o custo de configuração do modelo é um investimento único que se paga ao longo de um processamento consistente.
Se você precisa de leitura de código de barras ou QR code integrada ao pipeline de extração, o Docparser inclui isso nativamente. O ImageToTable não consegue ler códigos de barras ou QR codes durante a extração — esse recurso não está disponível no produto atualmente.
O veredito honesto: o Docparser vence quando seus requisitos de processamento são profundos em regras e o formato é estável. O ImageToTable vence quando seu ecossistema de documentos é variado em formato, diverso em fontes ou tem layout mutável. Nenhuma das arquiteturas é universalmente melhor — a ferramenta certa depende do tipo de variabilidade que você realmente enfrenta.
O Veredito: Baseado em Cenários, Não em Binário Forçado
Depois de comparar as duas ferramentas em tempo de configuração, resiliência de formato, granularidade de análise, integrações, preços e flexibilidade de documentos, o quadro de decisão é mais claro do que a maioria dos artigos de comparação sugere.
O Docparser é feito para extração determinística de layouts estáveis. Seu mecanismo de OCR Zonal e sistema de regras recompensam equipes com formatos de documento consistentes por meio de extração precisa e repetível em nível de campo. O custo é a configuração e manutenção por layout. O retorno é o controle: normalização com regex, lógica condicional, leitura de códigos de barras e um pipeline de automação maduro que se conecta às ferramentas que você já usa. Se seus documentos vêm de um conjunto fixo de remetentes conhecidos cujos layouts não mudam, a profundidade e o escopo de integração do Docparser o tornam a escolha pragmática.
O ImageToTable.ai é feito para extração semântica de fontes variadas. Seu LLM de visão elimina totalmente a configuração por layout, lidando com qualquer formato, qualquer qualidade de entrada e qualquer combinação de tipos de documento em um único lote. O custo é menos controle granular sobre transformações em nível de campo. O retorno é a resiliência: mudanças de formato, novos fornecedores, fotos de celular, manuscritos e lotes mistos funcionam sem manutenção de modelo. Se seus documentos chegam de várias fontes com layouts diferentes, ou se a qualidade da entrada varia (digitalizações, fotos, manuscritos), o ImageToTable.ai elimina mais trabalho contínuo do que o conjunto de regras mais profundo do Docparser consegue compensar.
Se você está construindo um pipeline de automação de contas a pagar por e-mail com faturas de formato fixo fluindo para o QuickBooks via Zapier, o Docparser é a melhor opção — sua camada de automação e profundidade de regras combinam com esse fluxo de trabalho. Se você está coletando documentos de equipes de campo, processando pedidos de compra em formatos mistos ou extraindo dados em lote de fotos de celular e formulários digitalizados, a abordagem sem modelo do ImageToTable.ai poupa você do custo de manutenção que ferramentas baseadas em modelo impõem a fluxos de trabalho com entradas variadas. Nenhuma das ferramentas é uma resposta universal. Mas se você sabe como seu ecossistema de documentos realmente é — quantos formatos, com que frequência mudam, com que qualidade chegam — a escolha certa fica clara.
Para uma visão mais ampla de como as duas ferramentas se comparam com o restante do cenário de extração, veja ImageToTable vs Parseur.
Quer a versão resumida? Veja a tabela de comparação de recursos lado a lado, ou navegue por todas as comparações do ImageToTable.
Perguntas frequentes
O Docparser exige modelos ou o DocparserAI funciona sem eles?
O principal caminho de extração do Docparser é baseado em modelo — você cria um parser desenhando retângulos de OCR Zonal em um documento de exemplo. O DocparserAI adiciona recursos assistidos por IA (modelo SmartAI Parser que cria regras automaticamente, reconhecimento de escrita à mão, resumo de conteúdo), mas eles funcionam dentro da mesma arquitetura por tipo de documento. O SmartAI Parser reduz o tempo de configuração manual ao gerar regras automaticamente a partir de um documento de exemplo, mas ainda espera layouts consistentes dentro de um tipo de documento. O ImageToTable usa IA semântica exclusivamente — sem modelos, sem desenho de zonas, sem configuração por layout em nenhum caminho de extração.
O ImageToTable pode se integrar ao Zapier ou a webhooks como o Docparser?
Sim, através da API pública v1. A API REST do ImageToTable permite enviar documentos, acionar o processamento e registrar um webhook que dispara automaticamente quando um lote ou documento termina — sem necessidade de polling. O Zapier e o Make podem se conectar através dessa API, mas o ImageToTable não tem um conector pronto na app store nem integrações nativas com Salesforce/ERP como o Docparser. O ImageToTable também oferece exportação direta para Excel, CSV, JSON e Word, além de um add-on do Google Sheets que grava os dados extraídos diretamente na planilha ativa. Se você precisa do app Zapier de um clique do Docparser ou dos conectores nativos QuickBooks/Salesforce, o ecossistema de integrações do Docparser é mais maduro para esse caso específico.
Qual ferramenta é mais acessível para documentos de várias páginas?
Depende do tamanho do documento. O Docparser conta um crédito de parsing por documento até cinco páginas — então uma fatura de 5 páginas consome 1 crédito. O ImageToTable conta um crédito por página — essa mesma fatura de 5 páginas consome 5 créditos. Se seus documentos têm consistentemente 3–5 páginas, o modelo de créditos do Docparser pode ser significativamente mais barato por documento. Para documentos de uma página (recibos, a maioria das faturas), o preço do ImageToTable é menor por crédito. Seu custo total depende de você processar principalmente documentos de uma página ou de várias páginas. Veja detalhamento de preços de extração de documentos 2026 para uma comparação volume a volume.
O Docparser oferece suporte a processamento em lote como o ImageToTable?
O Docparser processa documentos dentro de uma caixa de correio — você pode enviar vários documentos de uma vez ou configurar importações automatizadas do armazenamento em nuvem ou e-mail. Mas cada documento é analisado individualmente, e mesclar resultados de vários documentos (especialmente entre diferentes analisadores) em uma única planilha alinhada exige trabalho externo via Zapier/API ou exportação manual. O ImageToTable foi projetado com prioridade em lote: envie arquivos de qualquer fonte, defina os nomes das colunas uma vez e baixe um único arquivo Excel mesclado com cabeçalhos consistentes em todos os documentos. Para equipes que processam lotes de formatos mistos regularmente, essa é uma diferença significativa no fluxo de trabalho.
O Docparser consegue lidar com escrita à mão tão bem quanto o ImageToTable?
O DocparserAI introduziu o reconhecimento de escrita à mão por meio do modelo SmartAI Parser. Ele consegue extrair texto manuscrito de documentos. No entanto, a arquitetura subjacente baseada em zonas significa que a escrita à mão deve aparecer em um local previsível na página para uma extração precisa. O LLM de visão do ImageToTable encontra campos manuscritos em qualquer lugar da página ao entender o contexto — não exige que a escrita à mão esteja em uma zona predefinida. Para documentos em que a escrita à mão aparece em posições variáveis (formulários de inspeção de local, planilhas de campo, notas de entrega preenchidas por pessoas diferentes), a abordagem do ImageToTable é mais confiável.
Posso migrar do Docparser para o ImageToTable?
Sim. A migração não exige importar modelos — o ImageToTable não usa modelos. Exporte seus dados históricos do Docparser como CSV ou Excel. Envie os mesmos documentos de origem para o ImageToTable, digite os nomes das colunas que correspondem às suas definições de campo do Docparser, e a IA os extrai sem qualquer configuração de modelo. Os nomes das colunas que você usou no Docparser (Invoice Number, Vendor Name, Date, Total) se tornam seus nomes de colunas no ImageToTable. Mescle seus dados históricos com novas extrações em uma planilha — nomes de cabeçalho consistentes tornam a transição simples.