ImageToTable vs Nanonets vs Parseur für nicht-technische Teams:
Ein ehrlicher Vergleich 2026
Die meisten Vergleiche zur Dokumentextraktion lesen sich wie Feature-Checklisten von Anbietern. Sie beantworten Fragen, die niemand in Ihrem Team tatsächlich stellt. Der Betriebsleiterin, die 200 Rechnungen pro Monat verarbeitet, ist es egal, welches Tool im IDP Leaderboard am besten abgeschnitten hat. Sie möchte wissen, ob jemand in ihrem Team es heute Nachmittag ohne IT-Hilfe herausfinden kann, was es monatlich wirklich kostet und ob die extrahierten Daten ohne einen Zapier-Umweg in Google Sheets landen. Dieser Vergleich beantwortet diese Fragen – und beantwortet ausdrücklich nicht die Fragen, die für Fortune-500-Einkaufsteams wichtiger sind als für das Team, das Sie tatsächlich leiten.
Wichtigste Erkenntnisse
- Alle drei Tools verkaufen „Dokumentextraktion" – aber ihre Preismodelle unterscheiden sich so stark, dass 400 Seiten pro Monat bei einem Tool 19 $ und bei einem anderen 120 $ kosten.
- Die entscheidende Google-Sheets-Frage ist nicht „können Daten irgendwann in eine Tabelle gelangen" – sondern ob die Extraktion direkt in der Tabelle stattfindet, die Ihr Team bereits geöffnet hat, und nur ImageToTable.ai bietet dafür ein natives Sidebar-Add-on.
- Vergessen Sie die Feature-Vergleichstabellen – die richtige Frage wählt Ihr Tool für Sie: Arbeitet Ihr Team hauptsächlich mit Tabellen, verarbeitet es Dokumente aus E-Mail-Weiterleitungen oder benötigt es Enterprise-Compliance-Zertifizierungen?
Warum dieser Vergleich existiert (und was wir nicht abdecken)
ImageToTable, Nanonets und Parseur lösen alle dasselbe Kernproblem: unstrukturierte Dokumente in strukturierte, tabellenfertige Daten zu verwandeln, ohne manuelles Abtippen. Aber sie gehen das Problem aus drei grundlegend verschiedenen Blickwinkeln an – und der Unterschied zählt mehr, als jede Feature-Liste zeigt.
Dieser Vergleich ist aus der Perspektive einer nicht-technischen Teamleitung geschrieben: jemand, der Betrieb, Finanzen oder ein kleines Unternehmen leitet und Dokumentenextraktion benötigt, die in einem tabellenorientierten Workflow funktioniert. Das Team arbeitet wahrscheinlich mit Google Sheets. Niemand im Team hat Zeit, Trainingsdaten zu labeln oder einen Implementierungszyklus abzuwarten. Das Budget ist real, aber nicht unbegrenzt – die Frage ist nicht „Was ist am günstigsten?", sondern „Was ist die richtige Ausgabe für unsere tatsächliche Nutzung?"
Was wir nicht abdecken: Dies ist keine Bewertung von API-Latenz, Modell-Benchmark-Ergebnissen oder Enterprise-Deployment-Architekturen. Wenn Sie ein Engineering-Leiter sind, der Extraktions-APIs für eine Produktionspipeline mit einer Million Seiten pro Monat evaluiert, sind die Kriterien, die für Sie zählen, andere als die hier relevanten. Wir werden auch nicht so tun, als wäre dies eine „unvoreingenommene Drittanbieter-Bewertung". Wir haben ImageToTable entwickelt. Aber wir haben die anderen beiden Tools verwendet, mit ihren Nutzern gesprochen und ihre Preise anhand öffentlicher Seiten recherchiert. Wenn ein Wettbewerber etwas besser macht, sagen wir das.
Wenn Sie sich noch mit den Grundlagen der KI-Dokumentenextraktion vertraut machen – und wie sie sich von den OCR-Tools unterscheidet, die Sie vielleicht zuvor ausprobiert haben –, beginnen Sie mit was Dokumentendatenextraktion tatsächlich bedeutet und wie sich KI-Extraktion von traditioneller OCR unterscheidet. Dieser Artikel setzt voraus, dass Sie bereits wissen, dass Sie ein Extraktionstool benötigen, und sich nun zwischen den Optionen entscheiden.
Frage 1: Kann heute jemand aus meinem Team damit arbeiten, ohne Schulung?
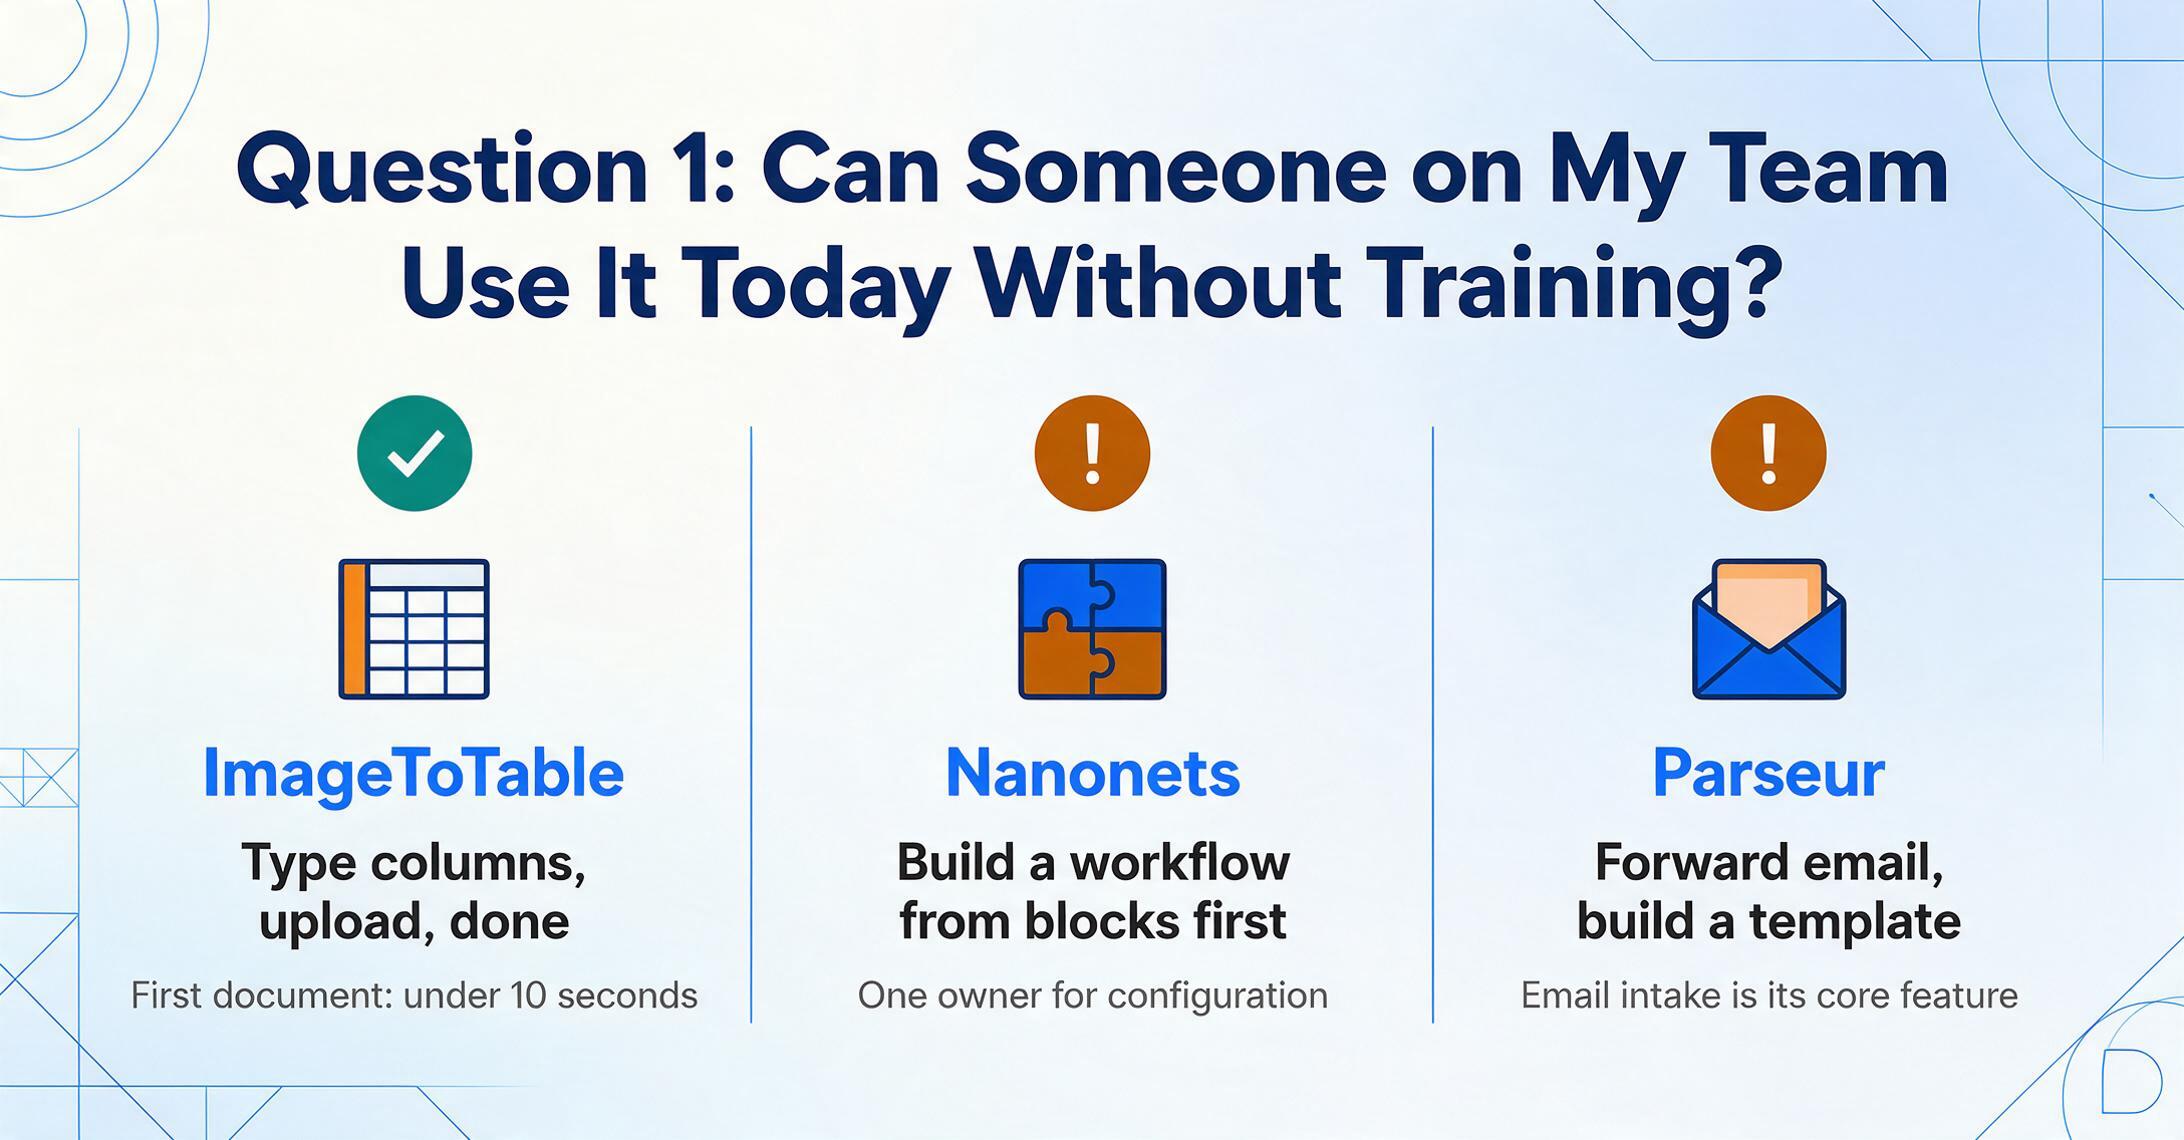
Diese Frage entscheidet über die meisten Tool-Evaluierungen. Ein Produkt kann auf dem Papier leistungsstark sein – aber wenn die Einarbeitung eine Woche dauert oder Konzepte erfordert, die Ihr Team nicht kennt, scheitert die Einführung im ersten Monat. Die drei Tools verfolgen deutlich unterschiedliche Ansätze für die erste Nutzung.
ImageToTable: Spaltennamen eingeben, hochladen, fertig
Es gibt keine Konfigurationsphase. Sie geben die gewünschten Feldnamen ein – „Rechnungsnummer", „Lieferant", „Datum", „Gesamtbetrag" – laden ein Dokument hoch, und die AI extrahiert diese Werte. Die von Ihnen eingegebenen Spaltennamen werden zu den Kopfzeilen Ihrer Ausgabetabelle. Es gibt keine Vorlage zu erstellen, keine Trainingsdaten zu beschriften und keine „Parse-Engine" auszuwählen. Sie können die Spaltennamen auch ganz weglassen und die AI die Dokumentinhalte automatisch erkennen lassen, um dann von dort aus zu verfeinern.
Dieser Ansatz – den wir Benutzerdefinierte Spaltenextraktion nennen – funktioniert, weil die AI semantisch versteht, was „Rechnungsnummer" bedeutet, und nicht, wo es auf der Seite steht. Sie zeichnen keine Felder ein und bringen dem System nicht bei, wie Ihre Rechnungen aussehen. Ein Lieferant ändert das Rechnungslayout? Die AI passt sich an. Jemand sendet ein Handyfoto statt einer PDF? Gleicher Ablauf. Für einen tieferen Einblick, warum das wichtig ist, lesen Sie wie sich die Benutzerdefinierte Spaltenextraktion von der Tabellenkonvertierung ganzer Dokumente unterscheidet.
Das erste Dokument wird in der Regel in unter 10 Sekunden verarbeitet. Ein neues Teammitglied kann ohne Dokumentation von der Anmeldung zur fertigen Extraktion gelangen.
Nanonets: Workflow mit Blöcken erstellen
Nanonets verwendet einen visuellen Workflow-Builder aus „Blöcken" – jeder Block führt einen Schritt aus: Dokumenterfassung, Klassifizierung, Datenextraktion, Validierung, Export. Für einen standardmäßigen Rechnungsworkflow verketten Sie in der Regel 4–6 Blöcke. Der Extraktionsblock ist KI-gestützt und erfordert keine Vorlagenerstellung – er erkennt Felder automatisch aus Dokumenten, ähnlich wie ImageToTable.
Einen Workflow in Produktion zu bringen, erfordert jedoch mehr Schritte als ein einfacher Upload-und-Extrahieren-Ablauf. Sie müssen das Blockkonzept verstehen, jede Stufe konfigurieren und die Pipeline Ende-zu-Ende testen. Die Oberfläche ist für Personen konzipiert, die mit Workflow-Automatisierungskonzepten vertraut sind – für dieses Publikum ist sie intuitiv, aber die Lernkurve ist steiler als „Felder eingeben, hochladen, herunterladen". Die offizielle Dokumentation von Nanonets schätzt die Einrichtungszeit für einfache Workflows auf Minuten, aber Nutzer auf Reddits r/dataengineering berichten, dass das Einrichten komplexer Pipelines mit mehreren Dokumenttypen Tage dauern kann.
Parseur: Engine wählen, Postfach einrichten
Parseur organisiert die Extraktion über „Postfächer" – jedes Postfach verarbeitet einen Dokumenttyp mit eigenem Feldschema und eigenen Verarbeitungsregeln. Beim ersten Upload erkennt Parseur automatisch die Felder, die Ihrer Meinung nach extrahiert werden sollen. Sie können die Feldliste dann verfeinern und pro Feld Anweisungen in einfachem Englisch verfassen. Parseur wählt automatisch die passende Parsing-Engine aus – Vision AI für bildlastige Layouts, Text AI für reinen Text, Vorlagen für feste Formulare.
Die automatische Felderkennung beim ersten Upload ist wirklich hilfreich und reduziert anfängliches Rätselraten. Aber die Postfach- + Engine- + Nachbearbeitungsstruktur führt Konzepte ein, die nicht-technische Nutzer lernen müssen. Die Vorlagen-Engine ist zwar optional, erfordert aber das Erstellen einer visuellen Vorlage pro Dokumentlayout – nützlich, wenn Sie jedes Mal identische Ausgaben benötigen, aber zusätzliche Arbeit, wenn Ihre Dokumente von vielen verschiedenen Anbietern mit unterschiedlichen Formaten stammen. Laut eigener Dokumentation von Parseur sind die meisten Workflows in unter 10 Minuten einsatzbereit für einfache Anwendungsfälle.
| ImageToTable | Nanonets | Parseur | |
|---|---|---|---|
| Zeit bis zur ersten Extraktion | Unter 1 Minute | 5–15 Minuten (einfacher Workflow) | 2–10 Minuten (erstes Postfach) |
| Einrichtungsmodell | Spaltennamen eingeben → hochladen | Visueller Workflow-Builder (Blöcke) | Postfach + Feldanweisungen |
| Vorlage erforderlich? | Nein | Nein (AI erkennt Felder automatisch) | Optional – AI funktioniert ohne Vorlagen |
| Trainingsdaten erforderlich? | Keine | Keine für Standardextraktion | Keine |
| Layoutänderungen verarbeitet? | Automatisch – semantische Extraktion | Automatisch – AI passt sich an | AI-Engines passen sich an; Vorlagen müssen aktualisiert werden |
Wenn Ihre Hauptanforderung darin besteht, ein nicht-technisches Teammitglied in unter 5 Minuten produktiv zu machen, bietet ImageToTable den kürzesten Weg. Das Postfachkonzept von Parseur ist der nächste zugänglichste Ansatz – die automatische Felderkennung beim ersten Upload beseitigt die Frage „Wie benenne ich die Felder?“. Nanonets bietet die meiste Workflow-Kontrolle, jedoch zu einem Komplexitätsaufwand, der mehr Sinn ergibt, wenn Sie bereits jemanden im Team haben, der sich mit Automatisierungstools auskennt.
Frage 2: Was zahle ich tatsächlich pro Monat?
Die Preismodelle bei der Dokumentenextraktion unterscheiden sich erheblich – und diese Unterschiede sind wichtiger als die Listenpreise. Ein Tool berechnet pro Seite, ein anderes pro KI-Operation, ein weiteres eine feste Monatsgebühr. Dieselbe Dokumentmenge kann je nach Modell zu sehr unterschiedlichen Rechnungen führen.
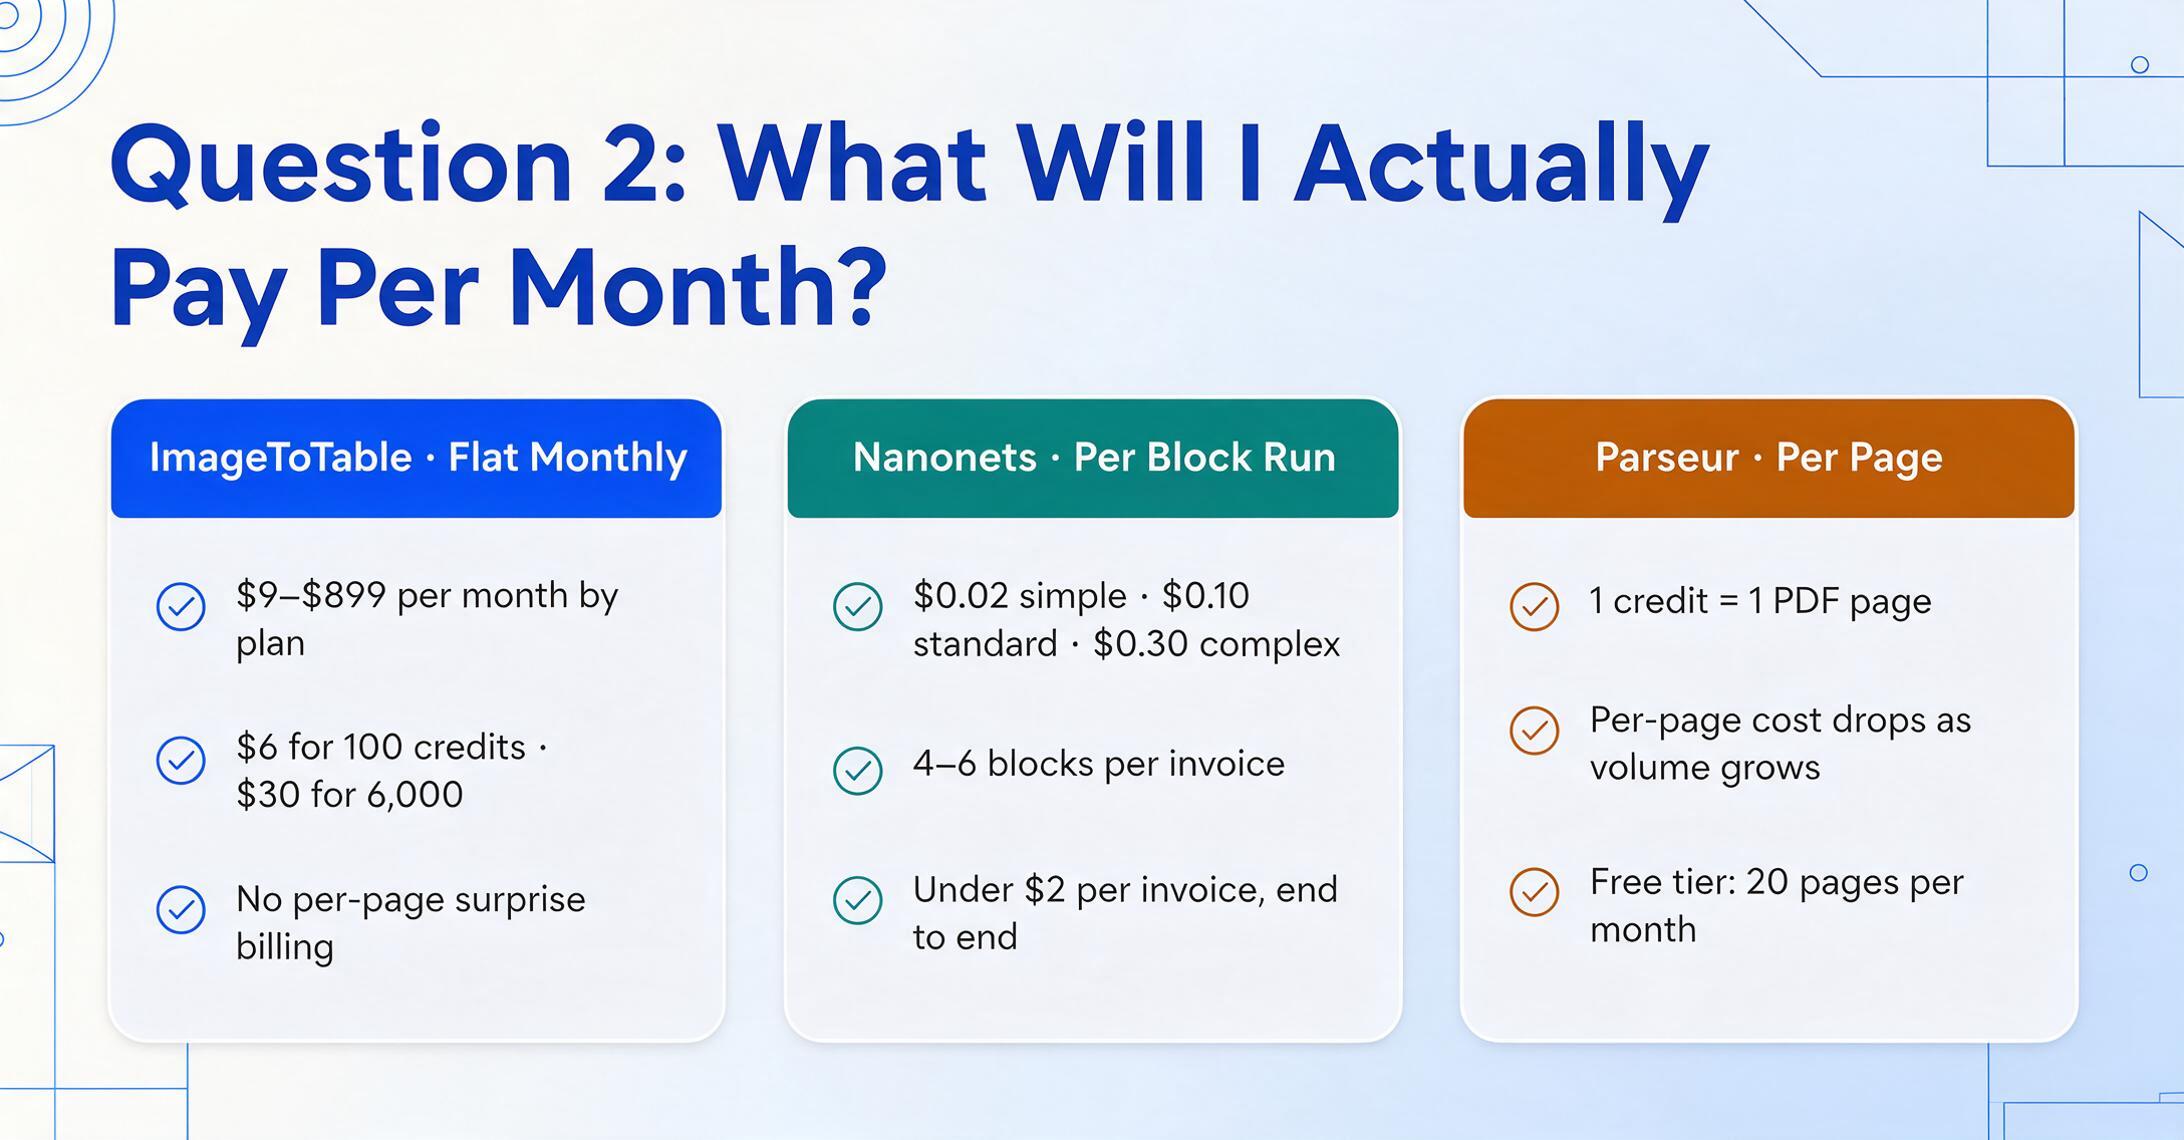
Die drei Preismodelle im Überblick
ImageToTable: Monatsabonnement mit Guthabenlimits. Sie zahlen eine feste Monatsgebühr (je nach Plan $9–$899) und erhalten eine bestimmte Anzahl an Guthaben – jedes Guthaben verarbeitet ein Bild oder eine PDF-Seite. Nicht genutzte Guthaben verfallen, aber es gibt keine Überraschungsrechnungen pro Seite. Sie können auch einmalige Guthabenpakete kaufen ($6 für 100 Guthaben, bis zu $300 für 6.000 Guthaben) ohne Abonnement. Ein tägliches kostenloses Kontingent ermöglicht es Ihnen, mit echten Dokumenten zu testen, bevor Sie etwas bezahlen.
Nanonets: Verbrauchsbasiertes Preismodell pro Block. Nanonets berechnet pro „Blocklauf" – jeder Schritt in einem Workflow verbraucht Guthaben zu unterschiedlichen Sätzen: $0,02 für einfache Operationen (Formatierung, Routing), $0,10 für Standard-KI (Klassifizierung, Validierung), $0,30 für komplexe KI (Datenextraktion). Ein typischer Rechnungsworkflow verwendet 4–6 Blöcke. Nanonets schätzt dies auf unter $2 pro Rechnung Ende-zu-Ende. Der Starter-Plan enthält $200 an kostenlosem Guthaben. Team-Pläne mit Mengenrabatten und geteiltem Guthaben erfordern die Kontaktaufnahme mit dem Vertrieb.
Parseur: Volumenbasiertes Preismodell pro Seite. Parseur berechnet pro verarbeiteter Seite, wobei der Preis pro Seite mit steigendem Volumen sinkt. 1 Guthaben = 1 PDF-Seite. E-Mails und Tabellen zählen unabhängig von ihrer Länge als 1 Seite. Der kostenlose Tarif umfasst 20 Seiten/Monat. Bezahlte Pläne starten auf einer Basisebene und skalieren im Self-Service bis zu 1 Million Seiten/Monat, Enterprise bewältigt bis zu 10 Millionen Seiten. Parseur veröffentlicht keine genauen Preise pro Seite für jede Volumenstufe – der Preisschieberegler ermöglicht eine Schätzung, der endgültige Preis erscheint jedoch erst nach der Anmeldung. Der ROI-Rechner auf Parseurs Preisseite ermöglicht es Ihnen, Kosten basierend auf Ihrem Dokumentvolumen und Ihrer Mitarbeiterzahl zu modellieren.
Was jedes Modell bei drei realistischen Volumina kostet
| Monatliches Volumen | ImageToTable | Nanonets (geschätzt) | Parseur (geschätzt) |
|---|---|---|---|
| 50 Seiten/Monat | $0 (kostenloses Tageskontingent) oder $9/Monat (Basic) | $0 (Starter-Guthaben deckt dies ab) | Kostenpflichtige Einstiegsstufe (über 20 kostenlose) |
| 400 Seiten/Monat | $19/Monat (Pro, 400 Credits) — ~$0,05/Seite | ~$60–$120/Monat (bei ~$0,15–$0,30/Seite für extraktionsintensive Workflows) | Kostenpflichtige Stufe — geschätzt $40–$80/Monat |
| 3.000 Seiten/Monat | $149/Monat (Growth, 3.000 geteilte Credits) — ~$0,05/Seite | ~$150–$300/Monat (mit Mengenrabatten, Vertrieb kontaktieren) | Scale-Stufe — geschätzt $150–$300/Monat |
ImageToTable-Preise von der öffentlichen Preisseite unter imagetotable.ai/upgrade_service. Nanonets-Schätzungen basieren auf der öffentlichen Preisgestaltung pro Block unter nanonets.com/pricing, unter Annahme eines typischen Rechnungsworkflows mit 4–6 Blöcken. Parseur-Schätzungen basieren auf den Volumenschiebereglern unter parseur.com/pricing — genaue Preise pro Seite erfordern eine Registrierung. Alle Preise in USD. Die Schätzungen für Nanonets und Parseur gelten für die Extraktion — für Zusatzfunktionen können weitere Kosten anfallen.
Das Modell pro Block führt zu einer echten Unvorhersehbarkeit, die Abonnementmodelle vermeiden. Einen Monat verarbeitet Ihr Team 400 Standard-Rechnungen mit einer Seite — erschwinglich. Im nächsten Monat sendet ein Lieferant 50 mehrseitige Kontoauszüge mit angehängten Verträgen, die jeweils mehr Blöcke auslösen als erwartet. Ihre Rechnung ändert sich, und Sie wissen nicht, um wie viel, bis sie eintrifft. Für Teams mit vorhersehbaren Dokumenttypen und -volumina ist das beherrschbar. Für Teams, die eine Mischung aus kurzen und langen Dokumenten aus wechselnden Quellen verarbeiten, ist das Abonnementmodell leichter zu budgetieren.
Ein Preisaspekt, bei dem Nanonets und Parseur einen Vorteil haben: Mengenrabatte. Wenn Sie regelmäßig über 10.000 Seiten pro Monat verarbeiten, kann ihre volumenbasierte Preisgestaltung bei den Kosten pro Seite flache Abonnementmodelle übertreffen. Für die Volumenbereiche, in denen die meisten nicht-technischen Teams arbeiten (50–3.000 Seiten/Monat), ist das flache Abonnement von ImageToTable jedoch in der Regel günstiger.
Frage 3: Funktioniert es in Google Sheets?
Für Teams, deren gesamter Workflow in Google Sheets stattfindet, lautet die Integrationsfrage nicht „Können Daten irgendwann in einer Tabelle landen?“, sondern „Kann ich Daten extrahieren, ohne die Tabelle zu verlassen, in der ich bereits arbeite?“ Der Unterschied zwischen einem nativen Add-on und einer Zapier/Webhook-Pipeline entscheidet darüber, ob die Extraktion Teil des Workflows wird oder ein separater Schritt, an den sich jemand erinnern muss.
ImageToTable: Natives Google Sheets-Seitenleisten-Add-on
ImageToTable bietet ein Google Workspace Marketplace-Add-on, das die vollständige Extraktions-Engine als Sheets-Seitenleiste einbettet. Sie definieren Spalten, laden Dokumente hoch, und extrahierte Daten landen direkt in Ihrem aktiven Blatt – kein Dateiexport, kein Download-und-Neu-Upload, kein Tab-Wechsel. Spaltenvorlagen können gespeichert und über Stapel hinweg wiederverwendet werden, sodass Ihre „Rechnungsextraktions“-Vorlage jeden Monat auf dieselbe Weise funktioniert.
Das Add-on läuft im Kontomodus: Verbinden Sie Ihren API-Key einmal, und Ihre Sheets-Extraktionshistorie und -Vorlagen synchronisieren sich mit Ihrem Webkonto. Die Nutzung zählt gegen Ihr Plan-Kontingent. Das ist wichtig, weil Ihr gesamtes Team das Add-on aus derselben gemeinsamen Tabelle verwenden kann – extrahierte Daten erscheinen dort, wo bereits alle arbeiten.
Nanonets: Zapier, API oder Export
Nanonets bietet kein natives Google Sheets-Add-on. Daten erreichen Google Sheets über einen von drei Wegen: einen Zapier/Make/Power Automate-Konnektor (der einen Middleware-Schritt und potenzielle Latenz hinzufügt), die REST-API (erfordert Entwicklungsarbeit, um eine Pipeline einzurichten) oder manuellen Export nach CSV/Excel (was den Zweck der Automatisierung zunichte macht).
Für Teams mit einem bestehenden Automatisierungs-Stack funktioniert der Zapier-Weg gut – einmal konfiguriert, fließen extrahierte Daten automatisch zu Sheets. Die anfängliche Konfiguration erfordert jedoch Verständnis sowohl für Nanonets' Workflow-Builder als auch für Zapiers Trigger/Aktions-Modell. Das ist nicht dasselbe wie eine Seitenleiste, die sofort funktioniert.
Parseur: Webhook, Zapier oder direkte Synchronisierung
Parseur bietet „Live-Google-Sheets-Synchronisierung" als native Integration an – nach der Verbindung werden geparste Daten automatisch mit einem bestimmten Blatt synchronisiert. Das kommt einer nativen Erfahrung näher als der Middleware-Ansatz von Nanonets, ist aber dennoch ein separater Konfigurationsschritt und kein Workflow innerhalb von Sheets. Parseur unterstützt Google Sheets außerdem über Zapier, Make, Power Automate und n8n-Konnektoren.
Die direkte Synchronisierung bedeutet, dass Sie die Verbindung einmal einrichten und die Daten bei jedem neuen verarbeiteten Dokument automatisch fließen. Aber Sie verwalten die Extraktion weiterhin über die Weboberfläche von Parseur – es gibt keine Seitenleiste, die Sie nutzen können, ohne Sheets zu verlassen.
Wenn Google Sheets der Arbeitsort Ihres Teams ist: Die native Seitenleiste von ImageToTable ist die engste Integration. Die direkte Synchronisierung von Parseur ist eine starke zweite Option für automatisierte „Einrichten und vergessen"-Pipelines. Nanonets erfordert die meisten Zwischenschritte, bietet aber die größte Flexibilität, wenn Ihr Workflow mehrere Ziele über Sheets hinaus umfasst.
Frage 4: Welche Dokumenttypen verarbeitet jedes Tool gut?
Alle drei Tools behaupten, „jedes Dokument" zu verarbeiten. In der Praxis hat jedes seine Stärken und Randfälle, in denen es am besten funktioniert – und wo es Schwierigkeiten haben könnte. Es geht hier nicht darum, einen Sieger zu küren, sondern darum, das Tool zu dem zu passen, was Ihr Team tatsächlich verarbeitet.
| Dokumentfunktion | ImageToTable | Nanonets | Parseur |
|---|---|---|---|
| Eingabeformate | PDF, JPG, PNG, WebP, AVIF, Screenshots | PDF, Bilder, Word, Excel – breite Formatunterstützung | PDF, Bilder, E-Mails, Tabellenkalkulationen, 25+ Formate |
| E-Mail-Erfassung | Verfügbar – dedizierte Postfachadresse, automatische Verarbeitung mit gebundener Vorlage | Verfügbar (E-Mail-Integration) | Kernfunktion – E-Mails an eindeutige Postfachadresse weiterleiten |
| Handschriftunterstützung | Ja – semantisches Verständnis per VLM | Nicht prominent beworben | Vision-AI erfasst Handschrift, Kontrollkästchen, Stempel |
| Tabellen-/Positionsdatenextraktion | Ja – spaltenbasiert + berechnete Spalte für Berechnungen | Ja – mit erhaltener Tabellenstruktur in der Ausgabe | Ja – jede Zeile wird ein eigener Datensatz, verarbeitet variable Zeilenanzahl |
| Mehrsprachige Dokumente | Wichtige Sprachen werden unterstützt | 100+ Sprachen | 200+ Sprachen (OCR); AI-Engines unterstützen wichtige Sprachen |
| Layout-Erhaltung (Nach Word) | Nach Word-Modus – vollständige Layout-Wiederherstellung in bearbeitbares Word | Layout in Markdown-Ausgabe erhalten | Keine Kernfunktion – Ausgabe sind strukturierte Daten |
| Kontrollkästchen-/Stempel-/Signaturerkennung | Ja – Kontrollkästchenstatus, Stempel, Signaturen | Barcode- & Signaturerkennung in Growth Team- und höheren Plänen | Vision-AI erfasst Kontrollkästchen und Stempel |
| Compliance- & Sicherheitszertifikate | HTTPS-Verschlüsselung, verschlüsselter Speicher, automatisches Löschen | SOC 2 Type II, HIPAA, GDPR, ISO 27001 | GDPR-nativ (EU-Hosting), SOC 2 Type II in Arbeit |
Der Unterschied bei der E-Mail-Erfassung war früher eine klare Lücke zwischen diesen Tools – das ist er nicht mehr. Parseur wurde rund um E-Mail als primäre Dokumentquelle aufgebaut – Sie leiten Rechnungen und Belege an eine dedizierte Postfachadresse weiter, und sie werden automatisch verarbeitet. Für Teams, deren Dokumente hauptsächlich per E-Mail eintreffen (Lieferantenrechnungen an ap@, Spesenbelege, die von Mitarbeitern weitergeleitet werden), ist das ein echter Produktivitätsgewinn. Nanonets bietet eine ähnliche E-Mail-Integration. ImageToTable hat dies jetzt auch über das E-Mail-Postfach: Jedes Konto erhält eine dedizierte Postfachadresse. Wenn Sie Auto-Process mit einer gebundenen Vorlage aktivieren, startet die Extraktion, sobald die Mail eintrifft, und eine optionale Absender-Whitelist hält unzugehörige Mails aus der Warteschlange. Das E-Mail-Postfach kann so eingestellt werden, dass es Anhänge, den E-Mail-Text selbst oder beides liest – damit deckt es beide Fälle ab: eine weitergeleitete Rechnungs-PDF oder einen Lieferanten, der die Zahlen direkt in den Nachrichtentext tippt.
Beim Thema Compliance ist Nanonets in einer anderen Liga. SOC 2 Type II, HIPAA, GDPR und ISO 27001-Zertifizierungen sind wichtig, wenn Sie im Gesundheitswesen, Finanzwesen oder in einer Branche mit regulierten Datenverarbeitungsanforderungen tätig sind. Parseur bietet eine GDPR-native Infrastruktur (EU-gehostet) mit SOC 2 in Arbeit. ImageToTable verschlüsselt Daten während der Übertragung und im Ruhezustand mit konfigurierbarer automatischer Löschung – ausreichend für die meisten SMB-Anwendungsfälle, aber nicht für Organisationen, die bei der Anbieterprüfung Compliance-Anforderungen erfüllen müssen.
Frage 5: Kann es mit uns wachsen?
Ein Tool, das für zwei Personen mit 100 Rechnungen pro Monat funktioniert, kann scheitern, wenn das Team auf acht Personen und 2.000 Rechnungen wächst. Bei der Wachstumsfrage geht es nicht nur um Volumen – sondern um Teamzugriff, gemeinsame Ressourcen und darum, ob die Obergrenze des Tools über oder unter der Entwicklung Ihres Teams liegt.
Batch-Verarbeitung: Wie viele Dokumente gleichzeitig?
ImageToTable unterstützt Batch-Uploads, bei denen Sie mehrere Dateien auf einmal hochladen, Ihre Spalten einmal definieren und eine einzige zusammengeführte Ausgabetabelle erhalten. Die Upload-Gleichzeitigkeit skaliert mit der Tarifstufe – von 1 gleichzeitigem Upload im Free-Tarif bis zu 3 in Team-Tarifen. Der eigentliche Batch-Wert liegt im Zusammenführen: 50 Rechnungen von 15 verschiedenen Anbietern, alle in einer Tabellenkalkulation mit konsistenten Spaltenüberschriften extrahiert, ohne Einrichtung pro Datei. Die Funktion „Sammellink" fügt eine Wachstumsdimension hinzu, die kein Wettbewerber bietet: Sie können einen teilbaren Link generieren, über den Kunden oder Außendienstmitarbeiter Dokumente direkt in Ihre Verarbeitungswarteschlange hochladen.
Nanonets bewältigt die Batch-Verarbeitung über seine Workflow-Engine – Dokumente durchlaufen die konfigurierten Blöcke in Sequenz, mit Kontowarteschlangen, die Ihre Verarbeitung von anderen Kunden isolieren. Team-Tarife umfassen gemeinsame Credits und bis zu 3 Benutzer im Starter-Tarif. Growth und Enterprise fügen Analysen, Berichte und Mengenrabatte von bis zu 40 % hinzu. Für Teams, die Extraktionsdurchsatz und Genauigkeitskennzahlen über Monate verfolgen müssen, ist die Analyseschicht von Nanonets die stärkste der drei.
Parseur verarbeitet Dokumente über Postfächer mit unbegrenzten Feldern pro Extraktion. Scale-Tarife (10.000+ Credits/Monat) schalten Mehrbenutzerkonten (bis zu 100 Benutzer), erweiterte Nachbearbeitung (Python-Code für benutzerdefinierte Geschäftslogik) und unbegrenzte Dokumentaufbewahrung frei. Die einzigartige Stärke von Parseur bei Skalierung ist seine E-Mail-Intake-Pipeline: Wenn Ihr Dokumentvolumen auf Tausende pro Monat wächst, wird die Fähigkeit, per E-Mail-Weiterleitung automatisch zu erfassen, wertvoller, nicht weniger.
Die Wachstumsdimension, bei der ImageToTable einen Vorteil hat, den kein Wettbewerber repliziert: Mit dem Sammellink können Sie Ihren Dokumenteingang vergrößern, ohne Ihr Team zu vergrößern. Statt jemanden einzustellen, der Lieferanten nach Rechnungen jagt oder Mitarbeiter an die Abgabe von Spesenbelegen erinnert, senden Sie einen Link. Die Dokumente kommen zu Ihnen. Das ist eine andere Art von Skalierbarkeit – nicht mehr Dokumente schneller verarbeiten, sondern Dokumente mit weniger Reibung in die Pipeline bringen.
Wann Sie welches Tool wählen sollten: Ein praktischer Entscheidungsleitfaden
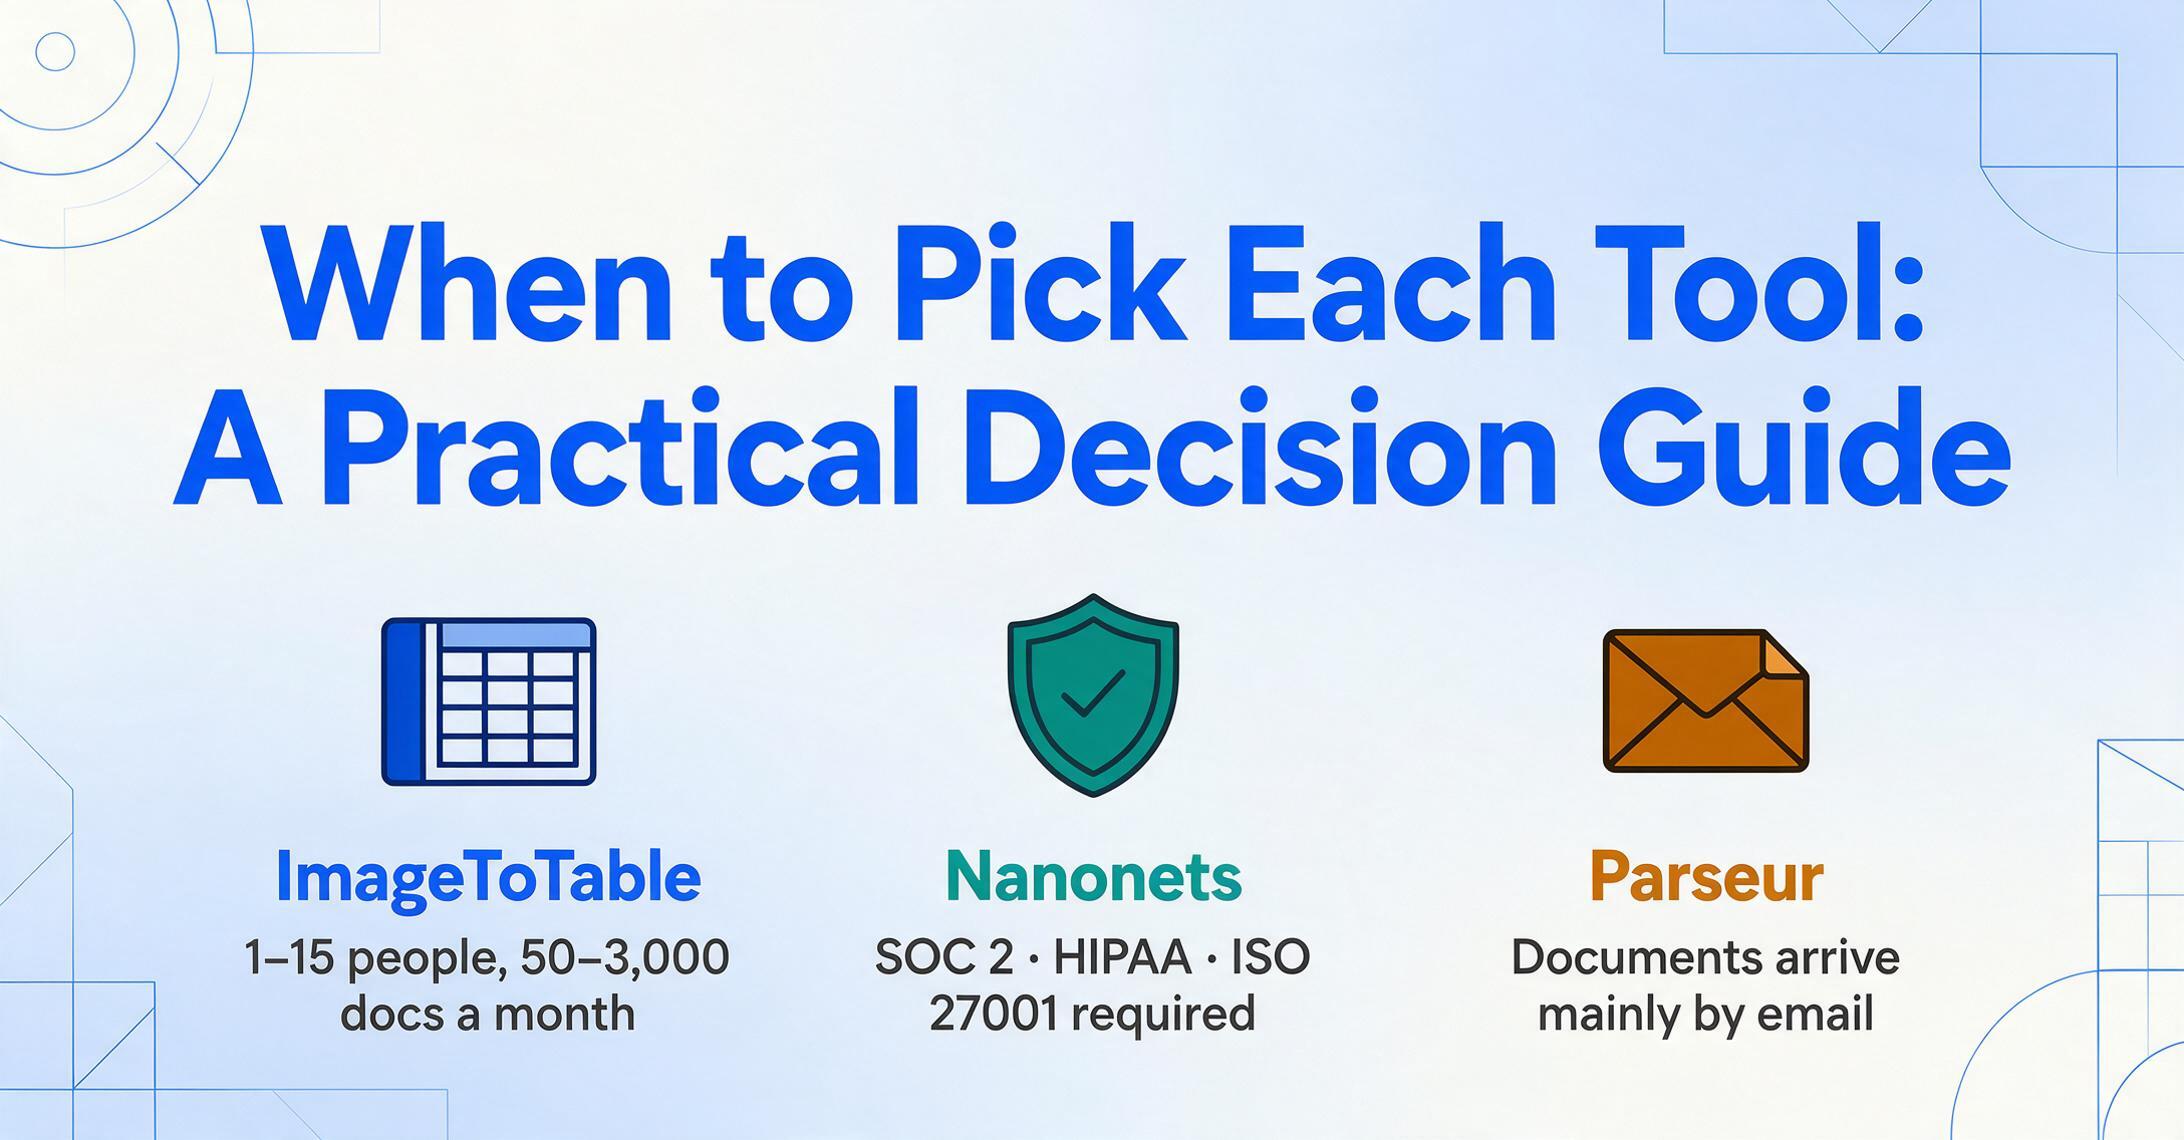
Kein Tool ist in allen Bereichen führend. Die richtige Wahl hängt davon ab, was Ihrem Team am wichtigsten ist und welche Kompromisse Sie eingehen möchten. So fällt die Entscheidung in den häufigsten Szenarien, die wir sehen.
Wählen Sie ImageToTable, wenn Ihr Team in Google Sheets arbeitet und die Extraktion noch heute funktionieren muss – ohne Einrichtung, ohne Training, ohne IT-Abteilung.
Am besten geeignet für: Kleine bis mittlere Teams (1–15 Personen), die 50–3.000 Dokumente pro Monat verarbeiten. Sie möchten eine Seitenleiste in Sheets, keinen weiteren Tab, den Sie verwalten müssen. Sie schätzen vorhersehbare monatliche Preise gegenüber einer Optimierung pro Dokument. Ihre Dokumente kommen aus mehreren Quellen und Sie benötigen den Sammellink, um sie ohne Nachfassen zu sammeln. Sie benötigen gelegentlich eine layout-erhaltende Word-Ausgabe. Sie benötigen keine Nanonets-Konformitätszertifizierungen wie SOC 2 oder HIPAA – der automatisierte E-Mail-Eingang wird bereits durch den E-Mail-Posteingang abgedeckt.
Wählen Sie Nanonets, wenn Compliance, Unternehmensintegrationen und Workflow-Automatisierung nicht verhandelbare Anforderungen sind.
Am besten geeignet für: Mittlere bis große Teams, die SOC 2 / HIPAA / ISO 27001-Konformität benötigen. Sie verbinden sich mit SAP, Oracle oder Salesforce – nicht nur mit Google Sheets. Sie möchten Analysen zu Extraktionsdurchsatz und -genauigkeit. Sie sind mit einer Workflow-Builder-Oberfläche vertraut und haben mindestens eine Person, die die Konfiguration übernehmen kann. Ihr Volumen rechtfertigt eine Preisgestaltung nach Volumenstufen. Sie benötigen Barcode-Erkennung oder benutzerdefinierte Python-Blöcke in Ihrer Extraktionspipeline.
Wählen Sie Parseur, wenn Ihre Dokumente hauptsächlich per E-Mail eintreffen und Sie eine unkomplizierte Pipeline mit hohem Volumen und Preisvorteilen benötigen.
Am besten geeignet für: Ops-Teams, die monatlich Hunderte oder Tausende standardisierter Dokumente per E-Mail erhalten (Lieferantenrechnungen an ap@, Versandbenachrichtigungen, Bestellbestätigungen). Sie möchten die Flexibilität der KI-Extraktion plus die Zuverlässigkeit der vorlagenbasierten Extraktion für Dokumente mit festem Format. Sie benötigen GDPR-Konformität mit EU-gehosteter Infrastruktur. Sie sind bereit, die Extraktion über das Parseur-Web-Dashboard zu verwalten und die Ausgabe über Sync oder Zapier mit Sheets zu verbinden. Ihr Volumen ist hoch genug (1.000+ Seiten/Monat), sodass die Preisgestaltung pro Seite für Sie von Vorteil ist.
Unsere Empfehlung: Eine subjektive, aber ehrliche Einschätzung
Wir haben ImageToTable entwickelt, daher wissen Sie, wohin unsere Sympathien gehen. Aber hier sagen wir Ihnen, wann wir die anderen Tools tatsächlich empfehlen würden – denn aus reiner Loyalität das falsche Tool zu wählen, hilft niemandem.
Wenn jemand in Ihrem Team Erfahrung mit Workflow-Automatisierungstools hat und Ihre Dokumente hauptsächlich per E-Mail eingehen, dann ist Parseurs E-Mail-Forwarding-Pipeline mit Template/AI-Hybrid-Engine wirklich schwer zu schlagen. Die Kombination aus „Weiterleiten an Postfach → automatische Extraktion → Synchronisierung mit Sheets" entfernt mehr Schritte aus dem Workflow als jeder andere Ansatz für dieses spezifische Eingabemuster.
Wenn Sie im Gesundheitswesen, im Rechtswesen oder im Finanzwesen tätig sind und Compliance-Zertifizierungen eine Grundvoraussetzung darstellen, dann setzt Nanonets mit seinem SOC-2-, HIPAA- und ISO-27001-Stack es in eine eigene Kategorie. Möglicherweise benötigen Sie auch deren Enterprise-Integrationen (SAP, Salesforce, Oracle), die Self-Service-Tools nicht bieten. In dieser Größenordnung kann die blockbasierte Preisgestaltung mit Mengenrabatten wirtschaftlicher sein als flache Abonnementmodelle.
Aber für das Team, das die meisten Menschen, die diese Frage stellen, tatsächlich führen – 3 bis 15 Personen, 100 bis 3.000 Dokumente pro Monat, Google Sheets als Dreh- und Angelpunkt, kein dedizierter Automatisierungsingenieur, keine Compliance-Zertifizierungs-Checkliste von der Rechtsabteilung – erledigt ImageToTable genau das, was sie brauchen (Extraktion basierend auf Spaltennamen in eine Tabellenkalkulation) mit der geringsten Reibung zwischen dem Öffnen des Tools und dem Vorhandensein nutzbarer Daten. Wenn Sie sich noch nicht sicher sind, gelten die praktischen Tipps, um das Beste aus der KI-Dokumentenextraktion herauszuholen unabhängig davon, welches Tool Sie wählen.
FAQ
Bieten diese Tools kostenlose Testversionen an?
Ja, alle drei. ImageToTable hat ein tägliches kostenloses Kontingent ohne Anmeldung – Sie können sofort echte Dokumente verarbeiten. Nanonets gibt jedem neuen Konto 200 $ an kostenlosen Credits, genug für Tausende von Dokumenten. Parseurs kostenloser Tarif umfasst 20 Seiten pro Monat mit vollem Funktionsumfang. Keines erfordert eine Kreditkarte zum Start.
Welches Tool hat die beste Genauigkeit?
Die Genauigkeit hängt mehr von Ihrem Dokumenttyp und der Dokumentqualität ab als vom Tool. Nanonets belegt Platz 1 im unabhängigen IDP Leaderboard für die Genauigkeit der Dokumentextraktion bei Benchmarks. Die Vorlagen-Engine von Parseur liefert bei festen Layouts jedes Mal identische Ergebnisse, und Vision AI verarbeitet variable Layouts. ImageToTable meldet bis zu 99 % Genauigkeit bei gedruckten Tabellendaten mithilfe der semantischen Extraktion auf VLM-Basis. Bei jedem Tool verringern handschriftliche Dokumente, Scans mit niedriger Qualität und stark verdichtete Layouts die Genauigkeit. Am besten vergleichen Sie die Tools, indem Sie sie mit Ihren eigenen Dokumenten testen – alle drei bieten kostenlose Einstiegspunkte.
Sind diese Tools DSGVO-konform?
Parseur ist bei der DSGVO am stärksten – die Infrastruktur wird in der EU gehostet und ist von Grund auf DSGVO-nativ. Nanonets bietet DSGVO-Konformität mit Optionen zur Datenresidenz (USA, EU, APAC) in Enterprise-Plänen. ImageToTable verschlüsselt Daten während der Übertragung und im Ruhezustand mit konfigurierbarer automatischer Löschung; es ist für die meisten SMB-Anwendungsfälle geeignet, verfügt jedoch nicht über eine formelle DSGVO-Zertifizierung. Wenn DSGVO-Konformität mit dokumentierten Zertifizierungen eine harte Anforderung ist, sind Parseur oder Nanonets Enterprise die sicherere Wahl.
Kann ich diese Tools ohne Programmierkenntnisse nutzen?
Ja, alle drei sind für den Betrieb ohne Code ausgelegt. ImageToTable: Geben Sie Spaltennamen in ein Textfeld ein, laden Sie Dateien hoch, laden Sie Ergebnisse herunter. Nanonets: Visueller Workflow-Builder mit Drag-and-Drop-Blöcken – Programmierung ist optional (benutzerdefinierte Python-Blöcke sind für fortgeschrittene Benutzer verfügbar). Parseur: Feldanweisungen in einfachem Englisch über eine Weboberfläche, mit optionaler Python-Nachbearbeitung in Scale+-Plänen. Für den Einstieg ist keine Programmierung erforderlich, obwohl alle drei APIs für Teams anbieten, die programmatischen Zugriff wünschen.
Kann ich verschiedene Dokumenttypen in einem Batch mischen?
ImageToTable: Ja – Sie können eine Mischung aus Rechnungen, Belegen und Kontoauszügen in einem Batch hochladen und aus jedem dieselben benannten Spalten extrahieren. Die AI findet „Datum“ oder „Gesamtbetrag“ unabhängig vom Dokumenttyp. Nanonets: Workflows werden in der Regel pro Dokumenttyp konfiguriert – Sie würden Klassifizierungsblöcke verwenden, um verschiedene Dokumente an verschiedene Extraktionspfade weiterzuleiten. Parseur: Jedes Postfach ist für ein Dokument-Schema ausgelegt, aber Vision AI und Text AI können Layoutvariationen innerhalb dieses Typs verarbeiten. Das Mischen grundlegend verschiedener Dokumenttypen (Rechnungen + Verträge) in einem Postfach ist nicht der vorgesehene Anwendungsfall.
Gibt es versteckte Kosten, auf die ich achten sollte?
Das Pro-Block-Modell von Nanonets birgt das größte Potenzial für unerwartete Kosten – ein komplexes Dokument, das mehr Blöcke auslöst als erwartet, kostet mehr als ein einfaches. Das Pro-Seite-Modell von Parseur ist vorhersehbarer, aber mehrseitige PDFs vervielfachen die Kosten (eine 10-seitige Abrechnung kostet das 10-fache einer 1-seitigen Rechnung). Das Abonnementmodell von ImageToTable ist am vorhersehbarsten – Sie zahlen die feste monatliche Gebühr unabhängig von Dokumentkomplexität oder Seitenanzahl, wobei eine Überschreitung Ihres Guthabenlimits ein Upgrade oder den Kauf zusätzlicher Credits erfordert.