ImageToTable vs Nanonets vs Parseur:非技術系チーム向けの
正直な2026年比較
ほとんどの文書抽出ツールの比較記事は、ベンダーが書いた機能チェックリストのようなものです。実際にあなたのチームが抱えている疑問には答えていません。毎月200件の請求書を処理するオペレーションマネージャーは、どのツールがIDP Leaderboardで最高スコアを獲得したかなど気にしません。彼女が知りたいのは、ITに連絡せずに今日の午後、チームの誰かが設定を理解できるかどうか、実際の月額コストはいくらか、そして抽出したデータがZapierを経由せずにGoogle Sheetsに直接入るかどうかです。この比較記事は、そうした質問に答えます。そして、フォーチュン500社の調達チームにとって重要で、あなたが実際に率いているチームには関係のない質問には、あえて答えません。
重要なポイント
- 3つのツールはすべて「文書抽出」を販売していますが、価格モデルは大きく異なり、月400ページの場合、あるツールでは$19、別のツールでは$120になります。
- 重要なGoogle Sheetsの質問は「データが最終的にスプレッドシートに届くか」ではなく、抽出があなたのチームがすでに開いているシート内で行われるかどうかです。そして、ネイティブのサイドバーアドオンで答えているのはImageToTable.aiだけです。
- 機能比較表は忘れてください — 正しい質問があなたに合ったツールを選ばせてくれます:あなたのチームはスプレッドシート中心ですか、メール転送から文書を処理しますか、それともエンタープライズ向けのコンプライアンス認証が必要ですか?
この比較が存在する理由(取り上げない内容について)
ImageToTable、Nanonets、Parseurはすべて同じ中核的な問題を解決します。手動での再入力なしに、非構造化ドキュメントを構造化されたスプレッドシート対応データに変換することです。しかし、そのアプローチは3つの根本的に異なる角度から来ており、その違いは機能リストが示す以上に重要です。
この比較は、非技術系のチームリーダーの視点から書かれています。つまり、運用、財務、または小規模ビジネスを担当し、スプレッドシート中心のワークフロー内でドキュメント抽出を機能させる必要がある人の視点です。チームはおそらくGoogle Sheetsで作業しています。スタッフにトレーニングデータにラベルを付けたり、実装サイクルを待つ時間はありません。予算は現実的ですがゼロではありません。問題は「何が一番安いか」ではなく「実際の使用状況に対して適切な支出は何か」です。
取り上げない内容:これはAPIレイテンシ、モデルのベンチマークスコア、またはエンタープライズ展開アーキテクチャのレビューではありません。毎月100万ページを処理する本番パイプライン用の抽出APIを評価しているエンジニアリングリーダーであれば、あなたにとって重要な基準はここで扱うものとは異なります。また、これを「偏りのない第三者レビュー」と偽るつもりもありません。私たちはImageToTableを開発しました。しかし、他の2つのツールも使用し、そのユーザーと話し、公開ページから価格を調査しました。競合他社が優れている点があれば、それを明言します。
AIドキュメント抽出が実際に何をするのか、そして以前試したかもしれないOCRツールとどう違うのかをまだ理解している途中なら、ドキュメントデータ抽出の実際の意味とAI抽出が従来のOCRとどう違うかから始めてください。この記事は、抽出ツールが必要だとすでに認識しており、どれを選ぶかを決めていることを前提としています。
質問1:チームの誰かがトレーニングなしで今日すぐ使えますか?
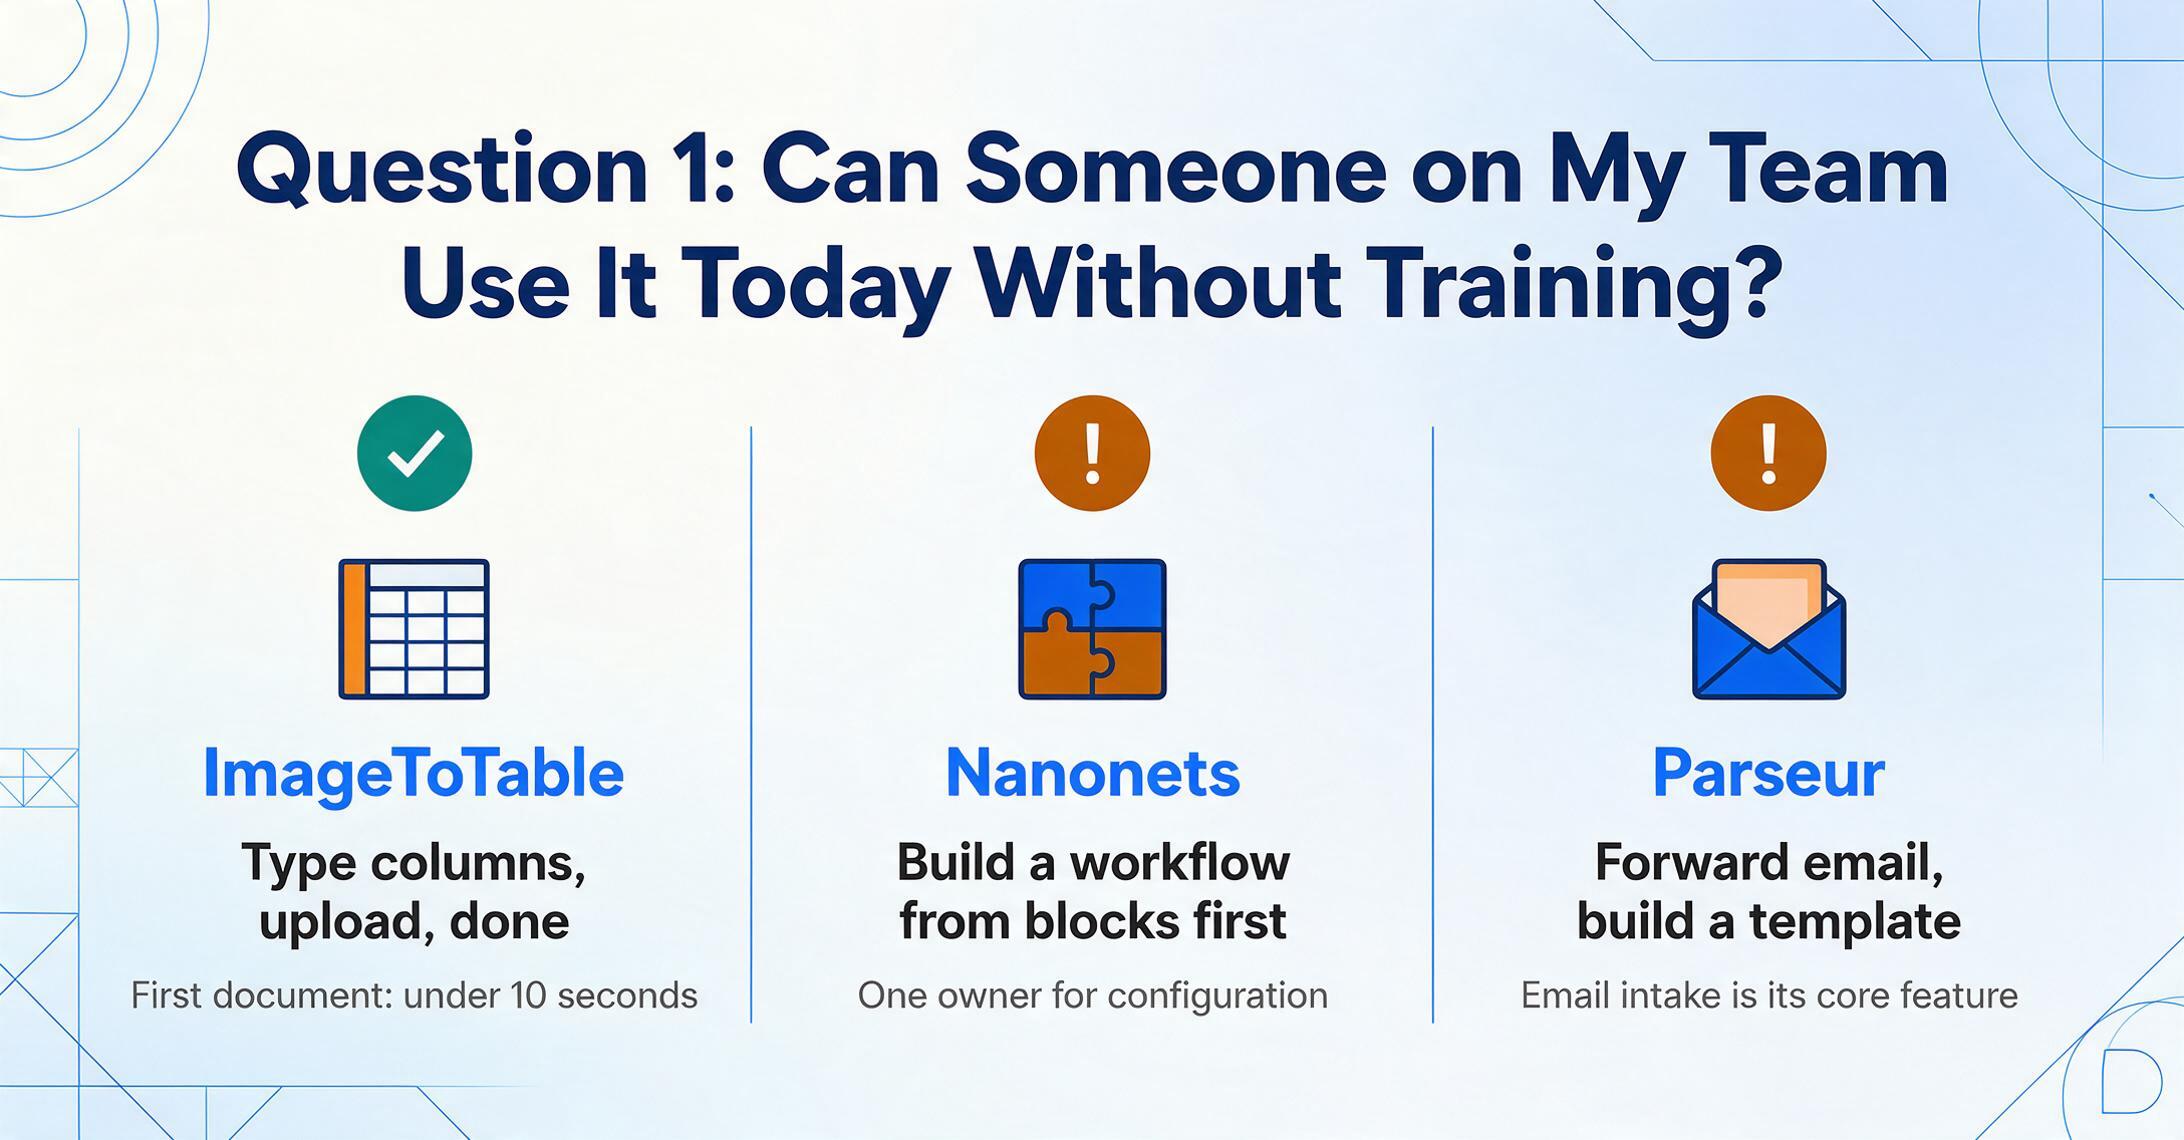
これはほとんどのツール評価を左右する質問です。製品が紙面上は強力でも、オンボーディングに1週間かかったり、チームにない概念を要求したりすれば、導入は最初の1か月で失敗します。3つのツールは、初回利用時の体験に対して明確に異なるアプローチを取っています。
ImageToTable:列名を入力して、アップロードして、完了
設定フェーズはありません。「請求書番号」「取引先」「日付」「合計」など、必要なフィールド名を入力し、文書をアップロードするだけで、AIがそれらの値を抽出します。入力した列名が出力テーブルのヘッダーになります。テンプレートの作成も、トレーニングデータのラベル付けも、「パースエンジン」の選択も不要です。列名を完全にスキップして、AIに文書の内容を自動検出させ、そこから調整することもできます。
このアプローチ(私たちがカスタム列抽出と呼ぶもの)が機能するのは、AIが「請求書番号」の意味を理解するからであり、ページ上の位置を理解するからではありません。フィールドの周りにボックスを描いたり、請求書の見た目をシステムに教えたりする必要はありません。取引先が請求書のレイアウトを変更しましたか?AIが適応します。PDFではなくスマホの写真が送られてきましたか?同じプロセスです。これが重要な理由について詳しくは、カスタム列抽出と文書全体のテーブル変換の比較をご覧ください。
最初の文書は通常10秒以内に処理されます。新しいチームメンバーは、ドキュメントなしでサインアップから抽出完了まで進めます。
Nanonets:ブロックでワークフローを構築
Nanonetsは「ブロック」で構成されたビジュアルワークフロービルダーを使用します。各ブロックは、文書取り込み、分類、データ抽出、検証、エクスポートという1つのステップを実行します。標準的な請求書ワークフローの場合、通常4〜6個のブロックを連結します。抽出ブロックはAI駆動で、テンプレート作成は不要です — ImageToTable.aiと同様に、文書からフィールドを自動検出します。
しかし、ワークフローを本番環境に移行するには、単純なアップロードと抽出のフローよりも多くの手順が必要です。ブロックの概念を理解し、各ステージを設定し、パイプラインをエンドツーエンドでテストする必要があります。このインターフェースは、ワークフロー自動化の概念に慣れた人向けに設計されており、そのようなユーザーにとっては直感的ですが、「フィールドを入力し、アップロードし、ダウンロードする」よりも学習曲線が急です。Nanonetsの公式ドキュメントでは、単純なワークフローであればセットアップ時間は数分と見積もられていますが、Redditのr/dataengineeringのユーザーは、複雑な複数文書タイプのパイプラインを調整するのに数日かかると報告しています。
Parseur:エンジンを選択し、メールボックスを設定
Parseurは「メールボックス」を中心に抽出を整理します。各メールボックスは、独自のフィールドスキーマと処理ルールを持つ1つの文書タイプを処理します。最初のアップロード時に、Parseurは抽出したいと思われるフィールドを自動識別します。その後、フィールドリストを調整し、フィールドごとに平易な英語の指示を書くことができます。Parseurは適切な解析エンジンを自動的に選択します — 画像中心のレイアウトにはVision AI、プレーンテキストコンテンツにはText AI、固定フォームにはテンプレートを使用します。
最初のアップロード時の自動フィールド検出は本当に役立ち、初期の試行錯誤を減らします。ただし、メールボックス+エンジン+後処理の構造には、非技術系ユーザーが学ぶ必要のある概念が導入されています。テンプレートエンジンはオプションですが、文書レイアウトごとにビジュアルテンプレートを作成する必要があります — 毎回同一の出力が必要な場合には便利ですが、異なる形式の多くのベンダーから文書が届く場合は追加の作業になります。Parseurの公式ドキュメントによると、単純なユースケースではほとんどのワークフローが10分以内に稼働します。
| ImageToTable | Nanonets | Parseur | |
|---|---|---|---|
| 初回抽出までの時間 | 1分未満 | 5〜15分(シンプルなワークフロー) | 2〜10分(最初のメールボックス) |
| セットアップ方法 | 列名を入力 → アップロード | ビジュアルワークフロービルダー(ブロック) | メールボックス+フィールド指示 |
| テンプレートは必要? | 不要 | 不要(AIが自動でフィールドを検出) | 任意 — AIはテンプレートなしで動作 |
| トレーニングデータは必要? | 不要 | 標準抽出には不要 | 不要 |
| レイアウト変更への対応 | 自動対応 — セマンティック抽出 | 自動対応 — AIが適応 | AIエンジンが適応;テンプレートは更新が必要 |
主な要件が、技術に詳しくないチームメンバーを5分以内に使いこなせるようにすることなら、ImageToTableが最短ルートです。Parseurのメールボックスという概念は次に取り組みやすい方法です — 初回アップロード時の自動フィールド検出により、「フィールドに何と名前を付けるか」という手間が省けます。Nanonetsは最もワークフロー制御に優れていますが、複雑さというコストが伴い、すでに自動化ツールに慣れた担当者がチームにいる場合に適しています。
質問2:実際に毎月いくら支払うことになるのか?
文書抽出の料金モデルは驚くほど異なります。そして、その違いは表示価格よりも重要です。あるツールはページごとに課金し、別のツールはAI操作ごとに課金し、また別のツールは定額の月額料金を請求します。同じ量の文書でも、どのモデルを利用しているかによって、請求額は大きく異なる可能性があります。
3つの料金モデルの説明
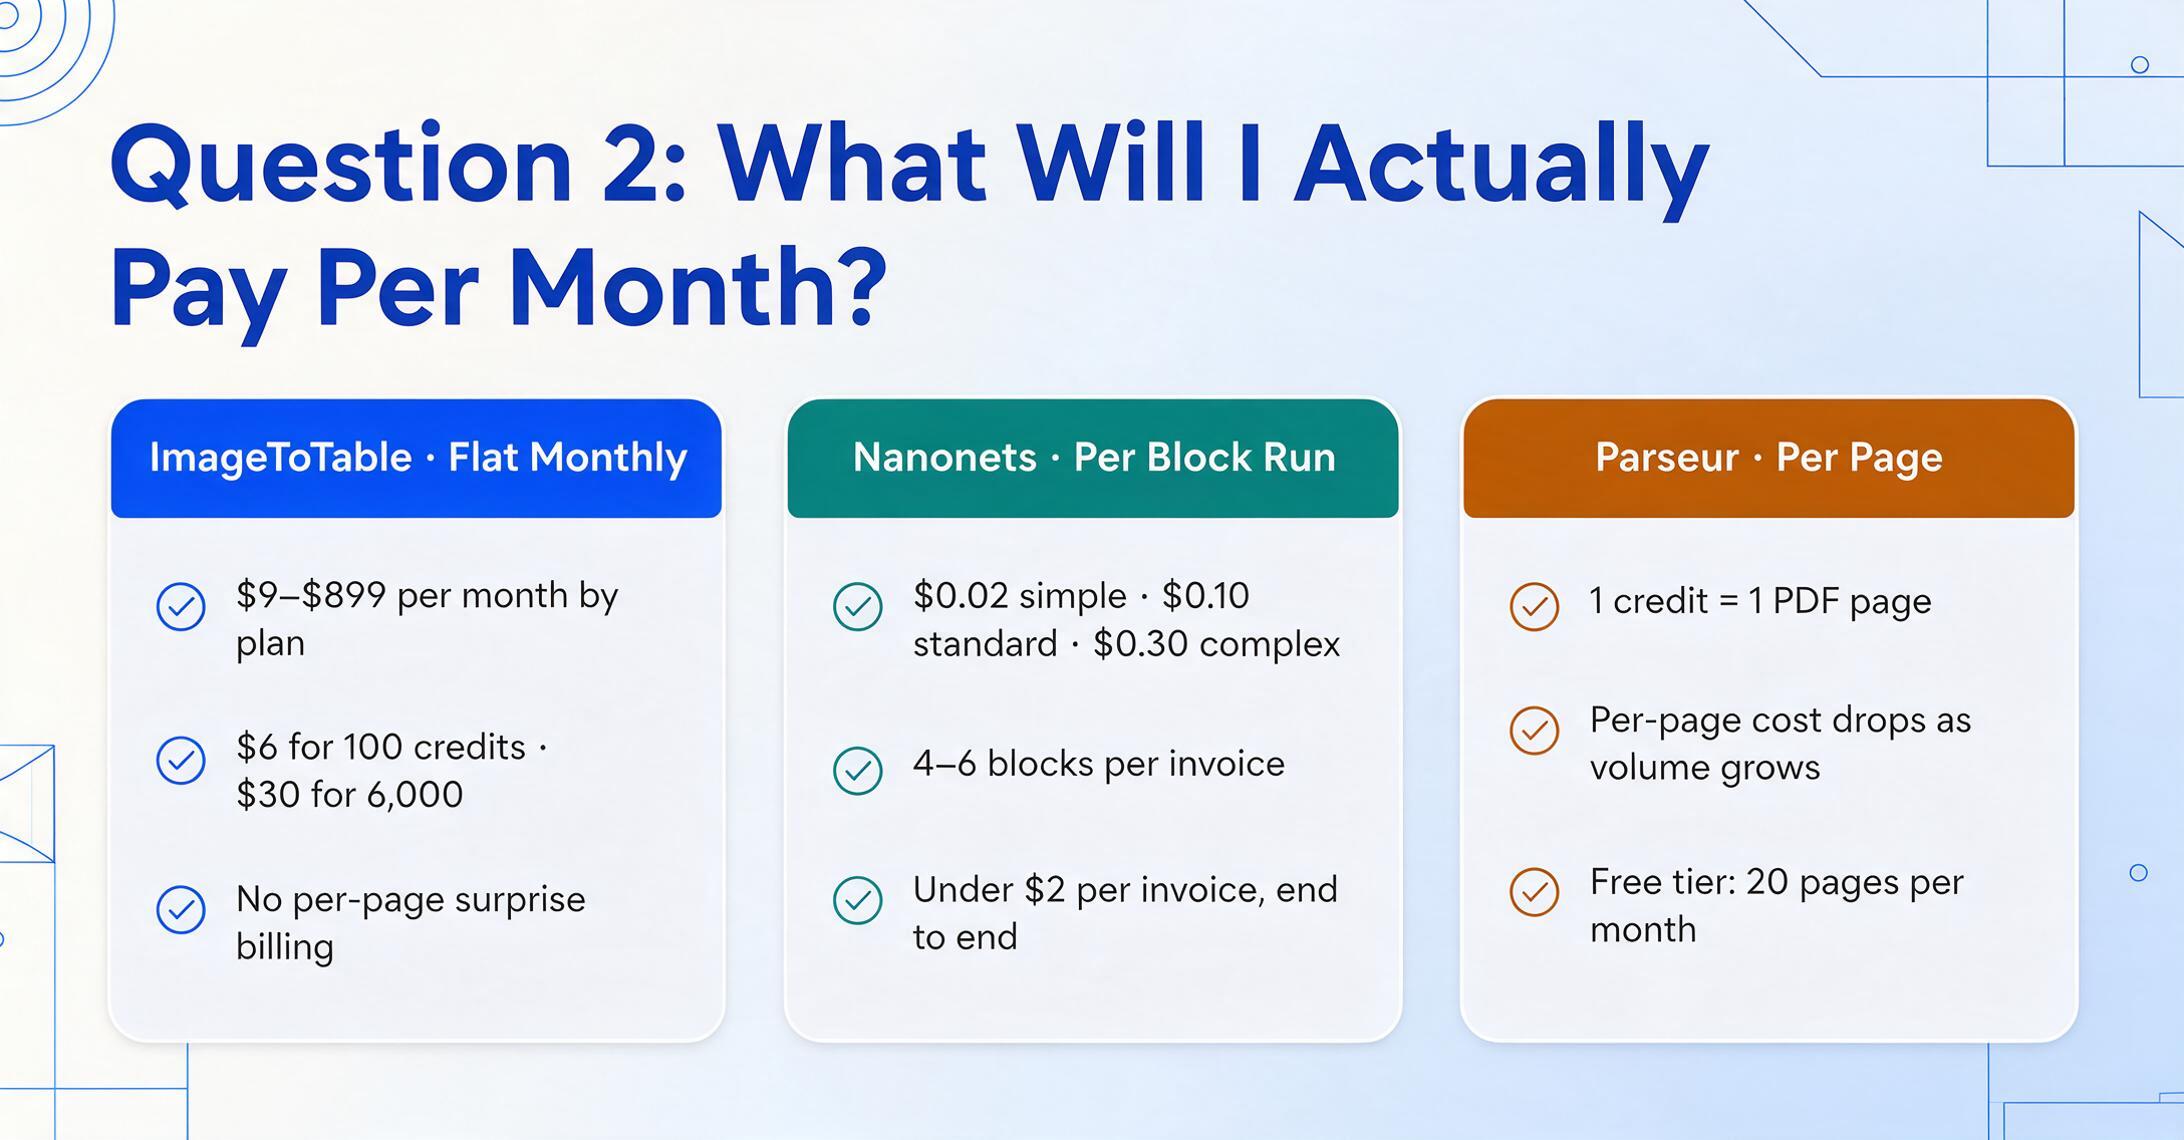
ImageToTable:クレジット制の月額サブスクリプション。 定額の月額料金(プランに応じて$9〜$899)を支払い、一定数のクレジットを受け取ります。各クレジットは、1枚の画像または1ページのPDFを処理します。未使用のクレジットは繰り越されませんが、ページごとの予期しない請求はありません。また、サブスクリプションなしで、一回限りのクレジットパック(100クレジットで$6、最大6,000クレジットで$300)を購入することもできます。無料の毎日クォータを使用すると、支払い前に実際の文書でテストできます。
Nanonets:ブロック単位の従量課金。 Nanonetsは「ブロック実行」ごとに課金します。ワークフローの各ステップは、異なるレートでクレジットを消費します。単純な操作(フォーマット、ルーティング)は$0.02、標準的なAI(分類、検証)は$0.10、複雑なAI(データ抽出)は$0.30です。一般的な請求書ワークフローでは4〜6ブロックを使用します。Nanonetsの見積もりでは、請求書1件あたりのエンドツーエンドのコストは$2未満とされています。スタータープランには$200分の無料クレジットが含まれています。ボリュームディスカウントと共有クレジットを備えたチームプランは、営業への問い合わせが必要です。
Parseur:ページ単位のボリューム料金。 Parseurは処理されたページごとに課金し、ページあたりのコストはボリュームが増えるにつれて減少します。1クレジット=PDF1ページです。メールとスプレッドシートは、長さに関係なく1ページとしてカウントされます。無料ティアには月20ページが含まれます。有料プランはベースティアから始まり、セルフサービスで月100万ページまで拡張でき、エンタープライズでは最大1,000万ページを処理できます。Parseurは各ボリュームティアの正確なページ単価を公開していません。価格スライダーで見積もりはできますが、最終的な価格はサインアップ後に表示されます。Parseurの価格ページにあるROI計算ツールを使用すると、文書量と従業員数に基づいてコストをモデル化できます。
各モデルの3つの現実的なボリュームでのコスト
| 月間ボリューム | ImageToTable | Nanonets(推定) | Parseur(推定) |
|---|---|---|---|
| 月50ページ | $0(無料の日次クォータ)または月額$9(Basic) | $0(Starterクレジットでカバー) | 低価格の有料プラン(無料20ページ超過分) |
| 月400ページ | 月額$19(Pro、400クレジット)— 1ページあたり約$0.05 | 月額約$60〜$120(抽出中心のワークフローで1ページあたり約$0.15〜$0.30) | 有料プラン — 月額$40〜$80と推定 |
| 月3,000ページ | 月額$149(Growth、3,000共有クレジット)— 1ページあたり約$0.05 | 月額約$150〜$300(ボリューム割引あり、営業に問い合わせ) | スケールプラン — 月額$150〜$300と推定 |
ImageToTableの価格はimagetotable.ai/upgrade_serviceの公開価格ページに基づく。Nanonetsの推定はnanonets.com/pricingの公開ブロック単価に基づき、一般的な4〜6ブロックの請求書ワークフローを想定。Parseurの推定はparseur.com/pricingのボリュームスライダー範囲に基づく — 正確な1ページあたりの価格はサインアップが必要。すべての価格はUSD。NanonetsとParseurの推定は抽出のみ — アドオン機能には追加コストがかかる場合あり。
ブロック単位のモデルは、サブスクリプションモデルにはない予測不可能性をもたらします。ある月はチームが標準的な1ページの請求書を400件処理するだけで済むかもしれません。しかし翌月、ベンダーが複数ページの明細書と契約書を送ってきて、それぞれが想定以上のブロックを消費するかもしれません。請求額が変わり、届くまでいくらになるかわかりません。文書タイプとボリュームが予測可能なチームにとっては管理可能です。しかし、短い文書と長い文書が混在し、供給元が変わるチームにとっては、サブスクリプションモデルの方が予算を立てやすいでしょう。
NanonetsとParseurが優位に立つ価格面が1つあります:高ボリューム割引です。毎月10,000ページ以上を安定して処理している場合、ボリューム階層型の価格設定は、1ページあたりのコストで定額サブスクリプションモデルを上回る可能性があります。しかし、ほとんどの非技術系チームが運用するボリューム範囲(月50〜3,000ページ)では、ImageToTableの定額サブスクリプションの方が通常は安価です。
質問3:Google Sheets内で動作しますか?
ワークフロー全体がGoogle Sheets内で完結しているチームにとって、統合の質問は「データは最終的にスプレッドシートに届くか?」ではなく、「すでに作業しているスプレッドシートから離れずにデータを抽出できるか?」です。ネイティブアドオンとZapier/ウェブフックパイプラインの違いは、抽出がワークフローの一部になるか、誰かが覚えておかなければならない別のステップになるかを決定づけます。
ImageToTable:ネイティブGoogle Sheetsサイドバーアドオン
ImageToTableは、完全な抽出エンジンをSheetsサイドバーとして埋め込むGoogle Workspace Marketplaceアドオンを提供しています。列を定義し、ドキュメントをアップロードすると、抽出されたデータがアクティブなシートに直接表示されます。ファイルのエクスポート、ダウンロードと再アップロード、タブの切り替えは一切不要です。列テンプレートは保存してバッチ間で再利用できるため、「請求書抽出」テンプレートは毎月同じように機能します。
このアドオンはアカウントモードで動作します。API Keyを一度接続すると、Sheetsの抽出履歴とテンプレートがウェブアカウントと同期されます。使用量はプランの割り当てにカウントされます。これは、チーム全体が同じ共有スプレッドシートからアドオンを使用できることを意味するため重要です。抽出されたデータは、全員がすでに作業している場所に表示されます。
Nanonets:Zapier、API、またはエクスポート
NanonetsにはネイティブのGoogle Sheetsアドオンはありません。データがGoogle Sheetsに到達する経路は3つあります。Zapier/Make/Power Automateコネクタ(ミドルウェアステップと潜在的な遅延が追加されます)、REST API(パイプラインのセットアップにエンジニアリング作業が必要)、またはCSV/Excelへの手動エクスポート(自動化の目的を無効にします)。
既存の自動化スタックを持つチームにとって、Zapierルートは問題なく機能します。一度設定すれば、抽出されたデータは自動的にSheetsに流れます。ただし、初期設定にはNanonetsのワークフロービルダーとZapierのトリガー/アクションモデルの両方を理解する必要があります。これは、すぐに使えるサイドバーとは異なります。
Parseur:Webhook、Zapier、または直接同期
Parseurはネイティブ統合として「Google Sheetsライブ同期」を提供しています。接続すると、解析されたデータが指定したシートに自動的に同期されます。これはNanonetsの中間層アプローチよりもネイティブに近い体験ですが、それでもSheets内のワークフローではなく、別途設定が必要なステップです。ParseurはZapier、Make、Power Automate、n8nコネクタ経由でもGoogle Sheetsをサポートしています。
直接同期では、接続を一度設定すれば、新しいドキュメントが処理されるたびにデータが自動的に流れます。ただし、抽出の管理はParseurのWebインターフェースから行う必要があります。Sheetsを離れずに使えるサイドバーはありません。
Google Sheetsがチームの作業拠点なら:ImageToTableのネイティブサイドバーが最も密接な統合です。Parseurの直接同期は、自動化された「設定して放置」パイプラインに強い第2の選択肢です。Nanonetsは中間ステップが最も多いものの、ワークフローがSheets以外の複数の宛先に及ぶ場合に最も柔軟性を提供します。
質問4:各ツールが得意とするドキュメントタイプは?
3つのツールすべてが「あらゆるドキュメント」に対応すると主張しています。実際には、それぞれに得意分野と苦手分野があり、最適なパフォーマンスを発揮するケースと苦戦するケースがあります。これを理解することは勝者を決めることではなく、チームが実際に処理するものにツールを合わせることです。
| 文書機能 | ImageToTable | Nanonets | Parseur |
|---|---|---|---|
| 入力形式 | PDF、JPG、PNG、WebP、AVIF、スクリーンショット | PDF、画像、Word、Excel — 幅広い形式に対応 | PDF、画像、メール、スプレッドシート、25以上の形式 |
| メール取り込み | 対応 — 専用受信トレイ、バインド済みテンプレートで自動処理 | 対応(メール統合) | 主要機能 — メールを専用メールアドレスに転送 |
| 手書き文字サポート | あり — VLMによる意味理解 | 目立った機能としては提供なし | Vision AIが手書き文字、チェックボックス、印鑑を認識 |
| テーブル / 明細行抽出 | あり — 列ベース + 計算列で計算に対応 | あり — 出力時にテーブル構造を保持 | あり — 各行が個別レコードになり、行数の変動に対応 |
| 多言語ドキュメント | 主要言語に対応 | 100以上の言語 | 200以上の言語(OCR); AIエンジンは主要言語に対応 |
| レイアウト保持(Wordに変換) | Wordに変換モード — レイアウトを完全復元して編集可能なWordに変換 | Markdown出力でレイアウトを保持 | 主要機能ではない — 出力は構造化データ |
| チェックボックス / 印鑑 / 署名検出 | あり — チェックボックス状態、印鑑、署名 | バーコード & 署名検出はGrowth+プランで対応 | Vision AIがチェックボックスと印鑑を認識 |
| コンプライアンス & セキュリティ認証 | HTTPS暗号化、暗号化ストレージ、自動削除 | SOC 2 Type II、HIPAA、GDPR、ISO 27001 | GDPR準拠(EUホスティング)、SOC 2 Type II取得中 |
メール取り込みの違いは、かつてこれらのツール間の明確な差でしたが、今はそうではありません。Parseurはメールを主要なドキュメントソースとして構築されました。請求書や領収書を専用のメールアドレスに転送すると、自動的に処理されます。ドキュメントが主にメールで届くチーム(ベンダー請求書がap@に送信される、経費領収書がスタッフによって転送される)にとって、これは真の生産性向上です。Nanonetsも同様のメール統合を提供しています。ImageToTableもEmail Inboxを通じてこれを実現しました。すべてのアカウントに専用の受信トレイアドレスが付与され、テンプレートをバインドしたAuto-Processを有効にすると、メールが届いた瞬間に抽出が開始され、オプションの送信者ホワイトリストで無関係なメールをキューから除外できます。Email Inboxは添付ファイル、メール本文、またはその両方を読み取るように設定できるため、転送された請求書PDFと、メッセージ本文に数字を直接入力するサプライヤーの両方のケースをカバーします。
コンプライアンス面では、Nanonetsは別格です。SOC 2 Type II、HIPAA、GDPR、ISO 27001の認証は、医療、金融、または規制されたデータ取り扱い要件のある業界にいる場合に重要です。ParseurはGDPRネイティブなインフラ(EUホスト)を提供し、SOC 2は取得中です。ImageToTableは転送中および保存中のデータを暗号化し、設定可能な自動削除機能を備えています。これはほとんどのSMBのユースケースには十分ですが、ベンダーレビュー中にコンプライアンス項目をチェックする必要がある組織には不十分です。
質問5:チームの成長に対応できますか?
2人で月100件の請求書を処理するのに適したツールでも、チームが8人に増えて月2,000件を処理するとなると、限界が来るかもしれません。成長に関する問いは、単なる処理量だけではありません。チームでのアクセス、共有リソース、そしてツールの上限が、チームの成長曲線の上にあるか下にあるかが重要です。
バッチ処理:一度に何件処理できますか?
ImageToTableはバッチアップロードに対応しており、複数ファイルを一度にドロップし、列を一度定義するだけで、統合された単一の出力テーブルが得られます。アップロードの同時実行数はプラン階層に応じて変わり、Freeプランでは1件、Teamプランでは3件までです。バッチ処理の真の価値は統合にあります。15社の異なるベンダーからの50件の請求書が、ファイルごとの設定なしに、一貫した列ヘッダーを持つ1つのスプレッドシートに抽出されます。コレクションリンク機能は、競合他社にはない成長の側面を追加します。クライアントや現場スタッフがあなたの処理キューに直接ドキュメントをアップロードできる共有リンクを生成できます。
Nanonetsはワークフローエンジンを通じてバッチ処理を処理します。ドキュメントは設定されたブロックを順に流れ、アカウントごとのキューが他の顧客から処理を分離します。Teamプランには共有クレジットとStarterプランで最大3ユーザーが含まれます。GrowthプランとEnterpriseプランでは、分析、レポート、最大40%のボリュームディスカウントが追加されます。月をまたいで抽出スループットと精度メトリクスを追跡する必要があるチームにとって、Nanonetsの分析レイヤーは3つの中で最も強力です。
Parseurはメールボックスを通じてドキュメントを処理し、抽出ごとに無制限のフィールドを提供します。Scaleプラン(月10,000クレジット以上)では、マルチユーザーアカウント(最大100ユーザー)、高度な後処理(カスタムビジネスロジック用のPythonコード)、無制限のドキュメント保持が利用可能になります。スケール時のParseurの独自の強みは、メール取り込みパイプラインです。ドキュメント量が月数千件に成長すると、メール転送による自動取り込みの価値は低下するどころか、むしろ高まります。
ImageToTableが競合他社にはない優位性を持つ成長の側面:コレクションリンクを使えば、チームを増やさずにドキュメントの受け入れ量を増やせます。ベンダーに請求書を催促する人を雇ったり、従業員に経費の領収書の提出を促したりする代わりに、リンクを送るだけです。ドキュメントはあなたの元に届きます。これは別の種類のスケーラビリティです。より速くドキュメントを処理することではなく、より少ない摩擦でドキュメントをパイプラインに取り込むことです。
各ツールを選ぶタイミング:実践的な判断ガイド
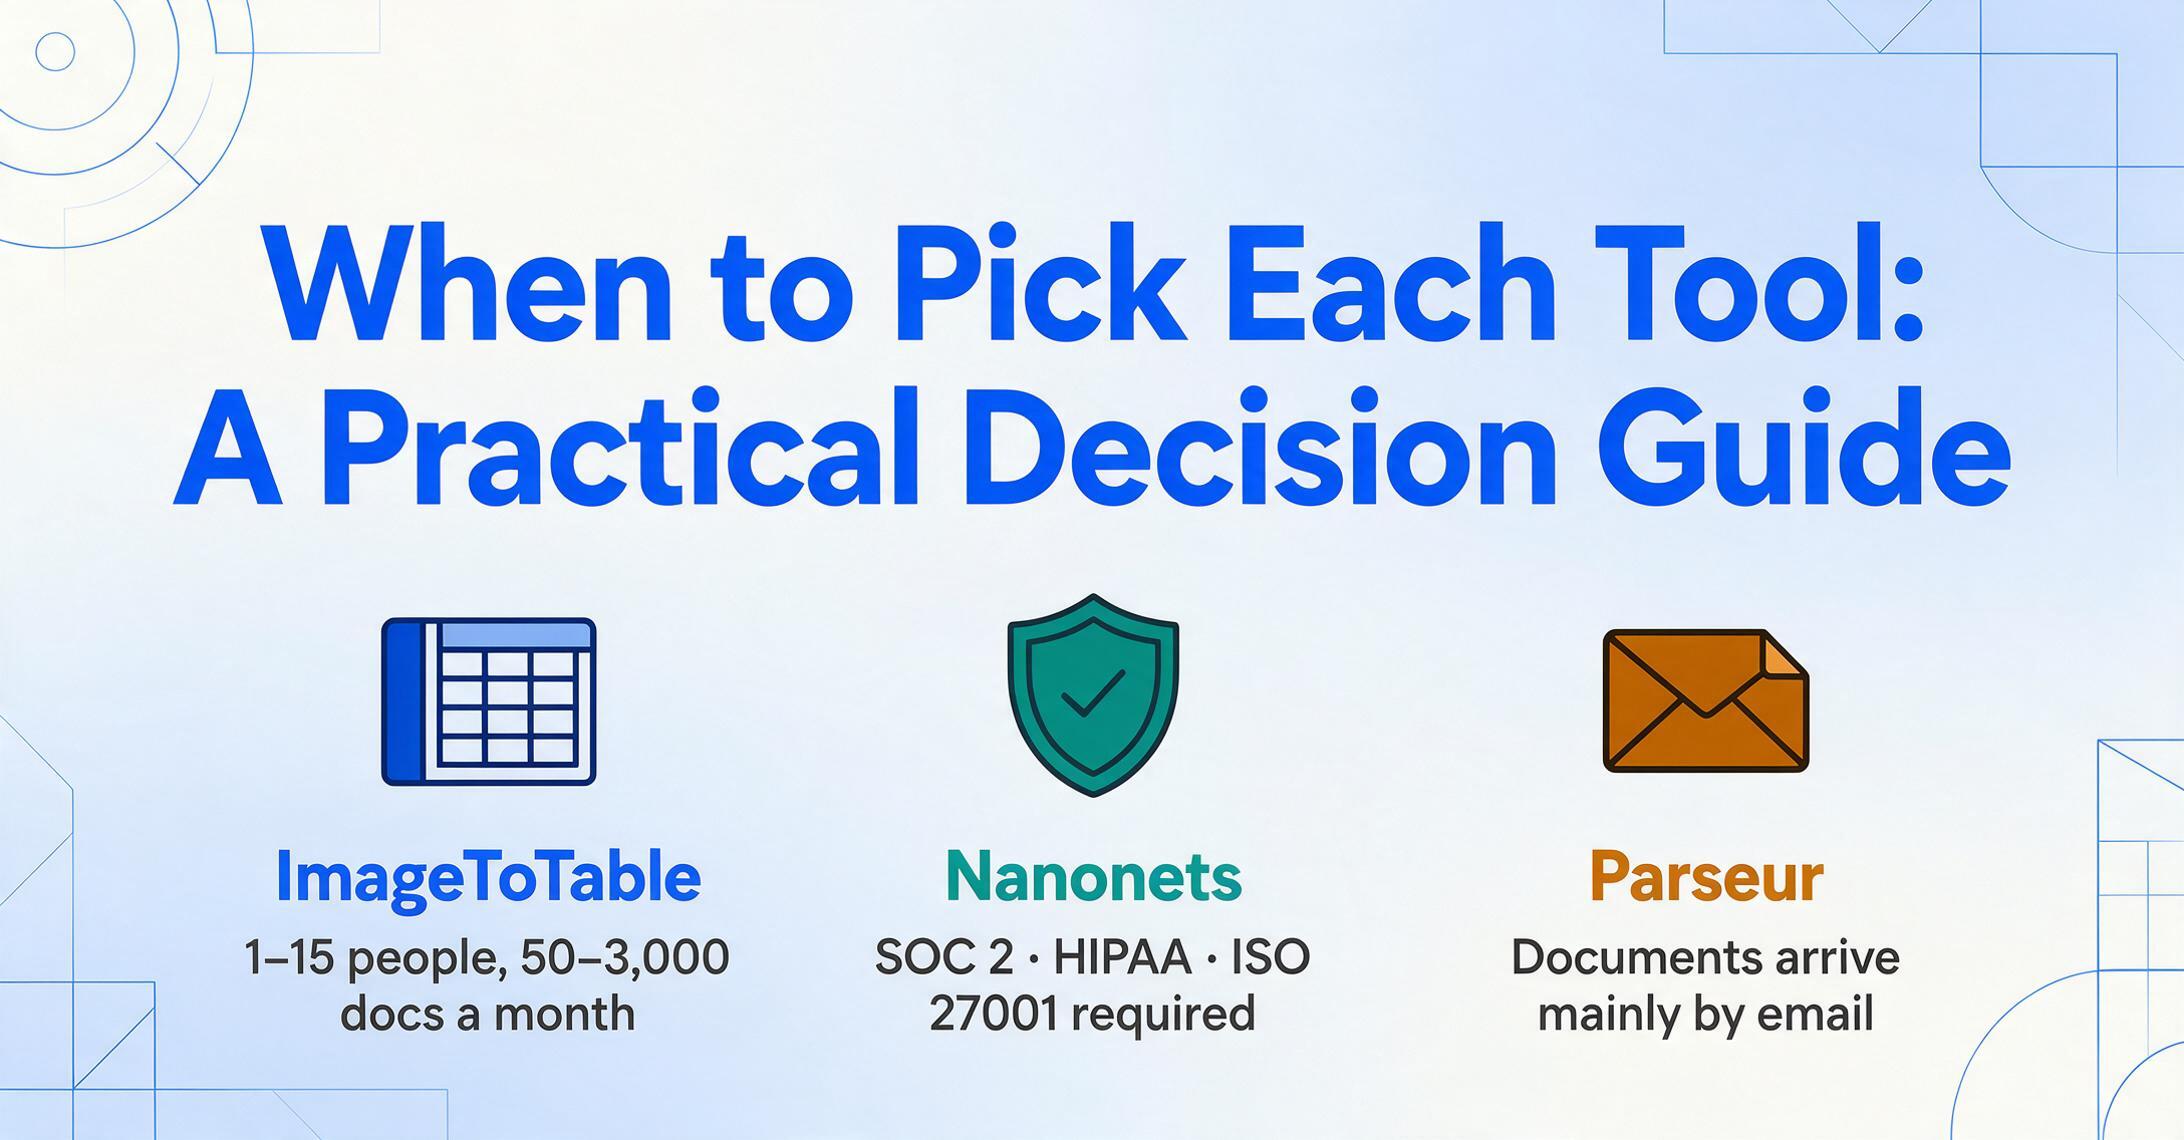
すべての面で優れたツールはありません。最適な選択は、チームが何を最も重視し、どのようなトレードオフを受け入れるかによって決まります。以下は、私たちがよく見かける一般的なシナリオでの判断の分かれ目です。
チームがGoogle Sheetsで作業しており、今すぐ使える抽出機能が必要ならImageToTableを選びましょう。セットアップ不要、トレーニング不要、IT部門の関与も不要です。
最適なケース: 毎月50〜3,000件のドキュメントを処理する小規模〜中規模チーム(1〜15人)。Sheetsのサイドバーが欲しいだけで、管理するタブを増やしたくない方。ドキュメント単位の最適化よりも、予測可能な月額料金を重視する方。複数のソースからドキュメントが届き、追跡せずにまとめられるコレクションリンクが必要な方。レイアウトを保持したWord出力が時々必要な方。SOC 2やHIPAAのようなNanonetsレベルのコンプライアンス認証は不要で、自動メール取り込みはEmail Inboxで対応済みの方。
コンプライアンス、エンタープライズ統合、ワークフロー自動化が必須条件ならNanonetsを選びましょう。
最適なケース: SOC 2 / HIPAA / ISO 27001コンプライアンスが必要な中規模〜エンタープライズチーム。Google Sheetsだけでなく、SAP、Oracle、Salesforceに接続する方。抽出スループットと精度の分析が必要な方。ワークフロービルダーインターフェースに慣れており、設定を担当できる人が少なくとも1人いる方。ボリュームがボリューム層別料金を正当化する規模の方。抽出パイプラインにバーコード検出やカスタムPythonブロックが必要な方。
ドキュメントが主にメールで届き、手間いらずの自動パイプラインと高ボリューム向け料金が必要ならParseurを選びましょう。
最適なケース: 毎月数百〜数千件の標準化されたドキュメントをメールで受け取るオペレーションチーム(ap@宛のベンダー請求書、出荷通知、注文確認など)。AI抽出の柔軟性と、固定フォーマットのドキュメントに対するテンプレートベース抽出の信頼性の両方が必要な方。EUホスト型インフラによるGDPRコンプライアンスが必要な方。ParseurのWebダッシュボードから抽出を管理し、同期またはZapier経由でSheetsに出力を接続することに抵抗がない方。ボリュームが十分に多い(月1,000ページ以上)ため、ページ単価制が有利に働く方。
私たちが使うなら:偏っているけど正直なおすすめ
私たちはImageToTableを開発しているので、どちらに偏るかはおわかりでしょう。でも、ここでは他のツールを実際におすすめするケースをお伝えします——忠誠心のために間違ったツールを選ぶのは誰の得にもなりませんから。
チームにワークフロー自動化ツールの経験者がいて、書類が主にメールで届くなら、Parseurのメール転送パイプラインとテンプレート/AIハイブリッドエンジンの組み合わせは、本当に打ち負かしがたいです。「メールボックスに転送→自動抽出→Sheetsに同期」という流れは、その特定の取り込みパターンにおいて、競合他社のどのアプローチよりも多くのステップを削減します。
医療、法律、金融の分野で、コンプライアンス認証が必須条件となる規模なら、NanonetsのSOC 2 + HIPAA + ISO 27001スタックは、独自のカテゴリーに位置づけられます。また、セルフサービスツールにはないエンタープライズ統合(SAP、Salesforce、Oracle)も必要になるかもしれません。その規模では、ボリュームディスカウント付きのブロック単位の価格設定が、定額サブスクリプションモデルよりも経済的になり得ます。
しかし、この質問をしているほとんどの人が実際に運営しているチーム——3〜15人、月100〜3,000件の書類、Google Sheetsをハブとして使用、専任の自動化エンジニアなし、法務からのコンプライアンス認証チェックリストなし——にとって、ImageToTableは彼らが必要とする特定のこと(列名ベースの抽出によるスプレッドシートへの取り込み)を、ツールを開いてから使えるデータを得るまでの摩擦が最も少ない方法で実現します。まだ迷っているなら、AI書類抽出を最大限に活用するための実践的なヒントは、どのツールを選んでも役立ちます。
FAQ
これらのツールには無料トライアルがありますか?
はい、3つすべてにあります。ImageToTableには、サインアップ不要の毎日の無料クォータがあり、すぐに実際の書類を処理できます。Nanonetsは、新しいアカウントごとに$200の無料クレジットを提供しており、数千件の書類を処理するのに十分です。Parseurの無料プランには、月20ページの全機能アクセスが含まれています。いずれも開始にクレジットカードは不要です。
最も精度が高いツールはどれですか?
精度はツールよりも、文書の種類と品質に左右されます。Nanonets は独立した IDP Leaderboard のベンチマーク文書抽出精度で第1位にランクされています。Parseur のテンプレートエンジンは固定レイアウトで毎回同じ出力を生成し、Vision AI は可変レイアウトに対応します。ImageToTable は VLM ベースのセマンティック抽出により、印刷されたテーブルデータで最大99%の精度を報告しています。どのツールでも、手書き文書、低品質スキャン、高密度レイアウトは精度を低下させます。比較する最善の方法は、各ツールを自分の文書でテストすることです。3つすべて無料の開始ポイントを提供しています。
これらのツールは GDPR に準拠していますか?
Parseur は GDPR に最も強いです。インフラは EU ホスティングで、設計上 GDPR ネイティブです。Nanonets は Enterprise プランでデータ所在地オプション(米国、EU、APAC)を備えた GDPR 準拠を提供しています。ImageToTable は転送中および保存中のデータを暗号化し、設定可能な自動削除機能を備えています。ほとんどの SMB ユースケースに適していますが、正式な GDPR 認証はありません。文書化された認証を伴う GDPR 準拠が必須要件である場合、Parseur または Nanonets Enterprise がより安全な選択肢です。
コードを書かずにこれらのツールを使用できますか?
はい、3つすべてノーコード運用向けに設計されています。ImageToTable: テキストフィールドに列名を入力し、ファイルをアップロードして、結果をダウンロードします。Nanonets: ドラッグ&ドロップブロックによるビジュアルワークフロービルダー。コーディングは任意です(上級者向けにカスタム Python ブロックも利用可能)。Parseur: Web UI を通じた平易な英語のフィールド指示で、Scale+ プランではオプションの Python 後処理も利用できます。開始にプログラミングは不要ですが、プログラムによるアクセスを希望するチーム向けに、3つすべて API を提供しています。
1つのバッチに異なる文書タイプを混在できますか?
ImageToTable: はい。1つのバッチに請求書、領収書、明細書を混在してアップロードし、それぞれから同じ名前の列を抽出できます。AI は文書タイプに関係なく「日付」や「合計」を特定します。Nanonets: ワークフローは通常、文書タイプごとに設定されます。分類ブロックを使用して、異なる文書を異なる抽出パスにルーティングします。Parseur: 各メールボックスは1つの文書スキーマ向けに設計されていますが、Vision AI と Text AI はそのタイプ内のレイアウトのばらつきに対応できます。根本的に異なる文書タイプ(請求書+契約書)を1つのメールボックスに混在させることは想定されたユースケースではありません。
注意すべき隠れたコストはありますか?
Nanonetsのブロック単位モデルは、予期しない請求が発生する可能性が最も高く、複雑なドキュメントは想定以上のブロックを消費し、単純なものよりコストがかかります。Parseurのページ単位モデルはより予測しやすいですが、複数ページのPDFはコストが倍増します(10ページの明細書は1ページの請求書の10倍のコスト)。ImageToTableのサブスクリプションモデルは最も予測しやすく、ドキュメントの複雑さやページ数に関係なく固定月額料金を支払います。ただし、クレジット上限を超える場合は、プランのアップグレードまたは追加クレジットの購入が必要です。