AI文書抽出でクリーンで正確な出力を
得る方法
AI文書抽出は従来のOCRとは異なります。ページ上のすべてをテキストストリームに出力する代わりに、特定の列を定義すると、モデルが任意の文書レイアウトからそのフィールドを見つけ出します。このシフトにより、より多くの制御があなたの手に委ねられますが、出力の品質は列の定義方法に大きく依存することも意味します。ここで紹介するテクニックが、乱雑な最初のパスと、クリーンで分析可能なテーブルの違いを生み出します。
重要なポイント
- カラム名はスプレッドシートのラベルではありません。それぞれがAIがバッチ内のすべての文書にわたって読み取り、解釈し、実行する検索指示です。
- 行内の単一のフィールドが欠落しても空白セルは生成されません。代わりに、右側のすべての値が1列分静かにシフトし、そのずれは下流で照合が失敗するまで検出されません。
- ImageToTable.aiは抽出された各値をその列インデックス番号とペアにするため、フィールドが欠落すると、行全体が左にシフトする代わりに、正しい位置に目に見える空のセルが生成されます。
カラム名は指示である
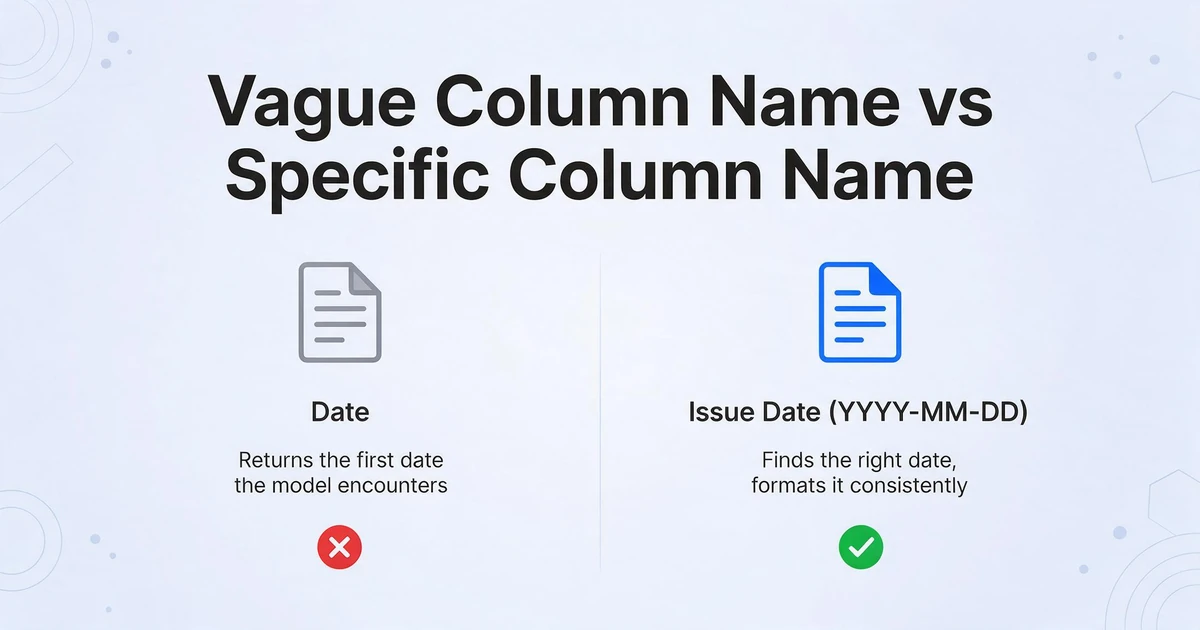
AI抽出ツールにカラム名を入力するとき、それは単にスプレッドシートの列にラベルを付けているだけではありません。モデルに何を探すべきか、どう識別するか、結果をどう整形するかを指示しているのです。モデルはカラム名を指示として読み取り、バッチ内のすべてのドキュメントに適用します。
つまり、曖昧なカラム名は曖昧な出力を生みます。5つの異なる日付がある請求書で「Date」と指定すると、モデルが最初に遭遇した日付が返ってきます。具体的なカラム名は具体的な出力を生みます。「Issue Date (YYYY-MM-DD)」と指定すれば、モデルはどの日付を探すべきか、どう整形すべきかを理解します。
以下の8つのヒントは、カラム名をより効果的に活用する主な方法をカバーしています。形式の制御から曖昧さの解消、バッチ処理での静かなエラーを防ぐ構造的テクニックまでです。
より良い抽出結果のための8つのヒント
1. カラム名に形式要件を組み込む
「Date」ではなく「Date (YYYY-MM-DD)」と書きましょう。「Amount」ではなく「Amount (number only, no currency symbol)」と書きましょう。モデルはカラム名をフィールド識別子と形式指示の両方として読み取ります。
これは重要です。なぜなら、異なるソースドキュメントは同じ値を異なる形式で記載しているからです。「March 15, 2024」「15/03/2024」「2024-03-15」はすべて同じ日付を3つの形式で表しています。カラム名を「Date (YYYY-MM-DD)」にすれば、バッチ内のすべてのドキュメントで出力が1つの形式に統一され、後処理は不要です。同じ原則が金額にも当てはまります。「Total Amount (number only, 2 decimal places)」と指定すれば、通貨記号や桁区切りが除去され、クリーンアップなしで数値演算に使える列になります。
2. 文書に同じフィールドタイプが複数存在する場合は、曖昧さを解消する
発注書には、注文日、納品日、支払期日があります。「日付」とだけ指定すると、モデルが最初に見つけた日付が返されます。「注文日」「納品日」「支払期日」を3つの別々のカラムとして指定してください。具体性があることで、抽出が毎回正しい値に導かれます。
これは金額(請求書合計 vs. 支払済み預り金 vs. 残高)、名前(販売元 vs. 受取人 vs. 連絡先)、参照番号(発注番号 vs. 請求書番号 vs. 追跡番号)にも同様に当てはまります。文書に複数回出現し得るフィールドタイプには、曖昧さを解消する名前が必要です。
3. 推論・分類フィールドには自然言語を使用する
文書がフィールドを何と呼んでいるかを知る必要はありません。必要なものを説明すればよいのです。「取引タイプ(借方または貸方)」は、異なる銀行が同じ概念を「引き出し/預け入れ」「DR/CR」と呼んだり、単に正負の金額で表したりする場合でも、カラム名として機能します。モデルはソース文書に対するキーワード一致ではなく、意味理解に基づいて各取引を分類します。
これは条件付きフィールドにも有効です。「ステータス(支払済みまたは未払い、支払スタンプまたは確認テキストに基づく)」は有効な指示です。モデルは文書を評価して分類ロジックを適用します。文字通りそのラベルで存在するフィールドに限定されるわけではありません。
4. 曖昧なカラムに例となる値を追加する
フィールド名だけでは複数の解釈が可能な場合、括弧内に例となる値を追加することで曖昧さが解消されます。モデルはその例をキャリブレーション信号として扱います。これは言語モデルのプロンプトにおけるfew-shotプロンプティングと同じ仕組みです。
これが一貫して役立つ3つのケース:
- 特定の分類体系を持つ分類フィールド:「経費カテゴリ(例:家賃、光熱費、給与、旅費)」— 例となる値が使用するカテゴリを正確に定義し、モデルが独自のカテゴリを発明するのを防ぎます。例がないと、異なるタイミングで処理された2つのバッチで、一貫性のないカテゴリ名が生成される可能性があります。
- 一貫性のないソース間での形式の固定:「電話番号(例:+1-415-555-0123)」— 異なる国やシステムの文書が異なる形式を使用している場合、例が明示的な形式ルールなしで出力を1つの形式に固定します。
- 類似した識別子の区別:「発注番号(例:PO-2024-0892、請求書番号ではない)」— 複数の参照番号を含む文書で、例が誤った番号を明示的に除外します。
例は実際のデータである必要はありません。もっともらしいサンプル値で十分です。これはパターンのデモンストレーターとして機能し、フィルターではありません。
5. カラムインデックスがサイレントエラーを防ぐ仕組みを理解する
信頼性の高いAI抽出の構造的特性:抽出された各値は、カンマ区切りの文字列内の位置だけでなく、カラムのインデックス番号とペアになるべきです。これは一見した以上に重要です。
明示的なカラムインデックスがない場合、フィールドの欠落はサイレントなカラムシフトを引き起こします。行に5つのカラムがあるのに、特定の文書にフィールド3が存在しないためにモデルがそれを省略した場合、その行ではフィールド4と5が誤ったカラムに配置されます。50件のバッチでは、この種のずれは発見が困難です — 合計がベンダー名のカラムに入り、日付が金額のカラムに入る — 下流で数値が一致しなくなるまで気づきません。
インデックス付き出力(例:「1. 2024-03-15」「2. 1590.00」「3. ACME Supplies」)では、各値がカラムの識別情報を明示的に保持します。フィールドが欠落すると、後続の値を静かに左へずらす代わりに、正しいインデックスに空のプレースホルダーが生成されます。ソース文書に実際に存在したフィールド数に関係なく、すべての行が同じ構造を維持し、空のセルは隣接するカラムを破損させる代わりに欠落データを正しく示します。
これにより、幻覚エラーの一種も抑制されます:インデックス制約がない場合、モデルは欠落フィールドを空白のままにする代わりに、もっともらしい隣接値を埋めることがあります。明示的なインデックスにより、「ここには何も見つからない」ことが有効で認識可能な出力状態になります。
6. 馴染みのない文書タイプではまず自動検出を使用する
これまで抽出したことのない文書タイプに遭遇した場合は、カラムを指定せずにアップロードしてください。モデルが文書の視覚的構造を分析し、見つかった内容に基づいて初期フィールドリストを生成します。
その出力を使用して、どのフィールドが一貫して存在し、ソース文書がそれらをどのようにラベル付けしているかを把握します — その後、後続のバッチ実行用にカラム名を調整します。これは、カラム名を推測して空白セルを繰り返し確認し、文書の実際の内容を見つけるよりも高速です。特に馴染みのないレイアウトで役立ちます:新しい病院システムの検査レポート、ワークフローに追加したばかりの銀行の明細書、新しいサプライヤーの請求書形式などです。
7. 1ドキュメントにつき1行にするか、明細ごとに1行にするかを明確に指定する
8つの明細がある請求書では、1行(明細を連結または要約したもの)または8行(明細ごとに1行)のどちらかを生成できます。指定するカラム名によって、どちらの動作になるかが決まります。
ドキュメントレベルの列(「仕入先名」「請求日」「合計金額」)を指定すると、ドキュメントごとに1行が生成されます。明細レベルの列(「品目説明」「数量」「単価」「明細合計」)を指定すると、バッチ内のすべてのドキュメントにわたって明細ごとに1行が生成されます。両方のタイプを1つの列セットに混在させることも有効です。モデルは各明細行に対してドキュメントレベルの値を繰り返し、Excelでフィルタリングやピボットが容易な非正規化テーブルを生成します。
8. 同じタイプのドキュメントをまとめてバッチ処理する
バッチ内のすべてのドキュメントが同じ列スキーマを共有している場合、各ドキュメントは1つのクリーンな結合テーブル内の一連の行になります。識別用の列なしに根本的に異なるドキュメントタイプを混在させると、あいまいさが生じます。請求書の「金額」と銀行明細書の「金額」は意味が異なり、結合された出力では区別できなくなります。
異なるドキュメントタイプを結合する必要がある場合は、「ドキュメントタイプ」または「ソース」列を追加してください。モデルは各ドキュメントからこれを直接読み取り、自動的に入力できます。各ファイルを手動でラベル付けする必要はありません。
Before and After: 曖昧なカラム名と正確なカラム名
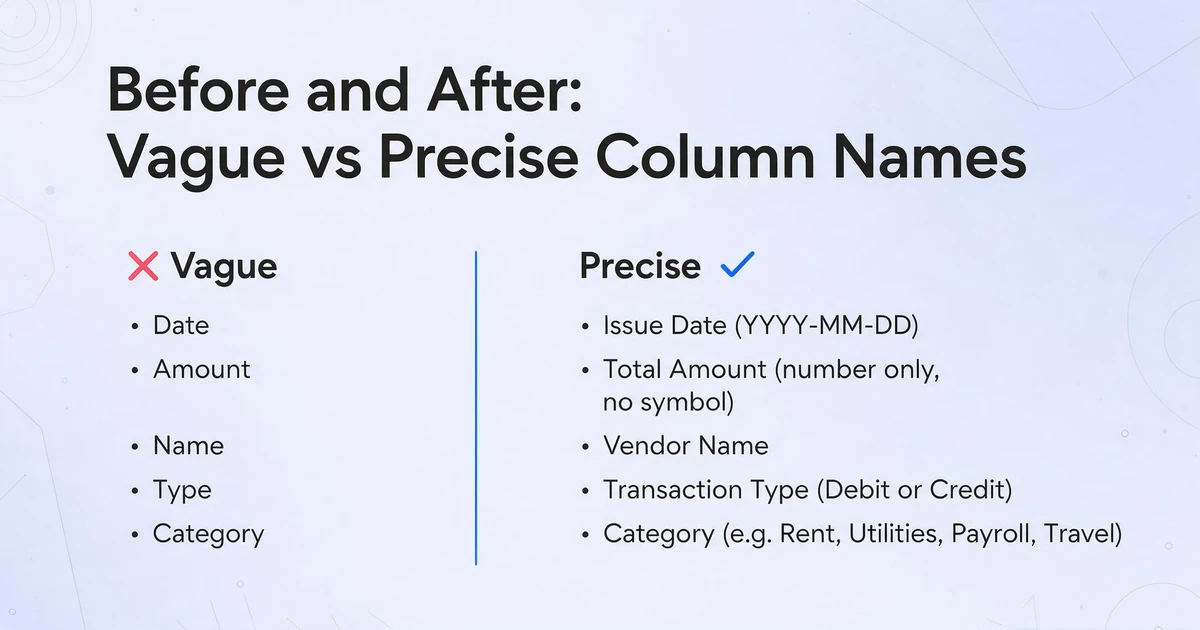
| 曖昧なカラム名 | より良いカラム名 | 改善される理由 |
|---|---|---|
| Date | Issue Date (YYYY-MM-DD) | どの日付かを明確にし、全ソースドキュメント間で形式を標準化します |
| Amount | Total Amount (number only, no symbol) | 通貨記号や書式を除去し、数値演算にすぐ使える状態にします |
| Name | Vendor Name | 同じドキュメント上の受取人、連絡先、承認者とベンダーを区別します |
| Type | Transaction Type (Debit or Credit) | 有効な出力値を提供し、銀行が列をどうラベル付けするかに依存しません |
| Category | Category (e.g. Rent, Utilities, Payroll, Travel) | few-shotの例が分類体系を固定し、バッチ間でのカテゴリ名の不整合を防ぎます |
| ID | Invoice Number (e.g. INV-2024-0892, not PO number) | 隣接する識別子を除外し、例が期待される形式を固定します |
よくある質問
どのカラムを指定すればよいかわからない場合はどうすればよいですか?
カラムを指定せずにドキュメントをアップロードしてください。モデルがドキュメント構造を分析し、検出した内容に基づいて推奨フィールドリストを生成します。これは、調整可能な出発点となります。この自動検出モードは、フィールド名を推測することなく、新しいドキュメントタイプを理解するための最速の方法です。
ドキュメント内に存在するとわかっているフィールドで、セルが一貫して空白になる場合はどうすればよいですか?
通常は、名前の曖昧さが原因です。モデルがカラム名をドキュメント内のフィールドに確信を持って一致させられなかった可能性があります。名前が一般的すぎる(「情報」、「詳細」など)、ドキュメントがそのフィールドに通常とは異なるラベルを使用している、またはフィールドが存在するものの周囲のテキストと明確に区別できない、といったケースが考えられます。より具体的な説明を試すか、括弧内に値の例を追加するか、ソースドキュメントのフィールドラベルが指定した内容と大きく異なるかどうかを確認してください。
異なるドキュメントタイプ間で同じカラムセットを再利用できますか?
はい、ただし、マージされた出力で行を区別できるように、「ドキュメントタイプ」カラムを追加してください。1つのバッチで請求書と領収書の両方から「金額」と「日付」を抽出する場合、これらのフィールドは同じ意味を持つため、マージされたテーブルはクリーンです。請求書と銀行取引明細書を混在させる場合、意味が異なります。請求書の合計からの「金額」と、銀行の単一取引からの「金額」は同じフィールドではないため、分離するかラベルを付ける必要があります。
カラム名の記述とフォーマットルールの記述はどう違うのですか?
カラム名はモデルに何を探すかを指示します。フォーマットルール(またはカラム名に埋め込まれたフォーマットヒント)は、見つかった値をどのようにレンダリングするかを指示します。両方はカラム名自体で表現できます。「合計金額(数字のみ、小数点以下2桁)」は、フィールドを識別し、出力形式を1つの指示で指定します。これらをカラム名にまとめておくことは、別のルールフィールドを管理するよりも簡単で、出力テーブルのヘッダーですぐに確認できます。
一度に1つのドキュメントしか処理しない場合、インデックス付き出力が重要なのはなぜですか?
単一のドキュメントでも、カラムのインデックス付けにより、欠落したフィールドが後続の値を左にシフトさせるのではなく、表示可能な空白セルを生成することが保証されます。特定の取引にメモがない銀行取引明細書では、メモカラムに空のセルが生成されます。日付や金額の値がそのスロットにシフトされることはありません。この動作は、欠落フィールドが一般的なバッチ処理で最も重要ですが、提供される構造的な正確性は、あらゆる複数カラム抽出に適用されます。
これらのテクニックを自分の文書で試してみてください — バッチをアップロードし、上記のカラム命名パターンを適用して、出力を以前の結果と比較してください。
抽出を開始