ImageToTable vs Nanonets vs Parseur pour les équipes non techniques :
Une comparaison honnête pour 2026
La plupart des comparaisons d'extraction de documents ressemblent à des listes de fonctionnalités écrites par les fournisseurs. Elles répondent à des questions que personne dans votre équipe ne se pose vraiment. La responsable des opérations qui traite 200 factures par mois ne se soucie pas de savoir quel outil a obtenu le meilleur score sur l'IDP Leaderboard. Elle veut savoir si quelqu'un de son équipe peut s'en sortir cet après-midi sans appeler l'informatique, ce que ça coûtera réellement chaque mois, et si les données extraites arrivent dans Google Sheets sans détour par Zapier. Cette comparaison répond à ces questions — et ne répond volontairement pas à celles qui importent plus aux équipes d'approvisionnement du Fortune 500 qu'à l'équipe que vous dirigez réellement.
Points clés à retenir
- Les trois outils vendent tous de l'« extraction de documents » — mais leurs modèles de tarification divergent tellement que 400 pages par mois coûtent 19 $ sur l'un et 120 $ sur un autre.
- La question Google Sheets qui compte n'est pas « les données peuvent-elles finalement atteindre une feuille de calcul » — c'est de savoir si l'extraction se fait dans la feuille que votre équipe a déjà ouverte, et seul ImageToTable.ai répond avec un module complémentaire natif en barre latérale.
- Oubliez les tableaux de comparaison de fonctionnalités — la bonne question choisit votre outil pour vous : votre équipe vit-elle dans des feuilles de calcul, traite-t-elle des documents à partir d'e-mails transférés, ou a-t-elle besoin de certifications de conformité d'entreprise ?
Pourquoi cette comparaison existe (et ce que nous ne couvrirons pas)
ImageToTable, Nanonets et Parseur résolvent tous le même problème central : transformer des documents non structurés en données structurées, prêtes pour un tableur, sans ressaisie manuelle. Mais ils l'abordent sous trois angles fondamentalement différents — et cette différence compte plus que n'importe quelle liste de fonctionnalités.
Cette comparaison est écrite du point de vue d'un responsable d'équipe non technique : quelqu'un qui gère les opérations, la finance ou une petite entreprise et qui a besoin que l'extraction de documents fonctionne dans un flux de travail centré sur le tableur. L'équipe vit probablement dans Google Sheets. Personne n'a le temps d'annoter des données d'entraînement ni d'attendre un cycle d'implémentation. Le budget est réel mais pas nul — la question n'est pas « quel est le moins cher » mais « quel est le bon investissement pour notre usage réel ».
Ce que nous ne couvrirons pas : Ceci n'est pas une revue de la latence API, des scores de benchmark des modèles ou des architectures de déploiement d'entreprise. Si vous êtes un responsable technique qui évalue des API d'extraction pour un pipeline de production traitant un million de pages par mois, les critères qui comptent pour vous sont différents de ceux qui comptent ici. Nous n'allons pas non plus prétendre que c'est une « revue tierce impartiale ». Nous avons construit ImageToTable. Mais nous avons utilisé les deux autres outils, parlé à leurs utilisateurs et les avons tarifés à partir de leurs pages publiques. Là où un concurrent fait mieux, nous le dirons.
Si vous cherchez encore à comprendre ce que fait réellement l'extraction de documents par IA — et en quoi elle diffère des outils OCR que vous avez peut-être essayés auparavant — commencez par ce que signifie réellement l'extraction de données documentaires et en quoi l'extraction par IA diffère de l'OCR traditionnel. Cet article suppose que vous savez déjà que vous avez besoin d'un outil d'extraction et que vous êtes en train de choisir lequel.
Question 1 : Un membre de mon équipe peut-il l'utiliser dès aujourd'hui sans formation ?
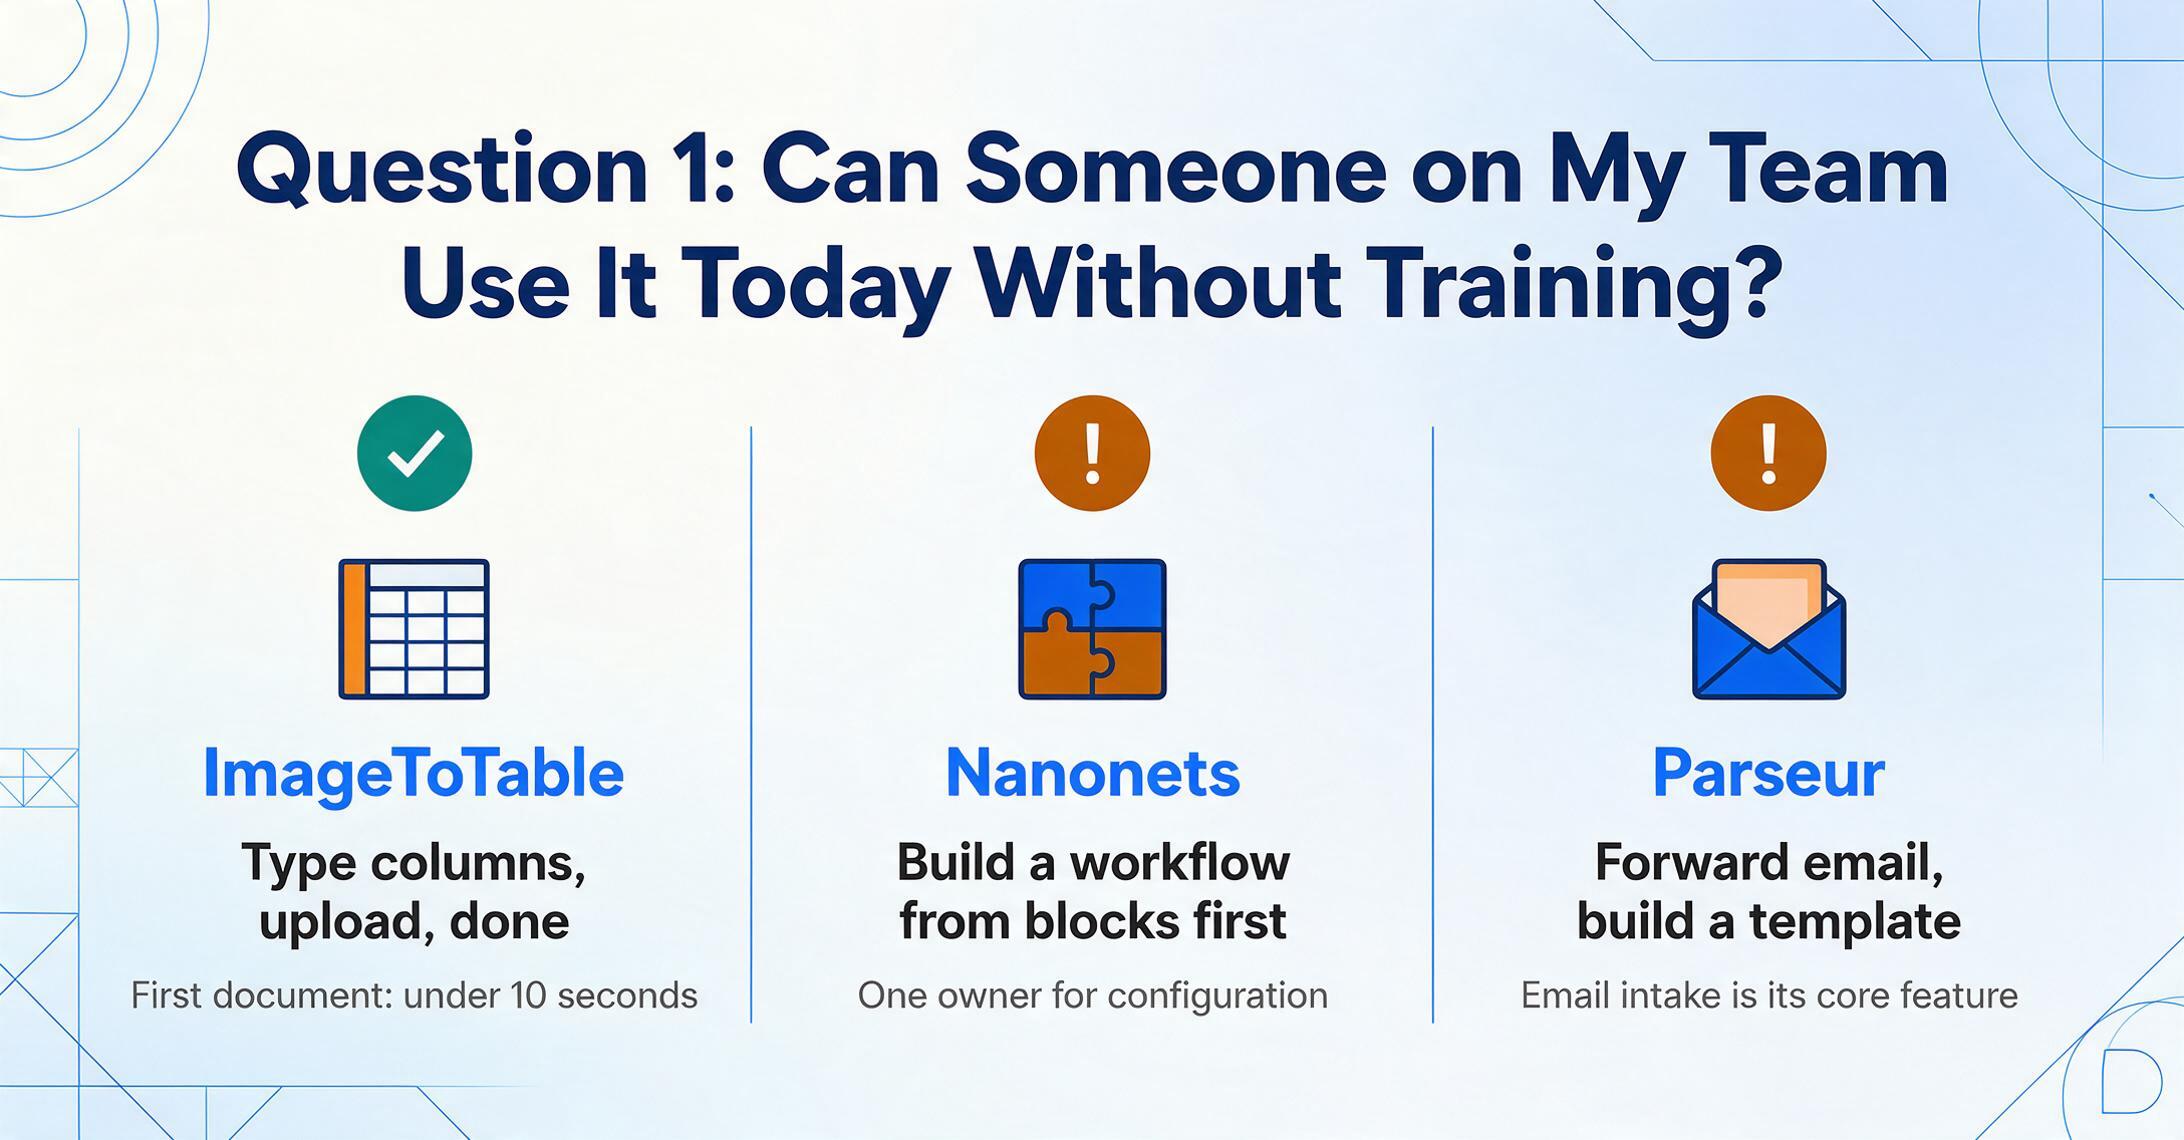
C'est la question qui élimine la plupart des évaluations d'outils. Un produit peut être puissant sur le papier, mais s'il faut une semaine pour l'adopter — ou s'il exige des concepts que votre équipe ne maîtrise pas — l'adoption meurt dès le premier mois. Les trois outils adoptent des approches nettement différentes pour l'expérience de première utilisation.
ImageToTable : saisissez vos noms de colonnes, importez, c'est terminé
Il n'y a pas de phase de configuration. Vous saisissez les noms de champs souhaités — « Numéro de facture », « Fournisseur », « Date », « Total » — importez un document, et l'AI extrait ces valeurs. Les noms de colonnes que vous saisissez deviennent les en-têtes de votre tableau de sortie. Pas de modèle à créer, pas de données d'entraînement à étiqueter, pas de « moteur d'analyse » à sélectionner. Vous pouvez même ignorer complètement les noms de colonnes et laisser l'AI détecter automatiquement le contenu du document, puis affiner à partir de là.
Cette approche — ce que nous appelons l'Extraction de colonnes personnalisées — fonctionne parce que l'AI comprend ce que « Numéro de facture » signifie sémantiquement, et non où il se trouve sur la page. Vous ne dessinez pas de cadres autour des champs et vous n'apprenez pas au système à quoi ressemblent vos factures. Un fournisseur modifie la mise en page de ses factures ? L'AI s'adapte. Quelqu'un envoie une photo prise au téléphone au lieu d'un PDF ? Même processus. Pour comprendre pourquoi cela compte, consultez comment l'extraction de colonnes personnalisées se compare à la conversion de tableaux entiers.
Le premier document est généralement traité en moins de 10 secondes. Un nouveau membre de l'équipe peut passer de l'inscription à l'extraction terminée sans documentation.
Nanonets : Créer un workflow avec des blocs
Nanonets utilise un créateur de workflow visuel composé de « blocs » — chaque bloc effectue une étape : réception de documents, classification, extraction de données, validation, export. Pour un workflow de factures standard, vous enchaînerez généralement 4 à 6 blocs. Le bloc d'extraction est propulsé par l'IA et ne nécessite pas de création de modèle — il détecte automatiquement les champs des documents, tout comme ImageToTable.ai.
Mais mettre un workflow en production demande plus d'étapes qu'un simple flux d'import et d'extraction. Vous devez comprendre le concept de bloc, configurer chaque étape et tester le pipeline de bout en bout. L'interface est conçue pour les personnes à l'aise avec les concepts d'automatisation de workflow — elle est intuitive pour ce public, mais la courbe d'apprentissage est plus raide que « saisir les champs, importer, télécharger ». La documentation officielle de Nanonets estime le temps de configuration à quelques minutes pour les workflows simples, mais les utilisateurs sur r/dataengineering de Reddit rapportent que l'ajustement de pipelines complexes multi-types de documents peut prendre des jours d'itération.
Parseur : Choisissez votre moteur, configurez une boîte mail
Parseur organise l'extraction autour de « boîtes mail » — chaque boîte mail gère un type de document avec son propre schéma de champs et ses règles de traitement. Lors du premier import, Parseur identifie automatiquement les champs qu'il pense que vous voulez extraire. Vous pouvez ensuite affiner la liste des champs et rédiger des instructions en anglais simple pour chaque champ. Parseur sélectionne automatiquement le bon moteur d'analyse — Vision AI pour les mises en page riches en images, Text AI pour le contenu en texte brut, et des modèles pour les formulaires fixes.
La détection automatique des champs lors du premier import est vraiment utile et réduit les tâtonnements initiaux. Mais la structure boîte mail + moteur + post-traitement introduit des concepts que les utilisateurs non techniques doivent apprendre. Le moteur de modèles, bien qu'optionnel, nécessite de créer un modèle visuel par mise en page de document — utile lorsque vous avez besoin d'un résultat identique à chaque fois, mais un travail supplémentaire si vos documents proviennent de nombreux fournisseurs différents avec des formats variés. Selon la documentation de Parseur, la plupart des workflows sont opérationnels en moins de 10 minutes pour les cas d'usage simples.
| ImageToTable | Nanonets | Parseur | |
|---|---|---|---|
| Temps avant la première extraction | Moins d'1 minute | 5–15 minutes (flux simple) | 2–10 minutes (première boîte mail) |
| Modèle de configuration | Saisir les noms de colonnes → importer | Constructeur de flux visuel (blocs) | Boîte mail + instructions de champs |
| Modèle requis ? | Non | Non (l'AI détecte les champs automatiquement) | Optionnel — l'AI fonctionne sans modèles |
| Données d'entraînement nécessaires ? | Aucune | Aucune pour l'extraction standard | Aucune |
| Changements de mise en page gérés ? | Automatiquement — extraction sémantique | Automatiquement — l'AI s'adapte | Les moteurs AI s'adaptent ; les modèles nécessitent une mise à jour |
Si votre besoin principal est de rendre un membre d'équipe non technique opérationnel en moins de 5 minutes, ImageToTable offre le chemin le plus court. Le concept de boîte mail de Parseur est le plus accessible ensuite — la détection automatique des champs au premier import élimine la friction du « comment nommer les champs ? ». Nanonets offre le plus de contrôle sur les flux, mais au prix d'une complexité qui a plus de sens si vous avez déjà quelqu'un à l'aise avec les outils d'automatisation dans l'équipe.
Question 2 : Combien vais-je réellement payer par mois ?
Les modèles de tarification en extraction de documents sont étonnamment différents — et ces différences comptent plus que les prix affichés. Un outil facture par page, un autre par opération d'IA, un autre par abonnement mensuel forfaitaire. Le même volume de documents peut générer des factures radicalement différentes selon le modèle dans lequel vous vous trouvez.
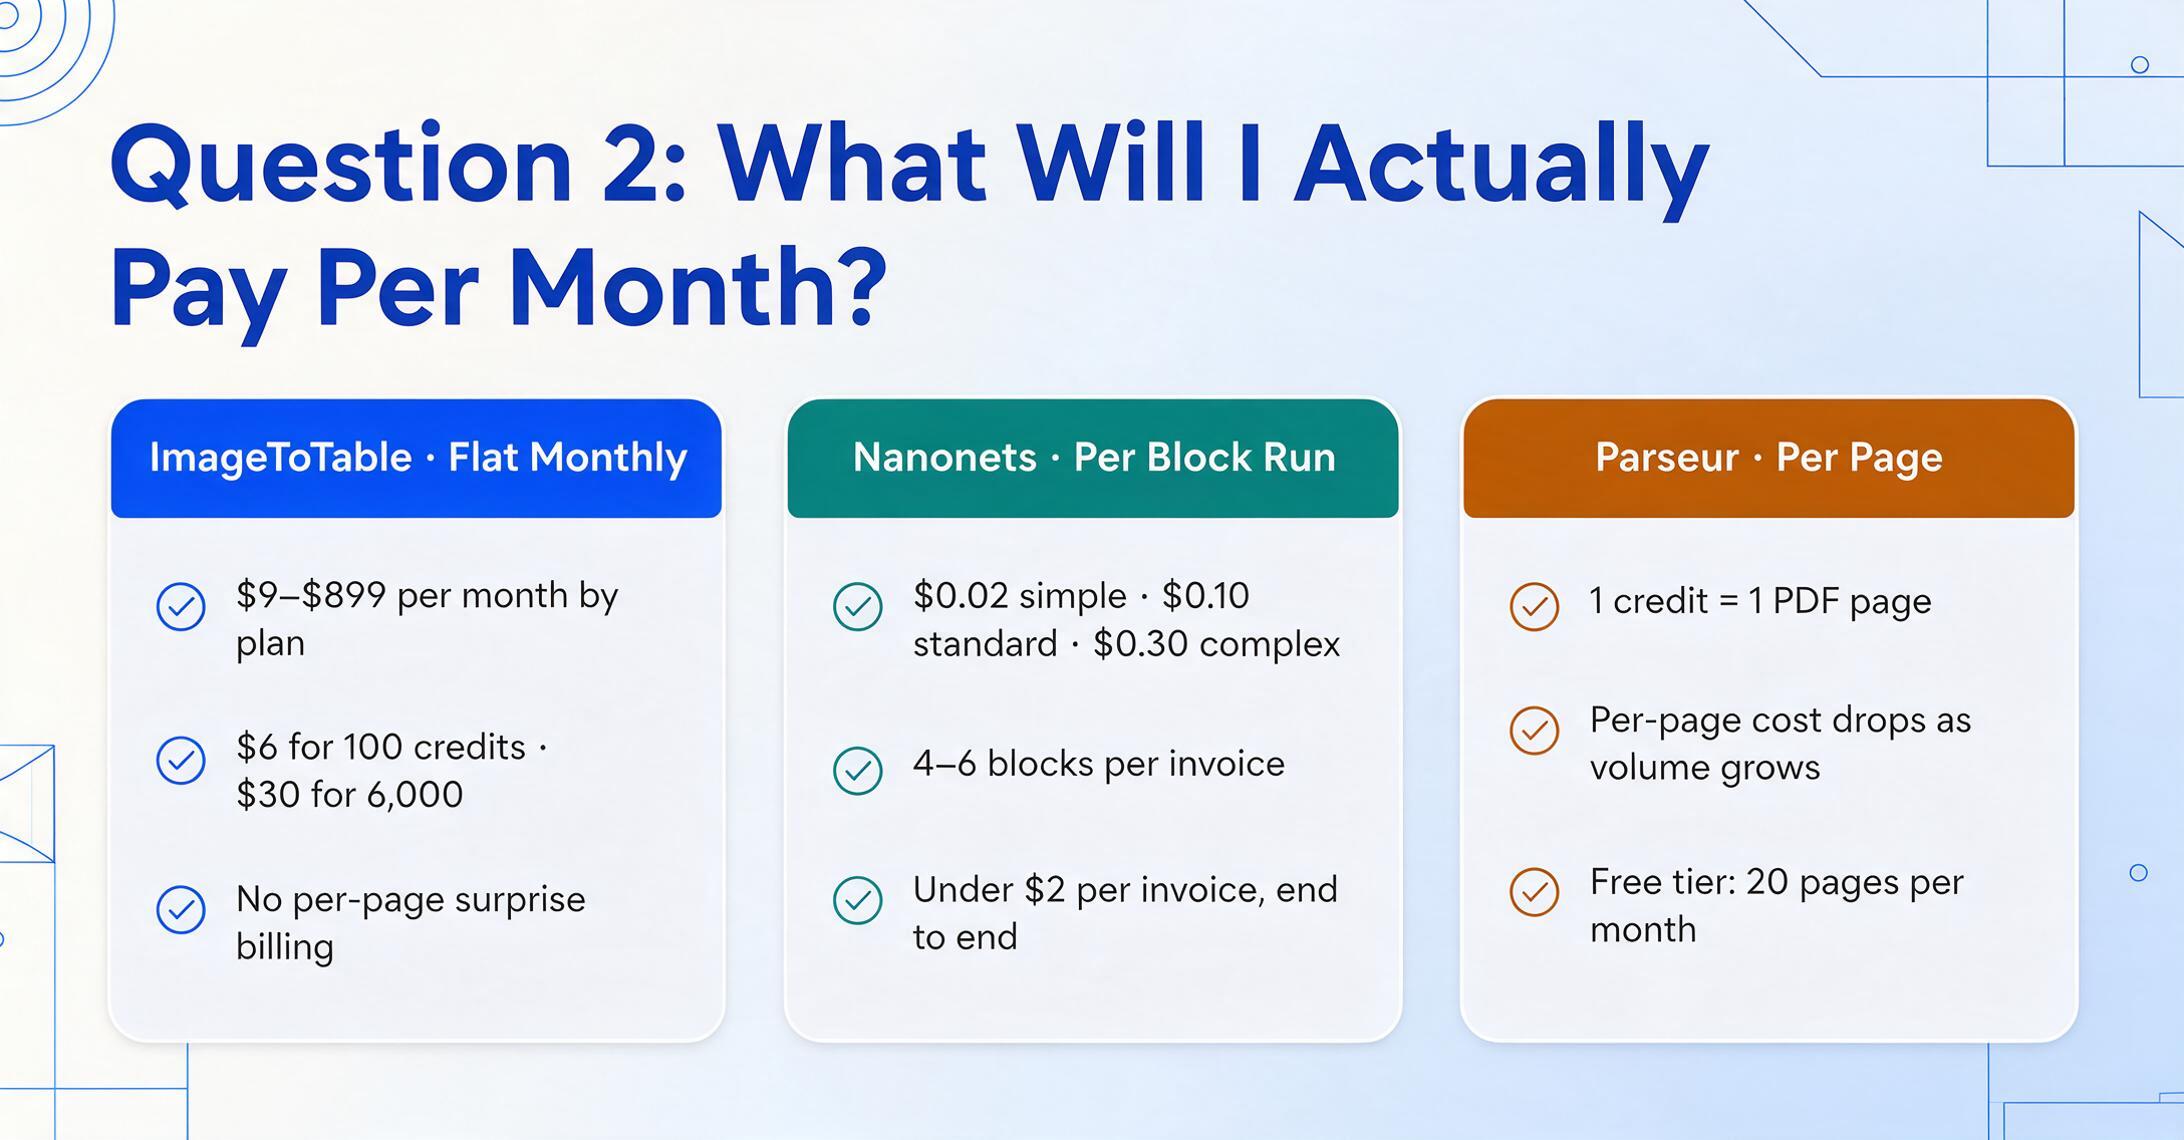
Les trois modèles de tarification, expliqués
ImageToTable : Abonnement mensuel avec limites de crédits. Vous payez un forfait mensuel fixe (9 $ à 899 $ selon le plan) et obtenez un nombre défini de crédits — chaque crédit traite une image ou une page PDF. Les crédits non utilisés ne sont pas reportés, mais il n'y a pas de facturation surprise par page. Vous pouvez aussi acheter des packs de crédits ponctuels (6 $ pour 100 crédits, jusqu'à 300 $ pour 6 000 crédits) sans abonnement. Un quota quotidien gratuit vous permet de tester avec de vrais documents avant de payer quoi que ce soit.
Nanonets : Consommation par bloc. Nanonets facture par « exécution de bloc » — chaque étape d'un workflow consomme des crédits à des taux différents : 0,02 $ pour les opérations simples (formatage, routage), 0,10 $ pour l'IA standard (classification, validation), 0,30 $ pour l'IA complexe (extraction de données). Un workflow de facture typique utilise 4 à 6 blocs. Nanonets estime cela à moins de 2 $ par facture de bout en bout. Le plan Starter inclut 200 $ de crédits gratuits. Les plans équipe avec remises sur volume et crédits partagés nécessitent de contacter les ventes.
Parseur : Tarification par volume de pages. Parseur facture par page traitée, le coût par page diminuant à mesure que le volume augmente. 1 crédit = 1 page PDF. Les e-mails et les feuilles de calcul comptent pour 1 page quelle que soit leur longueur. Le niveau gratuit inclut 20 pages/mois. Les plans payants commencent à un niveau de base et évoluent jusqu'à 1 million de pages/mois en libre-service, l'offre Enterprise gérant jusqu'à 10 millions de pages. Parseur ne publie pas les prix exacts par page à chaque palier de volume — le curseur de tarification permet d'estimer, mais le prix final apparaît après l'inscription. Le calculateur de ROI sur la page de tarification de Parseur vous permet de modéliser les coûts en fonction de votre volume de documents et du nombre d'employés.
Ce que coûte chaque modèle à trois volumes réalistes
| Volume mensuel | ImageToTable | Nanonets (est.) | Parseur (est.) |
|---|---|---|---|
| 50 pages/mois | $0 (quota quotidien gratuit) ou 9 $/mois (Basic) | $0 (les crédits Starter couvrent ce volume) | Forfait payant d'entrée de gamme (au-delà de 20 gratuites) |
| 400 pages/mois | 19 $/mois (Pro, 400 crédits) — ~0,05 $/page | ~60 $–120 $/mois (à ~0,15 $–0,30 $/page pour les flux de travail à extraction intensive) | Forfait payant — estimé à 40 $–80 $/mois |
| 3 000 pages/mois | 149 $/mois (Growth, 3 000 crédits partagés) — ~0,05 $/page | ~150 $–300 $/mois (avec remises sur volume, contacter les ventes) | Forfait Scale — estimé à 150 $–300 $/mois |
Prix ImageToTable issus de la page de tarification publique sur imagetotable.ai/upgrade_service. Estimations Nanonets basées sur la tarification publique par bloc sur nanonets.com/pricing, en supposant un flux de travail de facturation typique de 4 à 6 blocs. Estimations Parseur basées sur les plages du curseur de volume sur parseur.com/pricing — les prix exacts par page nécessitent une inscription. Tous les prix en USD. Les estimations Nanonets et Parseur concernent l'extraction — des coûts supplémentaires peuvent s'appliquer pour les fonctionnalités additionnelles.
Le modèle par bloc introduit une imprévisibilité réelle que les modèles d'abonnement évitent. Un mois, votre équipe traite 400 factures standard d'une page — abordable. Le mois suivant, un fournisseur envoie 50 relevés multipages avec contrats joints qui déclenchent chacun plus de blocs que prévu. Votre facture change et vous ne savez pas de combien jusqu'à son arrivée. Pour les équipes ayant des types de documents et des volumes prévisibles, c'est gérable. Pour les équipes traitant un mélange de documents courts et longs provenant de sources changeantes, le modèle d'abonnement est plus facile à budgéter.
Un aspect tarifaire où Nanonets et Parseur ont un avantage : les remises sur volume élevé. Si vous traitez 10 000+ pages par mois de manière constante, leur tarification par paliers de volume peut battre les modèles d'abonnement forfaitaires sur le coût par page. Pour les plages de volume dans lesquelles évoluent la plupart des équipes non techniques (50–3 000 pages/mois), l'abonnement forfaitaire d'ImageToTable s'avère cependant généralement moins cher.
Question 3 : Fonctionne-t-il dans Google Sheets ?
Pour les équipes dont tout le flux de travail se déroule dans Google Sheets, la question de l'intégration n'est pas « les données peuvent-elles finalement atteindre une feuille de calcul ? » — c'est « puis-je extraire des données sans quitter la feuille de calcul dans laquelle je travaille déjà ? » La différence entre un module complémentaire natif et un pipeline Zapier/webhook détermine si l'extraction fait partie du flux de travail ou devient une étape séparée que quelqu'un doit penser à faire.
ImageToTable : Module complémentaire natif en barre latérale Google Sheets
ImageToTable propose un module complémentaire Google Workspace Marketplace qui intègre le moteur d'extraction complet dans une barre latérale Sheets. Vous définissez les colonnes, téléchargez les documents, et les données extraites arrivent directement dans votre feuille active — pas d'export de fichier, pas de téléchargement-réimportation, pas de changement d'onglet. Les modèles de colonnes peuvent être enregistrés et réutilisés entre les lots, donc votre modèle « Extraction de factures » fonctionne de la même manière chaque mois.
Le module complémentaire fonctionne en mode compte : connectez votre API Key une fois, et votre historique d'extraction Sheets et vos modèles se synchronisent avec votre compte web. L'utilisation compte dans votre quota de plan. C'est important car cela signifie que toute votre équipe peut utiliser le module complémentaire depuis la même feuille de calcul partagée — les données extraites apparaissent là où tout le monde travaille déjà.
Nanonets : Zapier, API ou export
Nanonets ne propose pas de module complémentaire natif Google Sheets. Les données atteignent Google Sheets par l'un des trois chemins suivants : un connecteur Zapier/Make/Power Automate (qui ajoute une étape intermédiaire et une latence potentielle), l'API REST (qui nécessite du travail d'ingénierie pour configurer un pipeline), ou l'export manuel vers CSV/Excel (ce qui va à l'encontre du but de l'automatisation).
Pour les équipes disposant d'une pile d'automatisation existante, la voie Zapier fonctionne bien — une fois configurée, les données extraites circulent automatiquement vers Sheets. Mais la configuration initiale nécessite de comprendre à la fois le constructeur de flux de travail de Nanonets et le modèle déclencheur/action de Zapier. Ce n'est pas la même chose qu'une barre latérale qui fonctionne immédiatement.
Parseur : Webhook, Zapier ou synchronisation directe
Parseur propose une « synchronisation Google Sheets en direct » en tant qu'intégration native — une fois connecté, les données parsées se synchronisent automatiquement vers une feuille spécifiée. C'est plus proche d'une expérience native que l'approche middleware de Nanonets, mais il s'agit toujours d'une étape de configuration séparée plutôt que d'un workflow intégré à Sheets. Parseur prend également en charge Google Sheets via les connecteurs Zapier, Make, Power Automate et n8n.
La synchronisation directe signifie que vous configurez la connexion une fois et que les données circulent automatiquement à chaque nouveau document traité. Mais vous gérez toujours l'extraction depuis l'interface web de Parseur — il n'y a pas de barre latérale utilisable sans quitter Sheets.
Si Google Sheets est l'outil principal de votre équipe : la barre latérale native d'ImageToTable est l'intégration la plus proche. La synchronisation directe de Parseur est une excellente deuxième option pour les pipelines automatisés « configurez et oubliez ». Nanonets nécessite le plus d'étapes intermédiaires mais offre la plus grande flexibilité si votre workflow couvre plusieurs destinations au-delà de Sheets.
Question 4 : Quels types de documents chacun gère-t-il bien ?
Tous les trois outils prétendent gérer « n'importe quel document ». En pratique, chacun a ses points forts et ses cas limites où il performe le mieux — et où il peut rencontrer des difficultés. Comprendre ces différences ne consiste pas à déclarer un gagnant ; il s'agit d'associer l'outil à ce que votre équipe traite réellement.
| Capacité documentaire | ImageToTable | Nanonets | Parseur |
|---|---|---|---|
| Formats d'entrée | PDF, JPG, PNG, WebP, AVIF, captures d'écran | PDF, images, Word, Excel — prise en charge large des formats | PDF, images, e-mails, feuilles de calcul, 25+ formats |
| Réception par e-mail | Disponible — adresse de boîte mail dédiée, traitement automatique avec un modèle lié | Disponible (intégration e-mail) | Fonctionnalité clé — transférez les e-mails vers une adresse de boîte mail unique |
| Prise en charge de l'écriture manuscrite | Oui — compréhension sémantique VLM | Pas mis en avant | Vision AI capture l'écriture manuscrite, les cases à cocher, les tampons |
| Extraction de tableaux / lignes d'articles | Oui — basée sur les colonnes + colonnes calculées pour les calculs | Oui — structure du tableau préservée dans la sortie | Oui — chaque ligne devient un enregistrement, gère des nombres de lignes variables |
| Documents multilingues | Principales langues prises en charge | 100+ langues | 200+ langues (OCR) ; les moteurs AI prennent en charge les principales langues |
| Préservation de la mise en page (vers Word) | Mode Vers Word — restauration complète de la mise en page en Word modifiable | Mise en page préservée dans la sortie Markdown | Pas une fonctionnalité principale — la sortie est des données structurées |
| Détection de cases à cocher / tampons / signatures | Oui — état des cases à cocher, tampons, signatures | Détection de codes-barres et de signatures sur les plans Growth+ | Vision AI capture les cases à cocher et les tampons |
| Conformité et certifications de sécurité | Chiffrement HTTPS, stockage chiffré, suppression automatique | SOC 2 Type II, HIPAA, GDPR, ISO 27001 | Natif GDPR (hébergé dans l'UE), SOC 2 Type II en cours |
La différence de réception des e-mails était autrefois un écart clair entre ces outils — ce n'est plus le cas. Parseur a été conçu autour de l'e-mail comme source documentaire principale — vous transférez les factures et reçus vers une adresse de boîte mail dédiée et ils sont traités automatiquement. Pour les équipes dont les documents arrivent principalement par e-mail (factures fournisseurs envoyées à ap@, reçus de dépenses transférés par le personnel), c'est un véritable gain de productivité. Nanonets propose une intégration e-mail similaire. ImageToTable dispose désormais aussi de cette fonctionnalité via Email Inbox : chaque compte reçoit une adresse de boîte mail dédiée, activer Auto-Process avec un modèle lié lance l'extraction dès l'arrivée du courrier, et une liste blanche d'expéditeurs optionnelle garde les e-mails non liés hors de la file d'attente. Email Inbox peut être configuré pour lire les pièces jointes, le corps de l'e-mail lui-même, ou les deux, couvrant ainsi les deux cas — une facture PDF transférée ou un fournisseur qui saisit simplement les chiffres dans le texte du message.
Sur le front de la conformité, Nanonets est dans une catégorie à part. Les certifications SOC 2 Type II, HIPAA, GDPR et ISO 27001 comptent si vous êtes dans la santé, la finance ou toute industrie avec des exigences réglementaires de traitement des données. Parseur propose une infrastructure native GDPR (hébergée dans l'UE) avec SOC 2 en cours. ImageToTable chiffre les données en transit et au repos avec une suppression automatique configurable — suffisant pour la plupart des cas d'usage SMB mais pas pour les organisations qui doivent cocher les cases de conformité lors de l'évaluation des fournisseurs.
Question 5 : Peut-il évoluer avec nous ?
L'outil qui fonctionne pour deux personnes traitant 100 factures par mois peut montrer ses limites quand l'équipe passe à huit personnes traitant 2 000 factures. La question de l'évolution ne concerne pas seulement le volume — elle concerne l'accès de l'équipe, les ressources partagées, et si le plafond de l'outil se situe au-dessus ou en dessous de la trajectoire de votre équipe.
Traitement par lots : combien de documents à la fois ?
ImageToTable prend en charge les téléversements par lots : vous déposez plusieurs fichiers à la fois, définissez vos colonnes une seule fois, et obtenez un tableau de sortie fusionné unique. La concurrence des téléversements évolue selon le niveau du plan — de 1 téléversement simultané sur le plan Free à 3 sur les plans Team. La vraie valeur du traitement par lots, c'est la fusion : 50 factures de 15 fournisseurs différents, toutes extraites dans une seule feuille de calcul avec des en-têtes de colonnes cohérents, sans configuration par fichier. La fonctionnalité Lien de collecte ajoute une dimension d'évolution qu'aucun concurrent n'offre : vous pouvez générer un lien partageable où les clients ou le personnel terrain téléversent des documents directement dans votre file de traitement.
Nanonets gère le traitement par lots via son moteur de workflow — les documents passent séquentiellement par les blocs configurés, avec des files d'attente par compte qui isolent votre traitement des autres clients. Les plans Team incluent des crédits partagés et jusqu'à 3 utilisateurs sur Starter. Les plans Growth et Enterprise ajoutent des analyses, des rapports et des remises sur volume allant jusqu'à 40 %. Pour les équipes qui doivent suivre le débit d'extraction et les indicateurs de précision sur plusieurs mois, la couche d'analyse de Nanonets est la plus solide des trois.
Parseur traite les documents via des boîtes mail avec des champs illimités par extraction. Les plans Scale (10 000+ crédits/mois) débloquent les comptes multi-utilisateurs (jusqu'à 100 utilisateurs), le post-traitement avancé (code Python pour une logique métier personnalisée) et la conservation illimitée des documents. La force unique de Parseur à grande échelle est son pipeline d'ingestion par e-mail : quand votre volume de documents atteint des milliers par mois, la capacité d'ingestion automatique par transfert d'e-mail devient plus précieuse, pas moins.
La dimension d'évolution où ImageToTable a un avantage qu'aucun concurrent ne reproduit : le Lien de collecte vous permet d'accroître votre collecte de documents sans agrandir votre équipe. Au lieu d'embaucher quelqu'un pour courir après les fournisseurs pour les factures ou rappeler aux employés de soumettre leurs reçus de dépenses, vous envoyez un lien. Les documents viennent à vous. C'est un autre type d'évolutivité — non pas traiter plus de documents plus vite, mais faire entrer les documents dans le pipeline avec moins de friction.
Quand choisir chaque outil : un guide pratique de décision
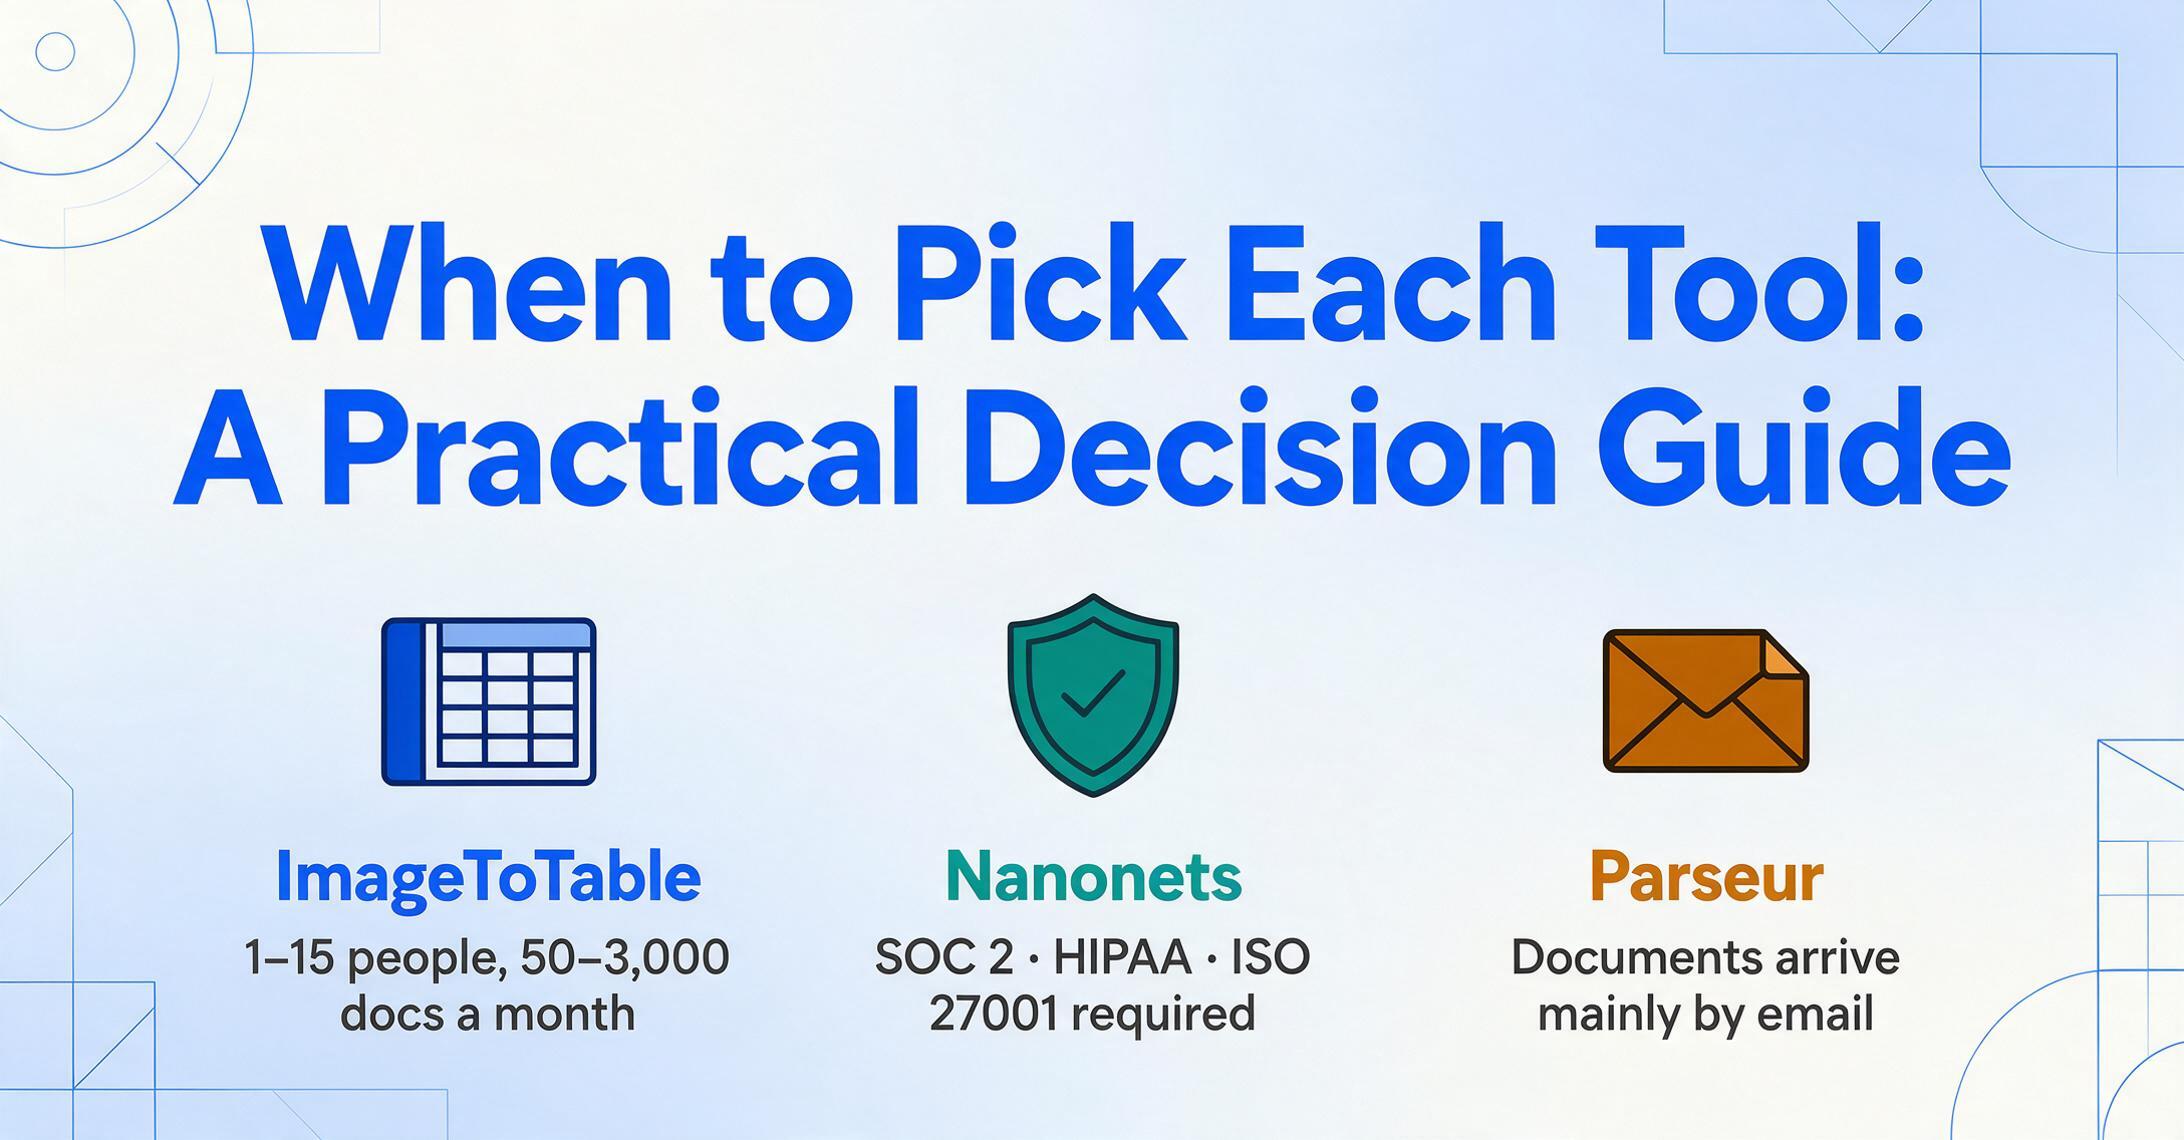
Aucun outil ne gagne sur tous les critères. Le bon choix dépend de ce que votre équipe valorise le plus et des compromis que vous êtes prêt à accepter. Voici comment la décision se décompose pour les scénarios les plus courants que nous observons.
Choisissez ImageToTable si votre équipe travaille dans Google Sheets et a besoin d'une extraction qui fonctionne dès aujourd'hui — sans configuration, sans formation, sans implication de l'informatique.
Idéal pour : les petites et moyennes équipes (1 à 15 personnes) traitant 50 à 3 000 documents par mois. Vous voulez un panneau latéral dans Sheets, pas un autre onglet à gérer. Vous préférez une tarification mensuelle prévisible à une optimisation par document. Vos documents arrivent de plusieurs sources et vous avez besoin du Lien de collecte pour les rassembler sans les courir après. Vous avez parfois besoin d'une sortie Word qui préserve la mise en page. Vous n'avez pas besoin de certifications de conformité de niveau Nanonets comme SOC 2 ou HIPAA — la réception automatisée des e-mails est déjà couverte par Email Inbox.
Choisissez Nanonets si la conformité, les intégrations d'entreprise et l'automatisation des flux de travail sont des exigences non négociables.
Idéal pour : les équipes de taille moyenne à grande qui ont besoin de la conformité SOC 2 / HIPAA / ISO 27001. Vous vous connectez à SAP, Oracle ou Salesforce — pas seulement à Google Sheets. Vous voulez des analyses sur le débit et la précision de l'extraction. Vous êtes à l'aise avec une interface de création de flux de travail et avez au moins une personne capable de gérer la configuration. Votre volume justifie une tarification par paliers de volume. Vous avez besoin de la détection de codes-barres ou de blocs Python personnalisés dans votre pipeline d'extraction.
Choisissez Parseur si vos documents arrivent principalement par e-mail et que vous avez besoin d'un pipeline autonome, configurable une fois pour toutes, avec une tarification adaptée aux gros volumes.
Idéal pour : les équipes opérationnelles qui reçoivent des centaines ou des milliers de documents standardisés par e-mail chaque mois (factures fournisseurs à ap@, notifications d'expédition, confirmations de commande). Vous voulez la flexibilité de l'extraction par IA plus la fiabilité de l'extraction basée sur des modèles pour les documents à format fixe. Vous avez besoin de la conformité GDPR avec une infrastructure hébergée dans l'UE. Vous êtes à l'aise pour gérer l'extraction depuis le tableau de bord web de Parseur et connecter les résultats à Sheets via une synchronisation ou Zapier. Votre volume est suffisamment élevé (1 000+ pages/mois) pour que la tarification par page joue en votre faveur.
Ce que nous utiliserions : une recommandation partiale mais honnête
Nous avons créé ImageToTable, donc vous savez de quel côté nous penchons. Mais voici quand nous recommanderions réellement les autres outils — parce que choisir le mauvais par loyauté n'aide personne.
Si quelqu'un dans votre équipe a de l'expérience avec les outils d'automatisation de flux de travail et que vos documents transitent principalement par e-mail, le pipeline de transfert par e-mail de Parseur associé à son moteur hybride modèle/AI est vraiment difficile à battre. La combinaison « transférer vers la boîte mail → extraction automatique → synchronisation vers Sheets » supprime plus d'étapes du flux de travail que toute autre approche concurrente pour ce type de réception spécifique.
Si vous travaillez dans la santé, le droit ou la finance à une échelle où les certifications de conformité sont des prérequis, la pile SOC 2 + HIPAA + ISO 27001 de Nanonets la place dans une catégorie à part. Vous pourriez aussi avoir besoin de leurs intégrations d'entreprise (SAP, Salesforce, Oracle) que les outils en libre-service ne proposent pas. À cette échelle, la tarification par bloc avec remises sur volume peut être plus économique que les abonnements forfaitaires.
Mais pour l'équipe que la plupart des gens qui posent cette question dirigent réellement — 3 à 15 personnes, 100 à 3 000 documents par mois, Google Sheets comme hub, pas d'ingénieur d'automatisation dédié, pas de checklist de certification de conformité du service juridique — ImageToTable fait précisément ce dont ils ont besoin (extraction basée sur les noms de colonnes dans une feuille de calcul) avec le moins de friction entre l'ouverture de l'outil et l'obtention de données exploitables. Si vous hésitez encore, les conseils pratiques pour tirer le meilleur parti de l'extraction de documents par AI s'appliquent quel que soit l'outil choisi.
FAQ
Ces outils proposent-ils des essais gratuits ?
Oui, tous les trois. ImageToTable a un quota gratuit quotidien sans inscription requise — vous pouvez traiter de vrais documents immédiatement. Nanonets donne à chaque nouveau compte 200 $ de crédits gratuits, assez pour des milliers de documents. Le forfait gratuit de Parseur inclut 20 pages par mois avec un accès complet à toutes les fonctionnalités. Aucun ne nécessite de carte de crédit pour commencer.
Quel outil offre la meilleure précision ?
La précision dépend plus du type et de la qualité de vos documents que de l'outil. Nanonets se classe n°1 sur le classement indépendant IDP Leaderboard pour la précision d'extraction de documents de référence. Le moteur de modèles de Parseur produit un résultat identique à chaque fois sur des mises en page fixes, et Vision AI gère les mises en page variables. ImageToTable rapporte jusqu'à 99 % de précision sur les données de tableaux imprimés grâce à l'extraction sémantique basée sur VLM. Pour tout outil, les documents manuscrits, les scans de faible qualité et les mises en page très denses réduiront la précision. La meilleure façon de comparer est de tester chacun avec vos propres documents — les trois offrent des points de départ gratuits.
Ces outils sont-ils conformes au RGPD ?
Parseur est le plus solide sur le RGPD — l'infrastructure est hébergée dans l'UE et native RGPD par conception. Nanonets offre la conformité RGPD avec des options de résidence des données (US, UE, APAC) sur les plans Enterprise. ImageToTable chiffre les données en transit et au repos avec une suppression automatique configurable ; il convient à la plupart des cas d'usage SMB mais ne porte pas de certification RGPD formelle. Si la conformité RGPD avec des certifications documentées est une exigence stricte, Parseur ou Nanonets Enterprise sont les choix les plus sûrs.
Puis-je utiliser ces outils sans écrire de code ?
Oui, les trois sont conçus pour une utilisation sans code. ImageToTable : saisissez les noms de colonnes dans un champ texte, téléchargez les fichiers, téléchargez les résultats. Nanonets : constructeur de flux visuel avec blocs glisser-déposer — le codage est facultatif (des blocs Python personnalisés sont disponibles pour les utilisateurs avancés). Parseur : instructions de champs en anglais simple via une interface web, avec post-traitement Python facultatif sur les plans Scale+. Aucun ne nécessite de programmation pour démarrer, bien que les trois offrent des API pour les équipes qui souhaitent un accès programmatique.
Puis-je mélanger différents types de documents dans un même lot ?
ImageToTable : Oui — vous pouvez télécharger un mélange de factures, reçus et relevés dans un même lot et extraire les mêmes colonnes nommées de chacun. L'IA localise « Date » ou « Total » quel que soit le type de document. Nanonets : les flux sont généralement configurés par type de document — vous utiliseriez des blocs de classification pour router différents documents vers différents chemins d'extraction. Parseur : chaque boîte aux lettres est conçue pour un schéma de document unique, mais Vision AI et Text AI peuvent gérer les variations de mise en page dans ce type. Mélanger des types de documents fondamentalement différents (factures + contrats) dans une même boîte aux lettres n'est pas le cas d'usage prévu.
Y a-t-il des coûts cachés à surveiller ?
Le modèle par bloc de Nanonets présente le plus de risques de frais inattendus — un document complexe qui déclenche plus de blocs que prévu coûte plus cher qu'un document simple. Le modèle par page de Parseur est plus prévisible, mais les PDF multipages multiplient le coût (un relevé de 10 pages coûte 10 fois plus qu'une facture d'une page). Le modèle par abonnement d'ImageToTable est le plus prévisible — vous payez les frais mensuels fixes, quel que soit la complexité du document ou le nombre de pages, bien que dépasser votre limite de crédit nécessite une mise à niveau ou l'achat de crédits supplémentaires.