Sua Cronologia do Caso Vive
nos Threads de E-mail
Pergunte a um paralegal de escritório pequeno onde o tempo vai em uma cronologia, e a resposta raramente é o gráfico. Uma cronologia do caso (também chamada de linha do tempo do caso ou cronologia de eventos) é uma lista datada dos eventos-chave em uma disputa, com cada entrada vinculada ao documento ou depoimento que a comprova. As colunas são simples. O que não é simples é ler centenas de mensagens encaminhadas, decidir qual das três datas em uma cadeia de respostas é a que importa, e digitá-la em uma linha. A linha do tempo é o entregável. O e-mail é o gargalo.
Principais Conclusões
- Uma cronologia do caso parece um problema de gráfico, mas na verdade é um problema de leitura.
- 73% do custo de produção de provas vai para a revisão de documentos, onde até revisores rápidos chegam perto de 100 documentos por hora.
- Nomeie as colunas uma vez e cada mensagem encaminhada vira uma linha, então a linha do tempo está a uma classificação de distância.
Uma Cronologia do Caso é Fácil de Desenhar. A Leitura é o Trabalho.
Advogados de litígio precisam de uma cronologia em quase todas as etapas de um caso. Eles a usam para preparar uma testemunha para uma deposição, para encontrar uma lacuna nas provas antes que o advogado adversário o faça, para verificar se uma reivindicação está dentro do prazo de prescrição e para explicar uma posição de acordo a um cliente ou seguradora. Cada um desses usos depende da mesma coisa: uma linha para cada evento, em ordem, com uma citação de volta à fonte. A estrutura leva uma hora para aprender. Preenchê-la leva dias.
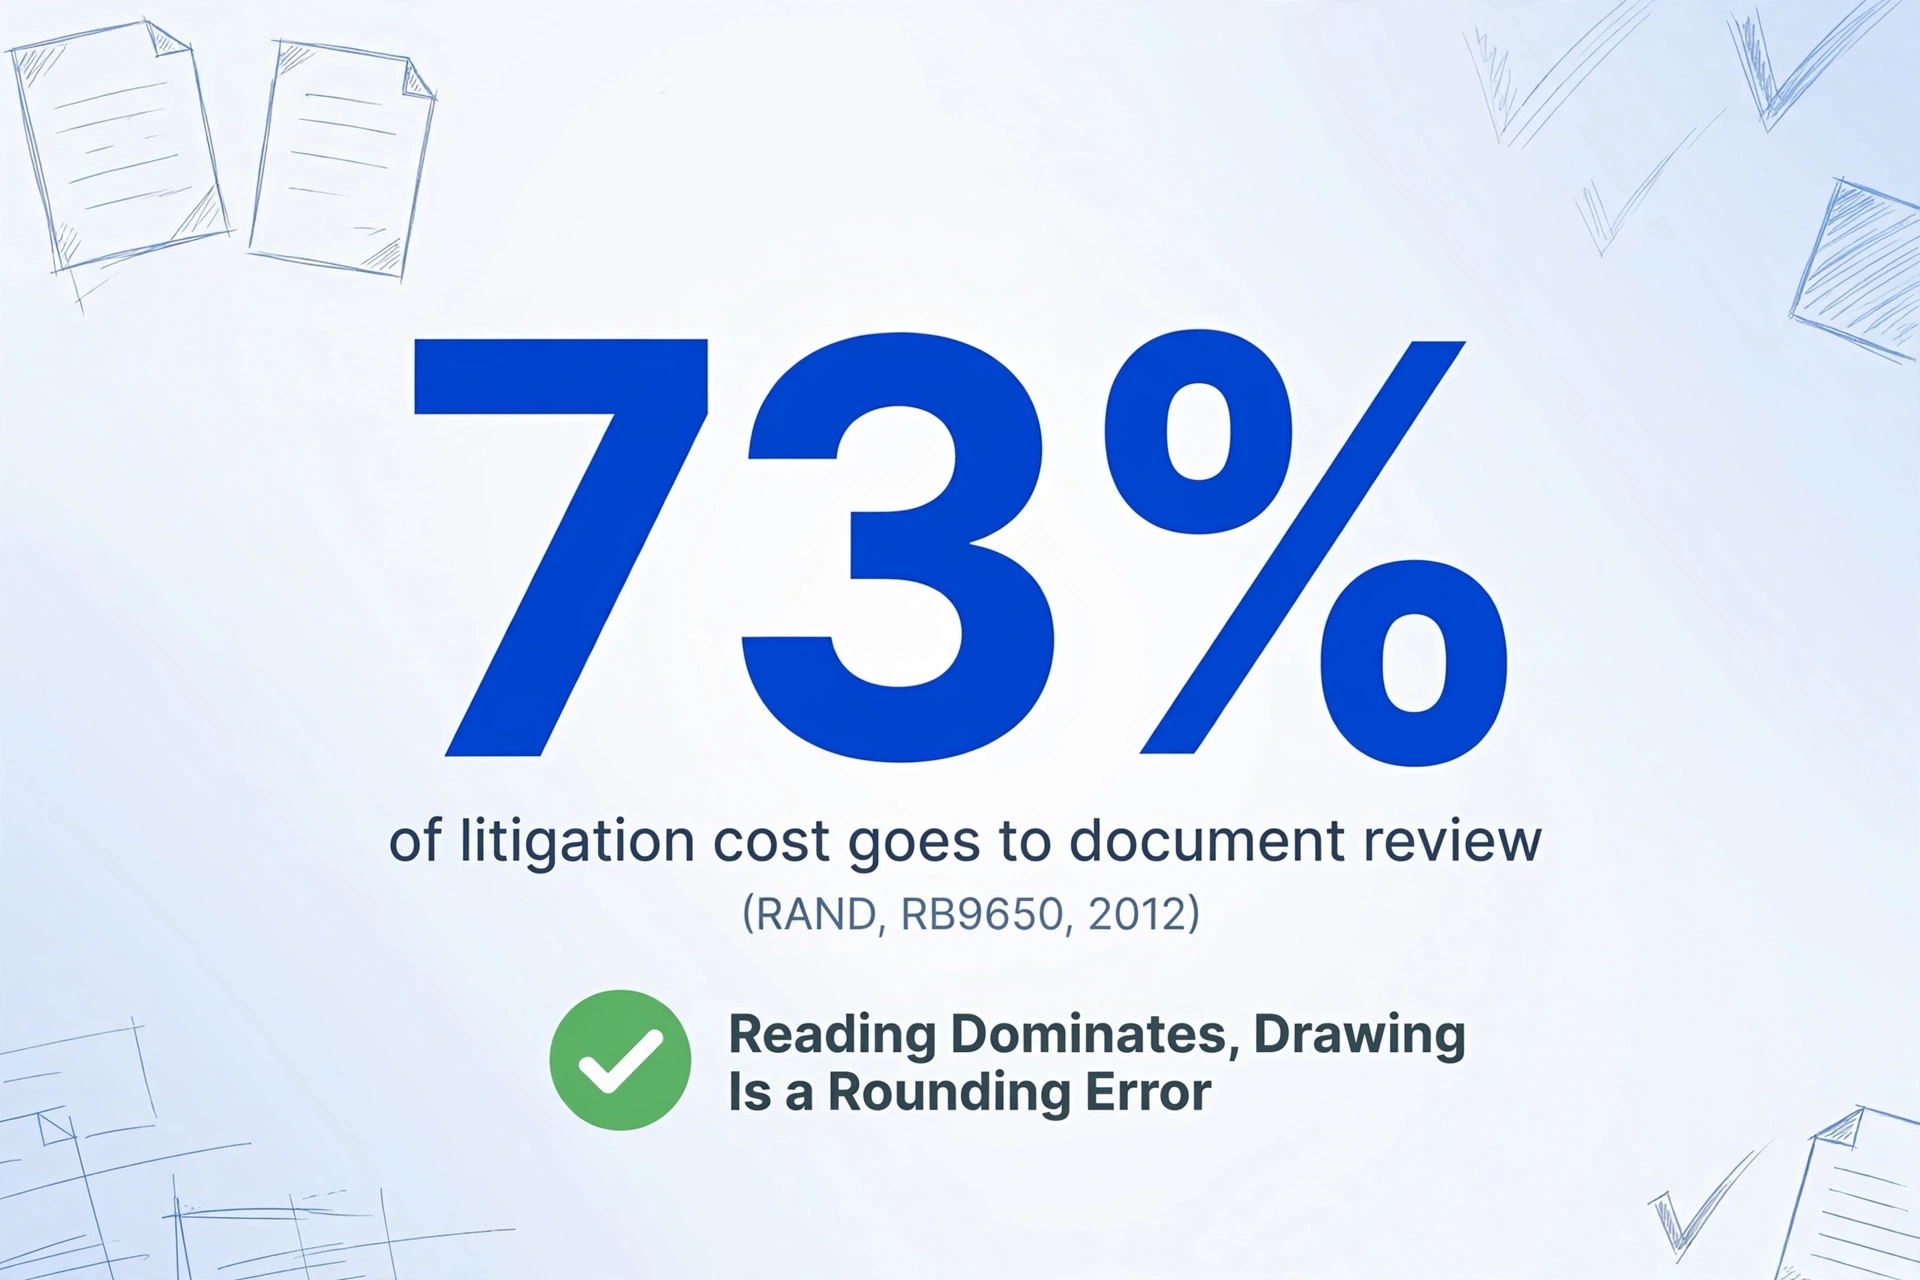
A razão é que a revisão de documentos, e não a montagem do gráfico, é onde as horas são gastas. Um estudo da RAND Corporation sobre grandes litígios descobriu que a revisão respondia por 73 por cento do custo total de produção de provas, e que mesmo revisores experientes chegam perto de 100 documentos por hora (RAND, RB9650, 2012). Um escritório pequeno não lida com esses volumes, mas a proporção se mantém: a leitura domina, e o desenho é um erro de arredondamento.
A cronologia não é difícil de desenhar. É difícil de conquistar, um e-mail de cada vez, antes de desenhar qualquer coisa.
A etapa de leitura agora carrega uma obrigação profissional além do seu custo. O Parecer Formal 512 da American Bar Association, emitido em julho de 2024, aplica os deveres de competência, confidencialidade do cliente e supervisão às ferramentas de IA generativa. Usar IA para ler correspondência de clientes é permitido, mas o advogado tem que entender a ferramenta, proteger o que entra nela e verificar o que sai (Parecer Formal 512 da ABA). Portanto, o objetivo não é remover o advogado do processo. É remover a redigitação, para que o processo seja gasto em julgamento em vez de transcrição.
Uma Cronologia de Caso Viável Tem Cinco Colunas e uma Citação em Cada Linha
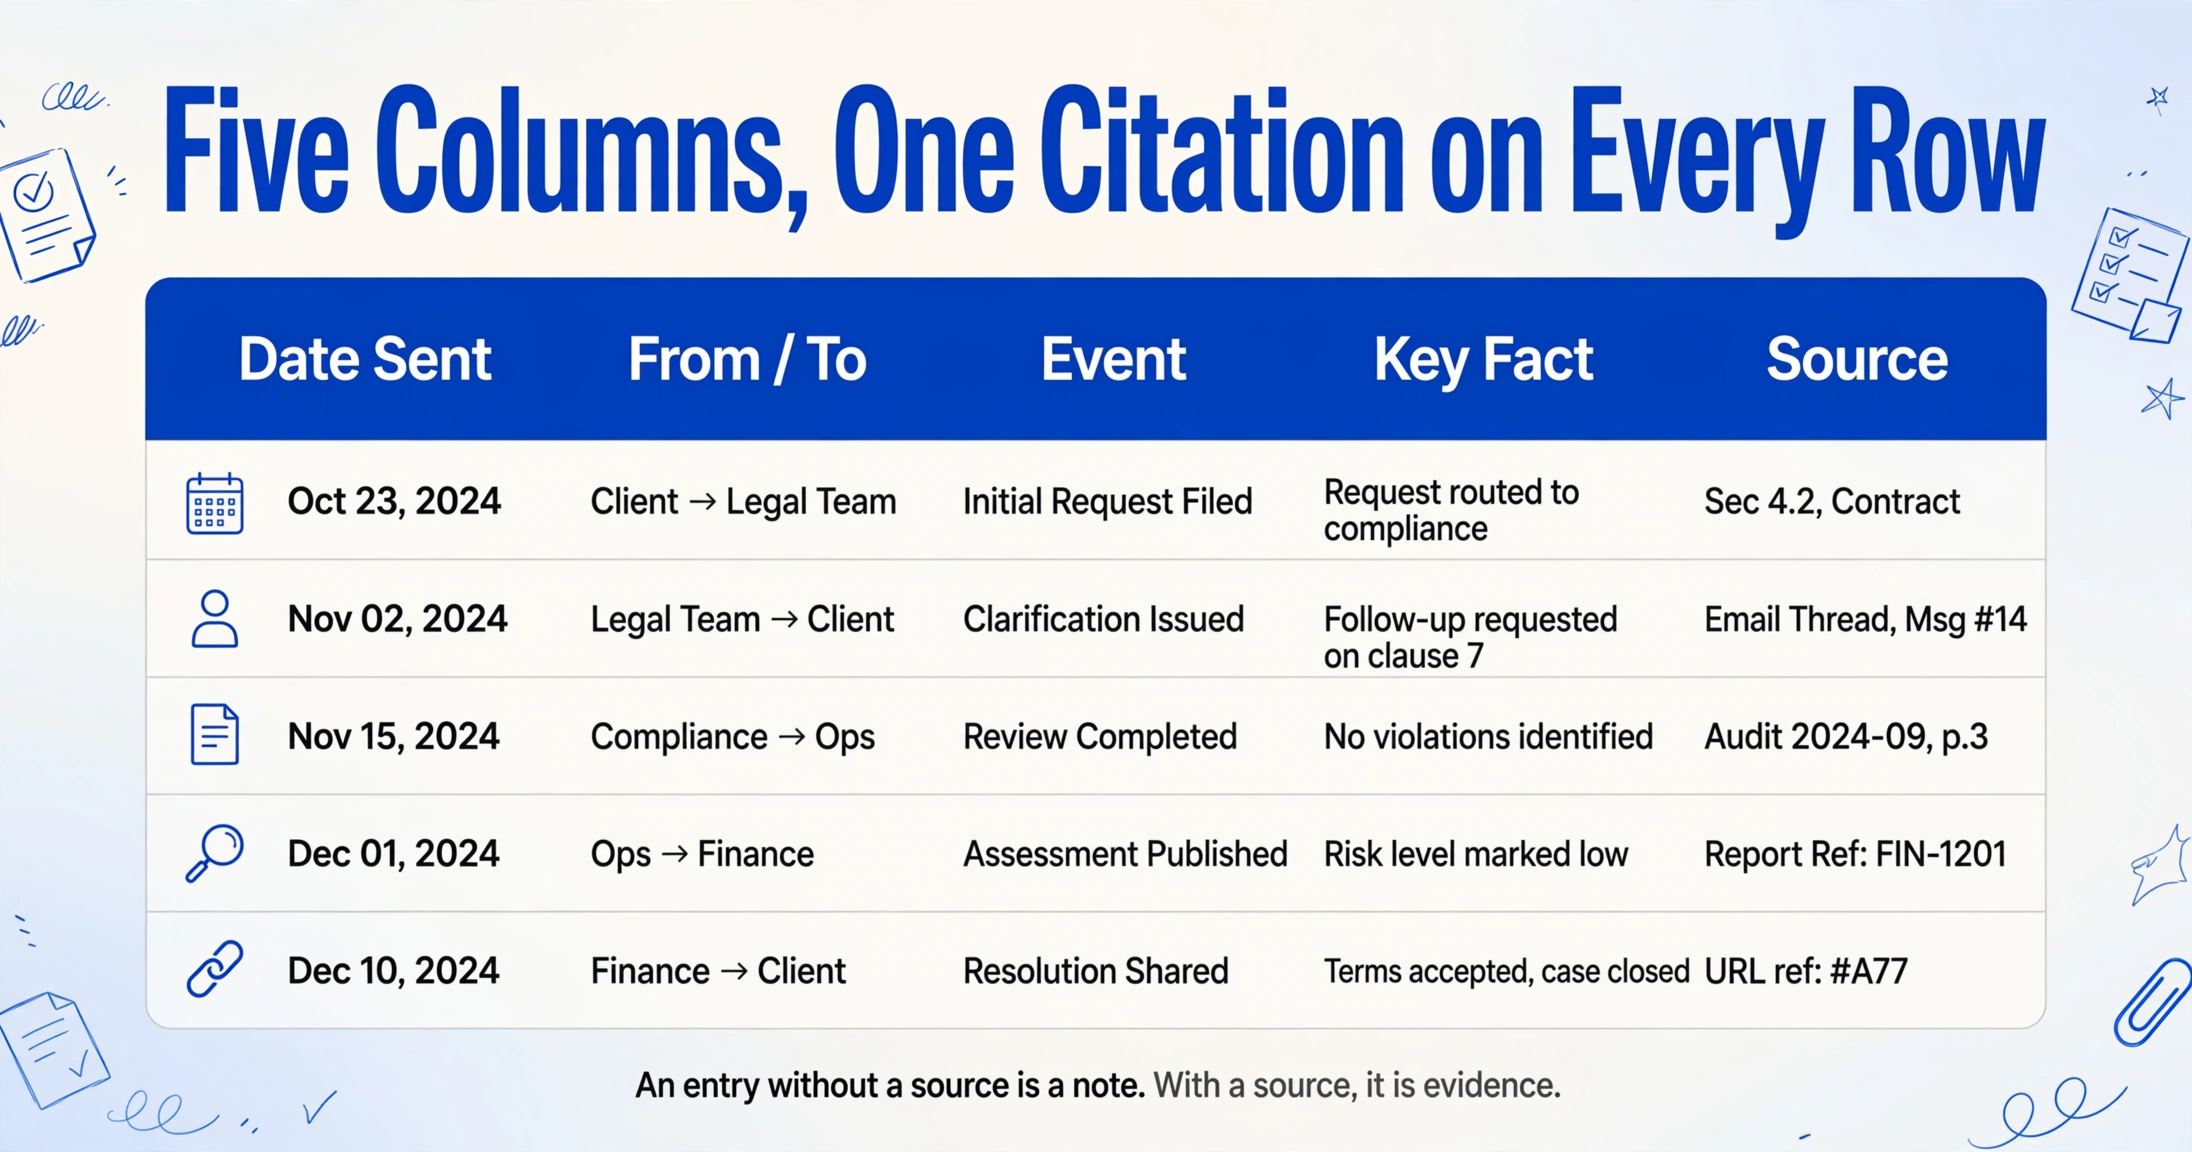
Antes de comparar ferramentas, é útil definir como deve ser o resultado, porque o problema do e-mail é, na verdade, um problema de coluna. Uma cronologia de caso construída a partir de correspondências às vezes é chamada de cronologia de e-mail ou linha do tempo de e-mail, e tem o mesmo esqueleto de qualquer outra: uma data, um evento, as partes, o fato que estabelece e a fonte de cada linha. Uma cronologia que um tribunal ou uma seguradora aceitará contém todos os cinco, citados.
| Coluna | O que contém | Por que é importante |
|---|---|---|
| Data de Envio | AAAA-MM-DD, a data em que a mensagem foi enviada, distinta da data de encaminhamento | Ordenar esta coluna é o que transforma uma pilha em uma linha do tempo |
| De / Para | O remetente e os destinatários, por nome e endereço | Estabelece quem sabia o quê e quando |
| Evento | Uma descrição de uma linha do que aconteceu ou foi acordado | A espinha dorsal da narrativa |
| Fato-chave | A admissão, instrução, advertência ou contradição que a mensagem contém | Separa as vinte linhas que importam das duzentas que não importam |
| Fonte | Linha de assunto mais data, ou a referência do anexo, para a mensagem exata | Uma entrada sem fonte é uma anotação. Com fonte, é uma evidência |
Para registros eletrônicos, a coluna de fonte não é decoração. As Regras Federais de Processo Civil tratam as informações armazenadas eletronicamente como uma categoria própria, e a Regra 26 define o escopo do que é descoberto, incluindo a proporcionalidade às necessidades do caso (Regra 26 das FRCP). A Regra 34 permite que a parte solicitante especifique a forma na qual essas informações são produzidas, razão pela qual uma cronologia que aponta claramente de volta para uma mensagem é mais defensável do que uma que diz "e-mail, em algum momento de março."
O e-mail é a fonte mais difícil de um arquivo de caso para transformar em linhas limpas
Um único thread encaminhado pode conter dez mensagens, três datas candidatas e nenhuma ordem confiável, e é por isso que a etapa de ingestão é onde o trabalho trava, independentemente do software de linha do tempo que você use. Os documentos que dominam o conteúdo de linhas do tempo jurídicas (boletins de ocorrência, depoimentos, registros médicos, petições) chegam cada um como um único arquivo com uma única data. O e-mail chega como uma conversa, e uma conversa não cabe em uma linha sem ser desmontada primeiro.
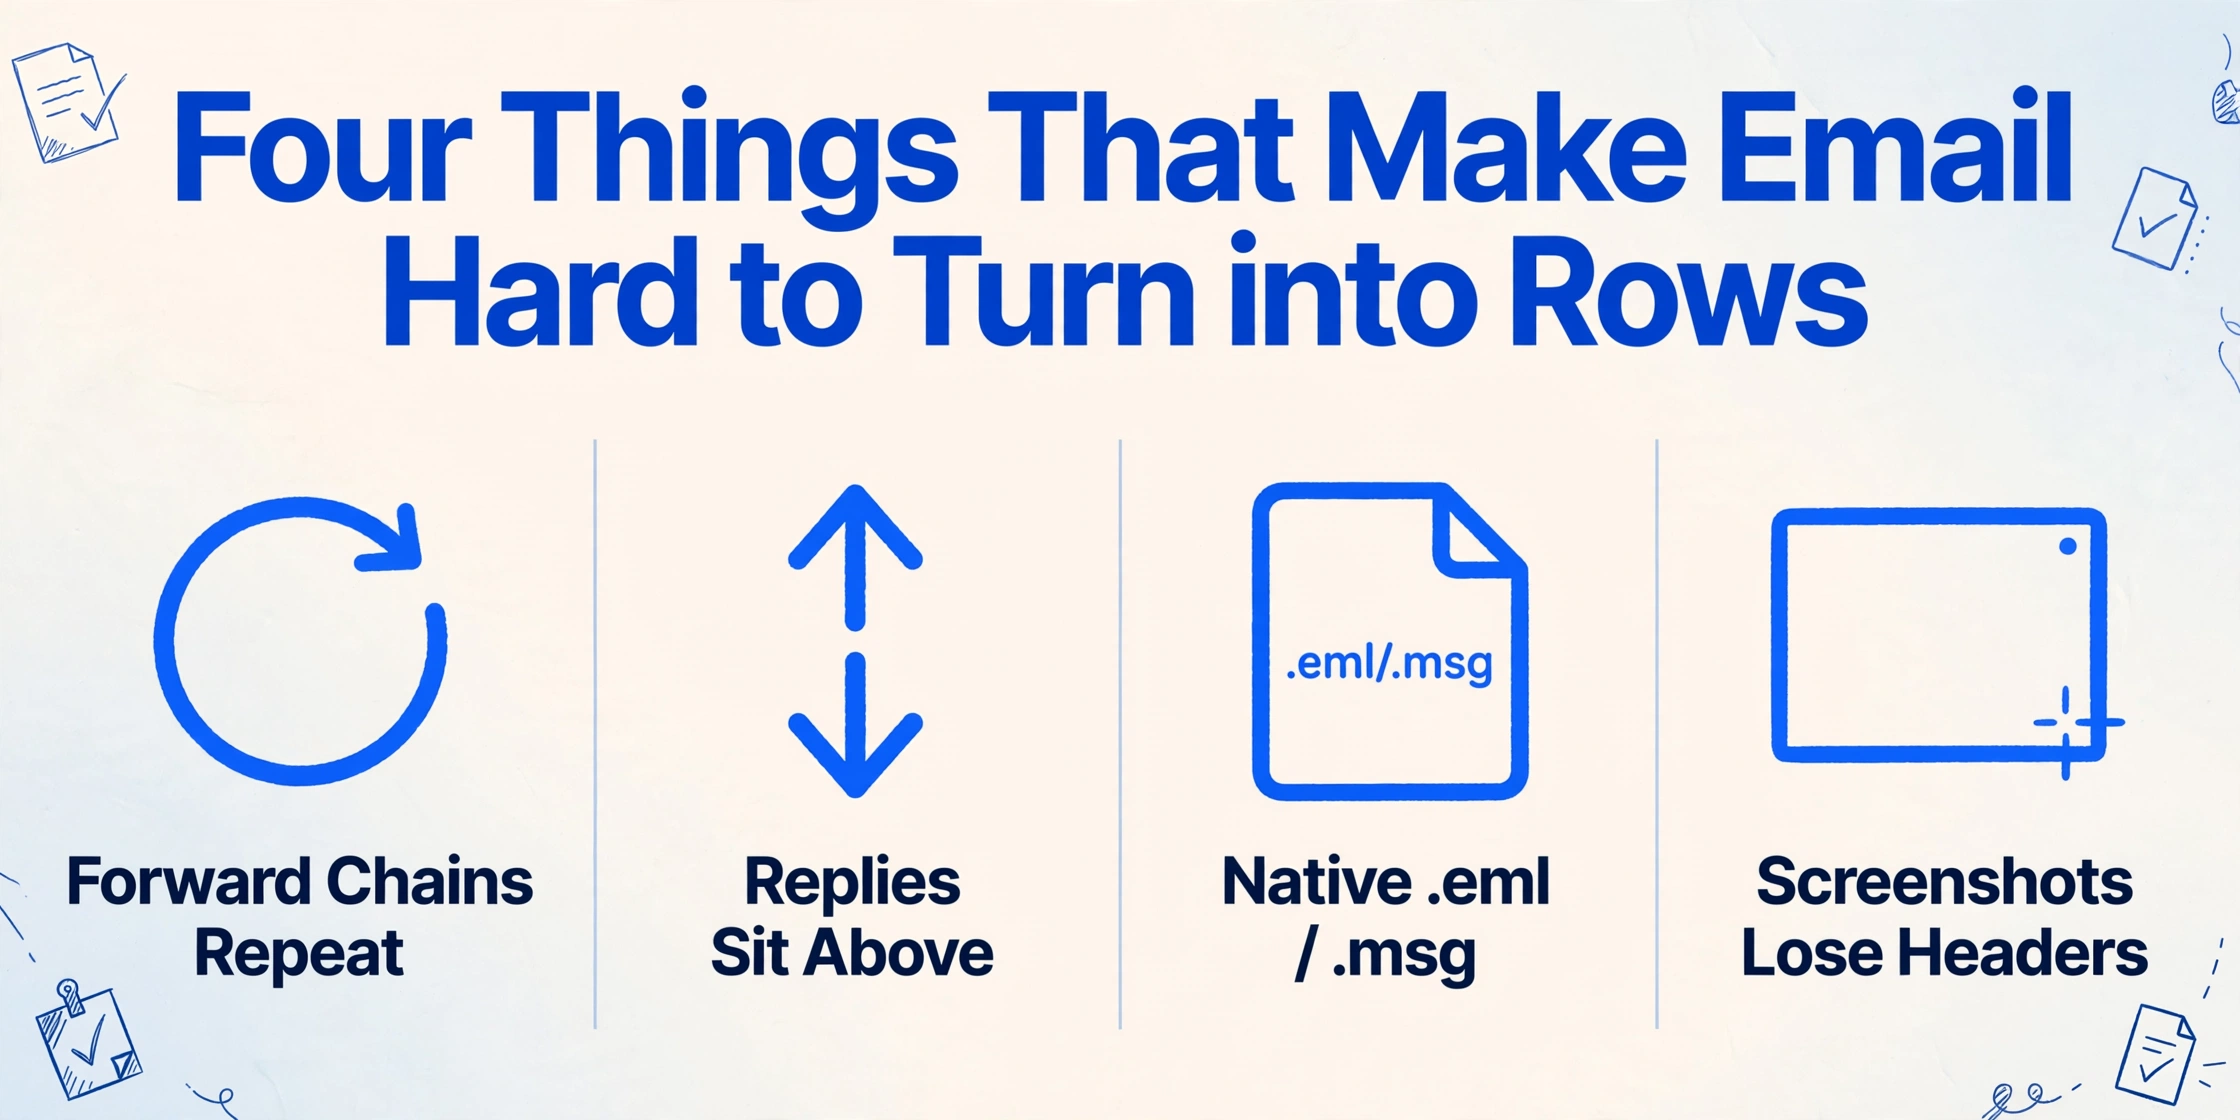
Quatro coisas tornam a desmontagem difícil. Uma cadeia de encaminhamento cita todas as mensagens mais antigas abaixo da mais nova, então o mesmo evento aparece várias vezes, e a cópia citada geralmente mostra um horário exibido diferente. Uma resposta fica acima da mensagem que ela responde, então ler de cima para baixo não é ler em ordem. Arquivos .eml e .msg nativos são exportações de caixa de entrada, em vez dos PDFs e imagens que a maioria das ferramentas de extração aceita. E uma captura de tela de um thread, a coisa mais rápida que um cliente pode enviar, perde completamente os cabeçalhos de remetente e destinatário.
As pessoas que fazem esse trabalho descrevem o gargalo nos mesmos termos que o restante deste artigo usa. No r/paralegal, um comentarista de suporte a litígios resumiu todo o trabalho como "o trabalho real é extrair-normalizar-sequenciar", acrescentando que a dificuldade é encontrar o nível certo de detalhe porque "muito esparso e eles perdem a causalidade, muito granular e é ruído." No mesmo thread, um paralegal descreveu o envio de uma linha do tempo por e-mail a um advogado após classificar marcadores manualmente e nomeou o desperdício exato: "Acho que economizaria tempo se eu pudesse simplesmente copiar e colar os marcadores no PDF em um e-mail para o advogado em vez de redigitá-los" (r/paralegal). Extrair, normalizar, sequenciar. Cada minuto gasto antes do sequenciamento é um minuto não gasto no caso.
Este é um problema mais restrito do que o já abordado ao extrair fatos de documentos de descoberta, como depoimentos e registros médicos, onde os arquivos de origem são separados e cada um tem sua própria data. O e-mail é diferente porque a entrada é um thread, e o problema de ingestão é intrínseco ao formato.
Transformando Threads de E-mail em Colunas Classificáveis e Depois Ordenando-as em uma Cronologia
Você transforma uma pasta de e-mails em uma cronologia datada tratando cada mensagem como uma linha e definindo as colunas antes de qualquer leitura, de modo que a etapa de leitura seja um preenchimento, e não um copiar e colar. O ImageToTable.ai faz isso com dois recursos que já existem no produto: Email Inbox, que coloca as mensagens na fila sem download ou novo upload, e Custom Column Extraction, que transforma o conteúdo da mensagem nas colunas exatas que uma cronologia precisa.
O Email Inbox dá a cada conta um endereço de caixa de entrada dedicado. Você encaminha as mensagens que pertencem ao caso para esse endereço, ou configura uma regra de encaminhamento na sua própria caixa de entrada para que elas sejam roteadas para lá na chegada, e elas caem na fila de processamento sem login e sem página de upload. Uma lista de remetentes permitidos mantém e-mails não relacionados fora. A configuração mais importante aqui é o modo de processamento. Por padrão, a caixa de entrada lê anexos reais e ignora o corpo, o que é errado para uma disputa que vive no texto da conversa. Você pode alternar para somente corpo, ou para anexos e corpo, de modo que uma mensagem escrita como texto simples e uma mensagem com PDF anexado sejam ambas lidas na mesma passada.
A Custom Column Extraction transforma o conteúdo da mensagem nas colunas da cronologia. Você digita os nomes que deseja, como Date Sent, From, To, Subject, Event, Key Fact e Source, e esses nomes se tornam os cabeçalhos da saída. A IA localiza cada valor entendendo o que ele significa, em vez de corresponder a uma posição fixa ou a um modelo, de modo que uma cadeia de encaminhamento, uma mensagem simples e uma mensagem com resposta citada sejam todas lidas da mesma forma. Como o e-mail é HTML e as tabelas HTML e os blocos de citação não se alinham de forma previsível, ler pelo significado é o que mantém os cabeçalhos estáveis entre remetentes que formatam seus e-mails de maneiras diferentes.
O processamento em lote coloca cada mensagem em uma única planilha, e a cronologia está a uma classificação de distância. Envie ou encaminhe o conjunto inteiro de uma vez e as mensagens serão mescladas em um único arquivo Excel, uma mensagem por linha. Classifique por Date Sent em ordem crescente e a linha do tempo aparece. Filtre por From ou To para isolar o lado de uma das partes na conversa. Examine a coluna Key Fact em busca de contradições, da mesma forma que você leria o relato de uma testemunha contra um documento.
Direcione o e-mail para a fila
Encaminhe as mensagens do assunto para o endereço de caixa de entrada dedicado da sua conta ou configure uma regra de encaminhamento para que cheguem automaticamente. Ative a lista de remetentes permitidos para manter e-mails não relacionados fora, e escolha anexos e corpo para que as mensagens que carregam a história no texto também sejam lidas.
Nomeie as colunas da cronologia uma vez
Digite Data de Envio, De, Para, Assunto, Evento, Fato-chave e Fonte, e salve-os como modelo. Os nomes das colunas se tornam os cabeçalhos da saída. Vincule o modelo e ative o Auto-Processar para que a extração comece no momento em que uma mensagem chegar.
Classifique a planilha mesclada e verifique
Cada mensagem chega como uma linha em uma planilha. Classifique por Data de Envio para ler o assunto em ordem, filtre por parte e examine Fato-chave para encontrar admissões e contradições. Para qualquer linha em que uma resposta citada tornou a fonte ambígua, passe o mouse sobre a célula para ver exatamente de qual texto o valor veio.
A etapa de verificação vale a pena, porque uma cadeia de encaminhamento pode repetir a mesma data várias vezes. O modo de revisão do ImageToTable.ai destaca o texto-fonte por trás de qualquer célula extraída, então confirmar de qual cópia de uma data uma linha veio é um relance, não uma releitura. Isso se soma ao trabalho que você já faz com anexos de e-mail, como um parser de e-mail que lê os arquivos anexados a uma mensagem, e a mesma abordagem em lote descrita para produzir documentos de descoberta legal em lote em uma única planilha.
Os arquivos são processados com segurança e não são armazenados.
O Que Isto Não Faz
Esta abordagem lê o conteúdo de e-mails e o organiza em colunas classificáveis, mas não preserva os metadados nativos da caixa postal, não substitui uma plataforma de eDiscovery e não produz, por conta própria, uma peça pronta para o tribunal. Cinco limites merecem ser declarados antes de você construir um fluxo de trabalho sobre ela.
Arquivos nativos .eml e .msg precisam ser convertidos ou encaminhados primeiro. Uma exportação bruta da caixa postal não é um arquivo que a ferramenta carrega diretamente. Converta-o para PDF, ou encaminhe as mensagens pela caixa de entrada de e-mail, e ele se torna uma entrada. Isso importa mais do que parece: molda a forma como você coleta o material de um cliente.
As colunas De, Para e Data são valores extraídos, não os cabeçalhos originais do e-mail. Elas vêm do que a mensagem mostra a um leitor. Isso geralmente é suficiente para uma cronologia, e não é o mesmo que os cabeçalhos brutos, o fuso horário ou o caminho de entrega que uma plataforma de eDiscovery registra. Se você precisar dos cabeçalhos originais para autenticação, trabalhe a partir da caixa postal de origem.
A confidencialidade continua sendo uma decisão sua. Nos termos do Parecer Formal 512 da ABA, colocar a correspondência do cliente em uma ferramenta de IA é uma decisão sobre competência e confidencialidade do cliente. Confirme como qualquer ferramenta lida e retém os arquivos antes de direcionar um caso para ela.
Não é uma plataforma de eDiscovery. Não há log de privilégio, numeração Bates, thread de e-mail entre custodiantes ou codificação preditiva. Para casos que envolvem dezenas de milhares de documentos, terabytes de dados ou um formato de produção defensável, as plataformas de revisão cuidam desse trabalho, e a escolha entre uma ferramenta de extração leve e uma plataforma completa é exatamente a comparação apresentada em software de revisão versus extração por IA para um escritório pequeno. Para o panorama mais amplo de ferramentas, o guia de software de extração de documentos para equipes jurídicas cobre onde cada tipo se encaixa.
A saída é uma planilha que você controla. Você obtém um arquivo Excel, CSV ou JSON, ou linhas gravadas no Google Sheets. Não é uma superfície de visibilidade para o cliente ou de colaboração, e não substitui o sistema de gestão de casos que o Clio ou o MyCase oferece. Ele substitui a parte do fluxo de trabalho em que alguém lê e-mails e digita as datas.
FAQ
Consegue extrair datas e remetentes de um thread de e-mail encaminhado?
Sim. Cada mensagem no conjunto vira uma linha, e as colunas que você definir, como data de envio, De, Para, Assunto e fato-chave, são preenchidas pela leitura do conteúdo da mensagem. Um bloco de citação que repete uma mensagem mais antiga é uma ambiguidade conhecida, por isso o modo de revisão permite que você confirme de qual texto um valor veio.
Ele preserva os metadados originais do e-mail?
Ele extrai De, Para e Data como colunas na saída, com base no que a mensagem apresenta. Isso não é o mesmo que os cabeçalhos nativos de e-mail ou dados de fuso horário. Se você precisar dos cabeçalhos brutos para autenticação, colete as mensagens da caixa de correio de origem, em vez de encaminhamentos.
Consegue ler arquivos .eml ou .msg diretamente?
Não diretamente. Uma exportação bruta da caixa de correio precisa ser convertida em PDF ou encaminhada pela caixa de entrada de e-mail primeiro. As entradas suportadas são PDF, JPG, PNG, WebP e AVIF, então um arquivo de mensagem nativo precisa de uma etapa de conversão antes de ser processado.
Quais colunas uma cronologia do caso deve ter?
Um conjunto prático é data de envio, De, Para, Assunto, evento, fato-chave e fonte. A coluna de evento carrega a descrição em uma linha, a coluna de fato-chave carrega o que a mensagem comprova, e a coluna de fonte aponta para a mensagem exata para que qualquer entrada possa ser verificada depois.
Isso substitui uma plataforma de eDiscovery ou de cronologia?
Não. Ele lê e-mails e documentos em uma planilha classificável e não faz revisão de privilégio, produção Bates ou codificação preditiva em escala. É o passo anterior às ferramentas de gerenciamento de caso e revisão: transformar a correspondência bruta em linhas estruturadas para que uma pessoa possa construir a cronologia rapidamente.
É seguro colocar e-mails de clientes nele?
Essa é uma decisão profissional com base nos deveres de confidencialidade e competência descritos no Parecer Formal 512 da ABA, e a resposta depende das obrigações do seu escritório e de como a ferramenta lida com os arquivos. Confirme a política de retenção e tratamento e encaminhe apenas o que o caso exigir. A extração não altera o seu dever de verificar o resultado antes de usá-lo.
A mudança útil é esta: pare de tratar o e-mail como algo para ler e redigitar e comece a tratá-lo como uma tabela que ainda não tem cabeçalhos. Defina as colunas uma vez, deixe que as mensagens as preencham, e a cronologia do caso se torna o que sempre deveria ser: uma visão ordenada do que aconteceu, em vez de uma nova transcrição disso.