Data Extraction vs Data Scraping
請求書にURLがない場合
ウェブスクレイパーとドキュメント抽出ツールに同じ銀行取引明細書をスプレッドシートに入れるよう指示すると、どちらも表を返します。一方は明細書を読み取り、もう一方はそれをダウンロードとして提供していたウェブページを読み取ったのです。
最もよくある失敗も、それぞれ異なる場所で起こります。スクレイパーは通常、目に見える場所で壊れます。クラス名が変わり、セレクタが何も返さなくなり、誰かがその日のうちに気づきます。ドキュメント抽出ツールは通常、単一のフィールド内で壊れます。ある金額が1桁ずれても、行数は依然として一致し、その列を突合するまで何もおかしく見えません。どちらの失敗をチームが吸収できるかは、ベンダーがどのカテゴリを主張するかよりも、優れた購入判断の問いです。
主なポイント
- スクレイパーもドキュメント抽出ツールも、同じ銀行取引明細書から表を渡してくるので、パッケージのラベルだけでは何も決まりません。
- 1桁のずれで十分です。ドキュメント抽出ツールの行数は依然として一致し、その列を合計して初めてエラーが表面化します。
- データが今どこにあるかがツールを決めるので、リクエストできるものはスクレイピングし、すでに手元にあるファイルは抽出しましょう。
定義は揺れる。情報源は揺れない。
この2つの用語には合意された定義がなく、だからこそ比較が何度も振り出しに戻ります。Bodleian Librariesのテキスト・データマイニングガイドでは、ウェブスクレイピングとスクリーンスクレイピングはデータベースやドキュメントと並んでデータスクレイピングの項目に分類されています。十数のベンダー解説記事はデータ抽出を上位概念とし、スクレイピングをその下に置いています。標準化団体がこの言葉の決着をつけたことはありません。
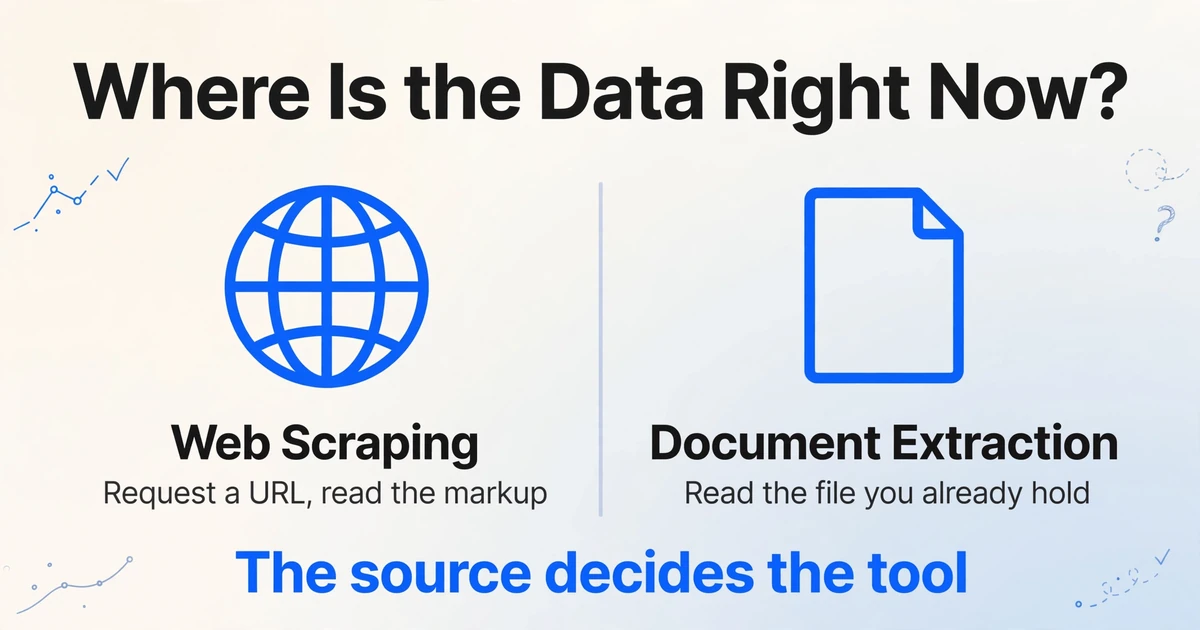
定義の不一致は、目の前の判断を変えません。ウェブスクレイピングは稼働中のウェブインターフェースからデータを収集します。ツールがURLをリクエストするかブラウザを操作し、HTML、レンダリングされたDOM、または埋め込みJSONを受け取り、その構造から値を取り出します。ドキュメント抽出は、すでに手元にあるファイルから名前付きの値を読み取ります。それがPDF、スキャン、領収書のスマホ写真、スクリーンショット、メール添付ファイルのいずれであっても同じです。リクエストする先も、検査するマークアップもありません。
定義の問題をすり抜ける近道は、データが今どこにあるかを問うことです。場所をリクエストして取得できるならスクレイピングの問題であり、サイトがAPIを提供しているならAPIの問題です。すでにファイルの中にあるなら、ドキュメントの問題です。
| 比較項目 | ウェブスクレイピング | ドキュメント抽出 |
|---|---|---|
| 出発点 | URL、またはそのリスト | ファイル: PDF、スキャン、写真、スクリーンショット、メール添付ファイル |
| ツールが読み取るもの | 配信されたページ: HTML、レンダリングされたDOM、埋め込みJSON | ピクセル、またはページの記述。ドキュメントオブジェクトモデルは存在しない |
| 値の特定方法 | CSSセレクタ、XPath、またはレスポンス内のパターン | レイアウトの再構築と意味の理解: どの数字が合計か |
| 壊れる原因 | マークアップの変更、ログインの壁、ボットチェック、画像としてレンダリングされた内容 | 不鮮明なスキャン、密集した手書き文字、同じ値が2回現れるページ |
| 情報源を管理するのは誰か | サイトを運営している人 | あなた、またはファイルを送ってきた相手 |
| 典型的な用途 | 競合の価格、商品リスト、ディレクトリ、検索結果 | 請求書、銀行取引明細書、領収書、契約書、フォーム |
スクレイパーが読み取るもの
スクレイパーはブラウザに渡されたマークアップを読み取ります。だからこそ、高速で安価、かつ正確であり得るのです。
URLにリクエストが送られ、サーバーがドキュメントを返し、そのドキュメントが要素のツリーに解析され、セレクタが値を持つ要素を選び出し、その処理がスケジュールに従ってページをまたいで繰り返されます。JavaScriptを多用するサイトでは、まずヘッドレスブラウザを動かすことがあり、選択が行われる前にツリーが存在することになります。
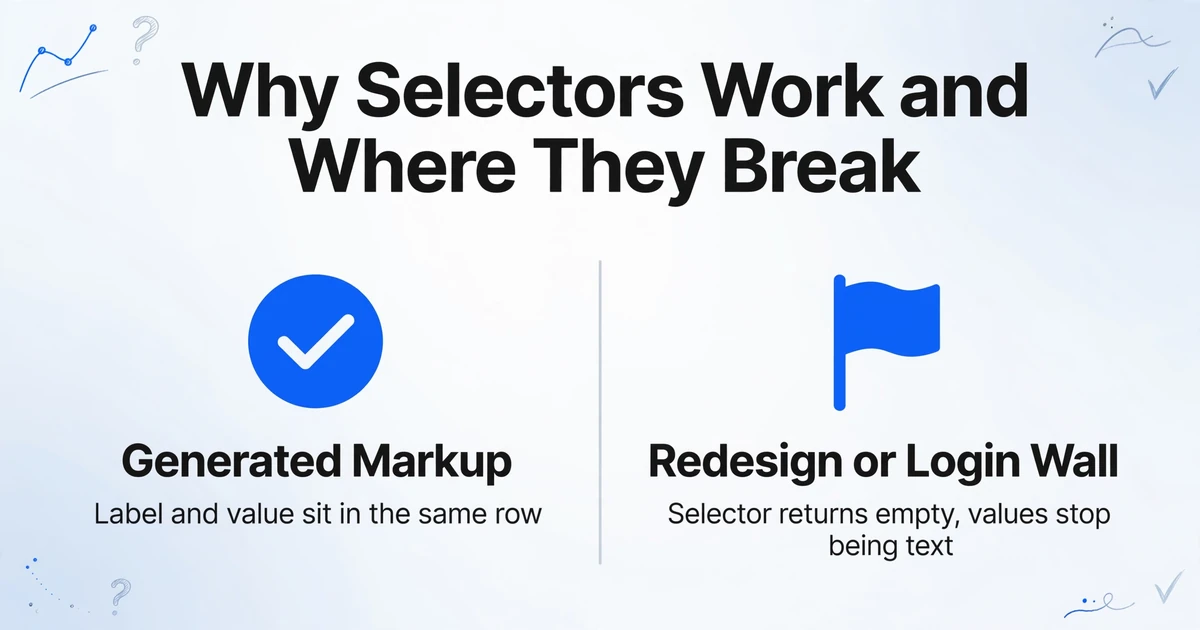
セレクタが機能する理由は、見落とされがちです。価格を表示するページはデータから生成されているため、ラベルと値は同じ行にあり、同じテンプレートによって書かれています。クラス.amountのセルをコピーすることは、サイト自身のコードがレンダリングに使ったフィールドを読み取ることになります。
セレクタは、ページがデータから生成されているからこそ機能するショートカットです。ソースが生成されたマークアップでなくなれば、そのショートカットは一切通用しません。
だからこそ、スクレイピングは特定の形で壊れます。リデザインでクラス名が変わり、セレクタが空のリストを返す。テーブルがcanvasや画像の中に移動し、値がテキストでなくなる。ログインウォールやボットチェックが、解析が始まる前にリクエストを止める。これらはアクセスと構造の問題であり、解決にはエンジニアリングの時間がかかります。
同じ性質が、混在プロジェクトで最もよくある誤りを説明します。ページを扱うツールなら、それに添付されたファイルも扱えるはずだという思い込みです。ある開発者はその壁を端的に述べています。「ほとんどのスクレイパー(BeautifulSoup、Playwrightなど)はHTMLの扱いには役立ちますが、クロール中にPDFを扱うには追加のレイヤーが必要です」。
ドキュメント抽出が代わりに読み取るもの
PDFには表オブジェクトも行もセルもありません。ページ上の座標にグリフを配置するための命令があるだけです。
これは文字通りの意味です。PDF仕様であるISO 32000は、テキストを一連の変換行列内でテキスト表示演算子によって配置されたグリフとして記述しています。画面上では構造化されて見える表も、たまたま整列した文字の集合にすぎません。ファイルが記録しているのは配置であり、関係性ではないため、パーサーは4つの値が1つの行に属すること、そして右端の値が2つ目の金額ではなく残高であることを推測しなければなりません。スキャンはさらに一段遠く、テキストレイヤーのない画像です。
作業の順序は逆転します。スクレイパーはどの要素が価格を保持しているかを問います。ドキュメント抽出ツールは、ある領域が表かどうか、ヘッダーがどこで終わるか、値がその上の行に属するか下の行に属するか、そしてどの数値が小計や税ではなく合計かを判断しなければなりません。光学文字認識は読み取り順に文字を返してそこで止まります。これが転記と抽出の違いです。
セマンティックレイヤーはサプライヤーごとのルール問題を取り除きます。ImageToTable.aiはカスタム列抽出を中心に構築されています。欲しい列名(「明細日」や「金額」など)を入力すると、モデルは前回の明細書のどこにあったかではなく、ラベルの意味を理解して各値を特定します。サプライヤーがレイアウトを変更しても、この種のツールにとってはイベントではありません。特定の基準が位置ではなかったからです。
2つのアプローチが実際に分岐する場所
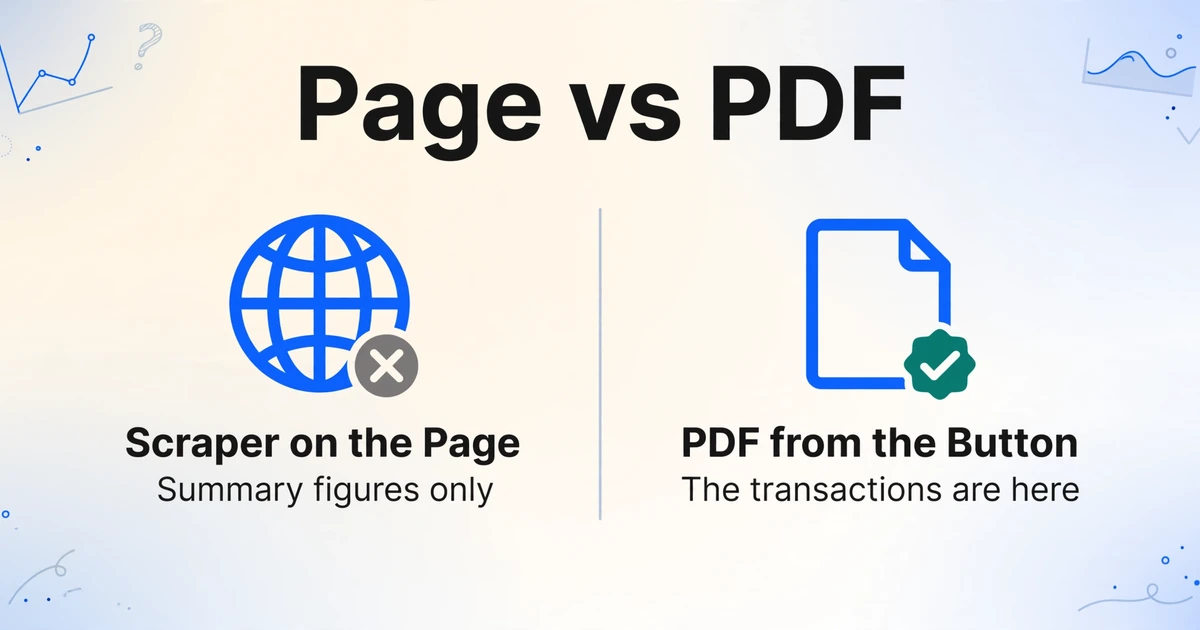
分岐が現れるのは1か所、必要な値を持つソースのレイヤーです。
ポータルに公開された銀行取引明細書はそれを可視化します。ページには概要ブロックが表示されます。期首残高、期末残高、入金、出金、そして明細書をPDFとしてダウンロードするボタンです。そのページを対象にしたスクレイパーは数秒で数値を返します。取引はボタンが生成するPDFの中にあり、ページ上のどこにも含まれていません。これはこの誤りのよくある形であり、エラーメッセージも出ないまま毎月繰り返されます。
同じPDFを位置ベースのパーサーで読むと、2つ目の失敗が現れます。残高列は右揃えなので、その数字は金額列の近くに位置します。空白でテキストをグループ化すると列が結合することがあり、桁区切りでテキストランをまたいで分割された数値は2つの断片として届くことがあります。出力は正しい行数とそれらしい合計を持つ有効なスプレッドシートです。誤りが表面化するのは、取引の合計が期末残高から期首残高を引いた額と一致するかを誰かが確認したときだけです。
3つ目のケースは最も単純で最も一般的です。メール添付で届く請求書には取得すべきページがありません。サプライヤーがPDFを生成して送信したのです。URLもマークアップもないため、スクレイピングスタックは誰かがドキュメントのステップを追加するまで何もできません。
概要ページを返すスクレイパーは故障していません。ソースの間違ったレイヤーに対して、求められたことを正確に実行しただけです。
見落とされがちなのは、たいてい見出しの数字ではありません。データを使い物にするための詳細です。
- 明細行。要約ページには合計が載り、請求書PDFにはその合計が何で構成されているかが載っているからです。
- 明細書の2ページ目以降。1ページ目に要約ブロックがあるからです。
- 金額の符号。クレジットが括弧付きで印刷され、テキストとしてコピーされたときです。
- 請求先住所。配送先住所と似たブロックにあるからです。
- ページを1つのレコードに結合するための識別子。
スクリーンショットは、ウェブサイトを写していてもドキュメントである
銀行のダッシュボードのスクリーンショットは、そのすべてのピクセルがウェブページ由来であっても、ドキュメントです。
これは先ほどの混同の逆で、ウェブコンテンツといえばウェブスクレイピングだと覚えたばかりの人をとらえます。PNGにはDOMもセレクタもなく、多くの場合到達可能なURLもありません。その状態に至るにはログインと3回のクリックが必要だったかもしれません。それを読み取るツールは、ピクセルを読み取るツールです。ポータルからダウンロードしたPDFも同じです。ディスクに保存された時点で、URLは重要でなくなります。スクリーンショットの取り込みについてはスクリーンショットからのデータ抽出で扱っています。
法的な問題は種類が異なる
スクレイピングは、そのデータに到達することが許されていたかを問います。ドキュメント抽出は、すでに保有しているデータで何をしてよいかを問います。
スクレイピング側では、利用規約が契約であり、実際のリスクのほとんどはそこにあります。技術的なチェックは見た目より弱いものです。2022年にRFC 9309として標準化されたRobots Exclusion Protocolは、その序文で、そのルールは「アクセス許可の一形態ではない」と述べています。robots.txtファイルは、運営者が何を望むかを示すものです。許可を与えるものではありません。
hiQ Labs v. LinkedInは、リスクがどこに落ちるかを示しています。2022年、第9巡回区控訴裁判所は、hiQが公開プロフィールを収集し続けることを認める差止命令を支持し、その理由として、公開データのスクレイピングはそれ自体ではComputer Fraud and Abuse Actの下で「許可されたアクセスを超える」ものではないとしました。これはスクレイパーにとって勝利に見えました。しかし事件は別の結末を迎えました。2022年11月、地方裁判所はhiQがLinkedInのユーザー契約に違反したと認定し、その12月に同意判決により50万ドルの判決が下され、hiQは恒久的にスクレイピングを禁じられました。契約上の請求は、劇的な理論よりも長く生き残りました。
金融チームにとって厄介なケースは、カテゴリ比較にはほとんど現れません。あなたの銀行口座の取引はあなたのデータですが、インターフェースは銀行のものです。自分の認証情報でそのインターフェースを自動化すると、お金が自分のものであっても銀行の規約に違反する可能性があります。まずエクスポートを依頼するか、公式APIの有無を確認してください。英国とEUでは、アクセスが画面自動化を経由しなくて済むようにオープンバンキングのルールが存在します。
ドキュメント側では、適法な所持が分析の出発点です。明細書には個人データが含まれるため、保持、アクセス、および処理者がファイルをどこに保存するかがすべて問題になります。その作業はプライバシーまたはコンプライアンスの担当者に属します。このセクションは、どの質問を誰に回すかの地図として扱ってください。法的助言ではありません。
データソース別の判断表
ソースがツールを決めますが、ほとんどのチームは同じ表の異なる行のために両方のツールを必要とします。
| データの場所 | 最初の一手 | 理由 | 注意点 |
|---|---|---|---|
| 受信トレイの請求書PDF | ドキュメント抽出 | URLがありません。ファイル自体が記録です | レイアウトはサプライヤーごとに異なるため、位置に依存するルールはサプライヤーごとに1つ必要です |
| ポータルからダウンロードした明細書PDF | ドキュメント抽出、テキストレイヤーまたはOCR | 右揃えの残高列を伴う複数ページの表 | 取引の合計を期首残高と期末残高に対して突合します |
| オンラインバンキングでのみ確認できる取引 | エクスポートまたは公式API、その後抽出 | あなたの認証情報、銀行のインターフェース | 利用規約とUIの変更。画面自動化は最後の手段です |
| 明細書を公開するサプライヤーポータル | 2ステップ:ファイルを取得し、その後抽出 | ダウンロードは自動化。読み取りは抽出です | 片方が変わっても他方に影響しないよう分離しておきます |
| 競合他社の価格や商品リスト | ウェブスクレイピング | データはライブページとしてのみ存在します | セレクタはリニューアルで壊れます。構築前に規約を確認してください |
| ダッシュボードやアプリのスクリーンショット | ドキュメント抽出 | ファイルはピクセルであり、その状態は再現できない可能性があります | 解像度とトリミングが、モデル以上に結果を左右します |
ポータルが必要なドキュメントを公開している場合、作業は2つに分かれます。何かがスケジュールに従ってファイルを取得し、何かがそれを読み取ります。読み取りステップがファイルの出所を気にしないようにパイプラインを構築すれば、銀行がAPIを提供した日に取得ステップを1つ削除するだけです。
ドキュメント抽出が対応できない領域
ドキュメント抽出はファイルが存在してから始まるため、ファイルを取得する問題は解決できません。
この境界は曖昧にせず明言しておく価値があります。ImageToTable.aiはドキュメントを読み取ります。ウェブサイトをスクレイピングしたり、ページをクロールしたり、ブラウザを操作したり、HTMLを解析したりはしません。PDF、画像、スクリーンショットをアップロードするか、メール受信アドレスに転送すると、テーブルが返ってきます。元のレイアウトが必要な場合はWordファイルも可能です。明細書が銀行のログインの背後にしか存在しない場合、抽出はパイプラインの後半部分にすぎません。
また、どの数字が正しいかも判断しません。ページに書かれている内容を読み取るだけです。きれいに印刷された表は簡単なケースで、当社のドキュメントでも印刷された表データについて最大99%の精度を謳っていますが、デスクライトの下でしわくちゃになった領収書の写真はそのケースには当たりません。密集した手書き文字や特殊なレイアウトでは、処理ティアとレビュー工程がその価値を発揮します。OCR、抽出、そして完全なIDPプラットフォームの違いについてはAIドキュメント抽出とは実際に何かで解説しています。
信頼できるのはバッチワークフローです。列に名前を付け、異なる取引先からのファイルを1つのバッチにまとめて投入すると、同じフィールドが同じ順序で並んだ1つのテーブルが得られます。手入力に3分かかっていたページが数秒で処理できます。この効果は確かにありますが、1つのツールがスクレイピングスタックとドキュメントパイプラインを同時に置き換えるという主張ほど大きなものではありません。
よくある質問
OCRはウェブスクレイピングと同じですか?
いいえ。OCRはピクセルから文字を読み取り、ウェブスクレイピングはライブページからマークアップを読み取ります。両者が交わるのは1つの狭いケースだけです。一部のサイトはスクレイパーを妨害するためにテキストを画像として描画しており、スクレイピングパイプラインがその画像に対してフォールバックとしてOCRを実行することがあります。OCRはスクレイピングジョブの内部コンポーネントであり、同義語ではありません。
ウェブスクレイパーはPDFの請求書を読み取れますか?
PDFをダウンロードすることはできます。請求書を読み取る部分はドキュメントパーサーです。PDFには選択できる要素が存在しないからです。ファイルにテキストレイヤーがあればパーサーが読み取れますが、スキャンの場合はOCRかビジョンモデルが先にページ画像を読み取る必要があります。スクレイピングフレームワークはファイルを取得しますが、そのセレクタのどれも開けないバイナリが残るだけです。
自分の銀行のオンラインバンキングサイトをスクレイピングできますか?
まず明細書のエクスポートや公式APIがないか確認してください。データはあなたのものですが、インターフェースは銀行のものであり、その自動化は通常、銀行の利用規約に従います。画面の自動操作は、銀行がページを再設計するたびに壊れます。明細書をエクスポートしてから、ファイルから抽出してください。
ダッシュボードのスクリーンショットにはどちらが必要ですか?
ドキュメント抽出です。スクリーンショットはDOMのないラスター画像で、多くの場合アクセス可能なURLもないため、スクレイパーが選択できるものが何もありません。スキャンと同様に扱い、元の画像が精度の上限を決めると考えてください。
どちらにも開発者が必要ですか?
スクレイピングには通常必要で、その後も必要であり続けます。セレクタ、プロキシ、アンチボット対策は継続的なメンテナンスだからです。ドキュメント抽出はノーコードツールならコードは不要で、この工程を自社システムに組み込みたい場合にはAPIも用意されています。
公開データのスクレイピングは合法ですか?
それは管轄区域、サイトの利用規約、データの種類、そして収集方法によって異なります。公開されているからといって無制限というわけではありません。個人データは、ページが公開されていたかどうかに関わらずプライバシー法の対象となります。また、サイトの利用規約を無視すると、アクセス自体が違法でなくても契約上の責任が生じる可能性があります。あなたの市場に詳しい弁護士に相談してください。
購入を決めるのはこの問い
ここまでの内容はすべて、一つの問いに集約されます。あなたのデータはどこでファイルであることをやめ、ページになるのか。この問いに答えれば、比較は買い物リストに変わります。ライブページ上に存在する行にはスクレイパー、請求書・明細書・領収書として届く行にはドキュメント抽出ツール、そしてログインの背後でファイルを公開するポータルにはその間の取得ステップです。
2つのレイヤーに2つのツールを買ったことを後悔するチームはほとんどありません。後悔するのは、読むために作られていないレイヤーに1つのツールを買い、突合の段階でそれに気づくことです。