Extração de Dados vs Web Scraping
Quando Sua Fatura Não Tem URL
Peça a um scraper e a um extrator de documentos que coloquem o mesmo extrato bancário em uma planilha e os dois retornam uma tabela. Um leu o extrato. O outro leu a página web que o oferecia para download.
As falhas mais comuns de cada um também aparecem em lugares diferentes. Um scraper geralmente quebra onde você consegue ver: um nome de classe muda, o seletor não retorna nada, e alguém percebe no mesmo dia. Um extrator de documentos geralmente quebra dentro de um único campo: um valor fica com um dígito errado, a contagem de linhas continua igual, e nada parece errado até a coluna ser conciliada. Qual falha sua equipe consegue absorver é uma pergunta de compra melhor do que a qual categoria um fornecedor afirma pertencer.
Principais Conclusões
- Um scraper e um extrator de documentos entregam a mesma tabela a partir do mesmo extrato bancário, então o rótulo na caixa não decide nada.
- Um dígito errado é tudo o que basta: a contagem de linhas de um extrator de documentos continua igual, e o erro só aparece quando você soma a coluna.
- Onde os dados estão agora decide a ferramenta, então faça web scraping do que você pode requisitar e extraia os arquivos que você já tem.
As definições variam. A fonte, não.
Os dois termos não têm definição consensual, e é por isso que a comparação sempre recomeça. O guia das Bibliotecas Bodleian sobre mineração de texto e dados classifica web scraping e screen scraping como data scraping, ao lado de bancos de dados e documentos. Uma dúzia de guias de fornecedores trata extração de dados como o termo guarda-chuva e coloca o scraping abaixo dele. Nenhum órgão de normalização jamais definiu esses termos.
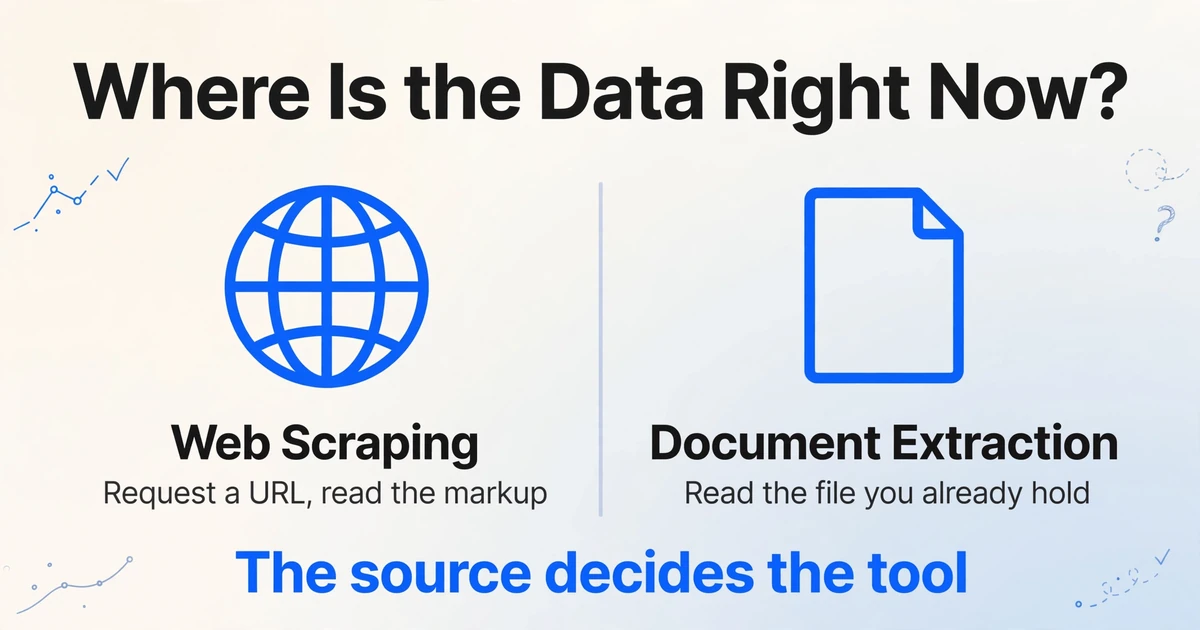
A divergência não muda a decisão diante de você. O web scraping coleta dados de uma interface web ativa: a ferramenta solicita uma URL ou controla um navegador, recebe HTML, um DOM renderizado ou JSON incorporado, e extrai valores dessa estrutura. A extração de documentos lê valores nomeados de um arquivo que você já tem, seja um PDF, uma digitalização, uma foto de recibo tirada com o celular, uma captura de tela ou um anexo de e-mail. Não há requisição a fazer nem marcação a inspecionar.
O atalho para o problema da definição é perguntar onde os dados estão agora. Se você consegue obtê-los solicitando um endereço, é um problema de scraping, ou de API se o site oferecer uma. Se já estão dentro de um arquivo, é um problema de documento.
| Comparado por | Web scraping | Extração de documentos |
|---|---|---|
| Com o que você começa | Uma URL, ou uma lista delas | Um arquivo: PDF, digitalização, foto, captura de tela, anexo de e-mail |
| O que a ferramenta lê | A página servida: HTML, DOM renderizado, JSON incorporado | Pixels, ou uma descrição da página. Não existe document object model |
| Como localiza um valor | Seletor CSS, XPath ou um padrão na resposta | Reconstrução do layout mais significado: qual número é o total |
| O que quebra o processo | Mudanças na marcação, telas de login, verificações de bot, imagens renderizadas | Digitalizações ruins, caligrafia densa, páginas em que o mesmo valor aparece duas vezes |
| Quem controla a fonte | Quem administra o site | Você, ou quem lhe enviou o arquivo |
| Trabalho típico | Preços de concorrentes, listagens de produtos, diretórios, resultados de busca | Faturas, extratos bancários, recibos, contratos, formulários |
O que um scraper lê
Um scraper lê a marcação que foi entregue ao navegador, e é por isso que ele pode ser rápido, barato e exato ao mesmo tempo.
Uma requisição vai para uma URL, um servidor retorna um documento, o documento é analisado em uma árvore de elementos, um seletor escolhe os elementos que contêm os valores, e a tarefa se repete entre páginas conforme uma programação. Em sites com muito JavaScript, ele pode primeiro acionar um navegador headless, para que a árvore exista antes de qualquer seleção.
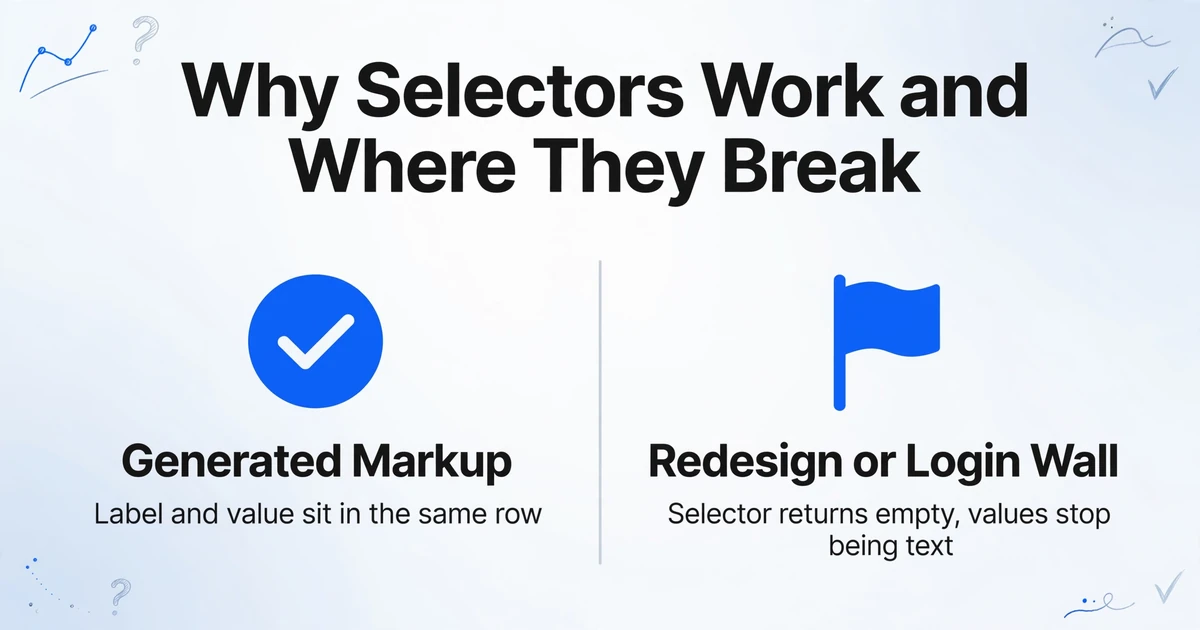
Um seletor funciona por um motivo fácil de passar despercebido. Uma página que exibe um preço foi gerada a partir de dados, então o rótulo e o valor ficam na mesma linha, escritos pelo mesmo modelo. Copiar a célula com a classe .amount lê o campo que o próprio código do site usou para renderizá-la.
O seletor é um atalho que funciona porque a página foi gerada a partir de dados. Nada desse atalho sobrevive quando a fonte deixa de ser marcação gerada.
É por isso que o web scraping quebra de formas específicas. Uma classe é renomeada em um redesign e o seletor retorna uma lista vazia. Uma tabela passa para dentro de um canvas ou de uma imagem e os valores deixam de ser texto. Um login ou uma verificação de bot interrompe a requisição antes de a análise começar. Esses são problemas de acesso e de estrutura, e a solução é tempo de engenharia.
Essa mesma propriedade explica o erro mais comum em projetos mistos: presumir que uma ferramenta que lida com páginas também lidará com os arquivos anexados a elas. Um desenvolvedor descreveu a barreira sem rodeios: "A maioria dos scrapers (como BeautifulSoup, Playwright, etc.) ajuda com HTML, mas lidar com PDFs durante o rastreamento exige uma camada adicional."
O que a extração de documentos lê em vez disso
Um PDF não tem objeto de tabela, nem linha, nem célula. Ele tem instruções para posicionar glifos em coordenadas de uma página.
Isso é literal. ISO 32000, a especificação do PDF, descreve o texto como glifos posicionados por operadores de exibição de texto dentro de uma série de matrizes de transformação. Uma tabela que parece estruturada na tela é um conjunto de caracteres que por acaso se alinham. O arquivo registra o alinhamento, não a relação, então um parser precisa inferir que quatro valores pertencem a uma linha e que o mais à direita é um saldo, e não um segundo valor. Uma digitalização está um passo mais distante: uma imagem sem camada de texto.
A ordem do trabalho se inverte. Um scraper pergunta qual elemento contém o preço. Um extrator de documentos precisa decidir se uma região é uma tabela, onde termina o cabeçalho, se um valor pertence à linha acima ou abaixo dele e qual número é o total, e não o subtotal ou o imposto. O OCR retorna caracteres na ordem de leitura e para por aí, que é a diferença entre transcrição e extração.
A camada semântica elimina o problema da regra por fornecedor. O ImageToTable.ai é construído em torno da Extração de Colunas Personalizadas: você digita os nomes das colunas que deseja, como "Statement Date" e "Amount", e o modelo localiza cada valor entendendo o que o rótulo significa, em vez de onde ele estava no último extrato. Um fornecedor que muda o layout não é um evento para esse tipo de ferramenta, porque o localizador nunca foi a posição.
Onde as duas abordagens realmente divergem
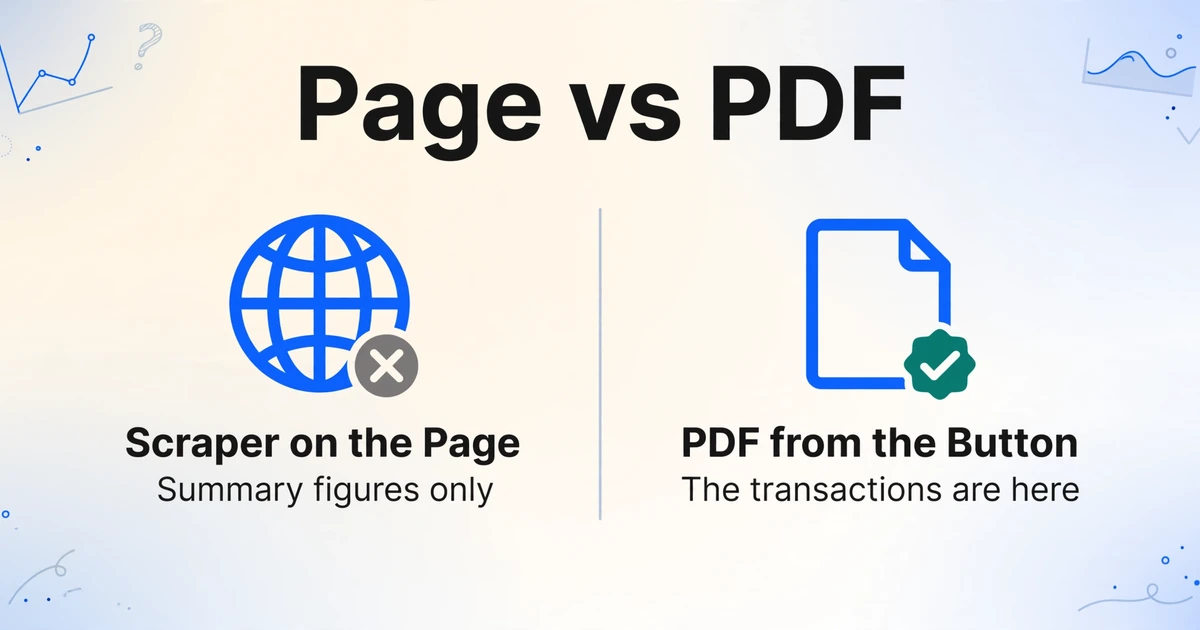
A divergência aparece em um ponto: a camada da fonte que contém os valores de que você precisa.
Um extrato bancário publicado em um portal o torna visível. A página mostra um bloco de resumo: saldo inicial, saldo final, entradas, saídas e um botão que baixa o extrato em PDF. Um scraper apontado para essa página retorna os valores em segundos. As transações estão no PDF que o botão gera, e nada na página as contém. Esta é a versão comum do erro, e ele se repete todo mês sem mensagem de erro.
Leia o mesmo PDF com um parser baseado em posição e uma segunda falha aparece. A coluna de saldo é alinhada à direita, então seus dígitos ficam próximos da coluna de valores. Agrupe o texto por espaços em branco e as colunas podem se fundir; um número dividido entre trechos de texto no separador de milhares pode chegar como dois fragmentos. A saída é uma planilha válida com a contagem de linhas correta e um total plausível. O erro só aparece quando alguém verifica se as transações somam o saldo final menos o saldo inicial.
O terceiro caso é o mais simples e o mais comum. Uma fatura que chega como anexo de e-mail não tem página para buscar. O fornecedor gerou um PDF e o enviou. Não há URL nem marcação, então uma pilha de web scraping não tem nada a fazer até que alguém adicione uma etapa de documento.
Um scraper que retorna a página de resumo não apresentou defeito. Ele fez exatamente o que lhe foi pedido, na camada errada da fonte.
O que costuma faltar raramente é o número principal. É o detalhe que torna os dados utilizáveis:
- Itens de linha, porque a página de resumo lista totais e o PDF da fatura lista do que os totais são feitos.
- Da segunda página em diante de um extrato, porque a primeira página traz o bloco de resumo.
- O sinal de um valor, quando um crédito é impresso entre parênteses e copiado como texto.
- O endereço de cobrança, que fica em um bloco parecido com o endereço de entrega.
- O identificador que permitiria reunir as páginas de volta em um único registro.
Uma captura de tela é um documento, mesmo quando mostra um site
Uma captura de tela de um painel bancário é um documento, ainda que cada pixel dela tenha começado como uma página web.
Este é o inverso da confusão anterior, e pega quem acabou de aprender que conteúdo web significa web scraping. Um PNG não tem DOM, não tem seletor e muitas vezes não tem URL acessível: o estado pode ter exigido login e três cliques. A ferramenta que o lê é a que lê pixels. Um PDF baixado de um portal funciona da mesma forma: depois que chega ao disco, a URL deixa de importar. Capturas de tela são abordadas em extração de dados de capturas de tela.
As questões jurídicas são de natureza diferente
O web scraping pergunta se você tinha permissão para acessar os dados. A extração de documentos pergunta o que você pode fazer com dados que já possui.
Do lado do web scraping, os termos de serviço são um contrato, e é aí que está a maior parte da exposição real. As verificações técnicas são mais frágeis do que parecem. O Robots Exclusion Protocol, padronizado como RFC 9309 em 2022, diz em sua introdução que suas regras "não são uma forma de autorização de acesso". Um arquivo robots.txt declara o que o operador preferiria. Ele não concede permissão.
hiQ Labs v. LinkedIn mostra onde o risco recai. Em 2022, o Nono Circuito manteve uma liminar que permitia à hiQ continuar coletando perfis públicos, com o raciocínio de que o web scraping de dados públicos não "excedia o acesso autorizado" por si só, sob o Computer Fraud and Abuse Act. Isso parecia uma vitória para os scrapers. O caso terminou de outra forma: em novembro de 2022, o tribunal distrital concluiu que a hiQ havia violado o contrato de usuário do LinkedIn, e uma sentença homologatória naquele dezembro impôs uma condenação de $500,000 e proibiu permanentemente a hiQ de fazer web scraping. A alegação contratual sobreviveu à teoria dramática.
O caso incômodo para equipes financeiras raramente aparece em comparações de categoria. As transações na sua conta bancária são seus dados; a interface pertence ao banco. Automatizar essa interface com suas próprias credenciais pode violar os termos do banco, ainda que o dinheiro seja seu. Peça uma exportação ou verifique se há uma API oficial primeiro; no Reino Unido e na UE, existem regras de open banking para que o acesso não precise passar por automação de tela.
Do lado dos documentos, a posse lícita é o ponto de partida da análise. Um extrato contém dados pessoais, então retenção, acesso e onde um operador armazena o arquivo tornam-se questões. Esse trabalho pertence a um responsável de privacidade ou conformidade. Trate esta seção como um mapa de quais perguntas encaminhar a quem, não como aconselhamento jurídico.
Uma Tabela de Decisão por Fonte de Dados
A fonte decide a ferramenta, e a maioria das equipes precisa das duas ferramentas para linhas diferentes da mesma tabela.
| Onde estão os dados | Primeiro passo | Por quê | O que observar |
|---|---|---|---|
| PDF de fatura na sua caixa de entrada | Extração de documentos | Não há URL. O arquivo é o registro | Os layouts variam por fornecedor, então regras ligadas à posição precisam de uma por fornecedor |
| PDF de extrato baixado de um portal | Extração de documentos, camada de texto ou OCR | Tabelas de várias páginas com colunas de saldo alinhadas à direita | Concilie a soma das transações com os saldos inicial e final |
| Transações visíveis apenas no internet banking | Exportação ou API oficial, depois extrair | Suas credenciais, a interface do banco | Termos de serviço e mudanças na interface. A automação de tela é o último recurso |
| Portal de fornecedor que publica extratos | Duas etapas: buscar o arquivo, depois extrair | O download é automação. A leitura é extração | Mantenha-os separados para que um possa mudar sem o outro |
| Preços de concorrentes ou listagens de produtos | Web scraping | Os dados existem apenas como uma página ativa | Os seletores quebram em redesigns. Verifique os termos antes de construir |
| Captura de tela de um dashboard ou aplicativo | Extração de documentos | O arquivo são pixels, e o estado pode não ser reproduzível | A resolução e o recorte decidem o resultado mais do que o modelo |
Quando um portal publica os documentos de que você precisa, o trabalho se divide em dois: algo busca o arquivo em um horário programado, e algo o lê. Construa o pipeline de modo que a etapa de leitura não se importe de onde o arquivo veio, e no dia em que o banco lançar uma API você exclui uma etapa de busca.
Onde a Extração de Documentos Para
A extração de documentos começa depois que o arquivo existe, então não consegue resolver o problema de obter o arquivo.
Vale afirmar essa fronteira sem rodeios. O ImageToTable.ai lê documentos. Ele não faz scraping de sites, não rastreia páginas, não controla um navegador nem analisa HTML. Você envia PDFs, imagens ou capturas de tela, ou os encaminha para um endereço de caixa de entrada de e-mail, e recebe uma tabela de volta, ou um arquivo Word se precisar do layout original. Se um extrato só existe atrás de um login bancário, a extração é a segunda metade do seu pipeline.
Ele também não sabe qual número está correto. Ele lê o que a página diz. Uma tabela impressa limpa é o caso fácil, e nossa própria documentação cita até 99% de precisão para dados de tabelas impressas; uma foto de um recibo amassado sob um abajur não é esse caso. Caligrafia densa e layouts incomuns são onde os níveis de processamento e uma etapa de revisão ganham seu lugar. A diferença entre OCR, extração e plataformas completas de IDP é abordada em o que a extração de documentos por IA realmente é.
O que se sustenta é o fluxo de trabalho em lote. Você nomeia as colunas, coloca uma pasta de arquivos de diferentes fornecedores em um único lote e recebe uma tabela com os mesmos campos na mesma ordem. Uma página que levava três minutos para digitar leva segundos para processar. Esse ganho é real, e menor do que a alegação de que uma ferramenta substitui ao mesmo tempo uma pilha de scraping e um pipeline de documentos.
Perguntas Frequentes
OCR é o mesmo que web scraping?
Não. O OCR lê caracteres a partir de pixels, enquanto o web scraping lê a marcação de uma página ativa. Os dois se encontram em um caso restrito: alguns sites renderizam texto como imagem para burlar scrapers, e um pipeline de scraping pode executar OCR nessa imagem como alternativa. O OCR é um componente dentro de uma tarefa de scraping, não um sinônimo dela.
Um scraper consegue ler uma fatura em PDF?
Ele consegue baixar o PDF. A parte que lê a fatura é um analisador de documentos, porque um PDF não tem elementos para selecionar. Se o arquivo tiver uma camada de texto, um analisador consegue lê-lo; se for uma digitalização, o OCR ou um modelo de visão precisa ler a imagem da página primeiro. Um framework de scraping vai buscar o arquivo e deixar você com um binário que nenhum de seus seletores consegue abrir.
Posso fazer scraping do site do meu próprio banco?
Verifique primeiro se há uma exportação de extrato ou uma API oficial. Os dados são seus, mas a interface é do banco, e automatizá-la geralmente é regido pelos termos deles. A automação de tela também quebra sempre que o banco redesenha uma página. Exporte o extrato e depois extraia do arquivo.
Qual dos dois eu preciso para uma captura de tela de um painel?
Extração de documentos. Uma captura de tela é uma imagem raster sem DOM e muitas vezes sem URL acessível, então não há nada para um scraper selecionar. Trate-a como uma digitalização e espere que a imagem de origem defina o teto da precisão.
Preciso de um desenvolvedor para qualquer um dos dois?
O scraping geralmente precisa de um, e continua precisando, porque seletores, proxies e tratamento anti-bot são manutenção contínua. A extração de documentos não exige código com uma ferramenta no-code, e existe uma API se você quiser a etapa dentro do seu próprio sistema.
Fazer scraping de dados públicos é legal?
Depende da jurisdição, dos termos do site, do tipo de dado e de como você o coleta. Público não significa irrestrito. Dados pessoais trazem a legislação de privacidade para o cenário, independentemente de a página estar aberta, e ignorar os termos de um site pode gerar responsabilidade contratual mesmo quando o acesso não era ilegal. Consulte um advogado que conheça o seu mercado.
A Pergunta Que Decide a Compra
Tudo acima se resume a uma pergunta: onde o seu dado deixa de ser um arquivo e passa a ser uma página? Responda isso e a comparação vira uma lista de compras: um scraper para as linhas que vivem em páginas ativas, um extrator de documentos para as linhas que chegam como faturas, extratos e recibos, e uma etapa de busca no meio para os portais que publicam arquivos atrás de um login.
As equipes raramente se arrependem de comprar duas ferramentas para duas camadas. Elas se arrependem de comprar uma ferramenta para uma camada que ela nunca foi feita para ler, e descobrir isso na conciliação.