Extracción de datos vs web scraping
Cuando su factura no tiene URL
Pida a un scraper web y a un extractor de documentos que pongan el mismo extracto bancario en una hoja de cálculo y ambos devolverán una tabla. Uno leyó el extracto. El otro leyó la página web que lo ofrecía como descarga.
Sus fallos más comunes también ocurren en lugares distintos. Un scraper suele romperse donde usted puede verlo: cambia un nombre de clase, el selector no devuelve nada y alguien lo nota ese mismo día. Un extractor de documentos suele romperse dentro de un solo campo: un importe queda un dígito desviado, el recuento de filas sigue coincidiendo y nada parece mal hasta que se concilia la columna. Qué fallo puede absorber su equipo es una mejor pregunta de compra que a qué categoría dice pertenecer un proveedor.
Puntos clave
- Un scraper y un extractor de documentos le entregan la misma tabla del mismo extracto bancario, así que la etiqueta de la caja no decide nada.
- Basta un dígito desviado: el recuento de filas de un extractor de documentos sigue coincidiendo y el error solo aparece cuando suma la columna.
- Dónde están los datos ahora mismo decide la herramienta, así que haga web scraping de lo que puede solicitar y extraiga los archivos que ya tiene.
Las definiciones varían. La fuente, no.
Los dos términos no tienen una definición acordada, y por eso la comparación se reinicia una y otra vez. La guía de las Bibliotecas Bodleian sobre minería de texto y datos clasifica el web y screen scraping dentro del data scraping, junto a bases de datos y documentos. Una docena de explicaciones de proveedores tratan la extracción de datos como el término paraguas y colocan el scraping debajo. Ningún organismo de normalización zanjó nunca las palabras.
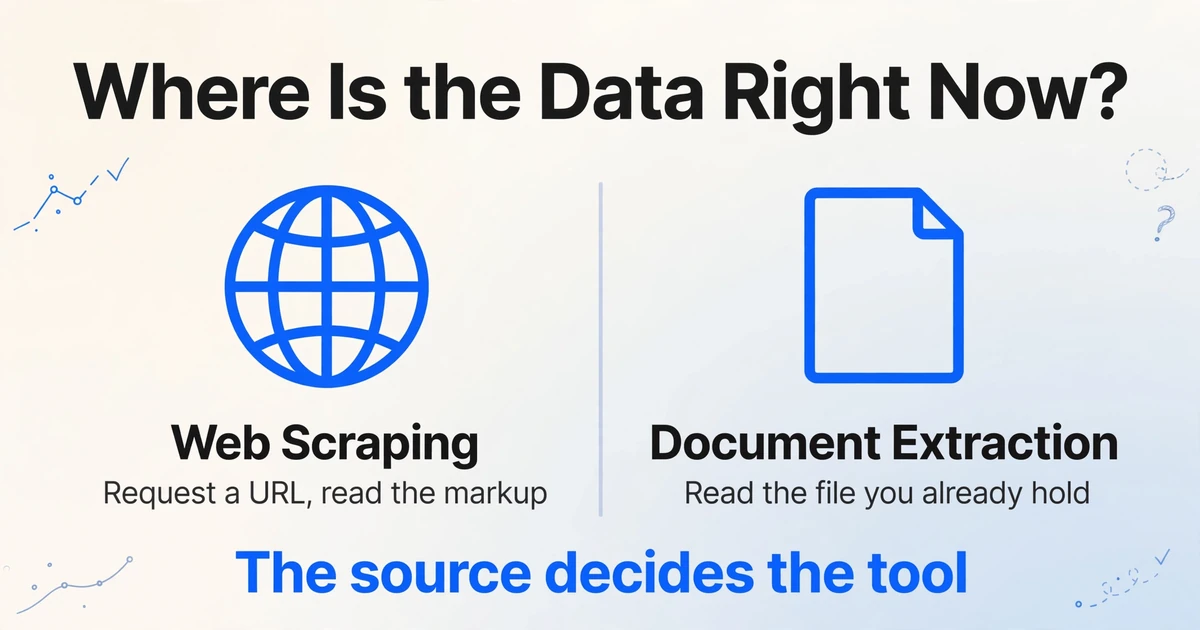
La discrepancia no cambia la decisión que tiene delante. El web scraping recopila datos de una interfaz web activa: la herramienta solicita una URL o controla un navegador, recibe HTML, un DOM renderizado o JSON incrustado, y extrae valores de esa estructura. La extracción de documentos lee valores con nombre de un archivo que usted ya tiene, sea un PDF, un escaneo, una foto de un recibo hecha con el móvil, una captura de pantalla o un archivo adjunto de correo. No hay ninguna solicitud que hacer ni ningún marcado que inspeccionar.
El atajo para sortear el problema de la definición es preguntar dónde están los datos ahora mismo. Si puede obtenerlos solicitando una ubicación, es un problema de scraping, o un problema de API si el sitio ofrece una. Si ya están dentro de un archivo, es un problema de documentos.
| Comparado en | Web scraping | Extracción de documentos |
|---|---|---|
| Con qué empieza | Una URL, o una lista de ellas | Un archivo: PDF, escaneo, foto, captura de pantalla, archivo adjunto de correo |
| Qué lee la herramienta | La página servida: HTML, DOM renderizado, JSON incrustado | Píxeles, o una descripción de la página. No hay modelo de objetos del documento |
| Cómo localiza un valor | Selector CSS, XPath, o un patrón en la respuesta | Reconstrucción del diseño más significado: qué número es el total |
| Qué lo rompe | Cambios en el marcado, muros de inicio de sesión, controles anti-bot, imágenes renderizadas | Escaneos deficientes, escritura a mano densa, páginas donde el mismo valor aparece dos veces |
| Quién controla la fuente | Quien gestiona el sitio | Usted, o la parte que le envió el archivo |
| Trabajo típico | Precios de la competencia, listados de productos, directorios, resultados de búsqueda | Facturas, extractos bancarios, recibos, contratos, formularios |
Qué lee un scraper
Un scraper lee el marcado que recibió un navegador, y por eso puede ser rápido, barato y exacto al mismo tiempo.
Se envía una solicitud a una URL, un servidor devuelve un documento, el documento se analiza en un árbol de elementos, un selector elige los elementos que contienen los valores y la tarea se repite en varias páginas según una programación. En sitios con mucho JavaScript, puede que primero se ejecute un navegador sin interfaz, de modo que el árbol exista antes de seleccionar nada.
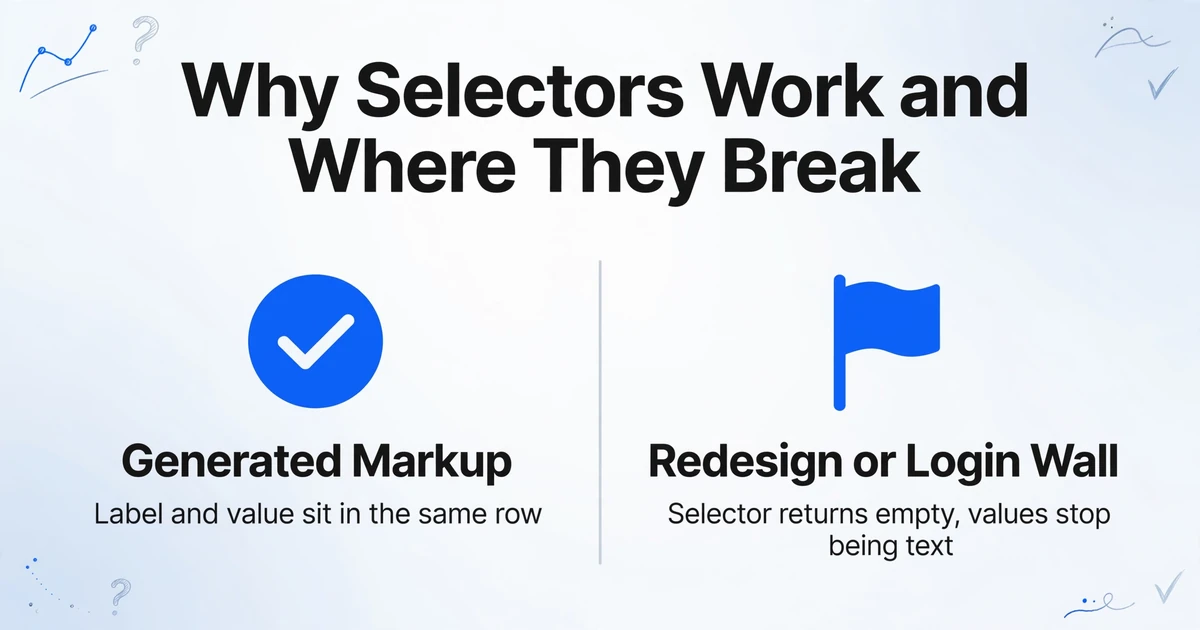
Un selector funciona por una razón que es fácil pasar por alto. Una página que muestra un precio se generó a partir de datos, así que la etiqueta y el valor están en la misma fila, escritos por la misma plantilla. Copiar la celda con la clase .amount lee el campo que usó el propio código del sitio para representarlo.
El selector es un atajo que funciona porque la página se generó a partir de datos. Nada de ese atajo sobrevive cuando la fuente deja de ser marcado generado.
Por eso el web scraping se rompe de formas concretas. Una clase cambia de nombre en un rediseño y el selector devuelve una lista vacía. Una tabla se traslada dentro de un canvas o una imagen y los valores dejan de ser texto. Un muro de inicio de sesión o una verificación contra bots detiene la solicitud antes de que empiece el análisis. Son problemas de acceso y de estructura, y la solución es tiempo de ingeniería.
Esa misma propiedad explica el error más común en proyectos mixtos: suponer que una herramienta que maneja páginas también manejará los archivos adjuntos a ellas. Un desarrollador describió el obstáculo con claridad: "La mayoría de los scrapers (como BeautifulSoup, Playwright, etc.) ayudan con HTML, pero manejar PDF durante el rastreo requiere una capa adicional."
Qué lee en su lugar la extracción de documentos
Un PDF no tiene objeto de tabla, ni fila, ni celda. Tiene instrucciones para colocar glifos en coordenadas de una página.
Eso es literal. ISO 32000, la especificación de PDF, describe el texto como glifos posicionados por operadores de muestra de texto dentro de una serie de matrices de transformación. Una tabla que parece estructurada en pantalla es un conjunto de caracteres que casualmente se alinean. El archivo registra la alineación, no la relación, así que un analizador debe inferir que cuatro valores pertenecen a una fila y que el de más a la derecha es un saldo y no un segundo importe. Un escaneo está un paso más lejos: una imagen sin capa de texto.
El orden del trabajo se invierte. Un scraper pregunta qué elemento contiene el precio. Un extractor de documentos debe decidir si una región es una tabla, dónde termina el encabezado, si un valor pertenece a la fila de arriba o a la de abajo, y qué número es el total y no el subtotal o el impuesto. El OCR devuelve caracteres en orden de lectura y se detiene ahí, que es la diferencia entre transcripción y extracción.
La capa semántica elimina el problema de una regla por proveedor. ImageToTable.ai se basa en Custom Column Extraction: usted escribe los nombres de columna que quiere, como "Statement Date" y "Amount", y el modelo localiza cada valor entendiendo qué significa la etiqueta en lugar de dónde estaba en el último extracto. Que un proveedor cambie su diseño no es un evento para este tipo de herramienta, porque el localizador nunca fue la posición.
Dónde divergen realmente los dos enfoques
La divergencia aparece en un solo lugar: la capa de la fuente que contiene los valores que usted necesita.
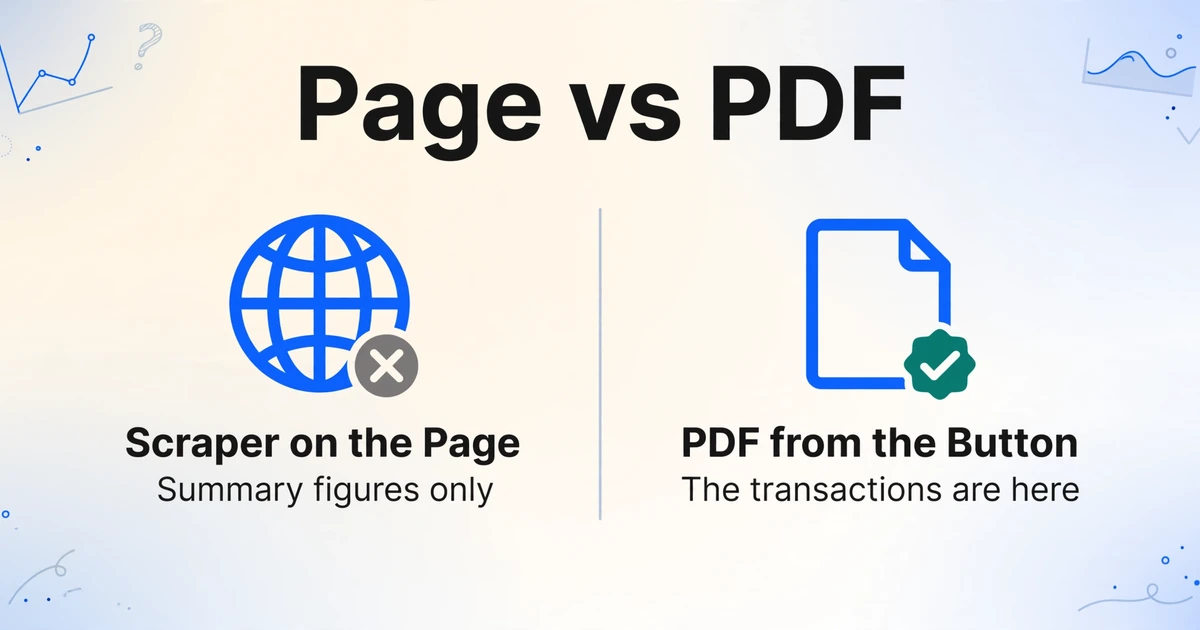
Un extracto bancario publicado en un portal lo hace visible. La página muestra un bloque de resumen: saldo inicial, saldo final, entradas, salidas y un botón que descarga el extracto como PDF. Un scraper apuntado a esa página devuelve las cifras en segundos. Las transacciones están en el PDF que produce el botón, y nada en la página las contiene. Esta es la versión ordinaria del error, y se repite cada mes sin un mensaje de error.
Lea el mismo PDF con un analizador basado en posiciones y aparece un segundo fallo. La columna de saldo está alineada a la derecha, así que sus dígitos quedan cerca de la columna de importes. Agrupe el texto por espacios en blanco y las columnas pueden fusionarse; un número dividido entre fragmentos de texto en el separador de miles puede llegar como dos fragmentos. La salida es una hoja de cálculo válida con el número correcto de filas y un total plausible. El error solo sale a la luz cuando alguien comprueba que las transacciones suman el saldo final menos el saldo inicial.
El tercer caso es el más simple y el más común. Una factura que llega como adjunto de correo no tiene página que obtener. El proveedor generó un PDF y lo envió. No hay URL ni marcado, así que una pila de web scraping no tiene nada que hacer hasta que alguien añade un paso de documento.
Un scraper que devuelve la página de resumen no ha fallado. Hizo exactamente lo que se le pidió, en la capa equivocada de la fuente.
Lo que desaparece rara vez es la cifra principal. Es el detalle que hace que los datos sean utilizables:
- Las líneas de detalle, porque la página de resumen enumera los totales y el PDF de la factura enumera de qué están hechos esos totales.
- Las páginas dos en adelante de un extracto, porque la primera página contiene el bloque de resumen.
- El signo de un importe, cuando un crédito se imprime entre paréntesis y se copia como texto.
- La dirección de facturación, que se encuentra en un bloque que parece la dirección de envío.
- El identificador que le permitiría unir las páginas de nuevo en un solo registro.
Una captura de pantalla es un documento, aunque muestre un sitio web
Una captura de pantalla de un panel bancario es un documento, aunque cada píxel de ella haya comenzado como una página web.
Esto es lo contrario de la confusión anterior, y sorprende a quienes acaban de aprender que el contenido web implica web scraping. Un PNG no tiene DOM, ni selector y a menudo ninguna URL accesible: el estado puede haber requerido un inicio de sesión y tres clics. La herramienta que lo lee es la que lee píxeles. Un PDF descargado de un portal funciona igual: una vez que llega al disco, la URL deja de importar. Las capturas de pantalla se tratan en extraer datos de capturas de pantalla.
Las cuestiones legales son de distinta naturaleza
El web scraping pregunta si se le permitió acceder a los datos. La extracción de documentos pregunta qué puede hacer con datos que ya posee.
Del lado del web scraping, los términos de servicio son un contrato, y ahí es donde reside la mayor parte de la exposición real. Las comprobaciones técnicas son más débiles de lo que parecen. El Robots Exclusion Protocol, estandarizado como RFC 9309 en 2022, dice en su introducción que sus reglas "no son una forma de autorización de acceso". Un archivo robots.txt indica lo que el operador preferiría. No otorga permiso.
hiQ Labs v. LinkedIn muestra dónde recae el riesgo. En 2022, el Noveno Circuito confirmó una orden judicial que permitía a hiQ seguir recopilando perfiles públicos, con el razonamiento de que el web scraping de datos públicos no "excedía el acceso autorizado" por sí mismo según la Computer Fraud and Abuse Act. Eso pareció una victoria para los scrapers. El caso terminó de otra manera: en noviembre de 2022, el tribunal de distrito determinó que hiQ había incumplido el acuerdo de usuario de LinkedIn, y un consent judgment de ese diciembre impuso una sentencia de $500,000 y prohibió permanentemente a hiQ hacer web scraping. La reclamación contractual sobrevivió a la teoría dramática.
El caso incómodo para los equipos de finanzas rara vez aparece en las comparativas de categorías. Las transacciones de su cuenta bancaria son sus datos; la interfaz pertenece al banco. Automatizar esa interfaz con sus propias credenciales puede infringir los términos del banco aunque el dinero sea suyo. Solicite primero una exportación o compruebe si existe una API oficial; en el Reino Unido y la UE, existen normas de banca abierta para que el acceso no tenga que pasar por la automatización de pantallas.
Del lado de los documentos, la posesión lícita es el punto de partida del análisis. Un extracto contiene datos personales, por lo que la retención, el acceso y dónde almacena el archivo un encargado del tratamiento se convierten en cuestiones relevantes. Ese trabajo corresponde a un responsable de privacidad o cumplimiento. Considere esta sección como un mapa de qué preguntas dirigir a quién, no como asesoramiento legal.
Una tabla de decisión según la fuente de datos
La fuente decide la herramienta, y la mayoría de los equipos necesita ambas herramientas para distintas filas de la misma tabla.
| Dónde están los datos | Primer paso | Por qué | Qué vigilar |
|---|---|---|---|
| Factura en PDF en su bandeja de entrada | Extracción de documentos | No hay URL. El archivo es el registro | Los diseños varían según el proveedor, así que las reglas ligadas a la posición necesitan una por proveedor |
| Extracto en PDF descargado de un portal | Extracción de documentos, capa de texto u OCR | Tablas de varias páginas con columnas de saldo alineadas a la derecha | Concilie la suma de transacciones con los saldos inicial y final |
| Transacciones visibles solo en la banca en línea | Exportación o API oficial, luego extraer | Sus credenciales, la interfaz del banco | Términos de servicio y cambios de interfaz. La automatización de pantalla es el último recurso |
| Portal de proveedor que publica extractos | Dos pasos: obtener el archivo, luego extraer | La descarga es automatización. La lectura es extracción | Manténgalos separados para que uno pueda cambiar sin el otro |
| Precios de la competencia o listados de productos | Web scraping | Los datos existen solo como página en vivo | Los selectores se rompen con los rediseños. Revise los términos antes de construir |
| Captura de pantalla de un panel o aplicación | Extracción de documentos | El archivo son píxeles, y el estado puede no ser reproducible | La resolución y el recorte deciden el resultado más que el modelo |
Cuando un portal publica los documentos que usted necesita, el trabajo se divide en dos: algo obtiene el archivo según una programación, y algo lo lee. Construya el flujo de trabajo de modo que el paso de lectura no le importe de dónde vino el archivo, y el día que el banco lance una API usted elimine un paso de obtención.
Dónde se detiene la extracción de documentos
La extracción de documentos comienza después de que el archivo existe, por lo que no puede resolver el problema de obtener el archivo.
Vale la pena afirmar este límite sin matices. ImageToTable.ai lee documentos. No hace web scraping de sitios web, no rastrea páginas, no controla un navegador ni analiza HTML. Usted sube PDF, imágenes o capturas de pantalla, o los reenvía a una dirección de correo electrónico, y recibe una tabla, o un archivo de Word si necesita el diseño original. Si un extracto bancario solo existe detrás de un inicio de sesión bancario, la extracción es la segunda mitad de su flujo de trabajo.
Tampoco sabe qué número es correcto. Lee lo que dice la página. Una tabla impresa limpia es el caso fácil, y nuestra propia documentación cita hasta un 99% de precisión para datos de tablas impresas; una fotografía de un recibo arrugado bajo una lámpara de escritorio no es ese caso. La escritura densa a mano y los diseños inusuales son donde los niveles de procesamiento y un paso de revisión se ganan su lugar. La diferencia entre OCR, extracción y plataformas IDP completas se cubre en qué es realmente la extracción de documentos con IA.
Lo que se mantiene es el flujo de trabajo por lotes. Usted nombra las columnas, coloca una carpeta de archivos de diferentes proveedores en un lote, y obtiene una tabla con los mismos campos en el mismo orden. Una página que tomaba tres minutos teclear tarda segundos en procesarse. Esa ganancia es real, y menor que la afirmación de que una herramienta reemplaza una pila de scraping y un flujo de documentos a la vez.
Preguntas frecuentes
¿Es el OCR lo mismo que el web scraping?
No. El OCR lee caracteres de píxeles, mientras que el web scraping lee el marcado de una página activa. Los dos se encuentran en un caso estrecho: algunos sitios renderizan texto como imagen para frustrar a los scrapers, y un flujo de scraping puede ejecutar OCR en esa imagen como respaldo. El OCR es un componente dentro de un trabajo de scraping, no un sinónimo de él.
¿Puede un scraper web leer una factura PDF?
Puede descargar el PDF. La parte que lee la factura es un analizador de documentos, porque un PDF no tiene elementos que seleccionar. Si el archivo tiene una capa de texto, un analizador puede leerlo; si es un escaneo, el OCR o un modelo de visión tienen que leer primero la imagen de la página. Un framework de scraping obtendrá el archivo y le dejará con un binario que ninguno de sus selectores puede abrir.
¿Puedo hacer scraping del sitio de banca en línea de mi propio banco?
Busque primero una exportación de extracto o una API oficial. Los datos son suyos, pero la interfaz es del banco, y automatizarla generalmente se rige por sus términos. La automatización de pantalla también se rompe cada vez que el banco rediseña una página. Exporte el extracto, luego extraiga del archivo.
¿Cuál necesito para una captura de pantalla de un panel de control?
Extracción de documentos. Una captura de pantalla es una imagen ráster sin DOM y a menudo sin URL accesible, por lo que no hay nada que un scraper pueda seleccionar. Trátela como un escaneo, y espere que la imagen de origen establezca el límite de precisión.
¿Necesito un desarrollador para cualquiera de los dos?
El scraping generalmente necesita uno, y sigue necesitando uno, porque los selectores, los proxies y el manejo anti-bot son mantenimiento continuo. La extracción de documentos no requiere código con una herramienta sin código, y existe una API si desea el paso dentro de su propio sistema.
¿Es legal el scraping de datos públicos?
Depende de la jurisdicción, los términos del sitio, el tipo de datos y cómo los recopile. Público no significa sin restricciones. Los datos personales introducen la legislación de privacidad en la ecuación, independientemente de si la página estaba abierta, e ignorar los términos de un sitio puede generar responsabilidad contractual incluso cuando el acceso no era ilegal. Consulte a un abogado que conozca su mercado.
La pregunta que decide la compra
Todo lo anterior se reduce a una pregunta: ¿dónde dejan sus datos de ser un archivo y empiezan a ser una página? Responda eso y la comparación se convierte en una lista de compras: un scraper para las filas que viven en páginas activas, un extractor de documentos para las filas que llegan como facturas, extractos y recibos, y un paso de obtención intermedio para los portales que publican archivos tras un inicio de sesión.
Los equipos rara vez se arrepienten de comprar dos herramientas para dos capas. Se arrepienten de comprar una herramienta para una capa que nunca fue diseñada para leer, y descubrirlo en la conciliación.