Extraction de données vs web scraping
Quand votre facture n'a pas d'URL
Demandez à un scraper et à un extracteur de documents de mettre le même relevé bancaire dans un tableur : les deux renvoient un tableau. L'un a lu le relevé. L'autre a lu la page web qui le proposait en téléchargement.
Leurs échecs les plus courants se produisent aussi à des endroits différents. Un scraper casse généralement là où c'est visible : un nom de classe change, le sélecteur ne renvoie rien, et quelqu'un s'en aperçoit le jour même. Un extracteur de documents casse généralement à l'intérieur d'un seul champ : un montant perd un chiffre, le nombre de lignes reste correct, et rien ne semble anormal jusqu'au rapprochement de la colonne. Le type d'échec que votre équipe peut absorber est une meilleure question d'achat que la catégorie revendiquée par un fournisseur.
Points clés
- Un scraper et un extracteur de documents vous donnent tous deux un tableau à partir du même relevé bancaire, donc l'étiquette sur la boîte ne décide rien.
- Un seul chiffre suffit : le nombre de lignes d'un extracteur de documents reste correct, et l'erreur n'apparaît que lorsque vous additionnez la colonne.
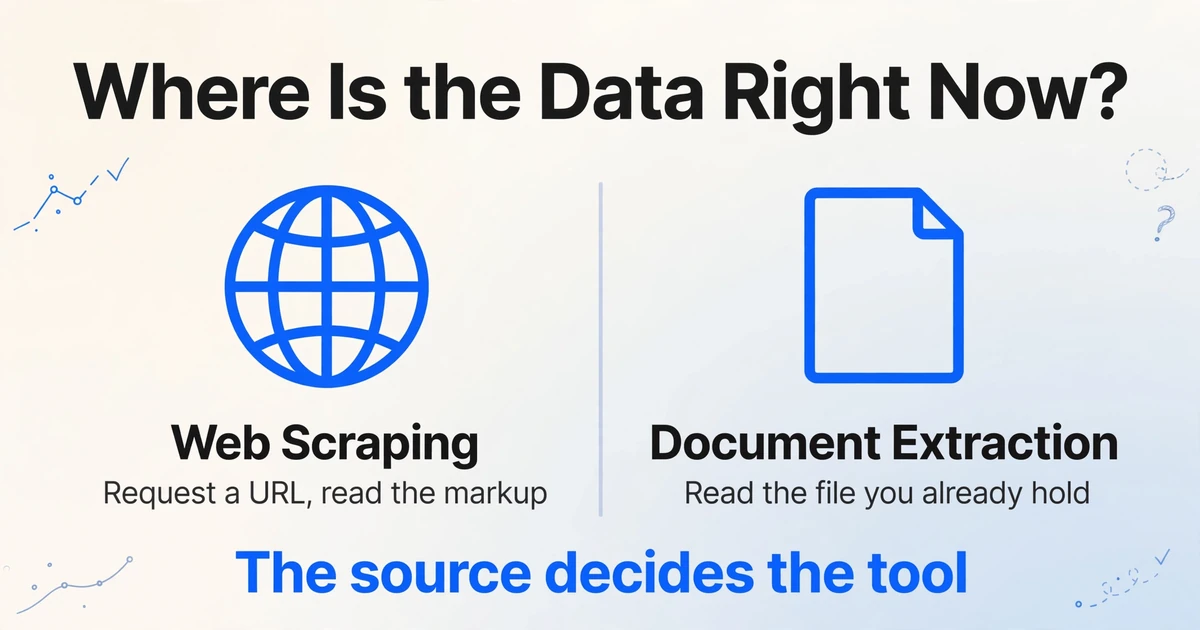
- L'endroit où se trouvent les données maintenant détermine l'outil : scrapez ce que vous pouvez demander et extrayez les fichiers que vous détenez déjà.
Les définitions varient. Pas la source.
Les deux termes n'ont pas de définition consensuelle, c'est pourquoi la comparaison ne cesse de repartir de zéro. Le guide des bibliothèques Bodleian sur l'exploration de textes et de données classe le web et le screen scraping sous le data scraping, aux côtés des bases de données et des documents. Une dizaine de pages explicatives d'éditeurs traitent l'extraction de données comme la catégorie générale et placent le scraping en dessous. Aucun organisme de normalisation n'a jamais tranché.
Ce désaccord ne change rien à la décision qui vous attend. Le web scraping collecte des données depuis une interface web active : l'outil demande une URL ou pilote un navigateur, reçoit du HTML, un DOM rendu ou du JSON intégré, et extrait des valeurs de cette structure. L'extraction de documents lit des valeurs nommées dans un fichier que vous possédez déjà, qu'il s'agisse d'un PDF, d'un scan, d'une photo de reçu prise au téléphone, d'une capture d'écran ou d'une pièce jointe. Il n'y a aucune requête à faire et aucun balisage à inspecter.
Le raccourci pour contourner le problème de définition consiste à demander où se trouvent les données maintenant. Si vous pouvez les obtenir en demandant un emplacement, c'est un problème de scraping, ou un problème d'API si le site en propose une. Si elles sont déjà dans un fichier, c'est un problème de document.
| Critère de comparaison | Web scraping | Extraction de documents |
|---|---|---|
| Point de départ | Une URL, ou une liste d'URL | Un fichier : PDF, scan, photo, capture d'écran, pièce jointe |
| Ce que l'outil lit | La page servie : HTML, DOM rendu, JSON intégré | Des pixels, ou une description de page. Il n'y a pas de document object model |
| Comment il localise une valeur | Sélecteur CSS, XPath, ou un motif dans la réponse | Reconstruction de la mise en page plus le sens : quel nombre est le total |
| Ce qui le fait échouer | Changements de balisage, murs de connexion, contrôles anti-bot, images rendues | Scans de mauvaise qualité, écriture manuscrite dense, pages où la même valeur apparaît deux fois |
| Qui contrôle la source | Celui qui gère le site | Vous, ou la partie qui vous a envoyé le fichier |
| Travail typique | Prix des concurrents, fiches produits, annuaires, résultats de recherche | Factures, relevés bancaires, reçus, contrats, formulaires |
Ce que lit un scraper
Un scraper lit le balisage fourni à un navigateur, c'est pourquoi il peut être à la fois rapide, économique et exact.
Une requête est envoyée à une URL, un serveur renvoie un document, le document est analysé en un arbre d'éléments, un sélecteur choisit les éléments contenant les valeurs, et la tâche se répète sur les pages selon un planning. Sur les sites riches en JavaScript, il peut d'abord piloter un navigateur headless, afin que l'arbre existe avant toute sélection.
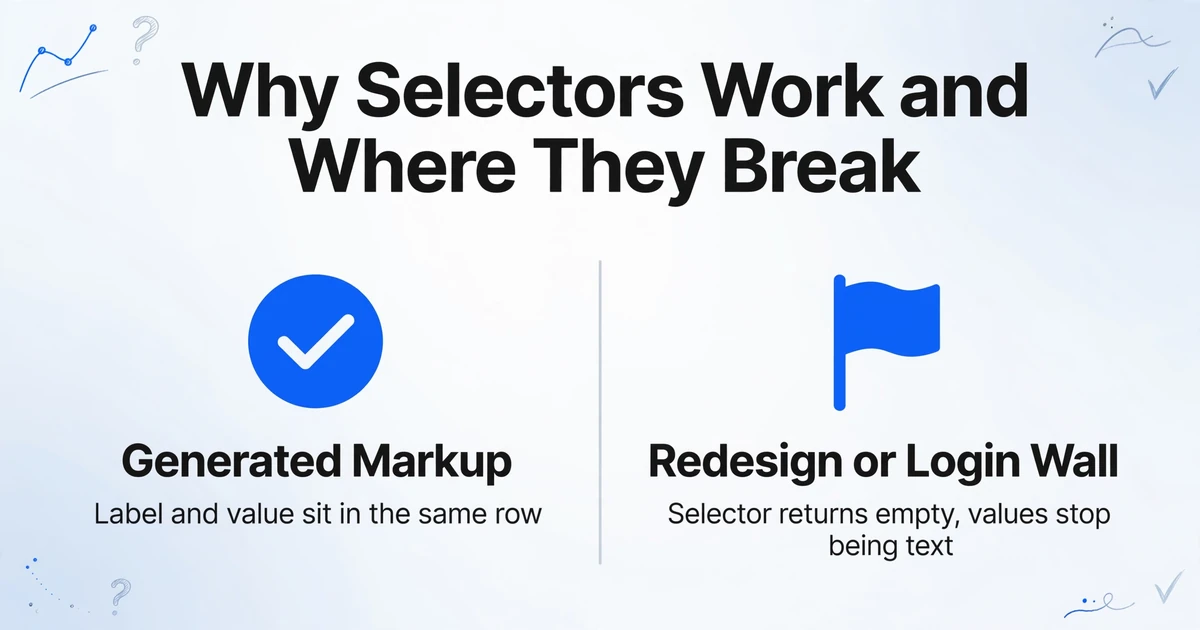
Un sélecteur fonctionne pour une raison facile à manquer. Une page affichant un prix a été générée à partir de données, donc le libellé et la valeur se trouvent dans la même ligne, écrits par le même modèle. Copier la cellule avec la classe .amount lit le champ que le propre code du site a utilisé pour le rendre.
Le sélecteur est un raccourci qui fonctionne parce que la page a été générée à partir de données. Rien de ce raccourci ne survit lorsque la source cesse d'être du balisage généré.
C'est pourquoi le web scraping casse de manières spécifiques. Une classe est renommée lors d'une refonte et le sélecteur renvoie une liste vide. Un tableau se déplace dans un canvas ou une image et les valeurs cessent d'être du texte. Un mur de connexion ou une vérification anti-bot arrête la requête avant que l'analyse ne commence. Ce sont des problèmes d'accès et de structure, et la solution est du temps d'ingénierie.
La même propriété explique l'erreur la plus courante dans les projets mixtes : supposer qu'un outil qui gère les pages gérera les fichiers qui y sont attachés. Un développeur a décrit le mur sans détour : « La plupart des scrapers (comme BeautifulSoup, Playwright, etc.) aident avec le HTML, mais gérer les PDF pendant le crawl nécessite une couche supplémentaire. »
Ce que l'extraction de documents lit à la place
Un PDF n'a pas d'objet tableau, ni de ligne, ni de cellule. Il contient des instructions pour placer des glyphes à des coordonnées sur une page.
C'est littéral. ISO 32000, la spécification PDF, décrit le texte comme des glyphes positionnés par des opérateurs d'affichage de texte au sein d'une série de matrices de transformation. Un tableau qui paraît structuré à l'écran n'est qu'un ensemble de caractères qui se trouvent alignés. Le fichier enregistre l'alignement, pas la relation, si bien qu'un parseur doit déduire que quatre valeurs appartiennent à une même ligne et que la plus à droite est un solde plutôt qu'un second montant. Un scan est un cran plus loin : une image sans couche de texte.
L'ordre du travail s'inverse. Un scraper demande quel élément contient le prix. Un extracteur de documents doit décider si une région est un tableau, où se termine l'en-tête, si une valeur appartient à la ligne du dessus ou du dessous, et quel nombre est le total plutôt que le sous-total ou la taxe. La reconnaissance optique de caractères renvoie des caractères dans l'ordre de lecture et s'arrête là, ce qui fait toute la différence entre transcription et extraction.
La couche sémantique supprime le problème de la règle par fournisseur. ImageToTable.ai est construit autour de Custom Column Extraction : vous saisissez les noms de colonnes souhaités, comme « Statement Date » et « Amount », et le modèle localise chaque valeur en comprenant ce que le libellé signifie plutôt que l'endroit où il se trouvait sur le dernier relevé. Qu'un fournisseur change sa mise en page n'est pas un événement pour ce type d'outil, car le localisateur n'a jamais été la position.
Où les deux approches divergent réellement
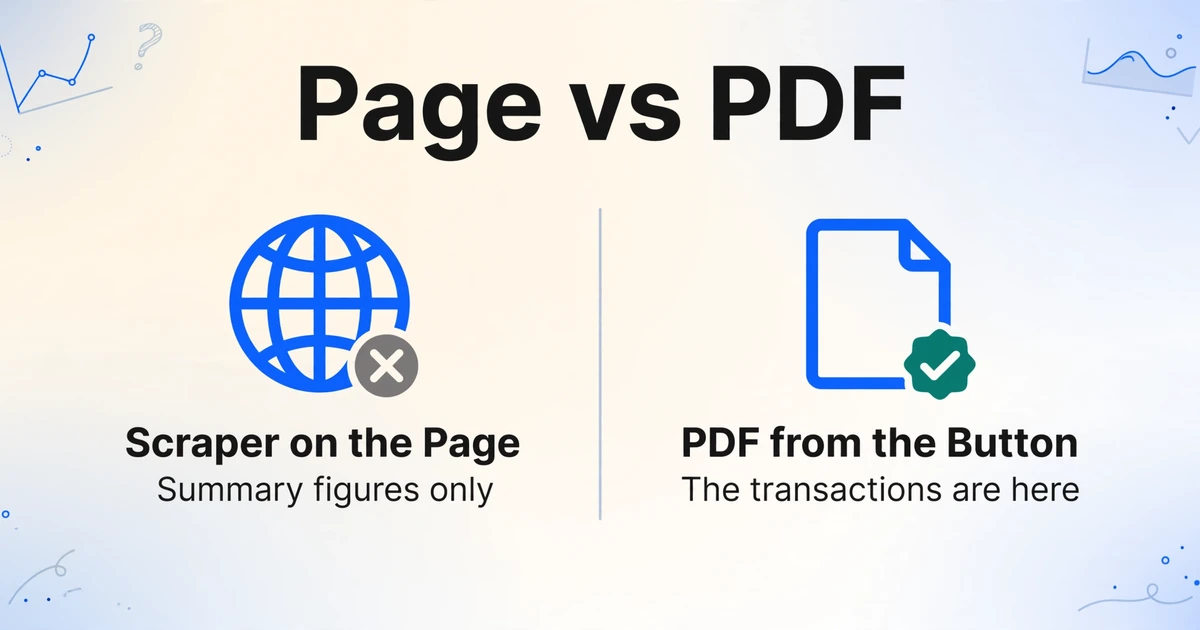
La divergence apparaît à un seul endroit : la couche de la source qui contient les valeurs dont vous avez besoin.
Un relevé bancaire publié sur un portail le rend visible. La page affiche un bloc récapitulatif : solde d'ouverture, solde de clôture, entrées, sorties, et un bouton qui télécharge le relevé au format PDF. Un scraper pointé sur cette page renvoie les chiffres en quelques secondes. Les transactions se trouvent dans le PDF que produit le bouton, et rien sur la page ne les contient. C'est la version ordinaire de l'erreur, et elle se répète chaque mois sans message d'erreur.
Lisez le même PDF avec un parseur basé sur les positions et une seconde défaillance apparaît. La colonne du solde est alignée à droite, si bien que ses chiffres sont proches de la colonne des montants. Regroupez le texte par espaces et les colonnes peuvent fusionner ; un nombre scindé entre plusieurs segments de texte au niveau du séparateur de milliers peut arriver en deux fragments. Le résultat est un tableur valide avec le bon nombre de lignes et un total plausible. L'erreur ne se manifeste que lorsque quelqu'un vérifie que les transactions totalisent le solde de clôture moins le solde d'ouverture.
Le troisième cas est le plus simple et le plus courant. Une facture qui arrive en pièce jointe d'un e-mail n'a aucune page à récupérer. Le fournisseur a généré un PDF et l'a envoyé. Il n'y a ni URL ni balisage, donc une pile de web scraping n'a rien à faire tant que personne n'ajoute une étape document.
Un scraper qui renvoie la page récapitulative n'a pas dysfonctionné. Il a fait exactement ce qu'on lui demandait, sur la mauvaise couche de la source.
Ce qui manque est rarement le chiffre principal. C'est le détail qui rend les données exploitables :
- Les lignes de détail, car la page de synthèse liste les totaux et la facture PDF liste ce qui compose ces totaux.
- Les pages deux et suivantes d'un relevé, car la première page porte le bloc de synthèse.
- Le signe d'un montant, lorsqu'un crédit est imprimé entre parenthèses et copié sous forme de texte.
- L'adresse de facturation, qui se trouve dans un bloc ressemblant à l'adresse de livraison.
- L'identifiant qui permettrait de réunir les pages en un seul enregistrement.
Une capture d'écran est un document, même lorsqu'elle montre un site web
Une capture d'écran d'un tableau de bord bancaire est un document, même si chacun de ses pixels provient d'une page web.
C'est l'inverse de la confusion précédente, et cela piège ceux qui viennent d'apprendre que contenu web signifie web scraping. Un PNG n'a ni DOM, ni sélecteur et souvent aucune URL accessible : l'état affiché peut avoir nécessité une connexion et trois clics. L'outil qui le lit est celui qui lit les pixels. Un PDF téléchargé depuis un portail fonctionne de la même manière : une fois sur le disque, l'URL n'a plus d'importance. Les captures d'écran sont traitées dans extracting data from screenshots.
Les questions juridiques sont d'une autre nature
Le web scraping demande si vous étiez autorisé à accéder aux données. L'extraction de documents demande ce que vous pouvez faire des données que vous détenez déjà.
Du côté du web scraping, les conditions d'utilisation constituent un contrat, et c'est là que réside l'essentiel du risque réel. Les contrôles techniques sont plus faibles qu'ils n'en ont l'air. Le Robots Exclusion Protocol, normalisé sous le nom de RFC 9309 en 2022, indique dans son introduction que ses règles « ne constituent pas une forme d'autorisation d'accès ». Un fichier robots.txt énonce ce que l'opérateur préférerait. Il n'accorde pas de permission.
hiQ Labs v. LinkedIn montre où se situe le risque. En 2022, le Ninth Circuit a confirmé une injonction permettant à hiQ de continuer à collecter des profils publics, au motif que le web scraping de données publiques ne constituait pas en soi un « dépassement d'un accès autorisé » au sens du Computer Fraud and Abuse Act. Cela ressemblait à une victoire pour les scrapers. L'affaire s'est terminée autrement : en novembre 2022, le tribunal de district a jugé que hiQ avait violé l'accord utilisateur de LinkedIn, et un jugement sur consentement rendu en décembre a prononcé une condamnation de $500,000 et interdit définitivement à hiQ tout web scraping. L'action contractuelle a survécu à la théorie spectaculaire.
Le cas délicat pour les équipes financières apparaît rarement dans les comparaisons de catégories. Les transactions de votre compte bancaire sont vos données ; l'interface appartient à la banque. Automatiser cette interface avec vos propres identifiants peut enfreindre les conditions de la banque, même si l'argent vous appartient. Demandez d'abord un export ou vérifiez l'existence d'une API officielle ; au Royaume-Uni et dans l'UE, les règles d'open banking existent pour que l'accès n'ait pas à passer par l'automatisation d'écran.
Du côté des documents, la possession licite est le point de départ de l'analyse. Un relevé contient des données personnelles, de sorte que la conservation, l'accès et le lieu de stockage du fichier par un sous-traitant deviennent des questions à part entière. Ce travail relève d'un responsable de la confidentialité ou de la conformité. Considérez cette section comme une carte des questions à transmettre à qui de droit, et non comme un avis juridique.
Un tableau de décision par source de données
La source détermine l'outil, et la plupart des équipes ont besoin des deux outils pour différentes lignes d'un même tableau.
| Où se trouvent les données | Première action | Pourquoi | Points de vigilance |
|---|---|---|---|
| Facture PDF dans votre boîte de réception | Extraction de documents | Il n'y a pas d'URL. Le fichier est l'enregistrement | Les mises en page varient selon le fournisseur, donc les règles liées à la position nécessitent une règle par fournisseur |
| Relevé bancaire PDF téléchargé depuis un portail | Extraction de documents, couche de texte ou OCR | Tableaux multipages avec colonnes de solde alignées à droite | Rapprochez la somme des transactions des soldes d'ouverture et de clôture |
| Transactions visibles uniquement dans la banque en ligne | Export ou API officielle, puis extraction | Vos identifiants, l'interface de la banque | Conditions d'utilisation et changements d'interface. L'automatisation d'écran est le dernier recours |
| Portail fournisseur qui publie des relevés | Deux étapes : récupérer le fichier, puis extraire | Le téléchargement est de l'automatisation. La lecture est de l'extraction | Gardez-les séparés pour que l'un puisse changer sans l'autre |
| Prix concurrents ou fiches produits | Web scraping | Les données n'existent que sous forme de page en direct | Les sélecteurs cassent lors d'une refonte. Vérifiez les conditions avant de construire |
| Capture d'écran d'un tableau de bord ou d'une application | Extraction de documents | Le fichier est en pixels, et l'état peut ne pas être reproductible | La résolution et le recadrage décident du résultat plus que le modèle |
Lorsqu'un portail publie les documents dont vous avez besoin, le travail se scinde en deux : quelque chose récupère le fichier selon un planning, et quelque chose le lit. Construisez le pipeline pour que l'étape de lecture ne se soucie pas de l'origine du fichier, et le jour où la banque livre une API, vous supprimez une étape de récupération.
Où l'extraction de documents s'arrête
L'extraction de documents commence une fois le fichier existant, elle ne peut donc pas résoudre le problème de l'obtention du fichier.
Cette limite mérite d'être énoncée sans détour. ImageToTable.ai lit les documents. Il ne fait pas de web scraping, ne crawle pas de pages, ne pilote pas de navigateur et n'analyse pas de HTML. Vous téléversez des PDF, des images ou des captures d'écran, ou vous les transférez à une adresse de boîte e-mail, et vous récupérez un tableau, ou un fichier Word si vous avez besoin de la mise en page d'origine. Si un relevé n'existe que derrière un identifiant bancaire, l'extraction est la seconde moitié de votre pipeline.
Il ne sait pas non plus quel chiffre est correct. Il lit ce que la page indique. Un tableau imprimé propre est le cas facile, et notre propre documentation annonce jusqu'à 99 % de précision pour les données de tableaux imprimés ; une photo d'un reçu froissé sous une lampe de bureau n'est pas ce cas. L'écriture manuscrite dense et les mises en page inhabituelles sont là où les niveaux de traitement et une étape de relecture gagnent leur place. La différence entre OCR, extraction et plateformes IDP complètes est traitée dans ce qu'est réellement l'extraction de documents par IA.
Ce qui tient la route, c'est le flux de travail par lots. Vous nommez les colonnes, déposez un dossier de fichiers de différents fournisseurs dans un seul lot, et obtenez un tableau avec les mêmes champs dans le même ordre. Une page qui prenait trois minutes à saisir se traite en quelques secondes. Ce gain est réel, et plus modeste que l'affirmation selon laquelle un seul outil remplace à la fois une pile de scraping et un pipeline de documents.
Questions fréquentes
L'OCR est-il la même chose que le web scraping ?
Non. L'OCR lit des caractères à partir de pixels, tandis que le web scraping lit du balisage sur une page en direct. Les deux se rejoignent dans un cas précis : certains sites affichent le texte sous forme d'image pour contrer les scrapers, et un pipeline de scraping peut exécuter l'OCR sur cette image en secours. L'OCR est un composant d'une tâche de scraping, pas un synonyme.
Un scraper web peut-il lire une facture PDF ?
Il peut télécharger le PDF. La partie qui lit la facture est un analyseur de documents, car un PDF n'a aucun élément à sélectionner. Si le fichier possède une couche de texte, un analyseur peut le lire ; s'il s'agit d'un scan, l'OCR ou un modèle de vision doit d'abord lire l'image de la page. Un framework de scraping récupérera le fichier et vous laissera avec un binaire qu'aucun de ses sélecteurs ne peut ouvrir.
Puis-je scraper le site bancaire de ma propre banque ?
Vérifiez d'abord s'il existe un export de relevé ou une API officielle. Les données vous appartiennent, mais l'interface est celle de la banque, et son automatisation est généralement régie par ses conditions. L'automatisation d'écran casse aussi dès que la banque remanie une page. Exportez le relevé, puis extrayez à partir du fichier.
Lequel me faut-il pour une capture d'écran d'un tableau de bord ?
L'extraction de documents. Une capture d'écran est une image matricielle sans DOM et souvent sans URL accessible, il n'y a donc rien qu'un scraper puisse sélectionner. Traitez-la comme un scan, et attendez-vous à ce que l'image source fixe le plafond de précision.
Ai-je besoin d'un développeur pour l'un ou l'autre ?
Le scraping en nécessite généralement un, et continue d'en nécessiter un, car les sélecteurs, les proxys et la gestion anti-bot demandent une maintenance continue. L'extraction de documents ne nécessite pas de code avec un outil no-code, et une API existe si vous voulez intégrer l'étape dans votre propre système.
Le scraping de données publiques est-il légal ?
Cela dépend de la juridiction, des conditions du site, du type de données et de la manière dont vous les collectez. Public ne signifie pas sans restriction. Les données personnelles font entrer le droit de la vie privée en jeu, que la page ait été ouverte ou non, et ignorer les conditions d'un site peut créer une responsabilité contractuelle même lorsque l'accès n'était pas illégal. Consultez un avocat qui connaît votre marché.
La question qui décide de l'achat
Tout ce qui précède se résume à une question : à quel moment vos données cessent-elles d'être un fichier pour devenir une page ? Répondez-y et la comparaison se transforme en liste d'achats : un scraper pour les lignes qui vivent sur des pages actives, un extracteur de documents pour les lignes qui arrivent sous forme de factures, de relevés et de reçus, et une étape de récupération entre les deux pour les portails qui publient des fichiers derrière un identifiant.
Les équipes regrettent rarement d'acheter deux outils pour deux couches. Elles regrettent d'acheter un seul outil pour une couche qu'il n'a jamais été conçu pour lire, et de le découvrir au moment du rapprochement.