Datenextraktion vs. Data Scraping
Wenn Ihre Rechnung keine URL hat
Bitten Sie einen Web Scraper und einen Dokumentenextraktor, denselben Kontoauszug in eine Tabelle zu bringen, liefern beide eine Tabelle. Der eine hat den Kontoauszug gelesen. Der andere die Webseite, die ihn zum Download anbot.
Auch ihre häufigsten Fehler treten an unterschiedlichen Stellen auf. Ein Scraper bricht meist dort, wo Sie es sehen: Ein Klassenname ändert sich, der Selektor liefert nichts, und jemand merkt es noch am selben Tag. Ein Dokumentenextraktor bricht meist innerhalb eines einzelnen Feldes: Ein Betrag liegt um eine Ziffer daneben, die Zeilenzahl stimmt weiterhin, und nichts sieht falsch aus, bis die Spalte abgeglichen wird. Welchen Fehler Ihr Team verkraften kann, ist eine bessere Kaufentscheidung als die Frage, zu welcher Kategorie ein Anbieter sich zählt.
Die wichtigsten Erkenntnisse
- Ein Scraper und ein Dokumentenextraktor liefern Ihnen beide eine Tabelle aus demselben Kontoauszug, das Etikett auf der Verpackung entscheidet also nichts.
- Eine Ziffer daneben genügt: Die Zeilenzahl eines Dokumentenextraktors stimmt weiterhin, und der Fehler zeigt sich erst, wenn Sie die Spalte zusammenzählen.
- Wo die Daten gerade liegen, entscheidet über das Tool: Scrapen Sie, was Sie abrufen können, und extrahieren Sie die Dateien, die Sie bereits haben.
Definitionen variieren. Die Quelle nicht.
Für die beiden Begriffe gibt es keine einheitliche Definition, weshalb der Vergleich immer wieder von vorn beginnt. Der Leitfaden der Bodleian Libraries zu Text- und Data-Mining ordnet Web- und Screen-Scraping unter Data Scraping ein, neben Datenbanken und Dokumenten. Ein Dutzend Anbieter-Erklärungen behandelt Data Extraction als Oberbegriff und stellt Scraping darunter. Keine Normungsorganisation hat die Begriffe je verbindlich festgelegt.
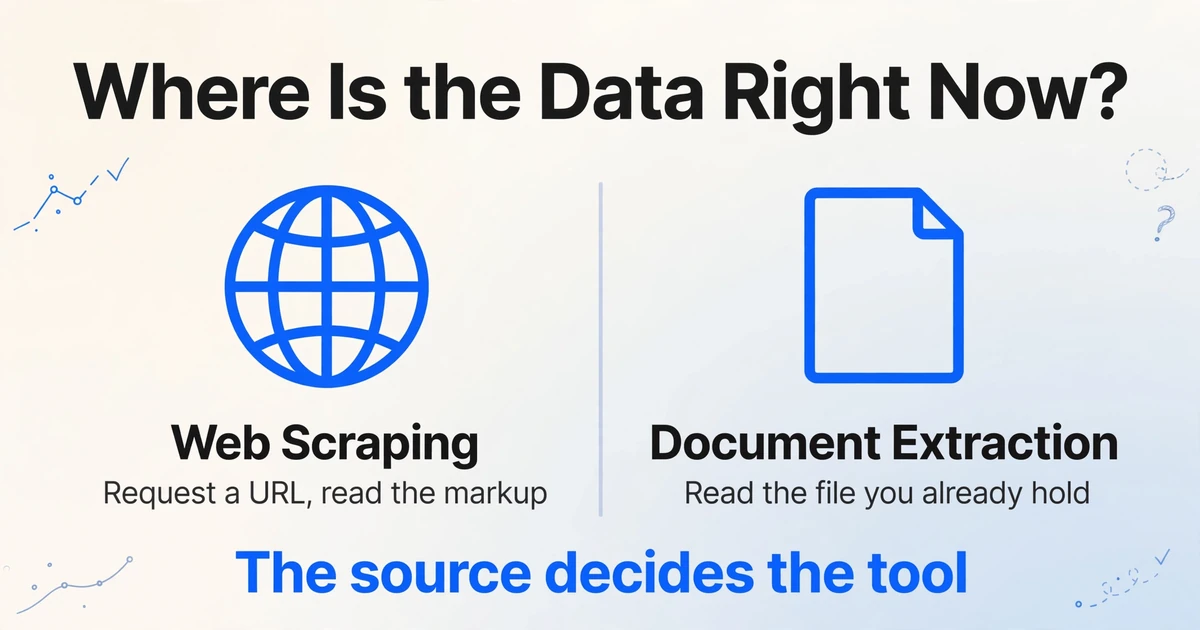
Die Uneinigkeit ändert nichts an der Entscheidung, die vor Ihnen liegt. Web Scraping sammelt Daten aus einer live laufenden Web-Oberfläche: Das Tool ruft eine URL ab oder steuert einen Browser, erhält HTML, ein gerendertes DOM oder eingebettetes JSON und liest Werte aus dieser Struktur heraus. Dokumentenextraktion liest benannte Werte aus einer Datei, die Sie bereits haben, sei es ein PDF, ein Scan, ein Handyfoto eines Belegs, ein Screenshot oder ein E-Mail-Anhang. Es gibt keine Anfrage zu stellen und kein Markup zu prüfen.
Die Abkürzung durch das Definitionsproblem ist die Frage, wo die Daten gerade liegen. Wenn Sie sie durch Abrufen einer Adresse erhalten können, ist es ein Scraping-Problem, oder ein API-Problem, wenn die Seite eine anbietet. Wenn sie bereits in einer Datei stecken, ist es ein Dokumentenproblem.
| Verglichen nach | Web Scraping | Dokumentenextraktion |
|---|---|---|
| Womit Sie starten | Eine URL oder eine Liste davon | Eine Datei: PDF, Scan, Foto, Screenshot, E-Mail-Anhang |
| Was das Tool liest | Die ausgelieferte Seite: HTML, gerendertes DOM, eingebettetes JSON | Pixel oder eine Seitenbeschreibung. Es gibt kein Document Object Model |
| Wie es einen Wert findet | CSS-Selektor, XPath oder ein Muster in der Antwort | Layout-Rekonstruktion plus Bedeutung: Welche Zahl ist die Summe |
| Was es zum Scheitern bringt | Markup-Änderungen, Login-Sperren, Bot-Prüfungen, gerenderte Bilder | Schlechte Scans, dichte Handschrift, Seiten, auf denen derselbe Wert zweimal vorkommt |
| Wer die Quelle kontrolliert | Wer die Seite betreibt | Sie oder die Partei, die Ihnen die Datei geschickt hat |
| Typische Arbeit | Wettbewerberpreise, Produktlisten, Verzeichnisse, Suchergebnisse | Rechnungen, Kontoauszüge, Belege, Verträge, Formulare |
Was ein Scraper liest
Ein Scraper liest das Markup, das ein Browser erhalten hat – deshalb kann er gleichzeitig schnell, günstig und exakt sein.
Eine Anfrage geht an eine URL, ein Server liefert ein Dokument zurück, das Dokument wird in einen Baum aus Elementen geparst, ein Selektor wählt die Elemente mit den Werten aus, und der Vorgang wiederholt sich nach Zeitplan über Seiten hinweg. Auf JavaScript-lastigen Seiten steuert er zuvor möglicherweise einen Headless-Browser, damit der Baum existiert, bevor etwas ausgewählt wird.
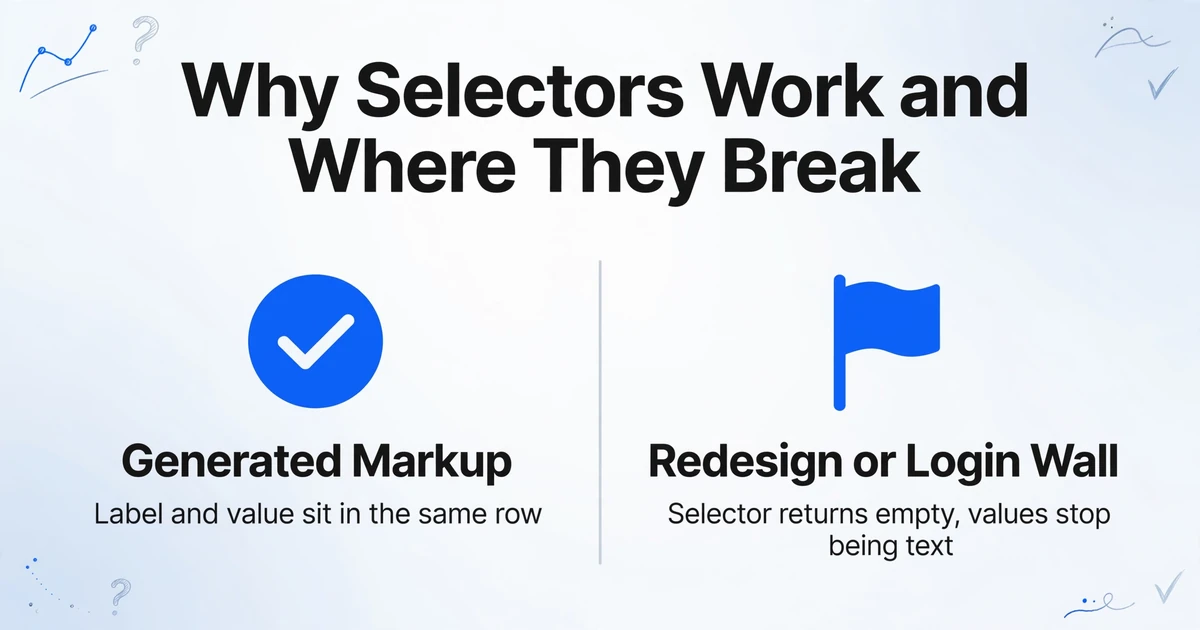
Ein Selektor funktioniert aus einem Grund, der leicht übersehen wird. Eine Seite, die einen Preis anzeigt, wurde aus Daten generiert, daher stehen Label und Wert in derselben Zeile, geschrieben von derselben Vorlage. Das Kopieren der Zelle mit der Klasse .amount liest das Feld, das der Code der Seite zum Rendern verwendet hat.
Der Selektor ist eine Abkürzung, die funktioniert, weil die Seite aus Daten generiert wurde. Nichts an dieser Abkürzung bleibt bestehen, wenn die Quelle kein generiertes Markup mehr ist.
Deshalb bricht Scraping auf bestimmte Weise. Eine Klasse wird bei einem Redesign umbenannt und der Selektor liefert eine leere Liste. Eine Tabelle wandert in ein Canvas oder ein Bild und die Werte sind kein Text mehr. Eine Login-Wand oder Bot-Prüfung stoppt die Anfrage, bevor das Parsen beginnt. Das sind Zugriffs- und Strukturprobleme, und die Lösung kostet Entwicklungszeit.
Dieselbe Eigenschaft erklärt den häufigsten Fehler in gemischten Projekten: anzunehmen, dass ein Tool, das Seiten verarbeitet, auch die angehängten Dateien verarbeitet. Ein Entwickler beschrieb die Hürde klar: „Die meisten Scraper (wie BeautifulSoup, Playwright usw.) helfen bei HTML, aber die Verarbeitung von PDFs während des Crawls erfordert eine zusätzliche Ebene."
Was Dokumentenextraktion stattdessen liest
Ein PDF hat kein Tabellenobjekt, keine Zeile und keine Zelle. Es enthält Anweisungen, Glyphen an Koordinaten auf einer Seite zu platzieren.
Das ist wörtlich gemeint. ISO 32000, die PDF-Spezifikation, beschreibt Text als Glyphen, die durch textanzeigende Operatoren innerhalb einer Reihe von Transformationsmatrizen positioniert werden. Eine Tabelle, die auf dem Bildschirm strukturiert aussieht, ist eine Menge von Zeichen, die zufällig ausgerichtet sind. Die Datei zeichnet die Ausrichtung auf, nicht die Beziehung, sodass ein Parser ableiten muss, dass vier Werte zu einer Zeile gehören und dass der rechteste ein Saldo und kein zweiter Betrag ist. Ein Scan ist einen Schritt weiter entfernt: ein Bild ohne Textebene.
Die Reihenfolge der Arbeit kehrt sich um. Ein Scraper fragt, welches Element den Preis enthält. Ein Dokumentenextraktor muss entscheiden, ob eine Region eine Tabelle ist, wo der Kopf endet, ob ein Wert unter die Zeile darüber oder darunter gehört und welche Zahl die Summe und nicht der Zwischensumme oder die Steuer ist. Optische Zeichenerkennung liefert Zeichen in Lesereihenfolge und hört dort auf, was der Unterschied zwischen Transkription und Extraktion ist.
Die semantische Ebene beseitigt das Problem der Regel-pro-Lieferant. ImageToTable.ai ist auf Benutzerdefinierte Spaltenextraktion aufgebaut: Sie geben die gewünschten Spaltennamen ein, wie „Statement Date" und „Amount", und das Modell findet jeden Wert, indem es versteht, was das Label bedeutet, statt wo es auf dem letzten Kontoauszug stand. Ein Lieferant, der sein Layout ändert, ist für diese Art von Tool kein Ereignis, weil der Locator nie die Position war.
Wo die beiden Ansätze tatsächlich auseinandergehen
Die Abweichung zeigt sich an einer Stelle: der Ebene der Quelle, die die Werte enthält, die Sie brauchen.
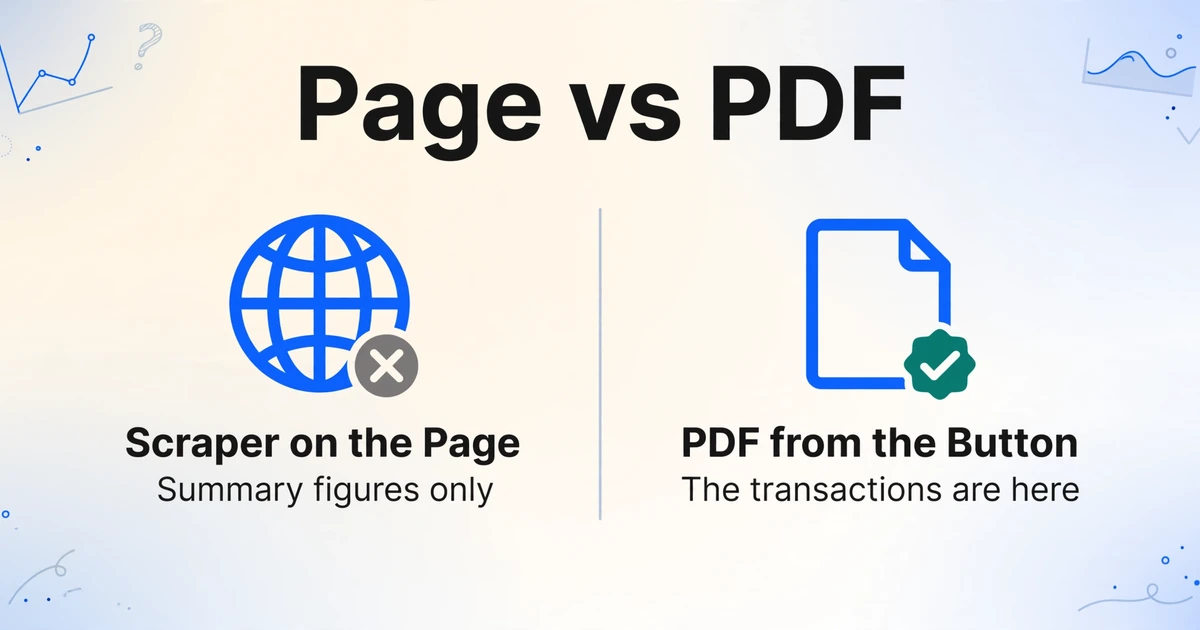
Ein Kontoauszug, der in einem Portal veröffentlicht wird, macht ihn sichtbar. Die Seite zeigt einen Zusammenfassungsblock: Anfangsbestand, Endbestand, Geldeingang, Geldausgang und eine Schaltfläche, die den Kontoauszug als PDF herunterlädt. Ein Scraper, der auf diese Seite gerichtet ist, liefert die Zahlen in Sekunden. Die Transaktionen befinden sich in dem PDF, das die Schaltfläche erzeugt, und nichts auf der Seite enthält sie. Dies ist die gewöhnliche Version des Fehlers, und er wiederholt sich jeden Monat ohne Fehlermeldung.
Lesen Sie dasselbe PDF mit einem positionsbasierten Parser, erscheint ein zweiter Fehler. Die Saldospalte ist rechtsbündig, sodass ihre Ziffern nahe an der Betragsspalte liegen. Gruppieren Sie Text nach Leerraum, können die Spalten verschmelzen; eine Zahl, die bei einem Tausendertrennzeichen über Textläufe aufgeteilt ist, kann als zwei Fragmente ankommen. Die Ausgabe ist eine gültige Tabellenkalkulation mit der richtigen Zeilenanzahl und einer plausiblen Summe. Der Fehler zeigt sich erst, wenn jemand prüft, ob die Transaktionen den Endbestand minus den Anfangsbestand ergeben.
Der dritte Fall ist der einfachste und der häufigste. Eine Rechnung, die als E-Mail-Anhang eintrifft, hat keine Seite zum Abrufen. Der Lieferant hat ein PDF erzeugt und gesendet. Es gibt keine URL und kein Markup, sodass ein Scraping-Stack nichts zu tun hat, bis jemand einen Dokumentenschritt hinzufügt.
Ein Scraper, der die Zusammenfassungsseite zurückgibt, hat nicht versagt. Er hat genau das getan, was verlangt wurde, auf der falschen Ebene der Quelle.
Was fehlt, ist selten die Hauptzahl. Es ist das Detail, das die Daten nutzbar macht:
- Einzelposten, denn die Übersichtsseite listet Summen und die Rechnungs-PDF listet, woraus die Summen bestehen.
- Die Seiten ab Seite zwei eines Kontoauszugs, weil die erste Seite den Übersichtsblock trägt.
- Das Vorzeichen eines Betrags, wenn eine Gutschrift in Klammern gedruckt und als Text kopiert wird.
- Die Rechnungsadresse, die in einem Block steht, der wie die Lieferadresse aussieht.
- Die Kennung, mit der Sie die Seiten wieder zu einem Datensatz zusammenführen könnten.
Ein Screenshot ist ein Dokument, auch wenn er eine Website zeigt
Ein Screenshot eines Bank-Dashboards ist ein Dokument, auch wenn jeder Pixel darin als Webseite begann.
Das ist die Umkehrung der vorherigen Verwechslung, und sie erwischt alle, die gerade gelernt haben, dass Webinhalte Web Scraping bedeuten. Ein PNG hat kein DOM, keinen Selektor und oft keine erreichbare URL: Der Zustand kann ein Login und drei Klicks erfordert haben. Das Werkzeug, das ihn liest, ist das, das Pixel liest. Eine aus einem Portal heruntergeladene PDF funktioniert genauso: Sobald sie auf der Festplatte liegt, spielt die URL keine Rolle mehr. Bildschirmaufnahmen werden in Daten aus Screenshots extrahieren behandelt.
Die rechtlichen Fragen sind grundlegend anderer Art
Beim Scraping geht es darum, ob Sie die Daten erreichen durften. Bei der Dokumentenextraktion geht es darum, was Sie mit Daten tun dürfen, die Sie bereits besitzen.
Auf der Scraping-Seite sind die Nutzungsbedingungen ein Vertrag, und dort liegt das meiste reale Risiko. Die technischen Prüfungen sind schwächer, als sie aussehen. Das Robots Exclusion Protocol, 2022 als RFC 9309 standardisiert, sagt in seiner Einleitung, seine Regeln seien „keine Form der Zugriffsberechtigung". Eine robots.txt-Datei gibt an, was der Betreiber bevorzugen würde. Sie erteilt keine Erlaubnis.
hiQ Labs v. LinkedIn zeigt, wo das Risiko landet. 2022 bestätigte der Ninth Circuit eine einstweilige Verfügung, die hiQ weiter öffentliche Profile sammeln ließ, mit der Begründung, das Scraping öffentlicher Daten überschreite für sich genommen nicht den „autorisierten Zugriff" im Sinne des Computer Fraud and Abuse Act. Das sah nach einem Sieg für Scraper aus. Der Fall endete anders: Im November 2022 stellte das Bezirksgericht fest, dass hiQ die Nutzungsvereinbarung von LinkedIn verletzt hatte, und ein Einverständnisurteil verhängte im Dezember ein Urteil über $500,000 und untersagte hiQ dauerhaft das Scraping. Der Vertragsanspruch überlebte die dramatische Theorie.
Der unangenehme Fall für Finanzteams taucht in Kategorievergleichen selten auf. Die Transaktionen auf Ihrem Bankkonto sind Ihre Daten; die Oberfläche gehört der Bank. Die Automatisierung dieser Oberfläche mit Ihren eigenen Zugangsdaten kann gegen die Bedingungen der Bank verstoßen, auch wenn das Geld Ihnen gehört. Bitten Sie zuerst um einen Export oder prüfen Sie, ob es eine offizielle API gibt; in UK und EU gibt es Open-Banking-Regeln, damit der Zugriff nicht über Bildschirmautomatisierung laufen muss.
Auf der Dokumentenseite ist der rechtmäßige Besitz der Ausgangspunkt der Analyse. Ein Kontoauszug enthält personenbezogene Daten, sodass Aufbewahrung, Zugriff und der Speicherort der Datei bei einem Auftragsverarbeiter zu Fragen werden. Diese Arbeit gehört in die Hände einer Datenschutz- oder Compliance-Verantwortlichen. Betrachten Sie diesen Abschnitt als Karte, welche Fragen an wen zu richten sind, nicht als Rechtsberatung.
Eine Entscheidungstabelle nach Datenquelle
Die Quelle entscheidet über das Tool, und die meisten Teams brauchen beide Tools für verschiedene Zeilen derselben Tabelle.
| Wo die Daten liegen | Erster Schritt | Warum | Worauf achten |
|---|---|---|---|
| Rechnungs-PDF in Ihrem Posteingang | Dokumentenextraktion | Es gibt keine URL. Die Datei ist der Datensatz | Layouts variieren je Lieferant, daher braucht positionsgebundene Regeln je Lieferant eine eigene |
| Kontoauszug-PDF aus einem Portal heruntergeladen | Dokumentenextraktion, Textebene oder OCR | Mehrseitige Tabellen mit rechtsbündigen Saldospalten | Gleichen Sie die Transaktionssumme mit Anfangs- und Endsaldo ab |
| Transaktionen nur im Online-Banking sichtbar | Export oder offizielle API, dann extrahieren | Ihre Zugangsdaten, die Oberfläche der Bank | Nutzungsbedingungen und UI-Änderungen. Bildschirmautomatisierung ist das letzte Mittel |
| Lieferantenportal, das Kontoauszüge bereitstellt | Zwei Schritte: Datei abrufen, dann extrahieren | Der Download ist Automatisierung. Das Lesen ist Extraktion | Halten Sie beides getrennt, damit eines sich ändern kann, ohne das andere zu berühren |
| Wettbewerberpreise oder Produktlistings | Web Scraping | Die Daten existieren nur als Live-Seite | Selektoren brechen bei Redesigns. Prüfen Sie die Bedingungen, bevor Sie bauen |
| Screenshot eines Dashboards oder einer App | Dokumentenextraktion | Die Datei besteht aus Pixeln, und der Zustand ist möglicherweise nicht reproduzierbar | Auflösung und Zuschnitt entscheiden das Ergebnis stärker als das Modell |
Wenn ein Portal die benötigten Dokumente bereitstellt, teilt sich die Aufgabe in zwei: Etwas ruft die Datei nach Zeitplan ab, und etwas liest sie. Bauen Sie die Pipeline so, dass der Leseschritt nicht weiß, woher die Datei kam, und an dem Tag, an dem die Bank eine API ausliefert, löschen Sie einen Abrufschritt.
Wo die Dokumentenextraktion an ihre Grenzen stößt
Die Dokumentenextraktion beginnt erst, wenn die Datei bereits existiert – sie kann das Problem, die Datei zu beschaffen, also nicht lösen.
Diese Grenze sollte man ohne Beschönigung benennen. ImageToTable.ai liest Dokumente. Es scrapt keine Websites, crawlt keine Seiten, steuert keinen Browser und parst kein HTML. Sie laden PDFs, Bilder oder Screenshots hoch oder leiten sie an eine E-Mail-Postfachadresse weiter und erhalten eine Tabelle zurück – oder eine Word-Datei, wenn Sie das ursprüngliche Layout benötigen. Wenn ein Kontoauszug nur hinter einem Bank-Login existiert, ist die Extraktion die zweite Hälfte Ihrer Pipeline.
Außerdem weiß es nicht, welche Zahl korrekt ist. Es liest, was auf der Seite steht. Eine sauber gedruckte Tabelle ist der einfache Fall, und unsere eigene Dokumentation nennt bis zu 99 % Genauigkeit für gedruckte Tabellendaten; ein Foto eines zerknitterten Belegs unter einer Schreibtischlampe ist nicht dieser Fall. Bei dichter Handschrift und ungewöhnlichen Layouts zeigen Modellstufen und ein Prüfschritt, was sie wert sind. Der Unterschied zwischen OCR, Extraktion und vollwertigen IDP-Plattformen wird in was KI-Dokumentenextraktion tatsächlich ist behandelt.
Was Bestand hat, ist der Batch-Workflow. Sie benennen die Spalten, werfen einen Ordner mit Dateien verschiedener Lieferanten in einen Batch und erhalten eine Tabelle mit denselben Feldern in derselben Reihenfolge. Eine Seite, deren Eingabe drei Minuten dauerte, ist in Sekunden verarbeitet. Dieser Gewinn ist real – und kleiner als die Behauptung, ein einziges Tool ersetze gleichzeitig einen Scraping-Stack und eine Dokumenten-Pipeline.
Häufig gestellte Fragen
Ist OCR dasselbe wie Web Scraping?
Nein. OCR liest Zeichen aus Pixeln, während Web Scraping Markup aus einer Live-Seite liest. Beide treffen in einem engen Fall aufeinander: Manche Websites rendern Text als Bild, um Scraper abzuwehren, und eine Scraping-Pipeline kann als Fallback OCR auf diesem Bild ausführen. OCR ist eine Komponente innerhalb eines Scraping-Jobs, kein Synonym dafür.
Kann ein Web Scraper eine PDF-Rechnung lesen?
Er kann das PDF herunterladen. Der Teil, der die Rechnung liest, ist ein Dokumentenparser, denn ein PDF hat keine Elemente, die man auswählen könnte. Hat die Datei eine Textebene, kann ein Parser sie lesen; ist es ein Scan, müssen OCR oder ein Vision-Modell zuerst das Seitenbild lesen. Ein Scraping-Framework lädt die Datei herunter und lässt Sie mit einer Binärdatei zurück, die keiner seiner Selektoren öffnen kann.
Kann ich die Online-Banking-Seite meiner eigenen Bank scrapen?
Prüfen Sie zuerst, ob es einen Kontoauszug-Export oder eine offizielle API gibt. Die Daten gehören Ihnen, aber die Oberfläche gehört der Bank, und die Automatisierung unterliegt in der Regel deren Bedingungen. Bildschirmautomatisierung bricht außerdem jedes Mal, wenn die Bank eine Seite neu gestaltet. Exportieren Sie den Kontoauszug und extrahieren Sie dann aus der Datei.
Was brauche ich für einen Screenshot eines Dashboards?
Dokumentenextraktion. Ein Screenshot ist ein Rasterbild ohne DOM und oft ohne erreichbare URL, es gibt also nichts, was ein Scraper auswählen könnte. Behandeln Sie ihn wie einen Scan, und rechnen Sie damit, dass das Quellbild die Obergrenze der Genauigkeit bestimmt.
Brauche ich für eines von beidem einen Entwickler?
Scraping braucht in der Regel einen – und braucht weiterhin einen, denn Selektoren, Proxys und Anti-Bot-Handling sind laufende Wartungsarbeit. Dokumentenextraktion erfordert mit einem No-Code-Tool keinen Code, und es gibt eine API, wenn Sie den Schritt in Ihr eigenes System einbinden möchten.
Ist das Scraping öffentlicher Daten legal?
Das hängt von der Rechtsordnung, den Bedingungen der Website, der Art der Daten und davon ab, wie Sie sie erfassen. Öffentlich bedeutet nicht uneingeschränkt. Bei personenbezogenen Daten kommt der Datenschutz ins Spiel, unabhängig davon, ob die Seite offen war, und das Ignorieren der Bedingungen einer Website kann eine vertragliche Haftung begründen, selbst wenn der Zugriff nicht rechtswidrig war. Fragen Sie einen Anwalt, der Ihren Markt kennt.
Die Frage, die den Kauf entscheidet
Alles oben Gesagte läuft auf eine Frage hinaus: Wo hört Ihr Datenbestand auf, eine Datei zu sein, und fängt an, eine Seite zu sein? Beantworten Sie sie, wird aus dem Vergleich eine Einkaufsliste: ein Scraper für die Zeilen, die auf Live-Seiten liegen, ein Dokumentenextraktor für die Zeilen, die als Rechnungen, Kontoauszüge und Belege eintreffen, und dazwischen ein Abrufschritt für die Portale, die Dateien hinter einem Login veröffentlichen.
Teams bereuen selten den Kauf von zwei Tools für zwei Ebenen. Sie bereuen den Kauf eines Tools für eine Ebene, die es nie lesen sollte, und merken es beim Abgleich.