給与明細データ抽出とは?
給与入力を自動化する
給与明細データ抽出とは、従業員名、支給期間、総支給額、手取り支給額、税金、控除、年初来累計などの主要な報酬項目を、デジタルまたはスキャンされた給与明細から自動的に読み取り、スプレッドシートの構造化された行として出力するプロセスです。給与明細のPDFを1つずつ開いて、給与台帳やExcelシートに1セルずつ値を入力する代わりに、抽出ソフトウェアがドキュメントを読み取り、列を自動で埋めます。給与明細がADP、Gusto、Paychex、QuickBooksのいずれから来たものでも関係ありません。
主なポイント
- 給与明細の処理のほとんどは、PDFを1つずつ開いて、賃金、税金、控除をスプレッドシートに1セルずつ入力する作業に集約されます。
- テンプレートベースの抽出は、見たことのない給与ソフトウェアから給与明細が届いた瞬間に破綻します。主要な給与システムが6つあり、それぞれ異なるレイアウトを使っているため、この破綻は例外ではなく日常的な現実です。
- 意味に基づいて給与明細を読み取るAIは、Federal Tax、PAYE、Lohnsteuerを、ページ上のラベルの位置に関係なく1つの列として扱います。テンプレートを構築する必要も、新しいフォーマットが現れたときに再トレーニングする必要もありません。
給与明細データ抽出とは実際に何か
給与明細データ抽出は給与ソフトウェアではありません。この区別が、この分野で最も多くの混乱を引き起こしています。給与ソフトウェア — ADP、Gusto、Paychex、QuickBooks Payroll — は給与明細を生成します。賃金を計算し、税金を源泉徴収し、コンプライアンス書類を提出し、PDFまたは紙の給与明細を出力します。抽出はその逆を行います。既存の給与明細を読み取り、あらゆるソース、あらゆる給与プロバイダー、あらゆるフォーマットから、分析可能な構造化された列にデータを引き出します。
抽出が独立したカテゴリとして存在する理由は、ほとんどの組織が単一システムの給与明細だけを扱っているわけではないからです。住宅ローン仲介業者は、ADP、Gusto、およびいくつかの小規模プロバイダーを利用する申請者から給与明細を受け取ります — それぞれレイアウトが異なります。人事チームが新入社員の入社手続きを行う際、前職の会社が発行した任意のフォーマットで前職の給与明細を収集します。給与監査担当者は、雇用主が給与プロバイダーを完全に切り替えた可能性がある複数年にわたる記録を照合します。いずれの場合も、データは同じです — 従業員、総支給額、手取り支給額、控除、年初来累計 — しかし、それが載っているテンプレートは毎回異なります。
給与明細から通常抽出されるフィールドは、2つのグループに分かれます:
従業員・雇用主フィールド
- 従業員名・ID
- 雇用主名
- 支給期間(開始日・終了日)
- 支払日
- 雇用状況・税コード
報酬フィールド
- 総支給額・基本給
- 残業代、賞与、手当
- 税控除(連邦・州・地方)
- 社会保険、401(k)、健康保険料
- 手取り支給額
- 各項目の年初来累計(YTD)
給与明細抽出が見た目より難しい理由は、給与エコシステム自体から生じるフォーマットの多様性です。ADPは年初来累計を当期の数値と並べて配置します。QuickBooksが生成した明細はそれらを横方向に並べます。英国の給与明細は国民保険と税コードを先頭に示します。フランスの bulletin de paie は Code du Travail の要件に基づき数十の必須項目を列挙します。フィールドは普遍的ですが、レイアウトはそうではありません。これがテンプレート不要の意味ベースの抽出が解決するために作られた問題です。AIは位置(「『手取り支給額』ラベルの右3インチを見る」)ではなく、意味(「従業員の手取り支給額らしきものを探す」)で読み取ります。このアプローチの背後にあるより広範な技術については、AIドキュメント抽出入門をご覧ください。
給与明細抽出 vs 給与ソフトウェア vs 手動入力
この3つの用語は根本的に異なるものを指しており、混同すると目的に合わないツールを購入してしまいます。
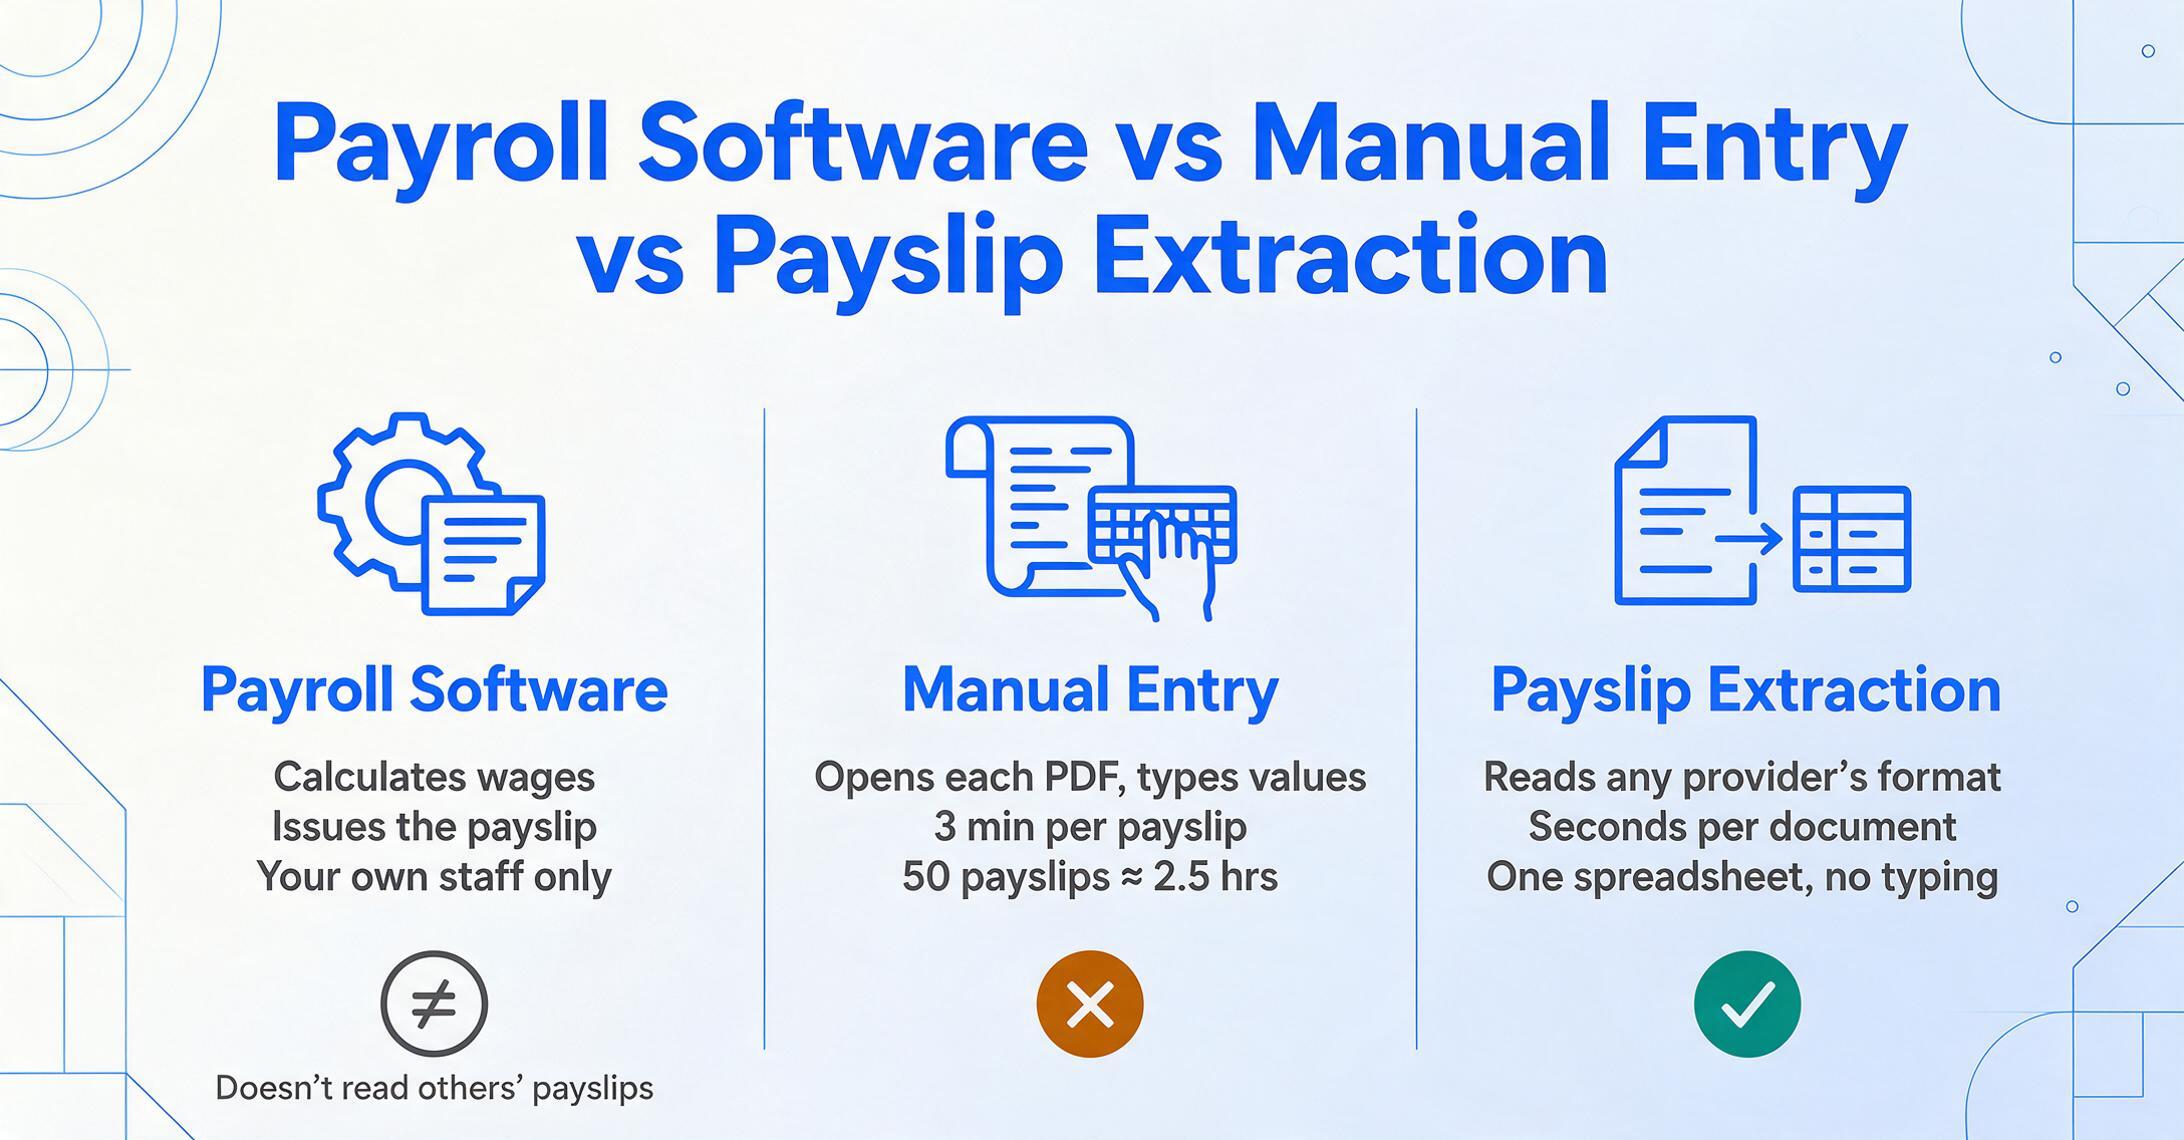
給与ソフトウェアは給与計算を実行します。賃金を計算し、税金を源泉徴収し、W-2やコンプライアンス書類を提出し、従業員向けの給与明細を生成します。ADP、Gusto、Paychexは給与ソフトウェアです。その役割は給与明細を生成することであり、他システムの給与明細を読み取ることではありません。自社の従業員に給与を支払う雇用主であれば、給与ソフトウェアが必要です。他者が生成した給与明細を読み取る立場なら、給与ソフトウェアは役に立ちません。
手動入力とは、抽出の仕組みがない場合に起こることです。担当者が各給与明細のPDFを開き、値を読み取り、スプレッドシートやデータベースに入力します。全項目(従業員情報、支給期間、総支給額、各控除行、手取り支給額、年初来累計の数値)で1件あたり3分かかると、50件で約2.5時間の集中作業になります。200件になれば丸一日です。第二の問題はエラー率です。手取り支給額の小数点の位置が1つずれるだけで、ローンの承認エラーや給与監査の不一致に波及し、原因追跡に何時間もかかることがあります。
給与明細データ抽出は、この手動での読み取りと入力の工程を置き換えます。給与計算は行いません。それは給与ソフトウェアの役割です。税金の申告も行いません。やることは1つ、給与明細のPDFや画像を構造化されたスプレッドシートデータに変換すること。1件あたり数秒で、あらゆる給与プロバイダーのフォーマットに対応します。給与明細を生成せずに受け取る側の組織——金融機関、ブローカー、人事チーム、監査担当者、給与計算アウトソーシング業者——にとって、抽出は給与ソフトウェアがそもそも対応するよう設計されていなかった隙間を埋めます。もしこの方程式の手動入力側に対処してきたなら、手動の給与明細データ入力が人事チームに実際にかかるコストの解説をご覧ください。
給与明細データ抽出の仕組み
給与明細の抽出パイプラインは、請求書抽出、発注書抽出、レシートOCRと同じアーキテクチャに従いますが、課題の性質は異なります。給与明細の項目はより多く、より数値的で、抽出時に保持すべき項目間の関係性があります。
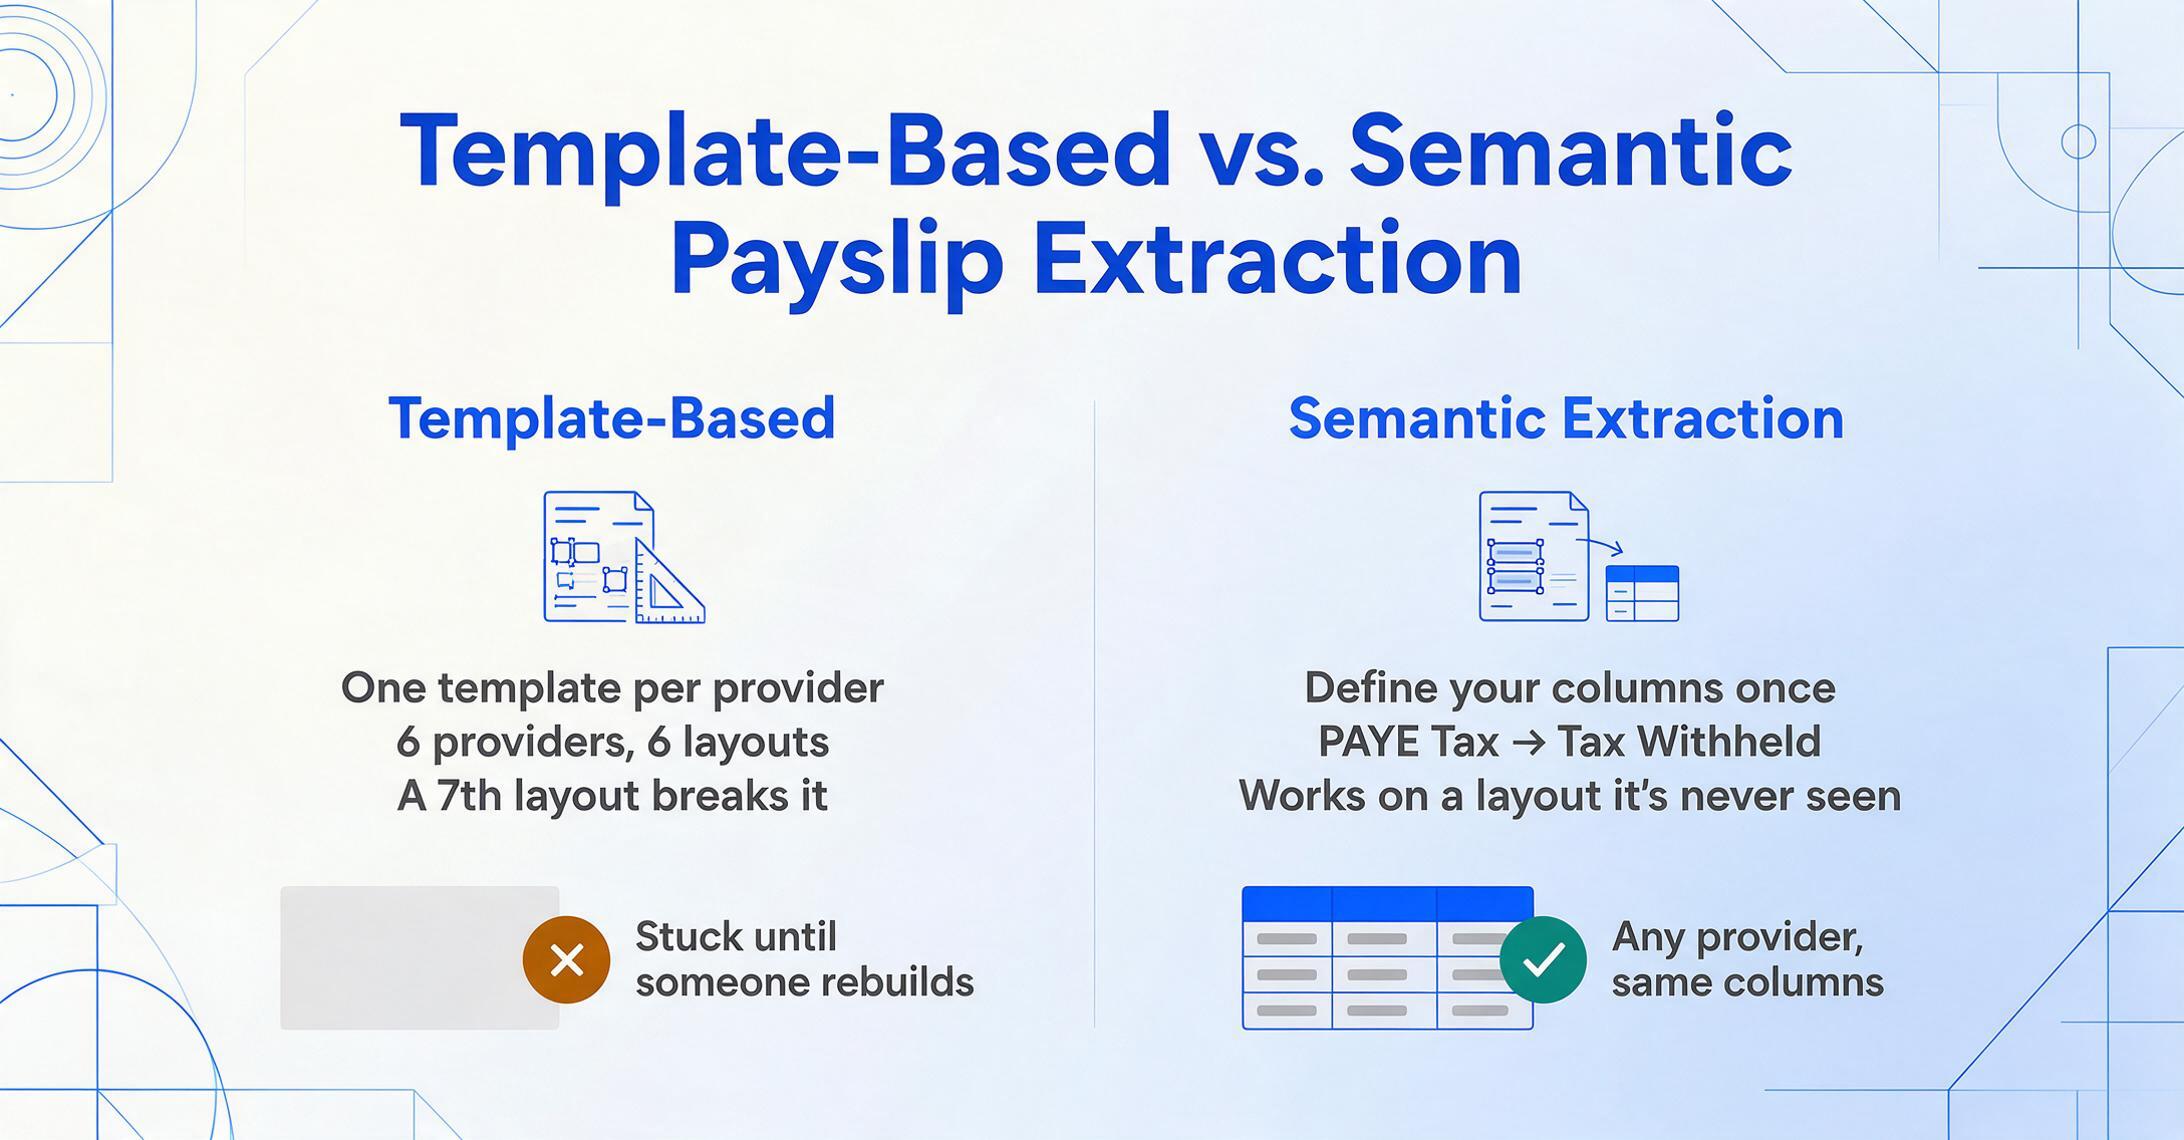
テンプレートベースの抽出 — 従来の方法。従来のツールでは、給与ソフトウェア提供元のフォーマットごとに解析テンプレートを構築する必要があります。あるレイアウトの「総支給額」の周囲にゾーンを描き、その位置をマークし、15以上の項目について繰り返します。そしてワークフローに入ってくる雇用主のフォーマットごとに、また同じ作業を繰り返します。ADP、Gusto、Paychex、QuickBooks、Workday、Sageの給与明細を扱う収入検証チームは、同じデータに対して6つのまったく異なるレイアウトを目にすることになります。7つ目のレイアウトが現れると、誰かがまたテンプレートを構築するまでシステムは破綻します。
意味ベースの抽出 — 現代の方法。現代のAIベースの抽出は、位置ではなく意味によって機能します。「従業員名」「総支給額」「連邦税」「手取り支給額」「年初来累計総支給額」など、必要な項目を指定します。AIはドキュメントを読み取り、英国の給与明細の「PAYE Tax」と米国の「Federal Income Tax」がどちらも「Tax Withheld」列にマッピングされることを理解し、それに従って抽出します。これがカスタム列抽出です。必要な出力列を定義すると、AIはこれまで見たことのないレイアウト上でも各値をその位置で特定します。テンプレート構築は不要で、新しい雇用主のフォーマットが現れても再トレーニングは不要です。
エンドツーエンドの流れは次のとおりです。
給与明細をアップロード
PDF、スキャン、スマホ写真をドロップするだけ — 単一でもバッチでも対応。ADPのエクスポート、GustoのPDF、Paychexの明細、QuickBooksのレポート、あらゆる雇用主の手動スキャン給与明細に対応します。
列を定義
抽出したいフィールド名を入力 — 「従業員」「支給期間」「総支給額」「連邦税」「手取り支給額」。これらがスプレッドシートのヘッダーになります。給与明細プリセットを使えばワンクリックで設定できます。
AIが読み取りマッピング
ビジョンモデルが意味を理解して、どの値がどの列に対応するかを特定します — ADP明細の「Federal Tax」、英国の給与明細の「PAYE」、ドイツの「Lohnsteuer」はすべて税列にマッピングされます。
構造化データをエクスポート
Excel(XLSX)、CSVとしてダウンロード、またはGoogle Sheetsに直接書き込み。各給与明細が1行になり、すべてのフィールドが列として並びます — フィルタリング、照合、給与システムへのインポートにすぐ使えます。
ファイルは安全に処理され、保存されません。
給与明細データ抽出が必要になるケース
抽出が価値を持つのは、給与明細が数枚しかないときではなく、量・フォーマットの多様性・転記ミスの下流への影響が、手入力では済まされないレベルに達したときです。
1. 大規模な収入確認。 住宅ローン仲介業者、自動車ローン会社、賃貸物件管理者は、申請者の収入を確認するために日常的に給与明細を収集します。Point Predictiveの2026年不正報告書によると、収入と雇用の虚偽申告は自動車ローンの不正損失全体の45%を占めており、前年比21%増加して、過去最高の104億ドルの不正リスクに達しています。自動抽出なら、それぞれ異なる雇用主・異なるフォーマットの申請者給与明細の山を、数分で比較可能な行に変換できます。手作業のレビューでは数時間かかっても偽造書類を見逃してしまいます。それ自体で不正を防ぐわけではありませんが、転記のボトルネックを取り除くことで、レビュー担当者はデータ入力ではなく確認作業に時間を使えます。
2. 複数従業員の給与明細の統合。 入社手続き中に前職の給与明細を集める人事チーム、クライアント企業間でデータを統合する給与サービス提供者、複数の雇用主にまたがる賃金記録を照合する経理担当者——いずれも同じパターンに直面します。異なる給与システムからのPDFが入ったフォルダを、1つのスプレッドシートにする必要があるのです。バッチ抽出ならこれを1回で処理できます。50枚の給与明細が50回の手入力になる代わりに、1回のアップロード、1回の処理ジョブ、1つの統合Excelファイルになります。さらに進んで結果を共有ワークスペースに集約したいチームには、給与明細抽出用Google Sheetsアドオンを使えば、ツールを切り替えずに直接スプレッドシートに処理・書き込みができます。
3. 給与監査と照合。 労災保険監査、401(k)コンプライアンスレビュー、社内給与照合はすべて、元の給与明細から構造化された賃金データを必要とします。監査人は元の書類と紐づく明細表を必要とし、各行は特定のPDFまで追跡可能でなければなりません。手動抽出では、監査ごとに数枚の給与明細をサンプリングするのが精一杯です。自動抽出なら全件サンプリングが可能になります。抜き取り検査ではなくすべての給与明細を処理し、レビュー担当者はデータ入力ではなく差異の確認に集中できます。このワークフローの詳細については、人事監査向けバッチ給与明細抽出のガイドをご覧ください。
4. 越境または多国間の給与処理。 米国、英国、ドイツのクライアントを管理する給与アウトソーシング業者は、3つの異なる法的フォーマットの給与明細を受け取ります。フィールド名も税項目の構造も言語も異なります。米国の給与明細には「Federal Income Tax」と「Social Security」が記載されています。英国の給与明細には「PAYE Tax」と「National Insurance」があります。ドイツのGehaltsabrechnungenには「Lohnsteuer」と「Solidaritätszuschlag」があります。意味で読み取る抽出なら、同じ列定義で3つすべてを処理できます。ラベルが何であれ、ページ上のどこにあっても、AIが出力フィールドにマッピングします。
給与明細抽出ツールの選び方
給与明細抽出ツールは、汎用的なOCRラッパーから給与ドキュメント専用に作られた処理ツールまで幅広く存在します。日常的に使う上で重要な基準は次のとおりです。
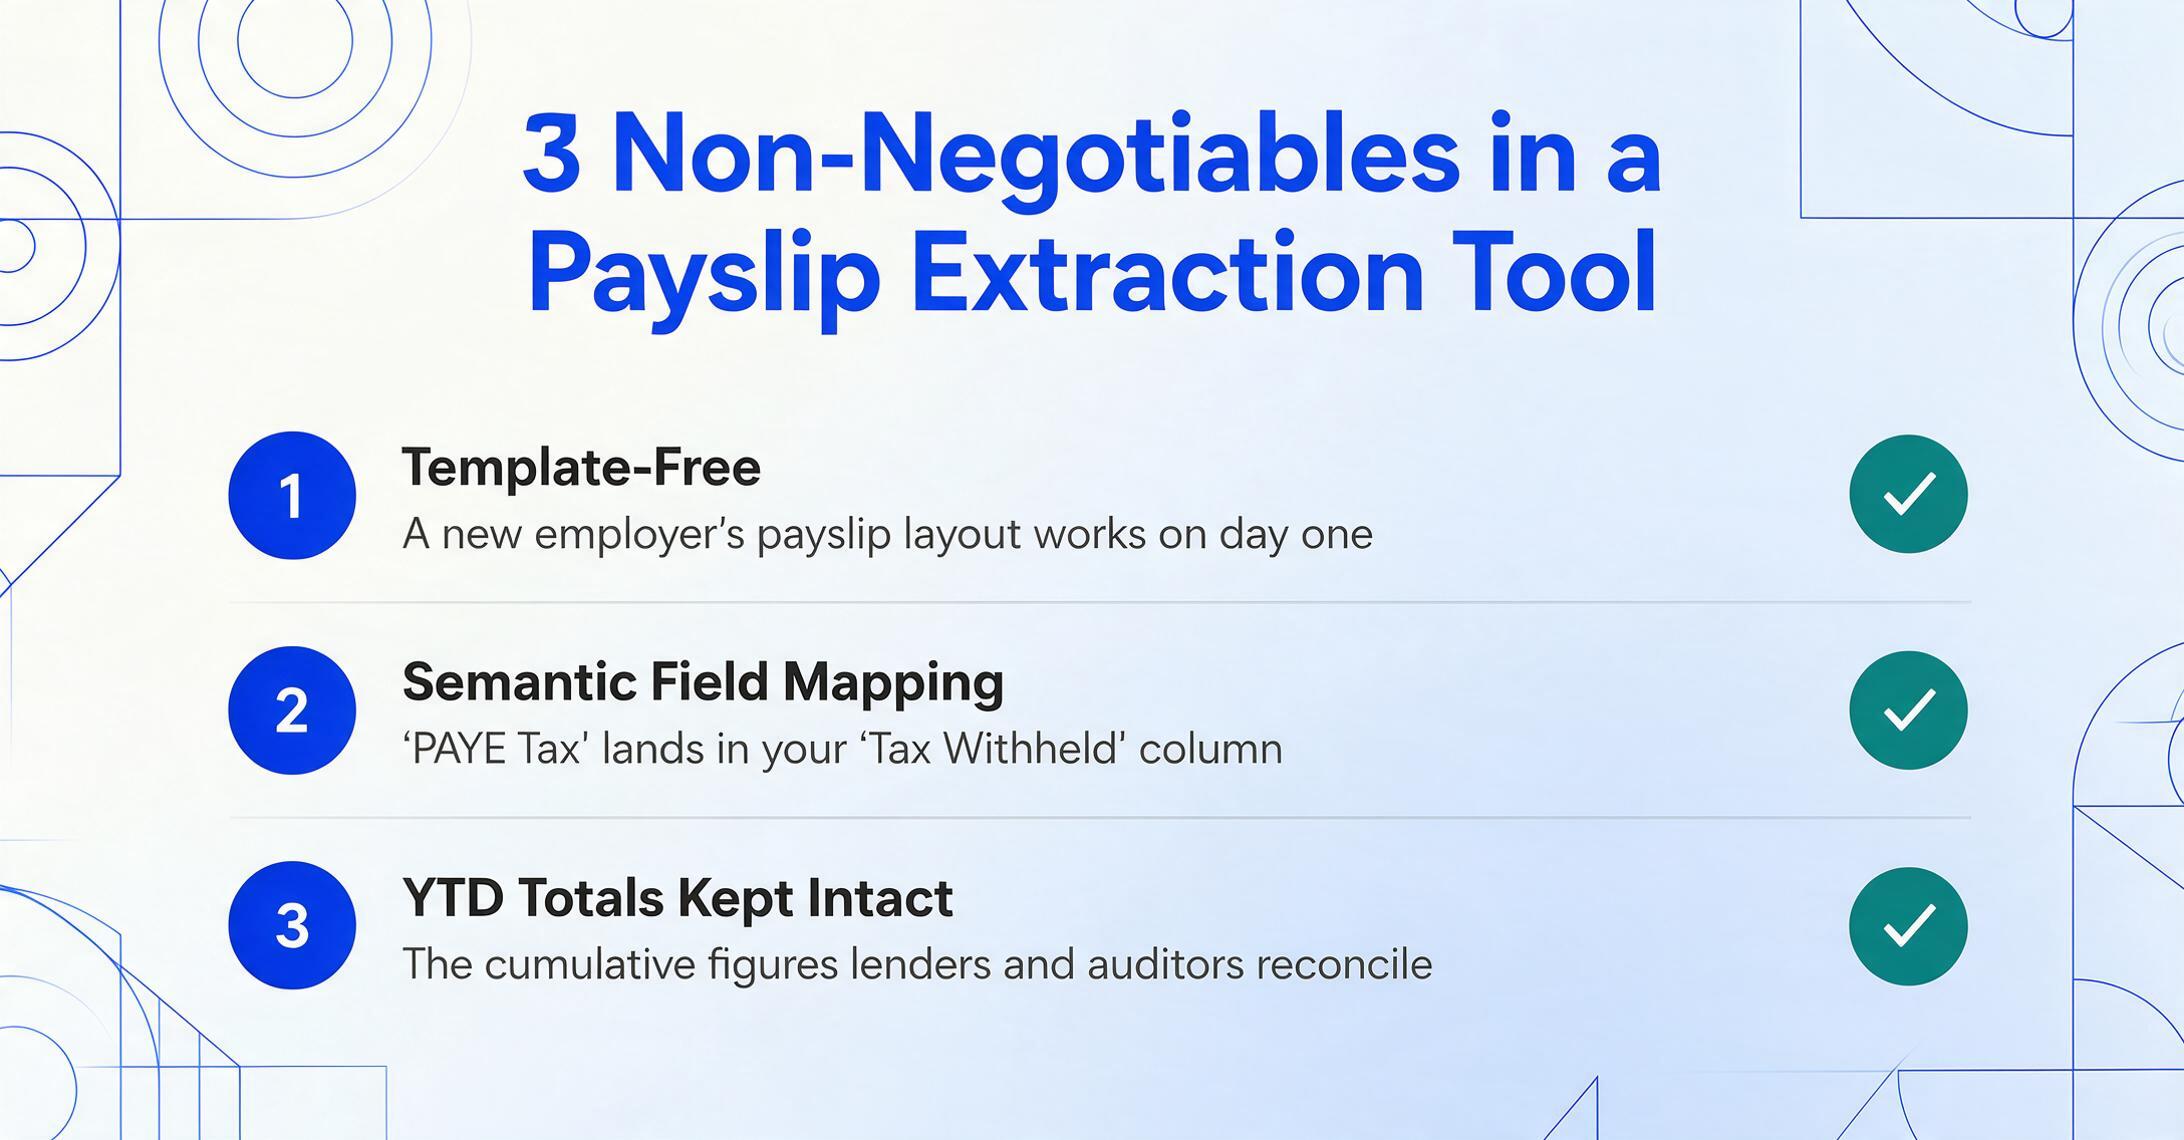
テンプレート不要・フォーマット非依存の動作。 これは譲れません。給与システムごとにパース用テンプレートの作成と保守を求めるツールは、問題を解決しているのではなく、「手動データ入力」を「テンプレート保守」に言い換えているだけです。問うべきは「見たことのない給与システムの明細など、新しい雇用主のフォーマットが出てきたとき、何をする必要があるか」です。答えがテンプレートの作成なら、そのツールは定常状態には対応できても、抽出が最も価値を発揮するオンボーディングの瞬間に失敗します。
プロバイダーをまたぐ意味ベースのフィールドマッピング。 ツールは、英国の給与明細の「PAYE Tax」と米国の「Federal Income Tax」がどちらもあなたの「Tax Withheld」列に対応することを理解する必要があります。これは、契約書から銀行明細まで、さまざまなドキュメント種別で最新の抽出ツールを有効にしているのと同じ能力です。これは翻訳機能ではなく、AIが文字列や位置を照合するのではなく、ドキュメントを意味的に読むという要件です。フィールドラベルが列名と完全一致する場合にしか機能しないツールは、最初の海外給与明細で失敗します。
YTDフィールドの処理。 年初来累計は給与明細で最も重要なフィールドの一つであり、金融機関は収入の一貫性を確認するために、監査担当者は累計控除を確認するために使用します。そして、確実に抽出するのが最も難しいものの一つでもあります。YTDの数値は、異なるフォントサイズの別セクションに表示されることが多く、当期の金額と並んで累計列に記載されることもあります。YTDの総支給額を当期の総支給額と混同するツールは、正しく見えるものの下流のあらゆる判断を誤らせるデータを生成します。YTDと給与明細の他のすべてのフィールドグループについての手順や、バッチ処理でそれらを検証可能なスプレッドシートにまとめる方法は、給与明細データ抽出ハンドブックで最初から最後まで解説しています。
マージ出力を伴うバッチ処理。 個別の抽出は前提条件にすぎません。使えるツールと部分的な解決策を分けるのは、100件の給与明細を一度にアップロードし、各行が1件の給与明細、各列が1つのフィールドである1つのスプレッドシートを返せるかどうかです。100件の個別抽出結果を後からコピー&ペーストするのではありません。
抽出に組み込まれた検証。 優れた抽出ツールはフィールドを読むだけでなく、検証します。手取り支給額は総支給額からすべての控除を引いた額と等しくなるはずです。抽出された値が合わない場合、ツールは矛盾したデータを黙って出力するのではなく、その行にフラグを立てるべきです。ここで給与明細抽出における計算列が検証の層を追加します。AIは抽出された総支給額と控除のフィールドから期待される手取り支給額を計算し、不一致にフラグを立てることができ、抽出を単なるコピー作業ではなく照合作業に変えます。給与明細特有の課題に対応する利用可能なツールの比較については、2026年のおすすめ給与明細抽出ツールまとめをご覧ください。
よくある質問
給与明細データ抽出は給与ソフトウェアと同じですか?
いいえ。給与ソフトウェア(ADP、Gusto、Paychex)は、自社の従業員のために賃金を計算し、税金を源泉徴収し、給与明細を生成します。給与明細抽出は、あらゆる給与システムの既存の給与明細を読み取り、構造化データに変換します。給与明細を生成する雇用主であれば給与ソフトウェアが必要です。他組織が生成した給与明細を収集・確認・監査する場合は抽出が必要です。
AI抽出はさまざまな国の給与明細に対応できますか?
はい、位置ベースではなく意味ベースの抽出を行うツールであれば対応できます。国によって項目名(PAYE、Federal Tax、Lohnsteuer)、控除の区分(National Insurance、Social Security、Sozialversicherung)、レイアウトが異なります。意味ベースの抽出ツールは、ラベルの照合ではなく意味で読み取るため、それらをすべて出力列にマッピングします。ドキュメント上の項目名が列名と一致している必要はありません。AIはそれらが同じ概念を表していると理解します。
給与明細抽出の精度はどのくらいですか?
印刷された判読可能な給与明細であれば、最新のAIベースのツールでは項目レベルの精度は95%〜99%です。従業員名、総支給額、手取り支給額は高い方に、年初来累計の数値や項目別の控除は、より密集して変動の多いセクションに現れるため低い方になります。紙の給与明細をスマートフォンで撮影した写真は、その範囲の低い方になります。重要なワークフローの変化は、抽出によって人の役割が「すべての項目を入力して確認する」から「抽出された項目を確認して例外にフラグを立てる」に移ることです。ここに時間短縮の効果があります。
給与明細抽出は偽造・改ざんされた給与明細を検出できますか?
抽出ツールは不正検出システムではありませんが、より多くのドキュメントでより多くのデータポイントを検証することを実用的にすることで、不正検出を可能にします。手取り支給額が総支給額から控除を引いた額と等しいかをチェックするツールは、計算上の矛盾を検出します。これは素人による偽造のよくある兆候の一つです。また、バッチ抽出ではサンプルを抜き取り確認するのではなく100%の給与明細を処理できるため、異常を捕捉できる可能性が高まります。重要な検証には、抽出は専用の収入検証サービスの代替ではなく、補完するものです。
雇用主ごとの給与明細フォーマットごとに異なるテンプレートが必要ですか?
テンプレート不要の抽出なら必要ありません。従来のOCRツールは位置で抽出するため、給与プロバイダーのレイアウトごとに固有のテンプレートが必要です(ADP用、Gusto用、Paychex用など)。最新のAI抽出は意味で読み取ります。必要な列(総支給額、手取り支給額、税)を定義すれば、AIはページ上のどこにあるかに関係なくそれらを見つけます。これまで見たことのない新しい雇用主のフォーマットも設定なしで処理できます。これはツールを選ぶ前に確認すべき最も重要な能力です。
どのような形式をアップロードできますか?スキャンした紙の給与明細にも対応していますか?
最新の抽出ツールのほとんどは、PDF、JPG、PNG、WebPに対応しています。給与ソフトウェアから出力されたデジタルPDFが最も精度が高いですが、スキャンした紙の給与明細やスマートフォンで撮影した写真も使用できます。精度は形式よりも判読性に依存します。重要な違いは、AIベースのツールは人間と同じようにドキュメントを「見る」ことでスキャン画像を処理するのに対し、従来のOCRはクリーンでコントラストの高いスキャンを必要とする点です。これは、従来のOCRが失敗する場面でもAI手書き文字認識が実用的になるのと同じ原理です。オフィスの照明下で適切な角度から撮影した給与明細は、通常、スキャン版と同じ精度で抽出できます。
給与明細の抽出は、銀行明細書の抽出や請求書の抽出とどう違うのですか?
抽出パイプラインはドキュメントの種類を問わず似ていますが、フィールドの構成は異なります。銀行明細書の抽出では、日付、摘要、金額を含む取引行を処理します。請求書の抽出では、ヘッダーフィールドに加えて複数行の明細項目を処理します。給与明細の抽出はその中間に位置し、多くの場合ドキュメントごとに1行ですが、数値フィールドが多く、フィールド間の関係(手取り支給額 = 総支給額 − 控除)や、当期の値と区別する必要がある年初来累計の累計値があります。給与ソフトウェアベンダーのエコシステム(ADP、Gusto、Paychex、QuickBooks、Workday、Sage)による形式の多様性も、給与明細では特に高いです。
次に進むべきこと
給与明細データ抽出は、給与ソフトウェアが決して埋めるようには設計されていなかった特定のギャップに対応します。それは、他者が生成した給与明細を読み取ることです。このニーズは、収入証明、人事オンボーディング、給与監査、多国間の給与統合など、給与明細がデータベースのレコードではなくドキュメントとして届くあらゆるワークフローに及びます。
抽出が自分のワークフローに合うかどうかを評価する最善の方法は、実際の給与明細でテストすることです。理想的には、異なる給与プロバイダーの複数のフォーマットを混ぜて試してください。最も多様な給与明細を1回のバッチで処理できれば、均一なものは自然と対応できます。AI抽出が従来のOCRとドキュメントタイプ別にどう比較されるかの全体像については、まずAIドキュメント抽出の概要をご覧ください。あるいは、ご自身の給与明細で今すぐテストする準備ができているなら、サンプルをアップロードして結果を確認してください。