解析済みデータをHubSpotに送信する
のは列マッピングの作業
SalesforceのState of Sales調査によると、営業担当者は週の約28パーセントを実際の販売活動に費やしており、手動データ入力が残りの時間を奪う最大の要因の一つです(Salesforce)。ほとんどの生産性調査はその数字で止まります。入力が始まる場所、つまりCRMレコードに単独でなり得なかったドキュメントやメールにまで遡ることはほとんどありません。
リードの問い合わせ、署名済み契約書、仕入先請求書、スキャンしたIDは、HubSpotの行として届くわけではありません。メール本文、PDF添付ファイル、スマホの写真として届き、そのメッセージとレコードの間で、誰かがそれを読んでプロパティに入力します。この記事では、そのギャップを埋めるパイプラインについて説明します。解析済みデータをHubSpotに自動的に送信する方法、各ドキュメントが属するHubSpotオブジェクト、そしてマッピング作業が実際に行われる場所についてです。
重要ポイント
- ドキュメントをHubSpotに取り込む際の難しい部分は統合ではなく、抽出列に付ける名前です。
- フィールドマッピングは通常、パーサーがフィールドに名前を付けた後、最後に行われるため、
inv_totalやrefは、テンプレート編集一つで壊れる可能性のある人間による変換を依然として必要とします。 - 列をHubSpot独自のプロパティに合わせて命名すれば、インポート、Zap、API呼び出しで変換する必要がなくなります。
HubSpotの標準機能が受信ドキュメントに対して行う処理
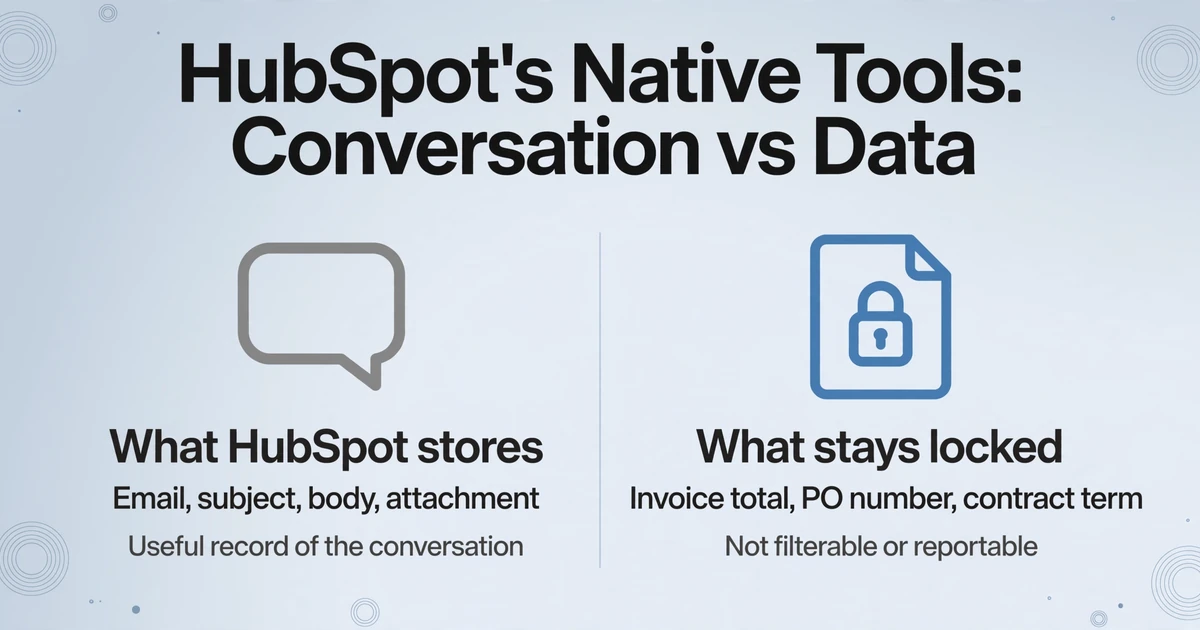
HubSpotの接続済み受信ボックスはメールをCRMに取り込みますが、ドキュメントのデータをレコードの項目に取り込むわけではありません。請求書やリードメールをHubSpotのログ記録用アドレスに転送すると、メッセージは送信者、件名、本文テキストとともに連絡先または取引のタイムラインに保存・表示され、添付ファイルはレコードの「添付ファイル」セクションに保存されます。これは会話の記録としては有用ですが、フィルタリング、レポート作成、ワークフロー起動に使用できる構造化されたプロパティデータではありません。
HubSpotの組み込みAIは、機能名から想像されるよりも範囲が狭いものです。メールから連絡先の詳細を入力する設定は、メールの署名をスキャンし、本文中の電話番号を取得できますが、書き込むのは名、姓、電話番号、役職、携帯番号、FAX番号、市区町村、都道府県、国、郵便番号、番地という固定の基本連絡先プロパティのみです。この機能は、プロパティが空で、かつユーザーによって編集されたことがない場合にのみ値を入力し、連絡先を作成することはありません(HubSpotナレッジベース)。請求書の合計金額、発注書番号、契約期間、明細項目のテーブルをカスタムプロパティに変換することはできません。
ネイティブ機能は会話の記録を残しますが、ドキュメント自体の情報は添付ファイル内にロックされたままです。請求書番号や発注書参照番号は、上流のステップで名前付きフィールドとして抽出されない限り、HubSpotのプロパティにはなりません。
オペレーションチームはこのギャップを自分たちの言葉で説明しています。ドキュメントからの手動コピーを避ける方法に関するr/hubspotのスレッドで、投稿者は率直にこう述べています。「誰かの詳細情報が記載されたドキュメントを受け取ったら、自分で読んでHubSpotのフィールドに入力しなければなりません。機能はしますが、時間がかかり、タイプミスも発生します。みんなコピー&ペーストをしているのでしょうか、それとももっと良いワークフローがあるのでしょうか?」
連絡先、取引先、または取引: まず宛先を選ぶ
HubSpot のオブジェクトによって必要な列が決まるため、自動化ツールを決める前にオブジェクトを決めてください。 HubSpot はレコード作成時に少数の必須プロパティを適用します。連絡先にはメールアドレス、取引先には名前または取引先ドメイン名、取引には取引名、パイプライン、取引ステージが必要です。重複を作成せずに既存レコードを更新するには、行に一意の識別子も必要です。連絡先の場合はメールアドレス、取引先の場合は取引先ドメイン名です(HubSpot ナレッジベース)。抽出前にこれらを把握しておくことで、ドキュメントから40個のフィールドを取得したのに、どれもインポートできないというよくある失敗を防げます。
| ドキュメント | 対象の HubSpot オブジェクト | 重要な列 |
|---|---|---|
| リードまたは問い合わせメール、問い合わせフォーム | 連絡先、通常は取引先も | email、firstname、lastname、phone、company、message |
| 名刺またはIDスキャン | 連絡先 | firstname、lastname、jobtitle、company、email、phone |
| 署名済み契約書または提案書 | 取引、連絡先に関連付け | dealname、amount、closedate、契約期間 |
| 仕入先請求書または発注書 | 取引、またはカスタムオブジェクト | 請求書番号、仕入先、金額、支払期日、PO参照 |
実用的なルールはシンプルです。ドキュメントがシステムに登録される人物または取引先を表す場合は、連絡先または取引先を対象にします。取引または商取引イベントを表す場合は、取引を対象にします。取引先レコードは抽出を省略できることがよくあります。HubSpot は連絡先の勤務先メールドメインから取引先を自動的に関連付けまたは作成でき、ドメインを取引先ドメイン名プロパティに一致させます(HubSpot ナレッジベース)。[email protected] の連絡先をプッシュすると、acme.com の取引先リンクが別の取引先行なしで自動的に表示されます。
逆の間違いは避けるべきです。すべての受信ドキュメントを新しい連絡先と新しい取引の両方に送ることです。明細書、公共料金請求書、定期通知は取引先またはカスタムオブジェクトに属し、営業パイプラインには属しません。ドキュメントがどのオブジェクトに属するかはプロセスに関する判断であり、どの自動化ツールも代わりに判断してくれません。
マッピングは実際には列名で行われる
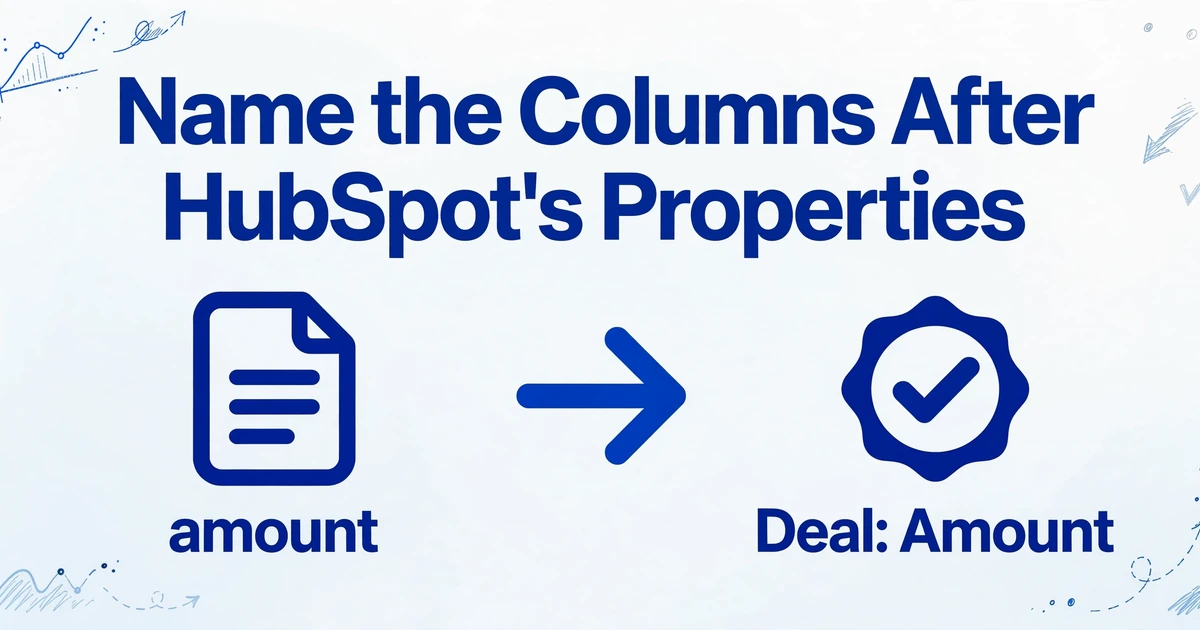
どのガイドもフィールドマッピングを抽出後に行うと説明しますが、その時点で高コストな決定はすでに下されています。 パーサーが vendor_name、inv_total、ref という名前のフィールドを返した場合、人間は inv_total が取引の金額プロパティを意味し、ref がカスタムのPOプロパティを意味することをまだ解決しなければなりません。この変換はすべてのワークフローの中で最も壊れやすい部分であり、テンプレートが編集されるたびに即座に変わります。
ImageToTable.ai は カスタム列抽出 で順序を逆転させます。既知のレイアウト上のフィールドにボックスを描く代わりに、必要な列名を入力すると、AI が各ドキュメントを読み取り、その名前と意味が一致する値を探します。メール本文、スキャンした請求書、撮影したIDはすべてレイアウトが異なりますが、列に email という名前を付ければ、AI はそのいずれからもメールアドレスを見つけます。ソースごとのテンプレートは不要で、送信者のフォーマットが再設計されても抽出は壊れません。
名前を自分で選べるため、HubSpot の内部プロパティ名を選ぶことができます。そうすれば、自動化ステップで変換する必要がなくなります。列 firstname はコンタクトのプロパティ firstname にマッピングされます。列 email は値であると同時に、重複排除のためのコンタクトの一意の識別子でもあります。列 dealname、amount、closedate は、HubSpot がレコードを作成するために必要な取引フィールドに対応します。これは、抽出した列を任意のターゲットシステムのインポート形式に合わせるのと同じ規律であり、在庫システム統合のチュートリアル で調達側の観点から説明しています。
| 抽出列名 | HubSpot のターゲット | 重要な理由 |
|---|---|---|
email | コンタクト: メール | 作成に必須であり、更新時の重複排除キー |
firstname、lastname | コンタクト: 名/姓 | レコード上の基本情報 |
company | コンタクト: 会社名 | 自動の会社関連付けをサポート |
dealname | 取引: 取引名 | HubSpot が取引を作成するために必要な3つのプロパティの1つ |
amount | 取引: 金額 | レコードだけでなくパイプラインが依存する値 |
closedate | 取引: 成約日 | レコードを正しいタイムラインに保つ |
後でクリーンアップする手間を省くための注意点が一つあります。実際に使用するものだけを抽出することです。どのHubSpotプロパティも使用しない列は、誰かが手動でマッピングするか削除することになる列です。構造化データ入力ワークフローも取り込み側から同じ点を指摘しており、抽出の価値はページ上のすべての値を取得することではなく、定義された出力形式にあると述べています。
HubSpotに行を入れる3つの方法
列が宛先と一致したら、行を移動する現実的な方法は3つあり、それらは主に誰がトリガーするか、そしてどれだけのセットアップが必要かによって異なります。
方法1:ファイルインポート。HubSpotのインポートツールは、HubSpotプロパティに対応する列を持つヘッダー行を含む.csvまたは.xlsxファイルを受け入れます。抽出出力が直接スプレッドシートに出力される場合、そのシートがインポートファイルとなり、作業はオブジェクトの選択、ヘッダーのマッピング、一意の識別子の選択になります。これは、大量の履歴データや、スケジュールで同期するだけのチームに適した方法です。Google Sheetsに出力される抽出では、ダウンロードと再フォーマットの手順が不要になり、同じパターンがスプレッドシート宛先に送信されるスクリーンショットデータにも適用されます。
方法2:ノーコードコネクタ。Zapier、Make、n8nはすべて、完了した解析をトリガーとして扱い、抽出されたフィールドをHubSpotアクションにマッピングします。重要なアクションは「作成」ではなく「作成または更新」です。同じ連絡先が2つ目のドキュメントを送信するたびに新しい重複が作成されるのを防ぐためです。Zapierは、メールを重複排除キーとして設定すると、そのルックアップを自動的に処理します。Makeでは、更新と作成を分岐させるために検索ステップとルーターが必要です。この方法は開発者を必要とせず、低〜中程度のボリュームに最適です。そのコストはチェーン自体です。3つのツールを組み合わせると、誰かがワークフローを編集した瞬間に壊れる可能性があります。
方法3:直接API呼び出し。開発者がいるチームの場合、抽出サービスは公開REST APIであるv1 APIを公開しており、ドキュメントのアップロードを受け付け、構造化JSONを返し、バッチが完了するとwebhookを発火できるため、コードがステータスをポーリングする必要はありません。そこから、JSONはHubSpotのCRM APIに投稿され、重複排除のためにメールをキーとする連絡先アップサートエンドポイントと、レート制限内に収まるようにバッチエンドポイントが使用されます。タスクごとのミドルウェア料金はなく、サードパーティのコネクタへの依存もありませんが、代わりにグルーコードを所有することになります。これは、より高いボリュームと、すでにレコードを他のシステムにルーティングしているチーム向けの方法です。
キャプチャステップはすべての前に来る
3つのパスはすべて、ドキュメントがすでにキューにあることを前提としており、それが最初に崩れる点です。リードのメールは共有受信ボックスに届き、請求書は個人用の受信ボックスに届き、IDスキャンはテキストメッセージで届きます。どれもパーサーの近くにはありません。キャプチャレイヤーがこれらのソースを1つの場所に集約する役割を担います。
ImageToTable.aiはすべてのアカウントに専用の受信アドレスを提供します。これがメール受信ボックス機能です。仕入先の請求書、クライアントのフォーム、または自分のメールをそのアドレスに転送すると、アップロードページを介さずに添付ファイルが処理キューに登録されます。保存済みの列テンプレートで自動処理を有効にすると、メールが届いた瞬間に抽出が始まります。送信者ホワイトリストで無関係なメールをキューから除外でき、パスワード保護されたPDFは事前に保存したパスワードでロックが解除され、処理は添付ファイルのみ、メール本文のみ、またはその両方を読み取るように設定できます。最後のオプションが重要なのは、一部の仕入先が添付ファイルなしで請求書データをメッセージ本文に直接貼り付けるためです(メール解析オプション)。
ドキュメントを自分の受信ボックスではなく他の人から受け取る必要がある場合、コレクションリンクは共有可能なアドレスで、ベンダー、クライアント、または現場作業員が短いコードを入力してファイルをアップロードでき、アカウントは不要です。ファイルは同じ処理キューに登録されるため、ドキュメントパイプラインは3つの異なるキャプチャポイントから開始しても、同じ形状の行を生成できます。これはドキュメント抽出パイプラインの概要で説明したのと同じアーキテクチャです。
人間が必要な部分
ドキュメントを抽出してCRMレコードを書き込むパイプラインは、正しいレコードを書き込むパイプラインと同じではありません。その違いは、自動化だけでは判断すべきではないいくつかの決定にあります。
重複排除はポリシーであり、設定ではありません。最初の行が届く前に一意の識別子を決定します。連絡先にはメール、企業には会社ドメインを使用し、作成ではなく更新するアクションを使用します。このステップがないパイプラインは、Janeが2回目にメールを送信したとき、忠実に2人目のJane Smithを作成します。
価値が高い、または曖昧な行はレビューパスが必要です。異常な条件の契約や、しきい値を超える請求書は、パイプラインに到達する前に目視確認するのは安価ですが、後で修正するのは高価です。手書きも同じカテゴリに該当します。印刷されたドキュメントは非常に高い精度で抽出されますが、急いだ署名やID写真は、AIの推測を再確認する価値があるまさにその場面です。
すべてのドキュメントがDealであるとは限りません。上記のオブジェクト決定は、適切に構築されたパイプラインがCRMを静かに劣化させる最も一般的な場所であり、本来そこに属さない定期的な明細でセールスパイプラインを氾濫させます。
同意はデータとは別です。連絡先をHubSpotに取り込んでも、メールやテキストを送信する許可は付与されません。マーケティングメールと自動テキストには独自のルールがあり、抽出レイヤーはそれらについて意図的に意見を持ちません。
よくある質問
HubSpot はメールやPDFのデータをカスタムプロパティにネイティブに解析できますか?
いいえ。HubSpot の組み込みAIは、メールの署名や本文中の電話番号から基本的な連絡先プロパティの短いリストを埋めることができますが、連絡先を作成したり、請求書、注文書、契約書をカスタムプロパティに読み込んだりすることはできません。ドキュメントの内容をプロパティにするには、上流での抽出ステップと、その後のファイルインポート、ノーコードコネクタ、またはAPI呼び出しが必要です。
抽出したデータを直接 HubSpot に入れることはできますか、それともCSVにする必要がありますか?
どちらも可能です。ファイルインポートの方法ではCSVまたはXLSXを使用します。直接の方法ではJSONを HubSpot のCRM APIに送信するため開発者が必要です。連絡先アップサートエンドポイントはサーバー側でメールによる重複排除を処理します。ノーコードコネクタはその中間にあり、エンジニアリングサポートのないチームには通常こちらが選ばれます。
パイプラインが重複した連絡先を作成しないようにするにはどうすればよいですか?
作成または更新アクションを使用し、メールアドレスを一意の識別子として設定します。ファイルインポートでは、Email 列を連絡先の一意の識別子にマッピングして、HubSpot が新しいレコードを追加する代わりに既存のレコードと一致するようにします。企業の場合、同等の識別子は企業のドメイン名です。
メール本文と添付ファイルの両方を読み取れますか?
はい。処理は添付ファイルのみ、メール本文のみ、または両方を一緒に読み取るように設定できます。これにより、PDFを添付する送信者と、詳細をメッセージに直接書く送信者が混在する現実的な状況に対応できます。
これには開発者が必要ですか?
インポートまたはノーコードの方法では必要ありません。開発者が必要なのは直接APIルートのみで、そのルートは通常、大量のデータを扱う場合や、抽出した同じデータを別の内部システムにも供給する場合に選択されます。
すべての HubSpot 統合ガイドが見落としている点は、抽出列に HubSpot 自身のプロパティと同じ名前を付けた瞬間にマッピングの問題が解決されるということです。そうすれば、Zap、インポート、またはAPI呼び出しは翻訳作業ではなくパススルーになります。
列が HubSpot のオブジェクトと一致すれば、パイプラインに残る変数は、毎週届くドキュメントの量と種類だけです。受信ボックスに既に存在する取り込みポイントから始め、HubSpot が実際に使用する少数の列を定義し、残りはコネクタに任せてください。自分のリードメールや請求書の1つで試して、どの列が返ってくるかを確認してください。