Enviar datos analizados a HubSpot
es una tarea de asignación de columnas
La investigación State of Sales de Salesforce descubrió que los representantes dedican aproximadamente el 28 por ciento de su semana a vender, y la introducción manual de datos es uno de los mayores bloqueos que consume el resto (Salesforce). La mayoría de los estudios de productividad se detienen en esa cifra. Rara vez rastrean el origen de la escritura, que suele ser un documento o un correo que nunca tuvo la oportunidad de convertirse en un registro de CRM por sí solo.
Una consulta de cliente potencial, un contrato firmado, una factura de proveedor o una identificación escaneada no llega como una fila completa de HubSpot. Llega como texto del cuerpo de un correo, un archivo adjunto en PDF o una foto tomada con el teléfono, y en algún punto entre ese mensaje y el registro, una persona lo lee y lo introduce en las propiedades. Este artículo trata sobre el proceso que cierra esa brecha: cómo enviar datos analizados a HubSpot automáticamente, a qué objeto de HubSpot pertenece cada documento y dónde reside realmente el trabajo de asignación.
Conclusiones clave
- La parte difícil de llevar documentos a HubSpot no es la integración, sino cómo se nombran las columnas de extracción.
- La asignación de campos suele ir al final, después de que el analizador haya nombrado los campos, por lo que
inv_totalyrefaún necesitan una traducción humana que una sola edición de plantilla puede romper. - Asigne nombres a las columnas según las propiedades propias de HubSpot, y la importación, el Zap o la llamada a la API no tendrán nada más que traducir.
Qué hacen las herramientas propias de HubSpot con un documento entrante
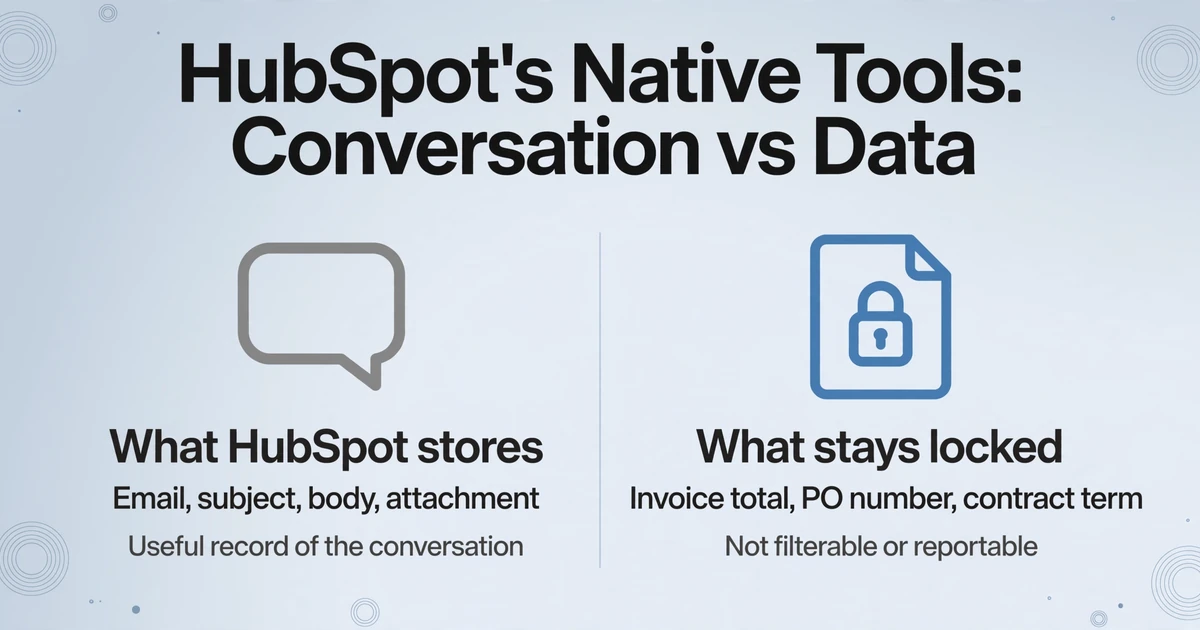
La bandeja de entrada conectada de HubSpot introduce el correo en el CRM; no introduce los datos del documento en los campos del registro. Cuando se reenvía una factura o un correo de un cliente potencial a la dirección de registro de HubSpot, el mensaje se almacena y se muestra en la línea de tiempo del contacto o del negocio, con su remitente, asunto y cuerpo del texto, y cualquier archivo adjunto se guarda en la sección Archivos adjuntos del registro. Eso es un registro útil de la conversación. No son datos de propiedades estructurados que se puedan filtrar, usar en informes o desde los que se pueda activar un flujo de trabajo.
La IA integrada de HubSpot es más limitada de lo que sugiere el nombre de la función. El ajuste que rellena los datos de contacto a partir de correos escanea una firma de correo y puede captar un número de teléfono en el cuerpo, pero solo escribe una lista fija de propiedades de contacto básicas: nombre, apellidos, teléfono, cargo, móvil, fax, ciudad, estado, país, código postal y dirección. Solo rellena una propiedad cuando está vacía y nunca ha sido editada por un usuario, y no crea contactos (Base de conocimientos de HubSpot). No convertirá el total de una factura, un número de orden de compra, la duración de un contrato ni una tabla de líneas de pedido en propiedades personalizadas.
La capa nativa registra qué conversación tuvo lugar; los datos propios del documento permanecen bloqueados en el archivo adjunto. El número de factura y la referencia de la orden de compra no se convertirán en propiedades de HubSpot a menos que un paso anterior los extraiga como campos con nombre.
Los equipos de operaciones describen esta brecha exacta con sus propias palabras. En el hilo de r/hubspot sobre cómo evitar la copia manual de datos de documentos, el autor lo expresó claramente: "si recibo un documento con los datos de alguien, todavía tengo que leerlo y rellenar los campos en HubSpot yo mismo. Funciona, pero lleva tiempo y se cometen errores tipográficos. ¿Todo el mundo está haciendo copiar/pegar, o hay un mejor flujo de trabajo?"
Contacto, Negocio o Empresa: Elija primero el destino
El objeto de HubSpot determina qué columnas necesita, así que decida el objeto antes de decidir la herramienta de automatización. HubSpot exige un pequeño conjunto de propiedades obligatorias al crear registros: un Contacto necesita un Email, una Empresa necesita un Nombre o un nombre de dominio de empresa, y un Negocio necesita un nombre de negocio, un Pipeline y una etapa de negocio. Para actualizar un registro existente en lugar de crear un duplicado, la fila también necesita un identificador único, que para los contactos es la dirección de correo electrónico y para las empresas es el nombre de dominio de la empresa (Base de conocimientos de HubSpot). Conocer estos datos antes de la extracción evita la trampa común de extraer cuarenta campos de un documento y luego descubrir que no puede importar ninguno de ellos.
| Documento | Objeto de HubSpot de destino | Columnas que importan |
|---|---|---|
| Correo de cliente potencial o consulta, formulario de contacto | Contacto y, por lo general, Empresa | email, firstname, lastname, phone, company, message |
| Escaneo de tarjeta de visita o identificación | Contacto | firstname, lastname, jobtitle, company, email, phone |
| Contrato o propuesta firmada | Negocio, asociado al Contacto | dealname, amount, closedate, contract term |
| Factura de proveedor u orden de compra | Negocio u objeto personalizado | invoice number, vendor, amount, due date, PO reference |
La regla práctica es simple: si el documento representa a una persona o empresa que ingresa en su sistema, apunte a un Contacto o una Empresa. Si representa una transacción o un evento comercial, apunte a un Negocio. El registro de Empresa suele ser el que puede omitir extraer, porque HubSpot puede asociar o crear una empresa automáticamente a partir del dominio del correo electrónico de trabajo de un contacto, haciendo coincidir el dominio con la propiedad de nombre de dominio de la empresa (Base de conocimientos de HubSpot). Envíe un Contacto con [email protected] y el vínculo de la empresa acme.com aparecerá por sí solo, sin necesidad de una fila de empresa separada.
El error a evitar es el inverso: enviar cada documento entrante a un nuevo Contacto y a un nuevo Negocio. Los estados de cuenta, las facturas de servicios públicos y los avisos recurrentes pertenecen a la Empresa o a un objeto personalizado, no al pipeline de ventas. A qué objeto pertenece un documento es un criterio sobre su proceso, y ninguna herramienta de automatización puede decidirlo por usted.
La asignación ocurre realmente en los nombres de las columnas
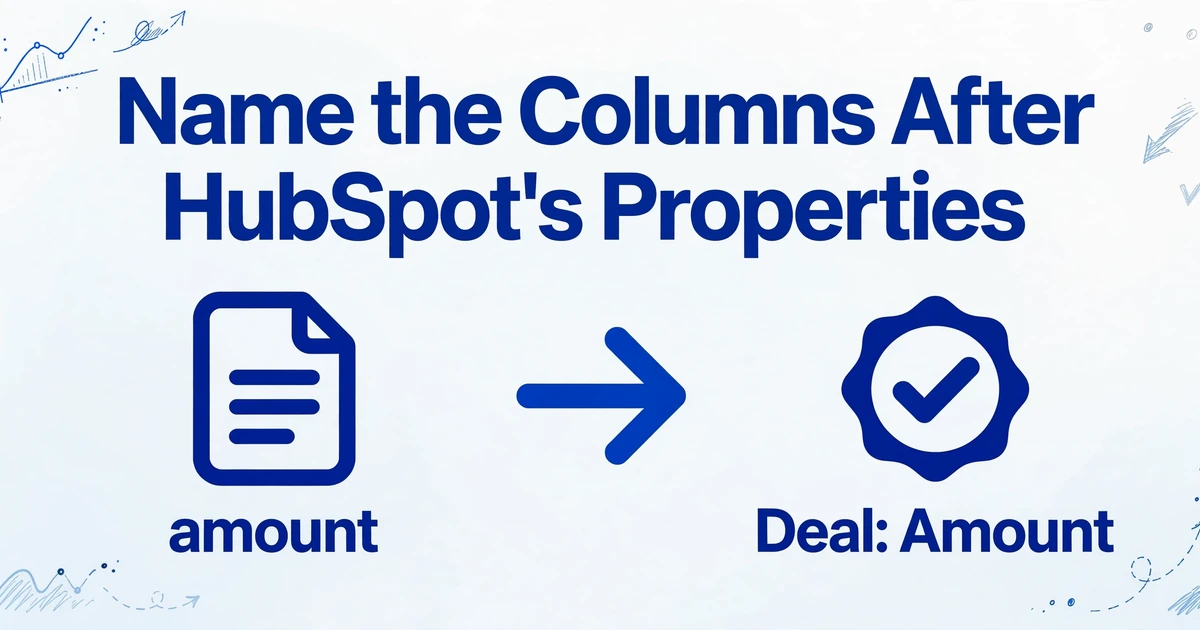
Toda guía sitúa la asignación de campos después de la extracción, pero para entonces la decisión costosa ya está tomada. Si el analizador entrega campos llamados vendor_name, inv_total y ref, una persona aún tiene que deducir que inv_total significa la propiedad Amount de la transacción y que ref significa una propiedad de orden de compra personalizada. Esa traducción es la parte frágil de todo flujo de trabajo y se rompe al instante cada vez que se edita una plantilla.
ImageToTable.ai invierte el orden con Extracción de Columnas Personalizadas: en lugar de dibujar recuadros alrededor de los campos en un diseño conocido, se escriben los nombres de las columnas deseadas y la IA lee cada documento para encontrar los valores que coinciden con esos nombres por significado. El cuerpo de un correo, una factura escaneada y una identificación fotografiada tienen diseños distintos, pero si se nombra una columna email, la IA encuentra la dirección de correo en cualquiera de ellos. Sin plantilla por fuente, y un rediseño del formato del remitente no rompe la extracción.
Como se eligen los nombres, se pueden elegir como los nombres internos de las propiedades de HubSpot. Al hacerlo, el paso de automatización no tiene nada que traducir. La columna firstname se asigna a la propiedad de Contacto firstname. La columna email es a la vez un valor y el identificador único del Contacto para la deduplicación. Las columnas dealname, amount y closedate se alinean con los campos de Transacción que HubSpot necesita para crear el registro. Esta es la misma disciplina que alinear las columnas extraídas al formato de importación de cualquier sistema de destino, que el tutorial de integración con el sistema de inventario cubre desde el lado de las adquisiciones.
| Nombre de la columna de extracción | Destino en HubSpot | Por qué es importante |
|---|---|---|
email | Contacto: Correo electrónico | Obligatorio para crear y clave de deduplicación para actualizaciones |
firstname, lastname | Contacto: Nombre/Apellido | Identidad básica en el registro |
company | Contacto: Nombre de la empresa | Respaldan la asociación automática de empresas |
dealname | Transacción: Nombre de la transacción | Una de las tres propiedades que HubSpot requiere para crear una Transacción |
amount | Transacción: Monto | El valor del que depende el pipeline, no solo el registro |
closedate | Transacción: Fecha de cierre | Mantiene el registro en el cronograma correcto |
Una precaución que ahorra limpieza después: solo extraer lo que realmente se vaya a utilizar. Una columna que ninguna propiedad de HubSpot consume es una columna que alguien terminará mapeando a mano o eliminando. El flujo de trabajo de entrada de datos estructurados plantea el mismo punto desde el lado de la captura: el valor de la extracción proviene de una forma de salida definida, no de extraer cada valor de la página.
Tres formas de llevar las filas a HubSpot
Una vez que las columnas coinciden con el destino, hay tres formas realistas de mover las filas, y se diferencian principalmente en quién las activa y cuánta configuración requieren.
Opción uno: importación de archivo. La herramienta de importación de HubSpot acepta un archivo .csv o .xlsx con una fila de encabezado cuyas columnas correspondan a las propiedades de HubSpot. Si el resultado de la extracción llega directamente a una hoja de cálculo, la hoja es el archivo de importación, y el trabajo se reduce a seleccionar el objeto, mapear los encabezados y elegir el identificador único. Esta es la opción adecuada para datos históricos masivos o para equipos que solo sincronizan de forma programada. La extracción que llega a Google Sheets elimina el paso de descargar y reformatear, y el mismo patrón se aplica a datos de capturas de pantalla enviados a un destino de hoja de cálculo.
Opción dos: conector sin código. Zapier, Make y n8n tratan un análisis completado como un desencadenante y luego mapean los campos extraídos a una acción de HubSpot. La acción que importa es "crear o actualizar", no "crear", porque evita un duplicado nuevo cada vez que el mismo contacto envía un segundo documento. Zapier gestiona esa búsqueda cuando se establece el correo electrónico como clave de deduplicación; Make necesita un paso de búsqueda y un enrutador para dividir entre actualizar y crear. Esta opción no requiere desarrollador y es la más adecuada para volúmenes bajos o moderados. Su costo es la cadena en sí: tres herramientas conectadas pueden fallar en el momento en que alguien edita un flujo de trabajo.
Opción tres: llamada directa a la API. Para equipos con un desarrollador, el servicio de extracción expone una API REST pública, la v1 API, que acepta cargas de documentos, devuelve JSON estructurado y puede activar un webhook cuando un lote finaliza, para que el código no tenga que consultar el estado. Desde allí, el JSON se envía a la API de CRM de HubSpot, utilizando el endpoint de upsert de contactos con el correo electrónico como clave de deduplicación y endpoints de lote para mantenerse dentro de los límites de velocidad. No hay tarifa de middleware por tarea ni dependencia de un conector de terceros, a costa de mantener el código de integración. Esta es la opción para volúmenes más altos y para equipos que ya enrutan registros hacia otros sistemas.
El paso de captura viene antes que cualquiera de ellos
Las tres rutas asumen que el documento ya está en una cola, y eso es lo primero que falla. Los correos de clientes potenciales llegan a una bandeja de entrada compartida, las facturas a una personal, los escaneos de identificación por mensaje de texto, y ninguno está cerca de un analizador. La capa de captura es la que canaliza esas fuentes hacia un solo lugar.
ImageToTable.ai le otorga a cada cuenta una dirección de bandeja de entrada dedicada, que es lo que es la función de Bandeja de entrada de correo: reenvíe una factura de proveedor, un formulario de cliente o su propio correo a esa dirección y el archivo adjunto llegará a su cola de procesamiento sin necesidad de una página de carga. Active el Procesamiento automático con una plantilla de columna guardada y la extracción comenzará en el momento en que llegue el correo. Una lista blanca de remitentes mantiene fuera de la cola el correo no relacionado, los PDF protegidos con contraseña se desbloquean con contraseñas que haya guardado de antemano, y el procesamiento se puede configurar para leer solo archivos adjuntos, solo el cuerpo del correo, o ambos. Esa última opción es importante porque algunos proveedores pegan los datos de la factura directamente en el texto del mensaje sin ningún archivo adjunto (opciones de análisis de correo).
Cuando los documentos deben provenir de otras personas y no de su propia bandeja de entrada, un Enlace de recopilación es una dirección compartible que permite a un proveedor, cliente o trabajador de campo subir archivos después de ingresar un código corto, sin necesidad de cuenta. Los archivos llegan a la misma cola de procesamiento, lo que significa que una canalización de documentos puede comenzar desde tres puntos de captura diferentes y aun así producir una sola forma de fila, la misma arquitectura descrita en la descripción general de la canalización de extracción de documentos.
Lo que todavía necesita a un humano
Una canalización que extrae documentos y escribe registros en el CRM no es lo mismo que una canalización que escribe registros correctos, y la diferencia reside en algunas decisiones que la automatización no debería tomar sola.
La Deduplicación es una política, no un ajuste. Decida el identificador único antes de que llegue la primera fila: correo electrónico para contactos y dominio de empresa para compañías, y use una acción que actualice en lugar de crear. Una canalización sin ese paso creará fielmente una segunda Jane Smith la segunda vez que Jane envíe un correo.
Las filas de alto valor o ambiguas merecen una revisión. Un contrato con términos inusuales, o una factura por encima de un umbral, es barato de revisar antes de que llegue a la canalización y costoso de corregir después. La escritura a mano cae en la misma categoría: los documentos impresos se extraen con muy alta precisión, pero una firma apresurada o una foto de identificación es exactamente donde una suposición de IA merece una segunda mirada.
No todos los documentos son una Oportunidad. La decisión de objeto mencionada arriba es el lugar más común donde una canalización bien construida degrada silenciosamente el CRM, al inundar la canalización de ventas con estados de cuenta recurrentes que nunca pertenecieron allí.
El consentimiento es separado de los datos. Registrar un contacto en HubSpot no otorga permiso para enviarle correos o mensajes de texto. El correo de marketing y los mensajes de texto automatizados tienen sus propias reglas, y la capa de extracción deliberadamente no tiene opinión sobre ellas.
Preguntas frecuentes
¿HubSpot analiza de forma nativa los datos de correos electrónicos o PDF en propiedades personalizadas?
No. La IA integrada de HubSpot puede completar una breve lista de propiedades básicas de contacto a partir de una firma de correo electrónico o un número de teléfono en el cuerpo, y no creará contactos ni leerá una factura, una orden de compra o un contrato en propiedades personalizadas. Convertir el contenido de un documento en propiedades requiere un paso de extracción previo y, a continuación, una importación de archivos, un conector sin código o una llamada a la API.
¿Pueden los datos extraídos ir directamente a HubSpot o tienen que ser un CSV?
Ambas opciones funcionan. La ruta de importación de archivos utiliza un CSV o XLSX. La ruta directa envía JSON a la API de CRM de HubSpot y requiere un desarrollador; el endpoint de upsert de contactos gestiona la deduplicación por correo electrónico en el servidor. Los conectores sin código se sitúan en medio y son la opción habitual para equipos sin soporte de ingeniería.
¿Cómo evito que el pipeline cree contactos duplicados?
Utilice una acción de crear o actualizar y establezca la dirección de correo electrónico como identificador único. En una importación de archivos, asigne la columna Email al identificador único del contacto para que HubSpot coincida con los registros existentes en lugar de añadir otros nuevos. Para las empresas, el identificador equivalente es el nombre de dominio de la empresa.
¿Puede leer tanto el cuerpo del correo electrónico como el archivo adjunto?
Sí. El procesamiento puede configurarse para leer solo los archivos adjuntos, solo el cuerpo del correo electrónico o ambos juntos. Esto cubre la combinación realista en la que algunos remitentes adjuntan un PDF y otros escriben los detalles directamente en el mensaje.
¿Esto requiere un desarrollador?
No para las rutas de importación o sin código. Solo se necesita un desarrollador para la ruta directa de la API, y esa ruta se elige normalmente para volúmenes más altos o cuando los mismos datos extraídos también alimentan otro sistema interno.
La pieza que toda guía de integración de HubSpot omite es que el problema de mapeo se resuelve en el momento en que nombra sus columnas de extracción con las mismas propiedades de HubSpot. Hágalo, y el Zap, la importación o la llamada a la API se convierten en un paso directo en lugar de un trabajo de traducción.
Una vez que las columnas coinciden con los objetos de HubSpot, el pipeline tiene una variable restante: el volumen y la variedad de documentos que llegan cada semana. Comience con el punto de captura que ya existe en su bandeja de entrada, defina el puñado de columnas que HubSpot realmente consume y deje que el conector haga el resto. Pruébelo con uno de sus propios correos electrónicos de clientes potenciales o facturas y vea qué columnas devuelve.