誤って抽出された数値の修正方法:
今日診断できる3つの根本原因
AI抽出で請求書の合計が$200ずれてしまう場合、問題はAIにあることはほとんどありません。これらのエラーのほとんどは、フィールド設計のミスに起因します。つまり、依頼した列の名前と定義の仕方です。その部分はあなたがコントロールでき、診断には数分しかかかりません。
重要なポイント
- 抽出された請求書の合計が$200ずれている場合、最初の直感は「AIは数字が苦手だ」ですが、このエラーには3つの独立した根本原因があり、どれもランダムなノイズではありません。
- 「Total」という名前の列は、1枚の請求書にある5つの異なる金額(Subtotal、Tax、Grand Total、Discount、Shipping)に対応するため、モデルはどれを意味しているのか推測しなければなりません。
- 「Total」を「Grand Total After Tax」に名前変更し、3つの検証ルール(数値のみチェック、範囲チェック、計算チェック)を追加します。ほとんどの誤った数値エラーは、会計システムに到達する前に表面化し、計算チェックはスプレッドシートではなく抽出中に実行できます。
AIは数字が苦手なわけではない——原因はフィールド名にある
AI抽出を扱うほとんどの人が一度は遭遇する状況があります。明確に読み取れる請求書をアップロードし、ツールがすべてのフィールドを自信を持って返し、そして気づくのです。「Total」列が$1,247.30を表示しているのに、実際の請求書の合計は$1,447.30だと。小計、税、明細項目はすべて正しい。しかし、最も重要な数字が$200ずれているのです。
誤った抽出合計はめったにランダムではありません。予測可能なパターンに従うため、ツールを切り替えずに診断して修正できることがほとんどです。当社が処理するドキュメント全体で、同じ3つの原因がほぼすべての誤った数字を占めています。
その影響は後工程に及びます。すでに転記された誤った合計は、修正に数分かかり、自動化プロセスが節約した以上にクリーンアップ作業を生み出すことになります。ただし、修正に別のAIエンジンが必要になることはほとんどありません。必要なのは、エラーが3つの根本原因カテゴリのどれに属するかを知ることです。
カスタム列抽出は、この診断の基盤となるメカニズムです。抽出したいフィールド名を入力すると、AIはラベルの意味を理解してページ上の一致する値を探し出します。位置ではなく意味を理解するのです。だからこそ、フィールド設計の重みが大きいのです。AIは指定した正確なラベルに基づいて動作し、正確なラベルがあれば誤った数字を選ぶ余地がほとんどなくなります。以下の3つの根本原因カテゴリは、ほぼすべての誤った数字エラーを説明し、それぞれに独自の診断テストがあります。
根本原因1:曖昧なフィールド設計——「Total」は十分に具体的ではない
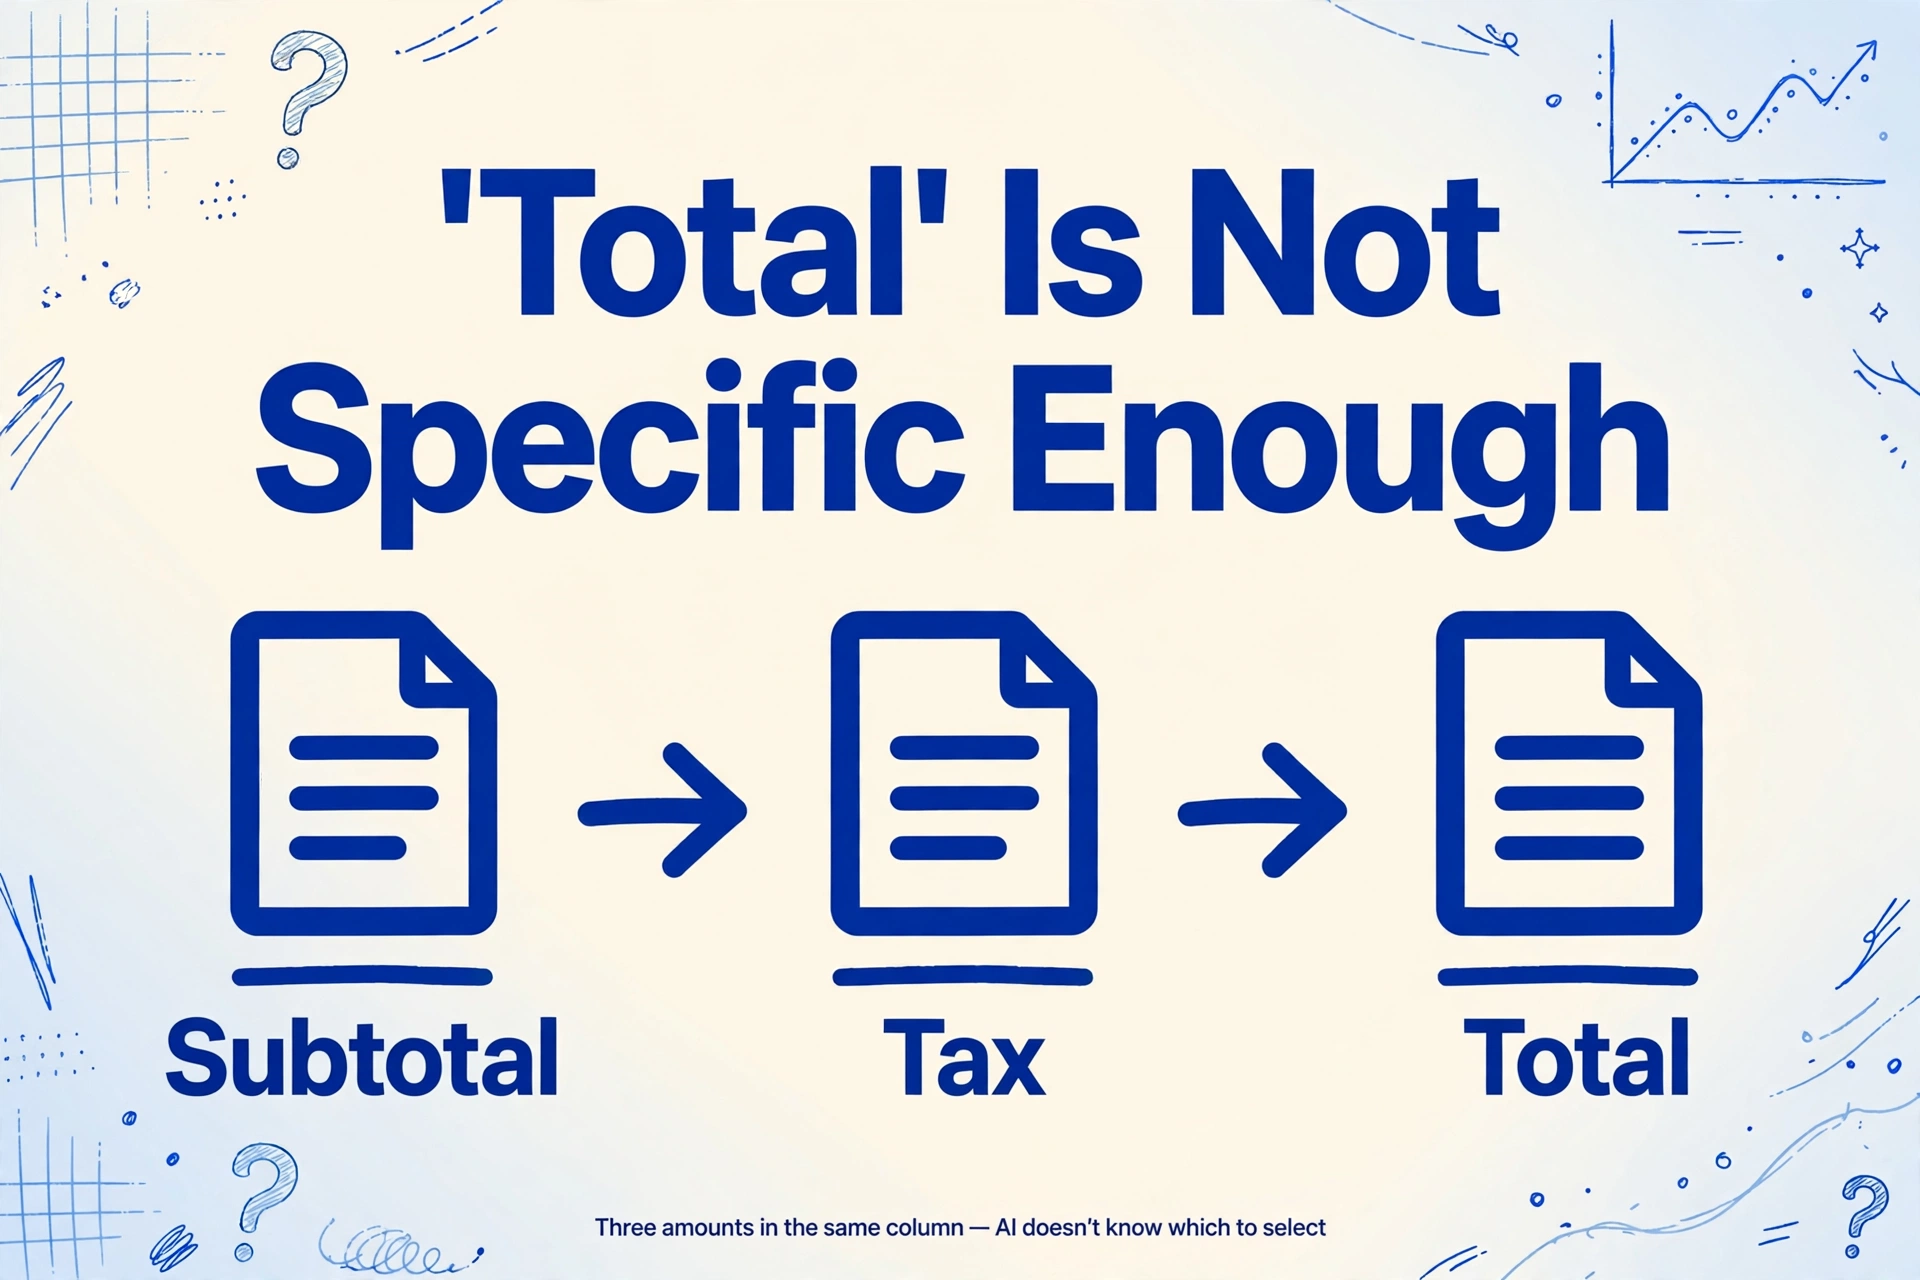
症状: 抽出された合計が期待した合計ではありません。小計の場合もあります。気づかなかった割引後の金額の場合もあります。税込み合計で、正味額が欲しかった場合もあります。ただし、数字自体は読み取れて請求書に記載されています——複数の利用可能な金額のうち、間違ったものを選んだだけです。
発生理由: 一般的な請求書の合計セクションには、Subtotal、Tax(またはVAT/GST)、Totalという少なくとも3つの金額フィールドが縦に積み重なっています。多くの請求書には、Discount、Shipping、Previous Balanceフィールドも同じ列に含まれています。抽出列を「Total」と名付けた場合、AIはこれらの金額のどれを意味するのか推測する必要があります。「Total」という単語はドキュメント上の有効なフィールドラベルですが、「Subtotal」にも含まれる単語であり、「Tax」や「Shipping」が配置されている領域でもあります。AIはどの合計を重視するかについてのネイティブな知識を持っていません——指定したラベルを読み取り、ページ上の最適な意味的マッチを見つけるのです。1つのラベルが5つの可能な値に対応する場合、エラー率は上がります。
これは特定のAIエンジンに限った制限ではありません。ビジョン言語モデルが曖昧な列リクエストを処理するときの内部の動きは次のとおりです。列定義で「Total」という単語を見て、合計セクションをスキャンし、すべてがもっともらしく一致する3つまたは4つの数字を見つけます——小計は税の1行上、総計は1行下にあります——そして最も強い意味的・位置的なシグナルを持つものを選びます。ほとんどの請求書では、これで問題なく機能します。小計と合計のフォントサイズが近く、1行の空白のみで区切られている請求書では、モデルの両オプションに対する信頼度はほぼ等しくなることがあります。結果は、出力上で自信満々の誤った回答のように見えるコイントスです。
修正方法:抽出したい金額を具体的に指定します。「Total」という列名ではなく、次のいずれかを使用してください:
- "Total Amount Due":曖昧さがなく、ほとんどの請求書で最終支払い額として表示される
- "Grand Total (after tax)":接尾辞がAIにすべての加算後の最終金額であることを伝える
- "Subtotal (before tax)":税込みの値が含まれないことを明示する
- "Amount Paid" / "Balance Due":明細書で支払済み金額と未払い金額を区別する
列名が具体的であればあるほど、AIが選択する候補が少なくなります。これは回避策ではなく、抽出が本来意図された動作です。現代のAIが請求書フィールドを位置ではなく意味で区別する方法では、ラベルの具体性がフィールドレベルの抽出精度を直接制御する理由を説明しています。
これが問題かどうかをテストするには:請求書を抽出出力と並べて確認します。AIが「Total」に対して返した値と、ドキュメント上で一致する値を見つけます。それらが同じでも、その値が小計や税込み合計である場合は、曖昧さの問題があります。修正にはより具体的な列名を付けるだけでコストはかかりません。列名が正しくなれば、特定の請求書フィールドをExcelに抽出するが次のステップです。
根本原因2:文字の混同 — 5がSになり、0がOになる場合
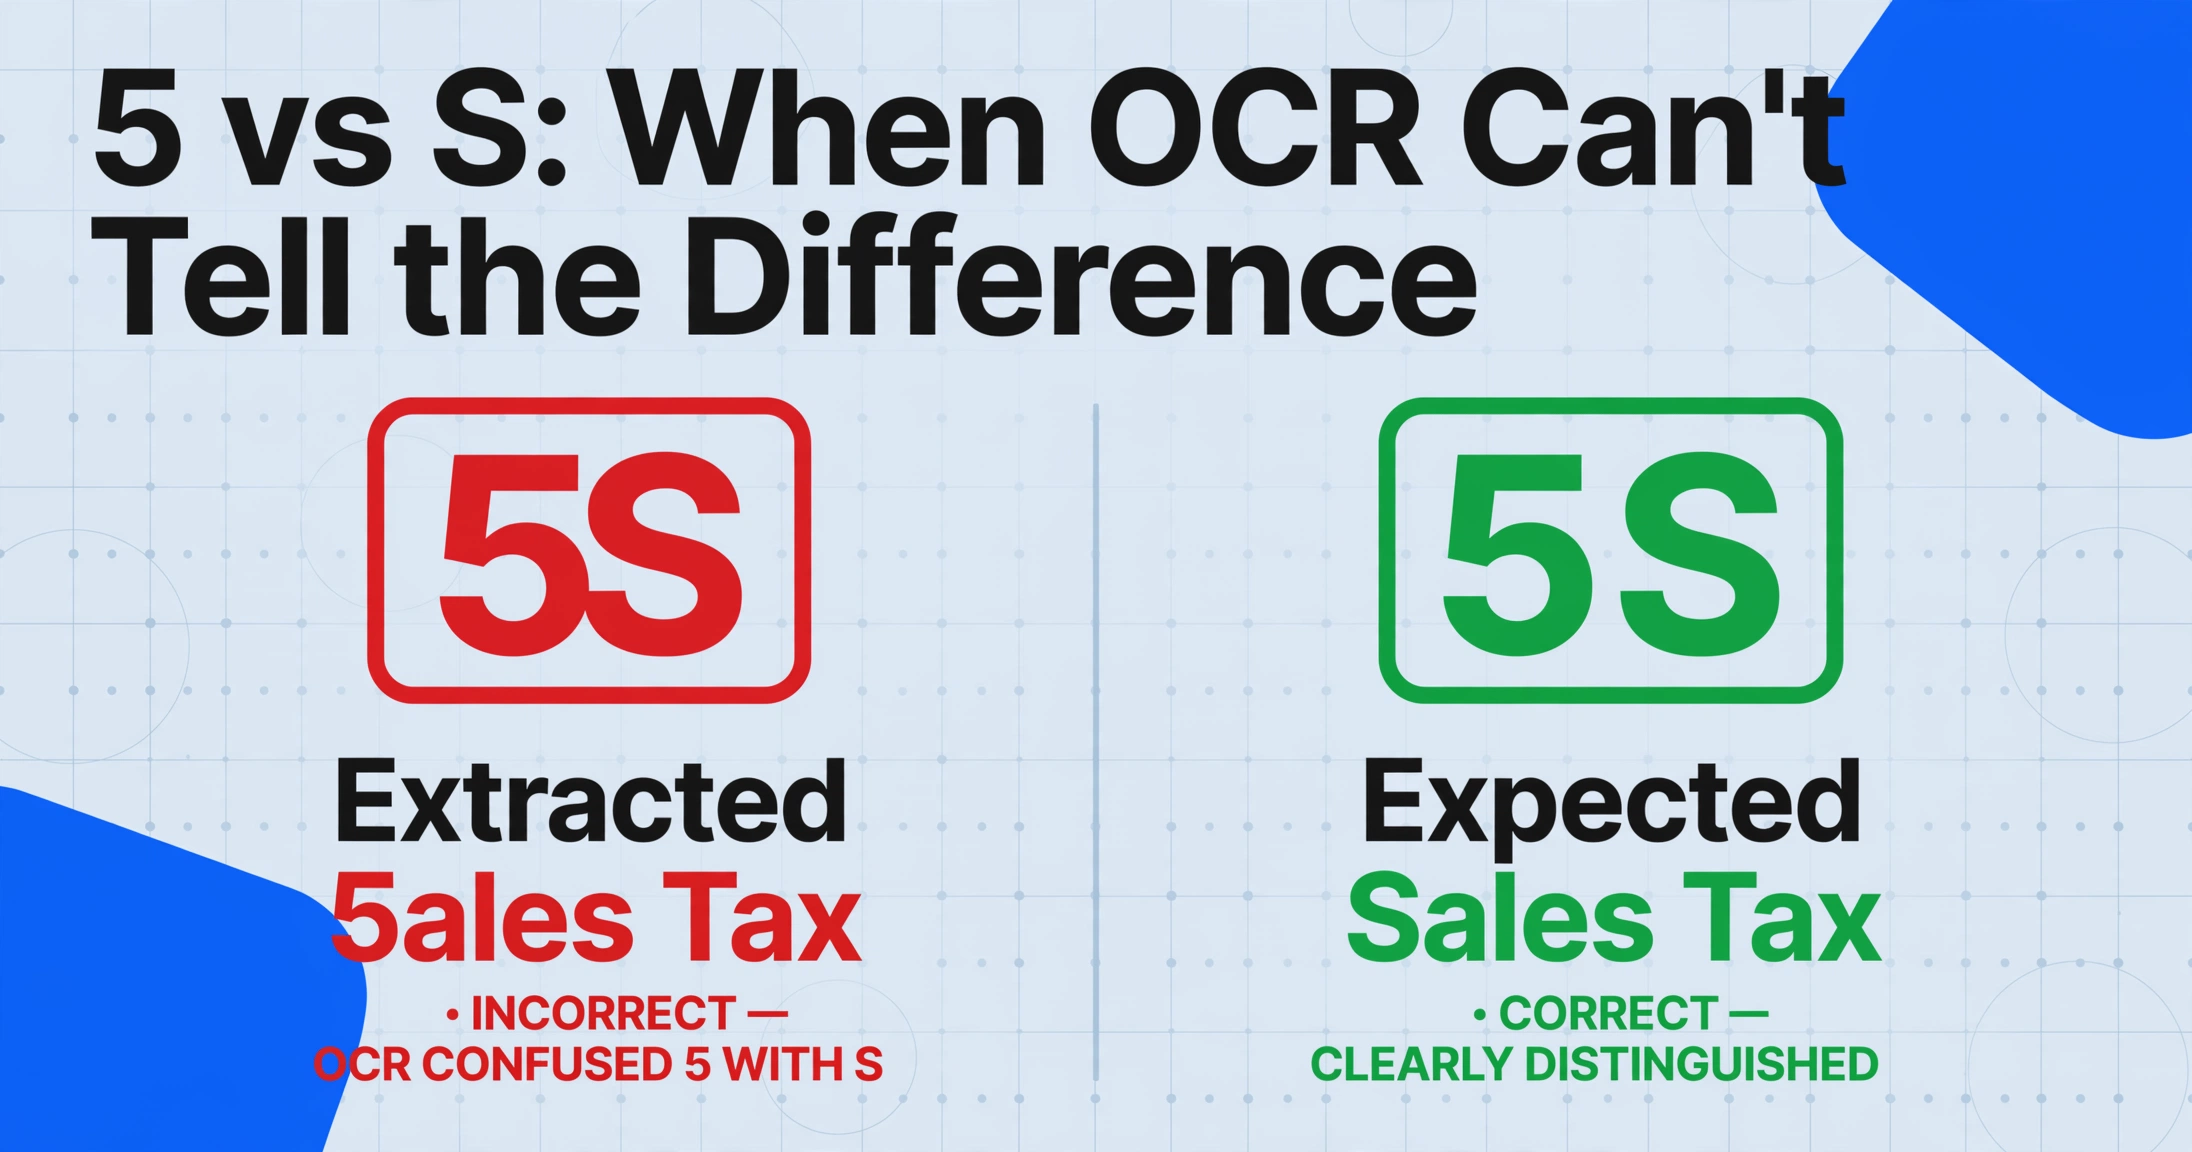
症状:抽出出力の数字に、数字であるべき場所に文字が含まれている —「5」が「S」として、「0」が「O」として、「1」が「l」または「7」として抽出される。エラーは同じソースからの類似ドキュメント間で一貫して発生します。数字は1〜2桁間違っていますが、桁の大きさはおおよそ正しく見えます。
発生理由:OCRエンジンとビジョンモデルはどちらも文字のピクセル形状を分析します。一般的なフォントサイズとスキャン解像度では、ほぼ同一の視覚プロファイルを共有する文字ペアがいくつかあります:
| ペア | OCRが混同する理由 |
|---|---|
| 5 / S | 小さなフォントや低コントラストのスキャンでは、上部と下部の曲線がほぼ同一に見える |
| 0 / O | 両方とも円形または楕円形に見える。ゼロのスラッシュはフォントで欠落していることが多い |
| 1 / l / 7 | 細い縦線が低解像度で同じ視覚プロファイルに潰れる |
| 8 / B | スキャンが少しぼやけると内部ループが視覚的に類似する |
| 6 / G | Gの尾部と6のループは小さいサイズではほぼ区別できない |
これは優れたAIでも完全に排除できる問題ではありません。最先端のビジョンモデルでも、圧縮アーティファクトのある9ピクセルの高さで文字が表示されると、「5」と「S」に対してほぼ同じ信頼度を持ちます。 人間の脳は単語レベルの文脈を使ってこれらの曖昧さを解決します — 「5ales Tax」が間違っているのは「Sales Tax」が既知の用語だからだとわかります。OCRエンジンは、特定のフィールドで辞書単語を期待するように特別にトレーニングされていない限り、そのような単語レベルの知識を持ちません。
修正方法:文字の混同は抽出中ではなく、抽出後に検出するのが最適です。抽出値を期待パターンに対してチェックするフィールドレベルの検証ルールを実装します:
- 数字のみのフィールド: フィールドに数字のみが含まれるべき場合(請求書番号、注文番号、勘定科目コード)、シンプルな正規表現チェックを実行します。数字のみのフィールドで数字以外の抽出文字があれば、ほぼ確実に誤読です。そのコンテキストでは「S」を「5」に、「O」を「0」に、「l」を「1」に置き換えます。
- 範囲チェック: 抽出された合計が$5,000.00である一方、そのベンダーの他の請求書がすべて$200〜$800の範囲内である場合、レビュー用にフラグを立てます。単一の外れ値は、小数点の位置の誤りや、文字の誤読によって値が桁違いに膨らんだ結果であることがよくあります。
- クロスフィールドの計算検証: 小計 + 税 = 合計を確認します。許容範囲内で計算が一致しない場合、3つの数字のうち少なくとも1つに文字レベルのエラーが含まれています。この単一のチェックで、文字の混同エラーの大半を検出できます。3つの合計のいずれかで数字を誤読すると、算術的な関係が崩れるためです。
ImageToTable.aiのインテリジェントなデータ後処理がこのフォーマットの半分を自動的に処理し、日付、金額、シリアル番号を標準化して、一貫した形式で値を届けます。計算の半分はスプレッドシートではなく抽出中に実行できます。列名で計算を説明します。例: "税チェック" — ImageToTable.aiがドキュメント読み取り中にそれを実行し、合格、不合格、または差を出力します。小計 + 税 が印刷された合計と等しくない場合、その不一致は、自分で作成する必要がある数式ではなく、それが属する行の値として届きます。
根本原因3: フォーマットの差異 — 1.234,56 と 1,234.56
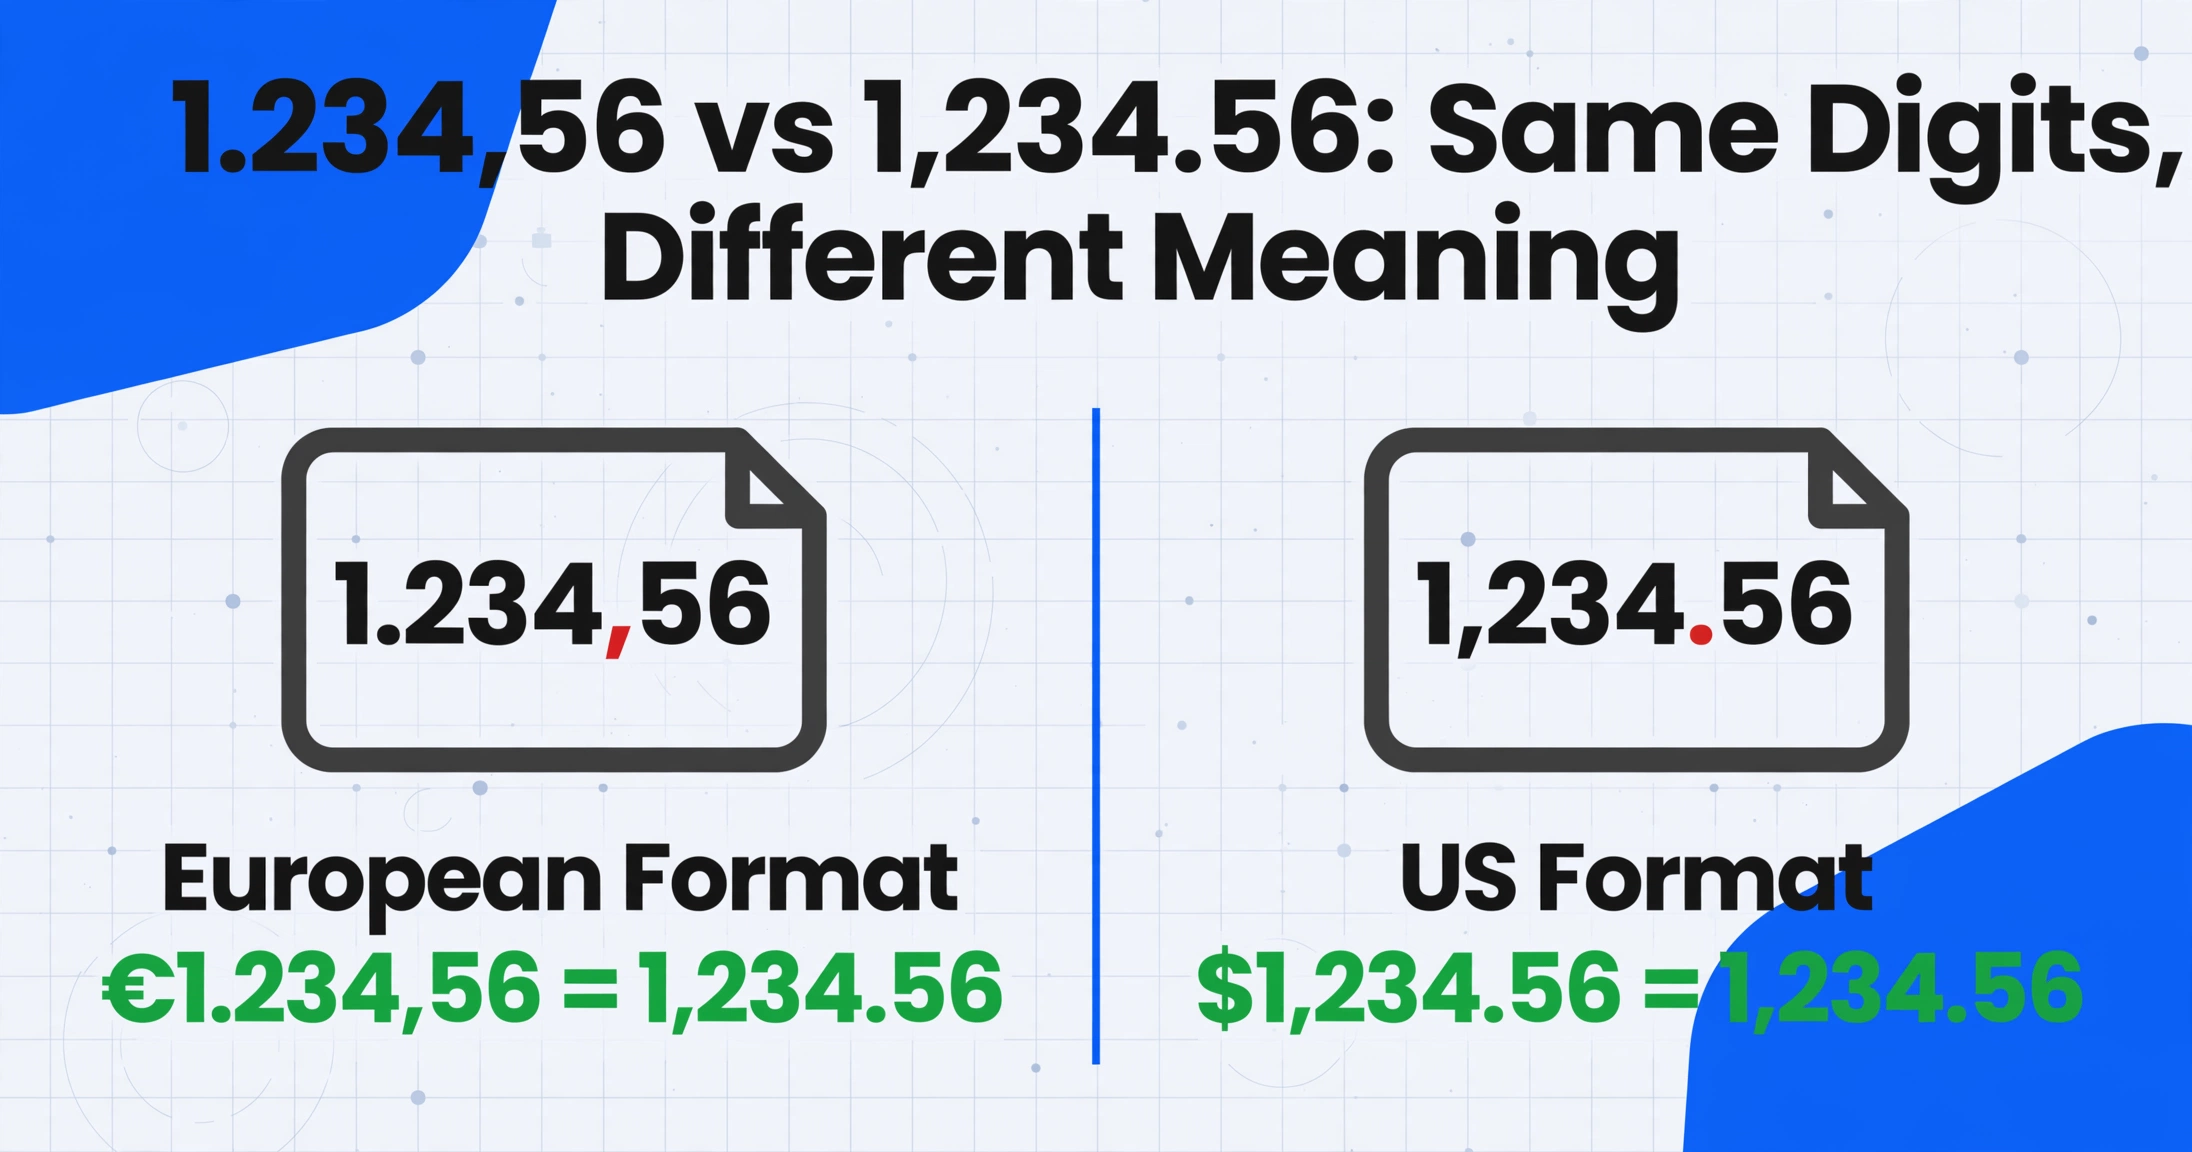
症状: 抽出された数値が3桁ずれます。ヨーロッパの請求書の€1.234,56という合計が1.234として抽出されたり、さらに悪い場合、1,234.56(ヨーロッパの表記では1234と56/100を意味します)として抽出されたりします。日付も影響を受けます。03/04/2026は、請求書が明らかに4月3日を意図しているのに、米国のシステムでは3月4日と読まれます。
なぜ起こるのか: ヨーロッパ大陸の大部分、南米の大部分、そしてアフリカとアジアの一部では、小数点区切りにカンマ、桁区切りにピリオドを使用します。一方、米国、英国、およびその他いくつかの国ではこの規則が逆です。ドイツの請求書(€1.234,56)と米国の請求書($1,234.56)を同じバッチで処理するAI抽出エンジンは、構造的に同一に見えるが、意味が完全に異なる2つの数値を目にします。
ここが微妙な点です: AIは、ドキュメントがどの規則に従っているかを、指定しない限り知りません。視覚的なパターン(2つの区切り文字を持つ数値)は同じだからです。モデルは「1.234,56」を見ても、ピリオドが桁区切り(ヨーロッパ式)なのか、小数点(いくつかの形式では珍しいが可能)なのかを本質的に判断する方法がありません。
修正方法: 抽出後の検証ルールが、フォーマットの差異に対して実際の作業を行います。なぜなら、AIの視覚的理解では、視覚的ではなく文化的な曖昧さを解決できないからです。
- 文書ソースごとに小数点区切りルールを設定する。ドイツの仕入先からの請求書を処理する場合、その文書グループに対してカンマを小数点区切りとして定義します。ImageToTable.aiのデータ後処理は、日付・金額・シリアル番号の形式を出力の一部として標準化するため、エクスポートされる値は設定した規則に従います。
- 範囲ベースの整合性チェックを適用する。抽出された「Total」が1.234(ヨーロッパ形式では1,234)なのに、明細項目の合計が約1.234,56(1,234と56セント)の場合、AIが小数点部分を誤って処理した可能性が高いです。抽出された合計を明細項目の合計と比較する範囲チェックで、これを即座に検出できます。
- 数学的な整合性チェックを使用する。根本原因2と同じく、小計+税=合計です。小数点区切りが誤って解釈された場合、計算が一致しないため、エラーが伝播する前に形式を再確認する必要があるとわかります。
より強力なOCRエンジンではこの問題は解決しません。曖昧さは視覚的ではなく文化的なものだからです。有効なのは、値が次の処理に進む前に、解析された数値を文書の他の部分と照合する検証レイヤーです。
エスカレーションのタイミング:優れたツールでも解決できないエッジケース
ここで正直になる必要があります。すべての誤った数値エラーにフィールド名レベルの修正があるわけではありません。最も具体的な列名と最も徹底した後処理を備えた最高のAI抽出でも、誤った出力が頻繁に発生する状況が2つあります。
状況1:同一書式の隣接する合計行。請求書に「Subtotal」「Discount」「Tax」「Total」が同じ右寄せ列に、同じフォントサイズ・同じフォントウェイトで、視覚的な区切りなしに並んでいる場合、どのAIエンジンでも真の曖昧さの問題が発生します。モデルがフィールドを識別するために使用するシグナル(フォントサイズ、空白、ラベルの位置など)が弱いか矛盾しています。この場合の実用的なアプローチは、4つの値すべてを抽出し(各列を定義)、期待される関係に基づいてダウンストリームのスプレッドシートでどれがどれかを解決することです。合計は最大の数値、小計は2番目に大きい数値、割引は最小の数値であるべきです。
状況2:単一文書内での小数点規則の不一致。一部の請求書では形式が混在しており、あるセクションではピリオドを小数点区切りとして使用し、別のセクションではカンマを使用しています。これは稀ですが存在し、複数の地域テンプレートから文書レイアウトが組み立てられた国境を越えた請求書で典型的に見られます。このような場合、文書全体に適用できる単一の形式規則はありません。解決策は、形式の混在が見られるフィールドの手動レビューと、明細項目と合計が異なる区切りパターンを使用している場合に警告するフラグ規則を組み合わせることです。
どちらのエッジケースでも、ツールを非難しても意味がありません。ソース文書自体に、自動化システムなら誰でも苦労する曖昧さが含まれているため、作業はその周りに検証ワークフローを設計することに移ります。
よくある質問
抽出されたTotalが間違っている場合、AIがランダムなエラーを起こしたと考えるべきですか?
いいえ。数値フィールドの抽出エラーには予測可能なパターンがあります。まず列名の具体性を確認してください。「Total」はほとんどの請求書で曖昧です。正しい数字がドキュメント上に存在するのにAIが返した数字と一致しない場合、根本原因はほぼ確実にフィールドの曖昧さ(根本原因1)です。数字自体に予期しない文字(数字があるべき場所に文字)が含まれている場合は、文字の混同(根本原因2)です。桁が約1,000倍ずれている場合は、小数点区切りの問題(根本原因3)です。それぞれ修正方法は異なりますが、どれもランダムなノイズとして扱うべきではありません。
常に総額を取得したい場合、同じ列名「Total」を使用してもよいですか?
使用できますが、Totalが曖昧な請求書では誤った結果になります。「Total」はドキュメント抽出で最も過負荷なフィールド名です。「Total Amount Due」や「Grand Total (after tax)」という列名にすれば、追加の作業なしで曖昧さが解消されます。AIは列名を主要な検索シグナルとして使用するため、シグナルが具体的であればあるほど、解釈の余地が減ります。
より高性能なAIハードウェアで5/Sや0/Oの文字の混同は解消されますか?
いいえ。文字の混同は根本的な視覚的曖昧さであり、ハードウェアの限界ではありません。最先端のビジョンモデルも基本的なOCRエンジンも、圧縮スキャン上で文字の高さが9ピクセルの場合、同じ5/Sの曖昧さに直面します。修正方法は抽出後の検証です。数値のみのフィールドに数字だけが含まれているか確認し、範囲チェックを適用し、クロスフィールド計算で不整合な値を検出してください。より強力なモデルに交換しても効果はなく、誤った値をより高い確信度で返すことで状況を悪化させる可能性があります。
ヨーロッパの請求書に€1.234,56とあるのに、抽出結果が1.234になるのはなぜですか?
AIが米国式の慣習に従い、ピリオドを小数点、カンマを桁区切りとして解釈した可能性が高く、小数部分が完全に切り捨てられました。ヨーロッパ形式の「1.234,56」は1,234と56/100を意味します。米国形式として読むと、ピリオドが小数点(値が1.234、つまり約1と4分の1)になり、カンマは桁区切りとなるため、4桁の数字では無視されます。バッチをヨーロッパの小数点形式に設定し、カンマが小数点区切りであることをシステムに指定してから再実行してください。
すべての抽出に手動レビューを追加すべきですか、それとも数字が疑わしい場合だけですか?
対象を絞ったレビューが、全体的なレビューよりも優れています。各バッチに3つのルールを適用してください:(1) 定義された範囲外にある抽出された合計にフラグを立てる(例:ベンダーの過去平均から3標準偏差以上)、(2) 小計 + 税 ≠ 合計が小さな許容差(例:$0.50)を超えて異なるバッチにフラグを立てる、(3) 数字のみのフィールドに数字以外の文字が含まれる場合にフラグを立てる。この3つのルールで、間違った数字のエラーの大部分を、すべての行を検査することなく捕捉できます。フラグが立てられた項目のみに手動レビューを行うことで、スループットを高く保ちながら、重要なエラーを捕捉できます。
Custom Column Extractionは、テンプレートベースのツールと比べて、曖昧なフィールド名をどのように処理しますか?
Custom Column Extractionは、各列名を位置ベースのルールではなく、意味検索クエリとして扱います。「Total Amount Due」と入力すると、AIはドキュメント全体を検索して、その特定の意味、つまりすべての加算と控除後の最終支払額に一致する値を探します。対照的に、テンプレートベースのツールは、ページ上の事前に記録された座標ゾーンを調べます。座標ゾーンのアプローチは、合計が移動しない場合にうまく機能します。Custom Column Extractionは、合計が移動してもその意味が変わらない場合にうまく機能します。
同じバッチに、異なる数値形式の米国と欧州のサプライヤーからの請求書を含めることはできますか?
可能ですが、形式のばらつきを後段で処理する必要があります。AIはページ上に表示されているとおりに数字を抽出し、バッチ内の形式規則を自動的に正規化しません。混合形式のバッチでは、実用的なアプローチは、米国と欧州のドキュメントを別々に処理し、各グループに一致する形式ルールを適用するか、値が会計システムに到達する前に後処理ステップで区切り記号を正規化することです。抽出ツールが直面する文字や文字の障害の種類について詳しくは、OCRが手書き文字に苦戦する理由とその修正方法に関する関連記事をご覧ください。
間違った抽出数字はイライラさせられますが、ほとんどランダムではありません。これらは、曖昧なフィールド名、文字の混同、形式のばらつきという3つの予測可能なカテゴリのいずれかに分類されます。最初に確認すべきはフィールド設計であり、各カテゴリにはツールの切り替えやモデルの再トレーニングを必要としない特定の修正方法があります。次に合計が間違って返ってきたときは、「なぜAIは数字が苦手なのか」と尋ねないでください。「これは3つの根本原因のどれで、最も安価な修正は何か」と尋ねてください。答えは通常、より具体的な列名か単一の検証ルールであり、どちらも数秒の思考以上のコストはかかりません。
自分のドキュメントでこのアプローチをテストしてください。間違った数字のエラーを引き起こしたことがわかっている請求書をアップロードし、「Total」の代わりに「Grand Total After Tax」を使用して、最大限の具体性で列を定義し、結果が変わるかどうかを確認してください。自分のドキュメントで抽出を試して、ドキュメントあたり3分が10秒になるかどうかを確認してください。