So beheben Sie falsch extrahierte Zahlen:
3 Ursachen, die Sie noch heute diagnostizieren können
Wenn Ihre KI-Extraktion die Rechnungssumme um $200 verfehlt, liegt das Problem selten an der KI. Die meisten dieser Fehler gehen auf Felddesign-Fehler zurück: darauf, wie die Spalten, die Sie angefragt haben, benannt und definiert wurden. Dieser Teil liegt in Ihrer Hand und lässt sich in wenigen Minuten diagnostizieren.
Die wichtigsten Erkenntnisse
- Wenn eine extrahierte Rechnungssumme um $200 danebenliegt, ist Ihr erster Gedanke „die KI kann nicht mit Zahlen umgehen“ – aber drei getrennte Ursachen führen zu diesem Fehler, und keine davon ist reines Rauschen.
- Eine Spalte mit dem Namen „Total“ verweist auf fünf verschiedene Beträge in einer einzigen Rechnung (Subtotal, Tax, Grand Total, Discount, Shipping), sodass das Modell raten muss, welchen Sie meinten.
- Benennen Sie „Total“ in „Grand Total After Tax“ um und fügen Sie drei Validierungsregeln hinzu (Nur-Zahlen-Prüfung, Bereichsprüfung, Rechenprüfung). Die meisten Fehler bei falschen Zahlen tauchen auf, bevor sie Ihr Buchhaltungssystem erreichen, und die Rechenprüfung kann bereits während der Extraktion laufen statt in Ihrer Tabellenkalkulation.
Die KI ist nicht schlecht in Mathe — Ihre Feldnamen sind das Problem
Hier ist eine Situation, die die meisten Menschen, die mit KI-Extraktion arbeiten, mindestens einmal erleben: Sie laden eine klar lesbare Rechnung hoch, das Tool liefert jedes Feld selbstbewusst zurück, und dann entdecken Sie es: Die Spalte „Total" zeigt $1.247,30, obwohl der tatsächliche Rechnungsbetrag $1.447,30 ist. Zwischensumme, Steuer, Positionen — alles sieht richtig aus. Aber genau die eine Zahl, die am wichtigsten ist, weicht um $200 ab.
Falsch extrahierte Summen sind selten Zufall. Sie folgen vorhersehbaren Mustern — deshalb können Sie die Ursache meist diagnostizieren und beheben, ohne das Tool zu wechseln. Bei den Dokumenten, die wir verarbeiten, sind dieselben drei Ursachen für fast jede falsche Zahl verantwortlich, die wir sehen.
Die Kosten schlagen sich downstream nieder. Eine falsche Summe, die bereits verbucht wurde, braucht Minuten, um sie nachzuverfolgen und zu korrigieren — und der automatisierte Prozess erzeugt am Ende mehr Bereinigungsaufwand, als er eingespart hat. Die Lösung erfordert allerdings selten eine andere KI-Engine. Sie erfordert zu wissen, zu welcher der drei Ursachenkategorien Ihr Fehler gehört.
Benutzerdefinierte Spaltenextraktion ist der Mechanismus, auf dem diese Diagnose beruht. Sie geben die Feldnamen ein, die Sie möchten, und die KI lokalisiert jeden passenden Wert überall auf der Seite, indem sie versteht, was das Label bedeutet, statt wo es steht. Genau deshalb hat das Felddesign so viel Gewicht: Die KI arbeitet mit dem exakten Label, das Sie ihr geben — und ein präzises Label lässt ihr wenig Spielraum, die falsche Zahl zu wählen. Die drei Ursachenkategorien unten erklären praktisch jeden Fehler bei falschen Zahlen, und jede hat ihren eigenen Diagnosetest.
Ursache 1: Mehrdeutiges Felddesign — „Total" ist nicht spezifisch genug
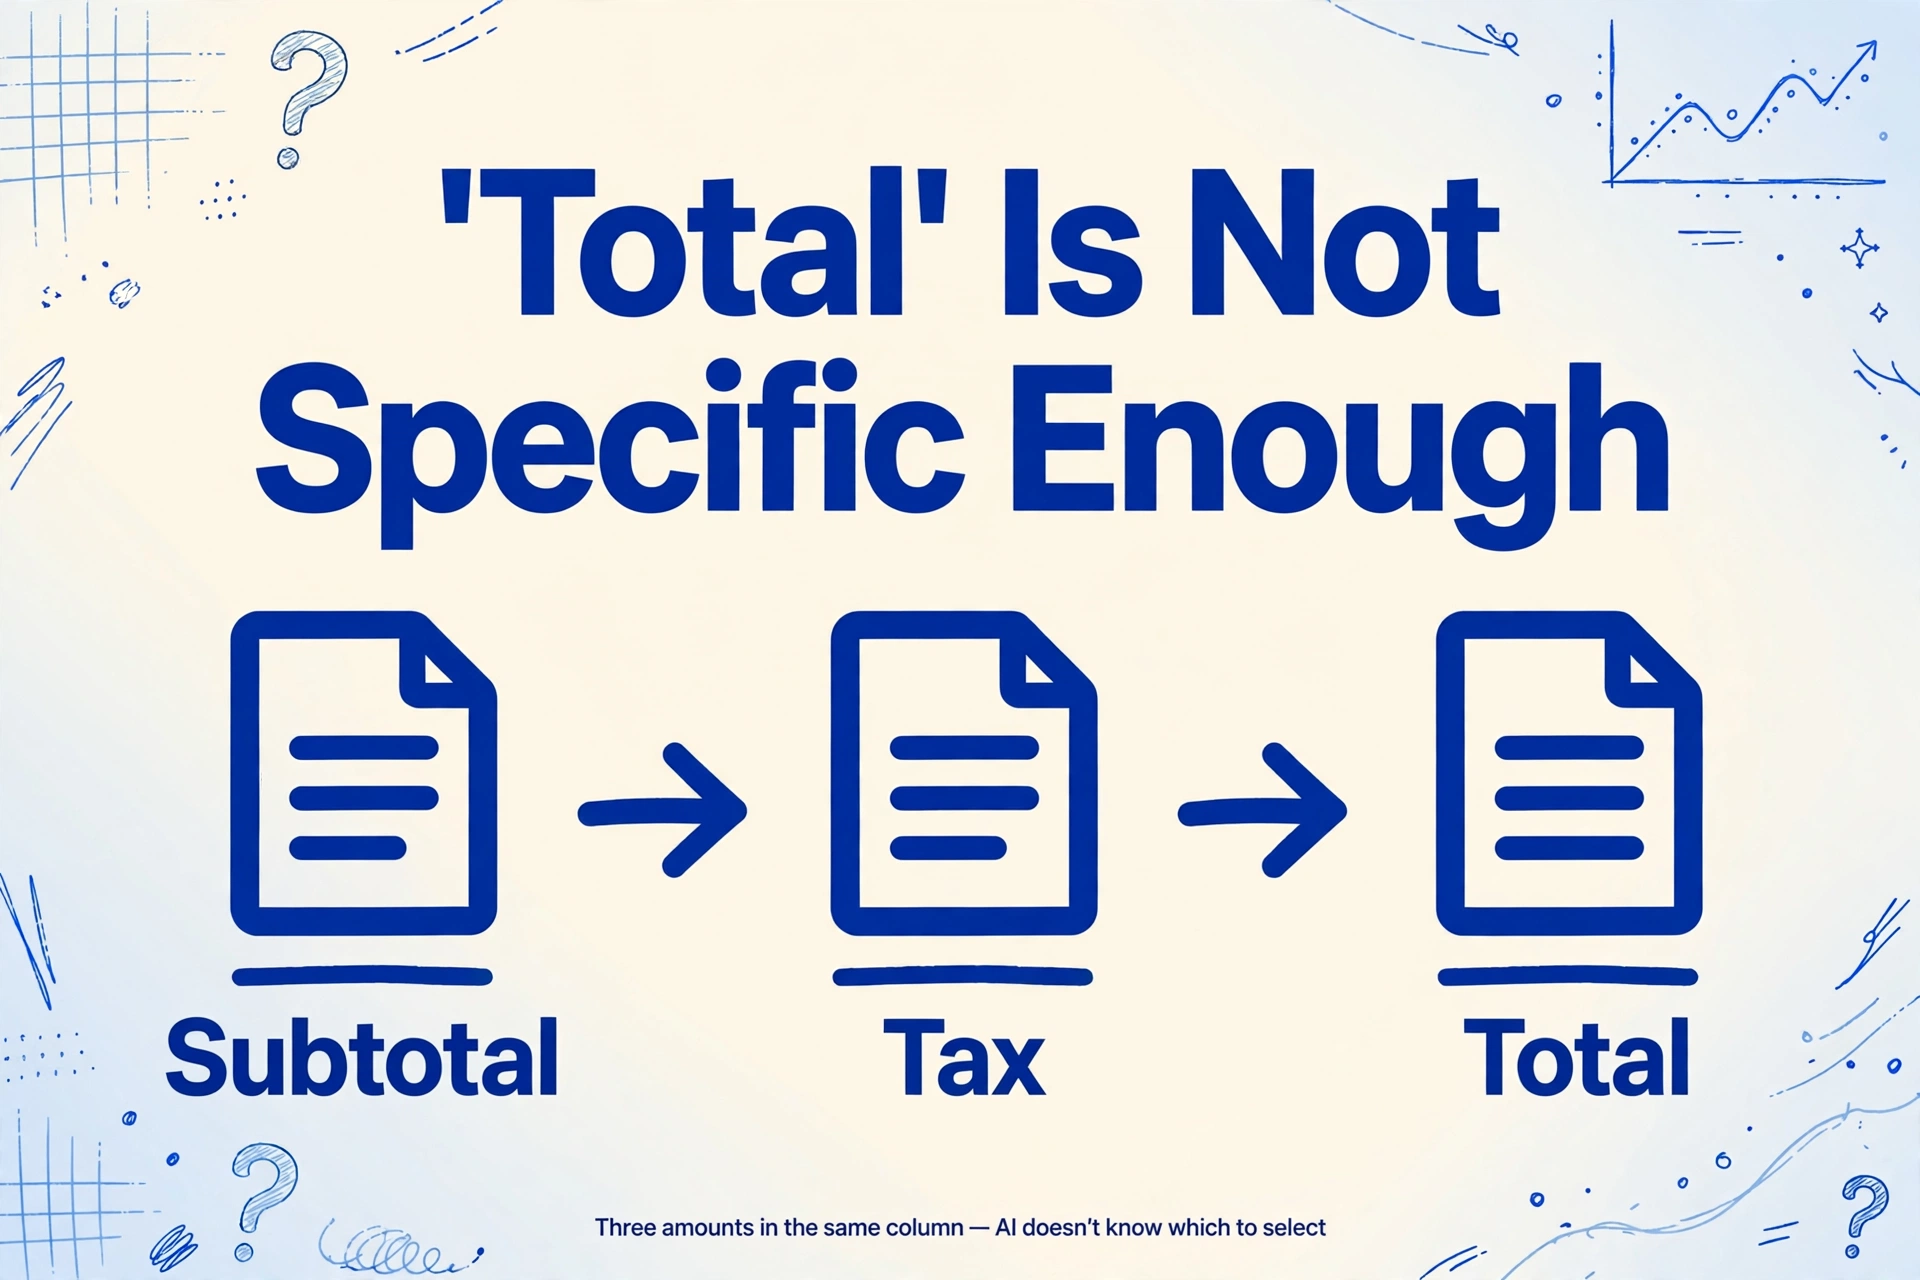
Symptome: Die extrahierte Summe ist nicht die Summe, die Sie erwarten. Es könnte die Zwischensumme sein. Es könnte der Betrag nach einem Rabatt sein, den Sie nicht bemerkt haben. Es könnte die inklusive Steuer berechnete Summe sein, wenn Sie den Nettobetrag wollten. Aber die Zahl selbst ist lesbar und erscheint auf der Rechnung — es ist nur die falsche von mehreren verfügbaren Beträgen.
Warum das passiert: Der Summenbereich einer typischen Rechnung enthält mindestens drei Geldbeträge, die vertikal gestapelt sind: Subtotal, Tax (oder VAT/GST) und Total. Viele Rechnungen enthalten außerdem Discount-, Shipping- oder Previous-Balance-Felder in derselben Spalte. Wenn Ihre Extraktionsspalte „Total" heißt, muss die KI raten, welchen dieser Beträge Sie meinen. Das Wort „Total" ist ein gültiges Feldlabel auf dem Dokument, aber es ist auch das Wort, das in „Subtotal" vorkommt, und der allgemeine Bereich, in dem auch „Tax" und „Shipping" stehen. Die KI hat kein angeborenes Wissen darüber, welche Summe Ihnen wichtig ist — sie liest das Label, das Sie ihr geben, und findet die beste semantische Übereinstimmung auf der Seite. Wenn ein Label auf fünf mögliche Werte passt, steigt die Fehlerquote.
Das ist keine Einschränkung, die nur einer bestimmten KI-Engine eigen ist. So läuft es in einem Vision-Language-Modell ab, wenn es eine mehrdeutige Spaltenanfrage verarbeitet: Es sieht das Wort „Total" in Ihrer Spaltendefinition, scannt den Summenbereich, findet drei oder vier Zahlen, die alle plausibel passen — die Zwischensumme sitzt eine Zeile über der Steuer, die Gesamtsumme eine Zeile darunter — und wählt die mit dem stärksten semantischen und positionsbezogenen Signal. Bei den meisten Rechnungen funktioniert das einwandfrei. Bei Rechnungen, auf denen Zwischensumme und Gesamtsumme in ähnlicher Schriftgröße und nur durch eine Leerzeile getrennt sind, kann die Konfidenz des Modells für beide Optionen nahezu gleich sein. Das Ergebnis ist ein Münzwurf, der in der Ausgabe wie eine selbstbewusste falsche Antwort aussieht.
So beheben Sie es: Geben Sie genau an, welchen Betrag Sie möchten. Verwenden Sie statt einer Spalte mit dem Namen „Total" eine der folgenden Optionen:
- „Total Amount Due": eindeutig, erscheint auf den meisten Rechnungen als endgültiger zu zahlender Betrag
- „Grand Total (nach Steuern)": das Suffix zeigt der KI, dass dies der endgültige Betrag nach allen Additionen ist
- „Subtotal (vor Steuern)": schließt steuerinklusive Werte ausdrücklich aus
- „Amount Paid" / „Balance Due": unterscheidet Zahlungen von offenen Beträgen auf Kontoauszügen
Je spezifischer Ihr Spaltenname ist, desto weniger Kandidaten hat die KI zur Auswahl. So soll die Extraktion funktionieren – das ist kein Workaround. Wie moderne KI Rechnungsfelder nach Bedeutung statt Position unterscheidet erklärt, warum die Spezifität von Bezeichnungen die Extraktionsgenauigkeit auf Feldebene direkt steuert.
Um zu testen, ob dies Ihr Problem ist: Betrachten Sie die Rechnung neben Ihrer Extraktionsausgabe. Finden Sie den Wert, den die KI für „Total" zurückgegeben hat, und den Wert im Dokument, der dazu passt. Wenn sie identisch sind, dieser Wert aber zufällig der Subtotal oder der steuerinklusive Gesamtbetrag ist, haben Sie ein Mehrdeutigkeitsproblem – und die Lösung kostet nichts außer einem spezifischeren Spaltennamen. Sobald die Namen stimmen, ist das Extrahieren spezifischer Rechnungsfelder in Excel der nächste Schritt.
Ursache 2: Zeichenverwechslung – wenn aus 5 ein S und aus 0 ein O wird
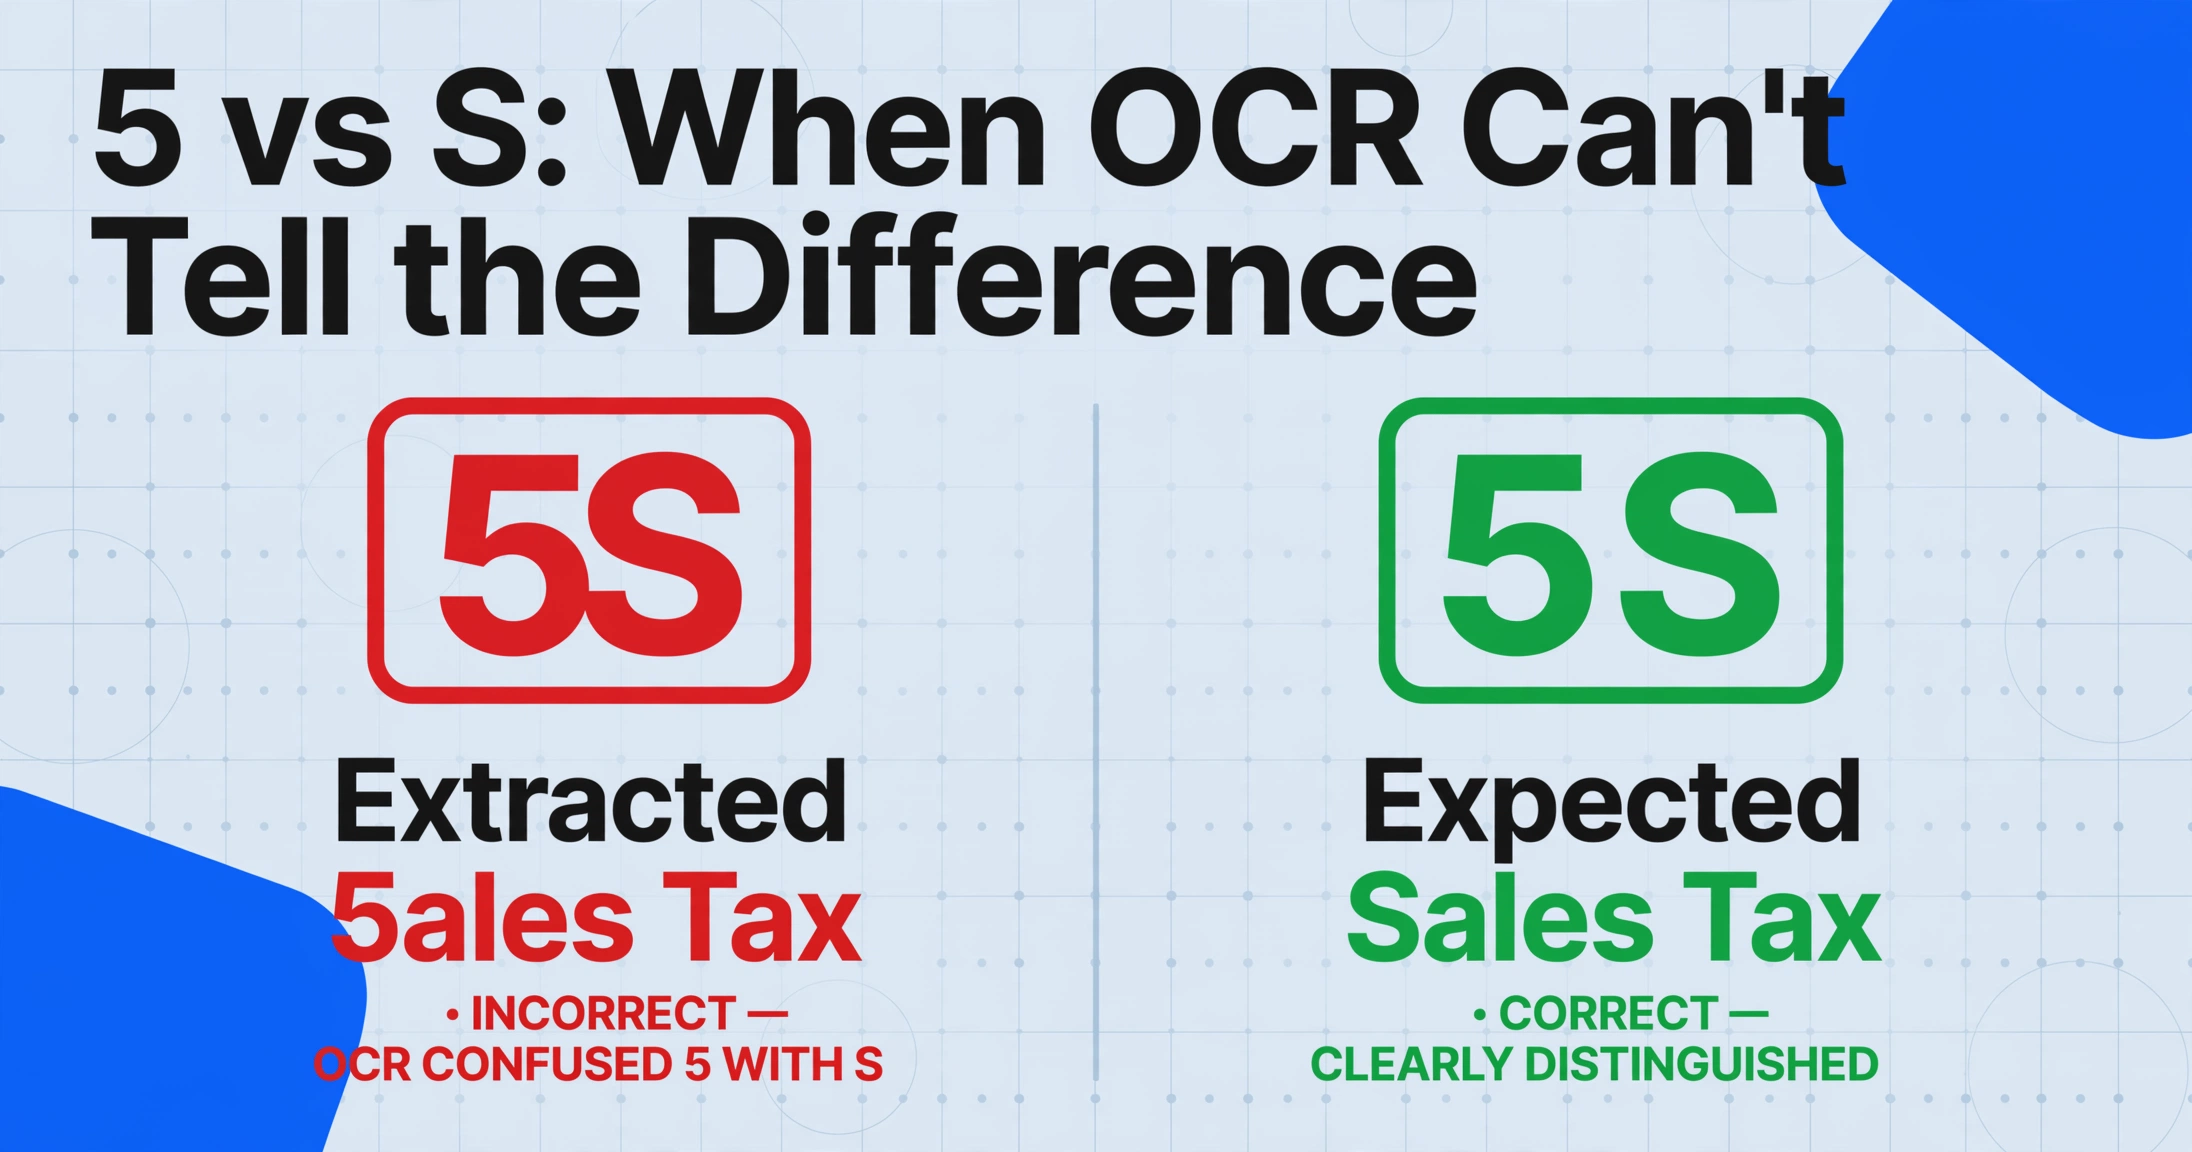
Symptome: Eine Zahl in der extrahierten Ausgabe enthält einen Buchstaben, wo eine Ziffer sein sollte – „5" als „S", „0" als „O", „1" als „l" oder „7" extrahiert. Der Fehler tritt konsistent bei ähnlichen Dokumenten aus derselben Quelle auf. Die Zahl ist an ein oder zwei Stellen falsch, aber die Größenordnung sieht ungefähr richtig aus.
Warum das passiert: OCR-Engines und Vision-Modelle analysieren beide die Pixelformen von Zeichen. Manche Zeichenpaare haben bei gängigen Schriftgrößen und Scan-Auflösungen nahezu identische visuelle Profile:
| Paar | Warum OCR sie verwechselt |
|---|---|
| 5 / S | Die geschwungene Ober- und Unterseite sehen bei kleinen Schriftgrößen oder kontrastarmen Scans nahezu identisch aus |
| 0 / O | Beide erscheinen als runde oder elliptische Form; der Schrägstrich durch die Null fehlt in Schriftarten oft |
| 1 / l / 7 | Dünne vertikale Striche verschmelzen bei niedriger Auflösung zu demselben visuellen Profil |
| 8 / B | Die inneren Schleifen sind visuell ähnlich, wenn der Scan leicht unscharf ist |
| 6 / G | Der Schwanz des G und die Schleife der 6 sind bei kleinen Größen kaum zu unterscheiden |
Das ist kein Problem, das bessere KI vollständig beseitigen kann. Selbst hochmoderne Vision-Modelle haben nahezu gleiche Konfidenz für „5" und „S", wenn das Zeichen 9 Pixel hoch ist und Komprimierungsartefakte aufweist. Das menschliche Gehirn löst diese Mehrdeutigkeiten mithilfe von Wortkontext auf – Sie wissen, dass „5ales Tax" falsch ist, weil „Sales Tax" ein bekannter Begriff ist. Eine OCR-Engine hat kein solches Wortwissen, es sei denn, sie wurde speziell darauf trainiert, Wörter aus dem Wörterbuch in bestimmten Feldern zu erwarten.
So beheben Sie es: Zeichenverwechslungen lassen sich am besten nach der Extraktion erkennen, nicht währenddessen. Implementieren Sie Validierungsregeln auf Feldebene, die den extrahierten Wert gegen erwartete Muster prüfen:
- Nur-Zahlen-Felder: Wenn ein Feld nur Ziffern enthalten soll (Rechnungsnummer, Bestellnummer, Kontocode), führen Sie eine einfache Regex-Prüfung durch. Jedes extrahierte Zeichen, das in einem Nur-Zahlen-Feld keine Ziffer ist, ist mit hoher Wahrscheinlichkeit eine Fehllesung. Ersetzen Sie in diesem Kontext „S“ durch „5“, „O“ durch „0“, „l“ durch „1“.
- Bereichsprüfungen: Wenn eine extrahierte Summe $5.000,00 beträgt, aber alle anderen Rechnungen dieses Anbieters im Bereich von $200–$800 liegen, markieren Sie sie zur Überprüfung. Ein einzelner Ausreißer ist oft das Ergebnis einer falsch platzierten Dezimalstelle oder einer Zeichenfehllesung, die einen Wert um eine Größenordnung erhöht hat.
- Feldübergreifende Mathematik-Validierung: Prüfen Sie, ob Subtotal + Tax = Total ergibt. Wenn die Mathematik nicht innerhalb einer kleinen Toleranz aufgeht, enthält mindestens eine der drei Zahlen einen Zeichenfehler. Diese einzelne Prüfung erfasst die Mehrheit der Zeichenverwechslungsfehler, weil eine fehlgelesene Ziffer in einer der drei Summen die arithmetische Beziehung bricht.
ImageToTable.ai's intelligente Daten-Nachbearbeitung übernimmt die Formatierungshälfte davon automatisch, standardisiert Daten, Beträge und Seriennummern, sodass ein Wert in einer konsistenten Form ankommt. Die Mathematik-Hälfte kann während der Extraktion statt in Ihrer Tabellenkalkulation ausgeführt werden: Beschreiben Sie die Berechnung in einem Spaltennamen, zum Beispiel "Tax Check (Subtotal + Tax = Total)", und ImageToTable.ai führt sie beim Lesen des Dokuments aus und gibt „bestanden“, „fehlgeschlagen“ oder die Differenz aus. Wenn Subtotal + Tax nicht dem gedruckten Total entspricht, erscheint diese Abweichung als Wert in der betreffenden Zeile, statt als Formel, die Sie noch selbst erstellen müssten.
Ursache 3: Formatabweichung — 1.234,56 vs 1,234.56
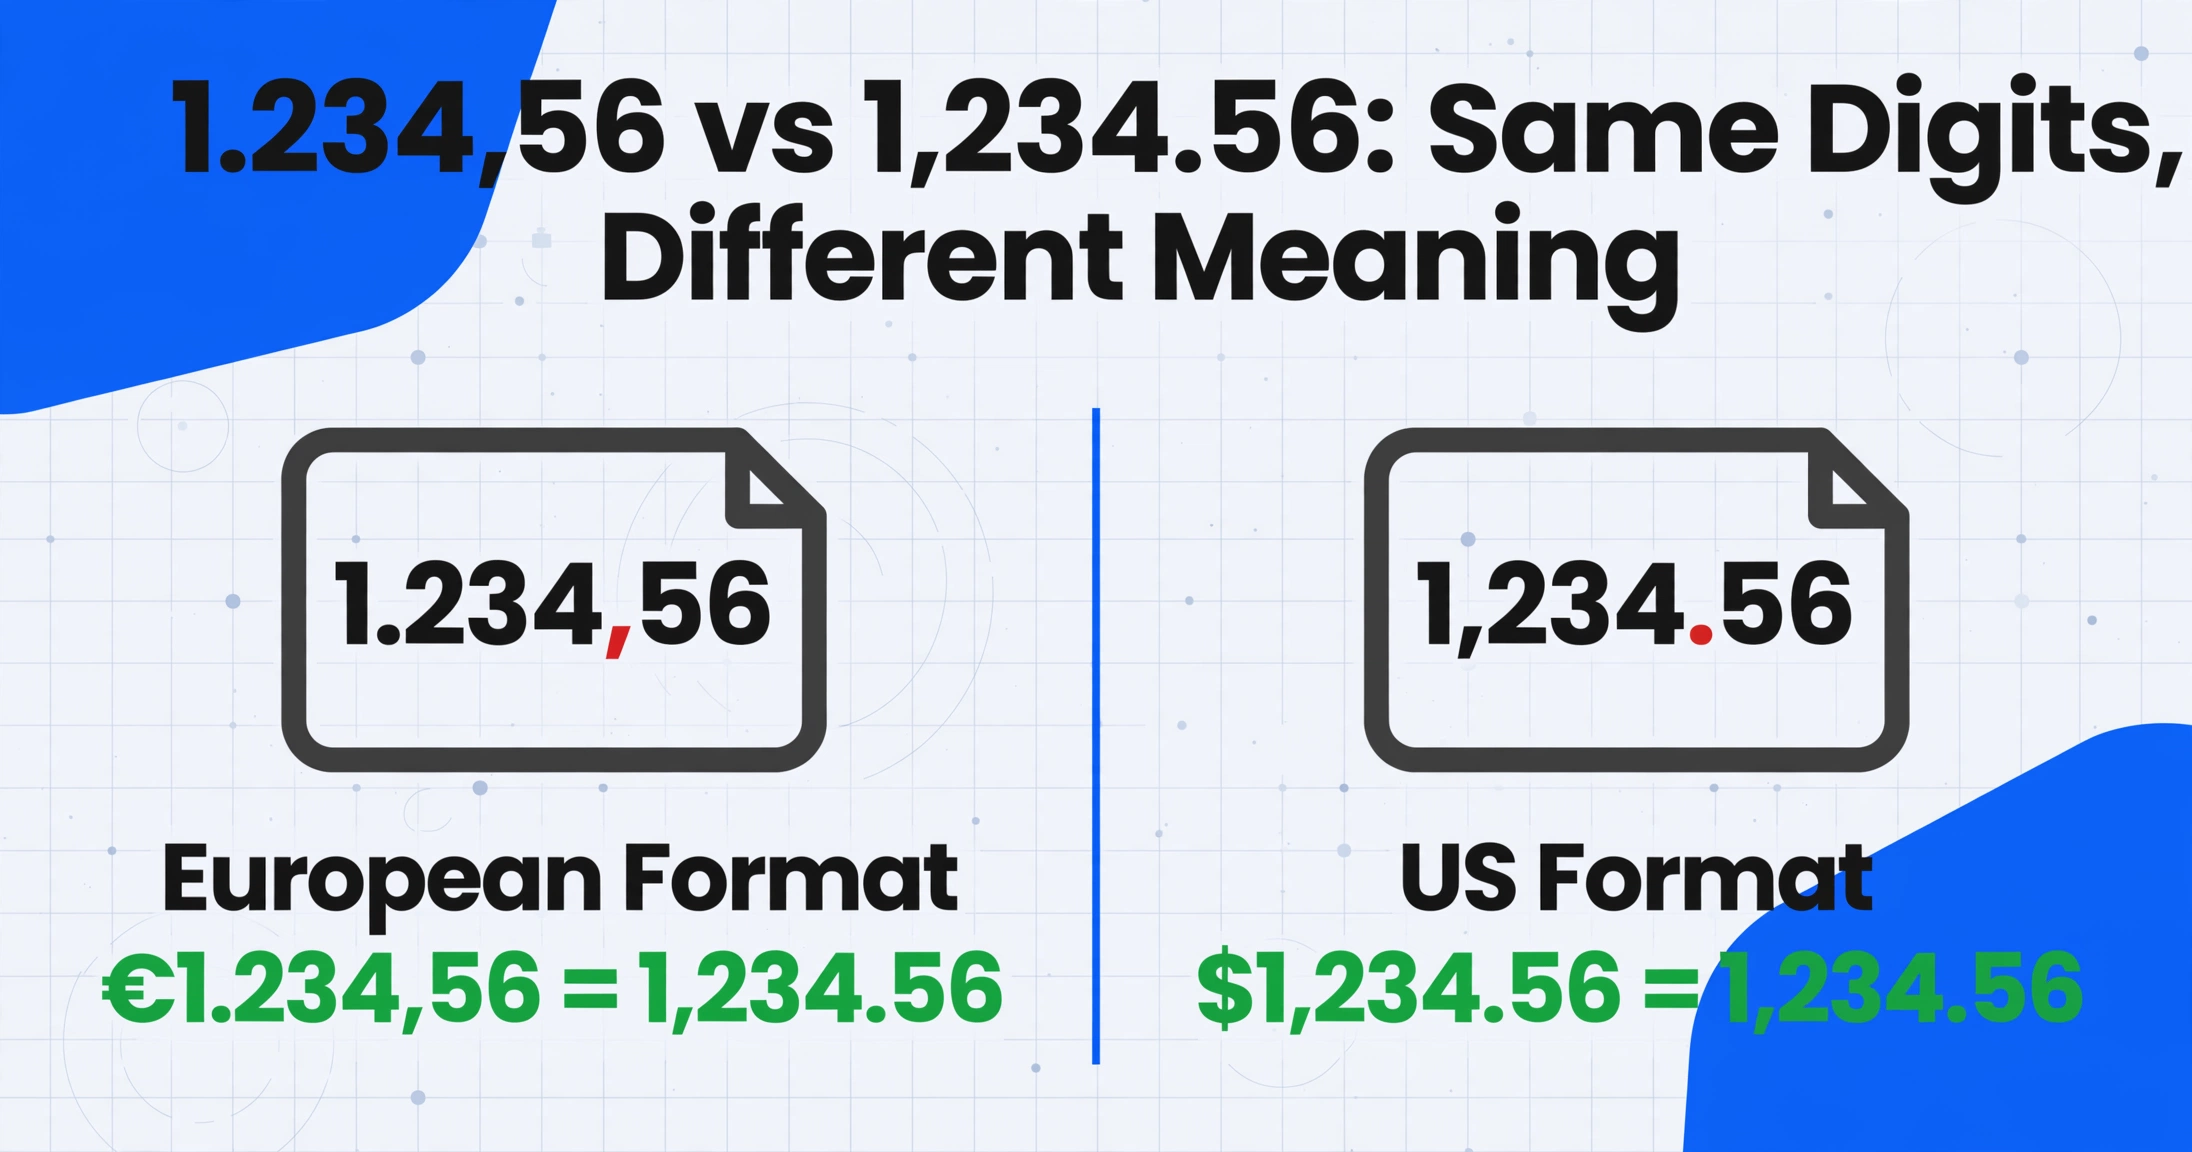
Symptome: Die extrahierte Zahl weicht um drei Größenordnungen ab. Ein Total von €1.234,56 auf einer europäischen Rechnung wird als 1.234 extrahiert oder schlimmer als 1,234.56 (was in europäischer Notation eintausendzweihundertvierunddreißig und 56/100 bedeutet). Auch Daten sind betroffen: 03/04/2026 wird von einem US-basierten System als 4. März gelesen, obwohl die Rechnung eindeutig den 3. April meint.
Warum das passiert: Der größte Teil Kontinentaleuropas, der größte Teil Südamerikas sowie Teile Afrikas und Asiens verwenden das Komma als Dezimaltrennzeichen und den Punkt als Tausendertrennzeichen. Die USA, das Vereinigte Königreich und einige andere Länder kehren diese Konvention um. Eine KI-Extraktions-Engine, die eine deutsche Rechnung (€1.234,56) und eine US-Rechnung ($1,234.56) im selben Batch verarbeitet, sieht zwei Zahlen, die strukturell identisch aussehen, aber völlig unterschiedliche Bedeutungen haben.
Hier ist der subtile Teil: Die KI weiß nicht, welcher Konvention das Dokument folgt, es sei denn, Sie sagen es ihr, denn das visuelle Muster ist dasselbe — eine Zahl mit zwei Trennzeichen. Das Modell sieht „1.234,56“ und hat keine inhärente Möglichkeit zu wissen, ob der Punkt ein Tausendertrennzeichen (europäisch) oder ein Dezimalpunkt (ungewöhnlich, aber in einigen Formaten möglich) ist.
So beheben Sie es: Validierungsregeln nach der Extraktion leisten die eigentliche Arbeit bei Formatabweichungen, denn das visuelle Verständnis der KI kann eine Mehrdeutigkeit, die kulturell und nicht visuell bedingt ist, nicht auflösen.
- Legen Sie eine Dezimaltrennzeichen-Regel pro Dokumentquelle fest. Wenn Sie Rechnungen von deutschen Lieferanten verarbeiten, definieren Sie das Komma als Dezimaltrennzeichen für diese Dokumentgruppe. Die Daten-Nachbearbeitung von ImageToTable.ai standardisiert Datums-, Betrags- und Seriennummernformate als Teil der Ausgabe, sodass die exportierten Werte der von Ihnen festgelegten Konvention folgen.
- Wenden Sie bereichsbasierte Plausibilitätsprüfungen an. Wenn eine extrahierte „Total" 1.234 (eintausendzweihundertvierunddreißig basierend auf europäischer Formatierung) beträgt, die Positionsbeträge sich aber auf etwa 1.234,56 (eintausendzweihundertvierunddreißig und 56 Cent) summieren, hat die KI wahrscheinlich den Dezimalteil verschluckt. Eine Bereichsprüfung, die die extrahierte Summe mit der Summe der Positionsbeträge vergleicht, erkennt dies sofort.
- Verwenden Sie mathematische Konsistenzprüfungen. Wie bei Ursache 2: Zwischensumme + Steuer = Gesamtsumme. Wenn das Dezimaltrennzeichen falsch interpretiert wurde, stimmt die Mathematik nicht, und Sie wissen, dass Sie das Format erneut prüfen müssen, bevor sich der Fehler ausbreitet.
Eine stärkere OCR-Engine löst dies nicht, da die Mehrdeutigkeit kultureller und nicht visueller Natur ist. Was funktioniert, ist eine Validierungsebene, die die geparste Zahl gegen den Rest des Dokuments prüft, bevor der Wert weiterverarbeitet wird.
Wann Sie eskalieren sollten: Die Randfälle, die selbst gute Tools nicht beheben können
Ehrlichkeit ist hier wichtig. Nicht jeder Fehler bei falschen Zahlen lässt sich auf Feldebene beheben. Es gibt zwei Situationen, in denen selbst die beste KI-Extraktion mit den spezifischsten Spaltennamen und der gründlichsten Nachbearbeitung immer noch mit einiger Häufigkeit falsche Ausgaben produziert.
Situation 1: Benachbarte Summenzeilen mit identischer Formatierung. Wenn eine Rechnung „Subtotal", „Discount", „Tax" und „Total" in derselben rechtsbündigen Spalte auflistet, mit derselben Schriftgröße und demselben Schriftgewicht und ohne visuelles Trennzeichen dazwischen, steht jede KI-Engine vor einem echten Mehrdeutigkeitsproblem. Die Signale, die das Modell zur Unterscheidung von Feldern verwendet, wie Schriftgröße, Leerraum und Label-Position, sind hier schwach oder widersprüchlich. In diesem Fall besteht der praktische Ansatz darin, alle vier Werte zu extrahieren (definieren Sie Spalten für jeden) und in Ihrem nachgelagerten Spreadsheet anhand erwarteter Beziehungen zu klären, welcher welcher ist: Die Gesamtsumme sollte die größte Zahl sein, die Zwischensumme die zweitgrößte und der Rabatt die kleinste.
Situation 2: Inkonsistente Dezimalkonventionen innerhalb eines einzelnen Dokuments. Einige Rechnungen mischen Formate, verwenden in einem Abschnitt einen Punkt als Dezimaltrennzeichen und in einem anderen ein Komma. Das ist selten, kommt aber vor, typischerweise bei grenzüberschreitenden Rechnungen, bei denen das Dokumentlayout aus mehreren regionalen Vorlagen zusammengesetzt wurde. In diesen Fällen funktioniert keine einzelne Formatregel für das gesamte Dokument. Die Lösung ist eine manuelle Überprüfung der Felder, in denen die Formatmischung auftritt, kombiniert mit einer Kennzeichnungsregel, die Sie warnt, wenn Positionsbeträge und Summen unterschiedliche Trennzeichenmuster verwenden.
In beiden Randfällen verfehlt es den Punkt, dem Tool die Schuld zu geben. Das Quelldokument selbst trägt eine Mehrdeutigkeit, mit der jedes automatisierte System zu kämpfen hätte. Die Arbeit verlagert sich also darauf, Ihren Validierungsworkflow entsprechend zu gestalten.
Häufig gestellte Fragen
Wenn meine extrahierte Summe falsch ist, sollte ich annehmen, dass die KI einen zufälligen Fehler gemacht hat?
Nein. Extraktionsfehler bei numerischen Feldern folgen vorhersehbaren Mustern. Überprüfen Sie zuerst die Spezifität Ihres Spaltennamens: „Total“ ist bei den meisten Rechnungen mehrdeutig. Wenn die korrekte Zahl auf dem Dokument erscheint, aber nicht die von der KI zurückgegebene, liegt die Ursache fast sicher an Feldmehrdeutigkeit (Ursache 1). Wenn die Zahl selbst unerwartete Zeichen enthält (Buchstaben, wo Ziffern sein sollten), handelt es sich um Zeichenverwechslung (Ursache 2). Wenn die Größenordnung um etwa das 1.000-fache abweicht, liegt ein Dezimaltrennzeichen-Problem vor (Ursache 3). Jede Ursache hat eine andere Lösung, aber keine sollte als zufälliges Rauschen behandelt werden.
Kann ich denselben Spaltennamen „Total“ verwenden, wenn ich immer die Gesamtsumme möchte?
Sie können, aber Sie erhalten falsche Ergebnisse bei jeder Rechnung, bei der die Summe mehrdeutig ist. „Total“ ist der am stärksten überladene Feldname in der Dokumentextraktion. Eine Spalte mit dem Namen „Total Amount Due“ oder „Grand Total (nach Steuern)“ beseitigt die Mehrdeutigkeit ohne zusätzlichen Aufwand. Die KI verwendet Ihren Spaltennamen als primäres Suchsignal. Je präziser das Signal, desto weniger Interpretationsspielraum bleibt.
Behebt bessere KI-Hardware die Zeichenverwechslung zwischen 5/S oder 0/O?
Nein. Zeichenverwechslung ist eine grundlegende visuelle Mehrdeutigkeit, keine Hardware-Einschränkung. Ein hochmodernes Vision-Modell und eine einfache OCR-Engine stehen vor derselben 5/S-Mehrdeutigkeit, wenn das Zeichen auf einem komprimierten Scan nur 9 Pixel hoch ist. Die Lösung ist eine Validierung nach der Extraktion: Prüfen Sie, ob rein numerische Felder nur Ziffern enthalten, wenden Sie Bereichsprüfungen an und nutzen Sie feldübergreifende Berechnungen, um inkonsistente Werte zu erkennen. Ein stärkeres Modell hilft nicht und kann die Sache verschlimmern, indem es einen falschen Wert mit größerer Sicherheit zurückgibt.
Meine europäische Rechnung hat €1.234,56, aber die Extraktion gibt 1.234 zurück. Was ist passiert?
Die KI hat wahrscheinlich den Punkt als Dezimaltrennzeichen und das Komma als Tausendertrennzeichen interpretiert, der US-Konvention folgend, wodurch der Dezimalteil vollständig abgeschnitten wurde. Der Wert „1.234,56“ in europäischer Formatierung bedeutet eintausendzweihundertvierunddreißig und 56/100. Im US-Format gelesen wird der Punkt zum Dezimaltrennzeichen (was den Wert 1.234 ergibt, also etwa eins und ein Viertel) und das Komma zum Tausendertrennzeichen, das bei einer vierstelligen Zahl ignoriert wird. Konfigurieren Sie Ihren Batch für europäische Dezimalformatierung, indem Sie dem System mitteilen, dass das Komma das Dezimaltrennzeichen ist, und führen Sie ihn dann erneut aus.
Sollte ich jede Extraktion manuell prüfen oder nur, wenn Zahlen verdächtig aussehen?
Gezielte Prüfung schlägt pauschale Prüfung. Wenden Sie drei Regeln auf jeden Batch an: (1) markieren Sie jeden extrahierten Total, der außerhalb eines definierten Bereichs liegt (z. B. 3 Standardabweichungen vom historischen Durchschnitt des Anbieters), (2) markieren Sie jeden Batch, bei dem Subtotal + Tax ≠ Total um mehr als eine kleine Toleranz (z. B. $0.50) abweicht, und (3) markieren Sie jedes reine Zahlenfeld, das Nicht-Ziffern-Zeichen enthält. Diese drei Regeln erfassen die überwiegende Mehrheit der Fehler bei falschen Zahlen, ohne dass Sie jede einzelne Zeile prüfen müssen. Manuelle Prüfung nur der markierten Einträge hält Ihren Durchsatz hoch und erfasst gleichzeitig die Fehler, die zählen.
Wie geht Benutzerdefinierte Spaltenextraktion anders mit mehrdeutigen Feldnamen um als vorlagenbasierte Tools?
Benutzerdefinierte Spaltenextraktion behandelt jeden Spaltennamen als semantische Suchanfrage, nicht als positionsbasierte Regel. Wenn Sie „Total Amount Due“ eingeben, durchsucht die KI das gesamte Dokument nach einem Wert, der dieser spezifischen Bedeutung entspricht – dem endgültigen fälligen Betrag nach allen Additionen und Abzügen. Ein vorlagenbasiertes Tool hingegen betrachtet einen vorab aufgezeichneten Koordinatenbereich auf der Seite. Der Koordinatenansatz funktioniert gut, wenn sich der Total nie bewegt; Benutzerdefinierte Spaltenextraktion funktioniert gut, wenn sich der Total bewegt, aber seine Bedeutung gleich bleibt.
Kann derselbe Batch Rechnungen von US- und europäischen Lieferanten mit unterschiedlichen Zahlenformaten enthalten?
Ja, aber Sie müssen die Formatabweichung nachgelagert behandeln. Die KI extrahiert die Zahlen so, wie sie auf der Seite erscheinen, und normalisiert Formatkonventionen innerhalb eines Batches nicht automatisch. Bei Batches mit gemischten Formaten ist der praktische Ansatz, US- und europäische Dokumente getrennt zu verarbeiten, die passende Formatregel auf jede Gruppe anzuwenden oder die Trennzeichen in einem Nachbearbeitungsschritt zu normalisieren, bevor die Werte Ihr Buchhaltungssystem erreichen. Für einen tieferen Einblick in die Arten von Schreib- und Zeichenhindernissen, mit denen Extraktionstools konfrontiert sind, lesen Sie unseren Begleitartikel zu warum OCR mit Handschrift kämpft und wie man das behebt.
Falsch extrahierte Zahlen sind frustrierend, aber sie sind fast nie zufällig. Sie fallen in eine von drei vorhersehbaren Kategorien: mehrdeutiges Felddesign, Zeichenverwechslung oder Formatabweichung. Der erste Ort, an dem man suchen sollte, ist das Felddesign, und jede Kategorie hat eine spezifische Lösung, die keinen Tool-Wechsel oder ein Modell-Retraining erfordert. Wenn ein Total das nächste Mal falsch zurückkommt, fragen Sie nicht „warum ist die KI schlecht bei Zahlen“. Fragen Sie „welche der drei Grundursachen ist das, und was ist die günstigste Lösung?“ Die Antwort ist meist ein spezifischerer Spaltenname oder eine einzelne Validierungsregel – beides kostet nicht mehr als ein paar Sekunden Nachdenken.
Testen Sie den Ansatz mit Ihren eigenen Dokumenten. Laden Sie eine Rechnung hoch, von der Sie wissen, dass sie einen Fehler bei falschen Zahlen verursacht hat, definieren Sie die Spalten mit maximaler Spezifität, verwenden Sie „Grand Total After Tax“ statt „Total“, und sehen Sie, ob sich das Ergebnis ändert. Probieren Sie die Extraktion mit Ihren eigenen Dokumenten aus und sehen Sie, ob aus drei Minuten pro Dokument zehn Sekunden werden.