Como Corrigir Números Extraídos Incorretamente:
3 Causas Raiz que Você Pode Diagnosticar Hoje
Quando sua extração com IA erra o total da fatura por $200, a IA raramente é o problema. A maioria desses erros se deve a erros no design de campo: como as colunas que você pediu foram nomeadas e definidas. Essa parte está sob seu controle e leva apenas alguns minutos para diagnosticar.
Principais Conclusões
- Quando um total extraído de fatura sai errado por $200, seu primeiro instinto é "A IA é ruim com números", mas três causas raiz distintas produzem esse erro, e nenhuma delas é ruído aleatório.
- Uma coluna chamada "Total" mapeia cinco valores diferentes em uma única fatura (subtotal, tax, grand total, discount, shipping), então o modelo precisa adivinhar qual você quis dizer.
- Renomeie "Total" para "Grand Total After Tax" e adicione três regras de validação (verificação apenas numérica, verificação de intervalo, verificação matemática). A maioria dos erros de números incorretos aparece antes de chegar ao seu sistema contábil, e a verificação matemática pode ser executada durante a extração em vez de na sua planilha.
A IA Não é Ruim com Números — Os Nomes dos Seus Campos São os Culpados
Aqui está uma situação que a maioria das pessoas que trabalham com extração por IA encontra pelo menos uma vez: você envia uma fatura claramente legível, a ferramenta retorna todos os campos com confiança, e então você percebe: a coluna "Total" mostra $1.247,30 quando o total real da fatura é $1.447,30. O subtotal, o imposto, os itens de linha — tudo parece certo. Mas o número que mais importa está errado por $200.
Totais extraídos incorretamente raramente são aleatórios. Eles seguem padrões previsíveis, e é por isso que você geralmente consegue diagnosticar e corrigir um sem trocar de ferramenta. Nos documentos que processamos, as mesmas três causas respondem por quase todos os números errados que vemos.
O custo aparece depois. Um total errado que já foi lançado leva minutos para rastrear e corrigir, e o processo automatizado acaba criando mais trabalho de limpeza do que economizou. A correção, no entanto, raramente exige um motor de IA diferente. Ela exige saber em qual das três categorias de causa raiz o seu erro se encaixa.
Extração de Colunas Personalizadas é o mecanismo no qual este diagnóstico se baseia. Você digita os nomes dos campos que deseja, e a IA localiza cada valor correspondente em qualquer lugar da página entendendo o que o rótulo significa, em vez de onde ele está. É por isso que o design do campo tem tanto peso: a IA trabalha a partir do rótulo exato que você forneceu, e um rótulo preciso deixa pouco espaço para ela escolher o número errado. As três categorias de causa raiz abaixo explicam praticamente todo erro de número errado, e cada uma tem seu próprio teste de diagnóstico.
Causa Raiz 1: Design de Campo Ambíguo — "Total" Não é Específico o Suficiente
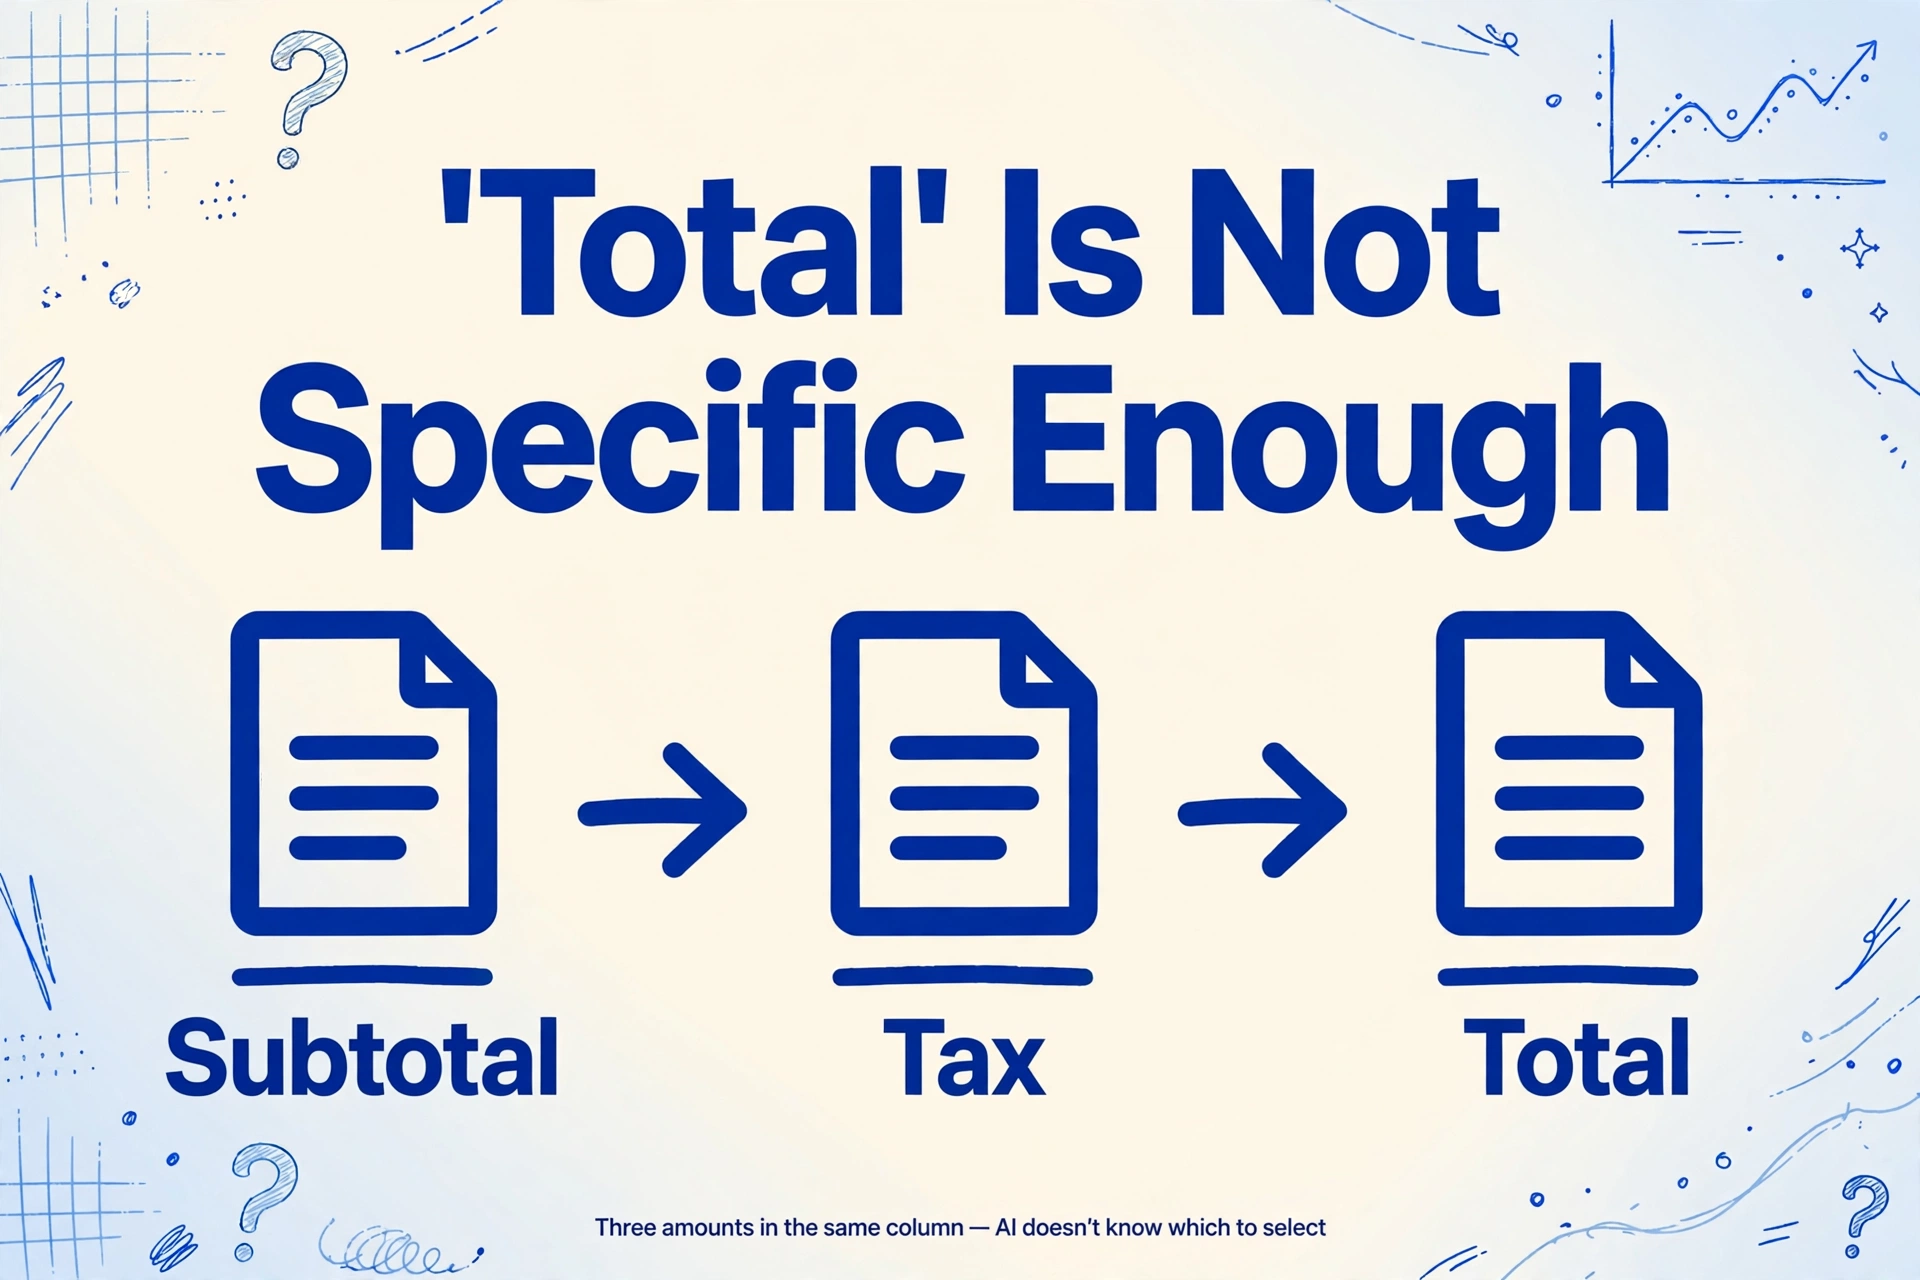
Sintomas: O total extraído não é o total que você espera. Pode ser o subtotal. Pode ser o valor após um desconto que você não notou. Pode ser o total com impostos incluídos quando você queria o valor líquido. Mas o número em si é legível e aparece na fatura — é apenas o errado entre vários valores disponíveis.
Por que isso acontece: A seção de totais de uma fatura típica contém pelo menos três campos monetários empilhados verticalmente: Subtotal, Tax (ou VAT/GST) e Total. Muitas faturas também incluem campos de Discount, Shipping ou Previous Balance na mesma coluna. Se sua coluna de extração se chama "Total", a IA precisa adivinhar qual desses valores você quer dizer. A palavra "Total" é um rótulo de campo válido no documento, mas também é a palavra que aparece em "Subtotal", e a área geral onde "Tax" e "Shipping" também ficam. A IA não tem conhecimento nativo de qual total você se importa — ela lê o rótulo que você fornece e encontra a melhor correspondência semântica na página. Quando um rótulo mapeia para cinco valores possíveis, a taxa de erro aumenta.
Isso não é uma limitação exclusiva de nenhum motor de IA específico. Aqui está o que acontece dentro de um modelo de visão-linguagem quando ele processa uma solicitação de coluna ambígua: ele vê a palavra "Total" na sua definição de coluna, examina a seção de totais, encontra três ou quatro números que todos correspondem de forma plausível — o subtotal fica uma linha acima do imposto, o total geral fica uma linha abaixo — e escolhe o que tem o sinal semântico e posicional mais forte. Na maioria das faturas, isso funciona bem. Em faturas onde o subtotal e o total têm tamanhos de fonte próximos e estão separados por apenas uma linha de espaço em branco, a confiança do modelo para qualquer uma das opções pode ser quase igual. O resultado é um cara ou coroa que parece uma resposta errada confiante na saída.
Como corrigir: Seja específico sobre qual valor você quer. Em vez de uma coluna chamada "Total", use uma destas:
- "Total Amount Due": inequívoco, aparece na maioria das faturas como o valor final a pagar
- "Grand Total (após impostos)": o sufixo informa à IA que este é o valor final após todas as adições
- "Subtotal (antes dos impostos)": exclui explicitamente valores que incluem impostos
- "Amount Paid" / "Balance Due": distingue pagamento de valores pendentes em extratos
Quanto mais específico for o nome da sua coluna, menos candidatos a IA terá para escolher. É assim que a extração deve funcionar, não é um contorno. Como a IA moderna distingue campos de fatura pelo significado, não pela posição explica por que a especificidade do rótulo controla diretamente a precisão da extração no nível do campo.
Para testar se este é o seu problema: observe a fatura junto com o resultado da extração. Encontre o valor que a IA retornou para "Total" e o valor no documento que corresponde a ele. Se forem iguais, mas esse valor for o subtotal ou o total com impostos, você tem um problema de ambiguidade, e a correção custa apenas um nome de coluna mais específico. Depois que os nomes estiverem corretos, extrair campos específicos de fatura para o Excel é o próximo passo.
Causa Raiz 2: Confusão de Caracteres — Quando 5 Vira S e 0 Vira O
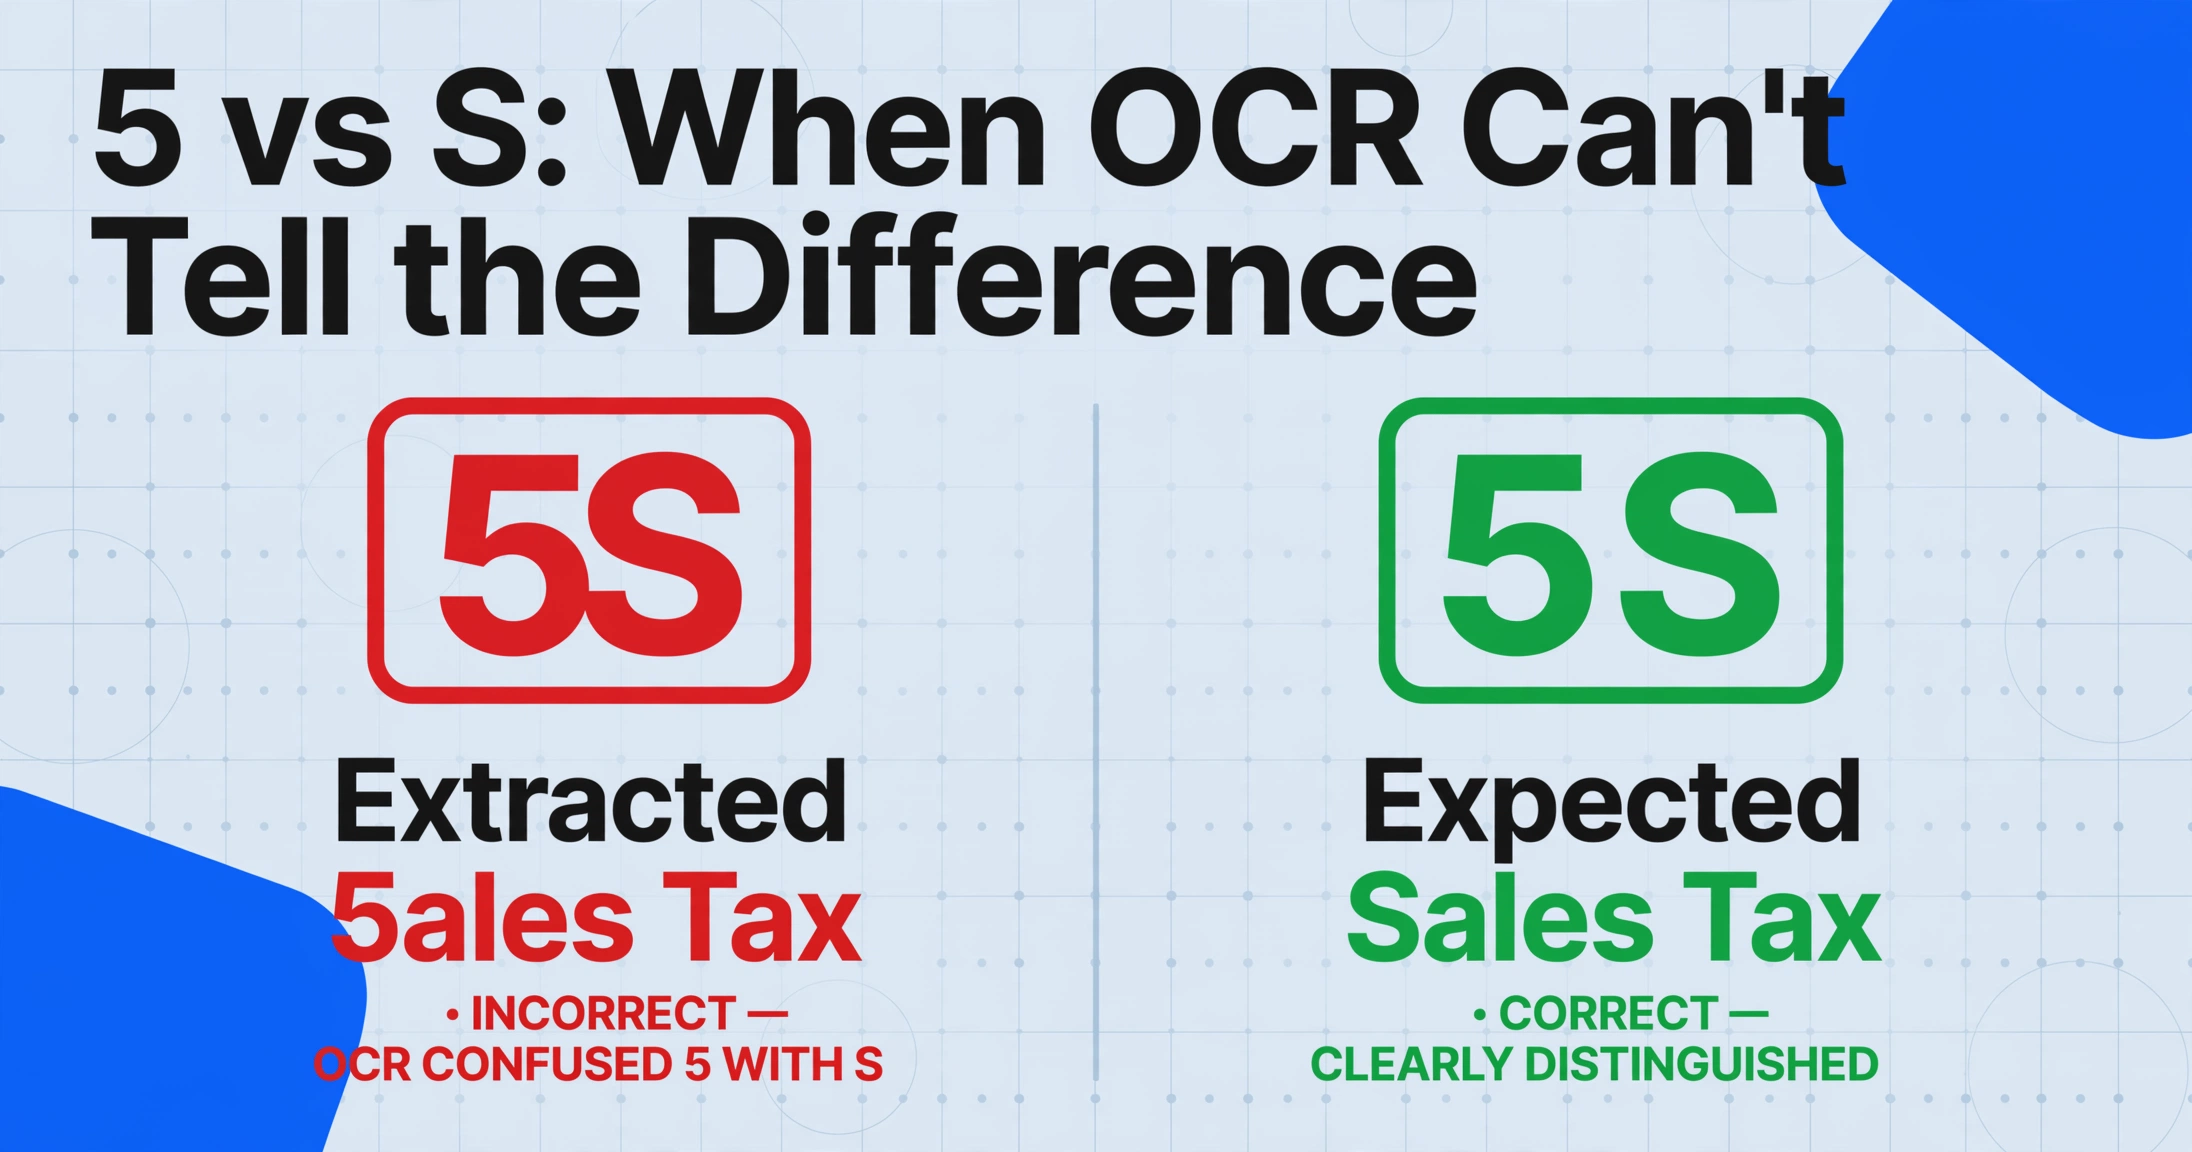
Sintomas: Um número no resultado extraído contém uma letra onde deveria haver um dígito — "5" extraído como "S", "0" como "O", "1" como "l" ou "7". O erro é consistente em documentos semelhantes da mesma origem. O número está errado em uma ou duas posições, mas a magnitude parece aproximadamente correta.
Por que isso acontece: Motores de OCR e modelos de visão analisam as formas dos pixels dos caracteres. Alguns pares de caracteres compartilham perfis visuais quase idênticos em tamanhos de fonte e resoluções de digitalização comuns:
| Par | Por que o OCR os Confunde |
|---|---|
| 5 / S | A curvatura superior e inferior parecem quase idênticas em fontes pequenas ou digitalizações de baixo contraste |
| 0 / O | Ambos aparecem como uma forma redonda ou elíptica; a barra no zero geralmente está ausente nas fontes |
| 1 / l / 7 | Traços verticais finos se fundem no mesmo perfil visual em baixa resolução |
| 8 / B | As alças internas são visualmente semelhantes quando a digitalização está levemente desfocada |
| 6 / G | A cauda do G e o laço do 6 são quase indistinguíveis em tamanhos pequenos |
Este não é um problema que uma IA melhor pode eliminar completamente. Mesmo modelos de visão de última geração têm confiança quase igual para "5" e "S" quando o caractere aparece com 9 pixels de altura e artefatos de compressão. O cérebro humano resolve essas ambiguidades usando contexto no nível da palavra — você sabe que "5ales Tax" está errado porque "Sales Tax" é um termo conhecido. Um motor de OCR não tem esse conhecimento no nível da palavra, a menos que tenha sido treinado especificamente para esperar palavras de dicionário em certos campos.
Como corrigir: A confusão de caracteres é melhor detectada após a extração, não durante. Implemente regras de validação no nível do campo que verifiquem o valor extraído contra padrões esperados:
- Campos somente numéricos: Se um campo deve conter apenas dígitos (número da fatura, número do pedido, código de conta), execute uma verificação simples de regex. Qualquer caractere extraído que não seja um dígito em um campo somente numérico é quase certamente uma leitura incorreta. Substitua "S" por "5", "O" por "0", "l" por "1" nesse contexto.
- Verificações de faixa: Se um total extraído for $5.000,00, mas todas as outras faturas desse fornecedor estiverem na faixa de $200–$800, sinalize-o para revisão. Um único valor discrepante geralmente é resultado de uma vírgula decimal mal posicionada ou de um caractere lido incorretamente que inflou um valor por uma ordem de magnitude.
- Validação matemática entre campos: Verifique se subtotal + imposto = total. Se a matemática não fechar dentro de uma pequena tolerância, pelo menos um dos três números contém um erro no nível do caractere. Essa única verificação captura a maioria dos erros de confusão de caracteres, porque um dígito lido incorretamente em qualquer um dos três totais quebra a relação aritmética.
O pós-processamento inteligente de dados do ImageToTable.ai cuida automaticamente da metade da formatação, padronizando datas, valores e números de série para que um valor chegue em um formato consistente. A metade matemática pode ser executada durante a extração em vez de na sua planilha: descreva o cálculo em um nome de coluna, por exemplo "Verificação de Imposto (Subtotal + Imposto = Total)", e o ImageToTable.ai o executa enquanto lê o documento, gerando aprovação, reprovação ou a diferença. Quando subtotal + imposto não é igual ao total impresso, essa divergência chega como um valor na linha correspondente, em vez de uma fórmula que você ainda precisaria criar.
Causa Raiz 3: Variação de Formato — 1.234,56 vs 1,234.56
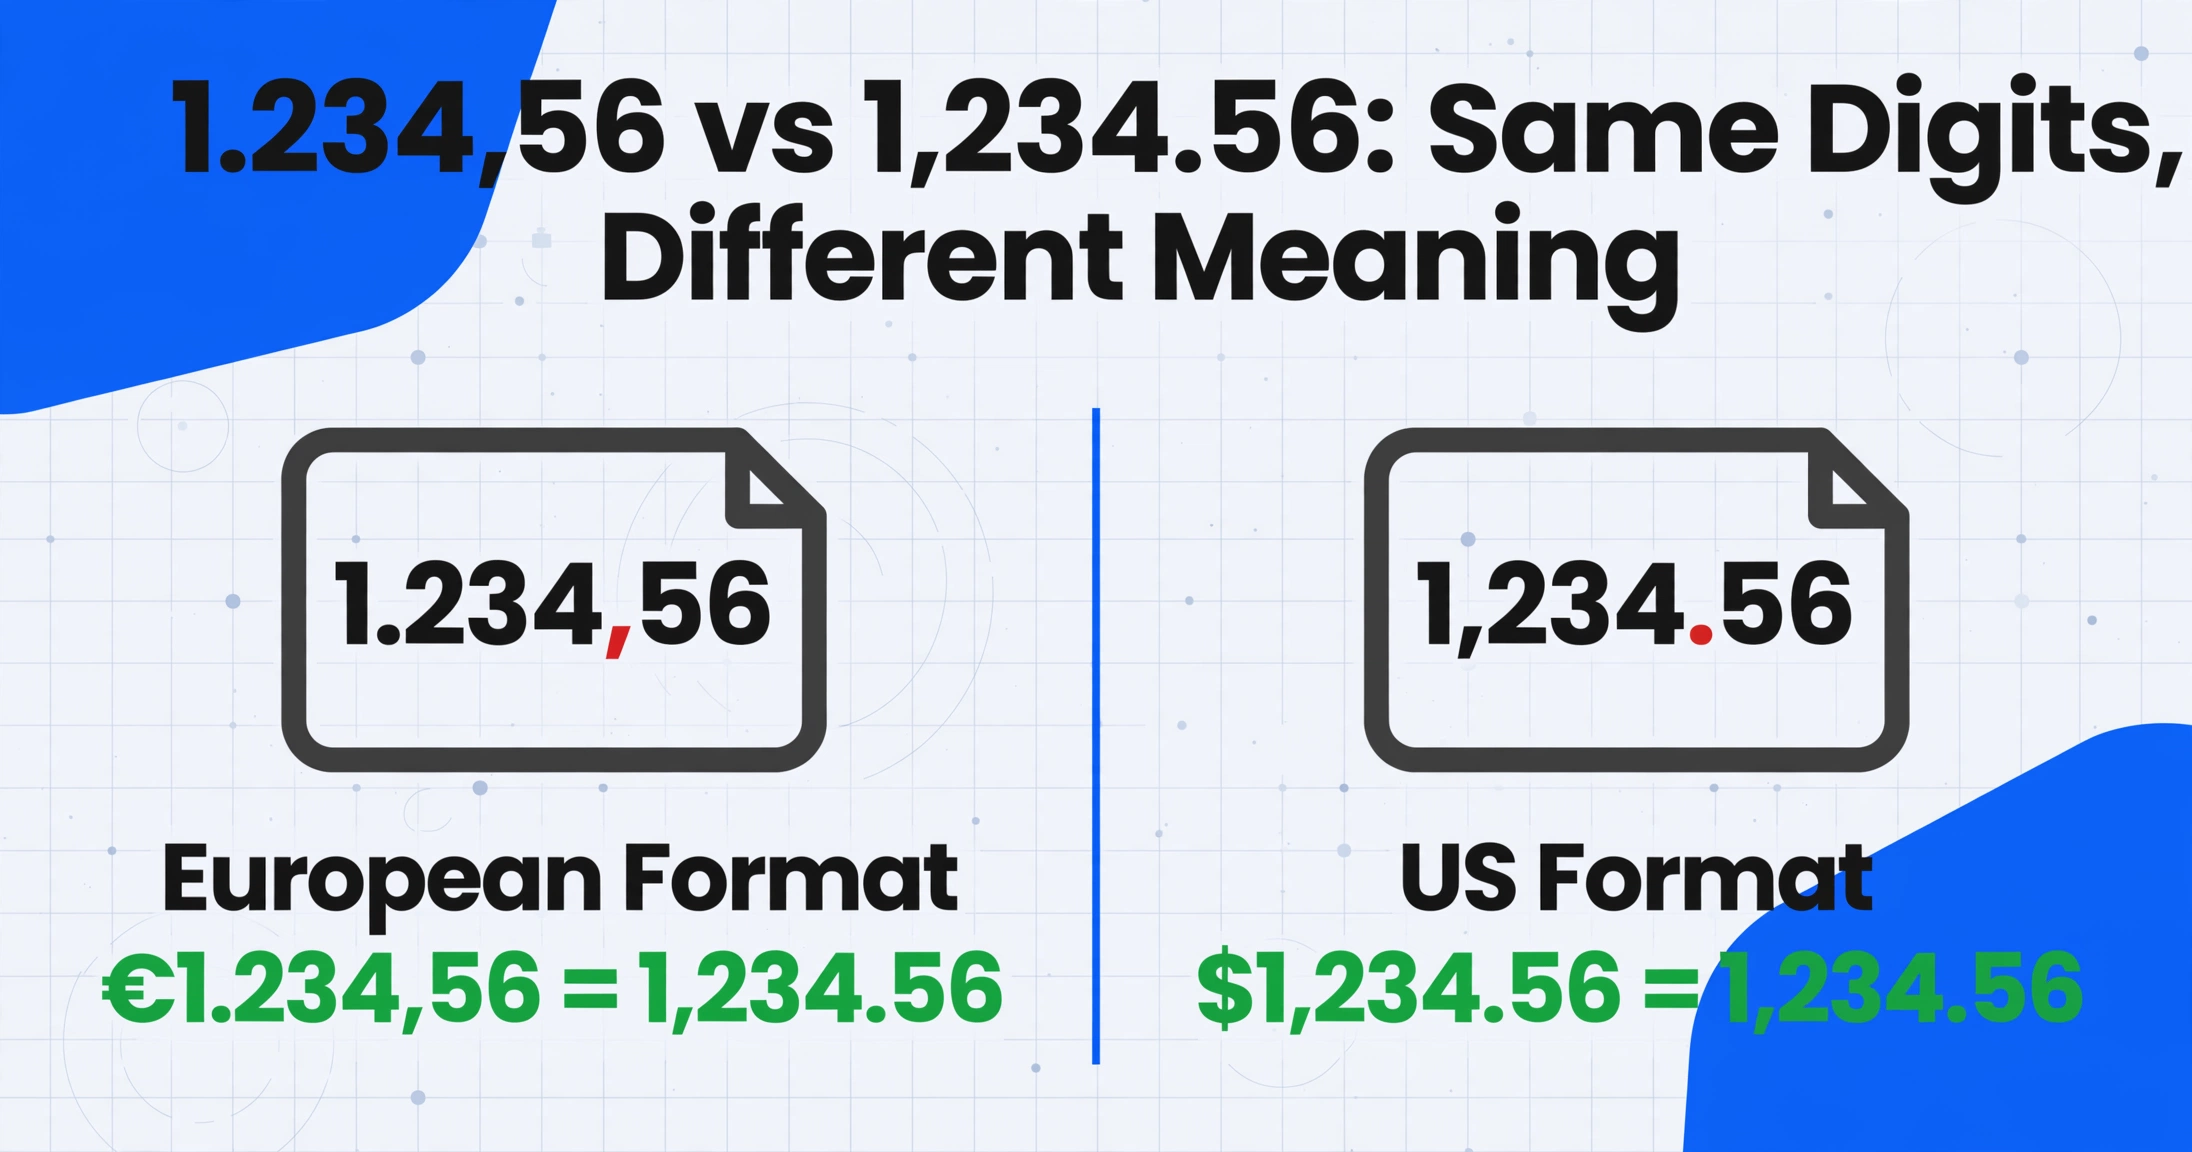
Sintomas: O número extraído está errado por três ordens de magnitude. Um total de €1.234,56 em uma fatura europeia é extraído como 1.234, ou pior, como 1,234.56 (que na notação europeia significa mil duzentos e trinta e quatro e 56/100). As datas também são afetadas: 03/04/2026 é lido como 4 de março por um sistema baseado nos EUA quando a fatura claramente indica 3 de abril.
Por que isso acontece: A maior parte da Europa continental, grande parte da América do Sul e partes da África e da Ásia usam a vírgula como separador decimal e o ponto como separador de milhares. Os Estados Unidos, o Reino Unido e alguns outros países invertem essa convenção. Um mecanismo de extração de IA que processa uma fatura alemã (€1.234,56) e uma fatura dos EUA ($1,234.56) no mesmo lote vê dois números que parecem estruturalmente idênticos, mas significam coisas completamente diferentes.
Aqui está a parte sutil: a IA não sabe qual convenção o documento segue a menos que você informe, porque o padrão visual é o mesmo — um número com dois separadores. O modelo vê "1.234,56" e não tem como saber inerentemente se o ponto é um separador de milhares (europeu) ou um ponto decimal (incomum, mas possível em alguns formatos).
Como corrigir: Regras de validação pós-extração fazem o trabalho real para variação de formato, porque o entendimento visual da IA não consegue resolver uma ambiguidade que é cultural e não visual.
- Configure uma regra de separador decimal por fonte de documento. Se você processa faturas de fornecedores alemães, defina a vírgula como separador decimal para esse grupo de documentos. O pós-processamento de dados do ImageToTable.ai padroniza formatos de data, valor e número de série como parte da saída, para que os valores exportados sigam a convenção que você definiu.
- Aplique verificações de sanidade baseadas em faixas. Se um "Total" extraído é 1.234 (mil duzentos e trinta e quatro com base na formatação europeia), mas os itens de linha somam cerca de 1.234,56 (mil duzentos e trinta e quatro e 56 centavos), a IA provavelmente engoliu a parte decimal. Uma verificação de faixa que compara o total extraído com a soma dos itens de linha detecta isso imediatamente.
- Use verificações de consistência matemática. Igual à Causa Raiz 2: subtotal + imposto = total. Se o separador decimal foi interpretado incorretamente, a matemática não vai fechar, e você saberá que precisa reexaminar o formato antes que o erro se propague.
Um mecanismo de OCR mais forte não resolve isso, porque a ambiguidade é cultural, não visual. O que funciona é uma camada de validação que verifica o número analisado contra o resto do documento antes que o valor siga adiante.
Quando Escalar: Os Casos Extremos que Até Boas Ferramentas Não Conseguem Resolver
Honestidade importa aqui. Nem todo erro de número errado tem uma correção no nível do nome do campo. Há duas situações em que até a melhor extração por IA, com os nomes de coluna mais específicos e o pós-processamento mais completo, ainda produzirá saídas erradas com alguma frequência.
Situação 1: Linhas de totais adjacentes com formatação idêntica. Quando uma fatura lista "Subtotal", "Discount", "Tax" e "Total" na mesma coluna alinhada à direita, usando o mesmo tamanho de fonte e o mesmo peso de fonte, sem separador visual entre elas, qualquer mecanismo de IA enfrenta um problema genuíno de ambiguidade. Os sinais que o modelo usa para desambiguar campos, como tamanho da fonte, espaçamento e posição do rótulo, são fracos ou contraditórios aqui. Nesse caso, a abordagem prática é extrair todos os quatro valores (defina colunas para cada um) e resolver qual é qual na sua planilha downstream com base nas relações esperadas: o total deve ser o maior número, o subtotal deve ser o segundo maior, e o desconto deve ser o menor.
Situação 2: Convenções decimais inconsistentes dentro de um único documento. Algumas faturas misturam formatos, usando ponto como separador decimal em uma seção e vírgula em outra. Isso é raro, mas existe, tipicamente em faturas transfronteiriças onde o layout do documento foi montado a partir de vários modelos regionais. Nesses casos, nenhuma regra de formato única funciona para o documento inteiro. A solução é uma revisão manual dos campos onde a mistura de formatos aparece, combinada com uma regra de sinalização que alerta você quando itens de linha e totais usam padrões de separador diferentes.
Em ambos os casos extremos, culpar a ferramenta perde o ponto. O documento de origem em si carrega uma ambiguidade com a qual qualquer sistema automatizado teria dificuldade, então o trabalho se desloca para projetar seu fluxo de validação em torno disso.
Perguntas Frequentes
Quando o meu total extraído está errado, devo assumir que a IA cometeu um erro aleatório?
Não. Erros de extração em campos numéricos seguem padrões previsíveis. Verifique primeiro a especificidade do nome da sua coluna: "Total" é ambíguo na maioria das faturas. Se o número correto aparece no documento, mas não é o que a IA retornou, a causa raiz é quase certamente o design de campo ambíguo (Causa Raiz 1). Se o número em si contém caracteres inesperados (letras onde deveriam haver dígitos), é confusão de caracteres (Causa Raiz 2). Se a magnitude estiver errada por aproximadamente 1.000x, é um problema de separador decimal (Causa Raiz 3). Cada uma tem uma correção diferente, mas nenhuma deve ser tratada como ruído aleatório.
Posso usar o mesmo nome de coluna "Total" se eu sempre quiser o grand total?
Você pode, mas obterá resultados errados em qualquer fatura onde o total for ambíguo. "Total" é o nome de campo mais sobrecarregado na extração de documentos. Uma coluna chamada "Total Amount Due" ou "Grand Total (após impostos)" elimina a ambiguidade sem esforço extra da sua parte. A IA usa o nome da sua coluna como sinal de busca principal, então quanto mais preciso o sinal, menos espaço para interpretação.
Um hardware de IA melhor resolve a confusão de caracteres entre 5/S ou 0/O?
Não. A confusão de caracteres é uma ambiguidade visual fundamental, não uma limitação de hardware. Um modelo de visão de última geração e um mecanismo básico de OCR enfrentam a mesma ambiguidade 5/S quando o caractere tem 9 pixels de altura em um scan compactado. A correção é a validação pós-extração: verifique se campos somente numéricos contêm apenas dígitos, aplique verificações de intervalo e use cálculos entre campos para detectar valores inconsistentes. Trocar por um modelo mais forte não ajuda, e pode piorar as coisas ao retornar um valor incorreto com mais confiança.
Minha fatura europeia tem €1.234,56, mas a extração retorna 1.234. O que aconteceu?
A IA provavelmente interpretou o ponto como separador decimal e a vírgula como separador de milhar, seguindo a convenção dos EUA, o que truncou a parte decimal completamente. O valor "1.234,56" no formato europeu significa mil duzentos e trinta e quatro e 56/100. Lido no formato dos EUA, o ponto vira o separador decimal (tornando o valor 1.234, ou aproximadamente um e um quarto) e a vírgula vira o separador de milhar, que é ignorado em um número de quatro dígitos. Configure seu lote para o formato decimal europeu informando ao sistema que a vírgula é o separador decimal e execute novamente.
Devo adicionar revisão manual para cada extração, ou apenas quando os números parecerem suspeitos?
Revisão direcionada é melhor que revisão geral. Aplique três regras a cada lote: (1) sinalize qualquer total extraído que fique fora de um intervalo definido (por exemplo, 3 desvios padrão da média histórica do fornecedor), (2) sinalize qualquer lote onde subtotal + tax ≠ total por mais de uma pequena tolerância (por exemplo, $0.50), e (3) sinalize qualquer campo apenas numérico que contenha caracteres não numéricos. Essas três regras capturam a grande maioria dos erros de números errados sem exigir que você inspecione cada linha individualmente. Revisão manual apenas nos itens sinalizados mantém sua produtividade alta enquanto captura os erros que importam.
Como a Extração de Colunas Personalizadas lida com nomes de campos ambíguos de forma diferente das ferramentas baseadas em modelo?
Extração de Colunas Personalizadas trata cada nome de coluna como uma consulta de busca semântica, não uma regra baseada em posição. Quando você digita "Total Amount Due," a IA busca em todo o documento um valor que corresponda a esse significado específico, o valor final a pagar após todas as adições e deduções. Uma ferramenta baseada em modelo, por outro lado, olha para uma zona de coordenadas pré-registrada na página. A abordagem de zona de coordenadas funciona bem quando o total nunca se move; a Extração de Colunas Personalizadas funciona bem quando o total se move, mas seu significado permanece o mesmo.
O mesmo lote pode conter faturas de fornecedores dos EUA e europeus com formatos de número diferentes?
Pode, mas você precisará lidar com a variação de formato downstream. A IA extrai os números como os vê na página e não normaliza automaticamente as convenções de formato dentro de um lote. Para lotes de formato misto, a abordagem prática é processar documentos dos EUA e europeus separadamente, aplicando a regra de formato correspondente a cada grupo, ou normalizar os separadores em uma etapa de pós-processamento antes que os valores cheguem ao seu sistema contábil. Para uma análise mais profunda dos tipos de obstáculos de escrita e caracteres que as ferramentas de extração enfrentam, veja nosso artigo complementar sobre por que o OCR tem dificuldades com caligrafia e como corrigir isso.
Números extraídos errados são frustrantes, mas quase nunca são aleatórios. Eles se enquadram em uma de três categorias previsíveis: design de campo ambíguo, confusão de caracteres ou variação de formato. O primeiro lugar para olhar é o design do campo, e cada categoria tem uma correção específica que não exige trocar de ferramenta ou retreinar um modelo. Na próxima vez que um total voltar errado, não pergunte "por que a IA é ruim com números." Pergunte "qual das três causas raiz é esta, e qual é a correção mais barata?" A resposta geralmente é um nome de coluna mais específico ou uma única regra de validação, e nenhuma custa mais do que alguns segundos de pensamento.
Teste a abordagem em seus próprios documentos. Envie uma fatura que você sabe que causou um erro de número errado, defina as colunas com máxima especificidade, usando "Grand Total After Tax" em vez de "Total," e veja se o resultado muda. Experimente a extração em seus próprios documentos e veja se três minutos por documento se tornam dez segundos.