Cómo corregir números extraídos incorrectamente:
3 causas raíz que puede diagnosticar hoy
Cuando su extracción con IA calcula mal el total de una factura por $200, rara vez el problema es la IA. La mayoría de estos errores se remontan a errores de diseño de campo: cómo se nombraron y definieron las columnas que solicitó. Esa parte está bajo su control, y solo toma unos minutos diagnosticarla.
Conclusiones clave
- Cuando el total extraído de una factura difiere por $200, su primer instinto es "la IA es mala con los números", pero tres causas raíz distintas producen este error, y ninguna es ruido aleatorio.
- Una columna llamada "Total" se asigna a cinco montos diferentes en una sola factura (subtotal, tax, grand total, discount, shipping), por lo que el modelo tiene que adivinar cuál quiso decir.
- Cambie el nombre de "Total" a "Grand Total After Tax" y agregue tres reglas de validación (verificación solo numérica, verificación de rango, verificación matemática). La mayoría de los errores de números incorrectos aparecen antes de llegar a su sistema contable, y la verificación matemática puede ejecutarse durante la extracción en lugar de en su hoja de cálculo.
La IA no es mala con los números: los nombres de sus campos son los culpables
Esta es una situación que la mayoría de las personas que trabajan con extracción por IA encuentran al menos una vez: sube una factura claramente legible, la herramienta devuelve cada campo con confianza, y luego lo detecta: la columna «Total» muestra $1,247.30 cuando el total real de la factura es $1,447.30. El Subtotal, el Tax, las líneas de los artículos se ven bien. Pero el único número que más importa está desviado por $200.
Los totales extraídos incorrectamente rara vez son aleatorios. Siguen patrones predecibles, por lo que normalmente puede diagnosticar y corregir uno sin cambiar de herramienta. En todos los documentos que procesamos, las mismas tres causas explican casi todos los números incorrectos que vemos.
El costo se traslada aguas abajo. Un total incorrecto que ya se registró toma minutos de rastrear y corregir, y el proceso automatizado termina creando más trabajo de limpieza del que ahorró. La solución, sin embargo, rara vez requiere un motor de IA diferente. Requiere saber a cuál de las tres categorías de causa raíz pertenece su error.
Extracción de Columnas Personalizadas es el mecanismo en el que se basa este diagnóstico. Escribe los nombres de los campos que desea, y la IA localiza cada valor correspondiente en cualquier parte de la página al comprender qué significa la etiqueta en lugar de dónde se encuentra. Esa es también la razón por la que el diseño de los campos tiene tanto peso: la IA trabaja a partir de la etiqueta exacta que usted le dio, y una etiqueta precisa le deja poco margen para elegir el número incorrecto. Las tres categorías de causa raíz a continuación explican prácticamente todos los errores de números incorrectos, y cada una tiene su propia prueba de diagnóstico.
Causa raíz 1: diseño de campo ambiguo — «Total» no es lo suficientemente específico
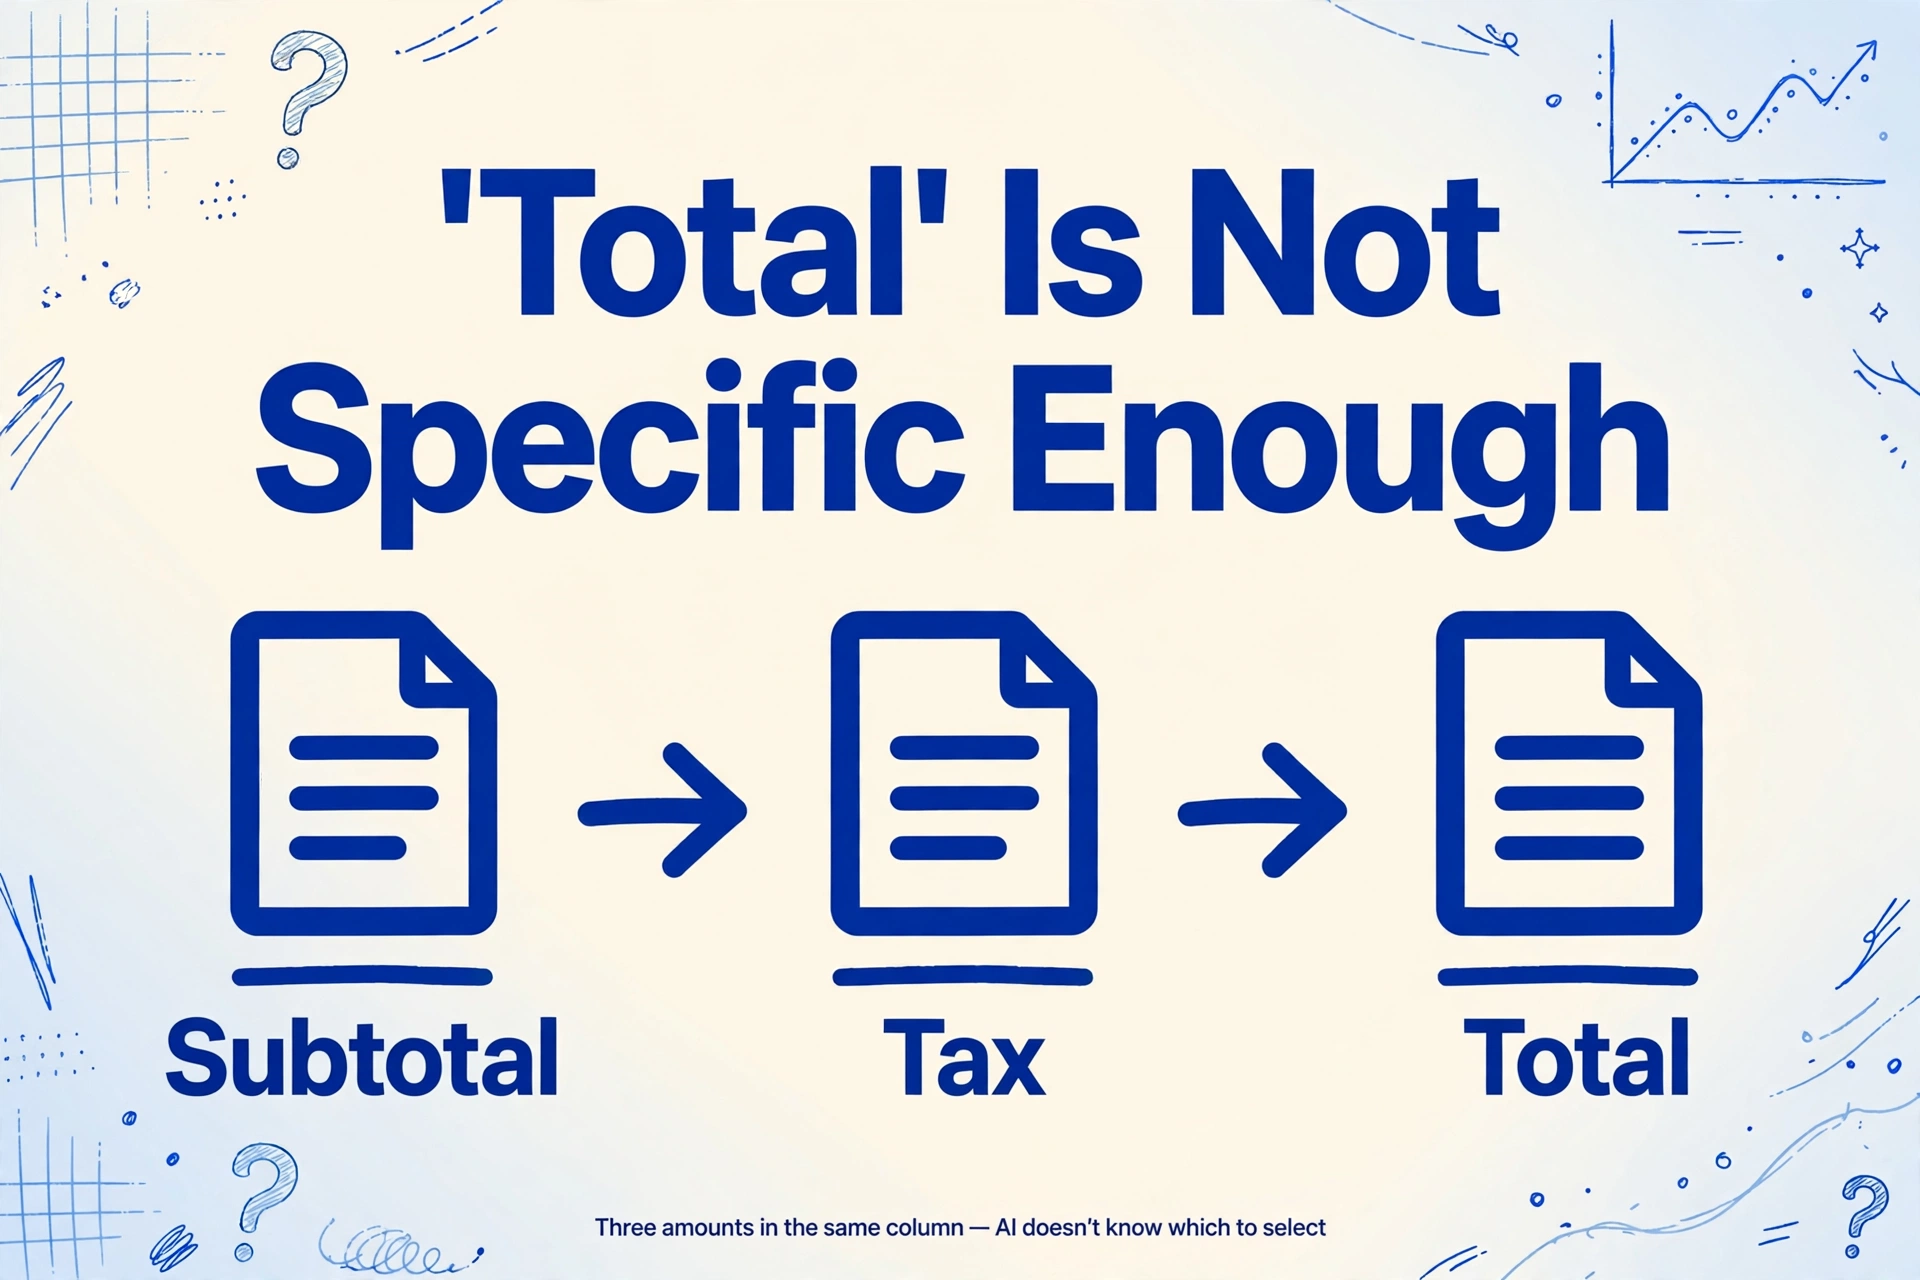
Síntomas: El total extraído no es el total que espera. Puede ser el subtotal. Puede ser el monto después de un descuento que no notó. Puede ser el total con impuestos incluidos cuando quería el monto neto. Pero el número en sí es legible y aparece en la factura: simplemente es el incorrecto entre varios montos disponibles.
Por qué sucede: La sección de totales de una factura típica contiene al menos tres campos monetarios apilados verticalmente: Subtotal, Tax (o VAT/GST) y Total. Muchas facturas también incluyen Discount, Shipping o Previous Balance en la misma columna. Si su columna de extracción se llama «Total», la IA tiene que adivinar cuál de estos montos quiere decir. La palabra «Total» es una etiqueta de campo válida en el documento, pero también es la palabra que aparece en «Subtotal» y el área general donde también se encuentran «Tax» y «Shipping». La IA no tiene conocimiento nativo de cuál total le importa: lee la etiqueta que usted le da y encuentra la mejor coincidencia semántica en la página. Cuando una etiqueta se asigna a cinco valores posibles, la tasa de error aumenta.
Esta no es una limitación exclusiva de ningún motor de IA en particular. Esto es lo que sucede dentro de un modelo de lenguaje-visión cuando procesa una solicitud de columna ambigua: ve la palabra «Total» en su definición de columna, escanea la sección de totales, encuentra tres o cuatro números que todos parecen coincidir de manera plausible (el subtotal está una línea arriba del tax, el grand total una línea abajo) y elige el que tiene la señal semántica y posicional más fuerte. En la mayoría de las facturas, eso funciona bien. En facturas donde el subtotal y el total tienen un tamaño de fuente similar y están separados por solo una línea de espacio en blanco, la confianza del modelo para cualquiera de las opciones puede ser casi igual. El resultado es un lanzamiento de moneda que parece una respuesta incorrecta y segura en la salida.
Cómo solucionarlo: Sea específico sobre qué monto desea. En lugar de una columna llamada "Total", use una de estas:
- "Total Amount Due": sin ambigüedad, aparece en la mayoría de las facturas como el monto final a pagar
- "Grand Total (after tax)": el sufijo le indica a la IA que este es el número final después de todas las adiciones
- "Subtotal (before tax)": excluye explícitamente los valores que incluyen impuestos
- "Amount Paid" / "Balance Due": distingue el pago de los montos pendientes en los estados de cuenta
Cuanto más específico sea el nombre de su columna, menos candidatos tendrá la IA para elegir. Así es como se supone que funciona la extracción, no es un trabajo alternativo. Cómo la IA moderna distingue los campos de facturas por significado, no por posición explica por qué la especificidad de las etiquetas controla directamente la precisión de la extracción a nivel de campo.
Para probar si este es su problema: mire la factura junto con su resultado de extracción. Encuentre el valor que la IA devolvió para "Total" y el valor en el documento que coincida con él. Si son iguales pero ese valor resulta ser el subtotal o el total con impuestos incluidos, tiene un problema de ambigüedad, y la solución no cuesta nada más que un nombre de columna más específico. Una vez que los nombres sean correctos, extraer campos específicos de facturas a Excel es el siguiente paso.
Causa raíz 2: Confusión de caracteres — cuando el 5 se convierte en S y el 0 en O
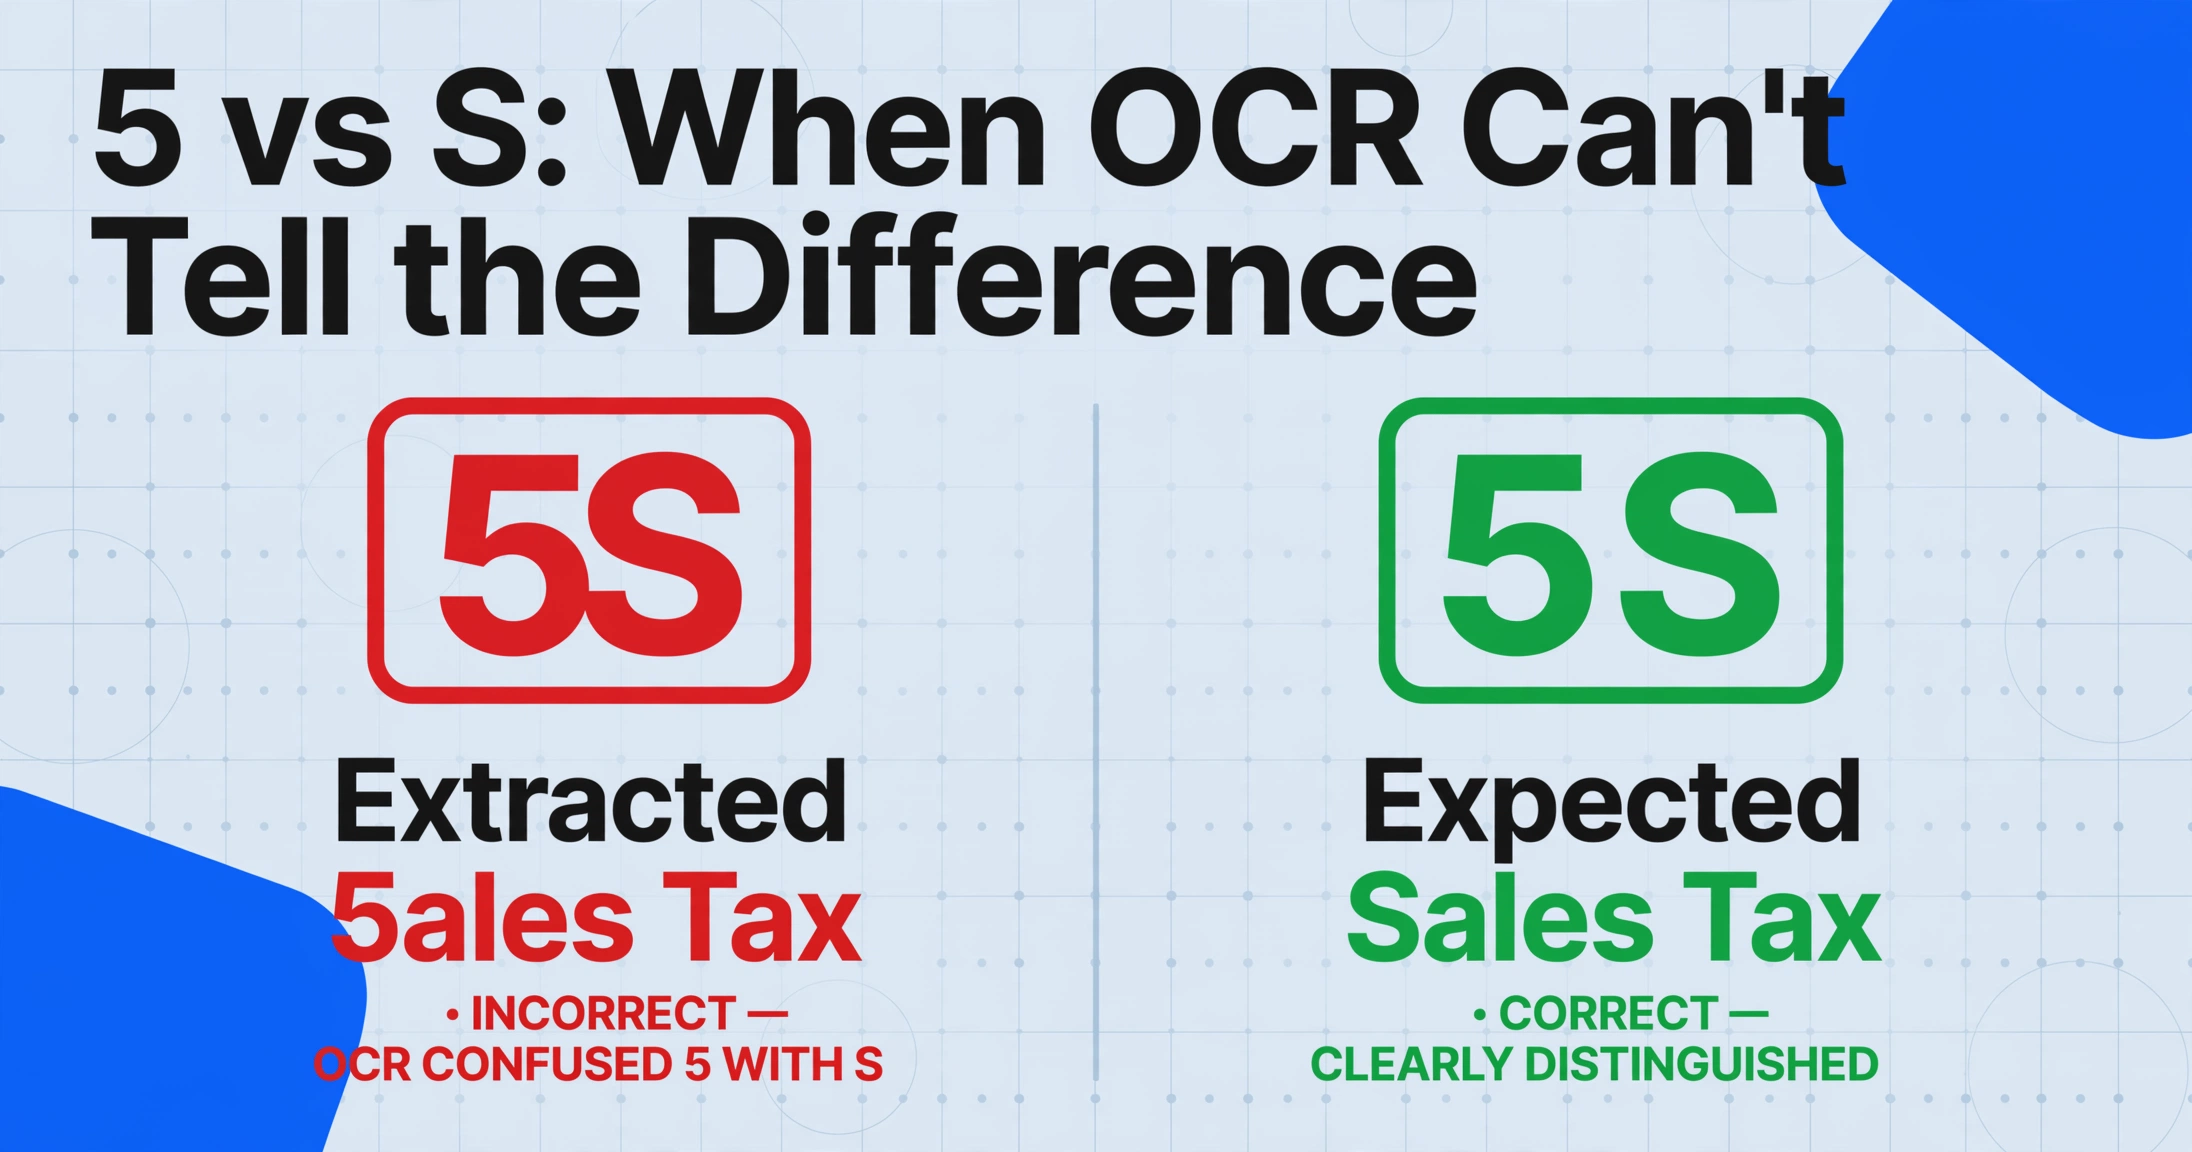
Síntomas: Un número en el resultado extraído contiene una letra donde debería haber un dígito — "5" extraído como "S", "0" como "O", "1" como "l" o "7". El error es consistente en documentos similares de la misma fuente. El número está mal en una o dos posiciones, pero la magnitud parece aproximadamente correcta.
Por qué sucede: Los motores OCR y los modelos de visión analizan ambas las formas de píxeles de los caracteres. Algunos pares de caracteres comparten perfiles visuales casi idénticos en tamaños de fuente y resoluciones de escaneo comunes:
| Par | Por qué el OCR los confunde |
|---|---|
| 5 / S | La parte superior e inferior curvadas se ven casi idénticas en fuentes pequeñas o escaneos de bajo contraste |
| 0 / O | Ambos aparecen como una forma redonda o elíptica; la barra diagonal del cero a menudo falta en las fuentes |
| 1 / l / 7 | Los trazos verticales delgados se colapsan en el mismo perfil visual a baja resolución |
| 8 / B | Los bucles internos son visualmente similares cuando el escaneo está ligeramente borroso |
| 6 / G | La cola de la G y el bucle del 6 son casi indistinguibles en tamaños pequeños |
Este no es un problema que una mejor IA pueda eliminar por completo. Incluso los modelos de visión de última generación tienen una confianza casi igual para "5" y "S" cuando el carácter aparece a 9 píxeles de alto con artefactos de compresión. El cerebro humano resuelve estas ambigüedades usando el contexto a nivel de palabra — usted sabe que "5ales Tax" está mal porque "Sales Tax" es un término conocido. Un motor OCR no tiene ese conocimiento a nivel de palabra a menos que haya sido entrenado específicamente para esperar palabras de diccionario en ciertos campos.
Cómo solucionarlo: La confusión de caracteres se detecta mejor después de la extracción, no durante ella. Implemente reglas de validación a nivel de campo que verifiquen el valor extraído contra patrones esperados:
- Campos solo numéricos: Si un campo debe contener solo dígitos (número de factura, número de orden de compra, código de cuenta), ejecute una verificación regex simple. Cualquier carácter extraído que no sea un dígito en un campo solo numérico es casi con certeza una lectura incorrecta. Reemplace "S" por "5", "O" por "0", "l" por "1" en ese contexto.
- Verificaciones de rango: Si un total extraído es $5,000.00 pero todas las demás facturas de ese proveedor están en el rango de $200–$800, márquelo para revisión. Un número atípico suele ser el resultado de un decimal mal colocado o de una lectura incorrecta de un carácter que infló un valor en un orden de magnitud.
- Validación matemática entre campos: Verifique si subtotal + impuesto = total. Si la operación no cuadra dentro de una pequeña tolerancia, al menos uno de los tres números contiene un error a nivel de carácter. Esta única verificación detecta la mayoría de los errores de confusión de caracteres porque un dígito mal leído en cualquiera de los tres totales rompe la relación aritmética.
El procesamiento inteligente de datos posterior de ImageToTable.ai maneja automáticamente la mitad del formato, estandarizando fechas, montos y números de serie para que un valor llegue en una forma consistente. La mitad matemática puede ejecutarse durante la extracción en lugar de en su hoja de cálculo: describa el cálculo en un nombre de columna, por ejemplo "Verificación de Impuesto (Subtotal + Impuesto = Total)", e ImageToTable.ai lo realiza mientras lee el documento, generando un aprobado, un fallo o la diferencia. Cuando subtotal + impuesto no coincide con el total impreso, esa discrepancia llega como un valor en la fila correspondiente en lugar de como una fórmula que aún debe construir.
Causa Raíz 3: Variación de Formato — 1.234,56 vs 1,234.56
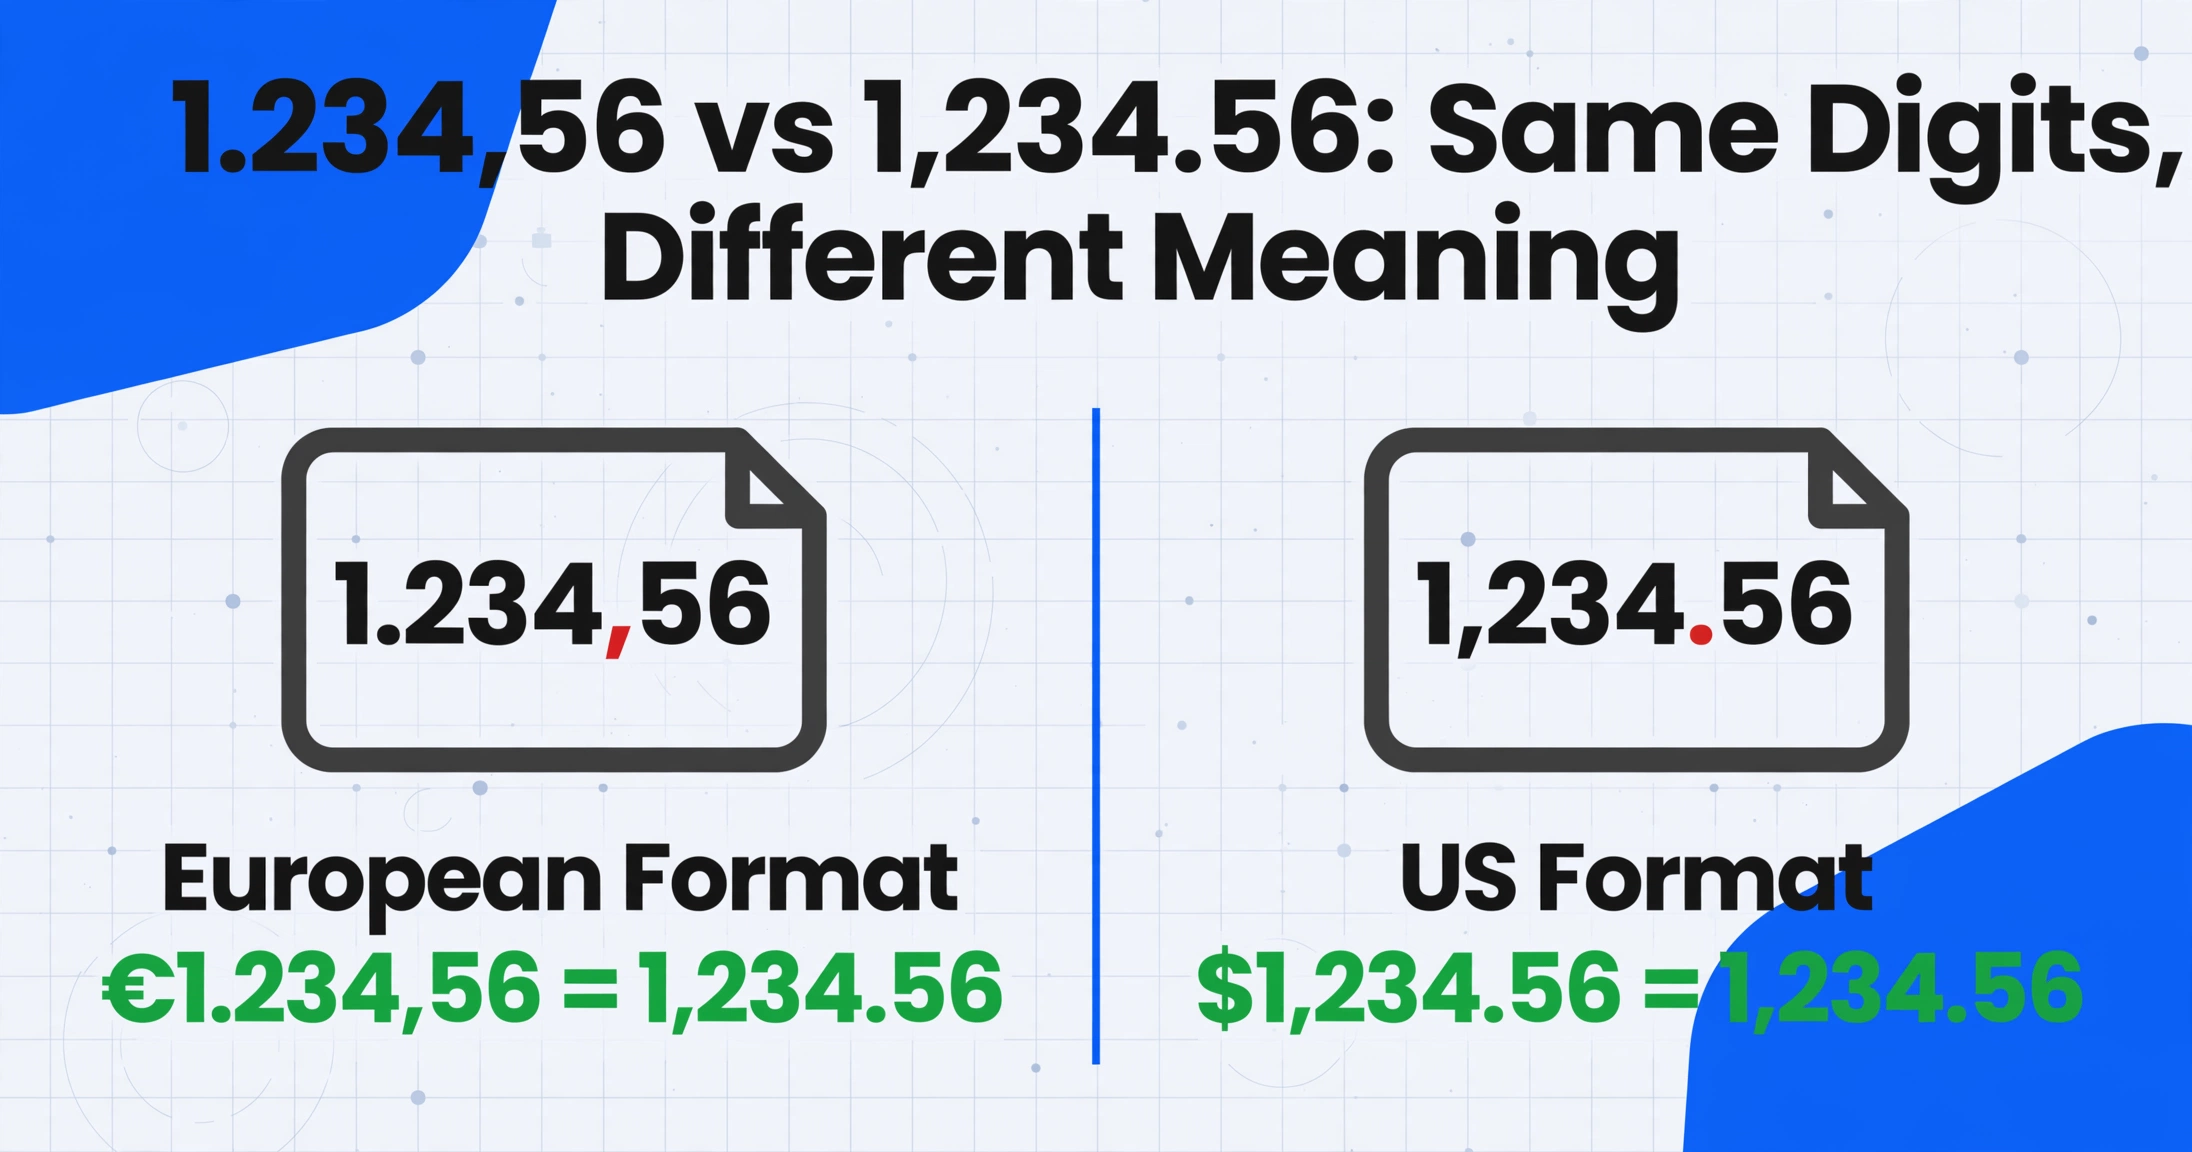
Síntomas: El número extraído está desviado por tres órdenes de magnitud. Un total de €1.234,56 en una factura europea se extrae como 1.234, o peor, como 1,234.56 (que en notación europea significa mil doscientos treinta y cuatro y 56/100). Las fechas también se ven afectadas: 03/04/2026 se lee como 4 de marzo en un sistema estadounidense cuando la factura claramente indica el 3 de abril.
Por qué sucede: La mayor parte de Europa continental, gran parte de Sudamérica y partes de África y Asia usan la coma como separador decimal y el punto como separador de miles. Estados Unidos, el Reino Unido y algunos otros países invierten esta convención. Un motor de extracción de IA que procesa una factura alemana (€1.234,56) y una factura estadounidense ($1,234.56) en el mismo lote ve dos números que parecen estructuralmente idénticos pero significan cosas completamente diferentes.
Aquí está la parte sutil: la IA no sabe qué convención sigue el documento a menos que se lo indique, porque el patrón visual es el mismo: un número con dos separadores. El modelo ve "1.234,56" y no tiene forma inherente de saber si el punto es un separador de miles (europeo) o un punto decimal (inusual pero posible en algunos formatos).
Cómo solucionarlo: Las reglas de validación posteriores a la extracción hacen el trabajo real para la variación de formato, porque la comprensión visual de la IA no puede resolver una ambigüedad que es cultural y no visual.
- Configure una regla de separador decimal por fuente de documento. Si procesa facturas de proveedores alemanes, defina la coma como separador decimal para ese grupo de documentos. El post-procesamiento de datos de ImageToTable.ai estandariza los formatos de fecha, monto y número de serie como parte de la salida, por lo que los valores exportados siguen la convención que usted establezca.
- Aplique verificaciones de rango basadas en rangos. Si un "Total" extraído es 1.234 (mil doscientos treinta y cuatro según el formato europeo) pero los elementos de línea suman alrededor de 1.234,56 (mil doscientos treinta y cuatro y 56 centavos), es probable que la IA haya omitido la parte decimal. Una verificación de rango que compare el total extraído con la suma de los elementos de línea detecta esto de inmediato.
- Use verificaciones de consistencia matemática. Igual que en la Causa Raíz 2: subtotal + impuesto = total. Si el separador decimal se interpretó mal, las matemáticas no cuadrarán y sabrá que debe reexaminar el formato antes de que el error se propague.
Un motor OCR más potente no resuelve esto, porque la ambigüedad es cultural, no visual. Lo que funciona es una capa de validación que verifique el número parseado contra el resto del documento antes de que el valor avance.
Cuándo Escalar: Los Casos Límite que Ni las Buenas Herramientas Pueden Resolver
La honestidad importa aquí. No todos los errores de números tienen una solución a nivel de nombre de campo. Hay dos situaciones donde incluso la mejor extracción con IA, con los nombres de columna más específicos y el post-procesamiento más exhaustivo, seguirá produciendo salidas incorrectas con cierta frecuencia.
Situación 1: Filas de totales adyacentes con formato idéntico. Cuando una factura lista "Subtotal", "Discount", "Tax" y "Total" en la misma columna alineada a la derecha, usando el mismo tamaño de fuente y el mismo peso de fuente, sin separador visual entre ellos, cualquier motor de IA enfrenta un problema genuino de ambigüedad. Las señales que el modelo usa para desambiguar campos, como tamaño de fuente, espacios en blanco y posición de la etiqueta, son débiles o contradictorias aquí. En ese caso, el enfoque práctico es extraer los cuatro valores (defina columnas para cada uno) y resolver cuál es cuál en su hoja de cálculo posterior basándose en relaciones esperadas: el total debe ser el número más grande, el subtotal el segundo más grande, y el descuento el más pequeño.
Situación 2: Convenciones decimales inconsistentes dentro de un solo documento. Algunas facturas mezclan formatos, usando un punto como separador decimal en una sección y una coma en otra. Esto es raro pero existe, típicamente en facturas transfronterizas donde el diseño del documento se ha ensamblado a partir de múltiples plantillas regionales. En estos casos, ninguna regla de formato única funciona para todo el documento. La solución es una revisión manual de los campos donde aparece la mezcla de formatos, combinada con una regla de marcado que le alerte cuando los elementos de línea y los totales usen patrones de separador diferentes.
En ambos casos límite, culpar a la herramienta no resuelve el problema. El documento fuente en sí mismo lleva una ambigüedad con la que cualquier sistema automatizado tendría dificultades, por lo que el trabajo se traslada a diseñar su flujo de validación en torno a ello.
Preguntas Frecuentes
Cuando el total extraído es incorrecto, ¿debo asumir que la IA cometió un error aleatorio?
No. Los errores de extracción en campos numéricos siguen patrones predecibles. Primero revise la especificidad del nombre de su columna: "Total" es ambiguo en la mayoría de las facturas. Si el número correcto aparece en el documento pero no es el que devolvió la IA, la causa raíz es casi con certeza la ambigüedad del campo (Causa Raíz 1). Si el número en sí contiene caracteres inesperados (letras donde debería haber dígitos), es confusión de caracteres (Causa Raíz 2). Si la magnitud difiere aproximadamente por 1,000x, es un problema de separador decimal (Causa Raíz 3). Cada caso tiene una solución diferente, pero ninguno debe tratarse como ruido aleatorio.
¿Puedo usar el mismo nombre de columna "Total" si siempre quiero el Grand Total?
Puede hacerlo, pero obtendrá resultados incorrectos en cualquier factura donde el total sea ambiguo. "Total" es el nombre de campo más sobrecargado en la extracción de documentos. Una columna llamada "Total Amount Due" o "Grand Total (after tax)" elimina la ambigüedad sin esfuerzo adicional de su parte. La IA usa el nombre de su columna como su principal señal de búsqueda, así que cuanto más precisa sea la señal, menos margen de interpretación.
¿Un mejor hardware de IA resuelve la confusión de caracteres entre 5/S o 0/O?
No. La confusión de caracteres es una ambigüedad visual fundamental, no una limitación de hardware. Un modelo de visión de última generación y un motor OCR básico enfrentan la misma ambigüedad 5/S cuando el carácter tiene 9 píxeles de alto en un escaneo comprimido. La solución es la validación posterior a la extracción: verifique que los campos solo numéricos contengan solo dígitos, aplique comprobaciones de rango y use cálculos entre campos para detectar valores inconsistentes. Cambiar a un modelo más potente no ayuda, y puede empeorar las cosas al devolver un valor incorrecto con más confianza.
Mi factura europea tiene €1.234,56 pero la extracción devuelve 1.234. ¿Qué pasó?
La IA probablemente interpretó el punto como separador decimal y la coma como separador de miles, siguiendo la convención estadounidense, lo que truncó por completo la parte decimal. El valor "1.234,56" en formato europeo significa mil doscientos treinta y cuatro y 56/100. Leído como formato estadounidense, el punto se convierte en el decimal (haciendo el valor 1.234, aproximadamente uno y un cuarto) y la coma se convierte en separador de miles, que se ignora en un número de cuatro dígitos. Configure su lote para el formato decimal europeo indicando al sistema que la coma es el separador decimal y vuelva a ejecutarlo.
¿Debo añadir revisión manual para cada extracción, o solo cuando los números parezcan sospechosos?
La revisión selectiva supera a la revisión general. Aplique tres reglas a cada lote: (1) marque cualquier total extraído que quede fuera de un rango definido (p. ej., 3 desviaciones estándar del promedio histórico del proveedor), (2) marque cualquier lote donde subtotal + tax ≠ total por más de una pequeña tolerancia (p. ej., $0.50), y (3) marque cualquier campo solo numérico que contenga caracteres no numéricos. Estas tres reglas detectan la gran mayoría de errores de números incorrectos sin que usted tenga que inspeccionar cada fila. La revisión manual solo de los elementos marcados mantiene su rendimiento alto mientras detecta los errores que importan.
¿Cómo maneja la Extracción de Columnas Personalizadas los nombres de campo ambiguos de manera diferente a las herramientas basadas en plantillas?
Extracción de Columnas Personalizadas trata cada nombre de columna como una consulta de búsqueda semántica, no como una regla basada en posición. Cuando escribe "Total Amount Due," la IA busca en todo el documento un valor que coincida con ese significado específico, el monto final pagadero después de todas las adiciones y deducciones. Una herramienta basada en plantillas, por el contrario, mira una zona de coordenadas previamente registrada en la página. El enfoque de zona de coordenadas funciona bien cuando el total nunca se mueve; la Extracción de Columnas Personalizadas funciona bien cuando el total se mueve pero su significado permanece igual.
¿Puede el mismo lote contener facturas de proveedores estadounidenses y europeos con diferentes formatos de números?
Sí puede, pero tendrá que manejar la variación de formato aguas abajo. La IA extrae los números tal como los ve en la página y no normaliza automáticamente las convenciones de formato dentro de un lote. Para lotes de formato mixto, el enfoque práctico es procesar los documentos estadounidenses y europeos por separado, aplicando la regla de formato correspondiente a cada grupo, o normalizar los separadores en un paso de posprocesamiento antes de que los valores lleguen a su sistema contable. Para un análisis más profundo de los tipos de obstáculos de escritura y caracteres que enfrentan las herramientas de extracción, vea nuestro artículo complementario sobre por qué el OCR tiene dificultades con la escritura a mano y cómo solucionarlo.
Los números extraídos incorrectos son frustrantes, pero casi nunca son aleatorios. Caen en una de tres categorías predecibles: diseño de campo ambiguo, confusión de caracteres o variación de formato. El primer lugar donde buscar es el diseño del campo, y cada categoría tiene una solución específica que no requiere cambiar de herramientas ni reentrenar un modelo. La próxima vez que un total salga incorrecto, no pregunte "por qué la IA es mala con los números." Pregunte "¿cuál de las tres causas raíz es esta, y cuál es la solución más económica?" La respuesta suele ser un nombre de columna más específico o una sola regla de validación, y ninguna cuesta más que unos segundos de pensamiento.
Pruebe el enfoque con sus propios documentos. Suba una factura que sepa que causó un error de número incorrecto, defina las columnas con la máxima especificidad, usando "Grand Total After Tax" en lugar de "Total," y vea si el resultado cambia. Pruebe la extracción con sus propios documentos y vea si tres minutos por documento se convierten en diez segundos.