Comment corriger les numéros extraits erronés :
3 causes racines que vous pouvez diagnostiquer aujourd'hui
Lorsque votre extraction IA se trompe de 200 $ sur le total d'une facture, l'IA est rarement le problème. La plupart de ces erreurs remontent à des erreurs de conception de champs : comment les colonnes que vous avez demandées ont été nommées et définies. Cette partie est sous votre contrôle, et il ne faut que quelques minutes pour la diagnostiquer.
Points clés à retenir
- Lorsqu'un total de facture extrait est faux de 200 $, votre premier réflexe est « l'IA est mauvaise avec les chiffres », mais trois causes racines distinctes produisent cette erreur, et aucune d'elles n'est un bruit aléatoire.
- Une colonne nommée « Total » correspond à cinq montants différents sur une seule facture (sous-total, taxe, total général, remise, expédition), le modèle doit donc deviner lequel vous vouliez.
- Renommez « Total » en « Total général après taxes » et ajoutez trois règles de validation (vérification numérique uniquement, vérification de plage, vérification mathématique). La plupart des erreurs de numéros remontent à la surface avant d'atteindre votre système comptable, et la vérification mathématique peut s'exécuter pendant l'extraction au lieu de dans votre feuille de calcul.
L'IA n'est pas mauvaise en chiffres — ce sont vos noms de champs qui posent problème
Voici une situation que rencontrent la plupart des personnes qui travaillent avec l'extraction par IA au moins une fois : vous téléversez une facture parfaitement lisible, l'outil renvoie chaque champ avec assurance, puis vous le repérez : la colonne « Total » affiche 1 247,30 $ alors que le total réel de la facture est de 1 447,30 $. Le subtotal, la taxe, les lignes d'articles semblent tous corrects. Mais le seul chiffre qui compte le plus est faux de 200 $.
Les totaux extraits incorrects sont rarement aléatoires. Ils suivent des schémas prévisibles, c'est pourquoi vous pouvez généralement les diagnostiquer et les corriger sans changer d'outil. Parmi les documents que nous traitons, les trois mêmes causes expliquent presque tous les chiffres erronés que nous voyons.
Le coût se répercute en aval. Un total erroné déjà comptabilisé prend des minutes à retracer et à corriger, et le processus automatisé finit par créer plus de travail de nettoyage qu'il n'en a économisé. La solution, cependant, requiert rarement un moteur d'IA différent. Elle requiert de savoir à laquelle des trois catégories de causes profondes votre erreur appartient.
Extraction de colonnes personnalisées est le mécanisme sur lequel repose ce diagnostic. Vous saisissez les noms de champs souhaités, et l'IA localise chaque valeur correspondante n'importe où sur la page en comprenant ce que signifie l'étiquette plutôt qu'en se fiant à son emplacement. C'est aussi pourquoi la conception des champs a tant d'importance : l'IA travaille à partir de l'étiquette exacte que vous lui donnez, et une étiquette précise lui laisse peu de marge pour choisir le mauvais chiffre. Les trois catégories de causes profondes ci-dessous expliquent pratiquement toutes les erreurs de chiffres, et chacune a son propre test de diagnostic.
Cause profonde 1 : Conception de champ ambiguë — « Total » n'est pas assez spécifique
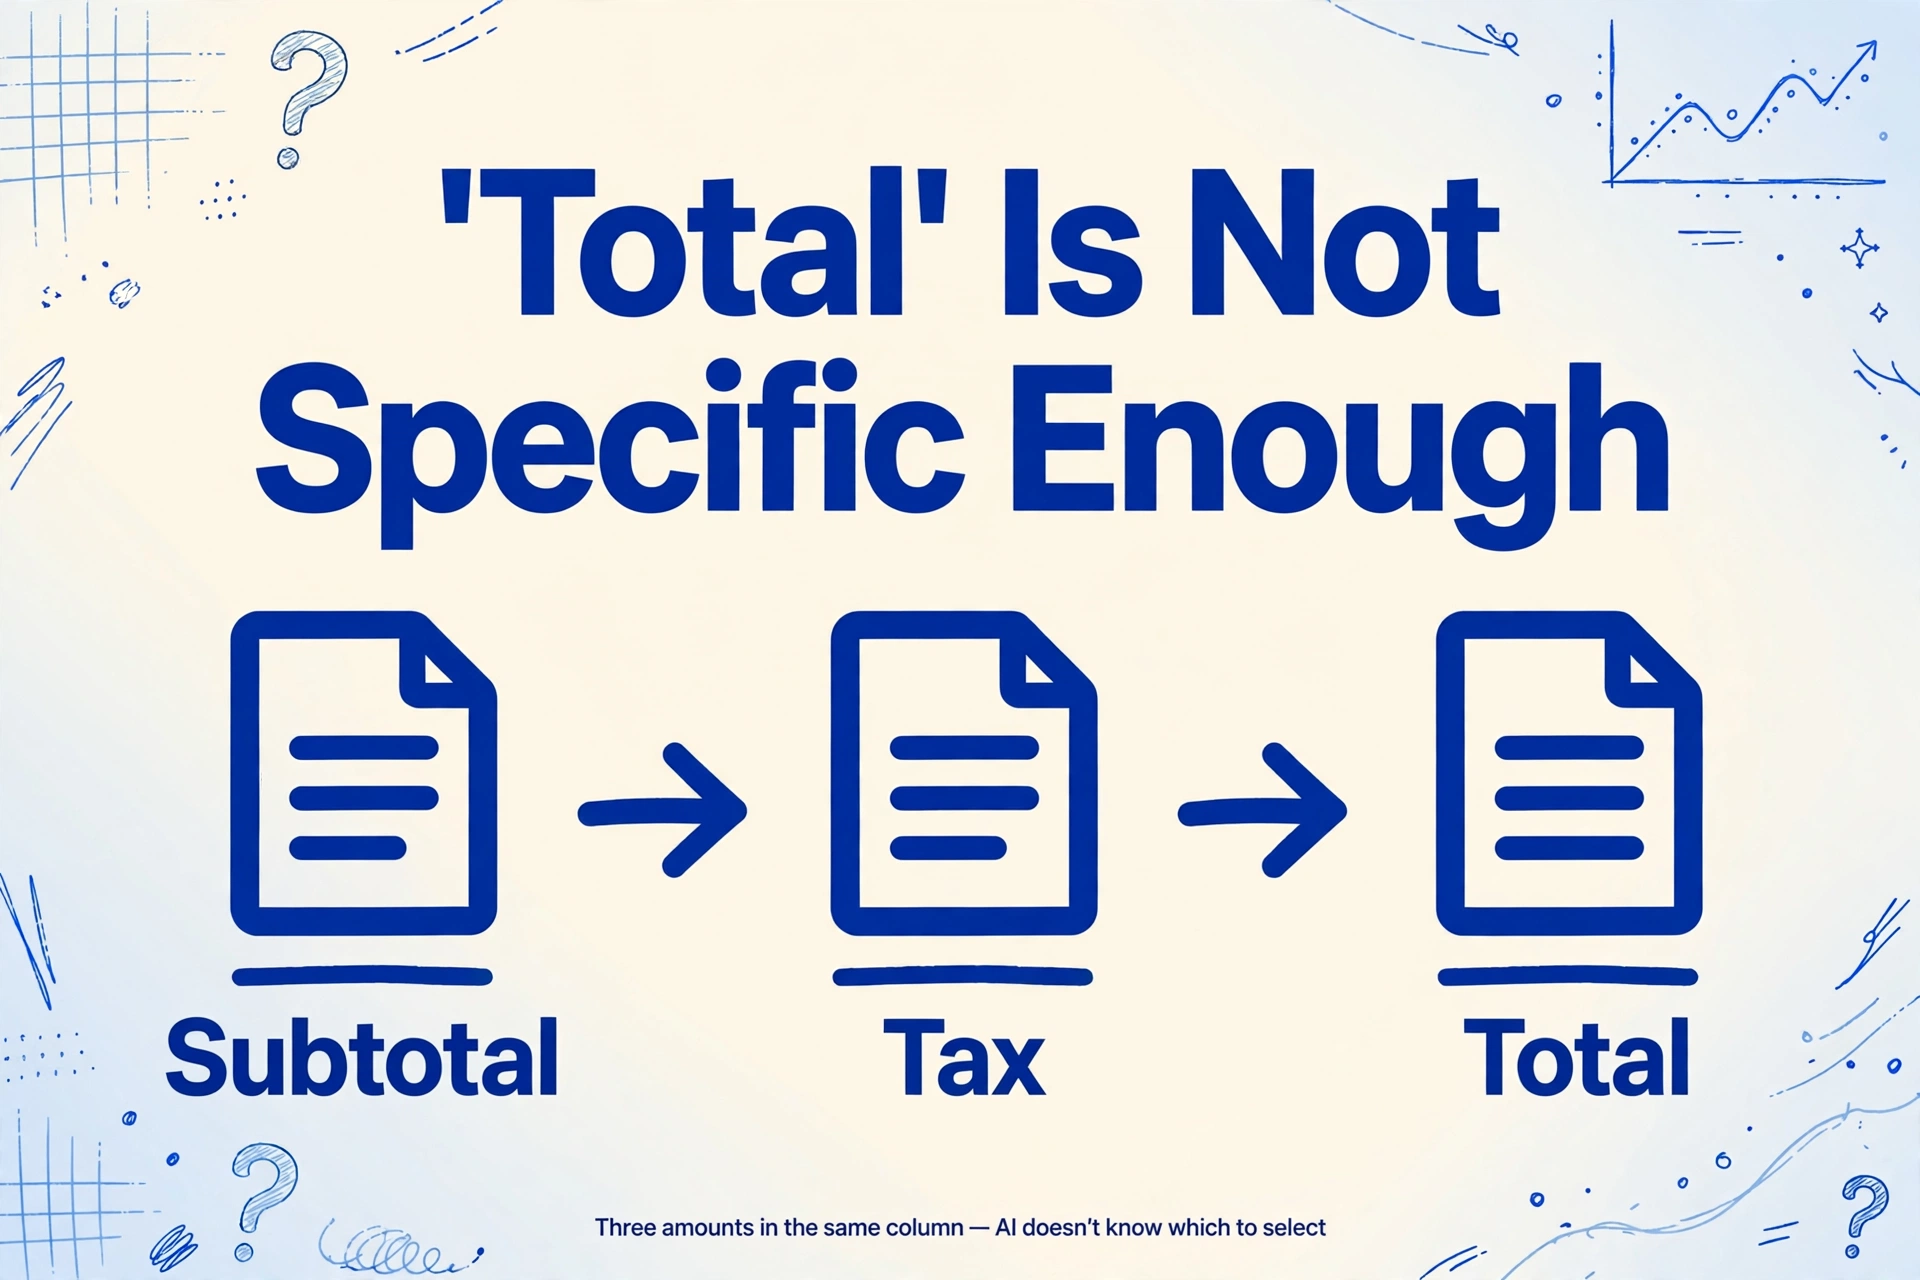
Symptômes : Le total extrait n'est pas le total attendu. Il peut s'agir du subtotal. Il peut s'agir du montant après une remise que vous n'aviez pas remarquée. Il peut s'agir du total taxes incluses alors que vous vouliez le montant net. Mais le chiffre lui-même est lisible et apparaît sur la facture — c'est simplement le mauvais parmi plusieurs montants disponibles.
Pourquoi cela se produit : La section des totaux d'une facture typique contient au moins trois champs monétaires empilés verticalement : Subtotal, Tax (ou TVA/TPS) et Total. De nombreuses factures incluent également des champs Discount, Shipping ou Previous Balance dans la même colonne. Si votre colonne d'extraction est nommée « Total », l'IA doit deviner lequel de ces montants vous voulez. Le mot « Total » est une étiquette de champ valide sur le document, mais c'est aussi le mot qui apparaît dans « Subtotal », et la zone générale où se trouvent également « Tax » et « Shipping ». L'IA n'a pas de connaissance native du total qui vous intéresse — elle lit l'étiquette que vous lui donnez et trouve la meilleure correspondance sémantique sur la page. Lorsqu'une étiquette correspond à cinq valeurs possibles, le taux d'erreur augmente.
Ce n'est pas une limitation propre à un moteur d'IA particulier. Voici ce qui se passe à l'intérieur d'un modèle vision-langage lorsqu'il traite une demande de colonne ambiguë : il voit le mot « Total » dans votre définition de colonne, scanne la section des totaux, trouve trois ou quatre chiffres qui correspondent tous de manière plausible — le subtotal se trouve une ligne au-dessus de la taxe, le grand total une ligne en dessous — et choisit celui qui présente le signal sémantique et positionnel le plus fort. Sur la plupart des factures, cela fonctionne bien. Sur les factures où le subtotal et le total sont proches en taille de police et séparés par une seule ligne d'espace blanc, la confiance du modèle pour l'une ou l'autre option peut être presque égale. Le résultat est un pile ou face qui ressemble à une réponse fausse mais assurée sur la sortie.
Comment corriger : Soyez précis sur le montant que vous souhaitez. Au lieu d'une colonne nommée « Total », utilisez l'une de ces options :
- « Total Amount Due » : sans ambiguïté, apparaît sur la plupart des factures comme le montant final à payer
- « Grand Total (after tax) » : le suffixe indique à l'IA qu'il s'agit du montant final après toutes les additions
- « Subtotal (before tax) » : exclut explicitement les valeurs incluant la taxe
- « Amount Paid » / « Balance Due » : distingue les paiements des montants impayés sur les relevés
Plus le nom de votre colonne est spécifique, moins l'IA a de candidats parmi lesquels choisir. C'est ainsi que l'extraction est censée fonctionner, pas une solution de contournement. Comment l'IA moderne distingue les champs de facture par le sens, pas par la position explique pourquoi la spécificité du libellé contrôle directement la précision de l'extraction au niveau du champ.
Pour tester si c'est votre problème : examinez la facture en parallèle de votre résultat d'extraction. Trouvez la valeur que l'IA a renvoyée pour « Total » et la valeur sur le document qui lui correspond. Si elles sont identiques mais que cette valeur se trouve être le sous-total ou le total incluant la taxe, vous avez un problème d'ambiguïté, et la correction ne coûte rien d'autre qu'un nom de colonne plus précis. Une fois les noms corrects, extraire des champs de facture spécifiques dans Excel est l'étape suivante.
Cause racine 2 : Confusion de caractères — quand 5 devient S et 0 devient O
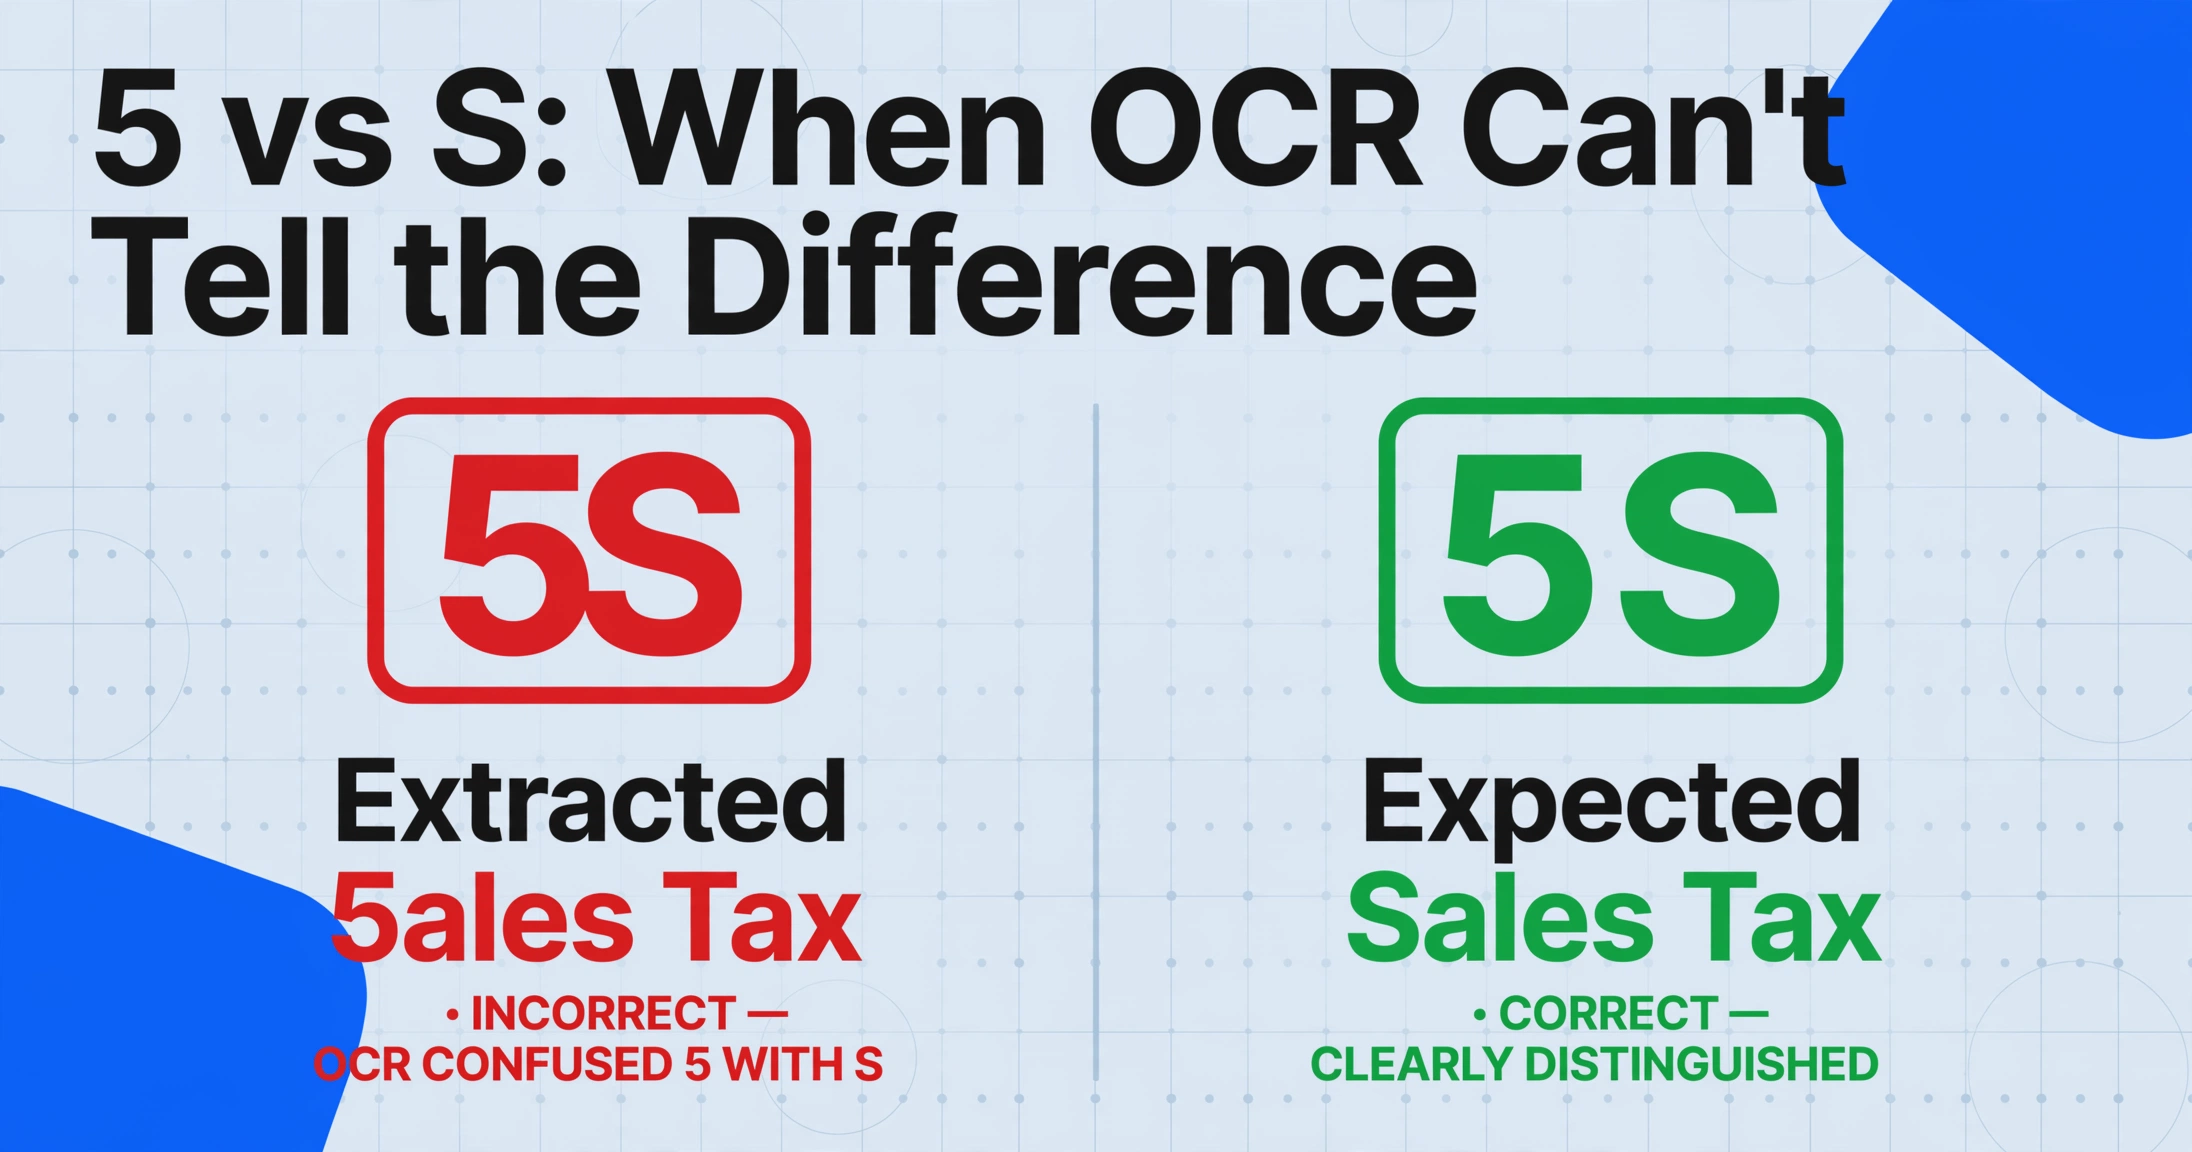
Symptômes : Un nombre dans le résultat extrait contient une lettre là où un chiffre devrait se trouver — « 5 » extrait comme « S », « 0 » comme « O », « 1 » comme « l » ou « 7 ». L'erreur est systématique sur des documents similaires provenant de la même source. Le nombre est faux sur une ou deux positions, mais l'ordre de grandeur semble à peu près correct.
Pourquoi cela se produit : Les moteurs OCR et les modèles de vision analysent tous deux les formes des pixels des caractères. Certaines paires de caractères partagent des profils visuels quasi identiques aux tailles de police et résolutions de numérisation courantes :
| Paire | Pourquoi l'OCR les confond |
|---|---|
| 5 / S | Le haut et le bas incurvés semblent presque identiques dans les petites polices ou les numérisations à faible contraste |
| 0 / O | Les deux apparaissent comme une forme ronde ou elliptique ; la barre diagonale du zéro est souvent absente dans les polices |
| 1 / l / 7 | Les traits verticaux fins se confondent dans le même profil visuel à basse résolution |
| 8 / B | Les boucles internes sont visuellement similaires lorsque la numérisation est légèrement floue |
| 6 / G | La queue du G et la boucle du 6 sont presque impossibles à distinguer aux petites tailles |
Ce n'est pas un problème qu'une meilleure IA peut entièrement éliminer. Même les modèles de vision de pointe ont une confiance quasi égale pour « 5 » et « S » lorsque le caractère apparaît à 9 pixels de haut avec des artefacts de compression. Le cerveau humain résout ces ambiguïtés en utilisant le contexte au niveau du mot — vous savez que « 5ales Tax » est faux parce que « Sales Tax » est un terme connu. Un moteur OCR n'a aucune connaissance au niveau du mot, sauf s'il a été spécifiquement entraîné à attendre des mots de dictionnaire dans certains champs.
Comment corriger : La confusion de caractères est mieux détectée après l'extraction, pas pendant. Implémentez des règles de validation au niveau du champ qui vérifient la valeur extraite par rapport aux modèles attendus :
- Champs numériques uniquement : Si un champ ne doit contenir que des chiffres (numéro de facture, numéro de bon de commande, code de compte), effectuez une simple vérification par expression régulière. Tout caractère extrait qui n'est pas un chiffre dans un champ numérique est presque certainement une erreur de lecture. Remplacez « S » par « 5 », « O » par « 0 », « l » par « 1 » dans ce contexte.
- Vérifications de plage : Si un total extrait est de 5 000,00 $ mais que toutes les autres factures de ce fournisseur se situent entre 200 et 800 $, signalez-le pour examen. Un nombre aberrant isolé est souvent le résultat d'une virgule mal placée ou d'une erreur de lecture de caractère qui a gonflé une valeur d'un ordre de grandeur.
- Validation mathématique croisée : Vérifiez si sous-total + taxe = total. Si le calcul ne tombe pas juste avec une petite tolérance, au moins un des trois nombres contient une erreur au niveau des caractères. Cette seule vérification détecte la majorité des erreurs de confusion de caractères, car un chiffre mal lu dans l'un des trois totaux rompt la relation arithmétique.
Le post-traitement intelligent des données d'ImageToTable.ai gère automatiquement la moitié du formatage, en normalisant les dates, les montants et les numéros de série afin qu'une valeur arrive sous une forme cohérente. La moitié mathématique peut être exécutée pendant l'extraction au lieu de l'être dans votre feuille de calcul : décrivez le calcul dans un nom de colonne, par exemple "Vérification de la taxe (Sous-total + Taxe = Total)", et ImageToTable.ai l'effectue pendant la lecture du document, en produisant une réussite, un échec ou la différence. Lorsque le sous-total + la taxe ne correspondent pas au total imprimé, cet écart arrive comme une valeur sur la ligne concernée plutôt que comme une formule que vous devez encore construire.
Cause racine 3 : Variance de format — 1.234,56 contre 1,234.56
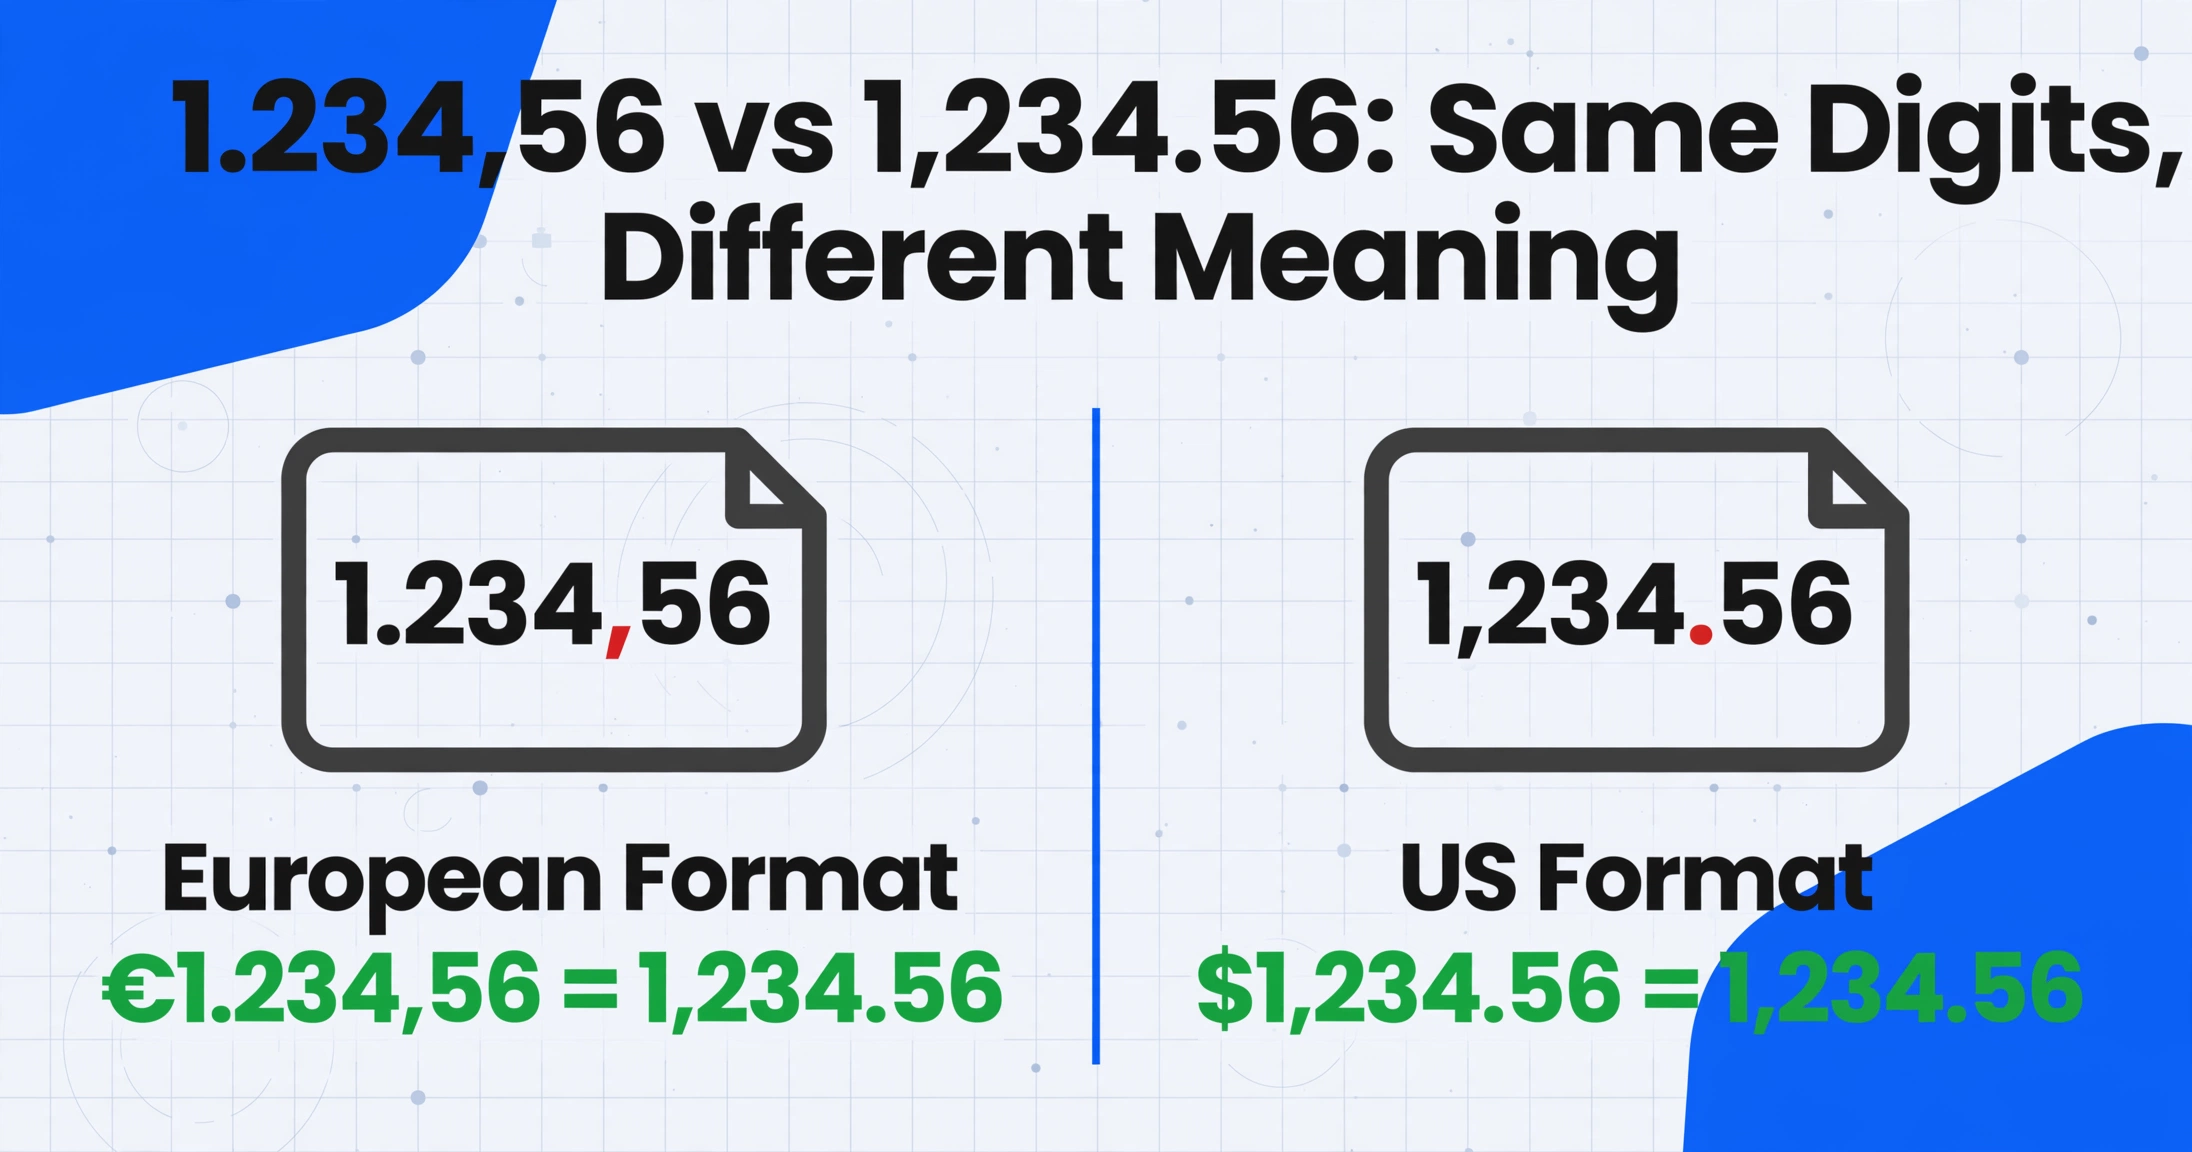
Symptômes : Le nombre extrait est décalé de trois ordres de grandeur. Un total de 1.234,56 € sur une facture européenne est extrait comme 1.234, ou pire, comme 1,234.56 (ce qui, en notation européenne, signifie mille deux cent trente-quatre et 56/100). Les dates sont également affectées : 03/04/2026 est lu comme le 4 mars par un système basé aux États-Unis alors que la facture indique clairement le 3 avril.
Pourquoi cela se produit : La majeure partie de l'Europe continentale, la majeure partie de l'Amérique du Sud et certaines parties de l'Afrique et de l'Asie utilisent la virgule comme séparateur décimal et le point comme séparateur de milliers. Les États-Unis, le Royaume-Uni et quelques autres pays inversent cette convention. Un moteur d'extraction IA qui traite une facture allemande (1.234,56 €) et une facture américaine (1 234,56 $) dans le même lot voit deux nombres qui semblent structurellement identiques mais qui signifient des choses complètement différentes.
Voici la partie subtile : l'IA ne sait pas quelle convention le document suit, à moins que vous ne le lui disiez, car le motif visuel est le même — un nombre avec deux séparateurs. Le modèle voit « 1.234,56 » et n'a aucun moyen inhérent de savoir si le point est un séparateur de milliers (européen) ou un point décimal (inhabituel mais possible dans certains formats).
Comment y remédier : Les règles de validation post-extraction font le vrai travail pour la variance de format, car la compréhension visuelle de l'IA ne peut pas résoudre une ambiguïté qui est culturelle plutôt que visuelle.
- Configurez une règle de séparateur décimal par source de document. Si vous traitez des factures de fournisseurs allemands, définissez la virgule comme séparateur décimal pour ce groupe de documents. Le post-traitement des données d'ImageToTable.ai standardise les formats de date, de montant et de numéro de série dans le résultat, de sorte que les valeurs exportées suivent la convention que vous avez définie.
- Appliquez des vérifications de plausibilité par plage. Si un « Total » extrait est 1.234 (mille deux cent trente-quatre selon le format européen) mais que le total des lignes s'élève à environ 1.234,56 (mille deux cent trente-quatre et 56 centimes), l'IA a probablement ignoré la partie décimale. Une vérification par plage qui compare le total extrait à la somme des lignes détecte ce problème immédiatement.
- Utilisez des vérifications de cohérence mathématique. Comme pour la cause n° 2 : Subtotal + Tax = Total. Si le séparateur décimal a été mal interprété, le calcul ne s'équilibrera pas et vous saurez qu'il faut réexaminer le format avant que l'erreur ne se propage.
Un moteur OCR plus puissant ne résout pas ce problème, car l'ambiguïté est culturelle plutôt que visuelle. Ce qui fonctionne, c'est une couche de validation qui vérifie le nombre analysé par rapport au reste du document avant que la valeur ne soit transmise.
Quand faire remonter : les cas limites que même les bons outils ne peuvent pas résoudre
La transparence est importante ici. Toute erreur de nombre n'a pas de correctif au niveau du nom de champ. Il existe deux situations où même la meilleure extraction par IA, avec les noms de colonnes les plus spécifiques et le post-traitement le plus approfondi, produira encore des résultats incorrects avec une certaine fréquence.
Situation 1 : Des lignes de totaux adjacentes avec un formatage identique. Lorsqu'une facture répertorie « Subtotal », « Discount », « Tax » et « Total » dans la même colonne alignée à droite, avec la même taille et la même graisse de police, sans séparateur visuel entre elles, tout moteur d'IA est confronté à un véritable problème d'ambiguïté. Les signaux utilisés par le modèle pour différencier les champs, comme la taille de police, les espaces et la position des libellés, sont faibles ou contradictoires dans ce cas. Dans une telle situation, l'approche pratique consiste à extraire les quatre valeurs (définir des colonnes pour chacune) et à déterminer laquelle est laquelle dans votre feuille de calcul en aval, en vous appuyant sur les relations attendues : le total doit être le nombre le plus élevé, le sous-total le deuxième plus élevé et le rabais le plus petit.
Situation 2 : Des conventions décimales incohérentes dans un même document. Certaines factures mélangent les formats, utilisant un point comme séparateur décimal dans une section et une virgule dans une autre. C'est rare, mais cela existe, en particulier dans les factures transfrontalières où la mise en page du document a été assemblée à partir de plusieurs modèles régionaux. Dans ces cas, aucune règle de format unique ne fonctionne pour l'ensemble du document. La solution est une vérification manuelle des champs où le mélange de formats apparaît, combinée à une règle de signalement qui vous alerte lorsque les lignes et les totaux utilisent des modèles de séparateurs différents.
Dans ces deux cas limites, blâmer l'outil passe à côté du sujet. Le document source lui-même porte une ambiguïté avec laquelle tout système automatisé aurait du mal, le travail consiste donc à concevoir votre processus de validation en conséquence.
Questions fréquemment posées
Lorsque mon total extrait est incorrect, dois-je supposer que l'IA a commis une erreur aléatoire ?
Non. Les erreurs d'extraction sur les champs numériques suivent des schémas prévisibles. Vérifiez d'abord la spécificité du nom de votre colonne : « Total » est ambigu sur la plupart des factures. Si le nombre correct apparaît sur le document mais que ce n'est pas celui que l'IA a renvoyé, la cause racine est presque certainement une ambiguïté du champ (cause racine 1). Si le nombre lui-même contient des caractères inattendus (des lettres là où il devrait y avoir des chiffres), il s'agit d'une confusion de caractères (cause racine 2). Si l'ampleur est décalée d'environ 1 000 fois, il s'agit d'un problème de séparateur décimal (cause racine 3). Chacune a une solution différente, mais aucune ne doit être traitée comme un bruit aléatoire.
Puis-je utiliser le même nom de colonne « Total » si je veux toujours le grand total ?
Vous pouvez, mais vous obtiendrez des résultats incorrects sur toute facture où le total est ambigu. « Total » est le nom de champ le plus surchargé dans l'extraction de documents. Une colonne nommée « Total Amount Due » ou « Grand Total (après taxes) » élimine l'ambiguïté sans effort supplémentaire de votre part. L'IA utilise le nom de votre colonne comme signal de recherche principal ; plus le signal est précis, moins il y a de place pour l'interprétation.
Un meilleur matériel IA résout-il la confusion de caractères entre 5/S ou 0/O ?
Non. La confusion de caractères est une ambiguïté visuelle fondamentale, pas une limitation matérielle. Un modèle de vision de pointe et un moteur OCR de base sont tous deux confrontés à la même ambiguïté 5/S lorsque le caractère fait 9 pixels de haut sur un scan compressé. La solution est une validation post-extraction : vérifiez que les champs numériques ne contiennent que des chiffres, appliquez des contrôles de plage et utilisez des calculs croisés entre champs pour détecter les valeurs incohérentes. Remplacer par un modèle plus puissant n'aide pas, et peut même aggraver les choses en renvoyant une valeur incorrecte avec plus de confiance.
Ma facture européenne affiche 1 234,56 € mais l'extraction renvoie 1.234. Que s'est-il passé ?
L'IA a probablement interprété le point comme le séparateur décimal et la virgule comme le séparateur de milliers, suivant la convention américaine, ce qui a tronqué entièrement la partie décimale. La valeur « 1.234,56 » au format européen signifie mille deux cent trente-quatre et 56/100. Lue au format américain, le point devient le séparateur décimal (ce qui donne la valeur 1,234, soit environ un et un quart) et la virgule devient le séparateur de milliers, qui est ignoré dans un nombre à quatre chiffres. Configurez votre lot pour le format décimal européen en indiquant au système que la virgule est le séparateur décimal, puis relancez.
Dois-je ajouter une vérification manuelle pour chaque extraction, ou uniquement lorsque les chiffres semblent suspects ?
Une vérification ciblée est préférable à une vérification systématique. Appliquez trois règles à chaque lot : (1) signalez tout total extrait qui sort d'une plage définie (par exemple, 3 écarts types par rapport à la moyenne historique du fournisseur), (2) signalez tout lot où subtotal + tax ≠ total avec un écart supérieur à une petite tolérance (par exemple, $0.50), et (3) signalez tout champ numérique contenant des caractères non numériques. Ces trois règles détectent la grande majorité des erreurs de chiffres sans vous obliger à inspecter chaque ligne. La vérification manuelle uniquement sur les éléments signalés maintient votre débit élevé tout en attrapant les erreurs qui comptent.
Comment l'Extraction de colonnes personnalisées gère-t-elle les noms de champs ambigus différemment des outils basés sur des modèles ?
Extraction de colonnes personnalisées traite chaque nom de colonne comme une requête de recherche sémantique, et non comme une règle basée sur la position. Lorsque vous saisissez « Total Amount Due », l'IA recherche dans tout le document une valeur correspondant à cette signification précise, le montant final payable après toutes les additions et déductions. Un outil basé sur un modèle, en revanche, examine une zone de coordonnées préenregistrée sur la page. L'approche par zone de coordonnées fonctionne bien lorsque le total ne bouge jamais ; l'Extraction de colonnes personnalisées fonctionne bien lorsque le total bouge mais que sa signification reste la même.
Le même lot peut-il contenir des factures de fournisseurs américains et européens avec des formats de nombres différents ?
Oui, mais vous devrez gérer la variance de format en aval. L'IA extrait les nombres tels qu'ils apparaissent sur la page et ne normalise pas automatiquement les conventions de format au sein d'un lot. Pour les lots à formats mixtes, l'approche pratique consiste à traiter les documents américains et européens séparément, en appliquant le format de règle correspondant à chaque groupe, ou à normaliser les séparateurs lors d'une étape de post-traitement avant que les valeurs n'atteignent votre système comptable. Pour un aperçu plus approfondi des types d'obstacles d'écriture et de caractères auxquels les outils d'extraction sont confrontés, consultez notre article complémentaire sur pourquoi l'OCR a du mal avec l'écriture manuscrite et comment y remédier.
Les chiffres extraits incorrects sont frustrants, mais ils ne sont presque jamais aléatoires. Ils se répartissent dans l'une des trois catégories prévisibles : ambiguïté du champ, confusion de caractères ou variance de format. Le premier endroit à examiner est la conception des champs, et chaque catégorie a une solution spécifique qui ne nécessite pas de changer d'outil ni de réentraîner un modèle. La prochaine fois qu'un total revient incorrect, ne demandez pas « pourquoi l'IA est-elle mauvaise avec les chiffres ». Demandez « laquelle des trois causes profondes est-ce, et quelle est la solution la moins coûteuse ? » La réponse est généralement un nom de colonne plus spécifique ou une seule règle de validation, et ni l'un ni l'autre ne coûte plus de quelques secondes de réflexion.
Testez l'approche sur vos propres documents. Téléversez une facture qui a causé une erreur de chiffres, définissez les colonnes avec une spécificité maximale, en utilisant « Grand Total After Tax » au lieu de « Total », et voyez si le résultat change. Essayez l'extraction sur vos propres documents et voyez si trois minutes par document deviennent dix secondes.