OCR低精度の
スキャン文書?根本原因5つと修正方法
文書の束をスキャンしてOCRにかけたのに、出力はエラーだらけ——数字のはずが文字になっていたり、行が半分欠けていたり、テキストがミキサーにかけられたような状態になっていたり。ページが5度傾いただけで単語誤認識率は15%上昇し、200 DPI未満でスキャンした文書は、OCRエンジンが動き出す前から文字精度が10〜20%も失われるのが一般的です。問題はほとんどエンジン自体にはありません。ほぼ常に、特定の画像欠陥と、エンジンがそれを処理する方法との相互作用が原因です。
重要ポイント
- スキャン文書のOCRがめちゃくちゃな結果を出すとき、原因はほぼエンジンではなく、5つの画像欠陥が真の原因であり、それぞれに読み取れる診断上の特徴があります。
- ほぼ目に見えない3度のページ傾きで単語誤認識率が15%増加し、150 DPIのスキャンではOCRエンジンがファイルに触れる前に文字精度が20%も静かに失われます。
- 各欠陥には特定の順序での的を絞った修正があり、前処理が限界に達したときの答えは、損傷したピクセルを一つずつ処理するのではなく、意味によって文書を読み取る別のパラダイムです。
スキャンされたドキュメントは、デジタルネイティブのPDFとは根本的に異なります。ドキュメントがデジタルで作成された場合、テキストはクリーンなベクター形状として存在します。スキャンされたドキュメントは印刷されたページの写真であり、その写真に存在するすべての画像欠陥は、OCRエンジンが1文字を認識する前に解決しなければならない問題になります。人間の目には「ほぼ十分」に見えるものでも、ピクセルレベルで動作するアルゴリズムにとっては絶望的に曖昧な場合があります。
良いニュース:スキャンされたドキュメントのOCR精度の低さは、予測可能なパターンに従います。各根本原因には診断用の指紋があり、どの欠陥に対処しているかを特定すれば、修正は再現可能です。
原因1 — 低DPI:最も一般的な精度低下の要因
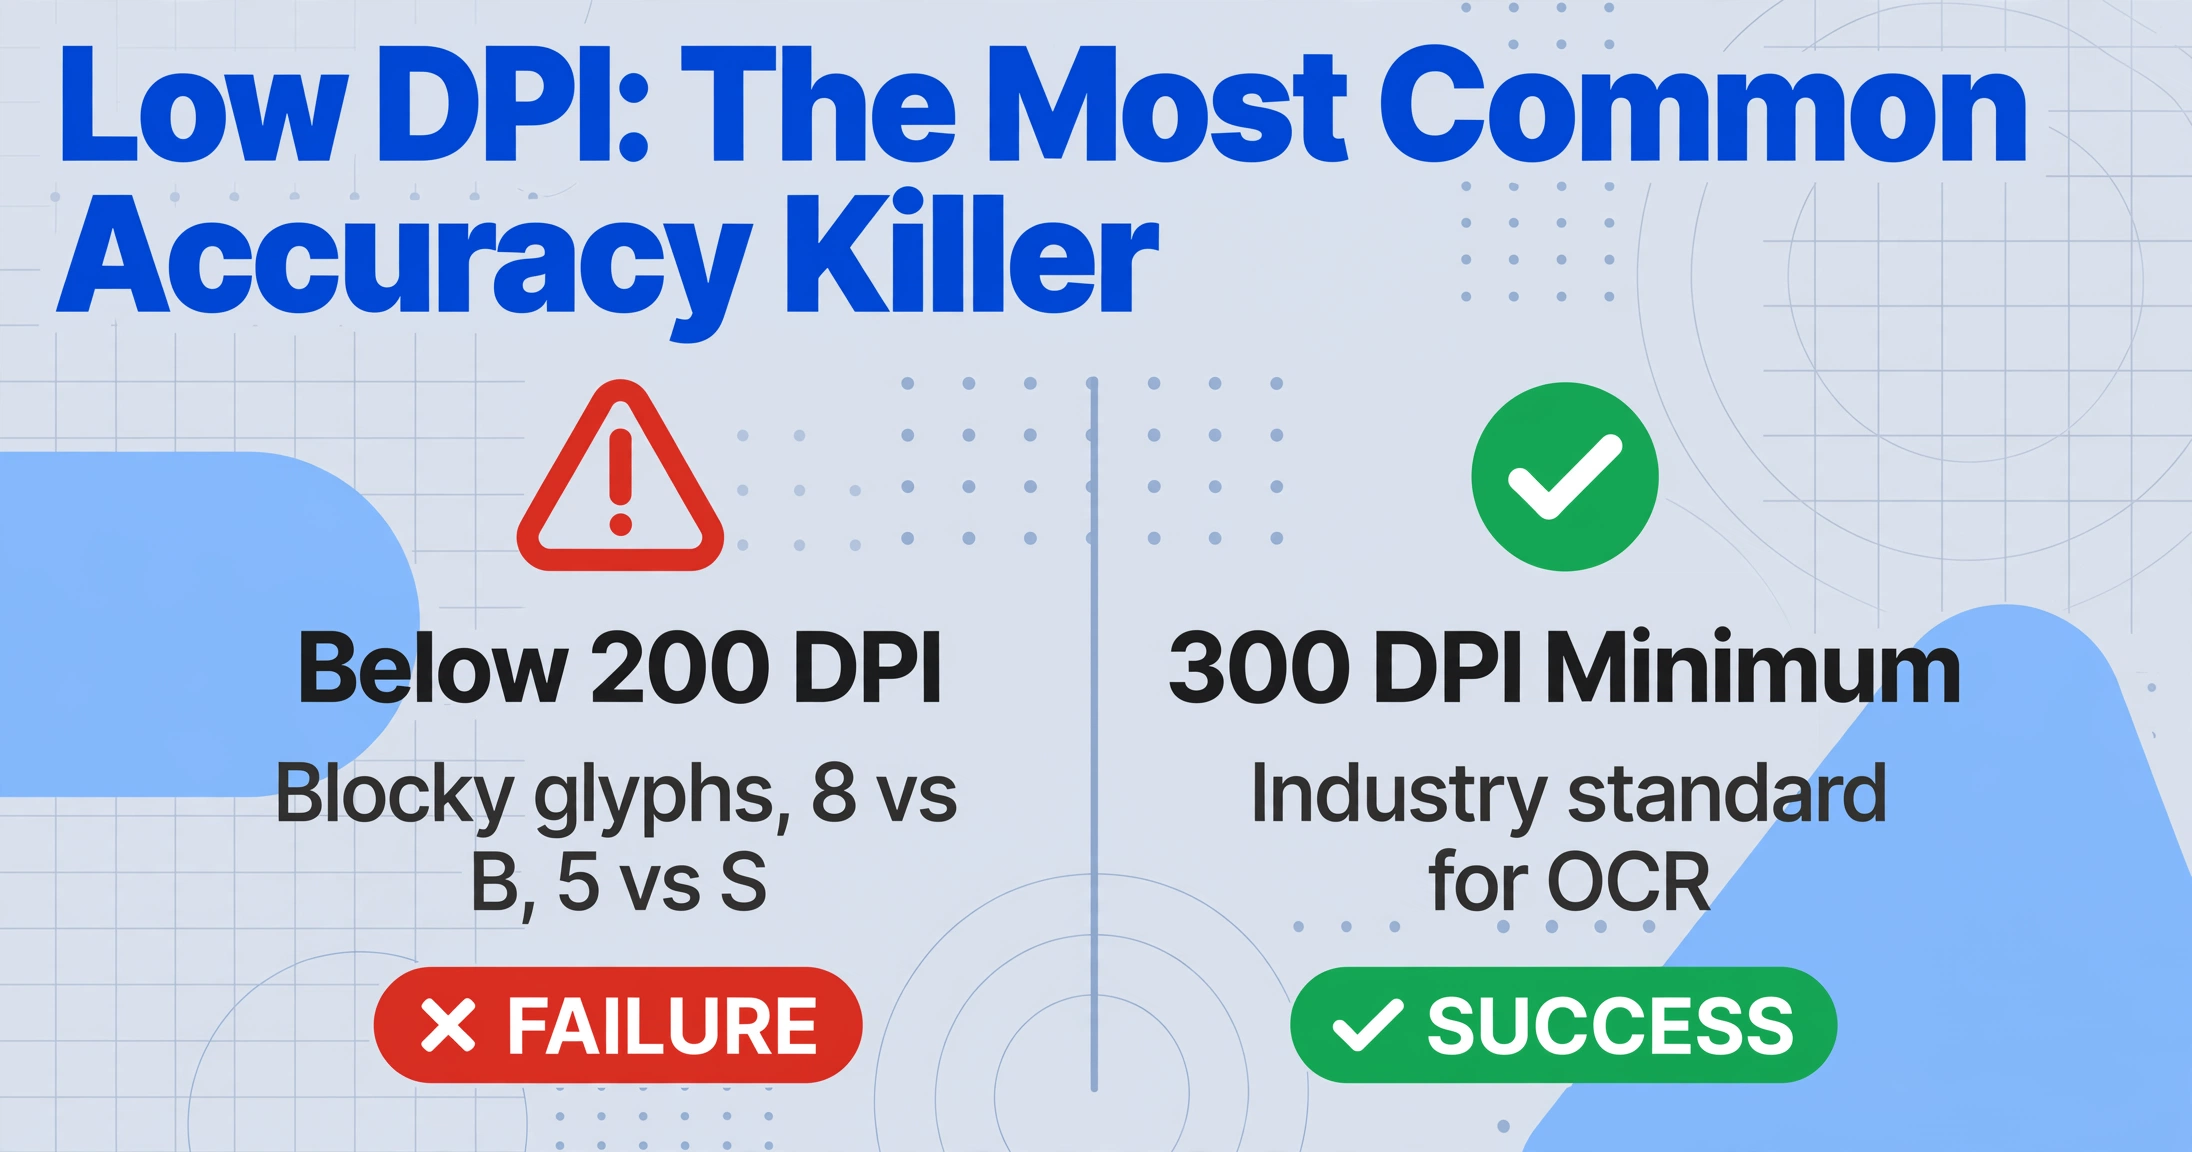
症状:ズームインすると文字がブロック状に見えます。OCRは類似したグリフを混同します — 8をB、5をSとして認識します。単語が予期せず分割され、句読点が頻繁に見落とされます。
発生理由:DPI(1インチあたりのドット数)は、物理的なページの1インチあたりにスキャナーが取り込むピクセル数を決定します。200 DPI未満では、文字あたりのピクセル数が非常に少なくなり、異なるグリフ形状が同一に見え始めます。小文字のeとcはどちらも数ピクセルの塊になります。150 DPIでは、ほとんどのエンジンで文字レベルの精度が90%未満に低下します。100 DPI — 腰の高さからのスマートフォン写真にほぼ相当 — では、小さな文字を含むドキュメントには精度が使用不能になります。
修正方法:最低300 DPIでスキャンしてください。これはOCRの業界標準であり、ファイルサイズと認識品質のバランスを取ります。10ポイント未満のテキストの場合は、400〜600 DPIに増やしてください。再スキャンできない場合は、超解像アップスケーリングを備えた前処理パイプラインで、劣化しすぎて使用できないように見える画像からも測定可能な精度を回復できます。
クイックチェック:スキャン画像を100%ズームで開いてください。文字のエッジが滑らかに見える場合は、DPIは十分です。階段状または目に見える正方形のピクセルのように見える場合は、しきい値を下回っています。
原因2 — 傾きと回転:ページがまっすぐでない場合
症状:テキスト行が斜めになる。一部の単語は正しく認識されるが、同じ行の隣接単語が断片化する。表の列がずれ、本来1列に収まるデータが次の列にはみ出す。
原因:従来のOCRはテキストが水平直線上にあると仮定する。人間の目にはほとんどわからない3度の傾きでも、文字がエンジンの想定するベースラインから外れる。行分割アルゴリズムが単語を行をまたいで分割し、文字認識は回転した参照とグリフを照合しようとして失敗する。影響は拡大し、左上の3度の傾きが右下では数ミリのずれになる。
修正方法:ほとんどの前処理ライブラリには自動傾き補正機能がある。これは支配的なテキスト角度を検出し、画像を回転して補正するアルゴリズムである。傾き補正は2値化前に適用する。2値画像は角度検出に必要な微妙なグラデーション情報を失うからだ。ここが、ビジョンベースのAI抽出が従来のOCRと異なる点でもある。ビジョンモデルはページ全体を視覚的なシーンとして処理し、回転に対して本質的に寛容である。
原因3 — ノイズと圧縮アーティファクト
症状:出力に余分な文字(元のページにないランダムな点、カンマ、断片)が現れる。きれいな白い領域に見える部分に、抽出結果では「ゴーストテキスト」が含まれる。
原因:ごま塩ノイズ(白黒の斑点)は、ファックス文書や汚れたスキャナーガラスからのスキャンでよく発生する。JPEG圧縮アーティファクトは文字のエッジ周辺にブロック状の歪みを生み、OCRがそれをグリフの一部と解釈する。スタンプや印鑑が印刷テキストに重なると、文字境界の検出が混乱する。エンジンはスタンプのインクと印刷インクを分離しようとして、両方を誤認識することが多い。
修正方法:メディアンフィルタ(カーネルサイズ3×3または5×5)は、ガウシアンブラーよりも文字エッジを保持しながらごま塩ノイズを除去する。JPEGアーティファクトには、バイラテラルフィルタがテキストをぼかさずに圧縮境界を平滑化する。スタンプが主な問題なら、HSV空間での色ベースフィルタリングで重なったスタンプインクを分離・除去してからOCRにかける。透かしやセキュリティ印刷などの背景パターンには、適応的閾値処理(大津法またはSauvola法)を使用する。これは局所的な明るさレベルを計算し、ページ領域ごとに異なる閾値を適用する。単一のグローバル閾値では達成できない、背景抑制と文字保存の両方を実現する。
原因4 — 退色と低コントラスト:見えない文字
症状:出力からテキスト行全体が欠落します。エンジンが検出できるのは断片的なものだけです — 認識可能な単語の途中の文字欠落、部分的な単語など。出力は原文をランダムにサンプリングしたように見えます。
原因:インクの退色、経年した感熱紙、カーボンコピーには共通の問題があります:インクと用紙のコントラストが低すぎて、OCRが確実に分離できません。エンジンが画像を2値化する際、明るさのしきい値以下のピクセルは「背景」として分類され破棄されます。インクが薄すぎるか、用紙が黄変していると、文字は単に消えてしまいます。感熱紙のレシートは特に顕著で、印刷された瞬間から画像層は劣化し続け、6ヶ月前には読めたレシートが今では白紙の出力になることもあります。
対策:CLAHE(コントラスト制限適応ヒストグラム均等化)が最も効果的です — 均一な領域のノイズを過度に増幅することなく、局所的なコントラストの差を増幅します。クリップリミット2.0〜3.0、タイルグリッドサイズはテキストサイズに合わせて適用します。全体的に暗くなった感熱紙の場合は、処理前に画像を反転します — エンジンの2値化は、暗い背景に明るいテキストの方がうまく機能することがあります。不均一な退色には、適応的2値化(Sauvola法)がグローバルな方法よりも局所的な変動に対応できます。
原因5 — 折れ目と物理的損傷
症状:OCR出力に暗い帯が現れ、その帯に沿った文字が欠落したり、無意味な文字に置き換わります。折り目付近では、テキストがずれたり重複して表示されることがあります。
原因:物理的な折れ目はスキャン時に影の線を生成します — エンジンの2値化が前景オブジェクトとして扱うほど暗くなります。影と交差する文字は隠されたり、断片に分割されます。折れ目の多い文書では、折り目での用紙の高さ変化によりページがスキャナーの被写界深度から外れ、影にぼけの帯が加わります。この組み合わせにより、高いコントラスト変動、焦点の合っていない文字、壊れたグリフ形状という、OCRにとって最悪の入力が生まれます。
対策:インペインティング — 周囲のピクセルから補間して損傷領域を埋める — が最も効果的な修復方法です。OpenCVのcv2.inpaint()をTeleaアルゴリズムで使用すると、下のテキストを保持しながら折れ目影を除去できます。インペインティング半径は3〜5ピクセルから始めます。テキストが物理的に欠損した破れ端には、モルフォロジー膨張(2値画像に2×2カーネル)で途切れたストロークを再接続し、認識できない断片を読み取り可能なグリフに戻すことがよくあります。
複数の欠陥に対応する前処理パイプラインの構築
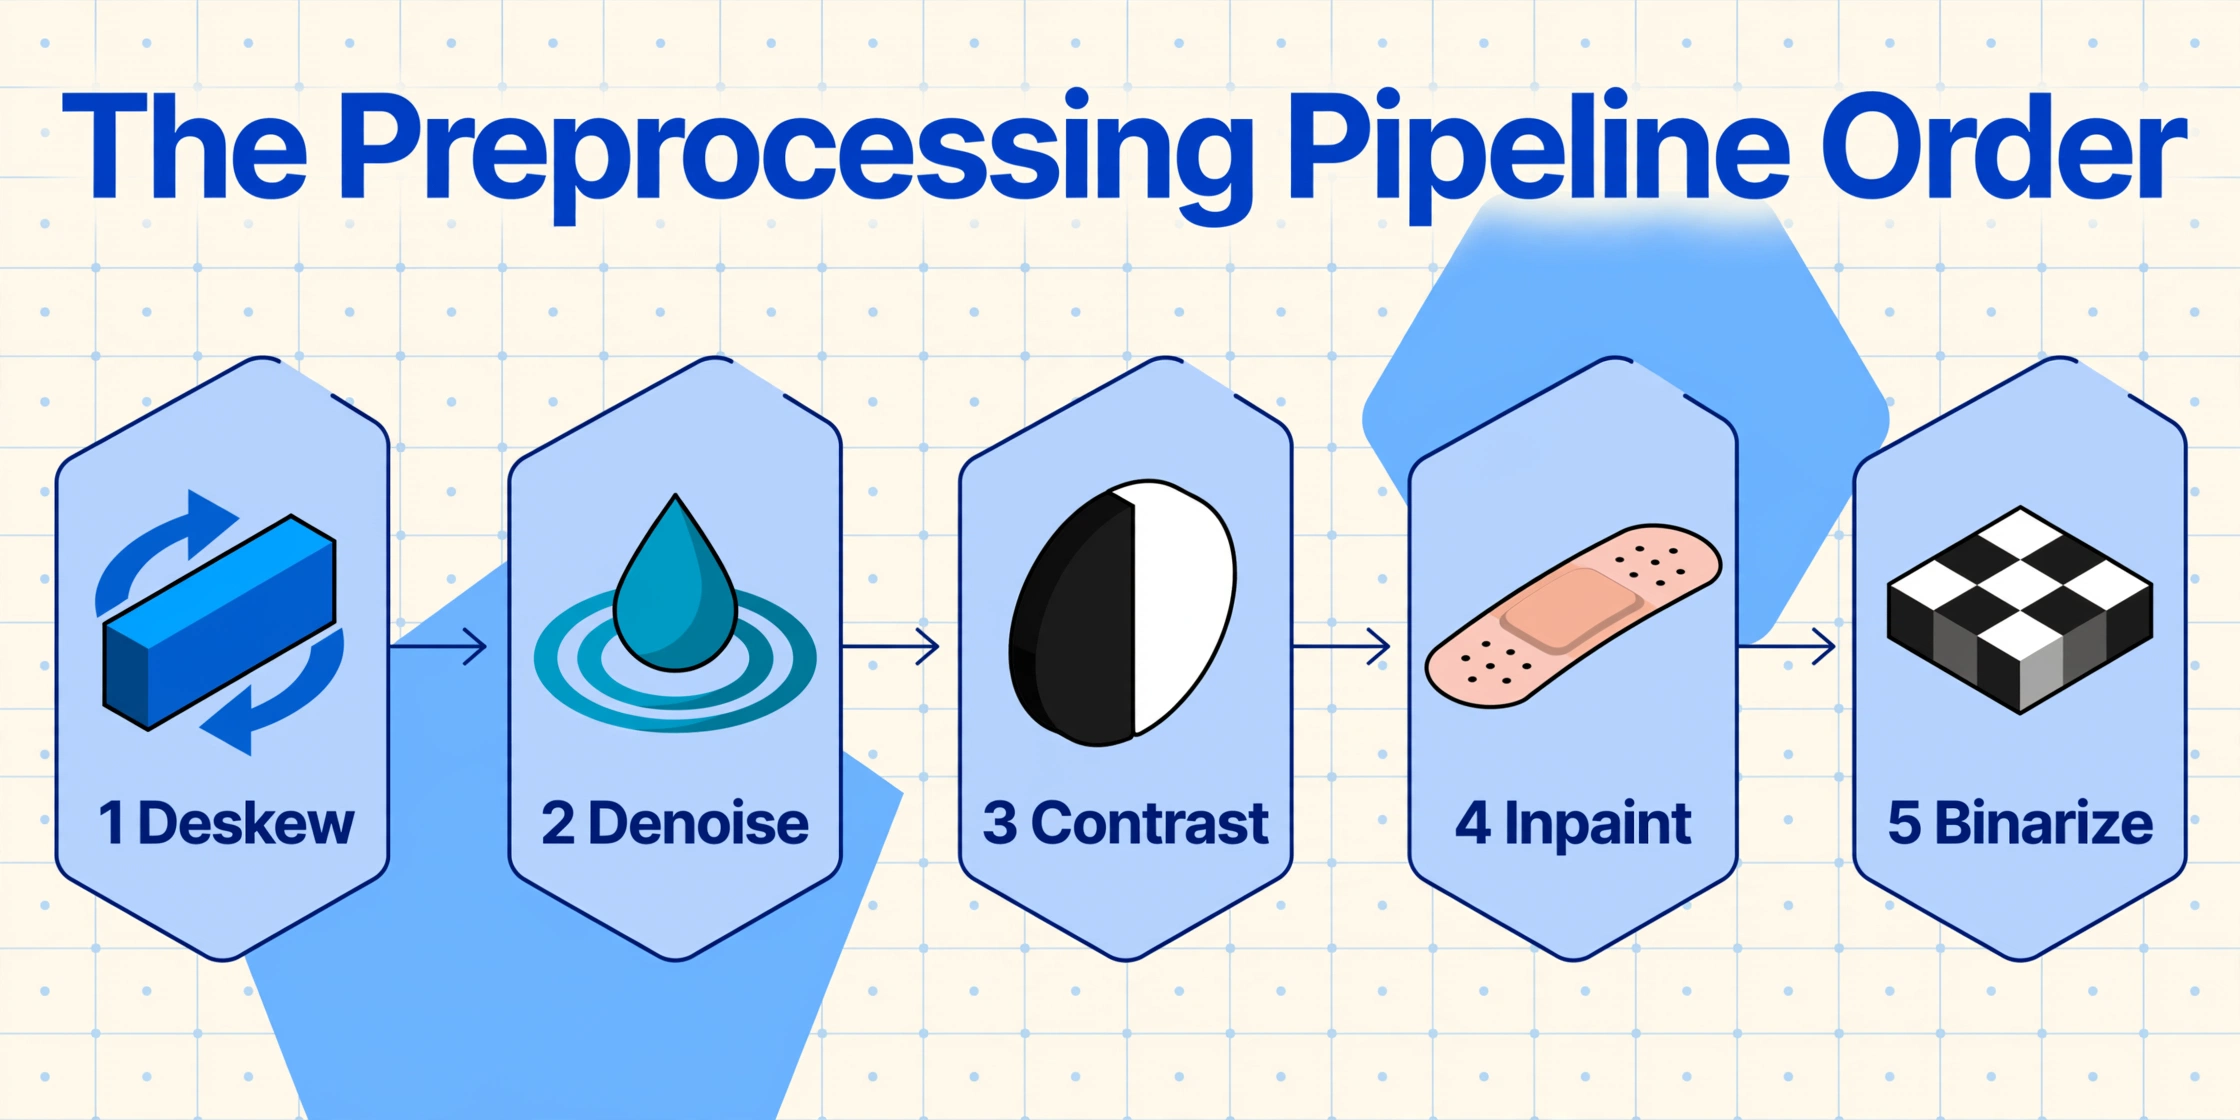
実際のスキャン文書の多くは、複数の欠陥を抱えています。ファックスで送られた契約書には、低いDPIとノイズの両方が含まれている場合があります。古い注文書には、かすんだインクと折り目が同時に存在することもあります。前処理ステップを適用する順序は重要です。
品質に複数の問題があるスキャン文書に推奨されるパイプラインの順序は次のとおりです。
このパイプラインは理論上のものではありません。複数のOCRベンチマークで、数千もの劣化した文書画像に対して検証されています。 OCR精度向上に関する専用ガイドでは、言語モデルベースの補正、フィールドレベルの検証、信頼度スコアリングなどの追加の後処理技術について説明しています。
前処理だけでは不十分な場合
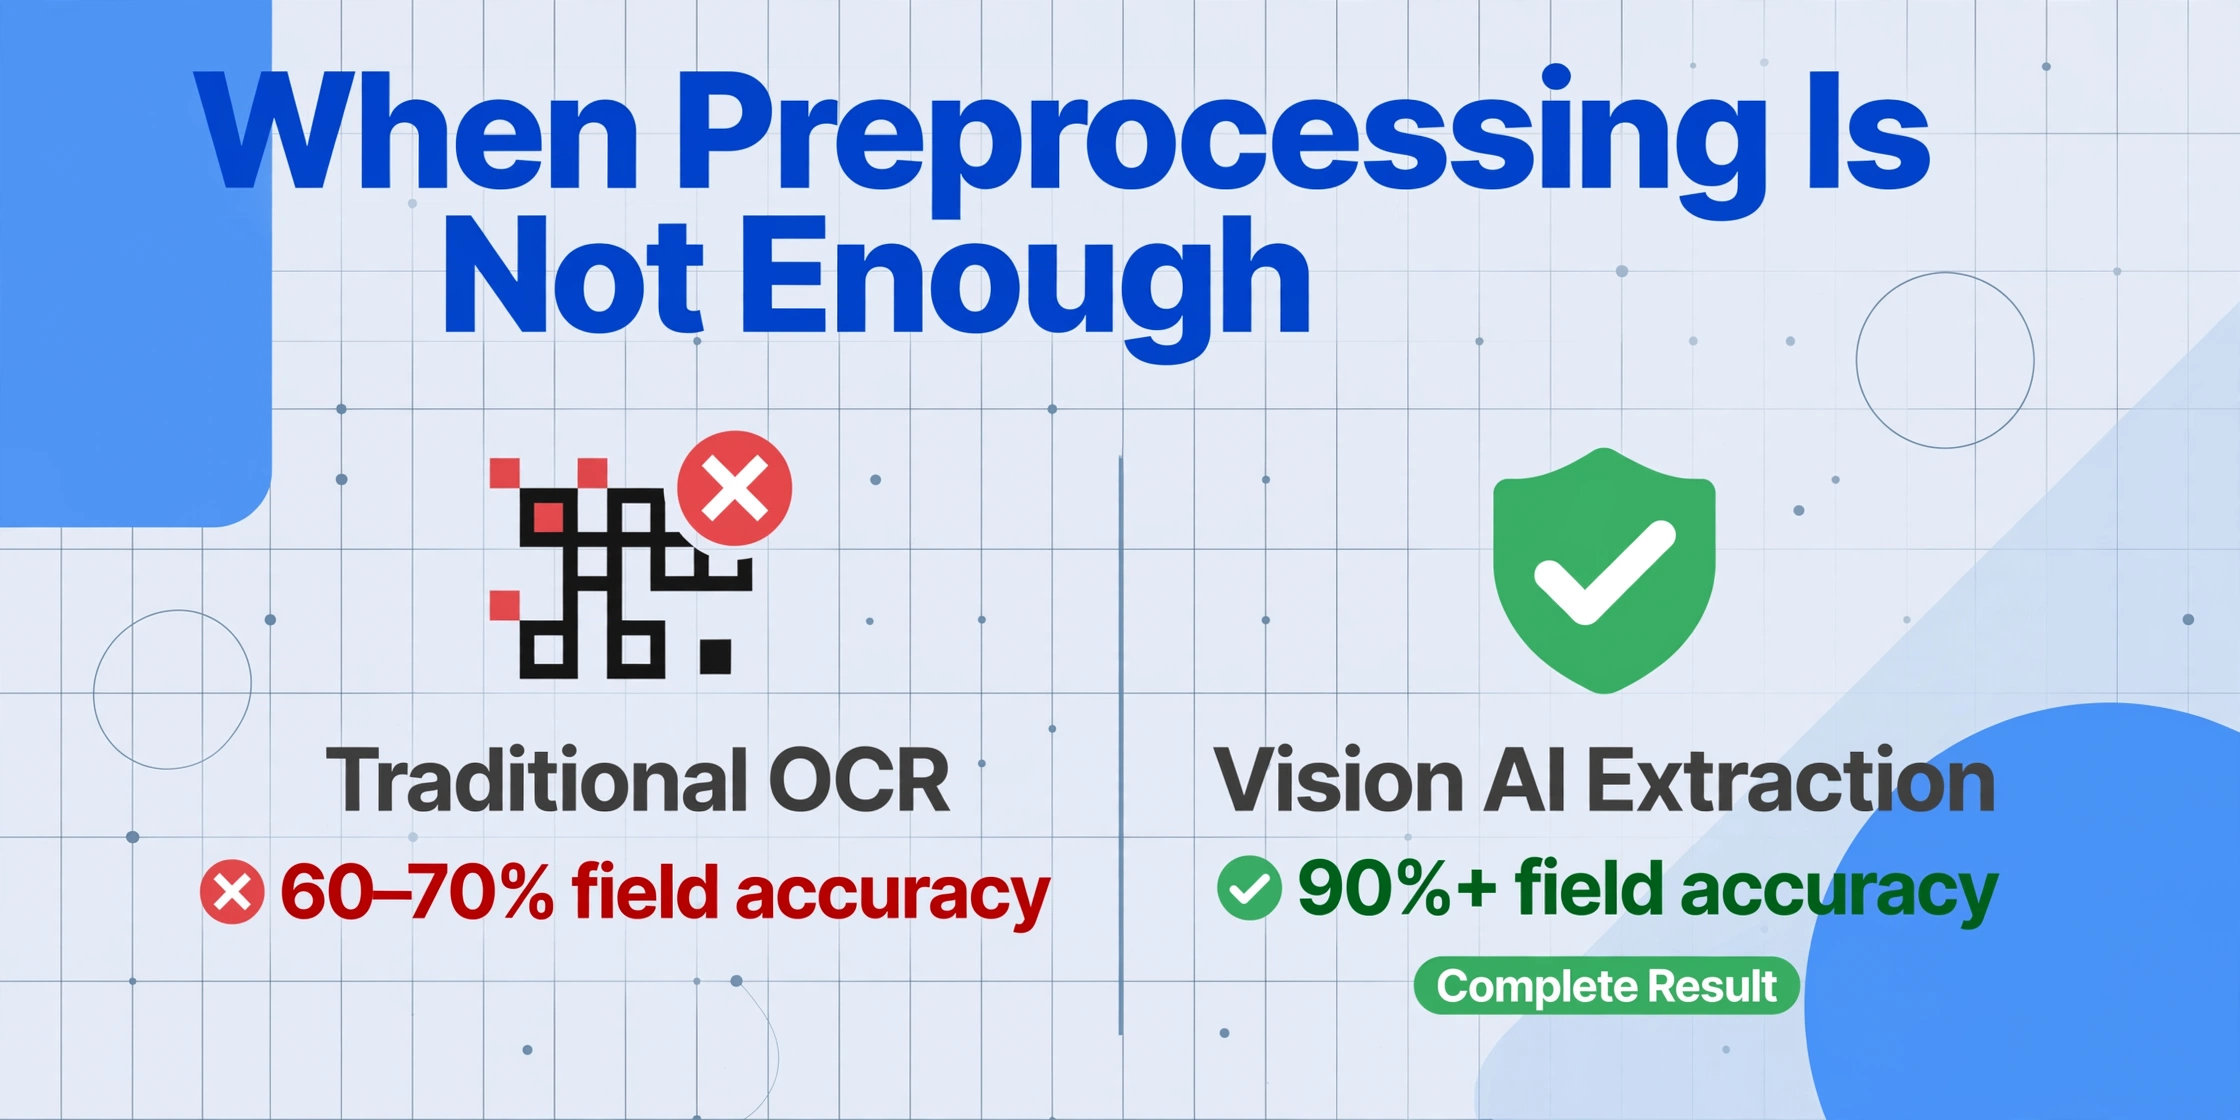
前処理によって、ドキュメントを「読めない」状態から「使える」状態にすることはできますが、それにも限界があります。ソースが72 DPIで汚れたフラットベッドスキャナーで読み取られ、その後FAXされ、さらに再スキャンされた場合、アルゴリズムによる修復で復元できる範囲には限りがあります。ある時点で、問いは「この画像をどう修正するか」から「適切な抽出アプローチを使っているか」へと変わります。
従来のOCR(Tesseract、ABBYY FineReader、ほとんどのクラウドOCR API)は、個々の文字の形状を認識することで機能します。これは根本的にピクセルレベルの処理です。ピクセルが損傷していれば、出力も損傷します。一方、最新のビジョンAIによる抽出は、ドキュメント全体を視覚的なシーンとして読み取ります。文字の一部のピクセルが欠落していても、文字の形状テンプレートではなく意味に照合するため、それが単語であることを理解できます。
この違いは、複数の欠陥があるドキュメントで最も顕著に現れます。かすれた紫色の印字、ホチキス跡によるわずかな傾き、ベンダー住所を横切る折り目があるカーボンコピーの請求書の場合、従来のOCRではフィールド精度が60〜70%になる可能性があります。ビジョンAIツールは、折り目の影を「テキストではない」と判断してその周囲を読み取るため、90%以上の精度を達成できることがよくあります。ドキュメントの種類によって精度低下への反応は異なりますが、原則は一貫しています。損傷がピクセルにある場合、修正はパラダイムの変更が必要になる可能性があります。
よくある質問
スキャン文書で信頼性の高いOCRに必要な最小DPIは?
300 DPIが業界標準です。200 DPI未満になると、ほとんどのOCRエンジンで文字レベルの精度が顕著に低下します。150 DPI未満では、標準的な印刷テキストの精度は90%を下回ります。テキストが10ポイント未満の場合は、400〜600 DPIが推奨されます。600 DPIを超えると頭打ち効果があり、解像度を上げても一般的な文書テキストでは精度向上はほとんど見込めず、ファイルサイズが増大するだけです。
AIは非常に低品質のスキャン文書からデータを抽出できますか?
ビジョンAIモデルは、ピクセル単位ではなく意味的にページを処理するため、従来のOCRよりも画像の欠陥に対する耐性が大幅に高くなっています。人間の目で読める文書(かろうじて読める場合でも)は、通常抽出可能です。ただし、テキストが完全に不可視な文書(インクが完全に薄れた、または物理的に破損した)は例外です。画像に存在しないデータを復元できる技術はありません。
傾き補正は実際にOCR精度を有意に向上させますか?
はい。5度の傾きがあると、従来のOCRエンジンでは単語誤り率が10〜15%増加します。10度では、損失が30%を超える可能性があります。傾き補正は最も費用対効果の高い前処理ステップの1つであり、処理時間はほぼゼロで、一貫した改善が得られます。
スキャンに低DPIとノイズの両方がある場合、どちらを先に修正すべきですか?
まずノイズを修正し、その後に解像度に対処します。低解像度画像のノイズ除去は、逆の順序よりも効果的です。先にアップスケールすると、テキストとともにノイズも増幅されます。このガイドのパイプライン順序はこの原則に従っています。コントラスト強調の前にノイズ除去、解像度依存の操作の前にコントラスト強調です。
フラットベッドスキャナの代わりにスマートフォンの写真を使用できますか?
スマートフォンの写真には、フラットベッドスキャナにはない透視歪み、レンズのぼけ、不均一な照明が生じます。フラットベッドスキャナが利用可能な場合は、より一貫した結果が得られます。スマートフォンを使用する必要がある場合は、ページの真上から撮影し、均一な自然光を使用し、最大解像度で撮影してください。ほとんどの最新スマートフォンは、十分に近づけて撮影すれば300 DPI相当を超えます。
体系的なアプローチが有効
スキャン文書におけるOCR精度の低下は、偶然ではありません。これは特定可能な画像欠陥の結果であり、それぞれに既知のメカニズムと的を絞った修正方法があります。多くの人が犯す間違いは、汎用的な「強調」フィルターを問題に適用することです。つまり、明るさとコントラストを恣意的に調整し、何かが効くことを期待するだけです。
体系的なアプローチはよりシンプルです。OCR出力を確認し、エラーパターンを特定し、根本原因を追跡し、単一の修正を適用します。低DPI → アップスケールまたは再スキャン。傾き → 傾き補正。ノイズ → メディアンフィルター。退色 → CLAHE。折り目 → インペインティング。文書に複数の欠陥がある場合は、依存関係の順序で修正を適用します。ノイズは解像度の前に、傾き補正は他のすべての前に実行します。
正しい修正を正しい順序で適用しても、精度がワークフローの要件を満たさない場合、制約は前処理ではなく抽出パラダイムにあります。ピクセル形状ではなく意味によって文書を読み取るビジョンAIツールは、実用的な結果へのより速い道かもしれません。前処理だけでは不十分な場合のフィールドレベルの検証と精度検証方法の詳細をご覧ください。