Baixa precisão de OCR em
documentos digitalizados? 5 causas raiz e correções
Você digitalizou uma pilha de documentos, executou-os no OCR e a saída está cheia de erros — números onde deveriam estar letras, metade das linhas ausentes e texto que parece ter passado por um liquidificador. Uma inclinação de página de 5 graus sozinha pode aumentar a taxa de erro de palavras em 15%, e documentos digitalizados abaixo de 200 DPI perdem rotineiramente 10–20% da precisão em nível de caractere antes mesmo de o mecanismo de OCR começar a funcionar. O problema raramente é o mecanismo em si. Quase sempre é a interação entre um defeito específico de imagem e como o mecanismo o processa.
Principais conclusões
- Quando o OCR de documentos digitalizados produz resultados ruins, quase nunca é culpa do mecanismo — cinco defeitos de imagem são os verdadeiros culpados, cada um deixando uma assinatura diagnóstica que você pode aprender a ler.
- Uma inclinação de página de apenas 3 graus, quase imperceptível, adiciona 15% de erro de palavras, e uma digitalização de 150 DPI perde silenciosamente 20% da precisão de caracteres antes mesmo de o mecanismo de OCR tocar no arquivo.
- Cada defeito tem uma correção direcionada em uma ordem específica, e quando o pré-processamento atinge seu limite, a resposta é um paradigma diferente que lê documentos pelo significado em vez de combater pixels danificados um a um.
Um documento digitalizado é fundamentalmente diferente de um PDF nativo digital. Quando um documento é criado digitalmente, o texto existe como formas vetoriais limpas. Um documento digitalizado é uma fotografia de uma página impressa — cada defeito de imagem presente nessa fotografia se torna um problema que o mecanismo de OCR precisa resolver antes de reconhecer uma única letra. O que parece "quase suficiente" para o olho humano pode ser irremediavelmente ambíguo para um algoritmo que trabalha no nível de pixel.
A boa notícia: baixa precisão de OCR em documentos digitalizados segue padrões previsíveis. Cada causa raiz deixa uma impressão digital diagnóstica e, uma vez que você identifica qual defeito está enfrentando, a solução é repetível.
Causa 1 — DPI baixo: O assassino de precisão mais comum
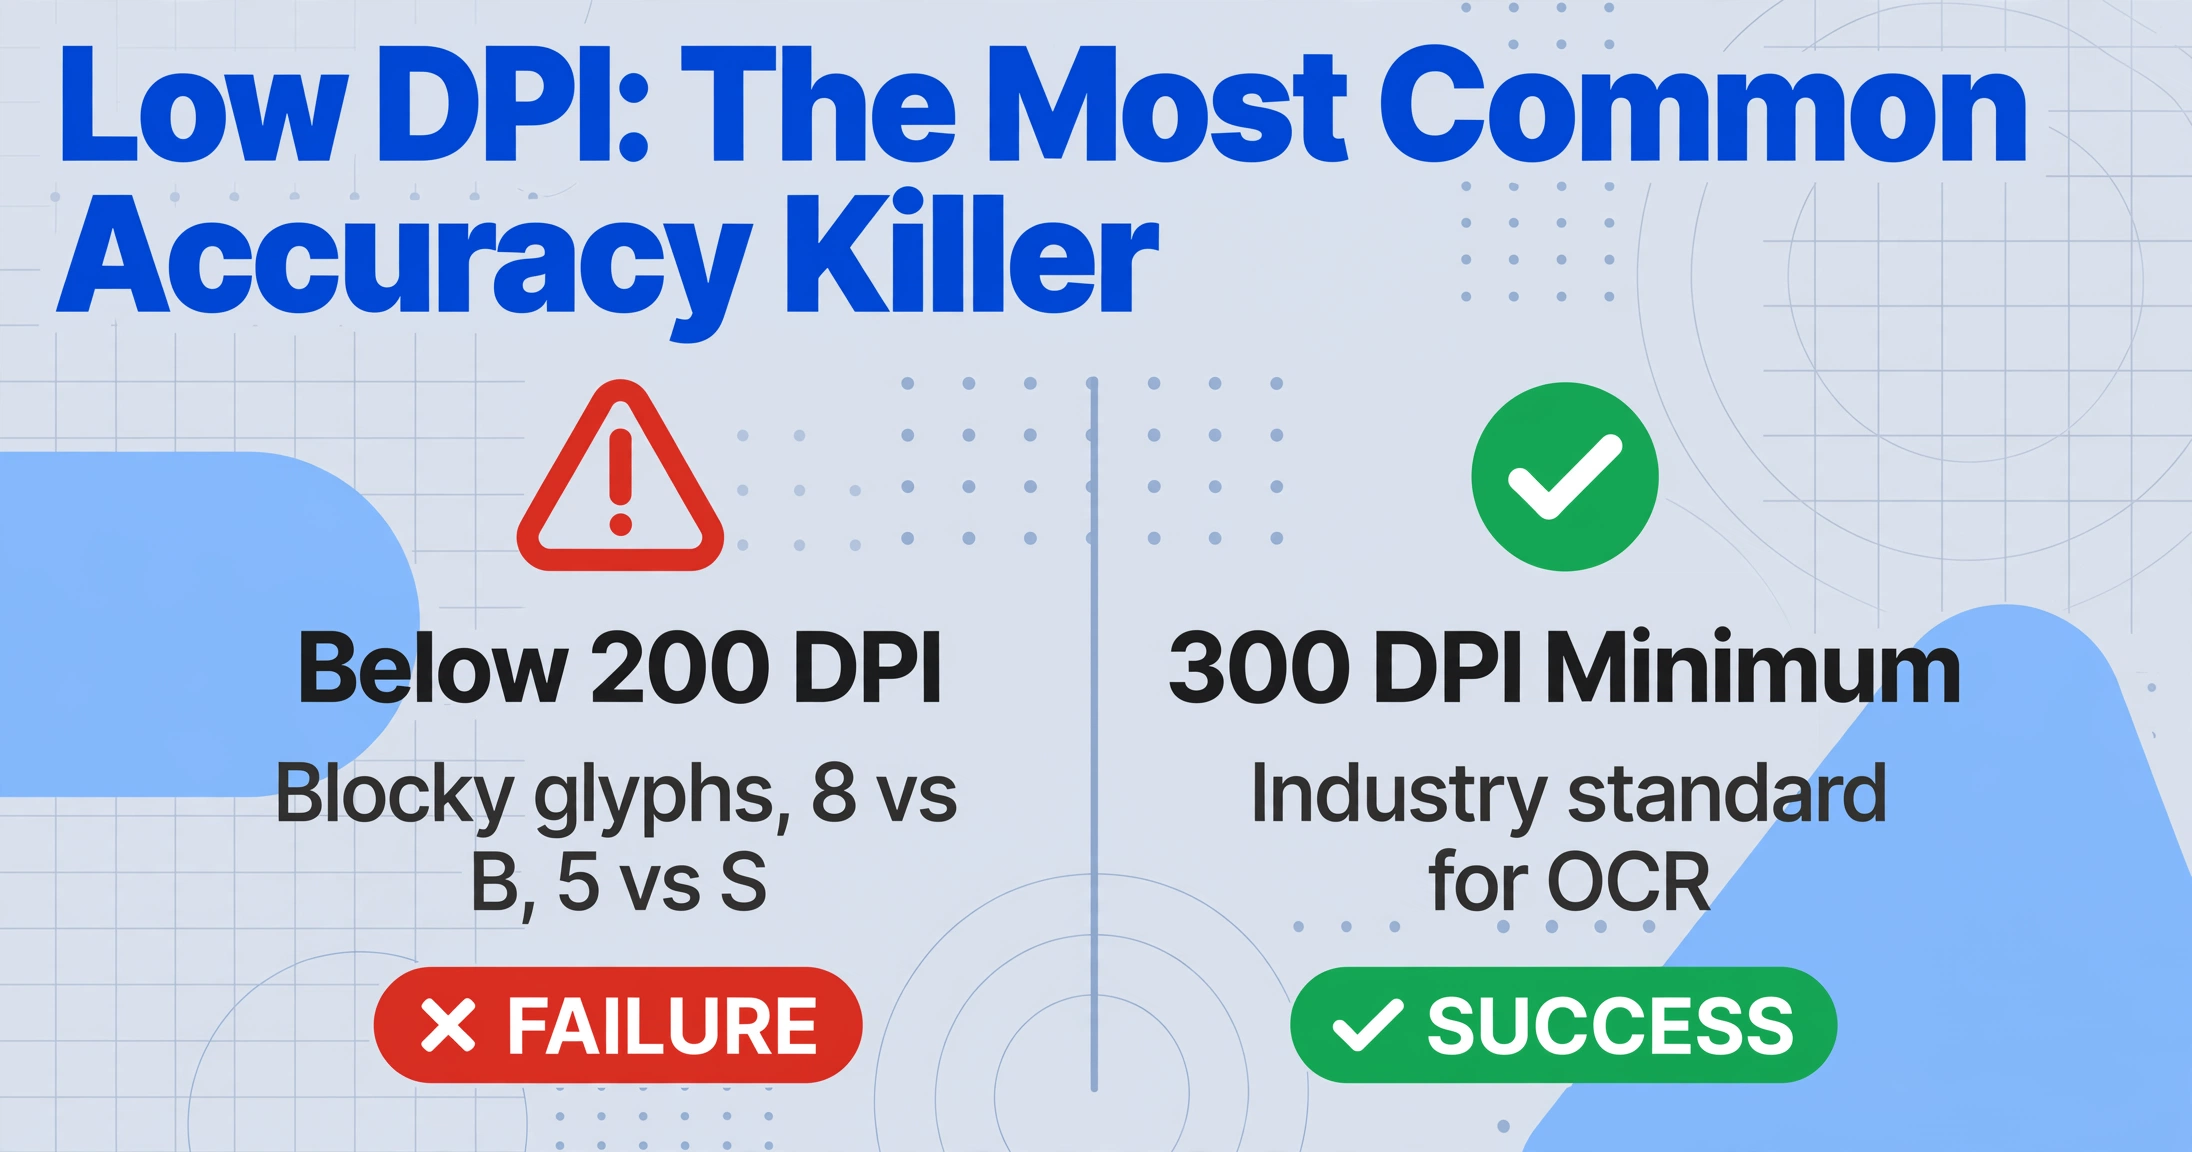
O sintoma: Os caracteres parecem irregulares quando você dá zoom. O OCR confunde glifos semelhantes — 8 como B, 5 como S. Palavras quebram inesperadamente e a pontuação é frequentemente perdida.
Por que isso acontece: DPI (pontos por polegada) determina quantos pixels o scanner captura por polegada da página física. Abaixo de 200 DPI, a contagem de pixels por caractere se torna tão pequena que formas distintas de glifos começam a parecer idênticas. Um e minúsculo e um c ambos se tornam um borrão de alguns pixels. A 150 DPI, a precisão em nível de caractere cai abaixo de 90% para a maioria dos mecanismos. A 100 DPI — aproximadamente o que uma foto de smartphone tirada da altura da cintura produz — a precisão se torna inutilizável para qualquer documento com letras pequenas.
A solução: Digitalize a 300 DPI no mínimo. Este é o padrão da indústria para OCR e equilibra o tamanho do arquivo com a qualidade de reconhecimento. Para texto abaixo de 10 pontos, aumente para 400–600 DPI. Se você não puder redigitalizar, um pipeline de pré-processamento com upscaling de super-resolução pode recuperar precisão mensurável de imagens que parecem degradadas demais para uso.
Verificação rápida: Abra sua imagem digitalizada com zoom de 100%. Se as bordas dos caracteres parecerem suaves, seu DPI é adequado. Se parecerem uma escada ou pixels quadrados visíveis, você está abaixo do limite.
Causa 2 — Inclinação e Torção: Quando a Página Não Está Reta
O sintoma: Linhas de texto inclinam para cima ou para baixo. Algumas palavras são detectadas corretamente, enquanto palavras adjacentes na mesma linha são fragmentadas. Colunas de tabelas se deslocam, e dados que pertencem a uma coluna transbordam para a seguinte.
Por que acontece: O OCR tradicional assume que o texto está em linhas retas horizontais. Uma inclinação de 3 graus — quase imperceptível ao olho humano — faz com que os caracteres percam a linha de base esperada pelo mecanismo. Algoritmos de segmentação de linhas dividem palavras entre linhas, e o reconhecimento de caracteres falha porque o mecanismo está comparando glifos com referências rotacionadas. O efeito se acumula: o que começa como uma inclinação de 3 graus no canto superior esquerdo se torna um deslocamento de vários milímetros no canto inferior direito.
A correção: A maioria das bibliotecas de pré-processamento inclui endireitamento automático — um algoritmo que detecta o ângulo dominante do texto e rotaciona a imagem para compensar. Aplique o endireitamento antes da binarização; imagens binárias perdem as informações sutis de gradiente das quais a detecção de ângulo depende. É aqui também que a extração baseada em IA visual se separa do OCR tradicional — modelos de visão processam a página como uma cena visual completa e são inerentemente mais tolerantes à rotação.
Causa 3 — Ruído e Artefatos de Compressão
O sintoma: Caracteres extras aparecem na saída — pontos aleatórios, vírgulas ou fragmentos que não existem na página original. Áreas que parecem espaço em branco limpo contêm "texto fantasma" no resultado da extração.
Por que acontece: Ruído sal-e-pimenta — pontos pretos e brancos — é comum em documentos enviados por fax e digitalizações de vidro sujo do scanner. Artefatos de compressão JPEG criam distorções em blocos ao redor das bordas dos caracteres, que o OCR interpreta como parte do glifo. Carimbos e selos sobrepostos ao texto impresso confundem a detecção de limites de caracteres — o mecanismo tenta separar a tinta do carimbo da tinta impressa e frequentemente erra ambos.
A correção: Um filtro mediano (tamanho de kernel 3×3 ou 5×5) remove o ruído sal-e-pimenta enquanto preserva as bordas dos caracteres melhor do que o desfoque Gaussiano. Para artefatos JPEG, um filtro bilateral suaviza os limites de compressão sem suavizar o texto. Se carimbos são o problema principal, a filtragem baseada em cor no espaço HSV pode isolar e remover a tinta de carimbo sobreposta antes do OCR. Para padrões de fundo como marcas d'água ou impressão de segurança, use limiarização adaptativa (Otsu ou Sauvola), que calcula níveis de brilho locais e aplica diferentes limiares a diferentes regiões da página — alcançando tanto a supressão de fundo quanto a preservação de caracteres que um único limiar global não consegue.
Causa 4 — Desbotamento e Baixo Contraste: Texto Invisível
O sintoma: Linhas inteiras de texto desaparecem da saída. O que o mecanismo detecta é fragmentário — palavras parciais, caracteres faltando no meio de termos reconhecíveis. A saída parece com amostras aleatórias do original.
Por que acontece: Tinta desbotada, papel térmico envelhecido e cópias carbono compartilham o mesmo problema: o contraste entre tinta e papel é muito baixo para o OCR separá-los de forma confiável. Quando o mecanismo binariza a imagem, pixels abaixo do seu limiar de brilho são classificados como "fundo" e descartados. Se a tinta for clara o suficiente — ou o papel amarelado o bastante — caracteres simplesmente desaparecem. Recibos de papel térmico são notórios: a camada de imagem se degrada continuamente desde o momento da impressão, e um recibo legível há seis meses pode agora produzir uma saída em branco.
A correção: CLAHE (Equalização de Histograma Adaptativa com Limitação de Contraste) é a técnica mais eficaz — ela amplifica diferenças locais de contraste sem amplificar demais o ruído em áreas uniformes. Aplique com um limite de clip de 2,0–3,0 e um tamanho de grade de blocos correspondente ao tamanho do seu texto. Para papel térmico que escureceu uniformemente, inverta a imagem antes do processamento — a binarização do mecanismo pode ter melhor desempenho em texto claro sobre fundo escuro. Para desbotamento irregular, a binarização adaptativa (método Sauvola) lida melhor com variações locais do que métodos globais.
Causa 5 — Vincos e Danos Físicos
O sintoma: Uma faixa escura corta a saída do OCR, com caracteres ao longo da faixa ausentes ou substituídos por lixo. Perto das linhas de dobra, o texto pode aparecer deslocado ou duplicado.
Por que acontece: Uma dobra física cria uma linha de sombra ao ser digitalizada — escura o suficiente para que a binarização do mecanismo a trate como um objeto de primeiro plano. Caracteres que cruzam a sombra são obscurecidos ou divididos em fragmentos. Em documentos muito vincados, a mudança de elevação do papel na dobra empurra a página para fora da profundidade de campo do scanner, adicionando uma faixa de desfoque à sombra. A combinação cria um pior cenário para entrada de OCR: alta variação de contraste, caracteres desfocados e formas de glifos quebradas.
A correção: Inpainting — preenchimento de regiões danificadas por interpolação a partir de pixels vizinhos — é o remédio mais eficaz. O cv2.inpaint() do OpenCV com o algoritmo Telea remove sombras de vincos enquanto preserva o texto subjacente. Comece com um raio de inpainting de 3–5 pixels. Para bordas rasgadas onde o texto foi fisicamente removido, a dilatação morfológica (um kernel 2×2 na imagem binária) reconecta traços quebrados, muitas vezes transformando fragmentos irreconhecíveis de volta em glifos legíveis.
Construindo um pipeline de pré-processamento que lida com múltiples defeitos
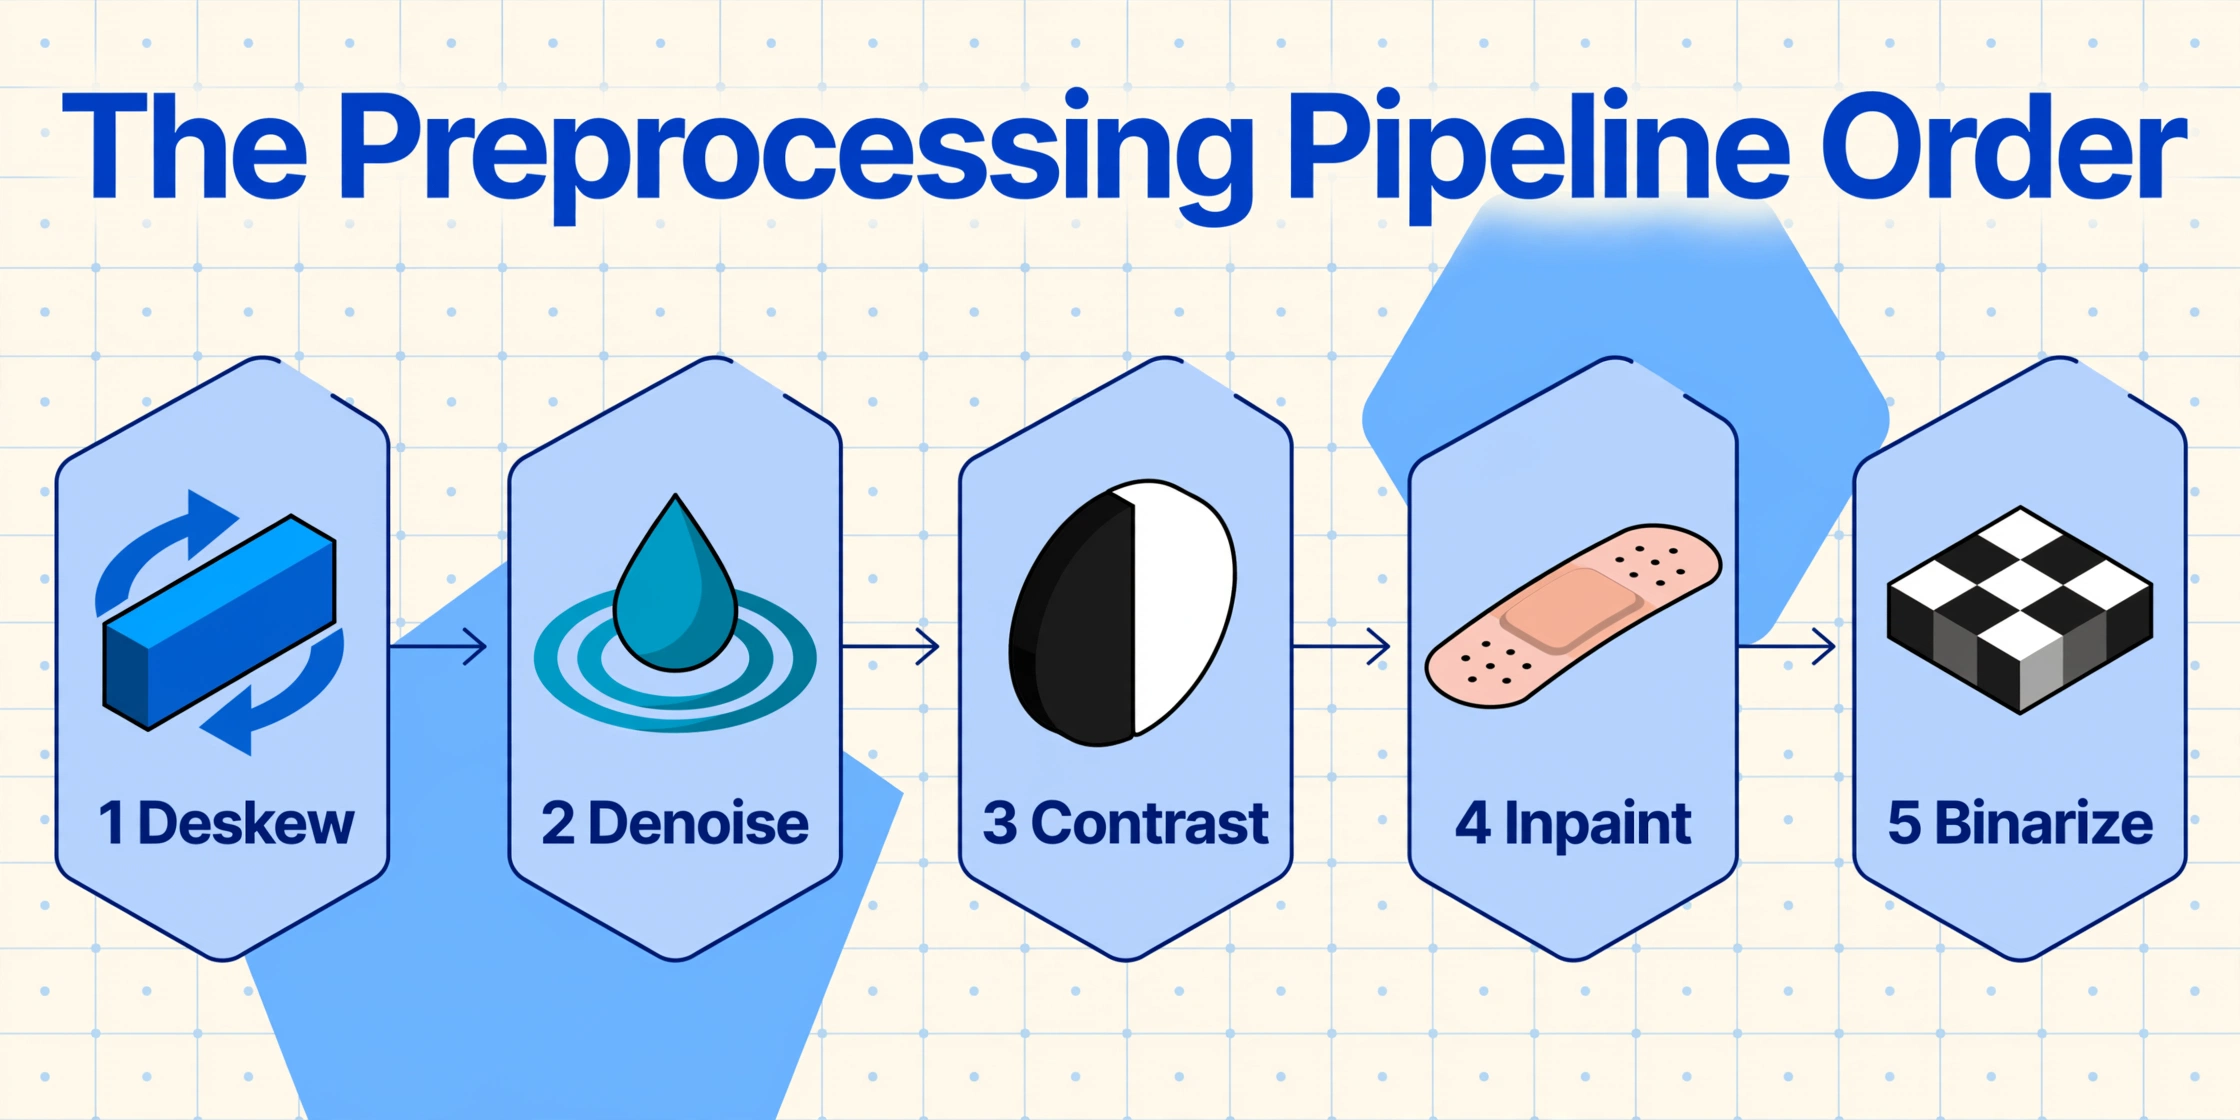
A maioria dos documentos digitalizados do mundo real tem mais de um defeito. Um contrato enviado por fax pode chegar com baixo DPI e artefatos de ruido. Uma ordem de compra antiga pode ter tinta desvanecida e uma dobra. A ordem em que você aplica as etapas de pré-processamento é importante.
A ordem recomendada do pipeline para documentos digitalizados com múltiples problemas de qualidade:
Este pipeline não é teórico — foi validado em milhares de imágenes de documentos degradados em múltiples benchmarks de OCR. Um guía dedicado para melhorar a precisión do OCR cobre técnicas de pós-processamento adicionais, incluindo corrección baseada em modelos de linguagem, validación a nível de campo e puntuación de confianza.
Quando o Pré-processamento Não é Suficiente
O pré-processamento pode levar um documento de "ilegível" para "utilizável" — mas apenas até certo ponto. Se a sua fonte foi digitalizada a 72 DPI em um scanner de mesa sujo, depois enviada por fax e digitalizada novamente, há um limite para o que a limpeza algorítmica pode recuperar. Em algum momento, a pergunta muda de "como eu corrijo esta imagem" para "estou usando a abordagem de extração certa?"
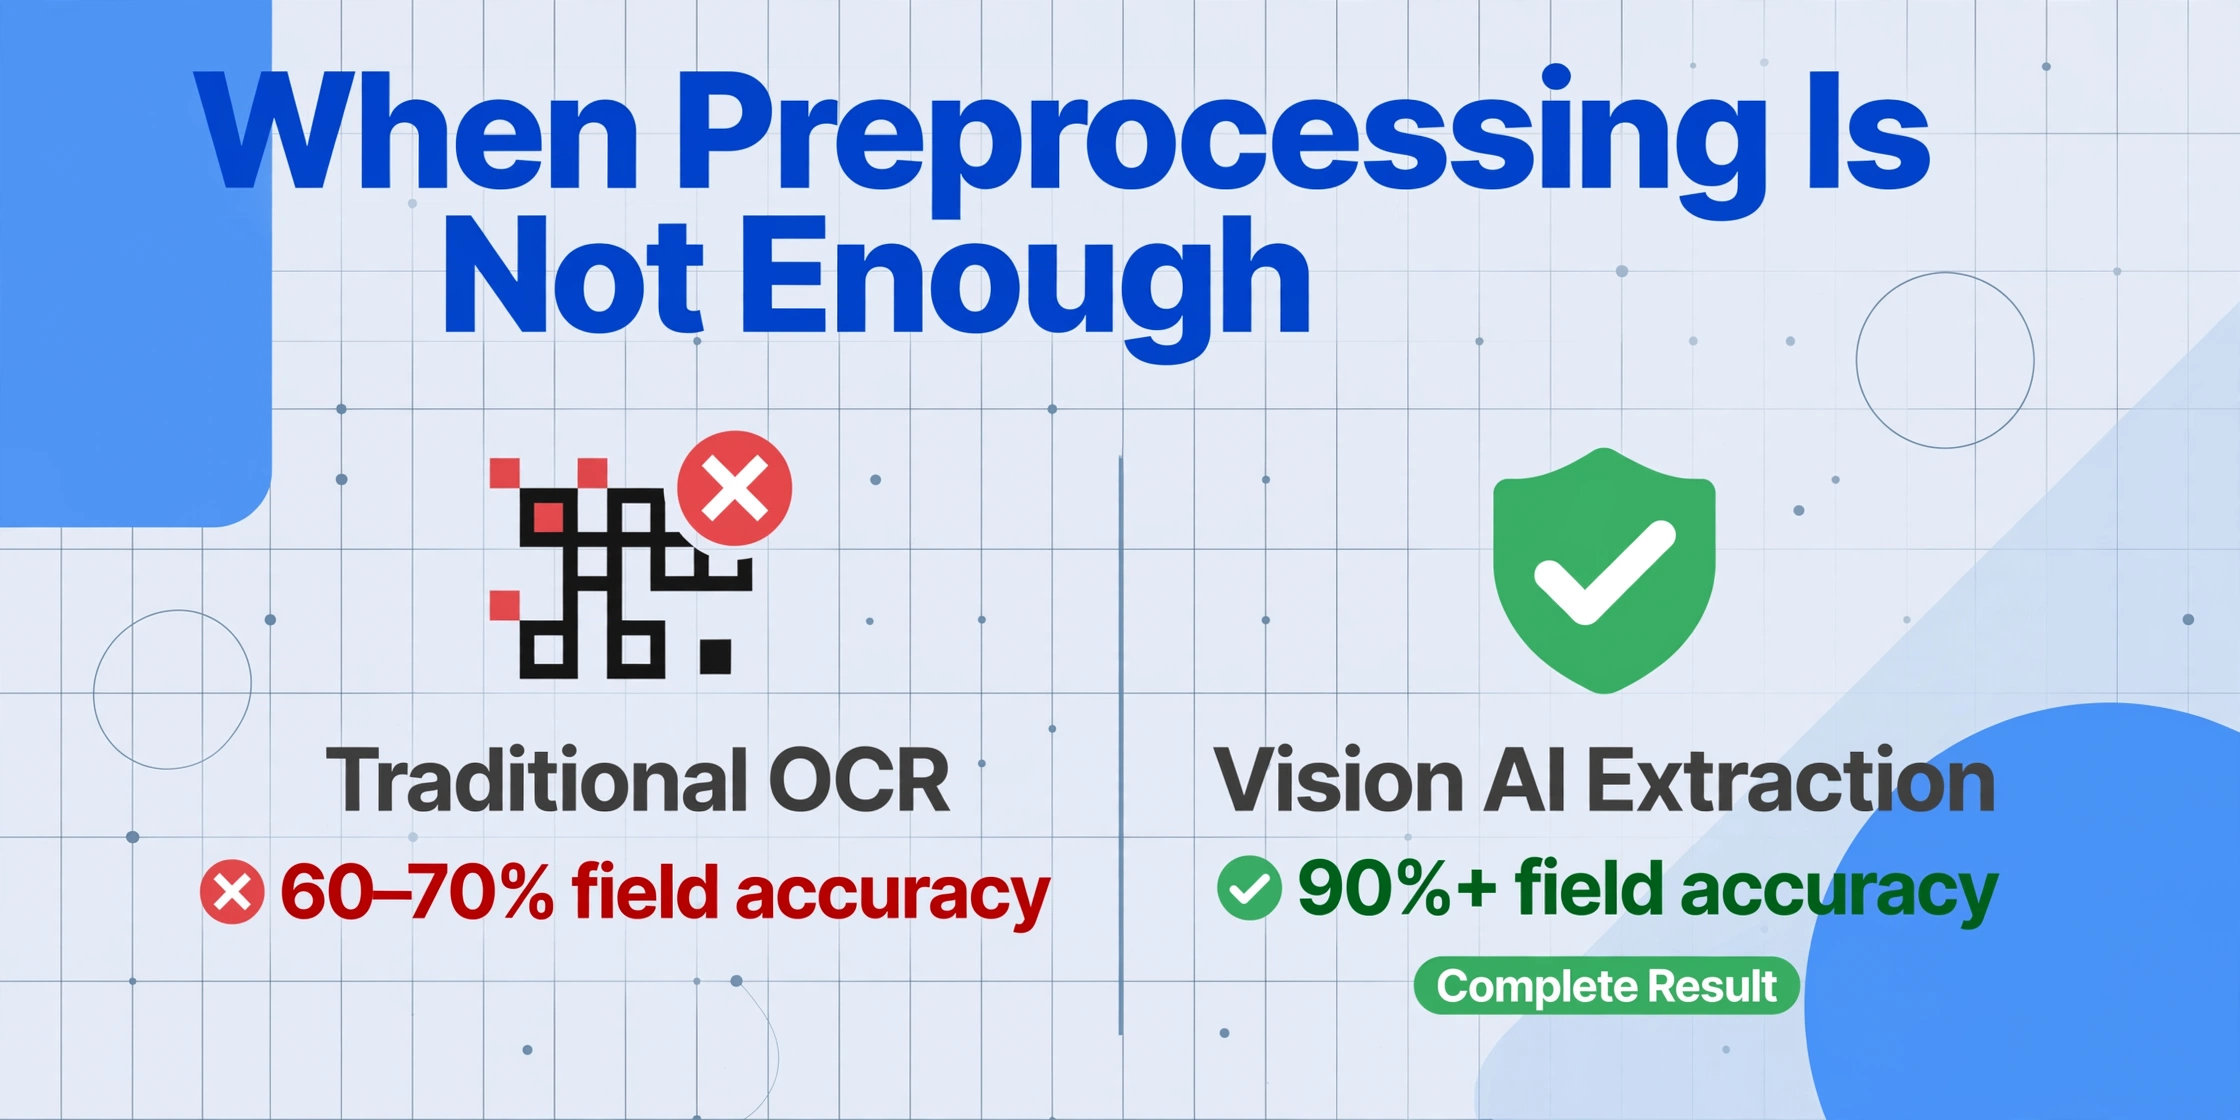
O OCR tradicional — Tesseract, ABBYY FineReader, a maioria das APIs de OCR em nuvem — funciona reconhecendo formatos de caracteres individuais. Ele é fundamentalmente baseado em pixels. Se os pixels estão danificados, a saída está danificada. A extração moderna com IA baseada em visão lê o documento como uma cena visual completa. Ela entende que uma palavra é uma palavra mesmo quando alguns de seus pixels estão faltando, porque ela compara com o significado, não com um modelo de formato de caractere.
A diferença aparece mais em documentos com múltiplos defeitos. Uma fatura em papel carbono com impressão roxa apagada, leve inclinação devido ao canto grampeado e um vinco sobre o endereço do fornecedor — o OCR tradicional pode produzir 60–70% de precisão de campo nesta entrada. Uma ferramenta de IA de visão pode frequentemente alcançar 90% ou mais porque trata a sombra do vinco como "não texto" e lê ao redor dela. Diferentes tipos de documento respondem de forma diferente à degradação de precisão, mas o princípio é consistente: quando o dano está nos pixels, a correção pode precisar estar no paradigma.
Perguntas Frequentes
Qual é o DPI mínimo para OCR confiável em documentos digitalizados?
300 DPI é o padrão do setor. Abaixo de 200 DPI, a precisão em nível de caractere degrada de forma mensurável na maioria dos mecanismos de OCR. Abaixo de 150 DPI, a precisão cai abaixo de 90% para texto impresso padrão. Se o seu texto for menor que corpo 10, recomenda-se 400–600 DPI. Há um efeito teto acima de 600 DPI — resoluções mais altas aumentam o tamanho do arquivo sem ganhos significativos de precisão para texto documental típico.
A IA consegue extrair dados de documentos digitalizados de baixíssima qualidade?
Os modelos de IA de visão são significativamente mais tolerantes a defeitos de imagem do que o OCR tradicional, pois processam a página semanticamente, e não pixel por pixel. Um documento legível ao olho humano — mesmo que minimamente — geralmente é extraível. A ressalva são documentos em que o texto está verdadeiramente invisível (tinta completamente desbotada ou fisicamente danificada). Nenhuma tecnologia consegue recuperar dados que não existem na imagem.
A correção de inclinação realmente melhora a precisão do OCR em uma quantidade significativa?
Sim. Uma inclinação de 5 graus aumenta a taxa de erro de palavras em 10–15% nos mecanismos de OCR tradicionais. A 10 graus, a perda pode exceder 30%. A correção de inclinação é uma das etapas de pré-processamento com maior retorno — custa praticamente nada em tempo de processamento e produz melhorias consistentes.
E se minha digitalização tiver tanto DPI baixo quanto ruído — o que eu corrijo primeiro?
Corrija o ruído primeiro e depois a resolução. A redução de ruído em uma imagem de baixa resolução é mais eficaz do que o inverso — se você aumentar a resolução primeiro, amplifica o ruído junto com o texto. A ordem do pipeline neste guia segue esse princípio: reduza o ruído antes do realce de contraste, e o realce de contraste antes de qualquer operação dependente de resolução.
Posso usar uma foto de smartphone em vez de um scan de mesa?
Fotos de smartphone introduzem distorção de perspectiva, desfoque de lente e iluminação irregular que scans de mesa não têm. Se um scanner de mesa estiver disponível, ele produzirá resultados mais consistentes. Se você precisar usar o celular, fotografe diretamente de cima da página, use luz natural uniforme e capture na resolução máxima — a maioria dos smartphones modernos excede o equivalente a 300 DPI quando mantidos próximos o suficiente.
A Abordagem Sistemática Vence
A baixa precisão de OCR em documentos digitalizados não é aleatória. É o resultado de defeitos de imagem identificáveis, cada um com um mecanismo conhecido e uma correção específica. O erro que a maioria das pessoas comete é aplicar filtros genéricos de "melhorar" ao problema — ajustando brilho e contraste arbitrariamente, na esperança de que algo funcione.
A abordagem sistemática é mais simples: observe a saída do OCR, identifique o padrão de erro, rastreie-o até a causa raiz e aplique a correção única. DPI baixo → aumente a resolução ou rescaneie. Inclinação → corrija a inclinação. Ruído → filtro mediano. Desbotamento → CLAHE. Vincos → inpainting. Quando o documento tem múltiplos defeitos, aplique as correções em ordem de dependência — ruído antes de resolução, correção de inclinação antes de tudo.
Se você aplicou as correções certas na ordem certa e a precisão ainda está abaixo do que seu fluxo de trabalho exige, a limitação não é o seu pré-processamento — é o paradigma de extração. Uma ferramenta de IA de visão que lê documentos pelo significado, em vez da forma dos pixels, pode ser o caminho mais rápido para resultados utilizáveis. Saiba mais sobre validação em nível de campo e métodos de verificação de precisão para quando o pré-processamento sozinho não for suficiente.