Faible précision OCR sur
documents numérisés ? 5 causes racines et correctifs
Vous avez numérisé une pile de documents, les avez soumis à l'OCR, et le résultat est rempli d'erreurs — des chiffres là où il devrait y avoir des lettres, la moitié des lignes manquantes, et un texte qui semble avoir passé dans un mixeur. Une inclinaison de page de seulement 5 degrés peut à elle seule augmenter le taux d'erreur de mots de 15 %, et les documents numérisés sous 200 DPI perdent systématiquement 10 à 20 % de précision au niveau des caractères avant même que le moteur OCR ne commence à travailler. Le problème vient rarement du moteur lui-même. Il s'agit presque toujours de l'interaction entre un défaut d'image spécifique et la manière dont le moteur le traite.
Points clés à retenir
- Lorsque l'OCR d'un document numérisé produit des résultats inutilisables, ce n'est presque jamais la faute du moteur ; cinq défauts d'image en sont les véritables responsables, chacun laissant une empreinte diagnostique que vous pouvez apprendre à lire.
- Une inclinaison de page à peine visible de 3 degrés ajoute 15 % d'erreur de mots, et une numérisation à 150 DPI perd silencieusement 20 % de la précision des caractères avant même que le moteur OCR ne touche le fichier.
- Chaque défaut a un correctif ciblé dans un ordre spécifique, et lorsque le prétraitement atteint sa limite, la réponse est un paradigme différent qui lit les documents par le sens plutôt que de lutter contre les pixels endommagés un à un.
Un document scanné est fondamentalement différent d'un PDF natif numérique. Lorsqu'un document est créé numériquement, le texte existe sous forme de formes vectorielles nettes. Un document scanné est une photographie d'une page imprimée — chaque défaut d'image présent dans cette photographie devient un problème que le moteur OCR doit résoudre avant de pouvoir reconnaître une seule lettre. Ce qui semble « assez proche » à l'œil humain peut être désespérément ambigu pour un algorithme travaillant au niveau du pixel.
La bonne nouvelle : la faible précision de l'OCR sur les documents scannés suit des schémas prévisibles. Chaque cause racine laisse une empreinte diagnostique, et une fois que vous identifiez le défaut auquel vous avez affaire, la correction est reproductible.
Cause 1 — Faible DPI : le tueur de précision le plus courant
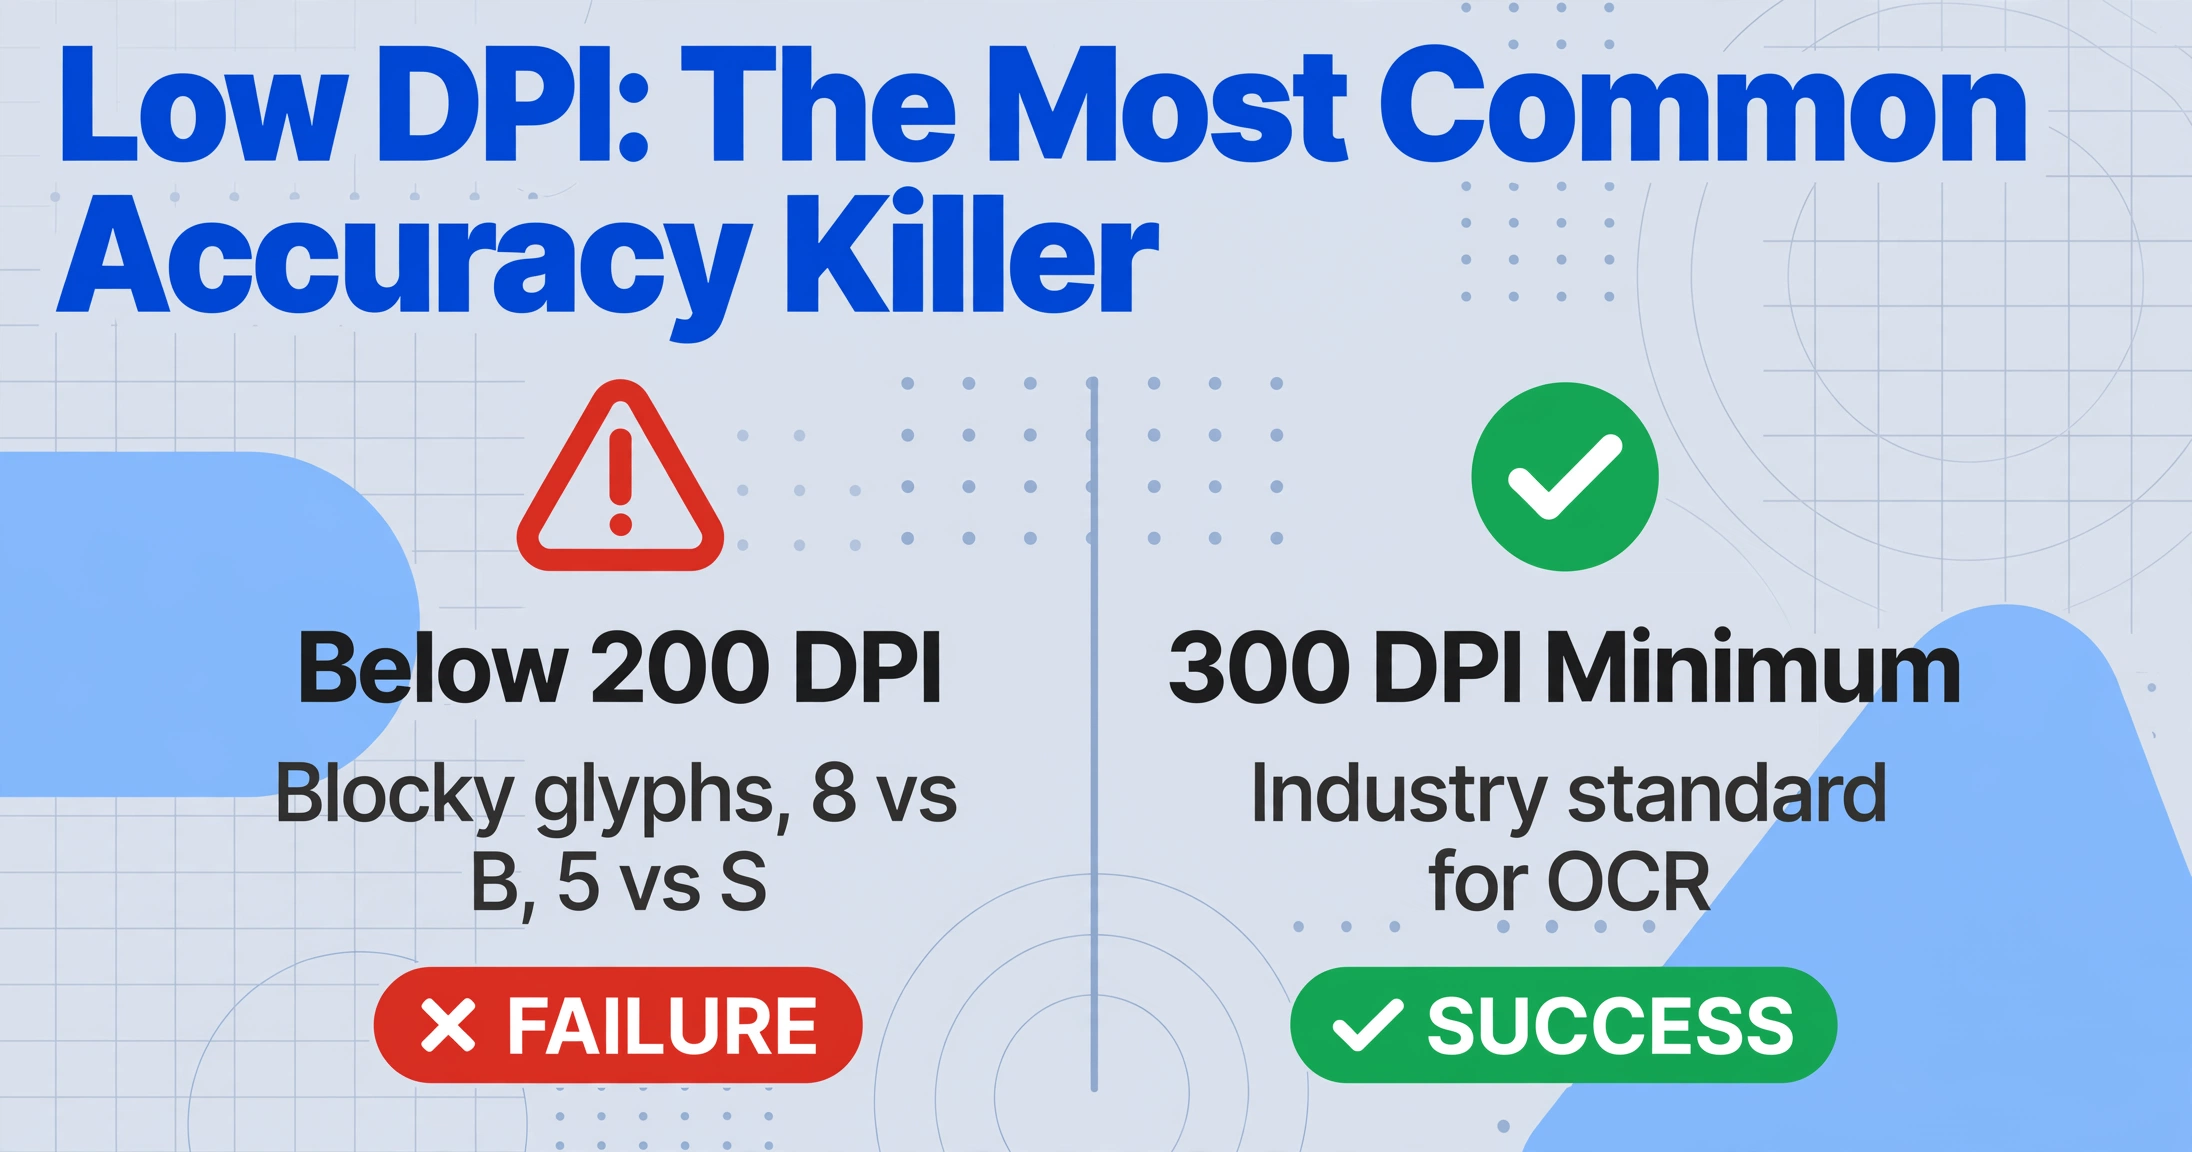
Le symptôme : Les caractères semblent pixelisés lorsque vous zoomez. L'OCR confond les glyphes similaires — 8 pour B, 5 pour S. Les mots se coupent de manière inattendue et la ponctuation est souvent manquée.
Pourquoi cela se produit : Le DPI (points par pouce) détermine le nombre de pixels que le scanner capture par pouce de la page physique. Sous 200 DPI, le nombre de pixels par caractère devient si faible que les formes distinctes des glyphes commencent à se ressembler. Un e et un c minuscules deviennent tous deux un amas de quelques pixels. À 150 DPI, la précision au niveau des caractères tombe sous 90 % pour la plupart des moteurs. À 100 DPI — approximativement ce qu'une photo de smartphone prise à hauteur de taille produit — la précision devient inutilisable pour tout document comportant des caractères petits.
La solution : Numérisez à 300 DPI minimum. C'est la norme industrielle pour l'OCR et cela équilibre la taille du fichier avec la qualité de reconnaissance. Pour un texte de moins de 10 points, augmentez à 400–600 DPI. Si vous ne pouvez pas renumériser, un pipeline de prétraitement avec suréchantillonnage super-résolution peut récupérer une précision mesurable à partir d'images qui semblent trop dégradées pour être utilisées.
Vérification rapide : Ouvrez votre image scannée à un zoom de 100 %. Si les bords des caractères semblent lisses, votre DPI est adéquat. S'ils ressemblent à un escalier ou à des pixels carrés visibles, vous êtes sous le seuil.
Cause 2 — Inclinaison et Dévers : Quand la Page n'est Pas Droite
Le symptôme : Les lignes de texte s'inclinent vers le haut ou le bas. Certains mots sont correctement détectés tandis que des mots adjacents sur la même ligne sont fragmentés. Les colonnes de tableau se décalent, et les données d'une colonne débordent dans la suivante.
Pourquoi cela arrive : La ROC traditionnelle suppose que le texte suit des lignes horizontales droites. Une inclinaison de 3 degrés — à peine perceptible à l'œil humain — fait que les caractères manquent la ligne de base attendue par le moteur. Les algorithmes de segmentation de ligne coupent les mots entre les rangées, et la reconnaissance des caractères échoue car le moteur compare les glyphes à des références pivotées. L'effet s'aggrave : ce qui commence par une inclinaison de 3 degrés en haut à gauche devient un décalage de plusieurs millimètres en bas à droite.
La solution : La plupart des bibliothèques de prétraitement incluent un redressement automatique — un algorithme qui détecte l'angle dominant du texte et fait pivoter l'image pour compenser. Appliquez le redressement avant la binarisation ; les images binaires perdent les informations subtiles de dégradé dont dépend la détection d'angle. C'est aussi là que l'extraction par IA basée sur la vision se distingue de la ROC traditionnelle — les modèles de vision traitent la page comme une scène visuelle globale et sont intrinsèquement plus tolérants à la rotation.
Cause 3 — Bruit et Artefacts de Compression
Le symptôme : Des caractères supplémentaires apparaissent dans la sortie — points aléatoires, virgules ou fragments qui n'existent pas sur la page originale. Des zones qui semblent être des espaces blancs propres contiennent du « texte fantôme » dans le résultat d'extraction.
Pourquoi cela arrive : Le bruit poivre et sel — des points noirs et blancs — est courant dans les documents faxés et les scans provenant d'une vitre de scanner sale. Les artefacts de compression JPEG créent des distorsions en blocs autour des bords des caractères, que la ROC interprète comme faisant partie du glyphe. Les tampons et sceaux chevauchant le texte imprimé perturbent la détection des limites des caractères — le moteur tente de séparer l'encre du tampon de l'encre imprimée et se trompe souvent sur les deux.
La solution : Un filtre médian (taille de noyau 3×3 ou 5×5) supprime le bruit poivre et sel tout en préservant mieux les bords des caractères qu'un flou gaussien. Pour les artefacts JPEG, un filtre bilatéral lisse les limites de compression sans adoucir le texte. Si les tampons sont le problème principal, un filtrage basé sur la couleur dans l'espace HSV peut isoler et supprimer l'encre de tampon superposée avant la ROC. Pour les motifs d'arrière-plan comme les filigranes ou les impressions de sécurité, utilisez un seuillage adaptatif (Otsu ou Sauvola), qui calcule les niveaux de luminosité locaux et applique différents seuils à différentes régions de la page — obtenant à la fois une suppression de l'arrière-plan et une préservation des caractères qu'un seul seuil global ne peut pas atteindre.
Cause 4 — Contraste insuffisant et délavage : texte invisible
Le symptôme : Des lignes entières disparaissent du résultat. Ce que le moteur détecte est fragmentaire — mots partiels, caractères manquants au milieu de termes reconnaissables. Le résultat ressemble à des échantillons aléatoires de l'original.
Pourquoi cela se produit : L'encre délavée, le papier thermique vieilli et les copies carbone partagent le même problème : le contraste entre l'encre et le papier est trop faible pour que l'OCR les sépare de manière fiable. Lorsque le moteur binarise l'image, les pixels en dessous de son seuil de luminosité sont classés comme « arrière-plan » et supprimés. Si l'encre est suffisamment claire — ou le papier suffisamment jauni — les caractères disparaissent tout simplement. Les tickets de caisse thermiques sont tristement célèbres : la couche d'image se dégrade continuellement dès l'impression, et un reçu lisible il y a six mois peut aujourd'hui produire un résultat vierge.
La solution : CLAHE (égalisation adaptative d'histogramme à contraste limité) est la technique la plus efficace — elle amplifie les différences de contraste locales sans amplifier excessivement le bruit dans les zones uniformes. Appliquez-la avec une limite de contraste de 2,0 à 3,0 et une taille de grille correspondant à la taille de votre texte. Pour le papier thermique qui a uniformément foncé, inversez l'image avant le traitement — la binarisation du moteur peut mieux fonctionner sur du texte clair sur fond sombre. Pour un délavage irrégulier, la binarisation adaptative (méthode de Sauvola) gère mieux les variations locales que les méthodes globales.
Cause 5 — Pliures et dommages physiques
Le symptôme : Une bande sombre traverse le résultat OCR, avec des caractères le long de la bande manquants ou remplacés par du charabia. Près des lignes de pli, le texte peut apparaître déplacé ou dupliqué.
Pourquoi cela se produit : Un pli physique crée une ligne d'ombre lors de la numérisation — suffisamment sombre pour que la binarisation du moteur la traite comme un objet de premier plan. Les caractères qui croisent l'ombre sont obscurcis ou divisés en fragments. Sur les documents fortement pliés, le changement d'élévation du papier au niveau du pli pousse la page hors de la profondeur de champ du scanner, ajoutant une bande de flou à l'ombre. La combinaison crée le pire scénario pour l'OCR : forte variation de contraste, caractères flous et formes de glyphes brisées.
La solution : L'inpainting — remplissage des zones endommagées par interpolation à partir des pixels environnants — est le remède le plus efficace. La fonction cv2.inpaint() d'OpenCV avec l'algorithme Telea supprime les ombres des plis tout en préservant le texte sous-jacent. Commencez avec un rayon d'inpainting de 3 à 5 pixels. Pour les bords déchirés où le texte a été physiquement supprimé, la dilatation morphologique (un noyau 2×2 sur l'image binaire) reconnecte les traits brisés, transformant souvent des fragments méconnaissables en glyphes lisibles.
Construire un pipeline de prétraitement qui gère plusieurs défauts
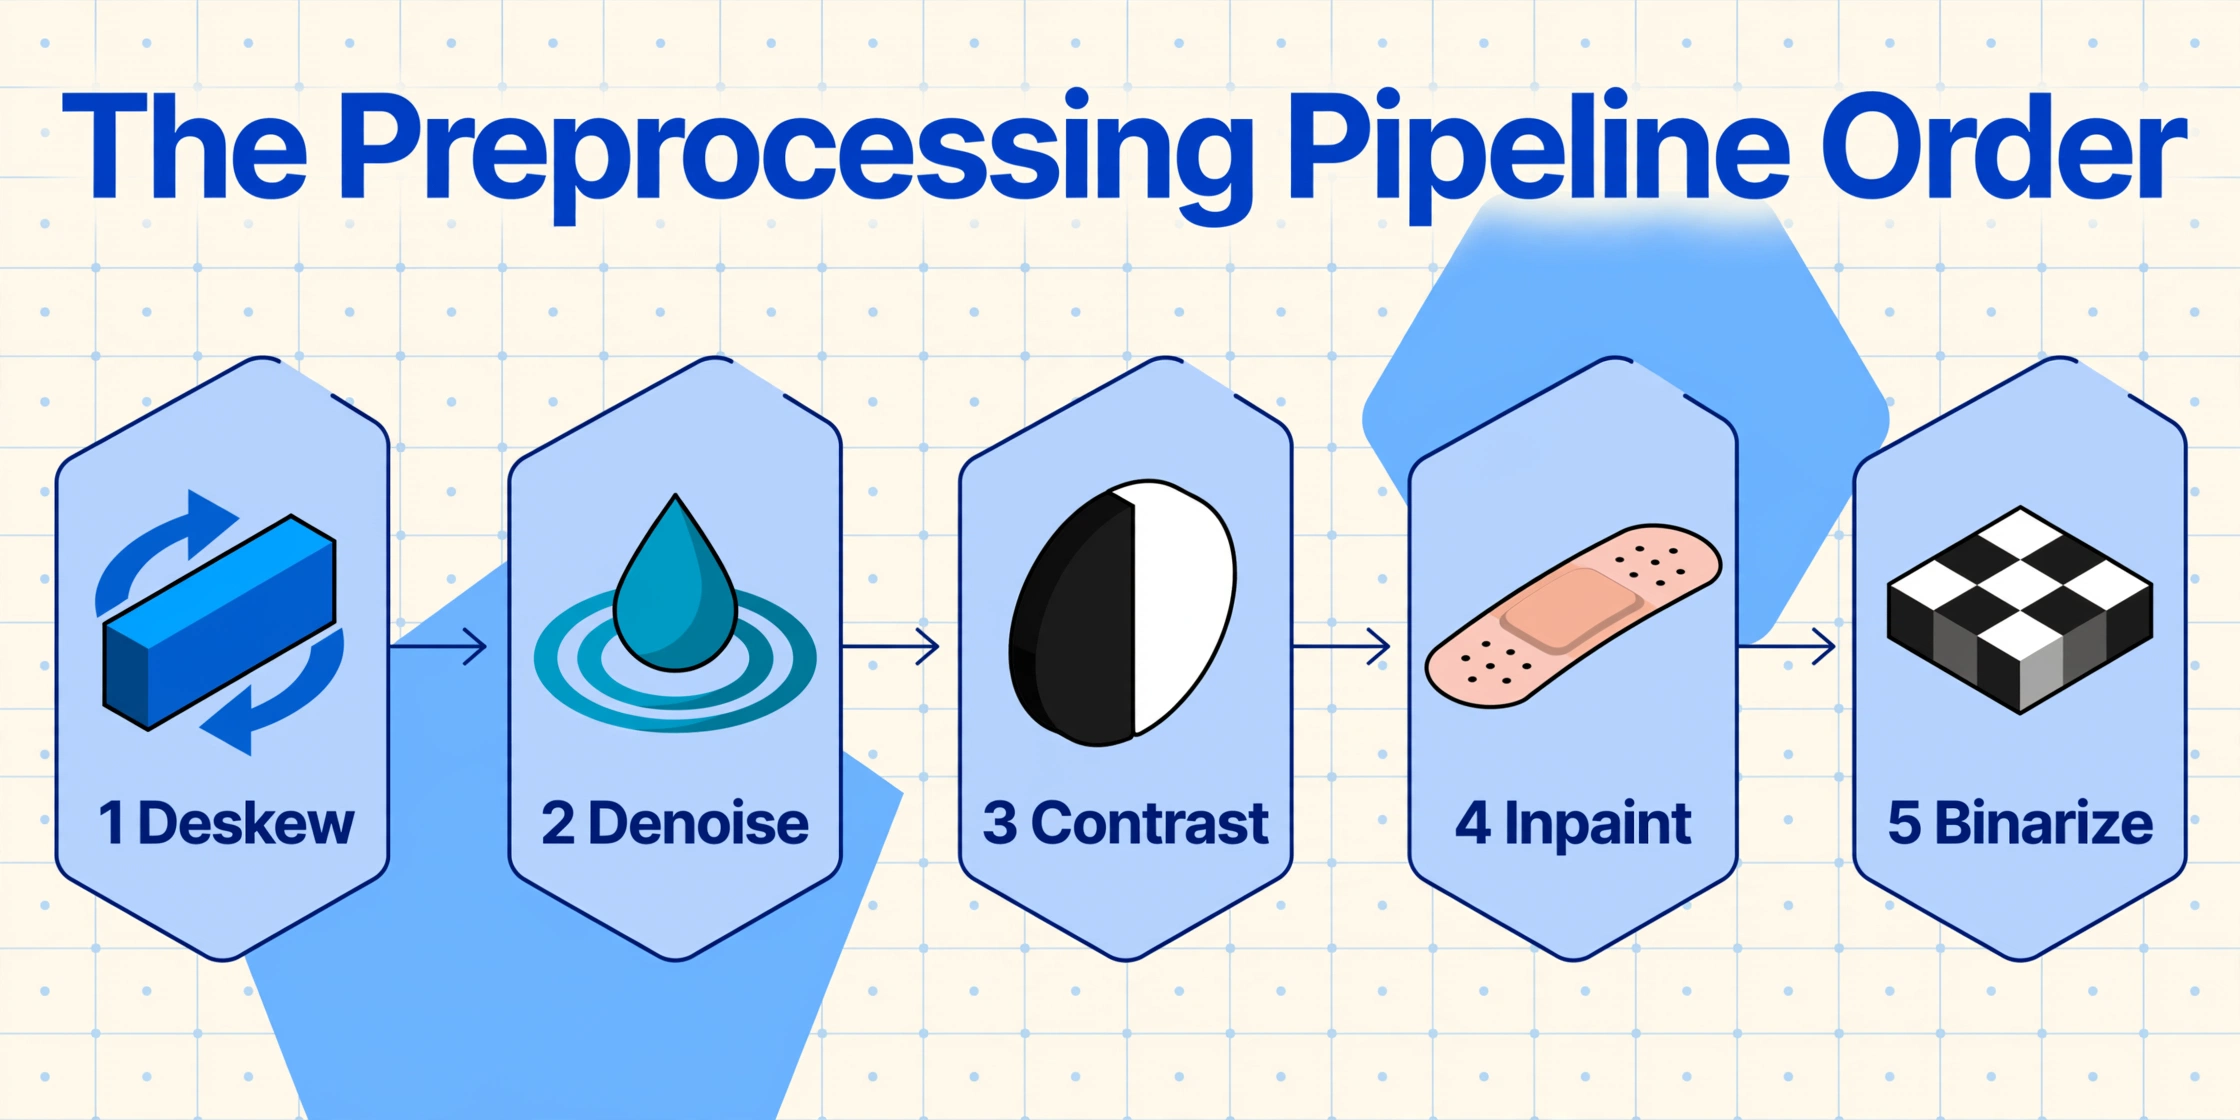
La plupart des documents numérisés réels présentent plus d'un défaut. Un contrat reçu par fax peut arriver avec à la fois un faible DPI et des artefacts de bruit. Un bon de commande ancien peut avoir une encre délavée et un pli. L'ordre dans lequel vous appliquez les étapes de prétraitement est important.
L'ordre de pipeline recommandé pour les documents numérisés présentant plusieurs problèmes de qualité :
Ce pipeline n'est pas théorique — il a été validé sur des milliers d'images de documents dégradés dans le cadre de plusieurs références OCR. Un guide dédié à l'amélioration de la précision de l'OCR couvre des techniques de post-traitement supplémentaires, notamment la correction basée sur un modèle de langage, la validation au niveau des champs et le calcul de score de confiance.
Quand le prétraitement ne suffit pas
Le prétraitement peut faire passer un document de « illisible » à « exploitable » — mais seulement jusqu'à un certain point. Si votre source a été numérisée à 72 DPI sur un scanner à plat sale, puis faxée, puis numérisée à nouveau, il y a une limite à ce que le nettoyage algorithmique peut récupérer. À un moment donné, la question passe de « comment réparer cette image » à « est-ce que j'utilise la bonne approche d'extraction ? »
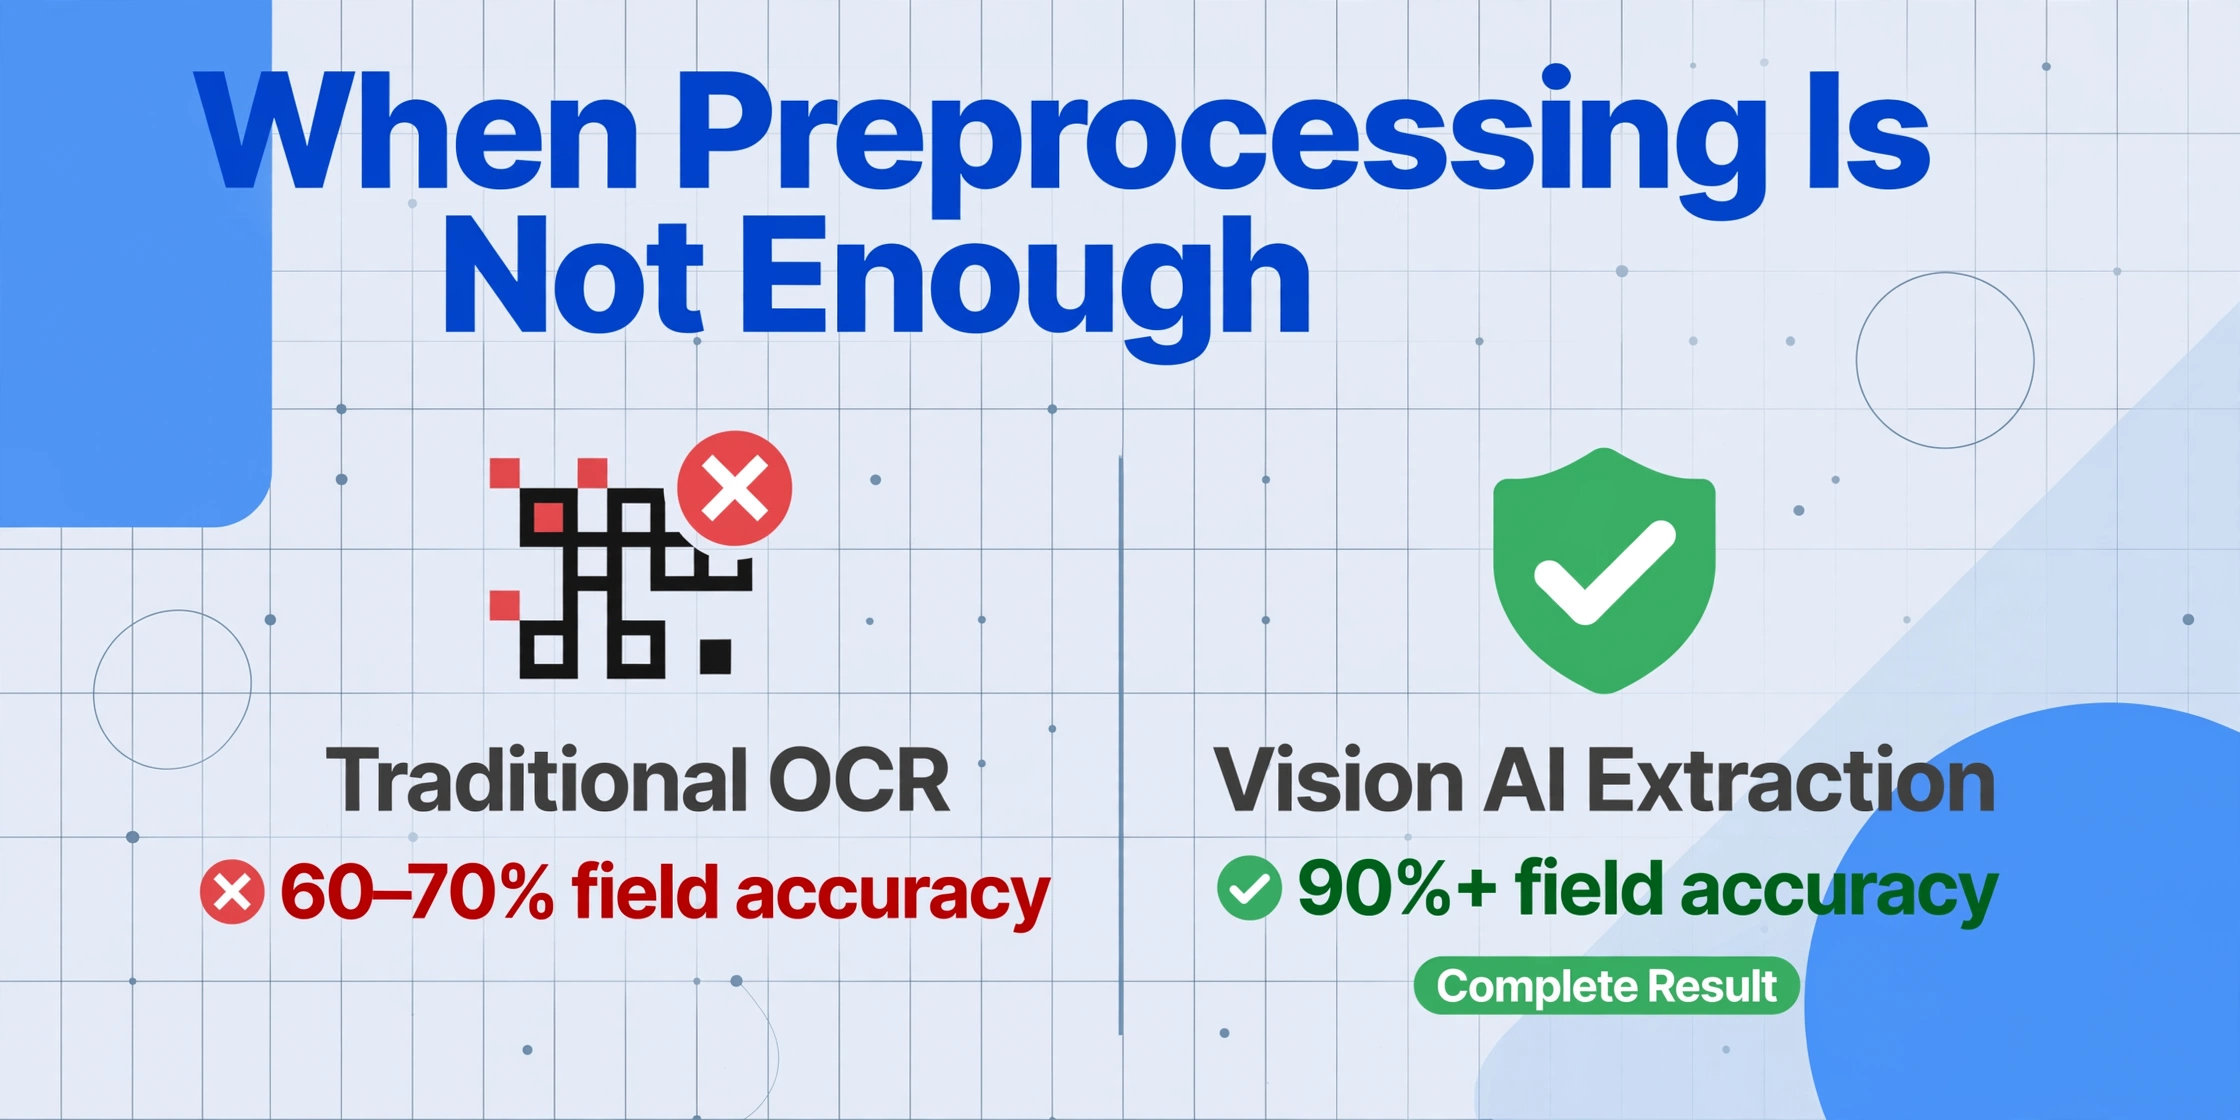
L'OCR traditionnel — Tesseract, ABBYY FineReader, la plupart des API OCR cloud — fonctionne en reconnaissant des formes de caractères individuelles. Il est fondamentalement au niveau des pixels. Si les pixels sont endommagés, la sortie est endommagée. L'extraction moderne par IA basée sur la vision lit le document comme une scène visuelle globale. Elle comprend qu'un mot est un mot même lorsque certains de ses pixels manquent, car elle s'appuie sur le sens, et non sur un modèle de forme de caractère.
La différence est la plus visible sur les documents présentant des défauts multiples. Une facture en copie carbone avec une impression violette pâle, une légère inclinaison due au coin agrafé et un pli traversant l'adresse du fournisseur — l'OCR traditionnel pourrait produire une précision des champs de 60 à 70 % sur cette entrée. Un outil d'IA vision peut souvent atteindre 90 % ou plus, car il traite l'ombre du pli comme « non-texte » et lit autour. Différents types de documents réagissent différemment à la dégradation de la précision, mais le principe est cohérent : lorsque les dommages sont dans les pixels, la solution peut devoir se trouver dans le paradigme.
Questions fréquemment posées
Quel est le DPI minimum pour une OCR fiable sur des documents numérisés ?
300 DPI est la norme du secteur. En dessous de 200 DPI, la précision au niveau des caractères se dégrade de manière mesurable pour la plupart des moteurs d'OCR. En dessous de 150 DPI, la précision tombe sous les 90 % pour un texte imprimé standard. Si votre texte est plus petit qu'une police de 10 points, un DPI de 400 à 600 est recommandé. Au-delà de 600 DPI, l'effet plafond s'applique — des résolutions plus élevées augmentent la taille du fichier sans gains de précision significatifs pour un texte documentaire typique.
L'IA peut-elle extraire des données de documents numérisés de très mauvaise qualité ?
Les modèles d'IA vision sont nettement plus tolérants aux défauts d'image que l'OCR traditionnelle, car ils traitent la page de manière sémantique plutôt que pixel par pixel. Un document lisible à l'œil humain — même à peine — est généralement extractible. La limite concerne les documents où le texte est réellement invisible (encre complètement délavée ou support physiquement déchiré). Aucune technologie ne peut récupérer des données qui n'existent pas dans l'image.
La redressement améliore-t-il réellement la précision de l'OCR de manière significative ?
Oui. Une inclinaison de 5 degrés augmente le taux d'erreur sur les mots de 10 à 15 % pour les moteurs d'OCR traditionnels. À 10 degrés, la perte peut dépasser 30 %. Le redressement est l'une des étapes de prétraitement au meilleur retour sur investissement — il ne coûte pratiquement rien en temps de traitement et produit des améliorations constantes.
Que faire si ma numérisation présente à la fois un faible DPI et du bruit — que corriger en premier ?
Corrigez le bruit d'abord, puis traitez la résolution. Débruiter une image basse résolution est plus efficace que l'inverse — si vous augmentez la résolution d'abord, vous amplifiez le bruit en même temps que le texte. L'ordre du pipeline dans ce guide suit ce principe : débruitage avant l'amélioration du contraste, et amélioration du contraste avant toute opération dépendante de la résolution.
Puis-je utiliser une photo de smartphone au lieu d’un scan à plat ?
Les photos de smartphone introduisent des distorsions de perspective, un flou d’objectif et un éclairage irrégulier que les scans à plat n’ont pas. Si un scanner à plat est disponible, il produira des résultats plus cohérents. Si vous devez utiliser un téléphone, photographiez la page directement d’en haut, utilisez une lumière naturelle et uniforme, et capturez à la résolution maximale — la plupart des téléphones modernes dépassent l’équivalent de 300 DPI lorsqu’ils sont tenus assez près.
L’approche systématique gagne
Une faible précision OCR sur des documents numérisés n’est pas aléatoire. Elle résulte de défauts d’image identifiables, chacun ayant un mécanisme connu et une solution ciblée. L’erreur que la plupart des gens commettent est d’appliquer des filtres « d’amélioration » génériques au problème — en ajustant la luminosité et le contraste arbitrairement, en espérant que quelque chose fonctionne.
L’approche systématique est plus simple : examinez votre sortie OCR, identifiez le type d’erreur, remontez à sa cause racine et appliquez la solution unique. Faible DPI → augmenter la résolution ou renumériser. Inclinaison → redressement. Bruit → filtre médian. Décoloration → CLAHE. Pliures → inpainting. Lorsque le document présente plusieurs défauts, appliquez les correctifs dans l’ordre de dépendance — le bruit avant la résolution, le redressement avant tout le reste.
Si vous avez appliqué les bons correctifs dans le bon ordre et que la précision est toujours inférieure à ce que votre flux de travail exige, la contrainte ne vient pas de votre prétraitement — elle vient du paradigme d’extraction. Un outil d’IA de vision qui lit les documents par le sens plutôt que par la forme des pixels peut être le chemin le plus rapide vers des résultats exploitables. En savoir plus sur les méthodes de validation au niveau des champs et de vérification de la précision lorsque le prétraitement seul ne suffit pas.