¿Baja precisión del OCR en
documentos escaneados? 5 causas raíz y soluciones
Escaneó una pila de documentos, los pasó por OCR y el resultado está lleno de errores: números donde debería haber letras, la mitad de las líneas faltantes y texto que parece haber pasado por una licuadora. Una inclinación de página de solo 5 grados puede aumentar la tasa de error de palabras en un 15 %, y los documentos escaneados por debajo de 200 DPI pierden habitualmente entre un 10 % y un 20 % de precisión a nivel de caracteres antes de que el motor de OCR siquiera comience a funcionar. El problema rara vez es el motor en sí mismo. Casi siempre es la interacción entre un defecto específico de la imagen y la forma en que el motor lo procesa.
Conclusiones clave
- Cuando el OCR de documentos escaneados produce resultados inservibles, casi nunca es culpa del motor: los cinco defectos de imagen son los verdaderos culpables, y cada uno deja una huella diagnóstica que usted puede aprender a leer.
- Una inclinación de página de 3 grados apenas visible añade un 15 % de error por palabra, y un escaneo de 150 DPI pierde silenciosamente un 20 % de precisión a nivel de caracteres antes de que el motor de OCR siquiera toque el archivo.
- Cada defecto tiene una corrección específica que aplicar en un orden determinado, y cuando el preprocesamiento alcanza su límite, la respuesta es un paradigma diferente que lee los documentos por su significado en lugar de luchar contra los píxeles dañados uno a uno.
Un documento escaneado es fundamentalmente diferente de un PDF creado digitalmente. Cuando un documento se crea de forma digital, el texto existe como formas vectoriales limpias. Un documento escaneado es una fotografía de una página impresa: cada defecto de imagen presente en esa fotografía se convierte en un problema que el motor de OCR debe resolver antes de poder reconocer una sola letra. Lo que parece «suficientemente cercano» al ojo humano puede ser irremediablemente ambiguo para un algoritmo que trabaja a nivel de píxel.
La buena noticia: la baja precisión del OCR en documentos escaneados sigue patrones predecibles. Cada causa raíz deja una huella diagnóstica, y una vez que identifica con qué defecto está tratando, la solución es repetible.
Causa 1 — Bajo DPI: el asesino de precisión más común
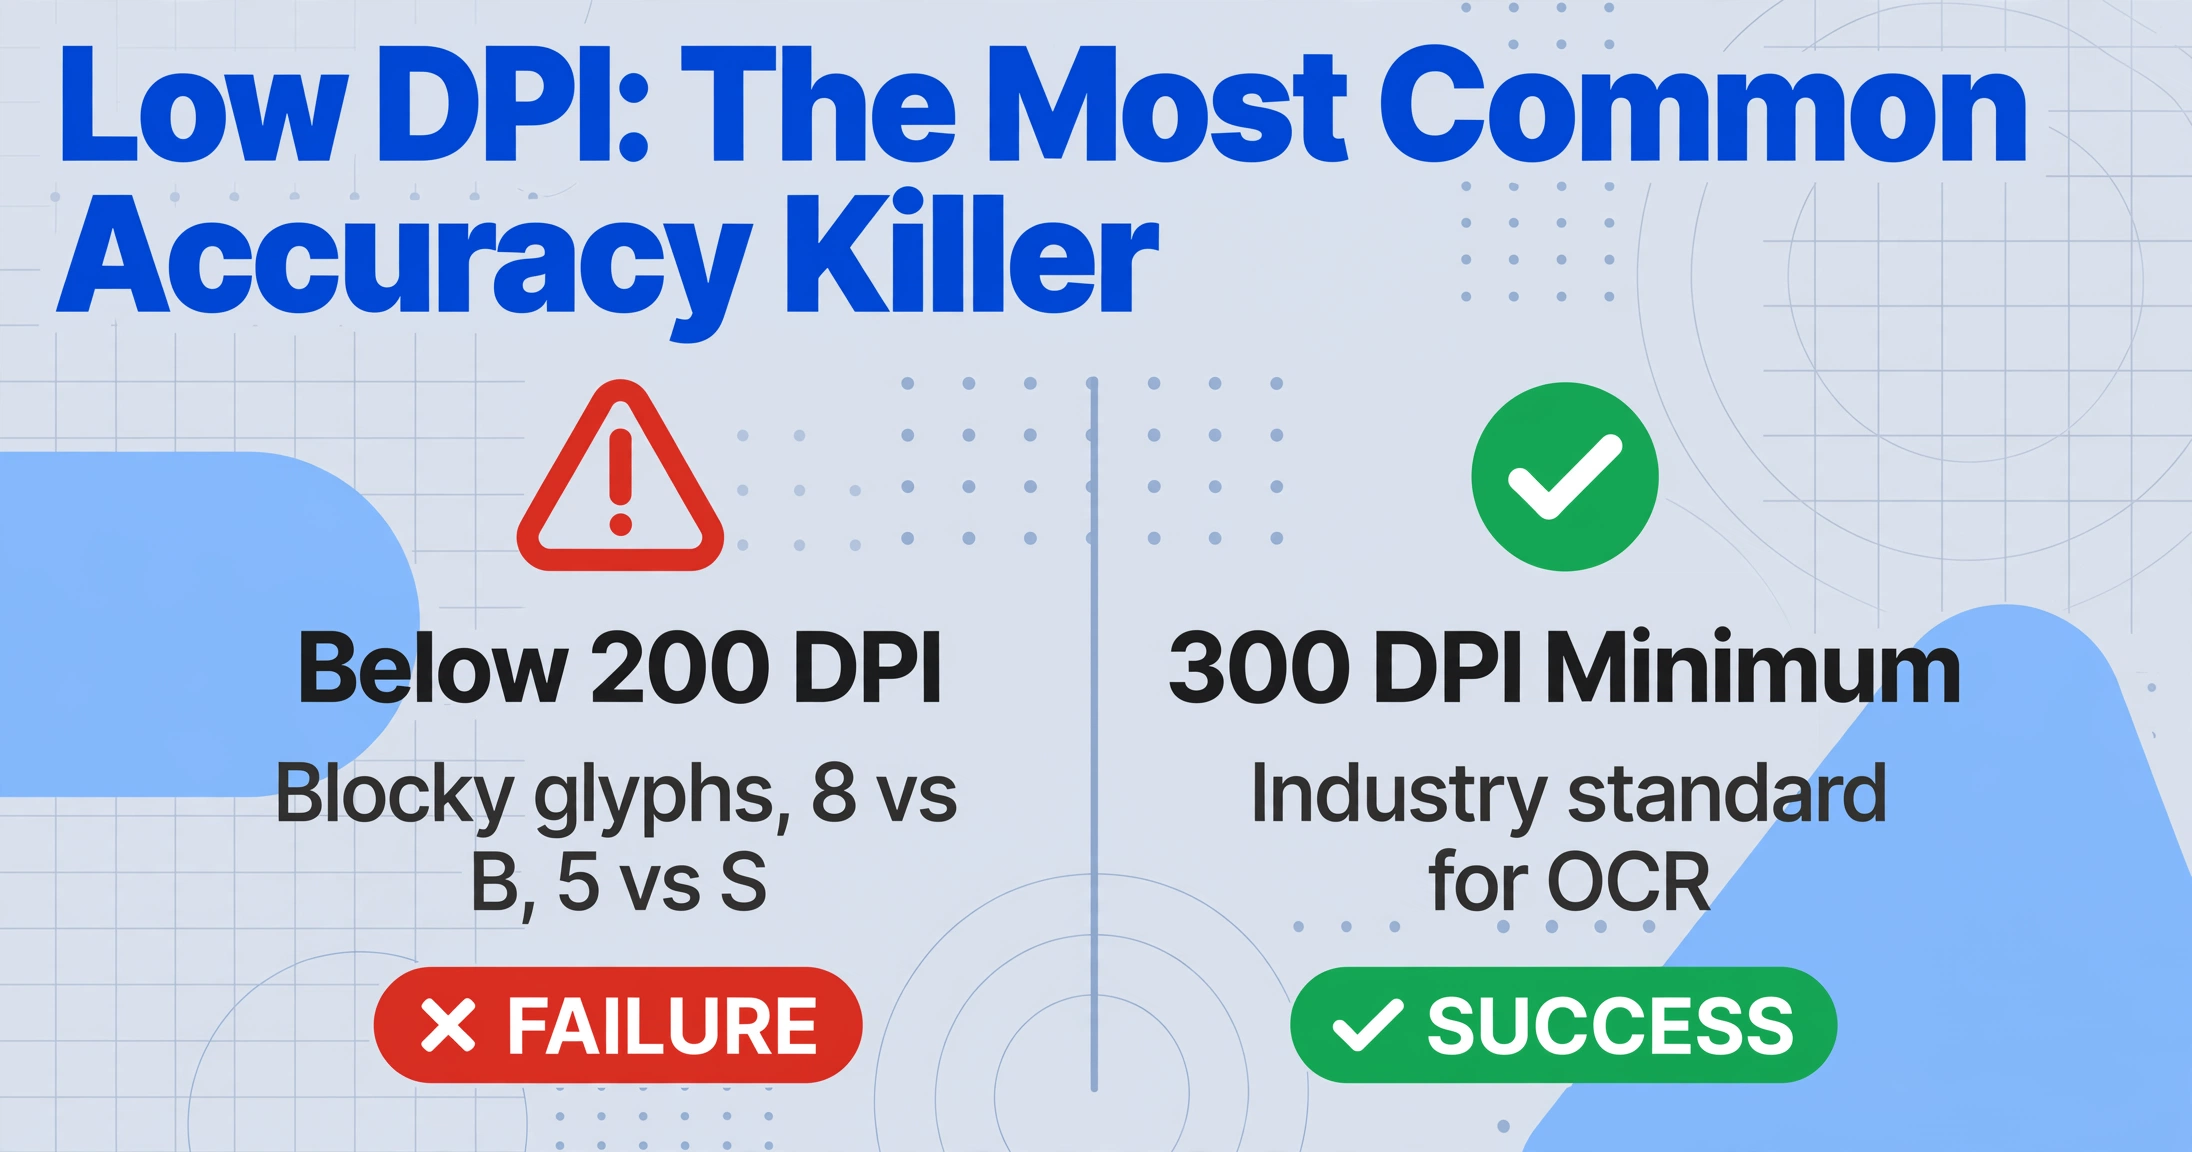
El síntoma: Los caracteres se ven en bloques al hacer zoom. El OCR confunde glifos similares: 8 como B, 5 como S. Las palabras se dividen inesperadamente y la puntuación se pierde con frecuencia.
Por qué ocurre: El DPI (puntos por pulgada) determina cuántos píxeles captura el escáner por pulgada de la página física. Por debajo de 200 DPI, el recuento de píxeles por carácter se vuelve tan pequeño que las formas distintivas de los glifos empiezan a parecer idénticas. Una e y una c minúsculas se convierten ambas en una mancha de unos pocos píxeles. A 150 DPI, la precisión a nivel de carácter cae por debajo del 90% en la mayoría de los motores. A 100 DPI — aproximadamente lo que produce una foto de teléfono inteligente tomada desde la altura de la cintura — la precisión se vuelve inutilizable para cualquier documento con letra pequeña.
La solución: Escanee a 300 DPI como mínimo. Este es el estándar de la industria para OCR y equilibra el tamaño del archivo con la calidad de reconocimiento. Para texto inferior a 10 puntos, aumente a 400–600 DPI. Si no puede volver a escanear, un proceso de preprocesamiento con ampliación de superresolución puede recuperar precisión medible en imágenes que parecen demasiado degradadas para usar.
Verificación rápida: Abra su imagen escaneada al 100% de zoom. Si los bordes de los caracteres se ven suaves, su DPI es adecuado. Si parecen una escalera o píxeles cuadrados visibles, está por debajo del umbral.
Causa 2 — Inclinación y Desviación: Cuando la Página No Está Recta
El síntoma: Las líneas de texto se inclinan hacia arriba o hacia abajo. Algunas palabras se detectan correctamente mientras que otras adyacentes en la misma línea aparecen fragmentadas. Las columnas de tablas se desplazan y los datos que pertenecen a una columna se derraman en la siguiente.
Por qué ocurre: El OCR tradicional asume que el texto corre en líneas horizontales rectas. Una inclinación de 3 grados —apenas perceptible al ojo humano— hace que los caracteres no coincidan con la línea base que el motor espera. Los algoritmos de segmentación de líneas dividen palabras entre renglones y el reconocimiento de caracteres falla porque el motor compara glifos con referencias rotadas. El efecto se acumula: lo que comienza como una inclinación de 3 grados en la esquina superior izquierda se convierte en un desplazamiento de varios milímetros en la esquina inferior derecha.
La solución: La mayoría de las bibliotecas de preprocesamiento incluyen enderezamiento automático —un algoritmo que detecta el ángulo dominante del texto y rota la imagen para compensarlo. Aplica el enderezamiento antes de la binarización; las imágenes binarias pierden la información sutil de degradado de la que depende la detección de ángulos. Aquí también es donde la extracción basada en visión artificial se separa del OCR tradicional —los modelos de visión procesan la página como una escena visual completa y son inherentemente más tolerantes a la rotación.
Causa 3 — Ruido y Artefactos de Compresión
El síntoma: Aparecen caracteres extra en la salida —puntos aleatorios, comas o fragmentos que no existen en la página original. Áreas que parecen espacios en blanco limpios contienen "texto fantasma" en el resultado de la extracción.
Por qué ocurre: El ruido sal-y-pimienta —motas blancas y negras— es común en documentos enviados por fax y escaneos de vidrio sucio. Los artefactos de compresión JPEG crean distorsiones en bloque alrededor de los bordes de los caracteres, que el OCR interpreta como parte del glifo. Los sellos y timbres que se superponen al texto impreso confunden la detección de límites de caracteres —el motor intenta separar la tinta del sello de la tinta impresa y a menudo se equivoca con ambas.
La solución: Un filtro de mediana (tamaño de kernel 3×3 o 5×5) elimina el ruido sal-y-pimienta preservando mejor los bordes de los caracteres que el desenfoque gaussiano. Para artefactos JPEG, un filtro bilateral suaviza los límites de compresión sin ablandar el texto. Si los sellos son el problema principal, el filtrado basado en color en espacio HSV puede aislar y eliminar la tinta del sello superpuesta antes del OCR. Para patrones de fondo como marcas de agua o impresiones de seguridad, usa umbralización adaptativa (Otsu o Sauvola), que calcula niveles de brillo local y aplica diferentes umbrales a distintas regiones de la página —logrando tanto la supresión del fondo como la preservación de caracteres que un solo umbral global no puede conseguir.
Causa 4 — Desvanecimiento y Bajo Contraste: Texto Invisible
El síntoma: Líneas de texto completas desaparecen de la salida. Lo que el motor detecta es fragmentario: palabras parciales, caracteres faltantes en medio de términos reconocibles. La salida parece piezas muestreadas al azar del original.
Por qué ocurre: Tinta desvaída, papel térmico envejecido y copias carbón comparten el mismo problema: el contraste entre tinta y papel es demasiado bajo para que el OCR las separe de forma fiable. Cuando el motor binariza la imagen, los píxeles por debajo de su umbral de brillo se clasifican como "fondo" y se descartan. Si la tinta es lo suficientemente clara — o el papel lo suficientemente amarillento — los caracteres simplemente se desvanecen. Los recibos de papel térmico son notorios: la capa de imagen se degrada continuamente desde el momento en que se imprimen, y un recibo legible hace seis meses ahora puede producir una salida en blanco.
La solución: CLAHE (Ecualización Adaptativa de Histograma con Limitación de Contraste) es la técnica más efectiva: amplifica las diferencias de contraste local sin amplificar en exceso el ruido en áreas uniformes. Aplíquelo con un límite de recorte de 2.0–3.0 y un tamaño de cuadrícula que coincida con el tamaño de su texto. Para papel térmico que se ha oscurecido uniformemente, invierta la imagen antes de procesar — la binarización del motor puede funcionar mejor con texto claro sobre fondo oscuro. Para desvanecimiento desigual, la binarización adaptativa (método Sauvola) maneja la variación local mejor que los métodos globales.
Causa 5 — Pliegues y Daños Físicos
El síntoma: Una banda oscura atraviesa la salida del OCR, con caracteres a lo largo de la banda faltantes o reemplazados por basura. Cerca de las líneas de pliegue, el texto puede aparecer desplazado o duplicado.
Por qué ocurre: Un pliegue físico crea una línea de sombra al escanearse — lo suficientemente oscura como para que la binarización del motor la trate como un objeto de primer plano. Los caracteres que intersectan la sombra se oscurecen o se dividen en fragmentos. En documentos muy doblados, el cambio de elevación del papel en el pliegue empuja la página fuera de la profundidad de campo del escáner, añadiendo una banda de desenfoque a la sombra. La combinación crea una entrada de OCR de caso peor: alta variación de contraste, caracteres desenfocados y formas de glifos rotas.
La solución: Inpainting — rellenar regiones dañadas interpolando desde píxeles circundantes — es el remedio más efectivo. El cv2.inpaint() de OpenCV con el algoritmo Telea elimina las sombras de los pliegues mientras preserva el texto subyacente. Comience con un radio de inpainting de 3–5 píxeles. Para bordes rasgados donde el texto se ha eliminado físicamente, la dilatación morfológica (un kernel de 2×2 en la imagen binaria) reconecta trazos rotos, a menudo convirtiendo fragmentos irreconocibles de nuevo en glifos legibles.
Cómo crear un pipeline de preprocesamiento que maneje múltiples defectos
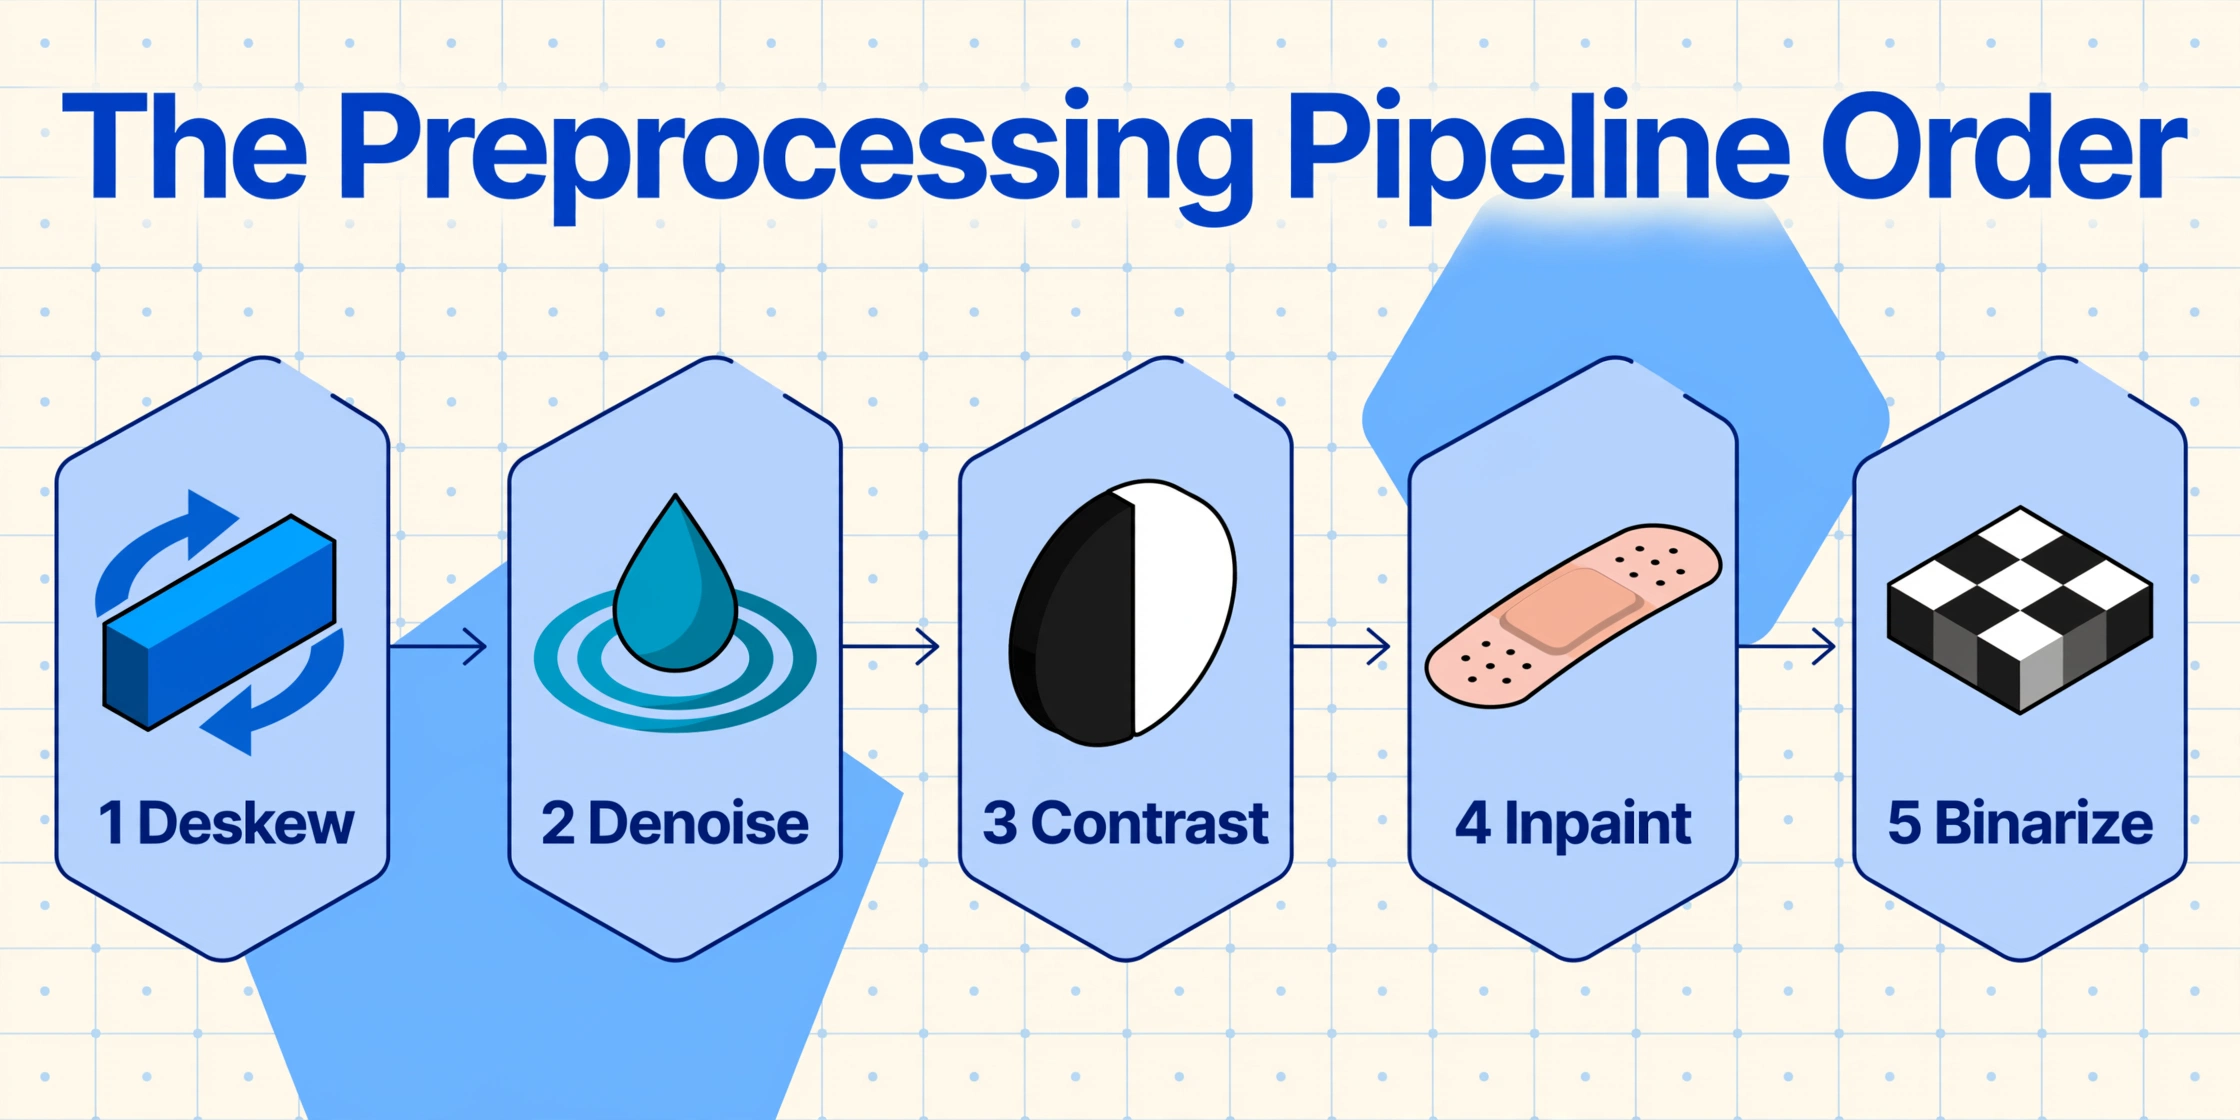
La mayoría de los documentos escaneados del mundo real tienen más de un defecto. Un contrato enviado por fax puede llegar con bajo DPI y artefactos de ruido. Una orden de compra antigua podría tener tinta desvanecida y un pliegue. El orden en que aplica los pasos de preprocesamiento es importante.
El orden de pipeline recomendado para documentos escaneados con múltiples problemas de calidad:
Este pipeline no es teórico: se ha validado en miles de imágenes de documentos degradados en múltiples puntos de referencia de OCR. Una guía dedicada a mejorar la precisión del OCR cubre técnicas de posprocesamiento adicionales, incluida la corrección basada en modelos de lenguaje, la validación a nivel de campo y la puntuación de confianza.
Cuando el Preprocesamiento No Es Suficiente
El preprocesamiento puede llevar un documento de "ilegible" a "utilizable", pero solo hasta cierto punto. Si su fuente se escaneó a 72 DPI en un escáner plano sucio, luego se envió por fax y se escaneó de nuevo, hay un límite a lo que la limpieza algorítmica puede recuperar. En algún momento, la pregunta cambia de "¿cómo arreglo esta imagen?" a "¿estoy usando el enfoque de extracción correcto?"
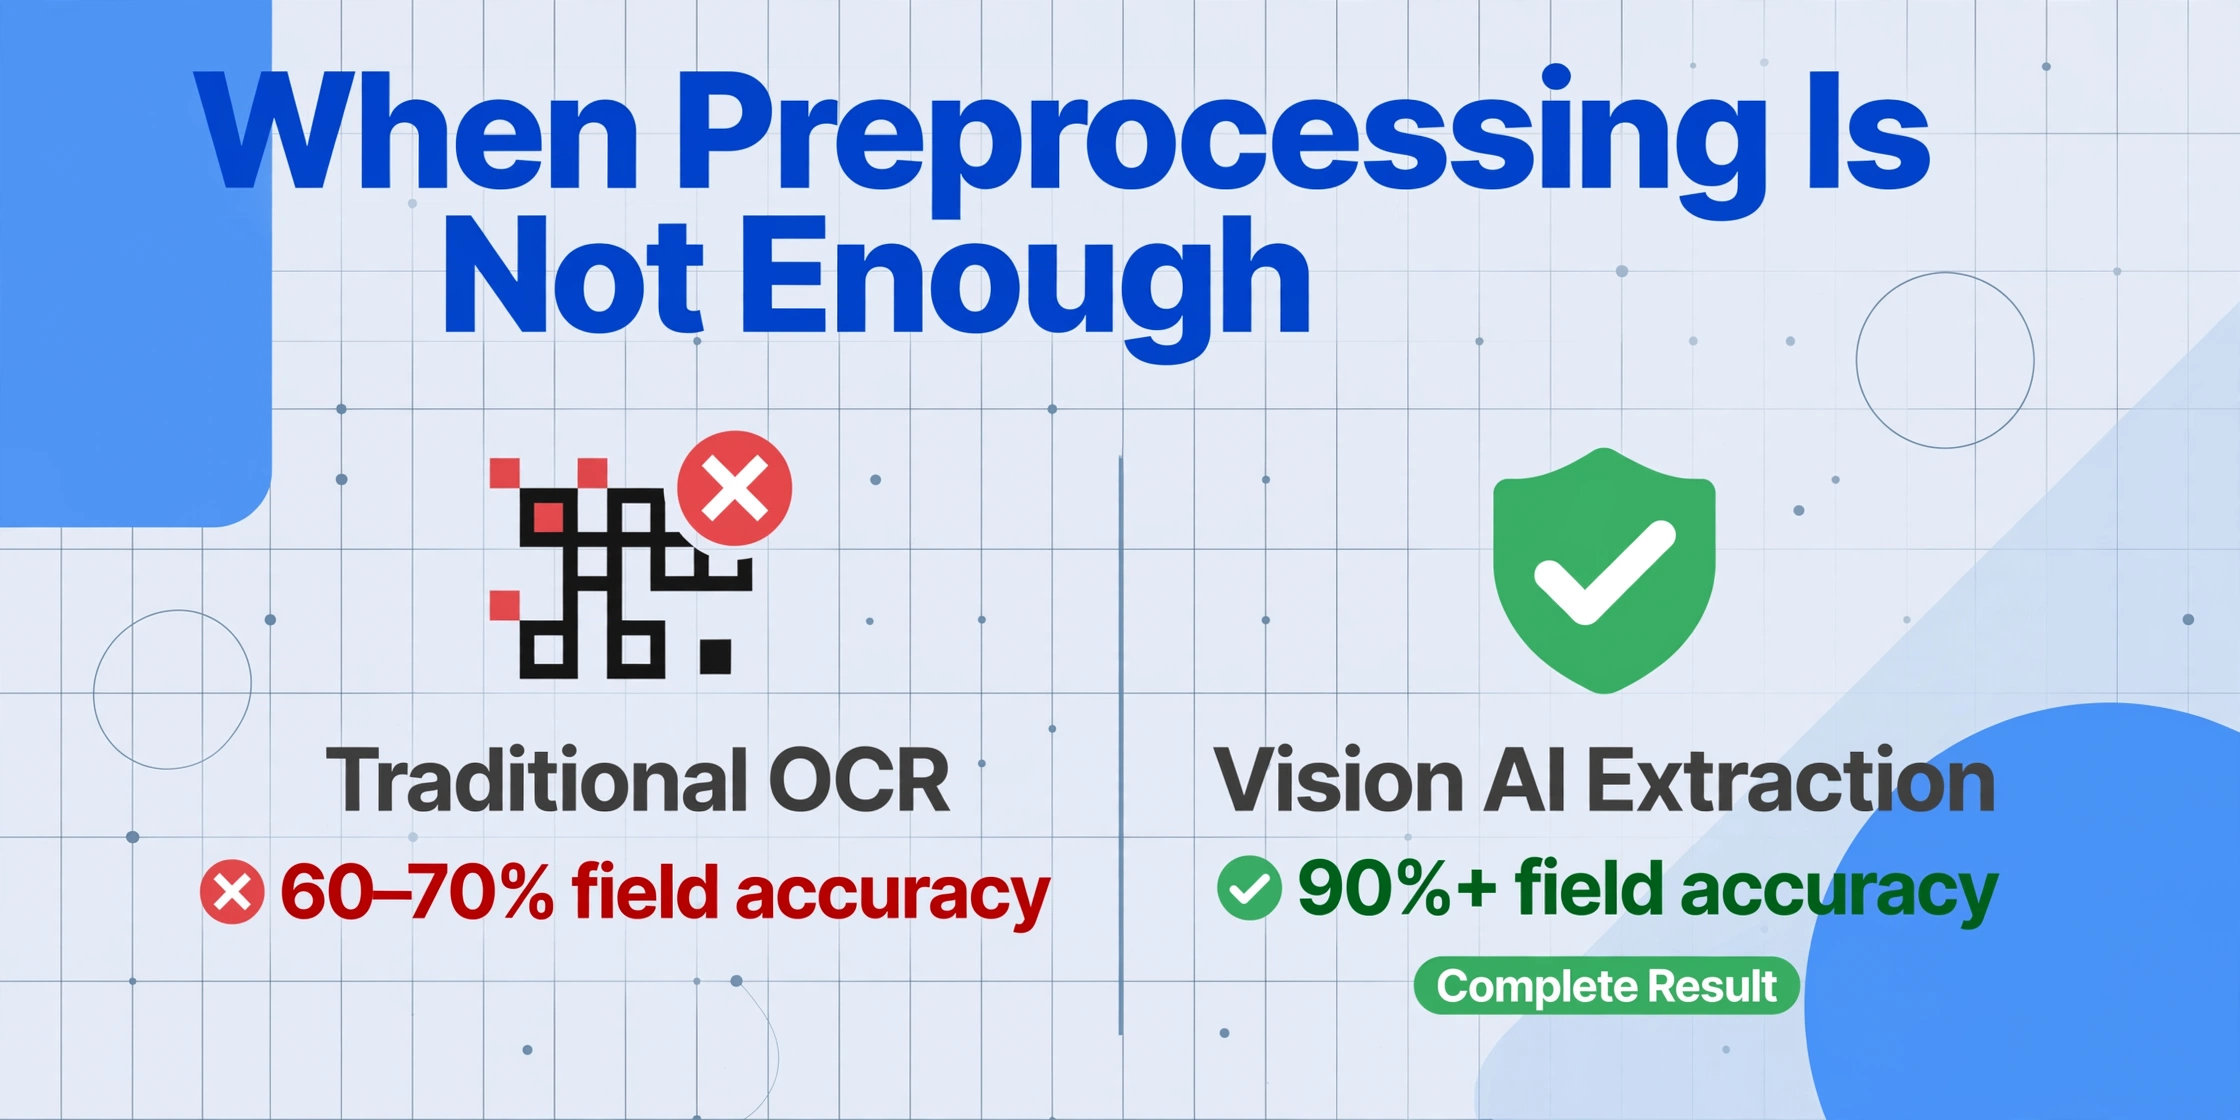
El OCR tradicional (Tesseract, ABBYY FineReader, la mayoría de las API de OCR en la nube) funciona reconociendo formas de caracteres individuales. Es fundamentalmente a nivel de píxeles. Si los píxeles están dañados, la salida está dañada. La extracción moderna con IA basada en visión lee el documento como una escena visual completa. Entiende que una palabra es una palabra incluso cuando faltan algunos de sus píxeles, porque compara con el significado, no con una plantilla de forma de carácter.
La diferencia se nota más en documentos con múltiples defectos. Una factura con copia carbón con impresión púrpura tenue, una ligera inclinación por la esquina grapada y un pliegue sobre la dirección del proveedor: el OCR tradicional podría producir una precisión de campo del 60–70% en esta entrada. Una herramienta de IA de visión a menudo puede alcanzar el 90% o más porque trata la sombra del pliegue como "no texto" y lee alrededor de ella. Los diferentes tipos de documentos responden de manera distinta a la degradación de la precisión, pero el principio es consistente: cuando el daño está en los píxeles, la solución puede necesitar estar en el paradigma.
Preguntas frecuentes
¿Cuál es el DPI mínimo para un OCR fiable en documentos escaneados?
300 DPI es el estándar del sector. Por debajo de 200 DPI, la precisión a nivel de caracteres se degrada de forma medible en la mayoría de los motores de OCR. Por debajo de 150 DPI, la precisión cae por debajo del 90 % para texto impreso estándar. Si su texto tiene un tamaño inferior a 10 puntos, se recomiendan 400–600 DPI. Por encima de 600 DPI existe un efecto de techo: las resoluciones más altas aumentan el tamaño del archivo sin mejoras significativas de precisión para el texto documental típico.
¿Puede la IA extraer datos de documentos escaneados de muy baja calidad?
Los modelos de IA de visión son significativamente más tolerantes a los defectos de imagen que el OCR tradicional, porque procesan la página de forma semántica y no píxel a píxel. Un documento legible para el ojo humano —aunque sea apenas— suele ser extraíble. La excepción son los documentos donde el texto es realmente invisible (tinta completamente desvanecida o papel físicamente rasgado). Ninguna tecnología puede recuperar datos que no existen en la imagen.
¿Enderezar el documento mejora realmente la precisión del OCR en una cantidad significativa?
Sí. Una inclinación de 5 grados aumenta la tasa de error por palabra entre un 10 y un 15 % en los motores de OCR tradicionales. A 10 grados, la pérdida puede superar el 30 %. El enderezado es uno de los pasos de preprocesamiento con mayor retorno de inversión: cuesta prácticamente nada en tiempo de procesamiento y produce mejoras constantes.
¿Qué ocurre si mi escaneo tiene tanto DPI bajo como ruido? ¿Qué corrijo primero?
Corrija primero el ruido y luego aborde la resolución. Reducir el ruido en una imagen de baja resolución es más eficaz que lo contrario: si aumenta la resolución primero, amplifica el ruido junto con el texto. El orden del flujo de trabajo en esta guía sigue este principio: reducción de ruido antes del realce de contraste, y realce de contraste antes de cualquier operación dependiente de la resolución.
¿Puedo usar una foto de teléfono inteligente en lugar de un escaneo de cama plana?
Las fotos de teléfonos inteligentes introducen distorsión de perspectiva, desenfoque de lente e iluminación desigual que los escaneos de cama plana no tienen. Si dispone de un escáner de cama plana, este producirá resultados más consistentes. Si debe usar un teléfono, tome la foto directamente desde arriba de la página, use luz natural uniforme y capture a la máxima resolución; la mayoría de los teléfonos modernos superan el equivalente a 300 DPI cuando se sostienen lo suficientemente cerca.
El Enfoque Sistemático Gana
La baja precisión de OCR en documentos escaneados no es aleatoria. Es el resultado de defectos de imagen identificables, cada uno con un mecanismo conocido y una solución específica. El error que comete la mayoría de las personas es aplicar filtros genéricos de "mejora" al problema: ajustar el brillo y el contraste arbitrariamente, esperando que algo funcione.
El enfoque sistemático es más simple: observe su salida de OCR, identifique el patrón de error, rastree su causa raíz y aplique la solución única. DPI bajo → aumente la resolución o vuelva a escanear. Inclinación → enderece. Ruido → filtro de mediana. Desvanecimiento → CLAHE. Pliegues → relleno de imágenes. Cuando el documento tiene múltiples defectos, aplique las soluciones en orden de dependencia: ruido antes que resolución, enderezar antes que todo lo demás.
Si ha aplicado las soluciones correctas en el orden correcto y la precisión sigue siendo inferior a la que su flujo de trabajo requiere, la limitación no es su preprocesamiento, sino el paradigma de extracción. Una herramienta de IA de visión que lee documentos por significado en lugar de por forma de píxel puede ser el camino más rápido hacia resultados utilizables. Aprenda más sobre la validación a nivel de campo y los métodos de verificación de precisión para cuando el preprocesamiento por sí solo no sea suficiente.